
📝 TLDR
强化学习中的critic通常估计绝对状态价值V(s),但控制只依赖价值差异。本文提出相对价值学习(RV),通过反对称函数Δ(s_i,s_j)=V(s_i)-V(s_j)直接学习价值差,构造配对Bellman算子证明其γ-收缩性,推导1步、n步、λ-回报目标并重建广义优势估计R-GAE。嵌入PPO后在49款ALE Atari游戏中取得与标准PPO相当的竞争性能。
🧭 速览
RL中critic通常估计绝对状态价值V(s),但控制决策只依赖价值差异,绝对值的标定存在冗余。
用反对称差分函数Δ(s_i,s_j)=V(s_i)-V(s_j)替代绝对价值,构造配对Bellman算子,推导1步、n步、λ-回报目标与R-GAE策略梯度估计器。
在49款ALE Atari基准上,RV-PPO与标准PPO性能相当,相对价值估计成为绝对critic的有效替代。
从理论收敛保证到Atari实证均验证了相对价值学习的可行性与有效性。
🆚 方法对比
Relative Value Learning (RV)
- 通过反对称函数从模型层面消除规范自由度
- 理论上证明成对贝尔曼算子为γ-收缩且有唯一不动点
- 在49个ALE游戏中与标准PPO取得有竞争力性能
- 天然适配偏好/人类反馈等仅有成对关系的RL场景
- 需处理O(N²)状态对的计算与采样开销
- 实验仅在Atari基准49个游戏上验证,泛化性待检验
- 实现复杂度高于标准绝对值批评器
- 目前仅与PPO集成,未验证其他on-policy算法
R-GAE (Relative GAE)
- 从成对值差异重构优势估计,策略梯度无偏
- 与标准GAE存在明确数学关系,易于分析
- 不依赖任何绝对值估计,降低标度敏感性
- 需额外成对状态采样,增加数据需求
- 估计质量受限于RV批评器的成对学习精度
- 推导与实现均比标准GAE更复杂
标准PPO + GAE (AV基线)
- 广泛验证的工业标准基线,实现简洁
- 信任域裁剪保证策略更新稳定
- 单状态输入,计算效率高,生态成熟
- 批评器估计绝对值,受规范自由度影响
- 奖励缩放或基线变化时易产生偏移
- 在偏好/隐式反馈场景下不适定
- 需额外基线减除以控制方差
Absolute Value Learning (AV)
- 理论框架简洁,贝尔曼方程直接应用
- 单状态前向计算,推理高效
- 数十年研究积累,成熟度高
- 绝对标度对控制无实际行为意义
- 存在规范自由度带来冗余参数空间
- 在奖励整形或基线变化时估计易漂移
- 无法直接处理仅有成对比较的反馈信号
RV通过直接学习成对值差异替代绝对值批评,从模型层面消除规范自由度并天然适配偏好RL;R-GAE将这一思想嵌入PPO,在Atari 49个游戏上与标准PPO+GAE取得有竞争力性能,但代价是更高的成对采样与计算复杂度。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
强化学习的评论器通常估计绝对状态价值,但控制只需要价值差异。本文提出相对价值学习(RV),通过反对称函数直接学习状态间的价值差,构造的成对Bellman算子被证明具有-收缩性,确保收敛到真实价值差。核心贡献包括适定的多步回报目标、无偏的策略梯度估计器R-GAE,以及轨迹排序初始化来控制方差。在49款Atari游戏中,RV嵌入PPO后取得了与标准PPO相当的性能,证明相对价值是绝对评论器的有效替代。
研究背景与动机
强化学习中的评论器(critic)传统上估计的是绝对状态价值函数,即在给定策略下从状态开始的期望累计折扣奖励。这个绝对值衡量的是"这个状态本身有多好"。然而,当我们审视强化学习的控制目标时,会发现一个根本性的不对称:决策行为——无论是贪心选择还是计算优势函数——本质上只依赖于状态或动作之间的相对差异。
这种不对称性揭示了一个长期被忽视的"规范自由度"(gauge freedom)问题。对任意常数,将价值函数平移为,同时将奖励塑形为,新的价值函数仍然满足Bellman方程,但更重要的是,所有动作偏好和优势函数保持完全不变。这意味着当我们只需要相对排序来做决策时,绝对标定是一个多余的自由度——它不仅没有提供决策所需的信息,还可能引入不必要的复杂性。
规范自由度在多个实际场景中造成具体困扰。在基于人类反馈的强化学习(RLHF)中,人类通常给出的是两两比较或偏好信号,而非绝对评分。在奖励塑形场景中,基线选择的变化会导致绝对价值飘移,但决策边界不应随之改变。在分布式强化学习中,不同worker的critic可能学到相差甚远的绝对值偏移,合并时需要额外校准。这些问题共同指向一个方向:与其学习一个本质上不确定的绝对值,不如直接从价值差异出发。
方法
基于上述洞察,作者提出相对价值学习(RV),其核心是学习一个反对称配对函数来近似真实价值差。这个函数必须满足和这两个约束,它们由网络架构天然保证:使用孪生编码器提取状态特征,然后将两个特征的差通过一个无偏置的线性投影。
形式上,作者引入成对Bellman恒等式。假设从状态和分别独立采样下一个状态和,有:
这推广了标准的单状态Bellman方程到配对形式。基于此,作者定义成对Bellman算子。一个关键的理论结果是定理3.1:在有界函数空间中,成对Bellman算子是-收缩的,即
由Banach不动点定理,这保证了唯一不动点的存在性,且该不动点恰好等于真实价值差。这为整个框架奠定了理论基础。
有了收缩算子,接下来需要构造可学习的回报目标。作者详细推导了1步目标,处理了终局状态带来的技术挑战——当或为终局时,期望中的下一项需要根据四种终局组合(00、01、10、11)分别给出明确定义,避免分母为零的未定义情况。更一般地,n步目标为:
通过指数加权混合多个n步目标,可以得到-回报目标。
策略梯度的核心是需要优势估计。作者提出了R-GAE(相对广义优势估计)。其构造颇为巧妙:首先定义一个"零锚定"的相对价值序列,以开始,然后通过累积构建每个状态的相对价值:
由此定义相对TD残差,并类似标准GAE构造优势估计。
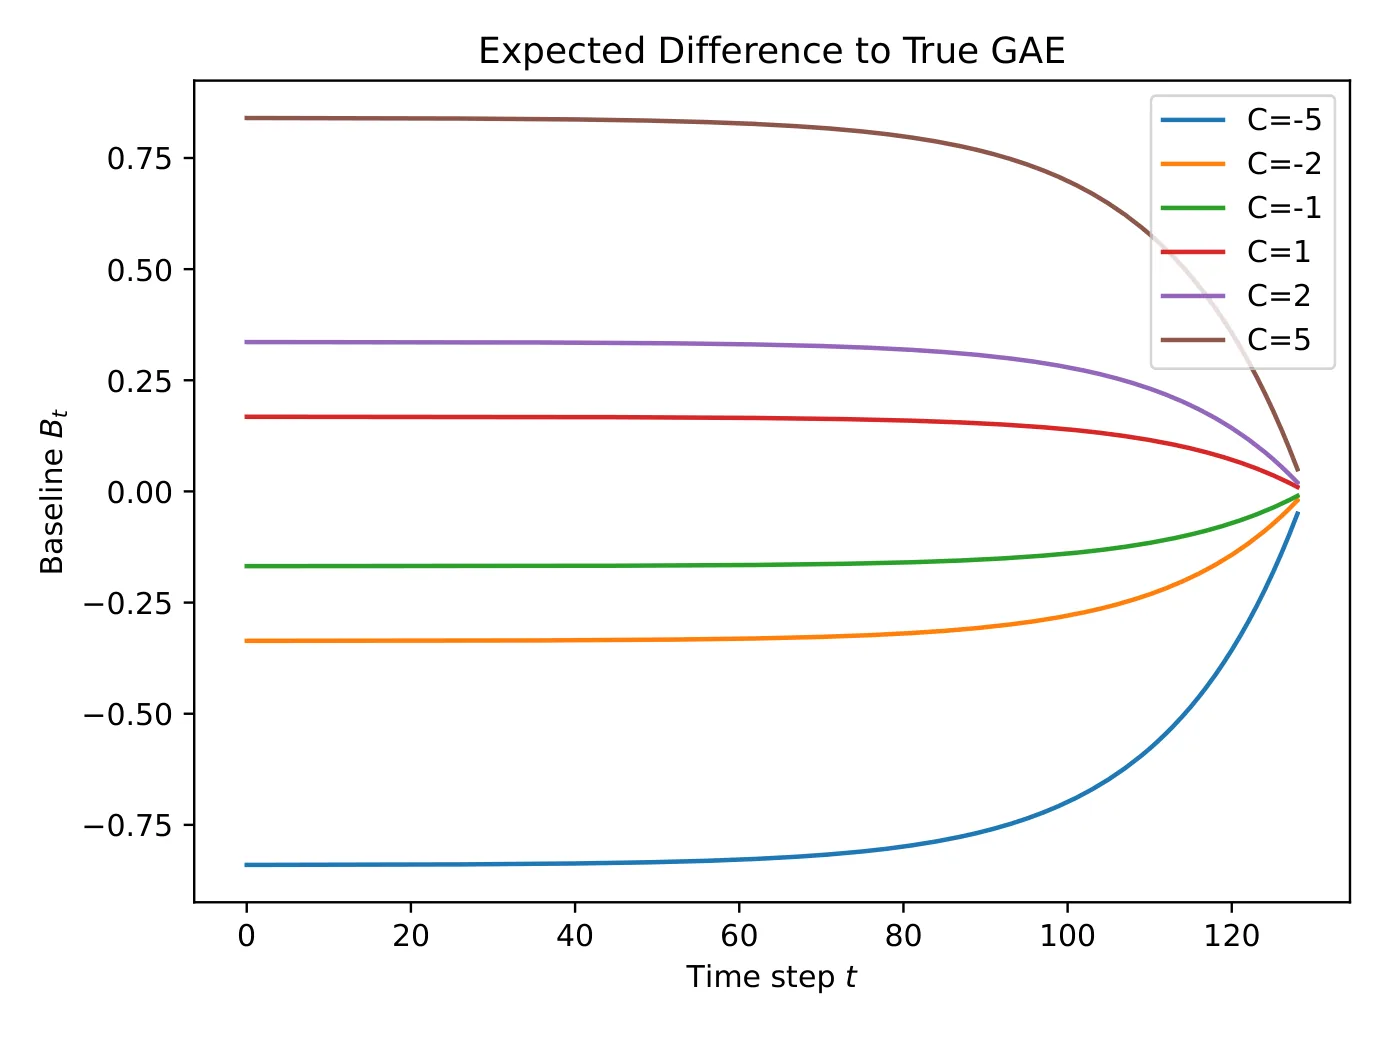
一个重要发现是引理3.2揭示的代数关系:,其中是一个轨迹常数项,与初始状态的真实价值相关。关键在于推论3.3:当将R-GAE优势代入[[策略梯度]]估计器时,在给定历史轨迹下的条件期望为零,因此策略梯度估计仍然无偏。唯一的代价是方差会增加一个与成正比的项。
为了控制这个方差项,作者提出轨迹排序初始化(Trajectory Ranking)。其思想是在batch中抽取多个轨迹的起始状态,构建价值差矩阵,用行均值减去batch最小值得到一个非负偏移估计。这个偏移量作为相对价值的"伪绝对参考点",使得不同轨迹的价值估计对齐到相近的尺度,从而让在期望意义上趋近于零。
最终的训练目标将PPO的策略损失与相对critic的回归损失以及熵正则化项相结合。值得注意的是配对采样的设计:33%的配对来自同一轨迹(提供短期差异信号),67%来自随机配对(提供跨轨迹的相对排序信号)。
实验与结果
实验在[[Atari]]基准的Arcade Learning Environment(ALE)上进行,涵盖49款游戏,使用标准的PPO预处理流程(84×84灰度图、4帧堆叠、frame skip等),训练40M帧。作者将PPO+RV与标准PPO以及直接优势估计(DAE)进行对比,后者是近期一个相关的基线方法。
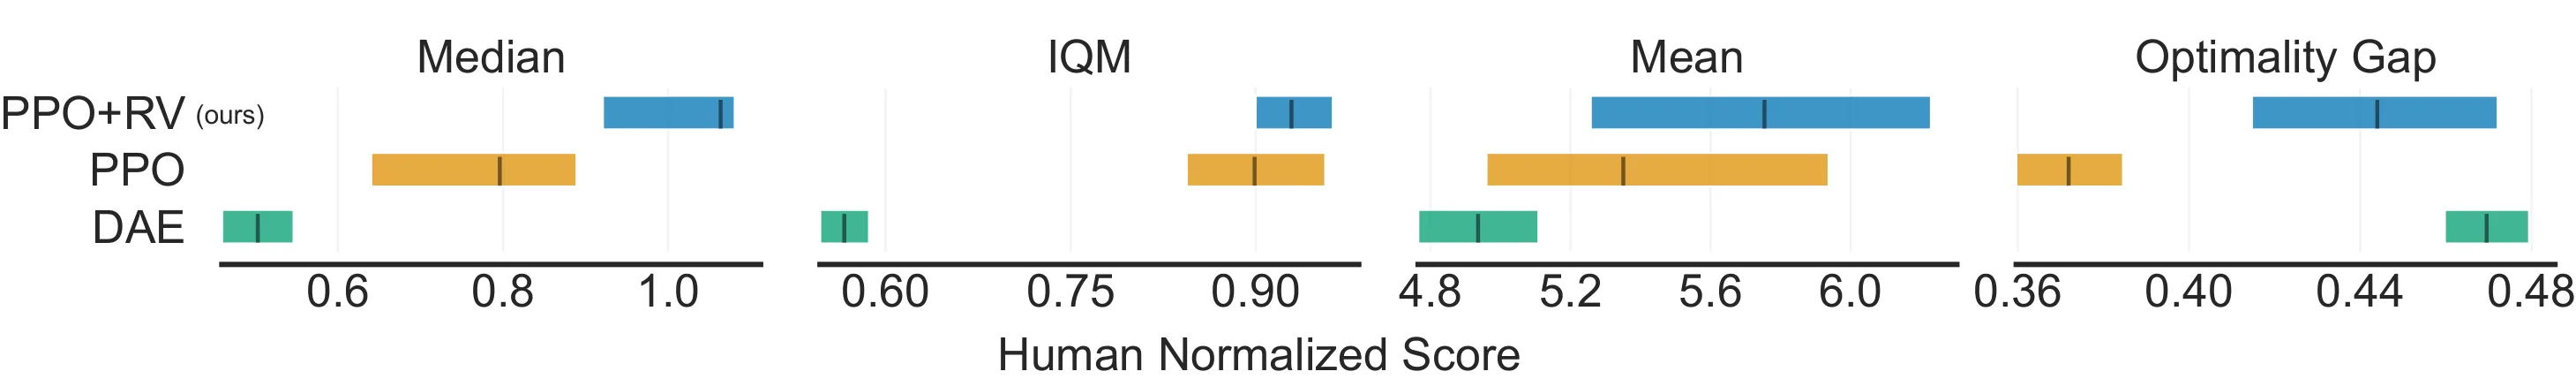
在单游戏层面,PPO+RV在30/49(61%)款游戏中超越了标准PPO,在37/49(75%)款游戏中超越了DAE。聚合指标方面,作者使用了IQM(区间四分位数均值)、中位数和最优性差距等鲁棒统计量。结果显示,PPO+RV在所有聚合指标上全面优于DAE,与标准PPO相当或略有优势。特别值得注意的是,PPO+RV在某些游戏中展现出显著提升,而几乎没有出现灾难性的性能下降。
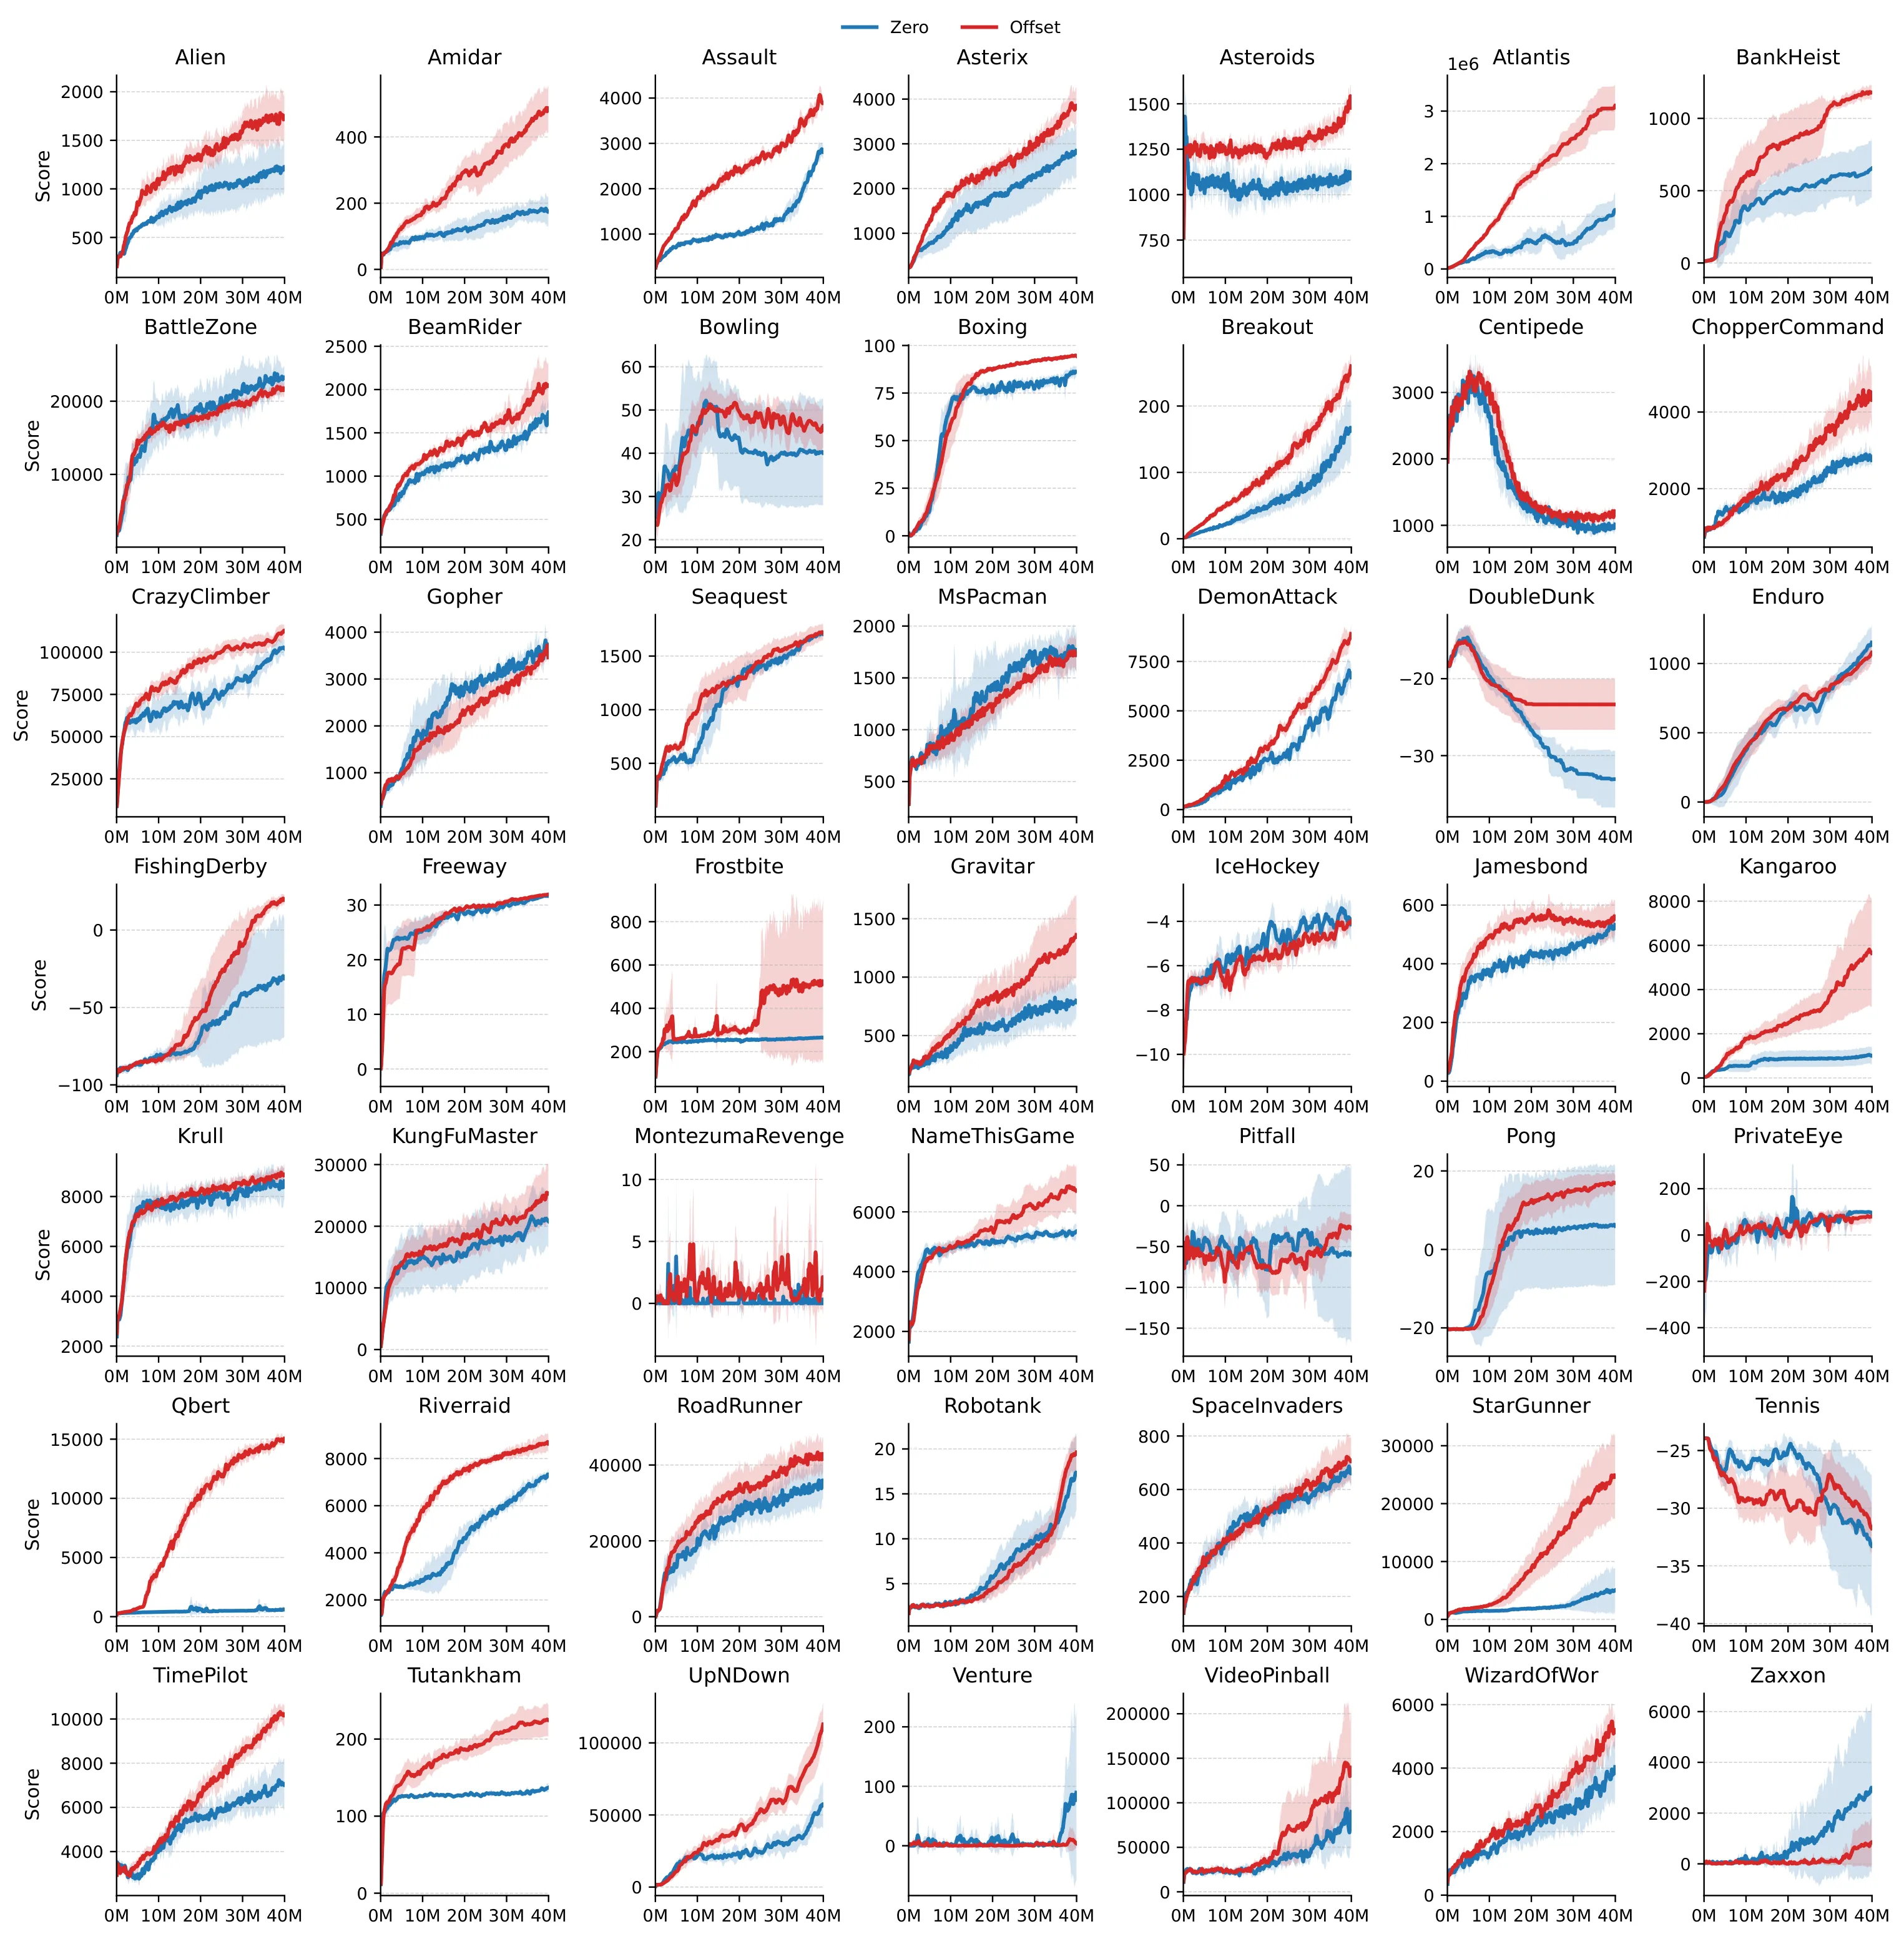
消融实验验证了轨迹排序初始化的有效性:相比简单的零初始化,带偏移的初始化在大多数游戏上表现更好,证实了控制方差的理论预期。配对采样策略的消融则表明,同轨迹配对比例过高时会损害性能,可能是因为这种配对丢失了跨轨迹的相对排序信息。
讨论与可借鉴点
这项工作的核心贡献在于理论层面:它将"控制只看相对差异"这一直觉严格化,构造了一套自洽的算子理论和学习目标。从这个角度看,成对Bellman算子的-收缩性是一个漂亮的结果,它说明在[[价值函数学习]]中消除规范自由度并不会牺牲收敛保证。
然而,这项工作也面临若干局限。首先,轨迹常数虽然在策略梯度无偏性上被"消除",但其方差效应仍然存在,轨迹排序初始化只是部分缓解了这一问题——论文自己也承认没有给出完整解决方案。其次,相对critic的表达力受到反对称结构的约束,强制要求可能限制了某些需要偏离这一约束的表示。
从实践角度,RV提供一个即插即用的critic替代方案:网络架构和超参数几乎不需要改变,就可以在标准PPO框架中尝试。在偏好学习或人类反馈强化学习场景中,由于人类天然给出的是相对偏好信号而非绝对评分,RV可能有更大的用武之地,但论文目前只在监督式Atari游戏上验证,连续控制或其他[[强化学习]]范式的表现仍是未知数。
对于研究者而言,这篇论文提供了一个值得借鉴的思路:从决策需求反推学习目标。当发现某个看似必要的设计(如绝对价值估计)实际上与最终目标(如动作选择)无关时,重新审视其必要性可能带来理论简化与实践改进的契机。
摘要
在强化学习中,评论器通常估计绝对状态价值 ,评估某个特定情境在孤立状态下的好坏。然而,事实上只有价值差异才对控制具有意义。受此启发,我们提出了相对价值学习(RV),一个通过反对称函数 直接学习价值差异的框架。我们引入成对 Bellman 算子,并证明其为 -收缩算子,存在唯一不动点等于真实价值差异;推导了适定的 步、 步及 -回报目标;并基于成对差异重构广义优势估计,得到无偏的策略梯度估计器(R-GAE)。除理论结果外,我们将 RV 与 PPO 相结合,在 Atari 基准测试(49 个 ALE 游戏)上取得了与标准 PPO 相当的竞争性能,表明相对价值估计是绝对评论器的有效替代方案。
Abstract
In reinforcement learning, critics typically estimate absolute state values , estimating how good a particular situation is in isolation. However, it turns out that only differences in value are relevant for control. Motivated by this, we propose Relative Value Learning (RV), a framework that learns value differences directly via an antisymmetric function . We introduce a pairwise Bellman operator and prove it is a -contraction with a unique fixed point equal to the true value differences, derive well-posed -step, -step and -return targets and reconstruct generalized advantage estimation from pairwise differences to obtain an unbiased policy-gradient estimator (R-GAE). Beyond theoretical results, we integrate RV with PPO and achieve competitive performance on the Atari benchmark (49 ALE games) compared to standard PPO, indicating that relative value estimation is an effective alternative to absolute critics.
论文详细总结(自动生成)
论文详细总结:Relative Value Learning(相对价值学习)
1. 核心问题与研究动机
- 量纲冗余问题:在标准强化学习中,评论器(critic)通常估计绝对状态价值 ,但决策(如贪心动作选择 或优势函数 )只依赖状态/动作间的相对差异。对任意常数 平移 后,所有动作偏好和优势都保持不变——这是一个固有的"规范自由度"(gauge freedom)。
- 绝对标定的副作用:绝对值标定带来不必要的自由度,对奖励塑形(reward shaping)或基线变化敏感;在只给定两两比较/偏好反馈的人类反馈 RL 场景下,绝对标定的合理性更成问题。
- 研究视角的转变:把"价值差异"放在首位,作为 critic 学习的基本对象,消除规范自由度并对齐决策本身的相对不变性。
2. 方法论
2.1 核心思想
学习一个反对称配对差分函数:
近似真实价值差 。
2.2 关键技术细节
- 成对 Bellman 恒等式(独立采样两个后继状态):
- 成对 Bellman 算子(在反对称有界函数 Banach 空间 上):
- 定理 3.1(-收缩与唯一性):
由 Banach 不动点定理, 有唯一不动点 。
- 规范不变性(Lemma B.1):对 加任意常数 (配合 reward shaping ),得到的 仍满足 Bellman 方程,且 、。
- 适定目标的推导(应对终局状态让目标分母无法定义的难题):
1-step 目标:
其中按 四种终局组合给出 的具体形式(例如两者皆终局时 ,单边终局时使用 等)。
n-step 目标:
-回报目标:以权重 混合多个 -step 目标。
- R-GAE(相对广义优势估计):
通过"零锚定"构造相对值序列 ,定义相对 TD 残差和优势:
- 关键定理(Lemma 3.2 / Corollary 3.3):
代入策略梯度后,由于 在给定历史下的条件期望消失,,即仍然无偏,但方差正比于 (Lemma C.1)。
- 轨迹排序初始化(Trajectory Ranking, §4):为缓解 对长 horizon 的方差放大,作者提出:跨多个 rollout 抽取其"开始状态",构建 的 矩阵,用行均值减去 batch 内最小值得到非负偏移估计 :
期望让 。
- 网络结构:与 PPO 相同的 CNN 编码器 共享,相对 critic 用孪生差分头
其中 取为单一向量 (无偏置),由构造保证反对称性和 。
- 训练目标:
其中
对采样策略 :33% 同轨迹、67% 随机配对(Appendix E 消融)。
3. 实验设计
- 基准场景:Arcade Learning Environment(ALE)Atari,49 款游戏的标准 PPO 预处理(random no-op resets、frame skip + max-pool、灰度缩放 、 帧堆叠、缩放到 )。
- 模拟器:EnvPool,训练 M 帧(M 环境步)。
- 基线方法:
- PPO(标准绝对 critic)
- DAE(Direct Advantage Estimation,Pan et al. 2022)
- PPO+RV(本文):把 PPO 的 critic 替换为相对 critic,使用 R-GAE 优势
- 评估指标:每个游戏 10 个种子,取最后 100 个 episode 的均值;同时报告 Median/IQM/Mean/Optimality Gap 等聚合指标(用 95% 分层 bootstrap 置信区间)。
- 消融实验:
- 相对值初始化对比(zero vs. trajectory ranking offset,Figure 4)
- 配对采样策略对比(p=0 / 0.33 / 0.66,Appendix E)
4. 资源与算力
- GPU:单卡 NVIDIA A100,12 核 CPU 配合使用。
- 单次训练时长:每个 40M 帧 run 约 65 分钟。
- 总开销:49 游戏 × 10 种子 = 490 次 run,折合 530 GPU-hours,约 22.1 A100-days。
- 这是论文中明确给出的算力信息。
5. 实验数量与充分性
- 数量上:49 游戏 × 10 种子 = 490 个主实验 + 多组聚合图(Figure 3)+ 大规模消融(Figure 4 覆盖全部 49 游戏的零/有偏移训练曲线 + Table 4 五种子对策略对比)——在样本量上较为充分。
- 公平性:
- 所有方法使用完全相同的网络架构(标准 PPO CNN)、相同超参数(见表 3:,等等),保证只比较 critic 设计的差异。
- 与 DAE、PPO 报告同样 40M 帧预算下的最终成绩。
- 不足:论文自己也承认,实验仅在 PPO + 离散动作 Atari 上,未在其他算法族、连续控制、off-policy 设置上验证;并且 10 颗种子在 Atari 上方差较大(某些游戏中标准差甚至超过均值),导致胜负判定需谨慎。
6. 主要结论与发现
- 理论方面:
- 成对 Bellman 算子是 -收缩,有唯一不动点=真实价值差。
- 1/n-step/ 回报目标在反对称差分函数空间内适定可采样。
- R-GAE 是标准 GAE 的相对版本:,其中 是依赖零锚点的轨迹常数。
- 替换 进入策略梯度仍保持无偏(Corollary 3.3),只是方差多出 的噪声项。
- 实证方面:
- PPO+RV 在 30/49 (61%) 游戏上超过 PPO;37/49 (75%) 超过 DAE。
- 聚合 IQM / Median / Optimality Gap 等指标全面优于 DAE,与 PPO 相当或略有优势(Figure 3)。
- 轨迹排序初始化消融显示,对多数游戏而言有偏估计优于零初始化(Figure 4)。
- 配对采样对性能影响较小,但当 (同轨迹概率)过大时性能有所下降(Table 4)。
7. 优点(亮点)
- 理论与几何视角吻合:从"决策只看相对量"出发得到一套自洽的算子、目标和算法;反对称性 + 由网络结构硬编码保证,而非依赖后处理。
- 算法实现简洁:仅替换 PPO 的 critic 与优势信号,网络架构/超参几乎不变,便于复现。
- 理论严谨性:给出了 1-step 目标终局情况的全部 4 种 case 详细推导,并通过数值小例子(Table 2/Figure 5)验证 的代数预言。
- 方差分析清晰:Lemma C.1 显式分解出 主导的方差放大项,并为缓解它给出 trajectory ranking 的实现路径。
- 配套代码公开:GitHub 仓库已公开。
8. 不足与局限
- 轨迹常数 仍是方差源:仅被部分缓解(per-trajectory 锚点替代 zero),长 horizon 或 时方差仍显著,论文并未给出完整解决方案。
- critic 表达力受限:强制反对称结构 + 单一向量投影(实际近似 linear head)可能在某些游戏上欠拟合,非线性反对称头的潜力未被充分挖掘。
- 配对训练的 复杂度:批大小 上为二次复杂度,需要子采样才能实用,从而以方差换计算。
- 轨迹排序假设:要求 batch 内各轨迹的后基线值在同一可比较尺度上;若不同 episode 的真实值差极大或排序信号本身被噪声主导,初始化可能退化为无效。
- 实验覆盖窄:仅在 on-policy PPO + 离散动作 Atari 上验证;连续动作控制、off-policy 设置、偏好/HITL-RL 等论文宣称最适用的场景没有实证支持。
- 过度规范化风险:理论上规范自由度对控制无意义,但在追求可解释性或下游使用(e.g., 折扣回报分解、终身价值迁移)时,绝对值的缺失可能成为阻碍。
- Atari 噪声大:10 颗种子在 Atari 上的标准差常常很大,单游戏胜负的统计显著性存疑,部分结论(如"60%+ 游戏胜 PPO")应结合 IQM 等聚合指标解读。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。