
TOUR:面向离线强化学习的轨迹级遗忘基准
TOUR: A Trajectory-Level Unlearning Benchmark for Offline Reinforcement Learning
📝 TLDR
离线RL智能体基于固定行为轨迹训练,训练后删除特定轨迹的隐私与效用评估缺乏统一标准。TOUR提出轨迹级遗忘基准,整合轨迹划分、匹配非成员对照、重训练参考与多攻击族隐私审计。实验显示常见删除基线的隐私-效用表现随环境变化,单一似然分数易高估删除质量。结论表明离线RL遗忘评估需依赖匹配对照、重训练相对校准与多维指标联合判断。
🧭 速览
离线RL训练后删除特定轨迹时,单一成员分数难以区分轨迹移除、残余记忆与策略崩溃。
TOUR基准整合轨迹划分、匹配非成员、重训练参考、效用锚点与多攻击族隐私审计。
重训练与微调常优于均匀GA+Refit,TrajDeleter非一致更强,单一似然分数易高估删除质量。
离线RL遗忘结论不稳定于单分数审计,需匹配对照、重训练校准与多攻击族联合判断。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
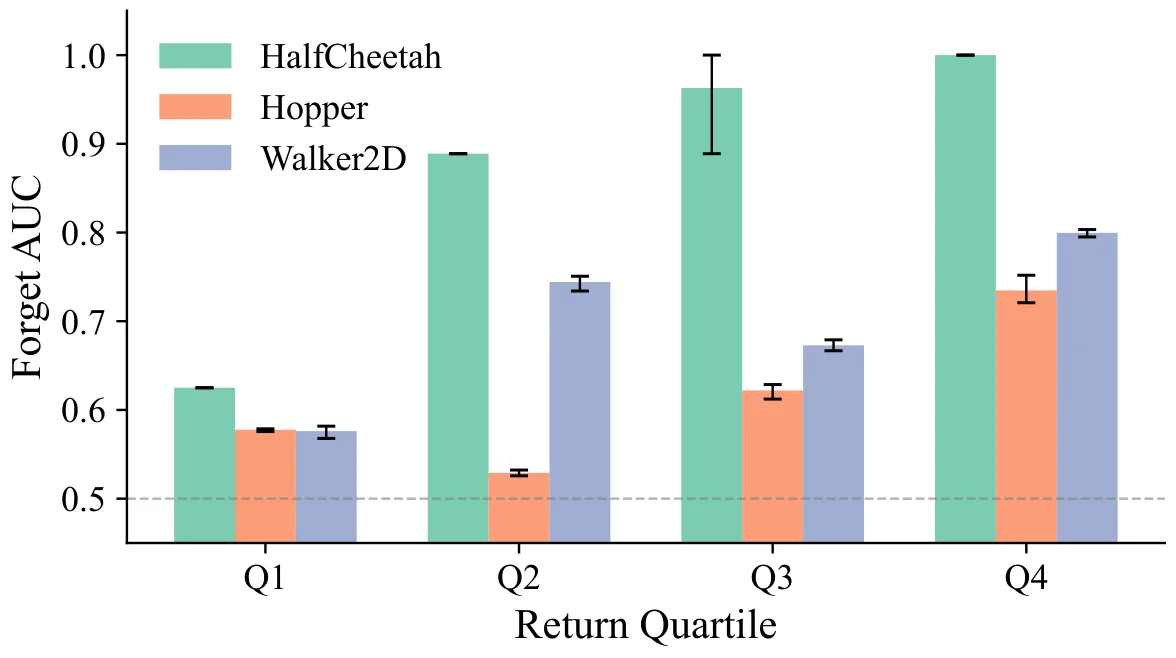
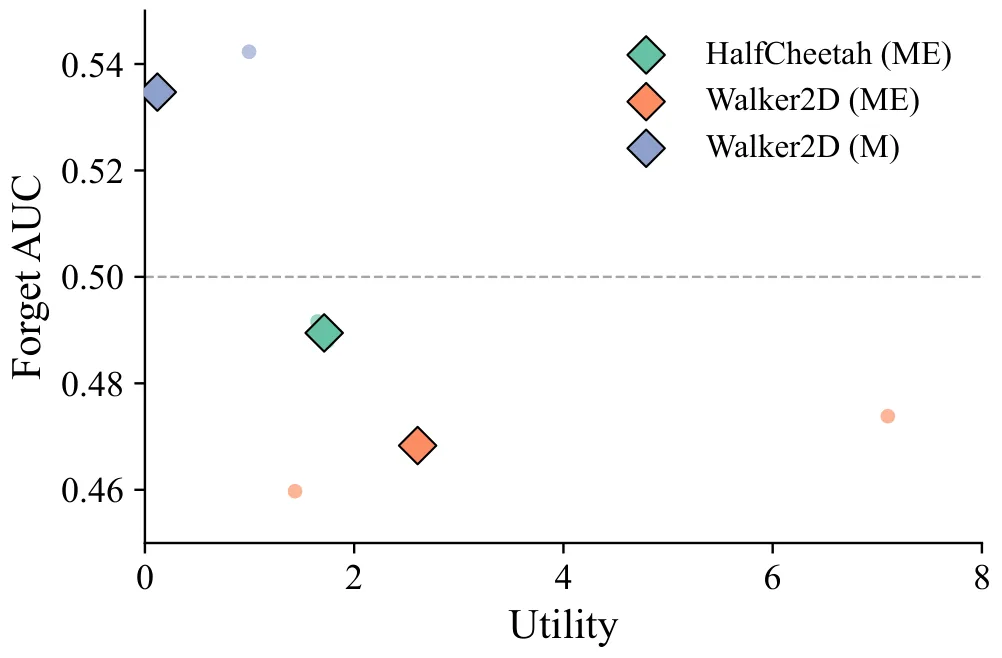
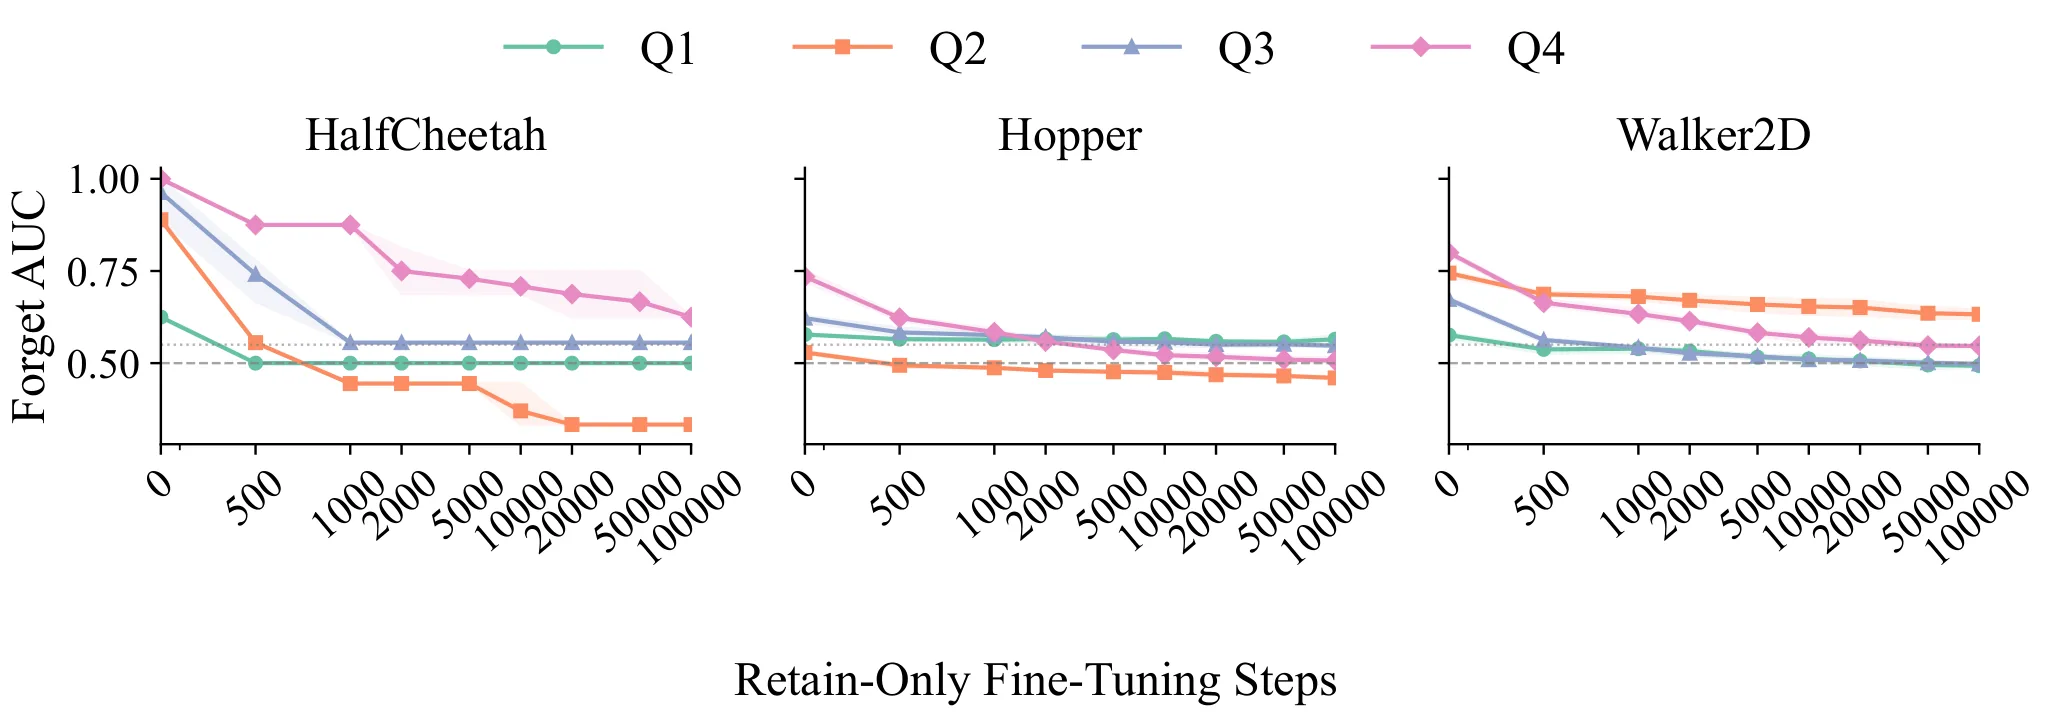
TL;DR
TOUR 是一个面向离线强化学习的轨迹级遗忘基准,旨在统一评估智能体在删除特定轨迹后的隐私保护与性能保留。研究者在 D4RL 运动控制环境和 AntMaze 扩展任务上系统测试了多种删除方法,发现常见的基线策略表现高度依赖环境,单一的似然分数会显著高估删除质量。这一工作揭示了离线 RL 遗忘评估不能依赖单一审计指标,而需要匹配非成员对照、重训练相对校准以及多攻击族联合判断的完整框架。
研究背景与动机
离线强化学习(Offline Reinforcement Learning)智能体的训练数据来自预先收集的行为轨迹集合,而非在线交互。这种训练范式在机器人控制、自动驾驶等场景中广泛应用,因为它避免了危险的在线探索。然而,当训练数据中包含敏感信息、版权内容或需要依法删除的个人数据时,如何在训练完成后将特定轨迹从智能体的"知识"中移除,就成了一个紧迫且尚未被充分解决的问题。
研究者将这个问题称为轨迹级遗忘(Trajectory-level Unlearning)。表面上,遗忘似乎只需要让模型"忘记"某些数据——但问题远非如此简单。一个更低的成员分数(表明轨迹已被遗忘)可能来自三种截然不同的原因:轨迹确实被成功移除;轨迹仍然被记住但对当前攻击不可见;或者模型为了"忘记"而发生了策略崩溃,连带破坏了大量有用的行为能力。这三种情况在评估指标上可能表现为相似的低分数,却对应着完全不同的隐私与效用状态。
此前的研究缺乏统一的基准来系统地比较不同遗忘方法在这种复杂权衡下的表现。TOUR 正是为了填补这一空白而诞生的。
方法
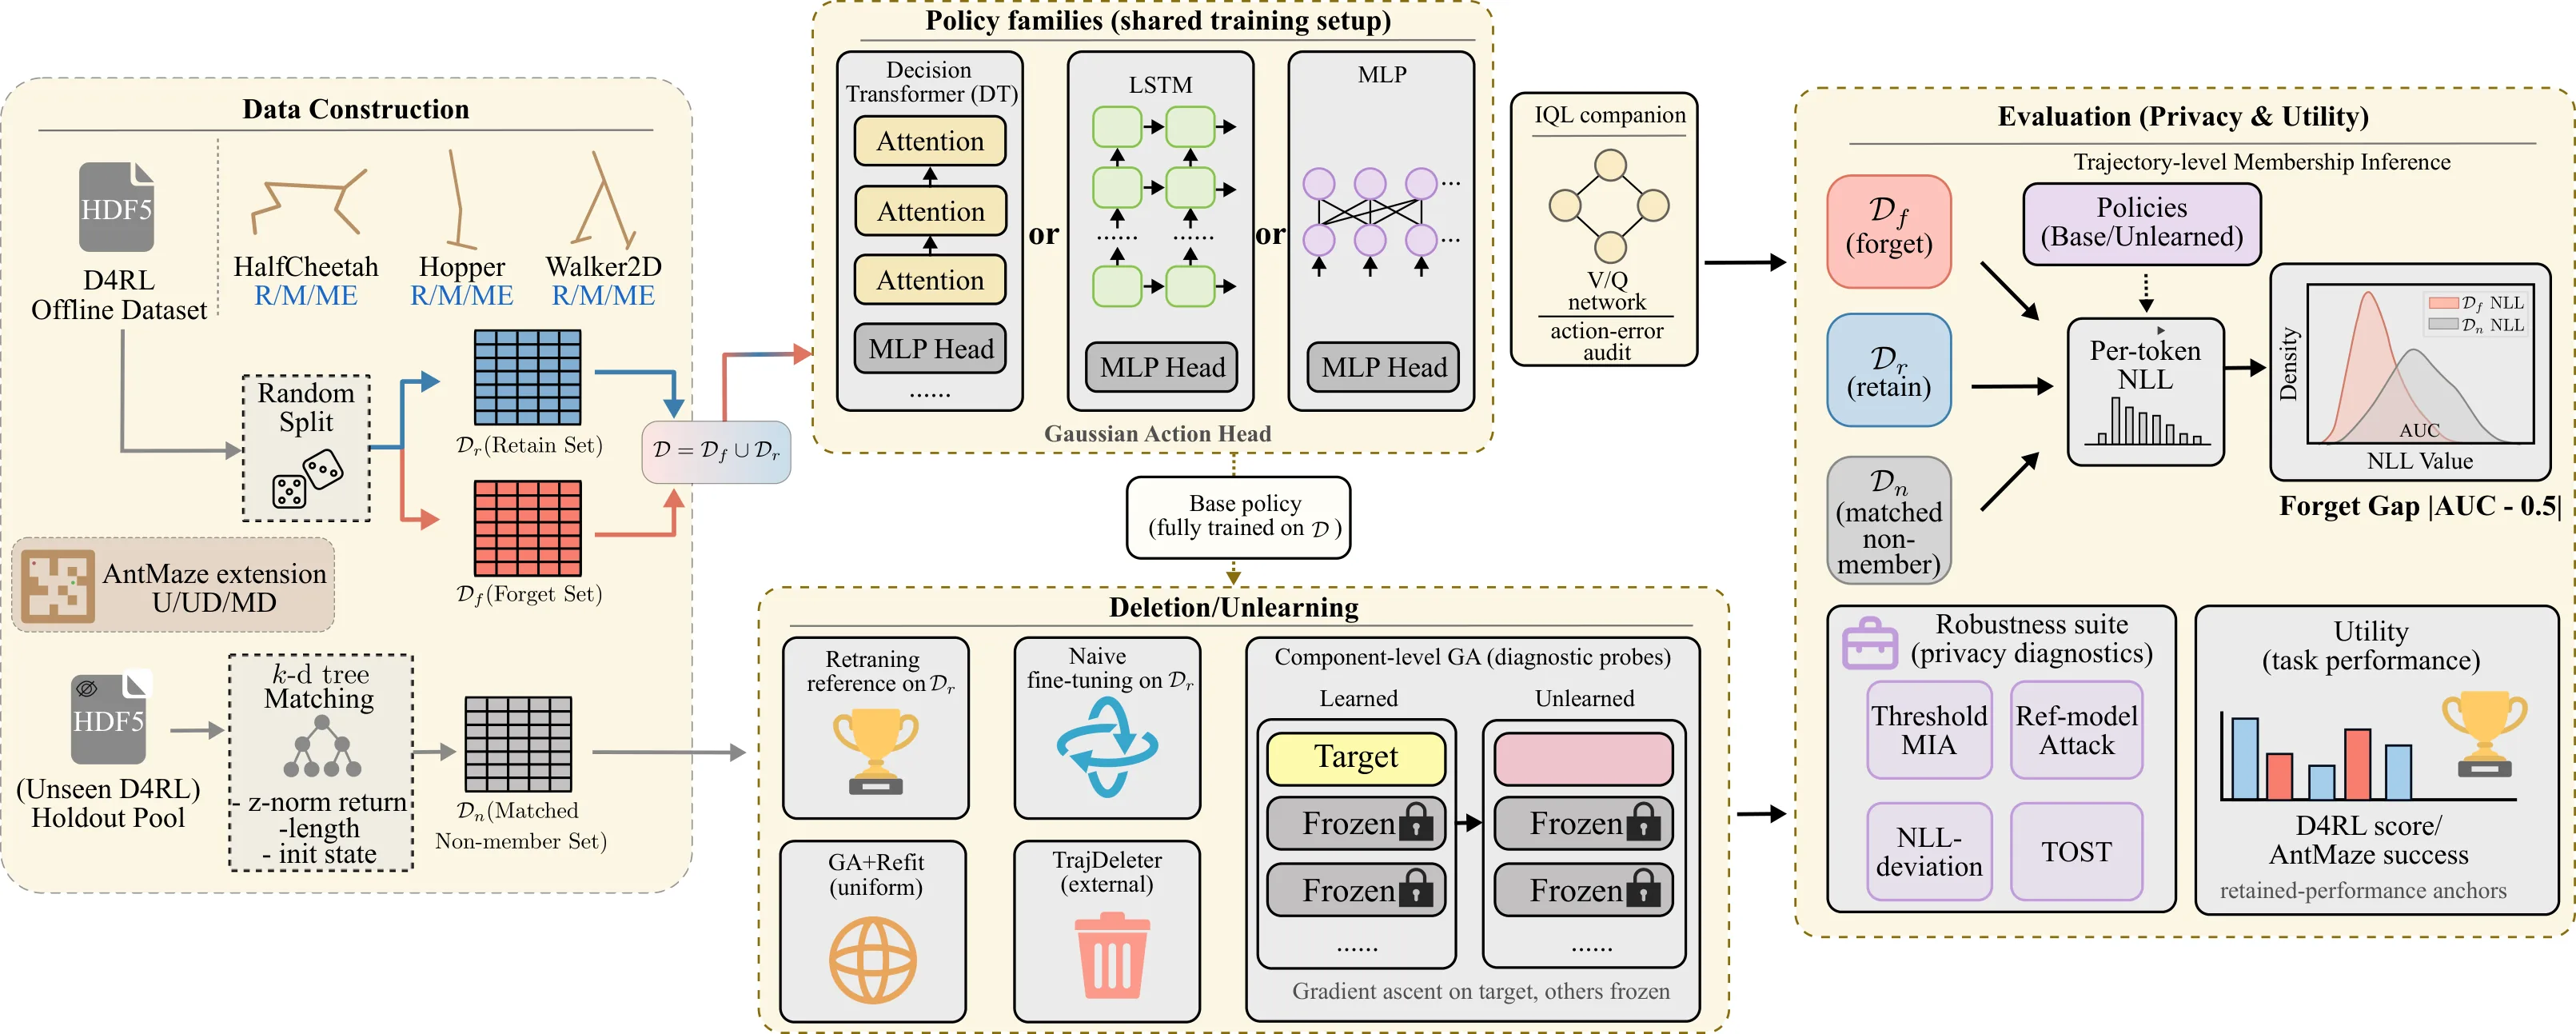
TOUR 的核心设计围绕五个关键组件展开,每个组件都针对遗忘评估中的一种固有挑战。
首先是轨迹级划分(Trajectory-level Partitioning)。与以往在样本级别进行成员推断攻击不同,TOUR 明确地在轨迹级别定义成员身份。这意味着一次遗忘操作可能涉及删除一条完整的机器人运动序列,而非其中的单个状态-动作对。这种划分更符合离线 RL 的实际数据组织方式,也为评估提供了更精细的粒度。
其次是匹配的非成员对照(Matched Non-member Controls)。研究者意识到,评估遗忘质量不能只看被删除轨迹的分数变化,还需要知道相似但未被删除的轨迹的分数如何表现。TOUR 构建了与被删除轨迹在状态分布、动作模式、轨迹长度等维度上匹配的对照组,通过对比两者的差异来校准评估结果。
第三是重训练参考(Retraining References)。最"干净"的遗忘基线是从头重训练一个完全不含目标轨迹的模型。TOUR 将这种方法作为效用保留的上界参考,同时也作为评估其他方法真实遗忘效果的校准基准。
第四是保留性能锚点(Retained-performance Anchors)。遗忘不能以牺牲太多任务性能为代价。TOUR 测量删除前后智能体在下游任务上的得分,确保高效遗忘方法同时也是高效保留方法。
最后是多攻击族隐私审计(Multi-attack Privacy Auditing)。这是 TOUR 最具创新的设计。研究者定义了七种不同类型的攻击家族:参考模型攻击、阈值攻击、偏差攻击、等价性攻击、动作误差攻击、表示攻击和查询受限攻击。每种攻击从不同角度探测轨迹记忆,捕捉遗忘的不完全性。这种多攻击联合审计的思路,源于对单一分数审计不稳定性的深刻认识。
实验与结果
实验在 D4RL 基准的多种运动控制任务上进行,包括 HalfCheetah、Walker2d、Hopper 等环境,并辅以 AntMaze 的探索性扩展。
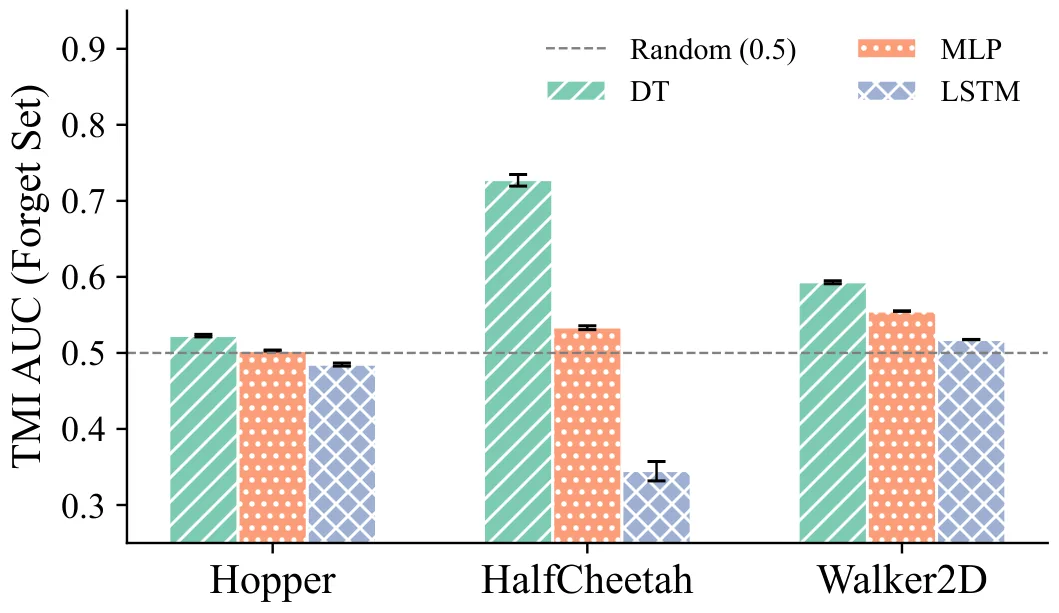
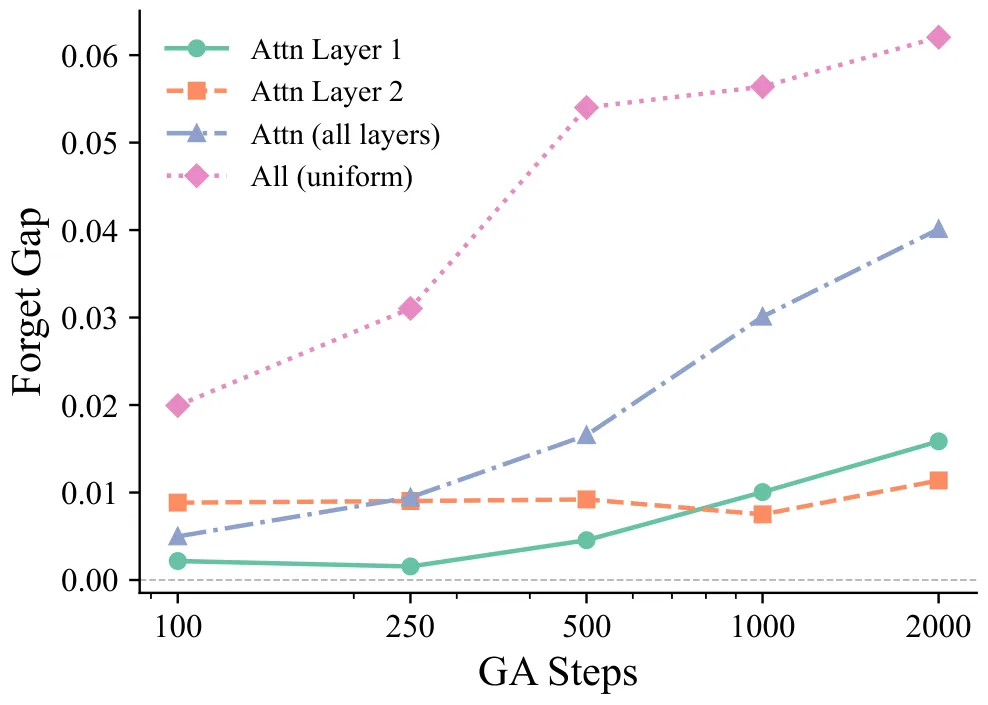
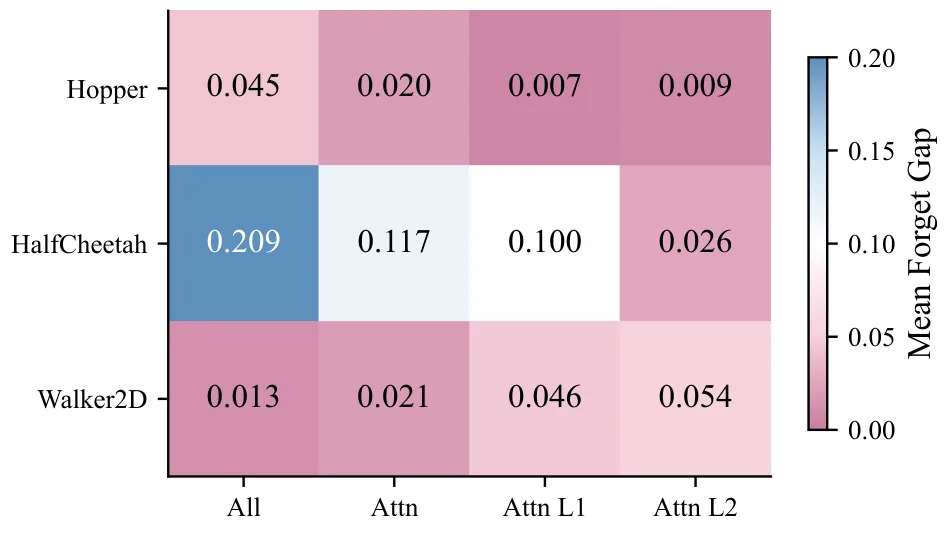
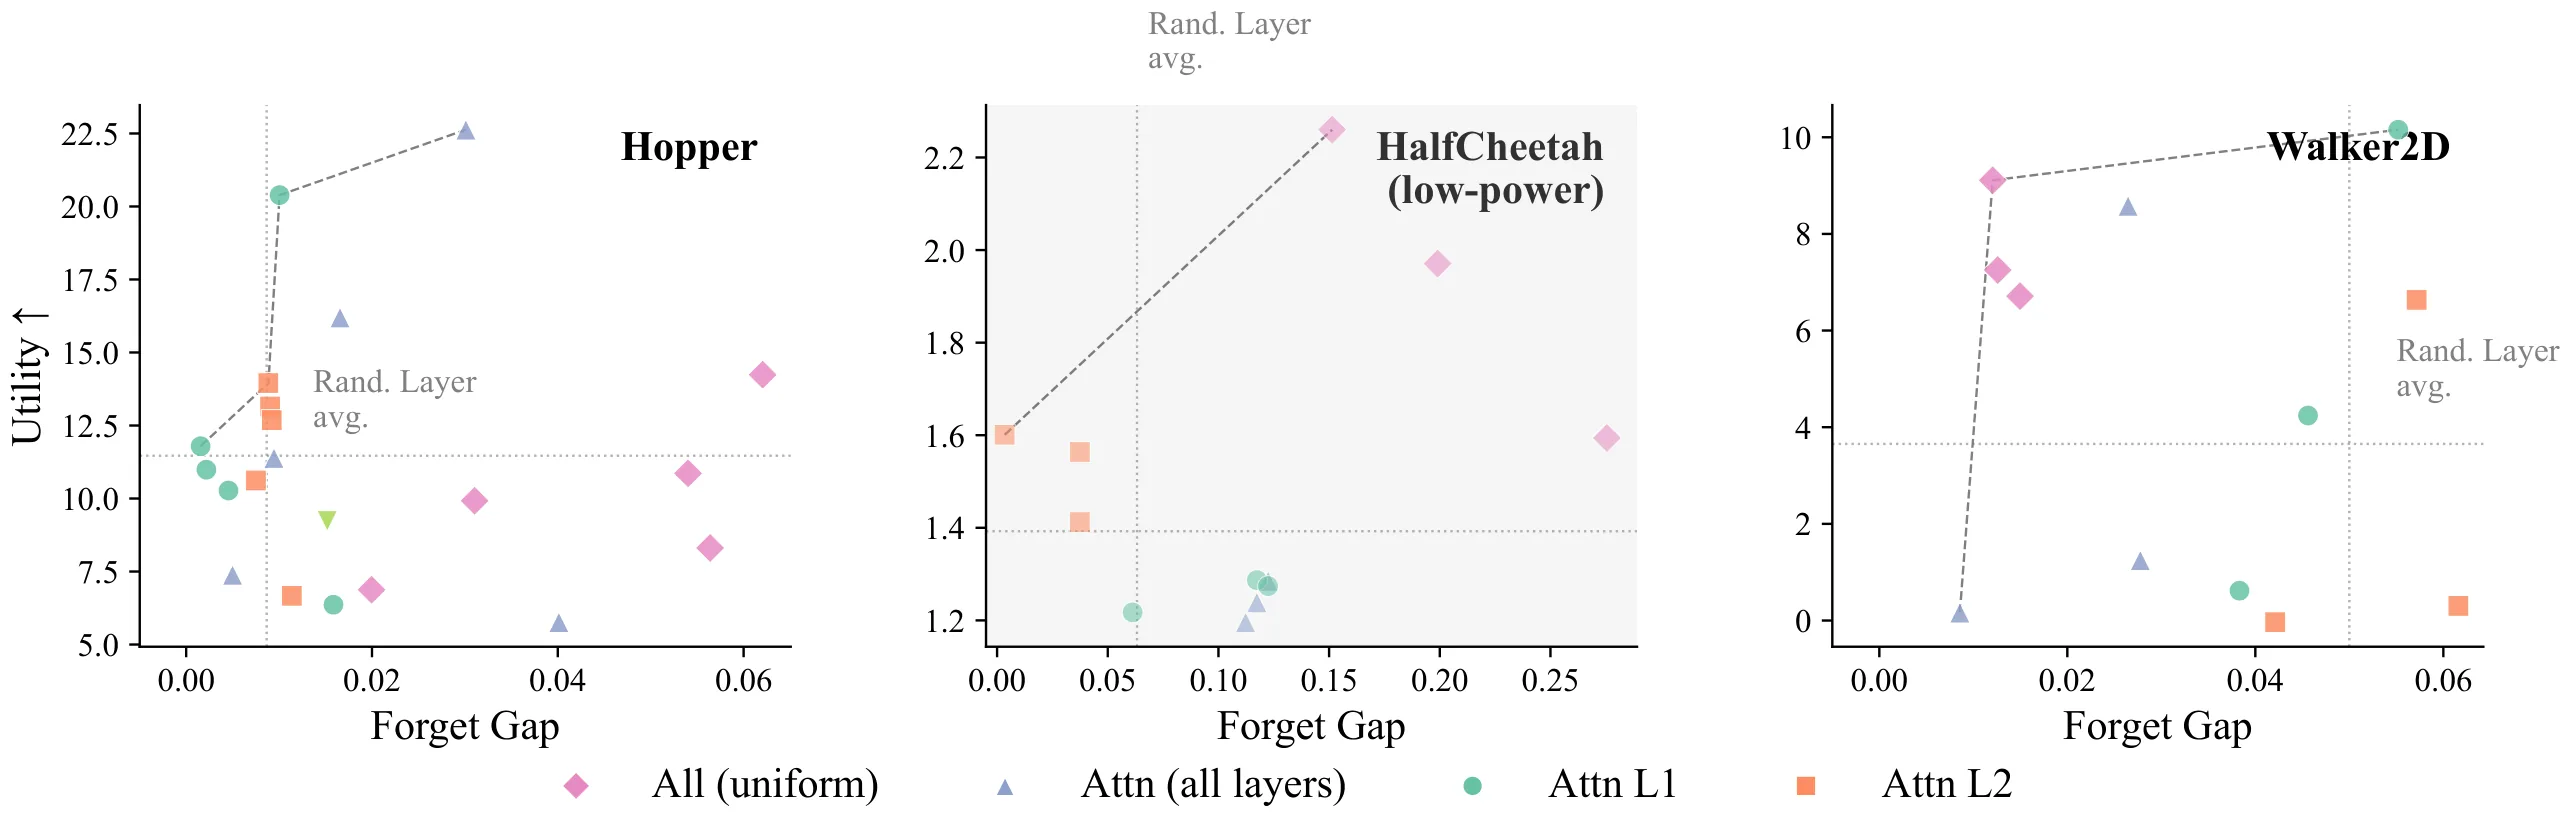
结果显示了一个令人警惕的现象:常见删除基线的隐私-效用表现高度依赖环境。例如,在某些环境下表现出色的删除方法,换到另一个环境后可能完全失效。这意味着基于单一环境或单一指标得出的"某方法优于某方法"的结论并不可靠。
在效用保留方面,重训练和微调方法通常提供了比一致性 GA+Refit(一种流行的机器遗忘方法)更强的参考基准。TrajDeleter 作为轨迹感知的遗忘方法仍然是有价值的对照,但它在相同的隐私审计下并非一致性地优于其他方法。
最关键的发现来自于多攻击审计:基于似然的单一成员分数确实会高估删除质量。当使用动作误差攻击或表示攻击进行审计时,许多在似然分数上表现"良好"的删除方法暴露出了残余的记忆痕迹。这些攻击利用了遗忘方法未覆盖的信息通道——比如动作分布的细微统计特性,或者表示空间中的异常相似性——来推断目标轨迹是否被真正遗忘。
讨论与可借鉴点
TOUR 的贡献不仅在于提供了一个基准,更在于揭示了离线 RL 遗忘评估中的深层挑战。单一分数审计的脆弱性意味着,研究者需要在评估中引入匹配非成员构建、重训练相对校准、多攻击族联合判断的完整框架,才能得出可信的结论。
这一发现对整个机器遗忘领域都有借鉴意义。在其他模态的遗忘研究中,类似的问题同样存在:当我们宣称某个方法"成功遗忘"了某些数据时,这个结论是否足够稳健?
TOUR 的局限性也值得注意。实验主要集中在 D4RL 的运动控制任务上,更复杂的离线 RL 场景(如多任务学习、稀疏奖励)可能展现出不同的遗忘挑战。七种攻击家族虽然覆盖面广,但可能仍有未被覆盖的攻击路径。此外,当前基准主要关注单条轨迹的遗忘,多轨迹批量遗忘的评估尚需进一步探索。
未来的工作可以在两个方向上深入:一是在架构层面设计对遗忘更友好的智能体结构,使得隐私保护与性能保留的权衡不再那么尖锐;二是将 TOUR 的评估框架扩展到更大规模、更多样化的离线 RL 数据集,建立更具统计显著性的结论基础。
摘要
离线强化学习(RL)智能体基于固定的行为轨迹进行训练,这使得在训练后需要删除特定数据时,轨迹级删除变得十分重要。由于较低的成员分数可能反映了轨迹被移除、对其他攻击仍可见的残余记忆,或是破坏有用行为的策略崩溃,因此评估此类删除十分困难。我们提出了离线强化学习中的轨迹级记忆与遗忘(TOUR),一个结合了轨迹级划分、匹配的非成员对照、重训练参考、保留性能锚点以及多攻击隐私审计的基准。在 D4RL 运动控制实验和探索性的 AntMaze 扩展任务中,TOUR 表明常见的删除基线方法具有依赖环境的隐私-效用行为。重训练和微调通常提供比一致性的 GA+Refit 更强的保留效用参考,而 TrajDeleter 仍是一个有用的对照方法,但在相同的审计下并非一致性地更强。参考模型、阈值、偏差、等价性、动作误差、基于表示以及查询受限等攻击进一步表明,基于似然的单一成员分数可能高估删除质量。在所评估的设置中,针对离线强化学习遗忘的结论因此在单一分数审计下并不稳定,它们依赖于匹配的非成员构建、相对于重训练的校准、攻击类别、保留效用,以及为诊断性架构或组件级证据提供的显式范围。
Abstract
Offline Reinforcement Learning (RL) agents are trained on fixed behavioral trajectories, which makes trajectory-level deletion important when selected data must be removed after training. Evaluating such deletion is difficult because a lower membership score can reflect trajectory removal, residual memorization visible to another attack, or policy collapse that destroys useful behavior. We introduce Trajectory-level memOrization and Unlearning in offline RL (TOUR), a benchmark that combines trajectory-level partitioning, matched non-member controls, retraining references, retained-performance anchors, and multi-attack privacy auditing. Across D4RL locomotion experiments and an exploratory AntMaze extension, TOUR shows that common deletion baselines have environment-dependent privacy-utility behavior. Retraining and fine-tuning often provide stronger retained-utility references than uniform GA+Refit, while TrajDeleter remains a useful comparator but is not uniformly stronger under the same audit. Reference-model, threshold, deviation, equivalence, action-error, representation-based, and query-limited attacks further show that a single likelihood-based membership score can overstate deletion quality. In the evaluated settings, conclusions about offline RL unlearning are therefore not stable under single-score auditing. They depend on matched non-member construction, retraining-relative calibration, attack family, retained utility, and explicit scope for diagnostic architecture or component-level evidence.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。