
面向自动驾驶赛车防超车的深度强化学习引导模型预测控制
Deep Reinforcement-Learning-Guided Model Predictive Control for Preventing Overtakes in Autonomous Racing
📝 TLDR
自动驾驶赛车场景下,防守方需在被更快对手超越时保持在动力学极限附近。区别于最小化圈速的传统方法,本文将防守建模为空间占用调控问题,构建Soft Actor-Critic策略层与非线性MPC结合的分层RL-MPC框架。策略层在Frenet坐标系生成几何感知的防御参考,MPC将其作为摩擦约束下的空间正则项嵌入求解。在Thunderhill West赛道仿真中,平均超车时间从8.8s延长至14.6s,对手推进距离显著降低,轮胎力利用率达83.4%,平均求解时间33.3ms。该框架为高速对抗场景下的实时决策提供了可行方案。
🧭 速览
传统赛车研究聚焦圈速最小化,缺乏针对防守对抗场景的策略生成与实时控制方法。
分层SAC-MPC框架:SAC策略层在Frenet域输出防御参考轨迹,MPC将其作为摩擦约束下的空间正则项嵌入非线性求解。
平均超车时间由8.8s延长至14.6s,轮胎力利用率83.4%,平均求解时间33.3ms,支持实时高速对抗交互。
为自动驾驶赛车防守场景提供了兼具战略智能与实时性的分层控制方案。
🆚 方法对比
Deep RL-Guided Spatial Envelope MPC (本文提出的框架)
- 将超车时间从8.8s提升至14.6s,防守效果显著
- 平均求解33.3ms,支持高速对抗实时控制
- 轮胎力利用率达83.4%,接近动力学极限
- 分层设计兼顾策略学习与安全约束保障
Soft Actor-Critic (SAC) 战略层
- 在Frenet域学习几何感知的防守参考轨迹
- 可自适应处理复杂交互与赛道几何
- 最大熵框架鼓励策略探索与鲁棒性
非线性MPC空间包络层 (Spatial Envelope MPC)
- 显式处理非线性轮胎力与摩擦约束
- 将RL策略嵌入为空间正则项保证可行解
- 滚动时域优化支持实时闭环执行
纯端到端强化学习方法
- 仿真中可展现竞争性驾驶性能
- 无需显式建模,灵活性较高
- 不显式施加动力学约束,鲁棒性存疑
- 仿真到实车迁移在安全关键场景困难
博弈论差分博弈MPC方法
- 可逼近纳什均衡,推理多车对抗行为
- 支持层级化团队策略扩展
- 依赖简化车辆模型,高速赛车保真度受限
- 为保计算可处理性常需离散化动作空间
蒙特卡洛树搜索 (MCTS) 离散规划
- 高层决策可展现交互式对抗行为
- 高层离散规划,不直接处理连续动力学
- 对高速摩擦受限场景控制精度不足
传统圈速最小化MPC方法
- 成熟方法,能精细处理轮胎模型与约束
- 支持实时执行的高效二次约束重规划
- 主要关注单车圈速,缺乏多车交互建模
- 不显式处理防守性的空间占据控制
本文提出分层SAC+MPC框架,通过将SAC在Frenet域学到的防守参考嵌入非线性MPC的空间正则项,弥补了纯端到端RL缺乏安全保证、传统博弈论MPC保真度不足、圈速优化MPC忽略多车交互的各自缺陷,在实时性、约束满足与策略学习之间取得平衡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 23 张)
展开查看 23 张图
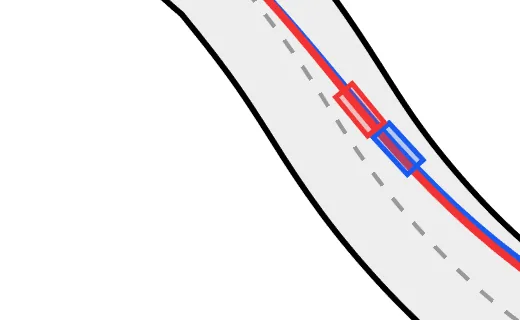
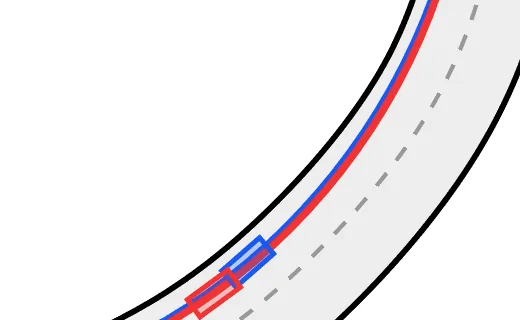
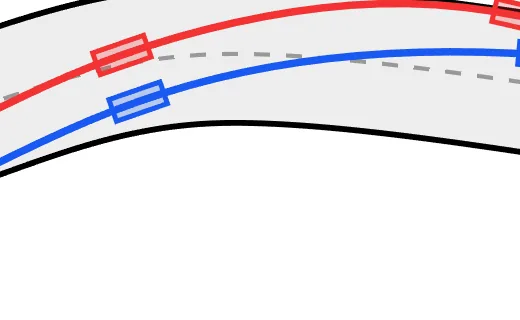
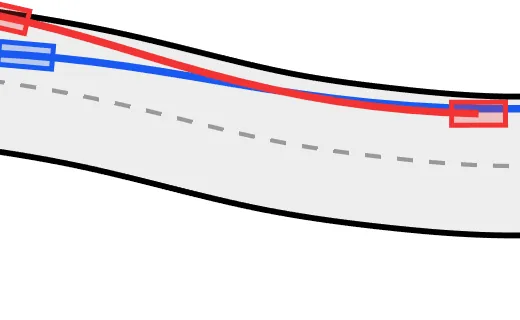
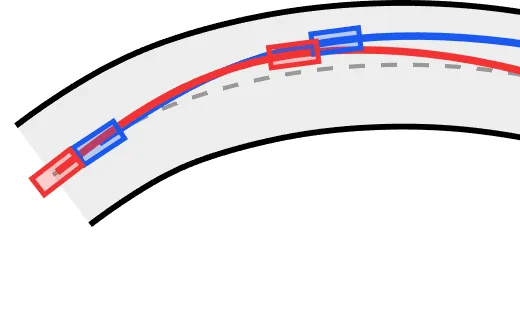
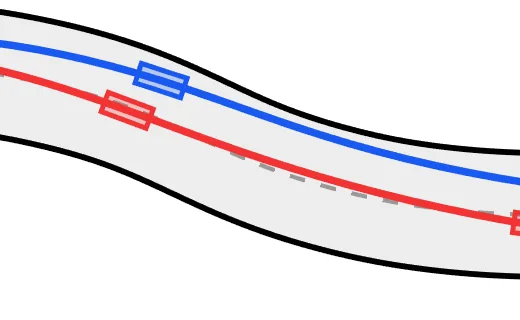
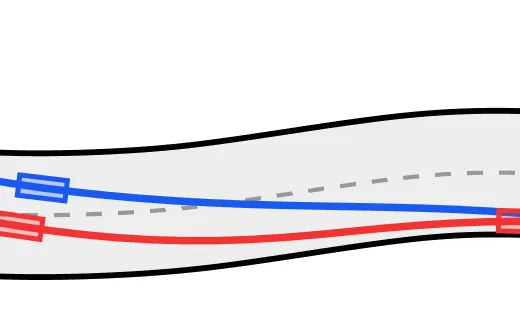
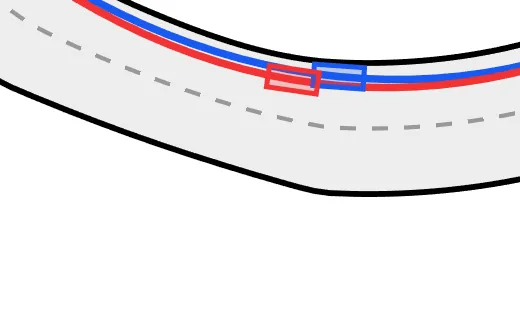
TL;DR
本文针对自动驾驶赛车中"防守性阻挡"这一被长期忽视的问题,提出了一种将 [[强化学习]] 与 [[模型预测控制]] 结合的分层框架。该框架让防守方在面对速度更快的对手时,通过主动调节自身空间占用来延长对手的超车窗口。在 Thunderhill West 赛道的仿真测试中,平均超车时间从 8.8 秒提升至 14.6 秒,提升幅度达 65.9%,同时平均求解时间控制在 33.3 毫秒,满足实时控制需求。
研究背景与动机
自动驾驶赛车领域的研究长期以来呈现出明显的"两极化"特征:一端是以圈速最小化为目标的最优轨迹规划,另一端是以超车为核心的对抗性行为生成。然而,真实赛道中的博弈往往发生在速度存在差距的情况下——当己方赛车无法在直道上依靠动力优势甩开对手时,防守方必须通过精细的空间控制来阻止对手完成超越。这种防守行为在传统研究中几乎是一片空白。
防守性阻挡之所以难做,是因为它横跨了三个层面的挑战。在动力学层面,赛车逼近轮胎与地面的摩擦极限时,任何微小的控制失误都可能导致失控,传统基于简化模型的博弈方法在此处难以保证可行性。在交互层面,对手的行为具有实时性和不确定性,依赖离散动作空间的博弈树搜索无法满足高速场景下的决策时效性。在算法层面,纯 [[模型预测控制]] 方法缺乏对对抗意图的语义理解能力,而纯端到端 [[强化学习]] 方法又难以在训练中保证物理约束的严格满足。
本文的核心洞察在于:防守的本质不是"开得快",而是"占得巧"。作者将防守行为重新建模为空间占用度调节问题,而非传统的性能最优化问题。这一范式转变使得高层策略可以从"如何跑得快"中解耦出来,专注于"如何让对手的空间选择变少"。
方法
整个框架采用三层分层结构,从战略到战术再到运行,逐层分解决策复杂性。
在战略层,作者使用 [[软演员-评论家]] 算法作为策略网络。该策略的输入输出设计颇具巧思:策略网络并不直接输出转向角或油门这类底层控制量,而是在 [[Frenet坐标系]] 下输出未来多个参考点的横向和纵向偏移修正。Frenet 坐标将车辆的绝对位置拆解为沿赛道中心线的弧长 和垂直于中心线的横向偏移 ,这使得策略网络天然具有对赛道几何的不变性——无论赛道是长直道还是连续弯道,策略学到的"向左偏移一点"这类知识都能泛化使用。
策略网络的输出形式为一系列带权重的参考点集合,这些点随后被传入战术层的空间包络 [[模型预测控制]] 问题中作为正则化项。值得注意的是,这里 [[模型预测控制]] 并非简单地将 RL 输出的轨迹作为跟踪目标,而是将参考点以软约束的方式嵌入优化目标。这样设计的好处在于:当 RL 给出的参考点因为预测误差而变得不可行时,MPC 可以在不丧失求解可行性的前提下"重新解释"这些意图,通过减速或调整横向位置来顺应实际的物理约束。这种"软引导加硬约束"的接口设计,既保留了 RL 策略的几何意图学习能力,又利用了 MPC 对非线性动力学的精确处理。
在动力学建模方面,车辆采用非线性单轨模型,轮胎力由 Fiala 模型描述,这比常用的线性轮胎模型更准确地捕捉了接近摩擦极限时的非线性特性。MPC 的优化问题显式包含了摩擦圆约束,确保每个时刻轮胎力的合力不超过可用附着力。
整个 RL-MPC 联合训练的奖励函数设计体现了攻防权衡的显式建模:奖励项包含推进进度奖励(鼓励己车前进)、防守奖励(当相对位置领先对手时给予额外奖励,但当落后时触发惩罚)、碰撞惩罚和赛道边界惩罚。通过调整这些奖励项的系数,策略在训练过程中逐渐学会了"宁可慢一点也要挡住对手"的防守偏好。
实验与结果
实验选择 Thunderhill Raceway Park West 赛道进行验证,这是一条位于美国的真实赛道,全长约 2 英里。作者刻意让训练在程序化生成的几何赛道片段上进行,而将 Thunderhill West 作为完全分布外的测试场景。这种设计直接考验了框架的泛化能力。
在对手建模方面,作者没有采用与防守方求解耦合博弈均衡的方案,而是让对手采用基于运动学预瞄的最优推进策略——预测自车未来 1 秒的运动轨迹,然后在摩擦约束下最大化自身的相对进度。这种对手模型虽然不具备真正的策略意图,但能够逼真地模拟一辆"技术娴熟但不会耍心眼"的真实赛车手的超车行为。
定量结果表明,提出的 RL-MPC 框架在各项指标上均显著优于去掉参考跟踪项的纯空间包络 MPC 基线。平均超车时间从 8.8 秒延长到 14.6 秒,提升幅度达到 65.9%,这意味着对手需要多花将近 6 秒才能找到超车窗口。在对手推进距离方面,防守方在固定的 20 秒对抗窗口内将对手的推进距离从 537.6 米限制到 504.8 米,减少了约 33 米。
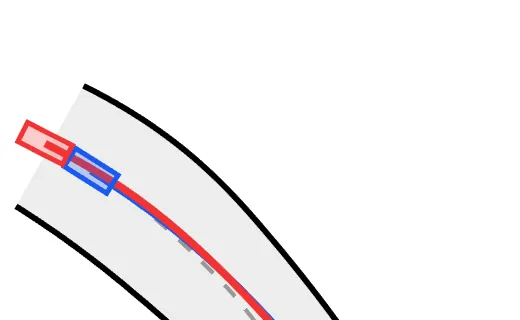
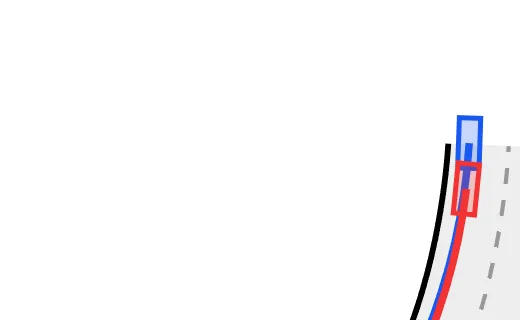
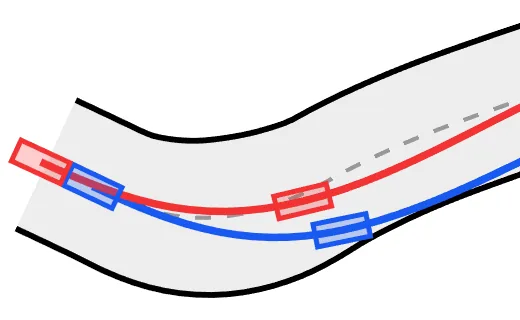
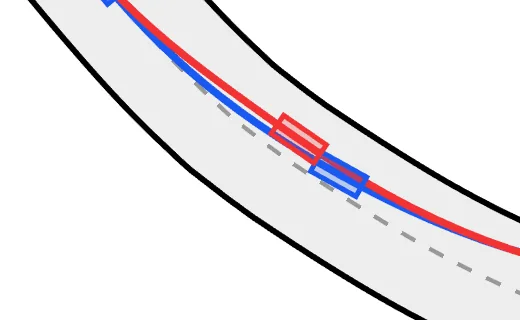
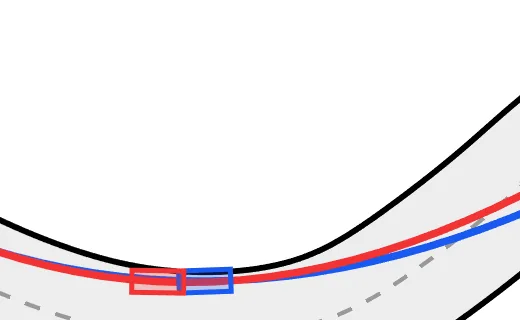
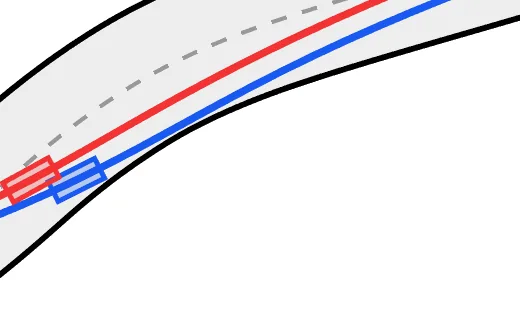
一个有趣的发现是轮胎力利用率指标:防守方的平均轮胎力利用率为 83.4%,仅比基线的 81.3%高出两个百分点。这个数字说明性能提升并非通过更激进地逼近物理极限获得,而是通过更聪明的空间策略实现——防守方并非"开得更猛",而是"占得更准"。从轨迹可视化中可以观察到策略涌现出的可解释行为,例如在弯道入口提前减速抢占内线,迫使对手走大半径外线,从而在同等动力条件下拉长对手的行驶距离。
在实时性方面,平均求解时间为 33.3 毫秒,标准差 13.9 毫秒,虽然比基线慢了约 9 毫秒,但仍在 100 毫秒的控制周期内,为实时部署提供了可行性。
讨论与可借鉴点
尽管实验结果令人鼓舞,但论文的局限性也值得认真审视。首先,测试仅在单条赛道和单一对手策略下进行,缺乏多赛道、多对手的泛化验证。其次,基线对比采用的是去掉了参考跟踪项的 MPC 消融版本,而非领域内已有的博弈论防守方法,这让相对性能的评估缺少参照系。此外,每项实验仅运行一次而未报告多次独立运行的标准差,统计结论的稳健性存在疑问。
从更宏观的视角看,这项工作最重要的贡献或许不在于具体的数字结果,而在于它将自动驾驶赛车的决策范式从"自车最优"拓展到了"对抗性空间占用"。这种思维框架的转变对于自动驾驶领域处理其他高交互场景——如匝道汇入、变道博弈、紧急避障中的社会行为建模——都具有潜在的启发价值。
对于工程实践者而言,"软引导加硬约束"的 RL-MPC 接口设计提供了一种平衡策略灵活性与物理安全性的可靠思路。当顶层策略专注于语义层面的目标表达,而底层优化器负责在物理约束内寻找可行解时,整个系统的可靠性和可解释性都会得到提升。这或许是未来高安全性自动驾驶系统的一个值得深耕的设计方向。
摘要
本文研究自动驾驶赛车中的防守性阻挡问题,即车辆需要在接近动态极限的工况下阻止速度更快的对手完成超越。与以最小化单圈时间为目标不同,我们将防守建模为空间占用度调节问题,并提出一种分层式强化学习引导的模型预测控制框架。软演员-评论家(Soft Actor-Critic)策略层在 Frenet 坐标系下运行,生成具有几何感知能力的防守参考轨迹,并将其作为空间正则化项嵌入到在摩擦约束下的非线性模型预测控制问题中。该框架在 Thunderhill West 赛道的仿真环境中进行了验证,结果表明:平均超车时间从 8.8 s 增加到 14.6 s,同时显著降低了对手的前进距离;车辆能够利用 83.4% 的可用轮胎力;平均求解时间为 33.3 ms(标准差 13.9 ms),可支持实时的高速对抗性交互任务。
Abstract
This paper addresses defensive blocking in autonomous racing, where a vehicle must prevent a faster opponent from overtaking while operating near its dynamic limits. Different from lap-time minimization, we formulate defense as a spatial occupancy regulation problem via a hierarchical reinforcement-learning guided model predictive control framework. A Soft Actor-Critic strategic layer operates in the Frenet domain to generate geometry-aware defensive references, which are embedded into the nonlinear model predictive control formulation as spatial regularization under friction constraints. Evaluated on the Thunderhill West circuit in simulation, the framework increases average overtake time from 8.8 s to 14.6 s while significantly reducing opponent progress. Meanwhile, it allows the vehicle to utilize 83.4% of available tire force. The framework achieves a 33.3 ms mean solve time (13.9 ms std), supporting real-time high-speed adversarial interaction.
论文详细总结(自动生成)
论文总结:面向自动驾驶赛车防超车的深度强化学习引导模型预测控制
1. 核心问题与研究背景
- 研究对象:自动驾驶赛车中的防守性阻挡(Defensive Blocking)问题。当己方车辆速度劣于对手时,需在接近动力学极限的工况下主动阻止对手完成超车。
- 传统研究空白:现有自动驾驶赛车研究主要聚焦于圈速最小化(lap-time minimization)和主动超车(overtaking)两方面。防守行为——即主动限制对手可行超车走廊、牺牲短期速度以换取策略优势——在高保真赛车控制中研究不足。
- 核心挑战(三个层面):
1. 动力学层面:非线性轮胎力与摩擦约束要求短时间域内的动态可行控制。
2. 交互层面:博弈论方法依赖简化模型或离散动作空间,难以兼顾高速高保真。
3. 算法层面:纯 MPC 缺乏自适应策略学习;纯端到端 RL 难以显式施加动力学约束,sim-to-real 风险高。现有混合 RL-MPC 多关注性能提升或模型自适应,少有显式建模防守空间交互。
- 本文思路转变:将防守建模为空间占用度调节(Spatial Occupancy Regulation)问题,而非自车性能最大化。
2. 方法论
2.1 整体框架(三层分层结构)
- 战略层(Strategic Layer):基于 Soft Actor-Critic(SAC)的深度 RL 模块,在 Frenet 坐标系生成几何感知的空间参考点集。
- 战术层(Tactical Layer):将 Frenet 学习到的策略转换到全局笛卡尔坐标,构建空间包络 MPC(Spatial Envelope MPC)实时求解。
- 运行层(Operational Layer):将控制输入施加到动力学仿真器,输出下一状态并将评估指标(碰撞、推进、安全等)反馈至战略层用于奖励计算。
2.2 Frenet 坐标系下的几何表达
采用非线性单轨(bicycle)动力学模型,状态与控制向量为:
采用控制增量(转向角速率 与纵向加加速度 )作为输入以保证执行器平滑。
Frenet 坐标通过下式定义:
其中 为弧长, 为横向偏移, 为单位法向量。该表示使高层策略对赛道几何与初始位置具有不变性。
2.3 SAC 策略与空间参考生成
策略不直接输出控制量,而是输出未来 个节点处的横向/纵向偏移修正:
由此构造参考集合 ,每个参考点带有固定权重 。
奖励函数显式编码攻防权衡:
其中 在相对领先 时给予正奖励,否则惩罚,并触发提前终止。
2.4 RL-MPC 嵌入与配置点对齐
将 RL 输出的参考点映射到 MPC 求解时域内的部分配置(collocation)节点,引入参考跟踪代价:
完整 MPC 问题为:
该设计使 RL 学到的几何意图以策略诱导正则化形式嵌入 MPC 求解,而非外部参考轨迹。
3. 实验设计
- 训练场景:采用程序化生成的多种几何赛道片段(直道、U 弯、单/连续发夹弯、大半径弯道、直弯过渡),每回合随机化曲率与片段组合,共训练 10,000 个 epoch,每 epoch 200 步(约 20 s 仿真时长)。
- 测试赛道:美国真实赛道 Thunderhill Raceway Park West(2 mile),仅用于测试,不参与训练(分布外验证)。赛道中心线由高分辨率 GPS 数据 + 样条插值得到。
- 车辆模型:基于雷克萨斯 LC500 平台参数的非线性单轨模型,轮胎采用 Fiala 模型。
- 对手设计:不求解耦合博弈均衡,而是基于非线性单轨动力学,配 1.0 s 自车运动预测预瞄,最大化相对进度,并受摩擦圆与执行器约束、碰撞与边界惩罚,仿真实际主动超车。
- 评价指标:
- 超车时间(OT):对手 Frenet 进度领先阈值 持续 。
- 对手行驶距离(越小越好)。
- 前轮胎力利用率(Fiala 模型归一化)。
- 单步求解时间(ms)。
- Benchmark:去掉参考跟踪项 的空间包络 MPC(即本文提出方法的消融基线)。作者明确声明该基线"并非最强防守控制器",仅为隔离参考项作用。
- 评估分段:分析全部 9 段,但 Segment 1–4 中基线 MPC 因赛道几何限制隐式占据超车走廊(不涉及交互感知),故重点对比 Segment 5–9。
4. 资源与算力
- 硬件:Alienware Aurora R15 台式机,13th Gen Intel Core i9-13900KF,64 GB RAM。
- 软件:Python + PyTorch(SAC 训练)+ CasADi(基于内点法的 MPC 求解器)。
- 未提及 GPU:文中未说明是否使用 GPU 训练 SAC,从配置推断可能仅以 CPU 训练。
- 训练规模:10,000 epoch × 200 步 ≈ 2,000,000 步仿真交互。
- 回放缓冲:;批量大小 256;Actor/Critic 学习率 。
- 未明确报告:总训练时长(小时/天数)未给出。
5. 实验数量与充分性
- 对比维度:5 个具有挑战性的赛道分段(Segment 5–9),每段对比 Proposed 与 Benchmark 两个控制器。
- 定量结果(表 II 摘要):
| 指标 | Benchmark | Proposed | 提升 |
|---|---|---|---|
| 平均超车时间 | 8.8 s | 14.6 s | +65.9% |
| 对手平均推进距离 | 537.6 m | 504.8 m | −32.8 m |
| 平均轮胎力利用率 | 81.3% | 83.4% | +2.1 pp |
| 平均求解时间 | 24.4 ms | 33.3 ms(std 13.9 ms) | 仍在 100 ms 内 |
- 定性分析:逐分段轨迹可视化对比(Segment 5–9),展示先入弯减速、内线挤压、迫使对手走大半径等策略行为。
- 充分性评估:
- 优势:覆盖了定量 + 定量 + 求解时间分布 + 轨迹形态;含有一个明确的轨迹级时间同步对比图。
- 不足:仅 1 条真实赛道 + 1 个对手策略;缺少与博弈论方法(如 Wang 等人的 i2Game)、MCTS 防守策略等更先进基准的对比;不包含消融中对 RL 与 MPC 松耦合方式的横向比较;仅 1 次随机种子结果,未报告多次独立运行的标准差或置信区间。
- 统计偏差风险:单个赛道、单次仿真的均值易被偶然性放大,结论稳健性需更多 run-to-run 重复。
6. 主要结论与发现
- 在分布外真实赛道 Thunderhill West 上,平均超车时间从 8.8 s 延长至 14.6 s(提升 65.9%),说明 RL 引导的空间正则项显著增强了 MPC 的对抗性防守持续性。
- 对手在固定 20 s 窗口内的推进距离减少约 32.8 m,验证了空间占用的策略有效性。
- 前轮胎力利用率仍维持在 83.4%(仅略高于基准 81.3%),说明性能提升并非通过违反动力学极限获得,而是合理的几何策略调控。
- 平均求解时间 33.3 ms(最大 100 ms),满足 100 ms 控制周期,支持实时部署。
- 涌现出先入弯减速(preemptive apex deceleration)与内线阻拦等可解释策略,部分参考点跨越赛道(动态不可行)时由 MPC 通过降低车速并横向移动解释为合理决策。
- Segment 9 中出现反例:即使调整参考仍存在可行超车走廊,学到的策略未能显著限制对手——揭示了纯几何占用的局限性。
7. 方法与设计亮点
- 范式创新:将自动驾驶赛车从"自车最优"扩展到"对抗性空间占用"问题,系统性填补了高保真下防守策略学习的研究空白。
- 坐标解耦:高层策略在 Frenet 域学习(具备几何泛化能力),底层控制在笛卡尔域执行(保持物理一致性),体现了几何不变性 + 物理保真度的清晰分工。
- 接口设计:RL 输出空间参考点集而非控制量,作为政策诱导正则项嵌入 MPC;这种"软引导 + 硬约束"的设计巧妙地保留了 MPC 的可行性保证,避免了 RL 直接输出控制可能违反动力学约束的风险。
- 安全性融合:在 MPC 中显式施加摩擦圆约束、状态/输入边界、空间包络代价,兼顾高性能与安全。
- 实时可靠性设计:MPC 暖启动 + 100 ms 时间窗回退策略,确保在最坏情况下也能保留一个满足约束的历史解。
8. 不足与局限
- 仿真单一性:仅在 1 条真实赛道上验证,未在多赛道、不同对手策略下进行泛化测试。
- 基准强度不足:对比对象为去掉 的空间包络 MPC(自消融),并非领域内已有的交互感知防守控制器(如博弈论、Nash 均衡、MCTS 等),难以判断相对其他高水平基线(如 i2Game、Game-Theoretic MPC 等)的优劣。
- 统计显著性缺乏:每段仅 1 次仿真结果,无多次独立运行的标准差或置信区间,结果易受随机种子影响。
- 现实条件缺失:未引入测量噪声、通信延迟、对手行为不确定性,也未加入赛车规则对过度阻挡的约束。
- 算力透明度低:未报告训练耗时、GPU/CPU 利用率;网络规模、推理延迟等边缘部署指标也未涉及。
- 策略可解释性限制:当 RL 输出动态不可行的参考点时,由 MPC 进行"重新解释",可能在某些边界情况下产生目标与行为不一致的隐性风险。
- 应用层面限制:仅适用于单车对单车的对抗,未考虑多车乱战(team racing、战术配合、对手行为切换等更复杂场景)。
- 可证明性缺口:未给出闭环系统稳定性或 RL-MPC 联合收敛性证明,安全性更多依赖仿真经验而非理论保证。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。