
学会恢复:面向中断情境下木材卡车路径与调度问题的基于强化学习的自适应局部分支
Learning to recover: Adaptive local branching with reinforcement learning for log-truck routing and scheduling under disruptions
📝 TLDR
加拿大林业原木卡车调度面临道路封闭、车辆故障等突发扰动,需同时恢复调度可行性并限制与原方案偏差。研究将恢复问题建模为受偏差界k约束的邻域受限混合整数规划,并利用REINFORCE策略梯度强化学习根据求解器反馈自适应选择k值,搜索稳定性与成本的Pareto前沿。实验在历史数据生成的周实例上验证,该方法以更少求解器调用获得更丰富Pareto前沿,并在各扰动场景下均能在可接受时间内输出可行恢复方案,为调度员提供多目标决策支持。
🧭 速览
实时扰动下原木卡车调度需同时兼顾恢复可行性与控制方案偏差,两目标天然紧张且时间紧迫。
以L1偏差界k参数化的邻域受限MILP为基础,用REINFORCE策略梯度根据求解器反馈自适应选k,搜索Pareto前沿。
在加拿大林业伙伴周实例与多类扰动场景下,方法以更少求解器调用获得更丰富Pareto前沿。
该方法为调度员提供结构化多目标恢复方案集,各配置下均能在可接受时间内产出可行解。
🆚 方法对比
RL引导自适应局部分支方法
- 比固定k网格更少的求解器调用即可获得更丰富的Pareto前沿
- 在所有配置和中断类型下均能在可接受的实时时间内生成可行恢复方案
- 将RL引导局部分支扩展至多目标设置,自适应导航Pareto前沿
- 在分析计算得到的k_min处锚定搜索起点,提高搜索稳定性
- 依赖求解器反馈,计算开销集中在有效区域
- 训练基于特定周实例,泛化到新场景能力待验证
- 框架复杂,结合MILP、RL与多目标三套独立技术流
- REINFORCE梯度估计方差较大,需多次迭代收敛
局部分支(Local Branching)
- 成熟的修复型MILP启发式方法,基于汉明距离约束
- 通过邻域半径k参数化搜索空间,结构清晰
- 可直接嵌入标准MILP求解器框架中实现
- 在车辆路径等问题上已有验证的有效方法
- 仅针对单一k值,无法直接生成Pareto前沿
- 缺乏关于半径k本身的解析结构分析
- 原始设计面向单目标修复,不适用于双目标场景
- k值选取不当会严重影响求解质量
固定k网格搜索(Fixed-k Grid)
- 实现简单,直接枚举预设k值集合
- 能保证覆盖整个k值范围的离散近似
- 无需训练,可直接部署使用
- 结果具有确定性和可复现性
- 在无生产力的k区域浪费大量求解器调用
- 无法根据求解反馈自适应调整搜索方向
- 网格密度限制可能遗漏Pareto关键点
- 计算资源利用效率低
二分搜索(Dichotomic Search)
- 比固定网格更系统地缩小搜索范围
- 每次迭代将搜索区间减半,收敛速度快
- 实现相对简单,无需训练过程
- 对单目标可行性边界搜索有效
- 仍不基于求解反馈自适应调整搜索策略
- 面向单目标搜索而非多目标Pareto前沿探索
- 缺乏终止判断标准,易过早或过晚停止
- 在非单调区域可能错失最优解
REINFORCE策略梯度算法
- 简单直观的策略梯度方法,易于实现
- 无需值函数估计,计算开销可控
- 可直接基于求解器反馈定义奖励信号
- 适用于离散动作空间(k值选择)
- 梯度估计方差较高,训练稳定性差
- 需要大量采样回合才能收敛
- 对奖励设计敏感,调参难度大
- 样本效率低,增加训练成本
多目标强化学习(MORL)
- 成熟的Pareto前沿近似范式,理论体系完善
- 可同时优化多个冲突目标
- 已有多种成熟算法和评估基准
- 在多个领域验证有效
- 假设策略评估廉价,不适用于求解器调用受限场景
- 未结合MILP修复问题的解析结构
- 直接应用于本场景需要重大改造
- 与局部分支文献缺乏整合桥梁
本文提出的RL引导自适应局部分支方法通过强化学习策略自适应选择k值,在固定k网格和二分搜索两个基线之上以更少求解器调用获得更丰富Pareto前沿,而局部分支、REINFORCE和MORL分别作为基础启发式、训练算法和相关范式被整合进统一框架,三者协同弥补了各自在多目标MILP修复场景中的不足。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
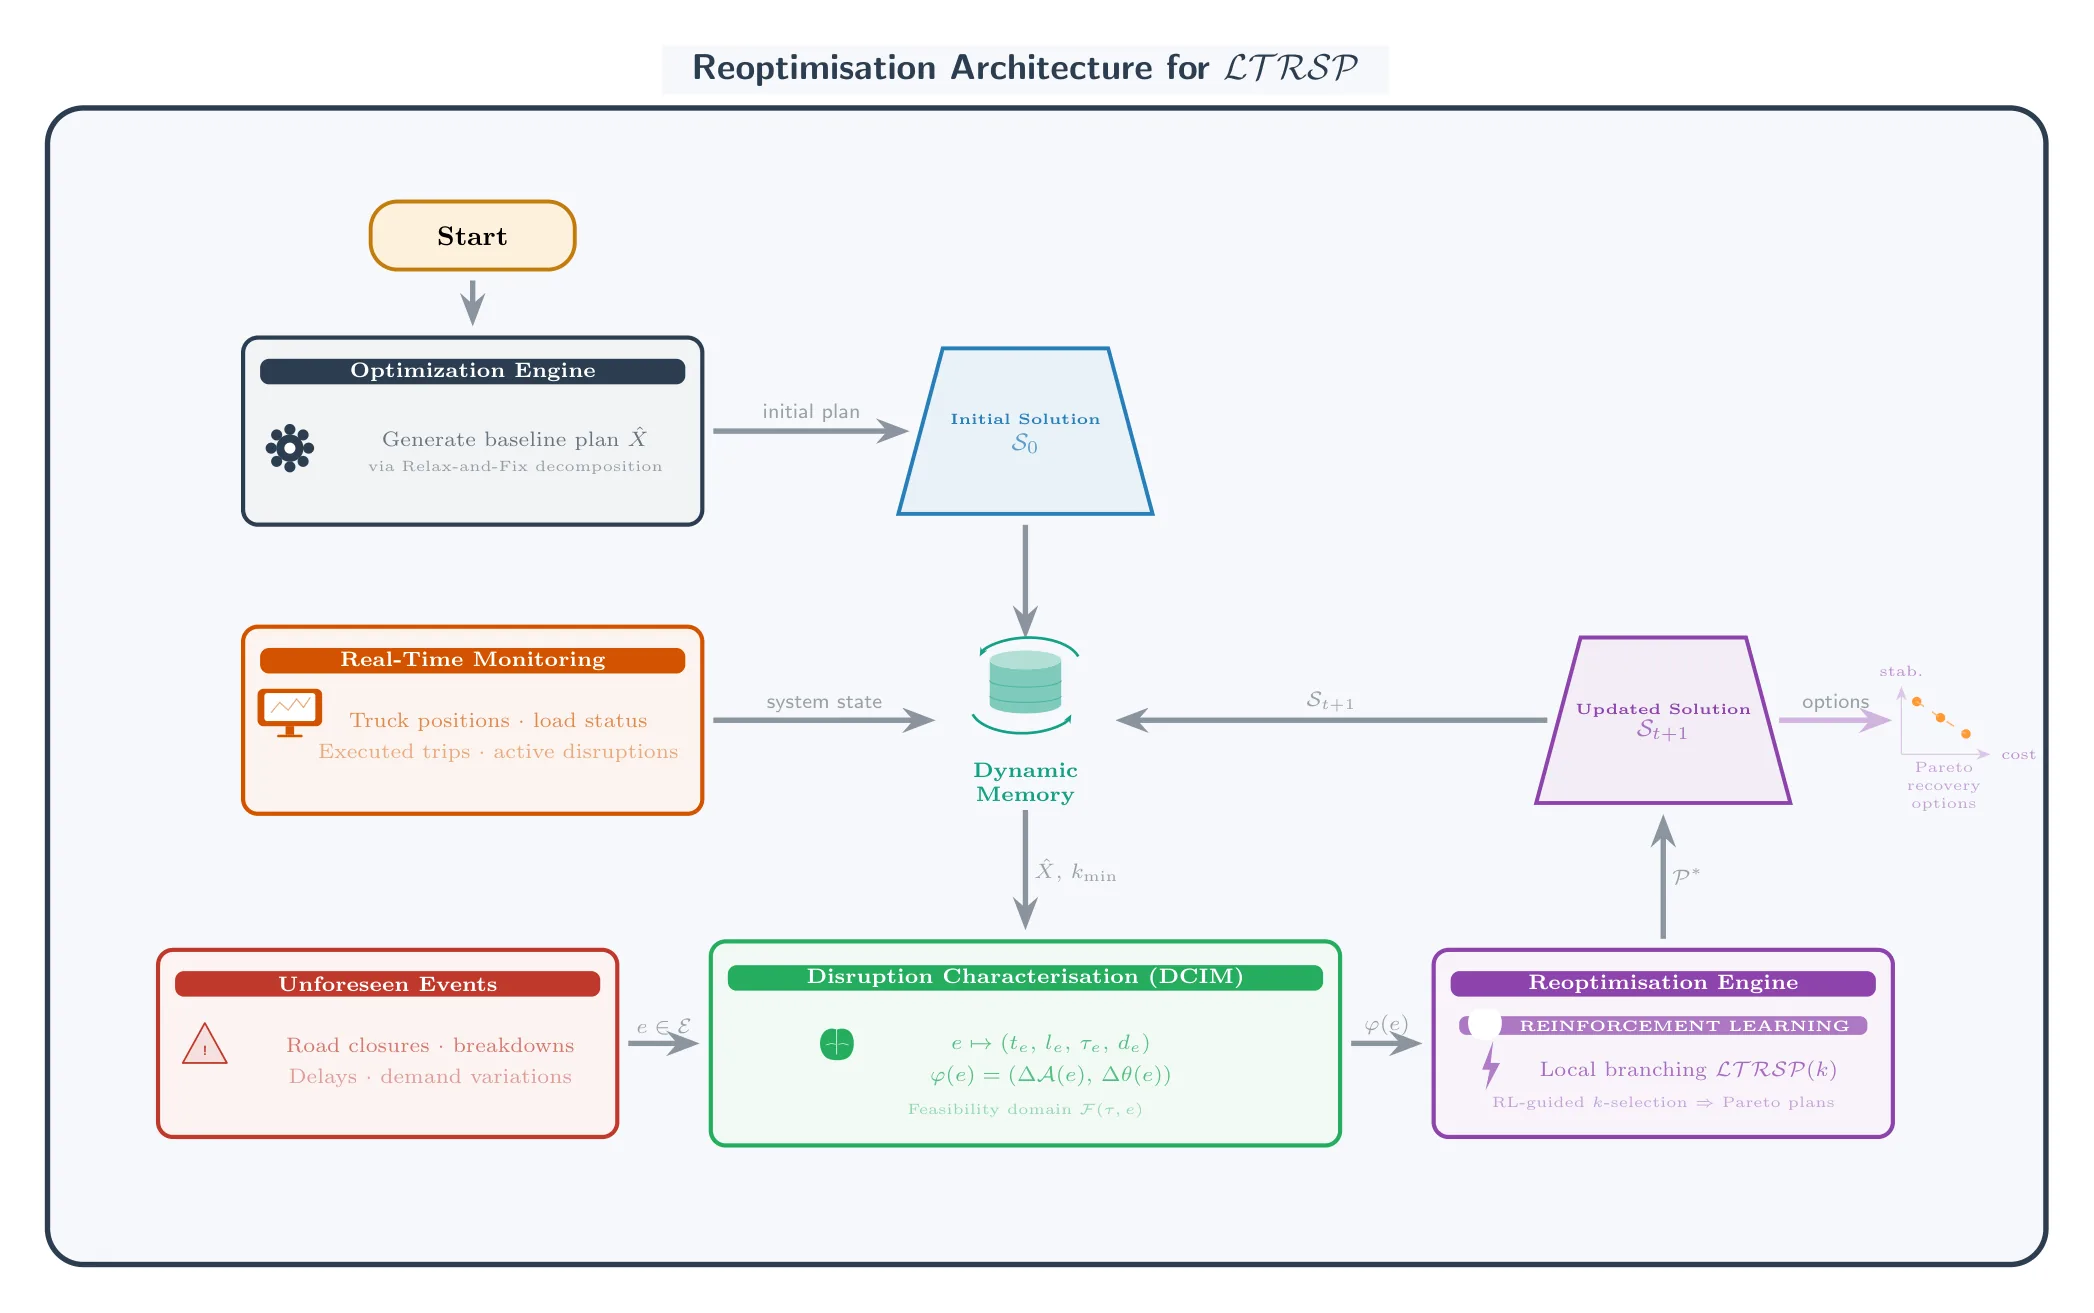
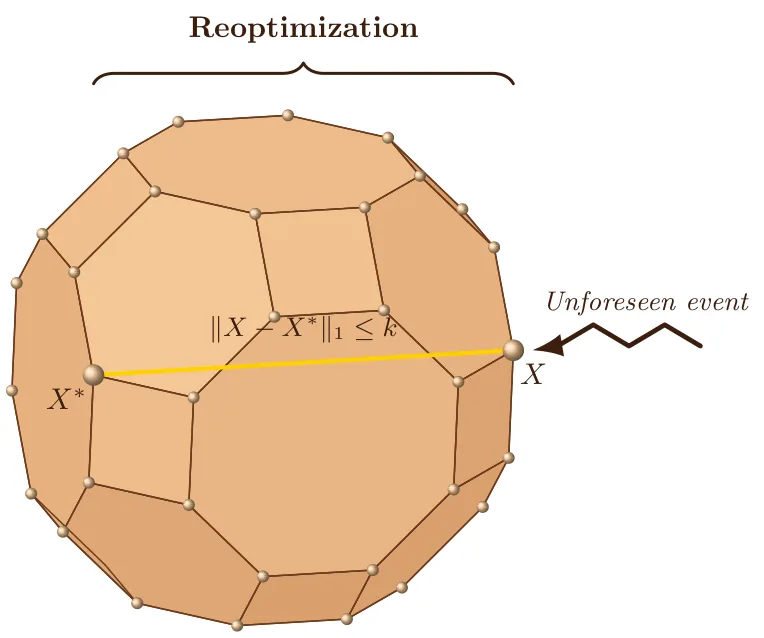
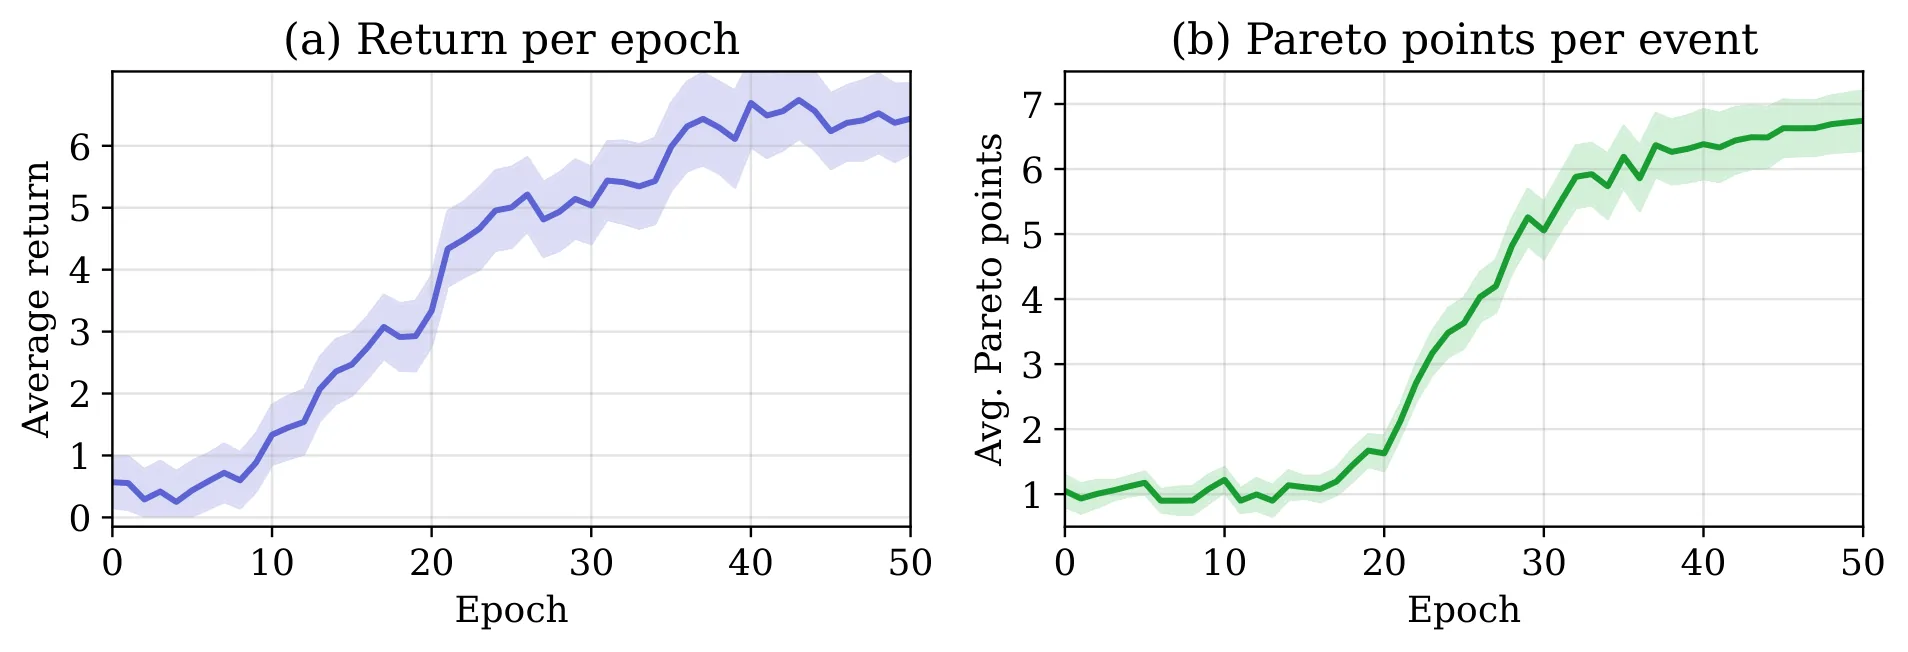
TL;DR
这篇论文针对加拿大林业原木卡车调度在遭遇道路封闭、车辆故障等突发事件后的实时恢复优化问题,提出了一种结合强化学习与混合整数规划的创新方法。核心思路是将恢复搜索限制在由偏差界 定义的邻域内,并通过 REINFORCE 策略梯度算法自适应地探索稳定性-代价空间,从而为调度员生成一条完整的帕累托前沿而非单一方案。实验结果表明,该方法在减少求解器调用次数的同时,获得了比固定 网格搜索和二分搜索基线更丰富的帕累托前沿,且能在实际可接受的时间内为各类中断场景生成可行恢复方案。
研究背景与动机
加拿大林业是一个高度依赖准时制物流的行业,原木从采伐点到加工厂的运输涉及复杂的路径规划与时序调度。企业在战术层面预先制定周密的卡车调度计划,但现实中总会有各种突发扰动打乱这些计划——道路可能因天气或维护而封闭,某辆卡车可能突发机械故障,装载或卸载时间可能因人为因素而延长,甚至原木需求量本身也可能出现波动。这些中断事件会使原本可行的计划瞬间失效,如果不能及时恢复,不仅会导致加工厂的原料断供,还会造成卡车和人员资源的空转浪费。
恢复调度可行性的紧迫性显而易见,但问题远非找到一个可行解那么简单。实际运营中还有一个同等重要的考量:偏离原始计划会造成额外的协调成本——调度员需要重新通知司机,供应链上下游的衔接需要重新对接,任何未预期的变更都可能引发连锁反应。因此,恢复决策面临一个根本性的张力:必须在最短时间内恢复可行性,同时又必须尽可能少地偏离原始计划。这两个目标在数学上是非平凡的,寻求其中一个最优往往意味着在另一个上做出牺牲。
传统方法通常将这种权衡显式地建模为单目标优化问题,通过加权求和的方式将两个目标合并。然而,加权系数的选取本身就是一门艺术——不同的调度员、不同的运营情境可能对稳定性与代价有不同的偏好。更关键的是,固定权重往往只能找到一个解,而调度员实际上需要的是一幅完整的决策图景:在稳定性与代价之间到底有哪些可选方案,各自的得失如何。帕累托最优的概念正是为解决这一问题而设计的,它能系统地揭示所有非支配解,让决策者根据实际情况做出知情选择。
方法
将恢复问题形式化是整个方法的起点。论文将恢复后计划与基准计划之间的偏差量化为 距离,定义为偏差界 ,并由此构建了一个受 约束的邻域受限混合整数线性规划模型。这个建模选择蕴含着深刻的直觉: 距离在调度问题中具有良好的可解释性,它直接对应着原计划中需要变更的指派数量或时间调整幅度;同时,将偏差硬性约束在界 之内而非软性地加权惩罚,使得恢复计划与原始计划的偏离被显式控制,为调度员提供了更强的可预测性。
给定一个具体的 值,求解该 [[混合整数线性规划]] 可以得到在偏差不超过 的约束下代价最小的恢复方案。但问题的关键在于:对于任意中断场景,最小可行的 值 是多少?如果不能回答这个问题,就无法锚定搜索空间的起点。论文的其中一个理论贡献在于证明了 可以被精确计算,这一结果将搜索稳定地固定在最稳定的极端处——即在不改变任何基准计划的前提下,检查是否存在可行的恢复方案;如果不存在,则逐步放宽约束直到找到可行域的边界。
然而,仅知道 并不足以生成完整的帕累托前沿。理论上,帕累托前沿由所有非支配解构成,穷举所有可能的 值在计算上是不切实际的。更高效的做法是有策略地探索 的取值空间,在保证前沿完整性的同时最小化求解器调用次数。这正是 [[强化学习]] 介入的切入点。
论文提出了一种基于 REINFORCE [[策略梯度]] 算法的策略网络,其输入是当前中断场景的特征表示以及求解器的历史反馈,输出是下一个待探索的 值。训练目标是最大化积累的帕累托前沿质量指标——既考虑前沿上解的分布密度,也考虑其对帕累托边界的覆盖程度。关键设计在于策略不是一次性输出整套 取值序列,而是自适应地、序贯地选取下一个 值,每一步都根据已探索点的情况动态调整探索方向。这种设计使得求解资源能够自动集中于前沿变化剧烈的区域,而在前沿趋于平坦的区域则及时终止探索,避免无效的计算开销。
实验与结果
实验基于一家加拿大林业合作伙伴的真实历史数据构建了周度测试实例,并设计了涵盖所有考虑的事件类别的中断场景,包括道路封闭、单车故障、多车故障、行程延误以及需求波动等。这种多类型的覆盖确保了评估结论的普适性。基线方法包括固定 网格搜索——以均匀间隔遍历 的取值范围,以及二分搜索——在 和预设上界之间对半切分以快速定位。
实验结果首先验证了 计算的有效性:无论中断类型如何,精确计算的最小可行偏差界都能快速锚定搜索起点,避免了在完全不可行区域的无谓搜索。更重要的是,REINFORCE 策略在帕累托前沿质量上显著优于两种基线。具体而言,在相同的求解器调用预算下,策略学习驱动的前沿包含更多非支配点,且这些点在稳定性-代价空间中的分布更为均匀,为调度员提供了更细粒度的决策选项。二分搜索虽然在找到单个解的效率上尚可,但它倾向于集中探索中间区域而忽略极端值,导致前沿两端的信息严重不足;网格搜索则因固定步长难以适应不同区域的复杂性,要么过度采样(浪费计算)要么采样不足(前沿缺失)。
运行时间方面,所有方法在可接受的范围内完成再优化——通常在分钟级别,这对于实时调度决策场景是必要的。值得注意的是,强化学习策略虽然需要额外的离线训练过程,但训练完成后的在线推理几乎不产生额外开销,而其带来的求解效率提升足以弥补训练成本。论文还进行了消融实验,分析了策略网络架构、训练数据规模等因素对最终性能的影响,验证了各组件的必要性。
讨论与可借鉴点
这篇论文的方法论贡献在于展示了如何将 [[策略梯度]] 强化学习有效地嵌入到组合优化的迭代求解过程中。与传统启发式或元启发式方法不同,强化学习策略不是直接输出解,而是充当求解过程的"智能调度器",决定在哪个子问题上投入计算资源。这种角色定位使得学习目标从"直接优化问题解"转化为"学习高效搜索策略",降低了学习难度的同时提升了迁移能力。
当然,方法也存在局限。首先,策略的训练依赖于历史中断场景的分布,如果实际运营中出现的扰动模式与训练数据差异显著,策略的适应性可能下降。其次, 的取值空间本身是离散的且规模有限,但在更复杂的调度环境中,偏差的度量方式可能需要扩展到时间窗口、资源容量等多维约束,这会显著增加探索空间的结构复杂性。此外,帕累托前沿的生成虽然为决策提供了丰富选项,但也意味着调度员需要额外的认知负载来理解和使用这些信息,如何设计直观的可视化界面或决策支持工具是值得进一步探索的方向。
从更广的角度看,这项工作为运筹优化与机器学习的交叉提供了一个有价值的范式:将领域知识(邻域受限建模、精确的 计算)与数据驱动的策略学习相结合,在保证求解质量的前提下提升效率。对于工业级的大规模调度系统,这种"学习何时搜索、如何搜索"的思路有望在更多场景中发挥作用。
摘要
我们研究加拿大林业行业中,在突发事件发生后木材卡车路径与调度的实时再优化问题。道路封闭、车辆故障、行程延误以及需求波动会使预先制定的战术计划失效,因此需要在紧张的时间约束下作出恢复决策,同时兼顾恢复可行性与限制偏离原始计划的程度,而这两个目标天然存在张力。我们将恢复过程建模为一系列邻域受限的混合整数线性规划序列,由偏差界 (即恢复后计划与基准计划之间的 距离)参数化。我们证明了最小可行值 可以被精确计算,从而将搜索锚定在最稳定的极端处。我们不以单一 为目标,而是寻求一个由非支配恢复计划构成的帕累托前沿,跨越稳定性-代价空间,为调度员提供一组结构化的运行备选方案。为高效遍历该空间,我们提出一种使用 REINFORCE 策略梯度算法训练的强化学习策略,该策略根据求解器反馈自适应地选取后续的 值,将计算资源集中于有成效的区域,并在进一步改进的可能性较低时终止探索。在基于一家加拿大林业合作伙伴历史数据构建的周度实例上,针对涵盖所有事件类别的中断场景进行评估,结果表明该方法在求解器调用次数更少的情况下,能够获得比固定 网格搜索与二分搜索基线更为丰富的帕累托前沿,并在所有配置与中断类型下,于运行上可接受的再优化时间内生成可行的恢复计划。
Abstract
We consider the real-time reoptimisation of log-truck routing and scheduling in the Canadian forestry industry following unforeseen disruptions. Road closures, vehicle breakdowns, travel delays, and demand fluctuations invalidate pre-established tactical plans and call for recovery decisions that simultaneously restore feasibility and limit deviation from the original schedule, two objectives inherently in tension under tight time constraints. We formulate recovery as a sequence of neighbourhood-restricted mixed-integer linear programs parameterised by a deviation bound , the distance between the recovered and baseline plans. We show that the minimum feasible value can be computed exactly, anchoring the search at its most stable extreme. Rather than targeting a single , we seek a Pareto front of non-dominated recovery plans spanning the stability--cost space, giving dispatchers a structured set of operational options. To navigate this space efficiently, we propose a reinforcement learning policy, trained with the REINFORCE policy-gradient algorithm, that adaptively selects successive values of from solver feedback, concentrating computational effort in productive regions and terminating exploration when further improvement is unlikely. Evaluated on weekly instances derived from historical data of a Canadian forestry partner, under disruption scenarios covering all event categories considered, the approach recovers richer Pareto fronts with fewer solver calls than fixed- grid and dichotomic search baselines, and produces feasible recovery plans within operationally acceptable reoptimization times across all configurations and disruption types.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。