
📝 TLDR
离线目标条件强化学习在长视野任务中面临"视野诅咒"问题,价值估计误差沿Bootstrap链累积。现有分层方法依赖短视的低层控制器,价值估计存在偏差。本文提出HiQC,将高层潜在规划与低层动作分块结合,通过对时序扩展动作序列做k步价值备份,理论上证明其误差上界更紧。实验在OGBench套件上取得最高综合性能,在humanoid-giant等长视野导航任务上增益最大。
🧭 速览
离线目标条件RL在长视野任务中存在"视野诅咒",价值估计误差沿长链Bootstrap备份不断累积。
HiQC结合高层潜在规划与低层动作分块,对时序扩展动作序列做无偏k步价值备份,双层压缩视野。
在OGBench套件综合性能最高,在humanoid-giant等长视野导航任务上增益最为显著。
双层分解在有界单步误差假设下给出比单一分层或平面分块更紧的价值误差上界。
🆚 方法对比
HiQC(Hierarchical Implicit Q-Chunking)
- 双层分解同时压缩规划与执行视野
- 低层评论家条件化动作块实现无偏k步回溯
- 误差界为O(√(T/k)),显著优于平坦TD的O(T)
- 在OGBench上聚合得分最高,长视野任务增益最大
- 理论分析基于简化的有界误差模型假设
- 不提供完整算法的端到端保证
- 依赖潜在子目标表示的稳定性
- 需组合多种组件,实现复杂度较高
IQL(Implicit Q-Learning)
- 避免查询分布外动作的值估计
- 通过expectile回归实现稳定值学习
- 样本内学习避免分布偏移问题
- 平坦值估计在长视野任务中受诅咒
- TD误差沿多步递归累积放大
- 缺乏对长视野结构的显式分解
标准分层强化学习(Standard HRL)
- 将长视野任务分解为可管理的子目标序列
- 通过子目标减少高层的规划视野
- 低层控制器存在短视执行问题
- 低层值估计存在偏差
- 高层依赖不稳定低层控制器
- 仅将误差界降至O(√T)
平坦动作分块(Flat Action Chunking)
- 评论家可对整块执行无偏n步回溯
- 压缩执行视野提高时序一致性
- 在模仿学习中生成时序连贯动作
- 仅以常数因子压缩视野
- 对超长视野任务仍不充分
- 块长度增大时方差升高
- 缺乏高层结构化分解
平坦TD学习(Flat TD Learning)
- 框架简单且理论成熟
- 短视野任务中表现稳定
- 广泛适用,易于实现
- 长视野中误差界为O(T),线性累积
- Bellman回溯链导致偏差复利放大
- 对远距离目标值估计不可靠
- 外推误差在分布外动作上严重
HiQC通过分层规划与动作分块的双层分解,在规划与执行两个层面同时压缩视野,优于仅缓解单一问题的标准分层RL(误差界O(√T))和平坦动作分块(仅常数因子压缩),在OGBench长视野任务上获得最佳性能。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
这篇论文针对离线目标条件强化学习中「视野诅咒」这一核心难题,提出了名为 HiQC 的分层隐式 Q 分块方法。核心思路是在高层利用潜在空间做子目标规划、在低层通过条件化整段动作序列实现无偏 k 步价值回溯,从而在规划和执行两个层级同时压缩视野。理论分析表明,相比标准分层或扁平动作分块,HiQC 能获得更紧的价值误差界。实验在 OGBench 套件上取得了对比方法中最高的综合性能,尤其在 humanoid-giant 等长视野导航任务上显著超越现有方法。
研究背景与动机
离线目标条件强化学习([[离线强化学习]])的核心目标是:从预先收集好的静态数据集中学习能够达成任意目标状态的通用策略。这种设定在实际应用中极具吸引力——我们可以用大量无需在线交互的演示数据训练策略,从而避开真实环境中采样高昂或危险的问题。然而,当任务视野(即从起点到目标所需的步数)变得很长时,现有的离线目标条件强化学习方法往往表现急剧下降。
问题出在价值函数的训练机制上。无论是哪种离线强化学习算法,值函数通常都通过递归的贝尔曼回溯来更新——用当前估计的未来累积奖励来调整对当前状态价值的判断。这种自举(bootstrapping)机制在短视野任务中尚可接受,但当任务需要成百上千步才能完成时,每次回溯引入的微小偏差会沿着整条链条累积,最终导致价值估计严重偏离真实值。这就是研究者所说的「视野诅咒」(curse of horizon):任务越复杂、步数越多,误差累积越严重。
已有的分层强化学习方法试图通过将长任务分解为一系列子目标来缓解这个问题。高层控制器负责在抽象空间中规划下一步应该到达什么子目标,低层控制器则负责执行到达该子目标的具体动作。理论上,这种分解应该能够缩短每条回溯链的长度。但问题在于,低层控制器通常仍然以单步粒度执行动作,这意味着高层虽然在规划层面做了压缩,低层的价值回溯仍然要沿着完整的执行轨迹一步步往后看。价值估计的偏差问题并没有被真正解决,只是被推迟到了更低的层级。
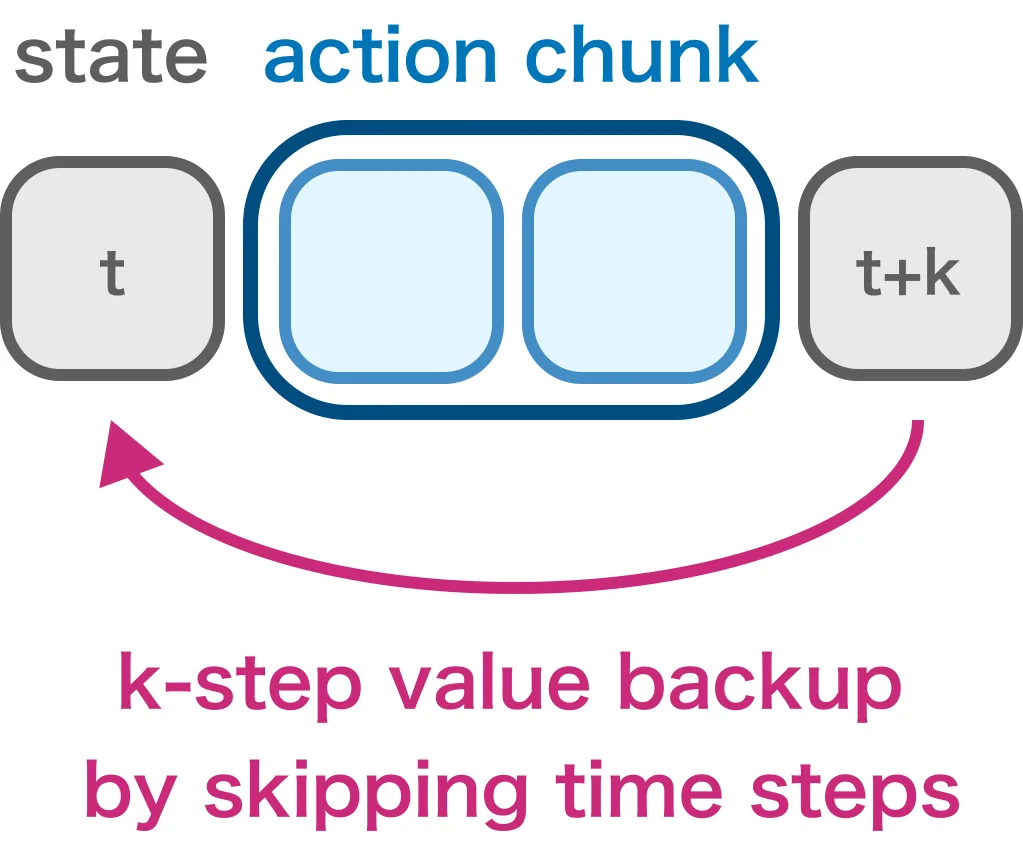
与此同时,动作分块(Action Chunking)方法提出了一种不同的思路:让智能体一次性输出并执行一段连续的动作序列,而不是每次只输出一步动作。通过将低层评论家条件化于整段动作序列,可以实现无偏的 k 步价值回溯——也就是说,贝尔曼回溯不再一步一回头,而是跳着看 k 步。这种方式确实能以常数因子压缩视野,但压缩的幅度有限。对于超长视野任务,仅仅靠改变动作输出的粒度仍然不足以克服误差累积。
HiQC 的出发点由此变得清晰:如果能够在规划层和执行层同时做视野压缩——让高层在潜在空间做子目标规划、低层通过动作分块做无偏回溯——两种分解机制协同作用,是否能获得比任何单一方法更紧的价值误差界?
方法
HiQC 的核心设计围绕「双层时间分解」展开,整个系统分为高层和低层两个层级,它们各自负责不同粒度的时间抽象。
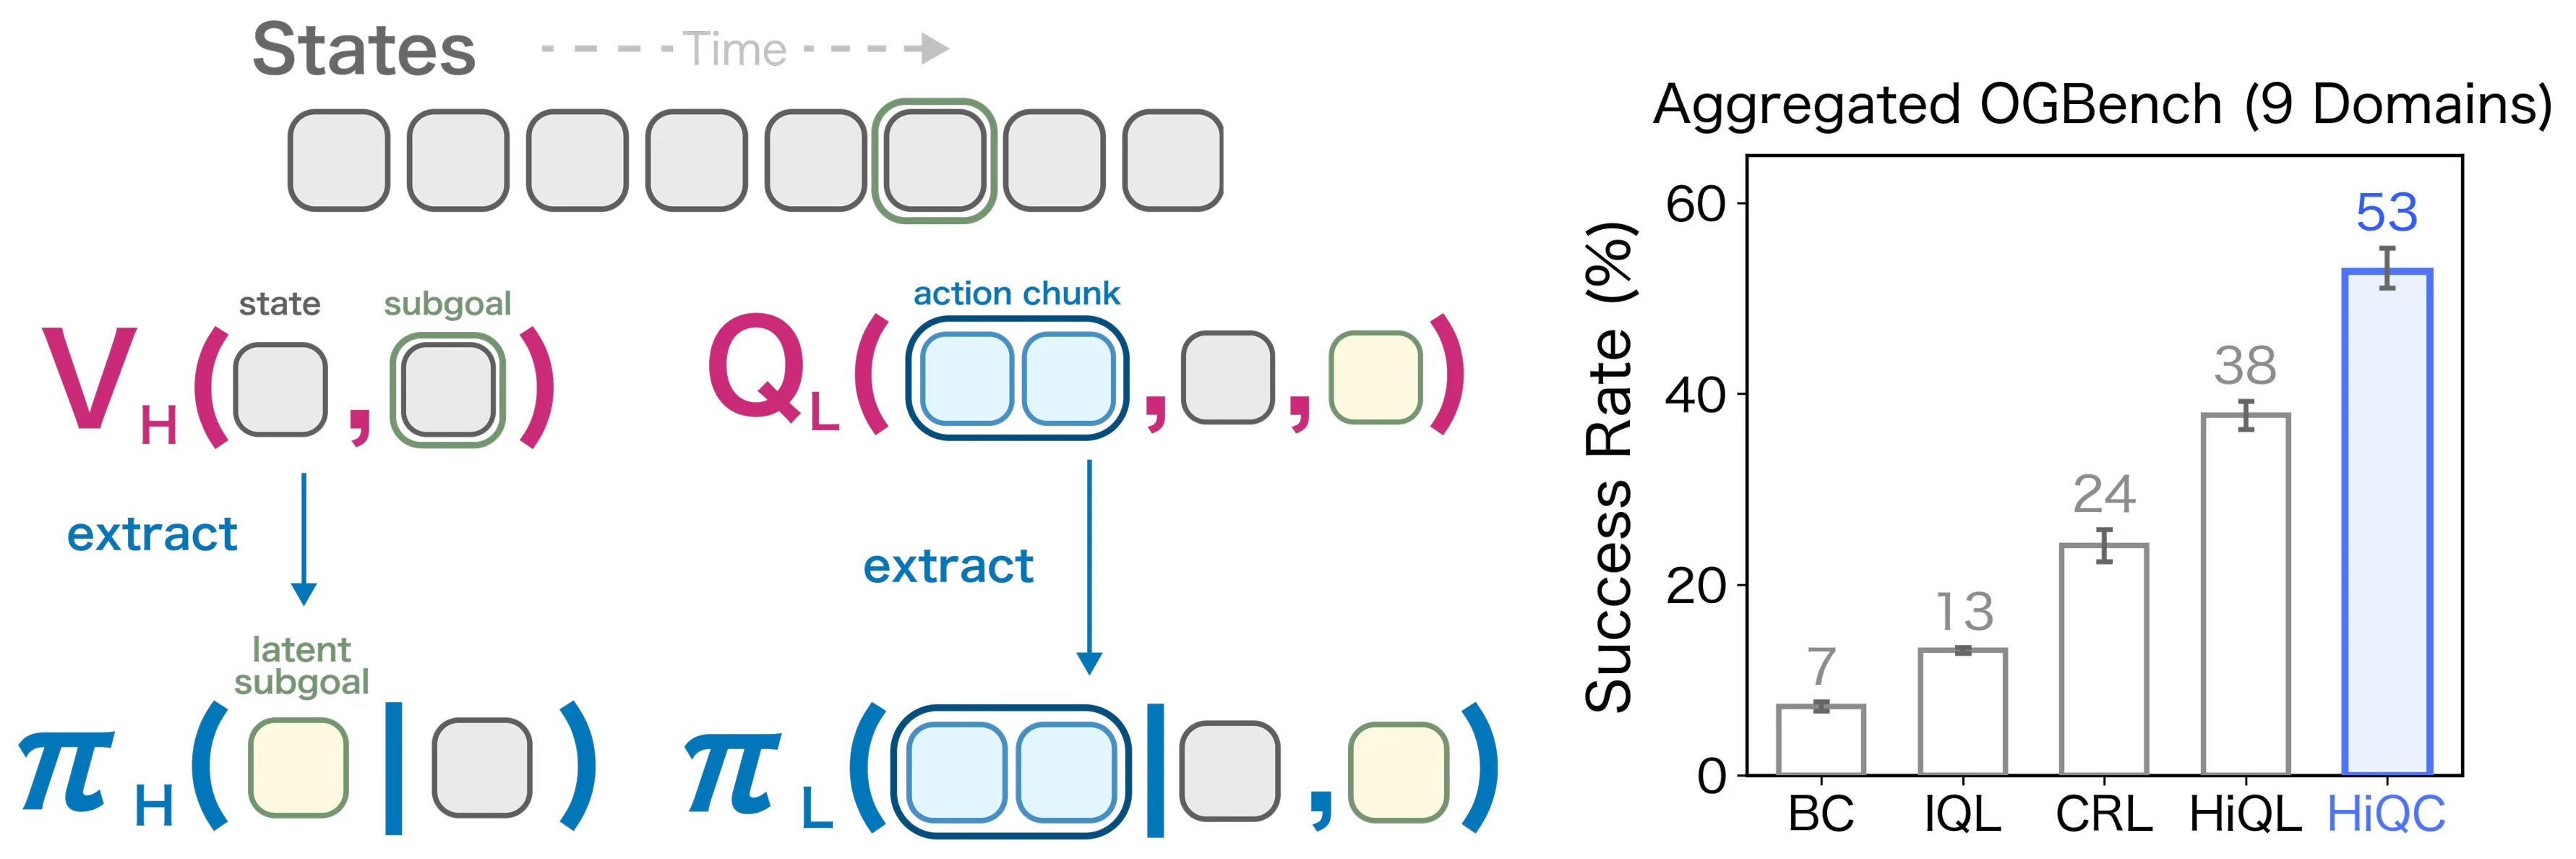
高层负责在潜在空间中规划子目标。给定当前状态 和目标状态 ,高层策略 输出一个潜在子目标 ,其中 是将状态映射到 10 维潜在空间的编码器。子目标不是任意选取的,而是从轨迹中间隔 步的未来状态中采样得到的。这种设计让高层天然具有 步的规划视野——它不需要精确预测每一步的执行细节,只需要预测「接下来应该朝哪个方向走」。高层值函数 通过隐式 V 学习(IVL)框架训练,其损失函数为:
注意这里的折扣因子是 而不是 ,这正是高层视野压缩的体现——跳过了中间的 步,直接从 连接到 。
低层负责执行具体的动作分块。与传统方法每次输出一个动作不同,低层策略 输出一个长度为 的动作序列 。更关键的是,低层评论家 以整段动作分块作为输入,而价值回溯的步长也是 :
这种条件化整段动作序列的做法是 Q-Chunking 的核心洞察。传统方法中,评论家只看到当前状态和当前动作, 步回溯需要递归地展开 次,每一步都会引入新的误差。而当评论家直接以 为条件时,它能够「看到」整个分块的全部内容,从而实现无偏的 步回溯——误差不再沿 步的链条累积,而是被压缩到一个统一的估计中。
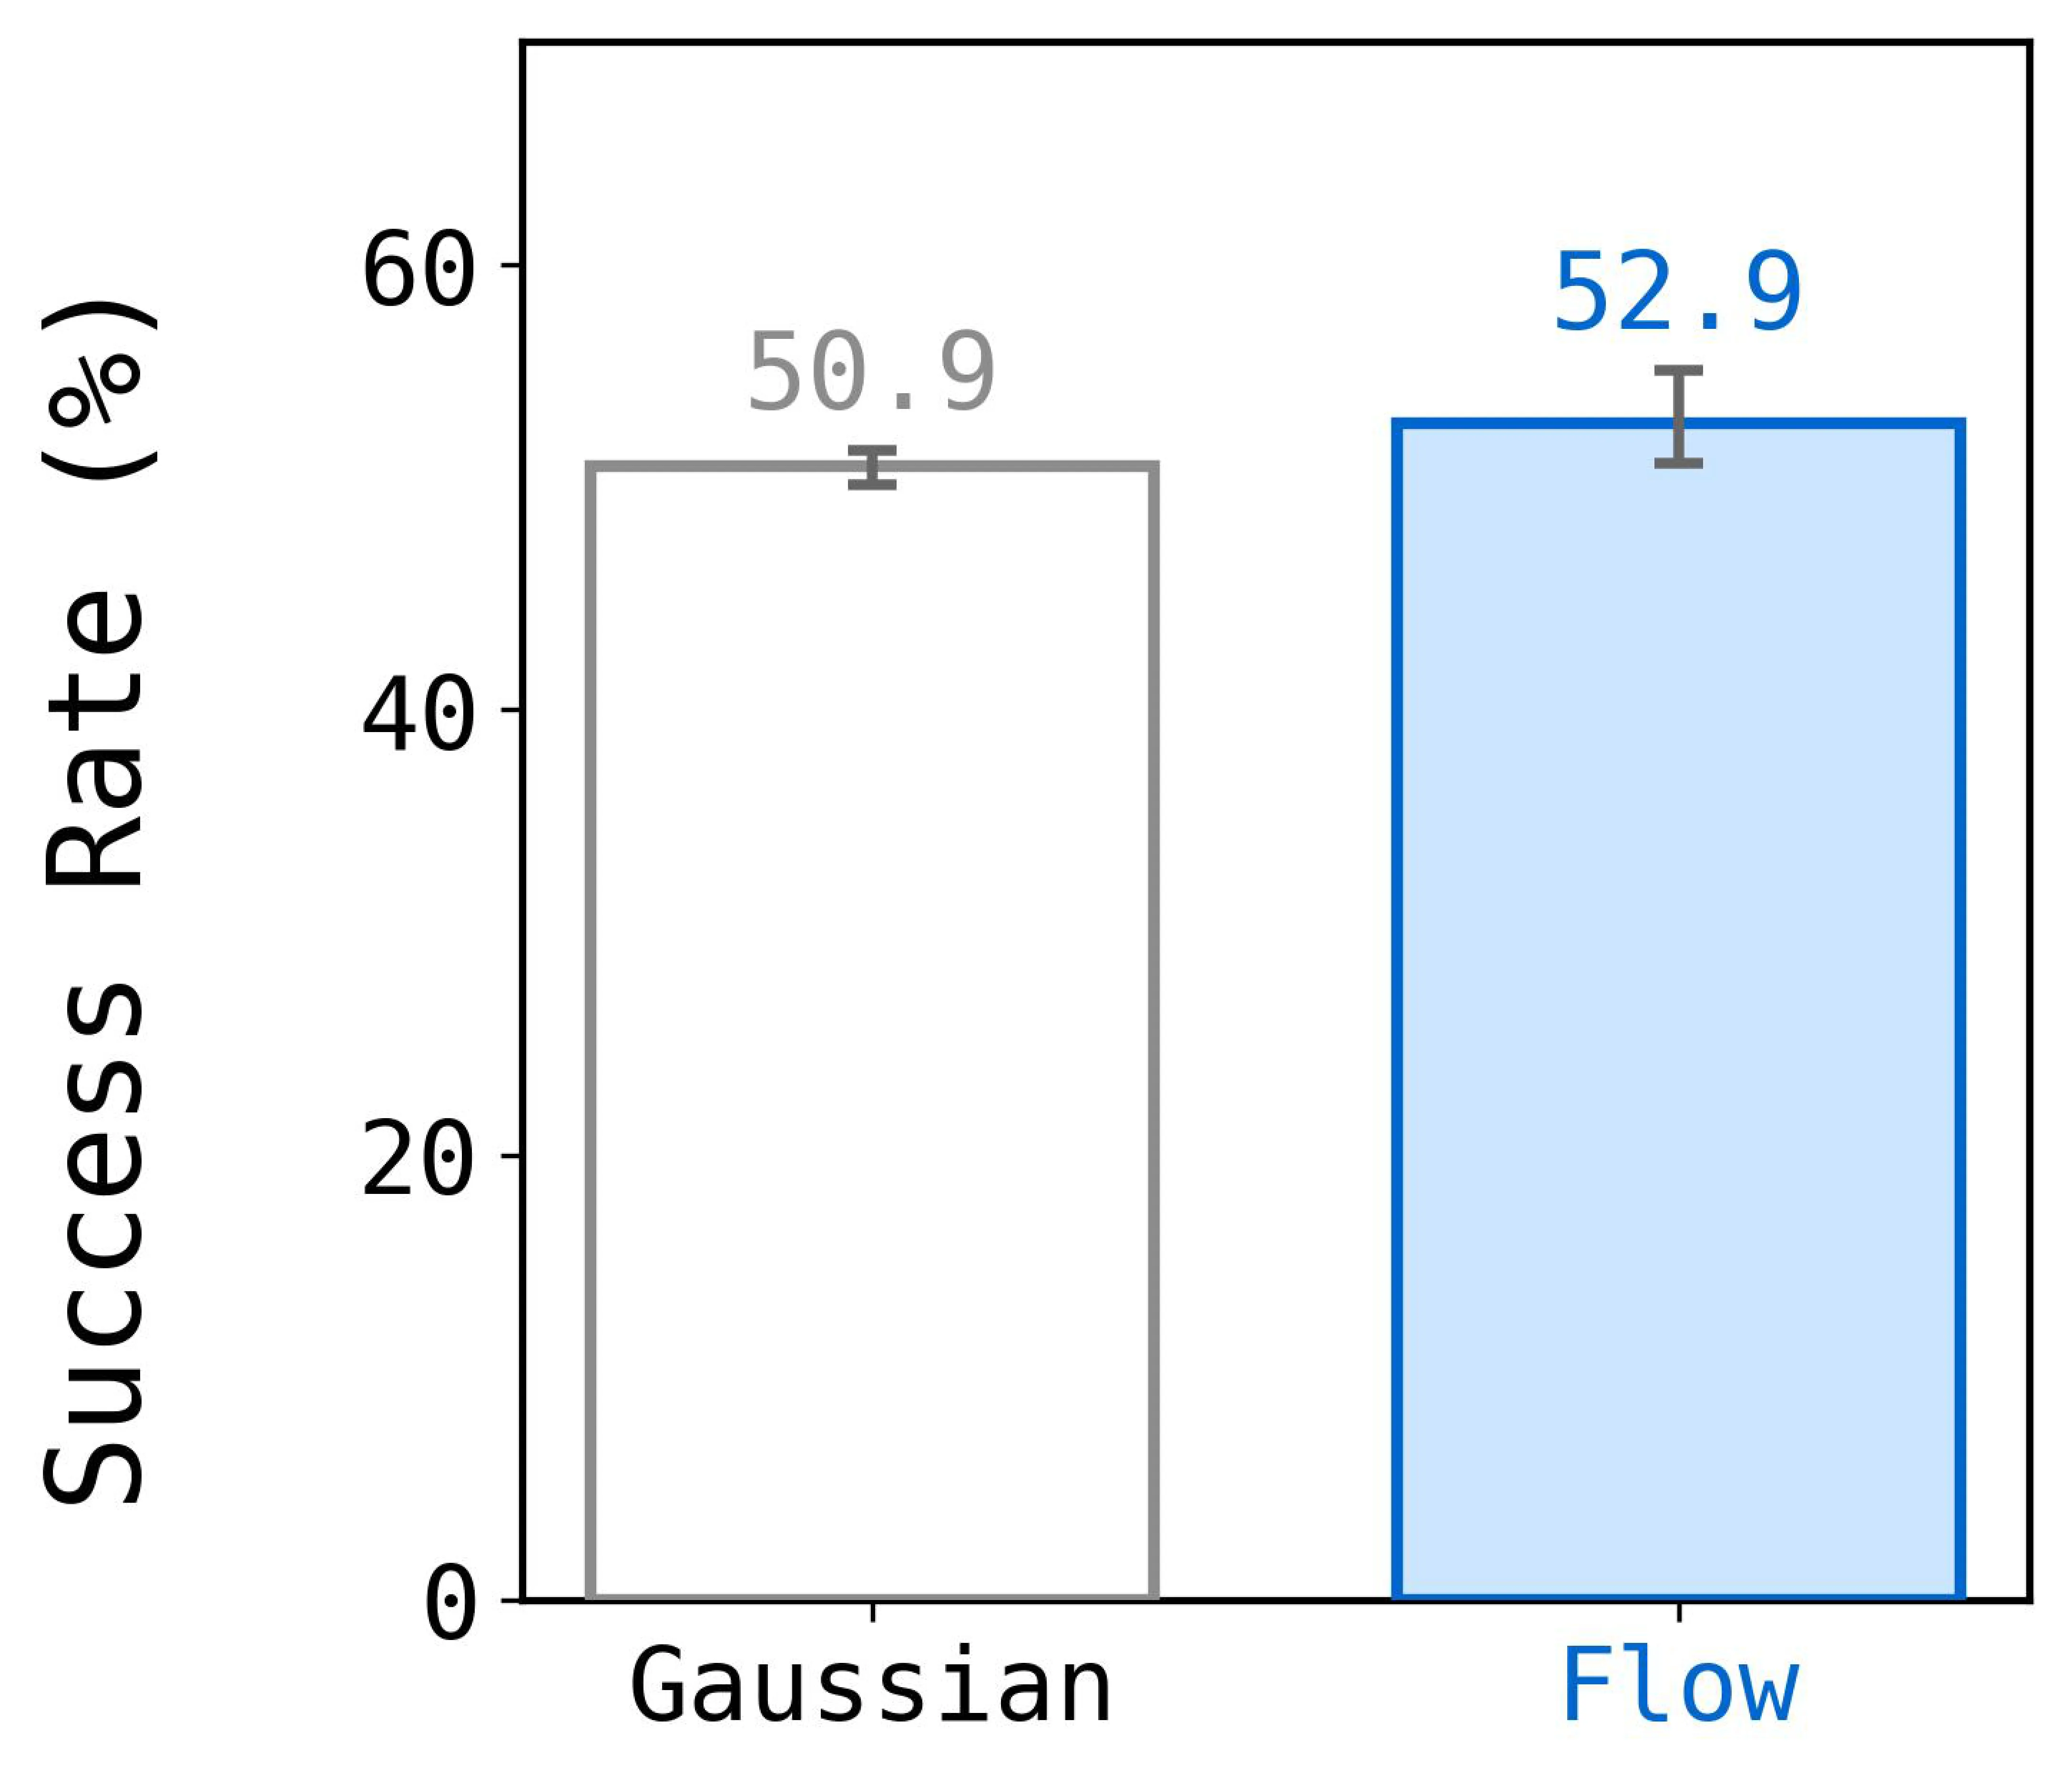
低层策略本身通过条件流匹配(CFM)来参数化。流匹配是一种生成式建模方法,它学习一个向量场 ,将服从均匀分布的噪声 通过常微分方程演化映射到目标动作分块 。这种参数化方式相比高斯策略具有更好的表达能力和多模态捕捉能力。低层策略的损失函数结合了优势加权和流匹配损失:
整个系统的执行流程是:给定状态-目标对 ,高层策略采样潜在子目标 ,低层策略在 的条件下生成动作分块 ,执行后得到 ,再进入下一个高层规划周期。通过这种方式,视野被双重压缩:高层跳 步,低层跳 步,综合视野压缩比为 。
实验与结果
实验在 OGBench 套件上进行,这是一个专门用于评估离线目标条件强化学习方法的标准化 benchmark,包含 9 个任务,涵盖运动导航(如 antmaze-large、humanoid-giant、pointmaze-large)和高维操作(如 cube-triple、puzzle-4x6、scene-play)两类场景。所有任务使用图像或像素观测而非 oracle 状态表征,奖励为稀疏二值——只有当智能体成功到达目标时才获得 0 奖励,否则为 -1。
对比基线分为三类:扁平方法(GCBC、CRL、GCIQL)不做任何时间分解;动作分块方法(Q-Chunking、Decoupled Q-Chunking)在单层上做 步回溯;分层方法(HGCBC、HGCBCAC、HIQL)引入子目标但低层仍为单步执行。HiQC 在所有 9 个任务上与这些基线进行了对比,每种配置使用 4 个随机种子。
整体结果表明,HiQC 以 53% 的总体成功率取得了对比方法中的最高综合分数。在长视野导航任务上的优势尤为显著:humanoid-giant 任务中,HiQC 达到 33% 成功率,而 HIQL 仅有 10%,其他扁平方法几乎为 0%;pointmaze-giant 上,HiQC 的 80% 显著领先于 HIQL 的 44%;在 antmaze-large 上,HiQC 达到 93%,比 HIQL 的 88% 和 CRL 的 81% 都有明显提升。这些数字有力地验证了双层视野压缩对克服长任务中误差累积的有效性。
然而,在操作任务上的结果则喜忧参半。HiQC 在 cube-triple 上取得最佳(9%),但在 puzzle-4x6 上仅 1%,scene-play 上以 65% 输给 DQC 的 76%。论文对这一现象给出了诚实分析:HiQC 使用 10 维潜在子目标作为瓶颈表征,可能无法充分编码离散对象状态(如 puzzle 中按钮的开合状态),而 DQC 通过解耦评论家视野与执行视野,在这类需要精细状态估计的任务上更具优势。
消融实验进一步揭示了关键设计选择的影响。块大小 的敏感性分析表明,从 增加到 能带来稳定提升,但当 后性能开始下降——过长的开环执行会导致误差在分块内部累积而无法及时修正。高层视野 同样存在「甜蜜点」: 过小则任务复杂度未得到有效降低, 过大则低层控制器难以可靠地到达远距离的子目标。这些发现为后续研究提供了重要的实践指导。
讨论与可借鉴点
HiQC 最有价值的贡献或许不在于某个具体的工程技巧,而在于它提供了一种清晰的分析框架来理解「时间抽象如何帮助克服视野诅咒」。论文的理论分析在简化的 bootstrap-chain 误差模型下证明,当单步回溯误差有界为 时,HiQC 的价值误差上界为 ,显著优于标准分层的 和扁平分块的 。这个结论虽然依赖于较强的假设(均匀有界的单步误差、确定性动力学),但它为理解双层分解的协同效应提供了坚实的数学直觉。
从实践角度,HiQC 的设计留下了几个值得探索的方向。首先,固定块大小 在所有状态上一刀切的做法是明显的局限——直觉上,在状态变化剧烈或不确定性高的区域,应该用更短的分块来及时修正;在稳定、可预测的区域,则可以用更长的分块来提高效率。自适应的分块边界机制是一个值得研究的问题。其次,潜在子目标表征的维度选择(论文固定为 10 维)可能需要根据任务特性调整,特别是在需要编码丰富状态信息的操作任务上。
另一个值得思考的问题是「解耦」与「耦合」的权衡。DQC 在操作任务上优于 HiQC 的事实说明,有时候让评论家的预测视野与执行视野解耦(即评论家可以「看」更远但实际执行步数更短)可能比强制耦合更有优势。这暗示未来工作或许可以在 HiQC 的框架中引入类似的解耦机制,或者探索更灵活的高层-低层信息传递方式。
总的来说,这篇论文的贡献是双重的:它不仅提出了一个性能领先的算法,更重要的是它通过理论分析揭示了「为什么分层+分块的双重分解能够比单一方法更有效」。这种将算法设计与理论分析紧密结合的研究风格值得借鉴。对于希望在离线目标条件强化学习方向深耕的研究者来说,理解 HiQC 的误差分析框架、识别其在操作任务上的局限,可能是开展后续工作的良好起点。
摘要
离线目标条件强化学习(RL)有望从静态数据集中学习通用策略。然而,由于维度诅咒的存在,将这些方法扩展到长视野任务仍然面临挑战,因为价值估计误差会在长链的自举贝尔曼回溯过程中不断累积。现有分层方法通过将任务分解为子目标来缓解这一问题,但它们通常依赖于因短视执行和有偏价值估计而受限的低层控制器。在本工作中,我们提出了分层隐式 Q 分块(HiQC),这是一种结合高层潜在规划与低层动作分块的离线目标条件 RL 算法。通过在时间延展的动作序列上对低层评论家进行条件化,HiQC 实现了无偏的 k 步价值回溯,从而在规划和执行两个层级上压缩了视野。我们在理论上证明,相较于单独使用标准分层或扁平分块,这种双重分解在有界单步回溯误差模型下能够得到更紧的价值误差界。实验上,HiQC 在 OGBench 套件的对比方法中取得了最高的总体性能,其在类人巨物(humanoid-giant)等长视野导航任务上的提升尤为显著。
Abstract
Offline goal-conditioned reinforcement learning (RL) holds the promise of learning general-purpose policies from static datasets. However, scaling these methods to long-horizon tasks remains a challenge due to the curse of horizon, where value estimation errors can compound through long chains of bootstrapped Bellman backups. Existing hierarchical approaches mitigate this by decomposing tasks into subgoals, yet they often rely on low-level controllers that suffer from myopic execution and biased value estimates. In this work, we propose Hierarchical Implicit Q-Chunking (HiQC), an offline goal-conditioned RL algorithm that combines high-level latent planning with low-level action chunking. By conditioning the low-level critic on temporally extended action sequences, HiQC enables unbiased k-step value backups, compressing the horizon at both the planning and execution levels. We theoretically demonstrate that this dual decomposition results in a tighter bound on value error under a bounded per-backup error model compared to standard hierarchy or flat chunking alone. Empirically, HiQC achieves the highest aggregate performance among the compared methods on the OGBench suite, with its largest gains on long-horizon navigation tasks such as humanoid-giant.
论文详细总结(自动生成)
论文总结:Offline RL with Hierarchical Action Chunking (HiQC)
1. 核心问题与整体含义
- 研究背景:离线目标条件强化学习(Offline Goal-Conditioned RL)旨在从静态数据集中学习通用策略,但将其扩展到长视野任务时面临"视野诅咒"(curse of horizon)问题。
- 核心挑战:
- 离线 RL 中值函数通过时序差分(TD)学习递归贝尔曼回溯进行训练;
- 当任务视野 较长时,每次 bootstrap 引入的偏差 会沿长度为 的链条累积;
- 现有分层方法(如 HIQL)虽将任务分解为子目标,但低层控制器仍以单步粒度执行,遗留局部视野效应;
- 现有动作分块方法(如 Q-Chunking)虽能实现无偏 步回溯,但仅以常数因子压缩视野,对超长视野任务仍不足。
- 研究目标:在规划层和执行层同时压缩视野,突破单一方法压缩倍数的瓶颈。
2. 方法论
2.1 核心思想
HiQC 提出双层时间分解:
- 高层(H):在潜在空间 中规划子目标,子目标间距为 步;
- 低层(L):执行长度为 的动作分块 ,通过条件化整段动作序列实现无偏 步值回溯。
2.2 关键技术细节
高层规划(Latent Planning):高层值函数参数化为 ,其中 将状态映射到潜在子目标空间。使用 Implicit V-Learning(IVL)训练高层值函数:
高层策略 通过优势加权回归(AWR)训练:
低层分块执行(Q-Chunking):低层评论家条件化于整段动作分块:
Flow-Based 策略:低层策略 使用条件流匹配(CFM)参数化,通过向量场 将噪声映射为动作分块:
2.3 理论分析
在有界单步回溯误差模型()下,通过 Lemma 1()得到 HiQC 的 bootstrap 链长度为 ,故:
由 AM-GM 不等式,最优 ,最小误差为:
相比标准分层()和平坦分块(),HiQC 在双层分解下获得更紧的误差界。
3. 实验设计
3.1 Benchmark 与数据集
- OGBench 套件(Park et al., 2025a),共 9 个任务:
- 运动导航:antmaze-large/giant、humanoid-large/giant、pointmaze-large/giant;
- 高维操作:cube-triple、puzzle-4x6、scene-play;
- 使用图像/像素观测而非 oracle 状态表征;奖励为稀疏二值(达到目标为 0,否则 )。
3.2 对比方法(9 类)
| 类别 | 方法 |
|---|---|
| Flat Baselines | GCBC、CRL、GCIQL |
| Action Chunking Baselines | Q-Chunking (QC)、Decoupled Q-Chunking (DQC) |
| Hierarchical Baselines | HGCBC、HGCBCAC、HIQL |
| 本文方法 | HiQC |
4. 资源与算力
- GPU 型号:NVIDIA RTX 4090;
- 训练时长:每次运行约 1.5 小时;
- 训练步数:1,000,000 梯度步;
- Batch size:1024;
- 优化器:Adam,学习率 ;
- 种子数:每个任务配置 4 个随机种子;
- 总模型数:9 种方法 × 9 个环境 = 超过 300 个模型从零训练;
- 文中明确指出受算力限制,未对 HiQC 进行逐域超参调优,高/低层超参分别继承自 HIQL 和 Q-Chunking 的默认配置。
5. 实验数量与充分性
- 主实验:9 个任务 × 9 种方法 × 4 seeds = 324 组实验;
- 消融实验:
- Flow Matching vs Gaussian 策略对比(9 个环境);
- 块大小 的敏感性分析(scene-play 环境,4 seeds);
- 高层规划视野 的敏感性分析;
- 附加分析:与 DQC 在操作任务上的结构差异比较(Appendix C);
- 充分性评估:
- 优点:环境覆盖广(运动 + 操作),对比方法多样,含完整消融;
- 不足:仅 4 seeds,置信区间在某些任务上较宽(如 cube-triple 上 HiQC 为 );未对 HiQC 进行逐域超参调优;manipulation 任务结果混合,未给出细分场景的失败模式分析。
6. 主要结论与发现
- 整体性能:HiQC 在 OGBench 上以 53% 的总体成功率取得对比方法中最高综合分;
- 长视野导航显著优势:
- humanoid-giant:HiQC 33% vs HIQL 10%,vs 其他 flat 方法基本为 0%;
- pointmaze-giant:HiQC 80% vs HIQL 44%;
- antmaze-large:HiQC 93% vs HIQL 88% vs CRL 81%;
- 操作任务结果混合:
- cube-triple 上 HiQC 取得最佳(9%);
- scene-play 与 puzzle-4x6 上 DQC 优于 HiQC(76% vs 65%;16% vs 1%);
- 推测原因:DQC 解耦了评论家视野()与执行视野(),且不使用潜在子目标瓶颈;
- 块大小敏感: 由 1 增至 5 提升性能,但 后因开环执行误差累积而下降;
- 高层视野敏感:存在"甜蜜点"—— 过小则任务复杂度未降低, 过大则低层难以到达远距子目标。
7. 优点
- 结构创新:首次将潜在分层规划与动作分块评论家统一于同一算法,形成"规划 + 执行"的双重视野压缩;
- 理论支撑:在简化的 bootstrap-chain 模型下给出 的严格误差上界,与 (flat TD)和 (标准分层)形成清晰的渐近对比;
- 实现现代:高层使用 IVL + AWR,低层使用 IQL + CFM,与 SOTA 离线 GCRL 基线接轨;
- 实验广度:覆盖 9 个 OGBench 任务,包含运动导航与高维操作两大域;
- 诚实呈现局限:在 antmaze-giant 上 HiQC 仅匹配 HIQL 而非超越,作者明确指出 限制了低层压缩能力;对 manipulation 上的劣势也给出诚实讨论与结构差异分析。
8. 不足与局限
- 统计强度有限:仅 4 个随机种子,部分任务置信区间宽(如 cube-triple 上 ),统计功效不足;
- 固定块大小: 在所有状态上保持恒定,过大的块会因开环执行误差累积而性能下降( 时明显退化),缺乏自适应状态条件化的块边界机制;
- 理论假设过强:bootstrap-chain 误差模型忽略函数逼近与采样误差,且有界单步误差 在深度网络下未必均匀成立;分析仅作为直觉构建而非端到端保证;
- 确定性假设:高层值函数在确定性动力学下才无偏(HIQL 已知限制),未扩展到随机动力学;
- 潜在子目标瓶颈:10 维潜在子目标可能无法编码离散对象状态(如 puzzle 的按钮状态),是 manipulation 任务上欠 DQC 的关键原因;
- 操作任务表现不佳:puzzle-4x6 上仅 1%,scene-play 上输给 DQC 11 个百分点;
- 超参与调优:未逐域调优 HiQC 超参,仅在 scene 环境做了有限的稳定性敏感度检查;
- 算力透明度:算力预算与训练时长已给出,但 4 seeds 的折中是否足以支撑广义性结论仍需更大规模复现验证。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。