
通过批处理实现奖励与状态污染下的鲁棒异步Q学习
Robust Asynchronous Q-Learning under Reward and State Corruption via Batching
📝 TLDR
在对抗性反馈污染的强化学习场景中,奖励和状态观测可能被扰动,导致标准Q学习失效。本文提出基于分批的鲁棒异步Q学习算法BR-Async-Q,通过将在线数据流分批降低方差,并据此构建Bellman最优算子的鲁棒估计。理论证明该算法在ℓ∞范数下的高概率误差界与标准Q学习一致,仅附加一项随污染比例增长的余项。该工作是首个同时针对奖励与状态污染提供鲁棒性保证的异步Q学习成果,且纯奖励污染情形下对污染比例的依赖达到极小极大最优。
🧭 速览
现实环境中奖励与状态观测可能被对手扰动,经典Q学习缺乏对二者同时受污染的鲁棒性保证。
提出基于分批的鲁棒异步Q学习算法BR-Async-Q,通过分批降低方差并构建Bellman最优算子的鲁棒估计。
证明高概率ℓ∞误差界匹配标准Q学习,余项随污染比例增长;纯奖励污染情形下对污染比例的依赖达到极小极大最优。
首个同时针对奖励与状态污染的异步Q学习鲁棒性保证工作,扩展了鲁棒强化学习的理论边界。
🆚 方法对比
BR-Async-Q
- 首个同时抗奖励和状态污染的异步Q学习算法
- ℓ∞误差界与标准Q学习匹配,附加项仅随污染比例缩放
- 仅奖励污染时,污染依赖达到minimax最优
- 通过批处理降低方差,缩小现有上下界差距
- 依赖批/epoch更新,Q表更新频率低,收敛可能慢
- 需已知或估计污染概率ε的先验知识
- 理论分析限定于表格型MDP,实际可扩展性待验证
Vanilla Q-learning
- 算法简单,每步更新Q表,实现直接
- 无污染环境下有成熟有限时间收敛保证
- 无法抵抗奖励或状态的对抗性污染
- 在重尾奖励分布下方差大,收敛速度受影响
Prior robust Q-learning variants [6]-[8]
- 已对奖励污染场景提供鲁棒性保证
- 为后续工作提供了理论分析框架
- 仅处理奖励污染,未覆盖状态污染场景
- 上下界之间存在显著差距,未达到minimax最优
BR-Async-Q通过批处理和鲁棒Bellman算子估计同时处理奖励与状态污染,弥补了Vanilla Q-learning无鲁棒性和现有方法[6]-[8]仅抗奖励污染、上下界不紧的双重不足。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
在奖励与状态观测可能同时遭受对抗性扰动的强化学习场景中,本文提出基于分批的鲁棒异步Q学习算法BR-Async-Q,通过将在线数据流划分为多个epoch并利用截尾均值估计器构建Bellman最优算子的鲁棒版本。理论证明该算法的高概率误差界与标准Q学习相当,仅多出一个随污染比例增长的加性余项,且在纯奖励污染情形下对污染比例的依赖达到[[minimax最优]]。这是首个同时处理奖励与状态联合污染的异步Q学习鲁棒性理论保证。
研究背景与动机
在真实部署强化学习系统时,智能体从环境中获取的观测数据往往并不完全可靠。传感器故障、网络传输错误、日志系统异常,甚至恶意攻击者,都可能导致奖励信号或状态转移被篡改。标准[[Q学习]]算法假设观测数据来自真实环境分布,一旦这些数据被污染,其Bellman最优算子的经验估计会产生严重偏倚,最终导致学到的策略远非最优甚至完全失效。
此前已有研究尝试在污染环境下为强化学习提供鲁棒保证,但这些工作存在明显的局限性。部分工作仅考虑奖励污染而忽略状态污染的场景,或要求数据来自同步采样(independent and identically distributed,i.i.d.)的平稳分布,这与异步Q学习实际运行的在线交互场景不符。更关键的是,已有的误差界中污染项对状态-动作对的最小访问概率呈反比放大关系,而理论上已知即使在无状态污染的情形下,误差下界也仅为,其中为奖励污染比例。这意味着现有方法的污染项依赖并非最优。
本文的切入点是:在异步采样环境下,如何同时处理奖励与状态观测的联合污染?核心挑战在于两种污染的数学性质截然不同——奖励污染直接影响[[Bellman最优算子]]的偏移量,而状态污染则通过扰动这一项间接影响算子输出。更棘手的是,真实环境中奖励分布可能具有重尾特性(如金融市场的极端收益、机器人碰撞产生的瞬时大损失),这使得区分“正常重尾噪声”与“对抗注入”变得极为困难。
方法
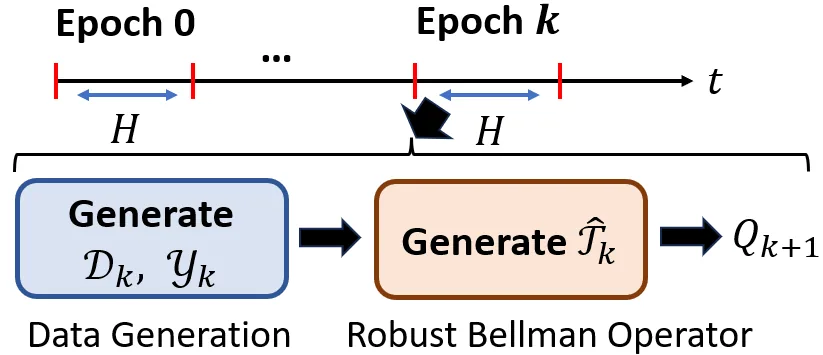
BR-Async-Q的核心思想可以概括为“先分批降方差,再鲁棒估计”。具体而言,算法将在线交互产生的数据流按时间顺序划分为若干个等长的epoch(记为个时间步为一个epoch),每个epoch结束后对所有对累积的样本进行一次Q表更新。这种分批策略带来了两方面好处:一是每个epoch内同一对的多个样本可以聚合后做统计估计,方差随样本数的平方根缩减;二是允许我们在获得足够数据后再构造[[Bellman最优算子]]的鲁棒版本,而不是在单步TD更新中直接面对污染风险。
对于奖励污染的处理,论文采用Lugosi-Mendelson截尾均值估计器(记为TRIM)。其基本思想是:在给定污染比例上界的条件下,剔除数据中比例最高的个样本后计算剩余样本的均值。形式上,给定数据集、污染率上界和置信参数,TRIM保证估计误差以高概率满足,其中为标准差估计、为样本量。值得注意的是,当奖励的取值边界已知时,可以使用更激进的截断均值估计器TRIM,其误差界中项可以改进为与成正比,从而在污染率极小时获得更紧的保证。
对于状态污染的鲁棒处理是本文最具创新性的部分。当状态转移被扰动时,下一状态可能被替换为任意值,进而会产生完全失控的偏差。为解决这个问题,BR-Async-Q采用了一种稳定化裁剪策略:首先利用已有的Q函数上界(其中为常数、为奖励方差上界)对项进行裁剪,将其限制在区间内;然后用TRIM对这个裁剪后的值序列计算鲁棒均值。这样即使部分样本的状态被严重污染,裁剪操作保证了每个样本对估计的贡献不会超过,从而将最坏情况下的偏差控制在有界范围内。
完整的[[Bellman最优算子]]鲁棒估计定义为:
其中和分别是通过截尾均值估计的奖励期望和状态转移后的价值均值,裁剪阈值根据污染比例和样本量自适应设置。最后,Q表的更新采用epoch-wise的[[批量学习]]方式:
其中的设置保证经过个epoch后累计更新量与成正比,从而确保收敛。
实验与结果
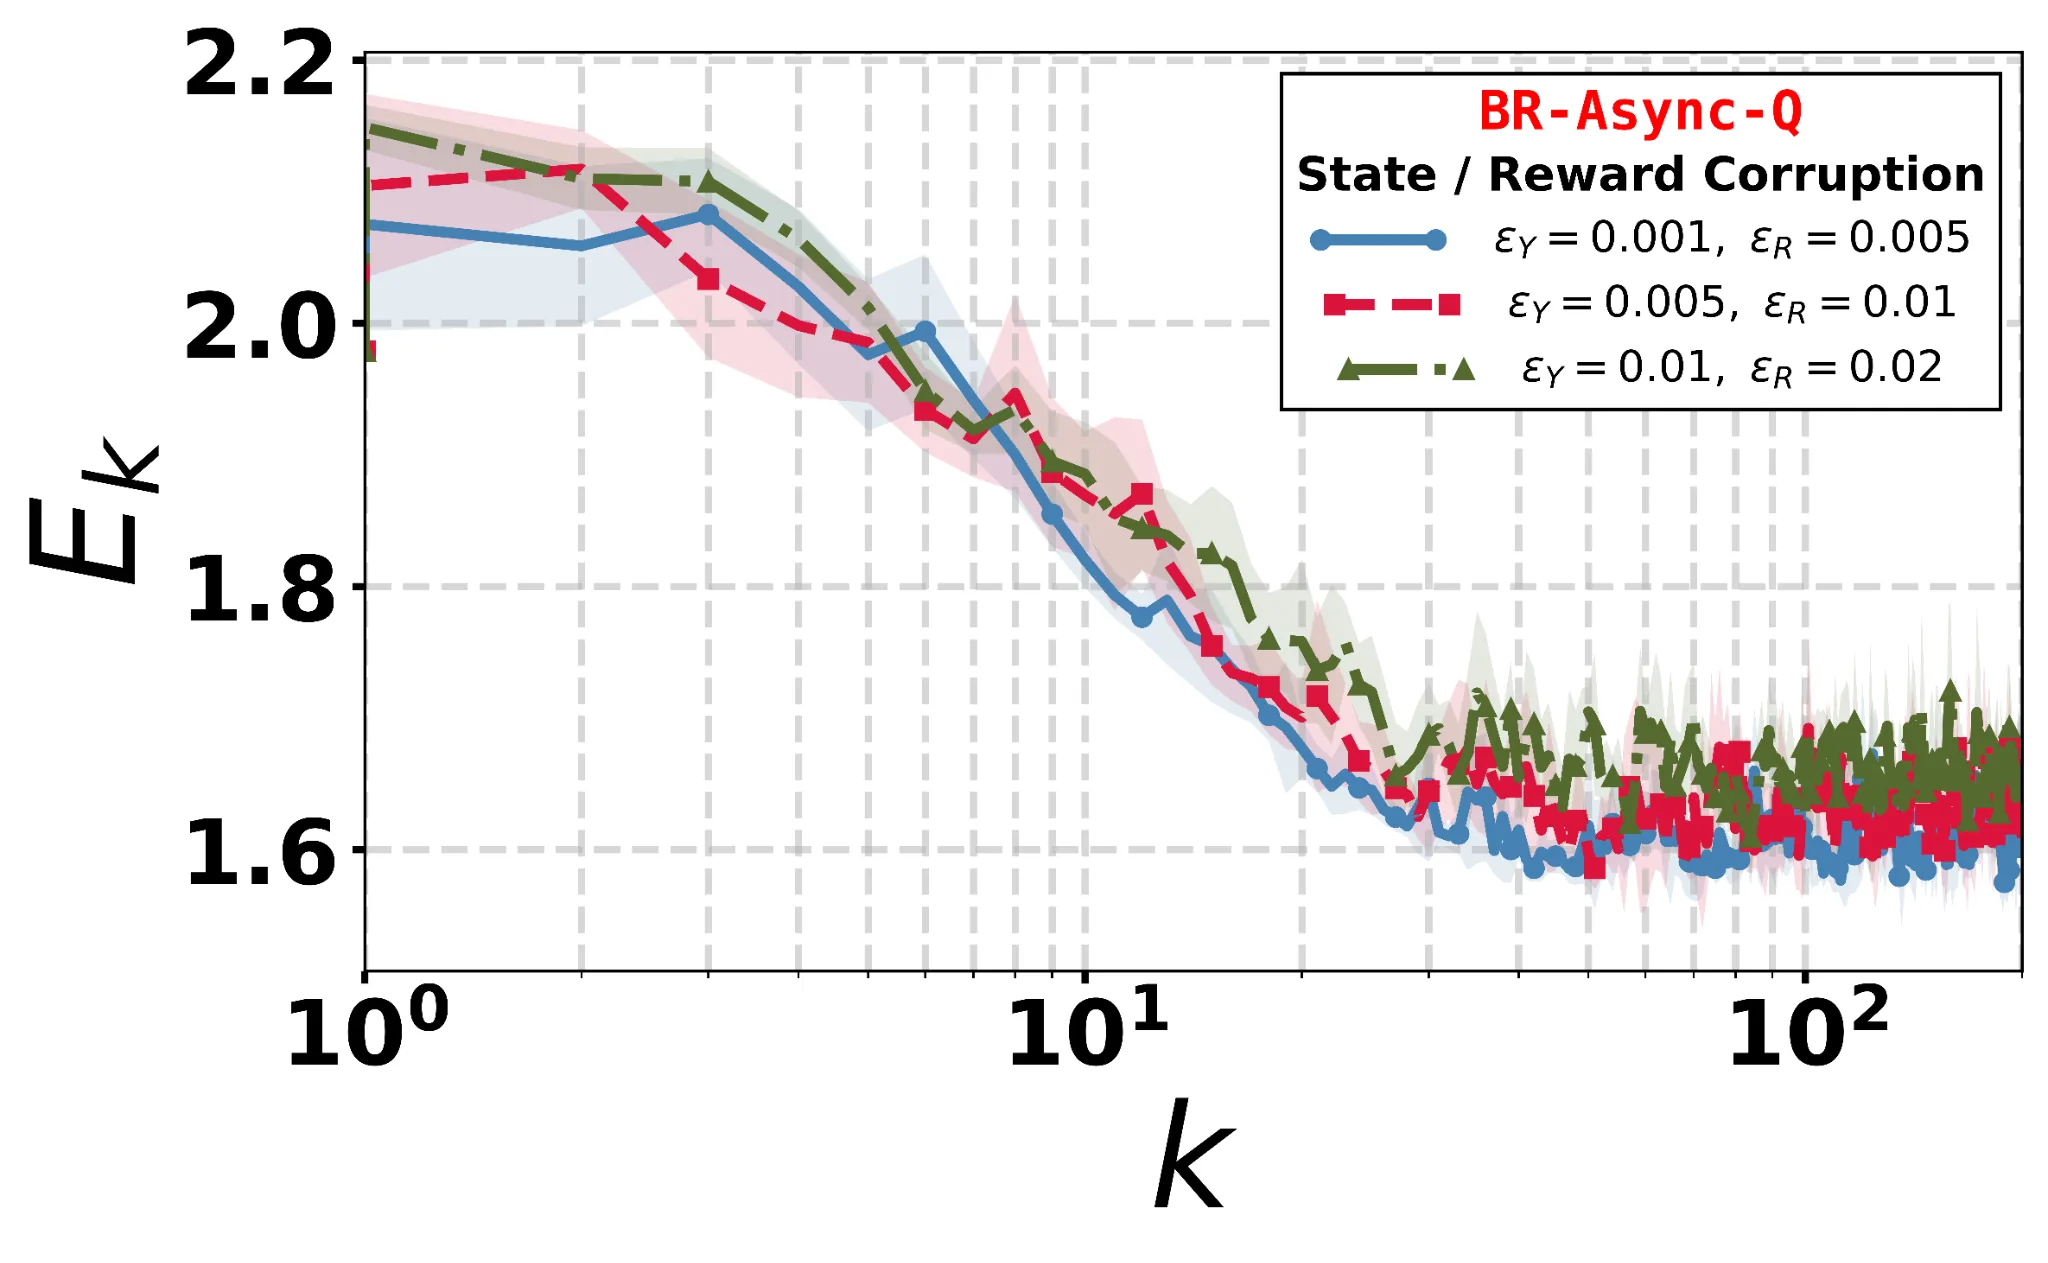
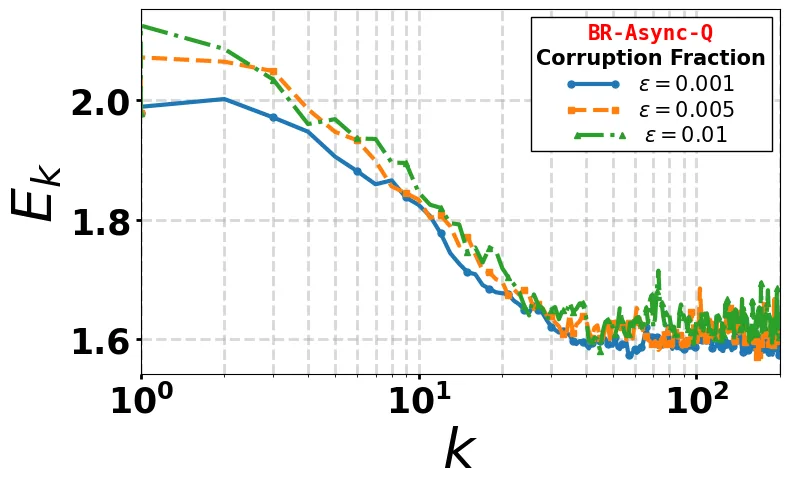
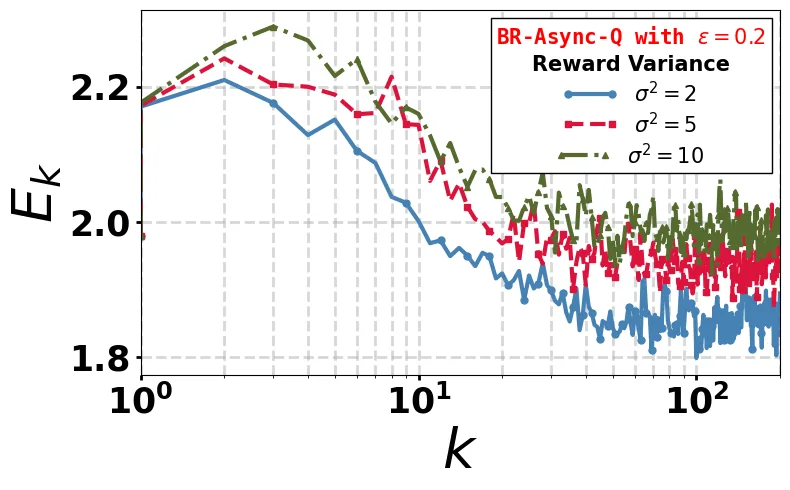
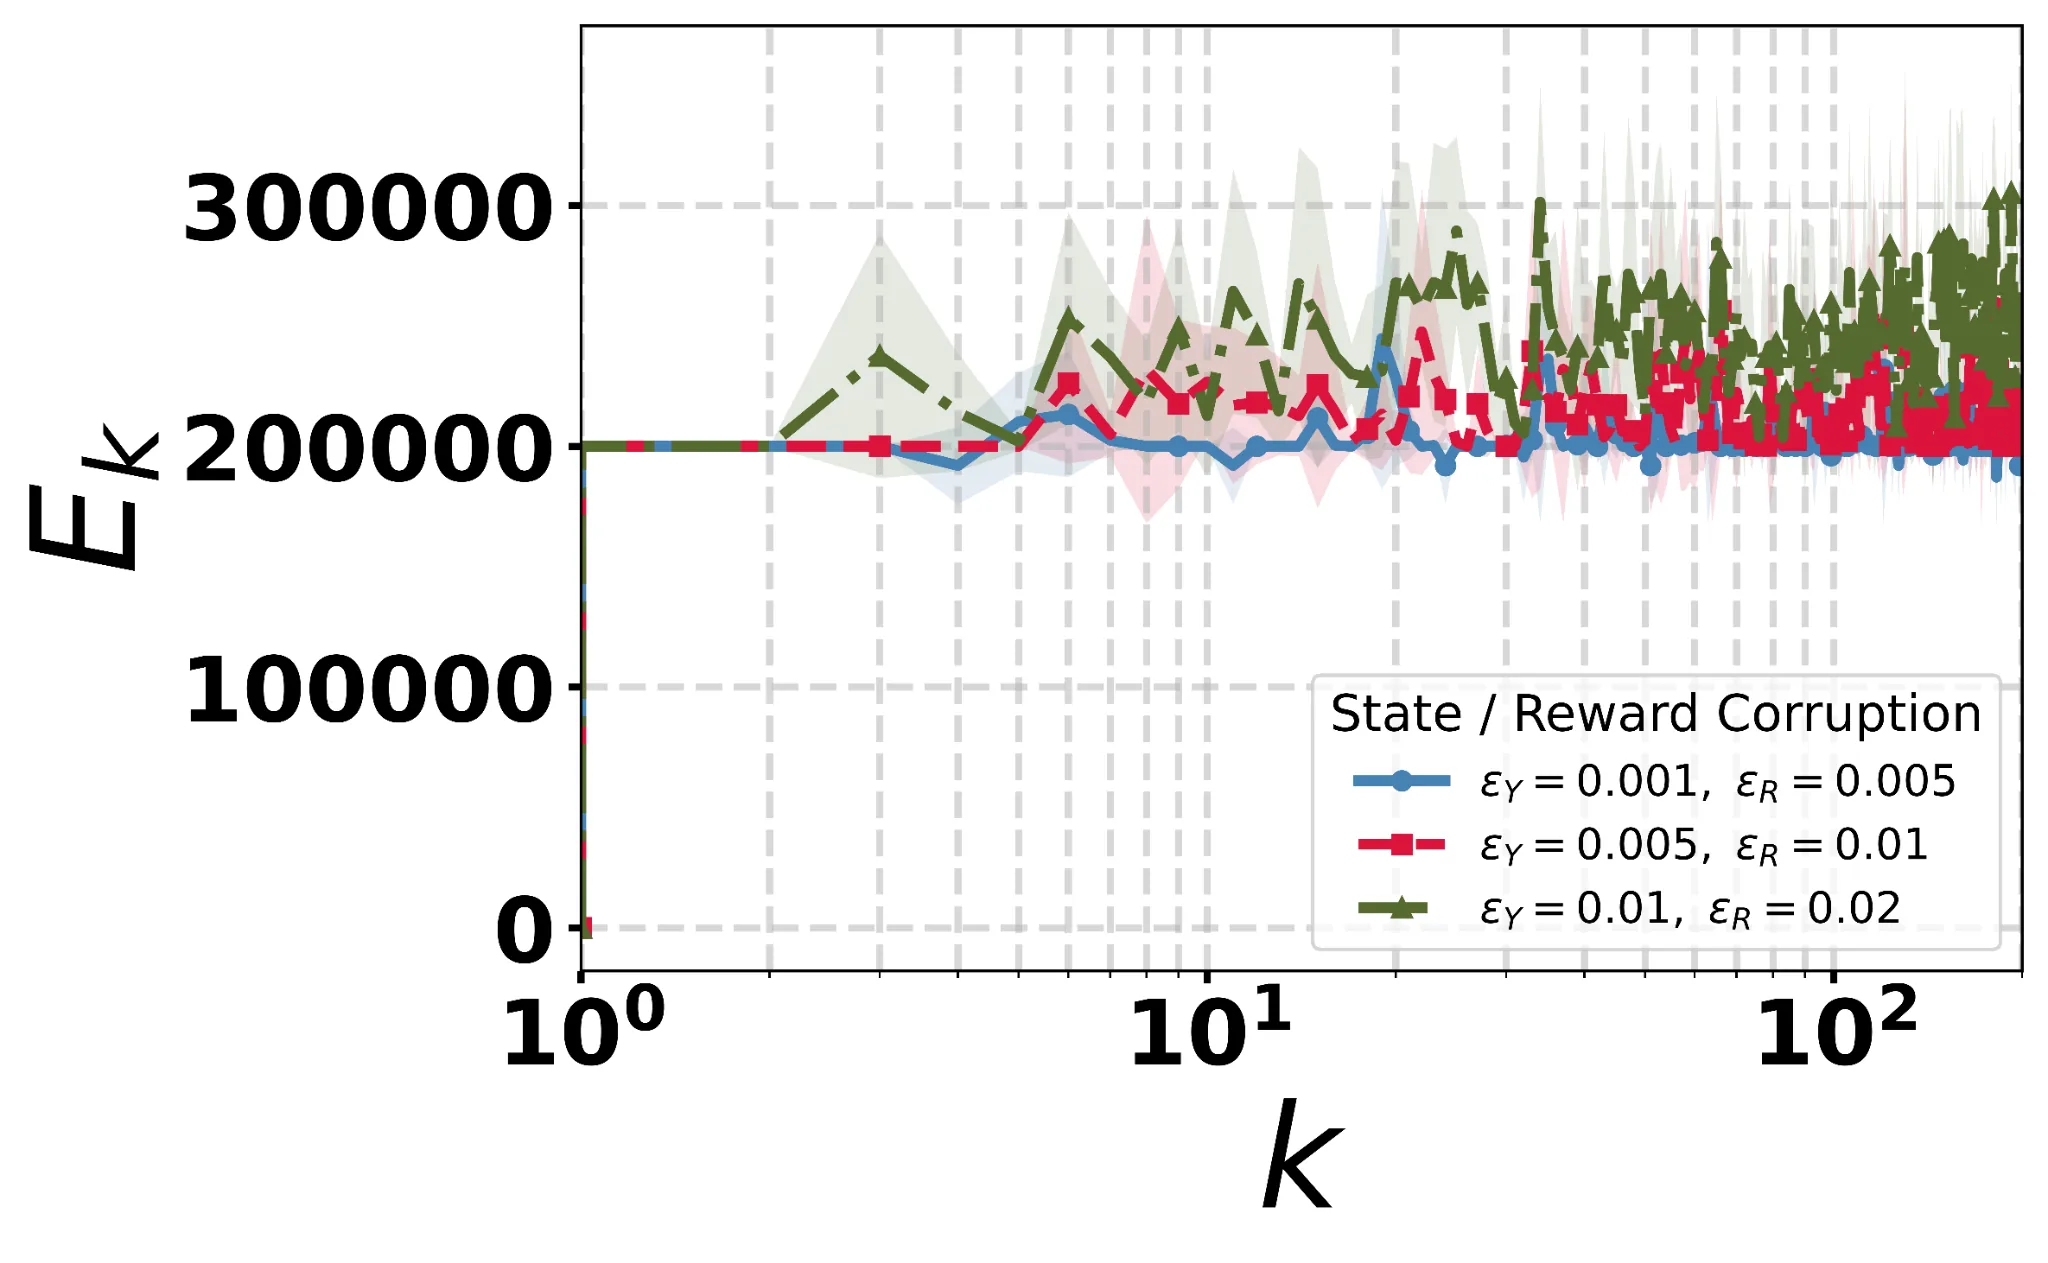
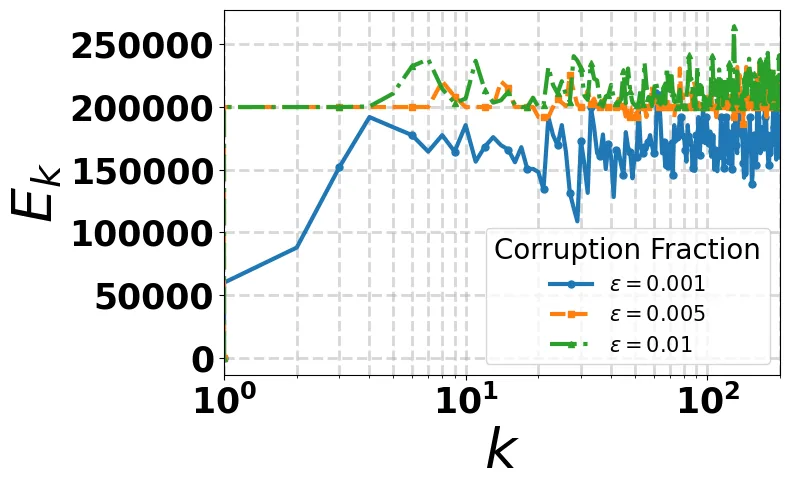
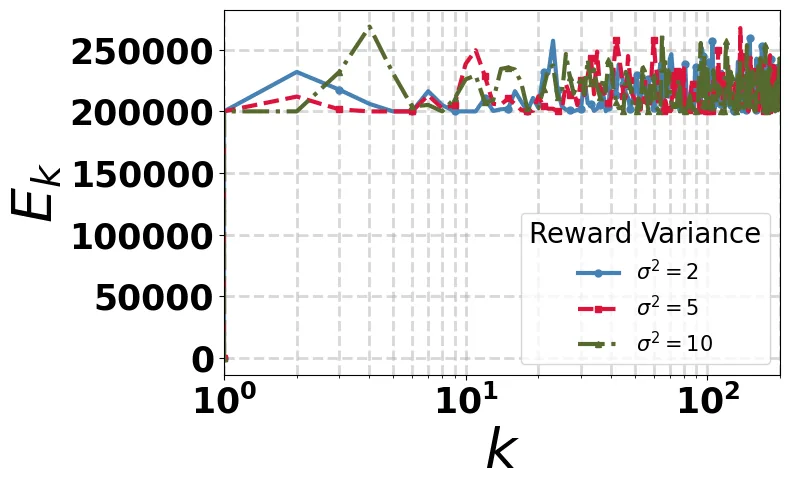
实验在经典的grid-world MDP上进行,包含100个状态和40个动作,折扣因子设为0.5。作者设置了多种污染场景来全面评估算法的鲁棒性:对称污染实验中奖励污染率与状态污染率相等,从0.001逐步提升到0.2;高污染实验中固定污染率为0.2但变化噪声方差;在非对称污染场景中则专门测试了奖励污染与状态污染比例不同时的算法表现。对抗性攻击的具体形式包括将奖励替换为或这样的极端负值,以及将下一状态从状态空间中均匀重采样。
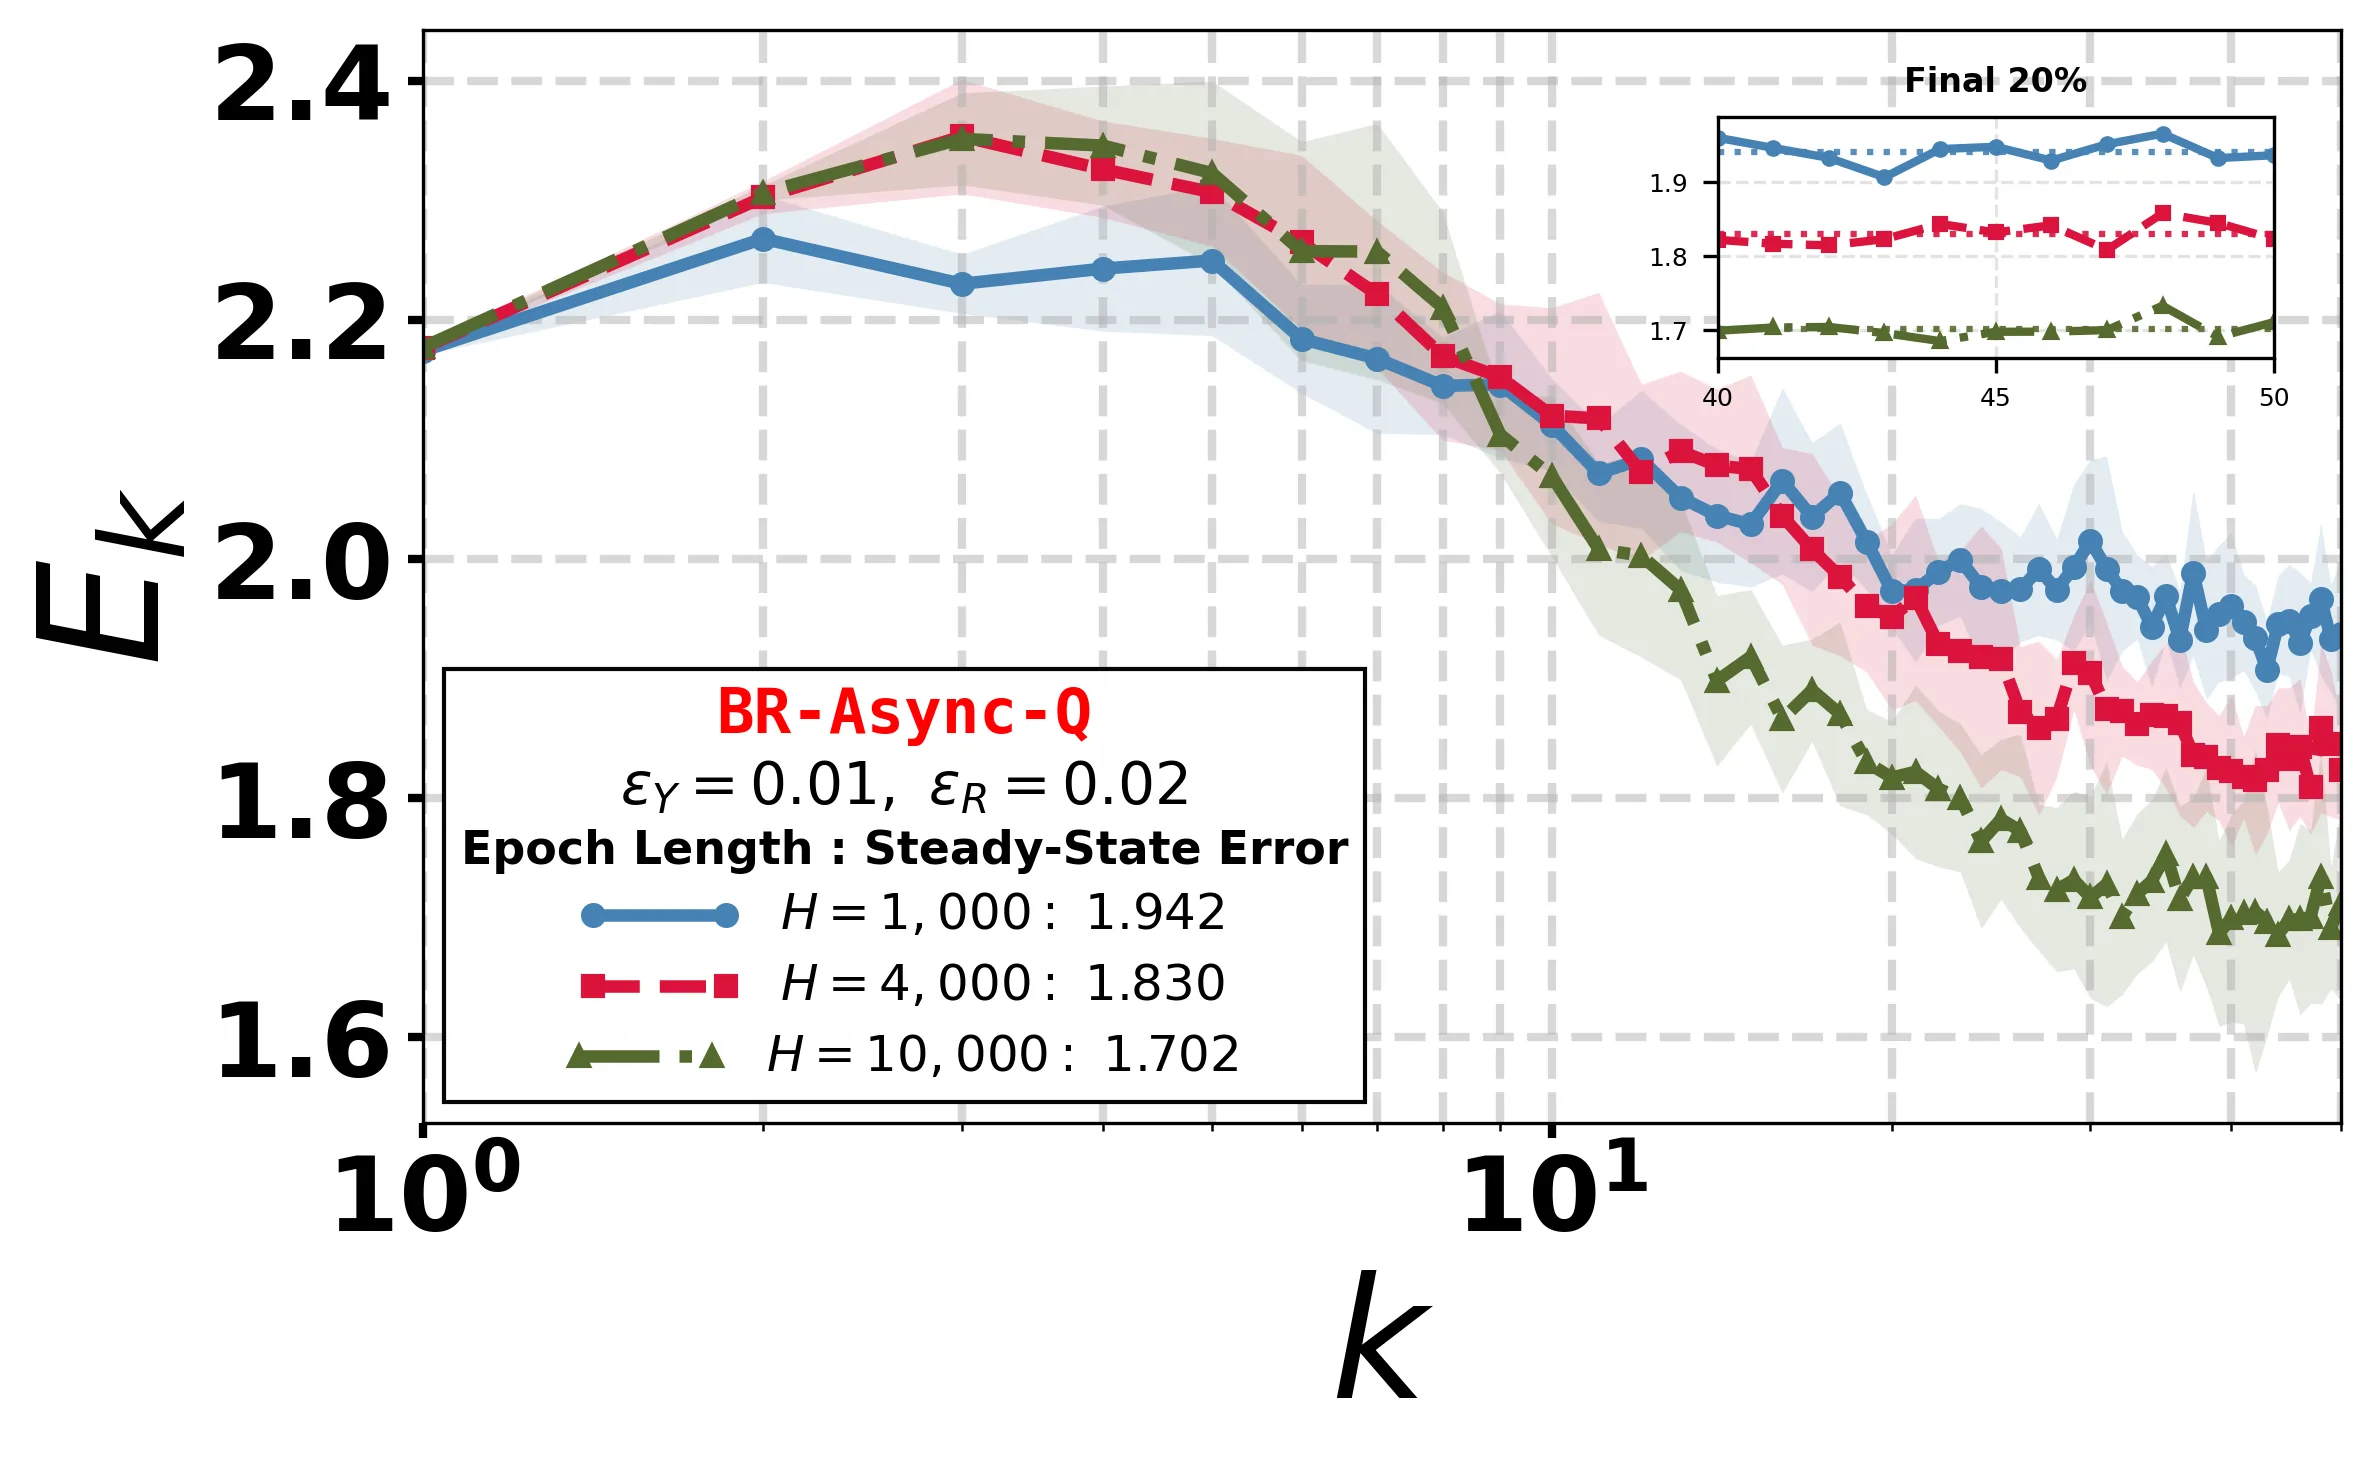
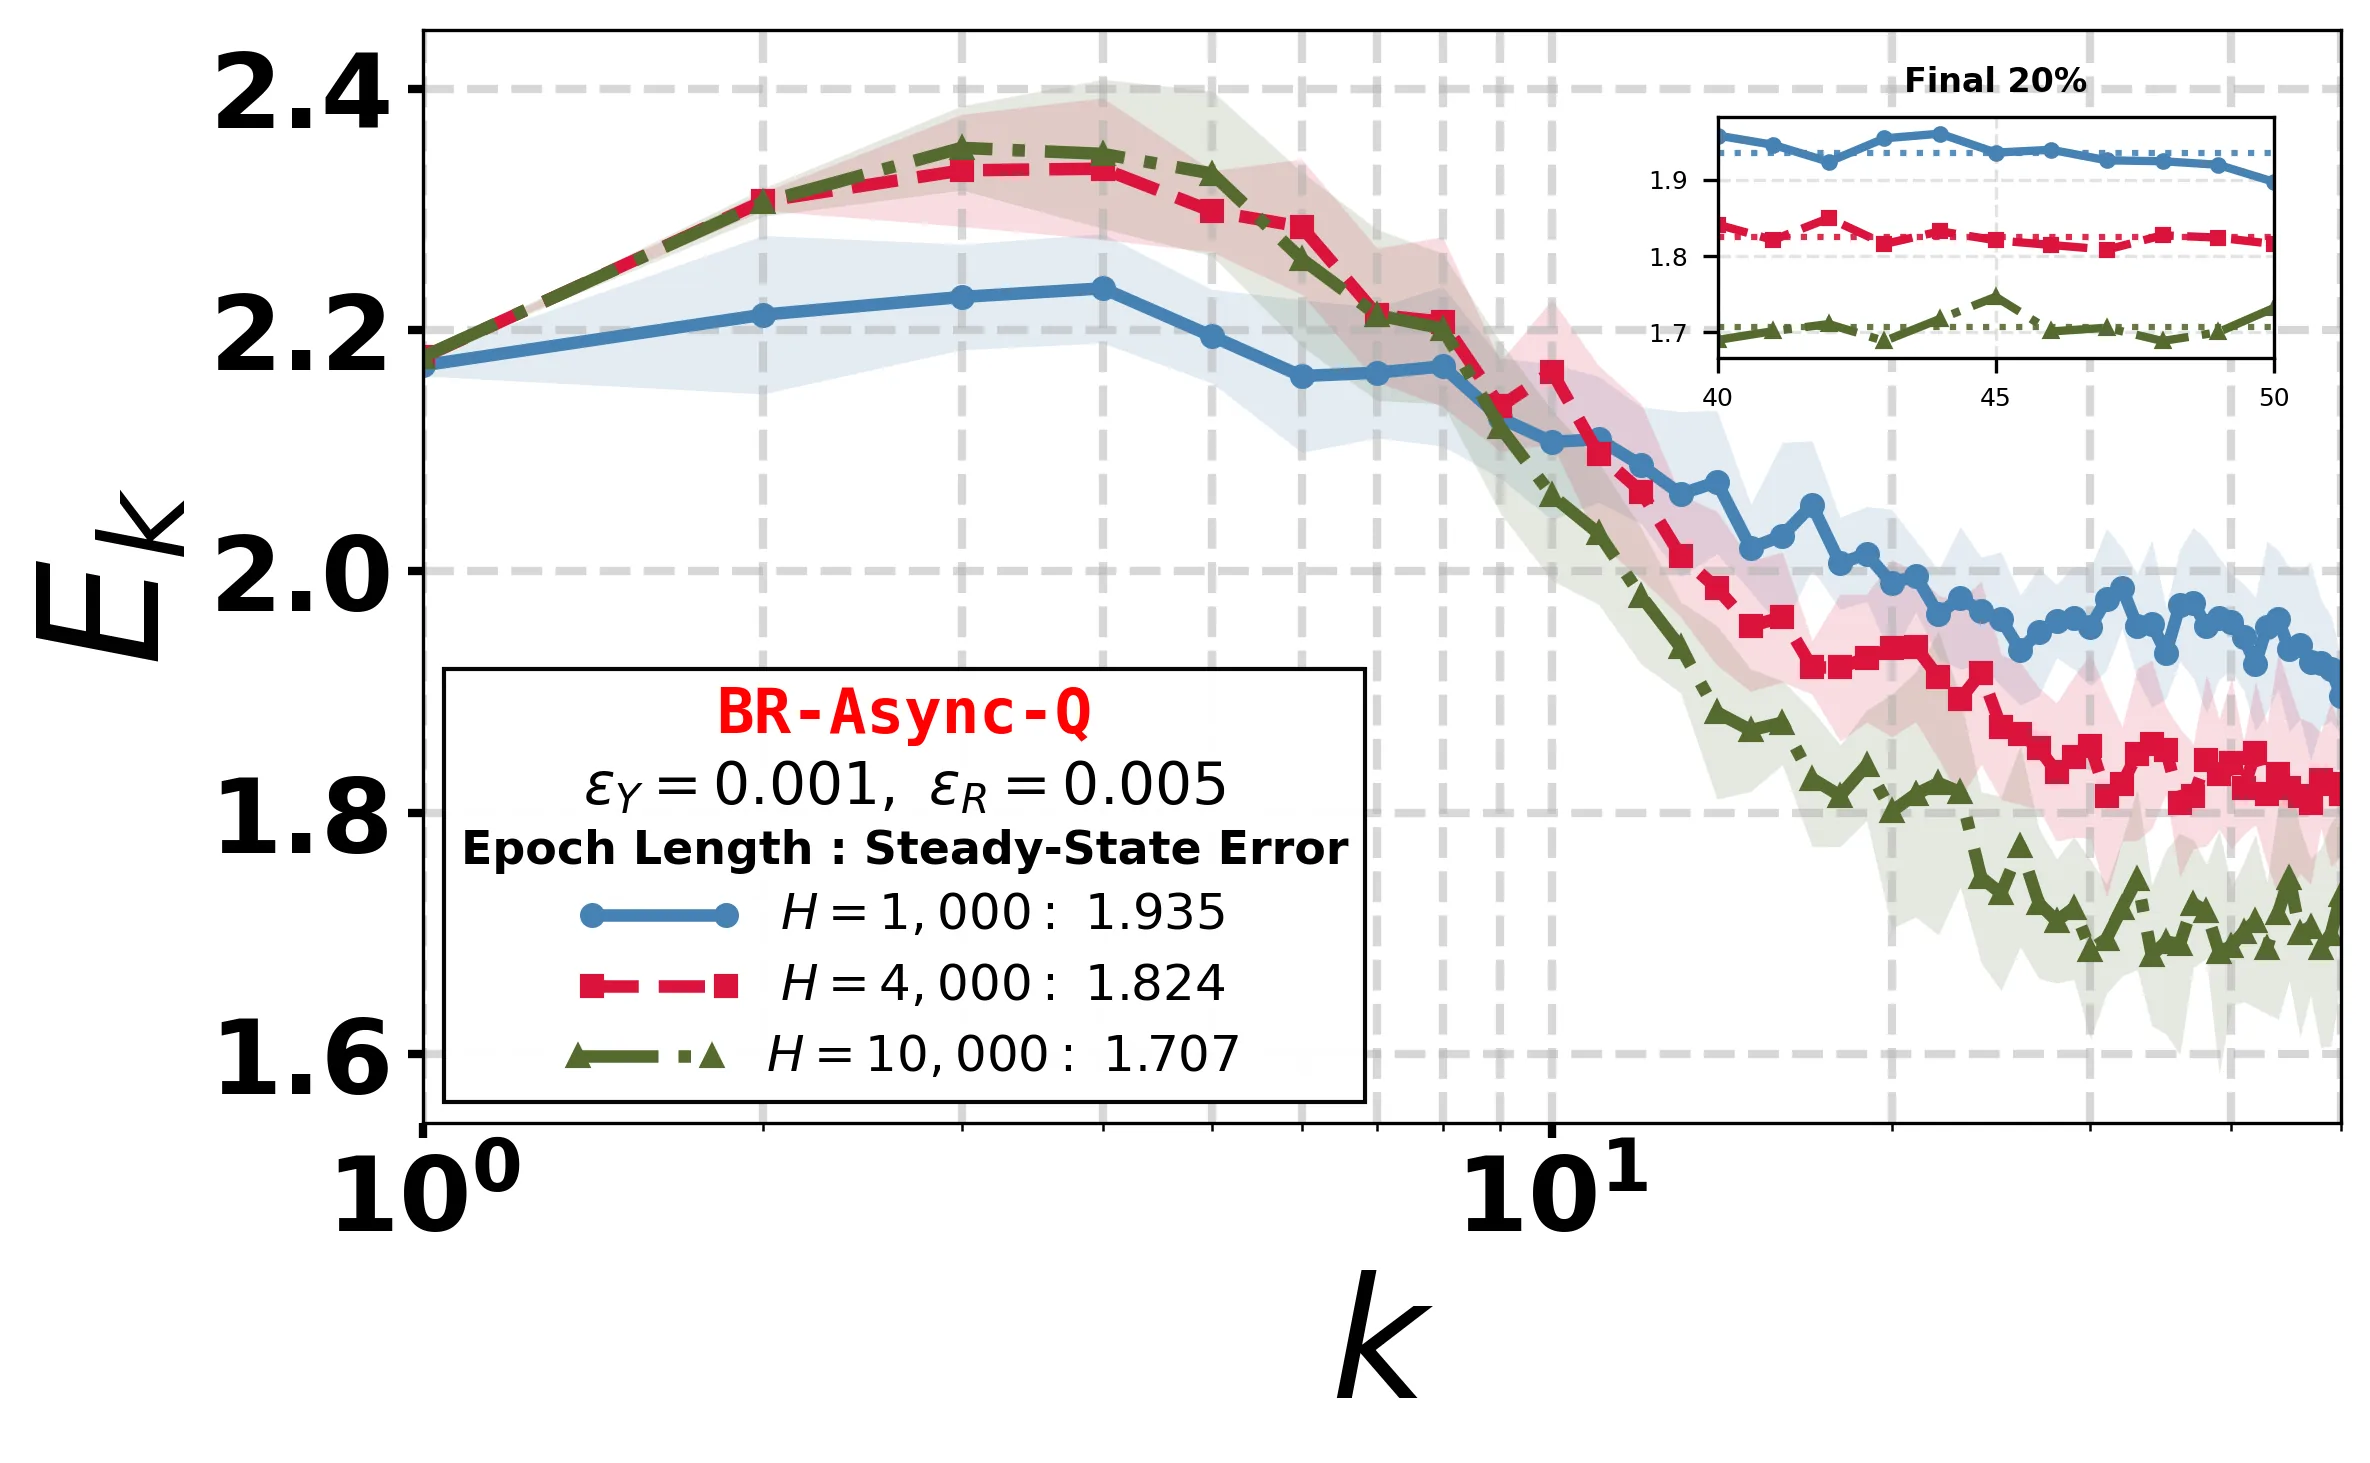
实验结果清晰地展示了BR-Async-Q的鲁棒优势。标准Q学习在强污染下误差持续攀升甚至无法收敛,而BR-Async-Q在所有污染强度下都能保持稳定向逼近。分批机制的功效也得到了验证——增大epoch长度(从1000到10000)能够有效降低估计方差,表现为更平滑的收敛曲线和更小的最终误差。特别值得注意的是,即使奖励分布本身具有重尾特性(仅假设二阶矩有界),TRIM估计器仍然能够正常工作,证明该方法对噪声特性具有较强的适应性。
论文还给出了一个重要的理论-实验对照发现:纯奖励污染时,误差界中的污染项与信息论下界精确匹配,说明在污染比例已知的前提下达成了[[minimax最优]]。但当状态污染存在时,污染项变为,对的线性依赖意味着高状态污染率下算法性能会有更明显的退化。
讨论与可借鉴点
BR-Async-Q的理论框架首次系统地解决了异步Q学习在联合奖励-状态污染下的鲁棒性问题,这一贡献填补了该领域的重要空白。分批策略与鲁棒估计的结合揭示了一个深刻的洞见:降低方差不仅是提升统计效率的手段,更是抵抗对抗性扰动的前置条件——当单样本估计的方差足够小时,异常值更容易被截尾机制识别和剔除。
然而这项工作也留有若干有待探索的方向。首先,算法显式依赖已知的污染比例和,在未知污染环境下如何自适应地发现污染边界仍是开放问题。其次,epoch长度的选择需要在存储开销与方差缩减之间权衡,论文中的下界要求,这在状态空间巨大或极小时可能不切实际。此外,当前分析局限于[[表格型强化学习]],向函数逼近(线性参数化或神经网络)的推广需要处理逼近误差与污染误差的耦合问题。最后,实验仅在单一grid-world环境验证,与已有鲁棒方法(如针对纯奖励污染的[[异步Q学习]]变体)的直接数值对比尚属空白。
对于从事鲁棒强化学习研究的研究者而言,本文的方法论提供了可迁移的思路:将在线数据流分批以创造“重置”机会,再在每个epoch边界使用统计鲁棒化工具处理累积的污染风险。这种设计模式或许可以推广到其他在线学习算法(如TD学习、策略梯度等),为构建更可靠的强化学习系统提供新的设计范式。
摘要
受恶劣环境下强化学习问题的驱动,我们考虑在对抗性污染反馈条件下学习最优策略的问题。具体而言,在每个时间步,攻击者可依据Huber污染模型同时扰动学习器所获得的奖励观测和状态观测。为抵御此类数据污染,我们提出了{\texttt{BR-Async-Q}}:一种新颖的、基于轮次(epoch-based)的鲁棒Q学习算法,该算法建立在两个关键思想之上:(i) 将在线数据流划分为多个批次以降低方差;(ii) 利用这些批数据构建Bellman最优算子的鲁棒估计。我们证明了{\texttt{BR-Async-Q}}的高概率误差界与普通(vanilla)Q学习的误差界相匹配,仅多出一个与污染样本比例相关的加性小项。据我们所知,这是首个针对同时存在奖励污染与状态污染的异步Q学习的鲁棒性保证。此外,当仅有奖励被污染时,我们算法误差界对污染比例的依赖在最小最大(minimax)意义下是最优的。
Abstract
Motivated by reinforcement learning in harsh environments, we consider the problem of learning an optimal policy subject to adversarially corrupted feedback. Specifically, at each time-step, an adversary can perturb both the reward and state observations of the learner following the Huber contamination model. To defend against such data corruption, we propose {\texttt{BR-Async-Q}}: a novel, epoch-based, robust \(Q\)-learning algorithm built upon two key ideas: (i) partitioning the online data stream into batches to reduce variance, and (ii) constructing robust estimates of the Bellman optimality operator using such batched data. We prove a high-probability error bound for {\texttt{BR-Async-Q}} that matches that for vanilla \(Q\)-learning, up to a small additive term that scales with the fraction of corrupted samples. To our knowledge, this provides the first robustness guarantee for asynchronous \(Q\)-learning subject to both reward and state corruption. Furthermore, when only rewards are corrupted, the dependence of our algorithm's bound on the corruption fraction is minimax optimal.
论文详细总结(自动生成)
论文总结:基于批处理的鲁棒异步Q学习(抗奖励与状态污染)
1. 核心问题与研究动机
- 研究场景:折扣无限时序强化学习(RL)中的在线决策问题,智能体通过行为策略与环境交互,学习最优状态-动作价值函数 。
- 关键痛点:在真实部署中,奖励与下一状态观测可能遭受对抗性扰动(如传感误差、日志失败或恶意投毒),而标准 Q-learning 缺乏对二者同时污染的鲁棒性保证。
- 理论空白:
- 既有工作 仅考虑奖励污染或同步采样情形,且其误差界中污染项随最小访问概率 反比放大,与已知的 信息论下界 存在差距。
- 在异步采样下,如何同时处理奖励污染与状态污染此前完全未被研究。
- 额外挑战:本文允许奖励分布具有重尾特性(仅要求二阶矩存在),进一步增加了区分"正常重尾噪声"与"对抗注入"的难度。
2. 方法论
2.1 总体思路
提出 BR-Async-Q(Batch Robust Asynchronous Q-Learning):将在线数据流划分为多个 epoch(批),在每个 epoch 内累积足够样本后,采用鲁棒均值估计器构造 Bellman 最优算子 的鲁棒估计 ,最后以低方差方向进行一次 Q 表更新。
2.2 污染模型
Huber 模型:
其中 、,、 可为任意对抗注入。
2.3 关键模块
- 鲁棒均值估计器(Algorithm 1:TRIM / TRIM)
- TRIM(Lugosi–Mendelson 截尾均值):误差界为 ;
- TRIM(已知边界 的截断均值):误差界为 ,将 改进为 。
- 在线分批与鲁棒 Bellman 算子估计
每个 epoch 内为每对 维护两个数据集:
然后计算:
- 稳定化裁剪与更新
其中 , 保证 (Lemma 1)。
2.4 主要理论结果
设 ,epoch 长度满足
则 BR-Async-Q 以至少 的概率满足:
- 统计项相对 Qu [9] 在 依赖上从 改进为 。
- 当 时,偏置项 与信息论下界精确匹配。
3. 实验设计
- 环境:经典 grid-world MDP, 个状态、 个动作、折扣因子 ,奖励均值上界 ,奖励方差上界 。
- 污染设置:
- 对称污染 ,取值 ;
- 高污染 ,比较不同噪声方差 ;
- 非对称污染 。
- 攻击类型:奖励污染样本被替换为 (强偏置攻击)或 ;状态污染样本从 上均匀重采样。
- Benchmark 对比:以 Vanilla Q-learning(无任何鲁棒机制)作为基线。
- 度量: 误差 随 epoch 的演化曲线。
4. 资源与算力
- 论文中未报告任何 GPU 型号、CPU 资源、训练时长或总计算开销等硬件信息。
- 实验规模(100 状态 × 40 动作 × 每曲线 50–100 次独立运行 × 多种污染设置)属于轻量级表格实验,推测在普通 CPU 工作站即可完成,但具体环境未披露。
5. 实验数量与充分性
- 实验组数:
- 4 张主图(Fig. 2–4),每张包含 2–3 个子面板,分别扫描污染比例、噪声方差以及 epoch 长度 ;
- 每条曲线平均 50–100 次独立运行,并给出标准差阴影带。
- 覆盖性:
- ✅ 涵盖对称/非对称污染、低/高污染、纯奖励污染与联合污染等多种情形;
- ✅ 对 epoch 长度的敏感性进行了消融;
- ❌ 仅一个 grid-world 环境,未在更大规模 MDP(如 Atari)或不同结构(如随机奖励、多模态奖励)上验证泛化性;
- ❌ 仅与 Vanilla Q-learning 对比,缺少与 中的 Robust Async-Q 等已有鲁棒基线的直接数值比较(文献中仅给出理论层面的对比说明)。
- 客观性:曲线均含 1 倍标准差阴影带,结果具有可重复性;但缺少统计显著性检验或具体数值表。
6. 主要结论与发现
- 在 Huber 联合污染模型下,BR-Async-Q 仍能收敛到 的一个邻域内,邻域半径由 与 主导。
- 即使奖励分布重尾(仅二阶矩有界),算法依然稳健。
- 方差缩减(分批 + 同步更新)消除了先前上界中污染项对 的不利依赖,从而在纯奖励污染情形下达到 minimax 最优。
- 实验上:Vanilla Q-learning 在污染下误差持续偏高甚至发散,而 BR-Async-Q 在所有污染强度下均保持稳定收敛;增大 epoch 长度 可进一步降低误差方差。
7. 优点
- 理论贡献扎实:首次给出异步 Q-learning 在联合奖励+状态污染下的高概率 有限时间界,且在纯奖励情形达到 minimax 最优。
- 算法简洁新颖:仅通过分批+鲁棒截尾+裁剪三项机制即可获得紧致界,无需重投影、镜像下降等复杂工具。
- 方差缩减带来的副作用:统计项对 的依赖从 提升到 ,即便在无污染场景下也具吸引力。
- 支持重尾奖励:放宽了此前工作对次高斯或确定性奖励的假设。
- 实证可信:多次独立重复 + 标准差阴影,攻击强度梯度设置合理。
8. 不足与局限
- 污染概率已知:算法与理论分析均显式依赖已知的 ,未给出未知污染比例下的自适应估计。
- 样本开销较高:epoch 长度 需 才能保证每对 至少被访问 次,导致存储 的内存随 线性增长,作者在结论中也明确指出该限制。
- 仅限表格(tabular):尚未推广到函数逼近(如线性或神经网络),距离实际大规模应用尚有距离。
- 实验场景单一:仅 grid-world,缺少更复杂 MDP(如随机奖励、多目标、稀疏奖励)以及与同类鲁棒 Q-learning 算法 的 head-to-head 比较。
- 理论假设:仍要求行为策略遍历性 ,并采用独立采样模型(i.i.d. from ),虽然文献中可用分块论证扩展到马尔可夫链情形,但这一过程会带来额外的对数因子与常数开销。
- 缺少消融实验:未单独验证"分批大小 "、"裁剪阈值 "、"TRIM vs TRIM 选用"等组件的边际贡献。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。