
📝 TLDR
强化学习依赖固定折扣因子施加单一指数衰减的时间视野,难以灵活权衡短期与长期收益,且在奖励结构变化时性能下降。受生物体时间贴现机制启发,本文提出自适应多视野方法,动态选择并组合多个时间折扣因子,免去人工调参。在MiniGrid基准及含三个连续切换任务的持续学习场景中验证,可自动识别有效折扣因子组合,显著提升参数效率与跨任务适应性。
🧭 速览
传统强化学习依赖单一固定折扣因子,无法灵活应对复杂环境中短期与长期收益权衡,也不适应奖励结构的动态变化。
提出多视野自适应方法,动态选择并组合多个时间折扣因子,实现无需手工调参的灵活时间贴现策略。
在MiniGrid环境及三任务连续切换的持续学习场景中,能自动识别出有效的折扣因子组合方案。
表明自适应时间贴现可提升参数效率与跨任务适应性,为类生物学习系统设计提供新思路。
🆚 方法对比
Multi-Horizon Adaptive RL(本文提出的多时间视野自适应方法)
- 无需手动调节折扣因子
- 自适应选择并组合多个时间尺度
- 在任务切换和环境变化中具鲁棒适应性
- 提升参数效率与适应性
- 需额外学习horizon选择机制,计算更复杂
- 多个horizon增加超参数搜索空间
- source: abstract only,实验范围限于MiniGrid环境
Fixed Discount Factor RL(固定折扣因子基线方法)
- 实现简单,计算开销低
- 理论成熟,广泛应用于现有RL算法
- 单一指数折扣时间视野受限
- 需手动调参,缺乏自适应能力
- 在continual learning场景中适应性差
Biological Adaptive Temporal Discounting(生物自适应时间折扣,灵感来源)
- 灵活且自适应的多时间尺度折扣机制
- 为多horizon设计提供生物学合理性依据
- 难以直接形式化并映射到RL算法
- source: abstract only,论文未给出完整生物机制模型
本文提出的Multi-Horizon Adaptive RL通过自适应选择与组合多个时间尺度,克服了传统固定折扣因子方法在continual learning和任务切换场景中适应性不足的问题,但代价是更高的计算复杂度与超参数空间。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 42 张)
展开查看 42 张图
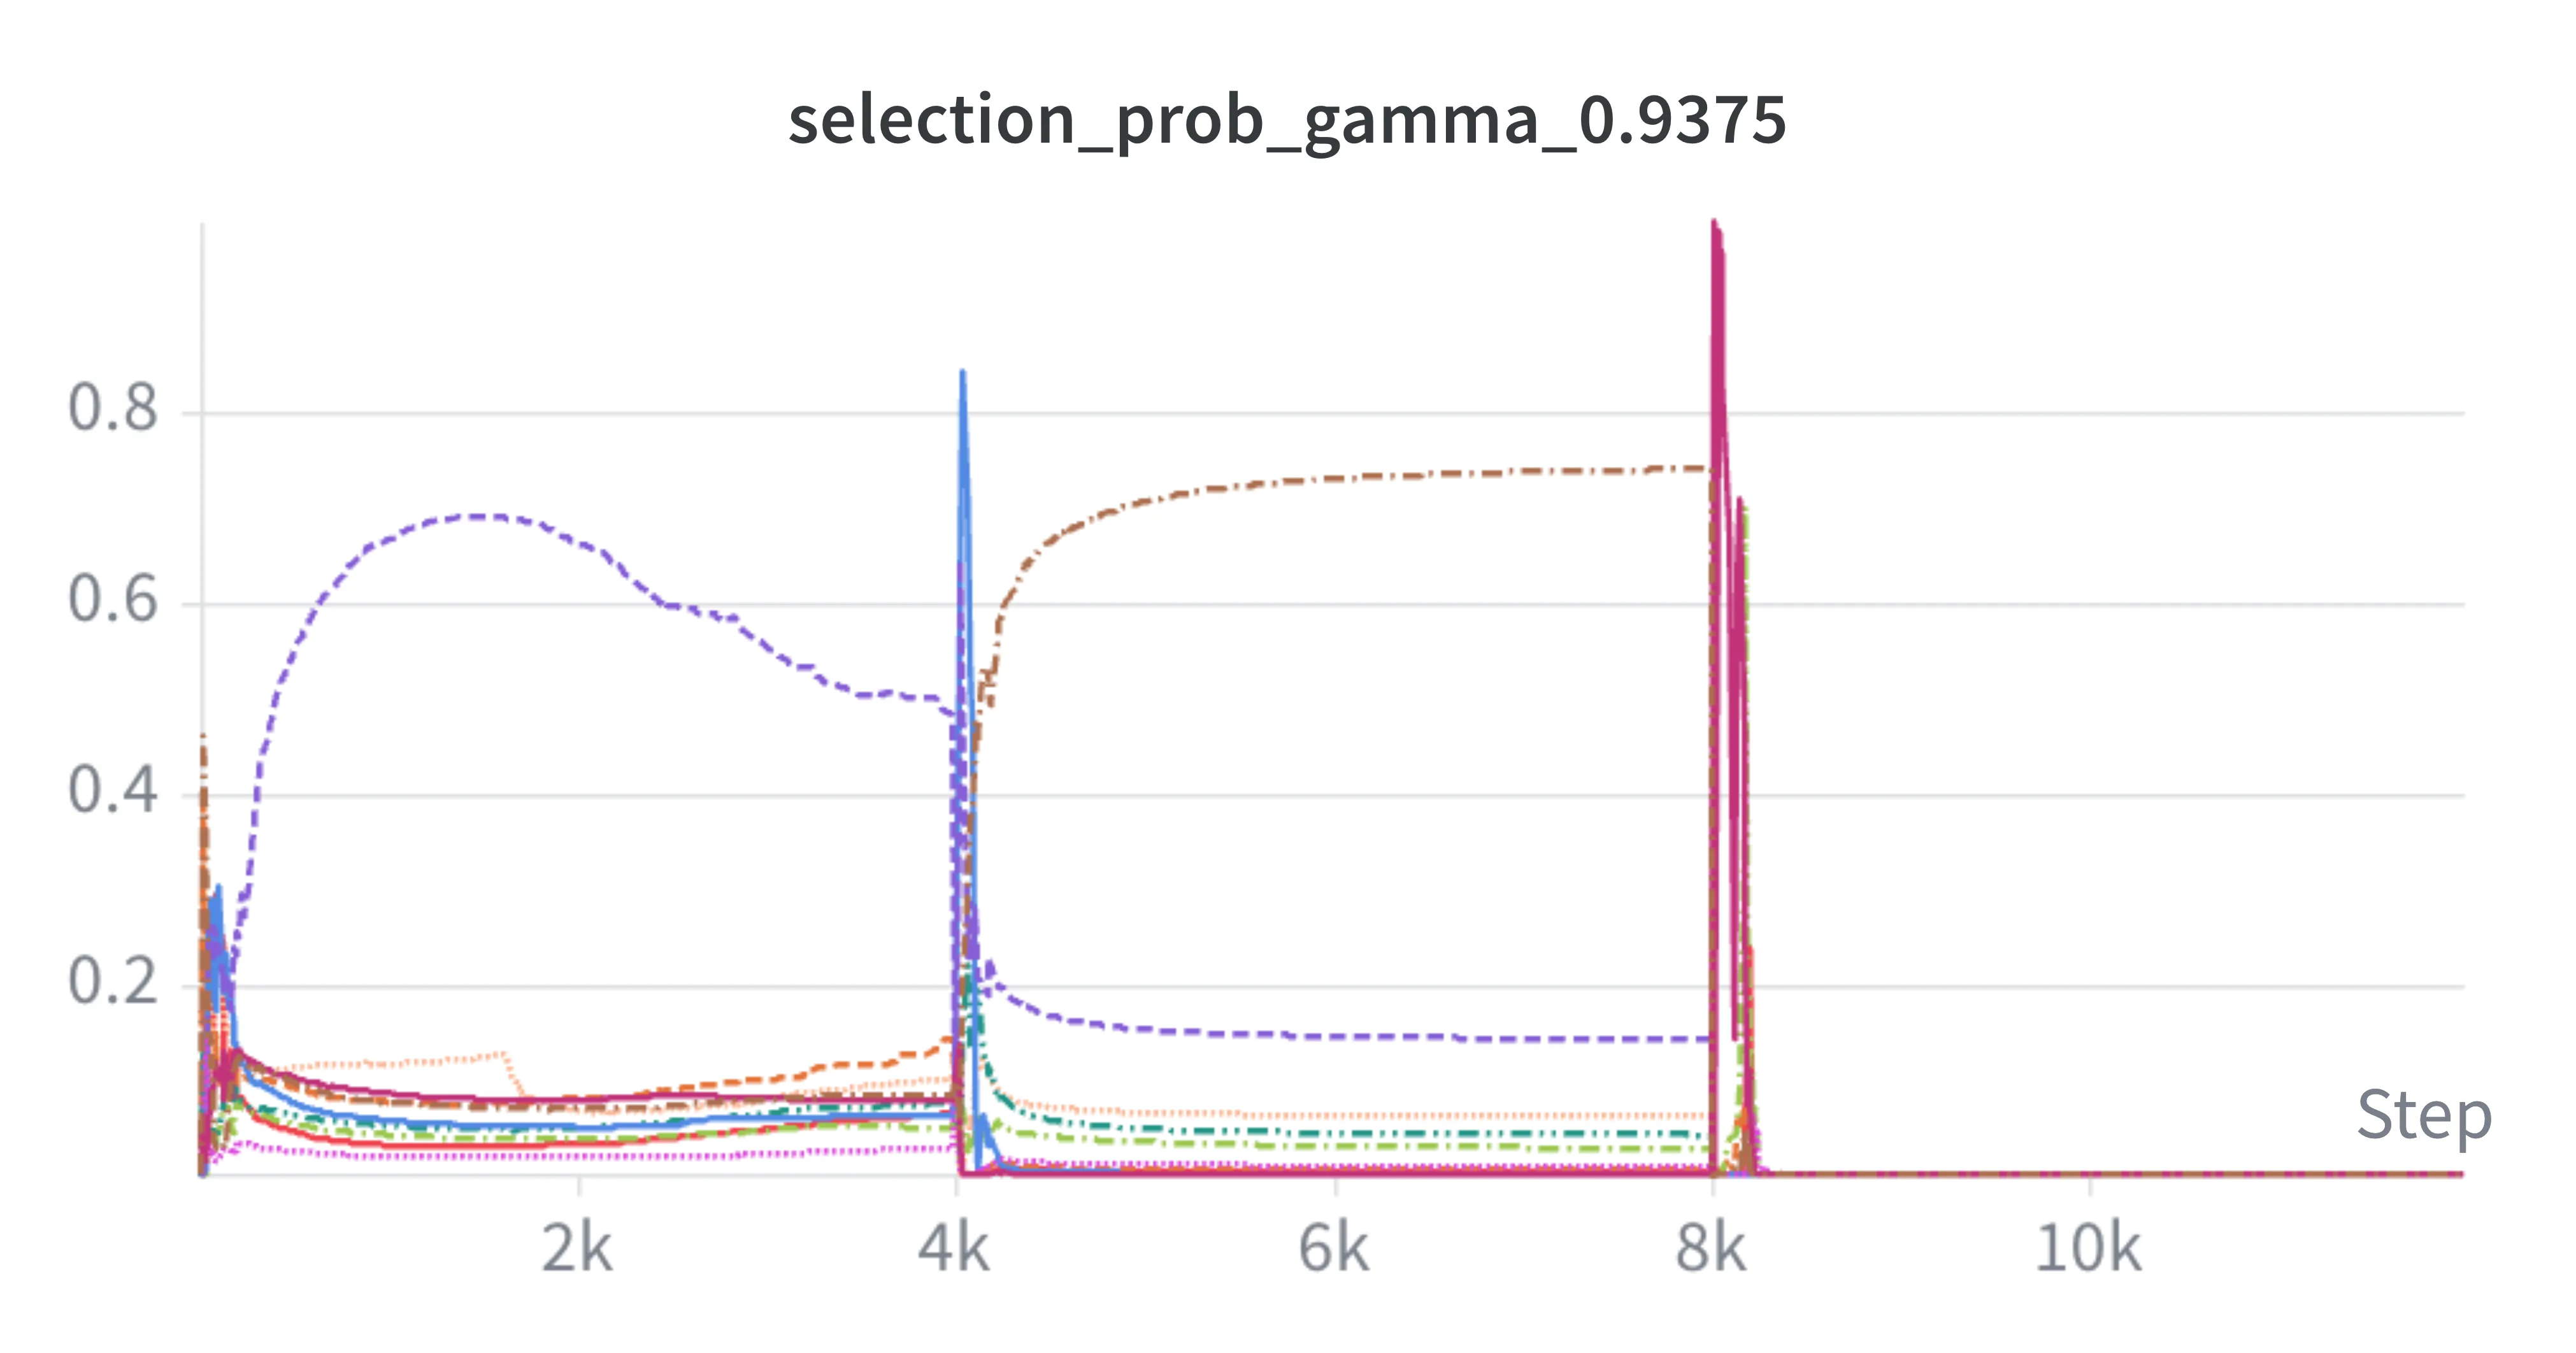
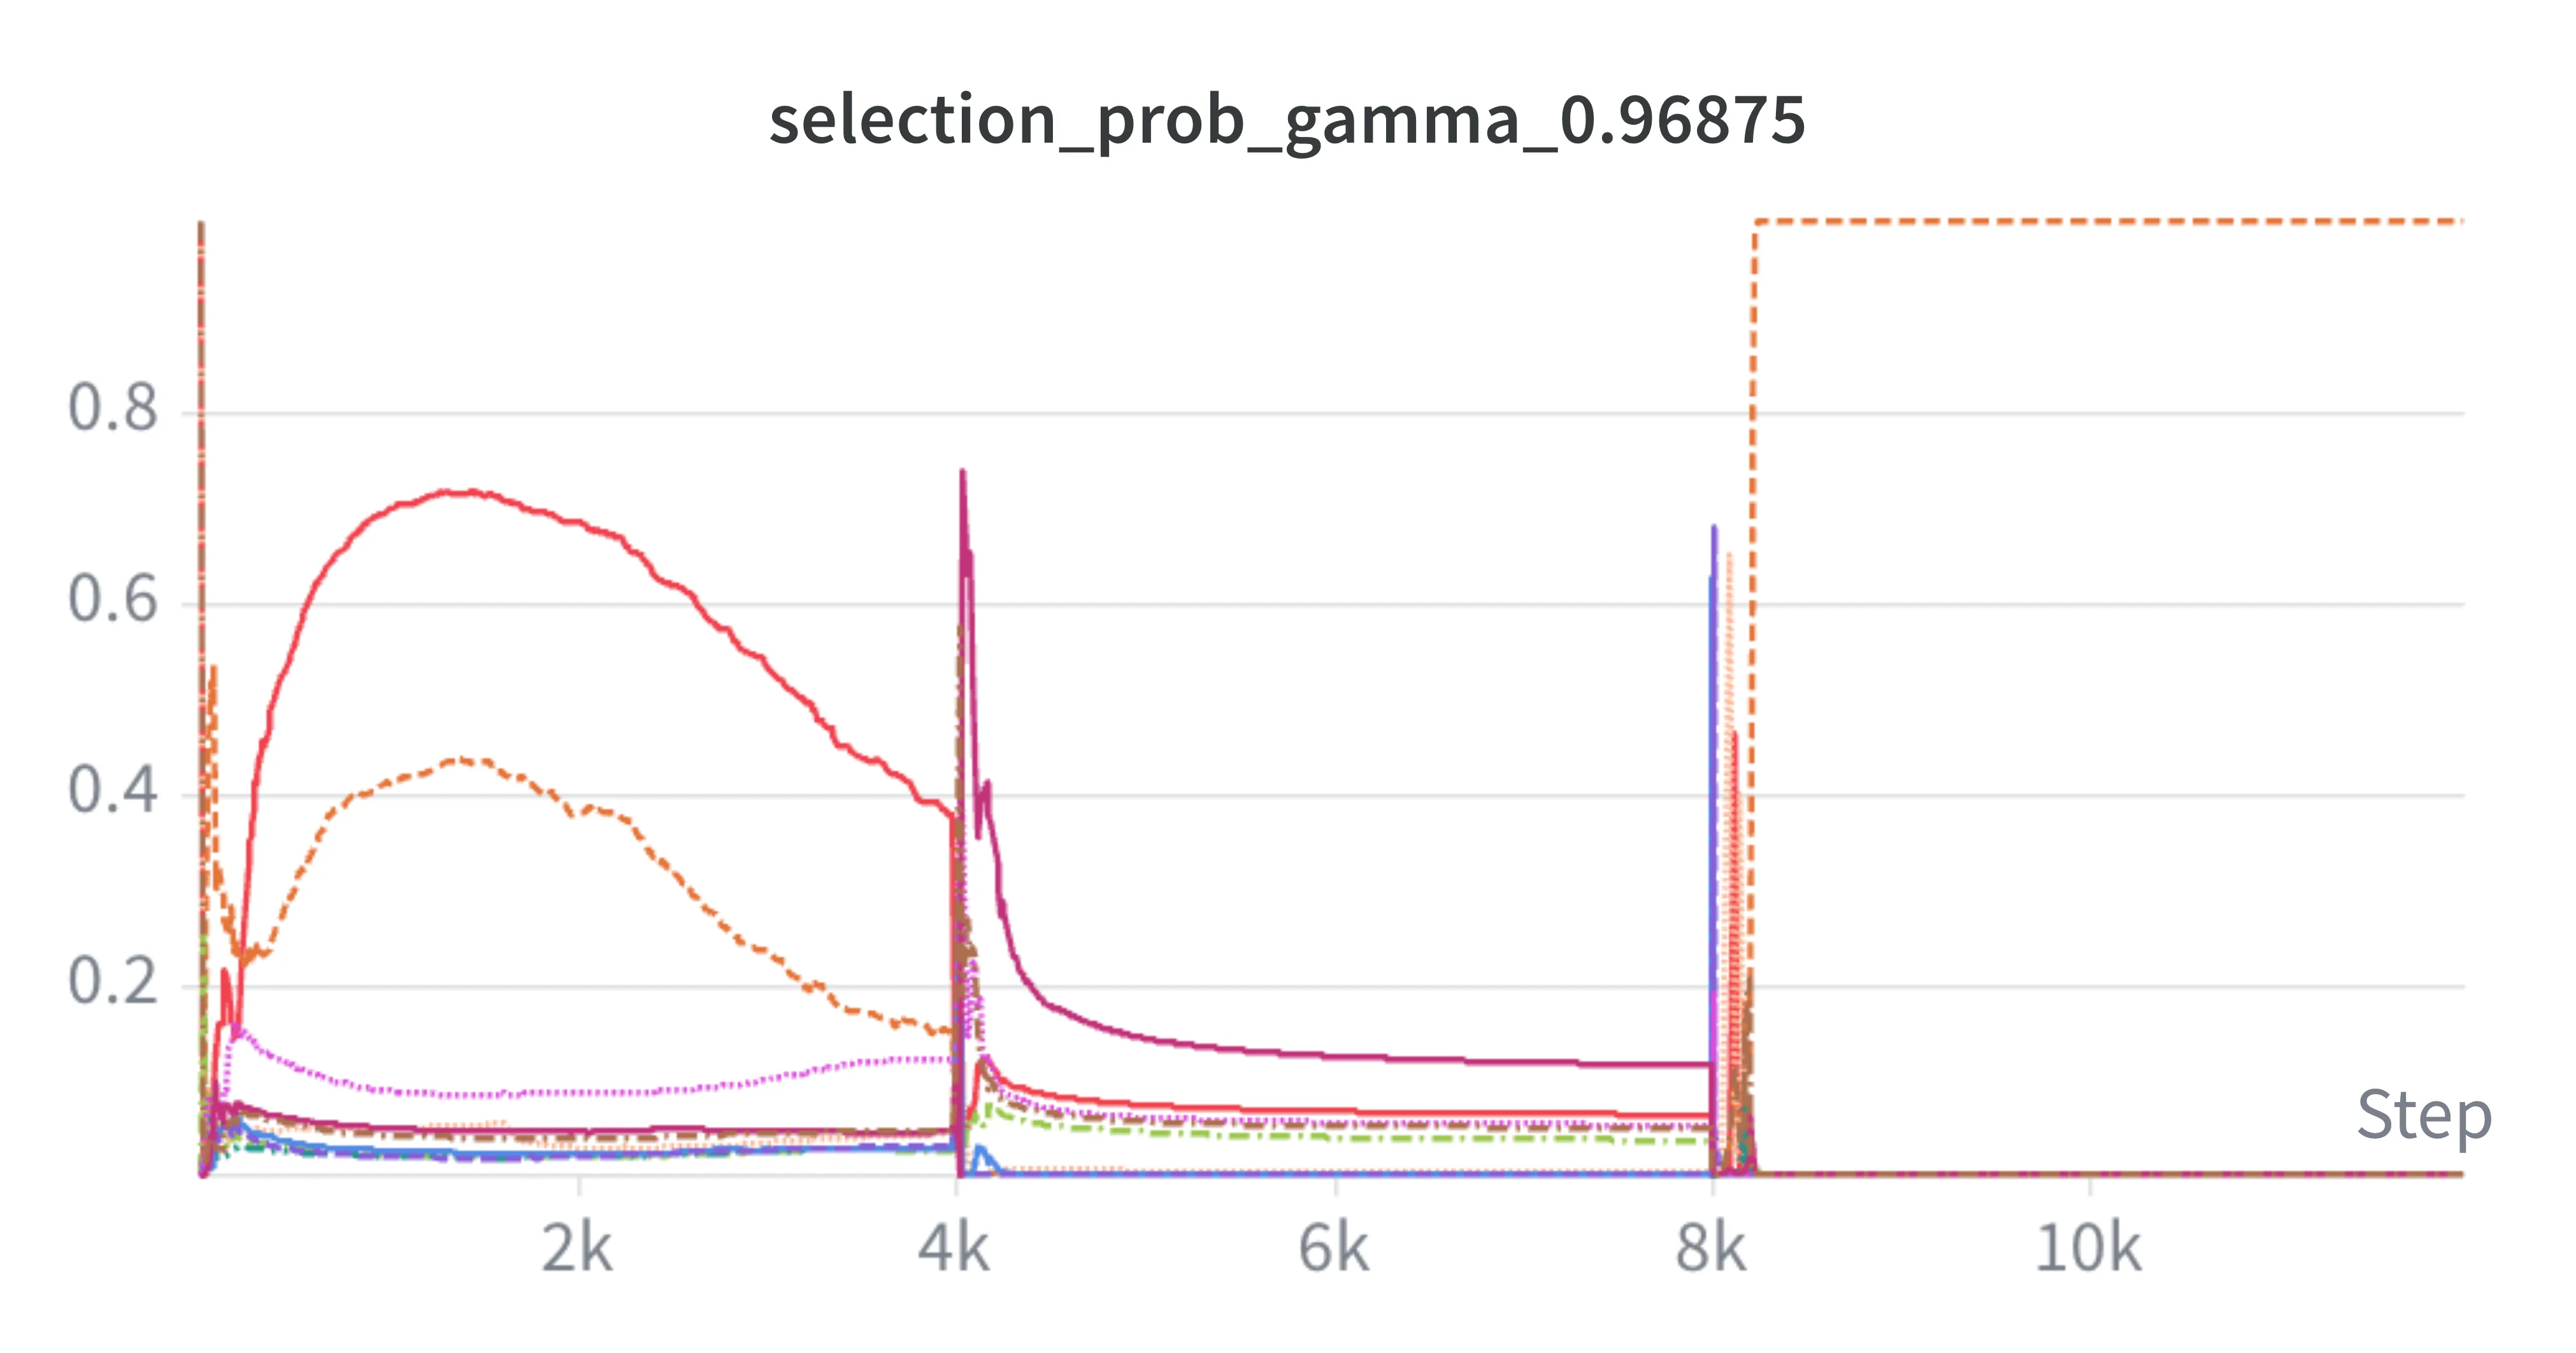
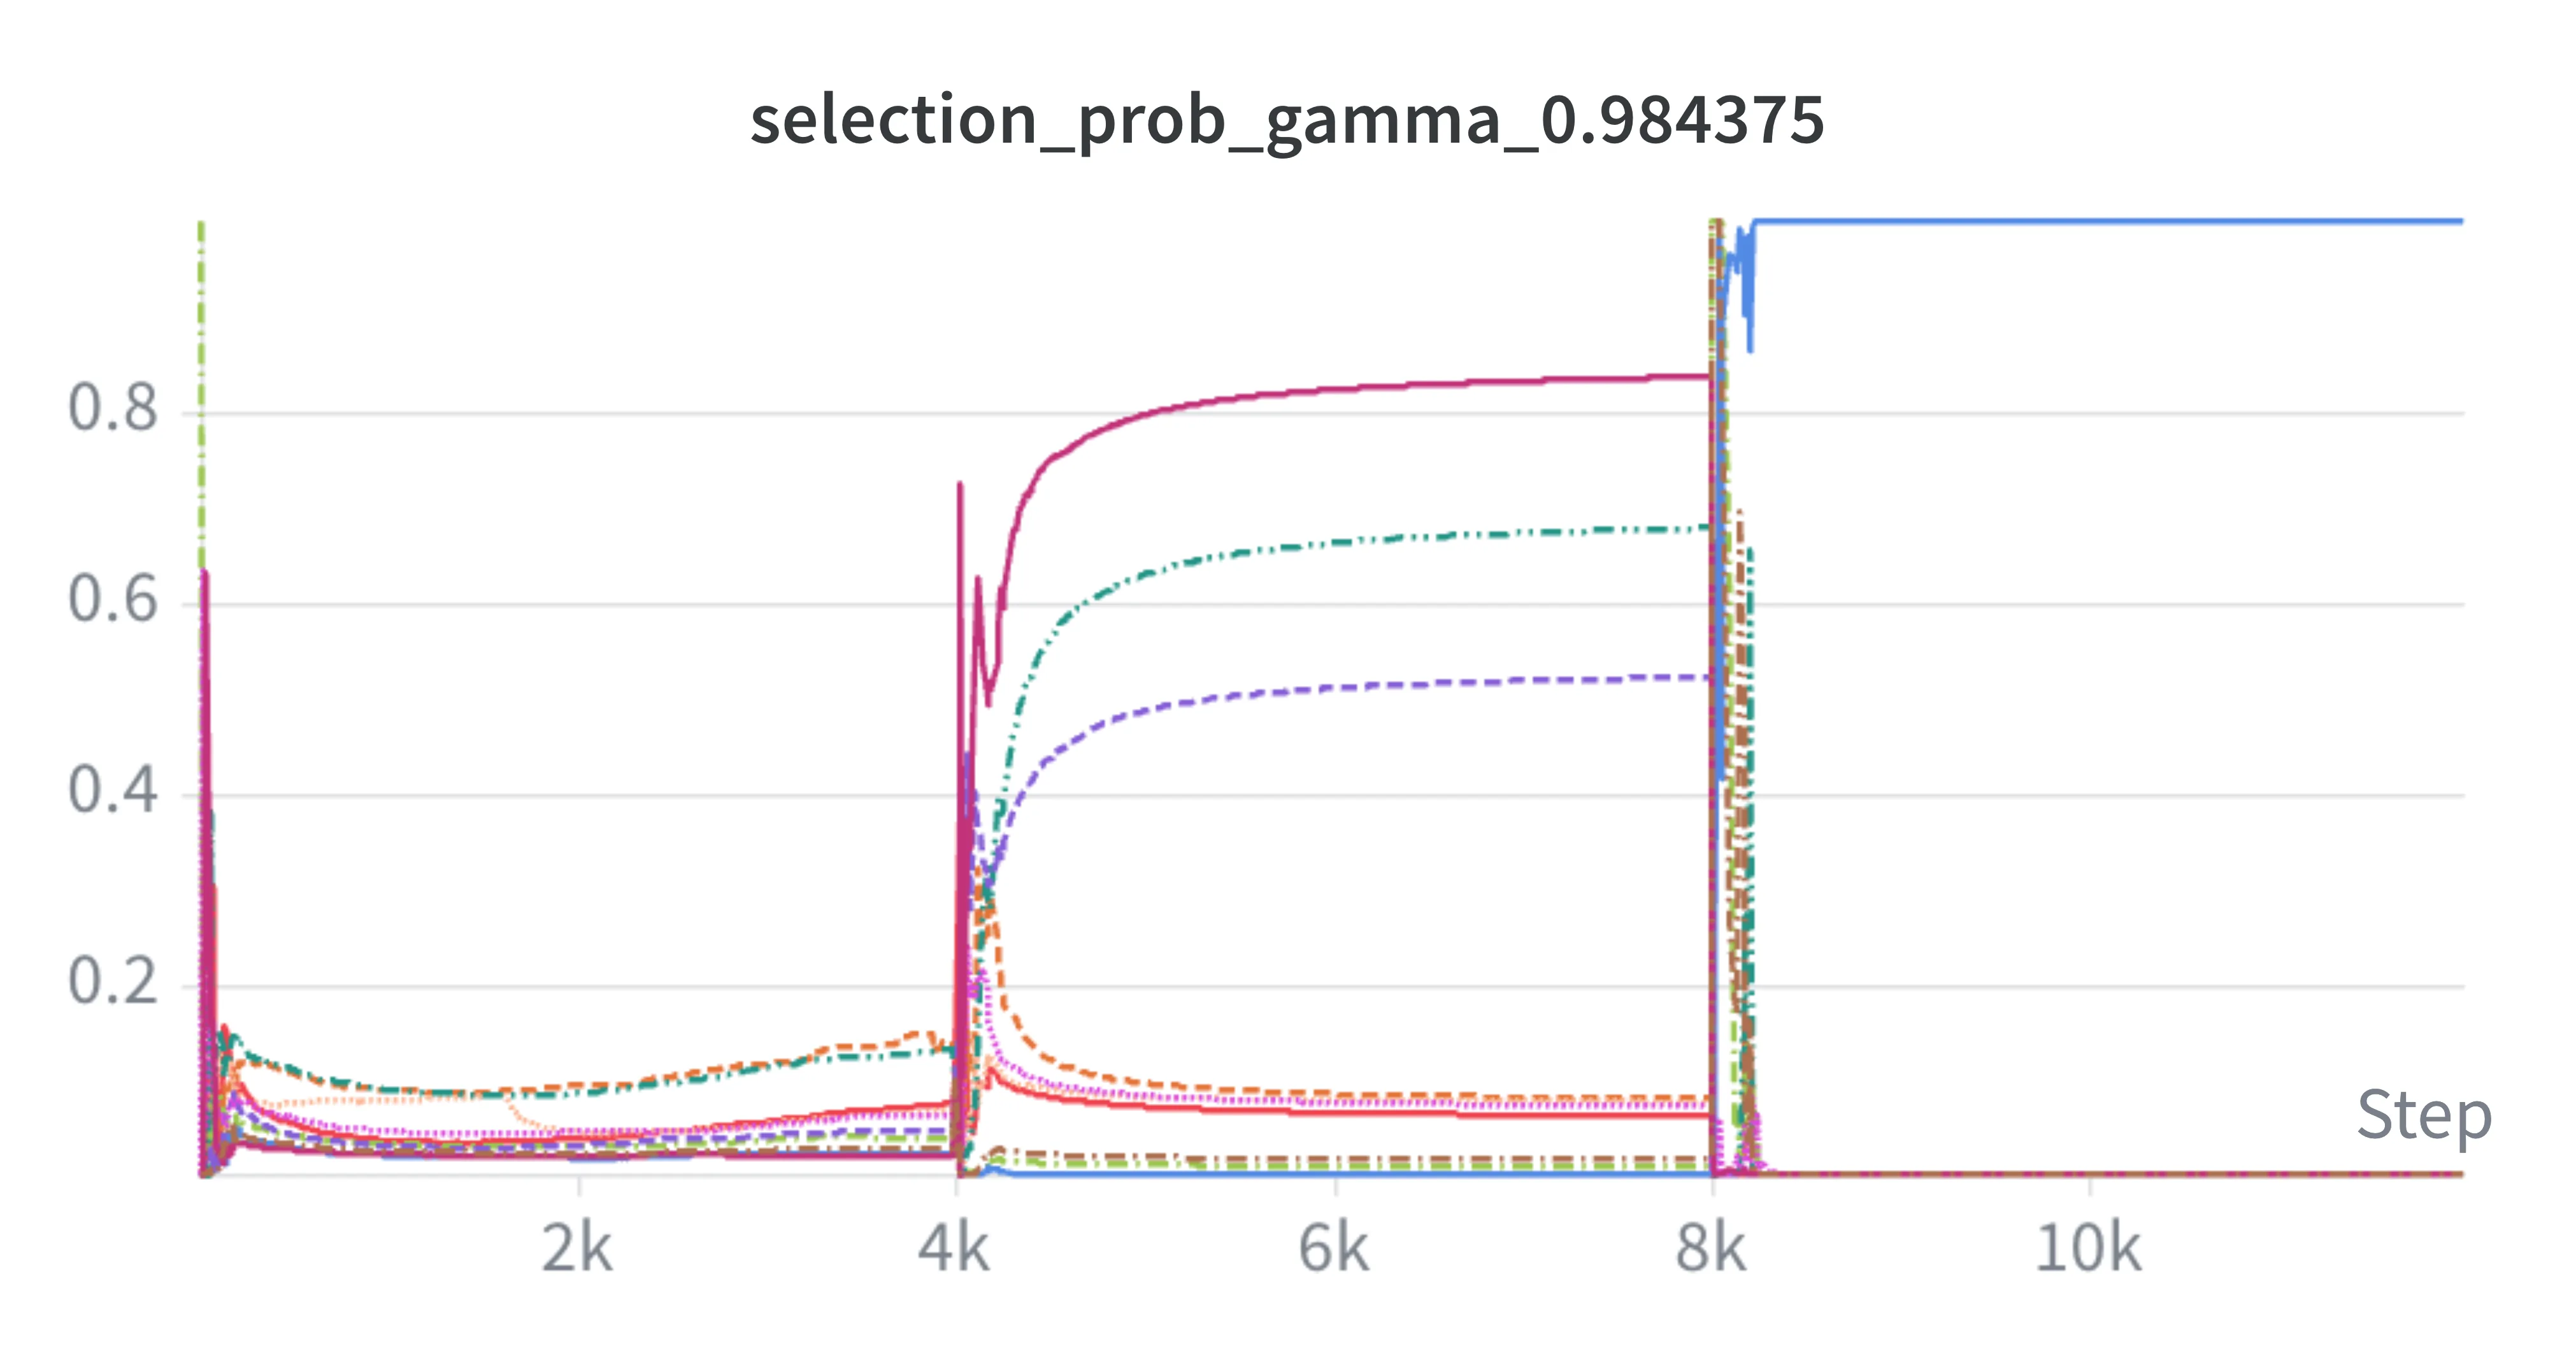
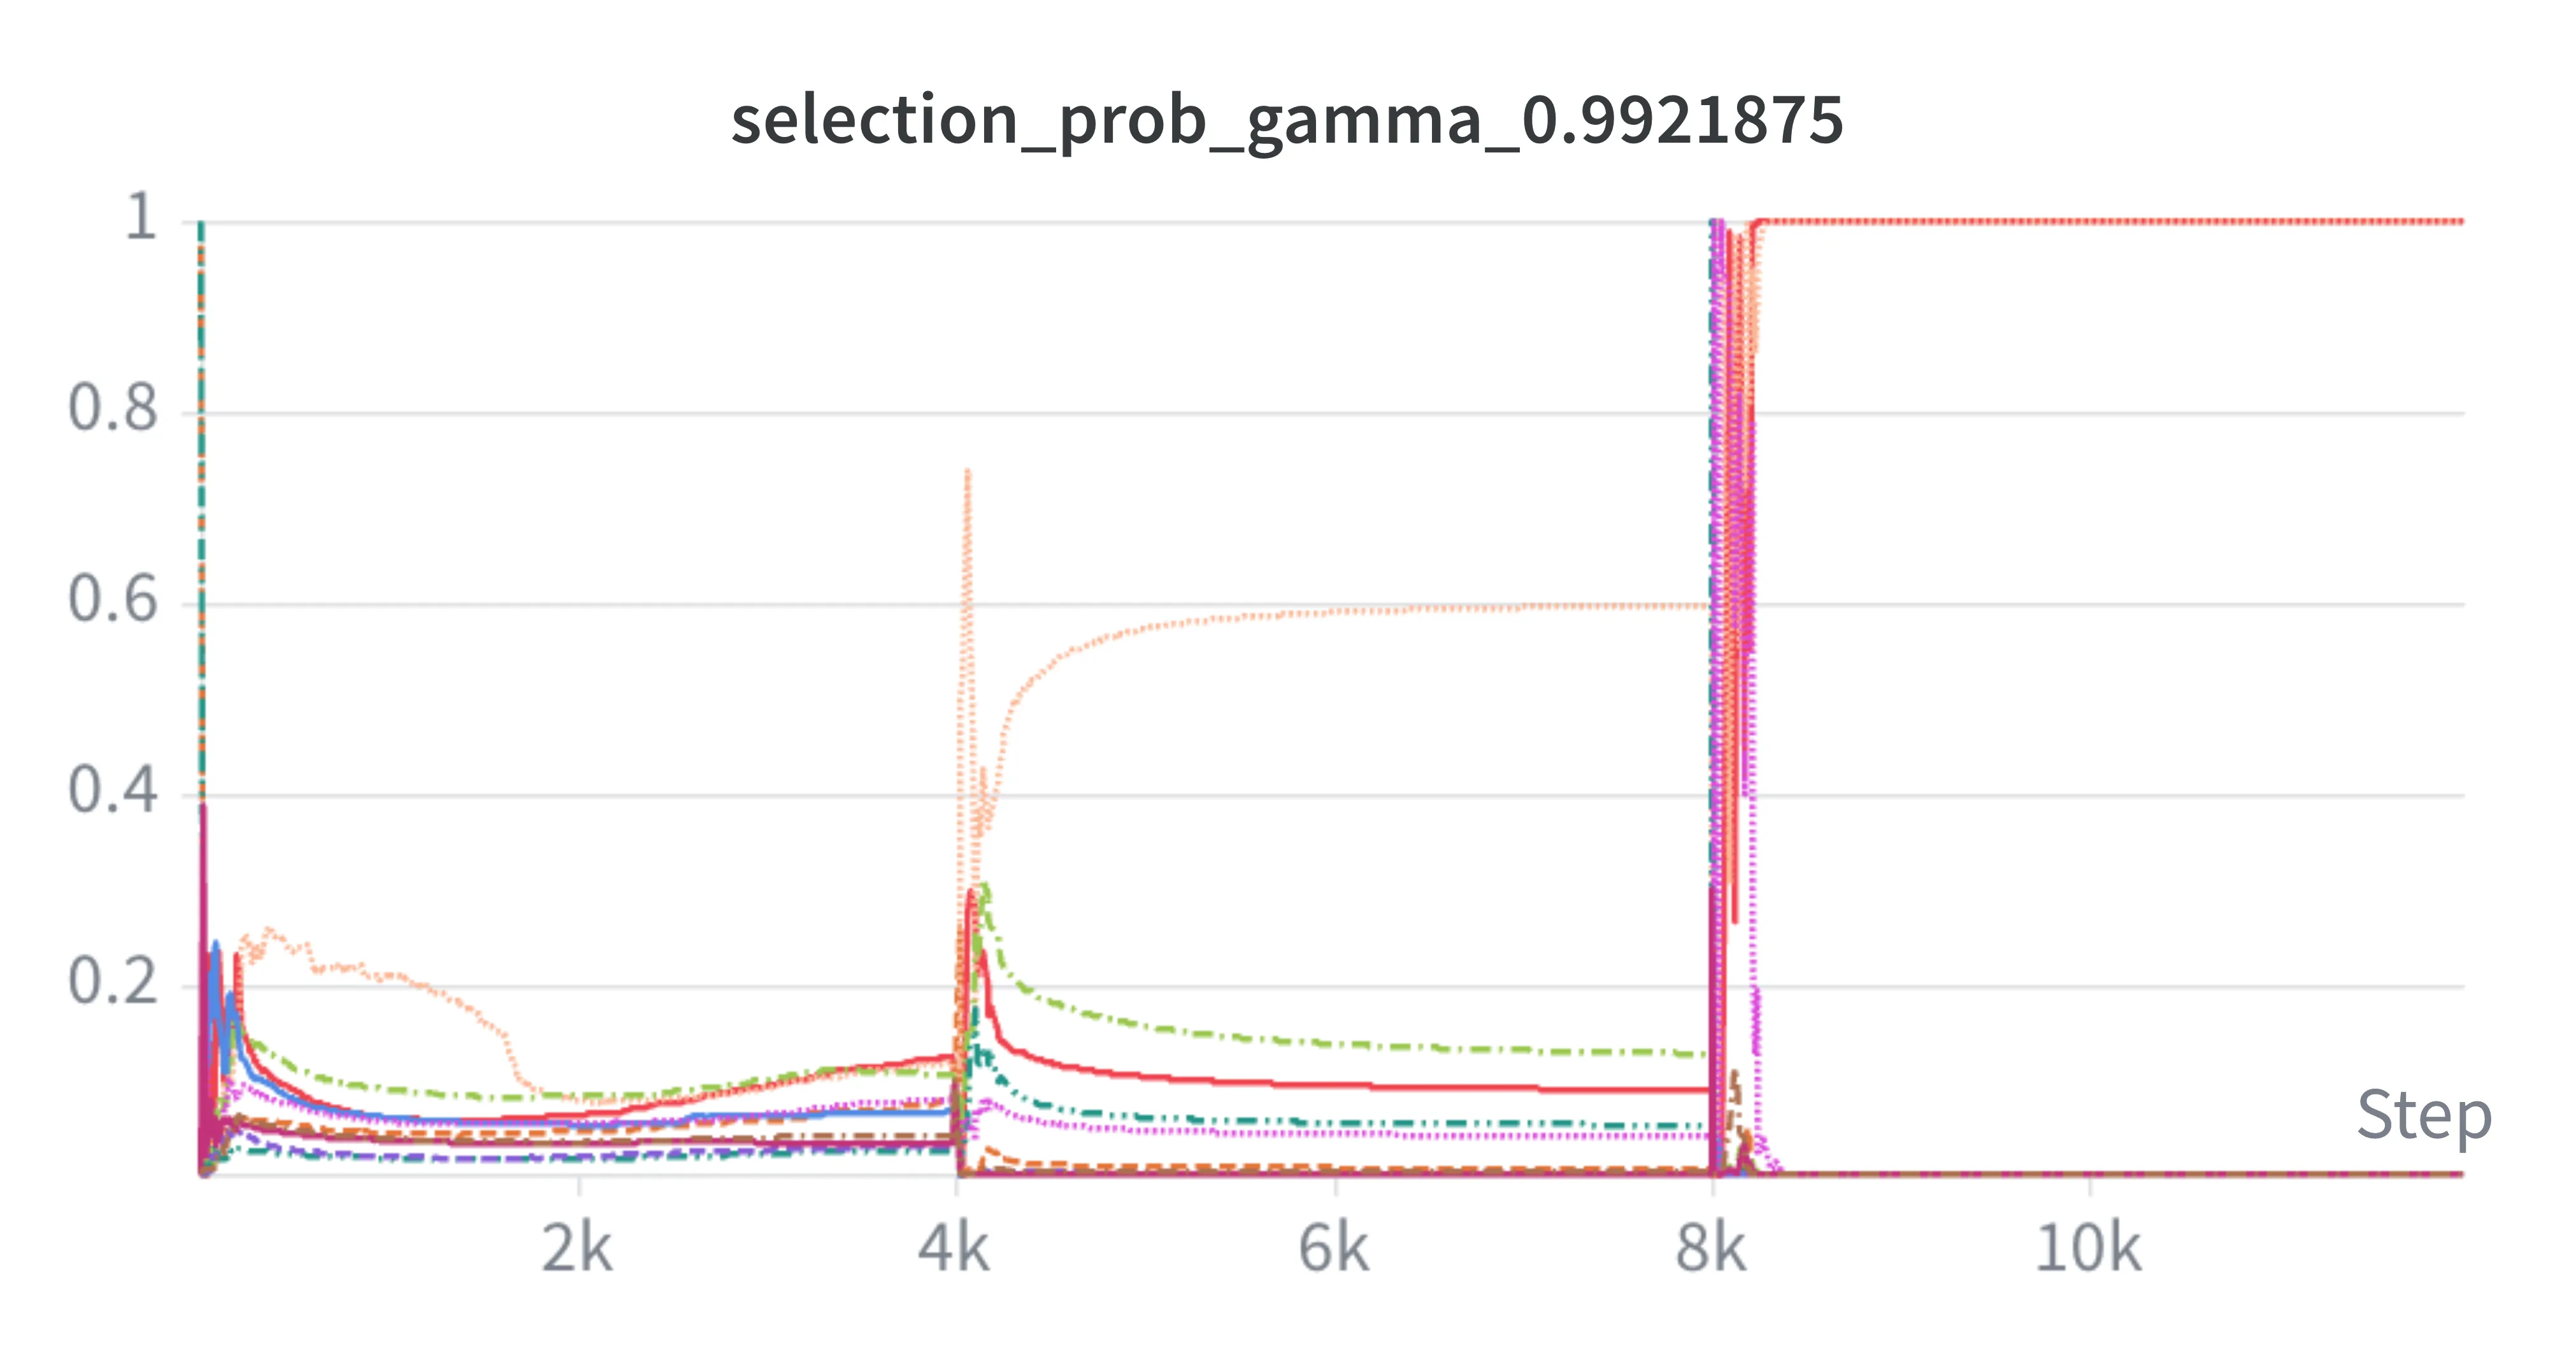
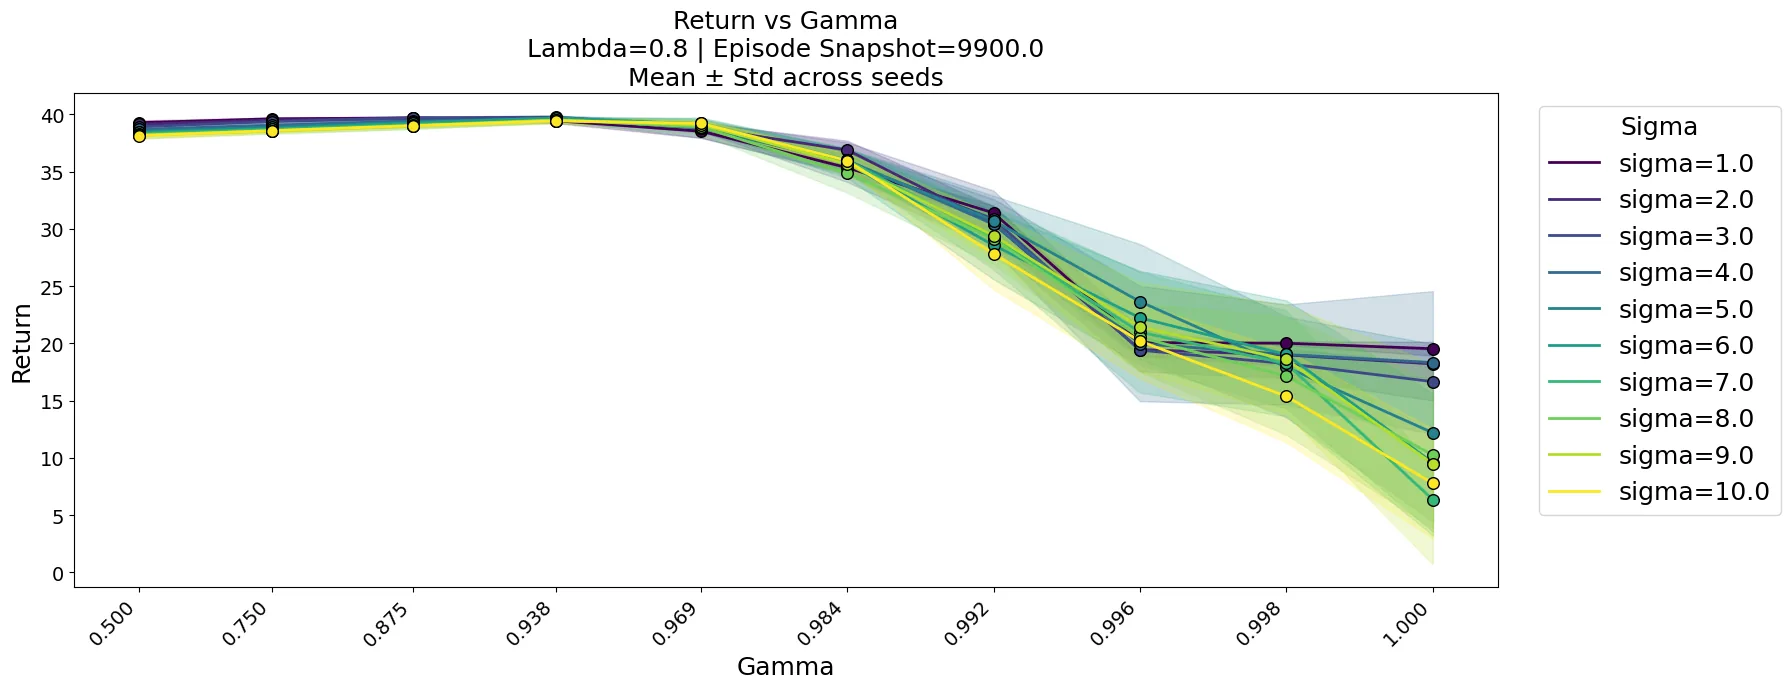
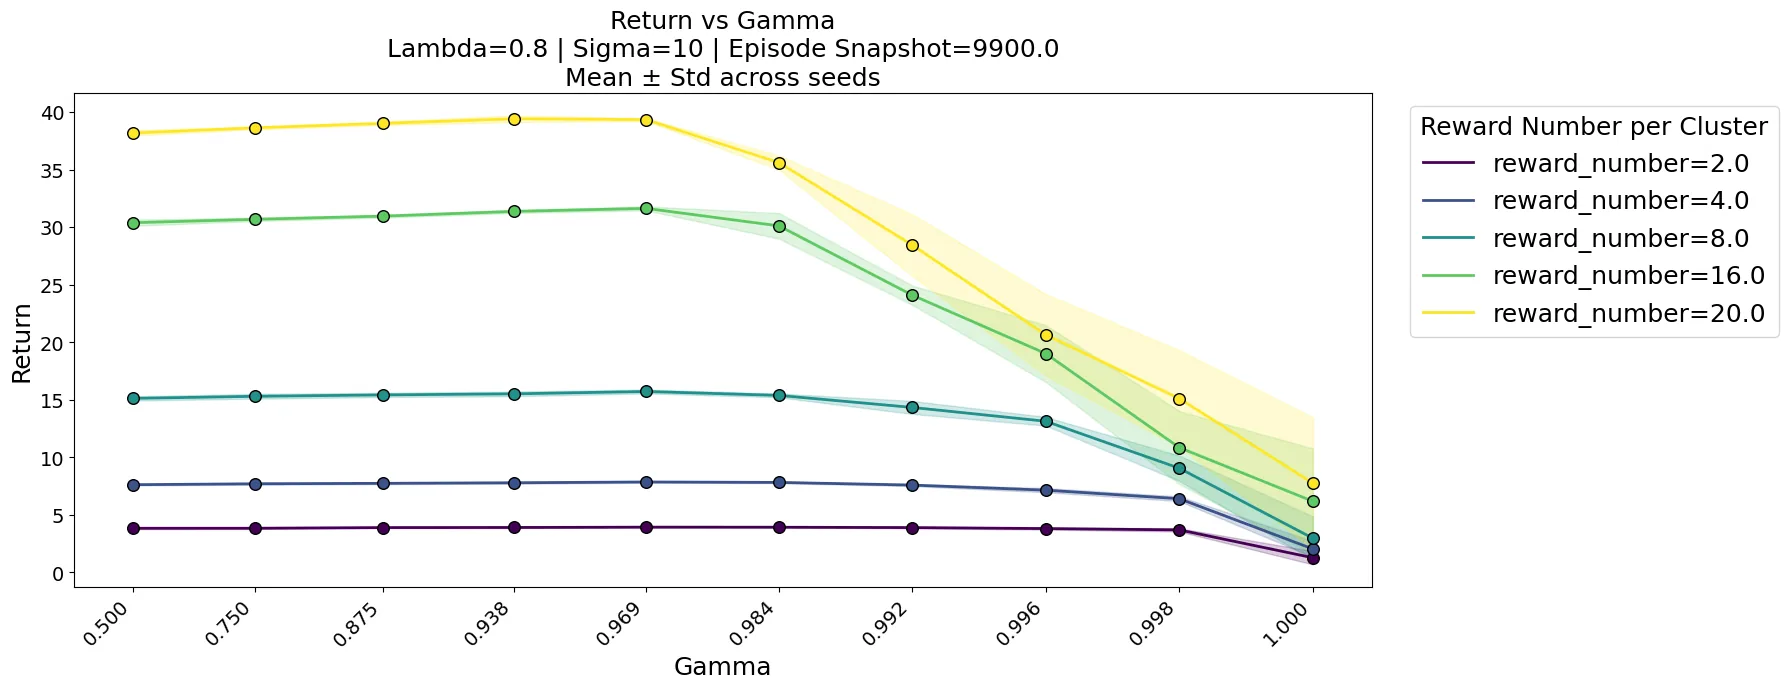
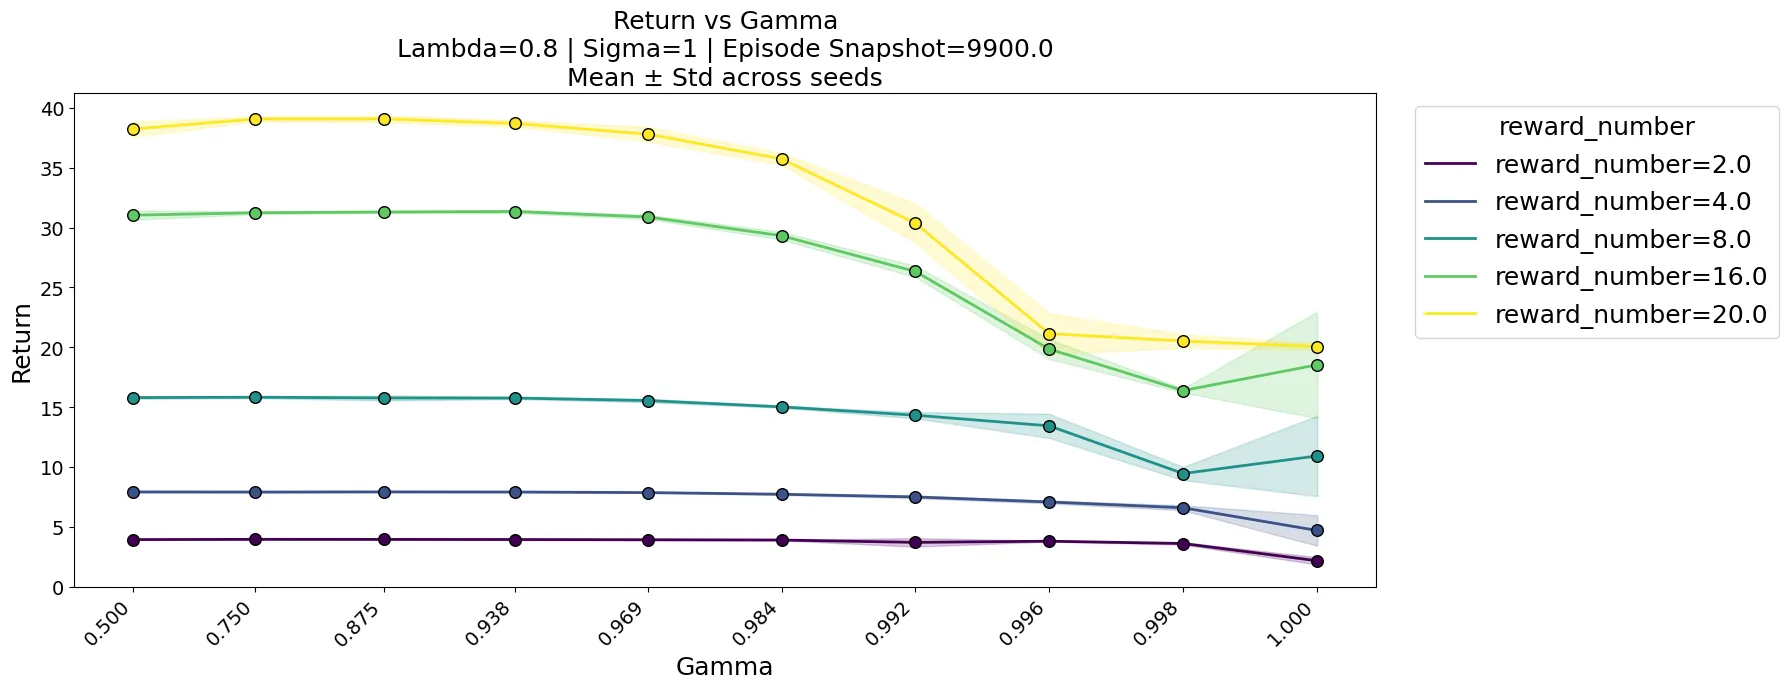
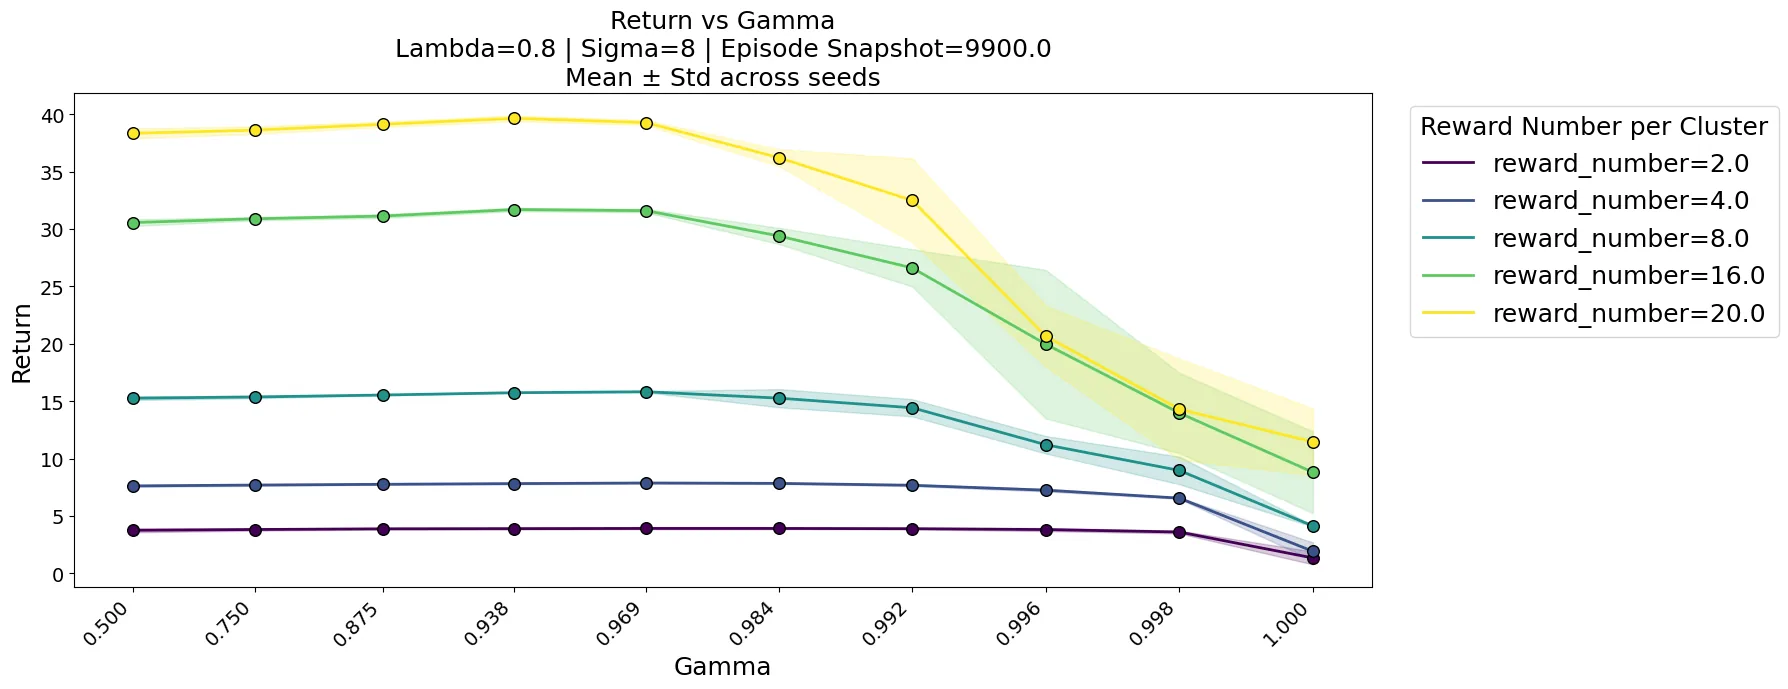
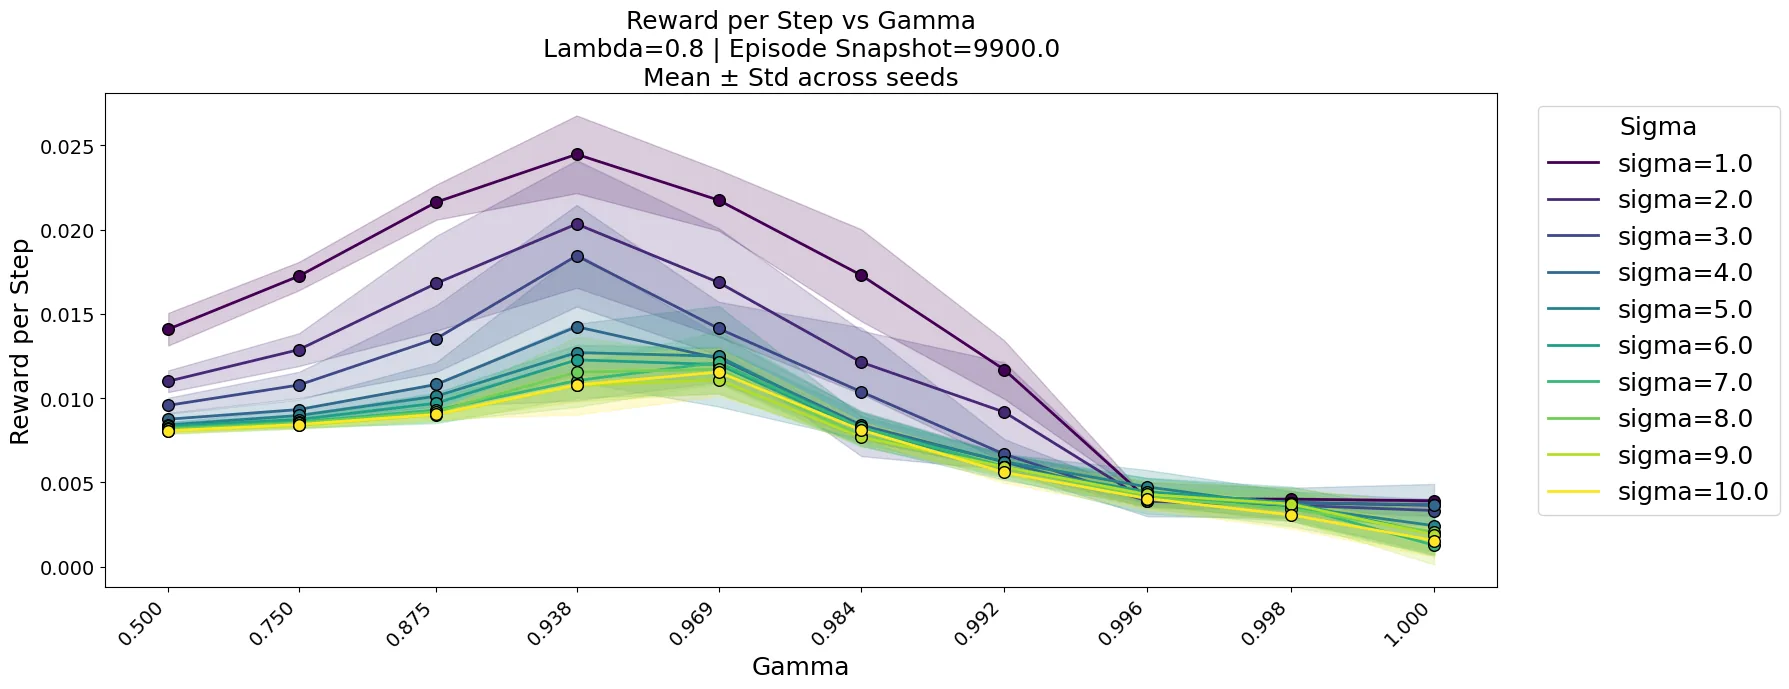
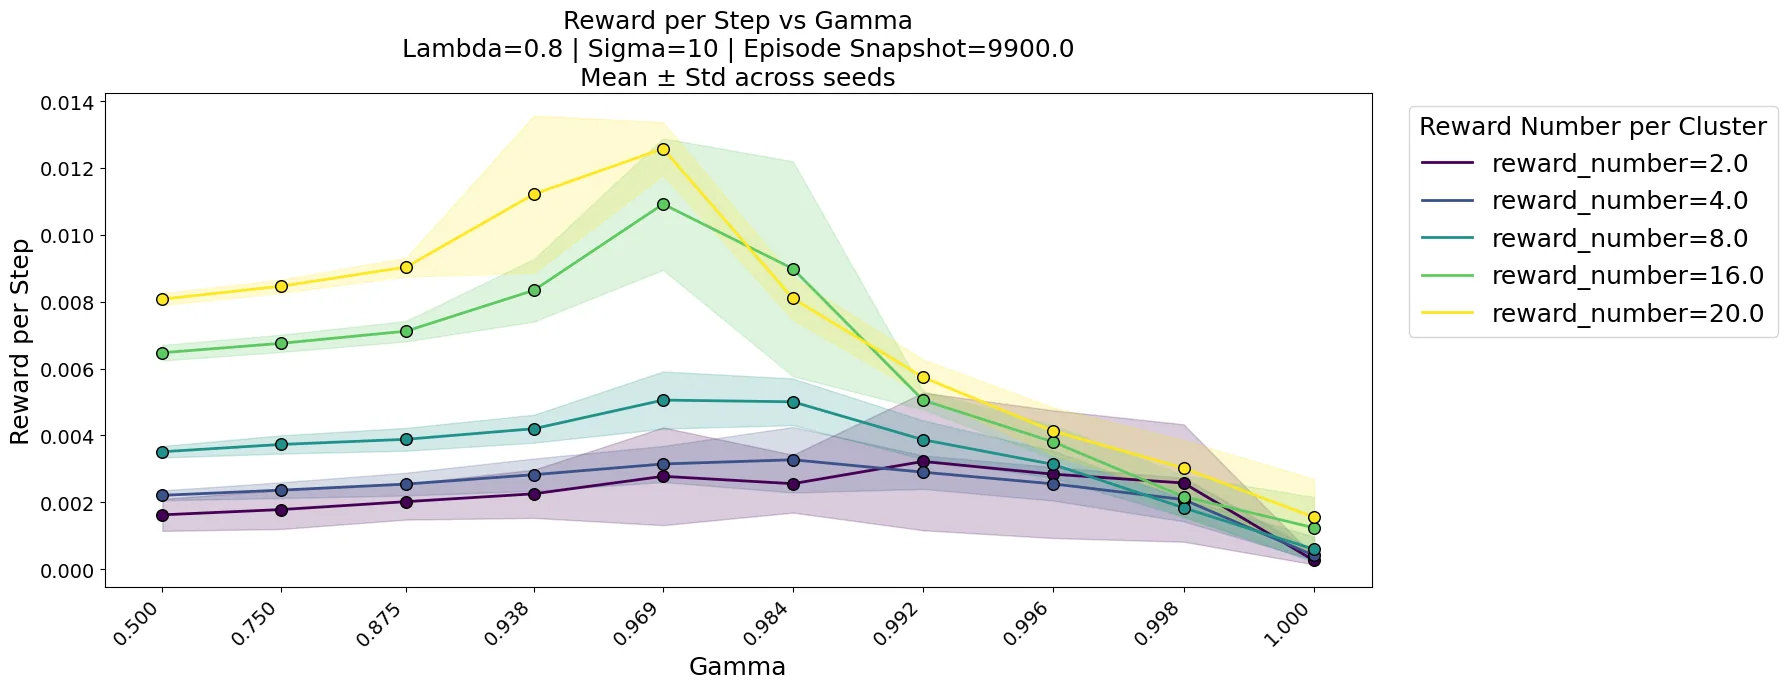
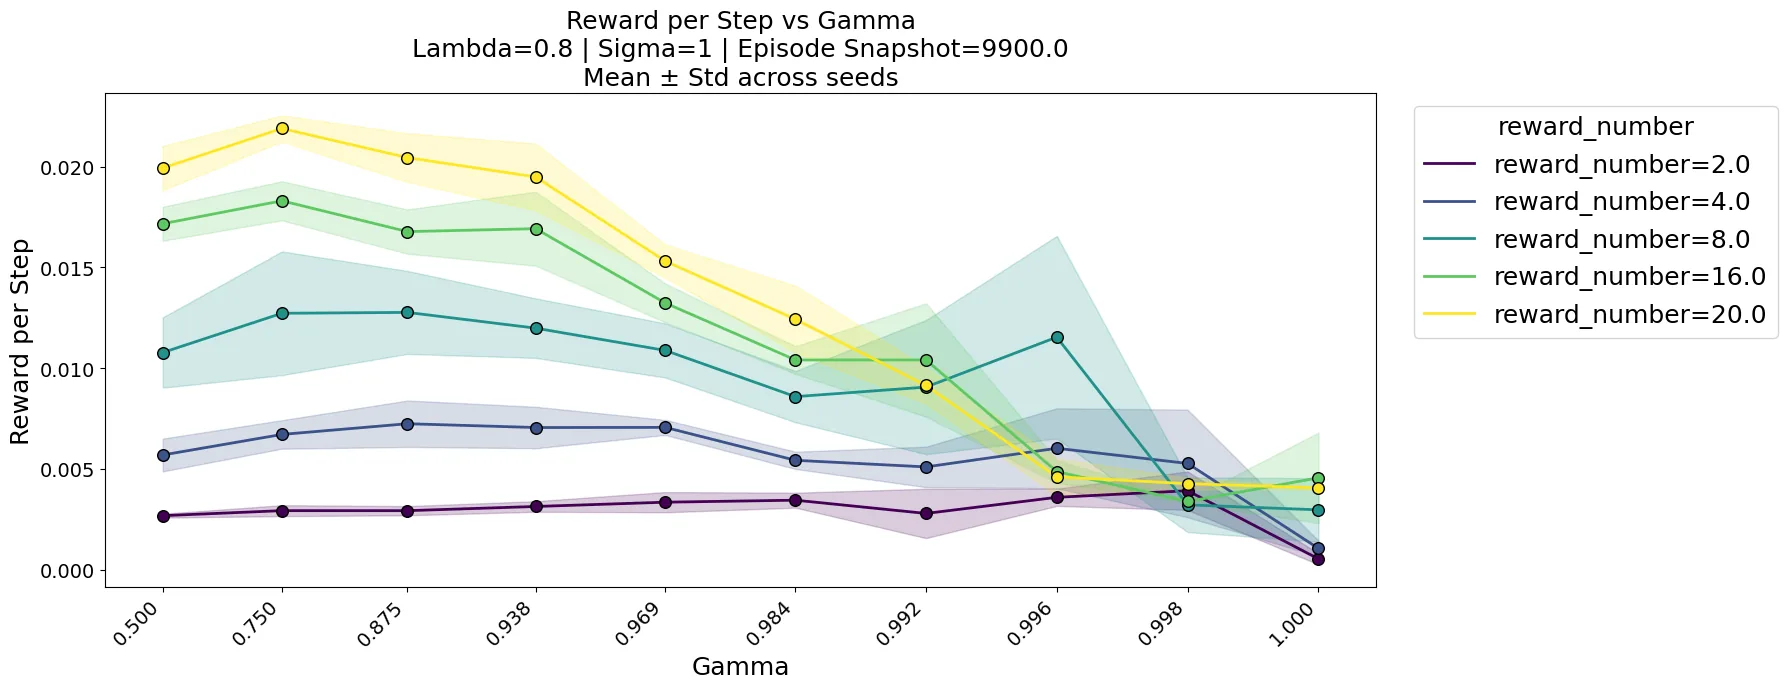
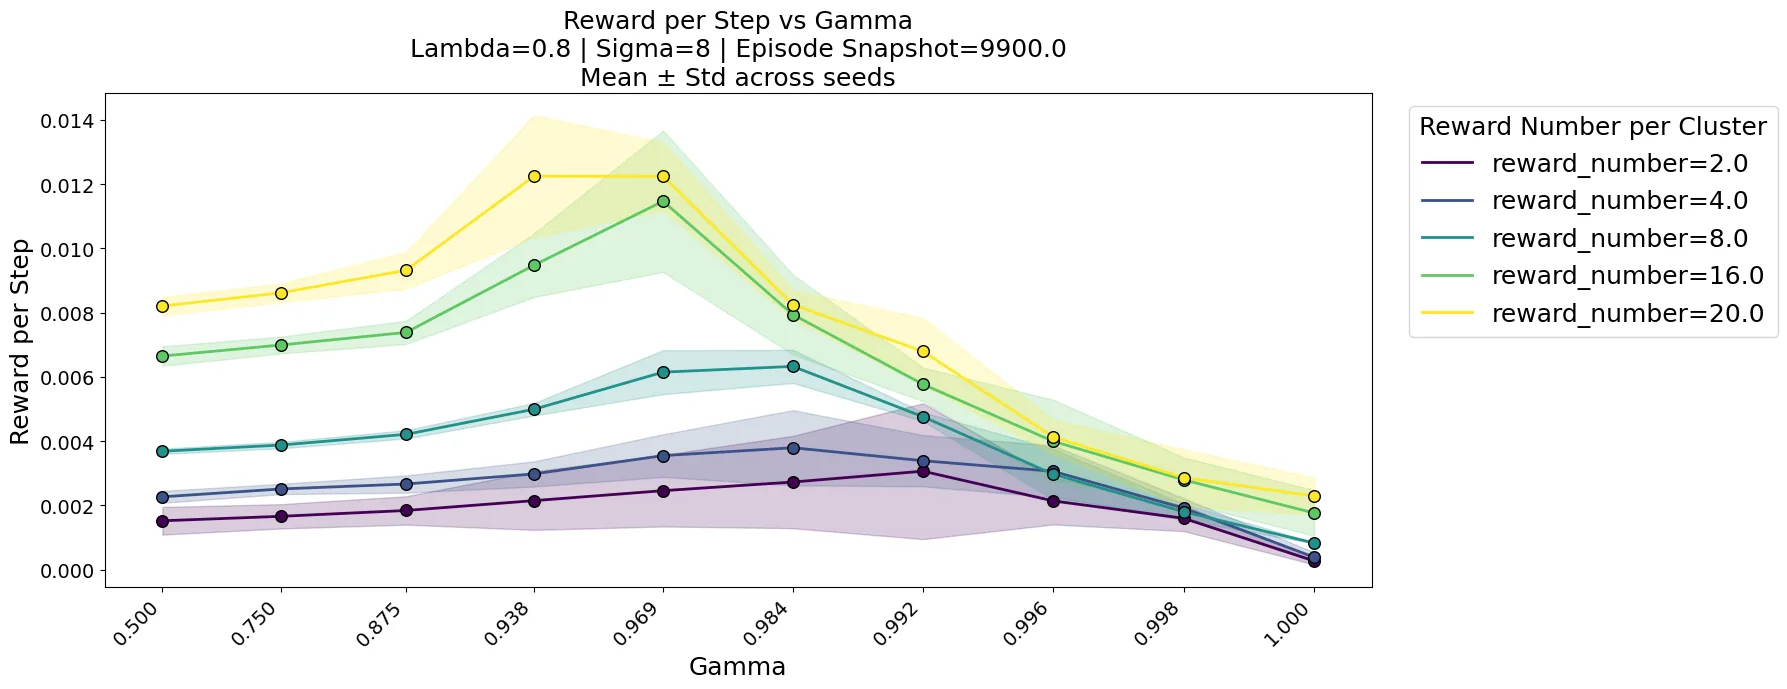
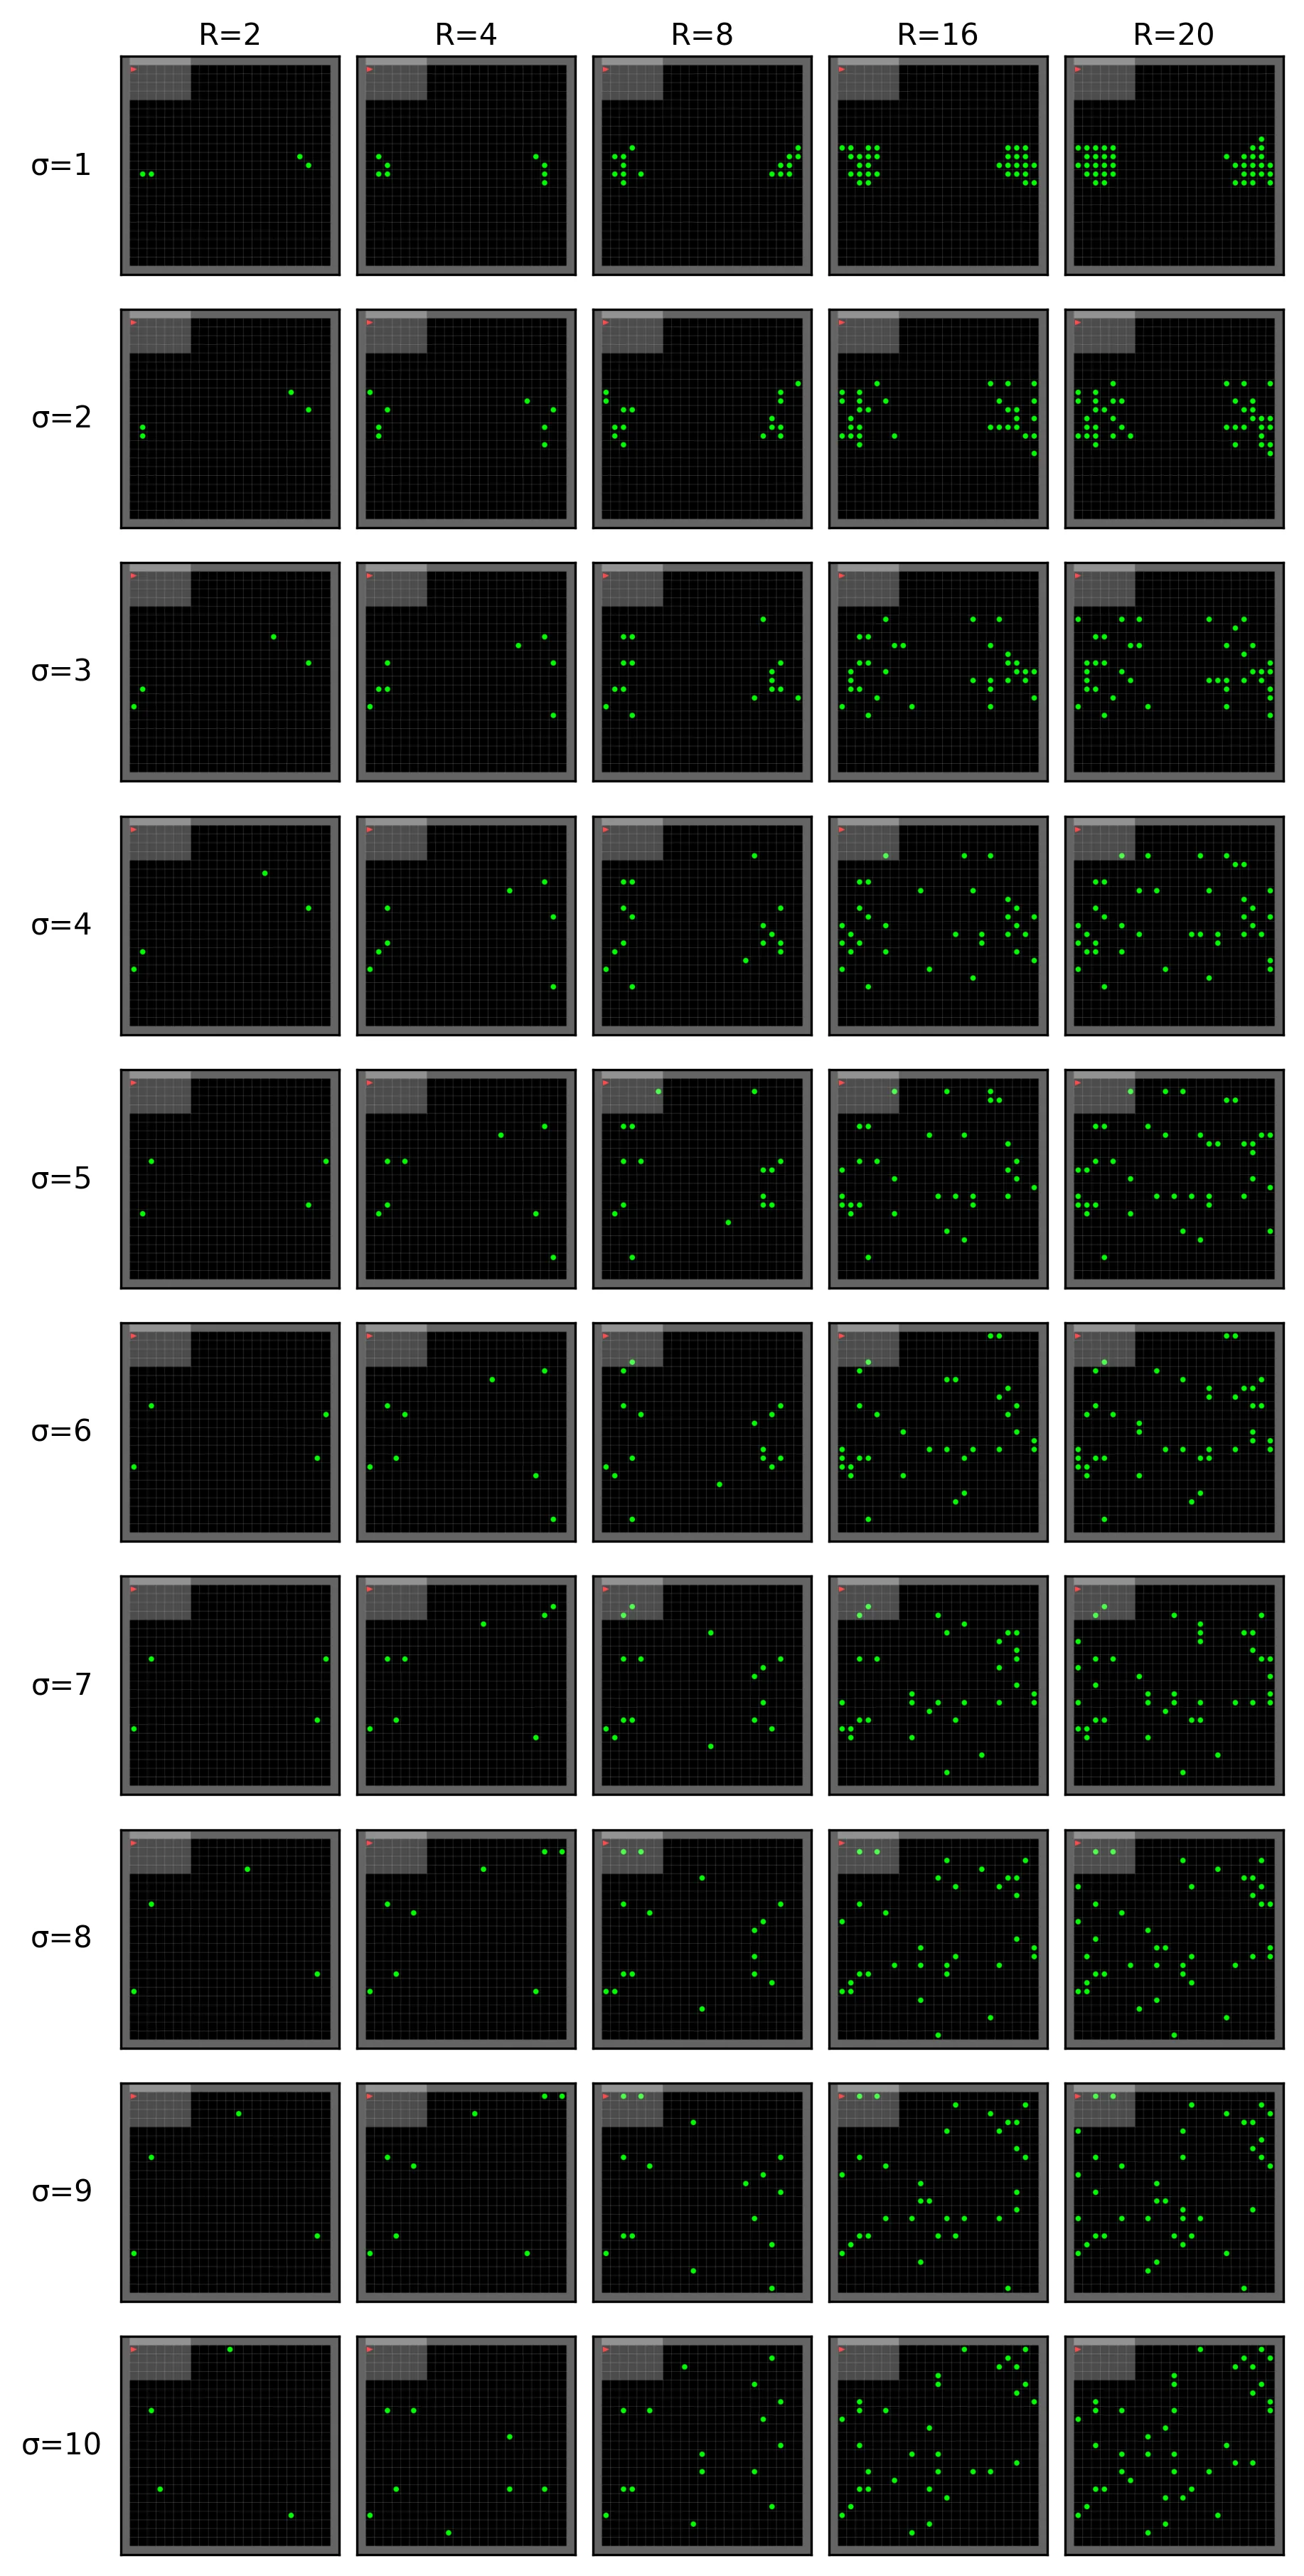
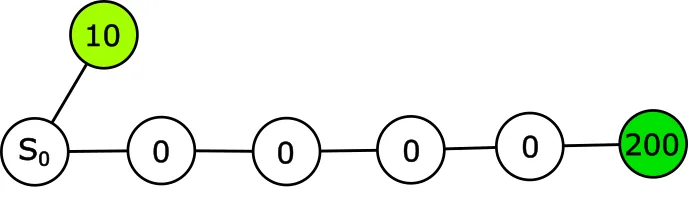
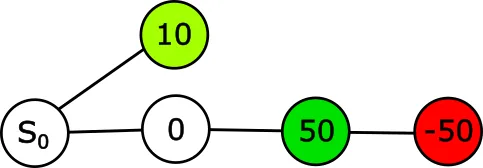
TL;DR
这篇论文针对传统强化学习中单一固定折扣因子难以平衡短期与长期收益的问题,提出了一种自适应多视野方法。该方法通过预设多个折扣因子对应的 Q 学习头,再由一个状态相关的混合网络动态组合它们的输出,从而在不同环境中自动识别有效的时间视野。在 MiniGrid 环境和包含三个任务切换的持续学习场景中验证了该方法的有效性,显著降低了对人工调参的依赖。
研究背景与动机
在强化学习中,智能体需要在即时奖励与未来潜在收益之间做出权衡。这一权衡通常由折扣因子 控制:它对 步之后的奖励施加 的衰减,最终形成一条指数衰减的时间视野。这一机制的核心公式为:
问题在于,不同任务往往需要不同的时间视野。较小的 使智能体更关注眼前的反馈,适合需要快速响应的任务;较大的 则引导智能体进行更长远的规划,但可能在奖励稀疏的环境中面临探索困难。更关键的是,当任务本身的奖励结构发生变化时——比如目标位置迁移、奖励信号重新定义——一个固定的 可能从最优选择瞬间变成次优甚至糟糕的选择。
传统做法是对 进行网格搜索,但这一过程既耗时又缺乏适应性。生物智能体却展现出一种更灵活的能力:它们能够根据环境上下文自适应地调整时间折扣的方式。受这一生物学观察的启发,本文试图在人工强化学习系统中复现这种多时间尺度的规划能力,核心目标是设计一种无需手工调节折扣因子的自适应方法,使其能够在任务切换和奖励结构变化时自动调整自身的时间视野偏好。
方法
论文提出的方法包含两个核心组件:多视野 Q 学习头集合与自适应混合网络。
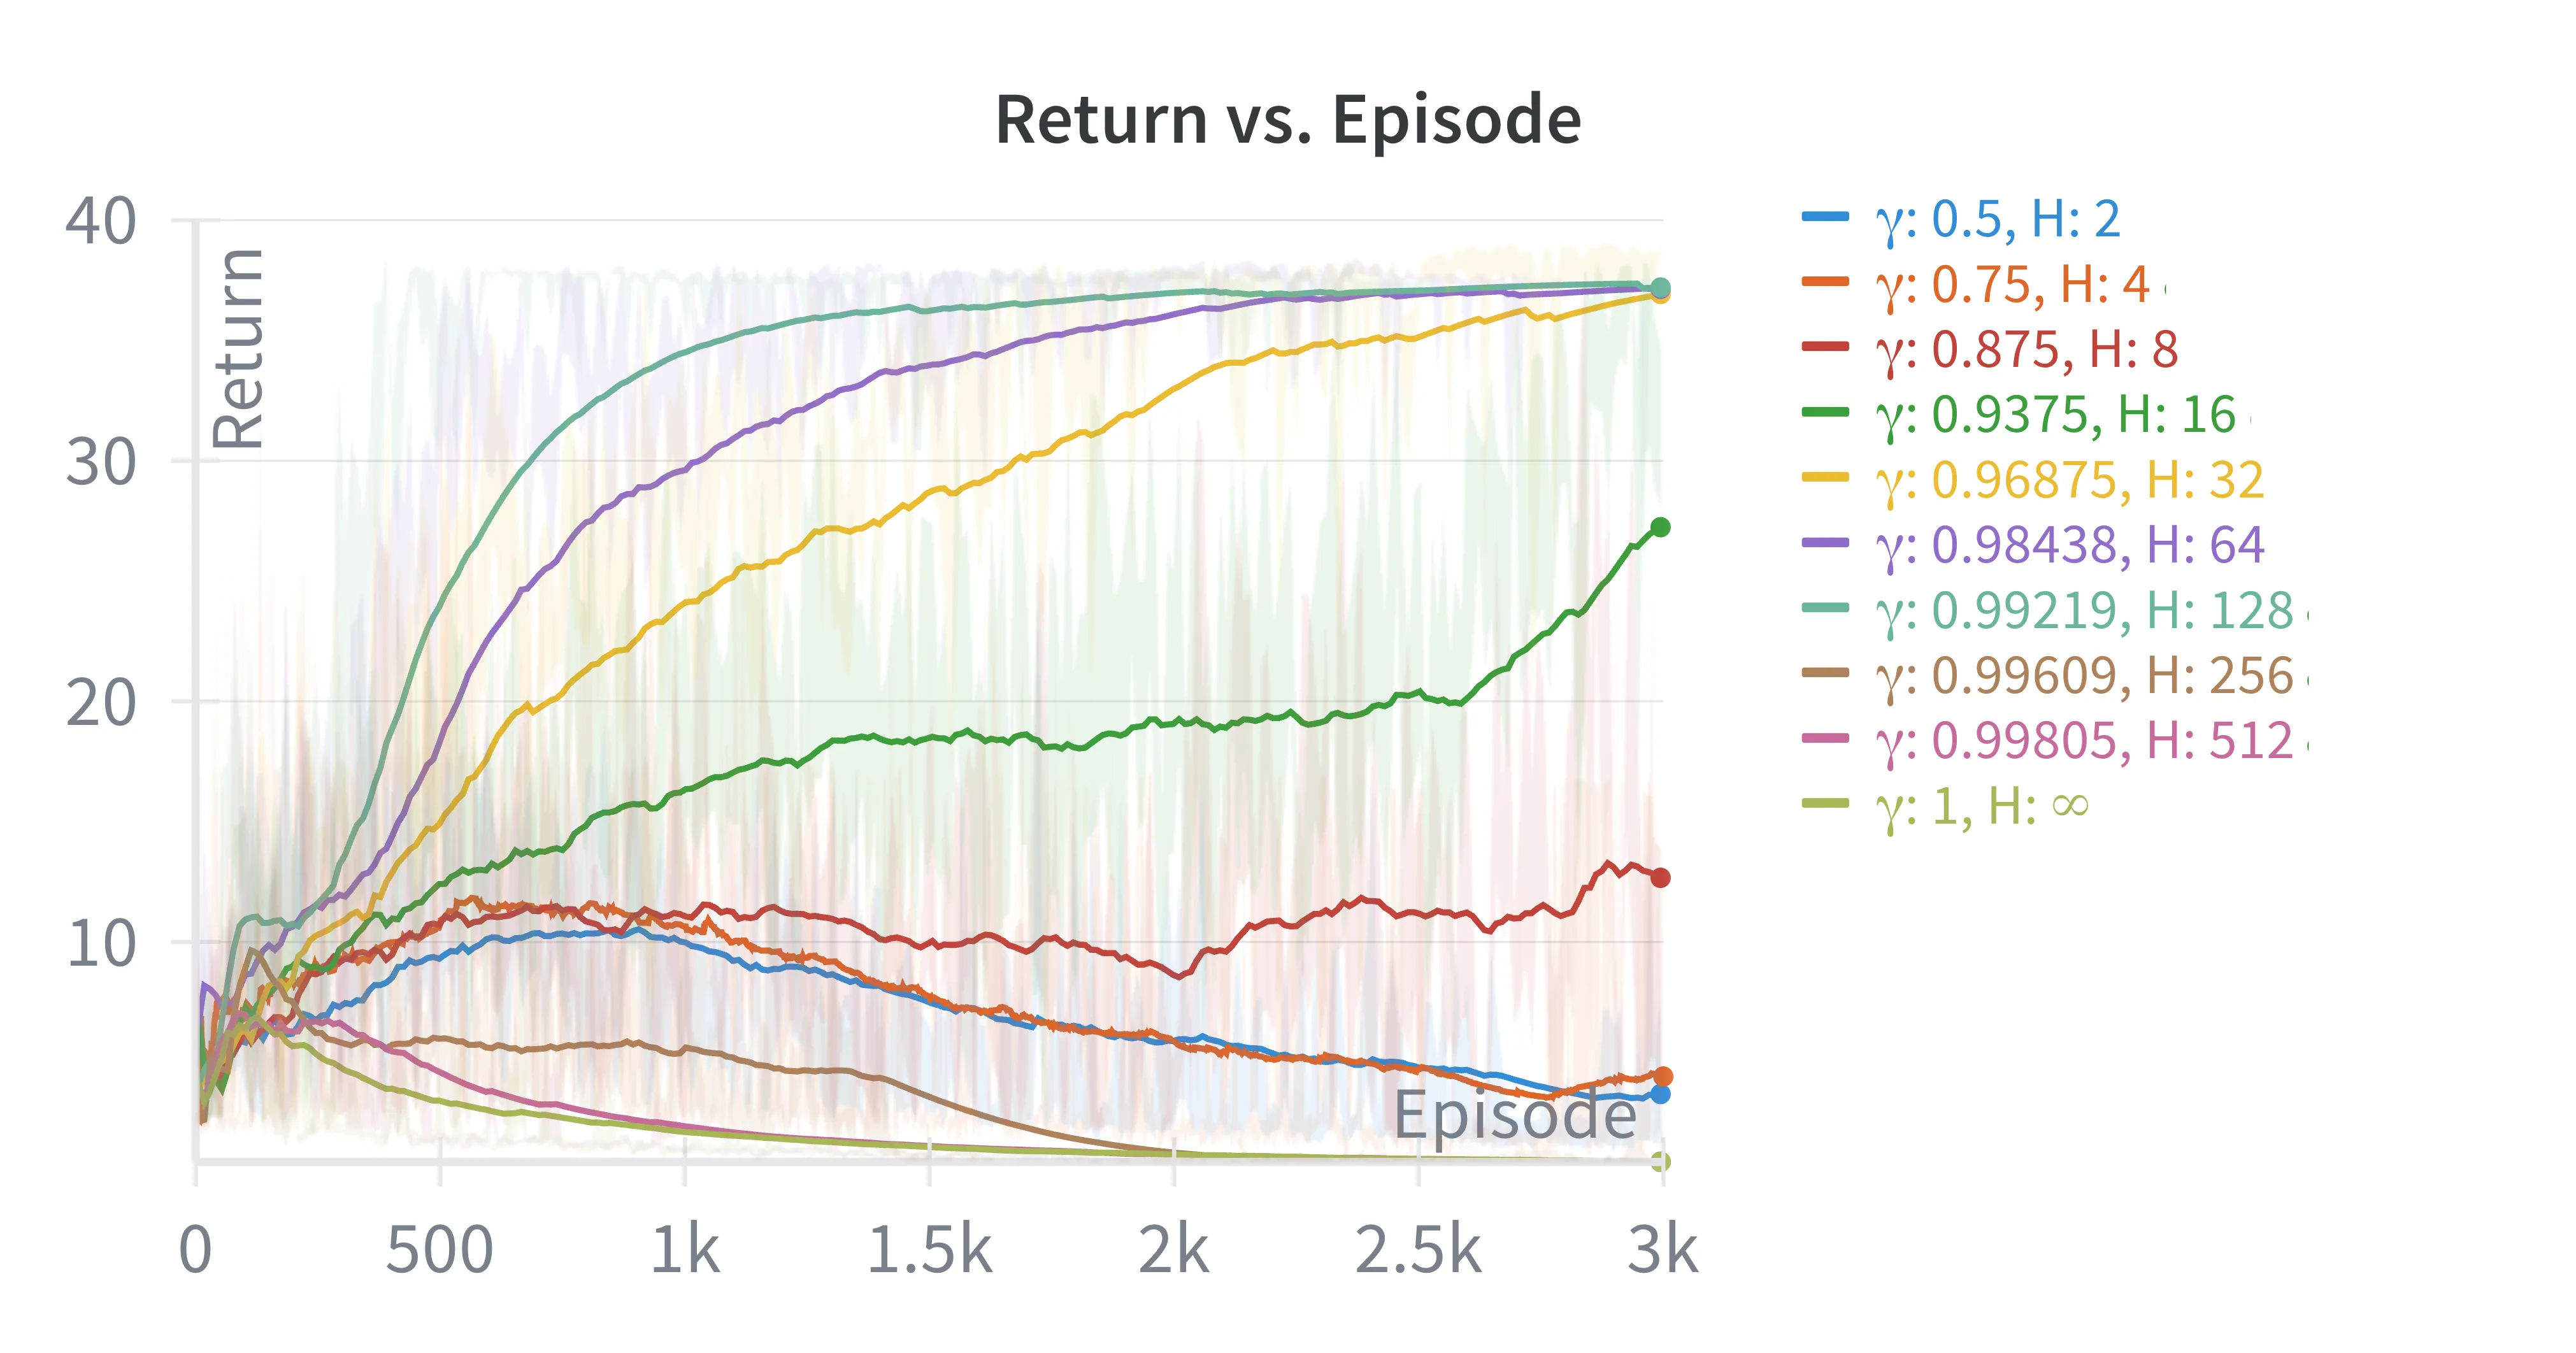
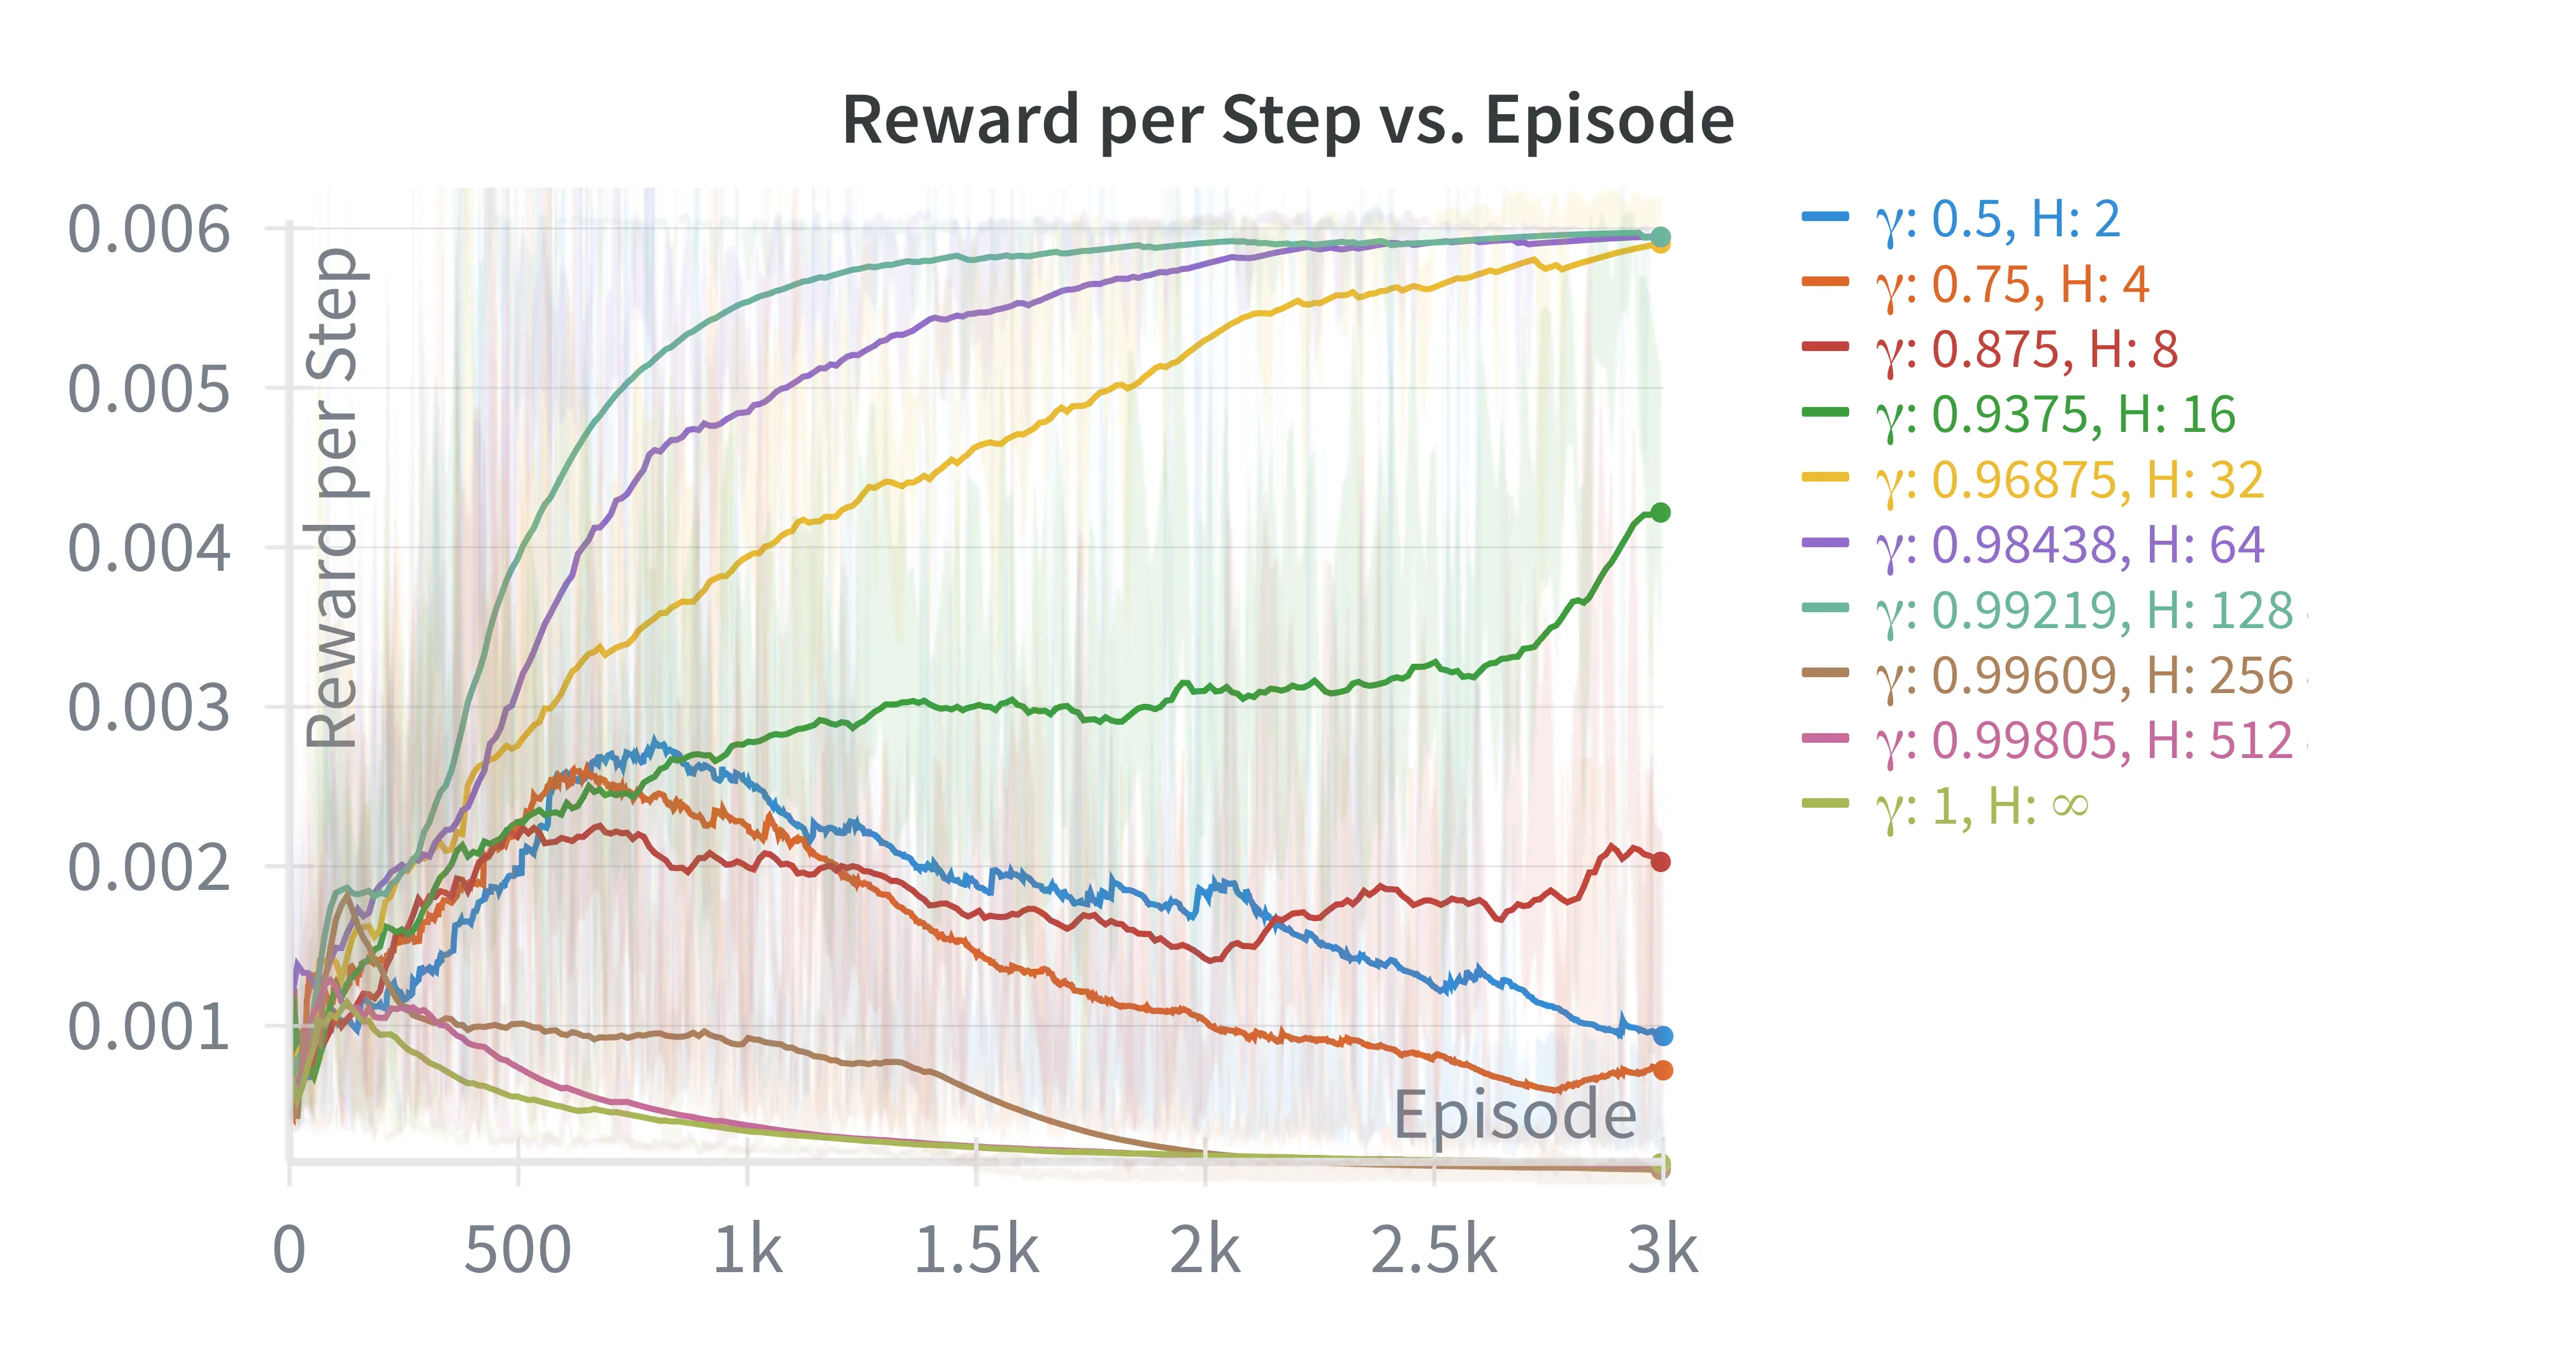
首先,预设一组离散的折扣因子集合,覆盖从极短视野到无折扣的完整谱系。论文选取了十个值:,对应的有效视野 从 2 延伸到无穷大。这种离散化设计既保证了视野覆盖的完整性,又避免了连续参数空间的优化困难。
每个折扣因子对应一个独立的 Q 学习头,学习该时间尺度下的动作价值函数 。论文采用 Q(λ) 框架,每个头的 TD 误差与资格迹更新都基于各自的 计算。资格迹机制在这里起到了加速学习的作用,使得各头能够更高效地传播延迟奖励的信用分配。
关键创新在于混合网络的设计。该网络以状态 为输入,通过特征提取得到 ,再经线性映射和 softmax 归一化,为每个 Q 头生成一个权重:
最终混合 Q 值为各头的加权平均:
权重满足非负且和为 1 的约束,这保证了 始终位于各头 Q 值构成的凸包内,是物理意义良好的混合结果。混合网络的损失函数基于 计算的 TD 误差,其梯度更新倾向于让高权重的头对应更高的 Q 值、低权重的头对应更低的 Q 值。
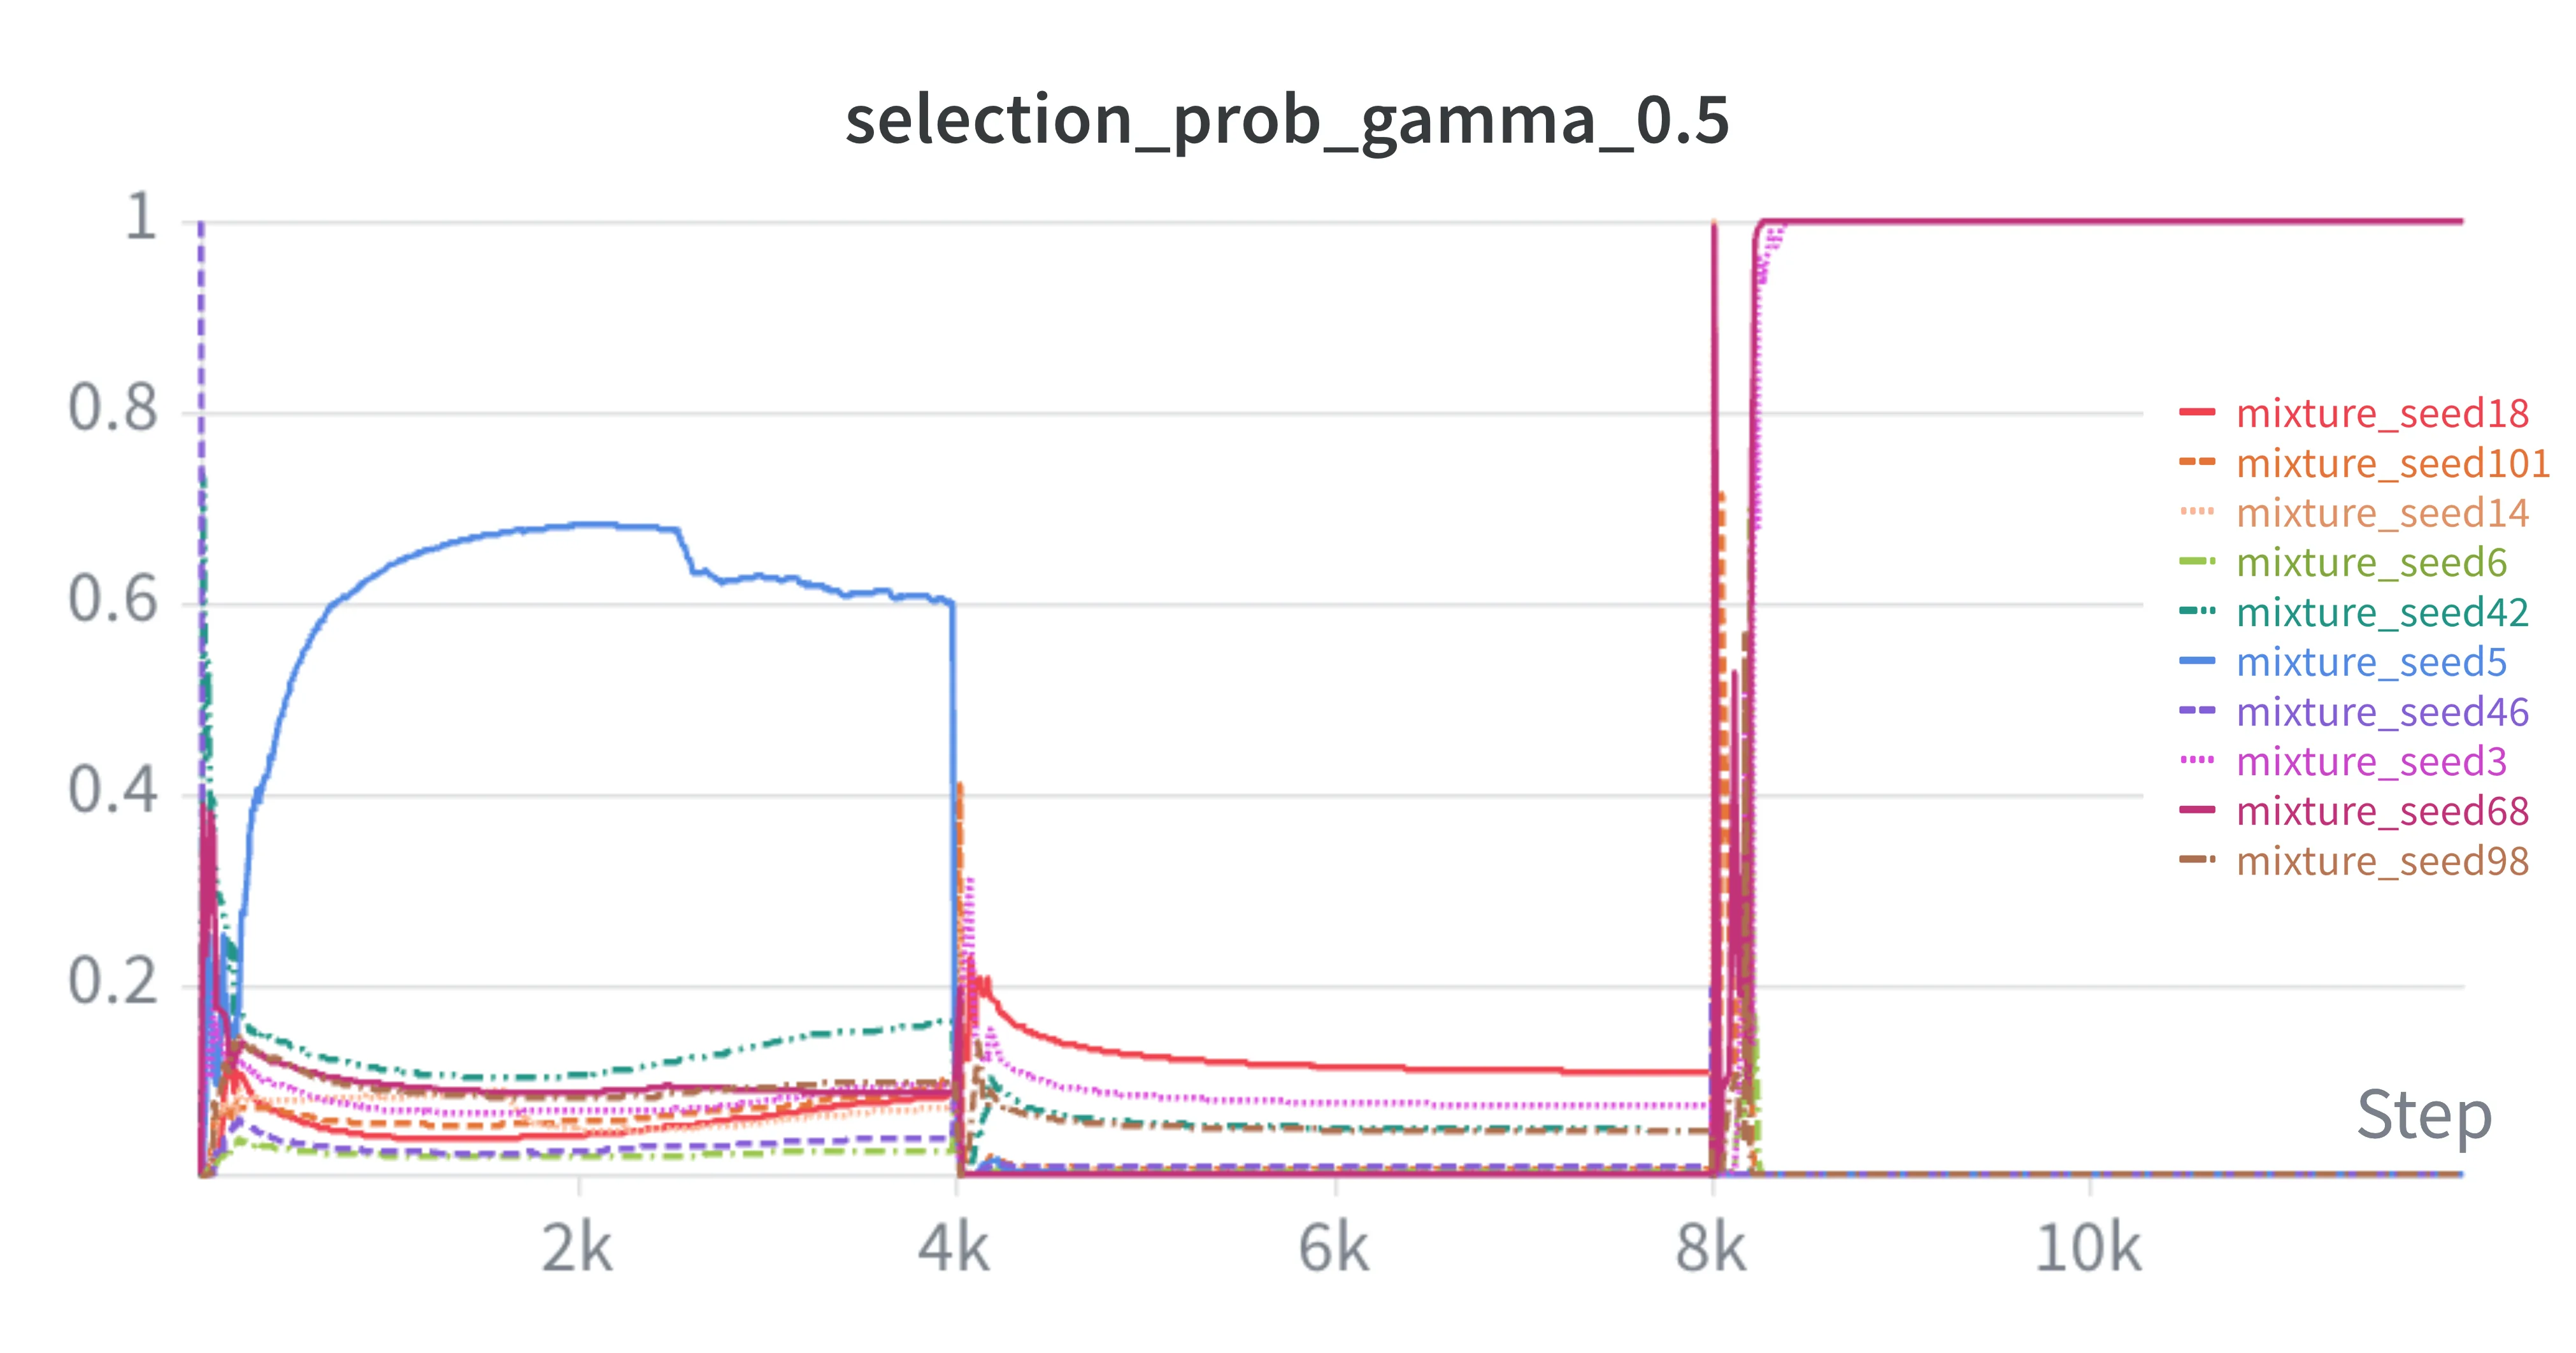
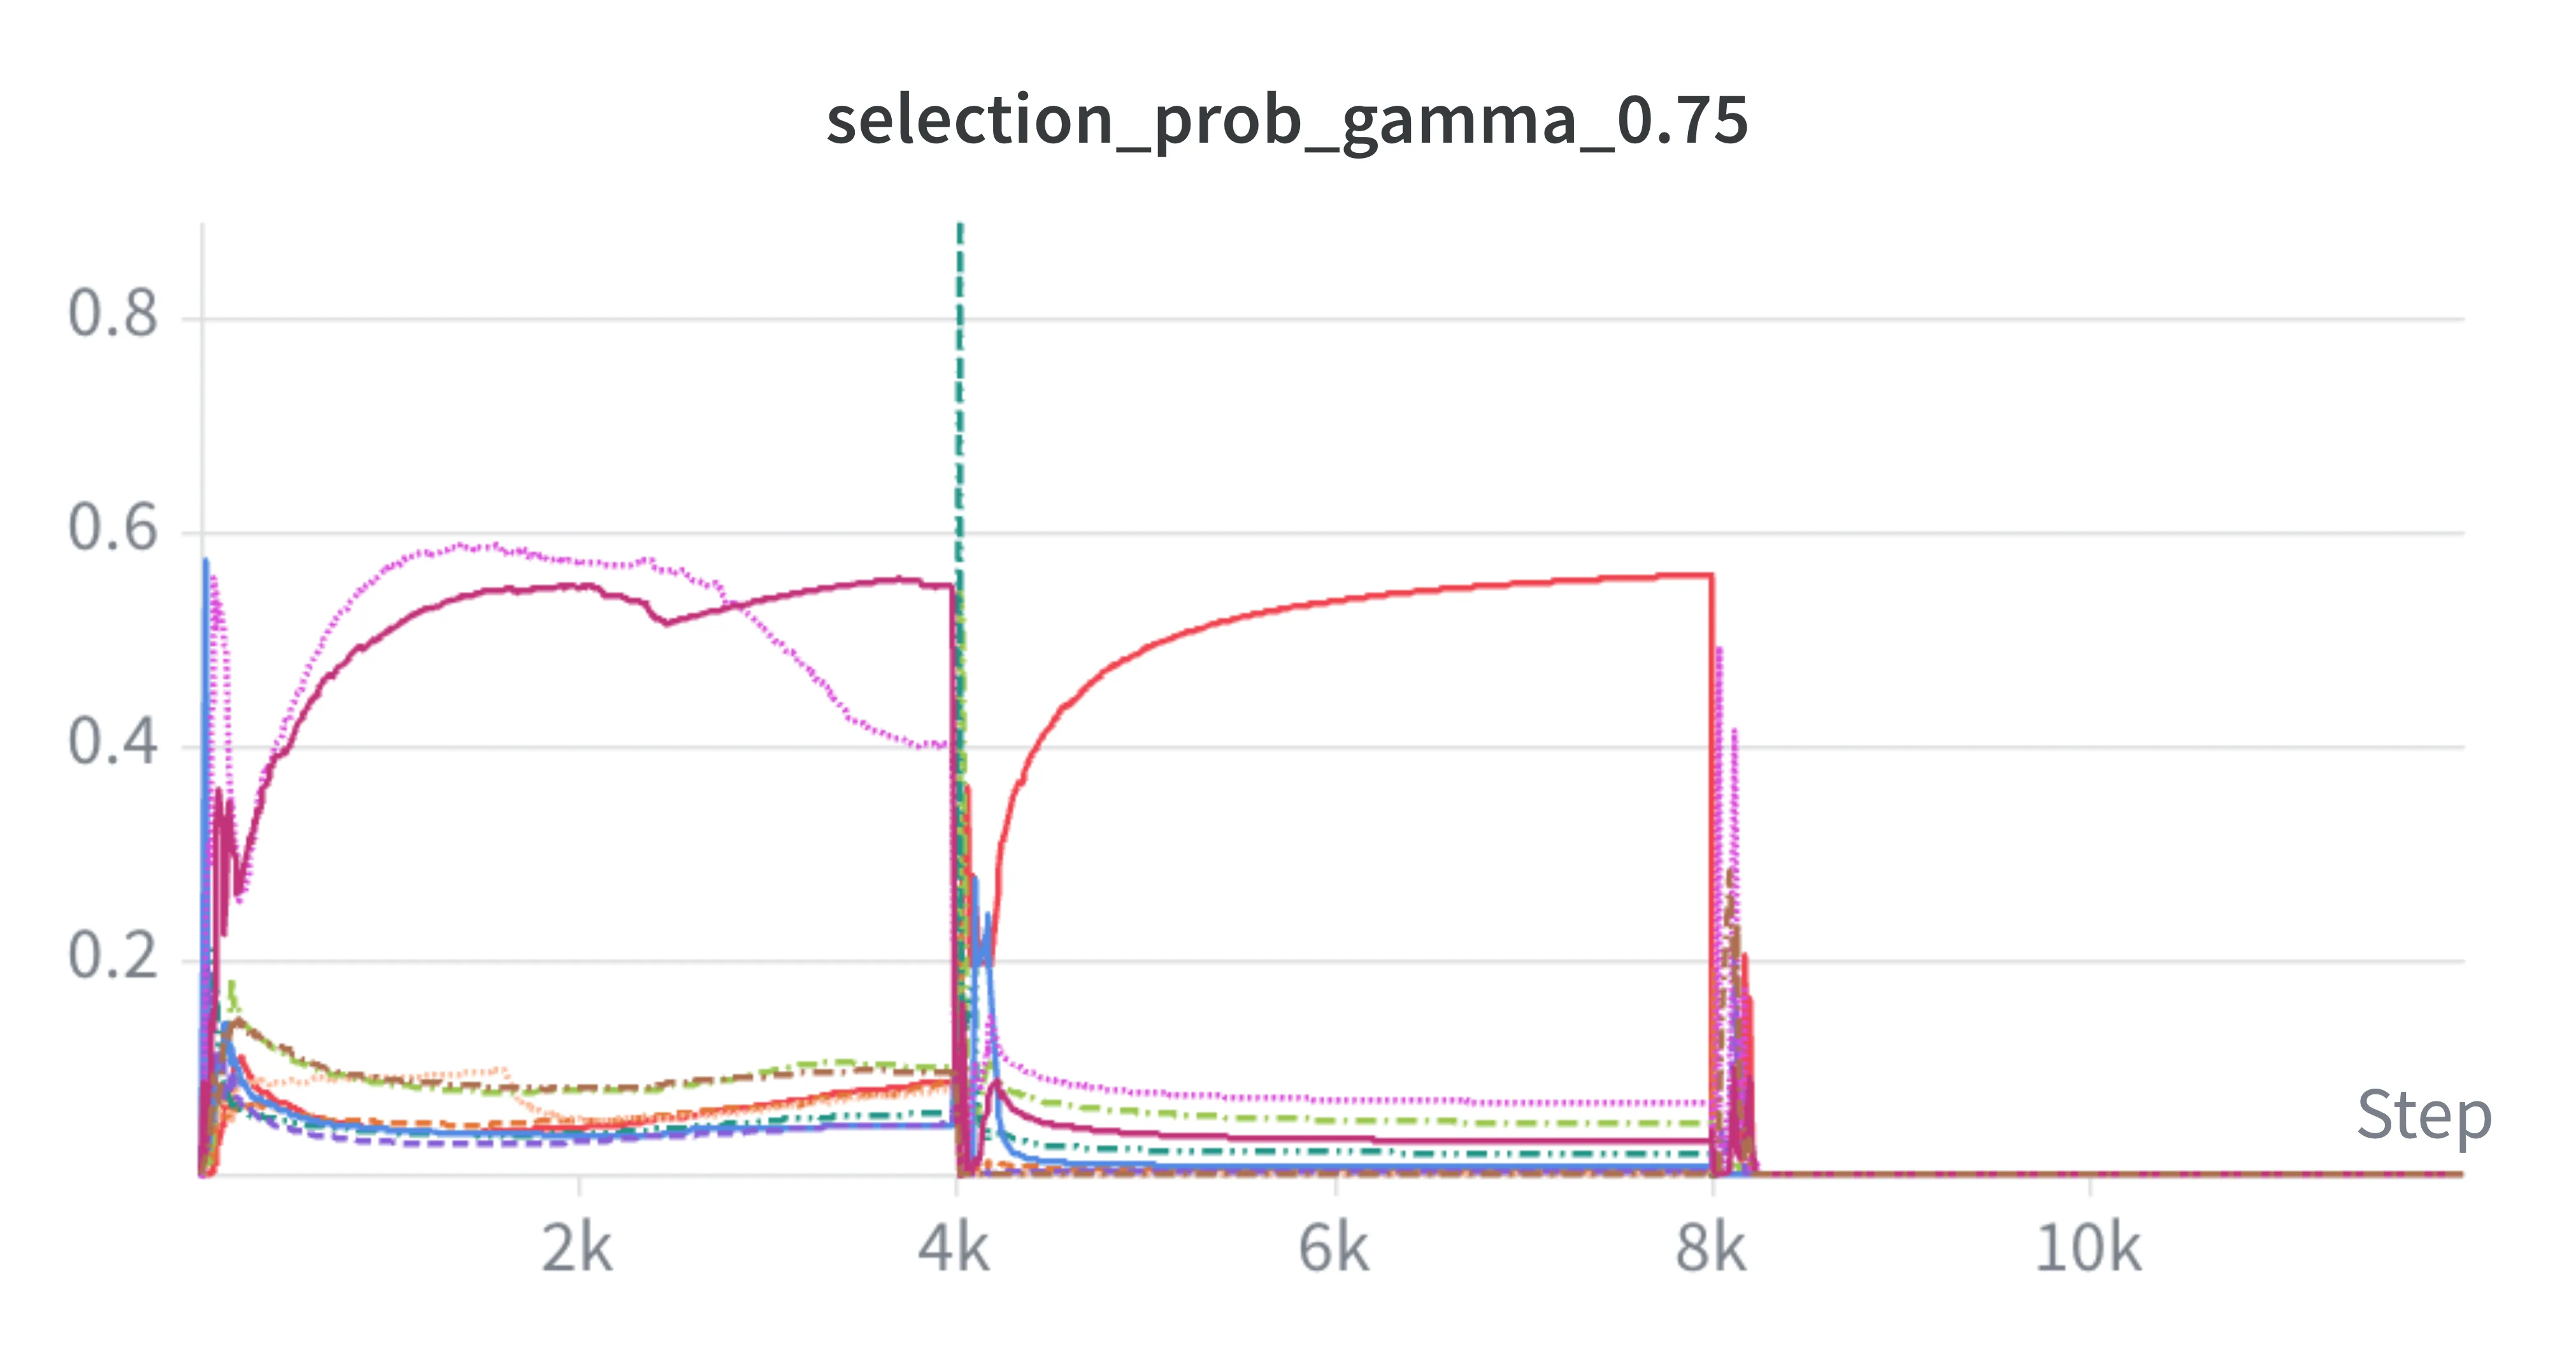
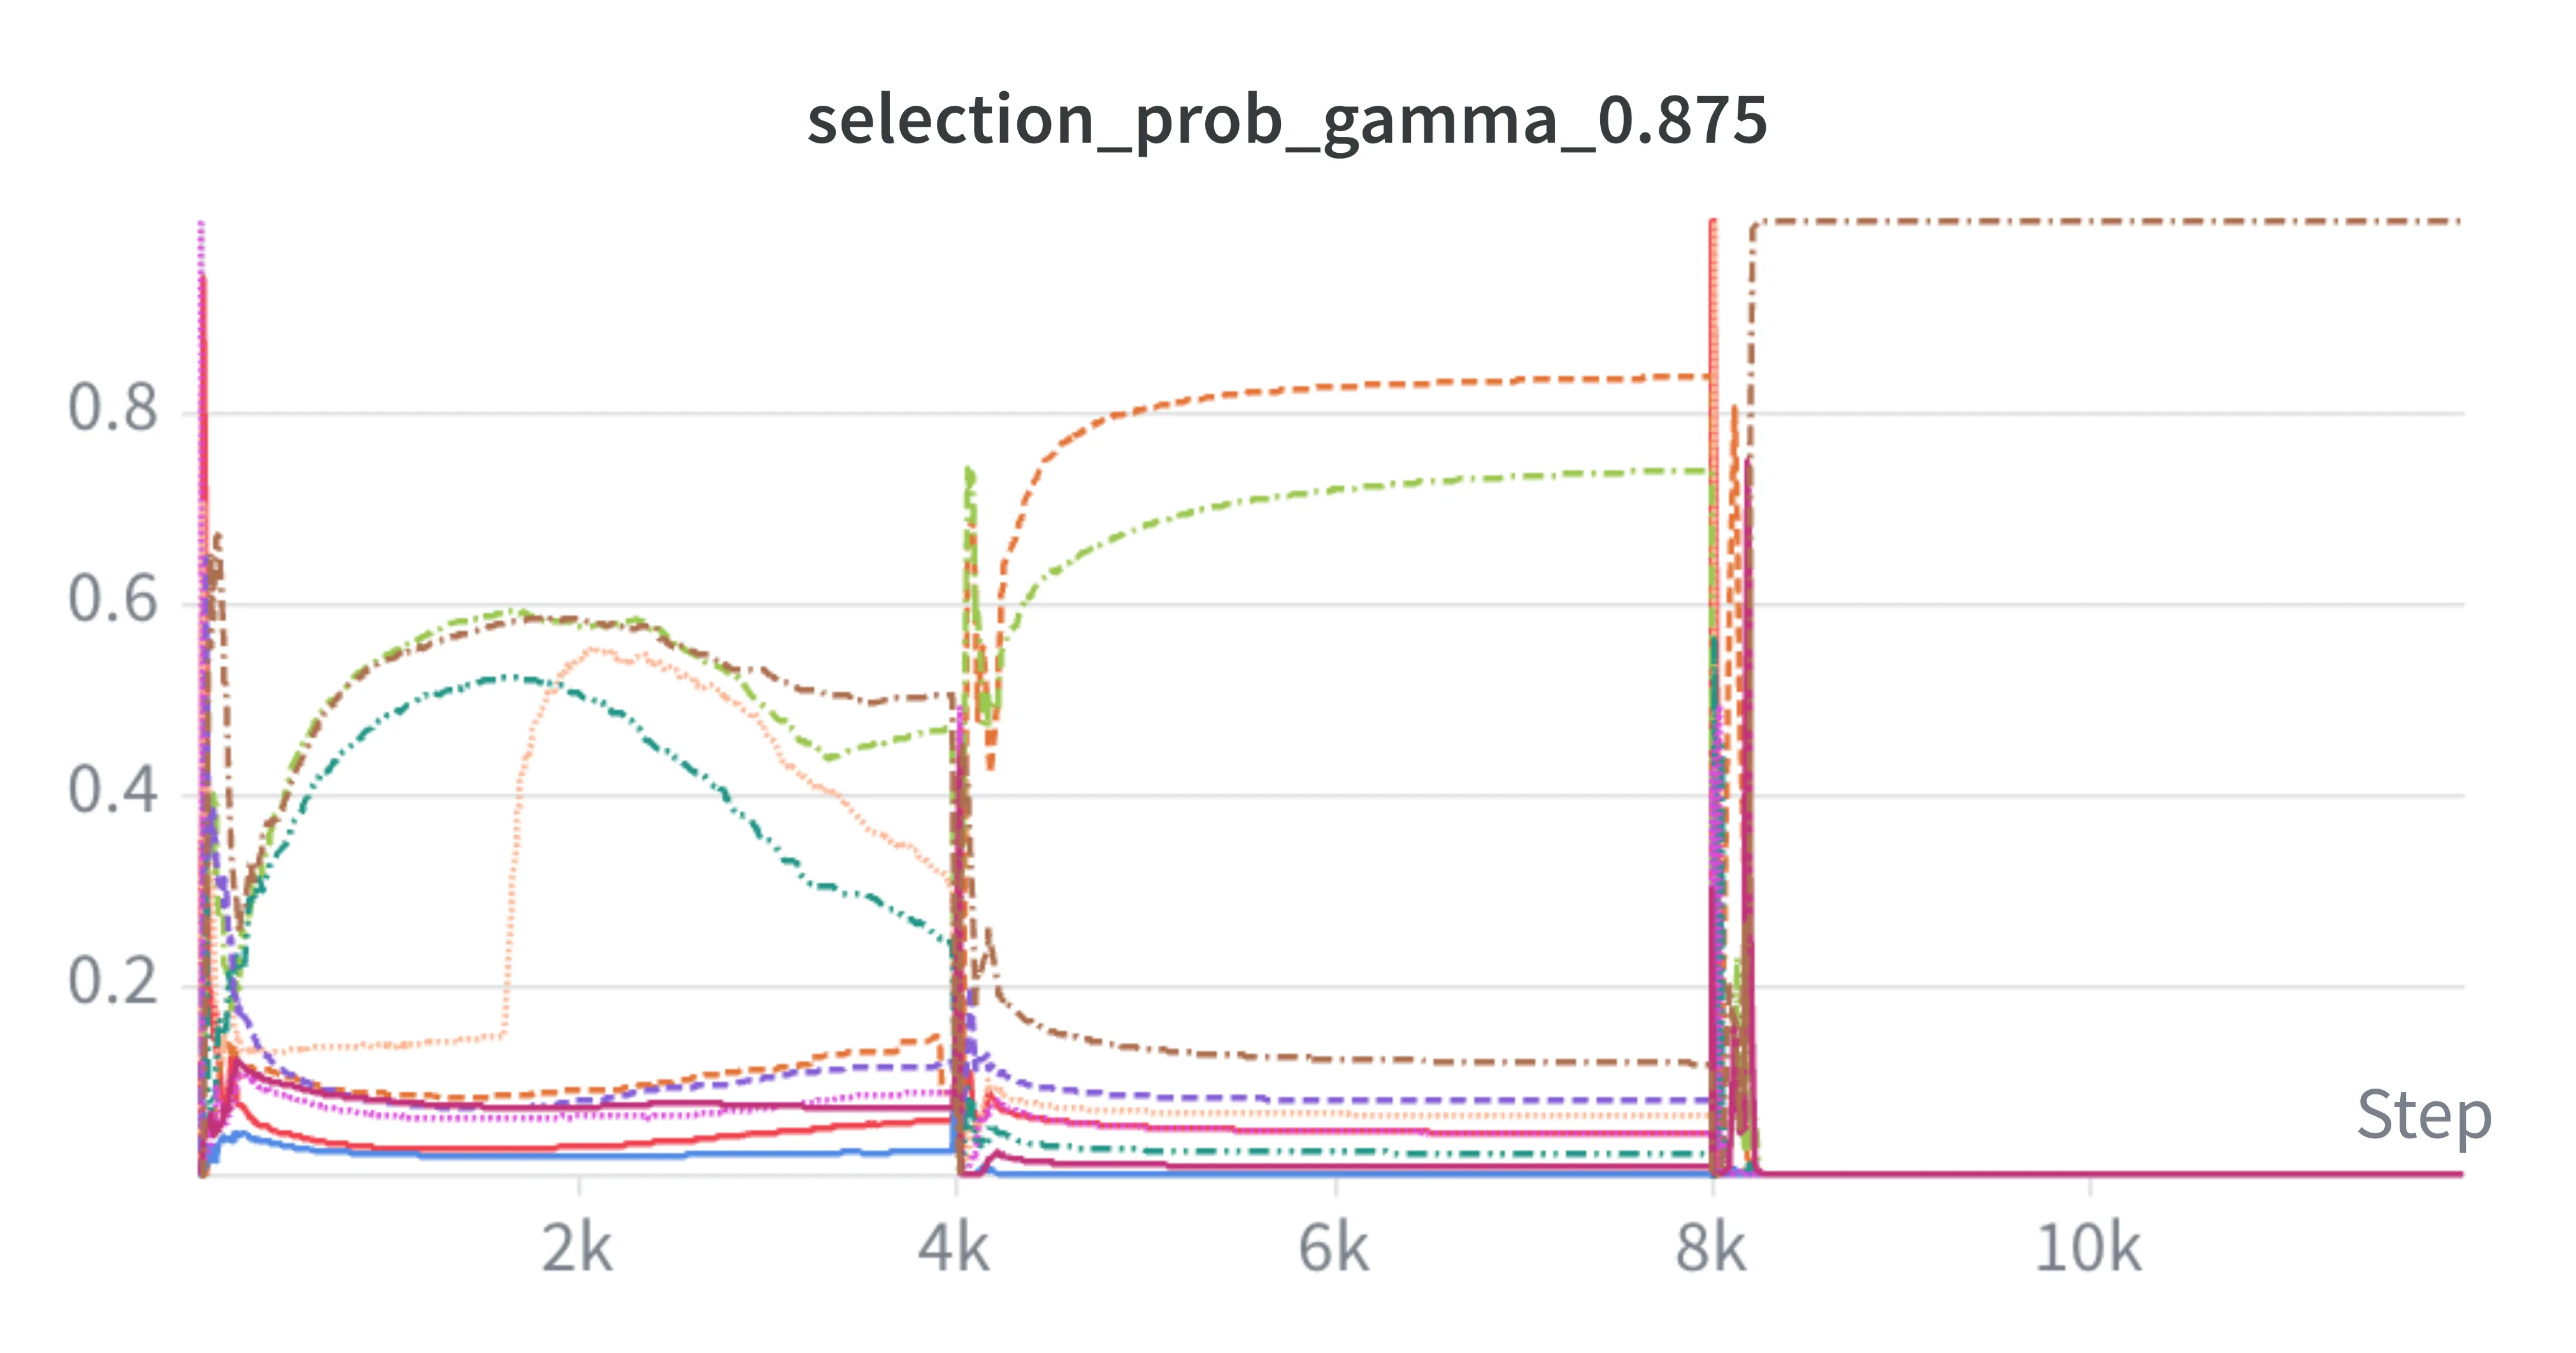
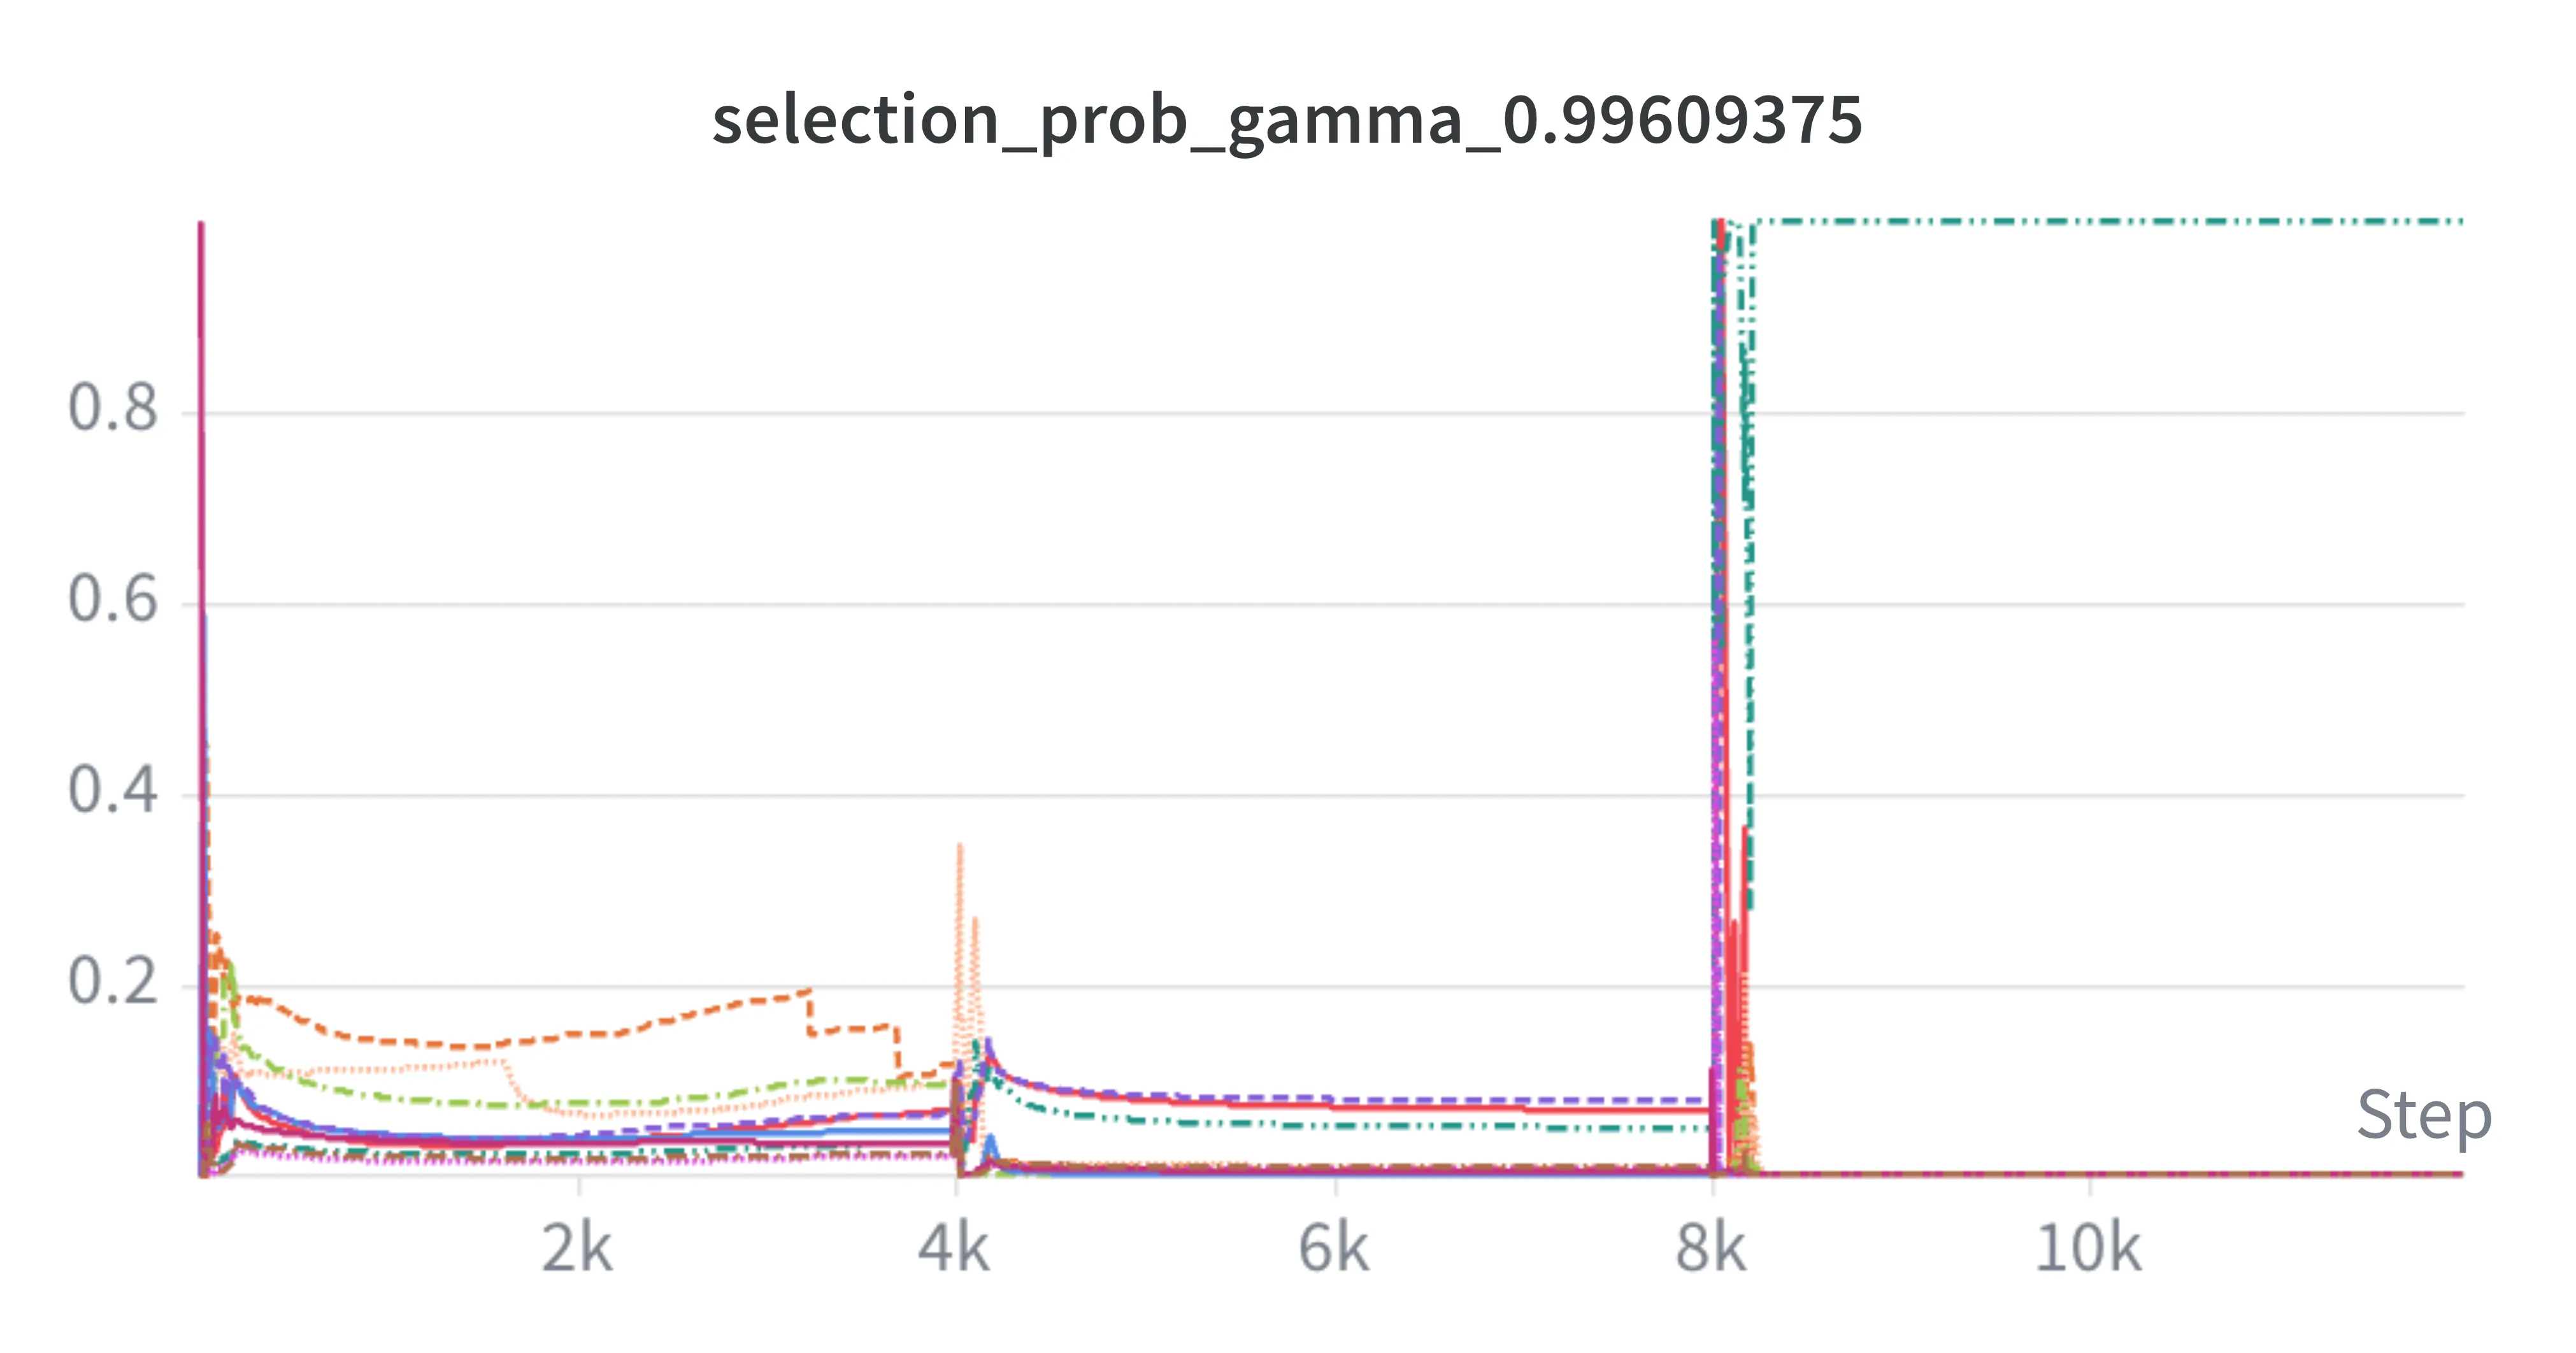
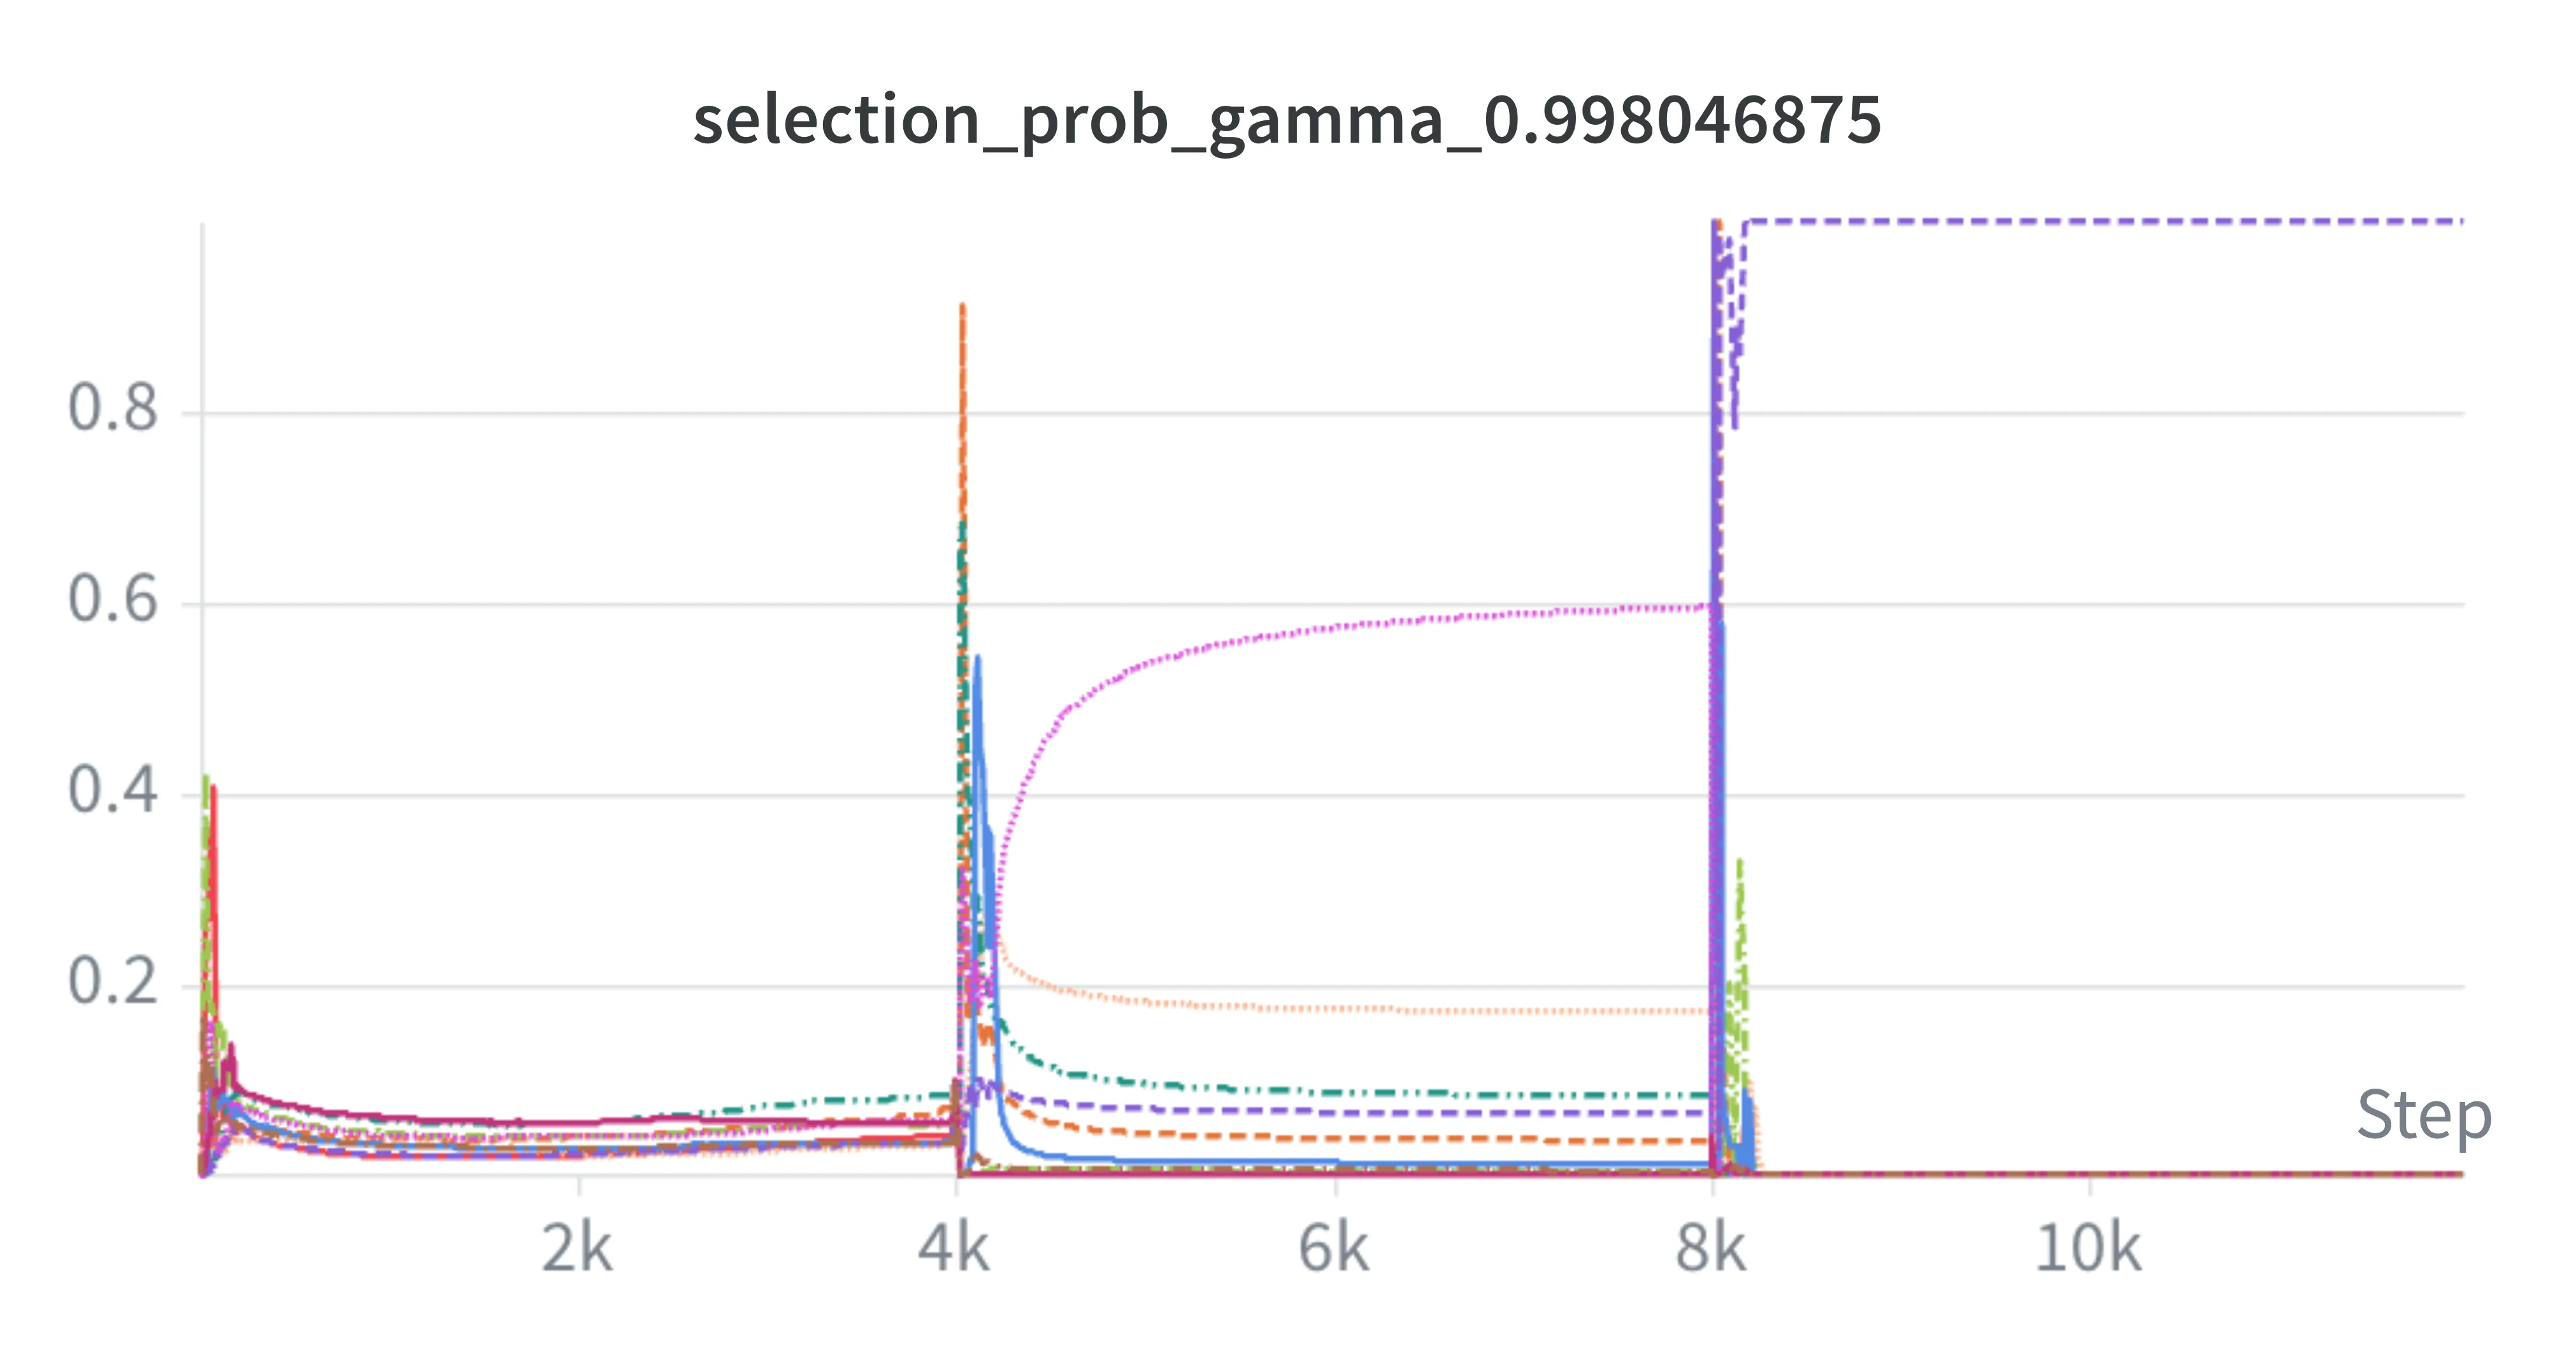
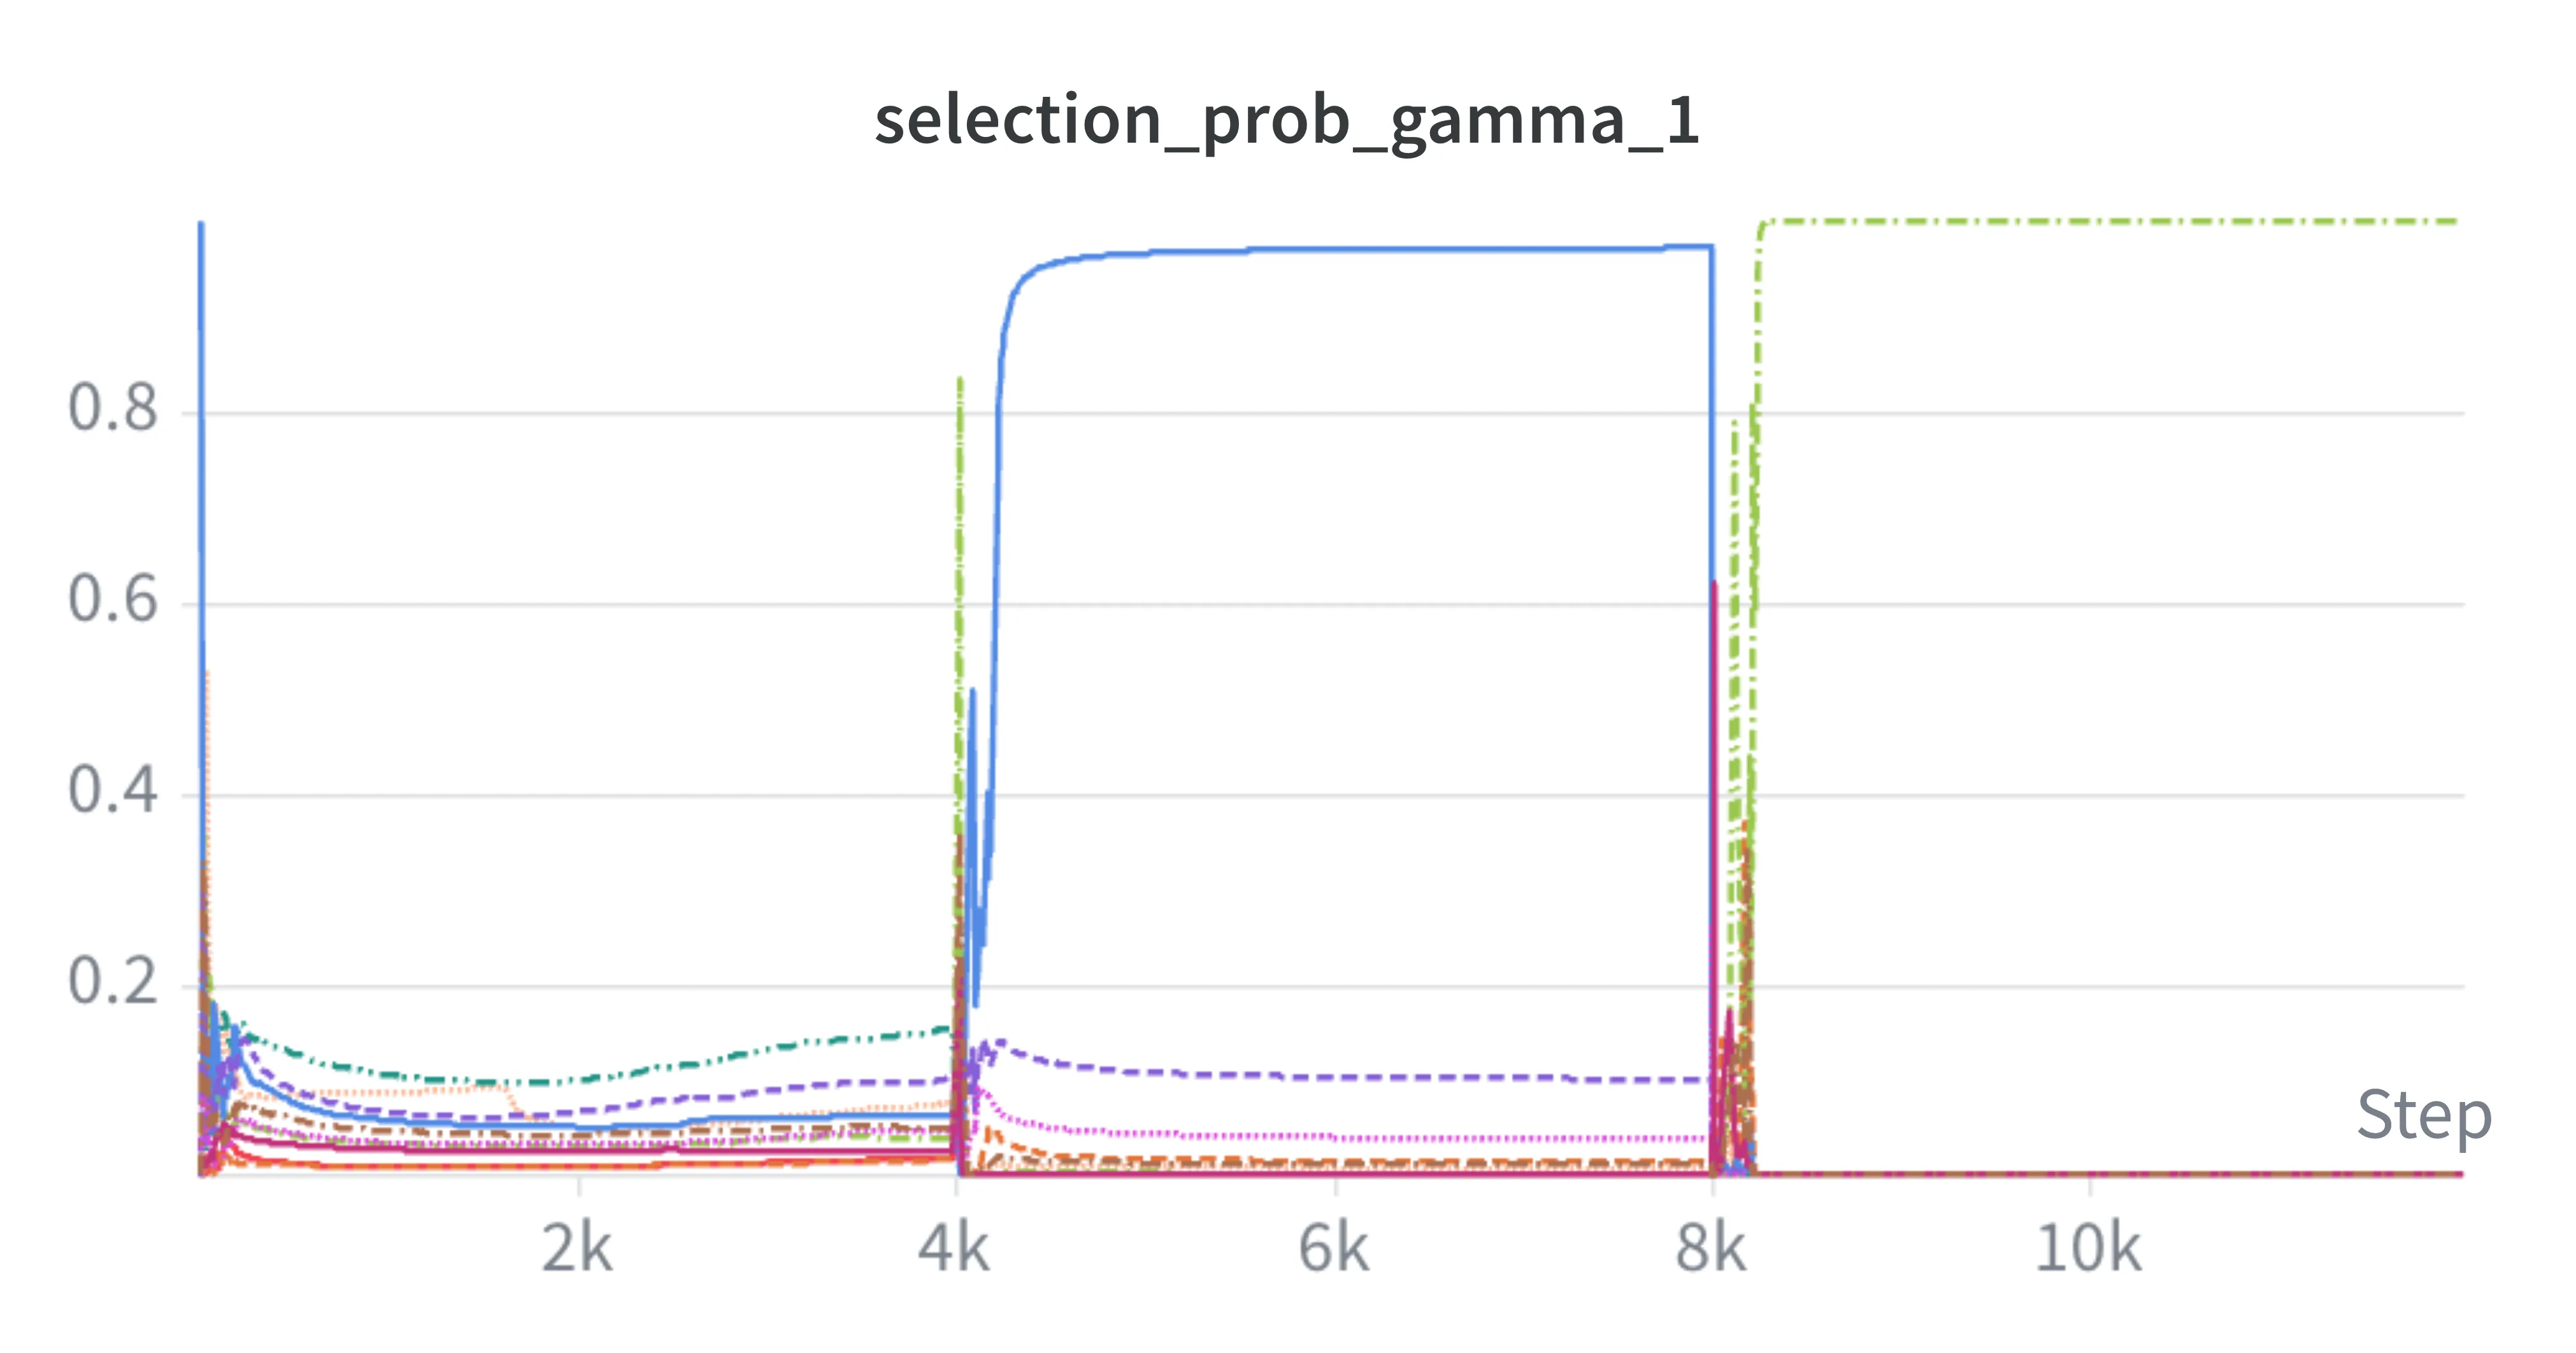
论文进一步证明了该方法的理论性质:在固定策略下,若某个折扣因子 是性能最优的,则训练过程中对应头的权重 将趋向于 1,其他权重趋向于 0。这意味着混合网络本质上在学习为当前状态选择最合适的时间视野。
直觉上,这种设计与人类决策的双过程理论相呼应:快速的「直觉」头捕捉短视但即时的反馈,而深谋远虑的头则积累长期信号,混合网络则根据当前情境决定两者的相对话语权。
实验与结果
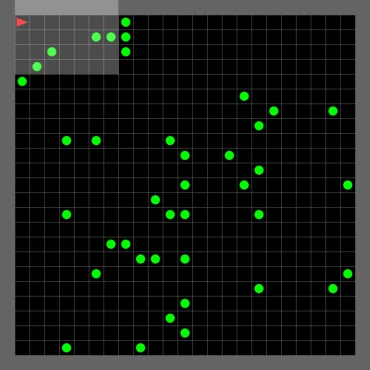
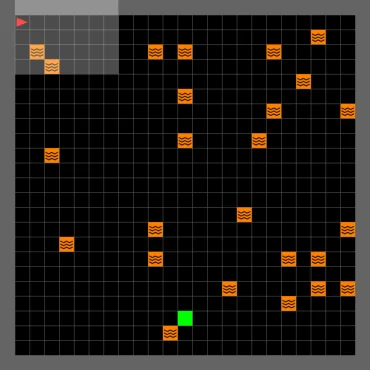
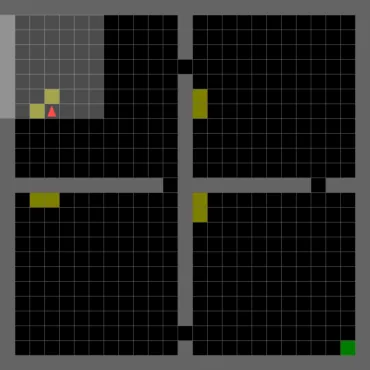
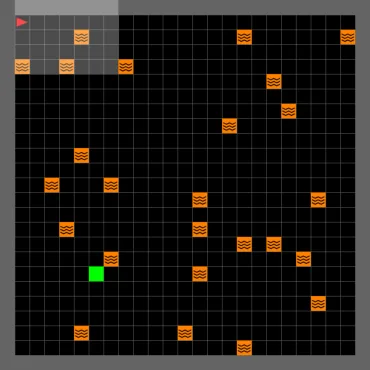
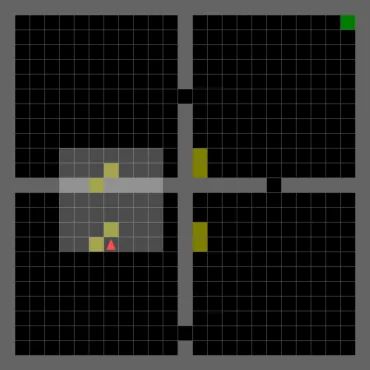
实验在 MiniGrid 系列的离散网格世界环境中进行,涵盖多种关卡配置以测试方法在不同任务要求下的适应性。
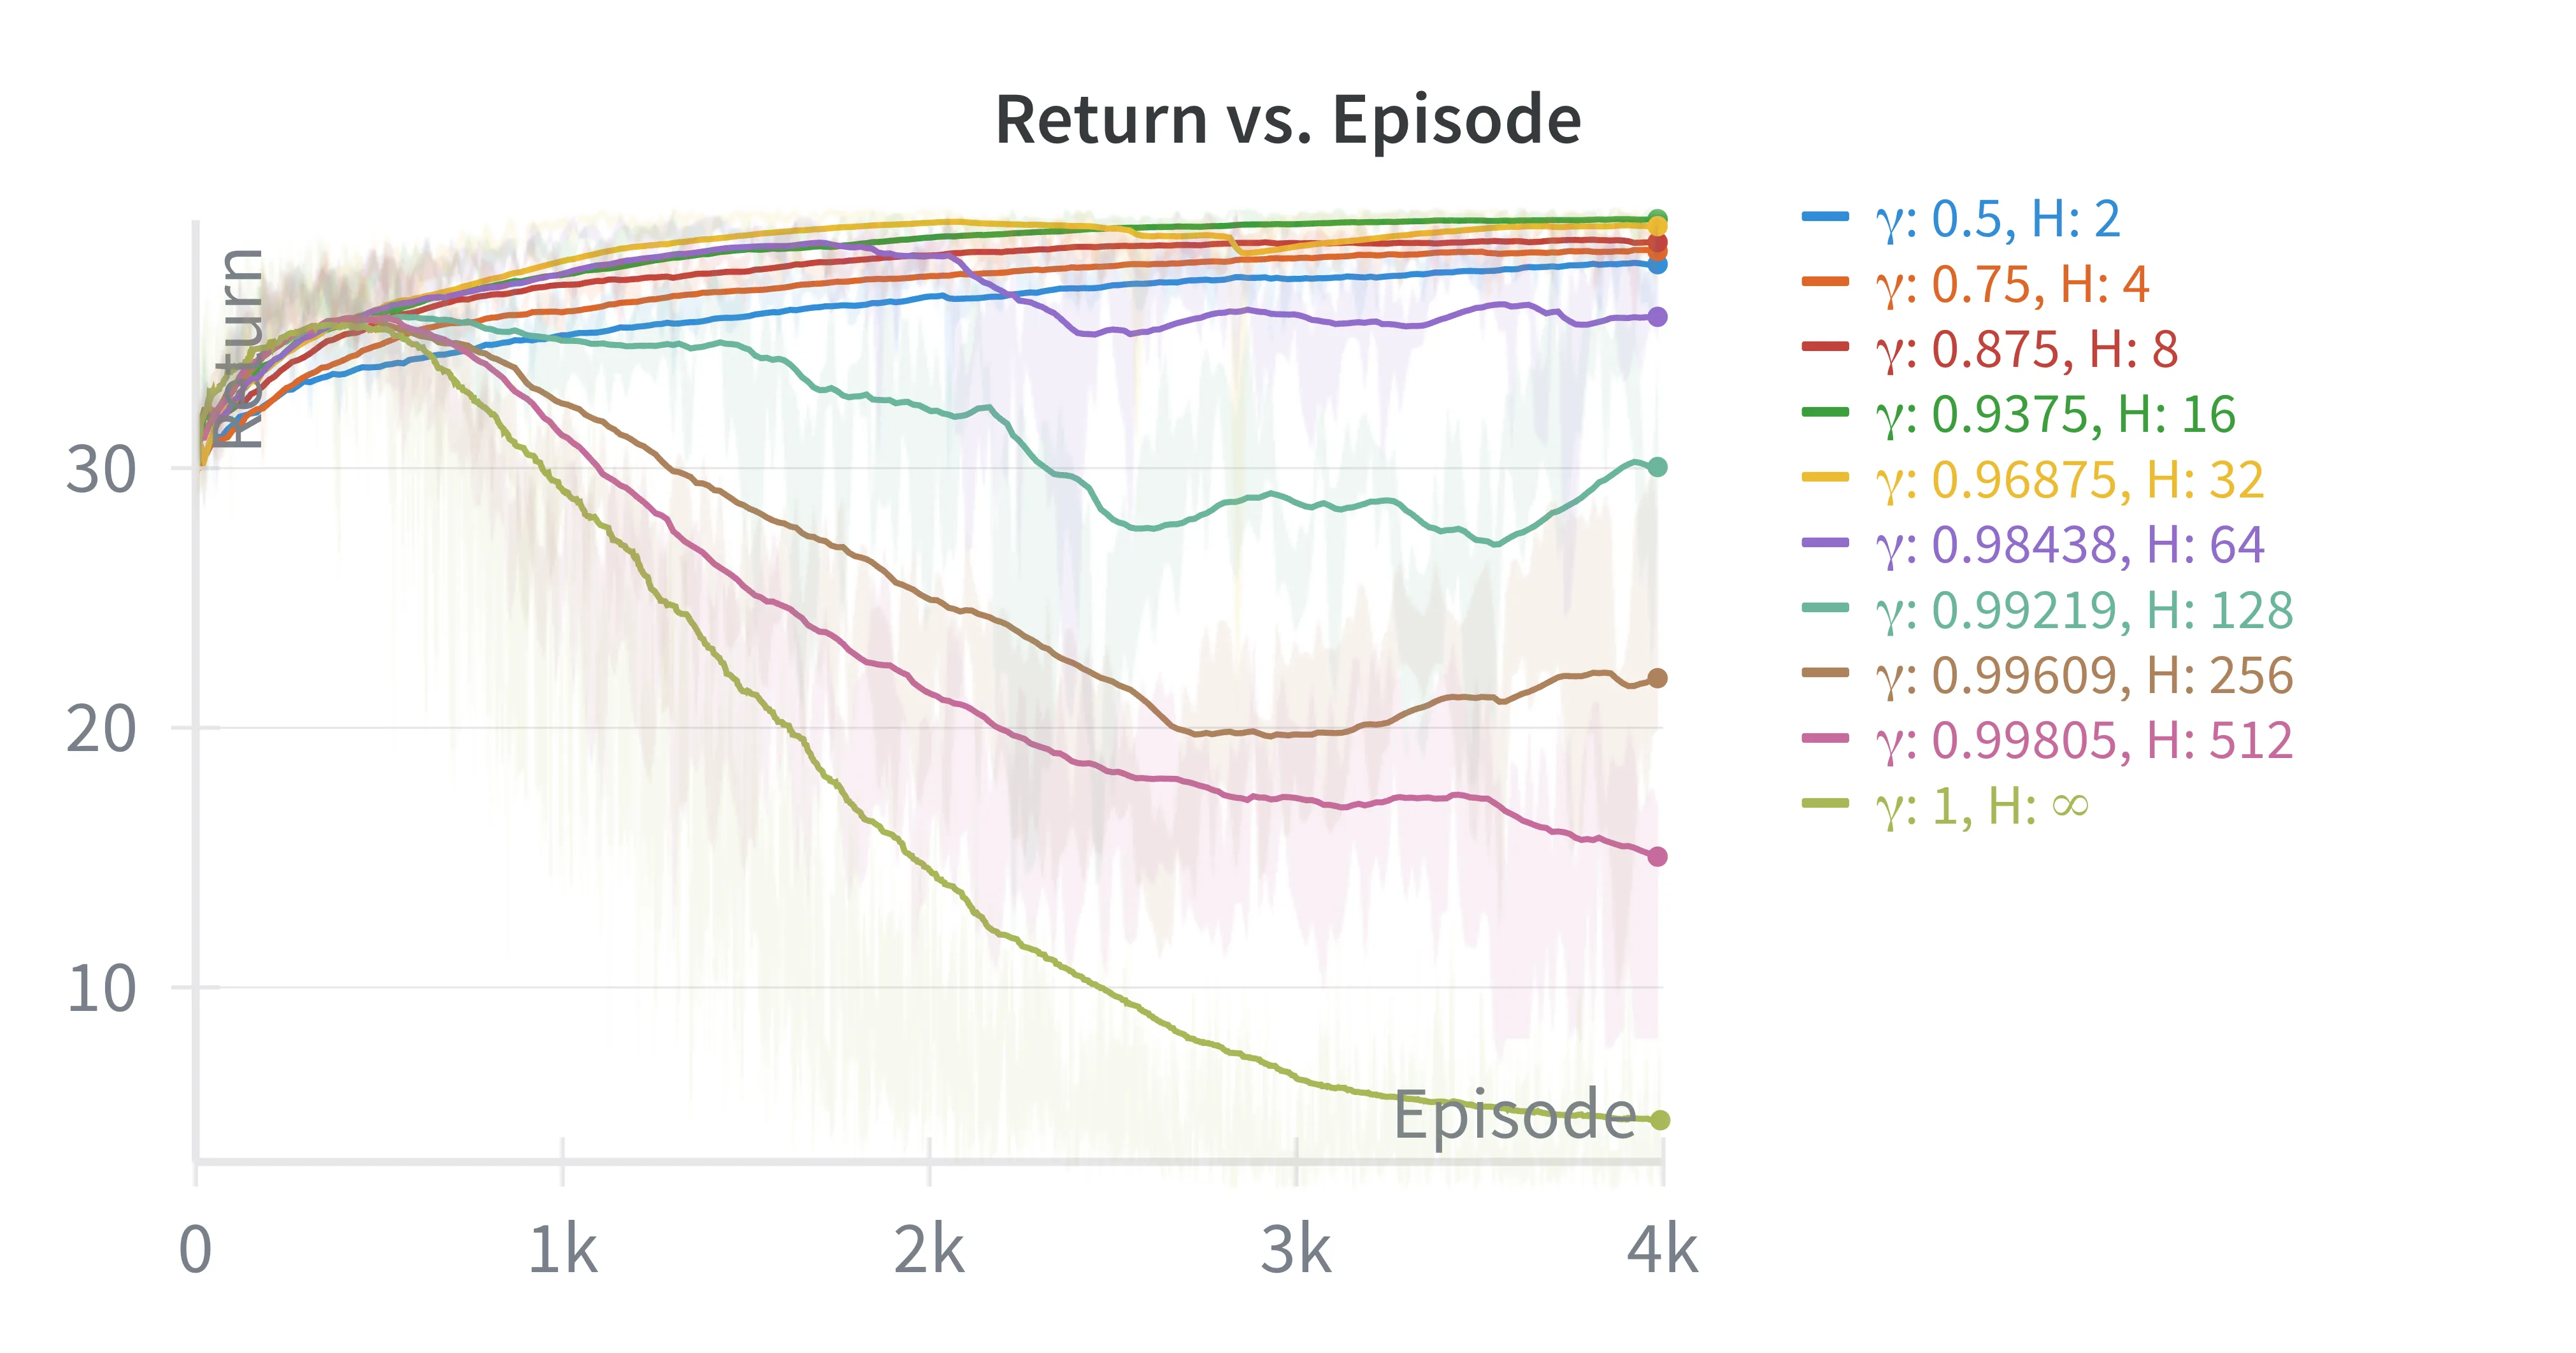
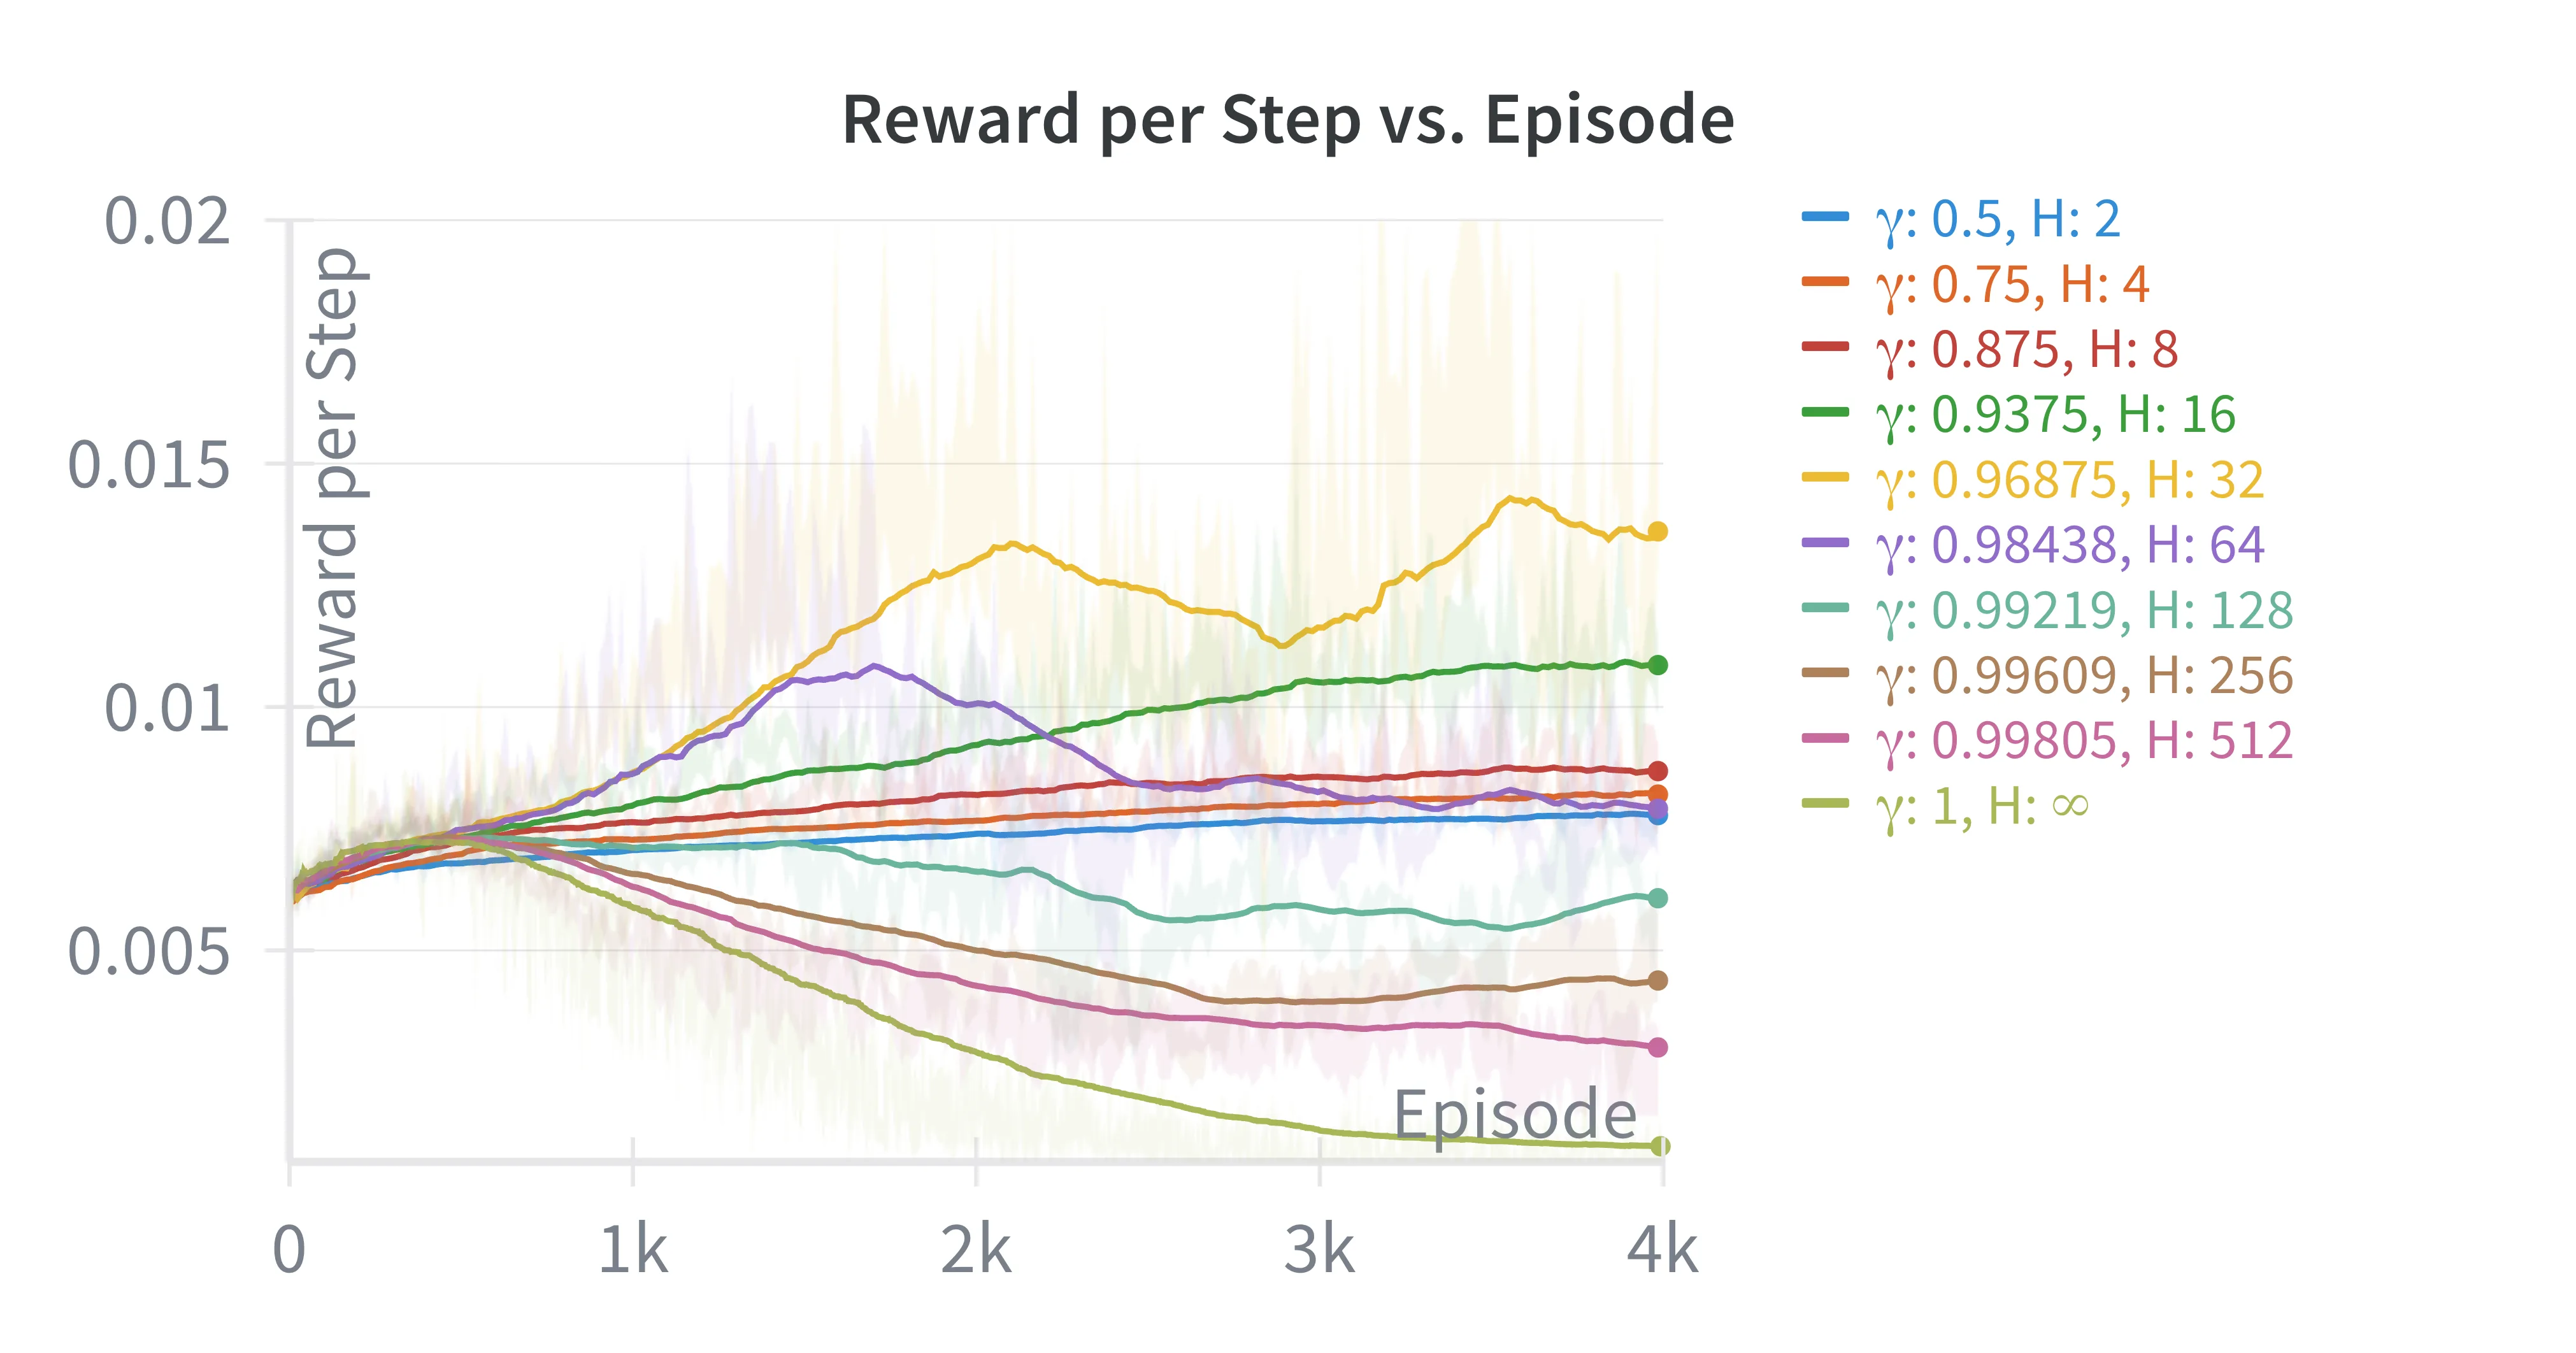
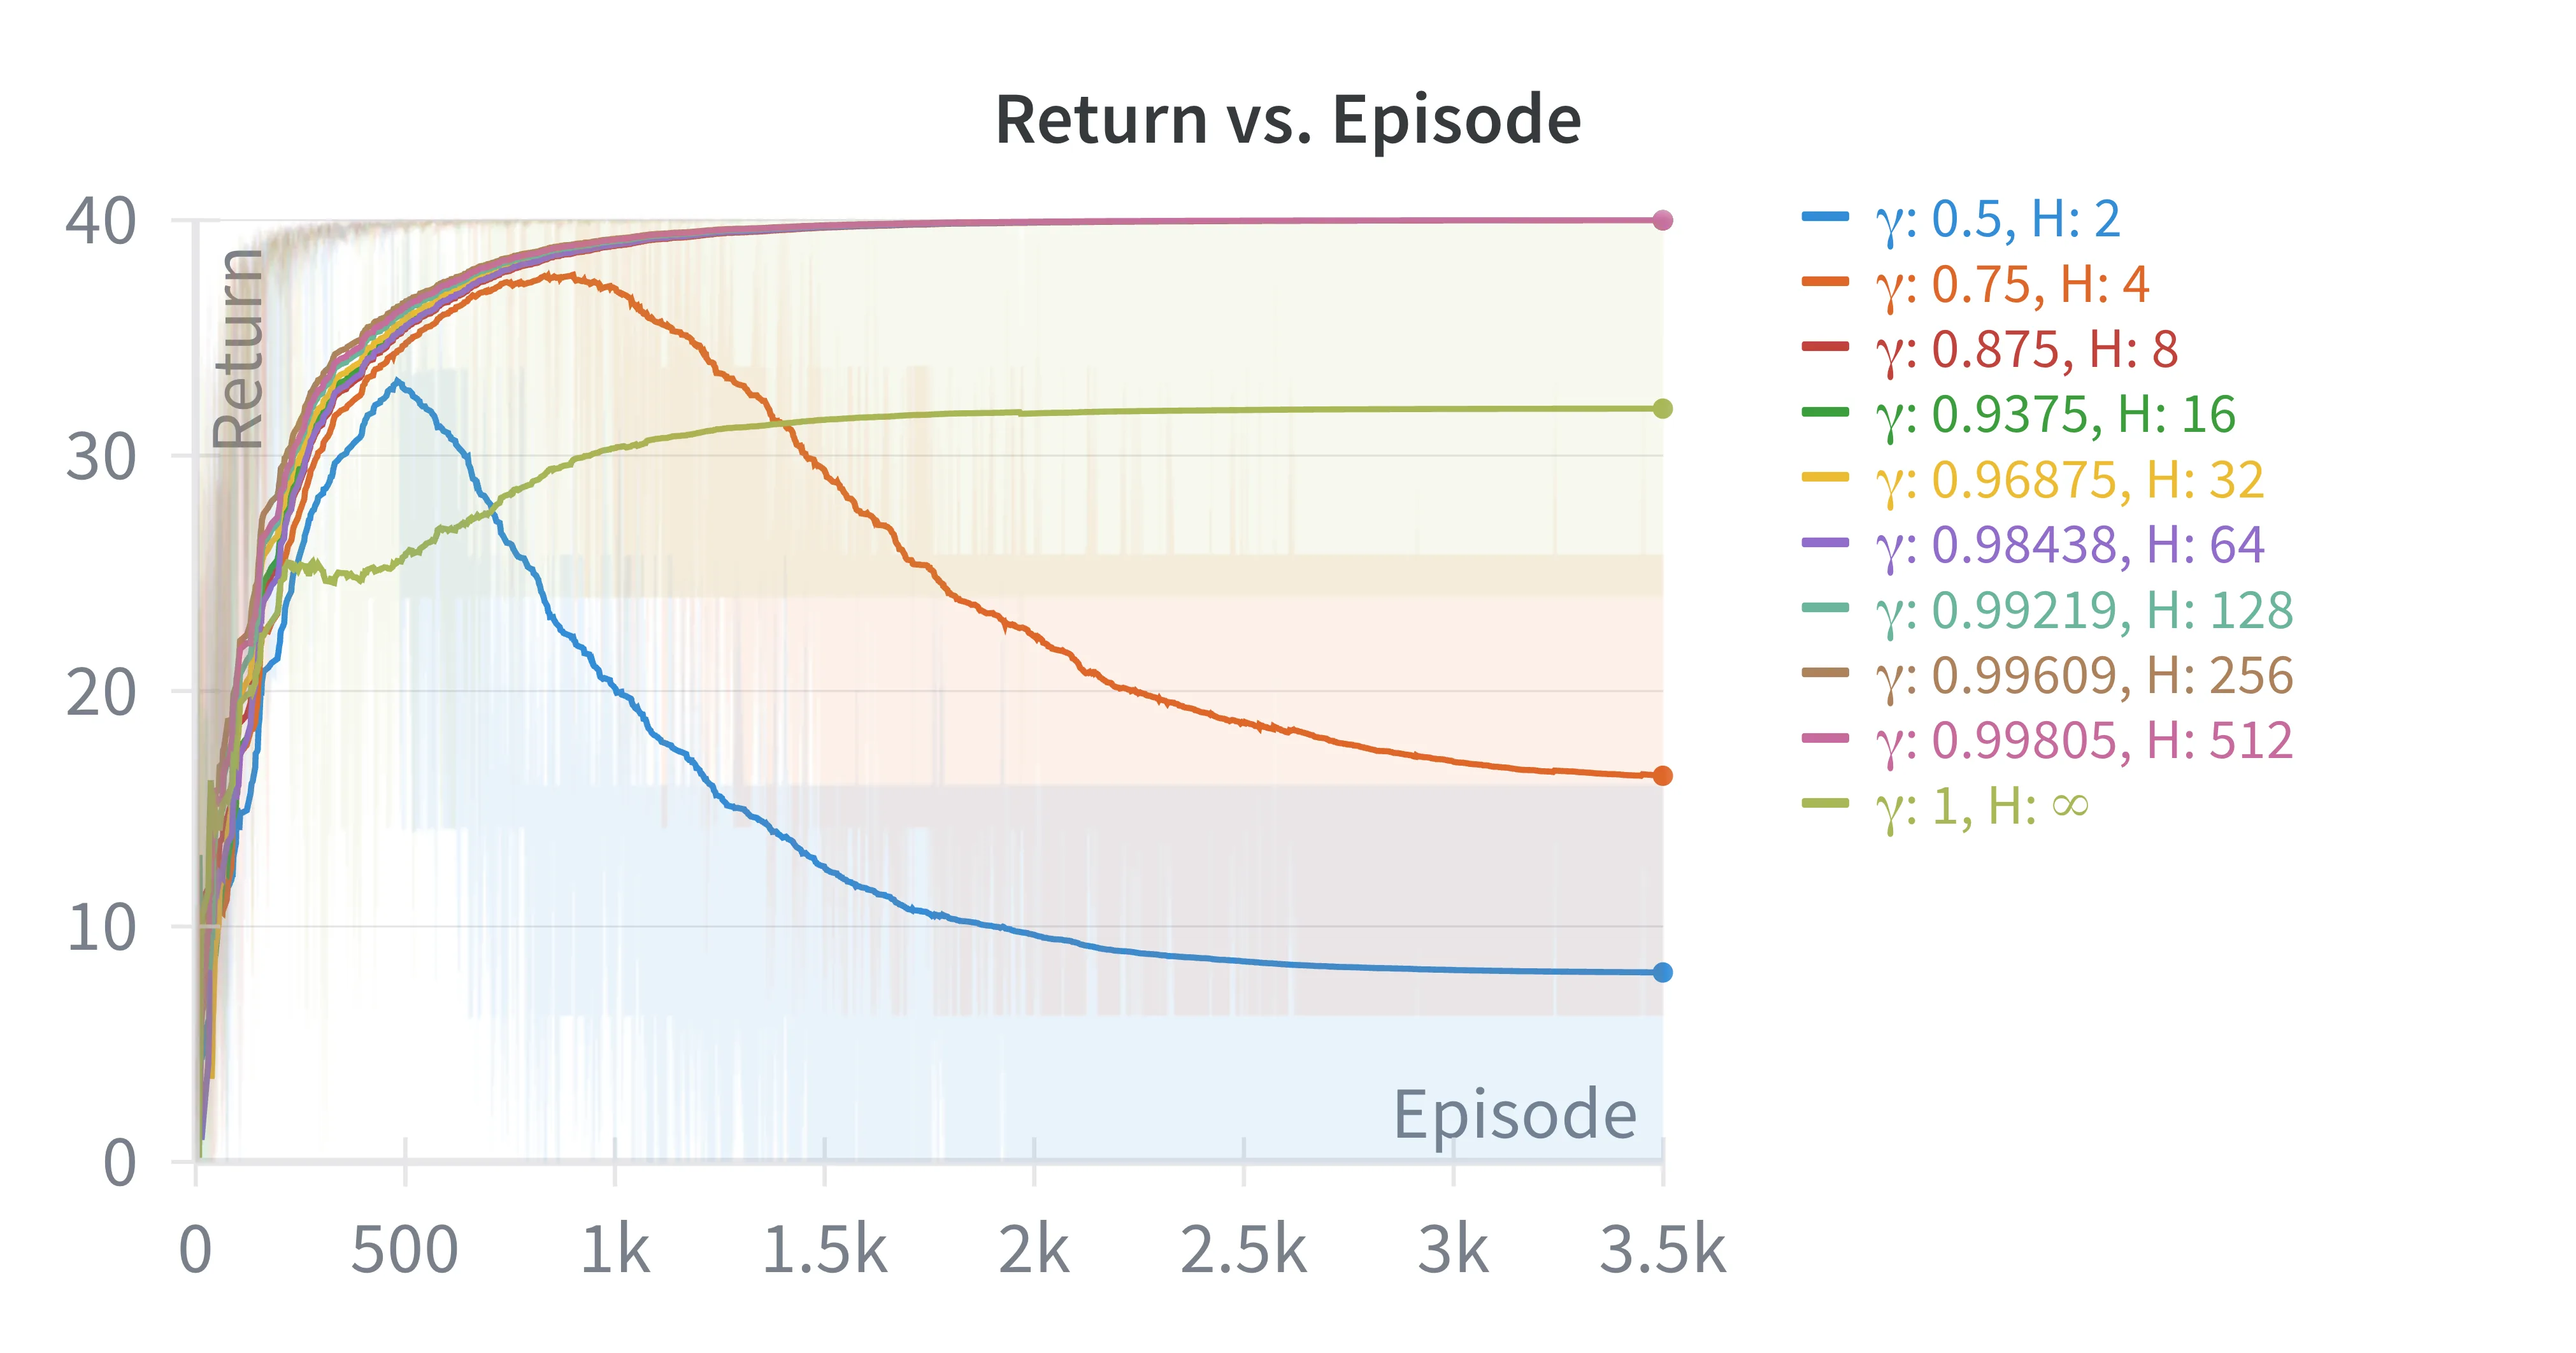
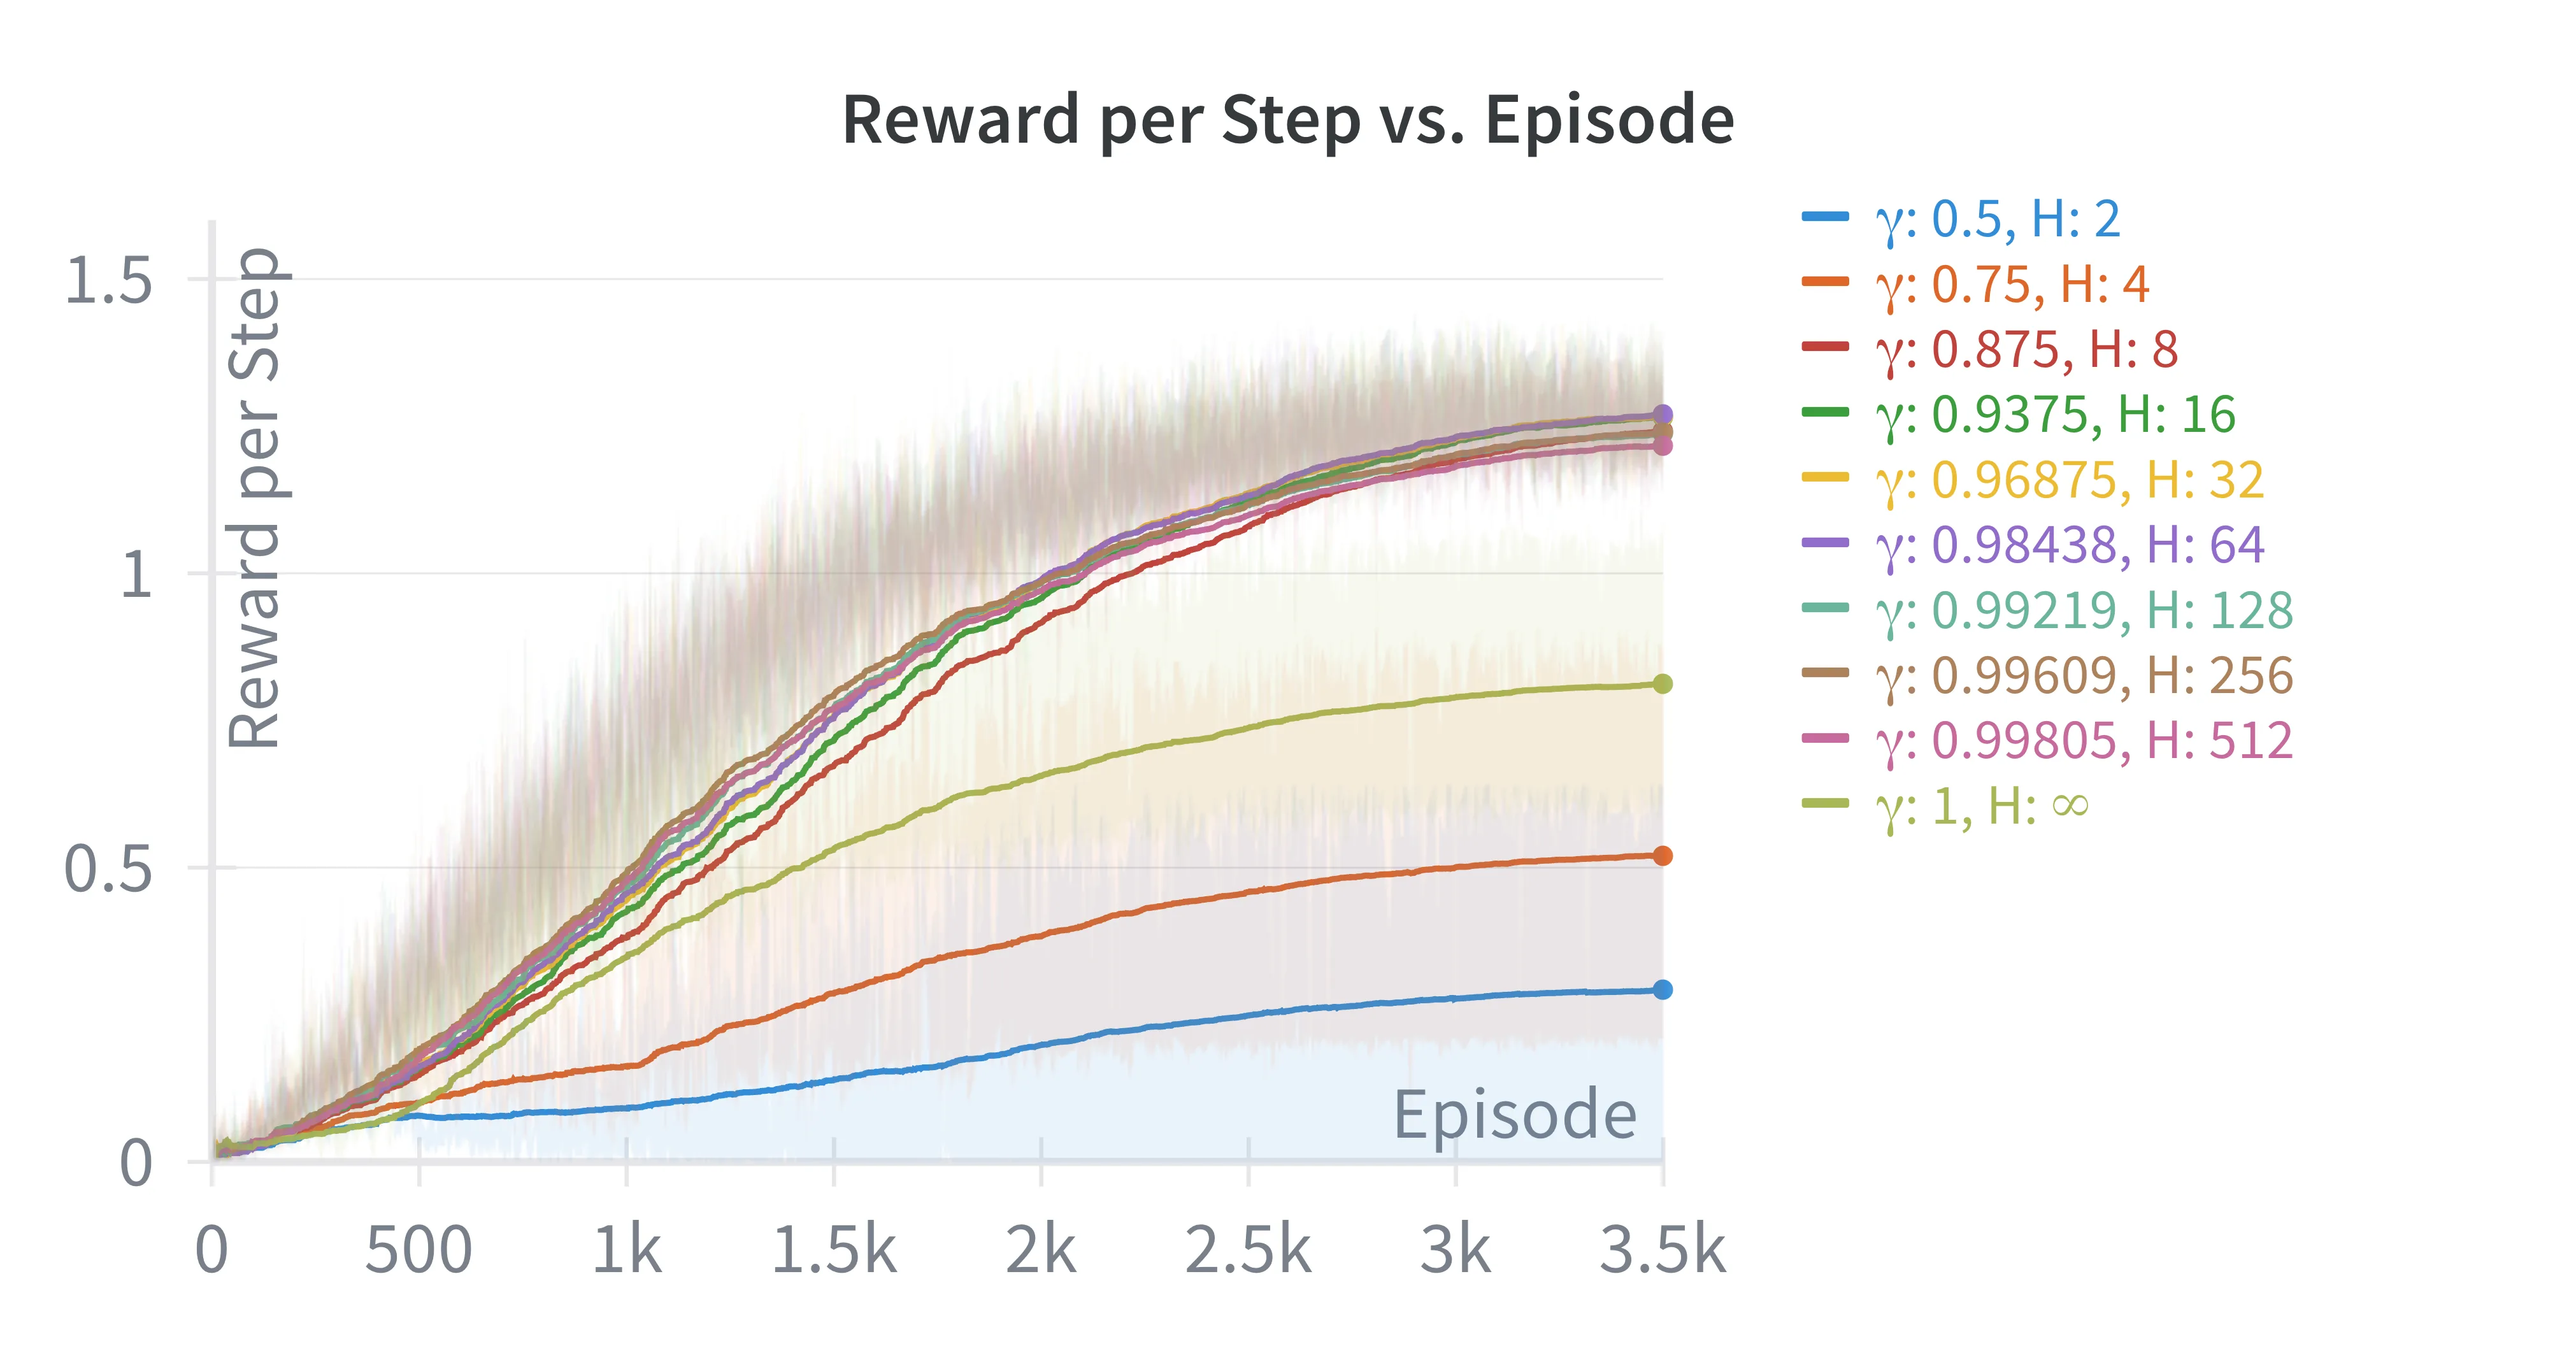
在标准 RL 任务中,论文对比了自适应多视野方法与固定 的多种取值。结果显示,多视野方法能够自动识别出在该环境中表现最优的时间折扣因子对应的头,并赋予其主导权重,而无需任何关于最优 的先验知识。相比之下,固定 方法需要在部署前进行耗时的网格搜索,且一旦任务变化就需要重新调参。
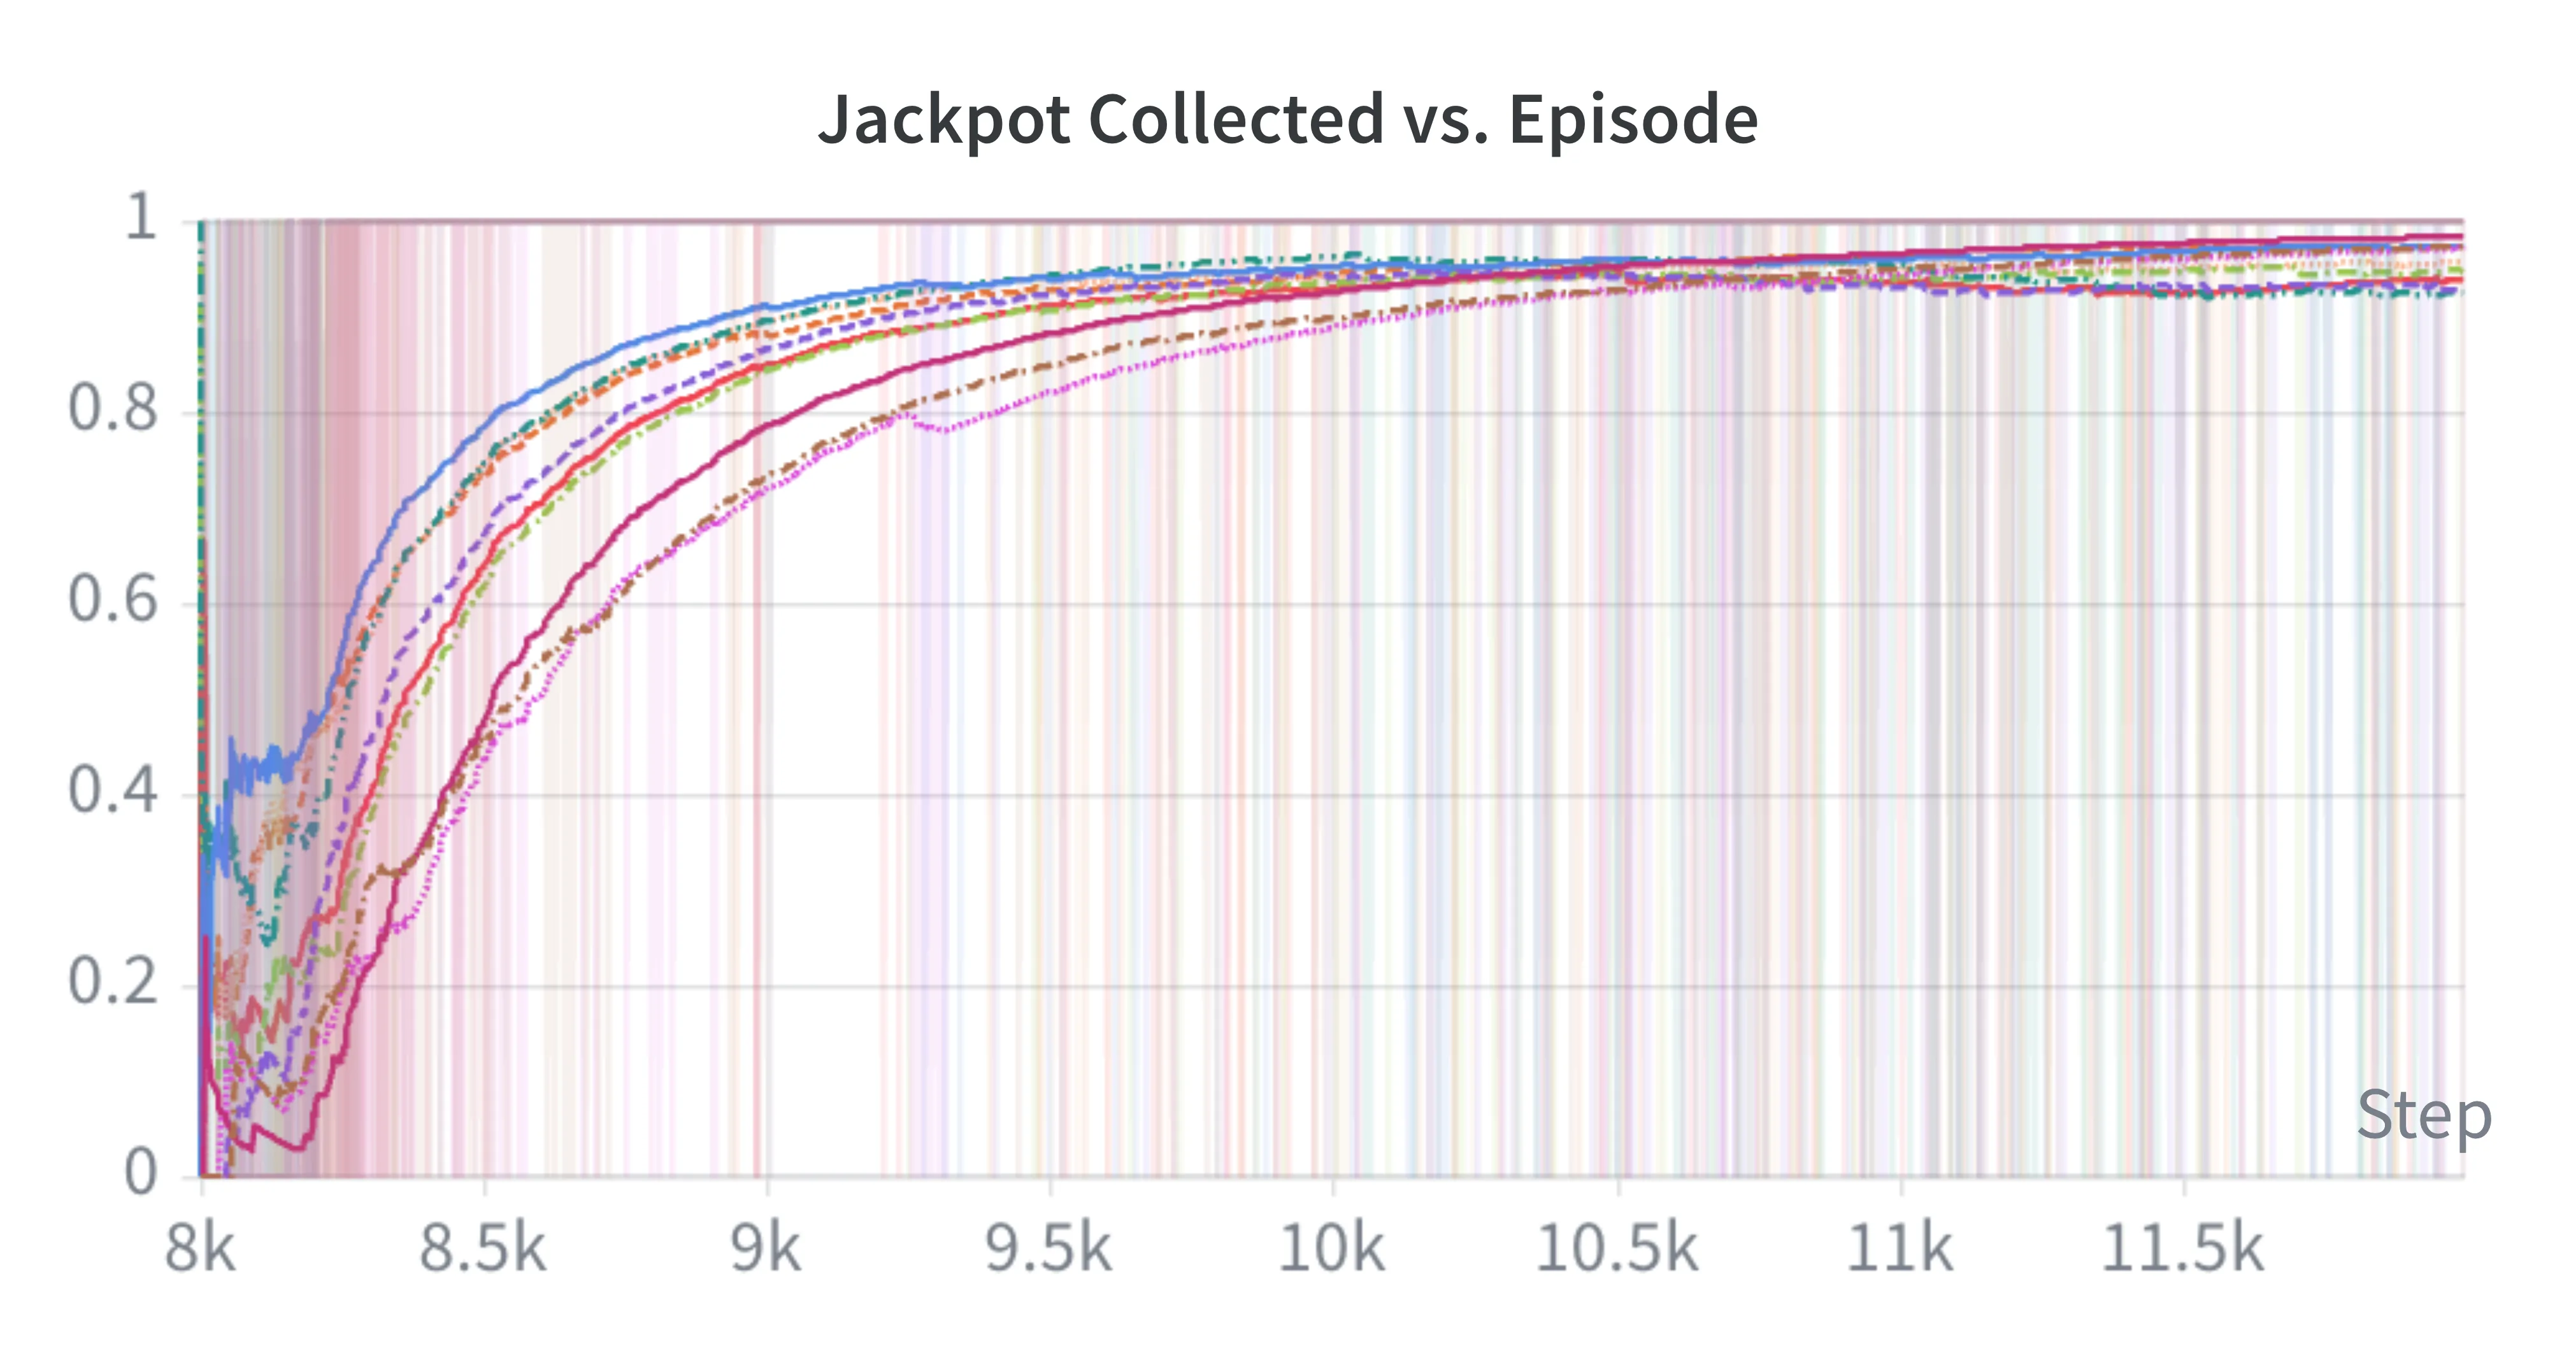
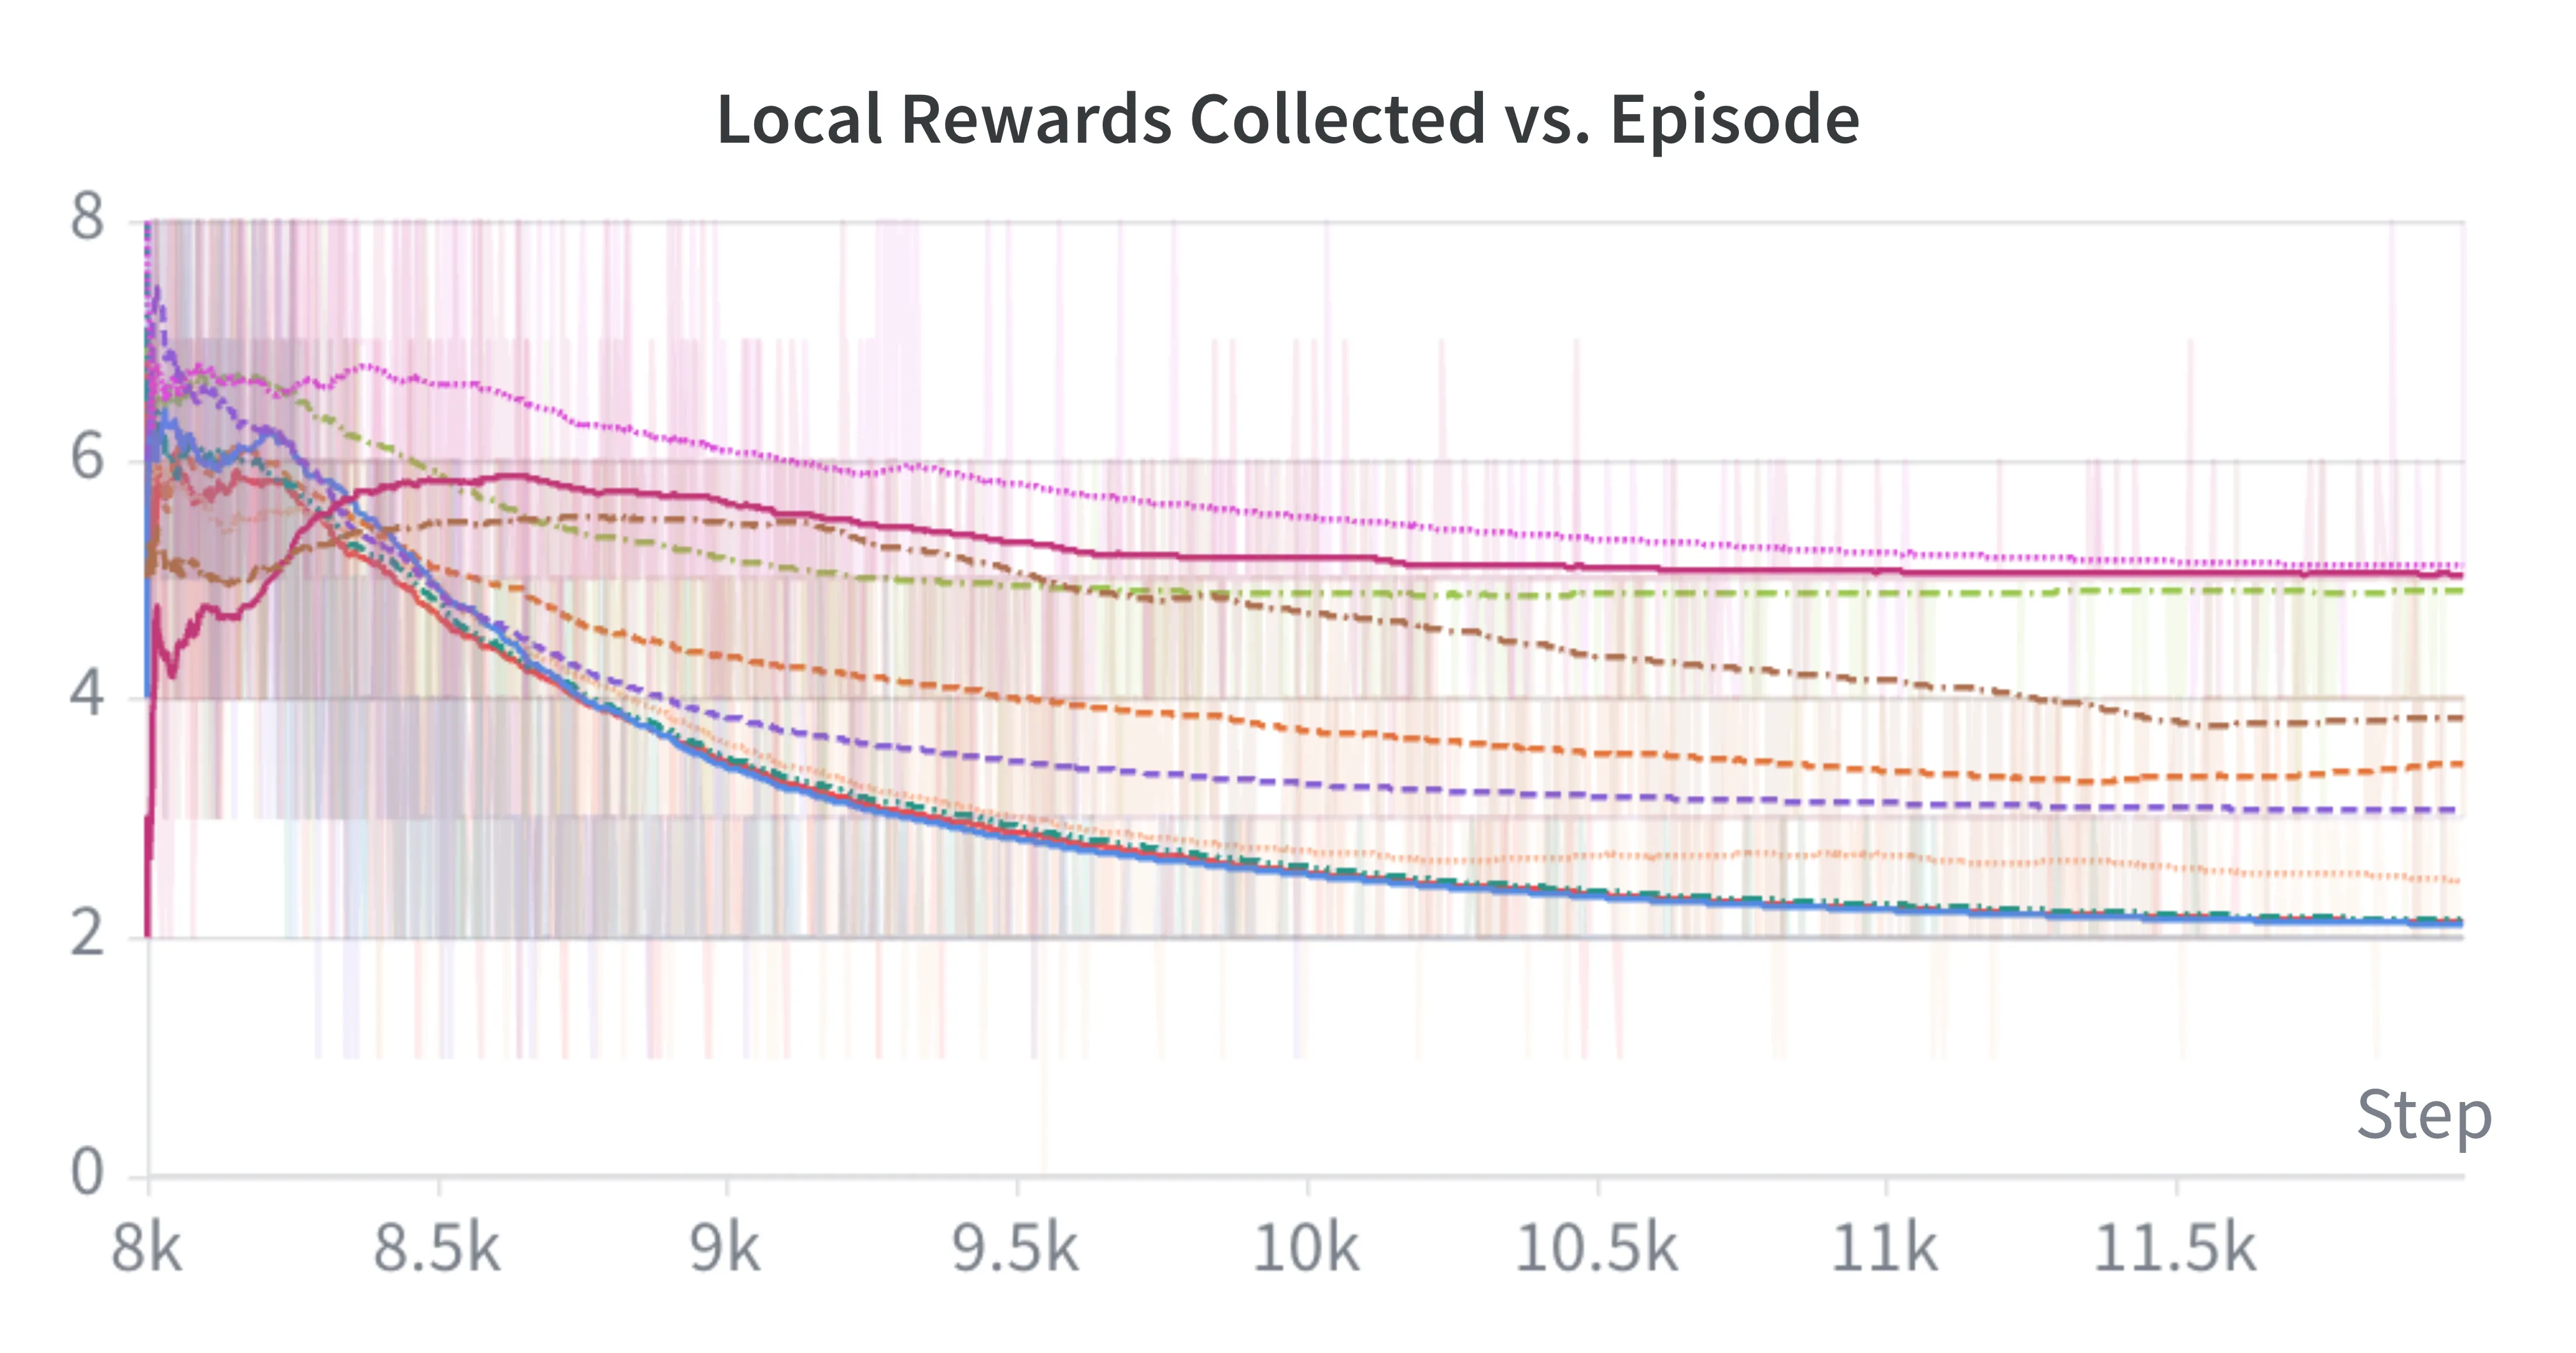
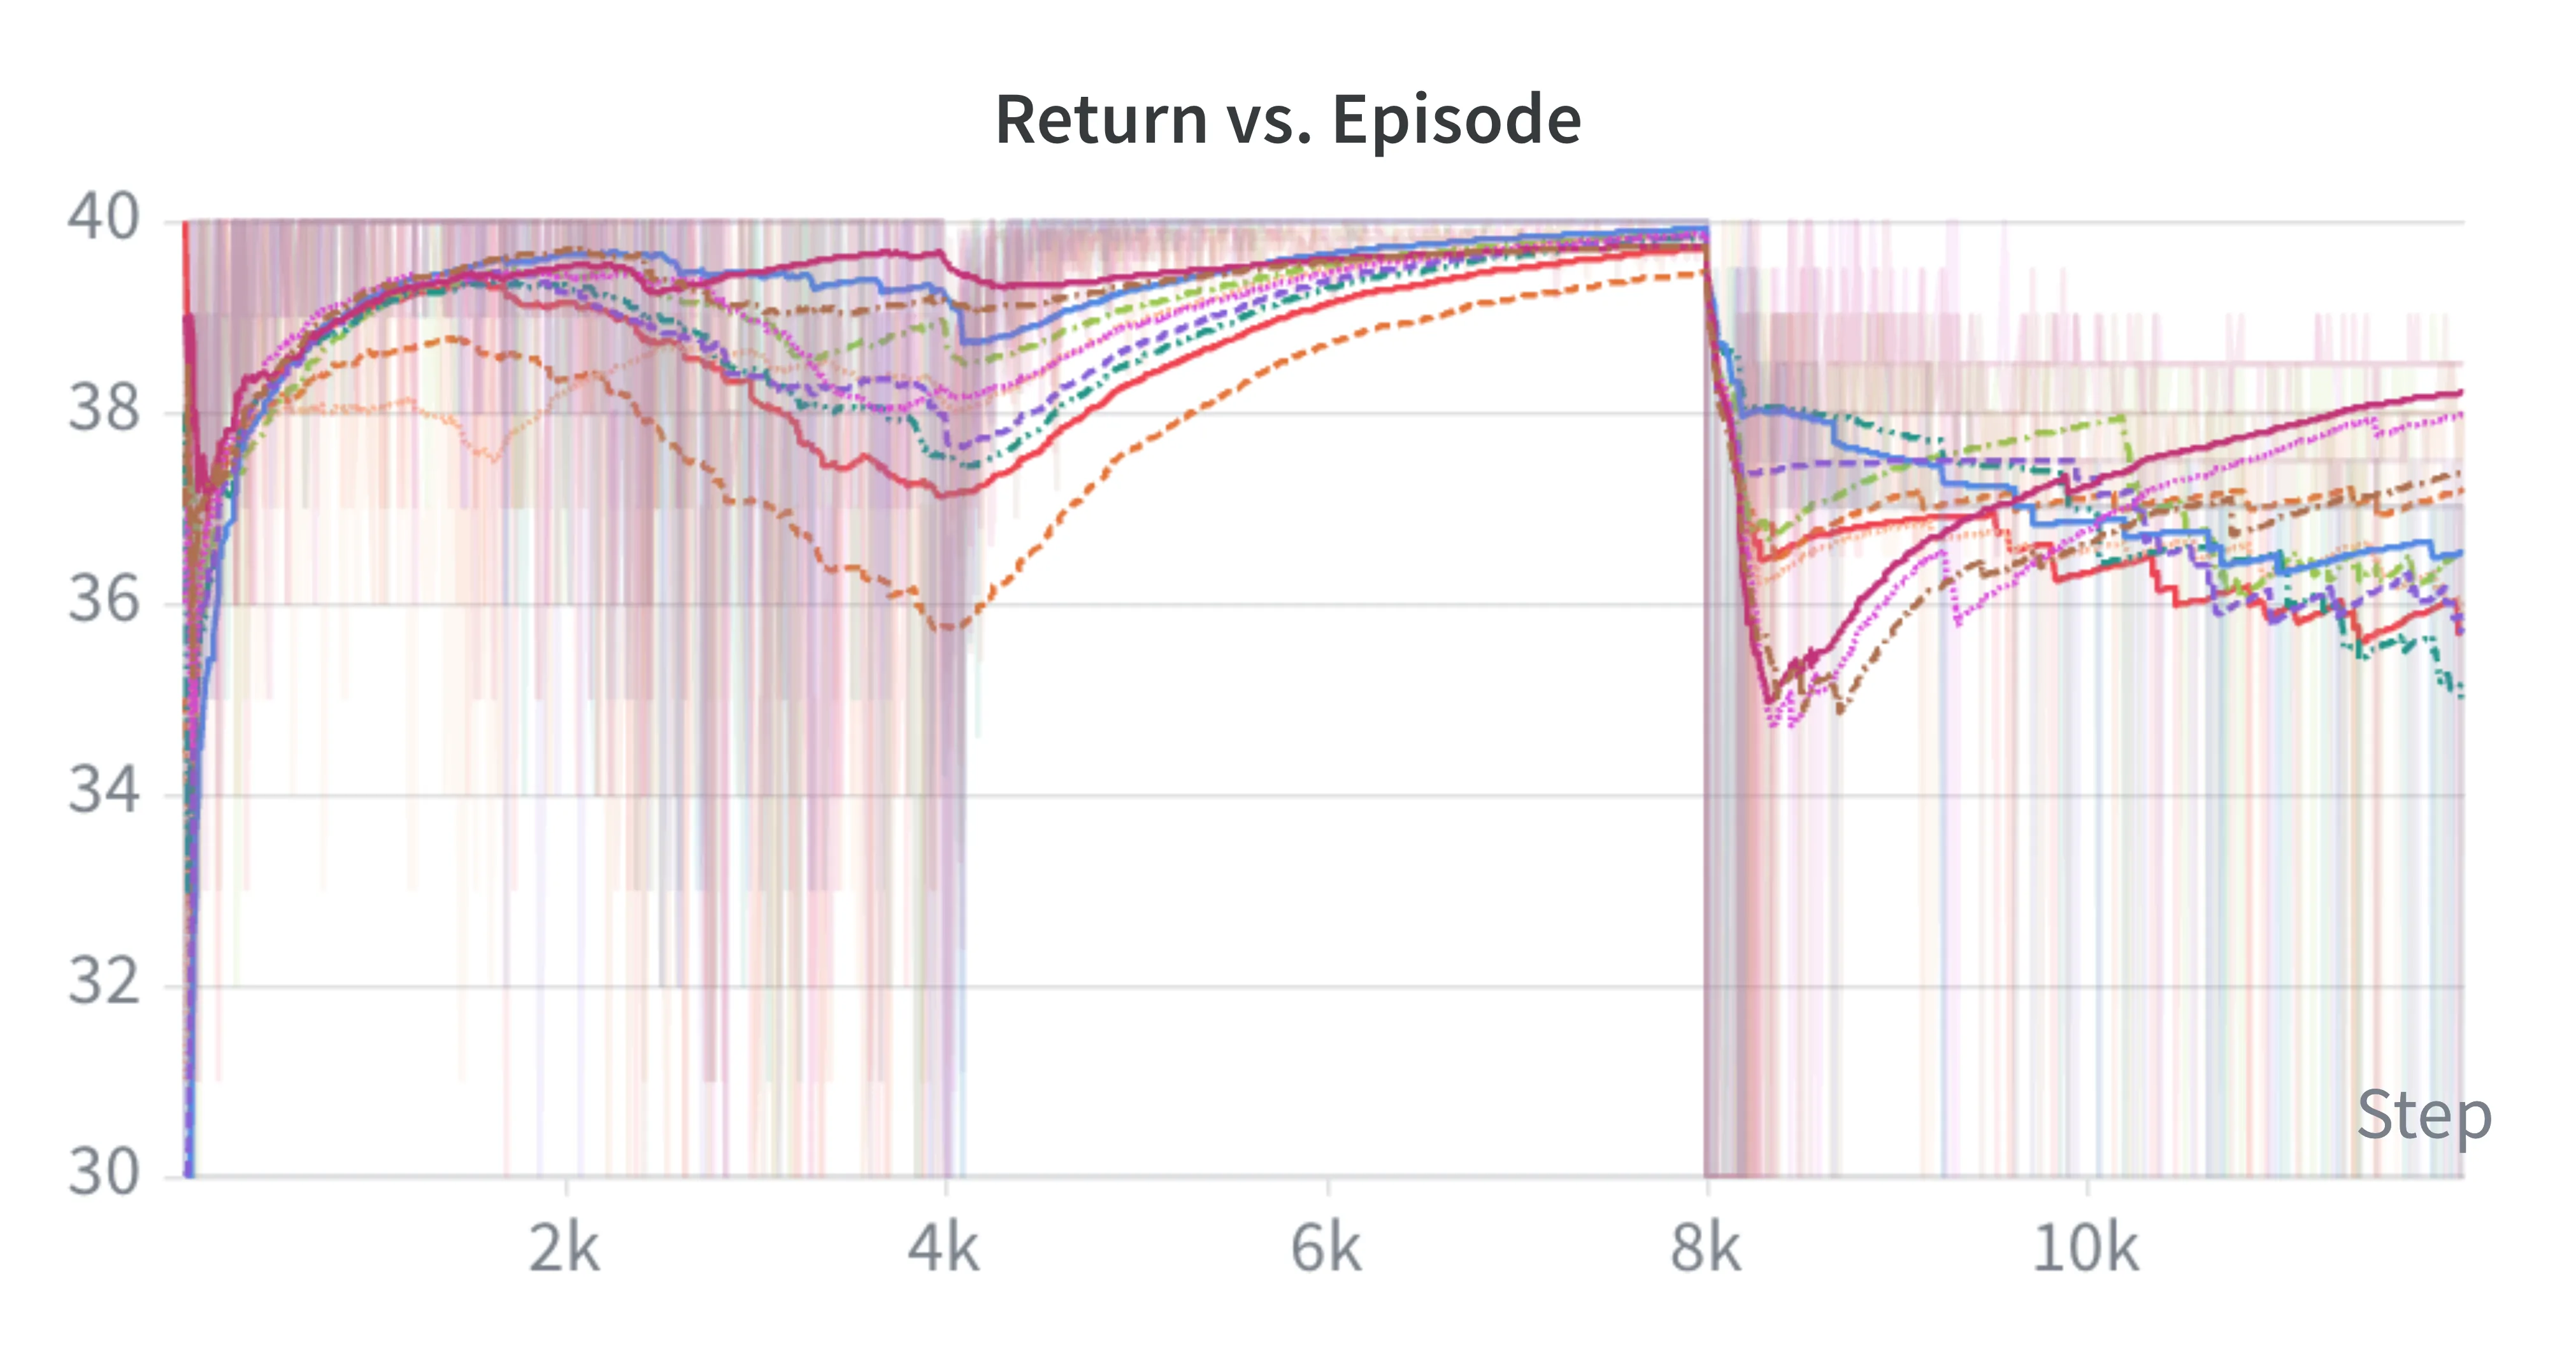
更具挑战性的是持续学习场景的测试。实验设置了一个包含三个顺序切换任务的序列,要求智能体在目标位置发生突变后迅速调整策略。多视野方法在此表现出显著的适应性优势:当任务切换时,混合网络的权重分布会相应地重新调整,从之前任务偏好的视野平滑过渡到新任务所需的时间尺度。这一动态调整过程本身就是对任务切换的隐性感知,可作为持续学习中任务边界检测的信号来源。
参数效率的提升也是关键发现之一。虽然多视野方法需要维护十个 Q 头,但其优势在于「一次训练、多场景适应」——同样的网络结构可以迁移到新任务而无需重新搜索 ,这在长期来看显著降低了调参的总成本。
讨论与可借鉴点
该方法的局限性主要集中在以下几个方面。首先,实验验证目前仅限于 MiniGrid 离散环境,在连续控制任务(如 MuJoCo)或高维感知任务(如 Atari)上的表现尚待考察,这些场景可能对视野选择有不同的需求。其次,十个 Q 头的线性增长带来了相应的参数与计算开销,在极端资源受限的场景下可能成为负担。此外,混合网络本身引入的超参数(如 softmax 温度)仍需手工设定,并非完全的无参数方法。
尽管如此,这项工作为强化学习中的时间视野问题提供了一个有价值的解决思路。其核心贡献在于将「选择合适的折扣因子」从手工调参转变为自动学习的过程,这在任务切换频繁或奖励结构事先未知的场景中尤为实用。混合网络的权重分布可解释性也值得注意——它为研究者提供了一种观察智能体时间偏好随任务演化的窗口。
对于更广泛的研究社区而言,这篇论文的启示在于:单一时间尺度的假设可能限制了 RL 系统的适应性,而多尺度组合的思路或许值得在更多元的任务类型中探索。生物学中多时间尺度机制的计算建模也为本工作增添了跨学科的参考价值,提示强化学习研究可以从认知科学与神经科学的发现中汲取灵感。
摘要
在复杂且不断变化的环境中进行有效决策需要平衡短期与长期的后果。在强化学习(RL)中,这种权衡通常通过固定的折扣因子来控制,它施加了一个单一的指数折扣时间视野。然而,生物智能体表现出灵活且自适应的时序折扣,表明有效的规划需要多个时间尺度。本文提出一种多视野方法,自适应地选择并组合时间视野,从而在无需手动调节折扣因子的情况下,对奖励结构的变化实现稳健适应。这种灵活性使该方法特别适用于涉及任务切换与多样化环境配置的持续学习场景。实验结果表明,我们的方法在一系列 MiniGrid 环境中能够识别出有效的折扣因子,包括由三个顺序变化的任务组成的持续学习设定。这些结果表明,自适应时序折扣能够提升参数效率,并在人工系统及受生物启发的学习系统中增强适应性。
Abstract
Effective decision-making in complex and changing environments requires balancing short-term and long-term consequences. In reinforcement learning (RL), this trade-off is typically controlled through a fixed discount factor, which imposes a single exponentially discounted temporal horizon. However, biological agents exhibit flexible and adaptive temporal discounting, suggesting that effective planning requires multiple timescales. Here, we propose a multi-horizon approach that adaptively selects and combines temporal horizons, enabling robust adaptation to changes in reward structure without manual discount-factor tuning. This flexibility makes the method particularly suitable for continual learning scenarios involving task switches and varying environmental configurations. Empirically, we demonstrate that our approach identifies effective discount factors across a range of MiniGrid environments, including continual settings composed of three sequentially changing tasks. These results suggest that adaptive temporal discounting can improve parameter efficiency and enhance adaptability in both artificial and biologically inspired learning systems.
论文详细总结(自动生成)
论文总结:自适应多视野强化学习
1. 核心问题与研究动机
- 核心问题:传统强化学习(RL)使用单一固定折扣因子 ,对未来奖励施加单一指数衰减的时间视野,无法灵活平衡短期与长期收益。
- 问题表现:
- 不同任务的最优视野不同,单一 难以兼顾(如公式 所示,过大或过小的 会导致近视或过度重视远期)。
- 当奖励结构发生切换或环境动态变化时,固定 策略性能下降。
- 生物学动机:生物智能体表现出灵活、自适应的时序折扣能力,提示有效规划需要多个时间尺度。
- 研究目标:设计一种能自动选择并组合多时间视野、无需手工调节 的自适应方法。
2. 方法论
2.1 核心思想
- 构建一组多视野 Q 学习头(multi-horizon Q-learning heads),每个头对应一个不同的折扣因子 ,并通过自适应混合网络(mixing network) 动态组合它们的输出。
- 混合权重由状态决定,并满足凸组合约束,从而保证混合 Q 函数的良好性质。
2.2 多视野集合
- 预设一组固定的折扣因子集合:
- 对应的有效视野为:
- 覆盖从"完全无折扣()"到"极短视野()"的完整谱系。
2.3 多头 Q(λ) 学习
- 每个头 学习对应 的动作价值函数 。
- TD 误差:
- 资格迹更新:
- 其中 为资格迹衰减参数。
2.4 混合网络(状态相关权重)
- 状态 经特征提取得到 ,再线性映射 。
- 权重通过 softmax 得到:
- 混合 Q 值:
- 权重约束 ,确保 。
2.5 混合网络的梯度更新
- 损失函数 ,其中 由 计算。
- 参数更新:
- 其中 表示各头 Q 值与混合 Q 值之差向量。
2.6 理论性质
- 凸组合性质: 始终位于各头 Q 值的凸包内。
- 最优 选择定理:在固定策略下,若 是性能最优的折扣因子,则训练过程中 ,而 ()。即混合网络会自动将权重集中到最优头。
3. 实验设计
3.1 基准与环境
- MiniGrid 系列离散网格世界环境(多种关卡配置)。
- 包含常规 RL 任务以及持续学习设定:由三个顺序切换的任务组成,测试在任务切换时的适应能力。
3.2 对比方法
- 单一折扣因子的标准 Q(λ) 学习(基线),通常需要对 进行网格搜索调参。
- 与固定 的多种取值(如 )进行比较,凸显多视野自适应方法的优势。
3.3 超参数范围
- 折扣因子集合:10 个值覆盖 从 2 到 。
- 资格迹参数:(注:此处 用作资格迹衰减系数,与回报函数中的 含义不同)。
4. 资源与算力
- 论文未明确给出所用 GPU 型号、数量及训练时长。
- 实验规模以 MiniGrid 离散环境为主,总体算力需求不高,但具体训练时长未在文中披露。
5. 实验数量与充分性
- 实验数量:
- 在多种 MiniGrid 环境中分别测试,包含至少一组由三个连续切换任务组成的持续学习场景。
- 对每个折扣因子头和不同 设置进行了网格扫描。
- 充分性评估:
- 优势:覆盖了常规 RL 与持续学习两种范式,并展示了权重收敛到最优 的现象,具有一定说服力。
- 局限:实验主要集中在 MiniGrid 离散环境,缺乏在连续控制任务(如 MuJoCo、Atari)上的验证;消融实验(如去除混合网络、改变视野数量)的描述较为有限;与近期自适应折扣方法(如 -网络、meta-RL 折扣学习)的对比不够充分。
6. 主要结论与发现
- 自适应能力:多视野混合网络能在不同环境中自动识别有效的折扣因子,无需人工调参。
- 持续学习表现:在三个顺序切换任务的持续学习场景中,能动态调整权重以适应新任务。
- 理论收敛:在固定策略下,混合权重会集中到最优折扣因子对应的头。
- 参数效率与适应性提升:自适应时间贴现比固定 具有更好的参数效率和跨任务适应性。
- 生物学启示:为类生物学习系统中的多时间尺度机制提供了计算模型。
7. 方法与实验设计的优点
- 生物学合理性:灵感来自生物智能体的多时间尺度时序折扣机制,理论动机清晰。
- 无需调参:通过预设视野集合 + 自适应混合,免去对 的网格搜索。
- 理论保证:凸组合约束保证混合 Q 值的合理性,且证明了权重收敛到最优头的性质。
- 架构简洁:在标准 Q(λ) 框架上扩展,仅增加一个小型混合网络,开销可控。
- 持续学习适用性:权重动态可作为任务切换的指示信号,具有实际应用价值。
8. 不足与局限
- 环境覆盖有限:仅在 MiniGrid 离散网格环境验证,未在更复杂的连续控制或高维感知任务上测试。
- 计算开销:维护 10 个 Q 头加混合网络,参数与计算量随视野数线性增长,规模可扩展性存疑。
- 超参依赖:(资格迹)、学习率、softmax 温度等仍需手工设定,并非完全免调参。
- 对比基线不够全面:缺少与近期自适应折扣方法(如 learned 、hypernetwork 生成 、分布式折扣 RL 等)的系统比较。
- 持续学习评估薄弱:仅展示三个切换任务的定性结果,缺乏更长期序列或更多任务切换的实验。
- 偏差风险:在单一环境族(MiniGrid)上的结论可能难以推广到奖励结构差异极大的领域。
- 收敛速度与稳定性:文中未深入分析权重收敛的动力学过程和稳定性保障。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。