
📝 TLDR
主动推断通过最小化期望自由能将认知性与实用性目标统一于变分框架,但缺乏与强化学习的理论桥梁。本文将主动推断重述为策略优化问题,证明闭环控制下期望自由能最小化可建模为凸马尔可夫决策过程,其中实用项等价于隐空间奖励最大化,认知项引入策略相关的非线性成分。进一步推导出有限时域、折扣与平均奖励三种设定下的镜像下降算法,揭示主动推断本质上是耦合世界模型学习的执行式强化学习,从而获得收敛性与策略改进的理论保证。
🧭 速览
主动推断缺乏与现代强化学习统一的理论框架,难以获得收敛性分析与策略改进保证。
将期望自由能最小化重构为凸马尔可夫决策过程,并推导镜像下降算法在当前状态边际处线性化目标。
实用项等价隐空间奖励最大化,认知项构成策略相关执行式奖励,并给出有限时域、折扣与平均奖励设定下的可求解算法。
主动推断可纳入执行式强化学习框架,为其提供收敛性分析与原则性策略改进的理论基础。
🆚 方法对比
Active Inference (AIF)
- 统一变分框架整合认知与实用目标
- 基于世界模型具有想象式规划能力
- 认知驱动实现信息增益驱动的探索
- 优化性质未被充分理解
- 缺乏收敛性与策略改进保证
- 传统形式偏向推理而非策略优化
Convex MDP
- 将任意凸泛函纳入策略优化目标
- 支持扩展动态规划方法保持可扩展性
- 可自然处理EFE中的认知项非线性成分
- 理论较新,工程实现尚不成熟
- 需要精确的凸性条件验证
- 高维状态下计算负担可能较大
Mirror Descent AIF (MD-AIF)
- 产生策略依赖奖励兼容执行器-评论家方法
- 局部线性化降低每步计算复杂度
- 可结合动态规划闭式求解softmax子问题
- 仅保证局部收敛,收敛速率有限
- 需要当前状态边际的线性化近似
- 对世界模型耦合的全局保证仍缺失
Model-Based Policy Optimization (MBPO)
- 可使用想象式回放提升样本效率
- 收敛性和策略改进保证成熟
- 与深度学习架构天然兼容
- 世界模型误差会累积影响性能
- 仅优化期望奖励线性目标
- 缺乏内建的认知探索机制
Performative Reinforcement Learning
- 可描述奖励随部署策略变化的情形
- 为AIF与策略耦合提供理论框架
- 支持更现实的智能体建模分析
- 研究尚处于早期阶段,理论不完善
- 实际算法收敛条件苛刻
- 工程实现复杂度高
本文将Active Inference重构为凸MDP框架,通过Mirror Descent算法桥接现代RL优化理论,揭示了AIF与MBPO在策略优化结构上的本质联系,并定位其为凸MDP与Performative RL的交叉领域。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
本文将主动推断的核心机制——期望自由能最小化——重新表述为一个凸优化问题,并证明其在闭环控制下等价于一个凸马尔可夫决策过程。这一视角建立了主动推断与强化学习之间的理论桥梁:认知项(探索驱动力)被揭示为一种依赖于策略的执行性奖励,而方法论上则可通过镜像下降算法实现,与现代强化学习的行动者-评论家框架兼容。
研究背景与动机
主动推断框架试图用统一的变分原理同时解释生物智能的认知与行动功能。其核心思想是将行为目标定义为期望自由能——一个同时包含实用性目标(类似强化学习中最大化累积奖励)和认知性目标(减少不确定性、主动探索未知)的综合代价函数。然而,尽管这一框架在神经科学和机器人控制中展现出强大的建模能力,它与主流强化学习理论之间始终存在一道鸿沟。
这道鸿沟主要体现在三个方面。首先,期望自由能的形式相对灵活,缺乏像强化学习中价值函数那样的结构化理论支撑,使得收敛性分析难以开展。其次,期望自由能中的认知项与状态转移概率存在复杂的耦合关系,这种非线性结构是否会导致优化陷入局部最优,长期以来并不清楚。第三,主动推断在实际应用中通常需要同时学习世界模型和策略,但这种耦合学习的收敛行为缺乏理论保障。
本文的切入点正是上述理论空白。作者追问:如果将期望自由能最小化严格视为一个策略优化问题,能否利用凸优化的数学工具为其建立一套完整的理论体系?
方法
将主动推断转化为凸优化问题的关键一步,在于重新审视期望自由能在闭环控制策略下的数学结构。
期望自由能的组成可以分解为两个部分:
其中实用性项只依赖于预测状态边际 ,在状态边际上呈线性结构;认知项则是KL散度形式,引入了策略相关的非线性成分。
凸性证明是本文的核心理论贡献。作者证明,对于闭环控制策略(策略仅依赖于当前状态而非完整历史),期望自由能关于状态边际是凸的。这意味着优化问题具有良好的数学结构——局部最优即是全局最优。这与直觉做法形成鲜明对比:如果采用开环策略(假设固定动作序列),期望自由能可能呈现复杂的非凸景观。
执行性奖励的揭示则具有深刻的理论含义。作者发现,认知项虽然是非线性的,但它本质上等价于一个依赖于当前策略的奖励函数——即执行性奖励。这一发现将主动推断与强化学习中的执行性在线学习问题联系起来,暗示探索驱动力可以被理解为一种动态变化的奖励信号。
在算法层面,作者推导了三种经典设定下(有限时域、折扣累积、平均奖励)的镜像下降算法。镜像下降的核心思想是在当前状态边际的邻域内对目标函数进行局部线性化,从而将原始的非线性问题转化为一系列线性子问题。这种处理方式与行动者-评论家方法天然兼容:评论家负责估计价值函数(线性子问题的解),行动者负责更新策略。
实验与结果
本文以理论分析为主,但作者提供了几个关键性的验证来支撑其理论框架。
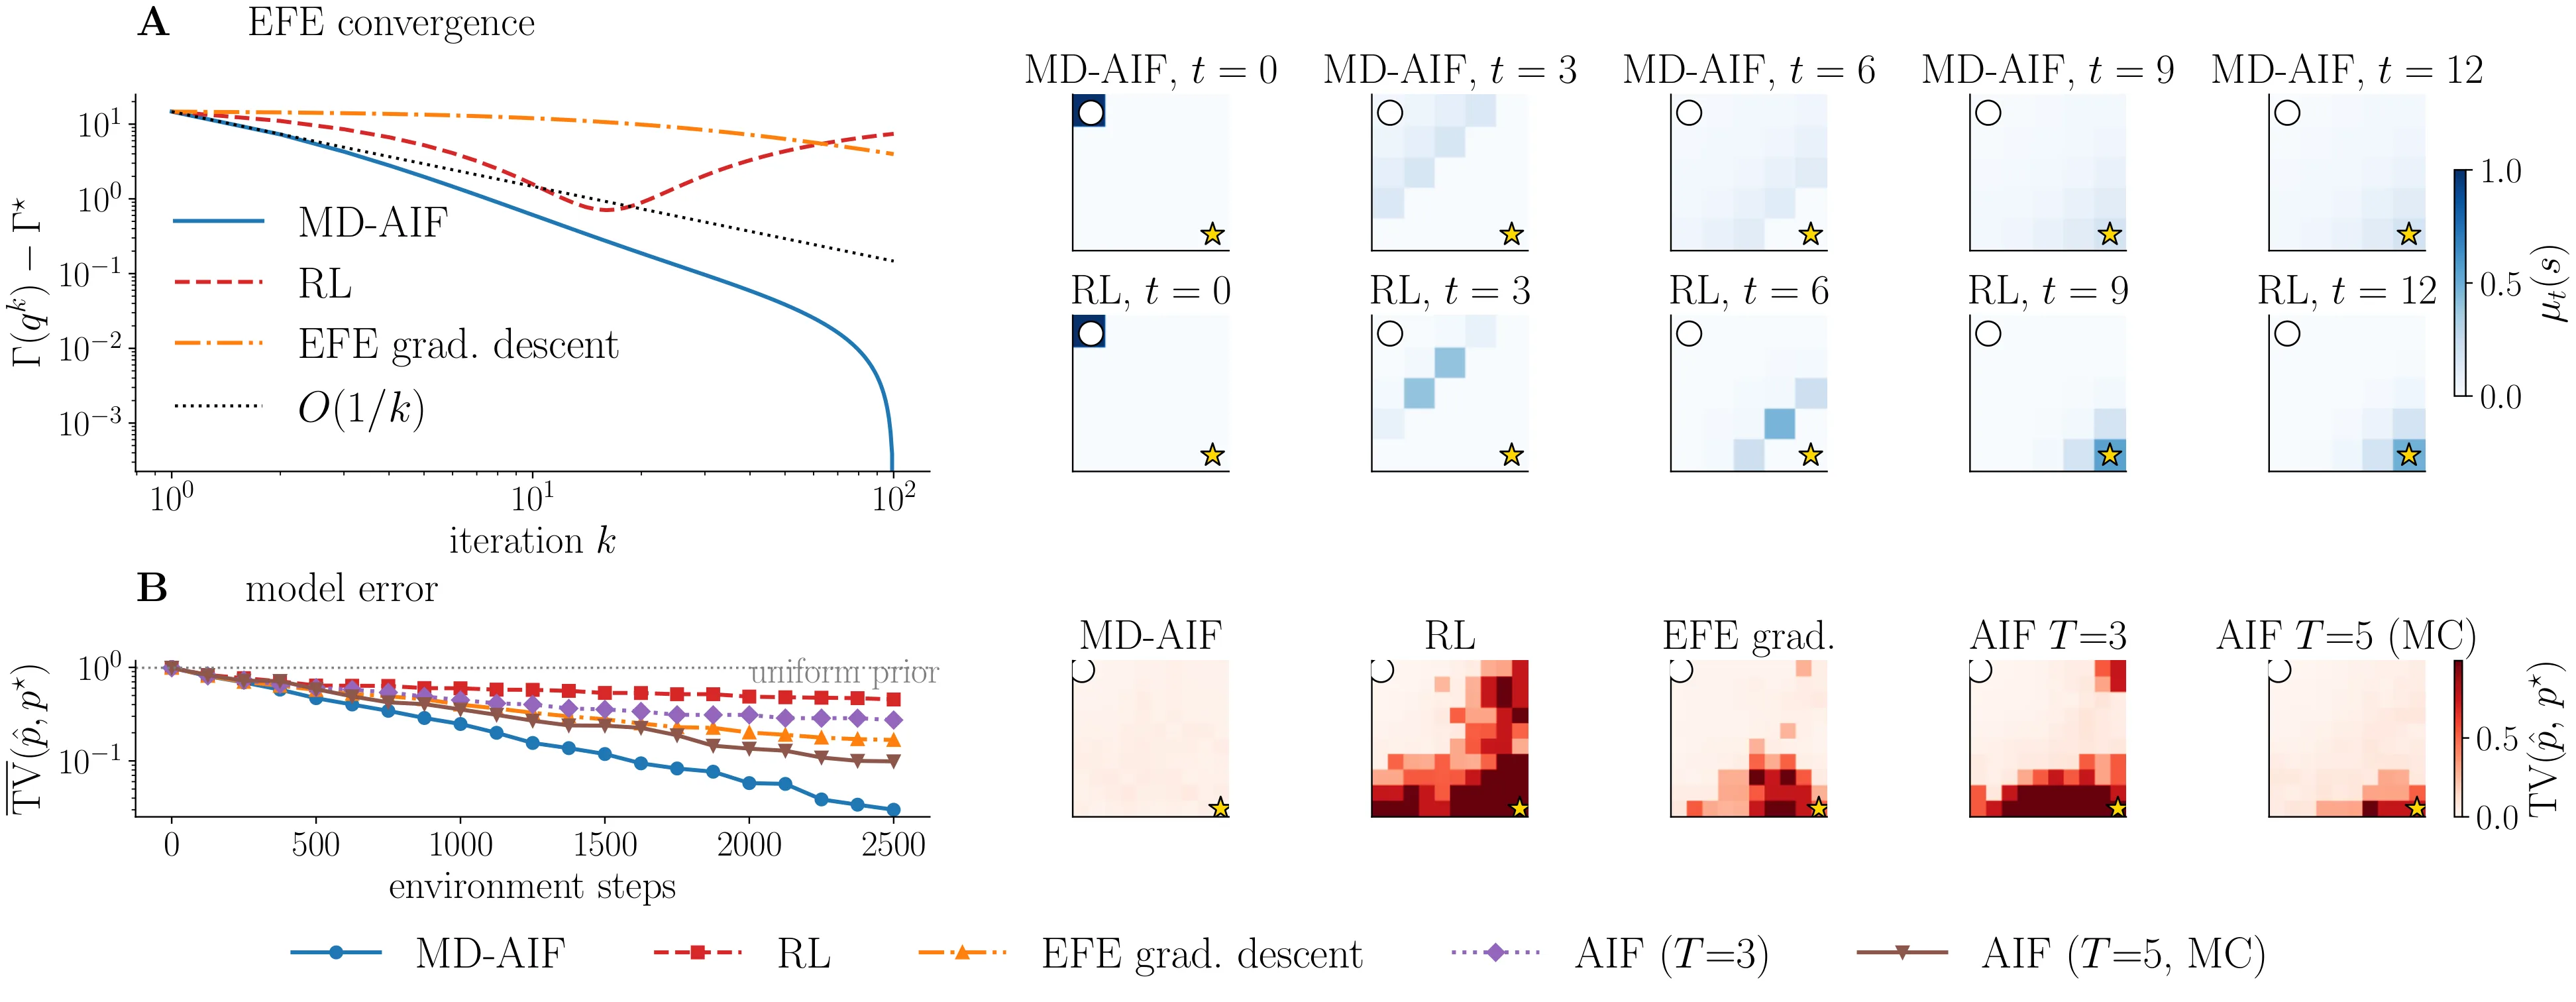
对于有限时域设定,作者证明期望自由能最小化可以精确地分解为动态规划结构——每一步的最优控制仅依赖于当前状态和剩余时间步数。这一结果意味着主动推断在有限时域下具有与标准MDP完全相同的计算结构,可以直接借用动态规划的高效算法。
对于折扣设定,作者建立了期望自由能与折扣奖励之间的对应关系。折扣因子在此处同时控制了两个方面:策略对近期与远期认知收益的权衡,以及状态边际的稳定性。这一分析揭示了折扣因子在主动推断中的双重角色。
平均奖励设定的分析则聚焦于稳态行为。当考虑无限期持续任务时,最优策略趋向于在状态空间上建立稳定的状态分布。此时认知项退化为一种对状态访问不确定性的惩罚项,推动策略探索那些模型尚未准确掌握的状态区域。
这些结果共同说明,主动推断在不同设定下都可以被纳入统一的凸MDP框架,从而获得了强化学习理论中的标准保证:收敛性可通过标准的不动点理论证明,策略改进则可通过值函数的单调递增性质保证。
讨论与可借鉴点
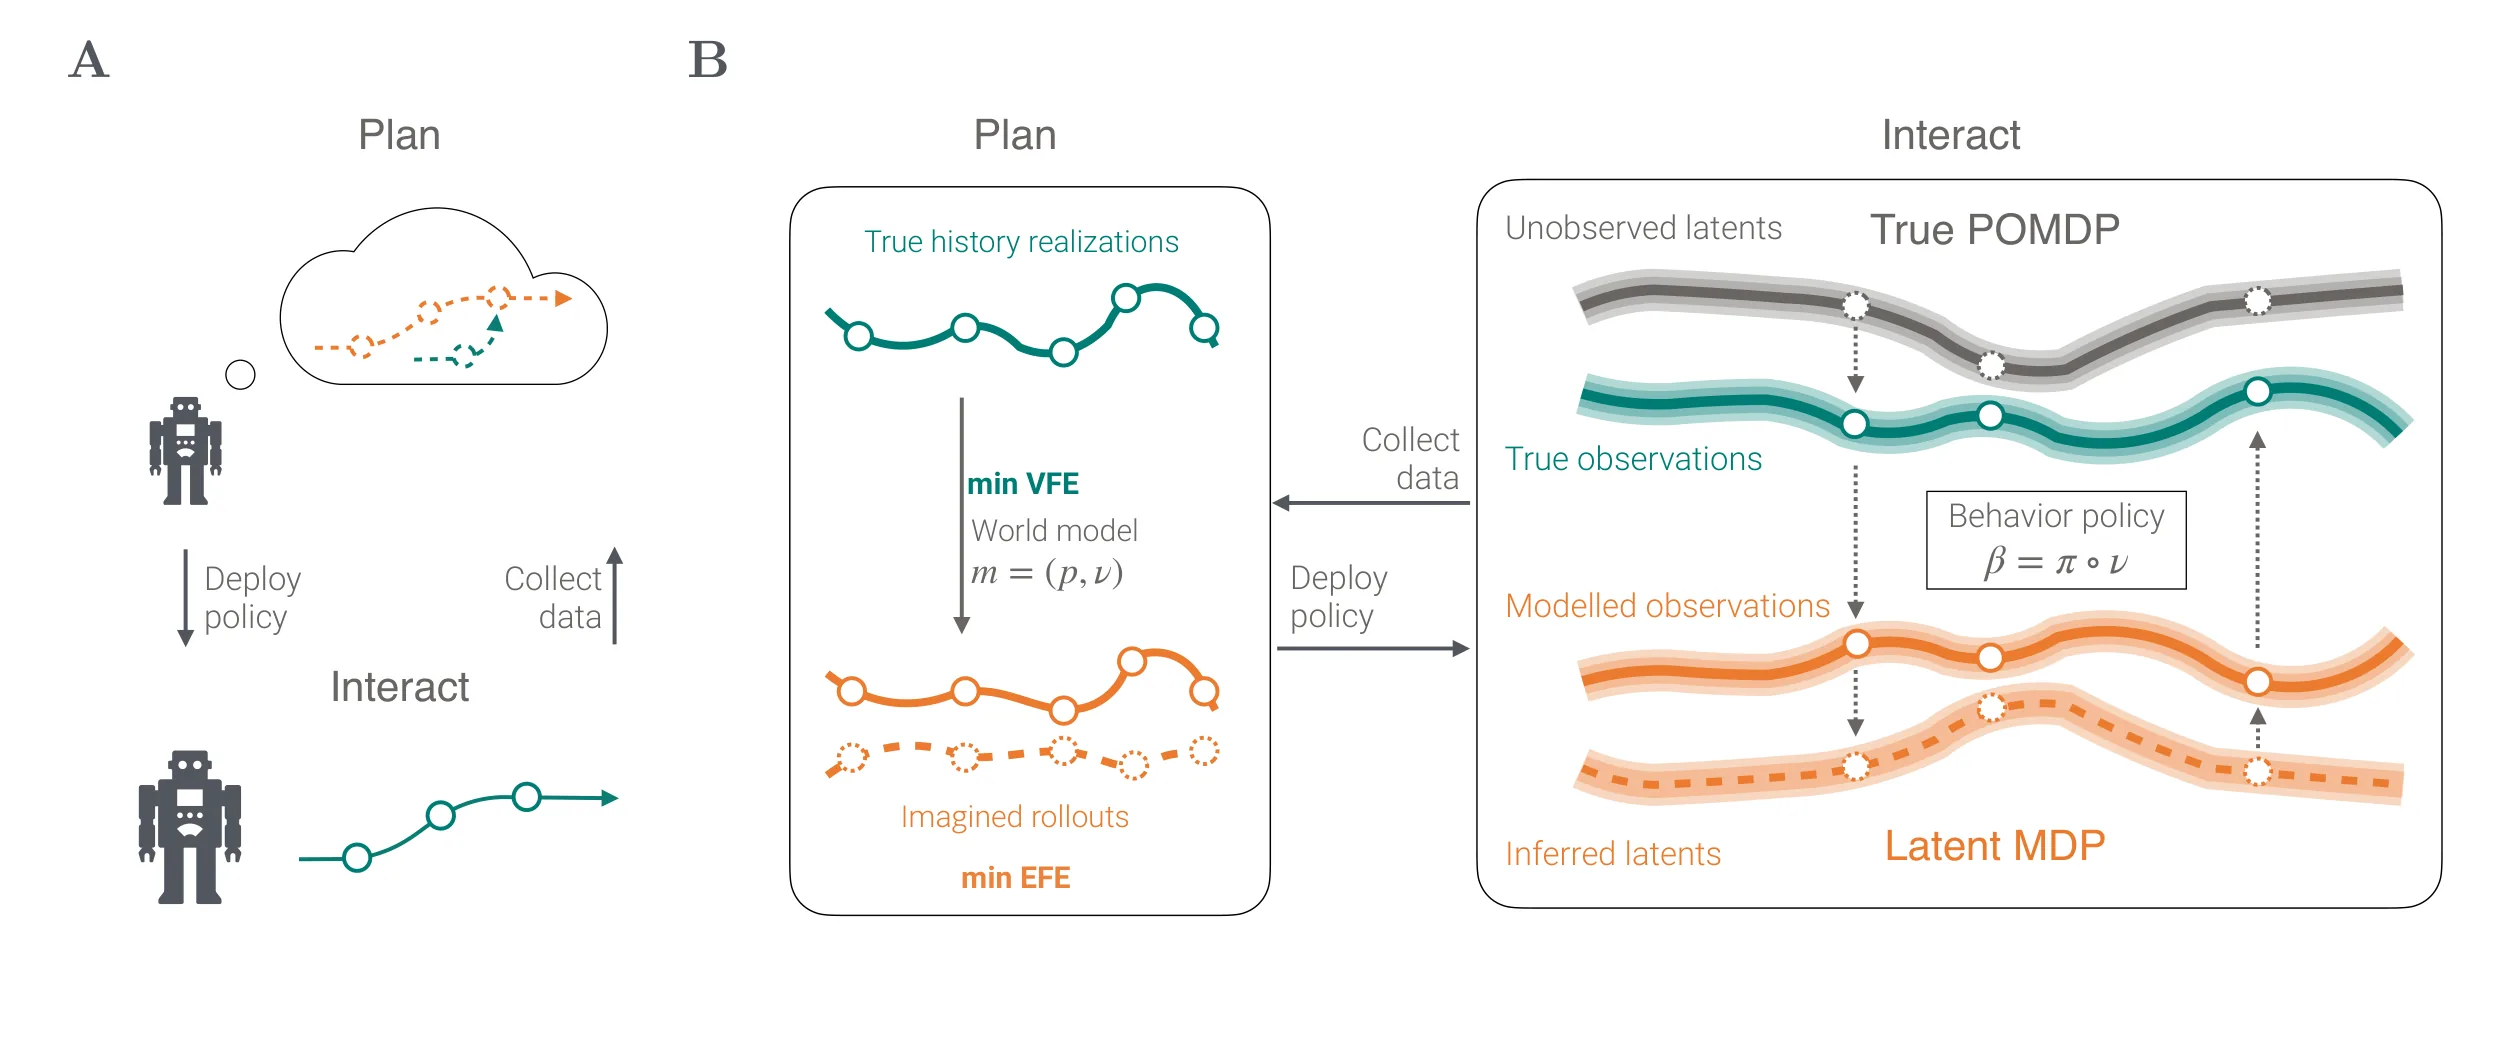
本文最重要的理论贡献,是揭示了主动推断与执行性强化学习之间的深层联系。在执行性强化学习中,智能体学习的世界模型会被其自身的策略所塑造——这与主动推断同时进行世界模型学习和策略优化的结构完全一致。这一视角不仅解释了为什么主动推断具有强大的自适应能力,更指明了将其纳入现代强化学习理论体系的路径。
本文的局限性在于理论分析主要集中于确定性环境,对于随机动态和部分可观测场景的理论保证尚需进一步发展。此外,镜像下降算法的计算效率与状态空间的维度高度相关,在高维问题中可能面临可扩展性挑战。
对于主动推断与强化学习交叉领域的研究者而言,本文提供了几个值得借鉴的方向:一是可以借鉴强化学习中的策略梯度理论来改进主动推断的学习效率;二是可以引入强化学习的安全保证机制来增强主动推断的可靠性;三是可以在主动推断的框架下探索更具认知合理性的探索机制。
摘要
主动推理(AIF)将适应性行为刻画为期望自由能(EFE)的最小化,在单一的变分原理中结合了认知性与实用性目标。我们将主动推理刻画为策略优化,并证明对于闭环控制策略,期望自由能最小化可以被表述为一个凸马尔可夫决策过程(MDP)。在该表述中,实用性项在预测状态边际上呈线性,因此等价于一个潜在MDP中的奖励最大化;而认知价值引入了一个非线性成分,使期望自由能最小化区别于标准的强化学习。这一视角进一步揭示了主动推理的认知驱动力可视为一种依赖于策略的(执行性)奖励。我们分析了期望自由能的有限期、折扣和平均奖励形式,并推导了一种镜像下降(MD)算法,该算法在当前状态边际附近对目标进行局部线性化,得到一个与行动者-评论家方法及动态规划兼容的依赖于策略的奖励。最后,我们论证将世界模型学习与策略优化相耦合,使主动推理具备了执行性强化学习的结构,为将主动推理置于现代强化学习与优化理论框架中(包括收敛性分析与有原则的策略改进保证)提供了一条路径。
Abstract
Active Inference (AIF) frames adaptive behavior as the minimization of expected free energy (EFE), combining epistemic and pragmatic objectives within a single variational principle. We frame AIF as policy optimization and show that, for closed-loop control policies, EFE minimization can be formulated as a convex Markov decision process (MDP). In this formulation, the pragmatic terms are linear in the predictive state marginals and therefore equivalent to reward maximization in a latent MDP, while the epistemic value introduces a nonlinear component that distinguishes EFE minimization from standard reinforcement learning. This perspective further reveals the epistemic drive of active inference as a policy-dependent (performative) reward. We analyze finite-horizon, discounted, and average-reward formulations of EFE and derive a mirror descent (MD) algorithm that locally linearizes the objective around the current state marginals, yielding a policy-dependent reward that is compatible with actor-critic methods and dynamic programming. Finally, we argue that coupling world-model learning with policy optimization gives active inference the structure of performative reinforcement learning, providing a route toward grounding active inference within modern reinforcement learning and optimization theory, including convergence analysis and principled policy improvement guarantees.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。