
📝 TLDR
后训练中策略模型不断变强,候选回复质量趋同,导致评估器给出的相对分数差坍缩,监督信号随之失效。论文从概率分配视角理论证明,策略优化方向增益等于回复间的评估分数差。基于此提出DynamicRubric框架,针对每组候选动态生成加权二元评分项并聚合为响应级分数,实现评估器与策略协同进化。8B参数基座上效果优于使用70B奖励模型和235B静态评分项的基线,优化后模型已部署于微信搜索AI问答场景,日均服务数千万请求。
🧭 速览
随着策略模型持续改进,其采样回复质量趋于相近,相对评分差坍缩,造成弱甚至误导性的优化监督信号。
提出DynamicRubric框架,按候选集合条件动态生成加权二元评分项并聚合成响应级分数,让评估器随策略共同进化。
8B基座上评估器性能与策略监督质量均优于70B奖励模型或235B静态评分项基线,推理与编程任务亦有提升。
评估器应与其监督的策略共同进化,基于此原则设计的DynamicRubric在实验中与实际部署均验证有效。
🆚 方法对比
DynamicRubric
- 8B骨干模型超越70B奖励模型和235B静态评分基准
- 响应集条件化评分保持相对差距,避免分数塌缩
- 已部署微信搜索,承载数千万日请求并提升线上指标
- 理论证明评分差距即为策略优化的方向增益信号
- 依赖冻结的DR-Verifier,增加系统复杂度
- 需要评估器与策略协同训练,计算开销较大
- 二元评分项粒度可能限制复杂语义区分能力
- 动态评分项生成对生成器质量要求较高
DR-Generator(动态评分项生成器)
- 响应集条件化生成,针对当前候选差异生成条目
- 通过最大化评分判别力目标进行优化
- 与策略同步演化,适应策略改进后的响应分布
- 训练过程需要频繁重训以跟上策略变化
- 8B模型能力上限可能限制评分项质量
DR-Verifier(评分验证器)
- 冻结保证评分标准一致性,避免训练不稳定
- 二元判断聚合可追溯到具体评分项
- 相同骨干初始化与生成器共享知识基础
- 冻结策略无法随策略演化自适应
- 二元判断可能丢失细粒度质量差异信息
传统奖励模型/LLM-as-Judge评估器
- 实现简单,可直接输出响应级分数
- 成熟方法,有广泛验证和支持
- 对接近质量的候选区分能力差,差距易塌缩
- 整体性评分难以追溯具体判断依据
- 分数绝对值不稳定,跨实例不可比
静态评分项评估器(Static Rubric)
- 评分标准预先定义,评判一致性高
- 将整体判断分解为可解释的多维度评分
- 评分项固定,无法适应策略改进后的响应集
- 235B大模型生成的评分项仍被8B动态方法超越
仅基于Prompt的评估器(Prompt-only Evaluator)
- 输入简单,无需候选响应集即可评估
- 是响应集条件化评估器的特例,理论包含
- 无法针对当前候选集的具体差异生成条目
- 缺乏对策略优化所需的细粒度判别能力
DynamicRubric通过评估器-策略双层协同演化解决了传统奖励模型和静态评分项在策略改进后分数差距消失的瓶颈,其核心优势在于响应集条件化的动态评分生成,相比静态评分项和大规模奖励模型基线在小模型规模下即可取得更优性能。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
后训练阶段中,策略模型生成的候选回复越来越接近,导致评估器给出的相对分数差趋向于零,监督信号随之坍缩。本文从概率分配的视角证明了「将概率质量从一个回复转移至另一个回复的方向性增益,恰好等于两者间的评估分数差」这一核心结论,并据此提出 DynamicRubric 框架——它以候选回复集合为条件,动态生成加权二元评分细则项并聚合为响应级分数,使评估器能够随策略共同演化。在 8B 参数基座上,该方法超越了使用 70B 奖励模型和 235B 静态评分细则生成器的基线方案,且已部署于微信搜索 AI 问答场景,日均处理数千万请求。
研究背景与动机
大语言模型的后训练阶段,通常依赖 [[强化学习]] 或 [[监督微调]] 机制来提升模型能力。其中一种核心范式是让评估器(evaluator)对策略模型(policy)生成的候选回复给出反馈,进而引导策略优化。然而随着策略能力不断增强,一个根本性的困境逐渐浮现:策略生成的多个候选回复在质量上愈发接近,评估器需要在这些「高手过招」的细微差异中做出辨别。
当候选回复质量趋同时,评估器给出的相对分数差会趋向于零或随机波动,这就是所谓的「分数坍缩」现象。分数坍缩带来的后果是致命的:策略优化依赖于有意义的梯度信号,而当分数差几乎为零时,梯度信号要么微弱得几乎无法驱动更新,要么因噪声而产生误导性的优化方向。这不仅浪费了计算资源,更可能导致模型能力的退化。
面对这一挑战,现有方案存在明显的局限性。一种思路是增大奖励模型的规模——更大的 [[奖励模型]] 往往拥有更强的辨别能力,能在细微差异处给出更有意义的分数。然而这带来了沉重的计算和部署成本,且无法从根本上解决「候选趋同」这一问题,因为规模再大的静态评估器也难以适应策略能力持续提升所带来的分布漂移。另一种思路是预先设计固定的评分细则(rubric),但静态细则无法捕捉不同候选集合之间的差异,当策略能力提升后,原本精心设计的细则也可能变得不再适用。
基于此,本文的核心切入点是:评估器不应是静态的、被动的打分工具,而应与策略模型形成协同演化的闭环。当策略生成的候选集合发生变化时,评估器也应当相应地调整其判别标准,从而在新的候选空间内保持有效的区分能力。
方法
DynamicRubric 的设计哲学建立在一个关键的理论发现之上。论文从概率分配的视角对策略优化进行了刻画:策略模型本质上是在多个候选回复之间分配概率质量,而优化的目标是让更高的概率落在更优质的回复上。论文证明了一个优雅的结论——将概率质量从一个响应转移至另一个响应的方向性增益,恰好等于这两个响应之间评估器分数差的期望值。用数学语言可以表述为,策略优化的梯度方向与评估分数差成正比,这使得相对分数差成为驱动策略更新的核心信号。
这一理论洞察直接指向了问题的本质:如果候选回复质量趋同导致分数差坍缩,那么解决方案就不在于设计更复杂的静态评分规则,而在于让评估器能够感知候选集合的上下文,针对每组候选动态生成判别依据。
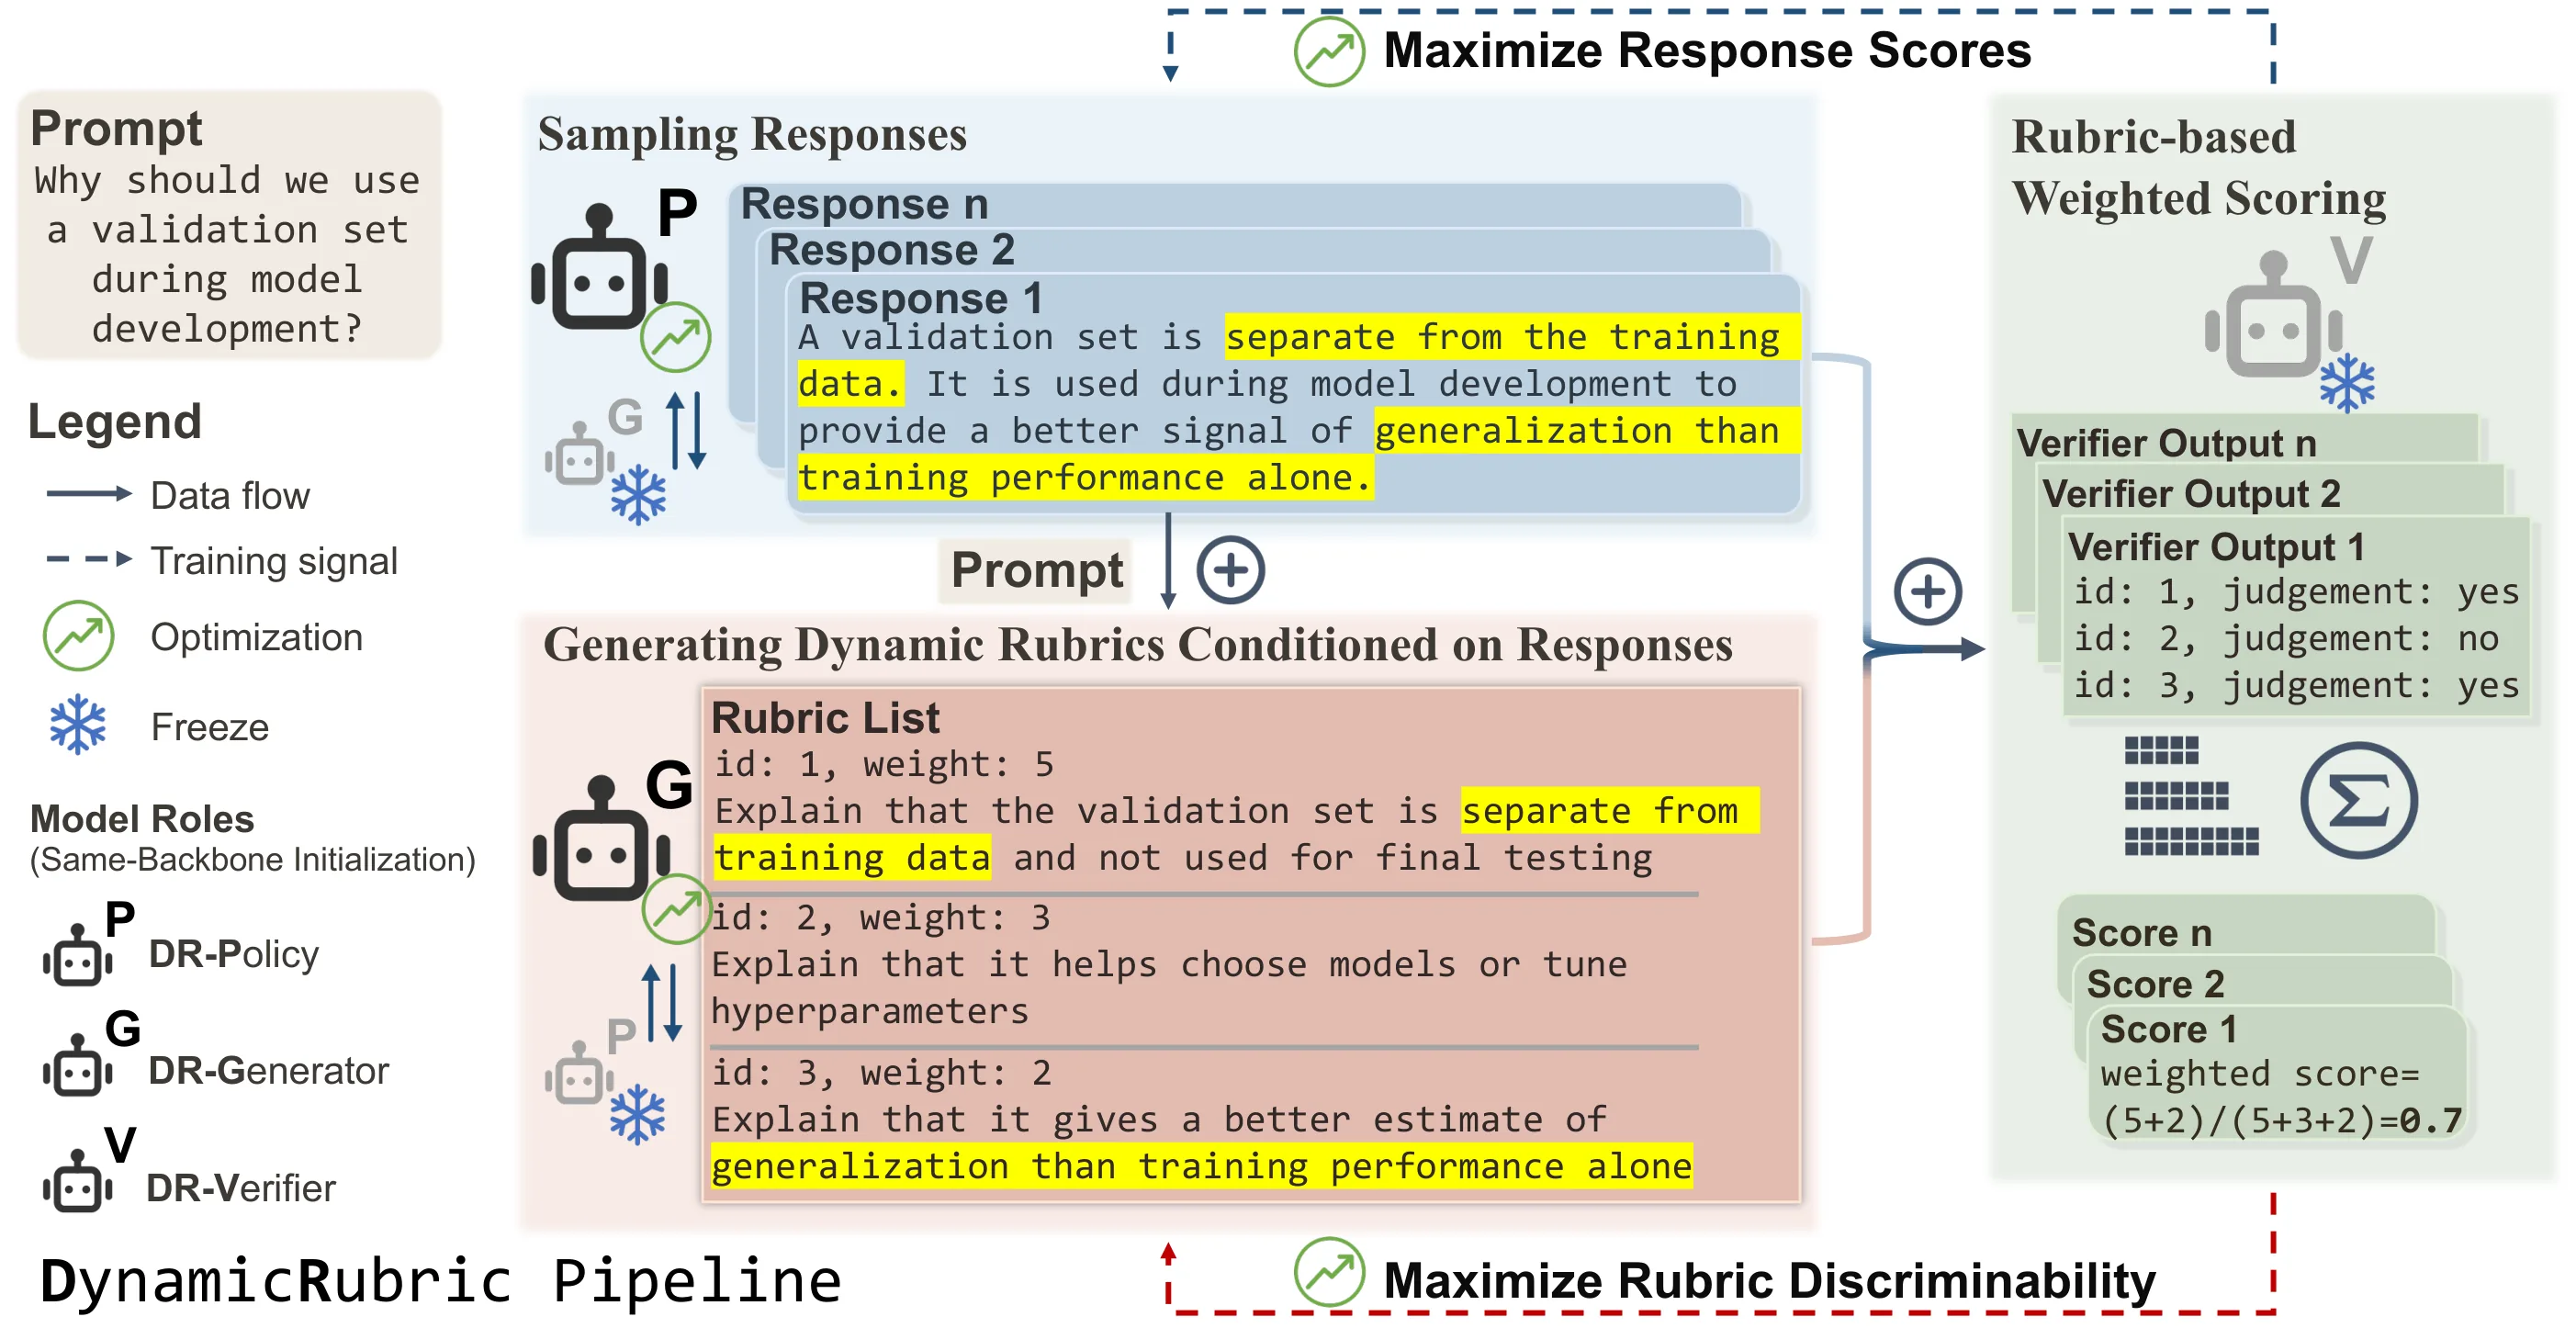
基于上述理论,DynamicRubric 提出了一个精巧的框架,它以候选回复集合为条件,动态生成加权二元评分细则项。具体而言,给定一组候选回复,框架首先利用一个 [[大语言模型]] 作为评分细则生成器,针对这组特定的候选生成若干个二元判断项(binary rubric item)。每个二元判断项对应一个简单的问题:「回复 A 在某个维度上是否优于回复 B?」生成器会根据候选集合的具体内容来判断哪些维度是具有区分力的,并据此生成相应的判断项。
每一个二元判断项并非等权聚合,而是被赋予一个可学习的权重。这个权重的设计体现了动态调整的思想:对于某组候选集合,某些维度的判断可能更具区分力(权重较高),而另一些维度可能几乎无法区分优劣(权重较低甚至为零)。通过 [[加权聚合]] 的方式,各个二元判断项的结论被综合为一个响应级别的最终分数。
整个框架的关键创新点在于其条件性(conditioning):评估器的评分细则不是预先固定的,而是在看到具体候选集合后才动态生成的。这使得评估器能够自适应地聚焦于候选之间真正存在差异的维度,从而在候选质量趋同的情况下依然保持有效的判别能力。这种设计也实现了评估器与策略的协同演化——当策略生成了新的候选分布时,评估器会自动调整其评分细则来适应这一变化,而非固守过时的判别标准。
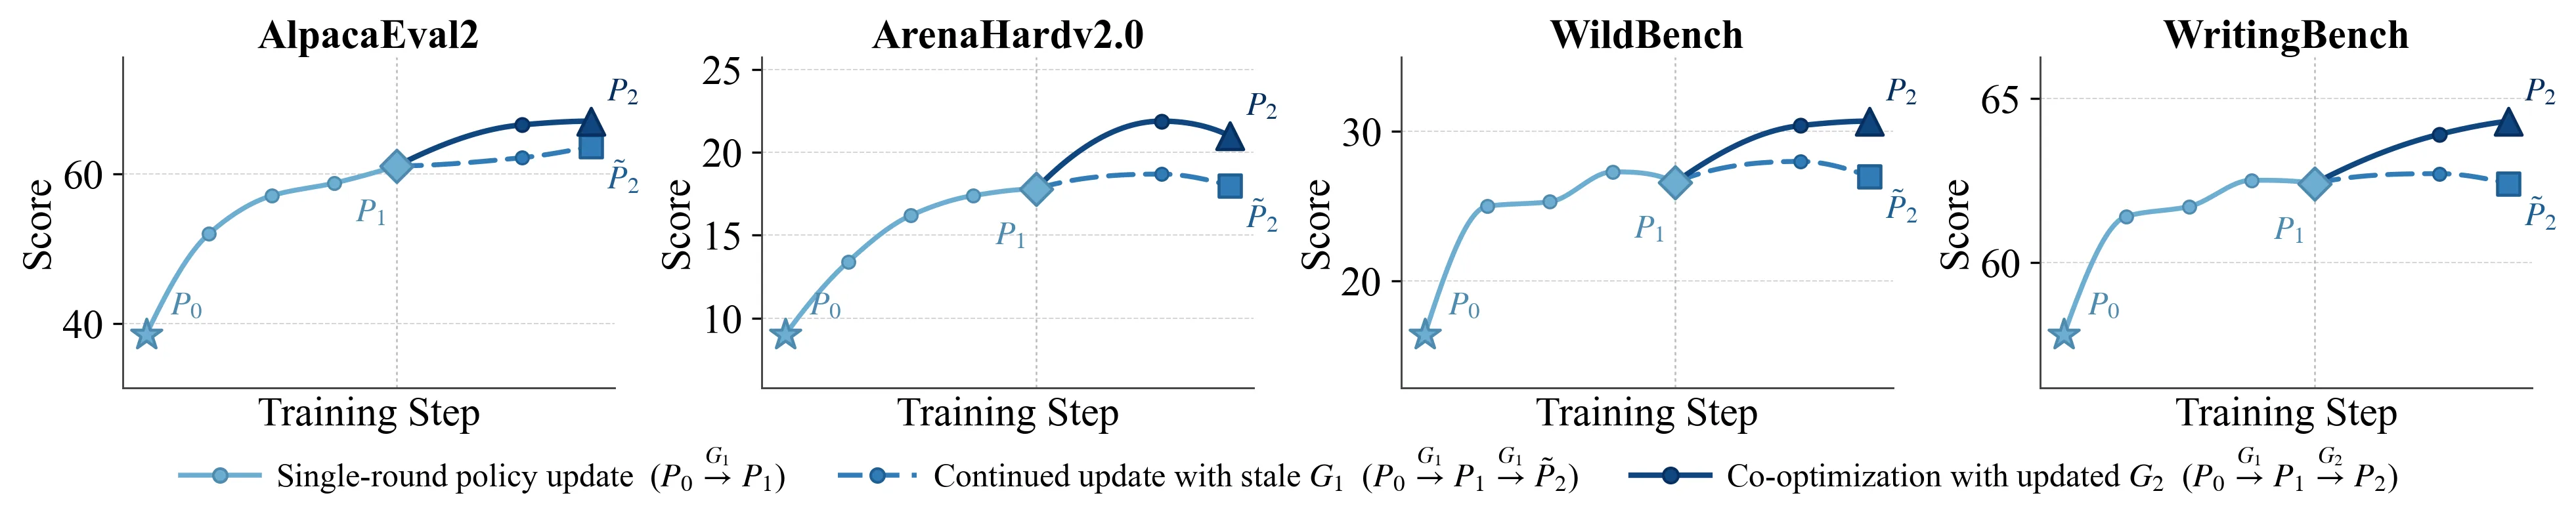
值得注意的是,框架中的评分细则生成器与策略模型可以是不同规模的模型。实验表明,仅使用 8B 参数规模的基座模型,配合动态生成的评分细则,就能超越使用 70B 奖励模型或 235B 静态评分细则生成器的基线方案,显示出条件生成策略相比静态大规模评估的效率优势。
实验与结果
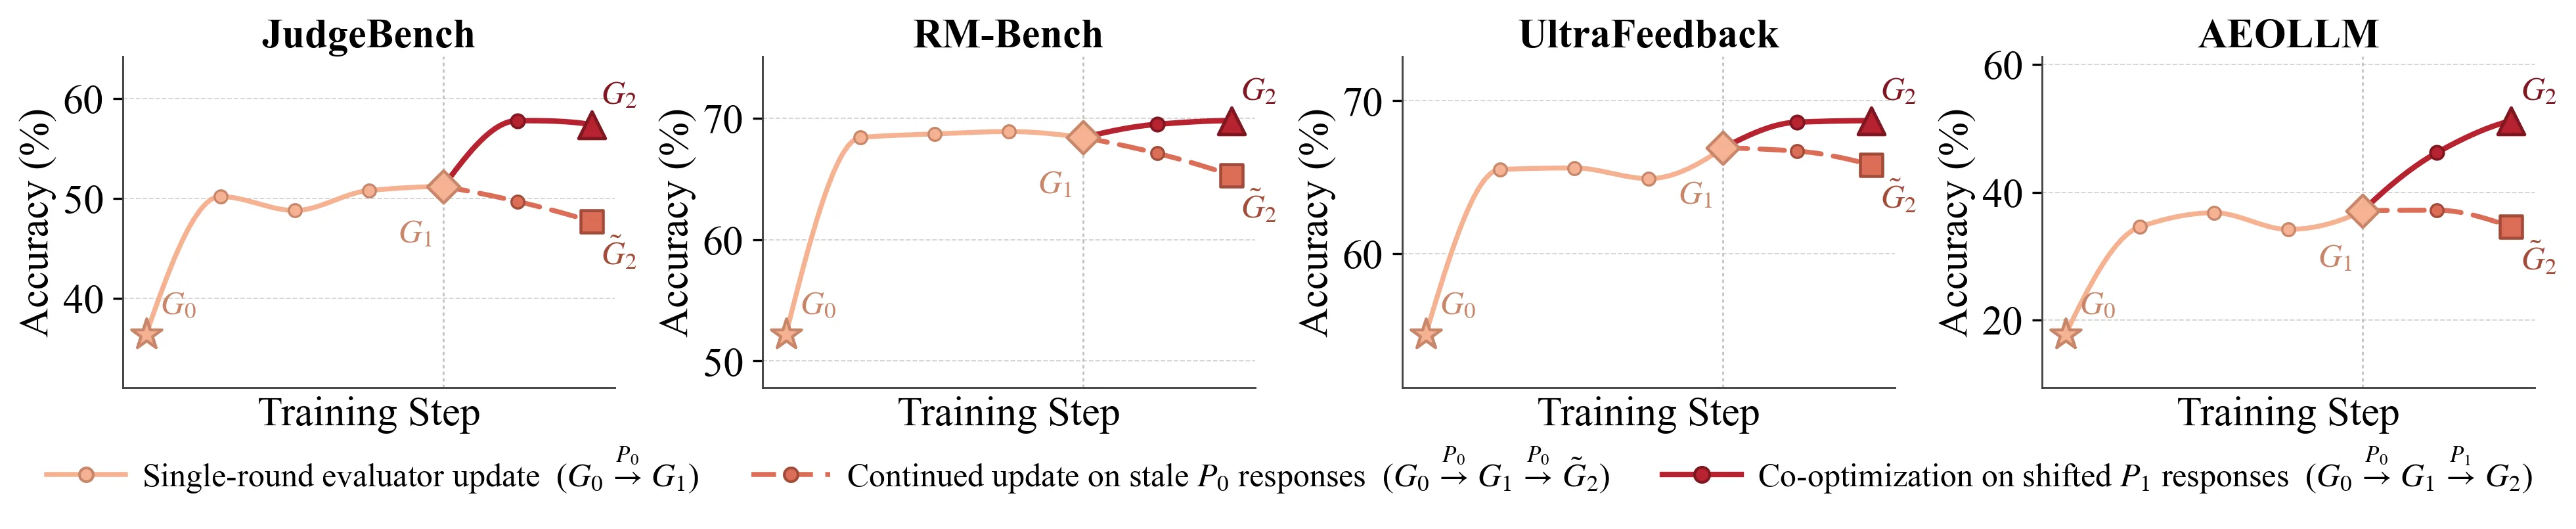
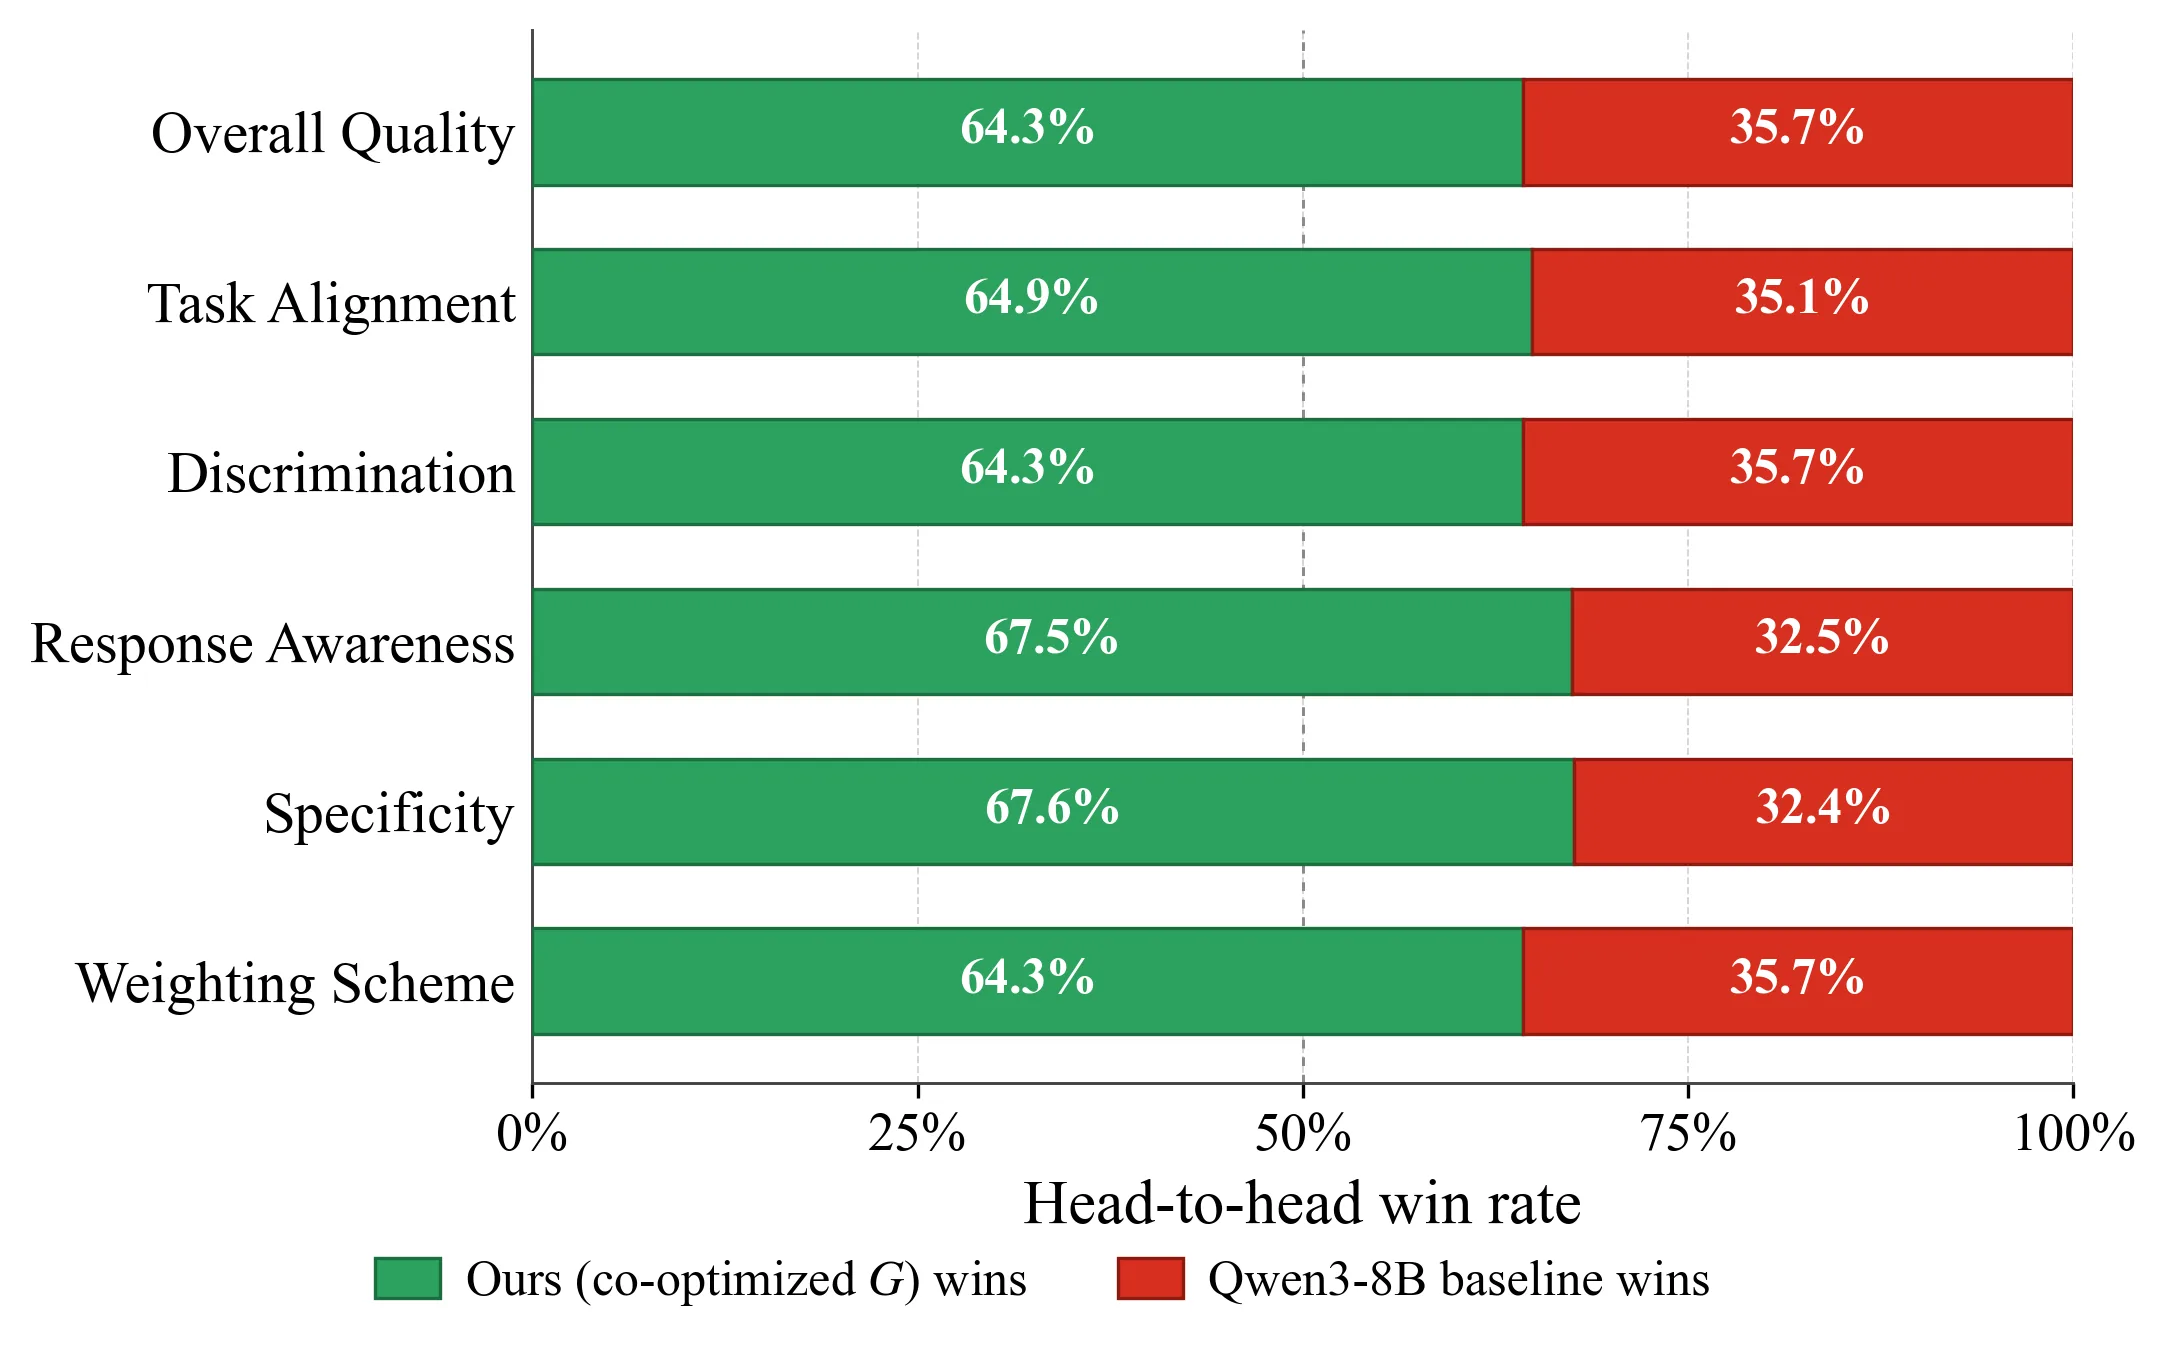
论文在多个维度上验证了 DynamicRubric 的有效性。在评估器性能方面,实验设置了与多种强基线的对比:一种是规模达到 70B 的奖励模型,另一种是使用 235B 静态评分细则生成器的方案。实验结果表明,DynamicRubric 在多个评测基准上取得了显著的提升,特别是在候选回复质量接近的场景下,其评估器依然能够给出具有区分力的分数差。
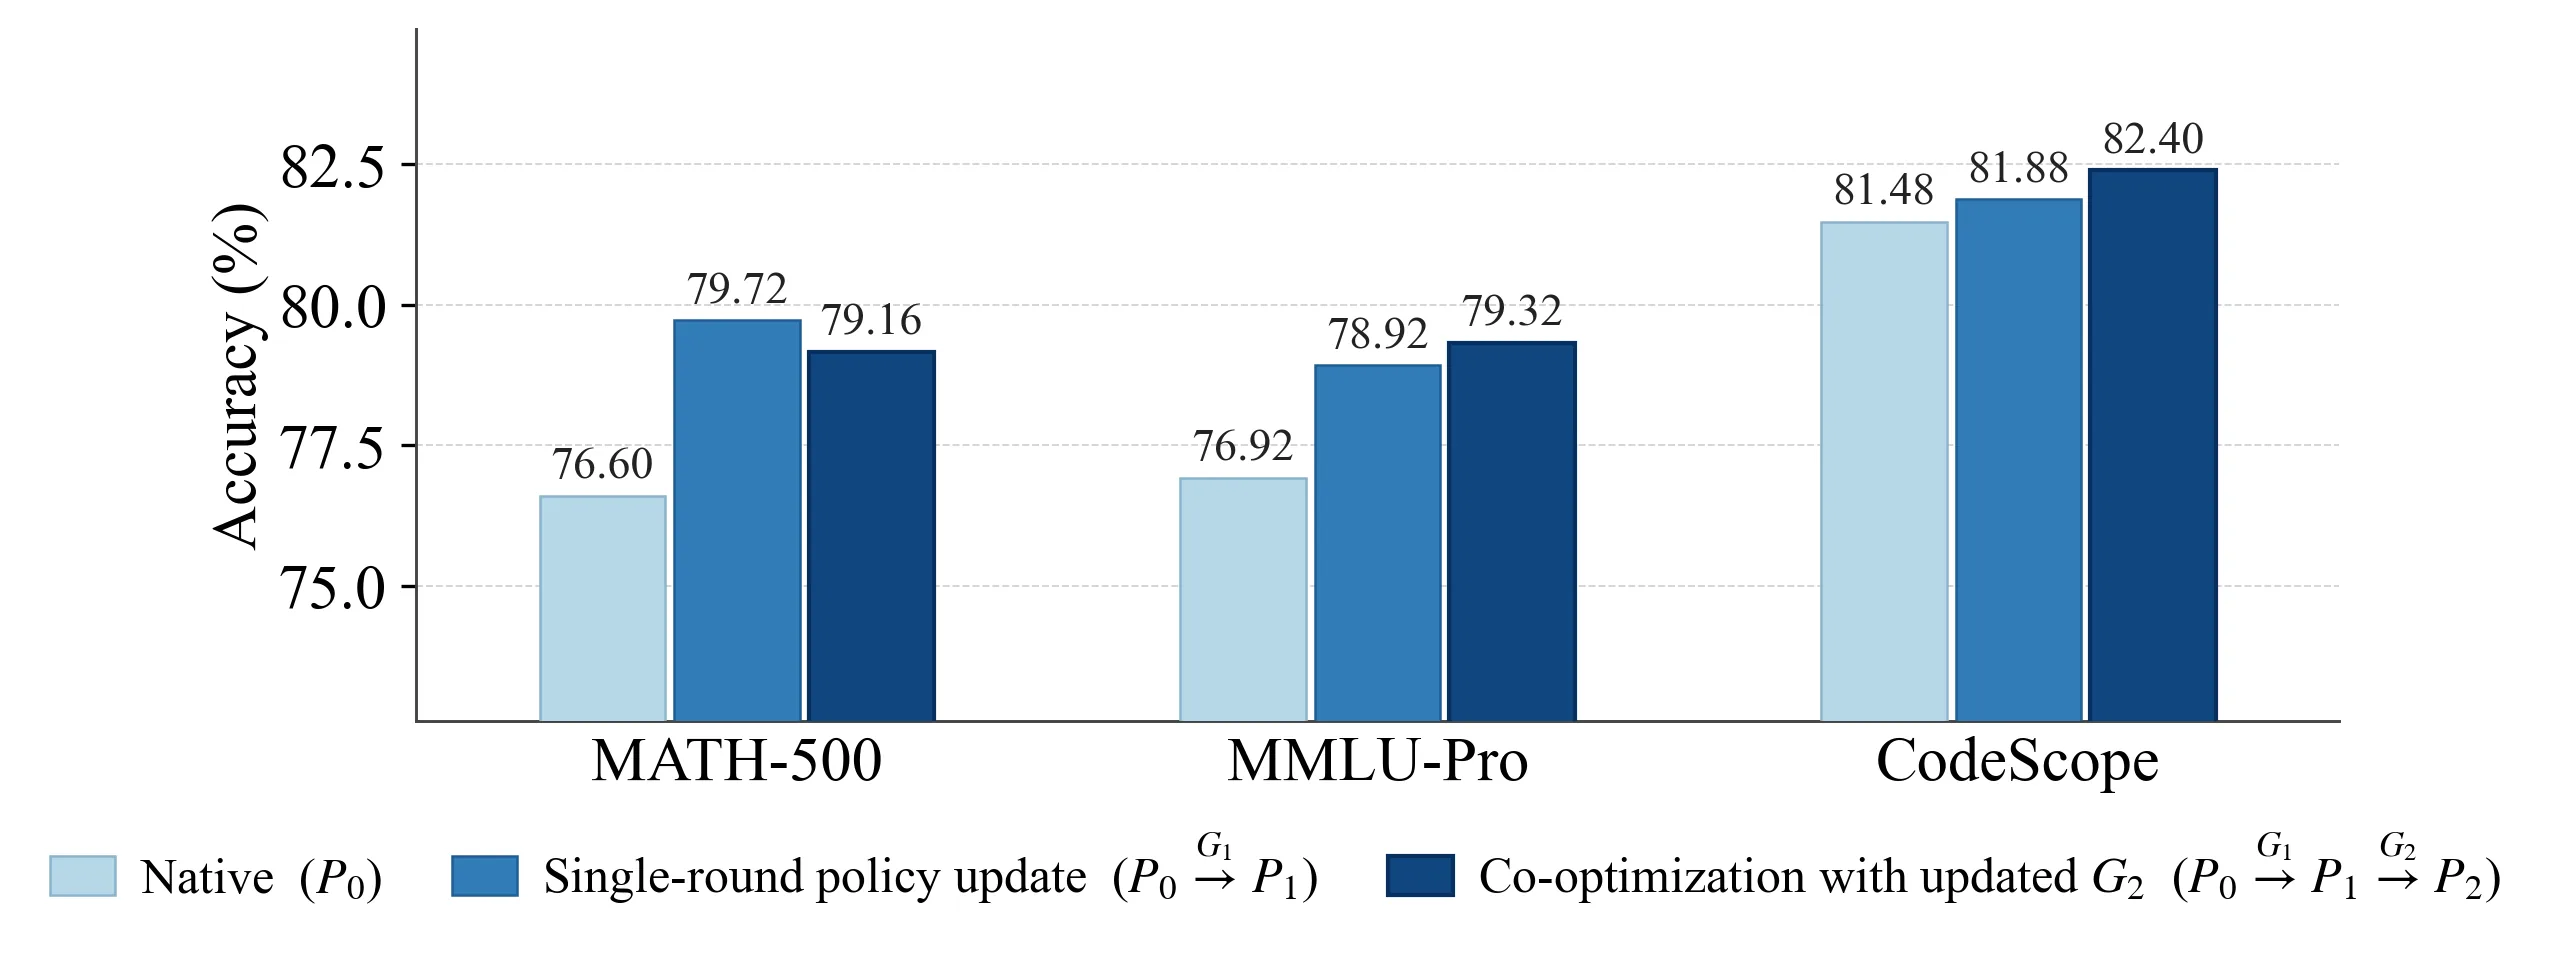
为了验证评估器的改进能否真正转化为策略优化的收益,论文进一步在可验证的推理任务和编程任务上进行了实验。结果显示,经过 DynamicRubric 优化的策略模型在数学推理和代码生成等任务上均展现出性能提升。这一结果验证了论文的核心论点:更强的评估器信号确实能够带来更好的策略优化效果。
论文还进行了消融实验来分析不同组件的贡献。结果表明,动态生成评分细则相比静态细则的优势是显著的,尤其是在候选质量分布发生变化时。同时,加权聚合机制相比等权聚合能够进一步提升评估器的判别能力,这验证了让评估器自适应调整各维度重要性的必要性。
最令人的实践验证来自线上部署。DynamicRubric 优化后的模型已完整部署于微信搜索的 AI 问答场景,这是业界少有的将后训练研究成果直接应用于大规模线上产品的案例。该模型目前承担着全部的在线流量,日均处理数千万次用户请求,并在关键在线指标上取得了改善。线上实验的结果证明了 DynamicRubric 在真实应用场景中的可靠性和实用性。
讨论与可借鉴点
这篇论文的核心贡献在于揭示了评估器与策略之间协同演化的必要性,并提供了一个可行的技术方案来实现这种协同演化。论文的理论分析从概率分配的角度建立了评估分数差与策略优化方向之间的精确联系,这一洞察不仅解释了为何分数坍缩会损害策略优化,也为设计更有效的评估器指明了方向。
DynamicRubric 的动态评分细则生成机制提供了一种优雅的思路:与其让评估器记住一套固定的判别标准,不如让它具备根据上下文灵活调整的能力。这种「因地制宜」的评估策略在候选分布持续变化的后训练场景中尤为重要。
当然,DynamicRubric 也存在一些局限和值得进一步探索的方向。首先,动态生成评分细则带来的额外计算开销需要权衡,尤其在推理时延敏感的线上场景中。其次,评分细则生成器的质量直接影响了最终评估器的性能,如何保证生成器在各种候选集合上都产生高质量的判断项仍是一个开放问题。此外,当前框架主要针对可验证的推理和编程任务设计,在开放域生成或主观偏好较强的任务上的表现还有待验证。
对于后续研究而言,这篇论文提出的「评估器应与策略共同演化」这一原则具有广泛的启发意义。无论是探索更高效的协同演化机制、设计能够捕捉更丰富语义维度的评分细则生成器,还是将协同演化的思想推广到其他评估场景(如 [[多智能体系统]] 中的互相评估),都值得深入研究。在大模型能力持续提升、后训练需求日益增长的背景下,DynamicRubric 为构建更高效、更适应性强的训练范式提供了有价值的参考。
摘要
在策略生成的样本上利用评估器反馈进行后训练,是改进大语言模型的重要机制。随着策略能力的提升,这些采样生成的响应在质量上彼此接近。这些相近的候选响应给策略优化带来了瓶颈:评估器相对分数的塌缩导致策略监督信号微弱甚至产生误导。我们从概率分配的角度对其进行理论刻画,表明将概率质量从一个响应转移到另一个响应所产生的方向性增益,恰好等于两者之间的评估器分数差。这一结果将相对分数差确立为引导更新的策略优化信号。基于这一视角,我们提出 DynamicRubric,一种以响应集为条件的评估器–策略协同演化框架。它为每个候选集合生成加权二元评分细则项,并将所得判断聚合为响应级别的评分。在以 8B 规模模型为骨干的实验中,DynamicRubric 在评估器性能上取得了提升,并比使用 70B 奖励模型或 235B 静态评分细则生成器的基线提供了更强的策略监督信号。经 DynamicRubric 优化的策略在可验证的推理与编程任务上也表现出性能提升。DynamicRubric 优化后的模型已完整部署于微信搜索的 AI 问答场景,每日处理数千万次在线请求,并改善了关键在线指标。这些结果表明,面向评估器引导的后训练应遵循一条原则:评估器应当与它们所监督的策略共同演化。
Abstract
Post-training with evaluator feedback on policy-induced samples serves as a major mechanism for improving large language models. As policies improve, these sampled responses become close in quality. These close candidates create a bottleneck for policy optimization: collapsed relative evaluator score gaps yield weak or misleading policy supervision. We theoretically characterize why these gaps matter through a probability allocation view, showing that the directional gain of shifting probability mass from one response to another is exactly the evaluator score gap between them. This identifies relative score gaps as the policy optimization signals that guide updates. Motivated by this view, we propose DynamicRubric, a response-set-conditioned evaluator--policy co-evolution framework that generates weighted binary rubric items for each candidate set and aggregates the resulting judgments into response-level scores. In our experiments with 8B backbones, DynamicRubric improves evaluator performance and provides stronger policy supervision than baselines using a 70B reward model or a 235B static rubric generator. DynamicRubric-optimized policies also show gains on verifiable reasoning and coding tasks. A DynamicRubric-optimized model is fully deployed in WeChat Search's AI answering scenario, where it serves all online traffic across tens of millions of requests per day and improves key online metrics. These results suggest a principle for evaluator-guided post-training: evaluators should evolve with the policies they supervise.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。