
基于记忆的协调:面向动态制造中多智能体自适应训练的图结构经验复用
Coordinating from Memory: Graph-Structured Experience Reuse for Multi-Agent Adaptation in Dynamic Manufacturing
📝 TLDR
动态制造环境中多智能体需在机器故障、急件到达等频繁扰动下协同,但现有MARL独立处理每次扰动而丢弃宝贵协同经验。本文提出图结构经验记忆(GSEM)框架,将历史协同事件编码为异构图,借助GNN检索相似经验实现策略自适应。实验表明相比最强记忆增强基线,makespan降低4.1%-10.0%、适应时间缩短33%-38%,扰动越频繁优势越大,并具备跨扰动泛化能力。
🧭 速览
现有MARL将每次扰动视为独立事件,丢弃了可加速未来适应的协同经验。
GSEM框架将历史协同编码为异构图(任务依赖、机器状态、协作模式),用GNN检索结构相似过往经验,指导策略自适应而非从头学习。
在动态柔性作业车间调度基准上,makespan降低4.1%-10.0%,适应时间缩短33%-38%,且扰动频率越高优势越明显。
消融与跨扰动迁移实验验证了图结构编码和相似检索的必要性,证明所学协同模式具备跨扰动泛化能力。
🆚 方法对比
Graph-Structured Experiential Memory (GSEM)
- 相较最强基线降低工期4.1%–10.0%
- 相较最强基线缩短适配时间33%–38%
- 扰动越频繁,优势幅度越大
- 跨扰动迁移验证协调模式可泛化
- 依赖完整图结构与相似历史
- 检索偏差可能误导策略适配
- 仅验证三类制造扰动
- 未报告真实车间在线结果
Multi-Agent Reinforcement Learning (MARL)
- 将决策分布到机器或生产单元
- 支持系统级多智能体协调
- 便于各智能体分布式调整动作
- 通常将扰动事件相互独立处理
- 跨事件协调经验复用不足
- 异构扰动下泛化能力有限
Heterogeneous Relational Graph Encoding
- 保留任务依赖与机器状态
- 表征智能体间协作模式
- 消融验证图编码的必要性
- 图构建与更新增加流程复杂度
- 结构噪声会降低检索可靠性
- 收益主要在三类扰动中验证
Graph Neural Networks (GNNs)
- 可有效建模制造关系结构
- 适合先序约束与资源竞争
- 能够表征跨智能体依赖
- 既有应用多用于当前状态编码
- 图推理增加检索计算开销
- 效果依赖图谱质量
GNN-based Graph Similarity Retrieval
- 基于图相似而非平面近邻
- 消融验证检索的必要性
- 结合经验质量与时效加权
- 相似度误差会检索到无关经验
- 额外推理增加计算开销
- 缺少真实规模系统压力测试
Quality-Recency Weighting
- 同时考虑经验质量与时效性
- 兼顾复用可靠性与状态变化
- 提升检索经验的时效性
- 陈旧高质量经验仍可能被选中
- 近期低质量经验也可能干扰
Gated Attention Fusion
- 按门控选择检索经验
- 将历史记忆与当前策略融合
- 可抑制部分无关经验干扰
- 增加门控与注意力参数
- 错误记忆可能被注意力放大
- 论文未量化单组件收益
Memory-Conditioned Communication
- 通过通信共享历史恢复模式
- 将经验复用引入执行期协作
- 支持智能体集体利用记忆
- 错误经验可能跨智能体传播
- 增加通信与策略耦合复杂度
- 论文未报告通信成本
Rule-Based Coordination
- 稳定环境下规则协调有效
- 预定义协议便于任务分配
- 难以适应机器故障等突发扰动
- 处理时间变化时适应性较弱
- 无法复用跨事件协调经验
Contract-Net-Style Negotiation
- 通过协商协议分配制造任务
- 预定义规则使智能体交互明确
- 固定协商协议难以快速重构
- 面对新扰动时适应性不足
- 不保存历史协调模式
Single-Agent RL
- 集中式策略统一处理调度
- 以马尔可夫决策过程统一建模
- 作业与机器增加时扩展困难
- 决策规模增长带来可扩展性问题
- 未利用跨扰动协调经验
Independent Learning
- 将决策分布到各智能体
- 便于机器或生产单元局部调整
- 各扰动经验通常被孤立处理
- 缺少结构化跨事件记忆
- 多智能体联合协调能力有限
QMIX
- 通过价值分解协调联合决策
- 适用于合作式动态制造调度
- 主要响应当前车间状态
- 难以复用历史协调经验
- 跨异构扰动泛化能力有限
Multi-Agent Proximal Policy Optimization (MAPPO)
- 面向多智能体合作策略优化
- 适用于动态制造联合决策
- 主要依赖当前策略应对扰动
- 缺少跨事件结构化记忆
- 新扰动下适配速度受限
Replay Mechanisms
- 重放转移数据提高训练效率
- 便于接入既有强化学习流程
- 重放内容主要是非结构化转移
- 执行期难以快速适配新扰动
- 跨异构扰动泛化能力有限
Flat Episodic Memory
- 事件级表示与检索较简单
- 平面状态可直接进行比较
- 无法保留先序约束与资源竞争
- 难以表征多智能体依赖关系
- 无法表示可复用恢复模式
GSEM通过图结构编码、结构相似检索、门控融合与记忆条件通信复用跨扰动经验,在工期和适配时间上均优于最强记忆增强基线。规则协商、单智能体强化学习、独立学习、QMIX和MAPPO主要依赖当前策略或重放,缺少结构化的跨事件协调记忆。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文针对动态制造环境中多智能体系统在频繁扰动下协同困难的问题,提出了图结构经验记忆(GSEM)框架。该框架将历史协调事件编码为异构图,利用图神经网络检索结构相似的过往经验来指导策略自适应,而非从零学习。实验在动态柔性作业车间调度基准上验证了方法的有效性,相比最强记忆增强基线,完工时间降低 4.1%–10.0%,适应时间缩短 33%–38%,且扰动越频繁优势越显著。
研究背景与动机
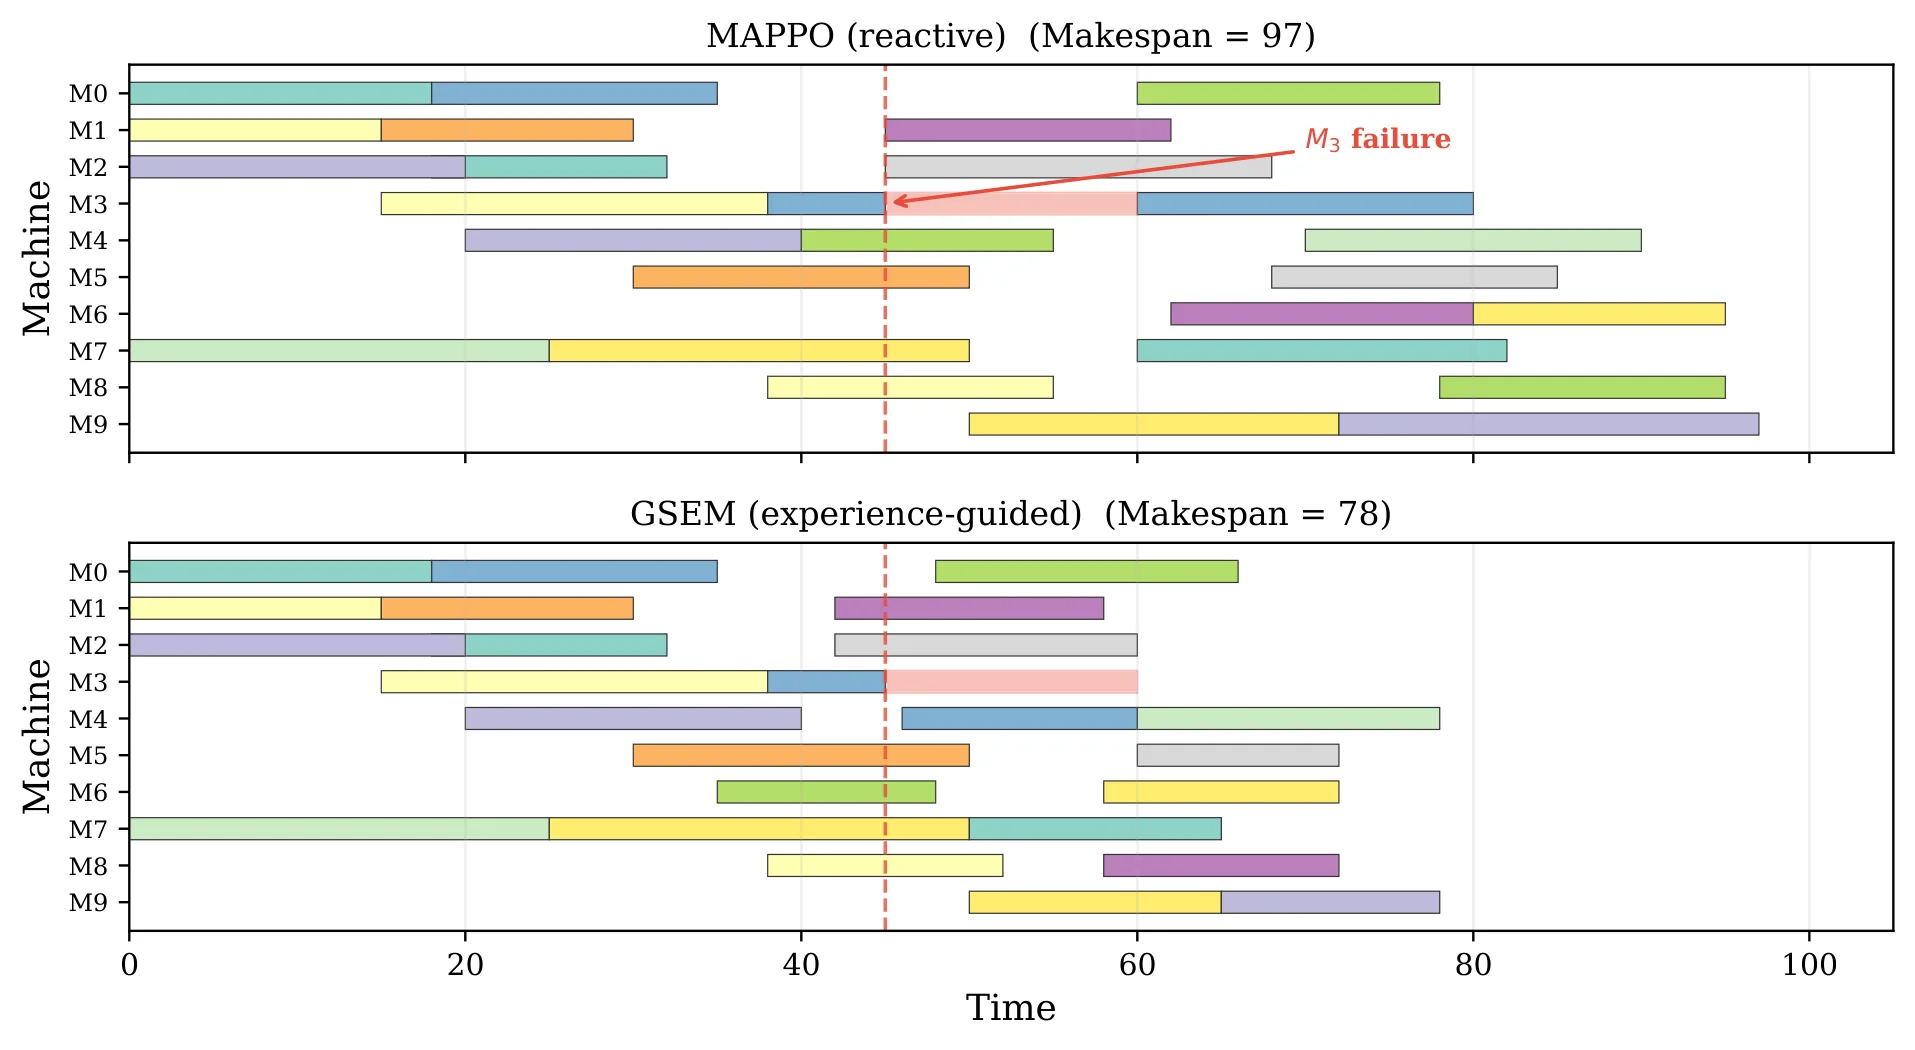
现代制造系统正经历深刻的变革。工业 4.0 背景下,车间调度面临机器故障、紧急订单到达、处理时间波动等多种动态扰动,这些扰动会在机器、工件、生产阶段之间传播,形成级联效应。动态柔性作业车间调度问题(Flexible Job-Shop Scheduling Problem,F-JSP)正是这一场景的典型抽象——每个工件包含多道工序,每道工序可由多台兼容机器执行,智能体需要协同决策工序分配与排序,同时应对上述扰动。
现有的多智能体强化学习方法(如 QMIX、MAPPO 等)在处理这类问题时,通常将每一次扰动事件视为独立的训练回合,仅依赖当前策略或经验回放缓冲区中的 transition 进行学习。这种做法丢弃了历史中宝贵的协调经验,导致系统在面对新扰动时需要"从头学起",适应速度慢、跨扰动的协调模式复用性差。论文敏锐地指出,真正值得复用的并非原始的过往状态,而是可复用的恢复模式(recovery motif)——例如机器故障后的协同重路由、紧急订单插入后的队列再平衡、处理时间波动下的冲突消解。这些模式本质上具有关系结构,传统的平面化经验记忆无法有效保留这种结构信息。
这一洞见成为 GSEM 的核心出发点:需要一种能够编码和检索结构化经验的方法,使系统能够在历史中找到与当前扰动"结构相似"的过往事件,从而借助经验指导策略自适应。
方法
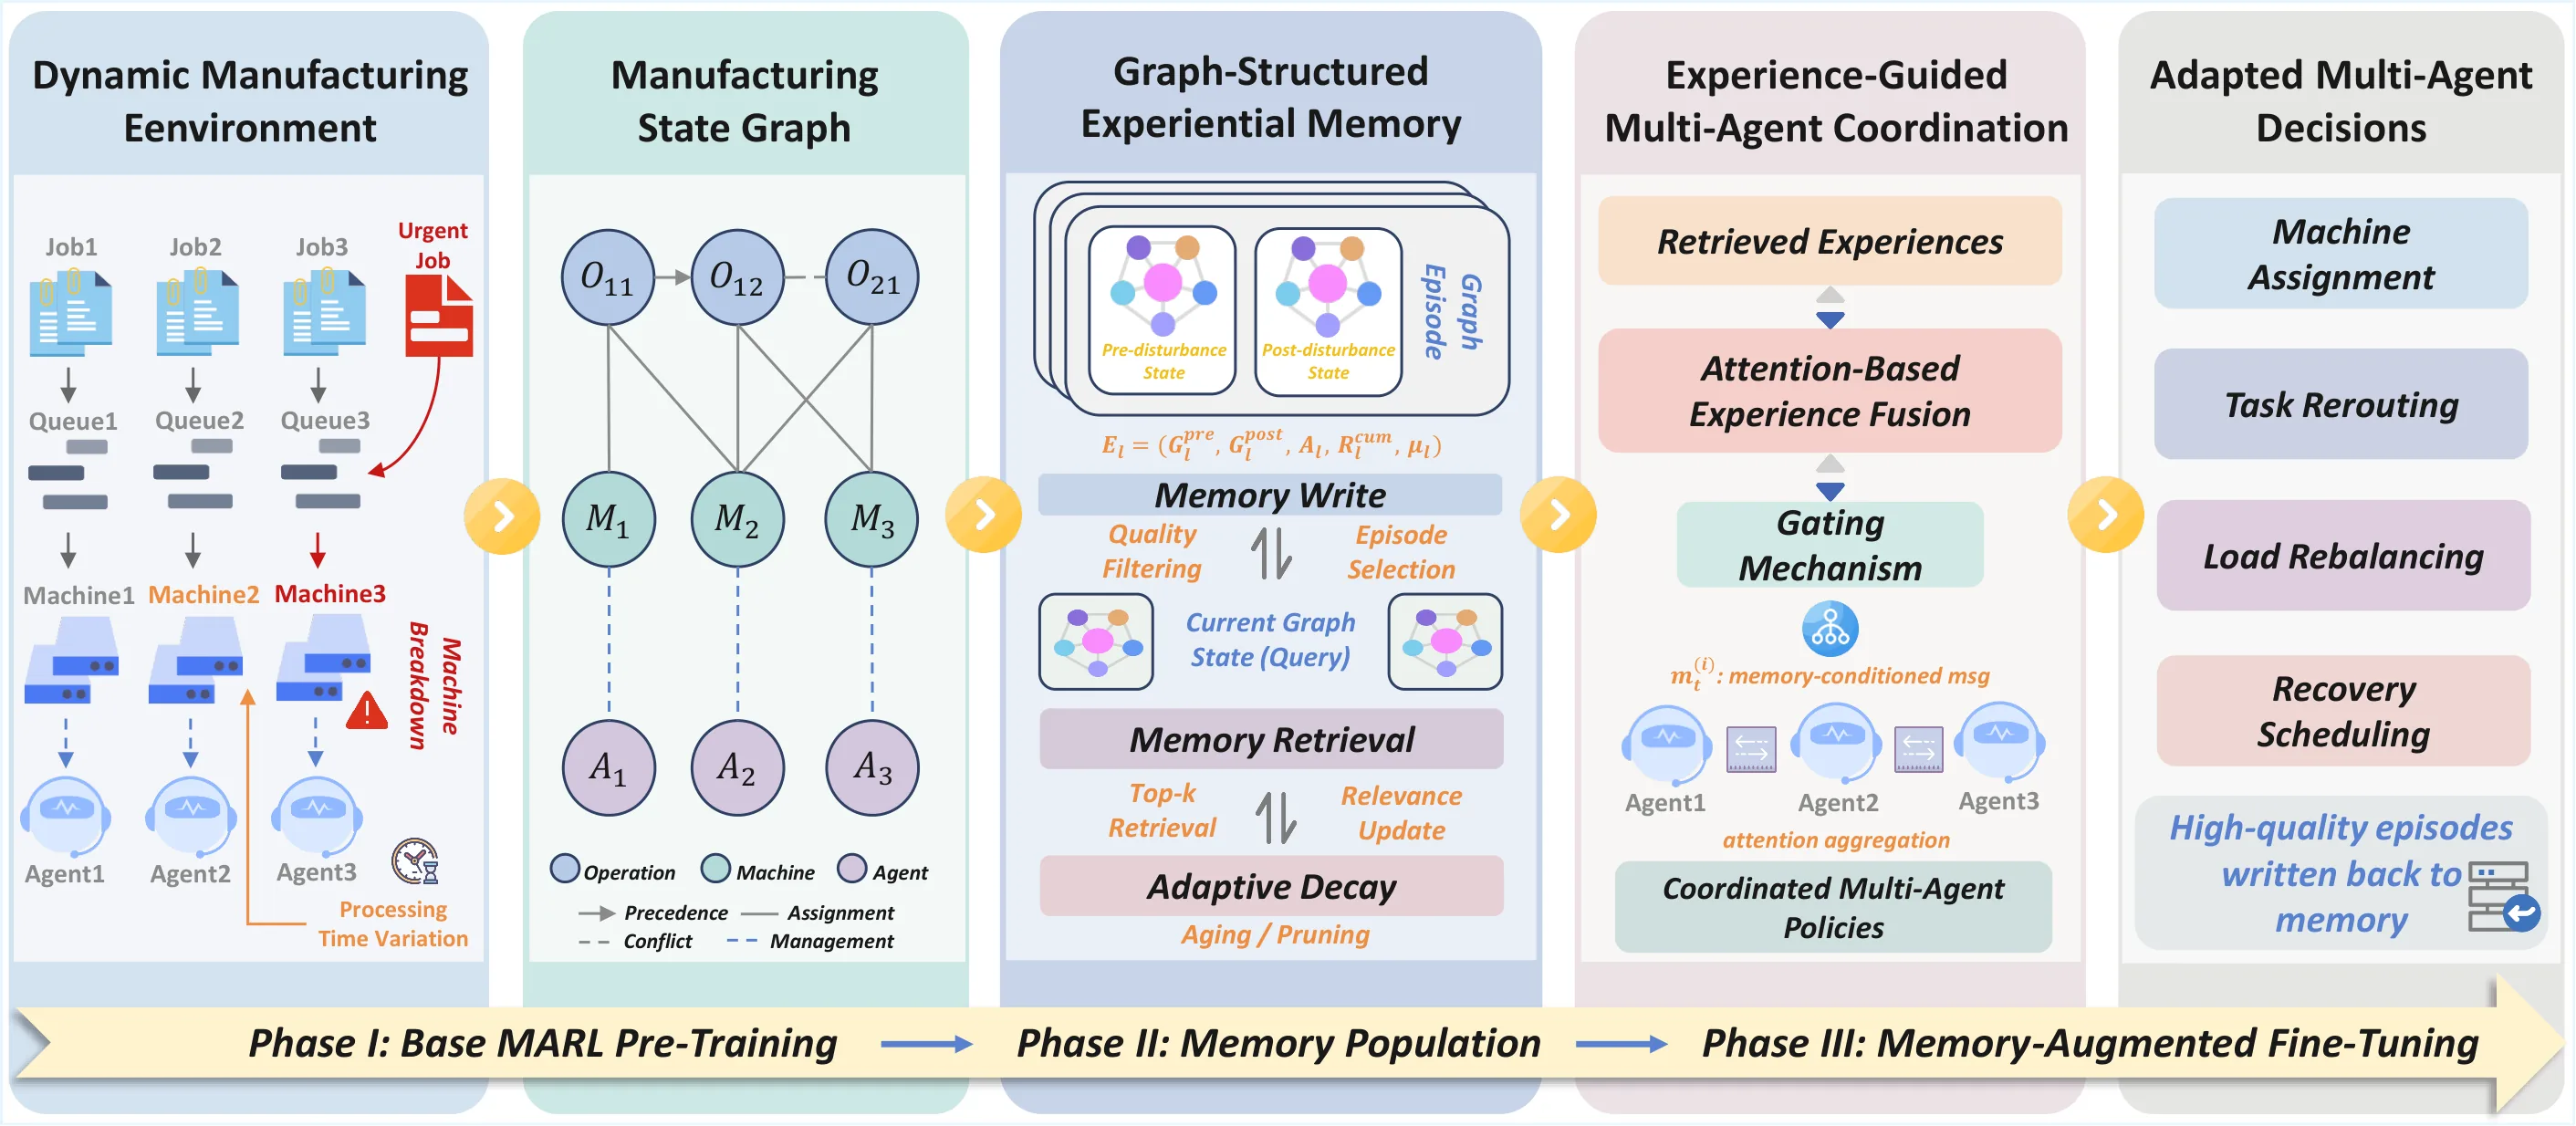
GSEM 框架的整体设计围绕三个核心阶段展开:基础多智能体强化学习预训练、记忆池填充,以及记忆增强的端到端微调。这种分阶段训练范式既保证了基础策略的质量,也避免了冷启动问题。
状态表示:异构关系图的构建。GSEM 的核心创新在于将每个决策点的车间状态表示为异构图 。图中包含三种节点类型——工序节点、机器节点和智能体节点,以及四种边类型:precedence(刻画工序间的先后依赖关系)、assignment(表示工序与兼容机器的关联)、management(连接机器与负责的智能体)、conflict(标识机器间的资源竞争)。这种异构图结构能够完整保留车间调度中的任务依赖、机器状态与协作模式信息。编码器采用 L 层关系图卷积网络(R-GCN),通过类型感知的 readout 函数聚合节点嵌入,生成图级表征向量 。
经验记忆池的结构与管理。记忆池中的每条记忆条目记录为一个五元组 ,包含扰动前后两个时间点的状态图、恢复期间的联合动作序列、累积奖励及元数据。论文设计了质量过滤器,仅保留累积奖励高于阈值的高质量恢复事件。记忆条目还维护一个相关性分数 ,被检索并成功使用的条目获得奖励增量,未被使用的条目随时间衰减,当容量超限时淘汰分数最低者。这种自适应机制确保记忆池始终保持与当前任务分布最相关的经验。
基于图相似度的检索机制。当新扰动发生时,系统需要从记忆池中检索结构相似的过往事件。检索相似度函数综合考虑图级表征的余弦相似度、记忆条目的质量分数,以及时间衰减因子。当前的图嵌入与历史状态图嵌入越相似、历史表现越好、距离当前时间越近的记忆条目越可能被选中。通过最大边际相关(MMR)策略选取 Top-K 个记忆条目,在检索相关性与多样性之间取得平衡。
经验引导的多智能体协调。选中的记忆条目被编码为统一的经验表征向量,与当前状态的 R-GCN 嵌入通过交叉注意力机制融合。每个智能体将自身的节点嵌入作为 query,以记忆表征作为 key/value 计算注意力权重,聚合相关经验信息。门控机制进一步自适应平衡当前状态与经验指导的权重——扰动初期倾向于依赖经验,随着适应进行逐渐转向当前策略。此外,智能体间的通信也受记忆条件调制,通过邻居注意力机制聚合来自协作智能体的消息,最终策略以拼接后的表征为输入。
训练信号的增强。除标准的多智能体策略梯度损失外,GSEM 还引入对比损失 ,将同类扰动的图嵌入在表征空间中拉近,辅助编码器更好地区分不同类型的扰动模式,提升检索质量。
实验与结果
实验在动态柔性作业车间调度基准上进行,场景包含 10 工件 × 10 机器、5 个调度智能体,每道工序兼容 2–4 台机器。动态扰动涵盖机器故障、紧急订单到达和处理时间波动三类,扰动频率分为低(2–3 次/episode)、中(5–7 次)、高(10+ 次)三个等级。
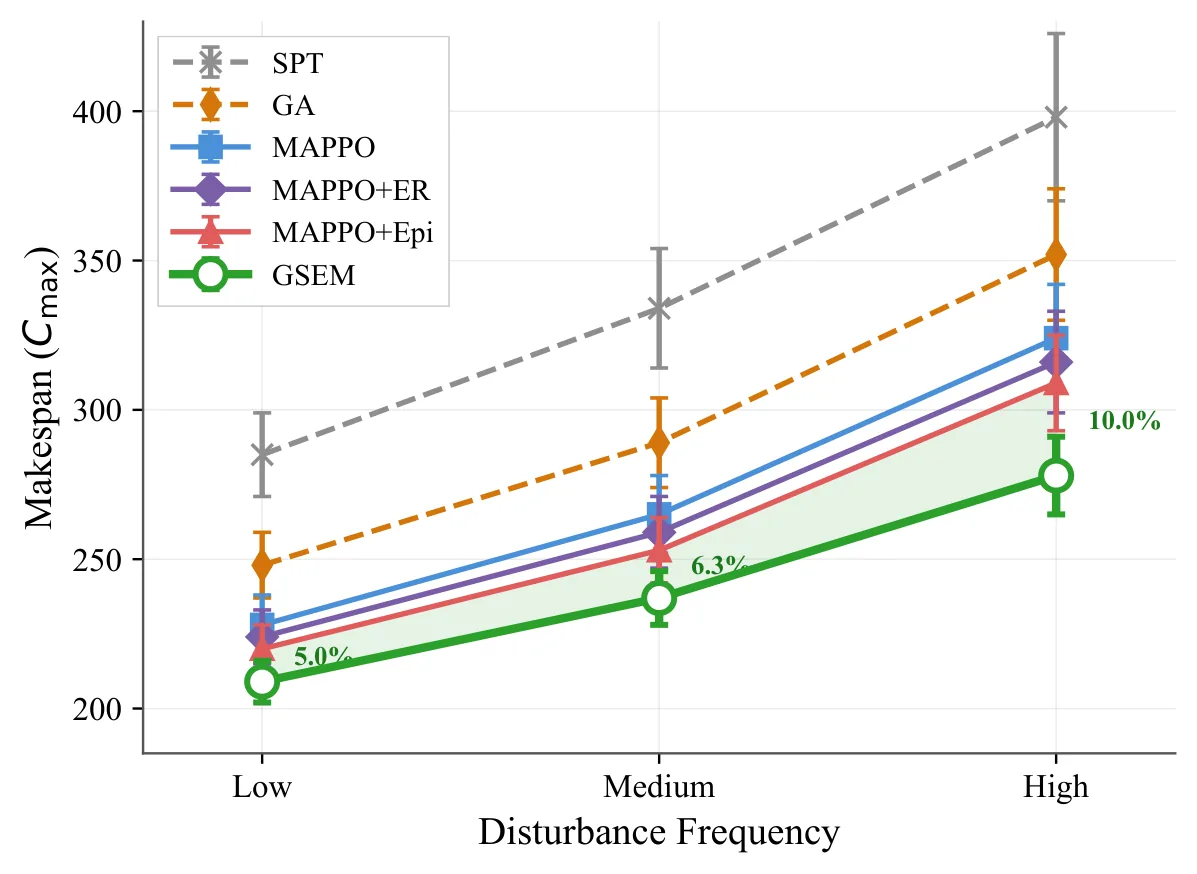
主实验结果表明,GSEM 在所有测试场景中均取得最佳性能。相较于最强的记忆增强基线 MAPPO+Epi,完工时间缩短 4.1%–10.0%,自适应步数减少 33%–38%。值得注意的是,扰动频率越高,GSEM 的优势越显著——高频混合扰动下完工时间优势从 5.0% 扩大到 10.0%,机器利用率从 65.1% 提升至 71.2%。这一结果有力证明了图结构经验记忆在应对级联扰动时的有效性。
消融实验揭示了各模块的贡献。将图结构替换为平面向量后,完工时间增加 6.3%,随机检索导致最大性能退化(8.0%),门控机制贡献 4.2% 的改善,记忆条件通信贡献 5.1%。这些数字清晰表明,图结构编码与相似度检索并非锦上添花,而是方法有效性的核心来源。
跨扰动迁移实验进一步验证了所学协调模式的泛化能力。以单一扰动类型构建记忆池时,仍优于无记忆基线;以混合扰动为记忆源时泛化最强。这说明 GSEM 学到的是可迁移的协调模式,而非针对特定扰动类型的表面关联。
讨论与可借鉴点
GSEM 论文的核心贡献在于将"结构化经验复用"引入多智能体强化学习,为动态环境中的快速自适应提供了新思路。其方法论层面的启示值得借鉴:经验记忆的设计不应止步于存取原始状态-动作对,而应提取并保留环境中的关系结构;检索机制需要兼顾相关性、多样性与时效性;个体适应与系统级协调的平衡可通过门控与条件通信实现。
然而,该工作也存在可改进空间。论文在更大规模车间(20×20 及以上)、更多扰动类型(物料短缺、人员变动等)、以及与基础模型方法的对比等方面尚未充分探索。此外,计算开销增加约 31% 且对相似历史经验的依赖性强,在完全未见过的全新扰动模式下仍需在线探索。记忆池容量(上限 500 条)与真实工业场景的规模需求之间也存在差距。
对于相关领域的研究者,GSEM 提示了一个重要方向:如何将结构化经验记忆与大型语言模型结合,使系统能够同时利用编码的恢复模式与人类专家的文字经验?这一问题值得在后续工作中深入探讨。
摘要
动态制造环境要求多智能体系统在频繁出现的操作扰动下(如机器故障、紧急订单到达以及处理时间波动)实现有效协调。现有的多智能体强化学习方法将每一次扰动事件独立处理,丢弃了那些能够加速未来自适应训练的宝贵协调经验。本文提出一种面向动态制造中多智能体协调的图结构经验记忆(GSEM)框架。该框架将历史协调事件编码为异构关系图,以刻画任务依赖关系、机器状态以及智能体间的协作模式。当新的扰动发生时,基于图神经网络的检索机制能够识别出结构上相似的历史事件,从而实现由经验引导的策略自适应,而非从头开始学习。在包含三类扰动的动态柔性作业车间调度基准实验上的结果表明,相较于最强的记忆增强基线方法,GSEM 将完工时间缩短了 4.1%–10.0%,并将自适应时间缩短了 33%–38%,且在更高扰动频率下其优势更加显著。消融实验以及跨扰动迁移实验进一步验证了图结构编码与基于相似度检索的必要性,并展示了所学协调模式在不同扰动间的泛化能力。
Abstract
Dynamic manufacturing environments require multi-agent systems to coordinate effectively under frequent operational disturbances such as machine failures, urgent job arrivals, and processing time variations. Existing multi-agent reinforcement learning approaches treat each disturbance episode independently, discarding valuable coordination experience that could accelerate future adaptation. In this paper, we propose a Graph-Structured Experiential Memory (GSEM) framework for multi-agent coordination in dynamic manufacturing. The framework encodes historical coordination episodes as heterogeneous relational graphs that capture task dependencies, machine states, and inter-agent collaboration patterns. When a new disturbance occurs, a graph neural network-based retrieval mechanism identifies structurally similar past episodes, enabling experience-guided policy adaptation rather than learning from scratch. Experiments on dynamic flexible job-shop scheduling benchmarks with three disturbance types show that GSEM reduces makespan by 4.1%-10.0% and adaptation time by 33%-38% compared to the strongest memory-augmented baseline, with the advantage increasing under higher disturbance frequency. Ablation studies and cross-disturbance transfer experiments further validate the necessity of graph-structured encoding and similarity-based retrieval and demonstrate the cross-disturbance generalizability of learned coordination patterns.
论文详细总结(自动生成)
论文总结:GSEM——面向动态制造多智能体自适应的图结构经验复用
一、核心问题与研究动机
研究背景:工业 4.0 时代的现代制造系统具有高产品多样性、短生产周期、高不确定性等特点,车间调度面临机器故障(breakdown)、紧急订单到达(urgent job arrival)、处理时间波动(processing time variation)等多种动态扰动。这些扰动往往会在机器、工件、生产阶段之间传播,使得动态调度本质上是一个分布式在线协调问题。
关键问题:现有的多智能体强化学习(MARL)方法(如 QMIX、MAPPO 等)通常将每次扰动事件视为独立的 episode,仅依赖当前策略或经验回放中的 transition 进行学习,丢弃了历史中宝贵的协调经验,导致:
- 适应速度慢;
- 跨扰动的协调模式复用性差;
- 面对高频级联扰动时性能急剧下降。
核心洞见:需要被复用的不是原始的过往状态,而是可复用的"恢复模式"(recovery motif)——例如机器故障后的协同重路由、紧急订单插入后的队列再平衡、处理时间波动下的冲突消解。这些模式本质上具有关系结构,平面化的 episodic memory 无法保留。
二、方法论:GSEM 框架
GSEM(Graph-Structured Experiential Memory)将历史协调 episode 存储为异构关系图,并通过 GNN 检索结构相似的过往经验来指导策略自适应。整体框架分为三个阶段:
阶段 I:基础 MARL 预训练
使用 MAPPO 训练基础策略,不启用记忆模块。
阶段 II:记忆池填充(Memory Population)
使用阶段 I 的策略 rollout,初始化质量过滤器的统计量 、,将高质量恢复 episode 写入记忆池 。
阶段 III:记忆增强的端到端微调
启用检索与融合机制,、 持续更新,并加入对比损失 。
关键技术细节
(1) 制造状态图(Manufacturing State Graph)
将每个决策点的状态表示为异构图 :
- 节点类型:operation、machine、agent;
- 边类型:precedence(工序优先级)、assignment(操作—机器兼容性)、management(机器—智能体归属)、conflict(机器资源竞争)。
采用 L 层 R-GCN 编码器得到节点嵌入,并通过类型感知的 readout 生成图级嵌入:
(2) 经验记忆池
每条记忆条目为元组:
包含扰动前后的状态图、恢复期间的联合动作序列、累积奖励及元数据。
写入规则:
- Episode 边界通过 突跃(> )与恢复(< )自动检测;
- 仅保留 的高质量 episode。
检索机制:
其中 为 min-max 归一化的质量分数。通过 MMR 选取 Top-K。
自适应衰减:每条记忆维护相关性分数 :
被检索的条目获得奖励 ,未使用条目随时间衰减;容量超限时淘汰 最低者。
(3) 经验引导的多智能体协调
将检索到的 episode 编码为统一表征:
注意力融合(Cross-Attention):每个智能体 的 R-GCN 嵌入 作为 query,episode 表征 作为 key/value:
门控机制:自适应平衡当前状态与经验:
门控值在扰动后倾向于依赖经验,随适应进行逐步转向当前策略。
记忆条件通信:每个智能体广播消息 ,通过基于邻居关系(共享作业的机器归属)的注意力机制聚合邻居消息 。最终策略以拼接 为输入。
(4) 训练损失
其中对比损失 将同类扰动的图嵌入拉近:
三、实验设计
数据集/场景
- DFJSP(Dynamic Flexible Job-Shop Scheduling Problem)基准:10 工件 × 10 机器,5 个调度智能体;每个工件含 3–6 道工序,每道工序兼容 2–4 台机器,处理时间采样自 。
- 三类动态扰动:
- 机器故障:故障率 /步,停机时长 ;
- 紧急订单到达:速率 0.05/步;
- 处理时间波动:扰动因子 。
- 扰动频率分级:Low(2–3 次/episode)、Medium(5–7 次)、High(10+ 次)。
对比方法
- 启发式规则:SPT、EDD;
- 元启发式:GA(带反应式重调度);
- 单智能体 RL:PPO;
- 多智能体 RL:QMIX、MAPPO、MAPPO+ER(带经验回放);
- 适配基线:GNN-Dispatch(基于 GNN 的反应式调度器)、MAPPO+Epi(带平面 episodic memory)。
评估指标
(完工时间)、Adapt.(扰动后恢复所需的步数)、机器利用率 、平均拖期 。
超参数
R-GCN 层数 ,隐藏维度 128,策略网络为 2 层 256 单元 MLP,Adam 学习率 ,折扣因子 ,PPO 裁剪 ,记忆池容量 ,检索大小 ,对比损失权重 ,衰减率 ,质量阈值 ,奖励系数 。
四、资源与算力
论文明确报告了硬件配置:
- CPU:双 AMD EPYC 9654;
- 内存:2 TB DDR5 RAM;
- GPU:4× NVIDIA RTX 5090;
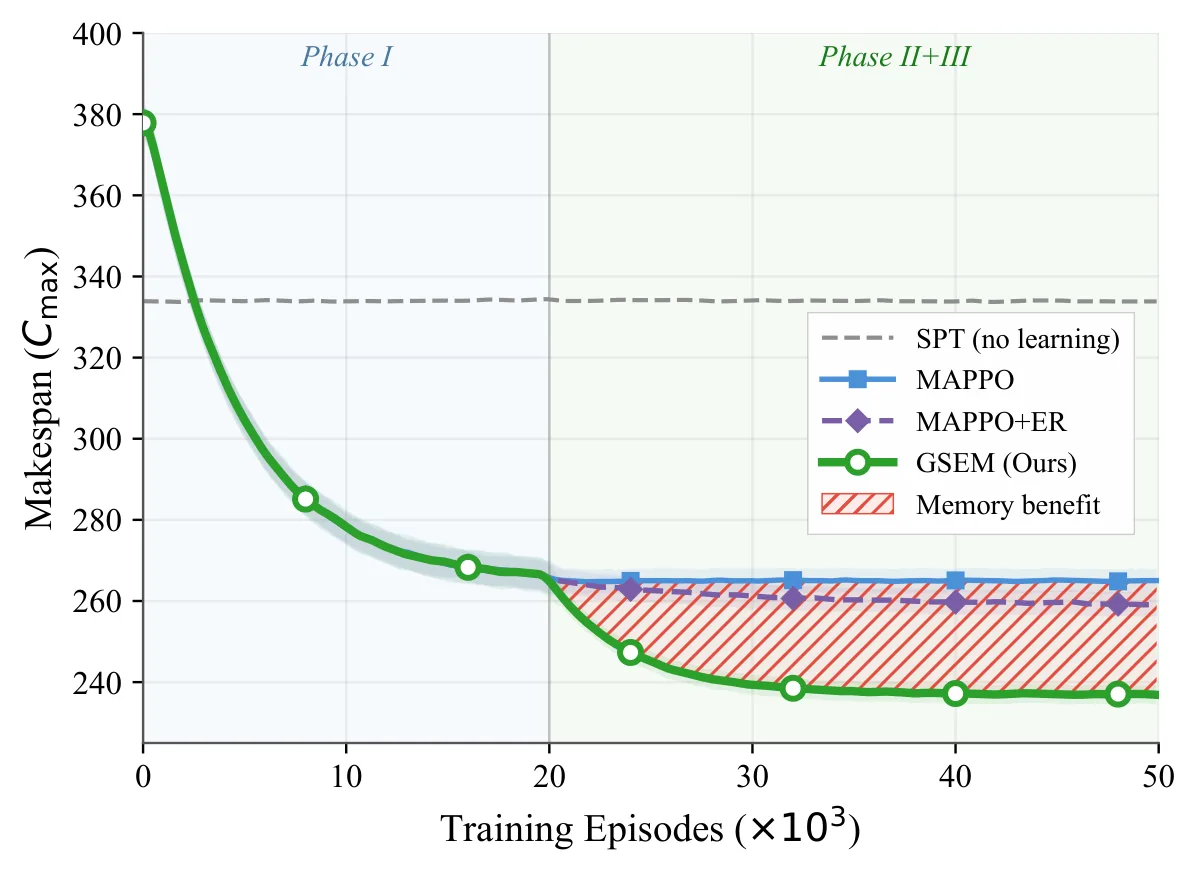
- 训练时长:阶段 I 20K episodes,阶段 II+III 30K episodes;GSEM 总训练时间约 14.2 小时(MAPPO 为 10.8 小时,约增加 31%);
- 每步推理开销:从 MAPPO 的 3.4 ms 增至 4.0 ms(+18%);
- 记忆池显存占用:约 120 MB。
五、实验数量与充分性
论文开展了较为系统的实验,包括:
1. 主结果(Table I):在 DFJSP 上对三类单扰动及混合扰动(低/中/高频)进行 6 个场景对比;
2. 扰动频率敏感性分析(Fig. 2):混合扰动下从 Low 到 High 的 makespan 变化曲线;
3. 训练收敛曲线(Fig. 3):阶段 I 与阶段 II+III 的对比,验证记忆带来的持续提升;
4. 消融实验(Table II):移除图结构(改为平面向量)、随机检索、无衰减、无门控、无通信、无对比损失共 6 种变体;
5. 跨扰动迁移实验(Table III):分别以单一扰动和混合扰动为记忆源,在三类扰动目标上测试;
6. 可扩展性测试:15×15、8 智能体更大规模场景。
实验数量较充分,每组结果均基于 20 个独立随机种子取均值,统计性较好。但仍存在以下局限:DFJSP 实例规模相对有限,未在多种车间布局/不同工件数量组合下系统评估;对在线自适应阶段的持续学习/灾难性遗忘问题未深入讨论。
六、主要结论与发现
1. GSEM 在所有场景均取得最佳性能:相比最强记忆增强基线 MAPPO+Epi,makespan 降低 4.1%–10.0%,适应时间缩短 33%–38%;
2. 扰动频率越高优势越大:高频混合扰动下,makespan 优势从 5.0% 扩大到 10.0%,机器利用率从 65.1% 提升至 71.2%,表明 GSEM 能有效应对级联扰动;
3. 图结构是关键:消融显示"无图(平面向量)"使 makespan 增加 6.3%,"随机检索"造成最大退化(8.0%),证明系统真正复用了结构化的恢复模式;
4. 门控与记忆条件通信显著贡献:分别贡献 4.2% 与 5.1% 的 makespan 改善,体现防止负迁移与系统级经验共享的价值;
5. 跨扰动泛化能力:以单一扰动类型为记忆源时,仍优于无记忆 MAPPO;以混合扰动为记忆源时泛化最强(平均 makespan 211.3 vs. 233.7),表明所学协调模式具备跨扰动可迁移性。
七、优点与亮点
- 将"可复用恢复模式"作为一等公民建模,明确提出 recovery motif 概念并以异构图结构承载;
- 三层式训练范式(预训练—记忆填充—记忆增强微调)实现清晰,避免冷启动问题;
- 质量过滤 + 自适应衰减 + MMR 检索三者结合,兼顾记忆多样性与时效性;
- 门控注意力 + 记忆条件通信的融合机制兼顾了个体适应与系统级协调;
- 对比损失辅助编码器区分扰动类型,提升检索质量;
- 实验覆盖单扰动、混合扰动、多频率、消融、迁移、可扩展性六个维度,且全部基于 20 个种子,结果较为可信。
八、不足与局限
- 对相似历史经验的依赖性强:当遇到从未见过的全新扰动模式时,仍需在线探索,无法完全"零成本"自适应;
- 记忆池容量有限(),在更大规模车间中可能成为瓶颈;
- 计算开销增加约 31%,尽管作者认为可接受,但限制了实时性要求极高场景的部署;
- 扰动类型仍有限(仅三类),未涵盖物料短缺、人员变动等真实车间常见扰动;
- DFJSP 规模有限(最大 15×15),与工业级上百台机器的复杂车间仍有差距;
- 缺乏对人类操作员经验整合的讨论(论文虽在结论中提及作为未来工作,但未验证);
- 未与最新的大语言模型辅助调度或基于基础模型的调度方法对比,方法栈略显传统;
- 公平性疑虑:作为对比的 GNN-Dispatch、MAPPO+Epi 均为"适配基线"(adapated baselines),实现细节可能未与原作者对齐,存在一定的不公平风险。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。