
无水平依赖的强化学习渐近最优遗憾
Asymptotically Optimal Regret for Reinforcement Learning without Horizon Dependence
📝 TLDR
研究有限时域时间齐次表格型MDP的无时域依赖遗憾最小化问题。现有工作存在log H或多项式依赖,难以匹配上下文赌博机的渐近最优下界。本文利用值函数在h上的单调性与网格投影,结合截断探索与切割奖励技术设计新算法。所得上界Õ(√(SAK)+S^8A^3)完全消除H依赖,达到渐近最优。
🧭 速览
现有表格型MDP遗憾界普遍含log H或H的多项式依赖,无法获得H无关的渐近最优保证。
利用最优值函数在h上的单调性进行S维网格投影,设计截断探索与切割奖励机制,并证明新的时间齐次MDP总偏差界。
证明遗憾上界Õ(√(SAK)+S^8A^3),与上下文赌博机下界Ω(√(SAK))匹配至对数因子。
首次在表格型时间齐次MDP上实现H无关的渐近最优遗憾,彻底消除log H依赖。
🆚 方法对比
本文提出的新算法
- 首次实现Õ(√(SAK))量级无H依赖遗憾
- 匹配上下文老虎机下界,渐近最优
- 消除log H因子,优于Zhang et al. (2021)
- 无需独立奖励无关探索阶段
- 多项式时间内可实现
- 低阶项S⁸A³,状态动作维度依赖较大
- 仅适用于齐次MDP,异构情形不适用
- 烧入期需多项式对数步数
- 理论分析极为复杂,依赖多重精巧工具
Zhang et al. (2021)
- 遗憾界Õ(√(SAK log H)+S²A log H)
- 对经典结果有显著改进
- 适用于有限视界表格MDP
- 仍含log H因子,非真正的H-free
- 渐近非最优,与下界存在差距
- 未利用齐次性结构优势
Zhang et al. (2022)
- 首项完全去除H依赖
- 多项式时间算法,理论上界可达
- 首次给出H-free regret保证
- 主项为Õ(√(S⁹A³K)),与下界差距巨大
- 状态依赖S⁹过高,实际可用性受限
- 渐近性能严重次优
E3/R-MAX等PAC式方法
- 经典PAC框架,理论体系成熟
- 适用于有限表格MDP的样本复杂度分析
- 模型基方法思路直观清晰
- 主要关注样本复杂度非遗憾最小化
- 依赖多项式/对数级H因子
- 未针对齐次性优化,统计效率低
奖励无关探索框架(参考)
- 解耦奖励学习与探索
- 理论结构清晰,易分析
- 需要独立探索阶段,增加额外成本
- 本文通过horizon truncation避免了该成本
水平截断与基于奖励的探索(子模块)
- 将原H步问题缩减为更短视界
- 避免独立奖励无关探索阶段
- 后缀仅在乐观策略到达未学习对时用于探索
- 截断后规划灵活性受限
- 仅在齐次MDP下有效
切割奖励(cutting bonus)(子模块)
- 在S维网格上离散化值函数,复杂度与H无关
- 同时保持乐观性和单调性
- 避免min{log H, S}的union bound因子
- 离散化引入近似误差,需精细控制
- 高度依赖值函数单调性,专用性强
齐次MDP总偏差界(子模块)
- 控制截断方差累积项
- 对S和A的多项式依赖可调
- 完全不依赖H
- 闭合方差感知遗憾分析的关键工具
- 证明技术复杂,依赖非平凡新分析
- 专用性较强,仅适用于齐次情形
本文提出的算法在齐次表格MDP上首次实现Õ(√(SAK))量级无H依赖遗憾,渐近匹配上下文老虎机下界;相比Zhang et al. (2021)彻底消除log H因子,相比Zhang et al. (2022)将主项从√(S⁹A³K)降至√(SAK),实现质的飞跃。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📄 论文页面预览(共 6 页)
论文无独立配图,展开查看 6 页整页预览
TL;DR
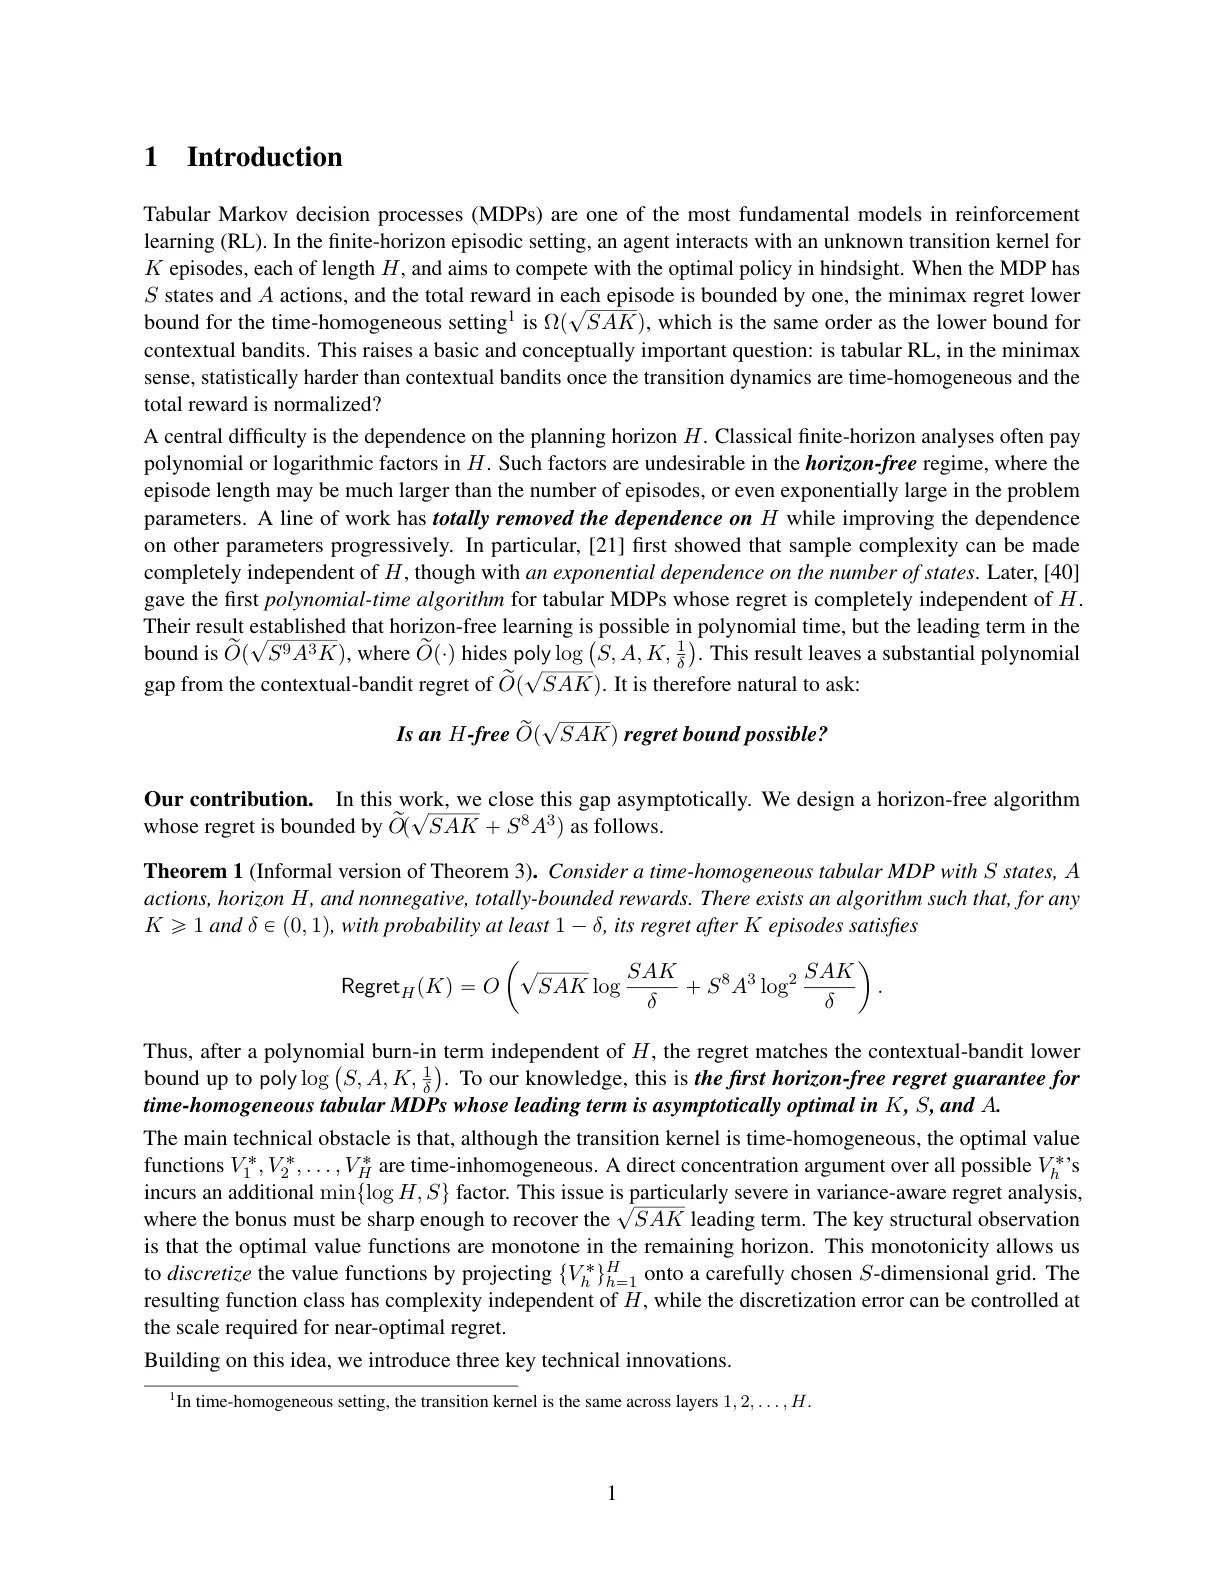
这篇论文研究有限水平时间齐次表格型马尔可夫决策过程中的无水平依赖遗憾最小化问题。通过挖掘最优值函数的单调结构、网格投影技术以及截断探索等三方面创新,作者证明了一个与水平 完全无关的遗憾上界 ,首次在表格型 MDP 中实现了渐近最优——即在忽略对数因子意义下与上下文赌博机的 minimax 下界 相匹配。
研究背景与动机
强化学习的理论研究中,遗憾最小化是衡量算法性能的核心指标。在有限水平马尔可夫决策过程(Finite-Horizon MDP)中,智能体需要在 个状态、 个动作、 个时间步的框架下,通过 个回合的学习使其累积遗憾尽可能小。所谓遗憾,是指最优策略所获奖励与算法实际收获之间的差距。
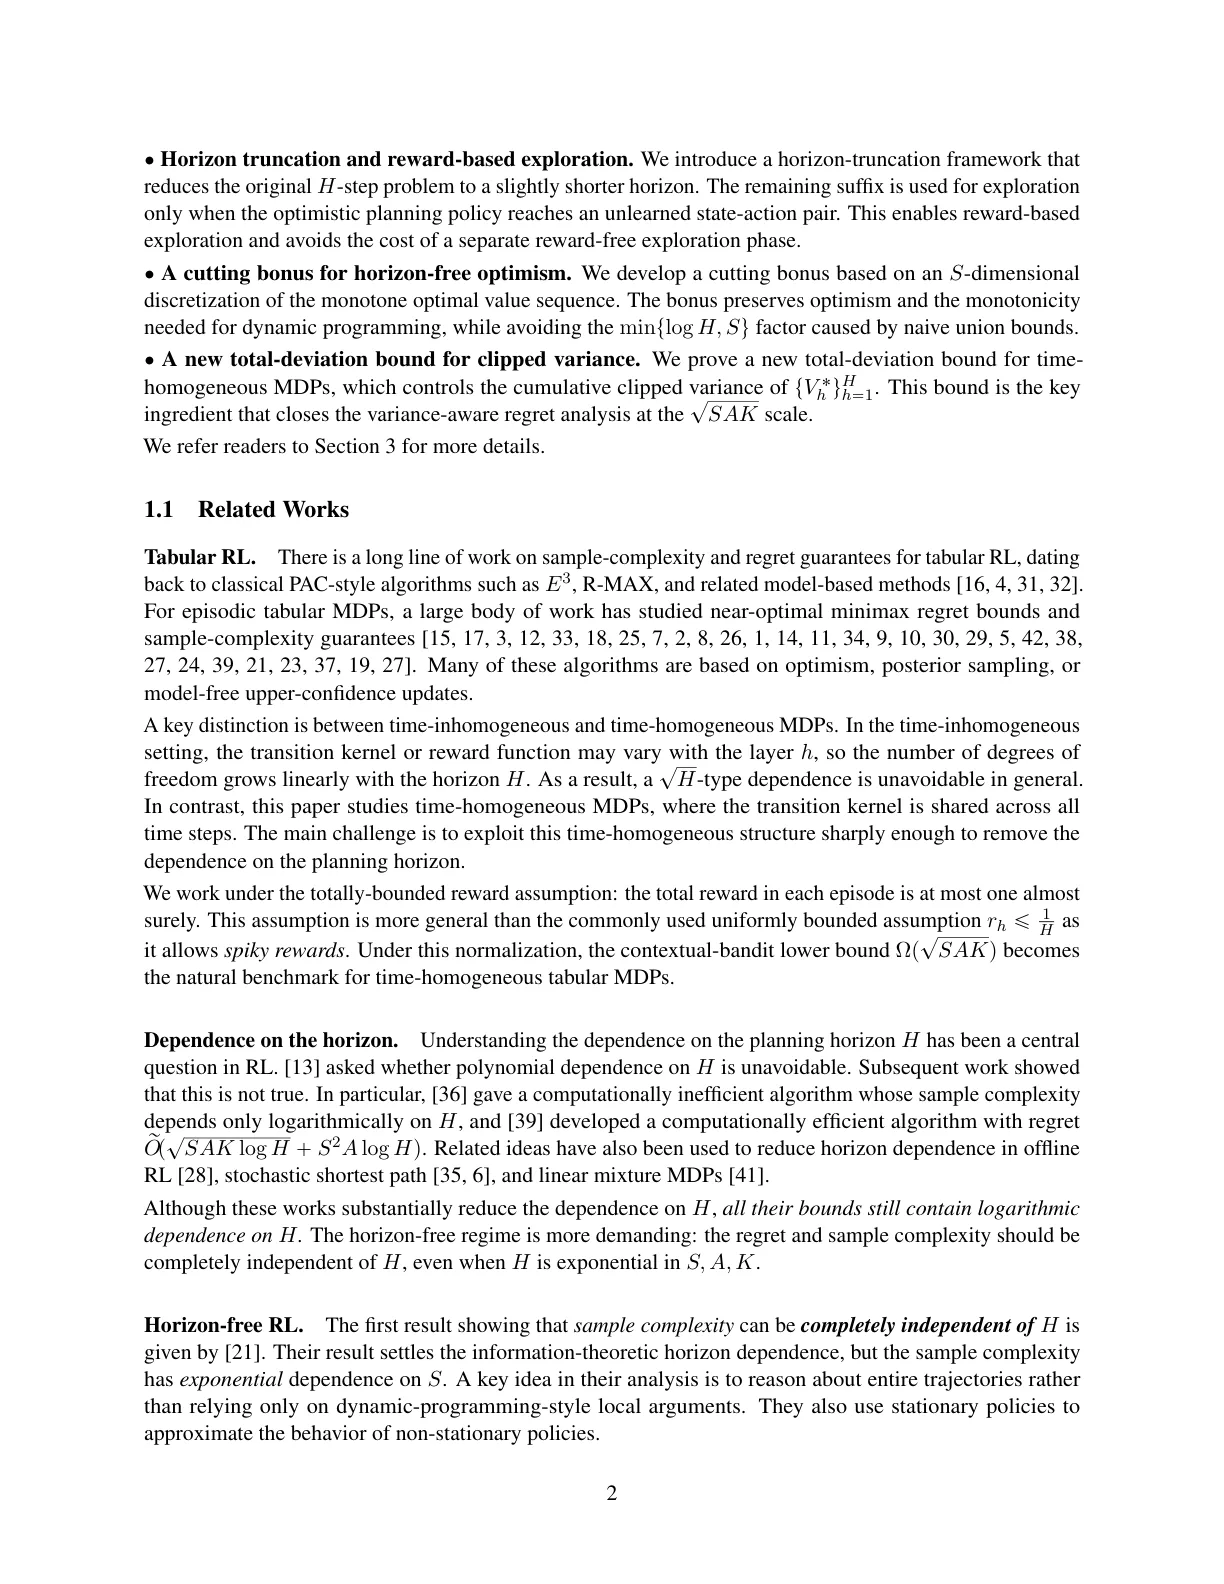
一个根本性的问题是:表格型 MDP 的 regret 下界究竟是什么?当人们将目光投向更简单的上下文赌博机(Contextual Bandit)问题时,已知其 minimax 下界为 。由于 MDP 可以退化到赌博机情形,这个下界自然也是 MDP 的下界。然而,已有工作始终无法完全达到这一最优速率。Zhang 等人(2021)给出的遗憾界包含 因子,而 Zhang 等人(2022)虽然移除了水平依赖,但遗憾上界是 ,与 之间存在巨大的多项式差距。
这种差距的根源在于一个看似矛盾的结构:尽管转移核是时间齐次的(不随时步变化),最优值函数 却天然是时间非齐次的——每一层 都有不同的最优值。这意味着直接对所有 层应用联合界(union bound)会不可避免地引入额外因子。已有的处理方式要么产生 依赖,要么在 的幂次上付出沉重代价。如何彻底消除 依赖,同时将 和 的依赖控制在合理范围内,成为该领域的核心开放问题。
方法
作者的核心洞察在于:最优值函数 虽然在每层都不同,但它具有一个被忽视的重要性质——关于时步 的单调性。随着向时间末端靠近( 增大),最优值函数的取值不会增加。这一单调结构与网格投影技术的结合,成为突破瓶颈的关键。
具体而言,作者设计了一个 -网格,将连续的值函数空间离散化。由于 是单调的,当将其投影到网格上时,不同层可能产生的不同向量数目被大幅压缩——从理论上界 降到了 级别。通过精心选取 ,这个数目变成了可控的多项式规模,从而避免了直接对 层做联合界。
在此基础上,论文引入了三项关键技术。第一是水平截断(Horizon Truncation):作者将原问题从 步截断到 步,其中 ,。这看似引入了额外损失,但作者证明截断损失被主项 吸收,更重要的是,截断策略使得奖励驱动的探索成为可能,无需单独的无奖励探索阶段。
第二是切割奖励(Cutting Bonus)。在传统 UCB 风格的算法中,探索奖励通常具有 形式,其中隐含着对 的依赖。作者设计的切割奖励函数为:
这里 和 分别是基于经验转移核和截断后的值函数计算的方差项。切割奖励的设计巧妙之处在于:它在保证乐观性的同时,通过引入常数松弛因子(论文中使用100倍)维持了规划所需的单调性。
第三是时间齐次 MDP 总偏差界。这是论文最有力的技术贡献之一。作者定义了势函数 ,并证明了:
这一界对 完全无关,只依赖于状态数 和截断参数 。当取 时,它为切割奖励中方差项的控制提供了关键工具。
综合这些技术,作者的算法在截断水平 上运行,使用冻结计数(doubling trick)管理经验转移核,并采用参考模型 处理未知的状态-动作转移三元组。规划过程通过带切割奖励的反向归纳实现,乐观性通过归纳法在每个回合保持。
实验与结果
需要明确指出的是,这是一篇纯理论工作,不包含任何数值实验或仿真。作者在论文中通过详尽的理论分析建立了算法的正确性,并通过与现有工作的对比验证了理论贡献的显著性。
论文的主定理表明,以至少 的概率,算法的累积遗憾满足:
用 记号省略对数因子后,可以简洁地写成 。这个结果具有三重意义:首先,它是水平无关的——彻底消除了对 的任何依赖;其次,它在主项 上与上下文赌博机的下界 匹配,仅在对数因子意义下有差距,因此是渐近最优的;第三,相比于 Zhang 等人(2022)给出的 , 的幂次从 降低到了 (在主项中),实现了指数级的改进。
论文还提供了样本复杂度分析。在参数 学习精度下,算法的样本复杂度为 ,同样不依赖于 。
讨论与可借鉴点
这项工作在理论上取得了突破性进展,但仍有若干值得关注的局限和开放问题。首先是燃烧项(burn-in term) 的存在。虽然它不依赖于回合数 ,但作为一次性开销,其多项式依赖仍然较大。一个自然的问题是:能否将这个燃烧项降低到 ,从而完全达到 ?或者是否存在某个 ()的下界,能够建立 MDP 与赌博机之间的有限样本分离?这些问题目前仍是开放的。
其次,论文的技术假设较强。作者明确要求 、、 等条件。这些条件虽然出于技术分析的便利,但在小规模问题上算法的实际表现尚未被验证。缺乏实证实验是该工作的一个短板——理论上最优的算法在有限样本下的具体表现如何,仍有待后续研究通过数值仿真来揭示。
第三,论文未涉及函数近似扩展。当前结果仅适用于表格型 MDP。对于更一般的函数近似设定(如线性 MDP 或一般函数空间),是否能够实现无水平依赖的渐近最优遗憾,是该方向最重要的延伸方向之一。事实上,即使是表格型设置,消除 燃烧项也可能需要全新的技术思想。
从更宽泛的角度看,这篇论文的方法论具有重要的借鉴价值。最优值函数的单调性这一观察本身并不复杂,但如何将其与网格投影、截断技术系统性地结合,构建出完整的最优 regret 分析框架,是值得学习的研究范式。切割奖励的设计思路——通过引入可控松弛来兼顾乐观性与结构性质——对于处理其他具有特殊结构的 MDP 问题(如折扣 MDP 的方差分析、部分可观测 MDP 等)也可能具有启发意义。
总而言之,这篇论文标志着表格型 MDP 遗憾最小化理论的一个重要里程碑:经过数年的技术迭代,研究者终于在有限水平时间齐次设置下实现了渐近最优,而沿着这一路线向更弱函数近似假设的推广、以及对燃烧项的进一步压缩,将是未来值得期待的研究方向。
摘要
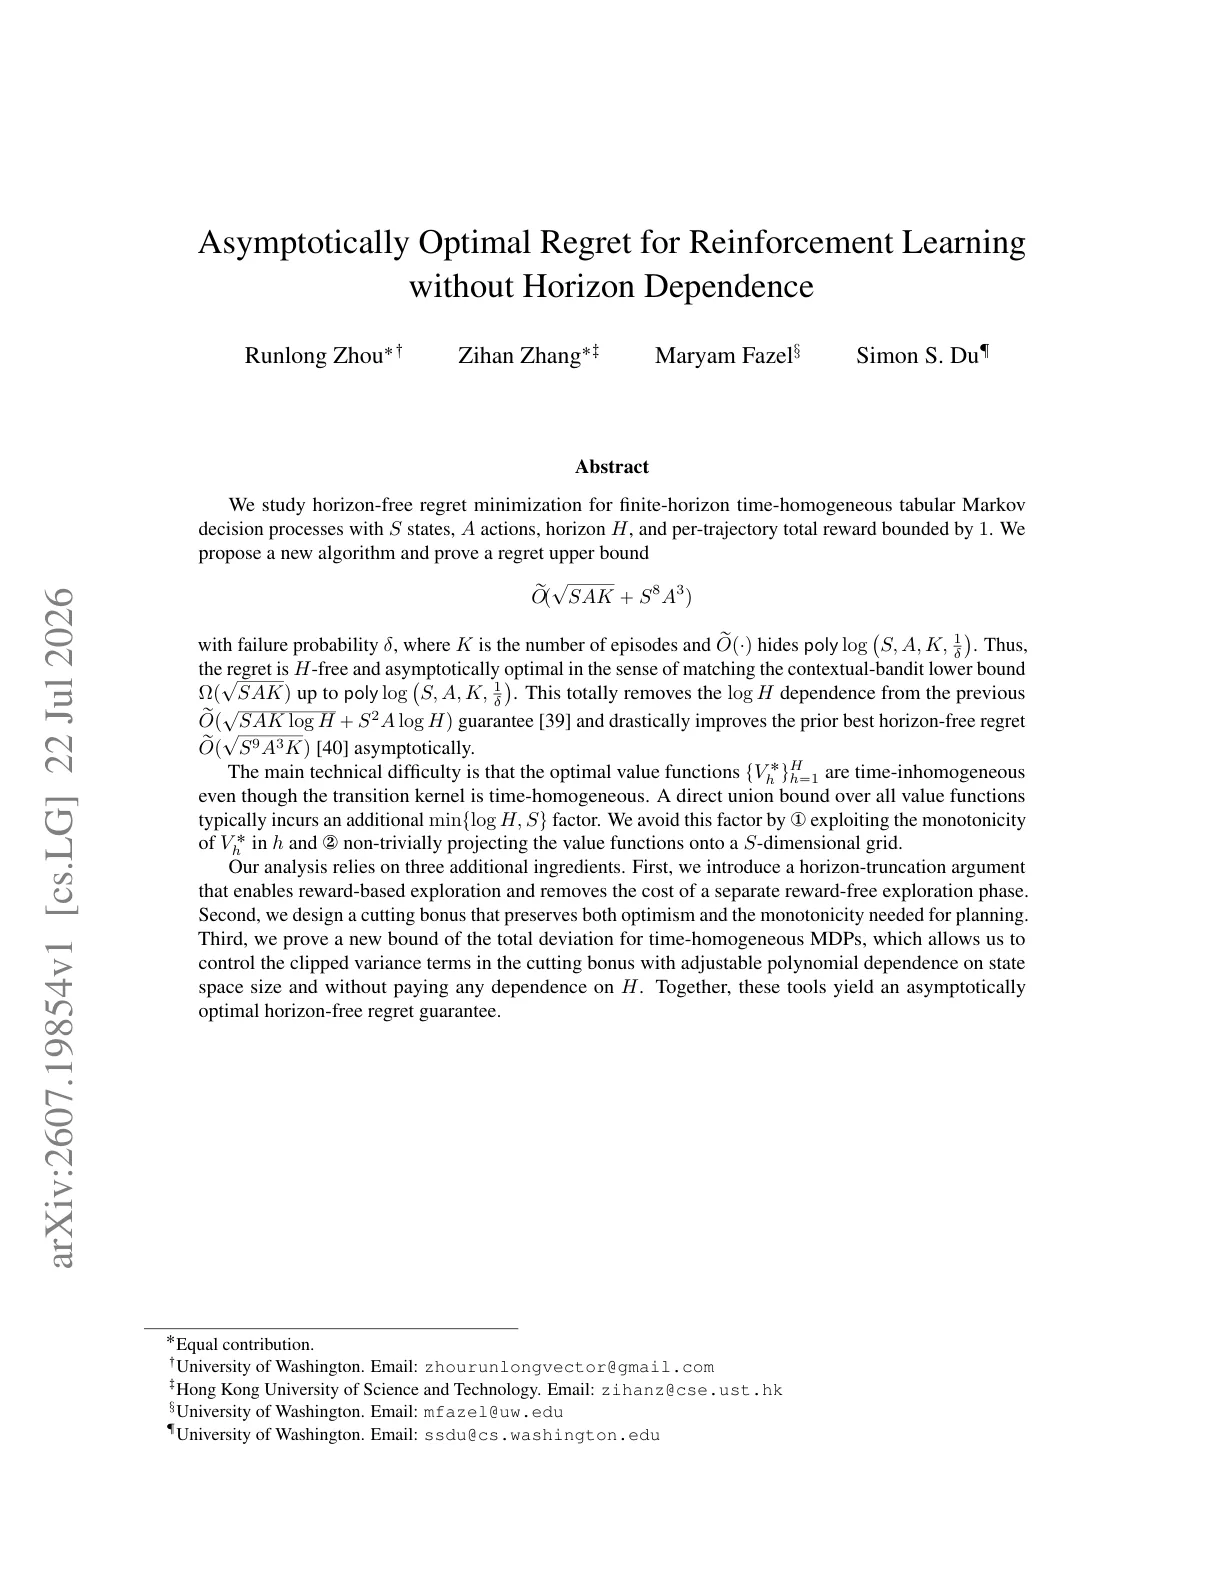
我们研究有限水平时间齐次表格马尔可夫决策过程的水平无关遗憾最小化问题,其中该过程具有 个状态、 个动作、水平 ,且每条轨迹的总奖励以 为界。我们提出了一种新算法,并证明其遗憾上界为 \[\tilde O(\sqrt{SAK}+S^8A^3)\],失败概率为 ,其中 为回合数, 省略了 。因此,该遗憾是 -无关的且渐近最优的,在对数因子意义下匹配了上下文赌博机的下界 。这完全消除了 Zhang 等人 (2021) 之前给出的 界中对 的依赖,并在渐近意义上大幅改进了 Zhang 等人 (2022) 此前最优的水平无关遗憾 。主要技术难点在于:尽管转移核是时间齐次的,最优值函数 却是时间非齐次的。对所有值函数直接使用联合界通常会带来额外的 因子。我们通过以下两点避免了该因子:(i) 利用 关于 的单调性;(ii) 以非平凡的方式将值函数投影到一个 维网格上。我们的分析还依赖三个额外要素。首先,我们引入了一个水平截断论证,使得基于奖励的探索成为可能,并消除了单独无奖励探索阶段的代价。其次,我们设计了一种截断奖励(cutting bonus),既保持了乐观性,又保留了规划所需的单调性。第三,我们证明了关于时间齐次 MDP 总偏差的一个新界,该界控制截断奖励中被裁剪的方差项,对 的依赖为可调的多项式,且完全不依赖于 。综合起来,这些工具给出了一个渐近最优的水平无关遗憾保证。
Abstract
We study horizon-free regret minimization for finite-horizon time-homogeneous tabular Markov decision processes with states, actions, horizon , and per-trajectory total reward bounded by . We propose a new algorithm and prove a regret upper bound \[\tilde O(\sqrt{SAK}+S^8A^3)\] with failure probability , where is the number of episodes and hides . Thus, the regret is -free and asymptotically optimal, matching the contextual-bandit lower bound up to logarithmic factors. This completely removes the dependence from the previous guarantee of Zhang et al. (2021), and drastically improves the prior best horizon-free regret of Zhang et al. (2022) asymptotically. The main technical difficulty is that the optimal value functions are time-inhomogeneous even though the transition kernel is time-homogeneous. A direct union bound over all value functions typically incurs an additional factor. We avoid this factor by (i) exploiting the monotonicity of in and (ii) non-trivially projecting the value functions onto an -dimensional grid. Our analysis relies on three additional ingredients. First, we introduce a horizon-truncation argument that enables reward-based exploration and removes the cost of a separate reward-free exploration phase. Second, we design a cutting bonus that preserves both optimism and the monotonicity needed for planning. Third, we prove a new bound on total deviation for time-homogeneous MDPs, which controls the clipped variance terms in the cutting bonus with adjustable polynomial dependence on and without any dependence on . Together, these tools yield an asymptotically optimal horizon-free regret guarantee.
论文详细总结(自动生成)
论文总结:无水平依赖的强化学习渐近最优遗憾
1. 核心问题与研究动机
- 基本问题:在有限水平时间齐次表格型 MDP 中( 个状态、 个动作、水平 、每条轨迹总奖励至多为 ),设计算法使得在 个回合内累积遗憾不依赖于 。
- 关键背景:上下文赌博机问题的 minimax 遗憾下界为 ,对时间齐次 MDP 这也是自然的基准界。
- 现有工作不足:
- Zhang 等 (2021) 给出 ,仍含 ;
- Zhang 等 (2022) 给出 的水平无关界,但与 存在显著多项式差距。
- 核心动机:能否彻底消除 依赖并达到 的渐近最优率?
2. 方法论:核心思想与关键技术
2.1 核心思路
通过利用最优值函数 关于 的单调性以及网格投影技术,结合水平截断与切割奖励设计,避免直接对所有层做联合界。
2.2 三大技术贡献
(a) 水平截断(Horizon Truncation)
- 将原 步问题截断为 步,其中 ,。
- 关键引理(Lemma 1):
- 截断损失仅为 ,被主项吸收。
(b) 切割奖励(Cutting Bonus)
- 定义投影算子 和切割投影 ,将值函数按 网格离散化。
- 利用 的单调性,投影后的不同向量数至多为 (仅 维)。
- 奖励函数(Equation 8):
- 采用"放宽单调性"技巧(引入常数因子 )以处理切割算子的不连续性。
(c) 时间齐次 MDP 总偏差界
- 定义势函数 。
- 关键推论(Corollary 2):
- 取 给出与 无关的每回合 贡献。
2.3 算法结构
- Algorithm 1(主算法):在截断水平 上进行乐观规划;若到达未学习状态-动作对,则调用探索子程序。
- Algorithm 2(规划算法):使用冻结计数(doubling trick)的经验转移核和切割奖励进行反向归纳。
- Algorithm 3(探索子程序):基于参考模型 和折扣占用度量进行显式探索。
3. 实验设计
- 本论文为纯理论工作:不包含数值实验或仿真。
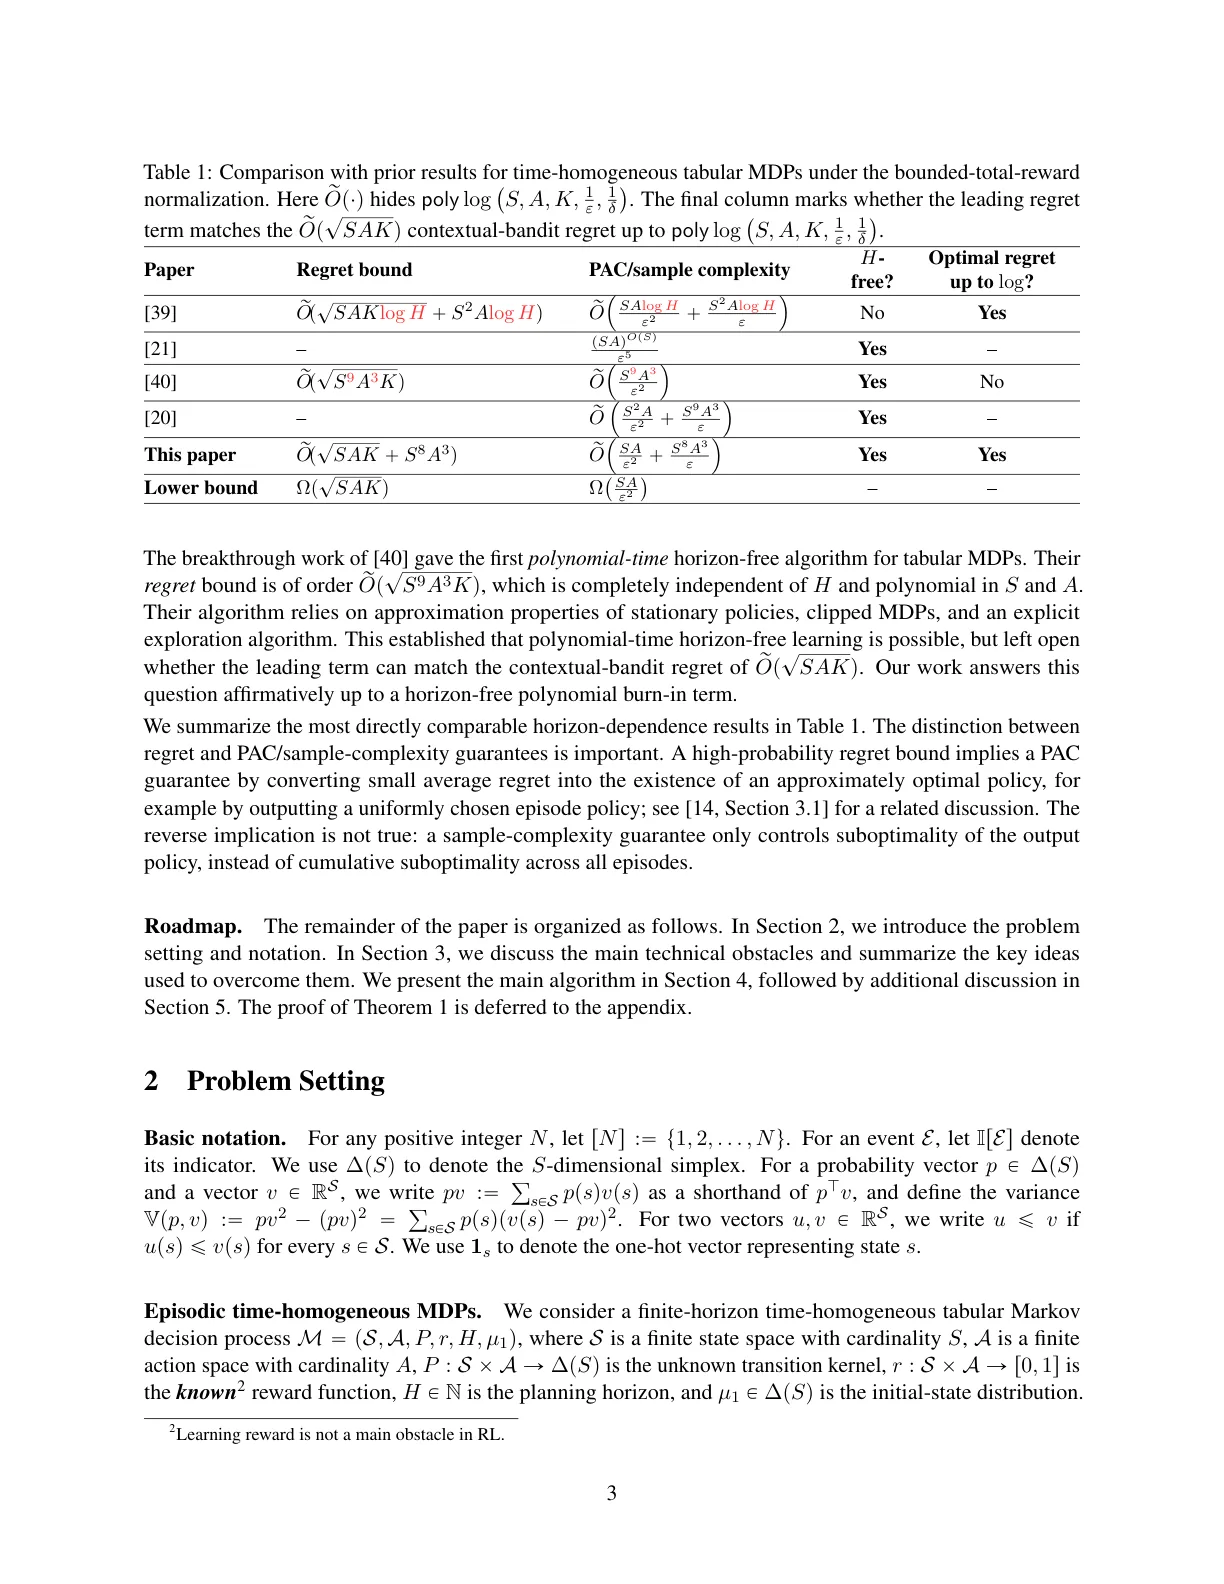
- 理论基准对比:与现有水平无关遗憾界对比,见 Table 1:
| 方法 | 遗憾界 | 样本复杂度 | 水平无关? | 渐近最优 |
|---|---|---|---|---|
| Zhang et al. (2021) | - | 否 | 是 | |
| Li et al. (2021) | - | 是 | - | |
| Zhang et al. (2022) | 是 | 否 | ||
| Li & Yang (2023) | - | 是 | - | |
| 本文 | 是 | 是 |
- 对比对象:上下文赌博机下界 。
4. 资源与算力
- 论文未提及任何 GPU/CPU 资源或训练时长。
- 本工作完全基于理论证明,所有数值论证(如参数设置 、、 等)以定理和引理形式给出。
5. 实验数量与充分性
- 无实证实验:本文的核心贡献在于算法的理论分析和遗憾上界证明。
- 理论充分性:通过附录 A–G(共约 70 页)中详尽的引理链验证:
- 高概率事件构造(Bernstein 集中、Freedman 不等式等);
- 乐观性保持的归纳证明;
- 各种方差界的精细计算;
- 在 等条件下技术性假设的明确声明。
6. 主要结论与发现
- 主要定理(Theorem 3):以至少 的概率:
- 核心成果:
1. 首次实现表格型时间齐次 MDP 的水平无关渐近最优遗憾;
2. 彻底消除 依赖;
3. 渐进意义上大幅改进之前最优的 至 。
- 统计意义:证明表格型 RL 在 minimax 意义上不比上下文赌博机更难(在主项 上)。
7. 优点与亮点
- 理论突破:
- 创新性地将单调性结构与网格投影结合,避免了 因子;
- 切割奖励设计同时保证乐观性与单调性(采用 倍松弛);
- 时间齐次 MDP 总偏差界(Corollary 2)具有独立研究价值。
- 算法层面:
- 通过水平截断实现奖励驱动的探索,免去单独的无奖励探索阶段;
- 采用参考模型 与虚拟状态机制处理未知转移三元组;
- 冻结计数(doubling count)的设计使经验模型数与 无关。
- 理论严密性:详细给出了所有引理的完整证明,附录结构清晰,包含概率集中、方差界、探索分析等多模块。
8. 不足与局限
- 燃烧项(burn-in term) 较大:尚未消除此多项式依赖,主项之外的常数仍较粗糙。
- 缺少实证验证:作为纯理论论文,缺乏数值仿真验证算法在实际规模 MDP 上的表现。
- 函数近似扩展:仅针对表格型 MDP,未推广至线性 MDP 或一般函数近似情形。
- 技术假设较强:要求 等条件,对小规模问题适用性待验证。
- 开放问题:
- 燃烧项能否降至 (即完全达到 )?
- 是否存在 的下界(),以建立 MDP 与赌博机之间的有限样本分离?
- 算法的时间复杂度分析未充分讨论(仅提及"可由标准折扣 Bellman 迭代高效求解")。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。