
Dreamer-CPC:基于世界模型的消息学习用于去中心化多智能体强化学习
Dreamer-CPC: Message Learning with World Models for Decentralized Multi-agent Reinforcement Learning
📝 TLDR
在部分可观测的多智能体强化学习中,现有通信方法仅基于当前观测生成消息,无法传递历史累积信息,限制了协作效果。为此,本文提出 Dreamer-CPC,将基于集体预测编码的消息学习集成到 DreamerV3 的世界模型中,使消息源自反映历史轨迹的潜状态。在自建的 CatchApple 任务和 Observer 任务上,方法显著优于 IPPO-CPC 等基线,尤其在观测暂时缺失场景下取得 4–5 倍回合回报提升。该工作证明了基于世界模型潜动力学的通信机制能有效支撑去中心化决策。
🧭 速览
部分可观测多智能体强化学习中,现有通信方法仅依赖当前观测生成消息,无法表达历史累积信息。
Dreamer-CPC 将基于 CPC 的消息学习嵌入 DreamerV3 世界模型,消息由反映历史轨迹的潜状态生成。
在 Observer 与自建 CatchApple 任务上优于 IPPO-CPC 等基线,CatchApple 上回合回报达后者 4–5 倍。
基于世界模型潜动力学的通信能有效支撑去中心化决策,应对当前观测不足场景。
🆚 方法对比
Dreamer-CPC
- 通信基于RSSM潜在状态,编码历史观测与动作信息
- CatchApple中回报达IPPO-CPC的4到5倍
- 世界模型与消息学习在统一目标函数下联合优化
- 支持去中心化训练与执行,突破CTDE局限
- 世界模型训练计算开销较大
- 仅在两个环境、2个agent设置下评估
- 依赖DreamerV3等复杂组件,工程实现复杂
IPPO-CPC
- 消息直接从当前观测生成,架构简洁
- 非合作设置下仍能涌现有效协调消息
- 基于成熟的CTDE与PPO框架,易于实现
- 仅依赖当前观测,无法传递时序累积信息
- CatchApple中性能远低于Dreamer-CPC
- 在观测暂时缺失时协调能力急剧下降
DreamerV3
- RSSM潜在状态编码完整观测-动作历史
- 想象rollout支持基于模型的策略优化
- 在多种任务上展现强泛化能力
- 世界模型训练计算成本高昂
- 潜在维度增加通信带宽与编码难度
- 超参数敏感,调参成本较高
Collective Predictive Coding (CPC)
- 提供去中心化贝叶斯推理的理论基础
- 支持非合作场景下符号自主涌现
- 无需集中训练或共享奖励
- 仅基于当前观测存在信息容量上限
- 依赖Metropolis-Hastings命名游戏的收敛假设
- 原始框架未扩展到模型强化学习
CTDE-based MARL方法(RIAL/DIAL/CommNet)
- 集中训练可优化全局价值函数提升性能
- 参数共享机制工程成熟、易部署
- 通信信号通过任务奖励直接优化
- 偏离自然去中心化学习范式
- 主要假设合作共享奖励设置
- 需要中心化优化框架,灵活性受限
Nomura等人的去中心化世界模型
- 每个agent独立维护本地RSSM支持去中心化
- 通过InfoNCE损失学习有意义的消息表征
- 策略仅通过行为克隆从专家演示学习
- 未在想象空间中进行强化学习训练
- 依赖专家数据,泛化场景受限
Dreamer-CPC通过将CPC消息学习整合进DreamerV3的世界模型潜在动态,突破了IPPO-CPC等仅依赖当前观测方法的时序信息瓶颈,在观测缺失的CatchApple环境中取得4-5倍性能提升;CTDE方法虽工程成熟但偏离去中心化范式,而Nomura等人的去中心化世界模型则缺乏强化学习优化能力。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
Dreamer-CPC 针对部分可观测多智能体强化学习中通信消息仅依赖当前观测、无法传递历史信息的核心缺陷,提出将基于集体预测编码(CPC)的消息学习嵌入 DreamerV3 的循环状态空间模型(RSSM)世界模型,使消息源自反映过去观测与动作序列的潜状态。实验在自建的 Observer 和 CatchApple 两个任务上验证了方法有效性,尤其在观测暂时缺失的 CatchApple 中取得 4-5 倍于基线的回合回报提升,证明了基于世界模型潜动力学的通信机制能有效支撑去中心化决策。
研究背景与动机
在现实世界的多智能体协作场景中,每个智能体往往只能获取局部观测——摄像头只看到自己前方的视野,传感器只感知近处环境。这种[[部分可观测性]]使得仅凭当前信息无法判断任务的全局状态,例如队友在做什么、目标下一步会移动到哪里。智能体间的通信因此成为突破观测局限、提升协作效果的关键技术。
现有通信方法大致可分为两类。一类是[[集中式训练分散式执行]](CTDE)范式下的方法,如 RIAL、DIAL、CommNet 等,这类方法依赖共享奖励信号或集中式价值函数来进行梯度计算,本质上仍然需要中心节点的协调,不符合去中心化学习的自然假设。另一类是基于[[表征学习]]的去中心化通信方法,它们让每个智能体根据自身观测独立学习消息,不需要中央控制。然而,这类方法存在一个根本性缺陷:消息完全由当前观测生成,无法表达随时间累积的历史上下文信息。
当任务相关的观测被暂时遮挡时,这一缺陷会直接导致协作失败。比如在接苹果场景中,如果苹果的轨迹被墙壁遮挡,智能体无法从当前观测推断苹果会落在哪里,必须依赖之前看到的运动历史来预测未来位置。IPPO-CPC 等现有基于当前观测的通信方法在这种场景下几乎无效,因为它们传递给队友的信息中不包含任何预测性内容。
Dreamer-CPC 的核心切入点正在于此:利用[[世界模型]]的潜状态来生成通信消息。DreamerV3 的 RSSM 通过维护确定性循环状态和随机潜变量,能够编码"过去发生了什么"的信息——这些信息恰是预测"未来会怎样"的基础。当智能体交换从潜状态推断出的消息时,它们实际上交换的是经过时间整合的高层语义,而非瞬时的、低维的观测切片。
方法
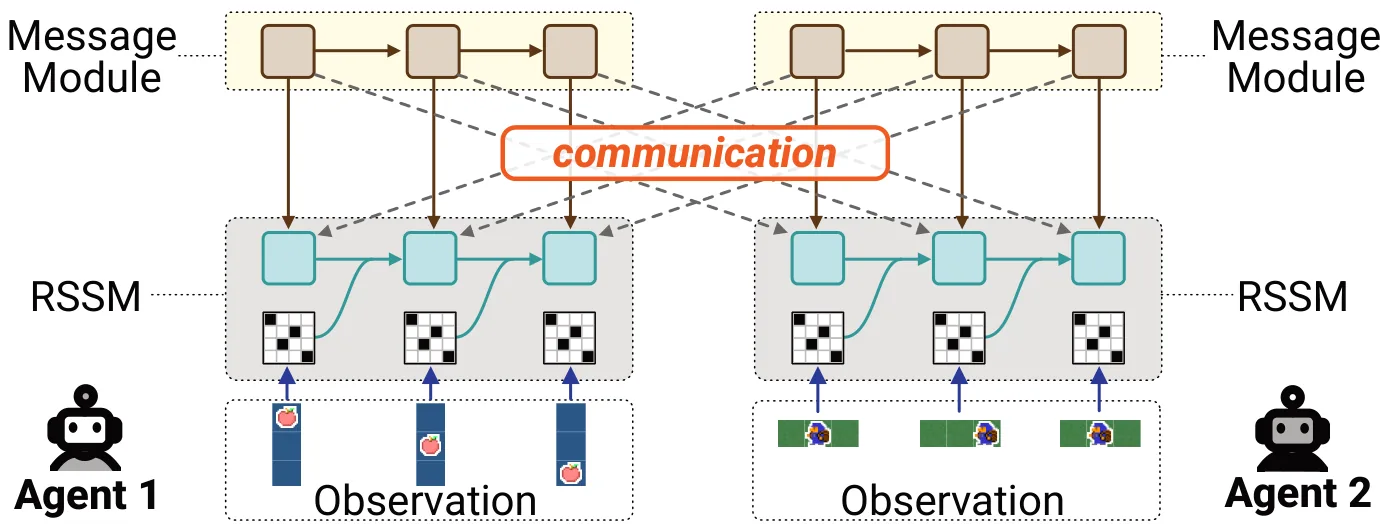
Dreamer-CPC 的设计围绕一个核心问题展开:如何让消息承载历史信息,同时保持严格去中心化的训练与执行?答案在于将消息学习模块与 DreamerV3 的[[循环状态空间模型]]深度整合,使两者共享同一套潜状态表示。
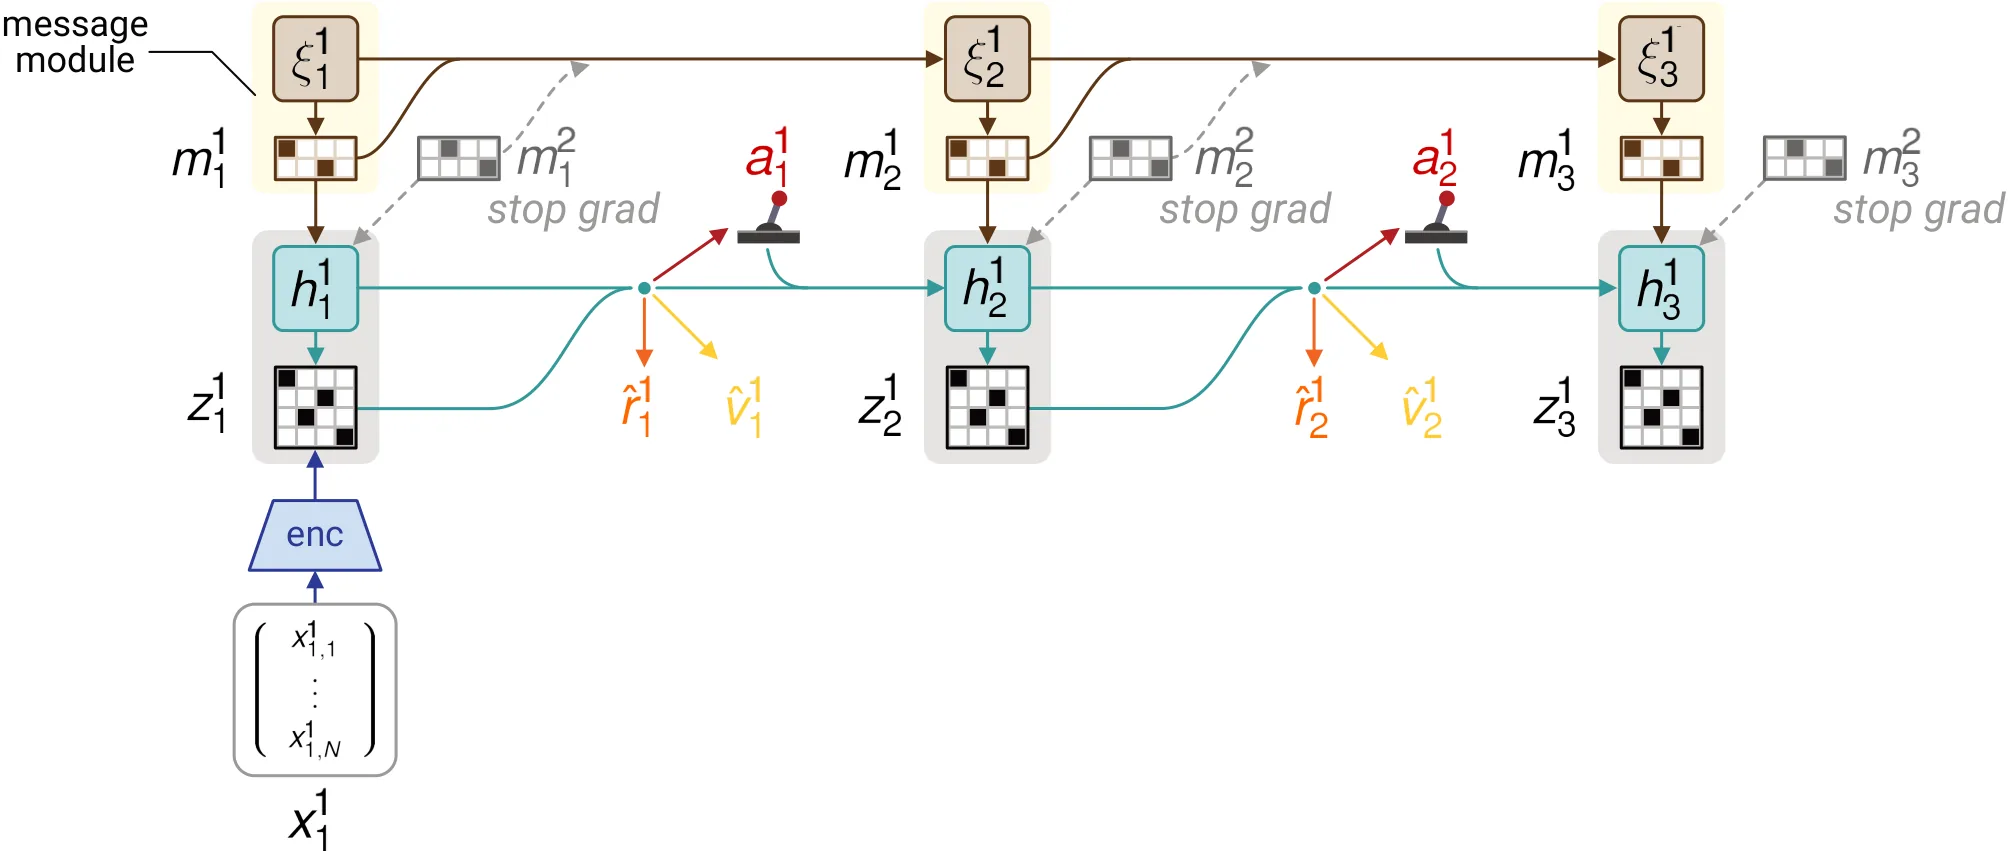
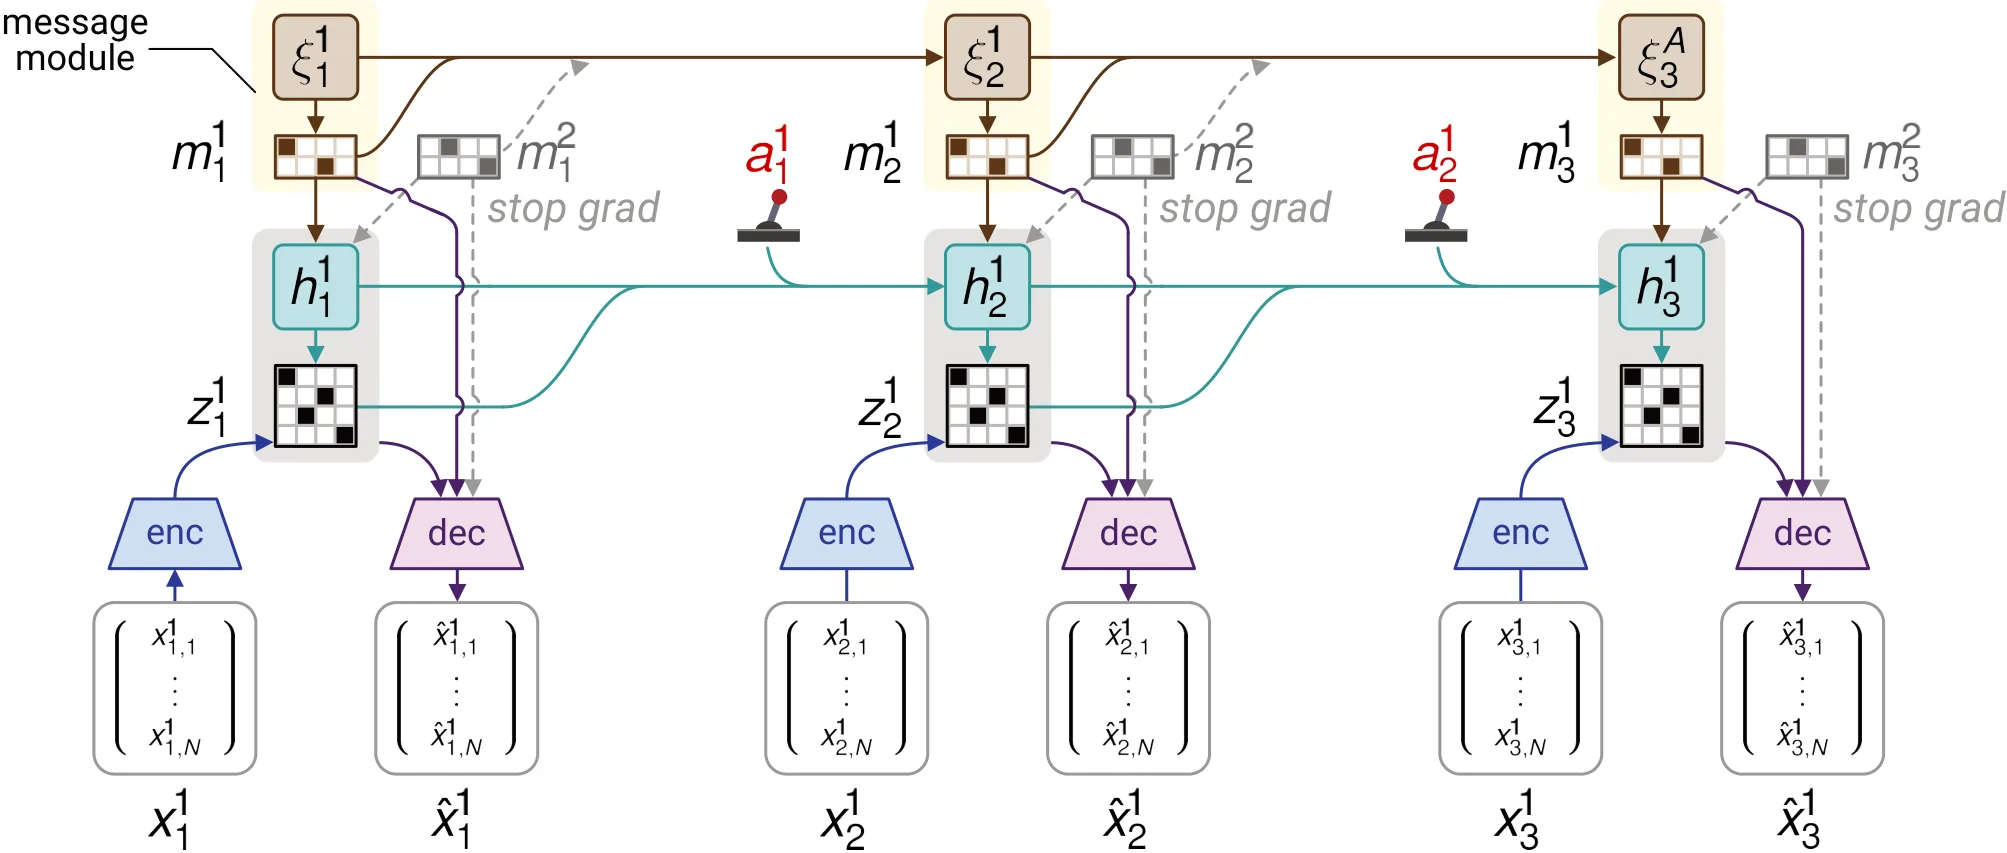
每个智能体 独立维护一个 RSSM,其状态由两部分组成:确定性循环状态 和随机潜状态 。循环状态通过递归更新,吸收过去所有观测、动作和消息的信息:
其中 是来自消息模块的先验消息。随机潜状态 则通过变分推断从当前观测 中采样得到,维持了对观测不确定性的建模能力。整个 RSSM 的训练目标是最小化重构误差(预测下一时刻的观测、奖励和终止标志)与 KL 正则项的加权和。
消息模块本身采用类似的循环架构。每个智能体维护一个消息循环状态 ,用于汇总历史消息:
消息的生成遵循 CPC 的预测编码逻辑:先验分布 仅依赖消息状态本身,编码了对其他智能体消息的预测;后验分布 则整合了来自 RSSM 的潜状态信息,生成实际传递给队友的消息。这两者的 KL 散度作为消息模块的训练信号,鼓励先验去预测其他智能体的潜状态表示。
去中心化训练的关键在于防止梯度穿过其他智能体的参数。Dreamer-CPC 使用 stop-gradient 操作,使得来自队友消息的梯度不会反向传播到对方的网络:
整个系统通过统一的变分下界目标进行端到端优化。预测目标包括观测、奖励和终止标志,KL 正则项同时约束潜状态和消息的质量。在实践中,作者采用了 KL-balanced 和 free bits 技术来稳定训练,平衡各个损失项的权重。
Actor-Critic 部分直接沿用 DreamerV3 的设计,但想象轨迹中每一步都同步执行消息交换与 RSSM 更新,确保策略学习基于真实的通信效果进行。
实验与结果
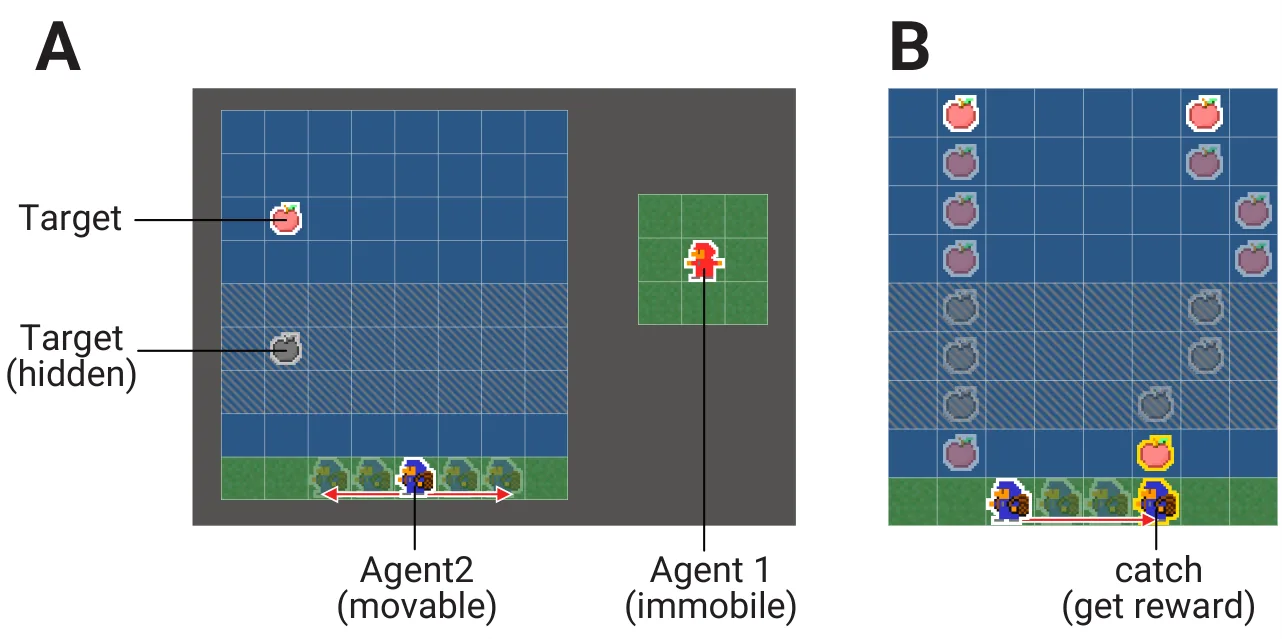
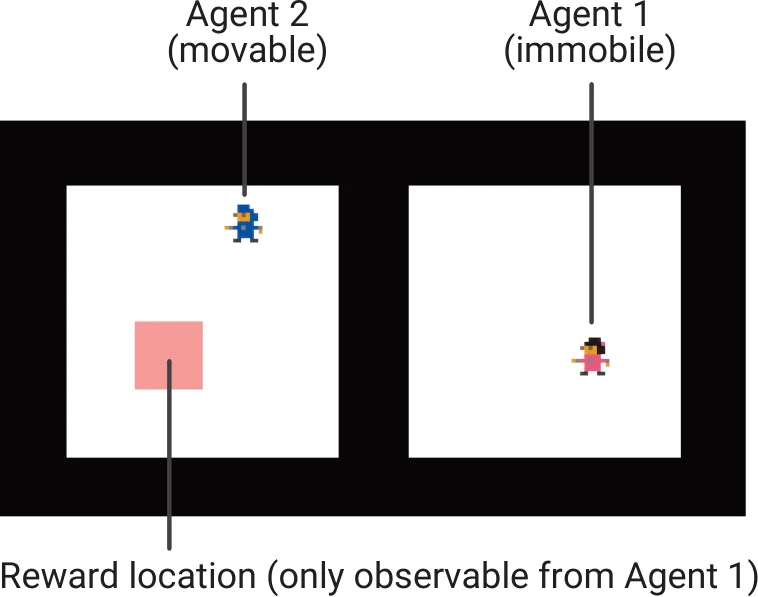
实验在两个自建环境中进行。Observer 是一个非合作的信息共享任务:Agent 1 静止不动,能够观测到奖励的位置但无法获取;Agent 2 需要移动到奖励位置并执行挖掘操作,但它的观测中不包含奖励位置信息。两者奖励不共享,只有 Agent 2 能获得奖励信号,这要求通信必须传递跨智能体的、不可直接观测的信息。
CatchApple 是作者新设计的任务,用于专门测试"观测暂时缺失"这一挑战。8×8 的场地分为落物区和地面行两个区域,苹果从随机位置开始沿固定方向滚动,滚出落物区边界后落在地面某处。Agent 1 负责追踪苹果轨迹,但存在部分时间步苹果被遮挡(用隐藏旗表示);Agent 2 负责在落点等待接苹果,但由于 Agent 1 的当前观测中看不到苹果,它必须依赖 Agent 1 传递的历史轨迹信息来预测落点位置。
实验对比了多种方法。无通信基线包括 IPPO 和独立 DreamerV3;IPPO-CPC 是最关键的基线,它采用相同的 CPC 框架但消息源自当前观测而非世界模型潜状态;DreamerV3 (obs-shared) 则直接共享原始观测,作为性能上界的参考。
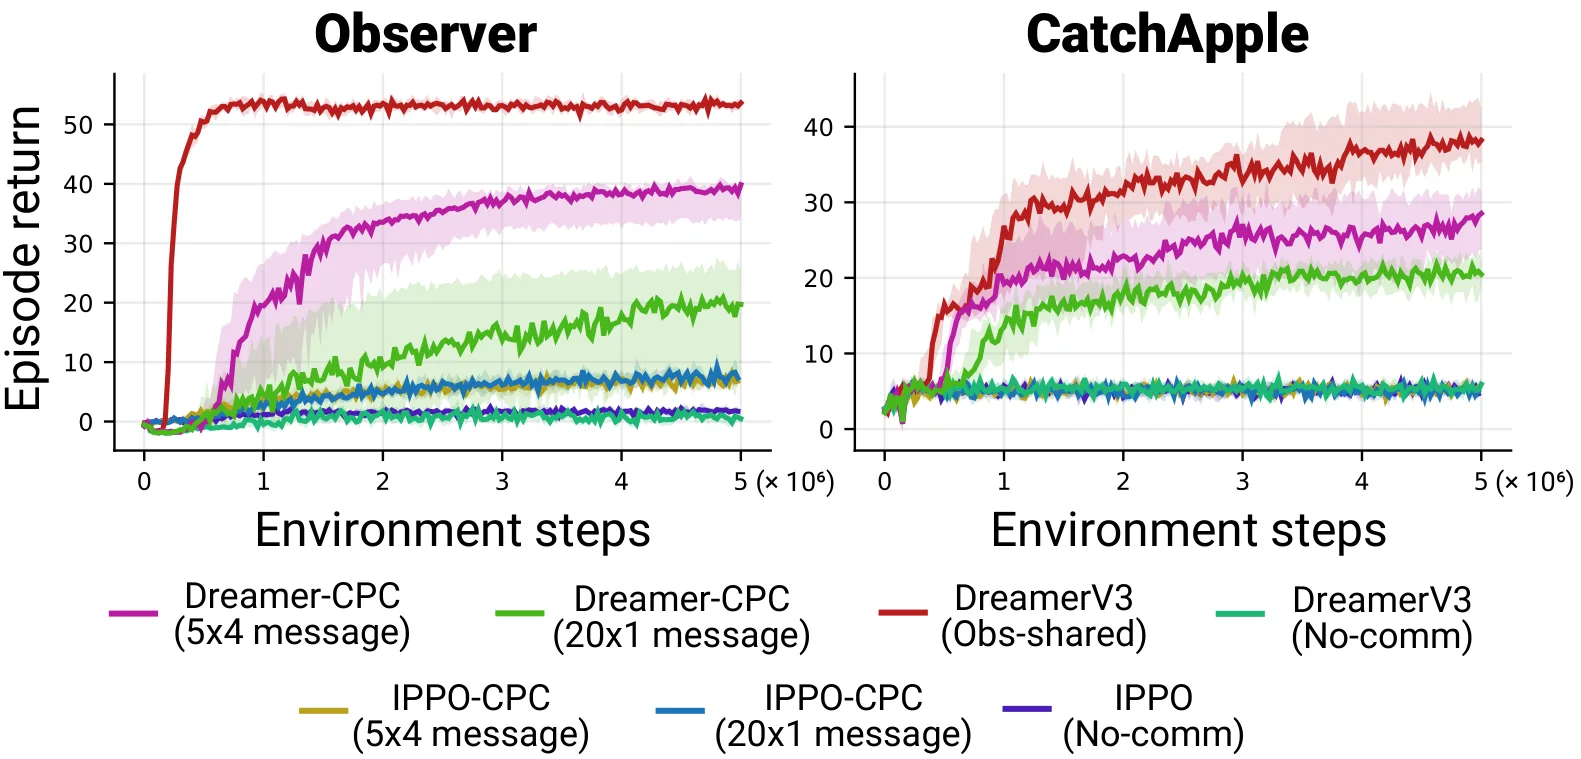
在 Observer 环境中,Dreamer-CPC 采用 5×4 消息结构(四个独立的 5-way one-hot)取得了 IQM = 39.85(95% CI [34.22, 40.82])的回合回报,远高于 IPPO-CPC 同配置的 6.81 和无通信基线的 1.74。这一差距表明,当信息必须跨智能体传递且无法从当前观测直接获取时,基于潜状态的消息具有显著优势。
CatchApple 环境的结果更加突出。Dreamer-CPC(5×4)达到 IQM = 28.53,是 IPPO-CPC(5.52)的约 5 倍;即使采用更紧凑的 20×1 消息结构,Dreamer-CPC 仍然达到 20.47,是 IPPO-CPC(4.98)的约 4 倍。值得注意的是,IPPO-CPC 在这个任务上的表现几乎与无通信基线持平,说明基于当前观测的 CPC 消息在这个场景下几乎没有传递任何有效信息——因为当苹果被遮挡时,当前观测本身就不包含任务相关状态。
这些结果有力地验证了论文的核心假设:当仅凭当前观测不足以推断任务状态时,基于[[世界模型]]潜动力学生成的通信消息能够支撑有效的去中心化决策。
讨论与可借鉴点
Dreamer-CPC 的一个重要贡献在于提出了 CatchApple 这个任务。与 SMAC、Cooperative Navigation 等经典 [[多智能体强化学习]] benchmark 相比,CatchApple 专门针对"历史依赖性"设计,能够暴露当前观测通信方法的根本局限。这类任务设计思路值得借鉴:构造能够区分"有无历史信息"对协作效果影响的场景,才能更清晰地验证通信机制的有效性。
在方法层面,Dreamer-CPC 展示了将消息学习模块与[[世界模型]]潜状态深度整合的可能性。传统上,通信模块往往是外挂的、基于辅助任务训练的;而 Dreamer-CPC 通过统一的变分下界目标,让消息质量直接作用于策略学习的效果。这种"通信即潜状态推断"的范式,或许能为未来的去中心化协作研究提供新的设计思路。
然而,当前工作也存在一些局限。首先,实验仅在 2 智能体场景下验证,未考察通信开销和协调效果随智能体数量增长的变化趋势。其次,任务环境均为低维离散空间,消息本身是 one-hot 向量,这与真实场景中高维图像输入的世界模型训练存在较大差距。论文没有消融实验来分析 stop-gradient 机制、消息模块结构或 KL 平衡权重的独立贡献,也没有深入分析 learned message 究竟编码了何种语义信息。
对于后续研究,一个有价值的探索方向是在 [[多智能体强化学习]] 标准 benchmark(如 SMAC、Overcooked)上验证类似思路,同时尝试高维观测输入的场景。另一个方向是分析消息表示的可解释性——当智能体声称传递了"历史轨迹"时,我们需要证据表明它确实编码了时间维度的信息,而非仅仅压缩了某个静态统计量。
摘要
在多智能体强化学习(MARL)中,智能体间的通信对于提升部分可观测性下的性能十分有效。基于表示学习的方法使得去中心化智能体能够基于自身观测学习消息,但这些方法仅依赖当前观测,无法传递随时间累积的信息。我们提出了Dreamer-CPC,一种去中心化、基于模型的MARL方法,它将基于集体预测编码(CPC)的消息学习集成到DreamerV3的世界模型中。每个智能体独立维护一个世界模型和一个消息模块,并从反映过去观测与动作历史的世界模型潜在状态中推断与交换消息。我们在两个环境中评估了Dreamer-CPC:Observer,一个非合作的信息共享任务;以及CatchApple,一个新引入的任务,其中任务相关的观测会暂时缺失。在这两个环境中,Dreamer-CPC均优于IPPO-CPC(一种现有的基于CPC、从当前观测生成消息的方法)以及无通信的基线方法。特别是在CatchApple中,Dreamer-CPC的回合回报达到了IPPO-CPC的4到5倍,在其他方法因观测缺失而失败的情况下实现了有效协调。这些结果表明,当仅凭当前观测不足时,基于世界模型潜在动态的通信能够支持去中心化决策。
Abstract
In multi-agent reinforcement learning (MARL), inter-agent communication is effective for improving performance under partial observability. Representation learning-based approaches enable decentralized agents to learn messages grounded in their own observations, but they rely only on current observations and cannot convey information accumulated over time. We propose Dreamer-CPC, a decentralized model-based MARL method that integrates message learning based on Collective Predictive Coding (CPC) into the world model of DreamerV3. Each agent independently maintains a world model and a message module, and infers and exchanges messages from the latent states of the world model that reflect the history of past observations and actions. We evaluated Dreamer-CPC in two environments: Observer, a non-cooperative information-sharing task, and CatchApple, a newly introduced task in which task-relevant observations are temporarily missing. In both environments, Dreamer-CPC outperformed IPPO-CPC, an existing CPC-based method that generates messages from current observations, as well as no-communication baselines. In particular, in CatchApple, Dreamer-CPC achieved 4 to 5 times the episode return of IPPO-CPC, demonstrating effective coordination where other methods fail due to missing observations. These results suggest that communication grounded in the latent dynamics of world models can support decentralized decision-making when current observations alone are insufficient.
论文详细总结(自动生成)
Dreamer-CPC 论文总结
1. 核心问题与研究动机
在部分可观测的多智能体强化学习(MARL)场景中,单个智能体仅凭当前局部观测无法获取任务相关的全局信息,因此智能体间的通信成为提升协作性能的关键手段。现有通信方法存在两类局限:
- 集中式训练分散式执行(CTDE)类方法(如 RIAL、DIAL、CommNet、VDN、MADDPG 等)依赖共享奖励或集中式价值函数,偏离了自然系统中"去中心化学习"的本质。
- 基于表征学习的方法(如 Lin et al. 的自编码器通信、CPC、Ebara et al.、MARL-CPC / IPPO-CPC)虽然实现了去中心化,但消息仅由当前观测生成,无法表达随时间累积的历史上下文信息。
当任务相关的观测被暂时遮挡、或智能体需要基于历史预测未来状态时,仅依赖当前观测的消息不足以支撑有效协调。这一缺陷在现有工作(无论是 CTDE 模型方法 Nomura et al. 行为克隆式世界模型,还是 IPPO-CPC 的观测级消息)中均未得到解决。
2. 方法论
2.1 核心思想
Dreamer-CPC 将基于集体预测编码(Collective Predictive Coding, CPC)的消息学习嵌入到 DreamerV3 的循环状态空间模型(RSSM)世界模型中,使消息源自反映"过去观测 + 动作"历史的潜在状态,从而支持去中心化训练与去中心化执行(DTDE)框架。
2.2 关键技术细节
(1)世界模型(RSSM)
每个智能体 独立维护一个 RSSM,包含确定性循环状态 和随机潜状态 :
(2)消息模块
每个智能体维护一个消息循环状态 ,以汇总历史消息:
其中 为消息先验(仅依赖 ), 为消息后验(依赖 )。先验消息 进入 RSSM 转移,后验消息 用于观测预测。
(3)去中心化机制
对来自其他智能体的消息施加 stop-gradient,避免反向传播穿过其他智能体的参数:
(4)统一变分下界目标
通过 Jensen 不等式得到预测目标 的证据下界:
实践中采用 KL-balanced + free bits 的稳定替代损失,权重为:
(5)Actor-Critic 与想象轨迹
策略 与价值 沿用 DreamerV3 训练目标,但想象轨迹中每一步都同步执行消息交换与 RSSM 更新(Algorithm 2)。
3. 实验设计
3.1 任务环境
| 环境 | 特性 | 关键挑战 |
|---|---|---|
| Observer | 非合作、奖励不共享;Agent 1 静止观测奖励位置,Agent 2 移动并执行 dig 找奖励 | 跨智能体信息不对称 |
| CatchApple(作者新提) | 8×8 落物区 + 地面行;Agent 1 观测轨迹,Agent 2 控制接球手;部分时间步被遮挡(隐藏旗) | 当前观测不足以决策,必须基于历史预测未来落点 |
3.2 对比方法
- IPPO-CPC(最关键基线):基于当前观测的 CPC 消息学习;
- IPPO:无通信独立 PPO;
- DreamerV3 (no-comm):独立 DreamerV3,无消息通道;
- DreamerV3 (obs-shared):直接共享原始观测(性能上界参考);
- 测试两种消息结构:(单个 20-way one-hot)与 (四个独立 5-way one-hot)。
3.3 评估指标
以 Agent 2 的回合回报为指标,使用 IQM(Interquartile Mean)+ 95% 置信区间(2000 次 bootstrap)评估 10 次独立运行的稳定性。
4. 资源与算力
论文中未明确报告所使用的 GPU 型号、数量及训练时长。文中仅指出:
- 每个智能体的 RSSM 与 Actor-Critic 约 3M 参数;
- 消息模块使用 BlockGRU(hidden=64, blocks=8),先验/后验网络为 2 层 MLP(hidden=128, GELU)。
训练步数从学习曲线(Fig. 6)可以推断为大约 环境步左右,但具体硬件配置与训练时长缺失。
5. 实验数量与充分性
- 实验规模:2 个环境 × 5 种方法 × 2 种消息结构 ≈ 20 组配置,每组 10 次独立运行,共约 200 次训练。
- 统计方法:使用 IQM 而非单点均值,2000 次 bootstrap 估计置信区间,方法学上较为规范。
- 不足:
- 缺少消融实验(例如:去掉消息模块、去掉 stop-gradient、仅用先验消息、改变消息结构等);
- 缺少更大规模智能体数量的验证(仅 2 智能体);
- 任务均为自建环境,未在标准 MARL benchmark(如 SMAC、Cooperative Navigation、MPE 等)上测试;
- 未分析消息编码的具体语义内容(论文自身也有提及此局限)。
总体而言,实验能支撑其核心结论(世界模型潜状态通信 > 当前观测通信),但充分性有限。
6. 主要结论与发现
6.1 Observer 环境
- Dreamer-CPC( 消息)最终 IQM = 39.85(95% CI [34.22, 40.82]),远高于 IPPO-CPC(同配置 6.81)。
- 消息亦显著优于 IPPO-CPC(19.72 vs 7.31)。
- 无通信基线(IPPO、DreamerV3 no-comm)几乎无性能(1.74 / 0.48)。
6.2 CatchApple 环境
- Dreamer-CPC()IQM = 28.53(95% CI [23.87, 31.56]),是 IPPO-CPC(5.52)的 ~5 倍;
- 消息 IQM = 20.47,是 IPPO-CPC(4.98)的 ~4 倍;
- IPPO-CPC 与无通信基线性能接近,表明其消息未能传递有效信息。
6.3 核心结论
基于世界模型潜动力学的通信可有效支撑去中心化决策,尤其在当前观测不足以推断任务相关状态时(观测临时缺失场景)。
7. 优点与亮点
- 概念新颖:首次将 CPC 消息学习与 DreamerV3 世界模型在统一目标下整合,使消息承载时间维度信息;
- 严格去中心化:通过 stop-gradient 避免智能体间的梯度耦合,契合 DTDE 范式;
- 非合作设定:奖励不共享下的通信仍能涌现,区别于多数 CTDE 工作;
- 统一损失函数:世界模型预测、KL 平衡损失、消息正则项在同一目标下联合优化;
- 新任务 CatchApple:暴露了"当前观测通信"的局限,为该类研究提供了更严格的测试平台;
- 统计评估规范:使用 IQM + bootstrap CI 而非单次均值,提升结论可信度。
8. 不足与局限
- 未做消融实验:KL 平衡权重、消息模块结构、stop-gradient 机制、RSSM 组件的贡献均未单独评估;
- 智能体数量受限:仅 2 智能体场景,未验证可扩展性;
- 环境通用性不足:均在作者自建任务上验证,缺少 SMAC、MPE、Hanabi 等标准基准上的测试;
- 消息可解释性缺失:未分析 learned message 编码了何种语义信息,难以判断其是否真正捕捉了"历史轨迹"还是仅仅传递了某个低维统计量;
- 算力与训练成本未报告:复现门槛与扩展成本不透明;
- 场景偏简单:CatchApple 仍为低维离散/one-hot 观测,未涉及高维图像输入的世界模型训练;
- 应用假设较强:要求每个智能体能独立维护完整 RSSM,对算力受限的边缘部署场景构成挑战。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。