
并非志趣相投者:基于人格的 LLM 智能体伙伴选择
Not Birds of a Feather: Personality-Based Partner Selection in LLM Agents
📝 TLDR
随着LLM智能体在多智能体生态中广泛应用,伙伴选择机制尚不明确。本文构建受控选择范式,让宿主智能体从六名仅大五人格描述不同、能力一致的候选中挑选合作者。实验覆盖375次试验、五类任务,发现选择显著依赖人格:中性宿主按任务类型匹配人格,创造性任务倾向选开放型,其他任务多选尽责型,而外倾、宜人、均衡型几乎不被选中。被赋予人格的宿主反而选择人格差异更大的搭档,低于随机基线。该结果为智能体市场的偏差审计与编排框架设计提供直接启示。
🧭 速览
以往多智能体团队的人格研究多外生固定成员构成,忽略了宿主自主选择搭档时人格是否起作用这一核心问题。
构建受控选择范式:宿主从六名仅大五人格不同、能力一致的候选中挑选合作者,共开展375次试验覆盖五类任务类别。
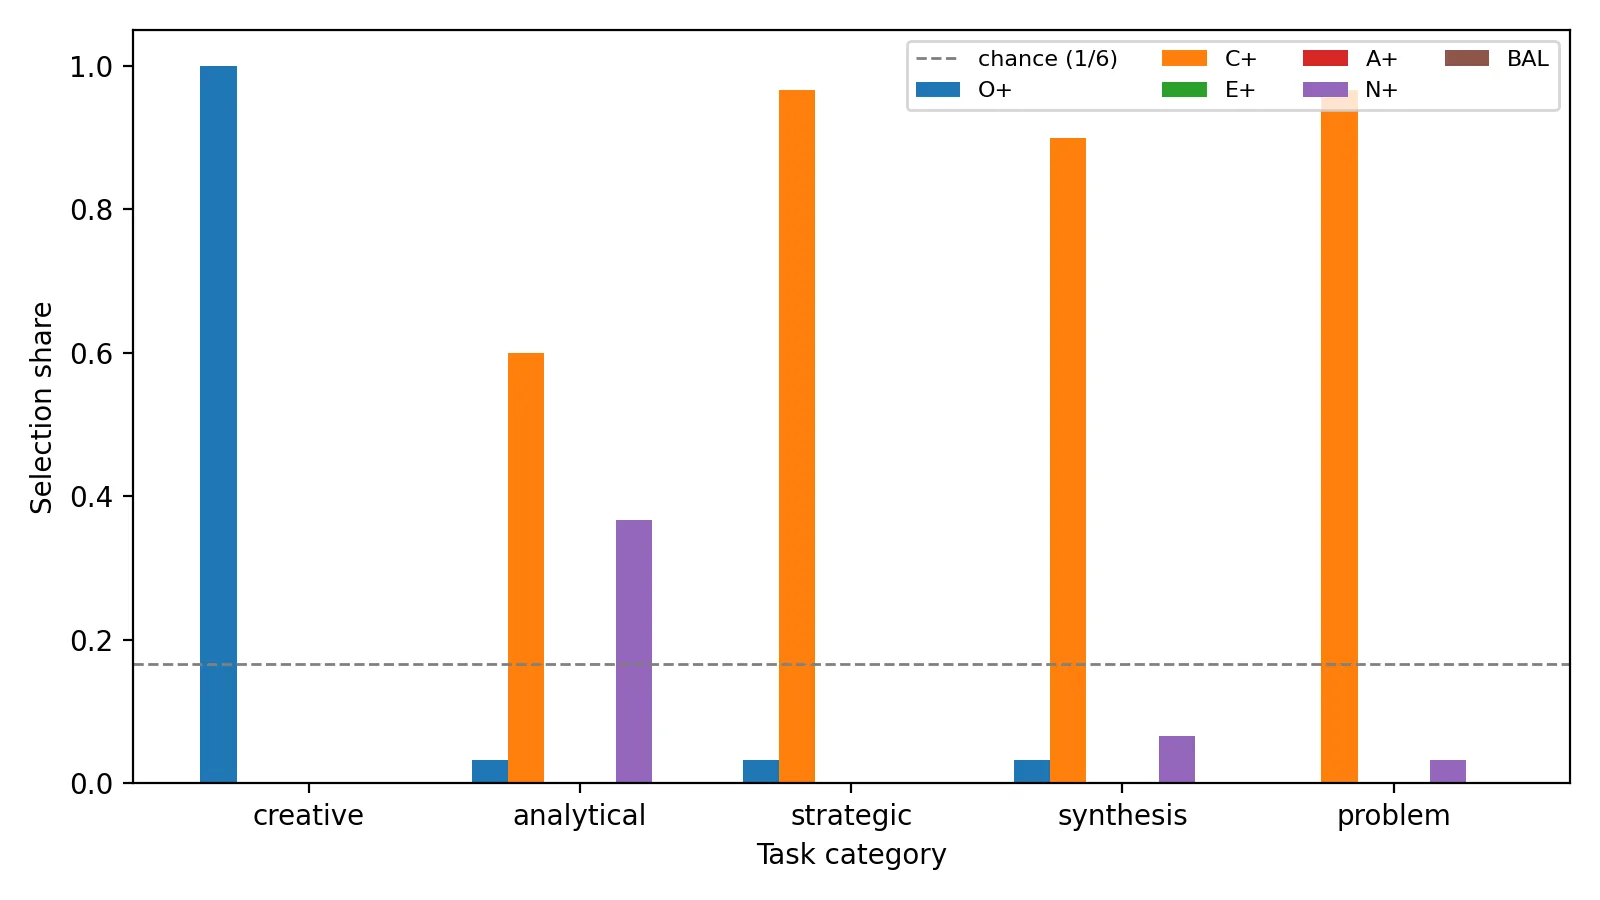
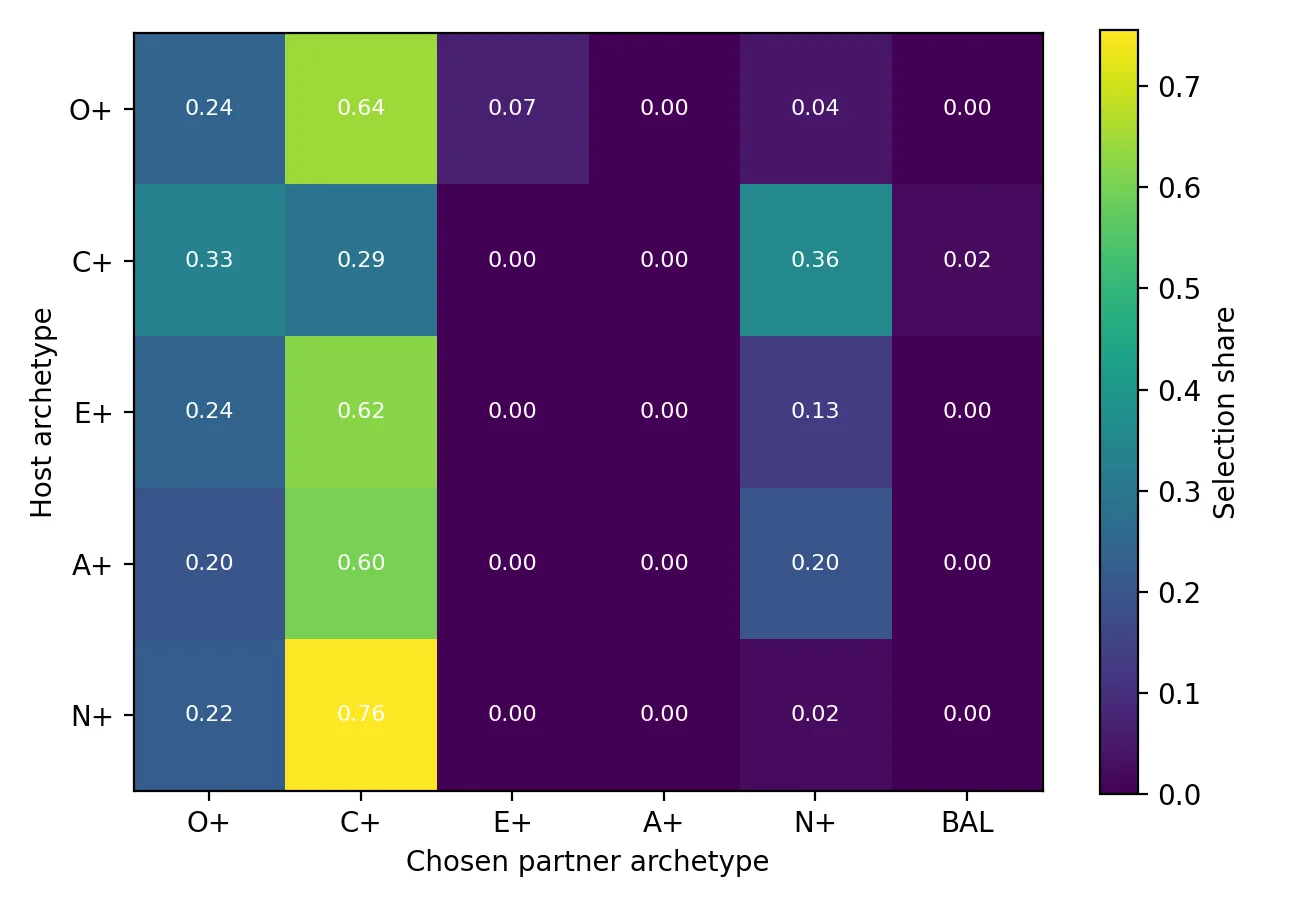
选择强烈依赖人格:中性宿主按任务匹配人格,创造任务选开放型、其余选尽责型;带人格的宿主选择差异更大的搭档,低于随机基线。
宿主将人格解读为任务适配信号而非相似吸引依据,遵循任务刻板印象并偏好互补,与人类同质相吸现象相反。
🆚 方法对比
Controlled Selection Paradigm
- 能力显式相等化,隔离性格变量
- 375次试验覆盖五类任务,样本充分
- 直接模拟主代理-候选代理生态结构
- 仅在六候选场景下验证,可扩展性未知
- 依赖单一LLM模型,泛化性待检验
- 未考虑候选数量对选择策略的影响
Study 1: Task-Stereotype Selection
- 150次试验跨五类任务,系统性强
- 揭示性格-任务刻板匹配的清晰模式
- 中立宿主设计消除自选偏差
- 外向、宜人、平衡候选几乎未被选中
- 与人类宜人性高绩效证据严重不一致
- 未量化任务完成质量作为验证
Study 2: Homophily Test
- 225次试验覆盖五种人格宿主,样本充足
- 发现宿主选择反同质化,结论新颖
- 特质空间距离量化增强论证力度
- 反同质化结果与传统吸引理论相悖,缺乏理论解释
- 自我相似选择低于随机,可能反映锚定偏差而非真实偏好
- 未区分互补选择与随机选择的边界
Big Five Archetype System
- 使用平衡效价描述,控制无关变量
- 结合BFI-10自报与盲测LLM评分双重验证
- 五维度+平衡控制设计完整
- 单维高/低原型过于简化真实人格复杂性
- 维度间未验证协同效应影响
- Archetype在文本生成中表达不均
Human Homophily Benchmark
- 基于元分析ρ值提供规范基准
- 区分绩效驱动与社会吸引驱动
- 为代理偏好提供可检验比较标准
- 人类团队证据本身存在争议(Peeters vs Han)
- 未考虑代理与人类决策机制差异
- 作为规范标准本身可能被误用
本文以Controlled Selection Paradigm为核心框架,通过Study 1(中立宿主)与Study 2(人格宿主)两个互补子研究,分别揭示任务刻板匹配与反同质化互补选择模式,并以人类同质化偏好作为规范参照,凸显LLM代理选择与人类证据的系统性错位。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
这项研究让大语言模型智能体在仅人格描述不同、能力完全一致的候选者中进行选择,发现它们会系统性地根据任务类型匹配人格——创意任务偏好开放型,其他任务偏好尽责型,而外倾、宜人和均衡型几乎无人问津。更反直觉的是,被赋予人格的智能体反而选择与自己差异更大的搭档,这与人类行为中的同质相吸现象完全相反。
研究背景与动机
多智能体系统正成为大语言模型落地的重要范式。在这类系统中,一个协调型智能体往往需要从大量候选者中挑选合作伙伴,与此同时,给智能体赋予人格特征(persona prompting)也已成为主流实践——通过在提示词中加入性格描述来塑造智能体的行为风格。
然而,一个根本性的问题尚未得到充分探讨:当智能体需要做选择时,它们会如何看待这些人格描述?人格差异是否会影响合作搭档的选择?
此前关于人格在多智能体团队中作用的研究,大多采用外生方式固定团队构成——也就是说,团队成员是谁由研究者预先设定,而非由智能体自主选择。这类研究无法回答"智能体自身如何做出伙伴选择"这一更本质的问题。
这篇论文的切入点正在于此:构建一种受控选择范式,让宿主智能体在纯粹因人格描述不同而存在差异的候选者中进行选择,从而隔离出人格对选择行为的独立影响。
方法
研究者设计了一套精巧的实验框架来解决这个问题。核心思路是严格控制变量:让候选智能体在能力上完全一致,唯一的区别只存在于大五人格(Big Five personality traits)描述中。
具体而言,实验中有六名候选智能体,它们各自对应大五人格中的一个突出特质维度:开放性(Openness)、尽责性(Conscientiousness)、外倾性(Extraversion)、宜人性(Agreeableness)以及一种均衡型配置。宿主智能体则分为两类:一部分是保持中性的宿主,另一部分则通过人格提示词被赋予了特定人格。
实验覆盖了五类任务——创意写作、代码生成、信息抽取、推理问答和数学问题——每类任务各进行了75次试验,总计375次选择试验。这一规模的重复实验确保了结果的统计可靠性。
实验与结果
实验结果揭示了令人意外的选择模式。对于中性宿主而言,选择行为呈现出明显的任务匹配特征。在创意性工作中,开放性高的候选智能体被选中的概率显著高于其他类型;而在其他大多数任务类别中,尽责性高的候选智能体则占据优势。
但更值得关注的是那些几乎从未被选中的类型:外倾型、宜人型和均衡型的候选智能体在全部375次试验中几乎无人问津。这一现象尤为讽刺,因为人类行为研究表明,宜人性恰恰是团队协作中与工作绩效最相关的特质之一。这暗示LLM智能体对人格的解读可能与人类社会的实际情况存在系统性偏差。
最具颠覆性的发现来自被赋予人格的宿主。当宿主自身也被赋予某种人格后,它们选择与自己人格相似的搭档的概率竟然低于随机基线。换句话说,这些宿主主动避开了与自己相似的候选者,选择的搭档在特质空间中的距离比随机选择产生的距离更远。
这一结果直接挑战了一个被广泛接受的人类行为规律——同质相吸(homophily)。在人类社会里,人们天然倾向于选择与自己相似的伙伴。然而LLM智能体似乎将人格描述解读为了任务契合度的信号,而非相似性吸引的依据:创意任务就该配开放型,常规任务就该配尽责型,选择遵循的是任务刻板印象。
讨论与可借鉴点
这项研究的发现对智能体生态系统的设计具有直接启示。首先,在构建智能体市场或编排框架时,必须意识到选择偏差的存在:某些人格类型可能被系统性地边缘化,这不仅涉及公平性问题,更关乎系统能否找到真正适合特定任务的合作者。其次,为智能体赋予人格时需要格外谨慎——当智能体具备人格后,其伙伴选择行为可能偏离设计者的预期。
研究本身也存在局限。实验中的候选智能体仅在人格描述上存在差异,真实场景中的合作伙伴还涉及专业技能、领域知识等多维度的异质性。此外,实验聚焦于二元选择情境,多智能体协作中的复杂动态尚未被覆盖。
对于多智能体系统的研究和实践而言,这项工作的核心启示在于:人格不应被视为简单的行为修饰符,它会深刻影响智能体的决策逻辑。未来的智能体市场设计需要引入偏差审计机制,而人机协作领域也应当重新审视"相似性"在选择过程中的作用——毕竟,智能体的偏好可能与人类直觉截然相反。
摘要
基于 LLM 的智能体越来越多地在多智能体生态系统中运行,其中协调型智能体需要选择与哪些其他智能体协作,并且这些智能体也越来越多地通过人格提示被赋予不同的个性。然而,人格本身是否会影响这种内生的伙伴选择尚未得到充分研究:先前关于多智能体团队中人格的工作通常以外生方式固定团队构成。我们提出了一种受控选择范式:由一个宿主智能体在六个仅在 Big Five 人格描述上有所不同的候选智能体中进行选择,同时显式地对其能力进行均衡处理(跨五个任务类别共 375 次试验)。我们发现,选择行为强烈且系统地依赖于人格。中性宿主会将人格与任务类型匹配,在创意性工作中选择开放性高的候选智能体,而在大多数其他类别中选择尽责性高的候选智能体;而外向性高的、宜人性高的以及均衡型的候选智能体几乎从未被选中,尽管人类研究表明宜人性是团队中与绩效最相关的特质之一。自身被赋予人格的宿主选择与自身相似的伙伴的概率低于随机水平,并且在特质空间中选择的伙伴比随机选择产生的伙伴距离自身更远。这些结果表明,宿主将人格描述解读为任务契合度的信号,而不是相似性吸引的基础:选择遵循任务刻板印象并倾向于互补型伙伴,这与人类的同质相吸引现象相反。我们的发现对智能体市场和编排框架中的偏见审计具有直接意义。
Abstract
LLM-based agents increasingly operate in multi-agent ecosystems where a coordinating agent chooses which other agents to work with, and agents are increasingly given personalities through persona prompts. However, whether personality itself influences this endogenous partner choice has not been sufficiently examined: prior work on personality in multi-agent teams has typically fixed team composition exogenously. We present a controlled selection paradigm in which a host agent chooses among six candidate agents that differ only in their Big Five personality descriptions, with capability explicitly equalized (375 trials across five task categories). We find that selection is strongly and systematically personality-dependent. Neutral hosts matched personalities to task types, choosing the open candidate for creative work and the conscientious candidate for most other categories, while the extraverted, agreeable, and balanced candidates were almost never chosen, despite human evidence that agreeableness is among the most performance-relevant traits for teams. Hosts that were themselves assigned personalities selected self-similar partners below chance and chose partners farther from themselves in trait space than random choice would produce. These results suggest that hosts read personality descriptions as signals of task fit rather than as grounds for similarity-based attraction: selection follows task stereotypes and favors complements, the opposite of human homophily. Our findings have direct implications for bias auditing in agent marketplaces and orchestration frameworks.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。