
CHMAS:一种用于多智能体强化学习的耦合分层框架
CHMAS: A Coupled Hierarchical Framework for Multi-Agent Reinforcement Learning
📝 TLDR
多智能体强化学习需要在全局协调与局部执行之间平衡不同时间尺度的决策。本文提出耦合分层多智能体框架CHMAS,将决策分解为中心化战略规划与分布式战术执行,并通过耦合系数λ实现双向信息流。异步更新协议缓解分层学习的非平稳性,理论证明战略层达到O(log K/√K)收敛率。多智能体觅食实验验证两层稳定收敛并习得空间分区探索策略。
🧭 速览
多智能体强化学习难以同时兼顾全局协调与局部执行,面临不同时间尺度决策的匹配难题。
CHMAS将决策分解为战略层与战术层,通过耦合系数λ实现双向信息流,并采用每N_f个战术回合异步更新战略参数的协议。
理论证明异步更新下战略层收敛率为O(log K/√K);多智能体觅食环境中两层均稳定收敛并习得空间分区探索策略。
CHMAS通过双向耦合与异步更新有效缓解分层MARL的非平稳性问题,为全局-局部协调提供可分析的新框架。
🆚 方法对比
CHMAS (Coupled Hierarchical Multi-Agent System)
- 双向耦合机制,通过λ反馈使策略贴合战术实际
- 集中策略规划+分布战术执行,兼顾协调与可扩展性
- 提供通用双层公式与可分析的加性近似
- 理论证明O(log K/√K)收敛保证
- 策略层需全局环境状态Senv,实际部署受限
- 集中策略层可能成为系统计算瓶颈
- 耦合系数λ和周期T需手动调优
AHPG (Asynchronous Hierarchical Policy Gradient)
- 异步更新协议有效缓解层次非平稳性问题
- 严格证明O(log K/√K)策略层收敛率
- 允许战术策略在策略更新间收敛到准平稳点
- 超参数Nf需仔细调优,过大或过小影响性能
- 依赖标准假设,实际场景收敛可能偏离理论
QMIX
- 集中训练分散执行的经典多智能体方法
- 通过混合网络处理信用分配问题
- 假设训练时所有智能体可获取全局信息
- 部分可观测与通信受限场景下不适用
- 缺乏层次结构,难以处理多时间尺度决策
MADDPG
- 集中评论家设计支持多智能体协作学习
- 适用于连续动作空间的策略学习
- 同样假设训练阶段全局信息可访问
- 缺乏层次时间尺度分离能力
现有层次化MARL方法 (单向控制)
- 层次强化学习天然适合多时间尺度决策
- 利用选项学习或奖励工程实现分层
- 采用单向控制,缺失战术对策略的反馈
- 策略变化违反战术平稳性假设
- 奖励工程依赖领域专家知识,泛化能力差
本文提出的CHMAS通过双向耦合与异步更新克服了QMIX/MADDPG缺乏层次结构和现有层次MARL单向控制的局限,实现了策略与战术间的信息互通与理论收敛保证。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 1 张)
展开查看 1 张图
TL;DR
CHMAS 提出了一种用于 [[多智能体强化学习]] 的耦合分层框架,将决策过程分解为中心化的战略规划层与分布式的战术执行层,并通过耦合系数 实现双向信息流。在 25×25 网格的多智能体觅食任务中,该方法学习到了空间分区的探索策略,理论分析证明战略层可达到 的收敛速率。
研究背景与动机
多智能体强化学习系统在实际应用中面临一个根本性的张力:全局协作需要中心化的协调能力,而局部执行需要分布式的实时响应。纯中心化方法虽然能够获得全局视图,但联合动作空间随智能体数量呈指数增长,在现实场景中很快会遇到维度灾难。纯分布式方法虽然具有良好的可扩展性,但难以协调长程的全局目标。介于两者之间的 [[CTDE]] 类方法虽然允许训练阶段访问全局信息,但在部分可观测或通信受限的环境中往往失效。
更深层的困难在于,多智能体环境天然具有不同的时间与空间尺度。战略层面的决策——如编队控制、任务分配——需要全局信息支撑,但只能以低频运行;战术层面的响应——如避障、局部适应——要求高频的局部反应,却无法直接感知全局状态。现有方法在处理这种多尺度特性时,往往只能做到单向的高层控制,高层指导低层执行,但低层的实际效果如何、是否合理,从未反馈回高层决策。
这种单向控制带来的另一个严重问题是 [[非平稳性]]。在分层结构中,当高层策略更新时,低层所面对的环境也随之改变——原本已经学好的低层策略在新环境下可能不再适用,甚至成为次优选择。这违反了强化学习中各层独立学习的平稳性假设,使得训练过程不稳定、收敛困难。
CHMAS 的切入点正是同时解决这两个问题:建立战略层与战术层之间的双向反馈机制,让低层的战术反馈影响高层的战略目标;同时设计异步更新协议,在时间上将两层解耦,使得战术层在战略层变化之间有机会收敛到准平稳状态。
方法
CHMAS 的核心设计可以概括为"分而治之加双向耦合"。框架将多智能体决策分解为两个层次:战略层负责全局规划,战术层负责局部执行。战略层采用中心化运行方式,可以访问所有智能体的状态 以及一个独占的全局环境状态 ——这个全局状态刻画的是单个智能体无法感知的整体信息,例如资源分布或整体覆盖情况。战略层每 个时间步生成一次指导动作 ,为每个智能体分配下一阶段的目标区域或方向,这个指导动作持续生效 步。战术层则采用分布式运行,每个智能体只能通过通信图感知邻域内邻居的信息,以增强后的局部观测运行自己的策略。
与既有分层方法最大的区别在于,CHMAS 建立了一种反馈机制。传统分层强化学习只有自上而下的单向控制,高层决定做什么,低层就执行什么。但真实世界的层级组织中,高层的规划必须"接地气"——必须考虑底层执行者的实际能力和约束。CHMAS 通过耦合系数 将累积的战术奖励反向注入战略目标:
当 时,框架退化为纯单向层级结构; 时,战略层的目标函数同时受到全局奖励和战术层累积奖励的共同驱动。这意味着战略规划必须考虑战术可行性——如果一个战略目标在战术层面根本行不通,那么它获得的累积战术奖励会很低,进而压低该战略目标的总体评价。
为了处理分层学习固有的非平稳性问题,CHMAS 提出了异步更新协议。战术策略每个 episode 更新一次,采用步长 ;战略参数则仅每 个战术回合才更新一次,采用衰减步长 。这种设计背后的直觉是:在两次战略更新之间,战术层面对的是一个相对稳定的环境(因为战略指导在这段时间内保持不变),因此有机会收敛到一个准平稳点。当战略层更新时,战术层重新在新战略指导下进行新一轮的适应。如此交替,将非平稳的分层学习问题转化为一系列交替的平稳子问题。
在理论分析层面,CHMAS 给出了双层目标的 [[Stackelberg]] 博弈形式:
为了获得可处理的理论结果,框架引入了加性近似,将两层目标解耦为独立项的和,跨层耦合通过异步更新调度隐式处理。该近似的误差随训练推进而消失,由战术最优性间隙 刻画。
实验与结果
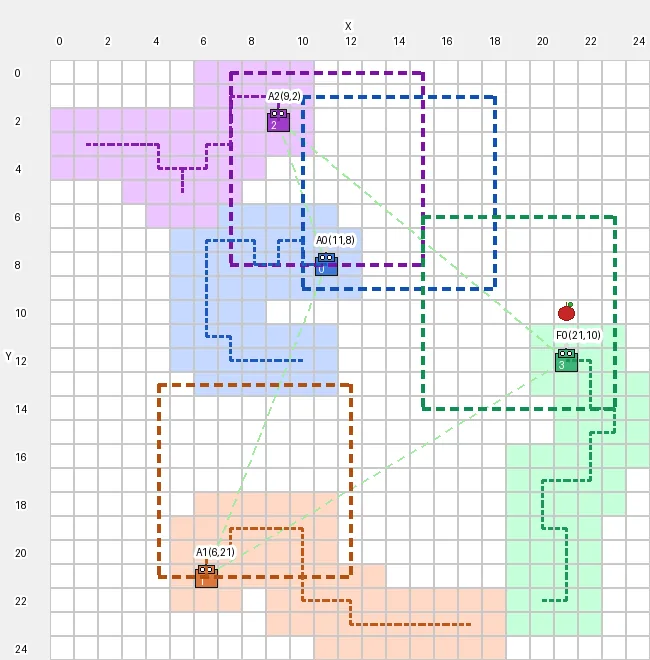
实验在 25×25 的 GridWorld 环境中进行,使用 4 个智能体完成协同觅食任务。每个智能体只能观测到 20 维的局部信息(位置、邻近资源、战略指导),而战略层可以访问完整的全局环境状态——一个 625 维的向量,记录了整个网格的访问情况。战略动作空间为每个智能体分配一个 9×9 子区域的中心坐标,战术动作空间包含移动、收集、等待等离散选项。奖励设计显式体现了双向耦合:战术层获得局部收集奖励和区域外移动惩罚,战略层获得全局覆盖奖励加上由 加权的战术累积奖励之和。
实验结果表明,框架的两层均能稳定收敛。战术层的 Q 值在约 300 个 episode 后趋于稳定,累积回报从约 提升至约 ;战略层的 Q 值从 附近上升至接近 0,累积回报从 提升至约 。值得注意的是,训练初期存在约 10–20 个 episode 的"延迟启动"阶段,这反映了异步协议的效果——战术策略先于战略层独立稳定,之后战略层才开始有效学习。
最引人注目的行为发现是,训练后的策略自发涌现出空间分区的探索策略。智能体被战略层分配到不重叠的子区域,各自负责一片区域的探索,同时在各自区域内兼顾局部资源收集。这种行为说明双向耦合确实发挥作用——战略层学会了分配任务,战术层学会了在指定区域内高效执行,两者形成了有效的分工协作。
从理论验证角度看,实验结果与理论预测一致:战略层以对数速率趋于收敛(学习曲线呈现先快后慢的典型特征),战术层的收敛速度则符合 的理论预测。
讨论与可借鉴点
CHMAS 在方法论层面的主要贡献是提出了双向耦合分层 [[强化学习]] 的框架设计,将高层战略规划"接地气"的需求形式化为耦合系数的加权机制。这种设计思路可以推广到其他需要双向反馈的分层决策问题中——不仅仅是多智能体场景,任何具有"规划-执行"分离结构的系统都可能受益于类似的反馈机制。
异步更新协议的设计也提供了有益的启示:将非平稳的分层学习问题通过时间解耦转化为交替平稳子问题,是一条可行的技术路径。战略层采用衰减步长、战术层采用固定步长的双时间尺度设计,在理论分析和工程实践中都表现出良好的性质。
然而,当前工作的局限性也是明显的。实验仅在单一的小规模场景上验证,缺乏与 QMIX、MADDPG、Feudal Networks 等成熟方法的定量对比,因此难以判断该框架在实际任务性能上的真实优势。框架中几个关键超参——战略周期 、异步更新频率 、耦合强度 ——均未做系统的消融分析, 的选取来自经验而非系统调优。此外,框架的通信图假设(智能体只能感知邻域信息)与实际的通信约束之间的匹配程度也值得进一步探索。
对于后续研究而言,一个自然的方向是在更大规模、更高复杂度的环境(如 StarCraft Multi-Agent Challenge 或多智能体粒子环境)中验证框架的可扩展性。另一个重要方向是探索耦合系数的自适应调整机制——当前的固定 需要人工设定,如果能够根据任务特性动态调整,可能会进一步提升框架的适应性。
摘要
多智能体强化学习(MARL)系统在不同时间尺度上协调全局协作与局部执行时面临着根本性的挑战。本文提出了耦合分层多智能体系统(CHMAS),一种将多智能体决策分解为集中式战略规划与分布式战术执行并具有双向信息流的新型框架。战略层整合所有智能体的状态以及一个独占的全局环境状态,每 个时间步生成一次指导动作;而战术智能体则执行由战略指导和局部邻域观测增强的分布式策略。与现有的具有单向控制的分层方法不同,CHMAS 建立了一种反馈机制,其中累积的战术奖励通过耦合系数 影响战略目标,确保战略规划始终根植于战术可行性。为应对分层学习固有的非平稳性,我们提出了一种异步更新协议,其中战略参数每 个战术回合更新一次,从而允许战术策略在战略变更之间收敛至准平稳点。我们给出了既能够刻画完整系统动态的一般双层形式化表述,以及一种支持严格分析的可处理加性近似。理论分析证明,在标准假设条件下,该异步方案在经过 次战略更新后,战略层可达到 的收敛速率。在多智能体觅食领域中的实验验证表明,该方法成功学习到了空间分区的探索策略,尽管存在分层耦合,两层均能稳定收敛。
Abstract
Multi-agent reinforcement learning (MARL) systems face fundamental challenges in balancing global coordination with local execution across different temporal scales. This paper introduces the Coupled Hierarchical Multi-Agent System (CHMAS), a novel framework that decomposes multi-agent decision-making into centralized strategic planning and distributed tactical execution with bidirectional information flow. The strategic layer integrates all agents' states with an exclusive global environmental state to generate guidance actions every timesteps, while tactical agents execute distributed policies augmented by strategic guidance and local neighborhood observations. Unlike existing hierarchical approaches with unidirectional control, CHMAS establishes a feedback mechanism where accumulated tactical rewards influence strategic objectives through a coupling coefficient , ensuring strategic plans remain grounded in tactical feasibility. To address the non-stationarity inherent in hierarchical learning, we propose an asynchronous update protocol where strategic parameters update every tactical episodes, allowing tactical policies to converge to quasi-stationary points between strategic changes. We present both a general bi-level formulation capturing full system dynamics and a tractable additive approximation enabling rigorous analysis. Theoretical analysis proves that this asynchronous scheme achieves convergence for the strategic layer after strategic updates under standard assumptions. Experimental validation in a multi-agent foraging domain demonstrates successful learning of spatially partitioned exploration strategies, with both layers converging stably despite hierarchical coupling.
论文详细总结(自动生成)
CHMAS 论文详细总结
1. 核心问题与研究背景
多智能体强化学习(MARL)系统在实际部署中面临一个根本性挑战:如何在多个时间与空间尺度上协调分布式智能体的全局协作与局部执行。
- 纯中心化方法:联合动作空间随智能体数量呈 规模增长,维度灾难严重,难以实际部署。
- 纯分布式方法:可扩展性好,但牺牲了对长程全局目标的协调能力。
- CTDE 类方法(如 QMIX、MADDPG):假设训练阶段可访问所有智能体的全局信息,但在部分可观测、通信受限的现实场景中往往失效。
- 现有多尺度方法:战略决策(编队控制、任务分配)需全局信息但只能以低频运行;战术响应(避障、局部适应)要求高频局部反应。二者天然处于不同时间尺度。
- 现有分层 MARL 缺陷:高层对低层是单向控制(unidirectional),缺乏战术→战略的反馈机制;同时策略更新会造成严重的非平稳性问题,违反各层独立学习的平稳性假设。
CHMAS 试图同时解决"全局-局部协调"与"分层非平稳性"两大难题。
2. 方法论
2.1 总体架构
CHMAS 将决策分解为两层,并通过双向耦合连接:
- 战略层(Strategic Layer):中心化运行,可访问所有智能体状态 与一个独占的全局环境状态 (如资源分布、整体覆盖等单个智能体无法感知的信息)。每 个时间步生成一次个性化指导动作 ,持续生效 步。
- 战术层(Tactical Layer):分布式运行,每个智能体 只能通过通信图 感知邻域 内邻居的信息,并以增强后的局部观测运行自己的策略。
2.2 双向耦合机制
- 下行耦合(战略 → 战术):通过观测增强 、战术奖励调制和动作时间持续性发挥作用。
- 上行耦合(战术 → 战略):累积的战术奖励通过耦合系数 影响战略目标:
其中 即退化为纯单向层级结构。
2.3 异步更新协议(AHPG)
- 战术策略每个 episode 更新一次,步长 。
- 战略参数仅每 个战术回合更新一次,步长采用衰减 。
- 这样保证在两次战略更新之间,战术层可在固定的战略指导下收敛到准平稳点,将非平稳的分层学习转化为一系列交替的平稳子问题。
2.4 双向耦合问题形式化
协同设置下的双层(Stackelberg)目标:
为便于理论分析,引入加性近似:
其中跨层耦合通过异步更新调度隐式处理,其近似误差由战术最优性间隙 控制, 随训练消失。
2.5 收敛性分析(定理 1)
在以下三类假设下:
- 假设 1(光滑性 + 有界性 + 梯度方差有限 + 战略梯度存在由非收敛战术参数引起的偏差 );
- 假设 2(战术层满足 -PL 条件:,并采用热启动和轮询更新);
- 假设 3(战略梯度对战术参数满足 -Lipschitz 连续性);
选取步长 ()、,则经过 次战略更新后:
证明思路:利用 PL 条件得到 的压缩因子,进而得 ;将该偏差代入战略层 Lyapunov 递推并对 求和,最终得到上述 速率。
3. 实验设计
3.1 任务与场景
- 场景:25×25 的 GridWorld 多智能体协同觅食任务, 个智能体。
- 信息不对称:每个智能体仅观测 (位置、邻近资源、战略指导);战略层可观测完整 ,其中 记录全局访问情况。
- 战略动作:每 步生成一次指导,为每个智能体分配一个 子区域中心 。
- 战术动作:离散动作集 (移动、收集、等待)。
- 奖励设计(显式实现双向耦合):
- 战术奖励
- 全局覆盖奖励
- 战略奖励 ,
3.2 实现方法
- 战术层:Multi-Agent DQN(MA-DQN),采用参数共享、对偶网络(dueling)、Double Q-learning 和优先经验回放。
- 战略层:基于全局状态的中心化 DQN。
- 训练设置:400 个 episode,5 个独立随机种子。
3.3 对比方法
论文未与传统分层 MARL 方法(如 Feudal Networks、HRL with options)以及 QMIX、MADDPG 等基线做定量对比实验,仅在引言和相关工作部分做了概念性比较。这一点是该论文实验部分的主要缺憾(详见第 8 节)。
4. 资源与算力
论文未明确报告:
- 使用的 GPU 型号与数量;
- 训练时长(每个 episode / 总训练时间);
- 内存占用;
- 任何形式的计算资源统计。
由于实验规模很小(25×25 网格、4 个智能体、400 episode、5 个种子),预计计算开销很低,普通 GPU 甚至 CPU 即可完成,但作者未给出具体信息。
5. 实验数量与充分性
- 实验规模:仅 1 个场景(25×25 GridWorld 觅食任务)、4 个智能体、400 episode、5 个随机种子、 的固定异步更新频率。
- 呈现形式:战术层和战略层各 4 条学习曲线(Q 值、回报、critic 损失、actor 损失),加上 5 帧执行轨迹的可视化。
- 充分性评估:
- ✅ 5 个种子提供了方差估计,结果相对可信;
- ✅ 消融了 的影响( 与 的对比隐含在框架设计中);
- ❌ 缺少不同 、 的消融实验;
- ❌ 缺少与 QMIX、MADDPG、Feudal Networks 等基线的定量对比;
- ❌ 仅在单一任务上验证,未证明方法在不同规模、稀疏奖励、对抗性环境中的可推广性;
- ❌ 未给出与"无战略层"的纯分布式基线对比,难以单独衡量战略层的边际收益。
整体而言,实验以"原理验证"为主,而非"性能基准"为主,对结论的普适性支持有限。
6. 主要结论与发现
1. 架构层面:双向耦合的分层结构能够将集中式全局信息优势与分布式可扩展性相结合。
2. 学习动态层面:战术层 Q 值在约 300 episode 后趋于稳定,回报由约 提升至约 ;战略层 Q 值由 上升至接近 0,回报由 提升至约 15。前 10–20 episode 的"延迟启动"反映异步协议允许战术策略先稳定。
3. 行为层面:训练后的策略涌现出空间分区的探索策略,智能体被分配到不重叠的子区域并自适应地向未探索区域迁移,同时兼顾局部资源收集(见 Fig. 4 轨迹可视化)。
4. 理论层面:在标准假设(PL 条件 + 双时间尺度步长)下,异步协议保证战略层以 、战术层以 收敛。
5. 方法论贡献:将分层 MARL 解释为一种带约束的强化学习——战略指导编码全局约束,战术反馈通过 调节约束满足程度。
7. 优点
- 新颖的双向耦合设计:打破既有分层 MARL 的单向控制传统,通过 让战略目标被战术可行性"接地气",更贴近真实层级控制问题。
- 清晰的信息不对称建模:显式引入"独占全局环境状态 ",刻画了战略层与战术层之间的信息瓶颈。
- 可处理的加性近似:在保留主要结构的前提下,使两时间尺度随机近似(two-timescale SA)的成熟收敛分析工具可用。
- 理论保证非平凡:证明在 PL 条件下战略层 收敛与战术层 收敛,log 因子来自衰减步长,是常见的次优界但推导完整。
- 算法即插即用:战略层可替换为 PPO 等中心化算法,战术层可替换为任意分布式策略梯度或 actor-critic。
- 实验呈现规范:5 个种子提供方差带,Q 值/回报/损失/轨迹可视化多维度佐证。
8. 不足与局限
- 实验范围过窄:仅在单一 网格、4 智能体、觅食任务上验证,缺乏对更大规模(如 StarCraft Multi-Agent Challenge、MPE、粒子环境)的测试,难以判断方法的可扩展性。
- 缺少基线对比:没有与 QMIX、MADDPG、Feudal Networks、Options Framework 等成熟分层/多智能体方法做定量比较,因此难以判断 收敛背后实际任务性能的真实优势。
- 关键超参固定:未对 (战略周期)、(异步频率)、(耦合强度)做消融,无法量化这些设计选择的敏感性。 是经验选取而非系统调优。
- 加性近似的合理性: 忽略了跨层依赖的精确刻画;理论上这种近似的误差界(与 相关)只在战术最优性间隙趋于零时才有保证,但实际训练中战术永远未真正最优。
- PL 条件假设较强:论文自己也承认 PL 条件仅在表格型 softmax 策略或过参数化神经网络"接近平稳点时局部成立"。对真实深度网络的全局收敛性无保证。
- 轮询更新假设:假设 2.3 要求战术层"轮询更新",同时更新的多智能体场景中该假设可能不成立,作者承认可放松但需更复杂的耦合分析。
- 集中化全局信息可获取性:战略层要求访问 和所有智能体状态,这一假设在通信受限或隐私敏感场景下难以满足。
- 算力与可复现性报告缺失:未说明硬件配置、训练时长、代码细节(仅提供 GitHub 链接),不便于其他研究者精确复现训练曲线。
- DQN 实验与理论脱节:定理 1 仅对策略梯度实现严格证明,DQN 实验作为"原理验证"存在,但理论-实验间的桥梁尚不完整。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。