
📝 TLDR
在大语言模型的序列决策场景中,监督微调虽能提升准确率却压缩了行为多样性,推理模式进一步加剧这一倾向。本文在可精确求解的井字棋变体套件上,从状态级、竞技对局和训练轨迹三层面系统测量多样性崩溃,并验证对全部最优动作进行增广训练可部分缓解该现象。研究揭示窄支撑模仿是LLM策略崩溃的根源之一,提示SFT阶段保留动作支撑对维持探索行为至关重要。
🧭 速览
SFT对LLM序列决策中行为多样性的影响尚未明确,缺乏可精确量化多样性的受控评测环境。
在井字棋变体套件中,从状态级、竞技对局与训练轨迹三个维度量化多样性与准确率,对比推理生成与动作增广训练的效果。
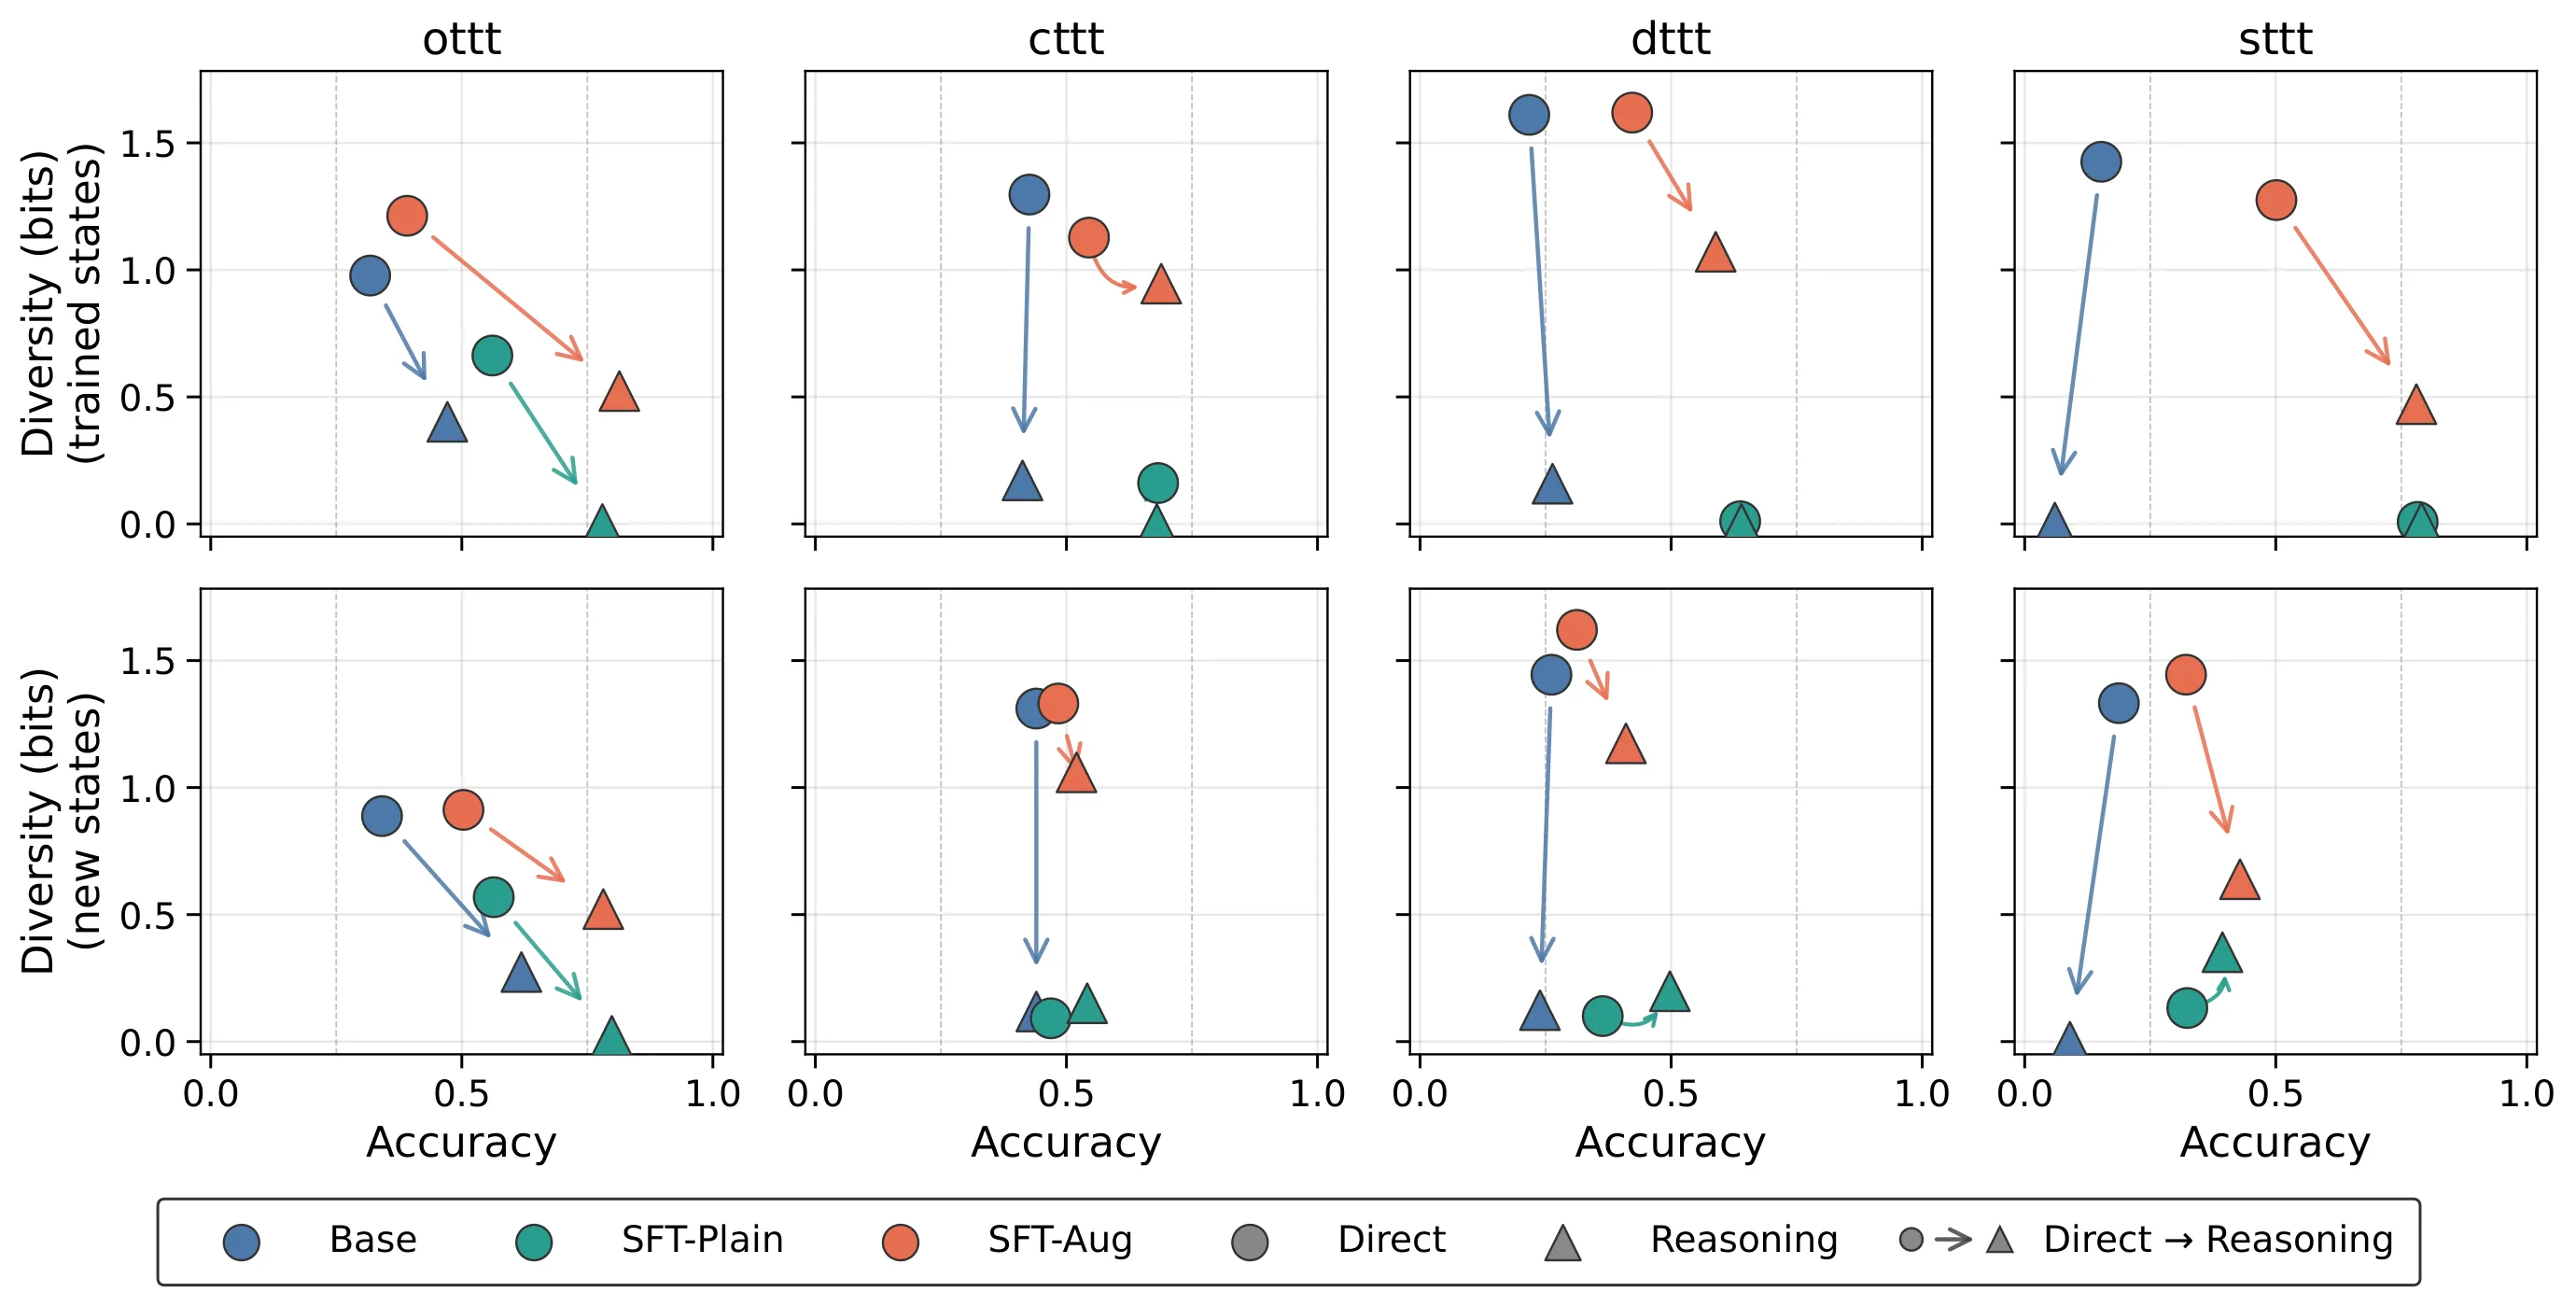
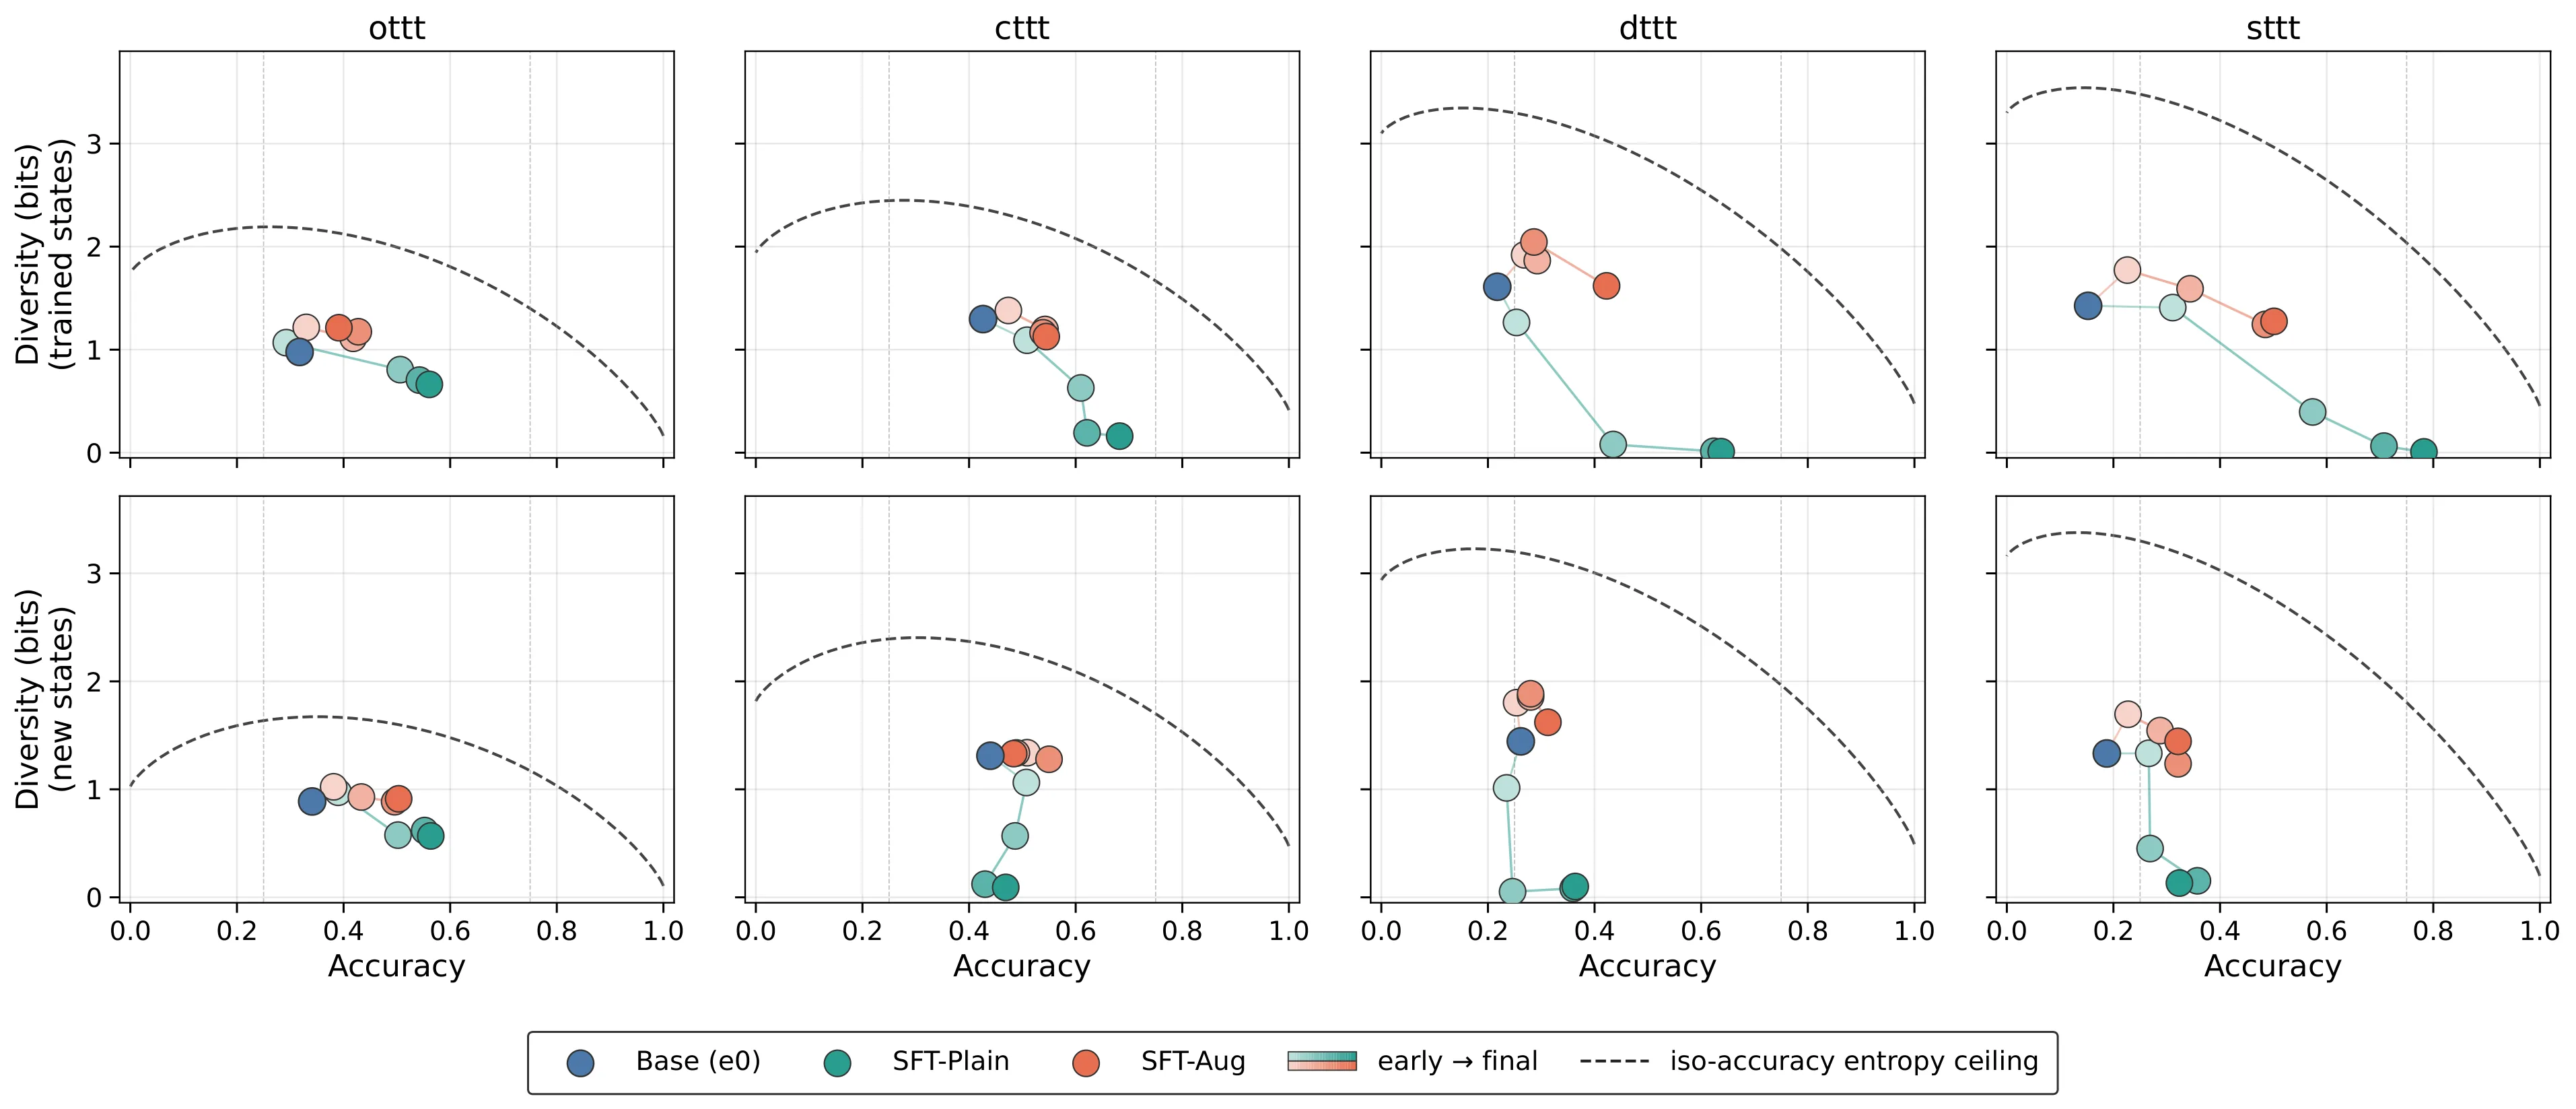
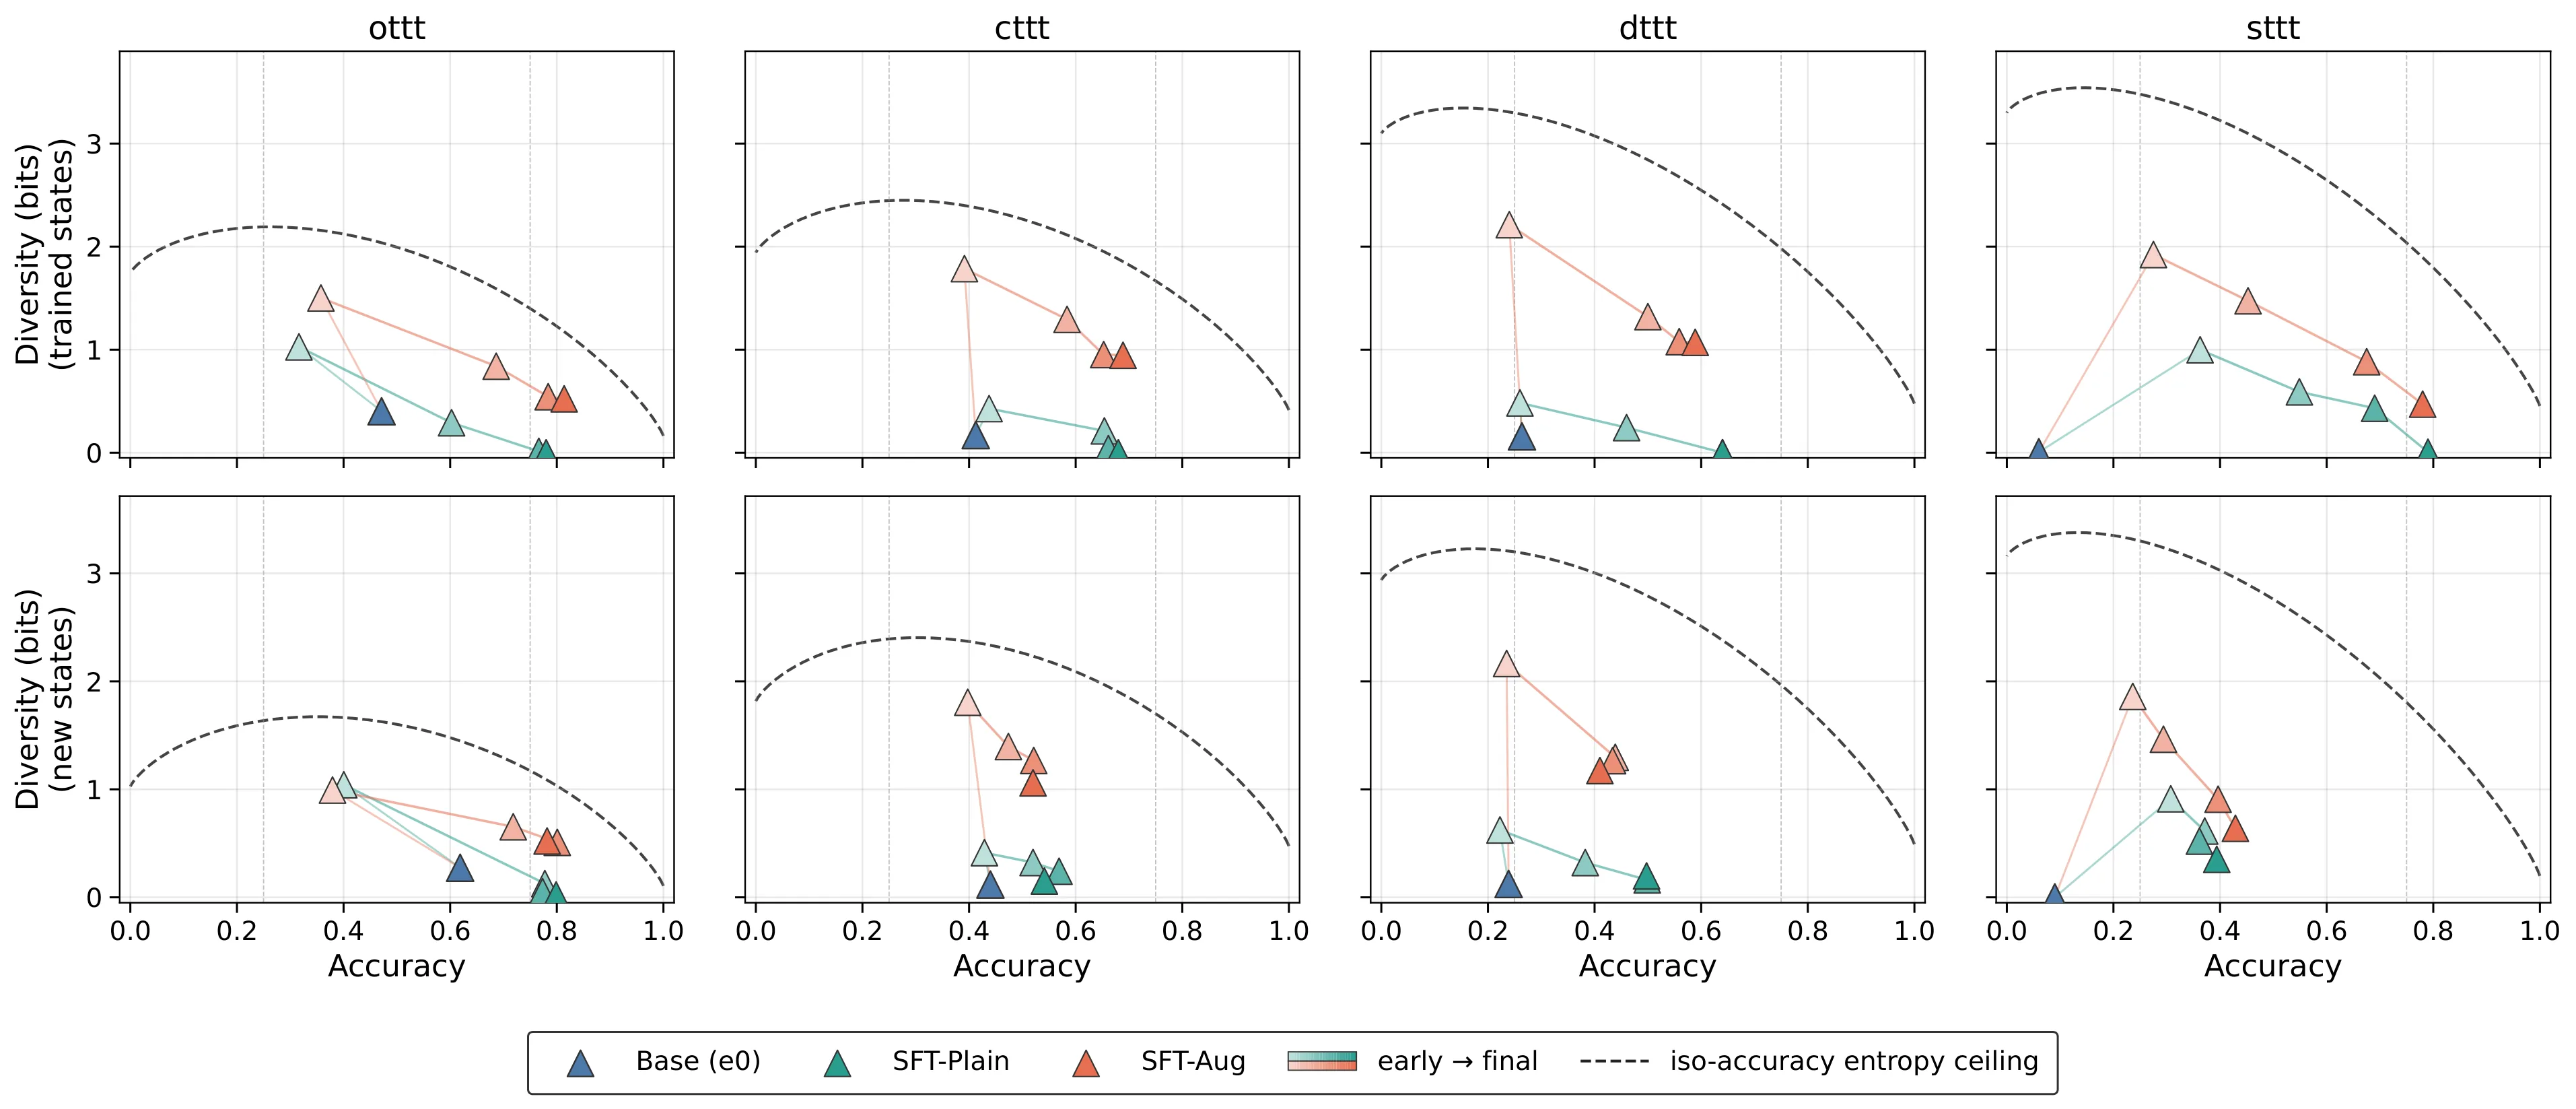
推理模式常压低多样性却未必提升准确率;标准SFT在准确率上升时出现过早多样性崩溃,超出准确率-多样性权衡的最小需求。
窄支撑模仿是LLM决策策略崩溃的来源,SFT中保留动作支撑对维持探索行为至关重要。
🆚 方法对比
Supervised Fine-Tuning (SFT)
- 提升动作准确率
- 适用于结构化输出任务
- 易于在下游任务上微调
- 在多个游戏中提升性能
- 诱发过早多样性坍缩
- 收窄输出分布,抑制探索
- 窄支持模仿导致策略坍缩
- 熵损失超过准确率-多样性权衡所需
Reasoning-mode generation
- 在部分配置下提升动作准确率
- 与动作增强结合效果最佳
- 支持链式思维的结构化推理
- 频繁压缩动作多样性
- 未必均匀提升准确率
- 放大弱动作偏好,策略集中
- 将策略推向准确率-多样性前沿之下
Action Augmentation
- 保留显著更多行为多样性
- 训练覆盖所有最优动作
- 缓解多样性坍缩问题
- 直接增强模型准确率较低
- 单独使用不足以兼顾二者
- 需与推理模式结合方达最佳效果
Non-reasoning direct generation
- 保留更多行为多样性
- 避免推理引入的策略集中
- 实现简单,计算开销低
- 动作准确率低于推理模式
- 策略探索缺乏结构化引导
- 在复杂决策场景性能有限
Tic-tac-toe variants (评估环境套件)
- 状态-动作-奖励空间定义明确
- 确定性与完全信息,策略可精确评估
- 多样性与性能可分离测量
- 支持大规模重复轨迹实验
- 局限于简单棋盘游戏设定
- 外推到复杂领域的能力有限
- LLM在此环境仍仅接近一步 lookahead
One-step lookahead player (经典基线)
- 在已解游戏中执行可靠
- 提供LLM性能的对照基准
- 策略简单且可复现
- 策略深度有限
- LLM仅与之相当表明决策能力弱
- 无法处理需多步推理的场景
论文以tic-tac-toe变体为受控环境,对比标准SFT、推理模式生成、动作增强及非推理直接生成等策略,发现推理模式常压缩多样性而未必提升准确率,而动作增强结合推理模式能在保持竞争力的准确率同时显著保留行为多样性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
TL;DR
这篇论文通过精心设计的井字棋变体游戏,首次在可精确求解的环境中系统揭示了监督微调(SFT)导致大语言模型行为多样性坍缩的机制。研究发现,推理模式的生成会抑制动作多样性,而标准 SFT 在提升准确率的同时,往往引发超出必要程度的多样性崩溃。通过在每个状态下训练所有最优动作而非单一示范动作的动作增强策略,可以部分缓解这一现象,为保持 LLM 在决策任务中的探索能力提供了新思路。
研究背景与动机
大语言模型在序列决策场景中的应用日益广泛,从游戏对局到机器人控制,模型需要在每一步做出正确的动作选择。监督微调作为将预训练模型适配到下游任务的标准范式,被认为能够有效提升模型在特定任务上的表现。然而,一个关键问题始终悬而未决:SFT 在提升任务准确率的同时,是否会不经意间压缩模型的行为多样性?
这个问题之所以重要,是因为行为多样性直接关系到模型的探索能力和泛化潜力。在真实世界的决策场景中,环境往往是部分可观测或动态变化的,模型需要保持一定的行为灵活性以应对未见过的状态。如果模型在微调后变得过于"确定",只认得单一的正确动作而忽略其他等优选择,其鲁棒性和适应性将大打折扣。
已有的研究多关注 SFT 如何提升准确率,却鲜少系统考察其对行为多样性的影响。这并非因为多样性不重要,而是因为在大多数真实任务中,最优动作本身就难以定义,多样性更是无从度量。论文的创新之处正在于此——作者选择在井字棋变体这一可控环境中研究该问题。井字棋的吸引力在于它具有明确的最优策略和可计算的最优动作集合,使得我们能够精确区分"正确但不唯一"的选项,从而真正量化多样性的变化。
方法
论文的核心方法论建立在三个支柱之上:可控的实验环境、精确的多样性度量,以及系统的分析框架。
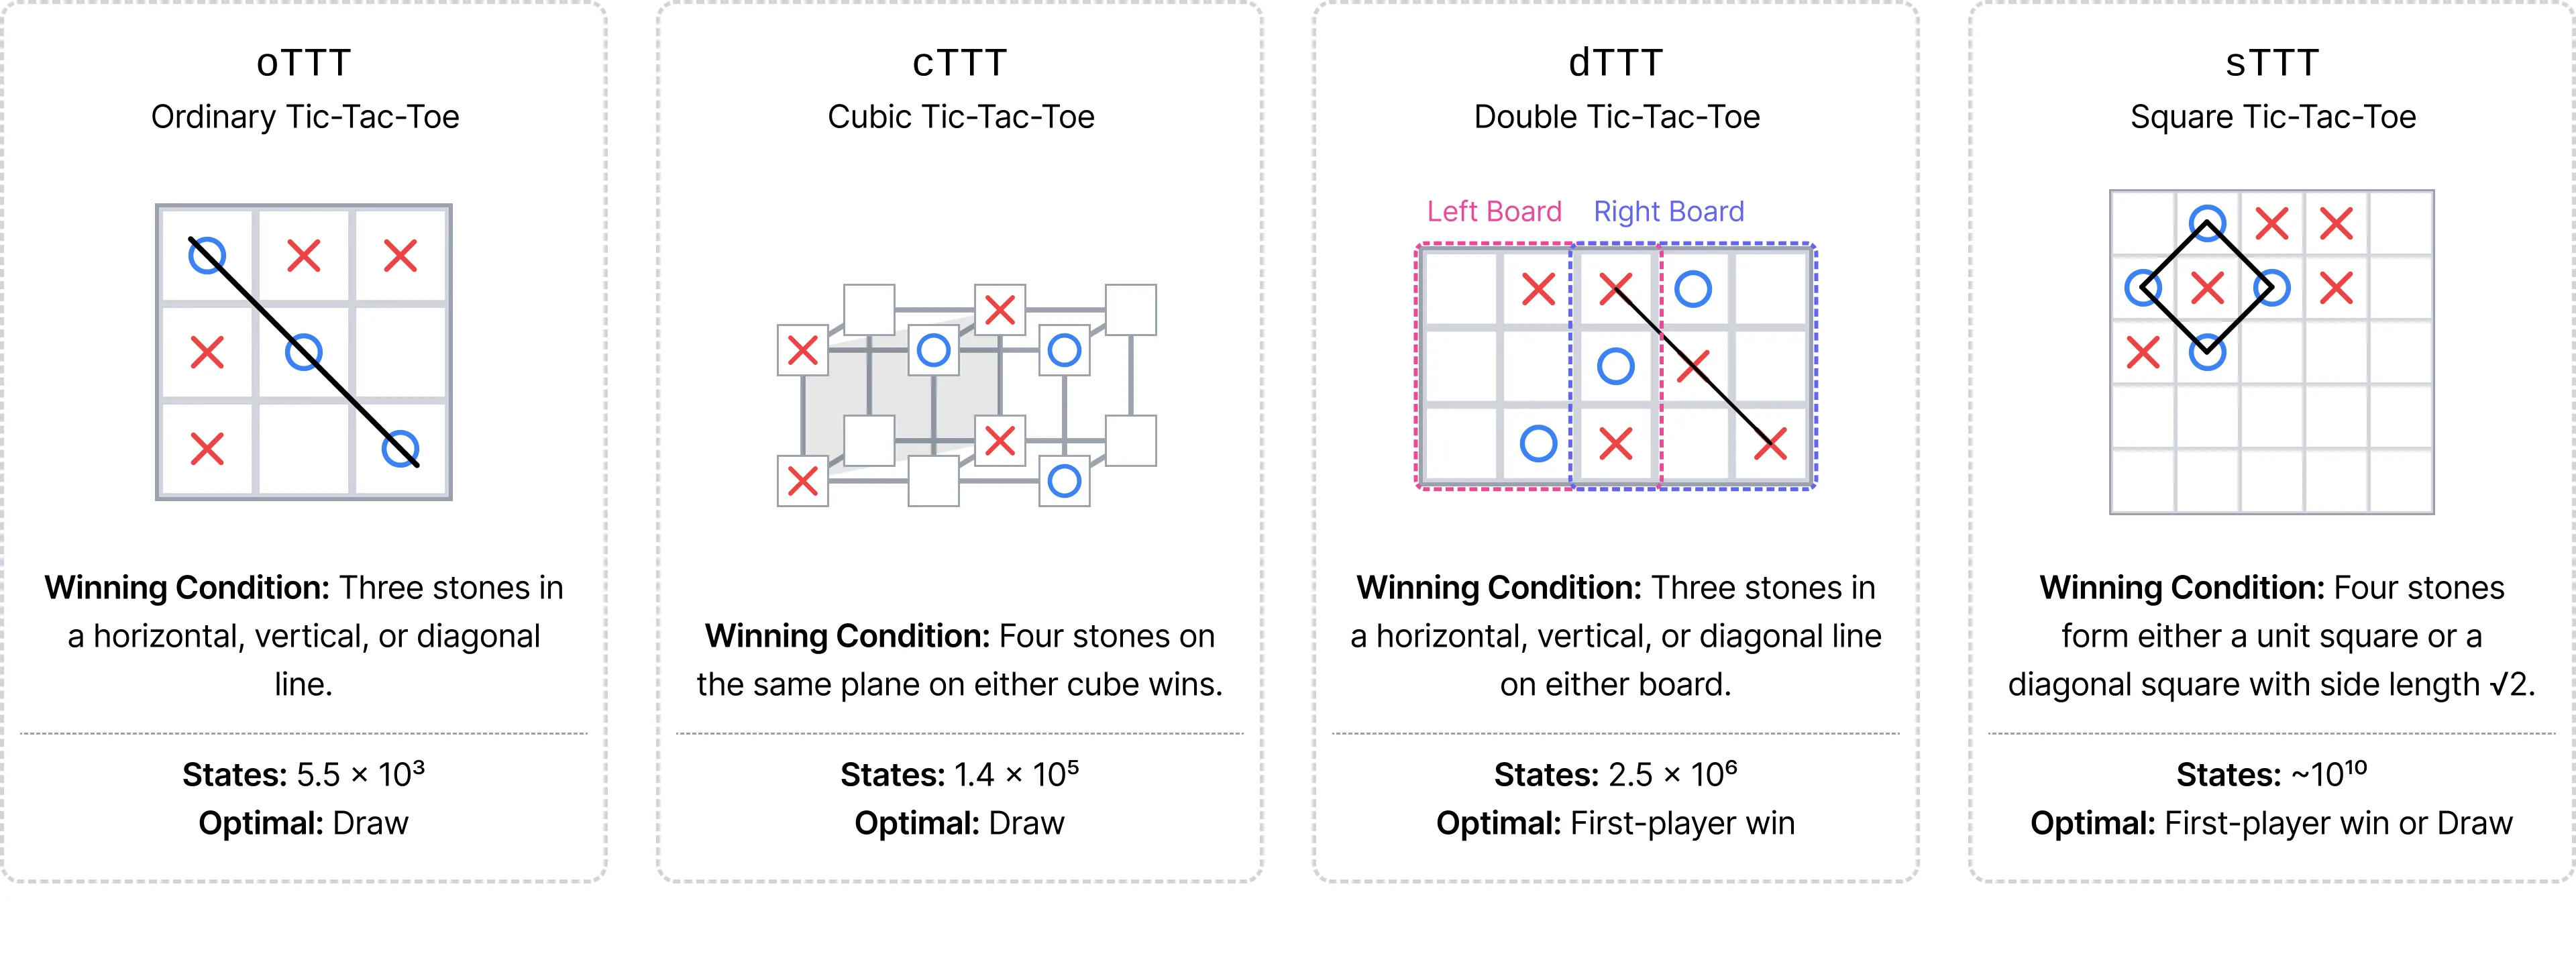
实验环境设计。作者构建了一套基于井字棋的确定性棋盘游戏套件,包括标准井字棋、带有惩罚机制的变体,以及更大规模的变体。这些游戏共享一个关键特性:对于任意状态,所有最优动作(即不差于最优结果的合法动作)都可以通过精确计算获得。以标准井字棋为例,当某一方在中心位置落子时,四个角落和四条边中点的走法都能达到相同的最优结果,这些动作构成了该状态的动作空间中的最优支撑。
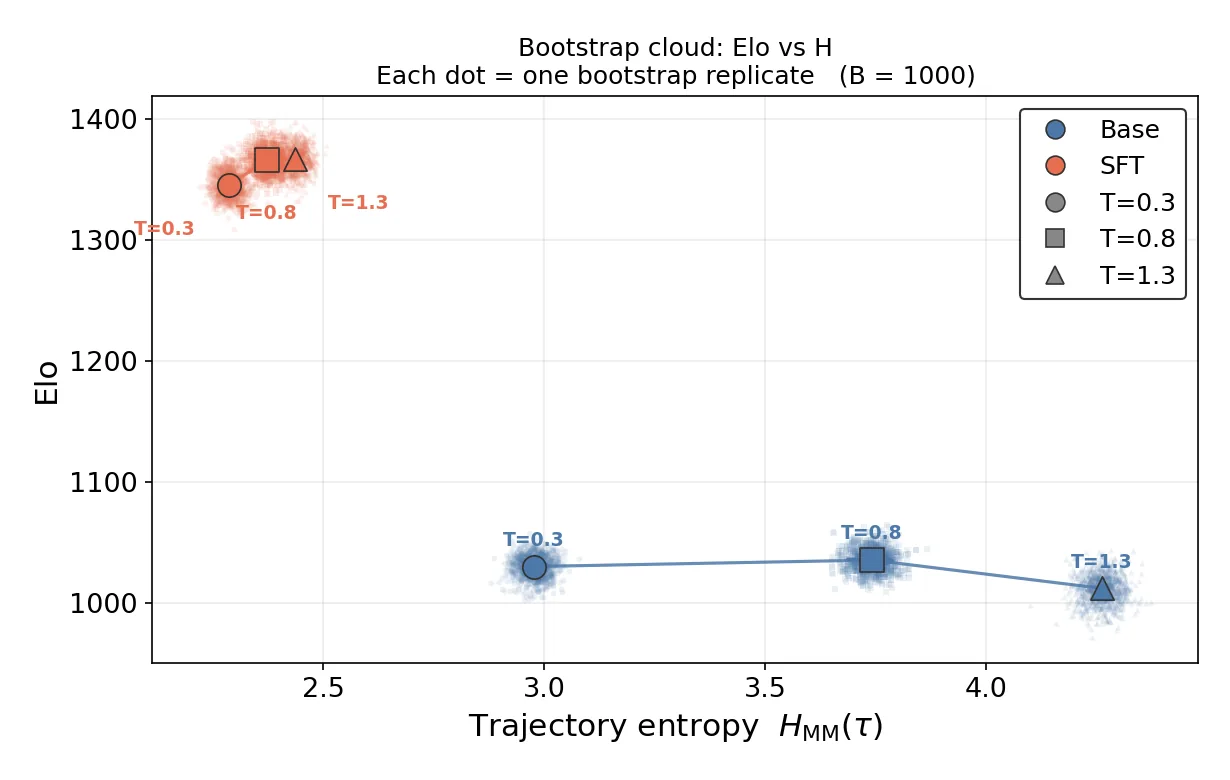
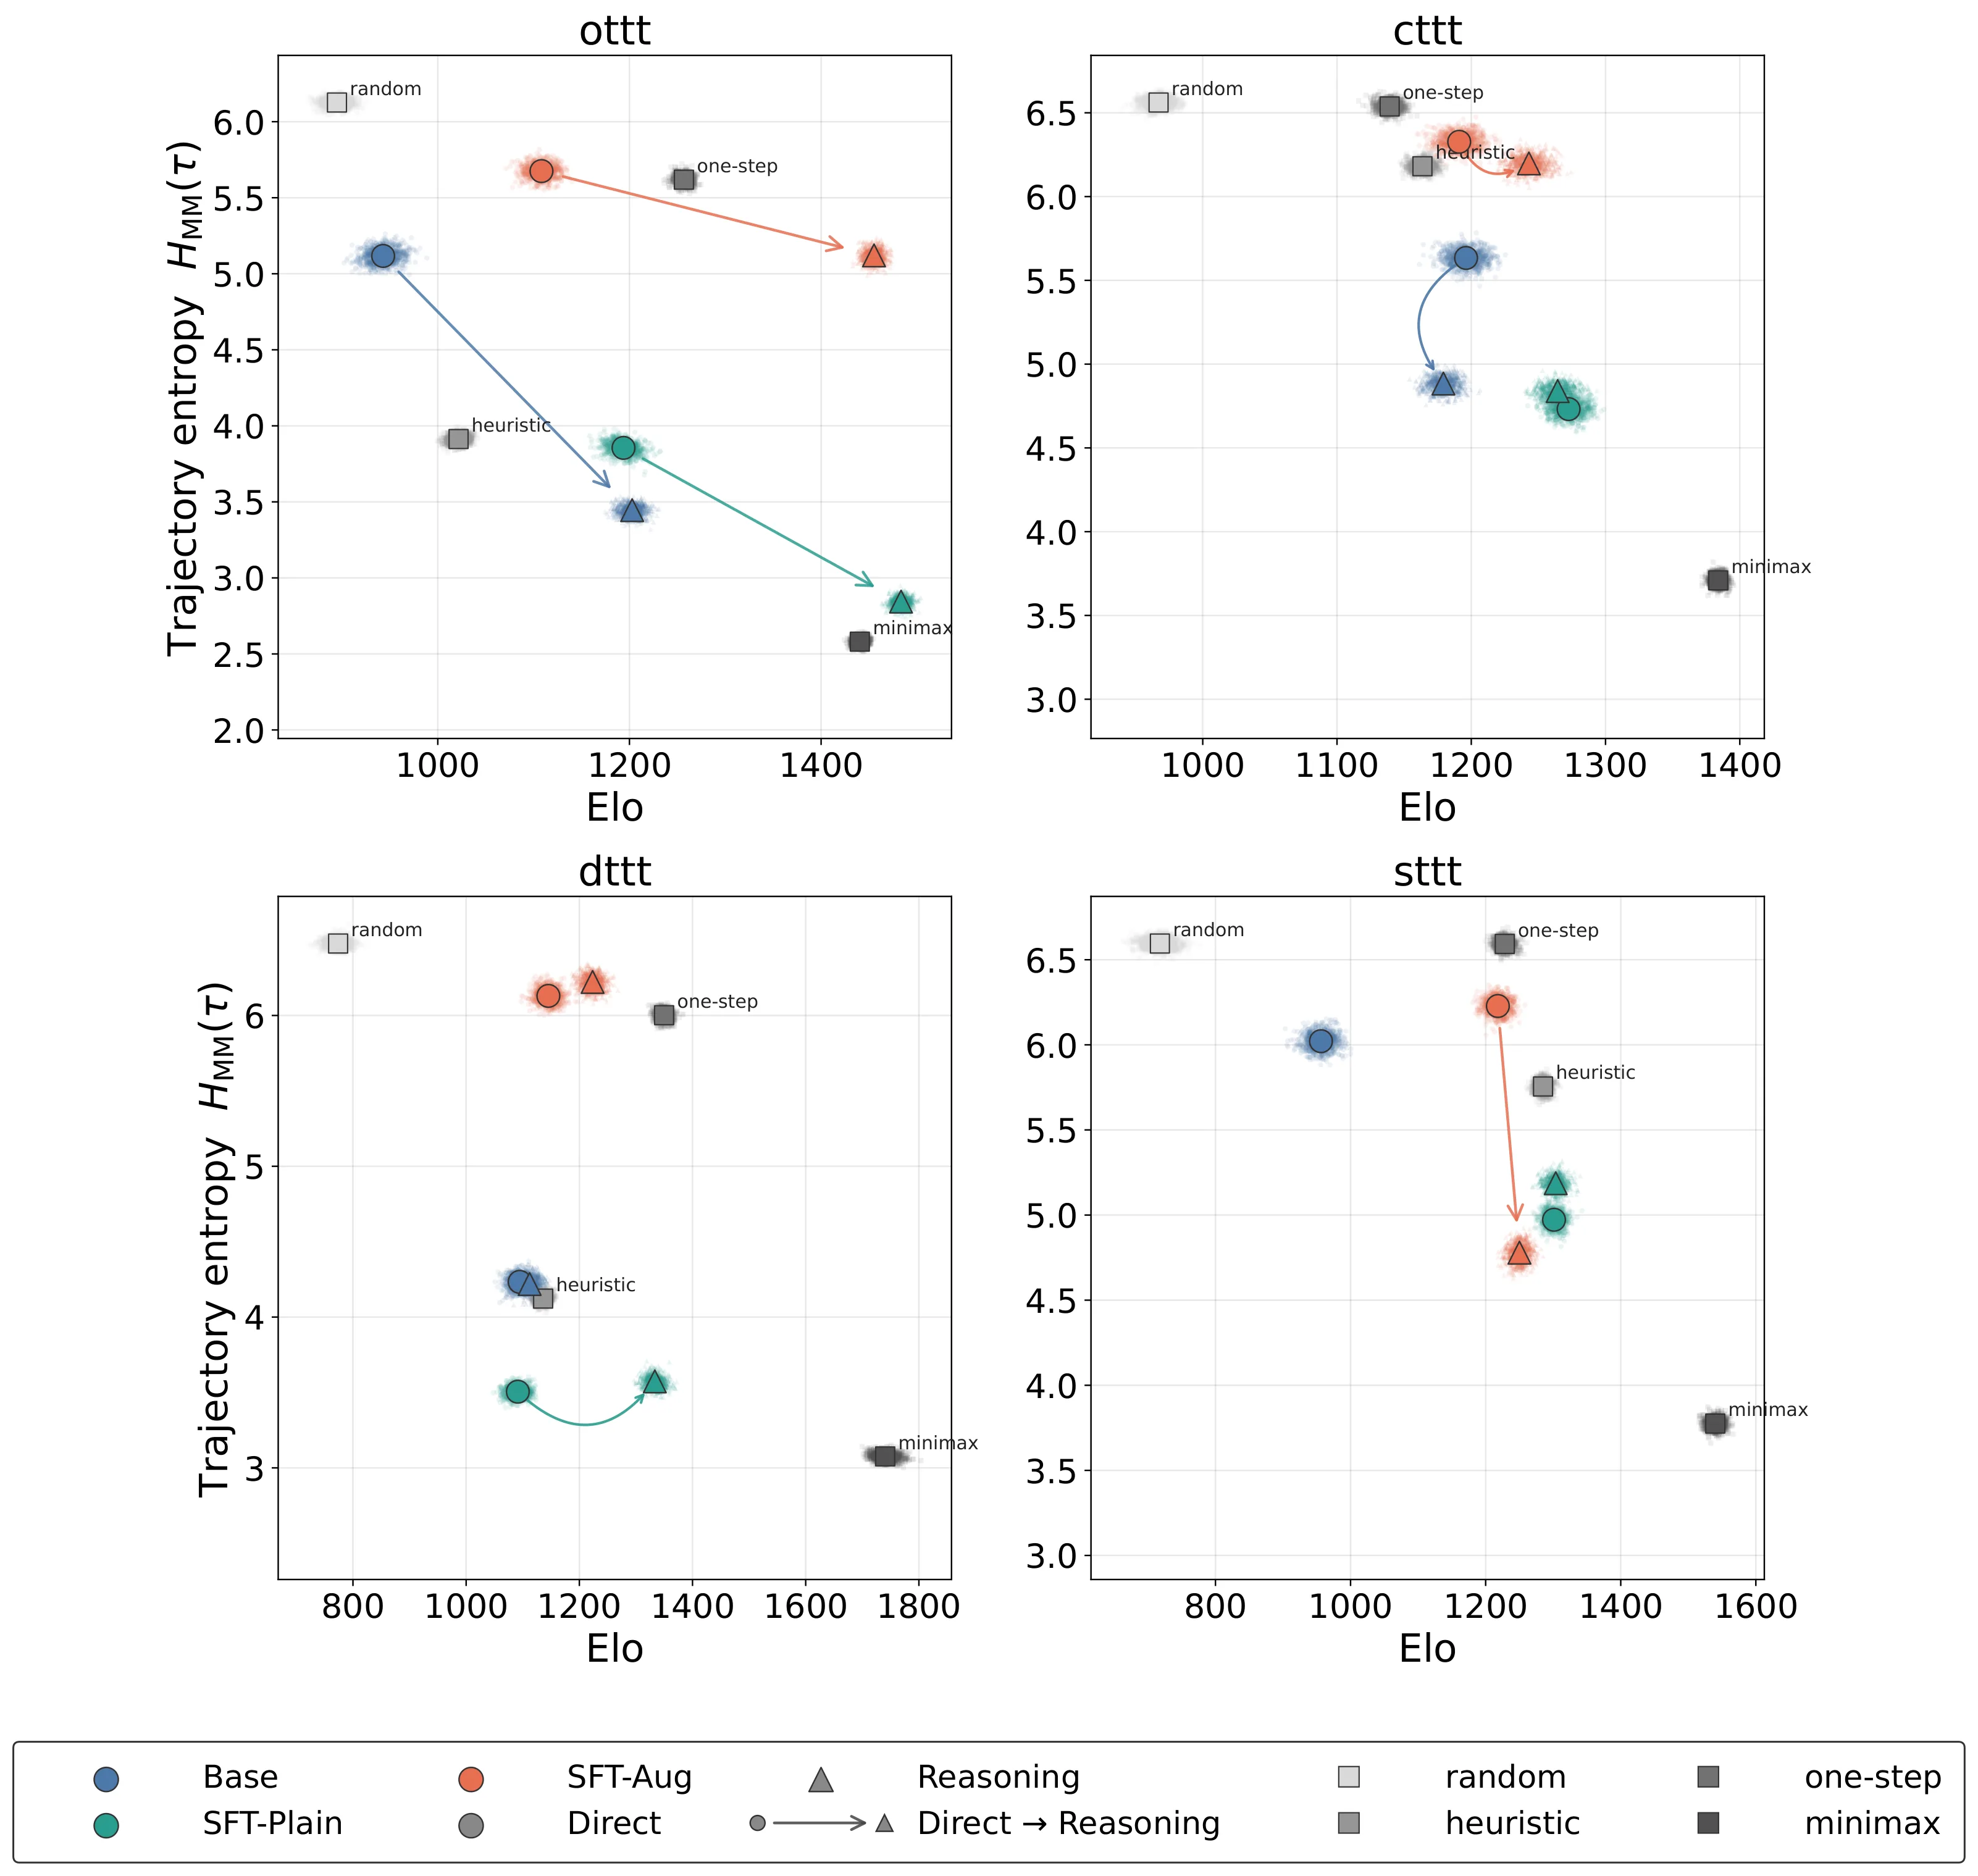
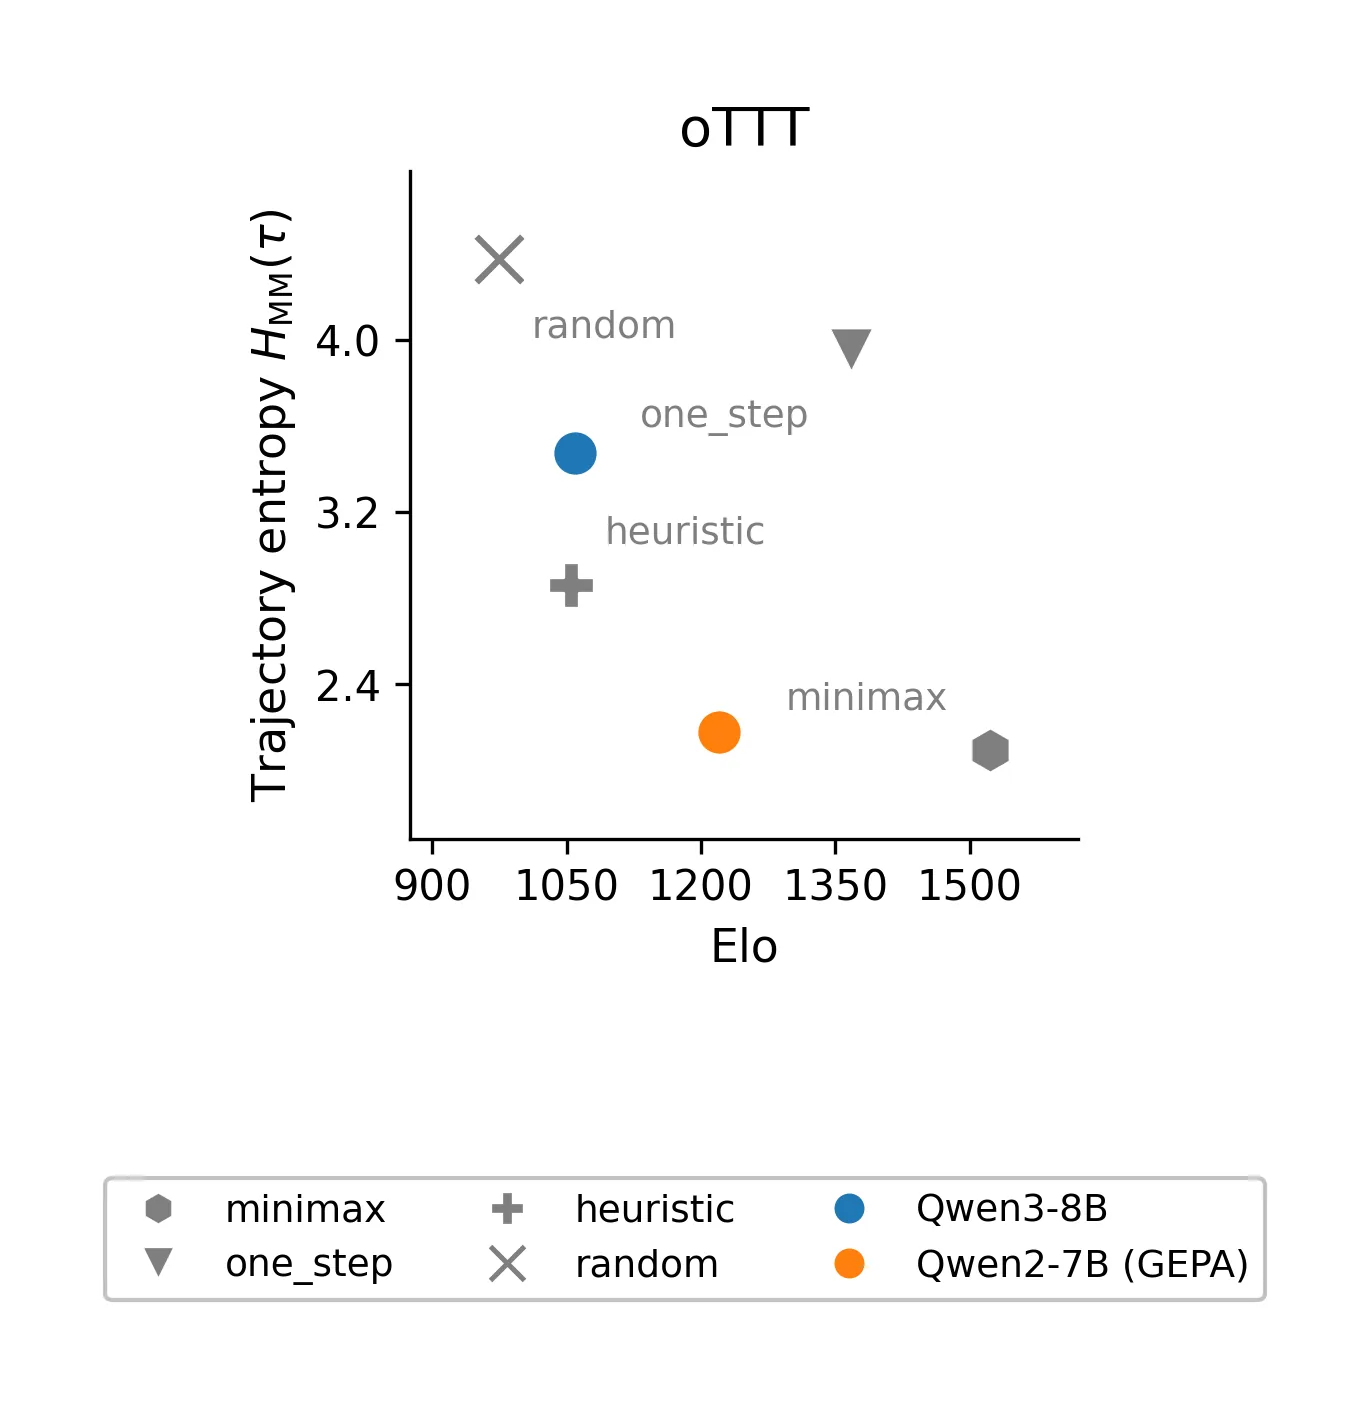
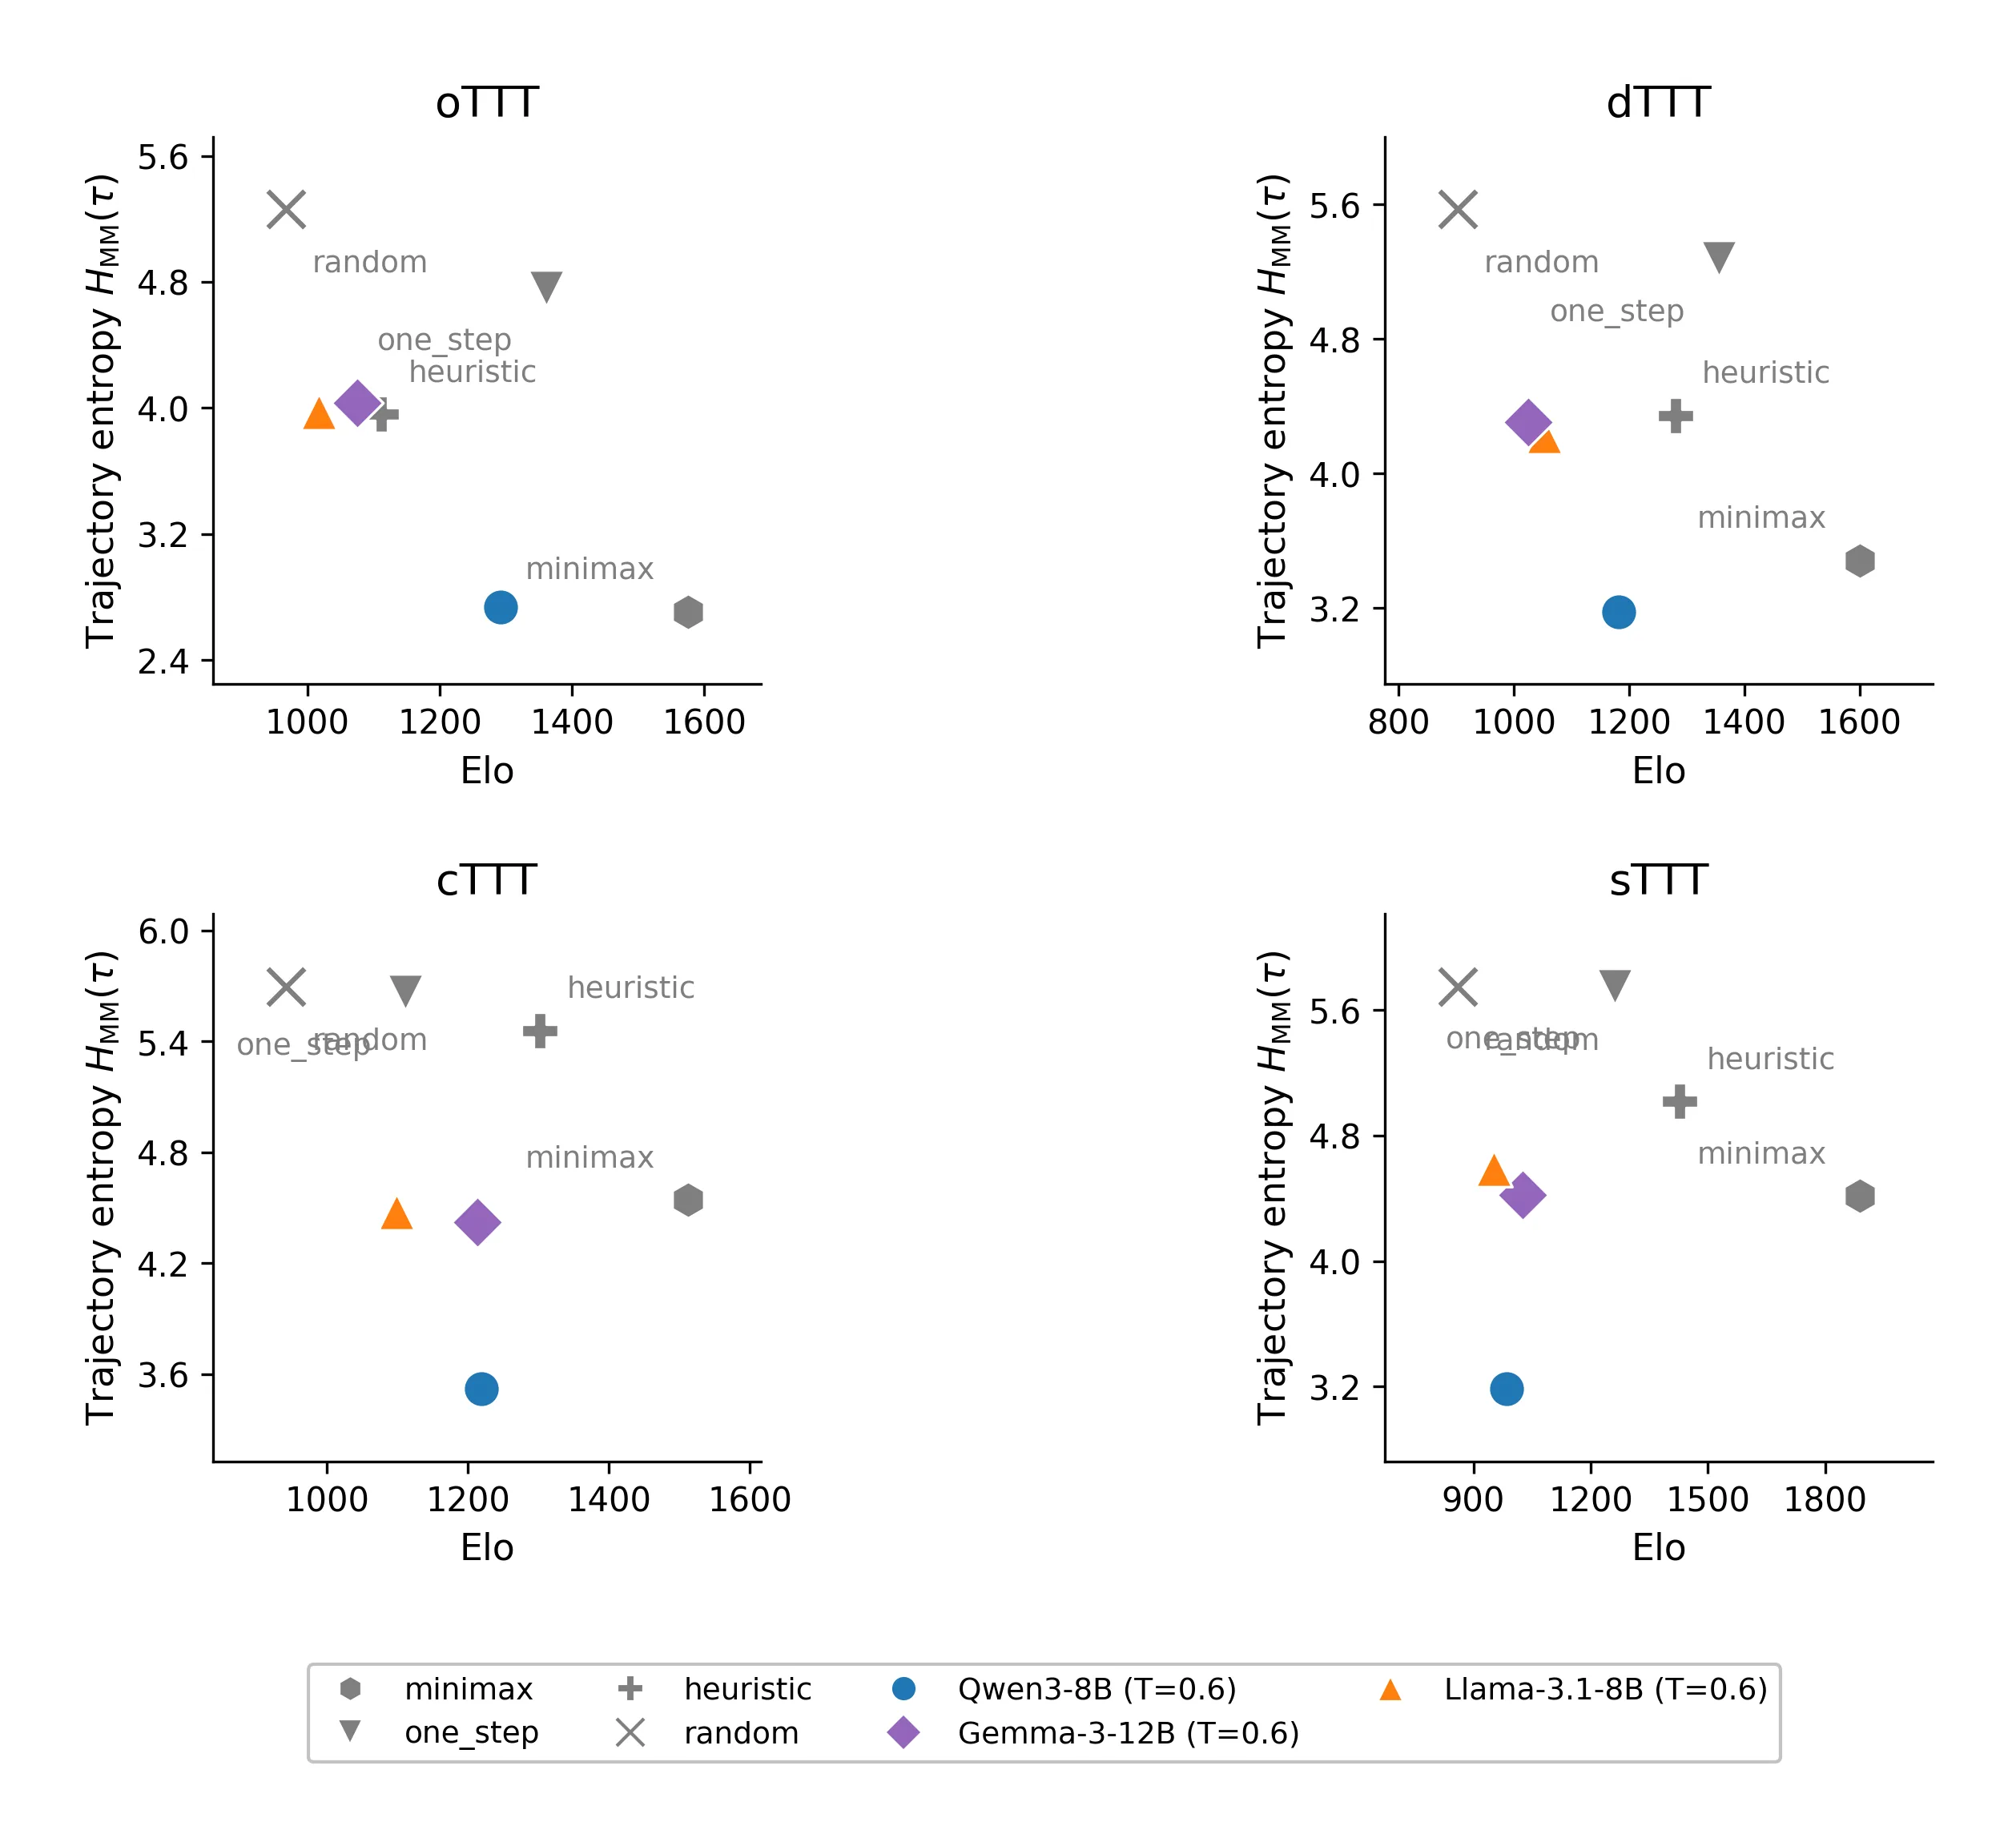
多样性度量。论文从三个层面定义和度量多样性。状态级评估关注模型对单个状态的响应分布,衡量模型在给定状态下是否只产生单一动作还是能以一定概率分布生成多个最优动作。对弈评估通过让微调后的模型与基准模型对战,考察整体策略的差异性。训练轨迹分析则追踪模型在微调过程中准确率和多样性的动态变化,寻找两者之间的权衡关系。
推理模式的作用。论文特别考察了推理模式(reasoning mode)的影响。在 LLM 生成过程中,模型可以选择直接输出动作,或者先生成推理步骤再输出动作。直觉上,推理过程可能帮助模型更谨慎地评估状态,从而产生更丰富的行为。但实验结果恰恰相反——推理模式的引入常常加剧多样性坍缩,而非缓解。这一发现挑战了"慢思考必然带来更全面考量"的朴素假设。
实验与结果
实验结果揭示了几个重要现象,每个发现都加深了我们对 SFT 本质缺陷的理解。
推理模式抑制多样性。在所有测试的游戏变体中,使用推理模式生成的模型展现出显著更低的多样性。具体而言,当模型先输出推理步骤时,其动作选择的集中程度更高——模型倾向于选择一个"看起来最优"的单一动作,而忽略其他等优选项。这一现象在中心开局后的状态上尤为明显:没有推理时模型可能在四个角落间均匀分配选择概率,但引入推理后,模型会"收敛"到某一个特定角落。
SFT 引发过度多样性坍缩。这是论文最核心的发现之一。作者证明,标准 SFT 虽然确实能提升动作准确率(模型更频繁地选择最优动作),但其导致的多样性损失超出了准确率-多样性帕累托边界所要求的最小程度。换言之,模型本可以在保持相当多样性的同时达到相近的准确率,但 SFT 过程却将模型推向极端——几乎只选择唯一一个最优动作。这种"过度坍缩"暗示 SFT 的优化目标可能存在偏差,它过于强调模仿某一个示范动作,而忽视了动作分布本身的信息价值。
动作增强的部分缓解效果。针对上述问题,作者提出了一种简单而有效的干预:动作增强(action augmentation)。传统 SFT 在每个状态上只使用单一示范动作进行训练,而动作增强方法将同一状态的所有最优动作都纳入训练集。实验表明,这种做法能够显著提升模型的多样性,同时对准确率的影响相对有限。动作增强后的模型在状态级评估中展现出更均匀的动作分布,在对弈中也表现出更强的策略灵活性。
讨论与可借鉴点
论文的发现为理解[[监督微调]]在决策场景中的局限性提供了新的视角,同时引发了若干值得深思的问题。
窄支撑模仿的本质。论文将问题根源归结为"窄支撑模仿"——模型在训练时被要求精确复现单个示范动作,而非学习最优动作集合的分布特性。这种学习方式天然倾向于产生方差极小的策略,因为最小化预测误差的优化过程会不断强化对单一动作的置信度,即使其他动作同样正确。[[模仿学习]]的经典文献早就指出这一问题,但将其与 LLM 的 SFT 联系起来仍是重要的新贡献。
推理模式的双刃剑效应。推理模式在提升可解释性的同时,可能带来行为收敛的风险。当模型被要求"思考"再行动时,它更容易锁定在一个看似最优的推理路径上,从而排除其他等优选项。这提示我们在设计决策系统时,不能简单假设"想得更仔细必然做得更全面"。特别是在需要保持探索性的任务中,推理模式的使用需要更审慎的考量。
开放问题。论文的实验环境虽然可控,但毕竟是完全可观测的确定性游戏。真实世界的决策场景往往涉及部分观测、随机转换或多智能体交互,在这些情况下多样性的定义和度量会更加复杂。此外,动作增强虽然有效,但其计算成本随最优动作数量线性增长,如何在更大规模的动作空间中高效实现仍是挑战。
实践启示。对于希望在决策任务中使用 LLM 的研究者而言,这项研究提供了几点可操作的建议。首先,在设计[[行为多样性]]的评估协议时,应超越单一的正确率指标,关注动作分布的熵或方差。其次,如果任务对探索性有要求,考虑在 SFT 阶段引入动作增强或类似的[[正则化]]技术。最后,对于需要推理模式的场景,应注意其对行为多样性的潜在抑制作用,可能需要在推理深度和行动多样性之间寻找平衡。
摘要
监督微调(SFT)被广泛用于将大语言模型适配到下游任务,但其对序贯决策中行为多样性的影响仍鲜有研究。我们在基于井字棋变体构建的一组可控的确定性棋盘游戏中考察了该问题,其中最优动作可精确计算,多样性也可直接度量。综合状态级评估、擂台对弈与训练轨迹的分析,我们发现推理模式的生成常常抑制动作多样性,且并未一致地提升动作准确率。此外,标准 SFT 虽然能提升准确率,却往往过早引发多样性坍缩,其程度超出了准确率–多样性权衡所要求的最小限度。我们进一步表明,对每个状态训练所有最优动作而非单一示范动作的动作增强方法可部分缓解这一现象。我们的研究结果指出,窄支撑的模仿是 LLM 决策中策略坍缩的一个来源,并表明在 SFT 过程中保留动作支撑对于维持探索性行为至关重要。
Abstract
Supervised fine-tuning (SFT) is widely used to adapt large language models to downstream tasks, but its effect on behavioral diversity in sequential decision-making remains under-explored. We study this question in a controlled suite of deterministic board games based on tic-tac-toe variants, where optimal actions are exactly computable and diversity can be measured directly. Across state-level evaluation, arena gameplay, and training trajectories, we find that reasoning-mode generation frequently suppresses action diversity without uniformly improving action accuracy. Furthermore, standard SFT improves accuracy but often induces premature diversity collapse, which exceeds what is minimally required by the accuracy-diversity tradeoff. We then show that action augmentation, which trains on all optimal actions per state rather than a single demonstrated action, would partially mitigates this effect. Our results identify narrow-support imitation as a source of policy collapse in LLM decision-making and suggest that preserving action support during SFT is important for maintaining exploratory behavior.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。