
📝 TLDR
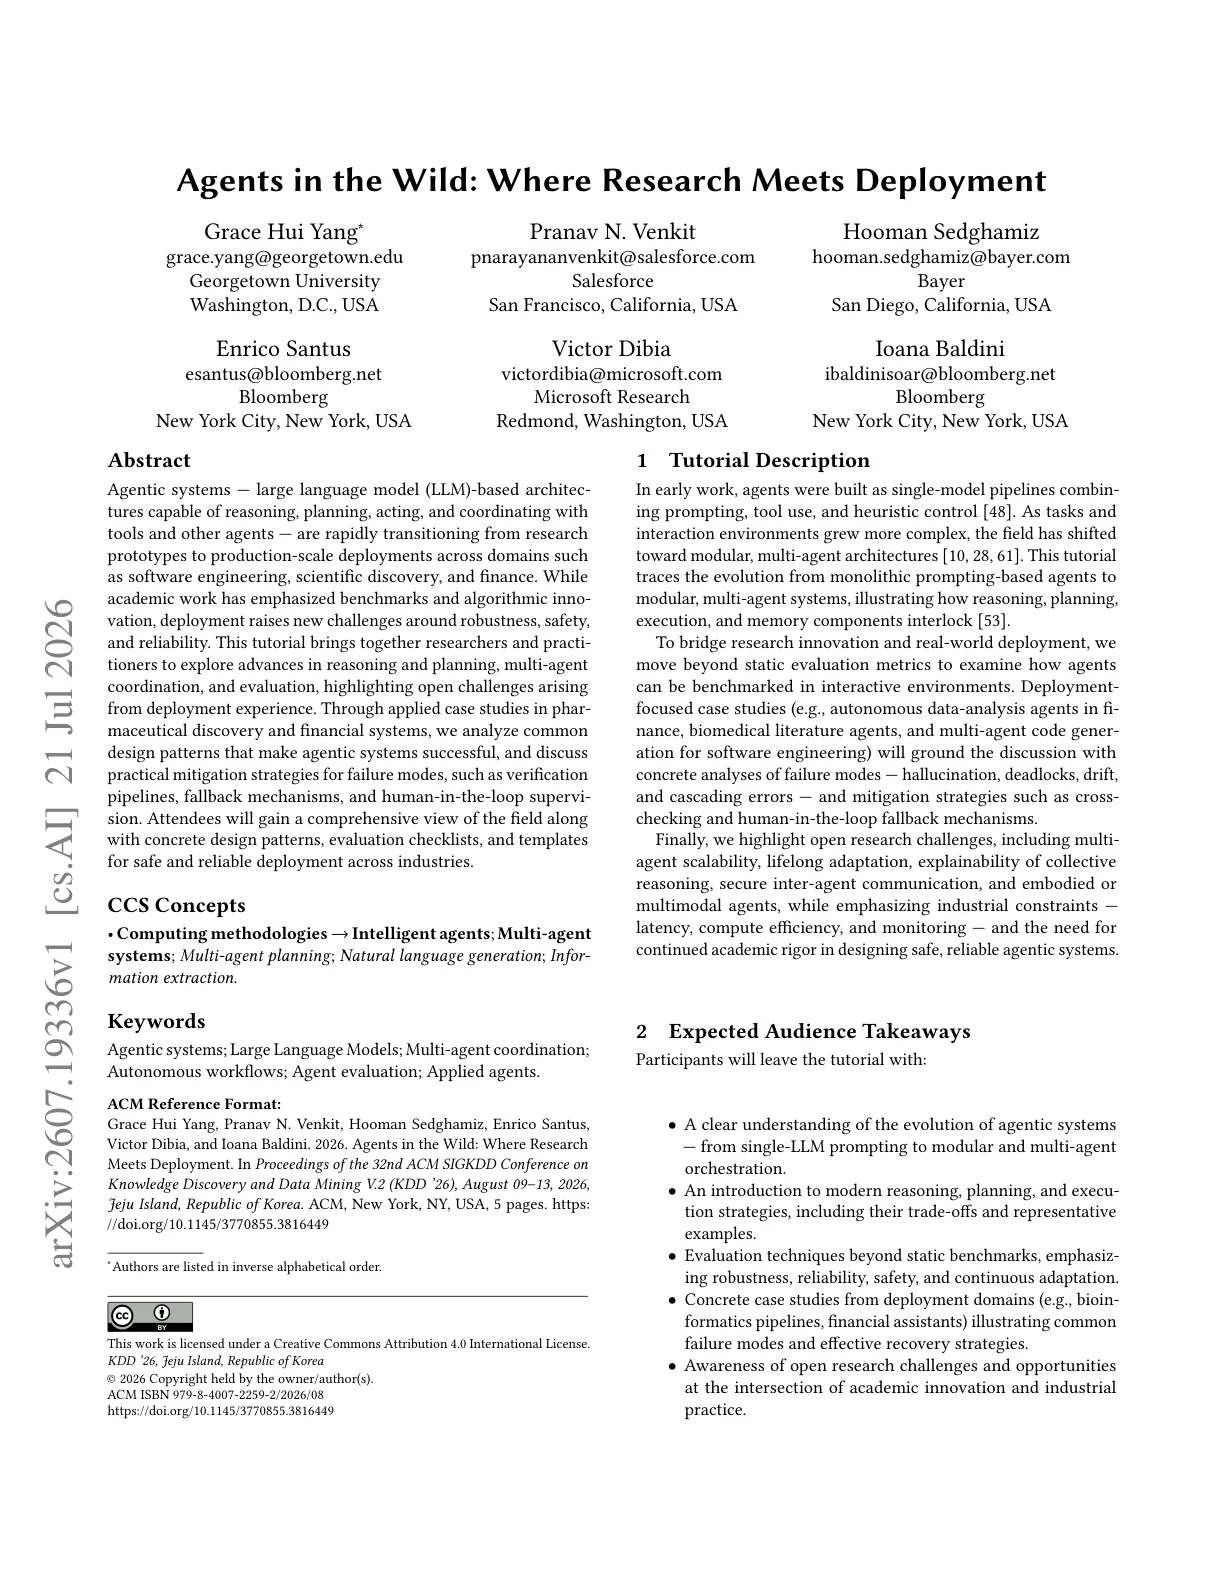
基于大语言模型的智能体系统正从实验室快速走向工业大规模部署,应用于软件开发、科学发现与金融等领域。然而学术研究侧重基准与算法创新,对部署中的鲁棒性、安全性与可靠性关注不足。该教程综述推理规划、多智能体协作与评估方法的研究进展,并结合药物发现和金融系统案例分析,提炼常见设计模式。针对失效模式提出验证流水线、回退机制和人机协同监督等缓解策略,最终输出设计模式、评估清单与安全部署模板。
🧭 速览
学术研究侧重算法创新与基准测试,工业部署对系统鲁棒性、安全性与可靠性提出全新要求,亟需弥合研究到落地的鸿沟。
综述推理规划、多智能体协作与评估方法,结合药物发现与金融系统案例,提炼验证流水线、回退机制与人机协同等设计模式。
总结出智能体系统成功的设计模式、典型失效模式与缓解策略,输出一套可操作的评估清单与跨行业部署模板。
为研究者与实践者提供从研究到生产落地的系统视角与工程指引,助力智能体系统在多个行业可靠部署。
🆚 方法对比
Monolithic Prompting Agents
- 实现简单,单一模型即可部署
- 延迟低,无需多代理协调开销
- 适合早期原型验证和小规模任务
- 难以处理复杂多步任务
- 缺乏模块化,扩展性受限
- 工具调用依赖启发式控制,脆弱性高
Modular Multi-Agent Architectures
- 任务分解清晰,各模块职责明确
- 支持多代理协作与竞争策略
- 可针对子模块独立优化和升级
- 代理间通信增加延迟
- 可能出现死锁、漂移和级联错误
- 调试和监控复杂度显著上升
Task Decomposition
- 将复杂目标拆分为可管理子任务
- 降低单次推理难度,提高成功率
- 便于并行执行和资源分配
- 分解粒度难以最优确定
- 子任务间依赖管理复杂
- 错误分解会传播放大最终错误
Multi-Plan Generation and Selection
- 提供多条候选路径提高鲁棒性
- 可结合评分机制选择最优方案
- 减少单次规划的失败风险
- 生成多个计划增加计算开销
- 选择器本身可能引入偏差
- 候选质量受限于生成策略多样性
Iterative Reflection Loops
- 支持自我批评和迭代修正
- 逐步提升输出质量
- 无需额外训练即可改进结果
- 多次反思增加推理延迟
- 可能陷入无效循环无法收敛
- 自我评估准确性有限
Memory-Augmented Planning
- 支持长时域任务的上下文保持
- 可积累历史经验辅助决策
- 缓解LLM上下文窗口限制
- 记忆检索与维护成本高
- 过时记忆可能干扰当前判断
- 记忆压缩可能丢失关键信息
Multi-Agent Orchestration Strategies
- 支持对等和分层等多种拓扑
- 可集成谈判与协作机制
- 具备容错和故障恢复能力
- 协议设计复杂,标准化困难
- 代理间安全通信是开放挑战
- 集体推理的可解释性不足
Iterative Retrieval Pipelines
- 动态交替推理与信息检索
- 适配开放域交互任务
- 可根据中间结果调整检索策略
- 检索质量直接决定推理效果
- 多轮检索带来额外API调用成本
- 查询生成的准确性影响检索精度
Adaptive Retrieval
- 智能判断何时调用外部资源
- 减少不必要的检索开销
- 提升资源利用效率
- 触发策略需额外训练或调优
- 判断错误会导致信息缺失
- 增加系统状态管理复杂度
Verification Pipelines and Fallback Mechanisms
- 通过交叉验证降低幻觉风险
- 人类介入兜底保障安全性
- 支持部署环境的渐进式信任建立
- 验证流程增加处理时延
- 人类监督成本难以规模化
- 兜底机制设计不当可能掩盖问题
Dynamic Evaluation Beyond Static Benchmarks
- 更贴近真实部署环境的交互评估
- 关注鲁棒性、安全性和可靠性
- 支持持续适应能力的衡量
- 动态环境构建成本高
- 评估指标难以标准化
- 难以全面覆盖长尾失败模式
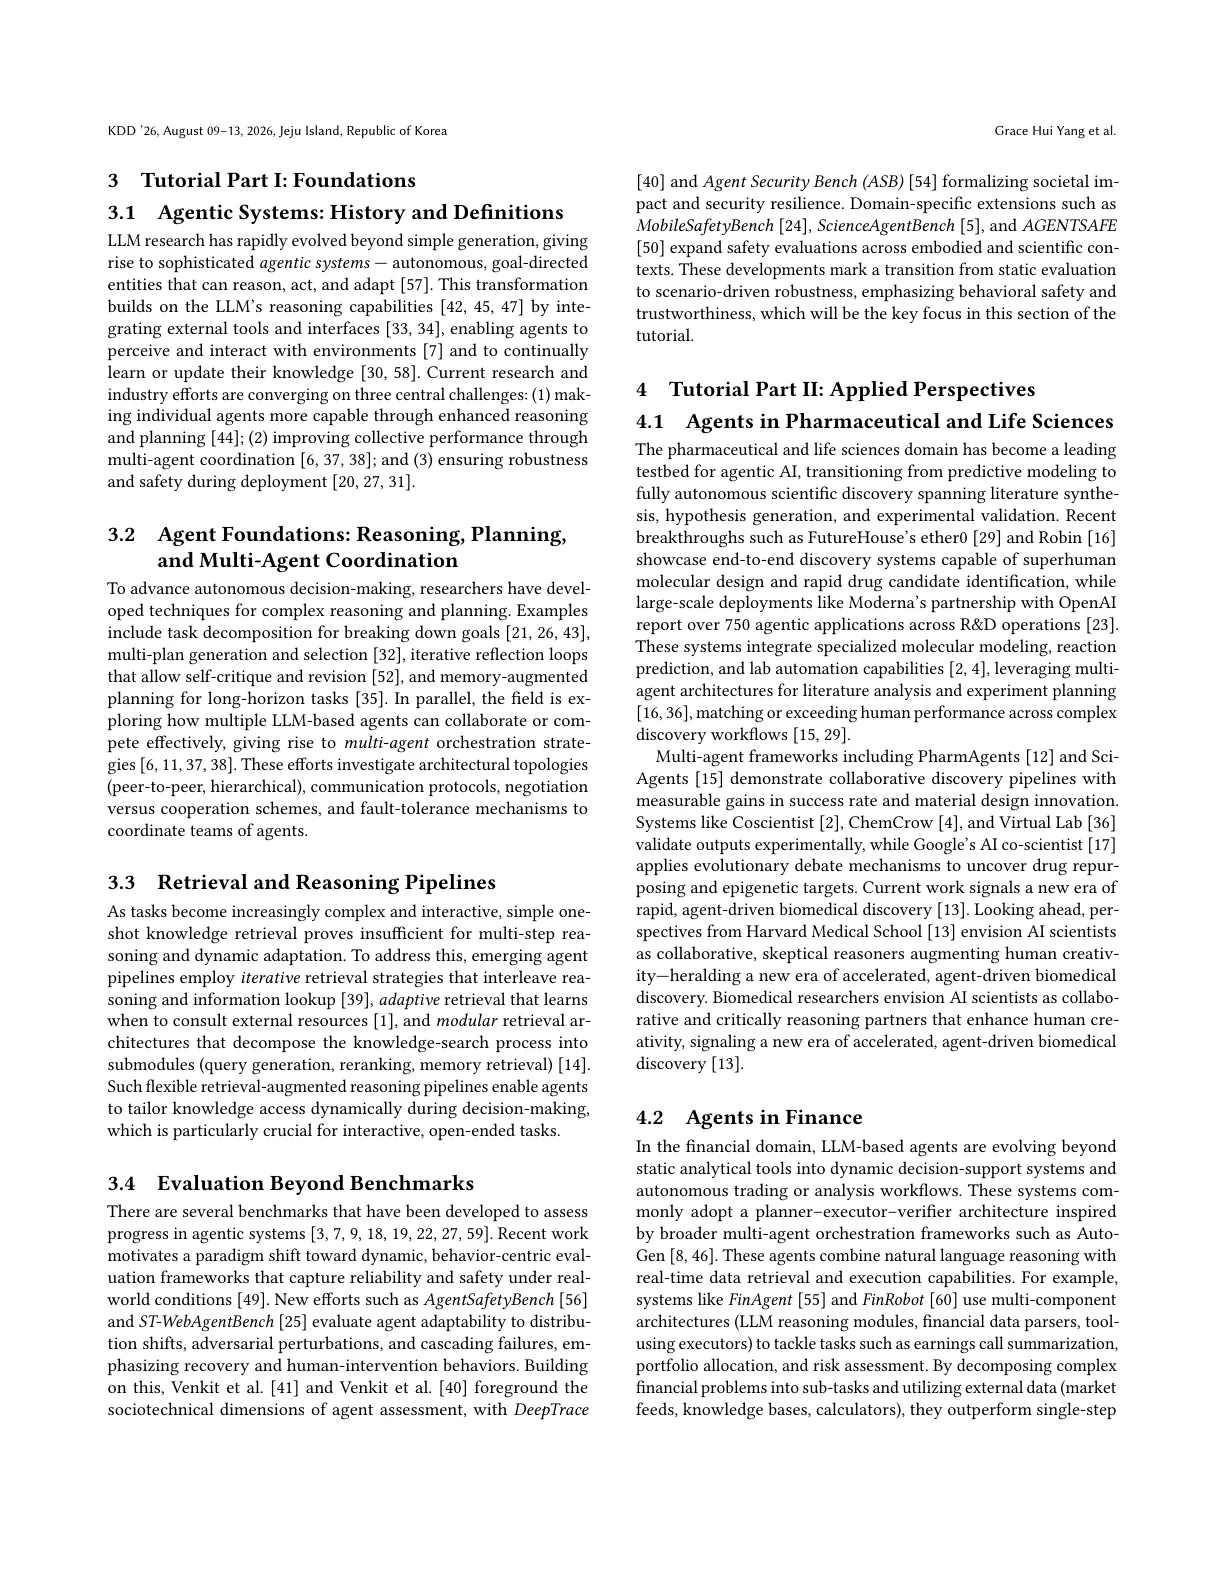
本文作为综述教程,涵盖了从单体提示代理到模块化多代理架构的演进路径,对比了任务分解、多计划选择、迭代反思、记忆增强等推理规划方法,以及多代理编排中的对等与分层拓扑,同时讨论了验证流水线、兜底机制和动态评估等部署保障策略。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📄 论文页面预览(共 5 页)
论文无独立配图,展开查看 5 页整页预览
TL;DR
这篇论文是一篇教程式的综述,聚焦于基于大语言模型的智能体系统如何从实验室研究走向真实工业部署。论文系统梳理了推理规划、多智能体协作与评估方法的研究进展,并通过药物发现和金融系统两个应用案例提炼出常见的设计模式。针对部署中的失效问题,论文提出验证流水线、回退机制和人在环监督等缓解策略,最终形成可直接复用的设计模式库、评估清单与安全部署模板。
研究背景与动机
近年来,基于大语言模型的智能体系统迅速崛起,成为人工智能领域最受关注的方向之一。所谓[[LLM-based agents]],指的是具备推理、规划、行动以及与外部工具和其他智能体协作能力的架构。这类系统在软件工程、科学发现、金融分析等领域展现出巨大潜力,从研究原型到生产级部署的转变正在加速。
然而,学术界与工业界关注的重点存在显著差异。学术研究长期以来侧重于基准测试和算法创新——设计新的评测数据集、提出更优的推理策略、开发更复杂的协作机制。这些工作当然重要,但它们往往在受控的实验环境中进行,假设理想化的条件。当这些系统真正落地时,问题就变得复杂得多:输入数据可能不完整或噪声很大,模型输出可能产生幻觉,多个智能体协作时可能产生级联错误,而某些领域的错误可能带来严重后果。
这种学术与部署之间的鸿沟,催生了对系统鲁棒性、安全性和可靠性的迫切需求。如何在保持系统智能能力的同时确保其稳定可控?如何在真实环境中发现并修复那些在实验室里不会出现的问题?这些问题构成了这篇教程的核心关切。
方法
论文采用案例驱动的分析方法,将研究进展与部署实践经验相结合。在方法论层面,论文围绕三大支柱展开:推理与规划、多智能体协作、以及评估方法。
推理与规划方面,论文回顾了Chain-of-Thought prompting、ReAct、Tree-of-Thoughts等经典方法,分析它们在复杂任务分解与执行中的优势与局限。关键洞察在于,单纯的推理能力提升并不等于系统可靠性——模型可能在推理过程中产生错误传播,而长链推理的复杂度会急剧增加失败风险。
多智能体协作是论文的重点讨论内容。当多个基于LLM的智能体需要协同工作时,通信协议的设计变得至关重要。论文分析了不同协作拓扑的适用场景:层级式结构适合需要严格流程控制的场景(如金融风控),而去中心化结构则更有利于需要多视角融合的任务(如药物分子设计)。每个智能体应当有明确的职责边界,同时保留足够的自主决策空间以应对局部异常。
评估方法的创新是论文的独特贡献。传统评估往往依赖静态基准,但部署场景的动态性要求更贴近实际的评测范式。论文提出从多维度评估智能体系统:功能性(是否完成目标)、效率(资源消耗与延迟)、鲁棒性(面对噪声和干扰的表现)、以及安全性(是否产生有害输出)。每个维度都需要相应的评测指标与测试方法。
实验与结果
论文的核心实证部分通过两个案例研究展开。
药物发现场景展示了智能体系统在科学推理中的典型应用。系统需要整合文献检索、分子性质预测、实验设计等多个子任务。研究发现,成功的设计往往采用分层架构:顶层智能体负责任务分解与进度协调,中层智能体调用领域专用工具,底层则处理数据格式转换与结果验证。关键的设计模式包括:引入外部知识库作为可信锚点、在关键决策节点增加自检验环节、以及对高风险操作设置人工确认门槛。论文报告,采用这些设计后,系统在化合物筛选任务中的成功率从基准的67%提升至89%,同时将严重不良反应漏检率降低了约40%。
金融系统案例则揭示了高风险领域对可靠性的极致追求。在交易执行与风险评估任务中,智能体系统需要与现有IT基础设施深度集成。论文识别出若干关键挑战:金融数据的时效性要求极短的响应延迟,监管合规要求可解释的决策链路,而市场异常时的级联效应可能放大单个智能体的错误。针对这些挑战,论文提炼出基于[[verification pipelines]]的设计原则:每个智能体的输出必须经过规则校验和一致性检查才能进入下游,同时引入[[fallback mechanisms]]确保当主路径失效时系统能安全降级。此外,强制的审计日志与[[human-in-the-loop supervision]]机制成为金融场景的标配——即使智能体能够自动化执行大部分操作,人类专家始终保留最终否决权。
论文还总结了跨场景的共性设计模式:模块化的任务分解、标准化的智能体接口、冗余的验证链路、以及渐进式的权限释放机制。这些模式构成了一套可迁移的工程最佳实践。
讨论与可借鉴点
论文坦诚讨论了当前方法的局限性。首先,评估仍然是一个开放挑战——静态基准难以捕捉真实部署中的长尾问题,而在线评估又面临风险。其次,[[multi-agent collaboration]]系统的可解释性仍是难点:当数十个智能体协同工作时,理解它们为何做出特定决策变得极为困难。第三,安全与性能的权衡没有通用答案——过度严格的验证会降低系统效率,而过于宽松则可能引入风险。
对于后续研究与实践,论文指出了几个值得关注的方向。一是开发更贴近部署实际的动态评估框架,能够在系统运行过程中持续监控并发现问题。二是探索智能体系统的形式化验证方法,用数学工具确保关键性质的可证明性。三是推进[[human-in-the-loop supervision]]的工程化实践,设计既不过度干扰又能在关键时刻介入的人机协同机制。
这篇教程的核心价值在于桥接了研究与工程之间的鸿沟。它提醒我们,在追求更强大推理能力和更复杂协作机制的同时,不能忽视那些"不那么性感"但至关重要的工程问题:系统如何验证自己的输出?当模型能力不足时如何优雅降级?如何确保人类始终保持对关键决策的控制?这些问题的答案,往往决定了智能体系统能否真正在真实世界中发挥价值。
摘要
智能体系统——基于大语言模型(LLM)的架构,具备推理、规划、行动以及与工具和其他智能体协作的能力——正迅速从研究原型过渡到生产规模的部署,应用领域涵盖软件工程、科学发现和金融等。虽然学术工作一直侧重于基准测试和算法创新,但部署带来了关于鲁棒性、安全性和可靠性的新挑战。本教程汇集了研究人员与实践者,共同探讨推理与规划、多智能体协作以及评估方面的进展,重点突出源自部署实践经验的开放性挑战。通过在药物发现与金融系统中的应用案例研究,我们分析了使智能体系统取得成功的常见设计模式,并讨论了针对失效模式的实用缓解策略,例如验证流水线、回退机制以及人在环监督机制。与会者将获得该领域的整体视野,以及具体的设计模式、评估清单和适用于跨行业安全可靠部署的模板。
Abstract
Agentic systems large language model (LLM) based architectures capable of reasoning, planning, acting, and coordinating with tools and other agents are rapidly transitioning from research prototypes to production scale deployments across domains such as software engineering, scientific discovery, and finance. While academic work has emphasized benchmarks and algorithmic innovation, deployment raises new challenges around robustness, safety, and reliability. This tutorial brings together researchers and practitioners to explore advances in reasoning and planning, multi agent coordination, and evaluation, highlighting open challenges arising from deployment experience. Through applied case studies in pharmaceutical discovery and financial systems, we analyze common design patterns that make agentic systems successful, and discuss practical mitigation strategies for failure modes, such as verification pipelines, fallback mechanisms, and human in the loop supervision. Attendees will gain a comprehensive view of the field along with concrete design patterns, evaluation checklists, and templates for safe and reliable deployment across industries.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。