
ABot-World-0:单台桌面 GPU 上的无限交互世界推演
ABot-World-0: Infinite Interactive World Rollout on a Single Desktop GPU
📝 TLDR
面向实时长程交互的世界模型部署困难,现有方法难以在消费级GPU上实现高帧率可控视频生成。ABot-World-0提出基于动作条件的视频世界模型,通过多源数据基础设施与WorldExplorer主动采集,结合teacher forcing、ODE蒸馏与LongForcing长程对齐策略,将双向teacher蒸馏为因果student模型。系统配备轻量VAE解码器、高效注意力与低比特DiT推理,在单张RTX 5090上以约19GiB显存实现720P视频16FPS流式输出,动作到首帧延迟1.2秒。该工作为游戏、仿真等场景的实时交互世界模拟提供了消费级部署方案。
🧭 速览
现有动作条件世界模型在长程交互中受自回归漂移与分布偏移困扰,且难以在消费级GPU实时部署。
构建多源数据流水线与世界探索采集,经teacher forcing与ODE蒸馏将双向teacher压缩为因果student,并引入LongForcing对齐长程自回归。
在RTX 5090单卡上以约19GiB显存流式输出720P视频达16FPS,动作到首帧延迟1.2秒,WorldRoamBench展示竞争力。
证明消费级GPU可承载长程交互式世界模型推理,为实时可控视频生成提供了可部署方案。
🆚 方法对比
ABot-World-0
- 支持实时长时程闭环交互,单卡RTX 5090达16 FPS 720P
- 统一键盘控制接口,兼容场景漫游与第三人称
- 多源数据基础设施覆盖AAA游戏、仿真引擎和网络视频
- 动作到首帧延迟仅1.2秒,峰值显存约19GiB
- 依赖桌面级高端GPU,部署门槛较高
- 依赖合成与互联网视频,物理真实性仍待验证
- 长时程自回归仍可能累积分布漂移
WorldExplorer
- 由训练反馈引导的智能体驱动采集,提升数据针对性
- 支持多源异构数据的自动化收集
- 可闭环反馈优化采集策略
- 依赖智能体策略质量,采集覆盖不均
- 反馈信号设计难度较高,需额外工程投入
双向到因果蒸馏框架
- 通过逐步蒸馏将双向教师压缩为因果学生
- 结合teacher forcing和ODE蒸馏提升稳定性
- 大幅降低推理成本便于实时部署
- 蒸馏过程可能损失部分细节生成能力
- 对教师模型质量高度敏感
LongForcing
- 对齐长学生自回归与扩展时程教师,缓解分布漂移
- 有效抑制自回归误差累积
- 提升长时程世界演化一致性
- 需要额外扩展时程教师,增加训练开销
- 长序列训练计算成本较高
参考角色记忆机制
- 提供持久外观线索,保障第三人称身份一致性
- 支持跨帧角色持续追踪
- 增强交互式回放的真实感
- 对参考图像质量依赖较高
- 在角色外观剧变时可能失效
流式推理栈
- 轻量VAE解码器与高效注意力降低计算开销
- 内存感知调度支持长时程生成
- 低比特DiT推理显著提升吞吐
- 低比特量化可能引入轻微画质损失
- 调优难度高,需与模型协同设计
WorldRoamBench
- 提供专门的交互式世界模型评测基准
- 支持可扩展的交互式回放评估
- 为可控制性提供量化指标
- 基准规模与覆盖范围有限
- 尚未成为社区广泛采用标准
ABot-World-0是一个融合多源数据采集(WorldExplorer)、双向到因果知识蒸馏(含LongForcing)和流式推理部署的统一框架,与现有视频世界模型相比,其核心差异在于通过LongForcing缓解长时程自回归漂移,并针对单卡桌面GPU实现了实时可交互部署。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图
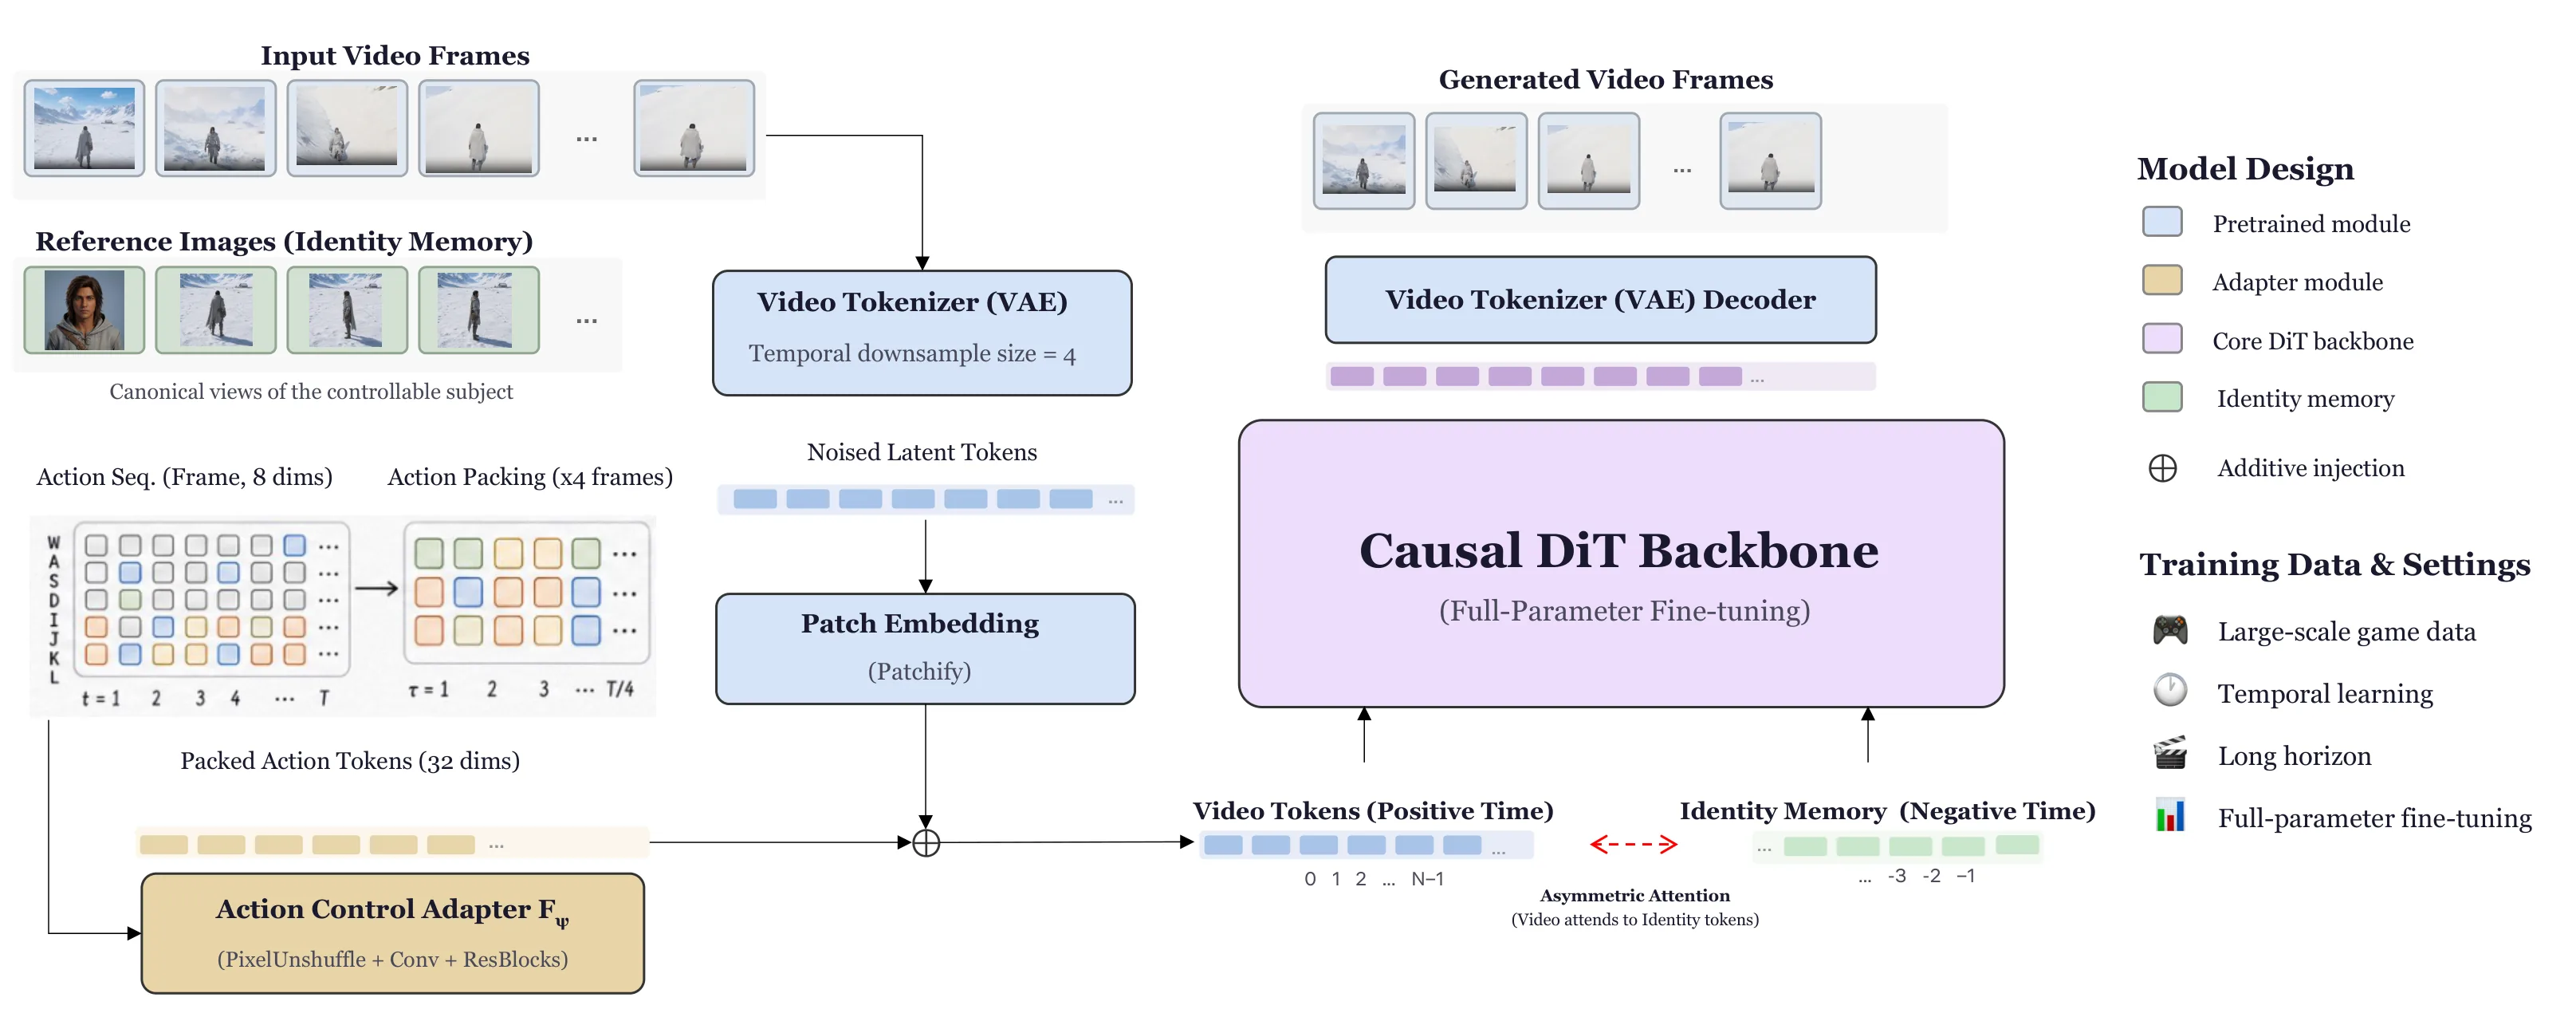
TL;DR
ABot-World-0 是一个面向实时长程交互的动作条件视频世界模型,通过多源数据采集、teacher-student 蒸馏架构与流式推理协同设计,在单张 RTX 5090 桌面 GPU 上实现了 720P 视频 16 FPS 的流式输出,动作到首帧延迟仅 1.2 秒,显存峰值约 19 GiB。这一工作证明了在消费级硬件上部署高质量交互式世界模型的可行性,为游戏、仿真等场景的实时世界模拟提供了可行的工程方案。
研究背景与动机
构建能够理解并推演物理世界的生成模型——即 [[World Model]]——一直是人工智能研究的核心目标之一。这类模型的价值在于,它们不仅能够"看懂"当前场景,还能基于交互动作预测未来的状态演化,从而为智能体提供"想象"能力,使其在虚拟环境中进行规划、试错和技能学习。
然而,将世界模型部署到实时交互场景中面临严峻挑战。理想的世界模型需要同时满足三个条件:高保真度的视觉生成、长时域的时间连贯性,以及低延迟的响应能力。现有方法往往只能兼顾其中一到两个维度。以高分辨率视频生成为例,即使是最先进的扩散模型,在消费级 GPU 上也难以实现实时帧率;而那些针对效率优化的模型,又常常在生成质量和长期一致性上做出过多妥协。
另一个关键障碍在于数据。训练世界模型需要大量动作-视频配对数据,而这类数据在公开数据集中极为稀缺。游戏和仿真引擎可以提供受控环境下的交互数据,但场景多样性和真实性有限;互联网视频虽然内容丰富,但往往缺少精确的动作标注。如何高效地构建一个覆盖多样化场景、具有一致标注的高质量训练数据集,成为制约世界模型发展的核心瓶颈。
ABot-World-0 的切入点正是同时解决这两个问题:在数据层面构建多源异构数据基础设施并开发智能采集系统,在算法层面设计高效的蒸馏与对齐策略以获得可实时推理的因果模型,在系统层面协同优化推理栈以充分利用消费级硬件的算力。
方法
ABot-World-0 的方法论可以从数据、训练、推理三个层面来理解,它们之间形成了紧密的工程闭环。
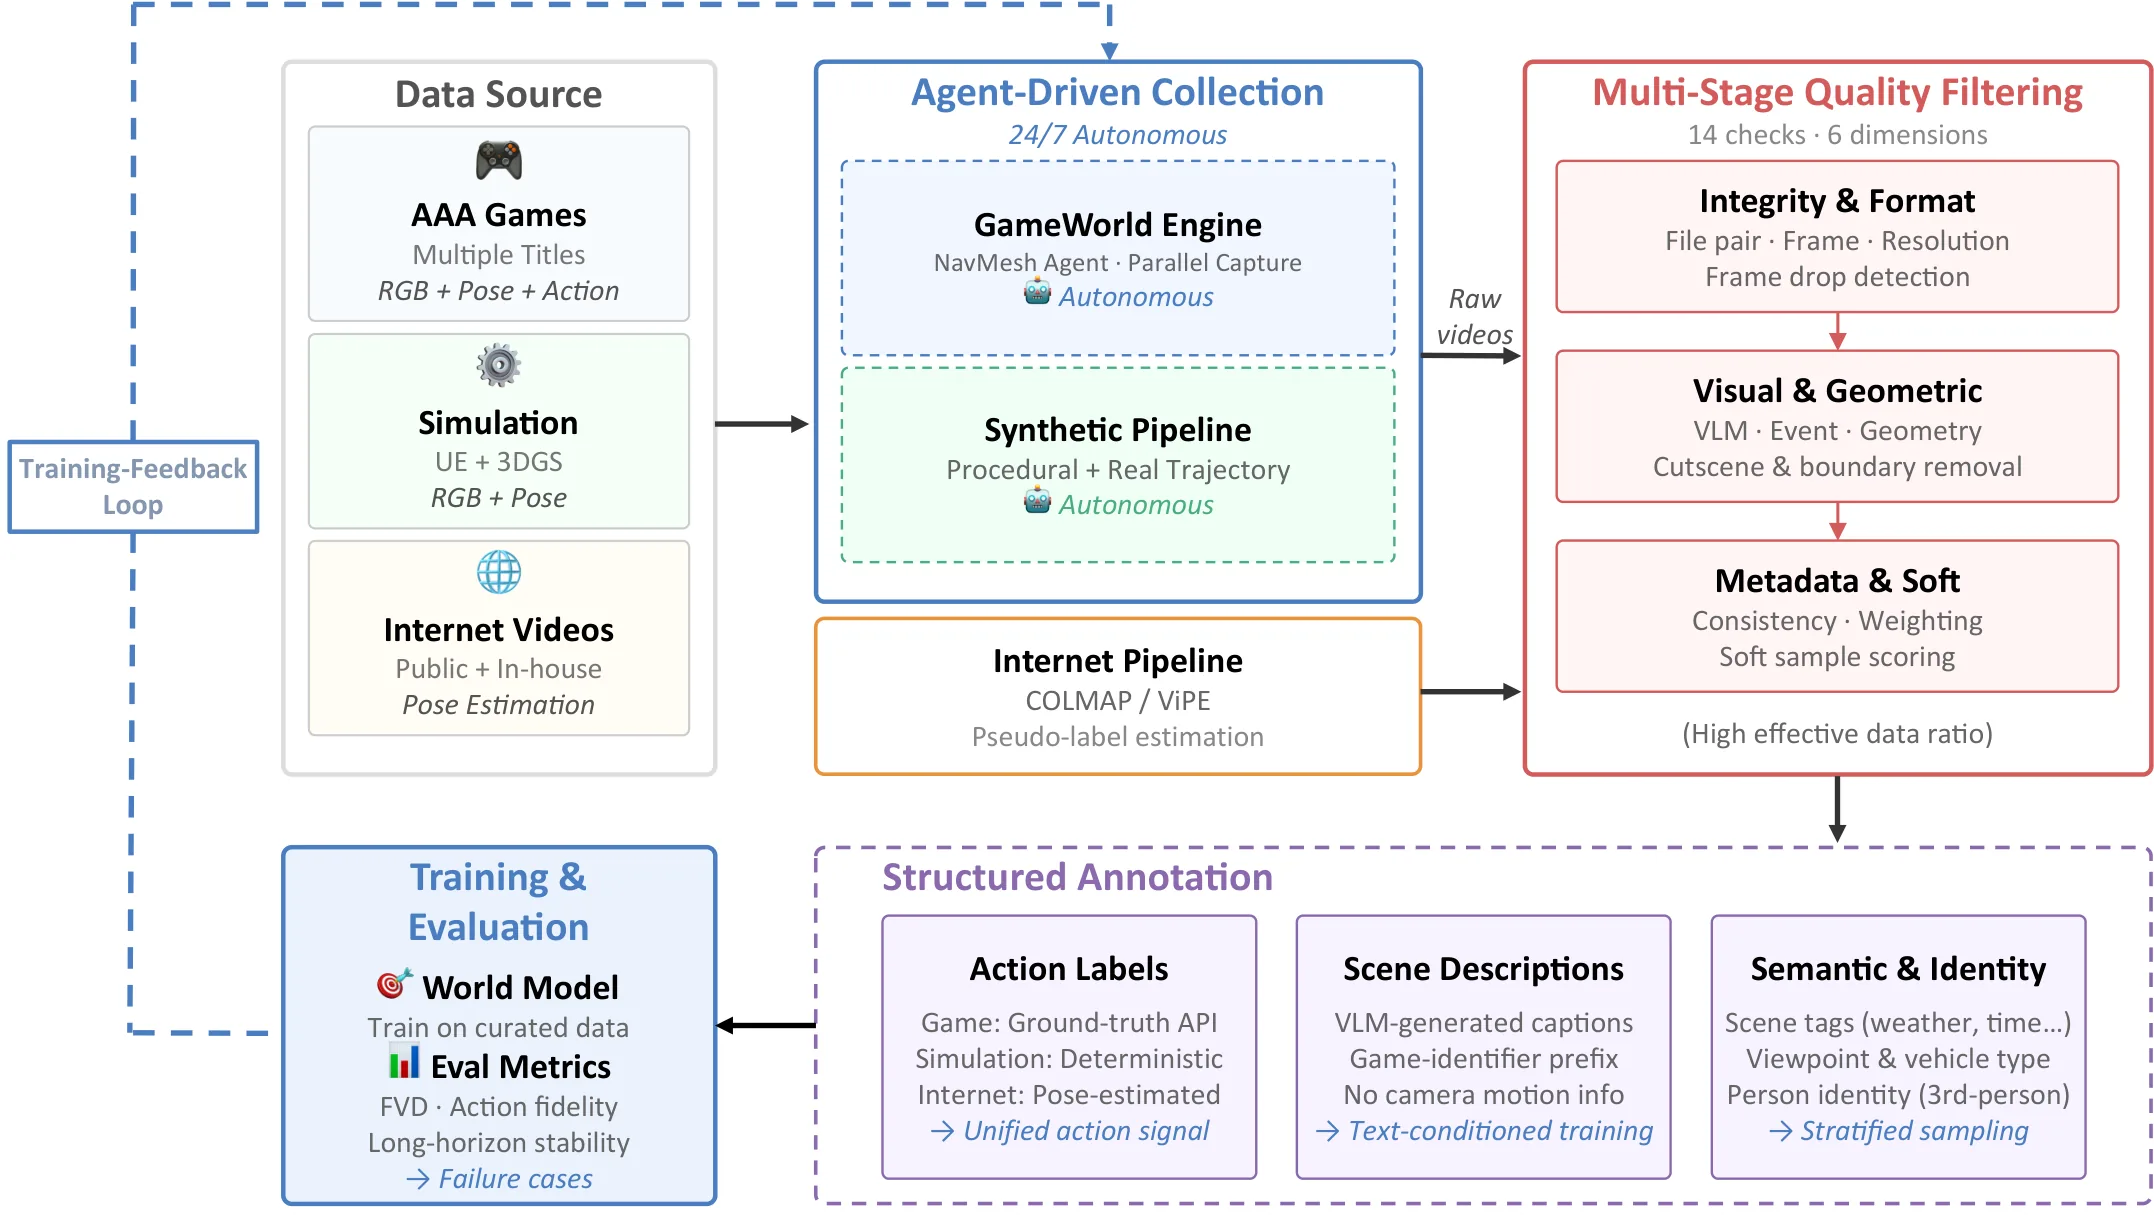
数据基础设施与主动采集。 研究团队构建了一个覆盖 3A 游戏、仿真引擎和互联网视频的多源数据管道。在数据处理上,他们设计了 14 项确定性质量检查规则(如画面稳定性检测、动作有效性过滤等),并引入视觉语言模型(VLM)进行语义层面的质量评估,确保采集的片段既有高质量的视觉内容,也有准确的动作和文本标注。这种多层级过滤机制保证了最终训练数据的可靠性。
在数据采集策略上,团队开发了 WorldExplorer 系统,它并非简单地回放预设轨迹,而是由一个训练反馈驱动的智能体引导采集过程。也就是说,模型在训练过程中的表现会被反馈到采集策略中,使系统能够主动填补那些模型预测困难或错误率高的场景,形成数据采集与模型训练的协同进化。
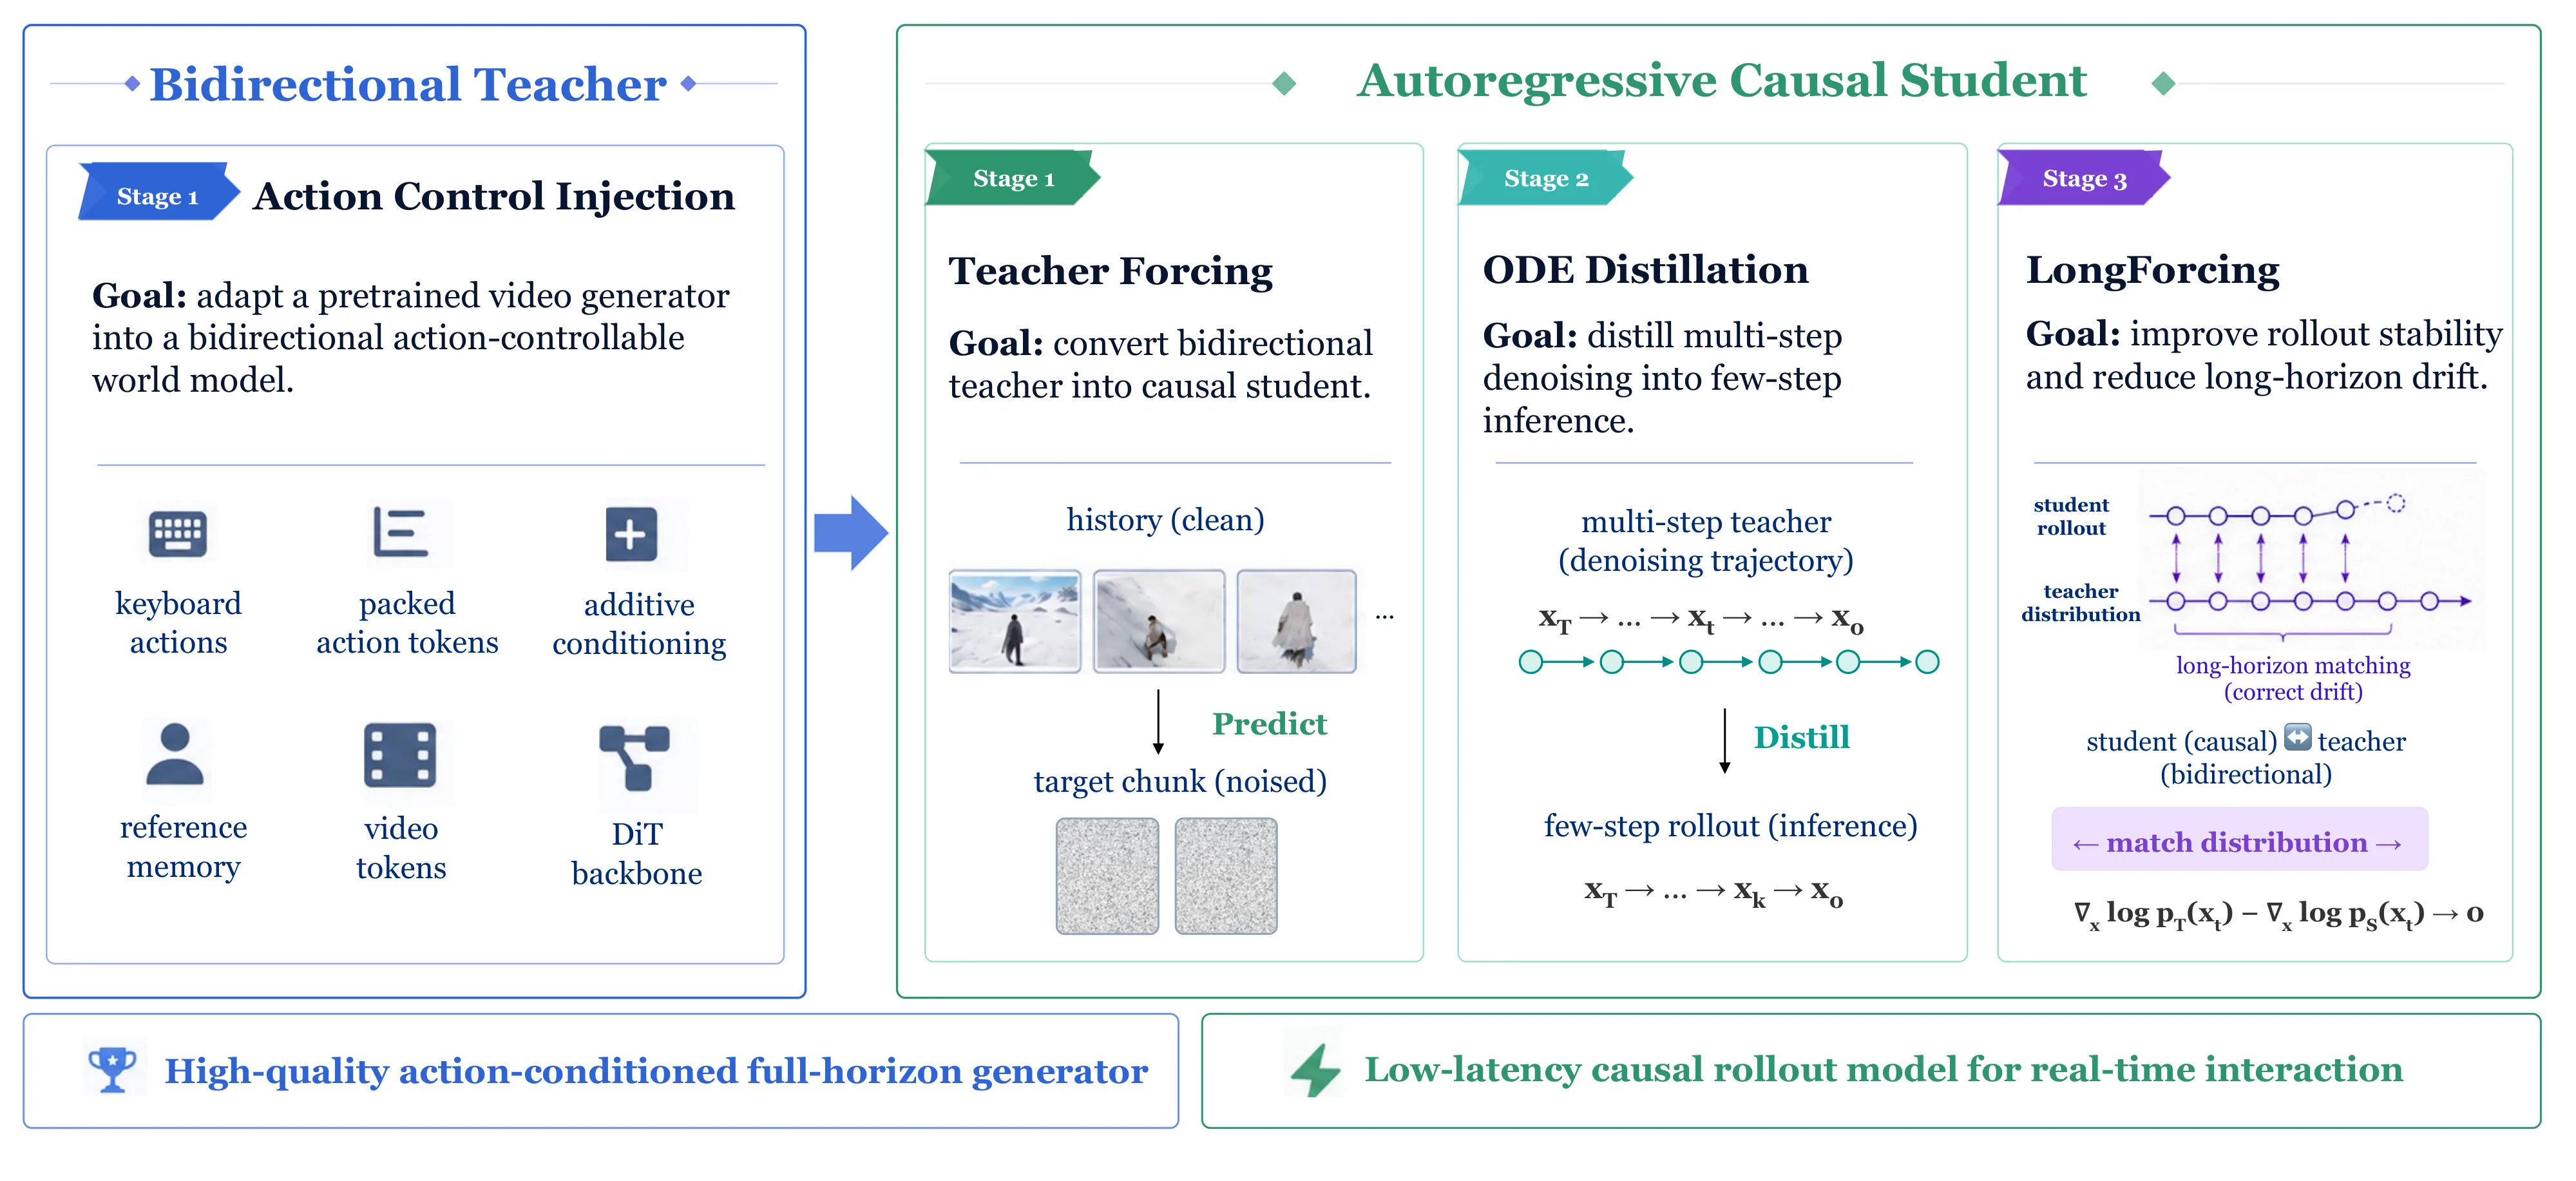
从双向教师到因果学生的蒸馏。 世界模型的核心推理需要因果结构——给定当前状态和动作,预测下一帧——但训练过程中利用双向上下文(如重建未来的条件)可以显著提升模型的质量和一致性。ABot-World-0 采用了两阶段蒸馏来弥合这一差距。
第一阶段是 teacher forcing 蒸馏。教师模型在训练时可以访问双向上下文,因此在每个时间步都能做出高质量预测。学生模型则被迫仅基于当前隐藏状态和动作进行自回归预测,通过让教师"强制喂给"学生每个时间步的真实输出,使学生逐渐学会从有限的因果信息中推断全局一致的状态。
第二阶段引入常微分方程(ODE)蒸馏。直觉上,模型的状态演化可以看作一个连续的动态系统,ODE 提供了描述这种连续演化的数学框架。通过将教师模型的预测轨迹建模为 ODE 的解,团队设计了一个蒸馏损失,使学生的离散自推演轨迹与教师在连续时间上的轨迹对齐。这一步骤进一步平滑了学生模型的行为,减少了因离散采样导致的不连贯性。
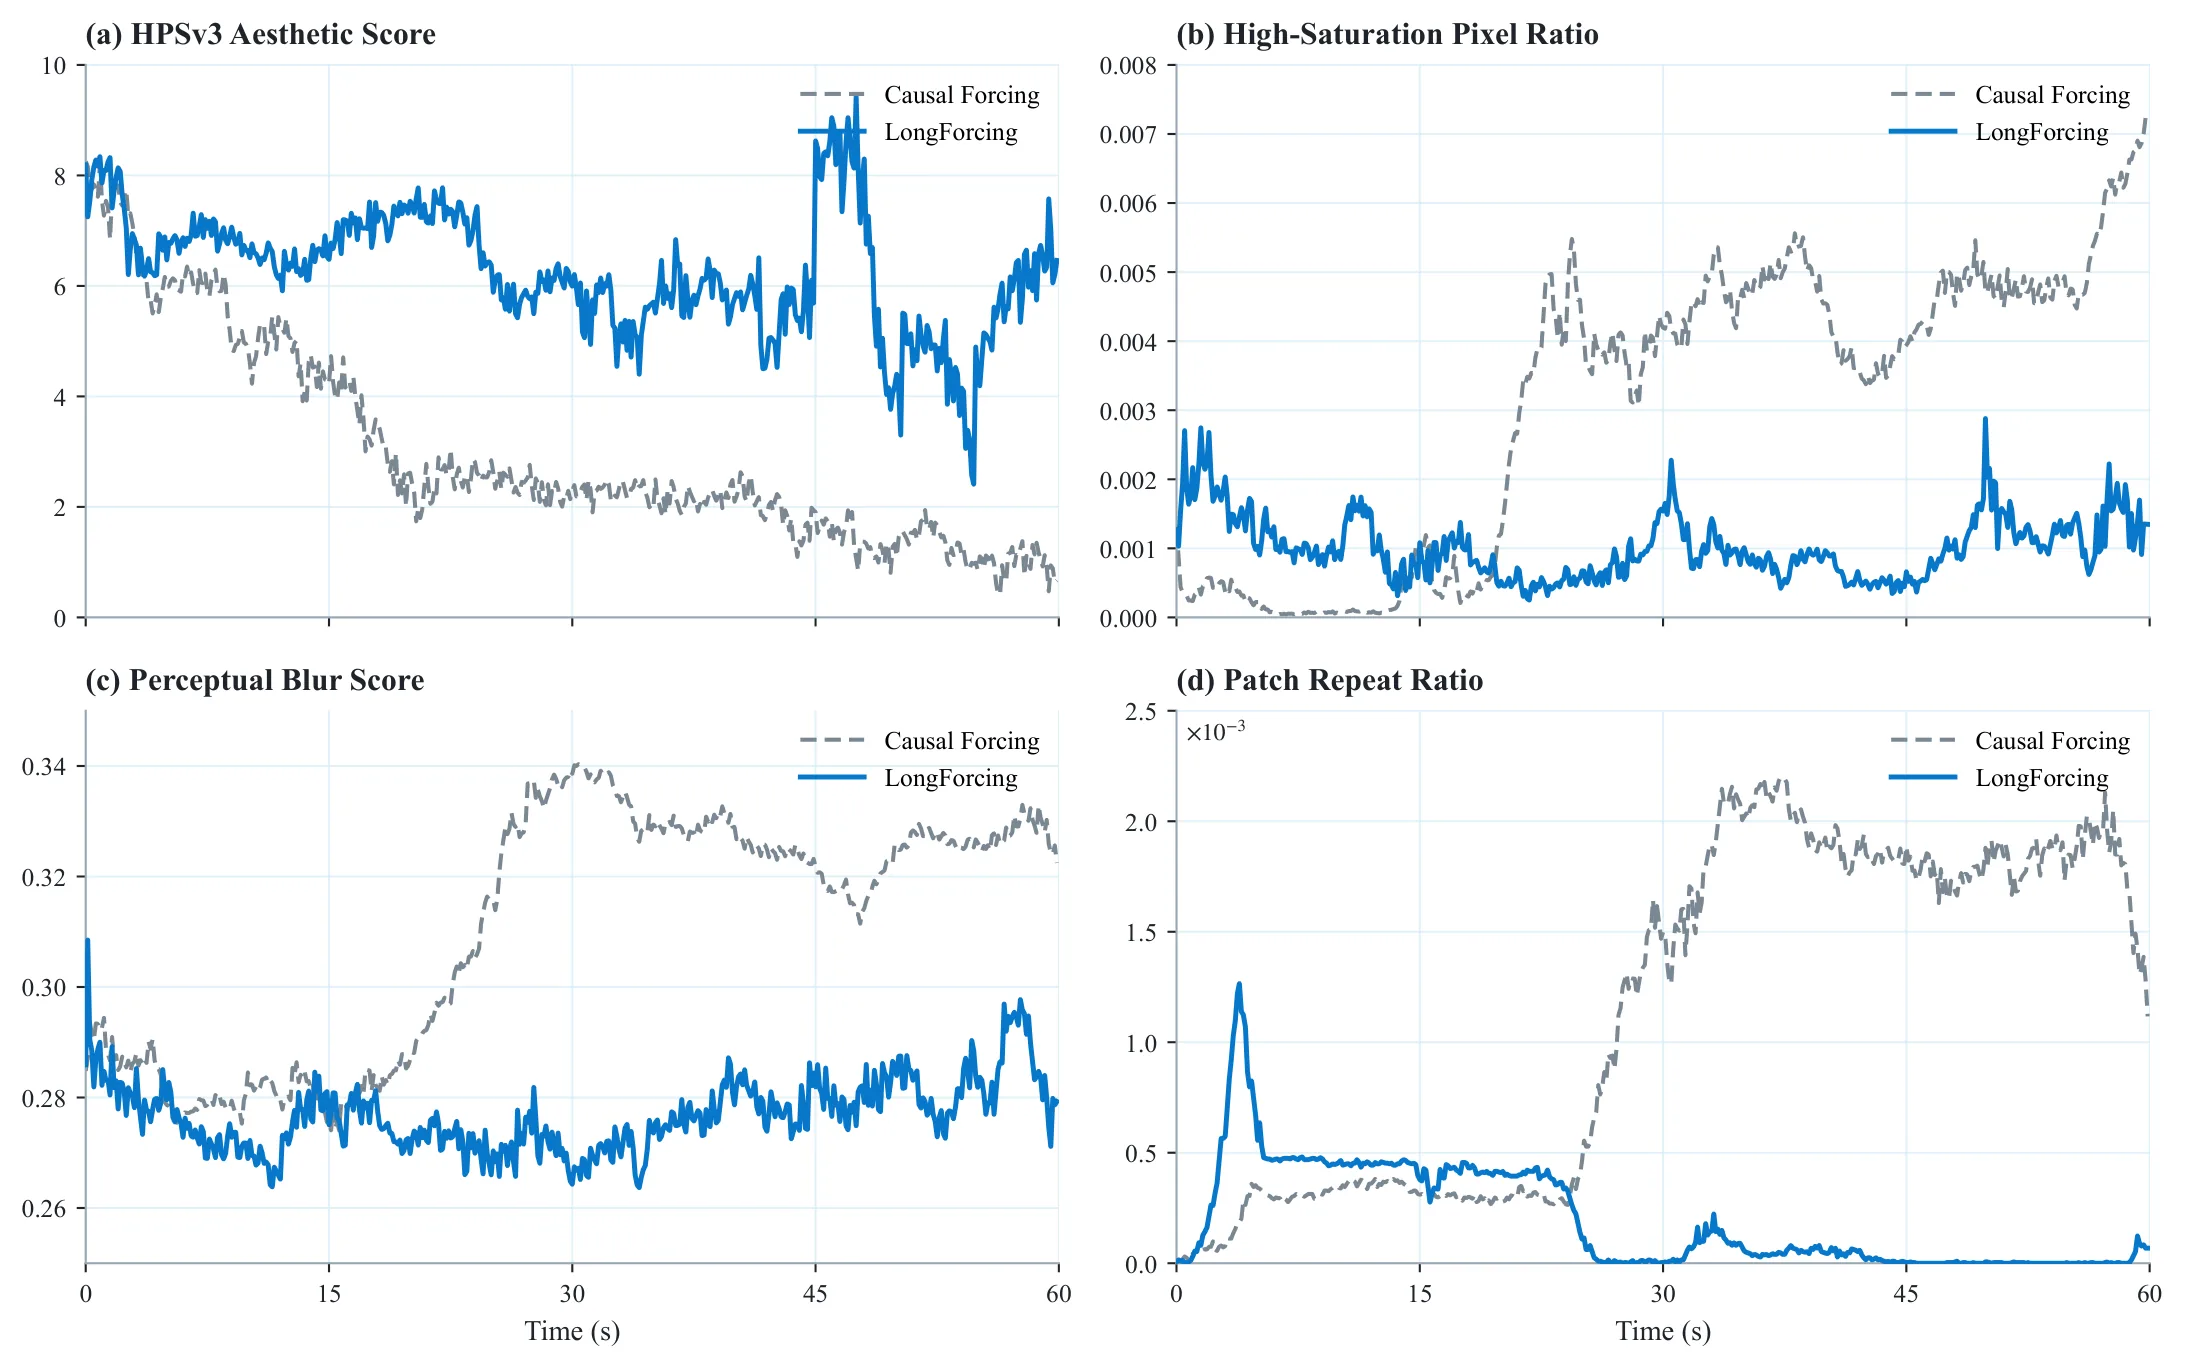
LongForcing 长程对齐策略。 即使完成了上述蒸馏,学生模型在长时间自推演过程中仍然会累积误差,导致视觉质量和动作可控性逐渐退化。这本质上是 [[Teacher Forcing]] 方法的经典问题:训练时看到真实标签,推理时却只能依赖自身预测,二者分布差异会随时间放大。
LongForcing 的核心思想是在训练后期引入周期性"对齐检查点":让学生的长时自推演结果与教师模型在扩展时域上的预测进行对比,如果偏离过大,则让教师重新"接管"几个时间步,提供纠正信号。这类似于给模型装上了一个周期性的校准机制,防止误差在时间维度上无限累积。
流式推理栈的协同设计。 部署层面面临的挑战是:要在有限显存下实现高帧率视频生成,必须在模型体积、计算效率和生成质量之间找到平衡点。ABot-World-0 的推理栈包含几个关键优化:轻量级 VAE 解码器减少了变分自编码器的计算开销;高效注意力机制(如稀疏或局部注意力)降低了 transformer 的计算复杂度;内存感知调度通过分块处理和显存复用减少了峰值显存占用;低位宽 DiT 推理(INT8/INT4 量化)则在保持质量的前提下大幅压缩了模型体积和计算量。这些优化并非独立进行,而是经过系统级的协同调优,使各组件的效率瓶颈相互错开,最终在 RTX 5090 上实现了约 19 GiB 显存下的 720P 16 FPS 流式输出。
实验与结果
实验在两个维度上验证了 ABot-World-0 的有效性:WorldRoamBench 基准测试和扩展的交互式推演。
WorldRoamBench 是一个针对世界模型设计的评测套件,它通过预设的动作序列和场景配置,考察模型在可控性(给定动作后生成结果是否符合意图)和长程连贯性(多帧连续推演后场景是否保持一致)上的表现。ABot-World-0 在这些指标上与同期其他方法相比展现了竞争力的表现,特别是在长时推演场景下,LongForcing 策略带来的改善是可量化的——随着推演步数增加,其性能衰减幅度显著低于基线方法。
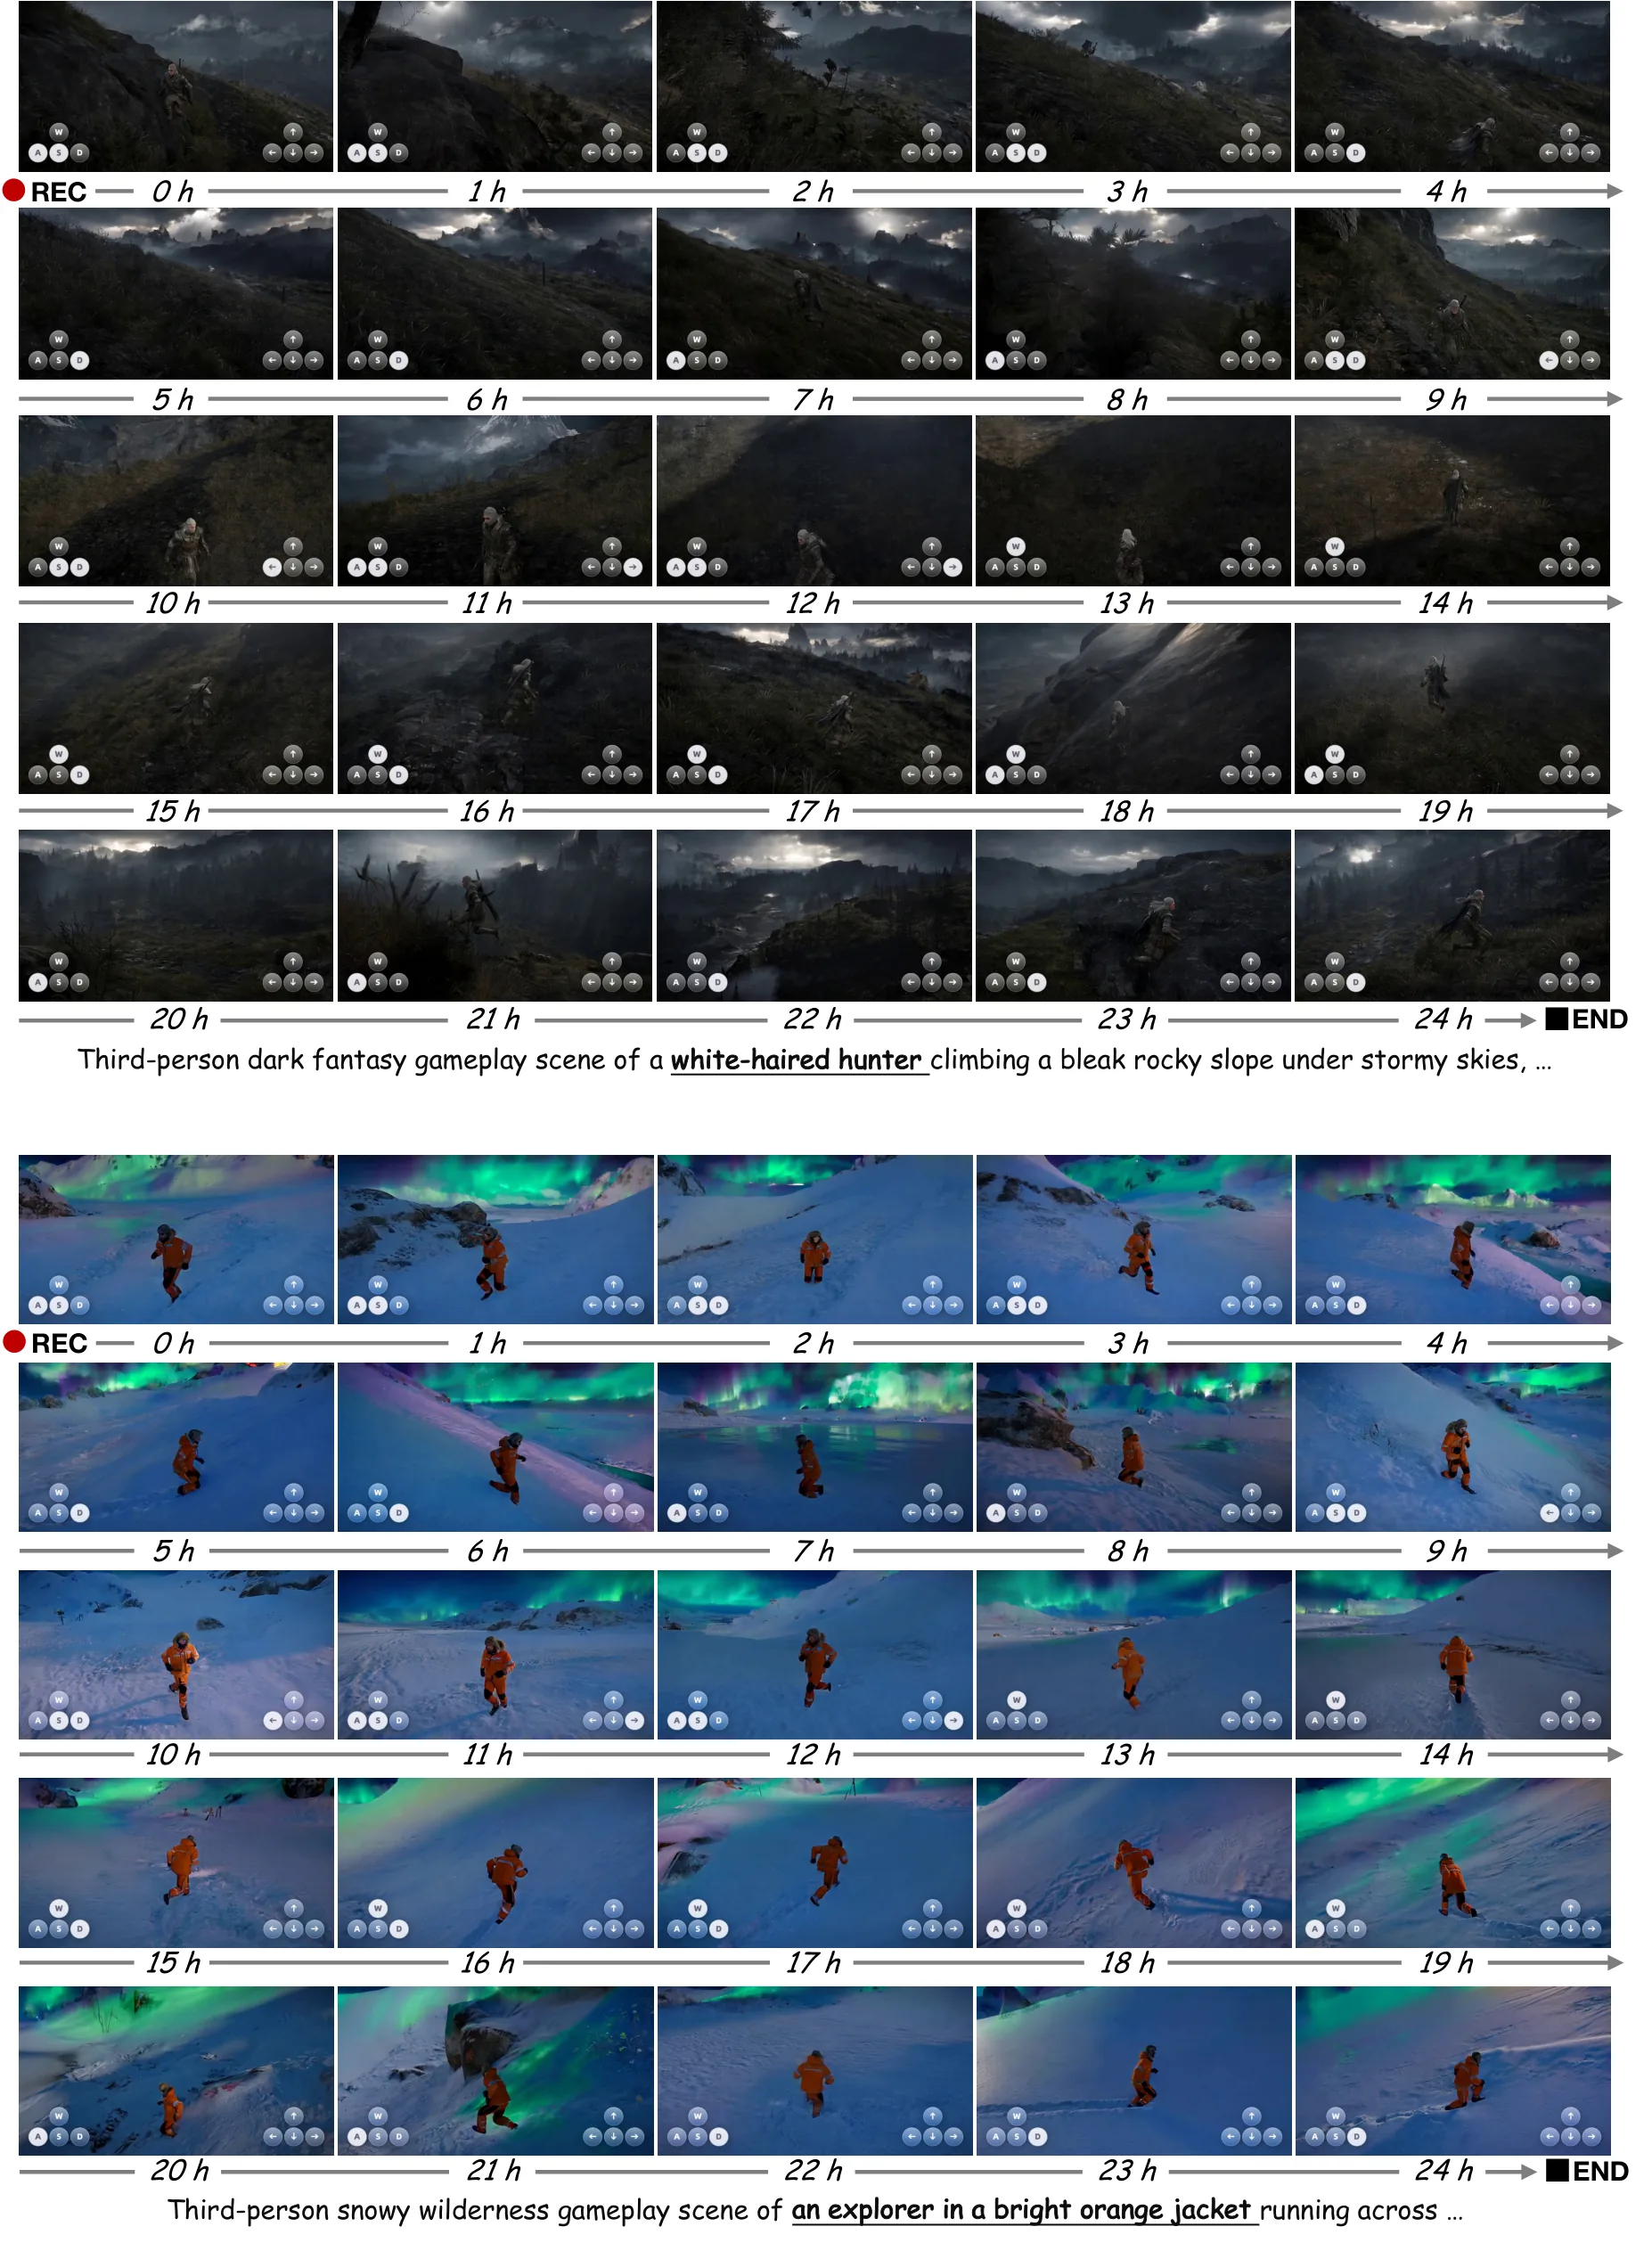
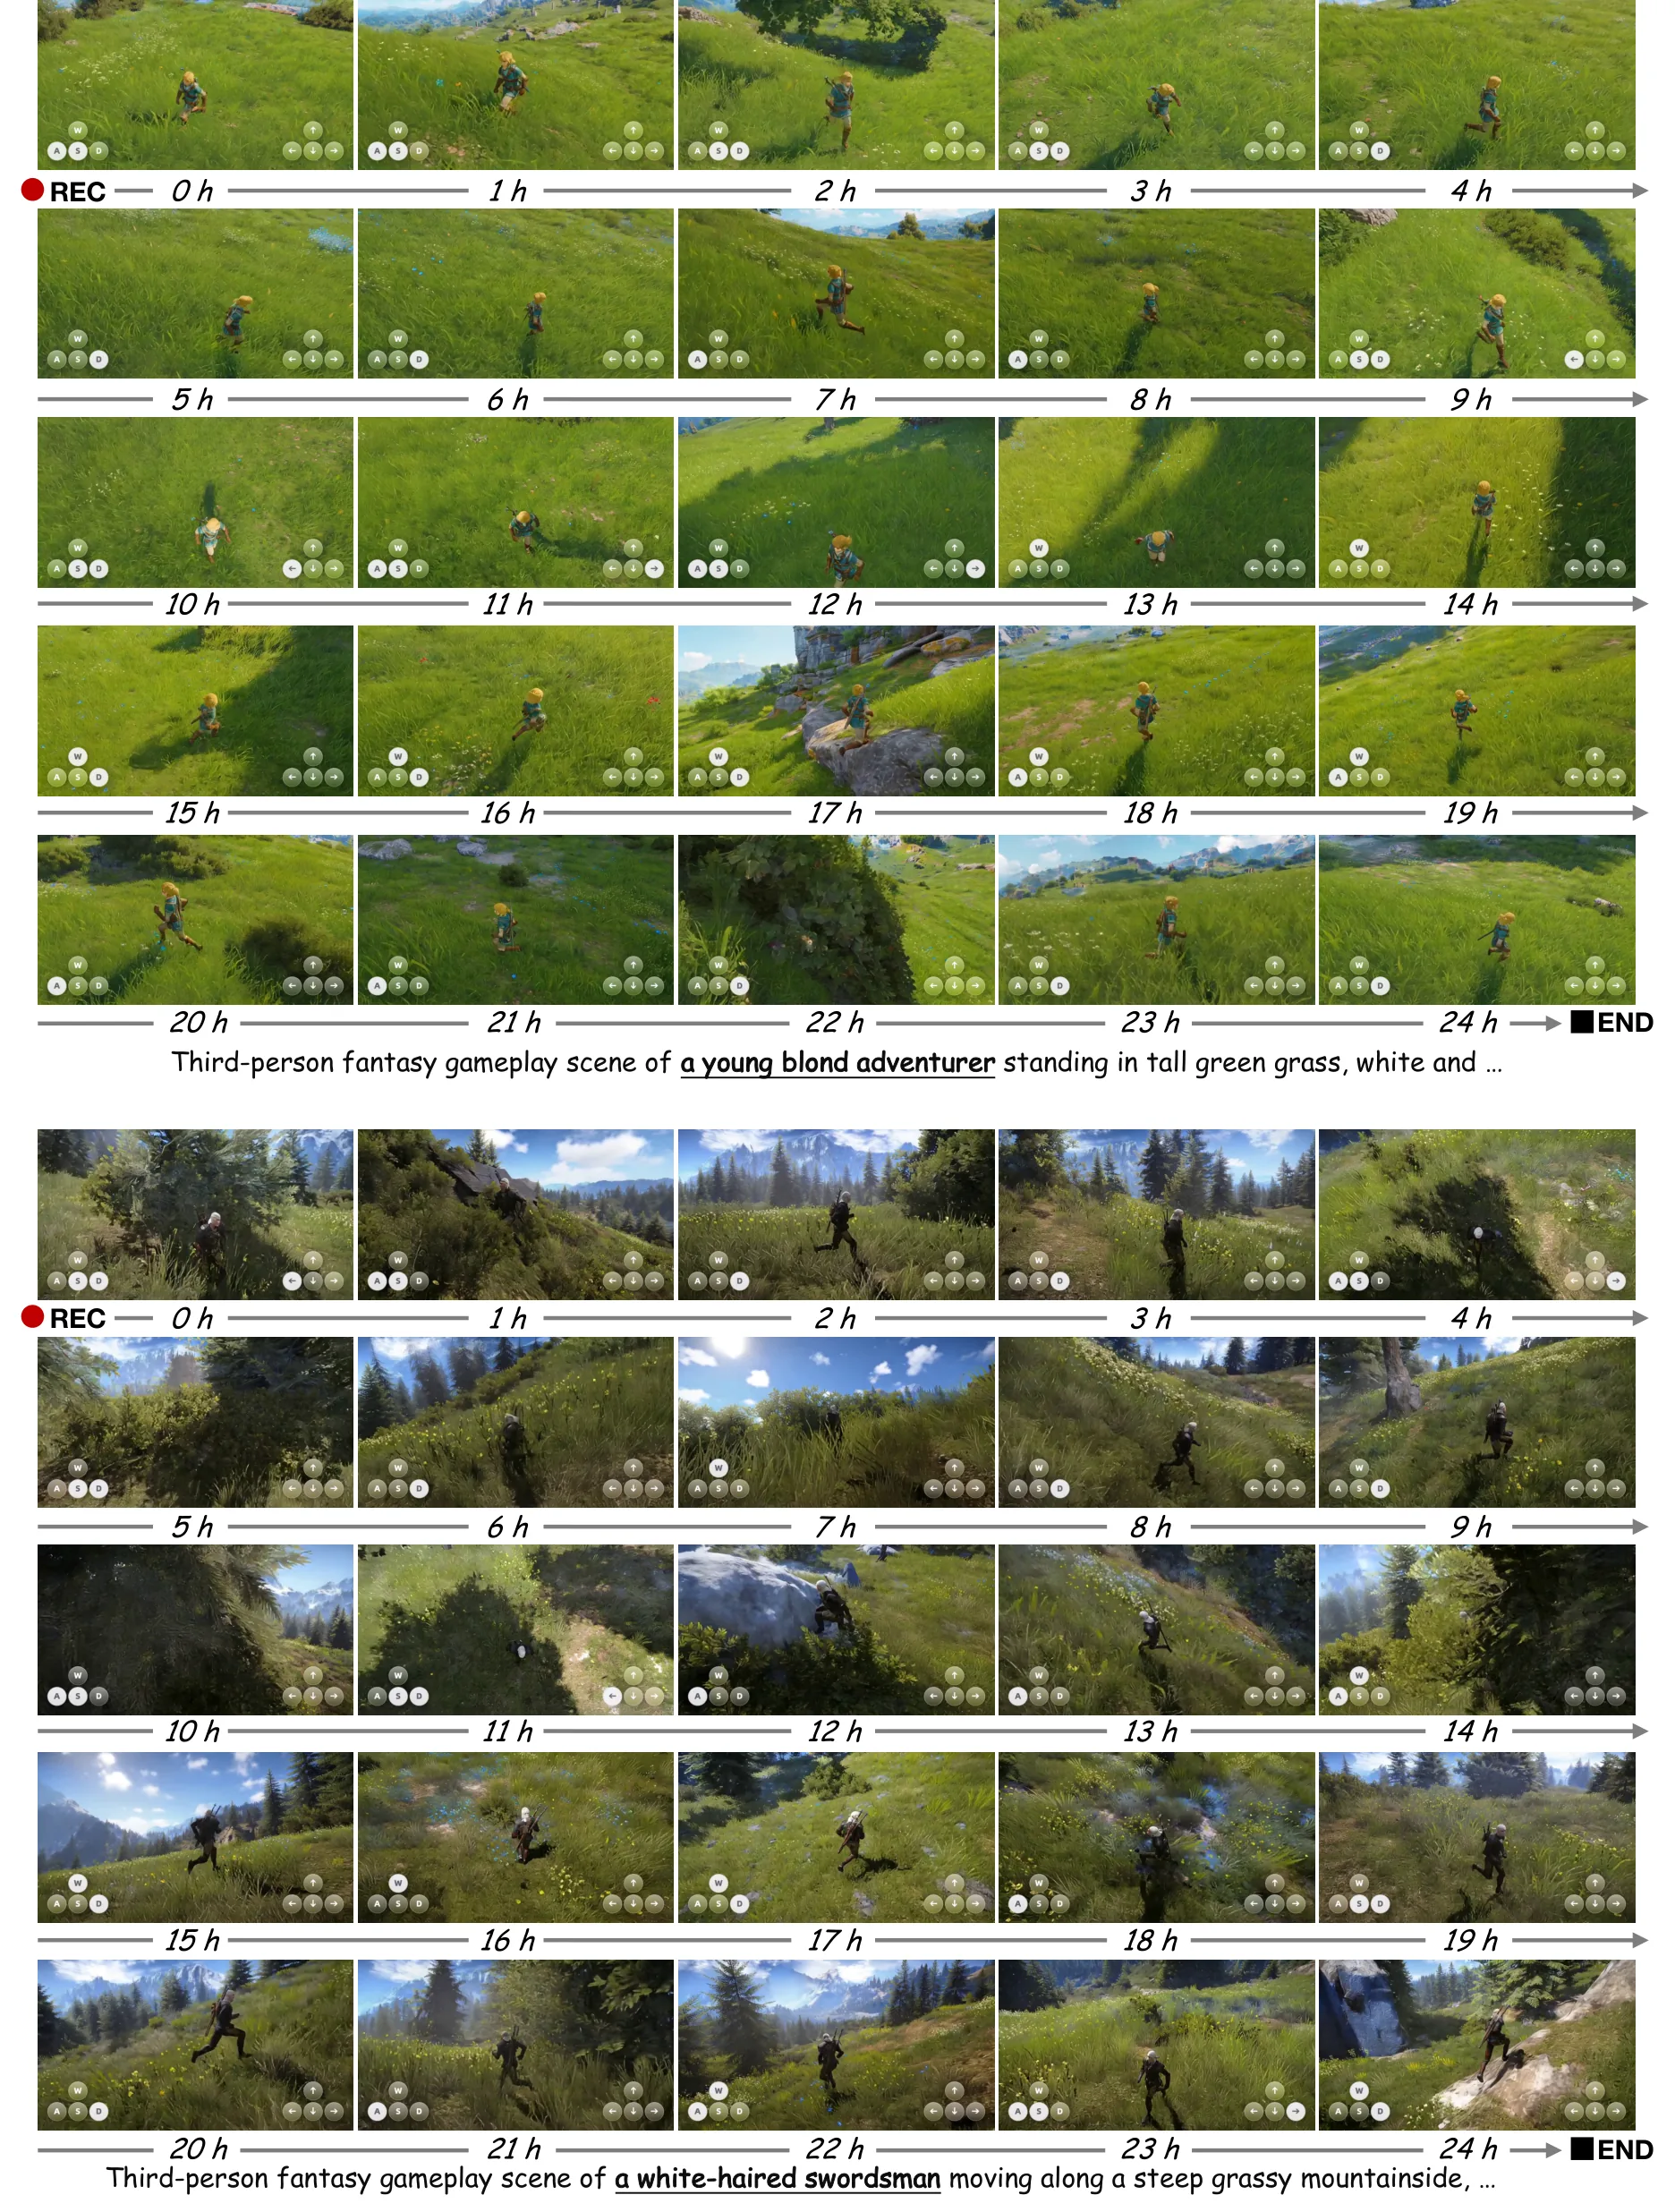
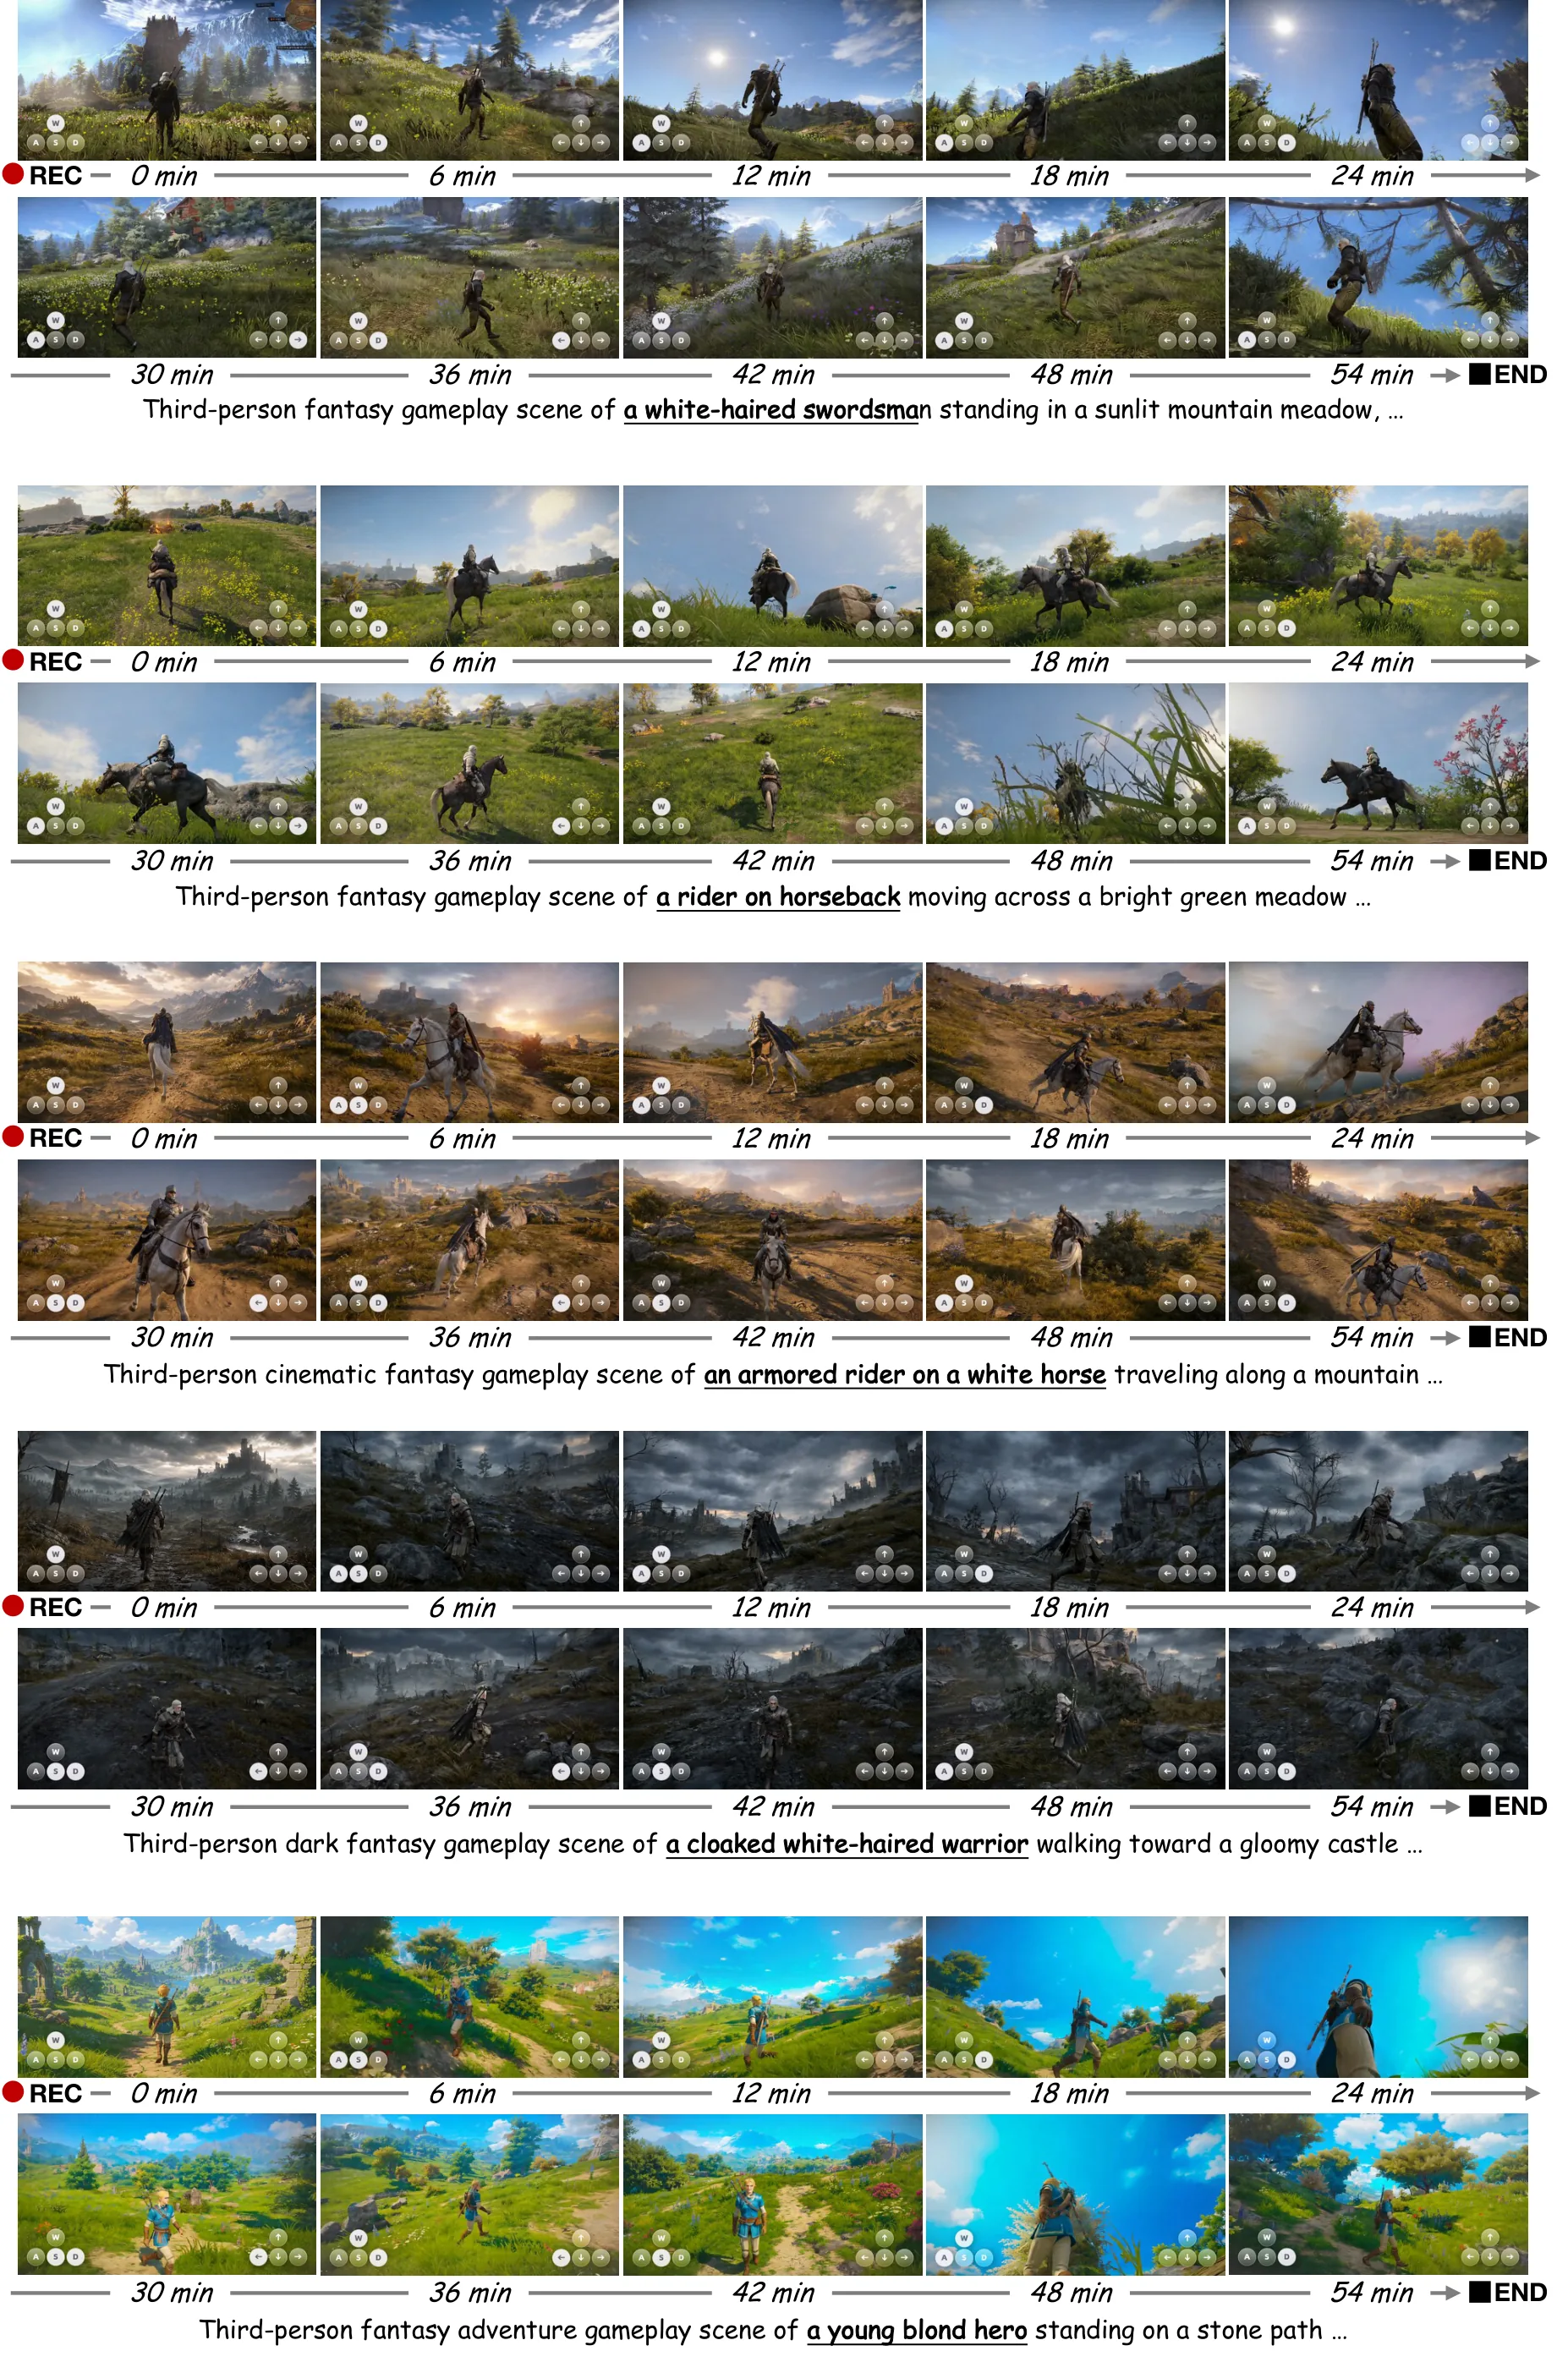
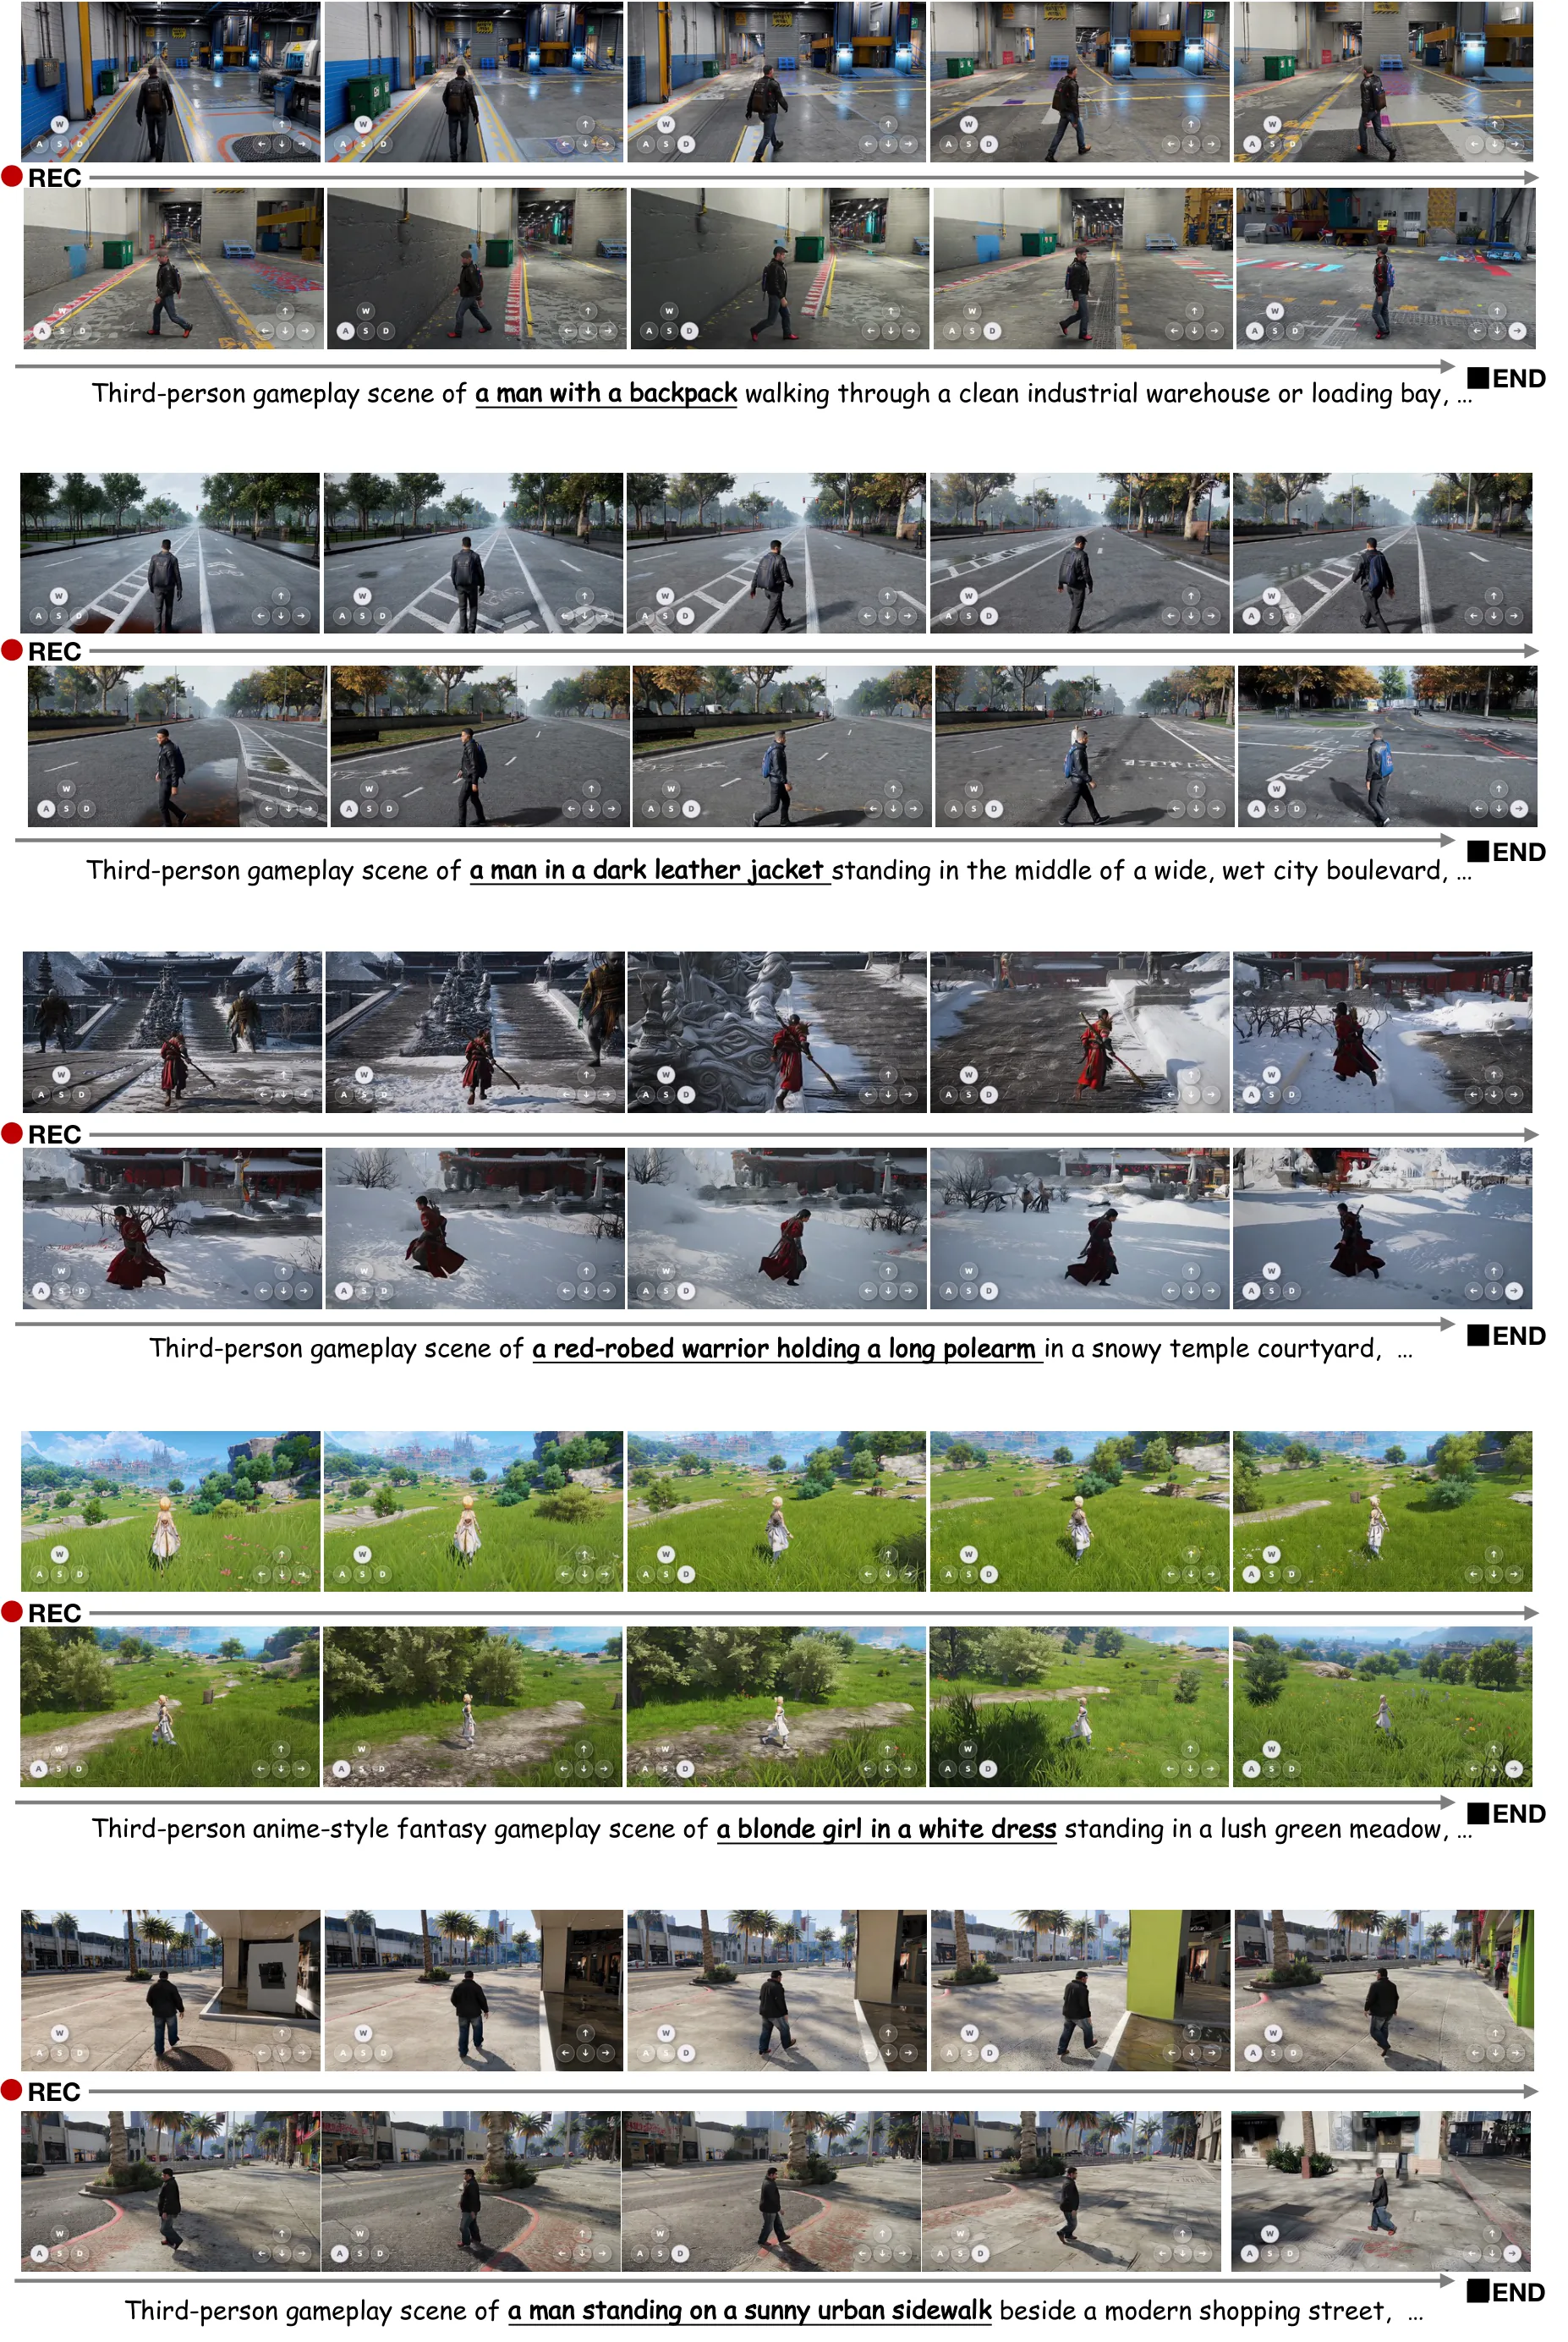
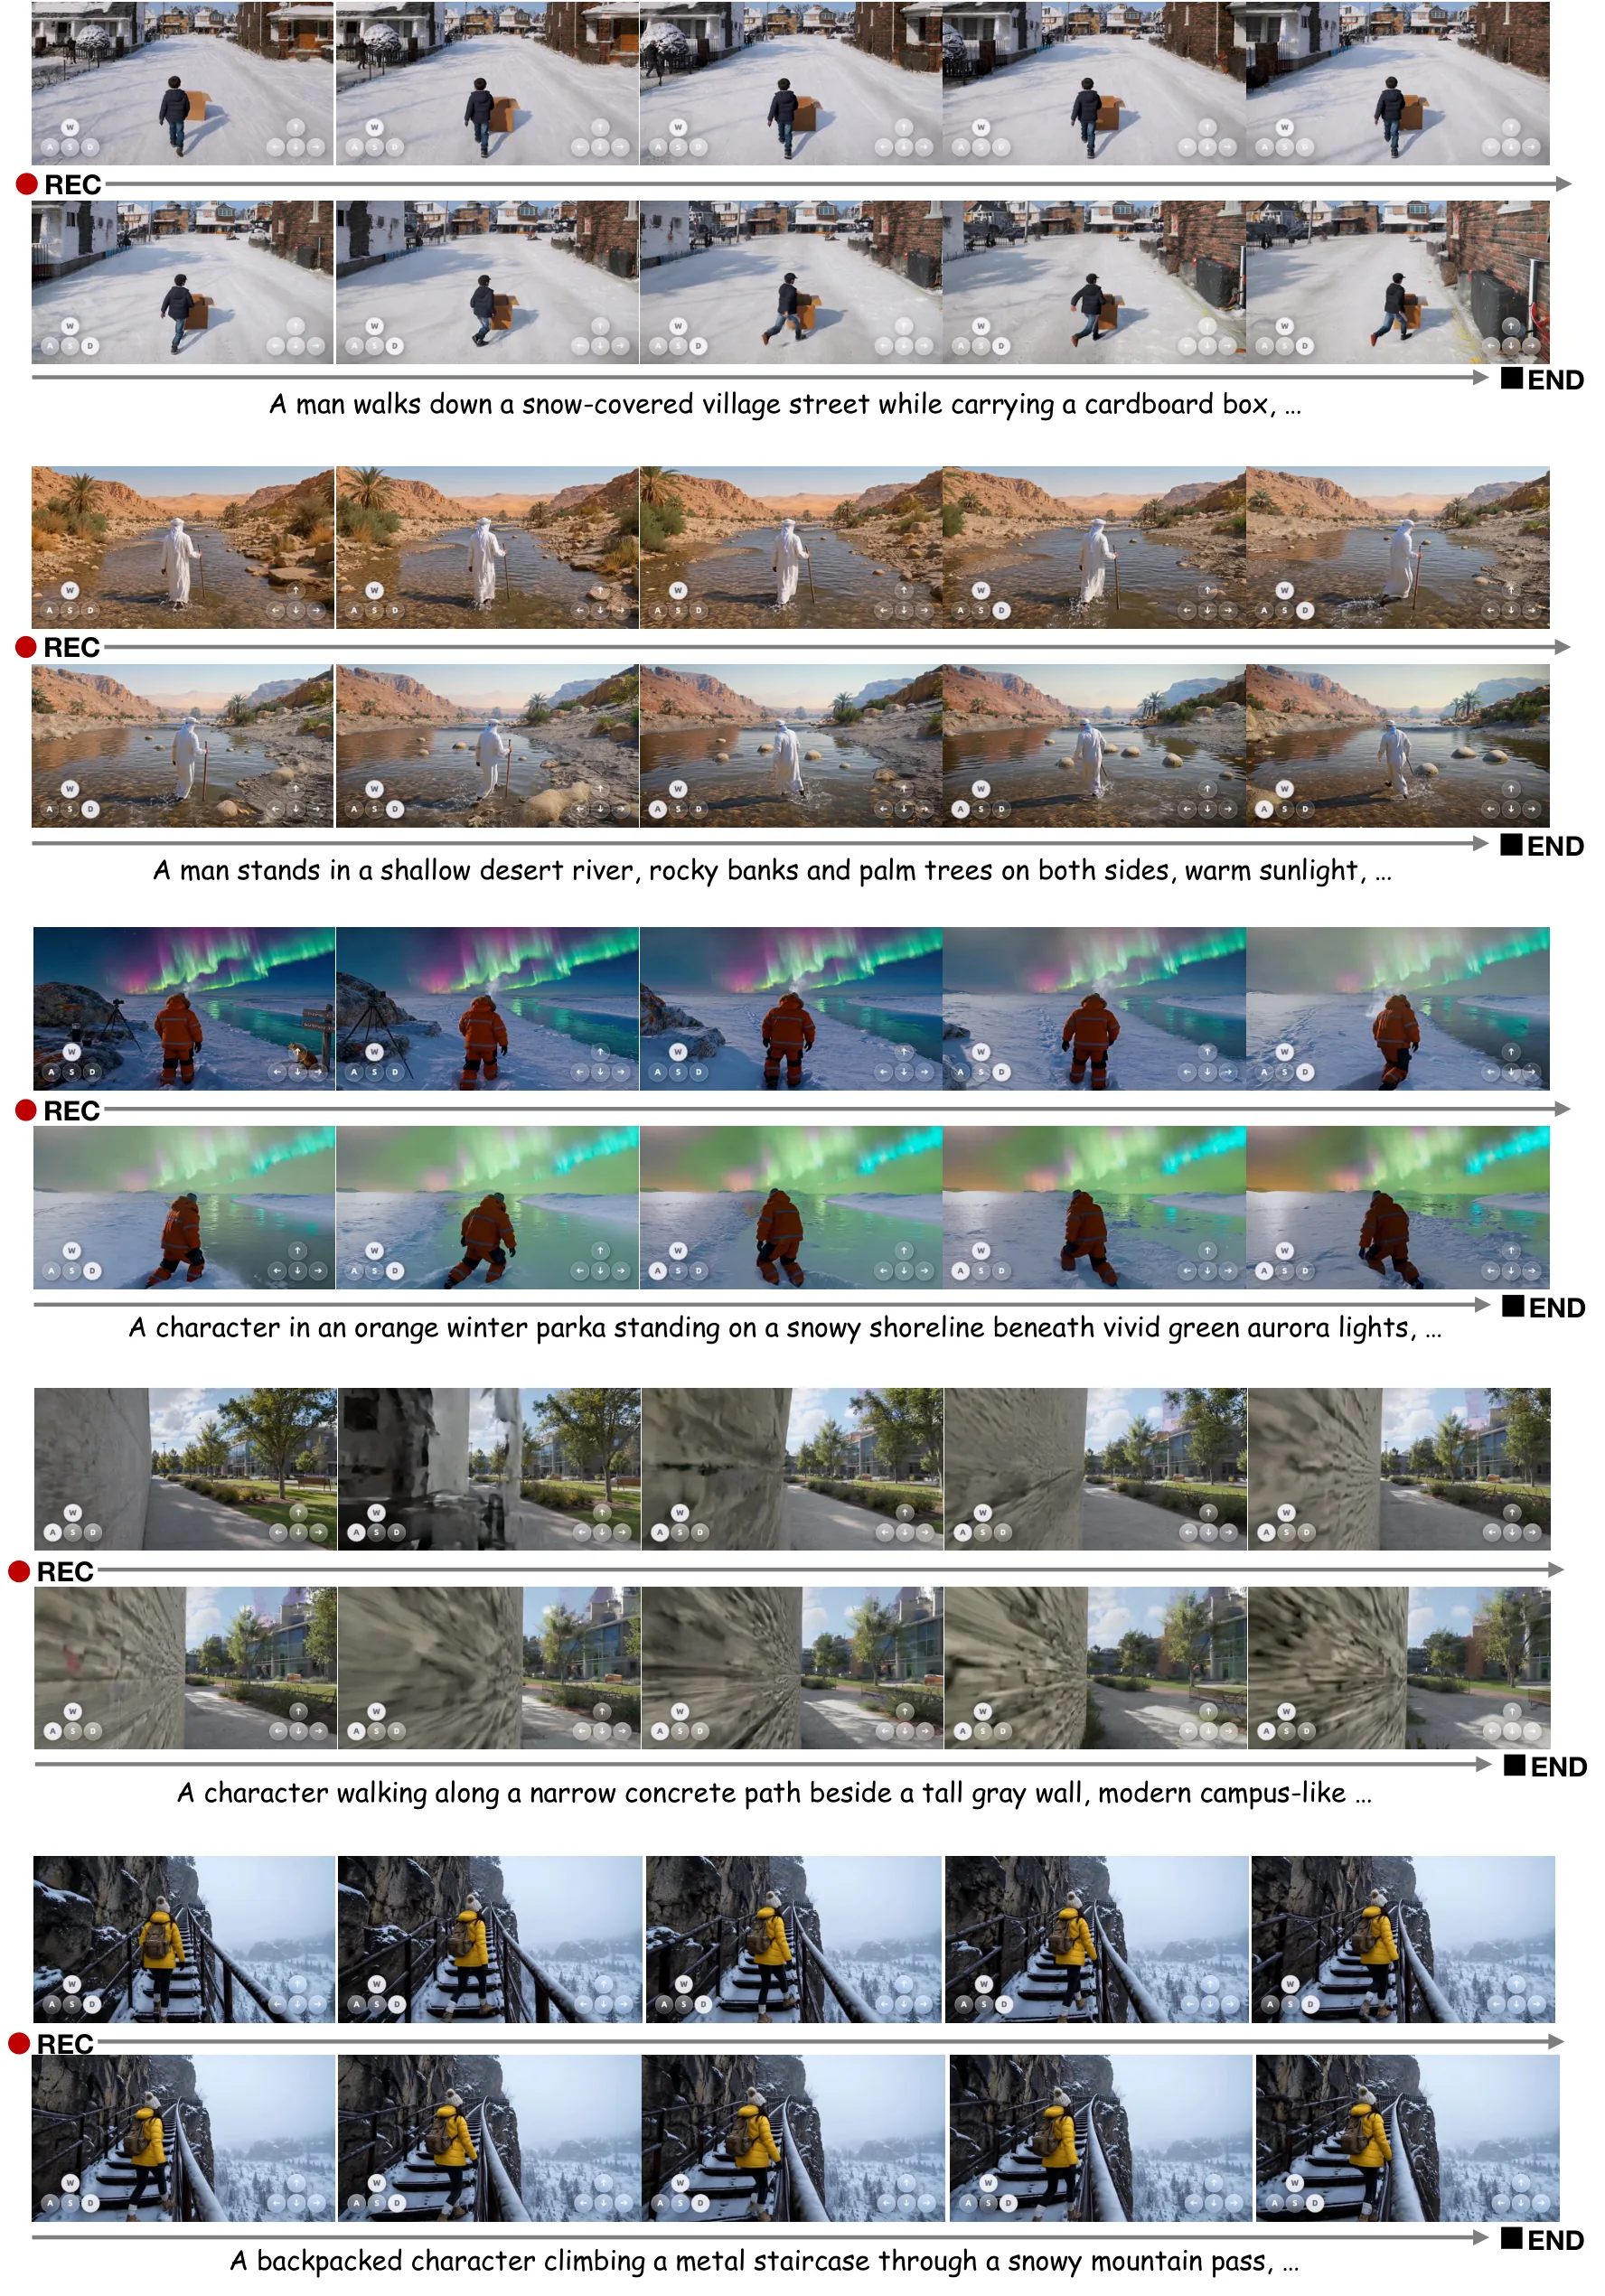
扩展交互式推演实验则更接近实际应用场景。研究者邀请用户通过键盘直接控制角色或相机,观察模型能否实时响应多样化的动作指令。结果显示,模型在场景漫游(第一人称视角)和角色交互(第三人称视角)两种模式下均能保持较低的动作响应延迟和视觉一致性。第三人称场景中引入的参考角色记忆机制,通过在推理时提供角色的外观特征作为持久线索,有效避免了长时间推演中身份信息丢失的问题。
值得注意的是,这些结果是在消费级硬件配置下取得的。RTX 5090 虽然是高端桌面 GPU,但并非专业计算卡,其 16 FPS 的帧率和 1.2 秒的首帧延迟意味着用户在实际交互中可以感受到近乎实时的反馈。这与许多只能在服务器级多卡集群上运行的世界模型形成鲜明对比,极大地拓展了潜在的应用场景边界。
讨论与可借鉴点
ABot-World-0 的核心贡献不仅在于刷新了某项技术指标,更在于它展示了一条从算法创新到系统优化再到硬件部署的完整链路。在这条链路上,有几个值得深思的设计哲学。
首先是数据与模型的协同进化。WorldExplorer 的主动采集策略打破了传统"先采集后训练"的线性流程,将模型反馈纳入数据收集的决策闭环。这种思路在数据饥渴的生成模型时代尤为重要——与其被动等待足够多的数据,不如让模型告诉你它还需要什么样的数据。
其次是蒸馏策略的系统性设计。从 teacher forcing 到 ODE 蒸馏再到 LongForcing,每一层都针对一个具体的分布漂移问题。这种层层递进的设计避免了"一招鲜"的简单方案可能带来的顾此失彼,也为后续研究提供了可组合的模块化组件。
第三是工程与学术的深度融合。在消费级硬件上实现高质量实时生成,不能仅仅依靠算法层面的创新,还需要在推理引擎、显存管理、量化策略等工程细节上做大量细致的优化。这提醒我们,大模型的落地从来不是算法独角戏,而是一个需要系统工程思维的综合性挑战。
当然,这项工作也存在局限。720P 分辨率虽然适合桌面交互,但距离电影级或工业仿真的需求仍有差距;16 FPS 在快节奏游戏中可能仍嫌不足;模型在极端动作(如快速场景切换、复杂物理交互)下的表现也有待进一步验证。此外,LongForcing 虽然有效缓解了长程漂移,但其计算开销和实现复杂度是否会限制模型进一步扩展,仍是一个开放问题。
对于整个世界模型研究社区而言,ABot-World-0 最有价值的启发或许在于:它证明了在现有硬件条件下,实时交互式世界模拟并非遥不可及。关键在于,是否愿意在数据、算法、系统三个层面同时发力,而非偏废其一。
摘要
我们提出了 ABot-World-0,这是一个面向实时、长时域闭环交互的动作条件视频世界模型,其依托覆盖 3A 游戏、仿真引擎与互联网视频的多源数据基础设施,以学习可控的世界动力学。WorldExplorer 在训练反馈的引导下执行由智能体驱动的数据采集,同时一条统一流水线应用 14 项确定性质量检查、基于 VLM 的评估以及动作与文本的同步标注。我们通过教师强制与 ODE 蒸馏,将一个双向动作条件的教师模型渐进地蒸馏为一个因果学生模型,并提出 LongForcing,使学生的长时自推演与扩展时域的教师模型对齐,从而缓解累积的分布漂移与自回归漂移。原始键盘动作提供了统一的控制接口,用于场景漫游与第三人称角色交互;参考角色记忆则在第三人称推演过程中提供持久的外观线索,以保持身份一致性。在部署方面,我们协同设计了一套流式推理栈,集成轻量级 VAE 解码器、高效注意力、内存感知调度以及低位宽 DiT 推理。在经过优化的低位宽配置下,ABot-World-0 可在单台 NVIDIA RTX 5090 桌面 GPU 上以最高 16 FPS 流式输出 720P 视频,动作到首帧延迟为 1.2 秒,显存峰值约为 19 GiB。在 WorldRoamBench 与扩展的交互式推演上的实验表明,该方法具有具有竞争力的可控性以及连贯的长时域世界演化。
Abstract
We present ABot-World-0, an action-conditioned video world model for real-time, long-horizon closed-loop interaction, supported by a multi-source data infrastructure spanning AAA games, simulation engines, and internet videos to learn controllable world dynamics. WorldExplorer performs agent-driven collection guided by training feedback, while a unified pipeline applies 14 deterministic quality checks, VLM-based assessment, and synchronized action and text annotation. We progressively distill a bidirectional action-conditioned teacher into a causal student through teacher forcing and ODE distillation, and introduce LongForcing to align long student self-rollouts with an extended-horizon teacher, mitigating accumulated distribution shift and autoregressive drift. Raw keyboard actions provide a unified control interface for scene roaming and third-person character interaction, while reference-character memory provides persistent appearance cues for identity consistency during third-person rollouts. For deployment, we co-design a streaming inference stack with a lightweight VAE decoder, efficient attention, memory-aware scheduling, and low-bit DiT inference. Across optimized low-bit configurations, ABot-World-0 streams 720P video at up to 16 FPS on a single NVIDIA RTX 5090 desktop GPU, with 1.2s action-to-first-frame latency and approximately 19GiB peak VRAM. Experiments on WorldRoamBench and extended interactive rollouts demonstrate competitive controllability and coherent long-horizon world evolution.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。