
参数化动作强化学习中多智能体Actor-Critic算法的比较研究
Comparative Study of Multi-Agent Actor-Critic Algorithms in Parameterized Action Reinforcement Learning
📝 TLDR
参数化动作强化学习需同时选择离散动作与连续参数,但现有研究多集中在单智能体场景。本文将GAC、SAC、TQC三种actor-critic算法扩展为共享经验回放的多智能体版本MAGAC、MASAC和MATQC,并在Platform-v0与Goal-v0上进行对比实验。结果显示MAGAC对GAC的提升最为显著且一致,而MASAC和MATQC相对其单智能体版本仅有小幅增益;智能体数量超过5个后性能收益有限但计算开销显著上升。该研究揭示了多智能体框架在性能与计算效率之间的权衡。
🧭 速览
参数化动作强化学习中单智能体算法已被验证有效,但其在多智能体场景下的扩展尚未得到充分研究。
提出共享经验回放的多智能体框架,将GAC、SAC、TQC扩展为MAGAC、MASAC、MATQC,在Platform-v0和Goal-v0上以3/5/10智能体配置对比评估。
MAGAC对GAC提升显著且一致,MASAC与MATQC相对单智能体版本仅有小幅增益;超过5个智能体后性能提升有限,计算成本大幅增加。
共享经验多智能体actor-critic方法在参数化动作任务中有效,但存在性能与计算效率的权衡,需在智能体数量与开销间审慎取舍。
🆚 方法对比
Greedy Actor-Critic (GAC)
- 用交叉熵法选择高价值动作
- 在参数化动作基准上有效
- 仅限单智能体设置
- 扩展到多智能体空间未被探索
Soft Actor-Critic (SAC)
- 熵最大化鼓励充分探索
- 避免收敛到次优策略
- 多智能体版本增益有限
- 单智能体框架局限性
Truncated Quantile Critics (TQC)
- 用分布式RL缓解过估计偏差
- 探索-利用平衡较好
- 多智能体扩展仅带来温和提升
- 单智能体设置无法利用共享经验
Multi-Agent Greedy Actor-Critic (MAGAC)
- 持续提升GAC在多智能体下的性能
- 从共享经验中获益最显著
- 计算成本随智能体数大幅增加
- 超过5个智能体后收益递减
Multi-Agent Soft Actor-Critic (MASAC)
- 相对单智能体SAC有所提升
- 共享回放缓冲区提升样本效率
- 相比单智能体版本增益温和
- 扩展性提升有限
Multi-Agent Truncated Quantile Critics (MATQC)
- 在多智能体设置下稳定改进
- 保持分布式RL优势
- 相比TQC仅获得温和增益
- 5个以上智能体边际效益低
共享经验多智能体框架
- 架构简单无需CTDE
- 共享缓冲区提升样本利用率
- 计算开销随智能体数线性增长
- 性能在5智能体后趋于饱和
CTDE范式
- 允许多智能体协同训练
- 是多智能体RL成熟方案
- 架构复杂,本研究未采用
- 集中式训练增加实现难度
论文对比了GAC、SAC、TQC三种单智能体算法及其共享经验多智能体扩展版本(MAGAC、MASAC、MATQC),发现MAGAC提升最显著而MASAC和MATQC增益温和,且超过5个智能体后性能饱和但计算成本大幅增加。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
本文将三种单智能体 [[Actor-Critic]] 算法——GAC、SAC 和 TQC——扩展为共享经验的多智能体版本(MAGAC、MASAC、MATQC),在参数化动作基准任务上系统比较了它们的性能与计算效率。实验结果表明,MAGAC 相比其单智能体基线 GAC 获得了一致且显著的性能提升,而 MASAC 和 MATQC 的增益相对有限;将智能体数量增加到五个以上几乎无法带来额外性能收益,却会显著增加训练时间,揭示了多智能体框架中性能与计算效率之间的关键权衡。
研究背景与动机
参数化动作强化学习是一类特殊的决策问题:智能体不仅需要从离散集合中选择动作类型,还需要同时为所选动作确定连续的参数值。例如在机器人控制场景中,智能体既要决定“伸手去抓取”还是“推开”,还需精确指定抓取的位置、角度和力度。这类问题广泛存在于自动驾驶、无人机编队协同、智能电网调度等实际应用中。
在单智能体场景下,贪心 Actor-Critic(GAC)、软 Actor-Critic(SAC)和截断分位数评论家(TQC)三种 [[Actor-Critic]] 算法已被证明能够在 Platform-v0 和 Goal-v0 等基准任务上取得良好效果。然而,现实世界中的许多系统天然具有多智能体属性——多个决策单元需要协作或竞争以完成复杂任务。将这些单智能体算法直接迁移到多智能体环境会遇到接口不匹配的问题:环境通常只接受单一动作输入,但多个智能体各自独立采样出的动作需要某种方式整合。
本文的核心研究动机在于探索一个关键问题:共享经验的 [[多智能体强化学习]] 框架能否持续提升参数化动作任务的学习性能?增加智能体数量是否会带来线性甚至超线性的性能增益,还是很快遭遇收益递减?回答这些问题不仅有助于理解 [[Actor-Critic]] 算法族在多智能体场景下的行为特性,也能为实际系统设计提供计算资源分配的依据。
方法
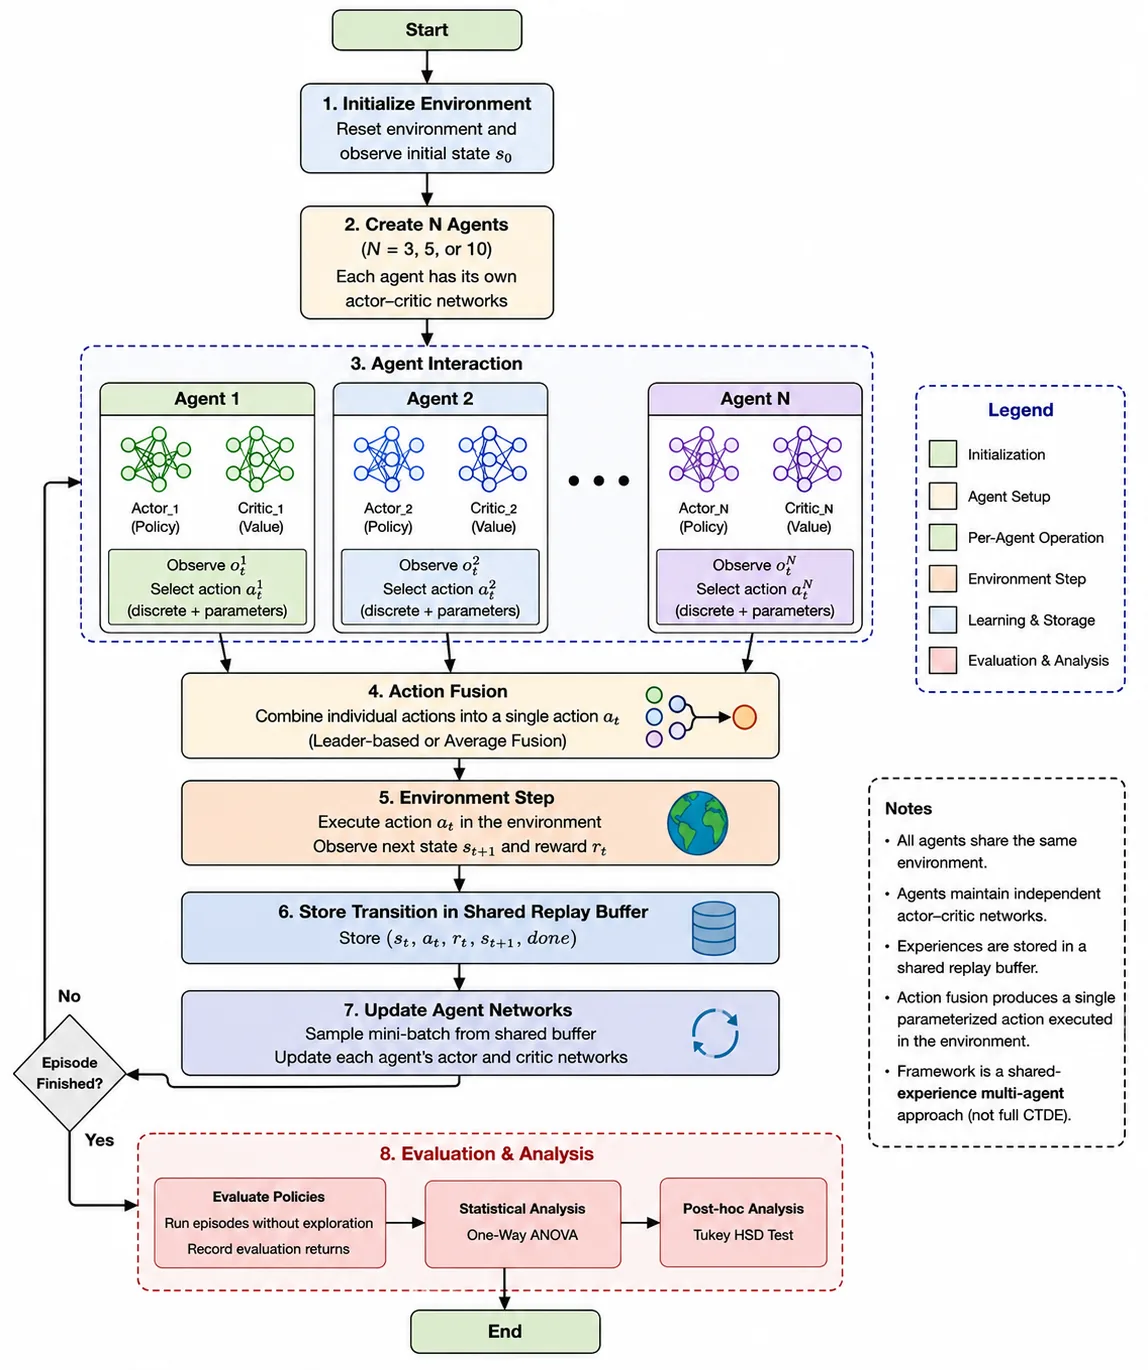
本文提出的多智能体扩展框架并未遵循当前主流的集中训练、分散执行(CTDE)范式,而是采用了一种更简洁的架构设计。框架包含 个相互独立的 [[Actor-Critic]] 智能体,每个智能体维护自己的策略网络和价值网络,但它们共享同一个[[经验回放缓冲区]]。这种设计的直觉在于:更多的智能体意味着更多的探索多样性,共享经验可以让每个智能体从同伴的经历中学习,从而加速收敛。
在具体实现上,每个智能体独立观测环境状态后,各自采样一个参数化动作 ,其中 表示离散动作类型, 表示连续参数向量。由于环境接口通常只接受单一动作输入,框架引入了动作融合机制,通过融合策略 将 个独立动作整合为环境可执行的动作:
训练过程中,所有智能体产生的交互转移被存储到共享缓冲区,缓冲区满后采用 FIFO 策略淘汰旧样本。在更新阶段,每个智能体独立地从共享缓冲区中采样数据进行梯度下降更新,这意味着各智能体虽然学习目标略有不同(基于各自策略网络产生的动作),但共享相似的经验分布。
基于这一框架,本文将三种算法分别扩展为多智能体版本。MAGAC 直接将 GAC 的更新规则应用到每个智能体;MASAC 保留了 SAC 的最大熵正则化框架,通过最大化包含熵项的目标函数来平衡探索与利用;MATQC 则采用分位数回归来估计价值函数分布,提供更稳健的值估计。三种算法的差异主要集中在 Critic 的结构与更新方式上:GAC 使用单步 TD 更新,SAC 引入自动温度调整的熵奖励,TQC 通过截断分位数来减少值过估计。
实验与结果
实验在两个标准参数化动作基准环境上进行:Platform-v0 要求智能体控制移动方向与步幅以到达目标平台,Goal-v0 则需要同时决定动作类型和到达目标的位置参数。研究团队采用三智能体、五智能体和十智能体三种配置,并设置了单智能体基线作为对照,每个配置重复十次独立训练以确保结果的统计可靠性。
性能评估采用了平均评估回报和训练墙钟时间两个维度,统计显著性通过单因素方差分析和 Tukey HSD 事后检验进行验证。在 Goal-v0 环境中,MAGAC 的五智能体配置将平均回报从基线 GAC 的 提升至 ,相对改善约 ,且统计检验显示这一差异具有高度显著性()。Platform-v0 上的结果更为明显,MAGAC 将基线 的回报提升至 ,效应量达到 ,表明多智能体框架对 GAC 的提升具有实质性的实际意义。
相比之下,MASAC 和 MATQC 的多智能体扩展相对各自单智能体基线仅表现出微弱增益,部分配置甚至无统计显著差异。Tukey HSD 检验证实,MAGAC 与 MASAC/MATQC 之间存在显著性能差距,而 MASAC 与 MATQC 之间则无明显区分。这一结果暗示,对于已经包含熵正则化(SAC)或对过估计有内在抑制(TQC)的算法,额外的探索多样性带来的边际收益已经相当有限。
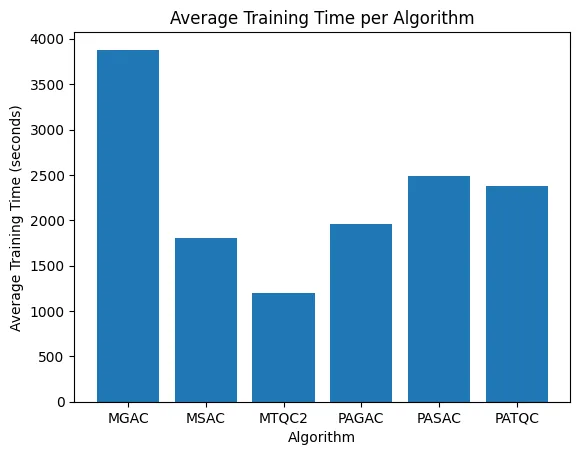
可扩展性分析揭示了计算成本与性能收益之间的非线性关系。将智能体数从三增加到五时,MAGAC 在两个环境上均获得约 – 的额外提升;然而从五增加到十时,性能曲线趋于平缓,提升不足 ,但训练时间却从约 小时急剧攀升至接近 小时。对于 MASAC 和 MATQC,增加智能体数量带来的性能增益更为边际,而计算开销的线性增长使得这种扩展策略难以产生合理的投入产出比。
讨论与可借鉴点
这项研究最重要的启示在于揭示了 [[多智能体强化学习]] 中“越多越好”假设的局限性。当底层算法已经具备良好的探索机制时,简单地增加智能体数量以引入更多随机性,其边际收益会快速衰减。MAGAC 的显著提升可能源于 GAC 本身对探索的支持较弱,而多智能体框架带来的多样化经验恰好弥补了这一短板;对于 SAC 和 TQC 这类内置熵机制或值分布建模的算法,额外的探索来源变得不再关键。
研究同时暴露了当前框架的几个局限。首先,非 CTDE 架构决定了各智能体缺乏对联合状态的显式建模能力,在需要紧密协调的高难度协作任务中可能表现乏力。其次,动作融合策略 的设计选择——如采用平均、投票还是注意力加权——未被系统探讨,不同融合方式可能对最终性能产生实质影响。此外,实验仅在两个相对简单的玩具环境中验证,结论在更复杂的真实世界场景(如多机器人协同操作或分布式能源调度)中的普适性有待检验。
对于后续研究而言,一个有价值的探索方向是将共享经验框架与 CTDE 范式相结合,让多个智能体既能享受独立探索的多样性红利,又能通过中心化 Critic 捕获联合动作值函数的全局信息。另一个值得关注的问题是动作融合机制的理论分析——是否存在最优的融合策略,使得多智能体的参数化动作组合能够比任何单一智能体产生更好的决策质量?这些问题为参数化动作 [[多智能体强化学习]] 的进一步发展指明了道路。
摘要
参数化动作强化学习在需要同时进行离散动作选择和连续参数化的环境中表现出了强大的性能。先前的研究已经确立了单智能体Actor-Critic算法——贪心Actor-Critic(GAC)、软Actor-Critic(SAC)和截断分位数评论家(TQC)——在参数化动作基准任务上的有效性,但这些算法向多智能体场景的扩展在很大程度上尚未得到探索。本文对这些算法的共享经验多智能体扩展进行了比较研究:多智能体贪心Actor-Critic(MAGAC)、多智能体软Actor-Critic(MASAC)和多智能体截断分位数评论家(MATQC)。所提出的框架并未遵循集中训练、分散执行(CTDE)范式,而是采用多个独立的Actor-Critic智能体,它们共享一个经验回放缓冲区,同时保持各自的策略网络和价值网络。我们在Platform-v0和Goal-v0基准上针对相应的单智能体版本评估了这些算法,使用三智能体、五智能体和十智能体配置来评估可扩展性。性能通过十次独立运行中的平均评估回报和训练时间来衡量,并采用单因素方差分析和Tukey HSD事后检验来评估统计显著性。结果表明,多智能体框架持续地提升了贪心Actor-Critic的性能,而MASAC和MATQC相对于其单智能体版本仅表现出相对适度的提升。将智能体数量增加到五个以上所带来的额外性能收益有限,同时却显著增加了计算成本,尤其是对MAGAC而言。这些结果凸显了学习性能与计算效率之间的权衡,为参数化动作强化学习中共享经验多智能体Actor-Critic方法的可扩展性提供了启示。
Abstract
Parameterized action reinforcement learning has shown strong performance in environments requiring both discrete action selection and continuous parameterization. Prior work established the effectiveness of single-agent actor-critic algorithms - Greedy Actor-Critic (GAC), Soft Actor-Critic (SAC), and Truncated Quantile Critics (TQC) - on benchmark parameterized action tasks, but their extension to multi-agent settings remains largely unexplored. This paper presents a comparative study of shared-experience multi-agent extensions of these algorithms: Multi-Agent Greedy Actor-Critic (MAGAC), Multi-Agent Soft Actor-Critic (MASAC), and Multi-Agent Truncated Quantile Critics (MATQC). Rather than following the centralized training, decentralized execution (CTDE) paradigm, the proposed framework uses multiple independent actor-critic agents that share a replay buffer while maintaining separate policy and value networks. We evaluate the algorithms on the Platform-v0 and Goal-v0 benchmarks against their single-agent counterparts, using three-, five-, and ten-agent configurations to assess scalability. Performance is measured by average evaluation return and training time across ten independent runs, with one-way ANOVA and Tukey HSD post-hoc tests used to assess statistical significance. Results show that the multi-agent framework consistently improves Greedy Actor-Critic performance, while MASAC and MATQC show comparatively modest gains over their single-agent versions. Increasing the number of agents beyond five yields limited additional performance while substantially raising computational cost, particularly for MAGAC. These results highlight a trade-off between learning performance and computational efficiency, offering insight into the scalability of shared-experience multi-agent actor-critic methods for parameterized action reinforcement learning.
论文详细总结(自动生成)
参数化动作强化学习中多智能体Actor-Critic算法的比较研究
1. 核心问题与研究动机
参数化动作强化学习(Parameterized Action RL)要求智能体同时选择离散动作类型与对应的连续参数,在搜索引擎匹配计划生成等场景中具有重要应用价值。先前工作已验证单智能体Actor-Critic算法(GAC、SAC、TQC)在Platform-v0、Goal-v0等参数化动作基准上的有效性,但向多智能体场景的扩展仍属空白。
本文关注的核心问题是:将单智能体参数化动作Actor-Critic算法扩展到共享经验多智能体框架后,能否持续提升学习性能?增加智能体数量是否会带来线性增益? 研究动机源于现实多智能体协作系统(如自动驾驶、机器人集群、智能电网)对参数化动作决策的需求,以及对算法可扩展性的关切。
2. 方法论
2.1 核心思想
提出一种共享经验多智能体框架(Shared-Experience Multi-Agent Framework),将三种单智能体算法扩展为多智能体变体:
- MAGAC(Multi-Agent Greedy Actor-Critic)
- MASAC(Multi-Agent Soft Actor-Critic)
- MATQC(Multi-Agent Truncated Quantile Critics)
2.2 关键技术细节
架构特点:与主流集中训练、分散执行(CTDE)范式(如MADDPG、QMIX、MAPPO)不同,本框架采用 个独立Actor-Critic智能体,每个智能体拥有独立策略网络与价值网络,但共享一个公共经验回放缓冲区。
动作融合机制(Action Fusion):每个智能体独立产生参数化动作 ( 为离散动作, 为连续参数),通过融合策略 合并为单一可执行动作:
以适配基准环境每步仅接受一个参数化动作的接口。
训练流程:
1. 初始化环境与 个独立Actor-Critic智能体;
2. 每回合各智能体观测状态并独立采样参数化动作;
3. 经动作融合后作用于环境,获得转移元组 ;
4. 转移存入共享回放缓冲区,按底层算法更新各智能体网络参数。
目标函数(以MASAC为例,保留SAC最大熵框架):
其中 为策略熵, 为温度系数;各智能体基于共享缓冲区独立最大化该目标。
3. 实验设计
3.1 基准环境
- Platform-v0:离散动作 + 连续参数(控制移动方向与幅度);
- Goal-v0:参数化目标到达任务。
3.2 对比方法
| 类型 | 算法 |
|---|---|
| 单智能体基线 | GAC、SAC、TQC |
| 多智能体扩展(本文) | MAGAC、MASAC、MATQC |
3.3 评估指标
- 平均评估回报(Average Evaluation Return)
- 平均训练时间(Average Training Time)
- 单因素方差分析(One-Way ANOVA)
- Tukey HSD事后多重比较
4. 资源与算力
- 使用 Microsoft NNI(Neural Network Intelligence) 进行超参数优化;
- 所有算法采用同一代码库实现,仅修改Actor-Critic更新机制以保证公平性;
- 每个算法每次配置运行10次独立试验,使用不同随机种子与权重初始化;
- 每轮训练 5,000 episodes;
- 论文未明确披露所用GPU型号、数量等具体硬件配置,仅报告训练墙钟时间(如Table I、II所示)。
训练时间示例(Goal-v0):
| 算法 | 配置 | 训练时间 |
|---|---|---|
| GAC 基线 | – | 00:24:05 |
| MAGAC | 3 agents | 00:37:49 |
| MAGAC | 5 agents | 01:30:11 |
| MAGAC | 10 agents | 02:55:18 |
5. 实验数量与充分性
5.1 实验规模
- 算法维度:3 单智能体 + 3 多智能体 = 6 种算法;
- 环境维度:2 个基准(Platform-v0、Goal-v0);
- 智能体规模维度:3、5、10 三种配置;
- 统计维度:每种配置10次独立运行;
总实验数约为 次完整训练运行,实验量较为充分。
5.2 公平性与客观性
- 同一代码库、统一超参数配置,避免实现差异引入的偏差;
- 多次独立试验 + ANOVA + Tukey HSD,使结论具备统计稳健性;
- 同时报告回报与训练时间,体现性能-效率权衡。
但实验也存在不足:未在算法内部进行更细粒度的消融(如动作融合策略、消融共享缓冲区等),且仅使用单一随机种子集的结果,未进行超参数敏感性分析。
6. 主要结论与发现
6.1 性能层面
- MAGAC相对GAC基线提升最显著且最一致:在Goal环境从 提升至 (5 agents),Platform环境从 提升至 ;
- MASAC、MATQC相对各自单智能体版本仅有小幅甚至可忽略的增益。
6.2 统计推断
- Goal环境 ANOVA:,,(效应量大);
- Platform环境 ANOVA:,,(效应量极大);
- Tukey HSD:MAGAC 与 MASAC、MATQC 差异均显著(两环境下 );MASAC 与 MATQC 之间无显著差异。
6.3 可扩展性
- 智能体数从 3 → 5 带来小幅提升;
- 从 5 → 10 几乎无额外性能收益,但MAGAC训练时间从 ~1.5h 飙升至 ~6h,计算成本非线性增长;
- 结论:算法选择比单纯增加智能体数更关键,存在明显的性能-效率权衡。
7. 优点
1. 填补研究空白:首次系统比较三种主流Actor-Critic算法在参数化动作空间的多智能体扩展;
2. 控制变量严谨:同代码库、统一超参数、独立多次运行、严格统计检验,可复现性强;
3. 指标全面:同时报告学习性能与计算开销,避免单一指标带来的误导;
4. 明确方法定位:清晰区分"共享经验多智能体"与"完整CTDE",避免概念混淆;
5. 效应量报告:除 值外给出 ,便于评估实际差异重要性。
8. 不足与局限
1. 非完整CTDE:缺乏中心化评论家与联合观测/动作建模,理论上无法处理需要强协调的任务;
2. 环境单一:仅在两个toy级参数化动作基准上评估,未在更复杂的多智能体协作环境(如SMAC、MAMuJoCo)中验证泛化性;
3. 动作融合策略未深入研究:融合算子 的设计选择(平均、投票、注意力等)缺乏消融实验;
4. 智能体规模跨度有限:仅测试 3/5/10 三档,未探索更细粒度的可扩展性曲线;
5. 算力信息不透明:未报告GPU型号、能耗等,难以评估实际部署可行性;
6. 缺乏基准对比:未与完整CTDE方法(如MADDPG、QMIX、MAPPO)在参数化动作空间下的直接对比,难以判断所提框架相对主流MARL方法的优劣;
7. 目标应用(搜索引擎匹配计划)缺失:虽动机来自match plan生成,但实验中未在真实搜索系统上进行端到端验证,工程价值有待进一步检验;
8. 协作信号缺失:智能体间缺乏显式通信或参数共享机制,对真正需要紧密协作的多智能体任务可能效果有限。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。