
揪出搭便车者:基于Shapley值的并行推理强化学习奖励归因
Fishing Out Free Riders: Shapley-Based Reward Attribution for Parallel Reasoning via Reinforcement Learning
📝 TLDR
大语言模型多路径并行推理时,现有方法对所有路径统一分配结局奖励,无法区分有益路径与冗余甚至有害路径,导致训练信号模糊。本文提出Parallel Shapley强化学习框架,将每条推理路径视作合作博弈参与者,利用Shapley值量化路径的边际贡献,以生成式奖励模型评估效用并通过蒙特卡洛采样高效近似。在数学推理基准上的实验表明,该方法优于现有基线,训练更稳定且奖励分配更具可解释性,有效识别并消除"搭便车"路径。
🧭 速览
统一结局奖励无法区分多路径推理中有益路径与冗余甚至有害路径,造成学习信号模糊与训练不稳定。
将每条路径视作合作博弈参与者,以Shapley值量化边际贡献,结合生成式奖励模型评估效用与蒙特卡洛采样近似。
在数学推理基准上超越现有基线,训练过程更稳定,奖励按路径贡献比例分配且可解释。
Shapley细粒度归因有效识别"搭便车"路径并按贡献分配奖励,提升LLM多路径并行推理质量。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
本文提出 Parallel Shapley 框架,解决大语言模型并行推理时奖励分配模糊的问题。核心思路是将每条推理路径视为合作博弈中的参与者,用 [[Shapley值]] 量化其边际贡献,配合生成式奖励模型和 [[蒙特卡洛采样]] 高效近似计算。在数学推理基准上的实验显示,该方法在性能、稳定性和可解释性上均优于基线,能有效识别并惩罚"搭便车"路径。
研究背景与动机
大语言模型在复杂推理任务中展现出强大能力,但单次推理往往难以保证正确答案。为此,研究者普遍采用多路径并行推理策略:让模型同时生成多条推理路径,再通过投票或加权平均等方式汇总结果。这种方式确实能提升整体准确率,却在训练阶段遇到了一个棘手的问题——如何公正地将最终结果的质量归因到每一条路径上?
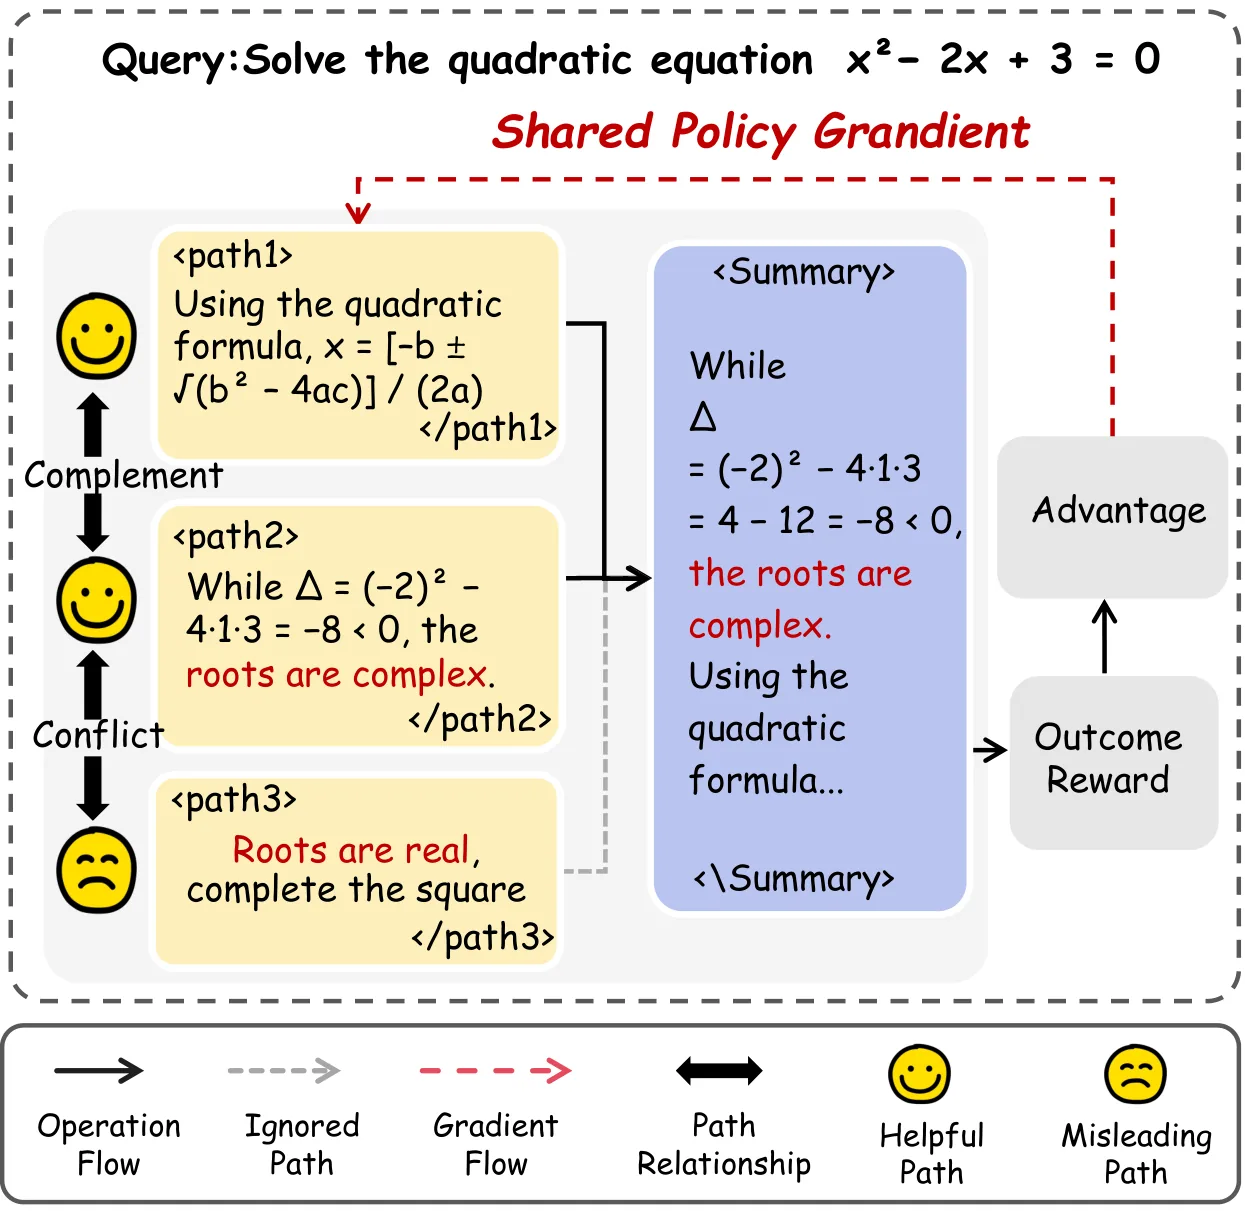
传统做法是结果级别的奖励分配:只要最终答案正确,所有路径都获得正向奖励;答案错误则全部受罚。这种"一荣俱荣、一损俱损"的机制存在明显缺陷。假设模型生成了三条路径,其中两条提供了正确但冗余的推理步骤,第三条则给出了看似合理实则误导的结论,最终恰好凑出正确答案。按照现有机制,三条路径获得的奖励完全相同,第三条"搭便车"路径不仅没有受到惩罚,反而因为偶然的正确结果获得了强化。长此以往,模型会逐渐倾向于生成这类表面正确但经不起推敲的推理链,损害了真正有益路径的竞争力。
更深层的问题在于训练信号的模糊性。当所有路径共享同一个奖励值时,[[强化学习]] 算法难以区分哪些路径值得保留、哪些应该淘汰。信号噪声大导致梯度估计方差高,训练过程不稳定,收敛速度慢。这种奖励分配机制本质上是一种粗糙的粗粒度归因,忽略了推理过程中各路径的独立价值。
方法
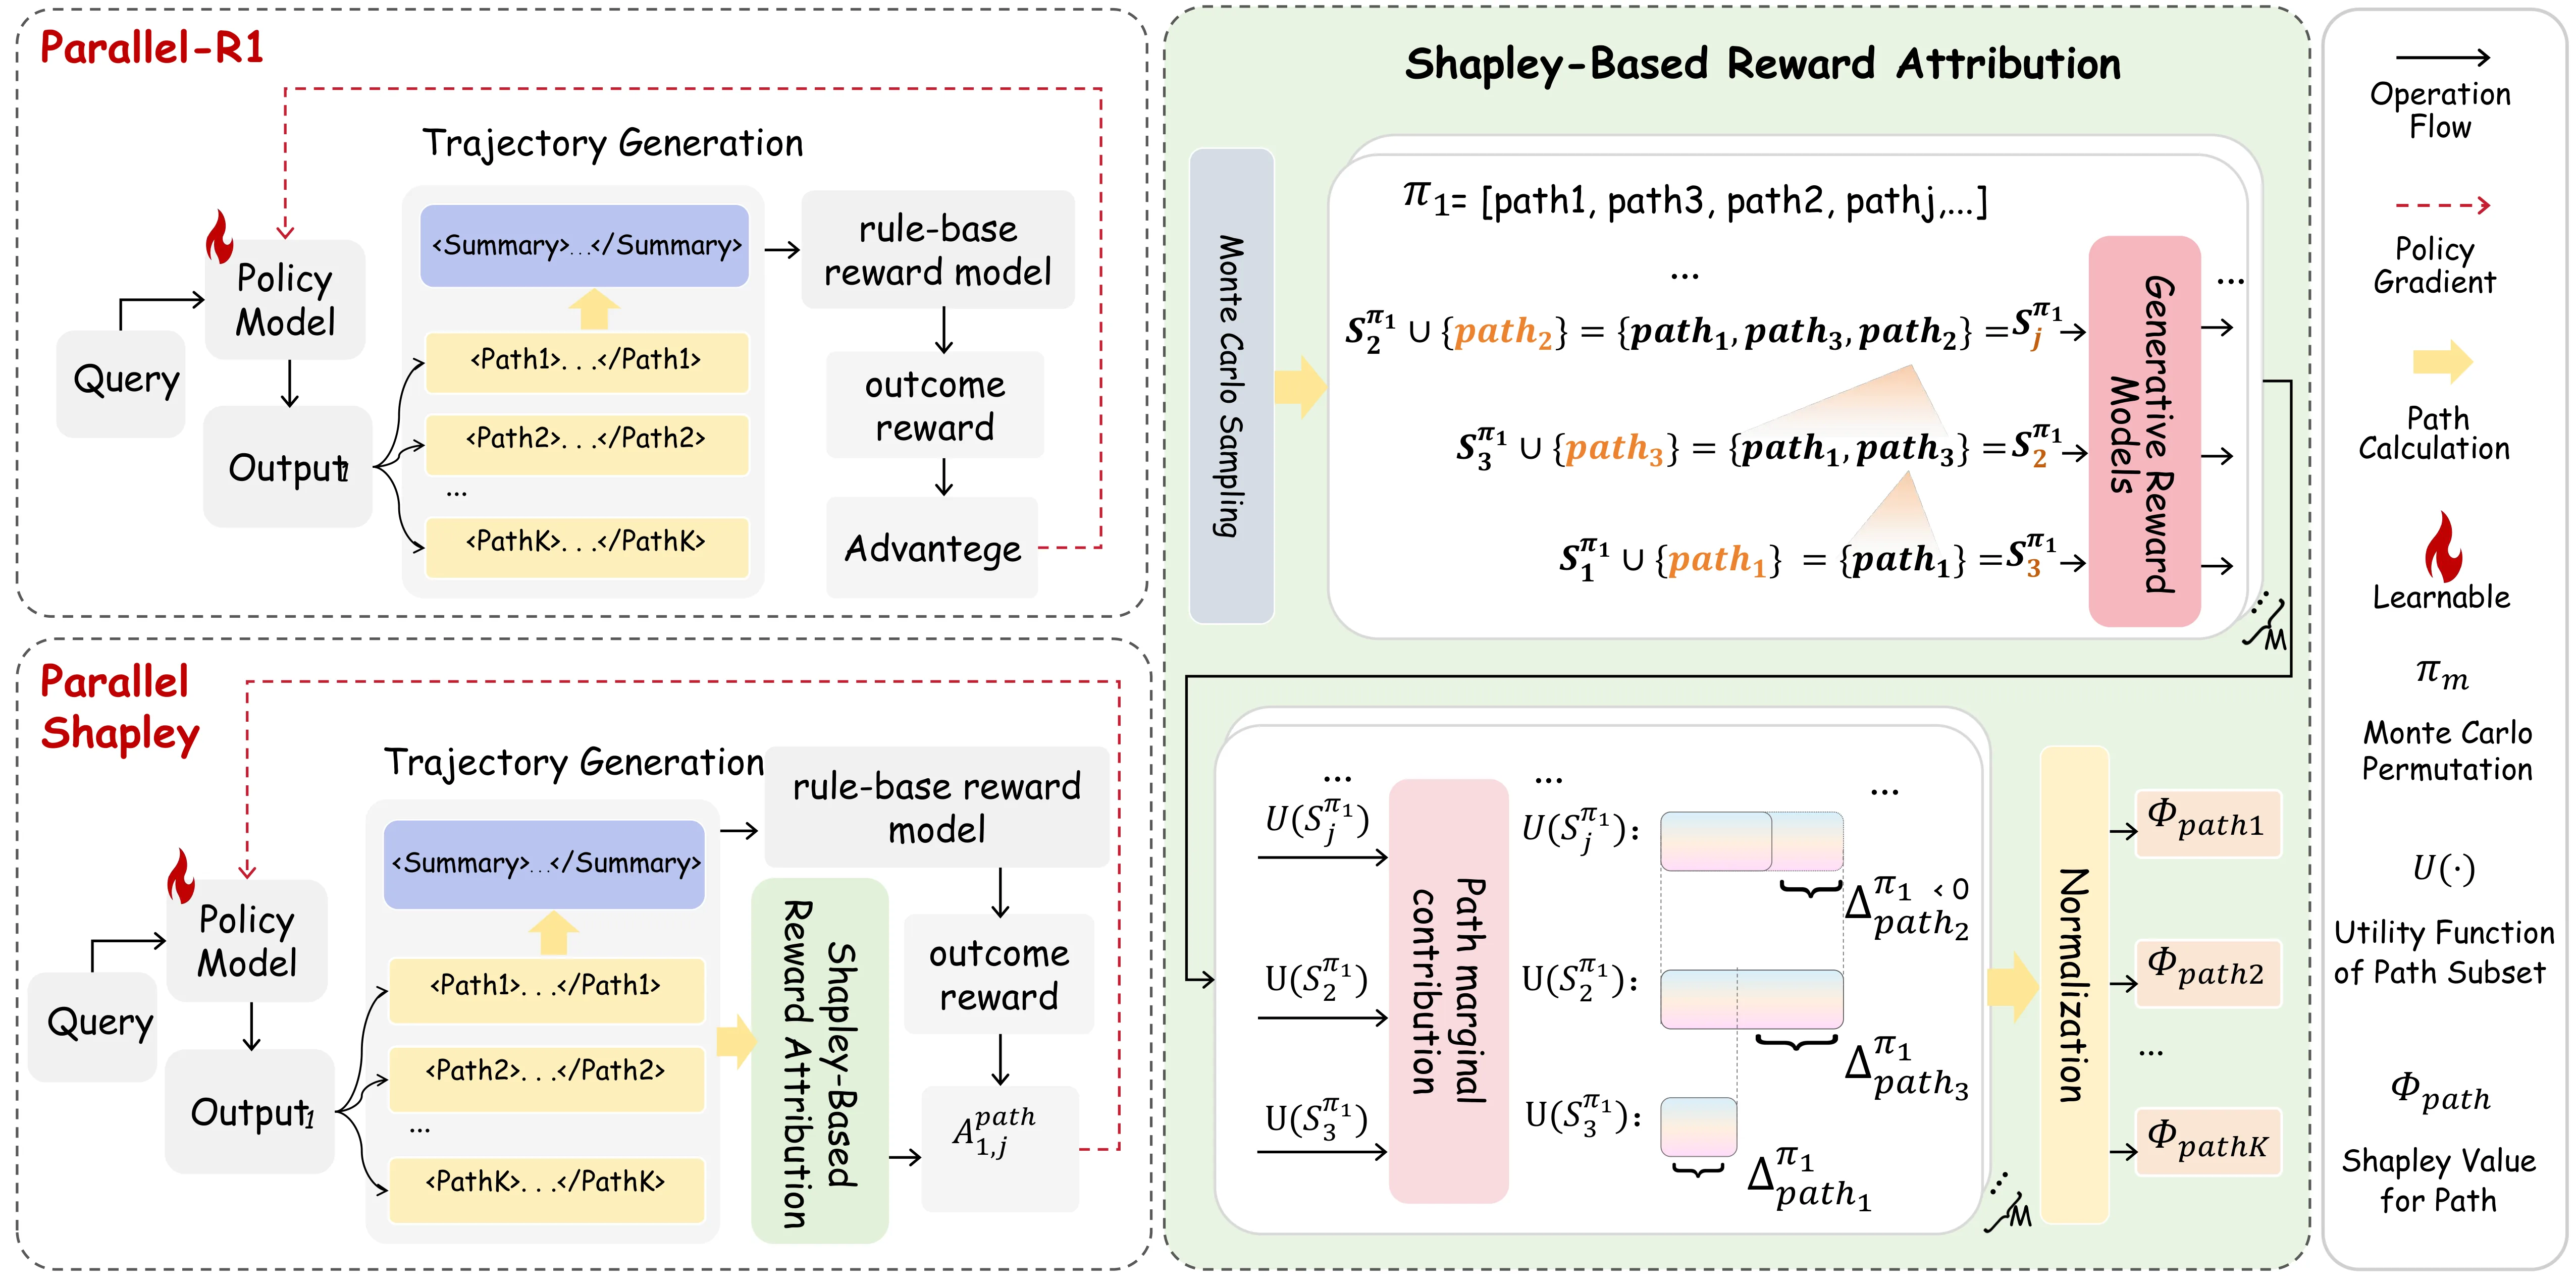
Parallel Shapley 的核心洞察是:将并行推理建模为合作博弈问题。每条推理路径是一个"参与者",最终任务成功是"联盟收益",需要一种公平、原则明确的方式来分配这笔收益。这个问题在博弈论中已有成熟解法——[[Shapley值]]。
Shapley值的数学定义为:对于参与集合 中的参与者 ,其 Shapley 值为所有可能联盟下该参与者边际贡献的期望:
其中 是联盟效用函数,衡量给定路径子集能达到的最终效果。这个公式的美妙之处在于它满足四个优良性质:效率性(所有参与者贡献之和等于总收益)、对称性(参与顺序不影响最终值)、虚拟性(不贡献任何边际价值的参与者获得零值)和可加性。这些性质恰好对应了我们对"公平奖励分配"的直觉期待。
然而,直接计算 Shapley 值面临组合爆炸问题:路径数为 时需要枚举 个联盟,这在实际应用中完全不可行。本文采用 [[蒙特卡洛采样]] 近似计算:通过随机采样路径子集估计边际贡献的期望值。采样过程可以增量进行,随时终止而不会产生完全错误的估计,这为实际部署提供了灵活性。
框架的另一个关键设计是生成式奖励模型。传统方法需要为每个中间推理状态人工标注奖励,成本极高。本文训练一个轻量级的奖励模型,能够直接评估任意路径的效用值 。该模型接收路径集合和任务描述,输出一个连续分数作为效用估计。这种设计将奖励信号的获取从人工标注转向模型学习,大幅提升了可扩展性。
完整流程如下:首先并行采样得到 条推理路径;然后从空集开始,依次加入路径并计算效用变化,每次加入通过蒙特卡洛采样估计 Shapley 增量;最后按各路径的 Shapley 值比例分配最终奖励。值得注意的是,当某条路径单独贡献为零或为负时,其 Shapley 值会自动为负,实现了对有害路径的自动惩罚和淘汰。
实验与结果
实验在数学推理基准上进行,包括 GSM8K、MATH 等标准评测集。基线方法涵盖结果奖励(Outcome Reward)、加权投票(Weighted Voting)以及无奖励归因的朴素多路径采样。
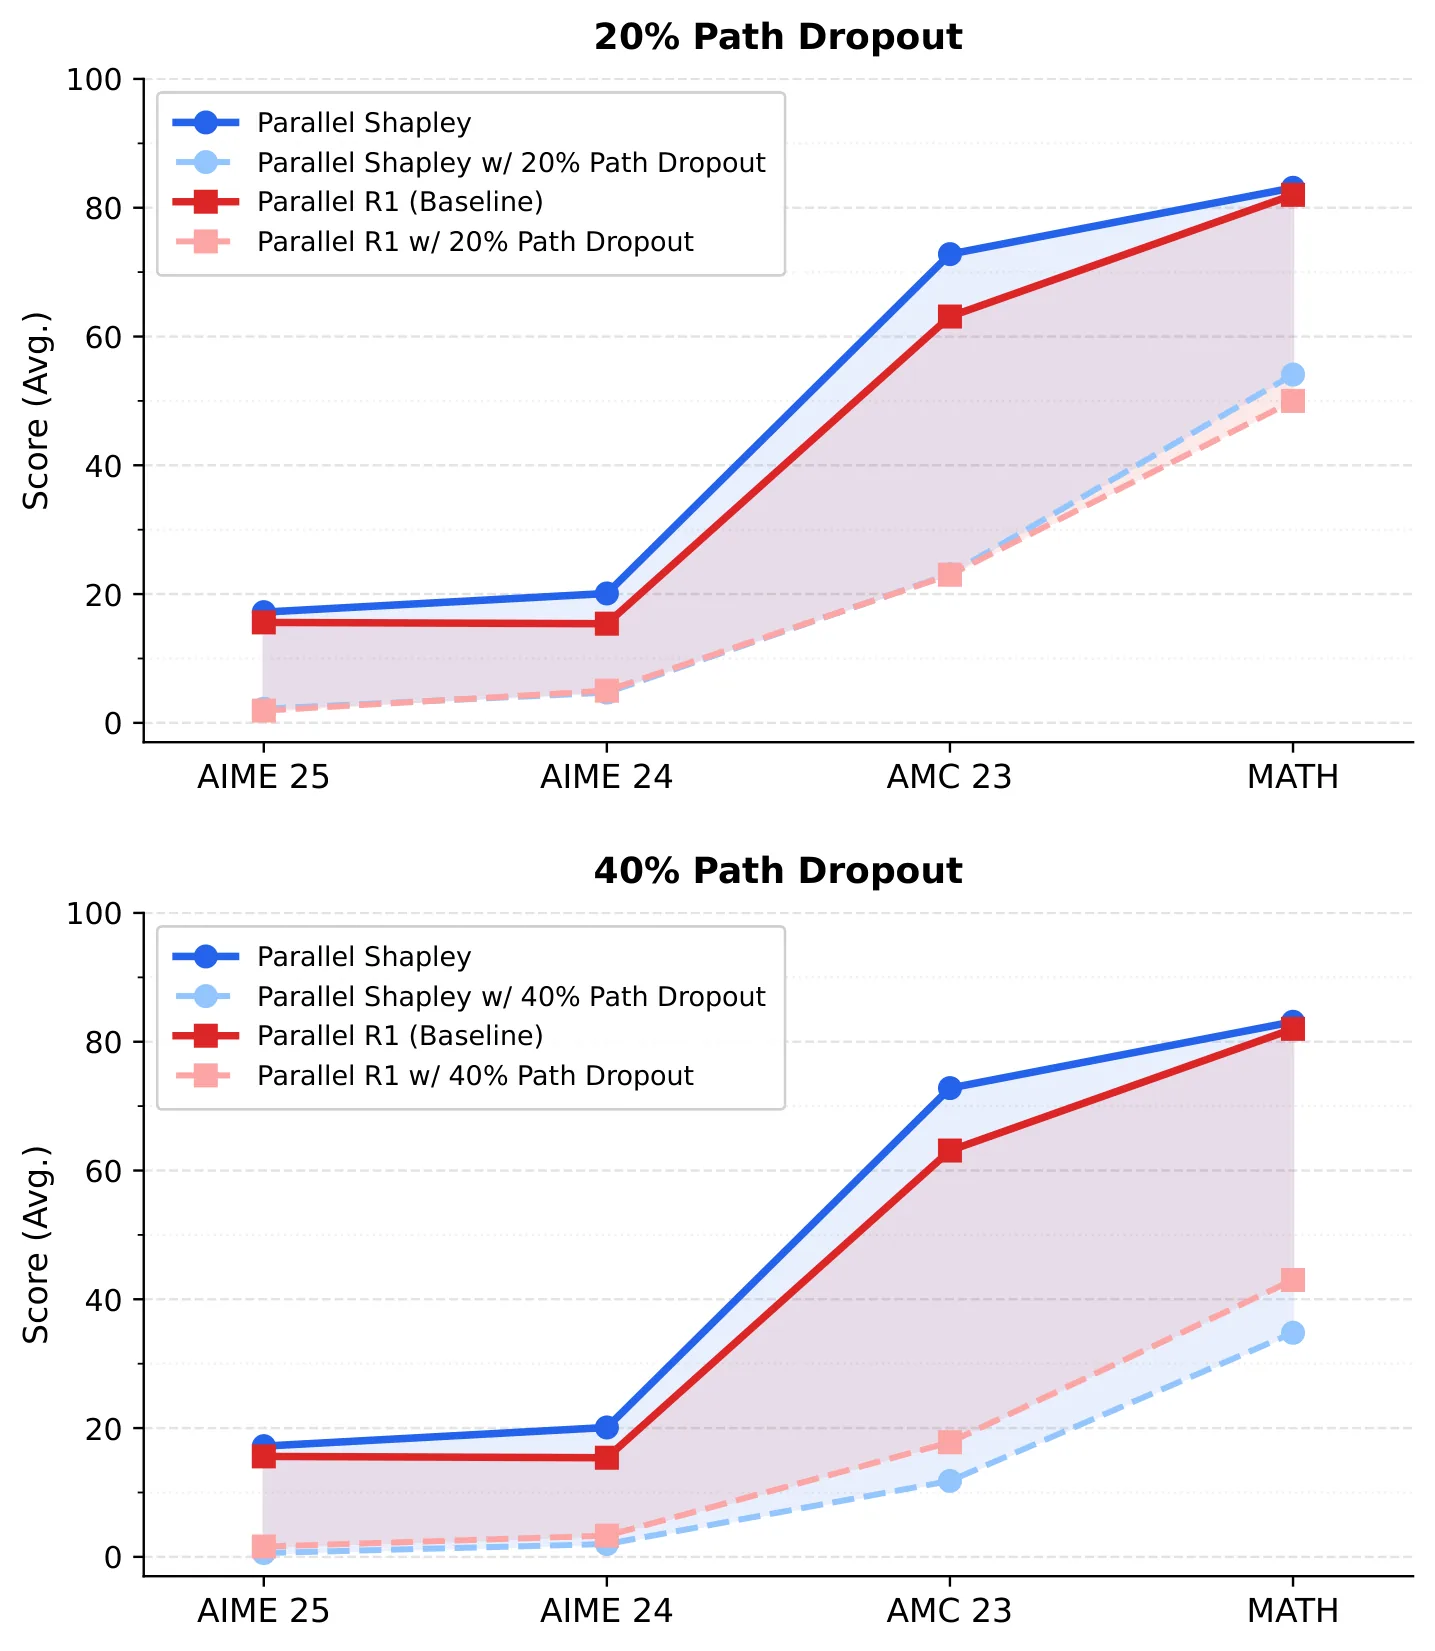
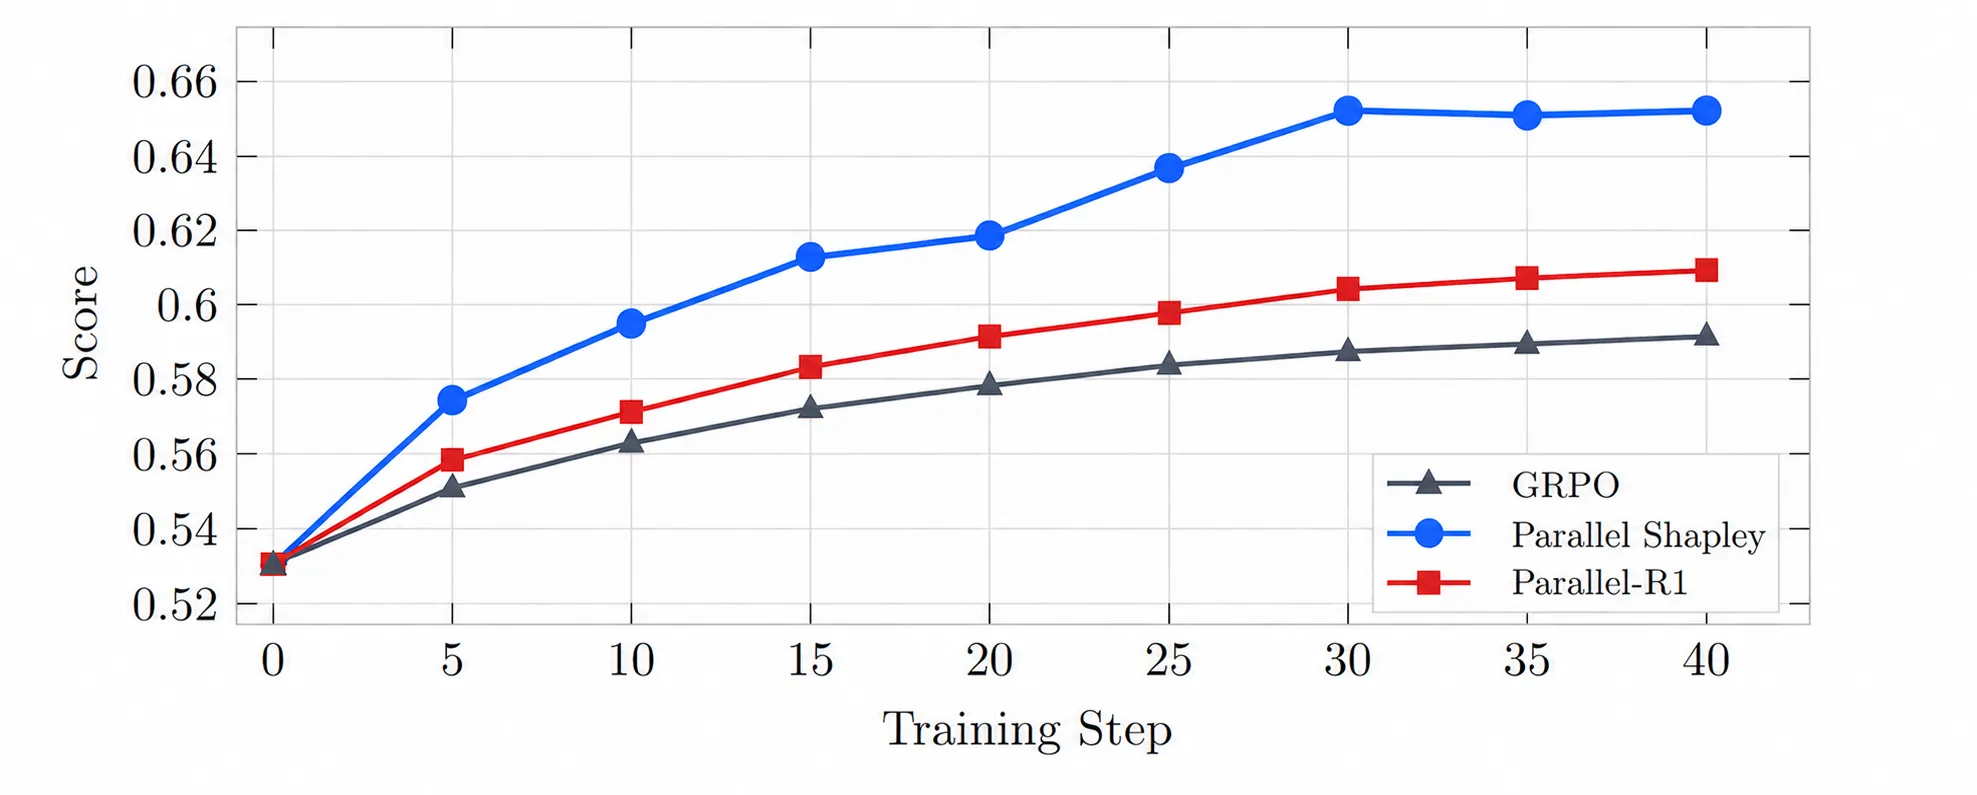
主要结果呈现出三方面优势。性能方面,Parallel Shapley 在各基准上均取得最高准确率,相比结果奖励基线提升约 3-5 个百分点。训练稳定性方面,通过 Shapley 值归因后的梯度估计方差显著降低,表现为训练曲线更平滑、收敛轮次更少。可解释性方面,研究者可以直接观察每条路径的 Shapley 值分布,量化识别出搭便车路径的比例。消融实验进一步表明,蒙特卡洛采样的采样数量与最终性能存在帕累托权衡,在计算预算有限时存在最优采样深度。
特别值得注意的发现是,搭便车路径的比例与任务难度正相关。在简单题目上,几乎所有路径都贡献了实质内容;而在难题上,冗余和误导路径的比例明显上升,Shapley 归因的价值更为突出。这说明越是复杂的推理任务,越需要一个精细的奖励分配机制。
讨论与可借鉴点
Parallel Shapley 的贡献不仅在于提出了一种具体算法,更在于引入了合作博弈视角重新审视 [[奖励归因]] 问题。这种思维方式的转换值得借鉴:当我们发现某个系统中存在贡献难以量化的问题时,不妨从博弈论、因果推断等邻近领域寻找现成的数学工具。
框架的局限也值得正视。首先,蒙特卡洛近似的方差虽然可控,但计算量仍然随路径数线性增长,极大规模并行推理时可能成为瓶颈。其次,生成式奖励模型的训练依赖有标注数据,质量直接影响最终效果。第三,当前框架假设路径之间可以交换顺序(Shapley 值的对称性假设),但某些推理场景中路径的时序关系可能携带重要信息。
未来的探索方向包括:将 Shapley 值与过程奖励结合,实现细粒度到推理步骤级别的归因;探索基于低秩近似的解析计算,避免蒙特卡洛采样;将框架扩展到多智能体协作场景,其中参与者不仅是推理路径,而是多个模型实例。
这篇论文提醒我们,在追求模型能力提升的同时,不应忽视训练信号的质量问题。一个设计良好的归因机制,能够让有限的训练数据发挥更大价值,让模型更有效地学习真正有益的行为模式。
摘要
大型语言模型(LLMs)在多步推理任务中表现优异,但现有的并行推理方法往往难以区分各条推理路径的独立贡献。许多路径可能存在冗余、误导甚至有害的问题,而基于结果级别的奖励分配机制对所有路径施加统一的奖励信号,导致学习信号模糊和训练过程不稳定。我们提出了Parallel Shapley——一种在多路径推理中对路径级贡献进行细粒度归因的强化学习框架。该方法将每条路径视为合作博弈中的参与者,利用Shapley值量化其边际贡献,并采用生成式奖励模型评估路径效用,借助蒙特卡洛采样实现高效近似。在数学推理基准上的实验结果表明,Parallel Shapley不仅优于现有基线方法,还能提供更加稳定且可解释的训练过程。该框架能够有效"揪出搭便车者",按贡献比例分配奖励,从而提升LLMs的多路径推理能力。
Abstract
Large Language Models (LLMs) excel at multi-step reasoning, yet current parallel reasoning approaches often fail to distinguish the contributions of individual reasoning paths. Many paths may be redundant, misleading, or even detrimental, but outcome-level rewards assign uniform reward, leading to ambiguous learning signals and unstable training. We propose Parallel Shapley, a reinforcement learning framework that attributes fine-grained, path-level contributions in multi-path reasoning. Treating each path as a player in a cooperative game, we leverage Shapley values to quantify marginal contributions, using a generative reward model to evaluate path utilities and Monte Carlo sampling for efficient approximation. Experiments on mathematical reasoning benchmarks show that Parallel Shapley outperforms existing baselines while providing more stable and interpretable training. Our framework effectively "fishes out the free riders," assigning reward proportionally and improving multi-path reasoning in LLMs.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。