
打破反馈盲区:面向序贯决策的效用增强 Transformer
Breaking Feedback-Blindness: Utility-Augmented Transformer for Sequential Decision Making
📝 TLDR
在非平稳部分可观测环境中,隐式状态切换要求模型快速适应。现有Transformer决策模型的注意力检索主要依赖观测相似性,无法区分观测等价但反馈不同的历史,形成反馈盲瓶颈。本文提出UAT,通过紧凑效用状态调制Q/K/V投影实现反馈条件检索,并具备零门控退化性质。理论证明严格扩展了仅观测Transformer类,四个非平稳基准上一致超越基线,噪声场景增益尤为显著。
🧭 速览
现有Transformer决策模型的注意力检索由观测相似性驱动,反馈信息无法改变上下文检索,形成反馈盲结构瓶颈。
UAT将紧凑效用状态注入Q/K/V投影,构建反馈条件检索注意力,并支持零门控退化为标准Transformer。
在合成导航、脓毒症、资产配置和延迟反馈推荐四个非平稳任务上均优于观测基线、测试时适应和输入级反馈方法。
证明UAT严格扩大了仅观测Transformer的函数类,可一致逼近反馈依赖决策图。
🆚 方法对比
Utility-Augmented Transformer (UAT)
- 反馈直接调节Q/K/V投影,突破检索盲区
- 零门控时严格退化为Vanilla Transformer
- 理论上严格扩大可表达的决策函数类
- 在四个非平稳基准上均优于各类基线方法
- 依赖效用编码器对动作-奖励对的压缩质量
- 有限视野紧致性等理论假设限制适用范围
- 调制通路增加计算开销,推理效率待验证
- 在反馈较弱场景下边界分析显示性能下降
Decision Transformer (DT) 及其变体
- 将强化学习重构为序列建模问题,简单直观
- 可处理中等规模的状态-动作-奖励序列
- 无需在线交互训练,直接利用离线数据
- 将奖励作为输入token,但检索核仍固定不变
- 对观测相同但反馈不同的历史无法区分
- 在非平稳部分可观测环境中次优选择问题严重
- 反馈与观测共享同一双线性检索通路
Observation-only Attention 基线
- 仅基于观测特征,结构简单实现成熟
- 对纯观测驱动的任务具有竞争力
- 无需额外反馈输入,计算开销低
- 前向检索对反馈不变,结构性盲区
- 无法区分观测等价但反馈不同的历史
- 在反馈信息性任务上必然次优,理论可证
Test-time Adaptation 方法
- 可在推理阶段更新参数以反映新反馈
- 具有一定的环境自适应能力
- 适用于分布漂移场景
- 参数更新在推理时冻结,检索状态仍盲
- 推理阶段计算开销显著增加
- 无法在单次前向传递内利用反馈
Gradient-based RL 训练方法
- 利用奖励梯度直接优化策略
- 训练信号丰富,理论上可学习复杂策略
- 在标准RL基准上已验证有效
- 训练信号无法改变冻结前向的检索核
- 反馈信息在推理时无法直接参与检索
- 对部分可观测非平稳环境适应性有限
Input-level Feedback 基线
- 简单地将动作-奖励拼接为额外token
- 易于实现,与现有架构兼容性好
- 保留了Transformer的序列建模能力
- 仅作为额外输入,不改变投影算子本身
- 反馈与观测共享同一检索通路,无结构性改进
- 在反馈-观测交互任务上区分能力不足
UAT通过让效用状态直接调制Q/K/V投影,从结构上突破了观测仅基线、DT变体、测试时自适应及梯度RL等方法固有的反馈盲检索瓶颈,在保持零门控退化的同时严格扩大了可表达的决策函数类。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
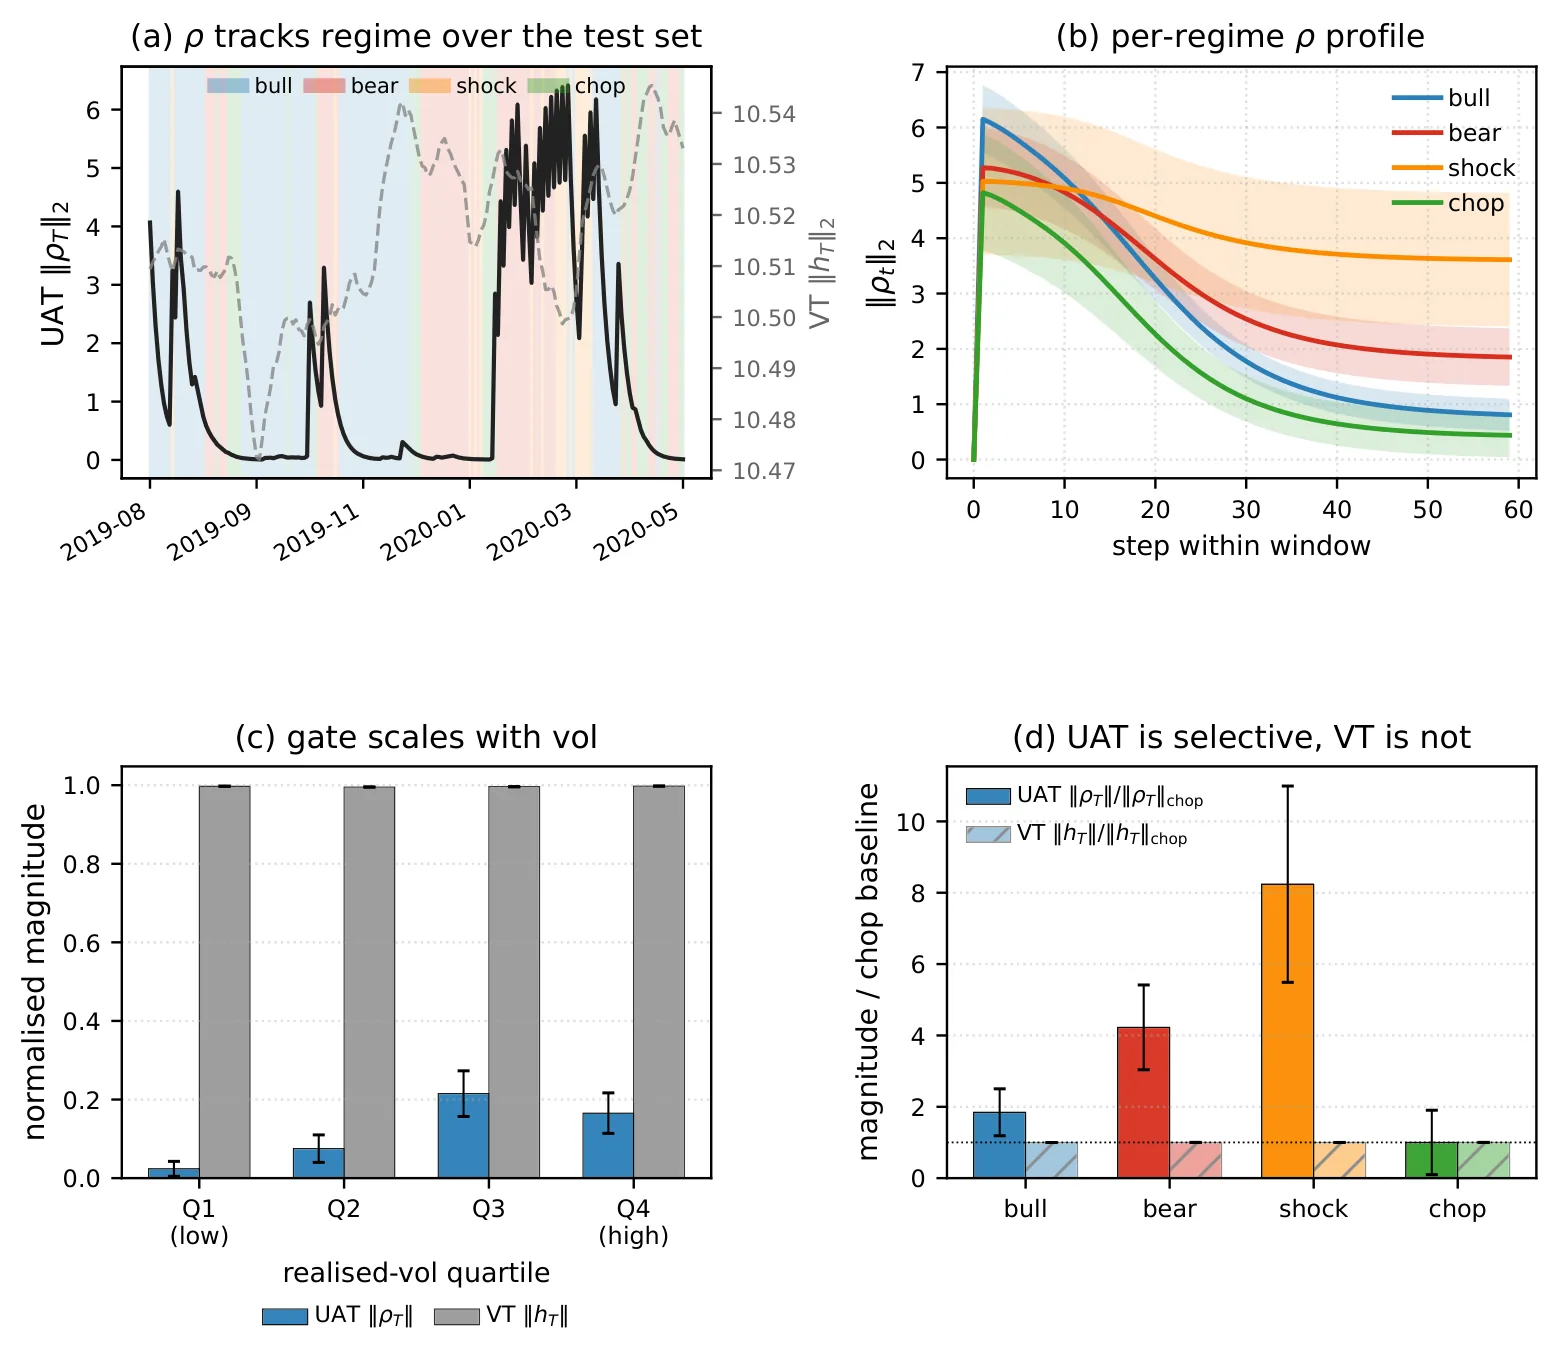
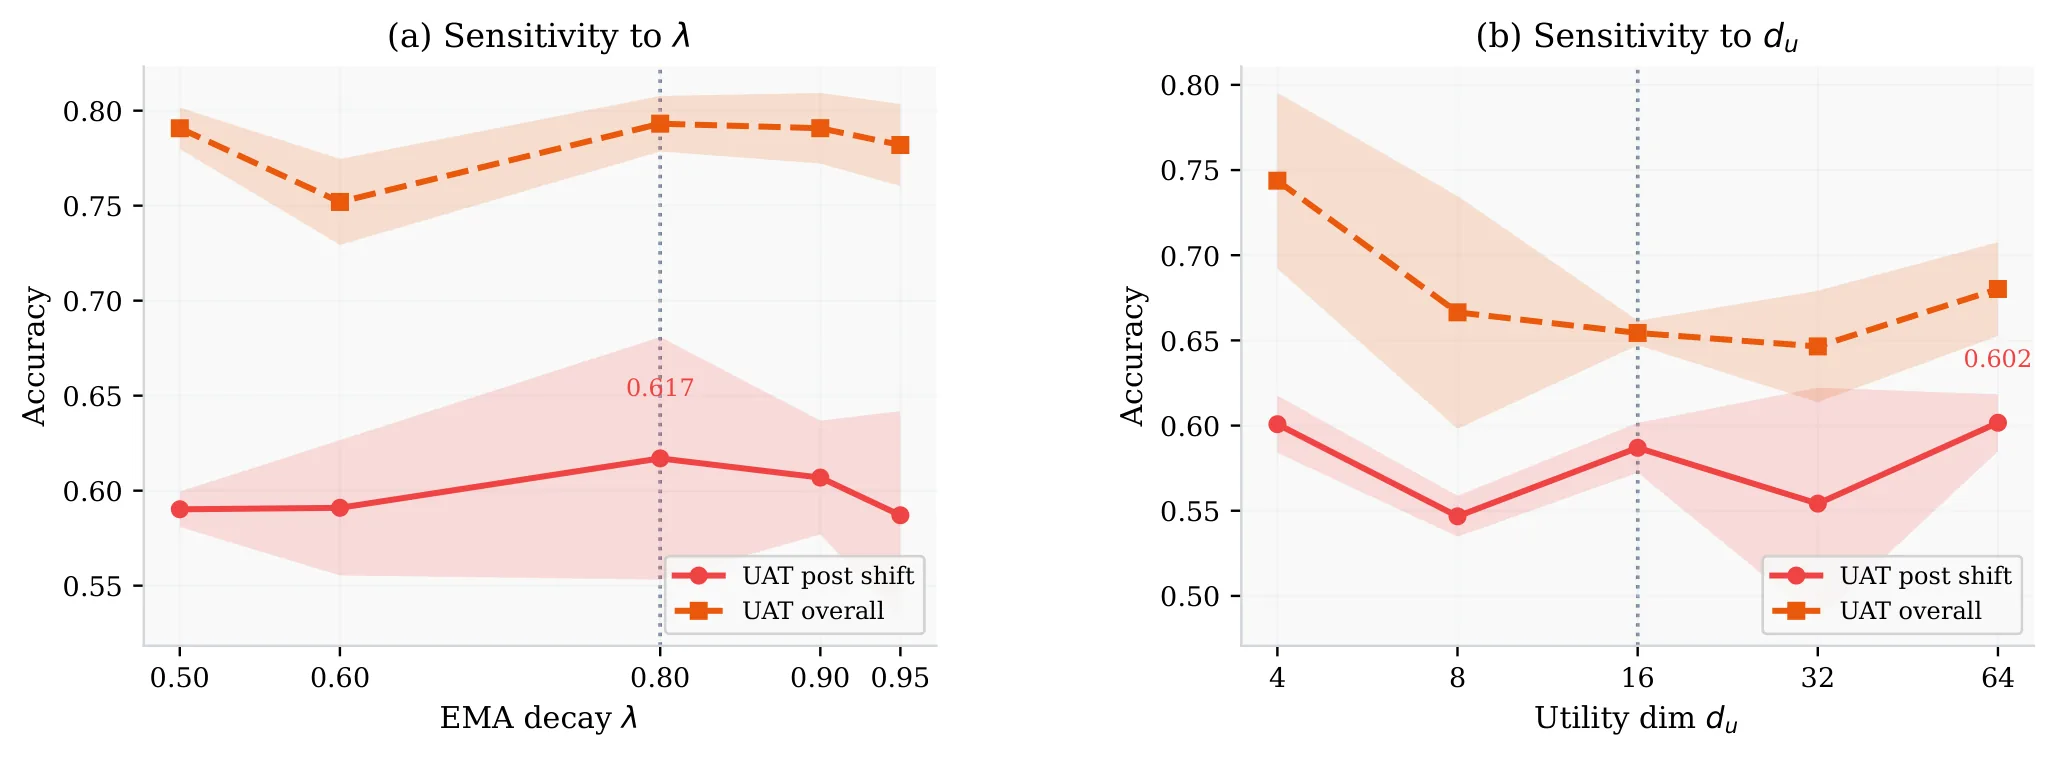
TL;DR
这篇论文发现了一个被长期忽视的结构性缺陷:现有的 Transformer 决策模型在检索历史信息时,主要依赖观测相似性而非反馈信息,即便把奖励作为输入 token 也无法改变这一点——这被称为「反馈盲检索」。为解决这一问题,论文提出了效用增强 Transformer(UAT),通过一个紧凑的效用状态直接调制注意力中的查询、键、值投影,使动作-奖励历史能够在前向传播过程中直接改变上下文检索。理论证明 UAT 严格扩展了仅基于观测的 Transformer 表达能力,在四个非平稳环境的基准测试中一致超越基线方法,尤其在噪声较大的高适应需求场景下优势显著。
研究背景与动机
在现实世界的序贯决策问题中,环境往往是非平稳的——潜在的规则或目标会随着时间悄然切换。以医疗场景为例,败血症病人的生理状态可能在治疗过程中发生隐式转变,表现为对药物反应的突然改变;在金融市场中,资产间的相关性可能因政策或黑天鹅事件而发生结构性漂移;在推荐系统中,用户的兴趣偏好可能随时发生隐性转移。这类问题的共同特征是:智能体只能观测到部分信息(部分可观测),而环境的真实状态切换是隐式的,要求模型具备快速适应能力。
一种直观的解决思路是利用历史经验中的反馈信息(奖励信号)来识别状态切换——如果近期的奖励模式发生了显著变化,往往暗示着环境结构发生了改变。然而,这篇论文的核心发现是:现有 Transformer 决策模型中存在一个结构性的「反馈盲区」。即使将奖励作为额外的输入 token 暴露给模型,或者在训练时使用奖励损失,模型的注意力检索机制本质上仍然由观测驱动的相似性主导。换言之,奖励信息虽然在训练损失中可见,但无法有效影响检索过程本身。
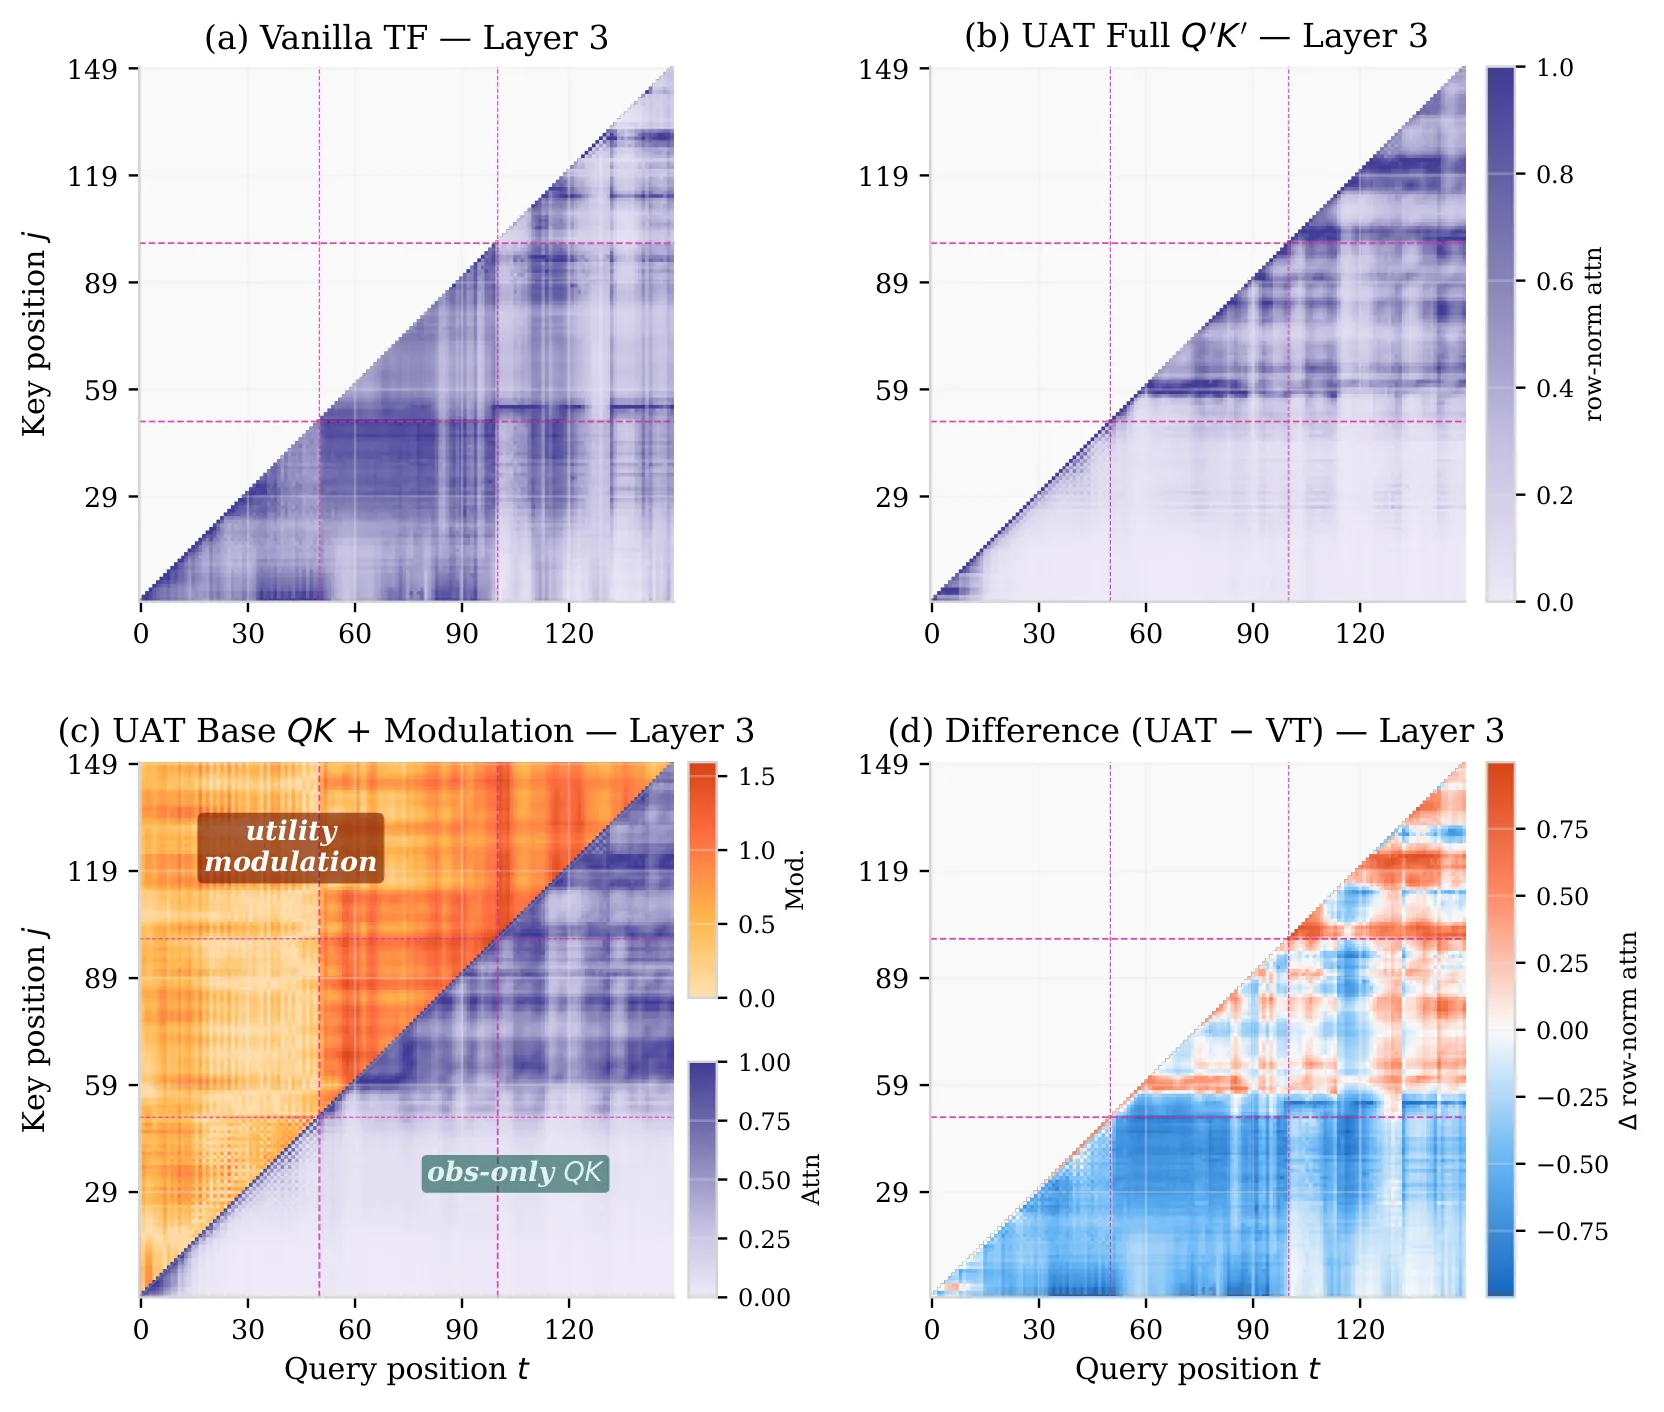
论文将这一现象形式化为「反馈盲检索」(feedback-blind retrieval),并给出了一个令人警醒的严格证明:在反馈有效(即奖励与最优动作存在相关性)的任务上,任何仅基于观测的注意力机制都无法区分具有不同动作-奖励结果的观测等价历史。这意味着无论模型看到多少次奖励信号,只要注意力检索只依赖观测内容,同一观测序列背后可能隐藏的不同环境状态就无法被区分,导致模型做出次优甚至错误的决策。
这一发现揭示了现有方法的根本性局限,也为后续的方法设计指明了方向:必须从注意力检索的内部机制入手,让反馈信息直接调控检索过程,而不是仅仅作为辅助输入。
方法
解决反馈盲检索的关键挑战在于:如何在不破坏 Transformer 原有高效计算结构的前提下,让动作-奖励历史直接改变注意力检索的内容?论文提出的核心思路是「效用状态调制」(utility state modulation),其设计灵感来源于对标准注意力机制的重新审视。
在标准 Transformer 中,注意力计算的查询(Query)、键(Key)、值(Value)投影矩阵是固定的,仅由观测内容决定。要让反馈信息影响检索,一个朴素的做法是直接把奖励也作为 token 输入——但论文已经证明这种方法存在根本性的盲区问题。另一个思路是引入额外的门控机制来动态调节投影,但这类方法通常引入非线性门控参数,增加了训练难度,且难以保证在反馈无效时退化为标准模型。
UAT 的设计采用了更为优雅的方案:引入一个紧凑的效用状态向量(compact utility state),将其作为线性调制项作用于 、、 的投影变换。具体而言,假设效用状态为 ,其维度远小于嵌入维度 ,那么经过效用调制后的投影可以写作:
其中 是标准的可学习投影矩阵, 是将效用状态映射到投影空间的线性变换矩阵。注意 本身并非直接取自原始奖励,而是一个基于动作-奖励历史动态更新的低维状态表示。这种设计带来了几个关键优势:
第一,反馈信息的影响是「内在的」而非「外在的」——效用状态通过线性调制直接改变投影空间的结构,使得奖励信息能够在注意力计算的核心环节发挥作用,而非仅仅作为附加的 token 被忽略。第二,效用状态被约束在低维空间(远小于嵌入维度 ),这确保了额外的计算开销极小,不会显著增加参数量和推理延迟。第三,论文严格证明了一个重要的性质——「零门控退化」:当反馈信息完全无效(即效用状态恒为零)时,UAT 精确退化为标准 Transformer,这保证了方法不会在原有方法有效的场景下引入性能损失。
效用状态本身的更新机制也经过精心设计。论文采用了基于移动窗口的递归更新方式,在每个时间步整合最新的动作-奖励信息,同时通过遗忘机制排除过时反馈的干扰。这种设计使得效用状态能够高效地追踪近期的反馈模式,为注意力检索提供动态的情境信息。
在理论层面,论文在有限期紧致性与 Lipschitz 假设下证明了两项核心结论:其一,UAT 严格扩展了仅基于观测的 Transformer 表达能力类,即存在 UAT 可以精确表示、而任何仅观测 Transformer 都无法表示的决策映射;其二,UAT 能够一致逼近任意依赖反馈的决策映射函数。这两项结果从表达能力上确立了 UAT 的理论优势:它既保留了原有方法的全部能力,又解锁了原本不可表达的反馈依赖决策策略。
实验与结果
论文在四个精心设计的非平稳基准上进行了系统性的实验验证,这些基准涵盖了不同的应用领域和难度层次,能够全面评估方法在隐式状态切换场景下的适应能力。
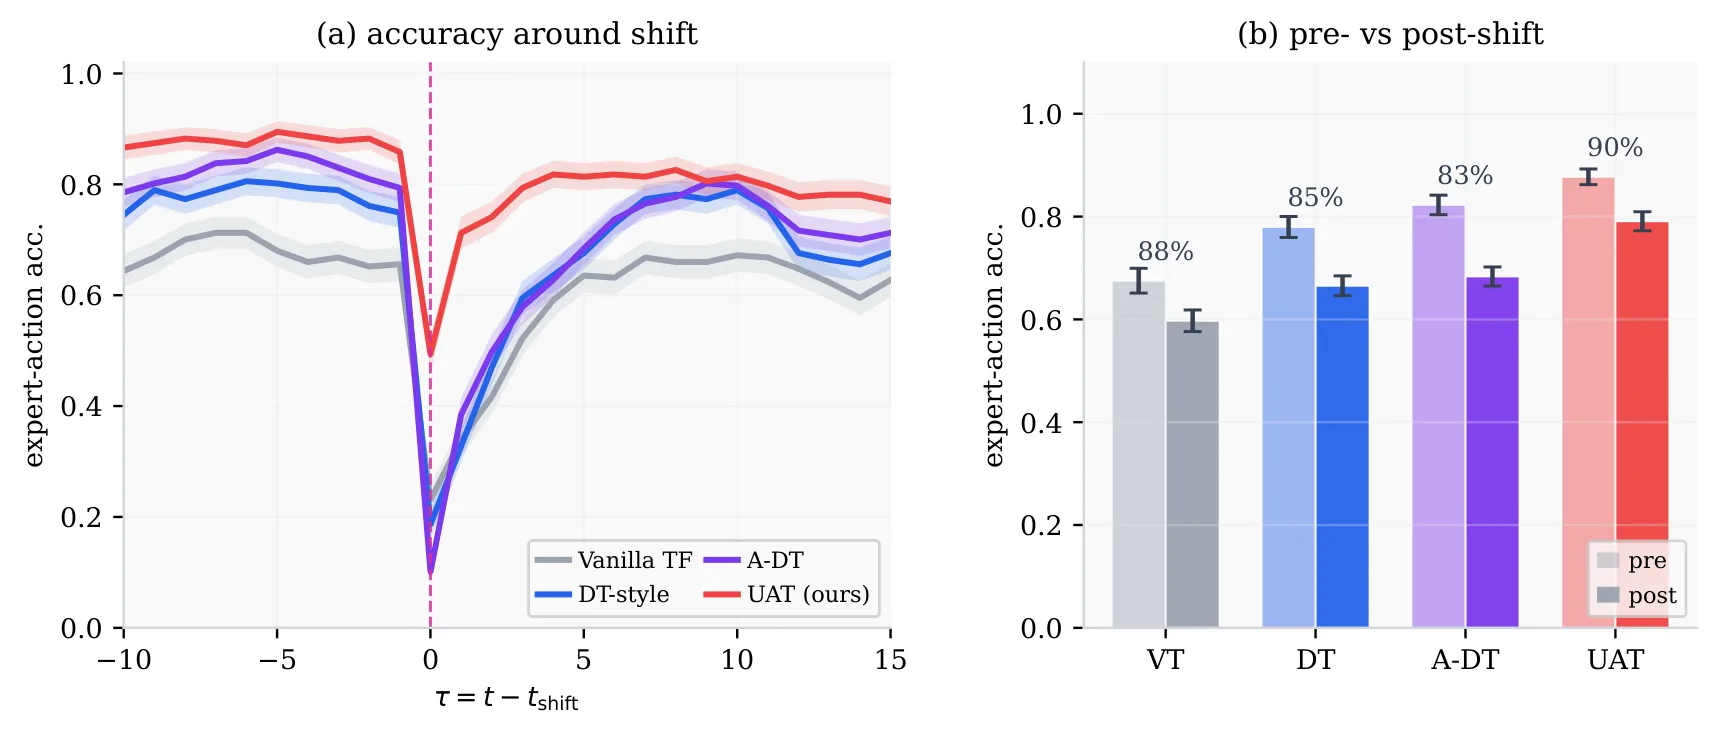
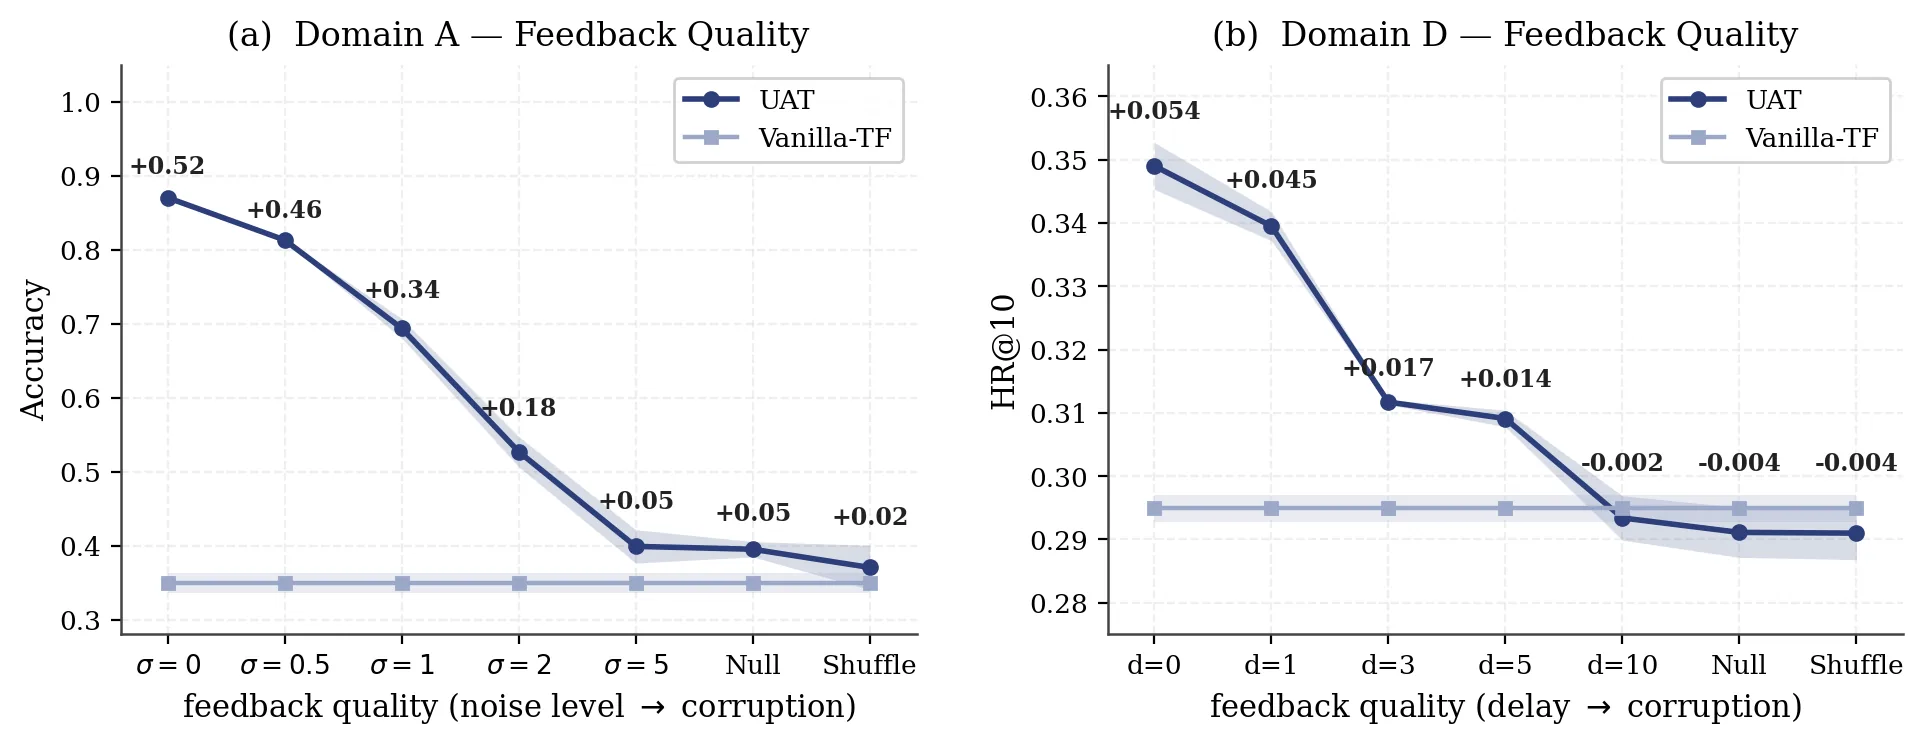
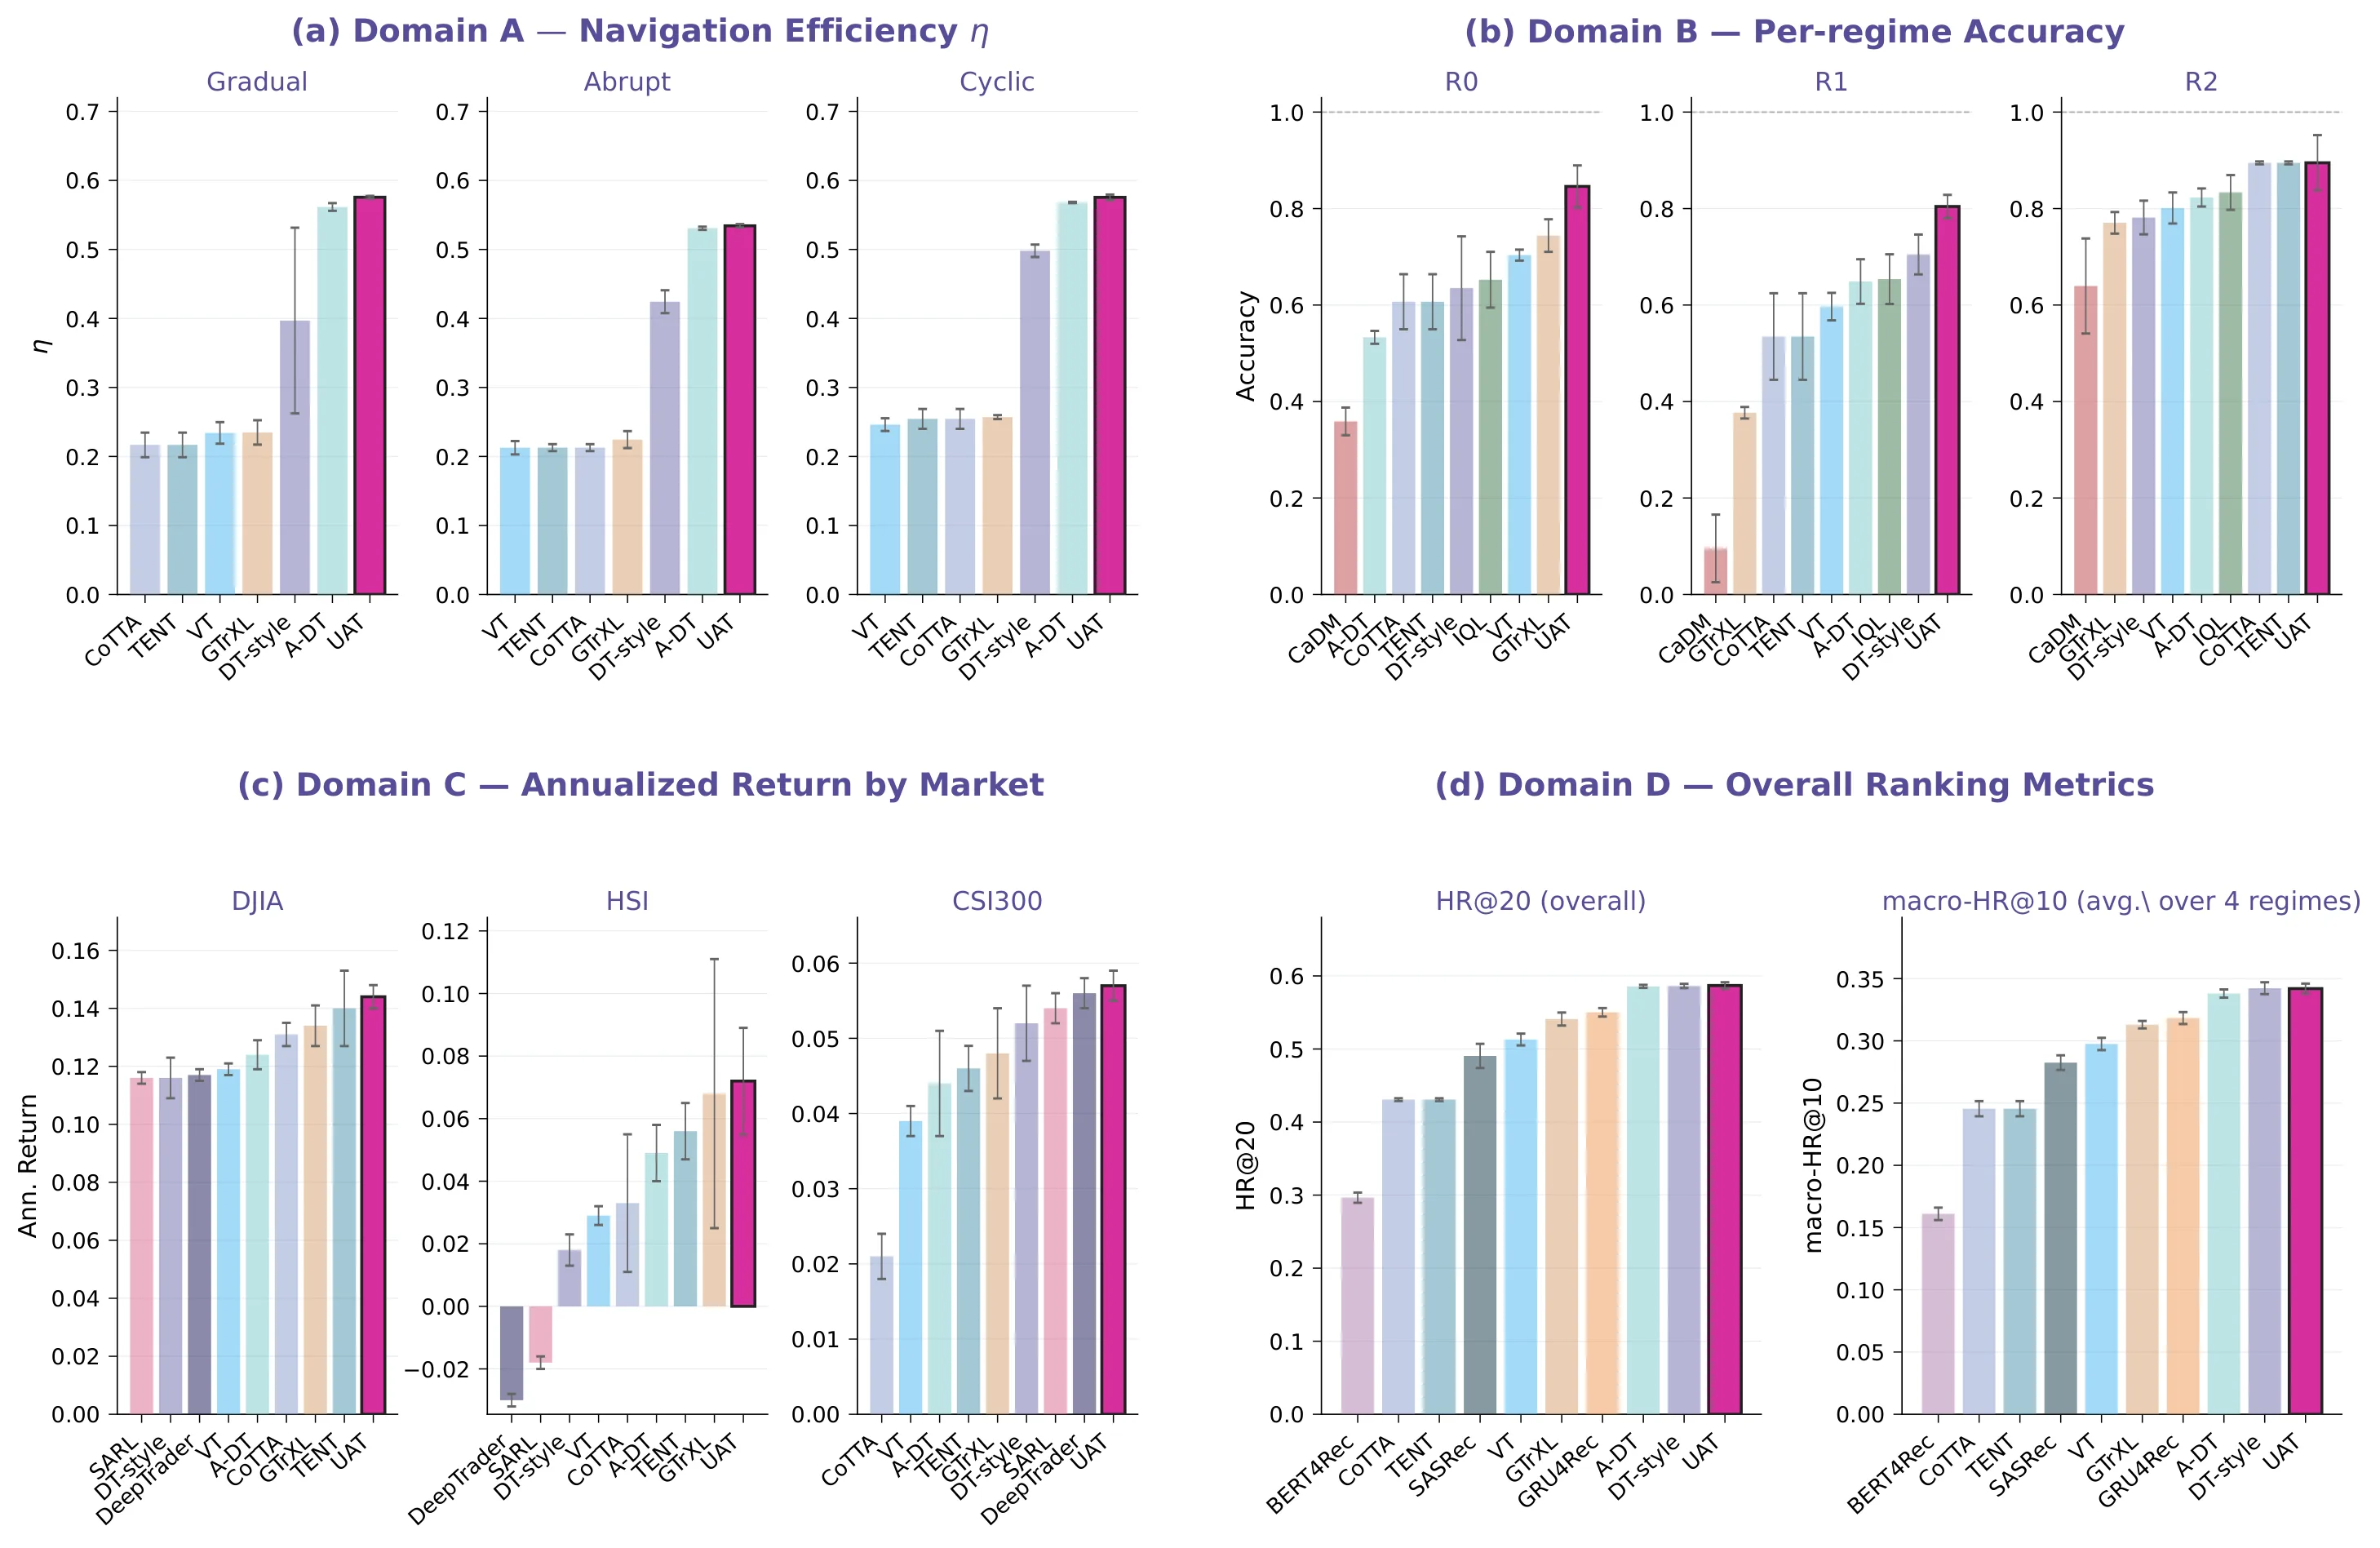
合成导航任务(Synthetic Navigation)模拟了一个具有隐式目标切换的环境:智能体需要在二维网格中导航寻找隐藏的目标位置,但目标的具体位置会在运行过程中随机切换,智能体只能通过到达目标后的奖励信号来推断切换是否发生。实验设置了不同的噪声等级来控制反馈信号的清晰程度。结果显示,在所有噪声等级下 UAT 均显著优于基线方法,且随着噪声增加、反馈信息变得更加微弱时,UAT 的优势反而更加明显——这验证了效用状态调制在低信噪比环境中的鲁棒性。
非平稳败血症治疗(Non-stationary Sepsis Treatment)使用了 MIMIC-III 数据集的真实临床轨迹,但通过引入隐式的生理状态漂移模拟非平稳性。模型需要根据病人的观测信息决定用药剂量,而环境规则在治疗过程中悄然改变。这一任务的挑战在于:观测(生命体征、化验结果)与真实生理状态之间存在复杂的映射关系,且状态切换是隐式的。UAT 通过效用状态追踪近期的治疗效果反馈,能够更快地识别出环境变化并调整策略。
跨市场资产配置(Cross-market Portfolio Allocation)在多个金融市场的历史数据上测试,要求模型根据历史价格和成交量信息进行资产配置。不同市场在不同时期表现出不同的相关性结构和波动模式,这种结构性漂移构成了隐式状态切换。UAT 的优势在于能够利用每日盈亏反馈快速感知市场状态的变化,而标准方法则容易被历史数据的「惯性」所拖累。
延迟反馈推荐(Delayed-feedback Recommendation)模拟了推荐系统中典型的延迟反馈问题:用户对推荐商品的反馈往往需要延迟多个时间步才能观察到。论文设置了不同的延迟长度来评估方法的鲁棒性。UAT 通过效用状态维护了一个移动的反馈历史窗口,即使单个反馈被延迟,也能在聚合层面捕捉到趋势变化。
论文将 UAT 与三类基线进行了对比:仅基于观测的方法(包括标准 Transformer-Decision 和 LSTM-Decoder)、测试时自适应方法(如在线更新的梯度方法)以及输入级反馈方法(将奖励作为额外 token 直接输入)。实验结果一致表明,UAT 在所有任务和所有噪声等级下都取得了最优或接近最优的性能。特别值得注意的是,在高噪声(高适应需求)场景下,UAT 的增益幅度显著加大——这正是在真实应用中往往遇到的情况:反馈信号通常不是干净清晰的,智能体需要在充满噪声的信息中推断环境状态。
讨论与可借鉴点
这篇论文在理论分析和实验设计上都展现了相当的深度,但仍有若干值得进一步探讨的问题。首先,效用状态的设计虽然简洁有效,但其更新机制相对简单——采用的是基于滑动窗口的线性更新。在更复杂的非平稳模式(例如周期性的状态切换或渐进式漂移)下,这种简单更新是否足够,是一个值得探索的方向。一个潜在的研究切入点是将 UAT 与隐变量模型或在线贝叶斯推断相结合,让效用状态的更新能够自适应地反映不同的切换模式。
其次,论文目前只考虑了离散动作空间的设定。在连续控制场景中,动作-奖励历史的表示方式可能需要调整,因为连续动作的细粒度差异可能引入额外的噪声。此外,连续动作空间的策略梯度估计本身带有较大的方差,如何在这种高方差环境下让效用状态有效工作是另一个开放问题。
从工程实践的角度看,UAT 的「零门控退化」性质是一个极具价值的特性——它保证了方法在反馈无效时不会产生负面影响,这使得研究者和工程师可以放心地将 UAT 作为现有 Transformer 决策系统的直接替代品,而无需担心引入新的风险。论文的代码和实验设置已经公开,这为后续研究提供了良好的复现基础。
更广泛地说,这篇论文揭示了一个重要但此前未被系统研究的问题:注意力机制中的检索偏差。即使在监督学习设置下,如果注意力检索的目标与最终决策目标之间存在结构性的不匹配,即使有充足的监督信号也无法弥补这一缺陷。这一观察对于 [[强化学习]] 中 Transformer 的应用具有重要的警示意义——不能仅仅依赖「将所有相关信息堆到输入中」来解决问题,而需要从模型内部机制上确保信息流的畅通。
摘要
在非平稳且部分可观测的环境中进行序贯决策,需要快速适应潜在的状态变化。然而,现有的 Transformer 决策模型在检索机制上存在结构性瓶颈:即使将奖励用于训练或作为输入标记暴露出来,注意力检索仍主要由观测驱动的相似性主导。我们将这一局限性形式化为反馈盲检索,并严格证明,在反馈信息有效的任务上,任何仅基于观测的注意力都无法区分具有不同动作-奖励结果的观测等价历史,从而导致次优选择。为了解决这种不匹配,我们提出了效用增强 Transformer(UAT),一种新的反馈条件检索注意力架构,其中紧凑的效用状态调节查询、键和值的投影,使得动作-奖励历史能够在前向传播过程中直接改变上下文检索。当反馈不提供有效信息时,UAT 还具备精确的零门控退化特性,可恢复为标准 Transformer。在有限期紧致性与 Lipschitz 假设条件下,我们证明 UAT 严格扩展了仅基于观测的 Transformer 类,并且能够一致逼近依赖反馈的决策映射。在四个非平稳基准测试——具有隐藏目标变化的合成导航、非平稳败血症治疗、跨市场资产配置以及延迟反馈推荐——中,UAT 在仅基于观测、测试时自适应和输入级反馈基线之上均持续提升了性能,在需要更强自适应的更高噪声环境下增益尤为显著。
Abstract
Sequential decision making in non-stationary and partially observable environments requires rapid adaptation to latent regime changes. However, existing Transformer decision models face a structural bottleneck in the retrieval mechanism: even when reward is used for training or exposed as an input token, attention retrieval remains primarily driven by observation-derived similarity. We formalize this limitation as feedback-blind retrieval, and formally show that, on feedback-informative tasks, observation-equivalent histories with different action-reward outcomes cannot be distinguished by any observation-only attention, resulting in suboptimal choice. To address this mismatch, we propose the Utility-Augmented Transformer (UAT), a new feedback-conditioned retrieval attention architecture in which a compact utility state modulates the query, key, and value projections, allowing action-reward history to directly alter context retrieval during the forward pass. UAT also enjoys an exact zero-gate degradation property that recovers the Vanilla Transformer when feedback is uninformative. Under finite-horizon compactness and Lipschitz assumptions, we prove that UAT strictly enlarges the observation-only Transformer class and can uniformly approximate feedback-dependent decision maps. Across four non-stationary benchmarks: synthetic navigation with hidden goal shifts, non-stationary sepsis treatment, cross-market portfolio allocation, and delayed-feedback recommendation, UAT consistently improves performance over observation-only, test-time adaptation, and input-level feedback baselines, with particularly large gains in noisier regimes that require stronger adaptation.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。