
陈旧但稳定:用于稳定异步强化学习的陈旧性自适应信赖域
Stale but Stable: Staleness-Adaptive Trust Regions for Stabilizing Asynchronous Reinforcement Learning
📝 TLDR
异步RL解耦rollout与优化提升吞吐,但陈旧性问题使PPO裁剪对高失配更新约束不足。提出陈旧性自适应信任域SAT,用分离对数比作陈旧代理,按核尺度识别批内高失配尾部并仅收缩PPO区间选中端点。理论上证明相对PPO的局部区间包含与逐点悲观性。在Qwen3-30B-A3B异步训练中,SAT-GSPO w/ R3在AIME24获35.83,验证按陈旧性异质性对齐裁剪区间可有效稳定异步RL。
🧭 速览
异步RL中策略滞后、引擎延迟与MoE路由引发陈旧性,PPO裁剪仅为采样代理,无法约束高陈旧更新。
提出SAT,以分离对数比为陈旧代理,按核尺度识别高失配尾部,仅收缩PPO区间符号选中端点。
SAT-GSPO w/ R3在Qwen3-30B-A3B异步训练中,AIME24 avg@8于lag 1与lag 8分别达35.83与34.79。
按陈旧性异质性自适应收缩裁剪区间,可有效稳定异步RL高失配尾部更新。
🆚 方法对比
SAT (Staleness-Adaptive Trust Region)
- 针对高staleness尾部自适应收缩clip区间
- 理论证明区间包含与点态悲观性
- 保持普通token的基线行为不变
- 高staleness场景下显著提升稳定性
- 依赖log-ratio作为staleness代理的精度
- 实现包含分位数校准与核缩放,复杂度较高
- 单独使用在lag=1时不如SAT-GSPO变体
- 仅在Qwen3-30B-A3B单一模型上验证
PPO clipping (baseline)
- 实现简单,是广泛使用的基线方法
- 作为采样代理目标在同设置RL中有效
- 对pull-back更新保持天然兼容
- 固定clip半径无法适应异构staleness
- 仅约束采样外向更新,非全局策略约束
- 在高staleness异步场景下控制力弱
- 对所有token同等对待,先验不匹配
SAT-GSPO
- 融合SAT与序列级GSPO的优势
- lag=1时AIME24 avg@8达34.17
- 在异步RL中比纯PPO更稳定
- 性能不及加入R3的完整变体
- 需同时调参SAT与GSPO两个机制
- 论文未单独对比纯GSPO效果
SAT-GSPO w/ R3
- AIME24 avg@8达35.83(lag=1),为最佳观测
- lag=8时仍保持34.79,高staleness优势明显
- 自适应clipping与R3形成互补双稳定器
- 需同时启用SAT、GSPO、R3三个组件
- 系统复杂度与计算开销最高
- 组件间协同调参难度大
GSPO
- 序列级优化目标适配异步RL
- 作为变体基座提供序列级稳定性
- 论文未深入独立分析其贡献
- 未与SAT的单独效果进行消融对比
Routing Replay (R3)
- 专门缓解MoE路由不一致问题
- 控制日志失配水平,与SAT互补
- 降低observed staleness
- 单独使用效果未充分报告
- 增加训练流程的系统复杂度
- 依赖路由日志的可用性
Decoupled Asynchronous RL
- 解耦rollout与优化,提升GPU利用率
- 提高训练吞吐量
- 适配大规模LLM训练的实际需求
- policy lag、引擎延迟、MoE路由导致staleness
- 训练-推理发散在高staleness时膨胀
- 固定clip机制在高staleness下脆弱
SAT在PPO基础上引入staleness感知的自适应clip收缩,SAT-GSPO进一步结合序列级目标,SAT-GSPO w/ R3通过叠加路由回放实现最佳性能(AIME24 avg@8 35.83),三者呈递进互补关系,均显著优于固定clip的PPO基线在高staleness异步场景下的表现。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
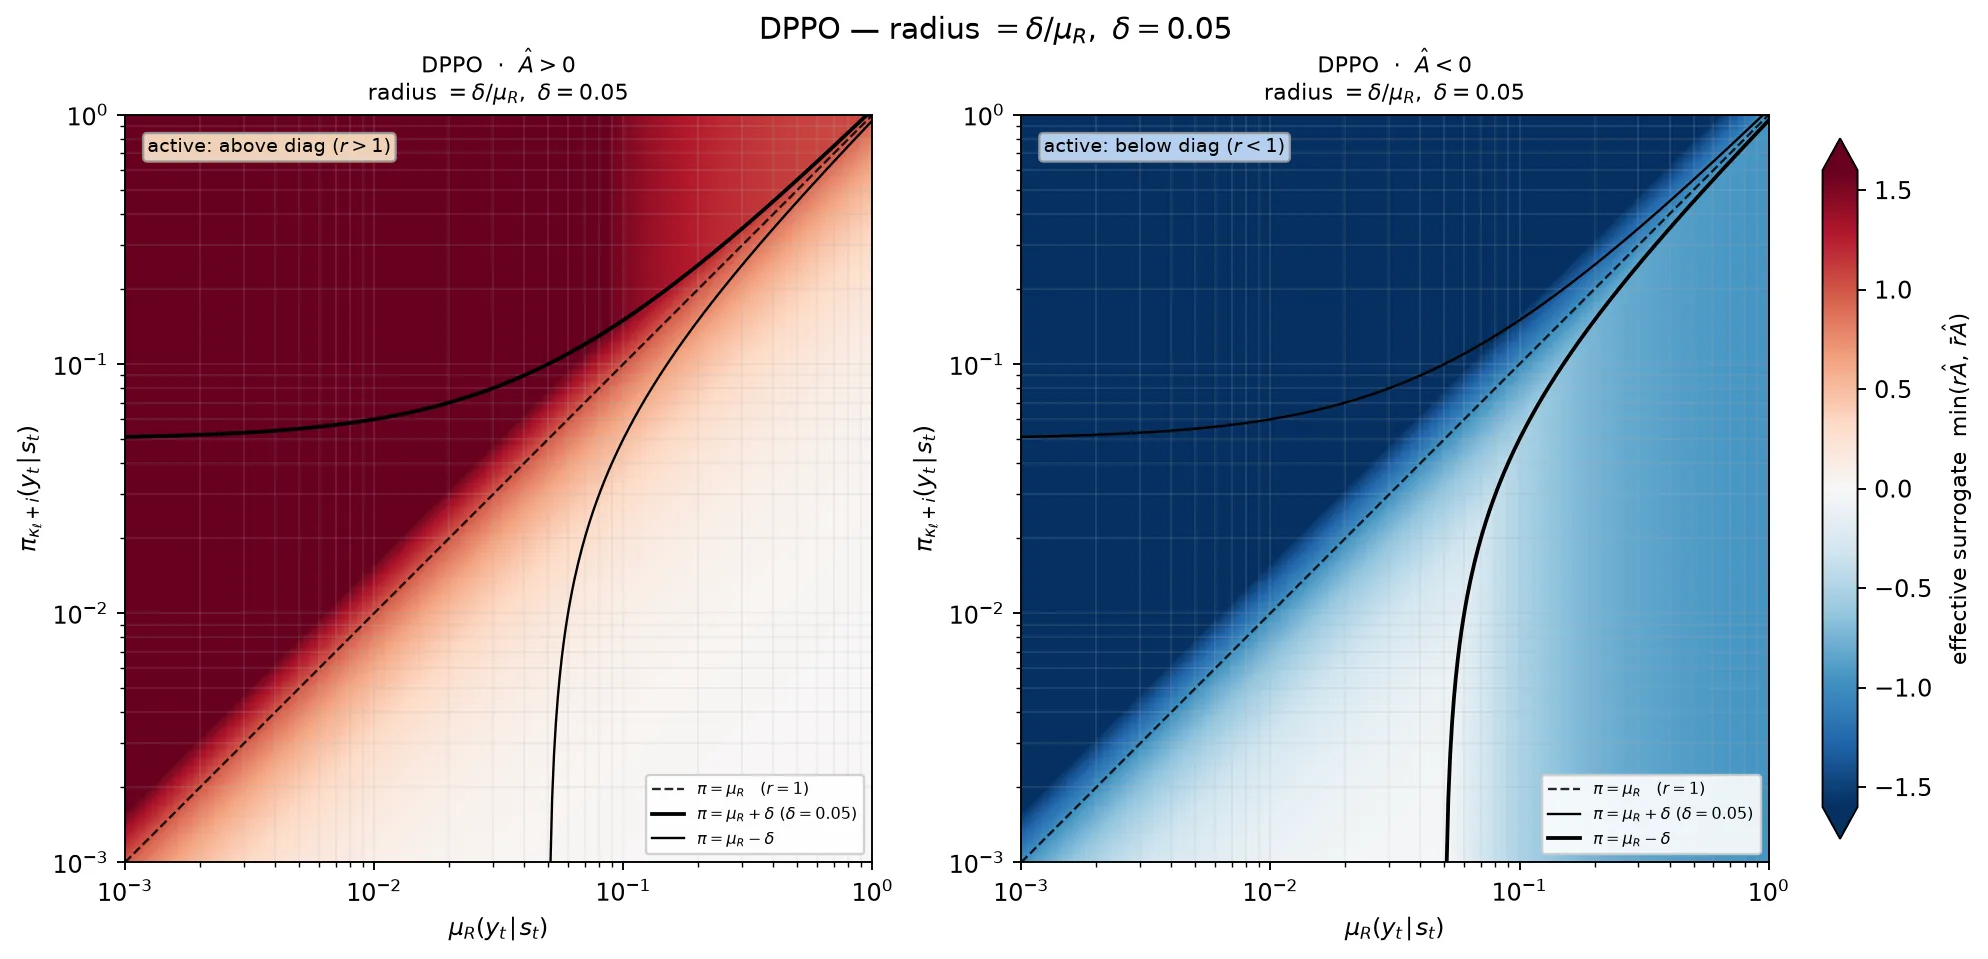
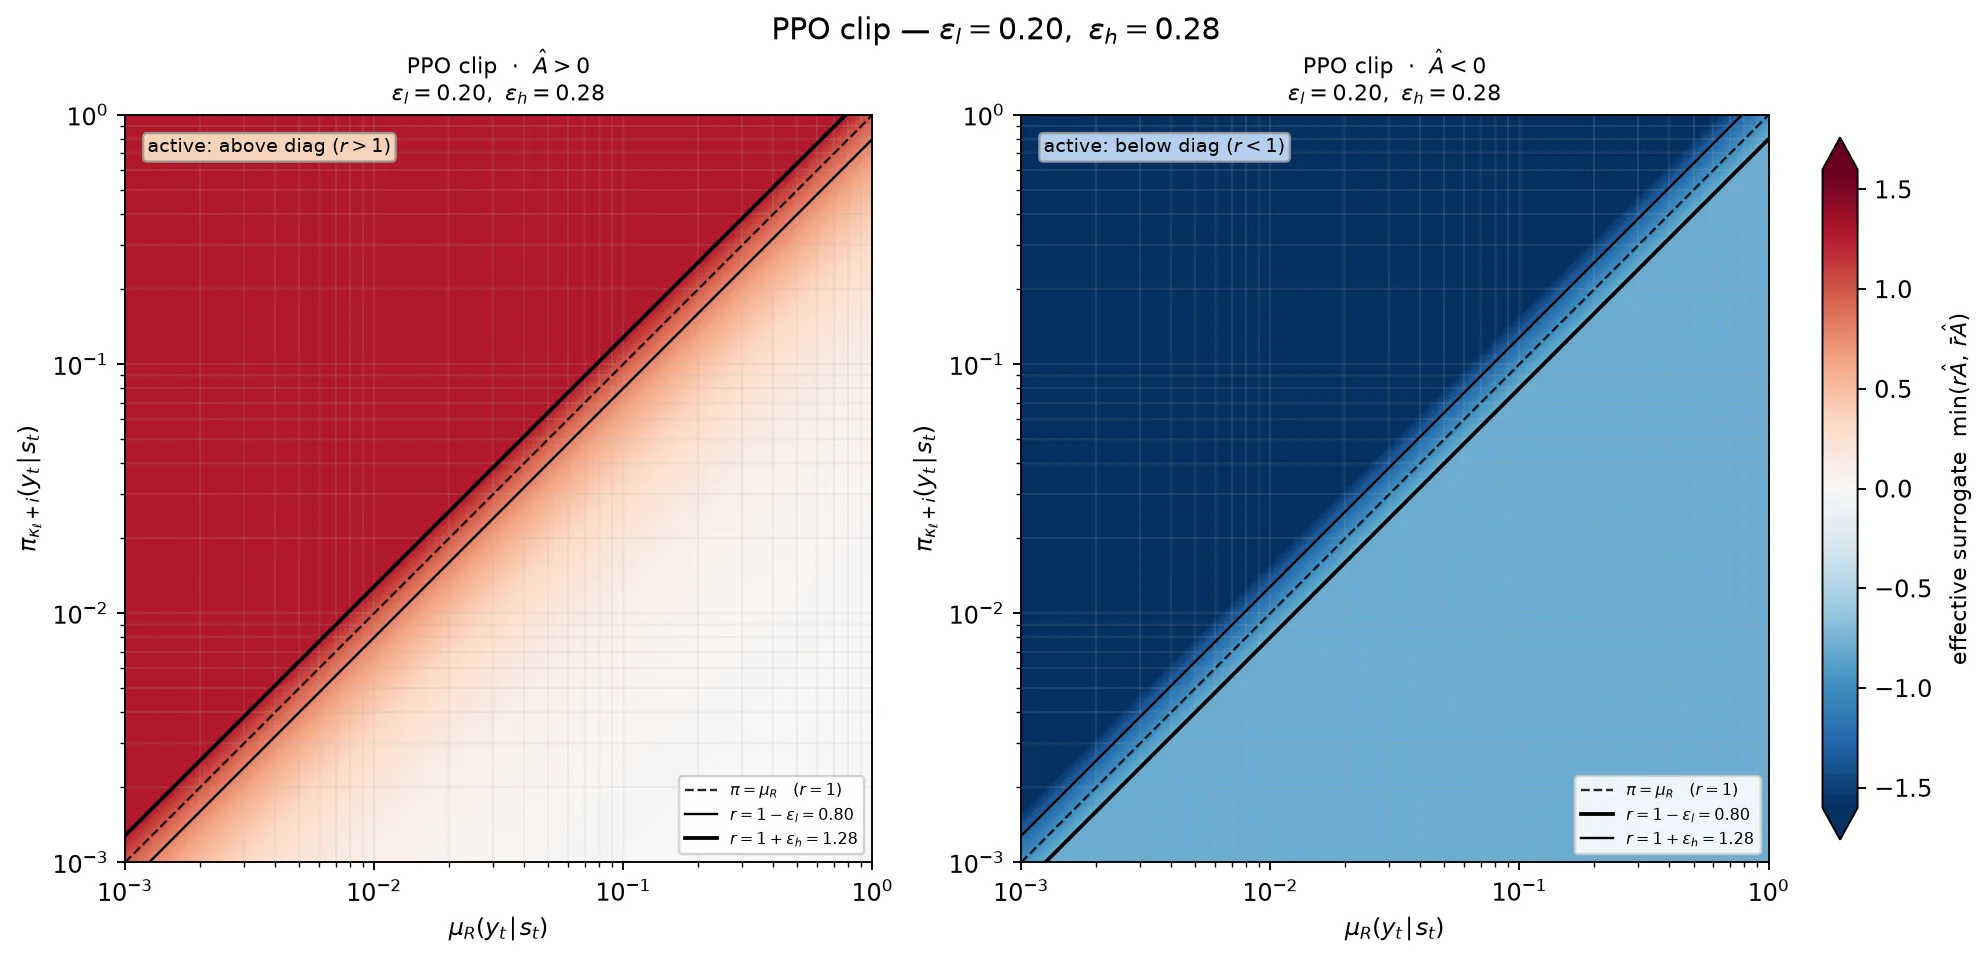
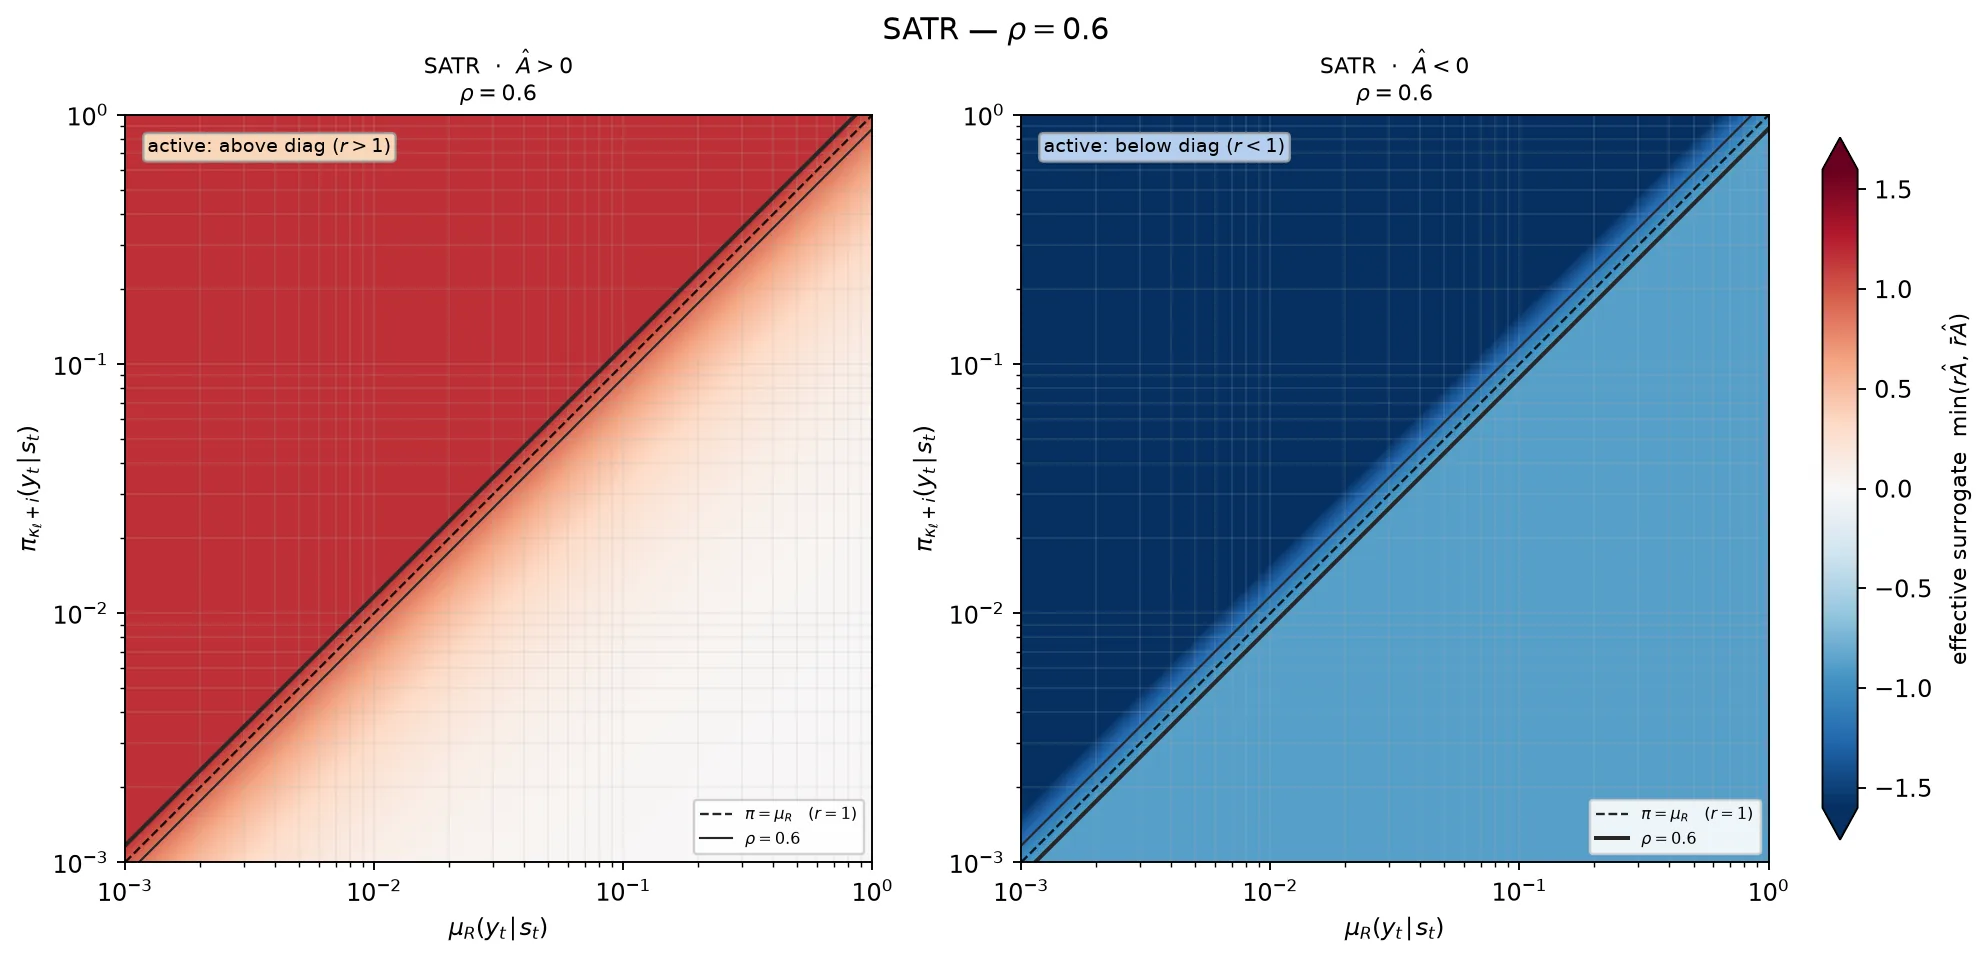
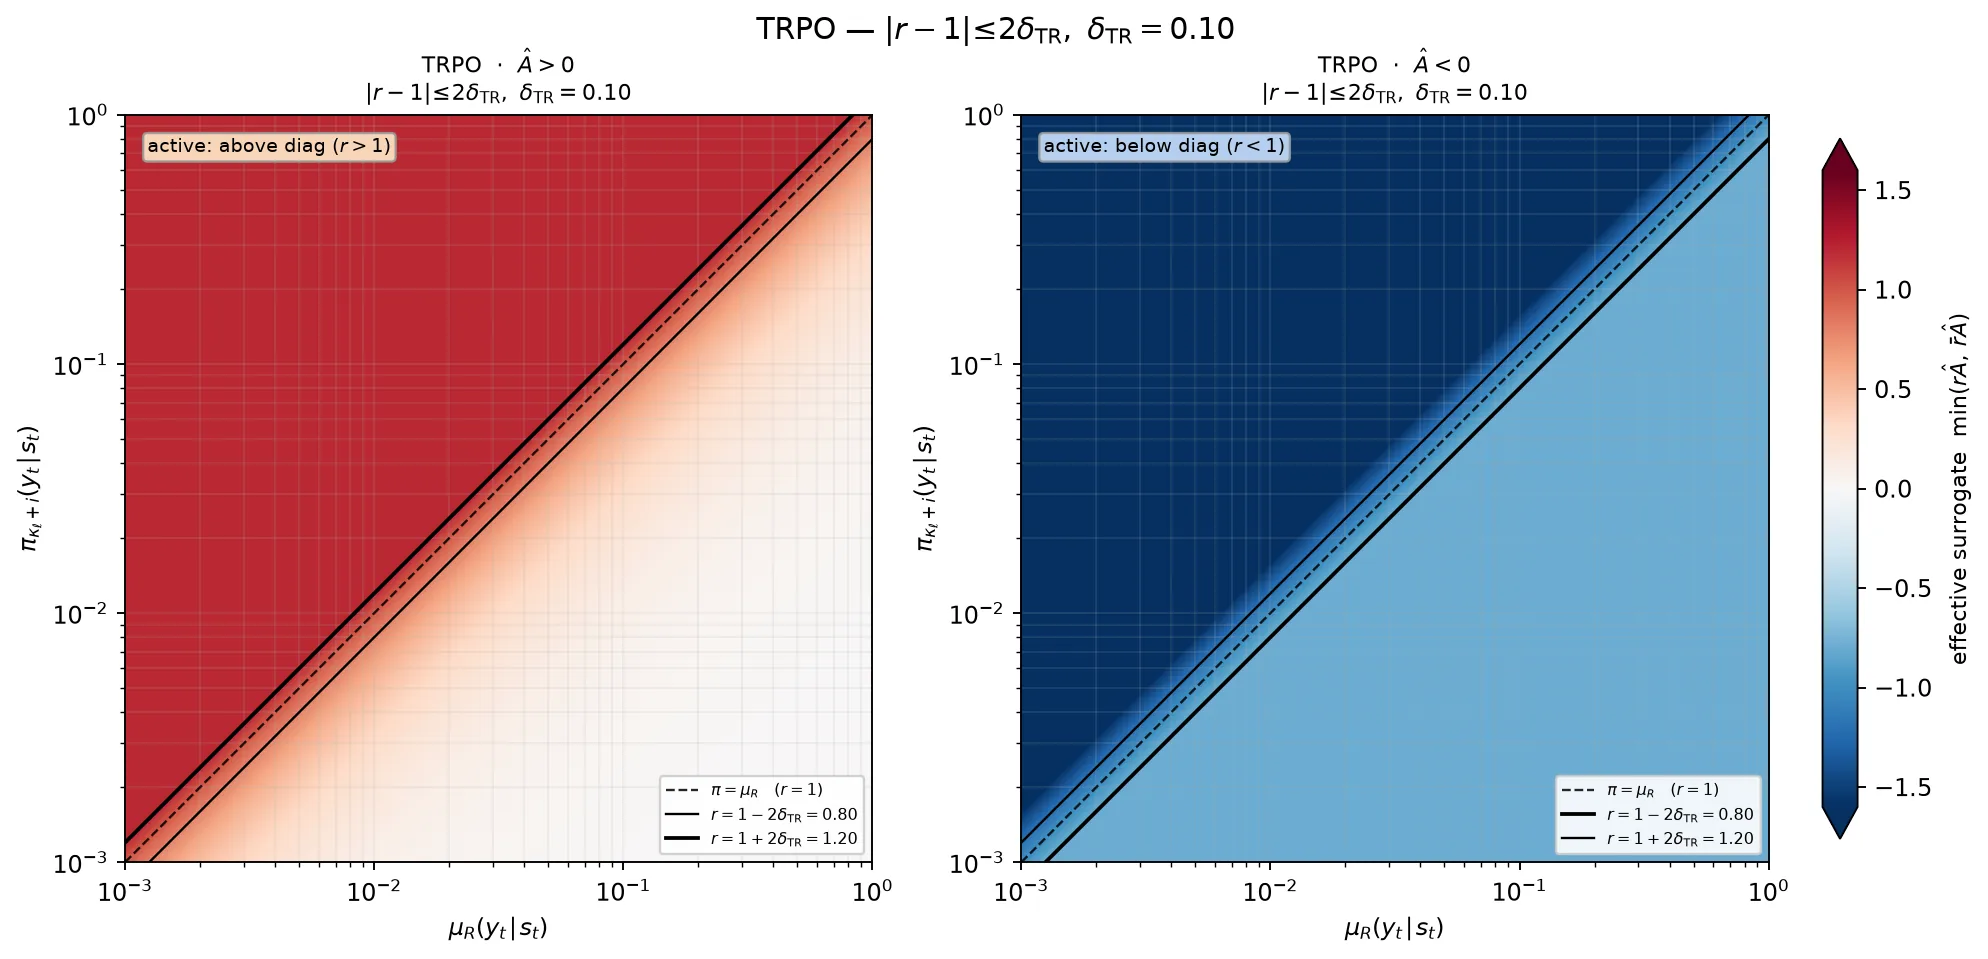
TL;DR
异步强化学习在提升吞吐量时不可避免地引入陈旧性问题,传统 PPO 裁剪仅作用于采样动作而非全策略约束,导致高陈旧性更新长期处于弱控制状态。本文提出陈旧性自适应信赖域(SAT),以去耦的采样对数比作为实用的陈旧性代理,通过基于分位数的核尺度在每批内识别高失配尾部,并仅对名义 PPO 区间中按符号选定的一端进行收缩。在 Qwen3-30B-A3B 异步训练设置下,SAT-GSPO w/ R3 在 AIME24 上达到 lag 1 时 35.83、lag 8 时 34.79 的最佳观测成绩,有效证明了将裁剪区间与陈旧性异质性对齐可以稳定异步强化学习。
研究背景与动机
异步强化学习的核心优势在于将 rollout 生成与策略优化解耦到独立的 GPU 池,通过周期性广播权重实现高吞吐与 GPU 利用率。然而这种解耦架构带来了一种固有的代价——陈旧性(staleness),它并非单一来源,而是由三类因素叠加而成。第一类是策略更新滞后,在权重广播窗口内进行的若干优化器步累积产生 log 概率差异 。第二类是实现失配,即使权重保持一致,训练端与推理端在算子实现、精度配置以及 MoE 路由策略上的差异仍会产生偏差 。第三类尤其值得关注,即 MoE 架构中的路由不一致性,Top-K mask 的不连续性使得小数值扰动即可激活完全不同的专家集合。
论文将总失配分解为 ,并指出这种失配分布在同一 rollout 窗口内呈现高度的异质性且呈长尾分布。值得注意的是,这种异质性并非均匀分布,而是存在明显的两极分化——部分 token 的失配极小,另一部分则处于严重失配的尾部。这一现象在异步机制下被显著放大:当 lag 增大时,高失配尾部的占比也随之扩大。
从信赖域的视角审视,现有 PPO 裁剪的局限性变得清晰。PPO 裁剪仅对已采样 token 的外向更新进行门控,本质上是一种采样代理而非全策略约束。论文通过 Lemma 3.1 将全动作比与总变差距离联系起来,论证了理想的全动作比包络控制本可以直接约束有限时间界中的 TV 惩罚项。然而 PPO 只作用于采样动作而非全部动作空间,这导致在高 lag(lag = 8)场景下,高陈旧性更新仍处于弱控制状态。实验观测进一步印证了这一理论分析:GRPO 和 GSPO 在 lag 8 下分别于 step 429 和 424 发生训练崩塌,这正是高失配尾部累积引发的典型症状。
方法
SAT 的核心设计遵循一个清晰的原则:仅对当前 batch 中观察到的"高陈旧性尾部"按符号方向收缩 PPO 区间,对普通 token 和 pull-back 更新保持原 PPO 行为,并且可以作为 drop-in 替换嵌入到现有框架中。这一设计背后有两层考量:一是异质性确实存在,不应被均匀化处理;二是保守性与表达能力之间需要平衡,不能不加区分地压缩所有更新。
首先需要解决的是如何量化每个 token 的陈旧性程度。论文选择以去耦的采样对数比作为实用的陈旧性代理:
这里使用 stop-gradient 操作(sg)将代理从梯度流中隔离,仅用于决定裁剪区间而不参与优化过程。这种设计既保留了识别失配的信息,又避免了代理本身被优化目标所污染。需要特别指出的是,去耦对数比同时编码了策略更新滞后与实现失配两类信息,这使得它成为一个全面而实用的陈旧性度量。
接下来需要识别高失配尾部。论文采用基于陈旧性的核函数尺度来实现这一点。首先计算当前 batch 内失配绝对值的经验分布函数:
参考分位数 由当前 batch 自校准得到, 意味着选取第 90 百分位作为阈值。分位数的自适应性是关键设计:它允许 SAT 根据每批数据的实际失配分布动态调整,而不是依赖固定的经验阈值。
在此基础上,论文引入 Hill 核函数进行符号分离和映射:
Hill 核函数的特性值得深入理解:当 时 ,随着 增大逐渐衰减至 (当 时);其导数 保证函数单调递减。这种设计使得高陈旧性 token 获得较小的收缩因子,而普通 token 几乎不受影响。
有效收缩因子的计算体现了这一机制:
当失配超过参考分位数 时,收缩因子 小于 1;否则保持为 1(即不收缩)。随后将收缩因子应用到 PPO 的裁剪边界:
最终得到 SAT 采样目标:
这里的核心洞察是:收缩仅作用于按符号选定的一端。当 (正向优势)且 (高陈旧性)时,仅收缩上界;当 (负向优势)且 时,仅收缩下界。这种符号感知机制确保了 pull-back 更新(有利于策略稳定回缩的更新)不会被误伤。
论文还提出了 GSPO 扩展,用长度归一化的序列级比值替换 token 级比值:
这使得 SAT 的思想可以在序列层面统一施加,为不同粒度的控制提供了灵活性。
理论保证是 SAT 设计的重要支撑。论文的命题 4.1 给出了三个关键性质。首先是区间包含:SAT 收缩区间 始终被原始 PPO 区间 所包含,门关闭时两区间重合,门开启时按符号选定的端点严格内移。其次是逐点悲观性:对于任意 和 ,有 。第三是差异精确作用域:SAT 与 PPO 的差异仅出现在新截获的外向区间上——即高陈旧性导致原本未被裁剪的外向更新现在被抑制为零梯度,而 pull-back 区间保持不变。这些性质共同刻画了 SAT 如何在保留基础 PPO 行为的同时,仅对高失配外向更新施加更保守的约束。
实验与结果
论文在解耦异步 RL 设置下对 SAT 进行系统评估,该设置基于 Qwen3-30B-A3B-Base 主干模型,使用 SGLang 作为推理引擎、Megatron 进行训练。具体配置为单节点 8 GPU,其中 GPU0-3 承载训练任务,GPU4-7 运行 rollout,这种分离设计正是异步 RL 架构的典型特征。并行策略采用 TP=4、PP=1、CP=1、EP=4、ETP=1,启用序列并行,训练精度为 bf16。
训练数据集包含 30,712 条 prompt,来源于 DAPO-Math-17k 与 Dolci-RL-Zero-Math-7B 的混合。每迭代使用 256 prompts × 16 样本的配置,共产生 4096 个 responses 用于优化。评估在 AIME24(30 道数学题,每题 16 样本)上进行,每 5 步评估一次,每次评估取 4 次采样的平均结果。实验重点对比了两种 lag 设置:lag=1 表示权重广播间隔为 1 步(几乎无陈旧性),lag=8 表示间隔 8 步(高陈旧性场景)。
主实验结果清晰地展示了方法的优越性。在 AIME24 avg@8 指标上,SAT-GSPO w/ R3 取得所观察到的最佳成绩,lag=1 时达到 35.83,lag=8 时仍保持 34.79。作为对比,SAT-GSPO 单体在 lag=1 时为 34.17,DPPO(论文提出的 DTV 变体)在两种 lag 下分别为 33.96 和 32.71。基线方法的表现则揭示了异步训练的不稳定性:GRPO 和 GSPO 在 lag=8 下分别于 step 429 和 424 发生训练崩塌(表中以 标注)。
值得注意的是 R3(Rollout Routing Replay)的互补作用。R3 针对的是 MoE 路由不一致性问题,它从源头降低由专家选择差异引入的失配水平。实验数据表明,R3 将 (策略级失配度量)稳定在约 0.007 附近,而未使用 R3 的 GSPO 在 lag=8 时 上升至 0.0109。SAT 则在 R3 已降低的失配分布基础上,进一步通过裁剪几何重塑来处理剩余的高失配尾部。二者的作用层面不同但效果可叠加,这解释了 SAT-GSPO w/ R3 组合为何能取得最佳成绩。
失配轨迹分析(图 4)进一步验证了 SAT 的工作机理。SAT 组的 始终低于对应基线,且在训练中后期保持稳定。基线方法则呈现先升后崩塌的模式,这是高失配尾部累积引发的不稳定性传播。
讨论与可借鉴点
论文的核心贡献在于揭示了裁剪区间与陈旧性异质性之间的对齐对于稳定异步 RL 的关键作用。从方法论角度,SAT 提供了几个值得借鉴的设计思路。其一是符号感知的自适应收缩,仅对使比值远离 1 的方向施加约束,避免误伤 pull-back 更新,这在保持策略表达能力的同时精准地控制风险更新。其二是基于 batch 级分位数的自校准,使得收缩强度可以根据实际失配分布动态调整,而不是依赖手工调参。其三是轻量级的 drop-in 设计,每 batch 仅增加一次分位数计算和少量逐元素 tensor 操作,当检测到无显著失配时可完全禁用。
论文的理论分析框架也具有启发性。通过将采样代理层面的控制与有限时间信赖域界显式关联,作者论证了 SAT 收缩的本质是对 PPO 采样代理缺失的全策略约束的补救。这一视角有助于理解为什么简单增大 clip epsilon 在高 lag 下反而有害——固定半径无法处理异质性,会在压缩高失配尾部的同时不必要地限制普通 token 的更新空间。
局限方面,论文的实验采用单一训练种子,未报告置信区间或多次 run 的误差棒,这使得性能差异的统计显著性难以评估。此外,SAT 与 R3/TIS 的组合优势来自复合机制,其各自的因果贡献难以单独剥离。论文在附录 E 中尝试将多种方法纳入统一框架,但不同稳定化器的交互效应仍需进一步研究。
对于异步强化学习的后续研究,SAT 的思路启示我们关注分布异质性而非仅关注均值或方差。在 rollout 与优化解耦的场景中,单一的全策略约束可能无法适应不同样本间的差异性,自适应地识别并处理高风险尾部是一种更具针对性的解决路径。
摘要
异步强化学习通过解耦 rollout 生成与优化来提升吞吐量,但陈旧性是不可避免的副产物,它由策略滞后、引擎延迟以及混合专家路由共同加剧。从信赖域的视角看,这种失配至关重要:训练-推理差异在有限时间界中决定了近似误差,而 PPO 裁剪仅对外向的已采样更新进行门控,充当的是采样代理而非全策略约束。其结果是在陈旧 rollout 影响最深的异步机制下,高陈旧性更新仍处于弱控制状态。我们提出陈旧性自适应信赖域(SAT),它将去耦的采样对数比作为实用的陈旧性代理,借助基于陈旧性的核尺度在每个批次中识别高失配尾部,并仅对名义 PPO 区间中按符号选定的一端进行收缩。这在普通 token 上保留了基线行为,同时在新截获的外向区间上施加更为保守的更新。我们证明了相对 PPO 的局部区间包含性与逐点悲观性,展示了自适应规则如何在异质陈旧性下重塑更新几何。我们在基于 Qwen3-30B-A3B-Base、以 SGLang 作为推理引擎、以 Megatron 进行训练的解耦异步 RL 设置中对 SAT 进行评估。在该设置下,SAT-GSPO w/ R3 取得了所观察到的最佳 AIME24 avg@8,在 lag 1 时达到 35.83,在 lag 8 时达到 34.79,而 SAT-GSPO 在 lag 1 时达到 34.17。自适应裁剪与路由重放分别作为针对失配尾部与路由不一致性的互补稳定器。总体而言,将裁剪区间与陈旧性异质性对齐可有效稳定异步强化学习。
Abstract
Asynchronous reinforcement learning improves throughput by decoupling rollout generation from optimization, but staleness is an inevitable byproduct compounded by policy lag, engine delays, and mixture-of-experts routing. From a trust-region perspective, this mismatch is critical: training-inference divergence governs approximation error in finite-horizon bounds, whereas PPO clipping only gates sampled outward updates, acting as a sampled surrogate rather than a full-policy constraint. As a result, high-staleness updates remain weakly controlled in the asynchronous regime where stale rollouts matter most. We introduce the Staleness-Adaptive Trust Region (SAT), which uses the detached sampled log-ratio as a practical staleness proxy, identifies high-mismatch tails within each batch via staleness-based kernel scaling, and contracts only the sign-selected endpoint of the nominal PPO interval. This preserves baseline behavior on ordinary tokens while enforcing more conservative updates on newly intercepted outward bands. We prove local interval containment and pointwise pessimism relative to PPO, showing how the adaptive rule reshapes update geometry under heterogeneous staleness. We evaluate SAT in a decoupled asynchronous RL setup built on Qwen3-30B-A3B-Base, using SGLang as the inference engine and Megatron for training. In this setting, SAT-GSPO w/ R3 achieves the best observed AIME24 avg@8, reaching 35.83 at lag 1 and 34.79 at lag 8, while SAT-GSPO reaches 34.17 at lag 1. Adaptive clipping and routing replay act as complementary stabilizers targeting mismatch tails and routing inconsistency, respectively. Overall, aligning clip intervals with staleness heterogeneity effectively stabilizes asynchronous RL.
论文详细总结(自动生成)
论文总结:Stale but Stable:用于稳定异步强化学习的陈旧性自适应信赖域
1. 核心问题与研究动机
异步强化学习(Asynchronous RL)通过将 rollout 生成与优化解耦到独立 GPU 池并周期性广播权重来提升吞吐与 GPU 利用率,但其代价是引入了陈旧性(staleness)。该陈旧性并非由单一来源构成,而是由三类因素叠加而成:
- 策略更新滞后:在权重广播窗口内进行的若干优化器步累积产生 ;
- 实现失配:即使权重一致,训练端与推理端的算子、精度与 MoE 路由仍产生差异 ;
- MoE 路由不一致:Top-K mask 的不连续性使小数值扰动即可激活不同专家集。
总失配分解为 ,其分布在同一 rollout 窗口内高度异质且呈长尾。论文将此现象称为陈旧性相关异步 RL 不稳定(Staleness-associated Asynchronous RL instability)。
从信赖域(trust region)角度看,PPO 裁剪仅是对已采样 token 的外向更新进行门控,是采样代理而非全策略约束;固定半径在异质失配下同时过松(高陈旧尾部)与过紧(普通 token),尤其在高 lag(lag = 8)下会引发训练中后期评价指标崩塌(collapse)。
2. 方法论:SAT 的核心思想、关键公式与算法流程
2.1 设计原则
SAT 旨在仅对当前 batch 中观察到的"高陈旧性尾部"按符号方向收缩 PPO 区间,对普通 token 和 pull-back 更新保持原 PPO 行为,并可作为 drop-in 替换。
2.2 关键技术细节
(1) 分离采样的 token 级陈旧性代理:
其中 sg 表示 stop-gradient,代理仅用于决定裁剪区间,不参与优化。
(2) 基于陈旧性的核函数尺度(Staleness-based Kernel Scaling):
参考分位数 由当前 batch 自校准,。符号分离后通过 Hill 核映射:
满足 ,,且 。
(3) 有效收缩因子(Effective Contraction Factors):
(4) SAT 采样目标:
2.3 序列级扩展(GSPO)
GSPO 用长度归一化序列比 替换 token 比,量化经验分位数在序列级施加 SAT。
2.4 理论保证(命题 4.1:更新几何)
设 ,,则:
- (i) 区间包含:;门关闭时两区间重合,门开启时按符号选定的端点严格内移。
- (ii) 逐点悲观性:。
- (iii) 差异精确作用域:仅在新截获的外向区间 上 SAT 梯度为零而 PPO 保留外向梯度 。
2.5 与信赖域界的联系
通过 Lemma 3.1()与 Proposition 3.2(理想全动作比包络控制 TV),SAT 论证:硬全动作比界本可控制有限时间界 (4) 的 TV 惩罚项,但 PPO 仅作用于采样动作;SAT 因此在采样代理层面对高陈旧尾部按需收缩。
3. 实验设计
- 数据集:30,712 条 prompt,来自 DAPO-Math-17k + Dolci-RL-Zero-Math-7B;每迭代 256 prompts × 16 样本,544 次 rollout,总计 4096 responses。
- 基准:AIME24(30 题,每题 16 样本,每 5 步评估一次,每评估为 4 次平均),基础模型参考 9.38。
- 主干模型:Qwen3-30B-A3B-Base(48 层、128 专家 Top-8、MoE-FFN 宽 768、RoPE base )。
- 配置 lag:,权重广播间隔 8(仅 lag 8)。
- 采样:temperature 1.0、top-p 1.0、top-k −1,保证完整词表支撑以满足 Lemma 3.1。
- 基线与对比方法:GRPO、GSPO、R3(Rollout Routing Replay)、TIS、DPPO(DTV 变体,阈值 )、IcePop、KPop、SeqClip,以及 SAT 自身四个变体(SAT-GRPO、SAT-GSPO、SAT-GRPO w/ R3、SAT-GSPO w/ R3)。
4. 资源与算力
- 硬件:单节点 8 GPU,GPU0–3 用于训练(Megatron),GPU4–7 用于 rollout(SGLang)。
- 并行配置:TP=4、PP=1、CP=1、EP=4、ETP=1,启用序列并行;bf16 训练,fp32 梯度 all-reduce,fp32 attention softmax,FlashAttention 后端;SGLang 显存占比 0.85。
- 训练时长:未明确给出 wall-clock 训练时间。
- 框架:slime 异步 RL 框架。
- 超参:Adam 、,常数学习率 ,KL 系数 ,base clip ;SAT 用 Hill 核指数 2、参考分位数 0.90。
5. 实验数量与充分性
- 规模:单对照表 Table 1 列出 14 种方法配置 × 2 个 lag 设置 = 28 个 run(每方法单个 seed);辅以 Figure 2/3 的不稳定诊断、Figure 4 的失配轨迹、Figure 5 的 AIME24 对比,以及附录 E 中按方法分组的局部对比。
- 覆盖维度:方法(PPO 家族、序列级、路由、token-level 屏蔽) × lag(1/8) × 是否启用 R3 与 TIS。
- 客观性局限:每个配置均为单一训练种子,Table 1 中给出"best checkpoint"和"末 epoch ",未报告置信区间或多次 run 误差棒; 与 Figure 4 的尾部 25% 统计可能对同一配置给出不同数值;Table 1 中标注 的 run 在日志窗口内发生崩塌(GRPO lag 8、GSPO lag 8)。
- 公平性:所有比较共享同一优化器、数据、奖励与模型,唯一变量是稳定化器与 lag;但 SAT 与 R3/TIS 的组合优势来自复合机制,难以单独剥离因果。
6. 主要结论与发现
- 最佳性能:SAT-GSPO w/ R3 在 AIME24 avg@8 上达到 lag 1 时 35.83、lag 8 时 34.79,超过所有单一方法与组合基线。
- 次优:SAT-GSPO 单体在 lag 1 达 34.17;DPPO lag 1/8 分别 33.96/32.71;GRPO/GSPO 在 lag 8 下分别于 step 429/424 发生训练崩塌。
- 失配水平:性能领先的配置同时维持更低 (SAT-GSPO w/ R3:lag 1 时 0.0056,lag 8 时 0.0076 vs. GSPO:0.0097/0.0109)。
- 互补性:路由重放(R3)从源头降低 MoE 路由带来的失配水平(将 限制在约 0.007 附近),SAT 则在已观察到的失配分布上重塑裁剪几何;二者作用层面不同但效果可叠加。
- 理论契合:SAT 的预测经验签名——尾部压制与中后期崩塌抑制——在 Figure 4 中得到验证。
7. 优点
- 理论与实证双重支撑:给出区间包含、逐点悲观与差异作用域的精确刻画(命题 4.1),并将采样代理层控制与有限时间信赖域界 (4) 显式关联。
- 轻量级 drop-in:每 batch 仅增加一次分位数计算与少量逐元素 tensor 操作;禁用时与基础 PPO/GRPO/GSPO bit-identical。
- 符号感知自适应:仅在使比值远离 1 的方向收缩,避免误伤 pull-back 更新。
- 方向感知统一框架:在附录 E 中将 PPO、TRPO、DPPO、SPO、DRPO、TIS、IcePop、KPop、GSPO、SeqClip、R3 纳入同一非对称裁剪设计空间,定位明确。
- 解耦稳定器:自适应裁剪针对失配尾部,R3 针对路由不一致,二者机制互补,避免一刀切。
8. 不足与局限
- 代理层控制:SAT 收缩的是采样名义区间而非已学策略本身,未观测的词表动作仍不受约束; 不等价于 (缺少概率质量加权),亦不等于版本年龄。
- 混合失配混淆: 同时混合策略滞后与实现失配,无法在两者间给出唯一可加性分解;论文将其作为诊断假设而非精确分解。
- 相对适应而非绝对适应:参考分位数 逐 batch 重算,因此方法响应的是相对失配尾部而非绝对标度,不能保证随 lag 增大单调收缩。
- 序列级语义的弱化:GSPO 路径下 token 比可相互抵消,序列比不再对应 token-level 解释。
- 经验范围有限:单一种子、无置信区间、单一 backbone、单一基准(AIME24)、单任务(数学推理);未在代码、对话、agentic 等异构任务上验证。
- 未报告关键训练元数据:未给出 wall-clock 训练时长、rollout-to-train 吞吐比、token 总数等工程指标,外推成本受限。
- 崩溃标注主观:collapse 判定基于日志窗口内是否恢复,缺乏自动判据。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。