
考虑其他智能体控制策略的策略跟随多智能体深度强化学习
Strategy-Following Multi-Agent Deep Reinforcement Learning Considering Control Strategies Provided to Other Agents
📝 TLDR
在多智能体深度强化学习中,已有指令控制方法要求向所有智能体下达指令,操作繁琐且难以设计更优协作模式。该研究提出一种策略跟随学习方法,仅对部分智能体下达关键动作指令,未受指令的智能体能够根据其他智能体的行为隐式补全整体任务。实验表明,该方法可使智能体切换至新的协作结构,并在性能上优于传统方法。该工作为人类管理者灵活控制多智能体协作提供了更高效的途径。
🧭 速览
现有可控制多智能体方法需对全部智能体下达指令,操作负担大且难以设计更优协作结构。
扩展多智能体深度强化学习的可控性工作,仅向部分智能体下达动作指令,其余智能体根据其他智能体的行为隐式补全任务。
实验显示采用该方法的智能体能切换到新的协作结构,整体性能优于传统指令控制方法。
该方法支持人类以更简洁指令灵活调控多智能体协作,提升了实际应用中的可控性与适应性。
🆚 方法对比
sfDA6-X(前期工作)
- 通过抽象策略指令实现学习后可控性
- 使用学习策略生成动作无需细粒度指令
- 学习时显式方向有助于防止惰性智能体
- 智能体可自主确定行为并覆盖环境
- 需要对全部智能体提供方向指令
- 智能体数量增加时指令负担显著增大
- 可能导致与环境结构不一致的行为
- 指令覆盖不全时出现协作不均衡
提出的方法(考虑其他智能体指令)
- 无需指令的智能体可自主补全协作任务
- 聚合其他智能体方向信息,与数量无关
- 可在不重训的情况下切换协作结构
- 实验显示性能优于sfDA6-X等传统方法
- 仅在目标收集游戏中验证,泛化待考察
- 依赖注意力机制聚合他人方向信息
- 智能体间隐式协调缺乏显式理论保证
- 对人类管理者意图推断仍有限制
传统MADRL方法
- 无需人类指令可自主学习协作策略
- 在自动驾驶、实时策略游戏等已广泛应用
- 深度学习支持复杂环境下的端到端学习
- 存在惰性智能体问题导致不协作
- 协作结构常收敛至局部最优
- 微调需重新训练,效率低下
- 学习后难以响应环境变化与人类意图
本文在sfDA6-X基础上提出新方法,核心改进在于让未被指令的智能体通过聚合他人的方向信息自适应补全协作任务,从需要对全部智能体指令扩展到仅需指定部分智能体指令,其余智能体隐式协作,从而缓解智能体规模扩大时的指令负担和协作失衡问题
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
这篇论文针对多智能体深度强化学习中人类难以高效控制协作结构的问题,提出了一种名为 sfDA7-X 的策略跟随方法。其核心思想是仅对部分关键智能体下达粗粒度指令(如"去某个区域"),未受指令的智能体则通过新设计的聚合目标通道(ADC)感知其他智能体的策略方向,自发补全被忽视的区域。实验在网格对象收集任务中验证了该方法的有效性:在有偏指令设置下,相比基线方法 sfDA6-IQN,对象收集数提升 8.00%,奖励提升 6.76%,且热力图可视化确认了智能体确实能实现互补覆盖而非重复进入同一区域。
研究背景与动机
基于深度强化学习的多智能体系统已在自动驾驶、实时战略游戏、无人机协作等场景展现出显著潜力。然而,训练完成的智能体在实际部署中仍面临两大长期挑战:一是懒智能体问题,即部分智能体发现不参与协作也能享受团队收益,从而逐渐丧失积极性;二是训练收敛的协作结构往往只是局部最优,难以与人类管理者的预期意图保持一致。
为解决可控性问题,已有研究尝试使用语言指令、程序化指令或条件策略等技术手段控制智能体行为。但这些方法存在一个共同缺陷:假设指令必须下达给全部智能体。在拥有数十乃至数百个智能体的真实系统中,对每个智能体逐一设计并下发指令既耗时耗力,也难以从全局视角优化协作结构。人类管理者真正期望的交互方式是:仅告诉某些关键智能体"去做什么",其余智能体能够自动理解整体目标并填补空缺——这正是本文想要解决的核心问题。
方法
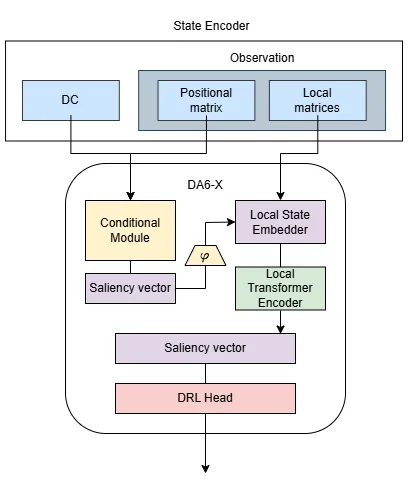
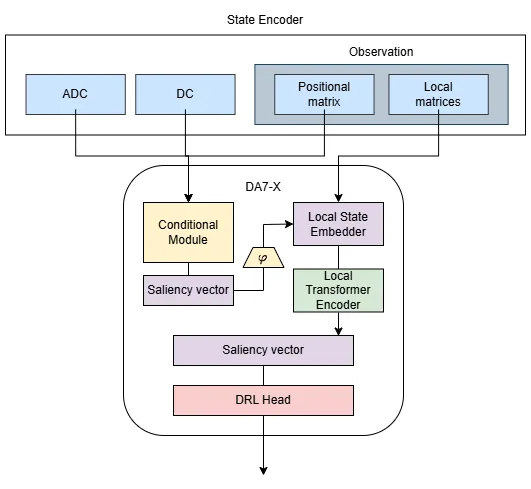
论文在已有的 sfDA6-X(策略跟随分布式注意力 actor 架构)基础上进行扩展,核心创新是引入聚合目标通道(Aggregated Decision Channel, ADC)。
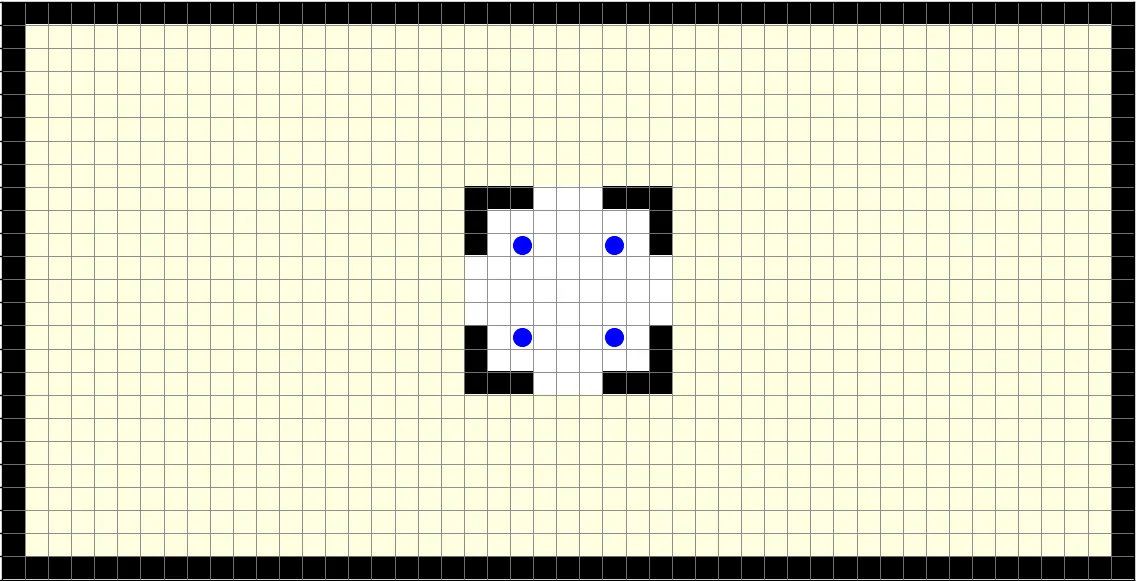
在形式化层面,多智能体系统被建模为 Dec-POMDP:时间步 ,智能体集合 ,每个智能体学习策略 以最大化折扣累积回报 。目标通道(DC)是一个 的二值矩阵,标记"建议活动区域"——训练时仅当智能体在 DC 标记区域内收集对象时获得正奖励。人类管理者通过调整 DC 形状即可在测试时以粗粒度方式控制智能体的偏好区域。
ADC 的设计理念是:让每个智能体不仅知道自己的指令,还能感知其他智能体被分配了什么指令。具体而言,设 episode 下分配给"除智能体 之外所有智能体"的 DC 集合为 ,则智能体 接收的 ADC 定义为:
这意味着当其他智能体都偏向同一区域时,ADC 在该区域的值会更大,从而自然引导当前智能体前往"被忽视"的区域。论文假设在执行阶段智能体可以获取所有 DC,这是因为 DC 由人类管理者统一下发,集中可获取。
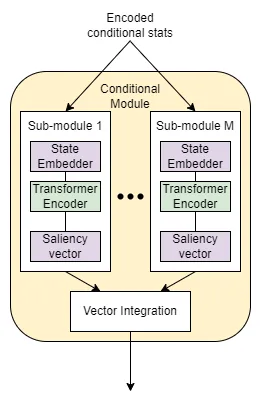
网络结构上,ADC 与原始 DC 一起输入条件模块的多头自注意力与 Transformer 编码器中,注意力机制帮助智能体权衡自身指令与其他智能体指令的相对重要性,生成综合性的显著性向量后传入 DRL head(如 IQN)输出 Q 值选择动作。ADC 的数学形式极为简洁——仅是对他人 DC 的求和,与智能体数量 无关,具有良好的工程化部署前景和可扩展性。
实验与结果
实验在 的网格对象收集游戏环境中进行,4 个智能体,动作集为四向移动,环境始终维持 80 个可收集对象,episode 长度为 200 步。DC 仅配置两种类型:entire(全域)与 half(半域),用于模拟人类下达的不同偏好的区域指令。
训练阶段的结果显示,sfDA7-X 相比基线 sfDA6-IQN 在对象收集数上提升 3.80%,奖励提升 3.26%,且收敛速度基本相当,说明额外的 ADC 输入并未显著增加学习负担。
更具实际意义的是有偏 DC 执行阶段的对比。此时人类有意让部分智能体偏向特定区域,观察未受指令智能体能否自动补全剩余工作。结果表明 sfDA7-IQN 在对象收集数上提升 8.00%,奖励提升 6.76%。热力图可视化直观揭示了行为差异:sfDA6-IQN 中未被指令的智能体倾向于重复进入已被同伴偏好的区域,导致区域覆盖不均;而 sfDA7-IQN 的智能体能够主动识别并走向被忽视的区域,实现更合理的互补覆盖。无偏 DC 下的实验进一步验证了 ADC 的可解释性——当其他智能体集中在某区域时,ADC 值差异显著影响当前智能体的行为倾斜程度。
讨论与可借鉴点
论文的方法在概念上清晰优雅:ADC 机制引入了"互补感知"的归纳偏置,使智能体无需显式通信即可理解团队协作的全局态势。这一设计兼顾了人类可控性与智能体自主性——人类只需给出粗粒度指令,高频的"剩余调度"由智能体自适应完成。
然而实验设计存在明显不足:仅在单一网格环境、仅 的设置下验证,缺乏与 QMIX、MAPPO 等标准多智能体基线的横向对比,也未进行消融实验来单独评估 ADC 的贡献。ADC 的有效性高度依赖"执行阶段可获取所有 DC"的假设——若在分布式场景中 DC 无法集中收集,则需要额外的通信开销。DC 类型仅限 entire/half 两种规则形状,更复杂的非凸区域或带障碍物的引导区域尚未探索。
对于该领域的研究者而言,ADC 的设计思路值得借鉴:让智能体感知"队友在做什么"而非直接传递动作信息,是一种轻量级的隐式协调机制。该思想可推广至需要层次化控制的多智能体场景,如多机器人仓库调度、异构无人机群协同等。后续工作应在 StarCraft 多智能体挑战、MuJoCo 等标准基准上验证,并探索 ADC 在更大规模智能体群中的可扩展性表现。
摘要
本研究提出了一种多智能体系统的学习方法,该方法允许智能体在学习后通过人类管理者的指令进行控制,并使未接受指令的智能体能够根据其他智能体的动作隐式地补充整体工作。基于深度学习的多智能体应用已展现出潜力;因此,为了实现广泛的社会应用,人类应能够使用简便的方法控制已训练的智能体,以应对环境和社会变化。即便没有上述变化,已学习到的协作通常也难以符合人类管理者的期望,因此更倾向于控制协作结构以匹配人类意图。一些研究致力于使用简单指令控制智能体行为。然而,它们假设指令会提供给所有智能体,这既耗时费力,在设计更优的协作机制时也不够清晰。理想情况下,特定智能体应接收关键动作指令,而其他智能体应自动完成剩余任务。所提方法扩展了先前关于多智能体深度强化学习可控性的研究,使未接受指令的智能体能够自适应地补充被忽视的任务和区域。实验结果表明,使用所提方法的智能体能够转换至另一种协作结构,并实现优于传统方法的性能。
Abstract
This study proposes a learning method for multi-agent systems that allows agents to be controlled through human manager instructions after learning and enables uninstructed agents to implicitly complement the overall work based on the actions of other agents. Multi-agent applications using deep learning have shown potential; thus, to achieve extensive social applications, humans should be able to control learned agents using simple methods to respond to environmental and social changes. Even without such changes, learned coordination often does not match the expectations of human managers, making it preferable to control coordination structures to match human intentions. Some studies have aimed to control agent behavior using simple instructions. However, they assumed that instructions are provided to all agents, which is time-consuming and not evident when designing a better cooperation regime. Ideally, specific agents should receive key action instructions, while others should automatically complete the remaining tasks. The proposed method, which extends previous work on controllability in multi-agent deep reinforcement learning, enables uninstructed agents to adaptively complement overlooked tasks and areas. The experimental results show that agents using the proposed method can shift to another cooperative structure and achieve better performance than those using conventional methods.
论文详细总结(自动生成)
论文总结:考虑其他智能体控制策略的策略跟随多智能体深度强化学习
一、核心问题与研究动机
- 背景:基于深度强化学习(DRL)的多智能体系统(MADRL)在自动驾驶、实时战略游戏、无人机/车载网络优化等场景中已展现出应用潜力,但训练完成后仍面临两大长期挑战:
- 懒智能体问题(lazy-agent problem):部分智能体发现不行动也能受益于他人,从而不再积极参与协作。
- 协作结构与人类意图不一致(unaligned coordination structure):训练收敛的协作结构可能只是局部最优,未必符合人类管理者的预期。
- 现有可控性方法的不足:已有研究(如 RL 中基于语言/程序化指令的方法、CIRL、sfDA6-X 等)通常假设需要对全部智能体下达指令,这既耗时,也难以设计最优协作组合。
- 本文核心问题:理想情况下应仅对关键智能体下达动作指令,而未受指令的智能体能够隐式补全整体任务——即在保证人类可控性的同时,尽量减少人类干预的工作量并提升协作效率。
二、方法论
2.1 整体框架:sfDA7-X
在已有的 sfDA6-X(strategy-following distributed attentional actor architecture after conditional attention)基础上扩展而来,核心新增 聚合目标通道(Aggregated DC, ADC),使智能体在决策时能感知其他智能体被分配的策略方向。
2.2 预备形式化(Dec-POMDP)
- 时间步 ,智能体集合 。
- 元组 。
- 状态转移 ,奖励 。
- 每个智能体学习策略 以最大化折扣累积回报:
2.3 目标通道(DC)
- 一个 二值矩阵(0/1),标记"建议活动区域"(beige 区域)。
- 训练时:仅当智能体在 DC 标记区域内收集对象时获得正奖励 ;其他区域收集无奖励。
- 通过调整 DC 形状即可在测试时以粗粒度控制智能体偏好的活动区域。
2.4 关键创新:聚合目标通道 ADC
设 episode 下分配给"除智能体 之外所有智能体"的 DC 集合为 ,则智能体 接收的 ADC 定义为:
- ADC 是单一矩阵,与智能体数量 无关。
- 当其他智能体偏向同一区域时,ADC 在该区域的值更大,可引导当前智能体前往"被忽视"区域。
- 作者假设:在执行阶段智能体可获得他人 DC,理由是 DC 由人类管理者下发,集中可获取。
2.5 网络结构
sfDA7-X 在 sfDA6-X 基础上将 DC + ADC 同时输入到条件模块(CM)的多头自注意力 + Transformer 编码器中,生成显著性向量 ,再传入 DRL head(本工作采用 IQN,即 implicit quantile network 作为 DRL head):
三、实验设计
3.1 场景:对象收集游戏(Object Collection Game)
- 网格环境 。
- 个智能体;动作集 。
- 初始位置固定;环境始终维持 80 个对象,收集后随机重生。
- Episode 长度 步;训练 20,000 episodes(约 4M steps)。
- 奖励:,,;视野 。
- -greedy:1.0 → 0.05,衰减 0.998;学习率 ,折扣 ,批大小 32。
- DC 类型仅两种:
entire(全域)与half(半域)。
3.2 Baseline
- sfDA6-IQN(原文 [10] 的方法,不接收 ADC)。
- 其他方法不接收 DC 故无法直接对比(文中提示相关比较可参见 [10])。
3.3 对照指标
- 训练期:EMA 平滑后的对象收集数 + 平均奖励。
- 执行期:在有偏 DC 组合与无偏 DC 组合下分别评估收集数与奖励。
- 通过热力图分析各智能体的实际活动区域。
四、资源与算力
- 文中未明确提及任何硬件配置(GPU 型号、数量、训练耗时等)。
- 仅给出训练超参数与 episode 总数(4M steps × 3 random seeds)。
- 这一信息的缺失使得复现成本与可对比性难以评估,是论文的一个明显空白。
五、实验数量与充分性
- 随机种子数:3(learning curve 与最终均值均报告 3 seeds 的 EMA)。
- 实验分组:
1. 训练阶段学习曲线与平均性能对比(Table II)。
2. 执行阶段 4 种 DC 组合 × 4 个智能体 = 16 个 case 的对象收集数与奖励均值(Table III)。
3. Case Study 1(Pattern 1、Pattern 2):热力图分析有偏 DC 下各智能体活动区域。
4. Case Study 2(无偏 DC):验证 ADC 在 DC 覆盖整个环境时的行为。
5. 附带讨论了"DC/ADC 的其他用法"(如屏蔽他人信息等),但未给出实验数据。
- 评估维度:性能(奖励、收集数)+ 行为合理性(热力图覆盖互补性)。
- 充分性评价:
- 仅在一个环境(49×25 网格对象收集游戏)上评估,泛化性证据不足。
- baseline 单一(仅与 sfDA6-IQN 对比),缺少与无 DC 的 SOTA MADRL(如 QMIX、MAPPO)的横向比较。
- 消融实验缺失:未独立评估 ADC 单独贡献、DC 类型消融、 的扩展性。
- 16 个 case 的均值化可能掩盖个别组合的显著差异,文中也未给出方差/置信区间。
六、主要结论与发现
- sfDA7-X 在训练阶段对象收集数提升 3.80%,奖励提升 3.26%。
- 在有偏 DC 执行阶段,sfDA7-IQN 相比 sfDA6-IQN 在对象收集数上提升 8.00%,奖励提升 6.76%。
- 热力图证据显示:
- sfDA6-IQN 的"无偏指令"智能体容易重复进入已被他人偏好的区域,遗漏对侧。
- sfDA7-IQN 的"无偏指令"智能体能够主动走向被忽视区域,实现互补覆盖。
- 在无偏 DC 下,ADC 元素差异(1 vs 3)显著影响其行为倾斜程度,验证了 ADC 的可解释性。
七、优点
- 方法简洁可落地:ADC 仅是对他人 DC 的求和,与 无关,易于工程化部署。
- 兼顾可控性与自主性:保留人类通过 DC 给出粗粒度指令的能力,同时把"剩余调度"交给智能体自适应完成。
- 可解释可视化:通过热力图直观呈现互补行为,对人类管理者友好。
- 学习效率不下降:训练曲线显示 sfDA7-X 收敛速度与 sfDA6-X 基本相当,并未因额外输入而显著恶化。
- 讨论了 ADC 灵活性:包括屏蔽他人信息(强制忽略 ADC)等实用用法。
八、不足与局限
- 缺乏硬件/算力信息:无法评估训练成本与可复现性。
- 环境单一:仅 49×25 网格 + 4 智能体的对象收集游戏,未在 StarCraft Multi-Agent Challenge、MuJoCo Multi-Agent、SMAC 等标准基准上验证。
- 方法局限:
- 依赖"执行阶段可获取所有 DC"的强假设;若 DC 由分布式人员下发而无法集中收集,方法需通信开销。
- 仅测试 ,未扩展至更大规模智能体群。
- DC 仅两类(entire / half),未考察更复杂形状(如不规则、有障碍的引导区域)。
- 实验充分性不足:无消融(如去掉 ADC)、无方法对比(如 QMIX/MAPPO)、无统计显著性检验;随机种子仅 3 个。
- 奖励设计可能掩盖问题:对象重生机制较简单,懒智能体风险未必充分暴露。
- 可扩展性未知:智能体网络结构、显著性向量维度等如何在更大 、更复杂任务下保持性能,文中未讨论。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。