
面向连续动作空间协作任务的自我演化默认动作
A Self-Evolving Default Action for Cooperative Tasks with Continuous Action Space
📝 TLDR
反事实信用分配在多智能体强化学习中效果显著,但难以直接推广到连续动作协同任务。现有基于蒙特卡洛采样的基线方法因采样动作未充分训练,易引入策略梯度偏差,无法保证收敛到局部最优。本文提出SAFE框架,利用各智能体经验回放池中的自演化默认动作作为反事实基线,无需额外仿真、奖励模型或领域先验。该方法在确定性策略梯度下无偏,可保证收敛到局部最优,并在合作式车辆任务上全面超越现有最优模型。
🧭 速览
连续动作空间中,蒙特卡洛采样得到的反事实基线训练不足,会向策略梯度引入偏差,难以保证收敛至局部最优。
提出SAFE框架,以从各智能体经验回放池采样的自演化默认动作充当反事实基线,无需额外仿真或奖励模型。
在合作式车辆任务的大量实验上,SAFE多个指标一致优于当前最优模型。
SAFE为连续动作协同任务提供无偏且可收敛的反事实信用分配方案,拓展了MARL适用边界。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
TL;DR
这篇论文研究了多智能体强化学习中如何将反事实信用分配扩展到连续动作空间的协作任务。核心思路是从各智能体的经验回放缓冲区中采样"自我演化默认动作"作为反事实基线,避免了蒙特卡洛采样引入的策略梯度偏差。SAFE 在合作式自动驾驶任务上全面超越了现有最优方法,且有严格的理论收敛性保证。
研究背景与动机
多智能体强化学习在协同任务中展现出巨大潜力,尤其是在离散动作空间的场景(如星际争霸II)中已经取得了显著突破。然而,真实世界中的许多应用——比如自动驾驶车辆编队控制、机器人协作搬运、无人机蜂群编队——本质上都需要连续动作控制。将已有的多智能体方法直接迁移到连续空间并非易事,这其中最核心的挑战之一就是[[反事实信用分配]]问题。
在单智能体场景中,我们可以通过比较当前动作与"如果做了别的动作会怎样"来量化每个决策的贡献。但多智能体场景更加复杂:多个智能体同时决策,最终结果往往是联合动作的产物。如何准确识别每个智能体的独立贡献,同时避免"旁观者智能体坐享其成"的问题,是多智能体信用分配的核心难题。COMA 等方法通过[[中心化训练去中心化执行(CTDE)]]范式,利用中心化评论家来估计反事实基线,在离散动作空间取得了不错的效果。
然而,当动作空间从离散变为连续时,问题的性质发生了根本性变化。最直觉的做法是用[[蒙特卡洛采样]]从连续动作空间中随机采样若干替代动作,然后用这些采样动作的 Q 值均值作为反事实基线。但这种方法存在致命缺陷:随机采样的动作很可能从未被智能体认真执行过,因此对应的 Q 值估计极其不准确。更严重的是,这样的基线在策略梯度中的期望不为零,会向梯度引入系统性偏差,最终导致算法无法保证收敛到局部最优解。
本文的研究问题由此清晰浮现:能否设计一种适用于连续动作空间的反事实基线,既能准确量化每个智能体的贡献,又不会向策略梯度引入偏差,同时保证收敛性?
方法
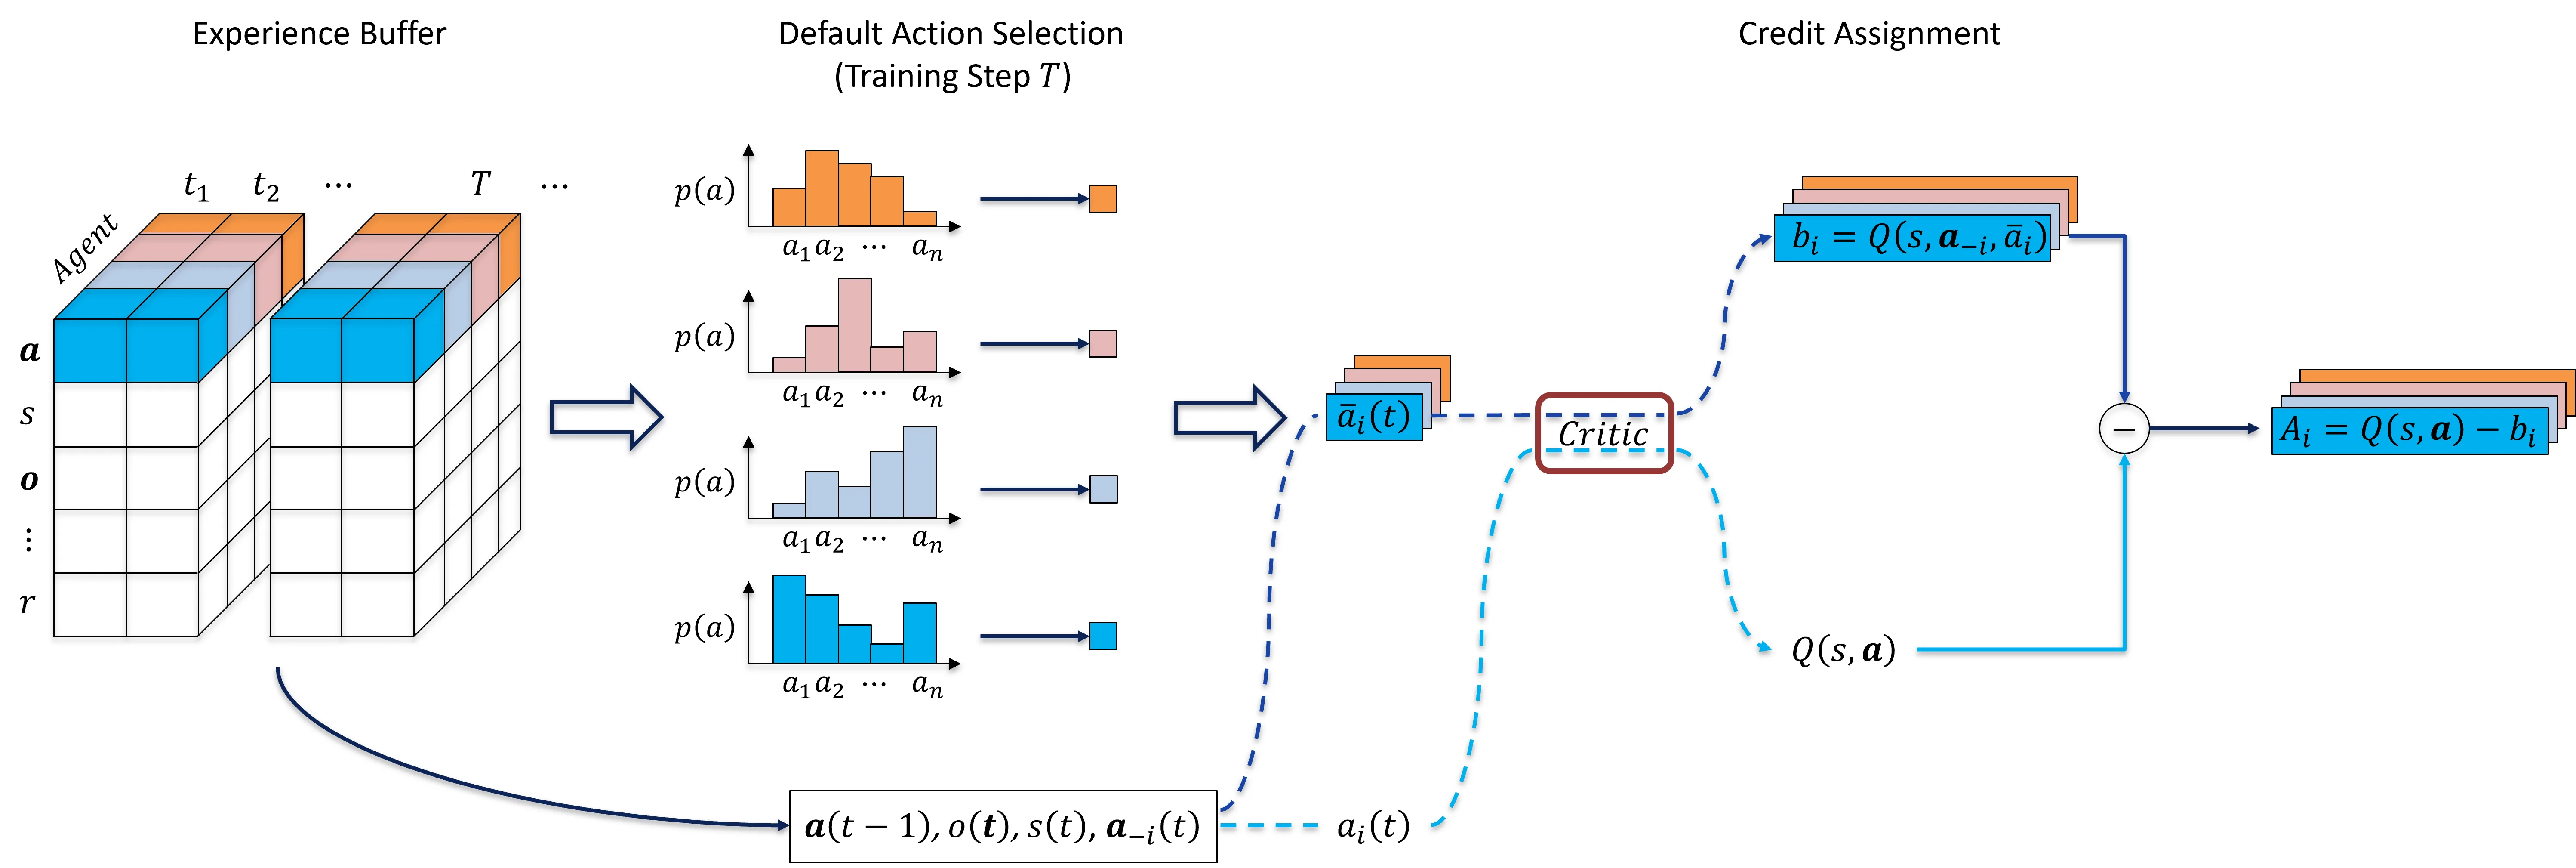
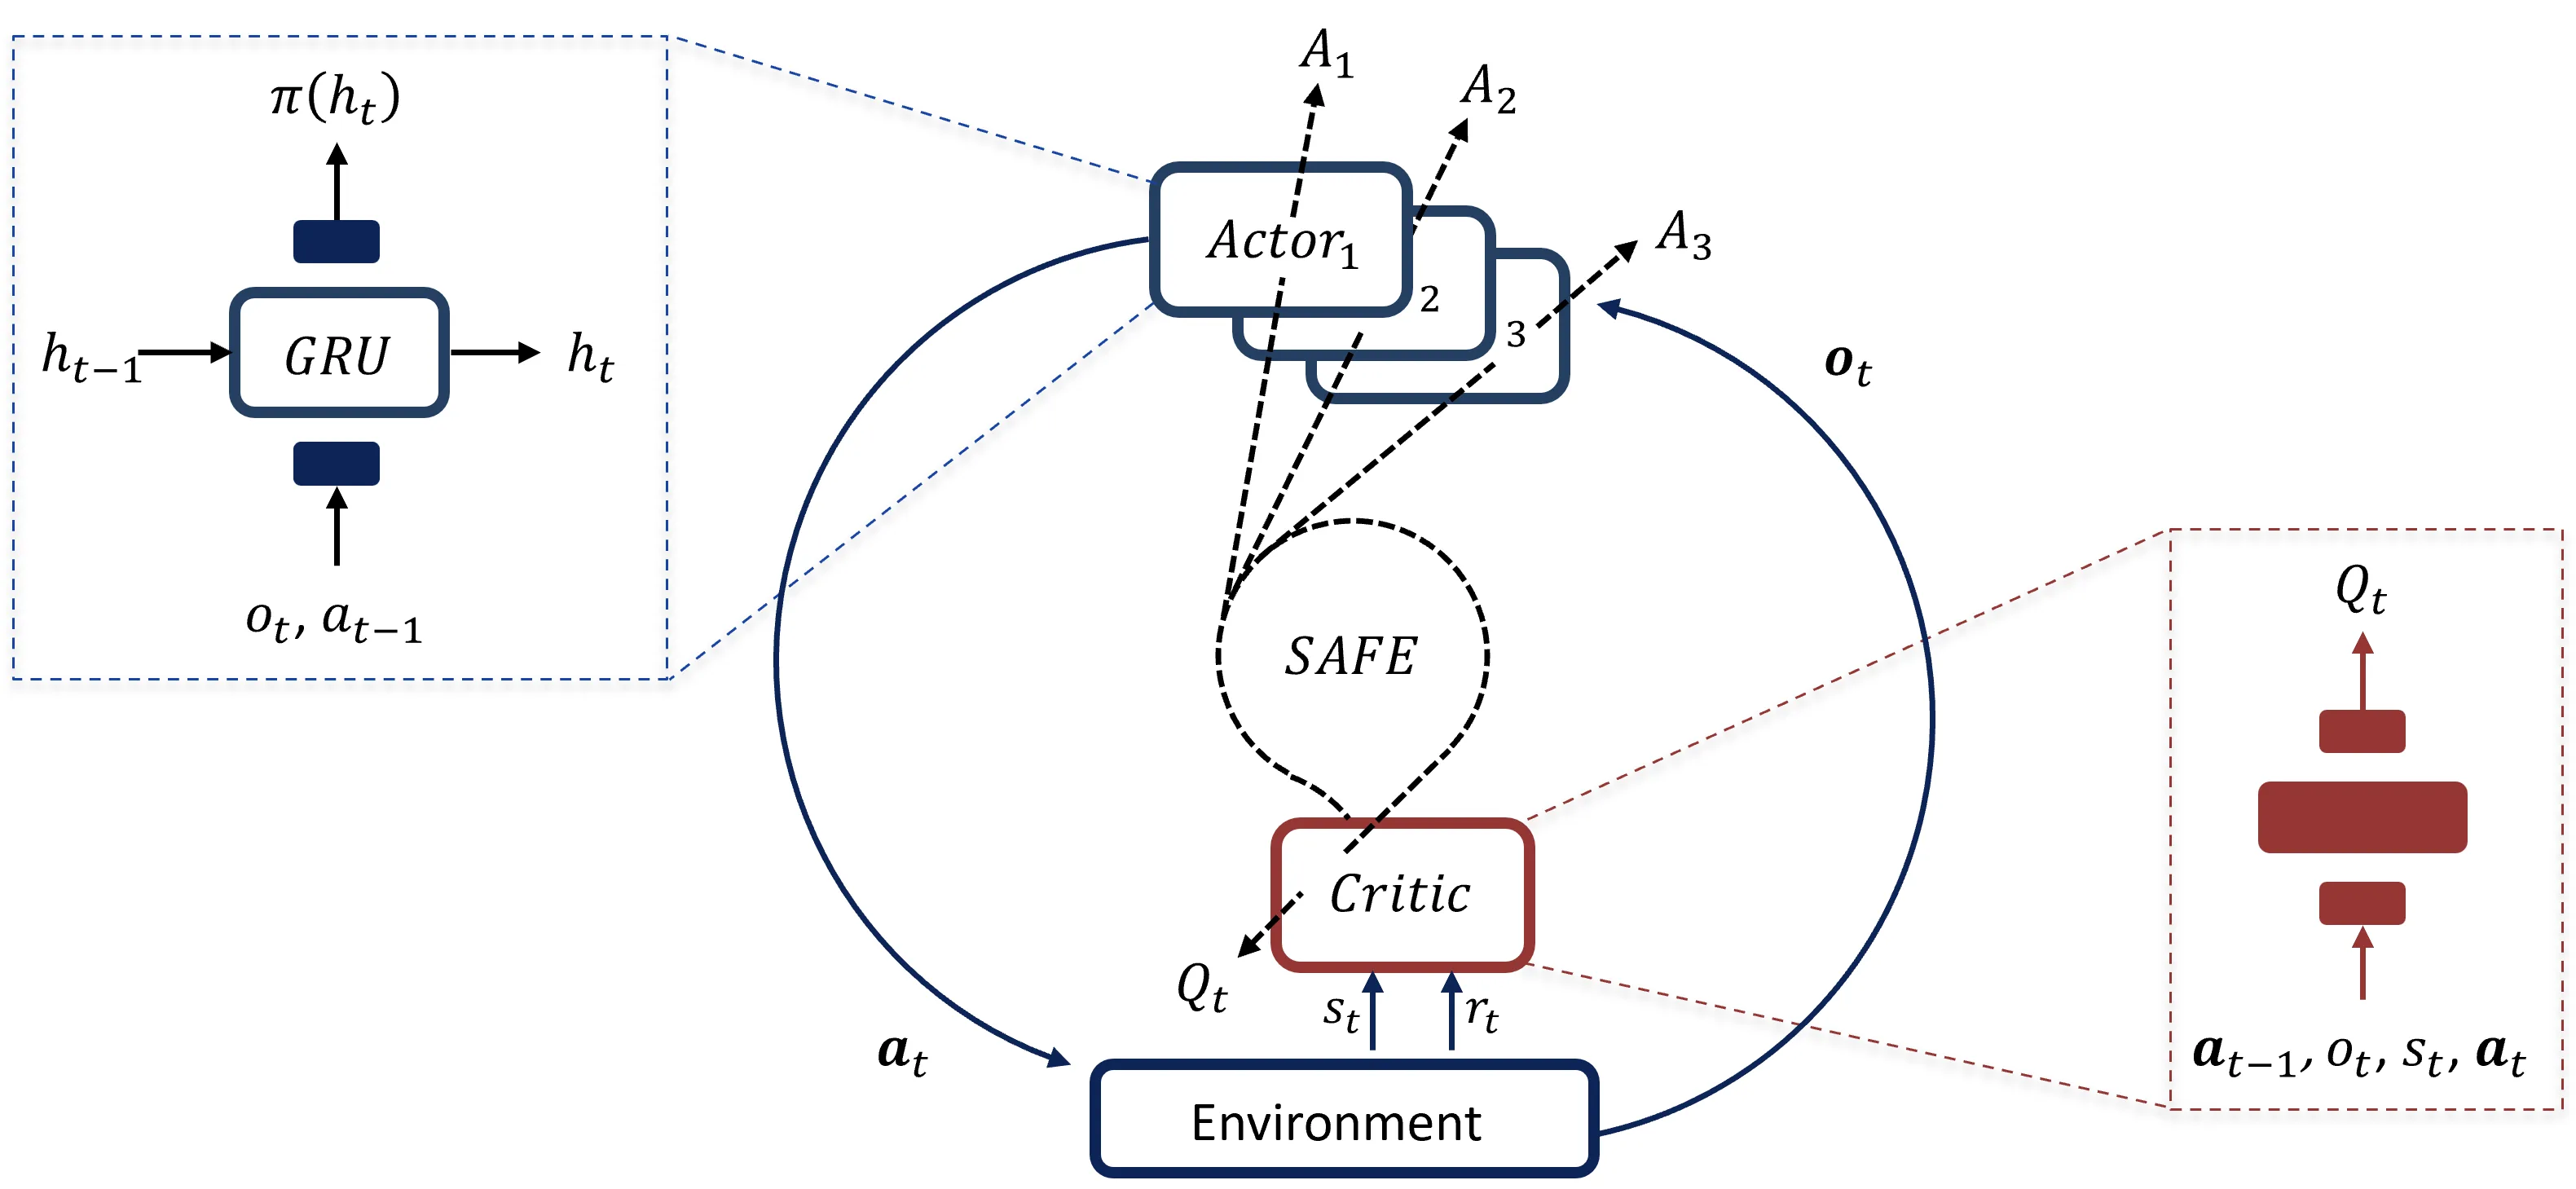
SAFE 的核心思想说起来相当优雅:从每个智能体自己的[[经验回放缓冲区]]中采样一个动作作为反事实基线。这个动作不是随机生成的,而是智能体在训练过程中真实执行过的,因此天然具有充分的训练量。
具体而言,设 为第 步训练时的经验回放池,SAFE 从中均匀采样得到默认动作 ,并以此构造反事实基线:
这里的 表示除智能体 之外所有智能体的动作, 是中心化评论家输出的联合 Q 值。优势函数则定义为:
整个设计的关键在于 与当前策略采样动作 的独立性。由于默认动作来源于经验回放池而非当前策略网络,基线项的期望恰好为零:
这意味着 SAFE 提供的基线不会向[[确定性策略梯度]]引入任何偏差。
网络的架构采用典型的 CTDE 模式:中心化评论家在训练时接收全局状态 和所有智能体的观测-动作历史 作为输入,输出联合 Q 值;去中心化演员在执行时仅依赖自身历史 输出连续动作。各智能体之间共享 actor 参数以提高可扩展性。动作的生成采用带探索的确定性策略:,其中 是动作空间内的均匀随机扰动, 从 1.0 指数退火至 0.05。
随着训练的推进,经验回放池中频繁执行的动作逐渐聚集,采样得到的 自然会逼近智能体的"平均表现"动作。这个过程完全是自监督的,无需额外的仿真环境、奖励模型或任务相关的领域知识。这正是方法命名为"自我演化默认动作"的原因。
实验与结果
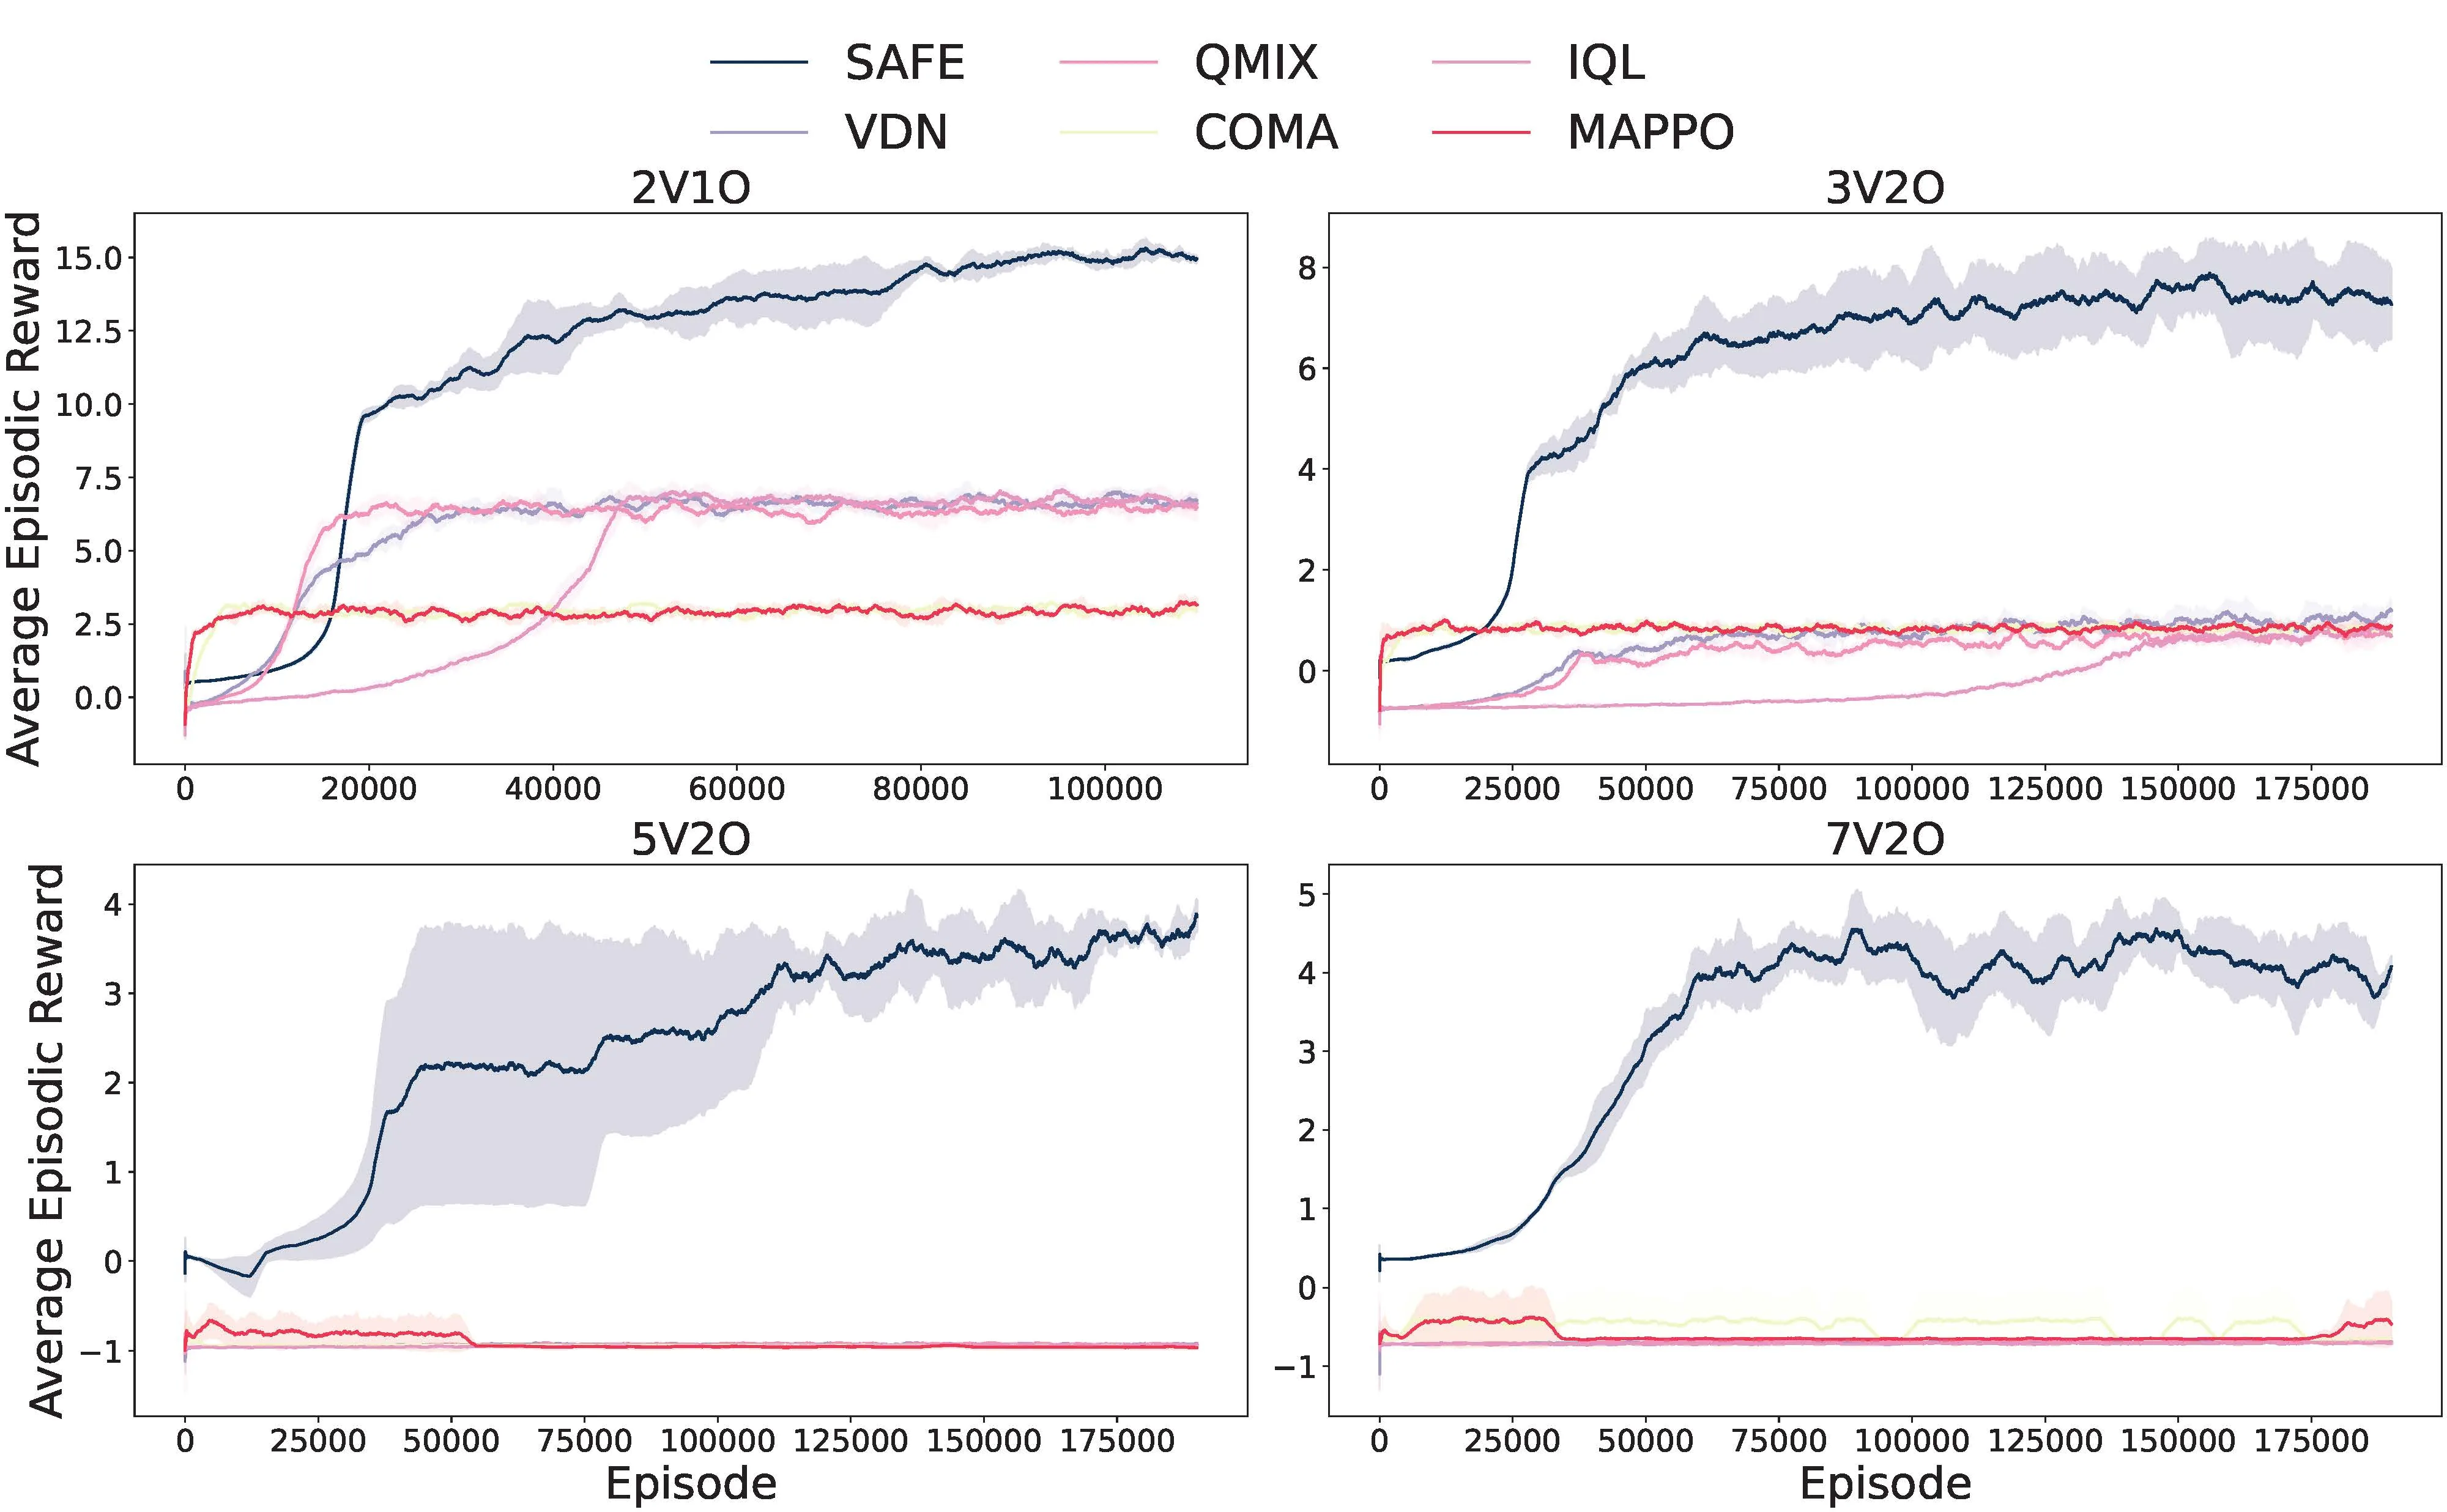
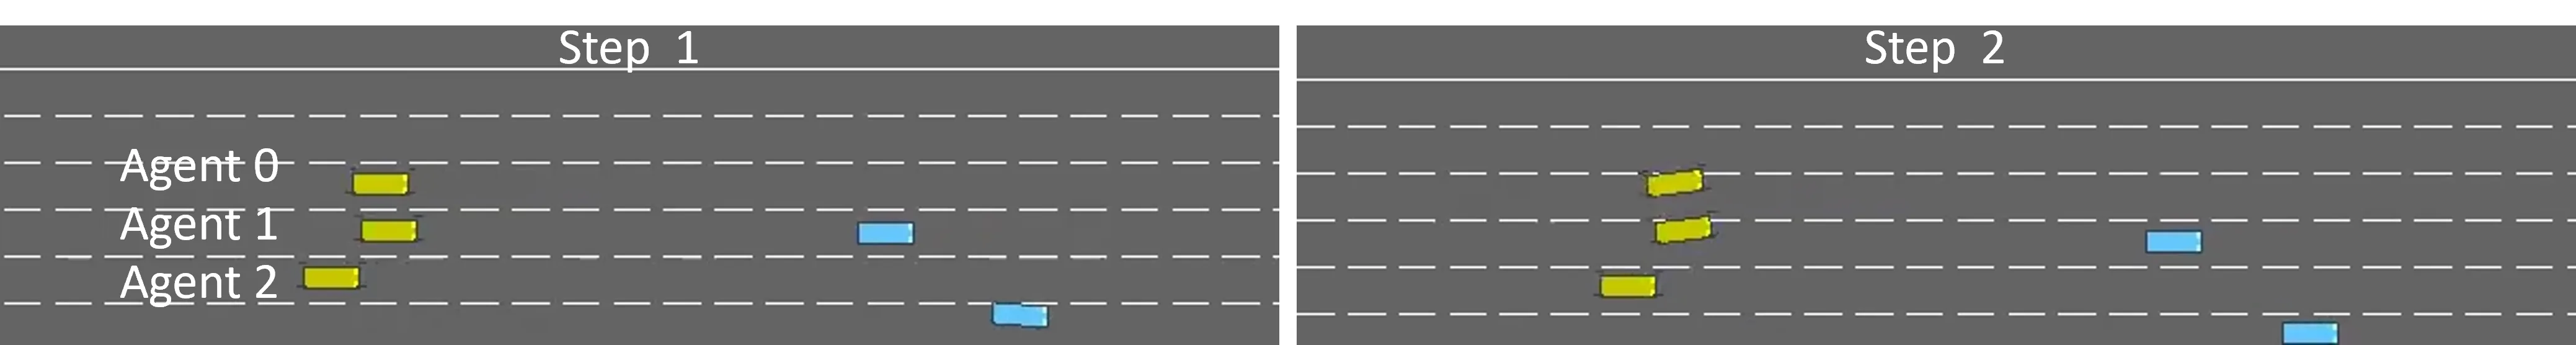
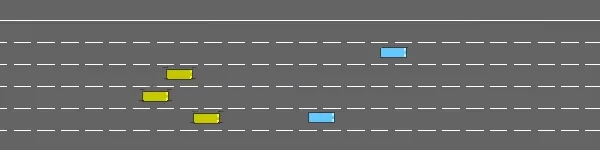
实验基于 Highway-Env 合作式自动驾驶环境构建了四个复杂度递增的场景:2V1O、3V2O、5V2O 和 7V2O(分别表示受控车辆数和障碍车辆数)。动作空间为转向角 的连续区间,奖励函数综合考虑碰撞惩罚、编队激励和行驶效率。
对比基线涵盖了当前主流的多智能体强化学习方法,包括价值分解类的 VDN 和 QMIX、独立学习方法 IQL、基于反事实信用分配的 COMA,以及策略梯度方法 MAPPO。值得注意的是,所有基线方法均被限制在离散元动作空间(如左车道、空挡、右车道、加速、减速)上进行对比,而非让其在连续动作下竞争性适配。
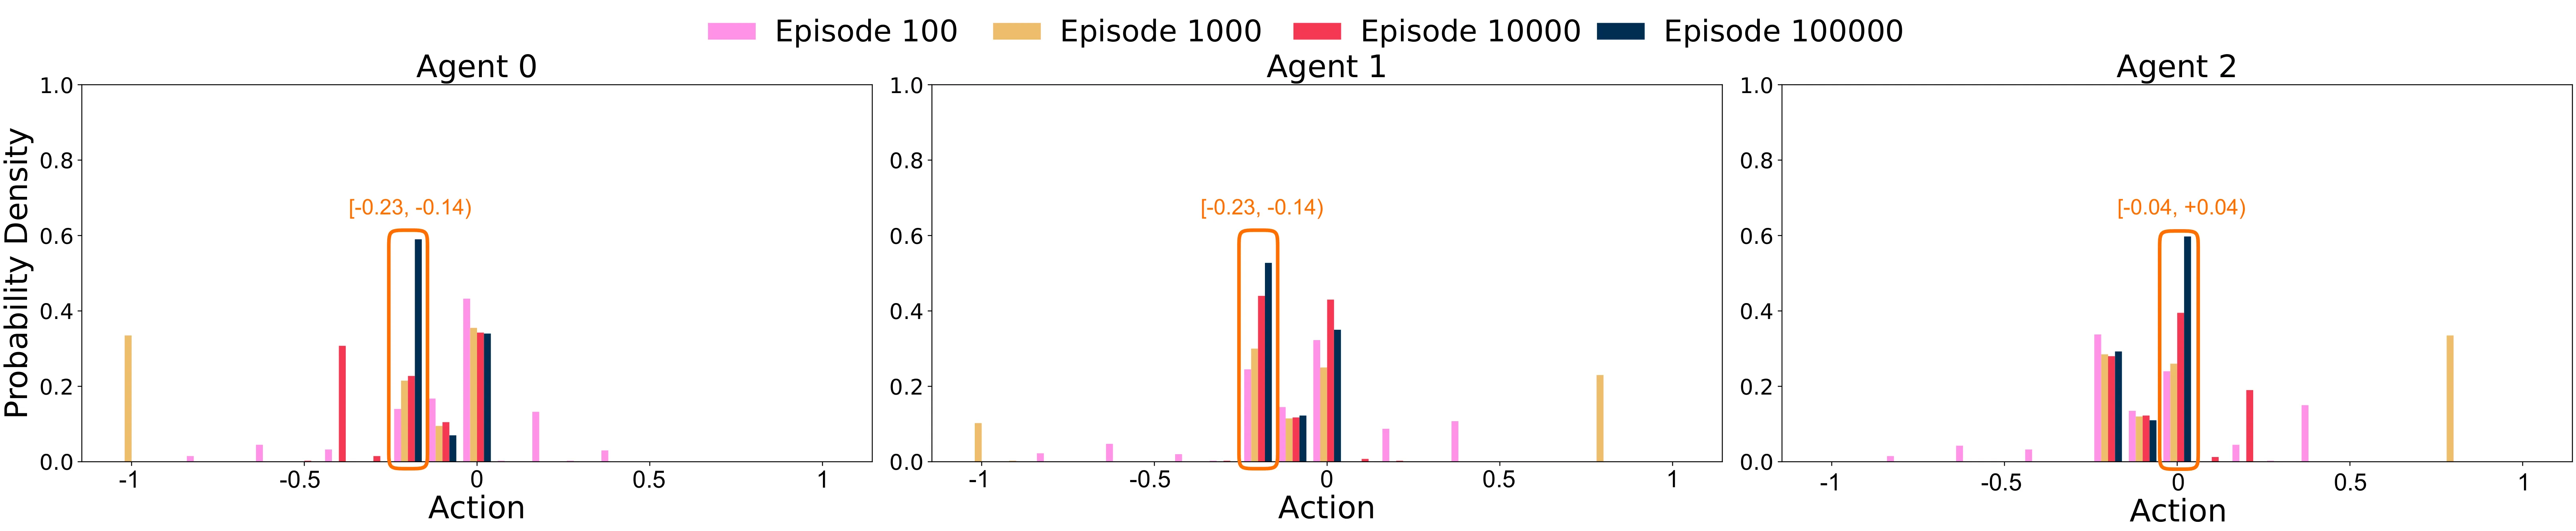
实验结果揭示了几个重要发现。在碰撞率指标上,SAFE 展现出压倒性优势:2V1O 场景中碰撞率仅为 0.029,比 COMA 低 97%,比 QMIX 低 40%;在更复杂的 7V2O 场景中,SAFE 的碰撞率仍显著低于所有基线。概率密度分析进一步验证了默认动作的演化特性:随着训练推进,采样动作的分布自发聚集到智能体最常执行的动作区间,有效反映了平均表现水平。
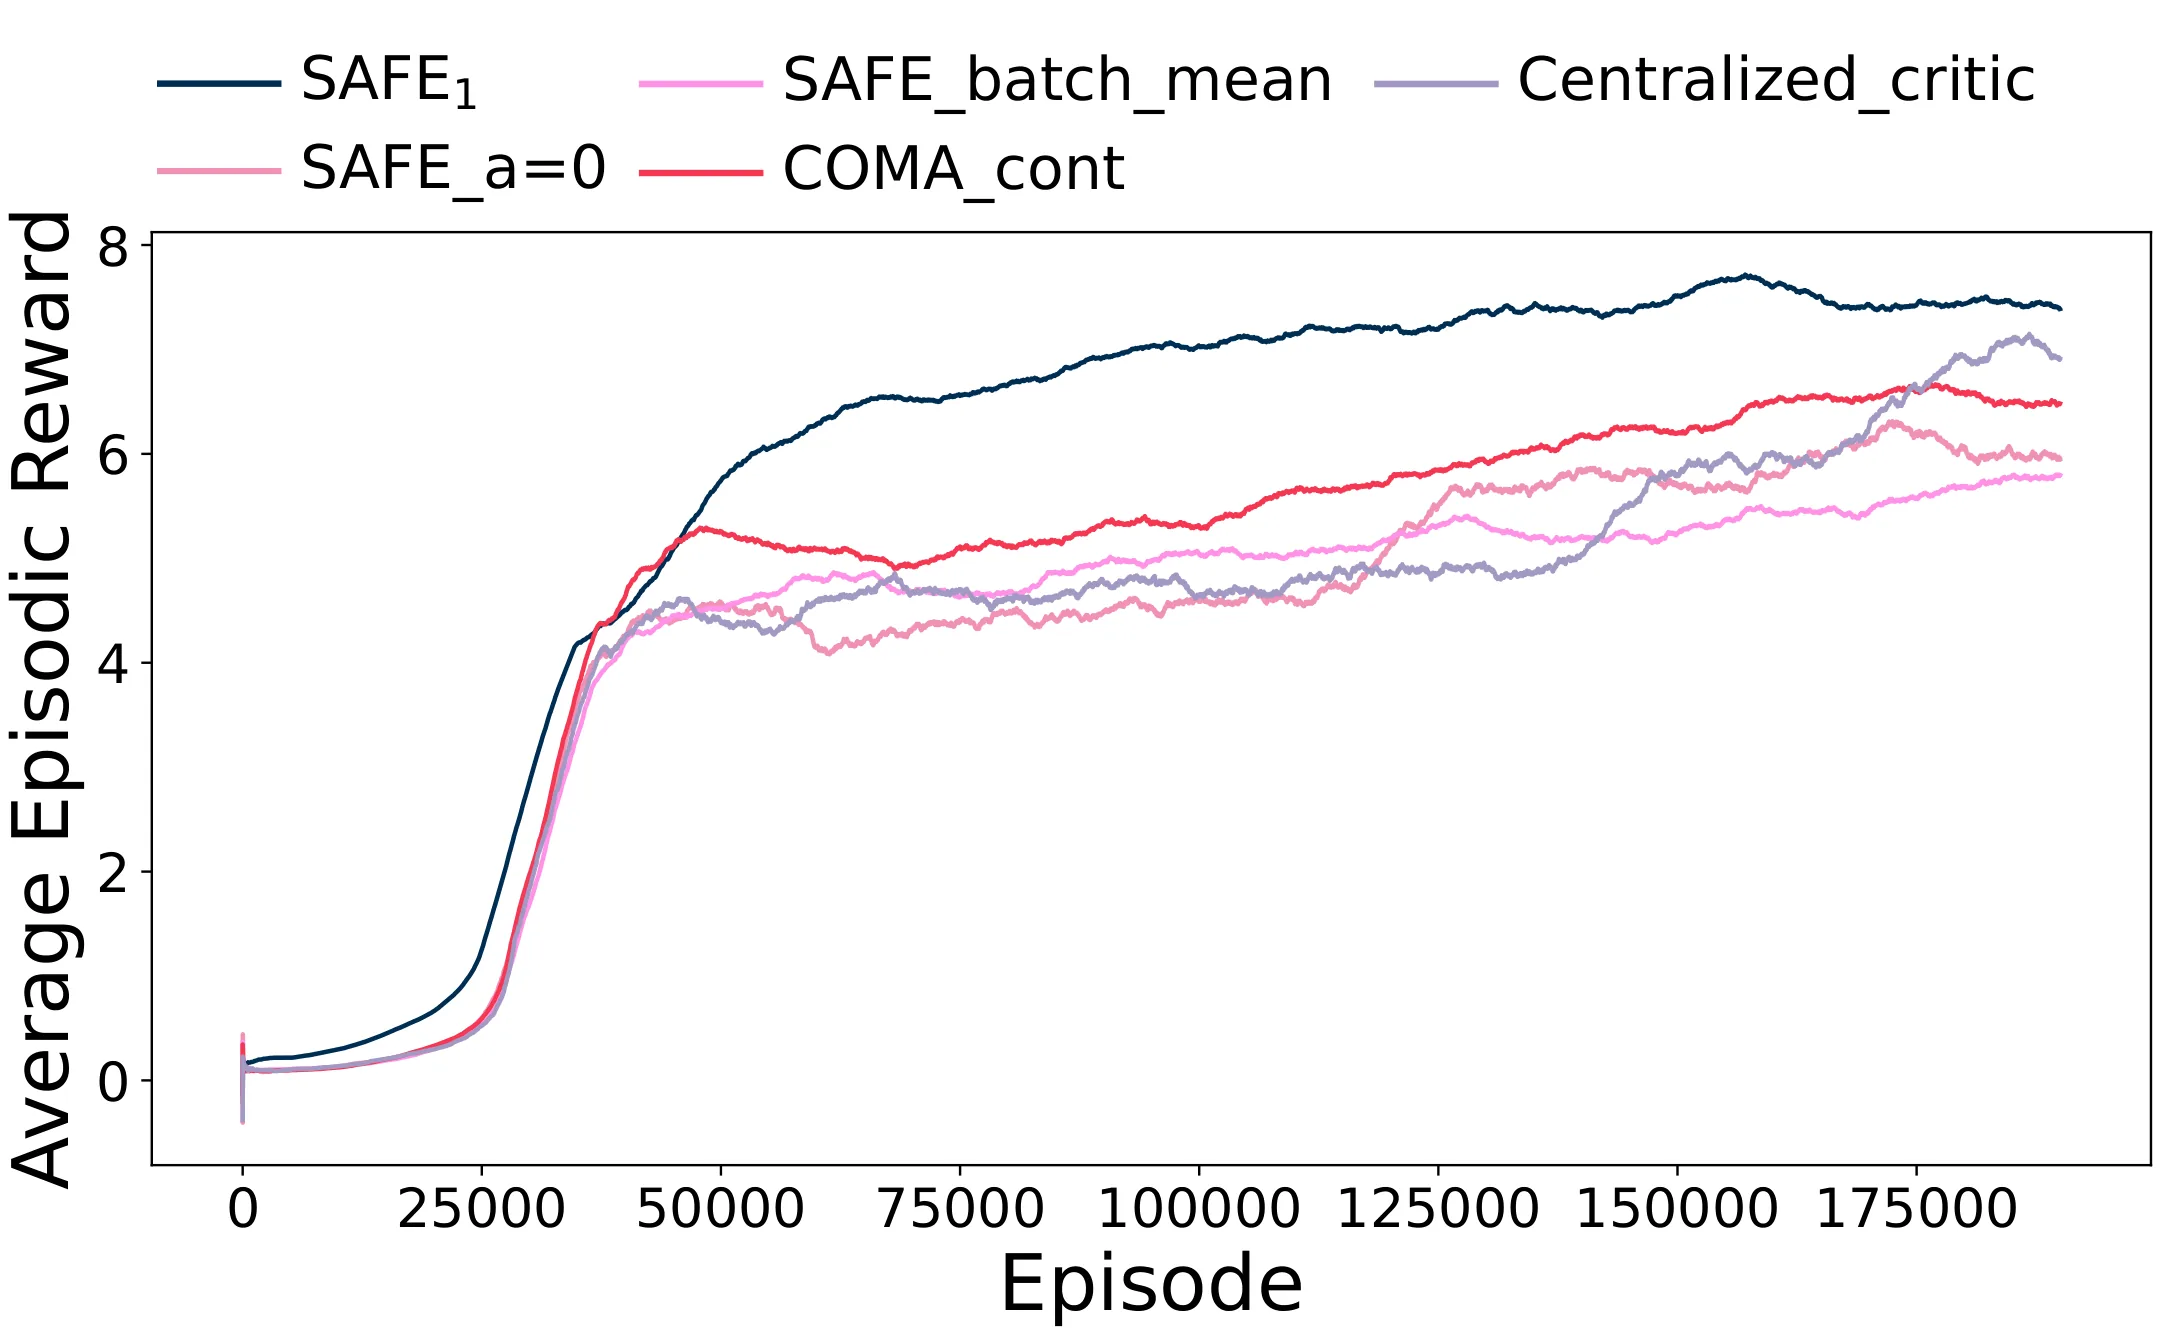
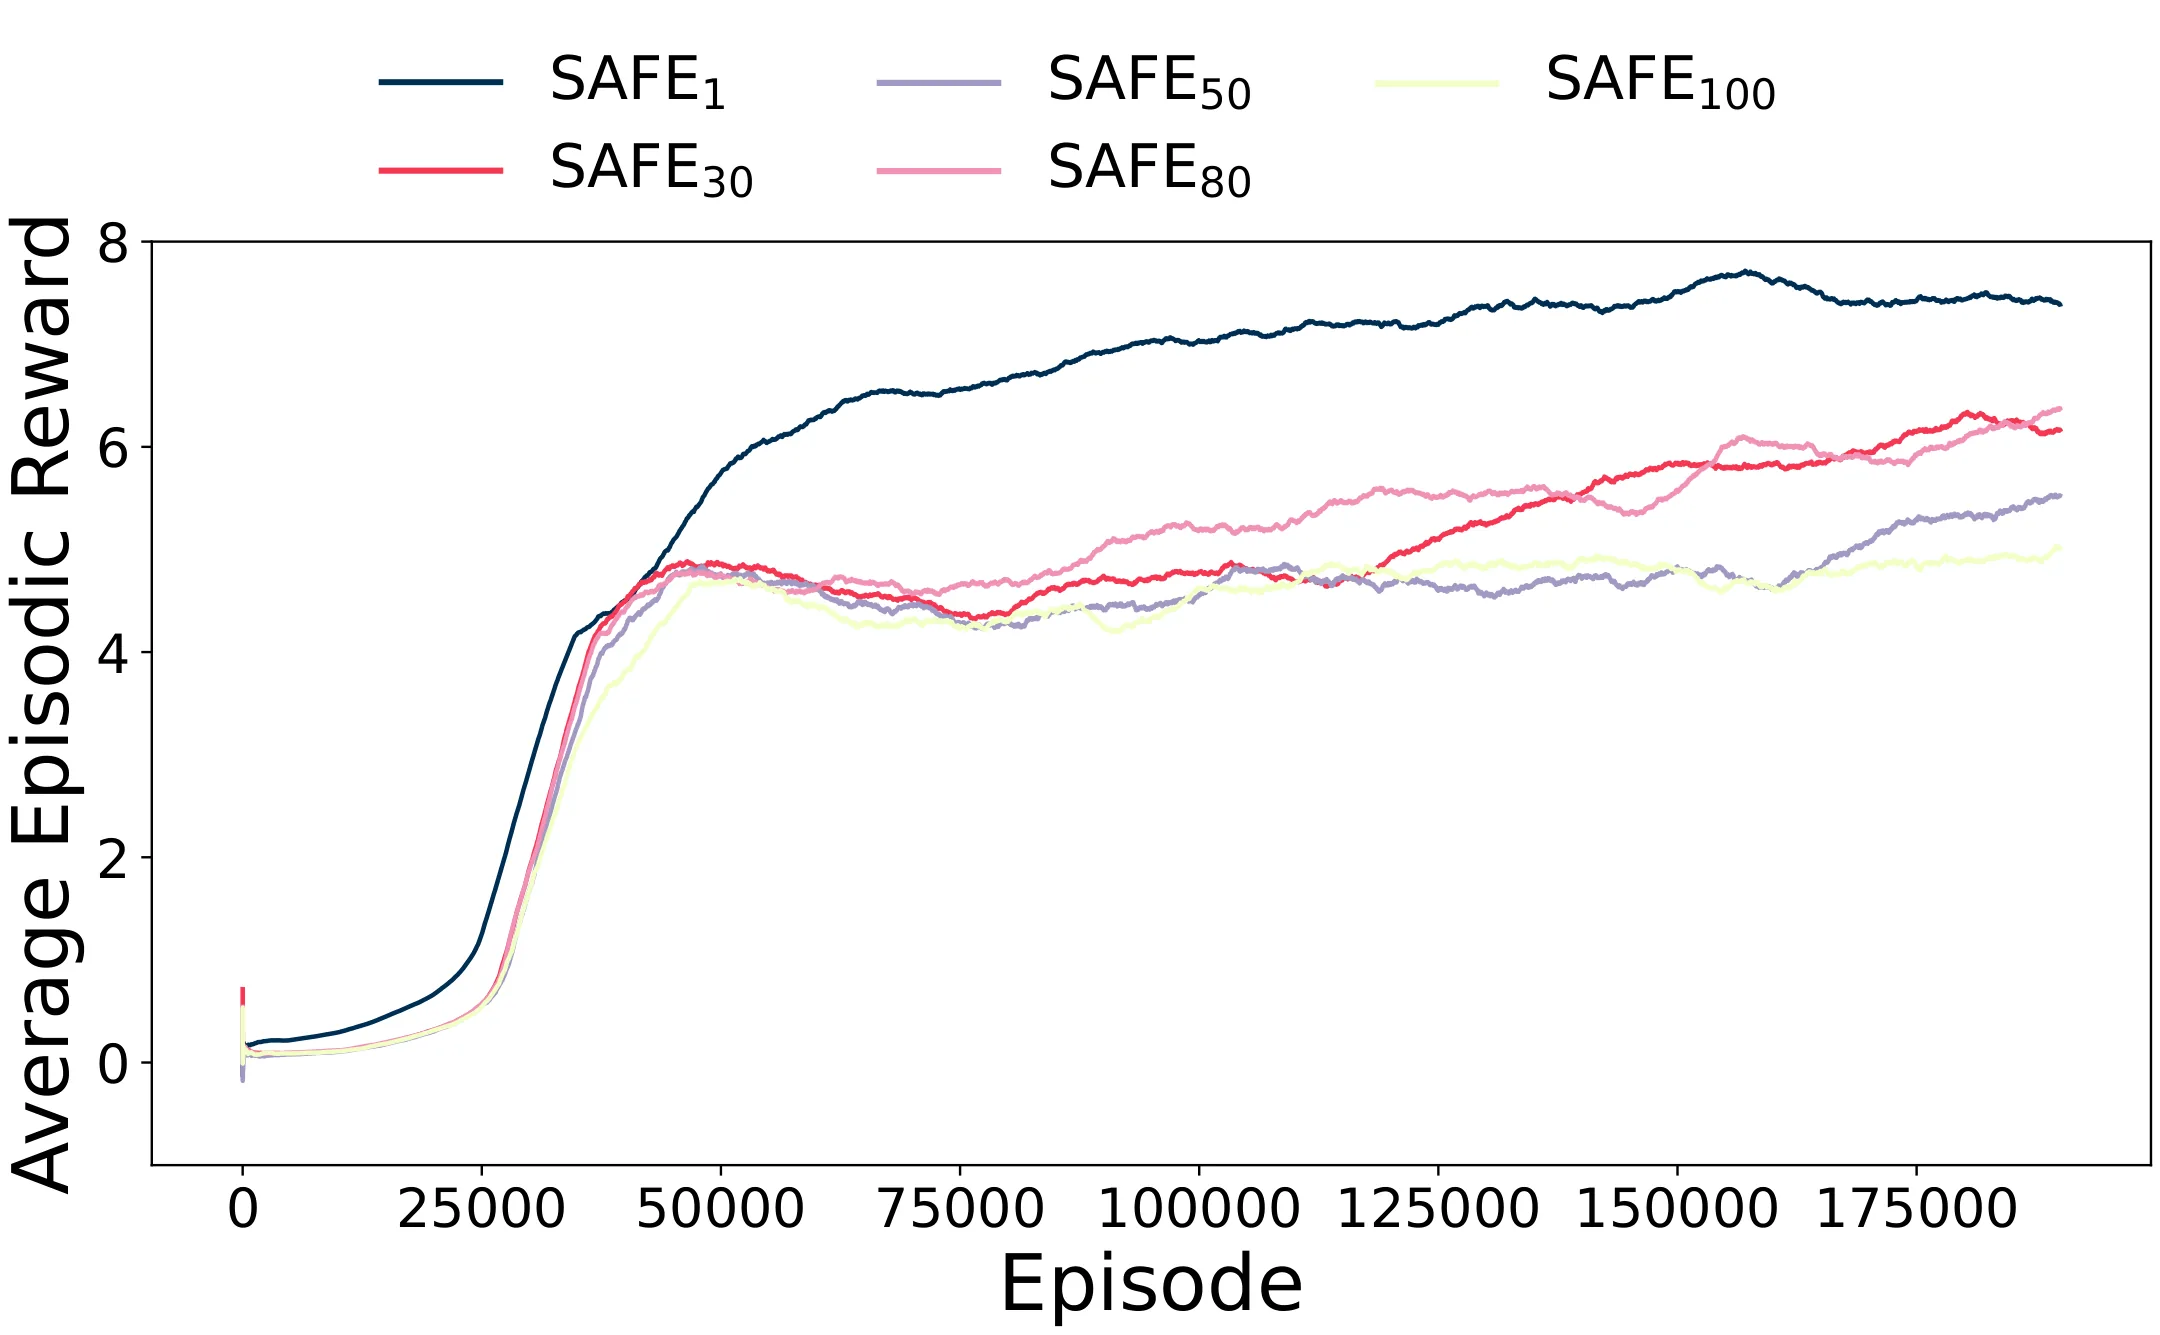
消融实验区分了性能提升的来源。对比 SAFE_a=0(固定零动作为基线)、SAFE_batch_mean(32 个采样动作均值)、COMA_cont(连续动作版 COMA)以及 Centralized_critic(无信用分配),结果明确显示 SAFE 的性能优势来源于信用分配机制本身,而非单纯的连续动作适配。参数研究还发现 时(即仅采样一个默认动作)性能最佳,增加采样数不仅无助于估计精度,反而会引入额外的偏差。
讨论与可借鉴点
SAFE 的核心贡献在于提出了一种简洁而有效的连续动作空间反事实基线设计。经验回放缓冲区作为"训练历史的记忆载体",自然地解决了蒙特卡洛采样的两大痛点:采样动作训练不足导致的 Q 值估计不准确,以及由此引入的策略梯度偏差。从理论层面看,利用经验池中已有动作的分布特性来构造基线,而非依赖额外的随机采样,这一设计选择既符合直觉又有严格的数学支撑。
然而,这项工作也存在值得关注的局限。首先,基线对比的公平性问题不可忽视:所有 MARL 基线被限制在离散动作空间,而 SAFE 在连续动作空间执行,这使得性能差距部分源于动作空间本身的表达能力差异。其次,实验仅在 Highway-Env 自动驾驶场景验证,未涵盖其他连续控制基准(如多机器人协作、分布式资源调度等),泛化性有待进一步检验。此外,论文仅报告 3 次独立运行的均值,未提供置信区间或标准差,统计显著性有限。经验池中动作分布的偏差(如早期训练阶段的极端动作)可能对基线质量产生影响,但论文未做深入分析。
对于后续研究,一个有价值的探索方向是在统一连续动作适配条件下重新对比各基线,以更公平地评估信用分配机制本身的贡献。另一个潜在改进是利用非均匀采样策略(如加权采样)根据动作的价值估计调整采样概率,可能进一步提高基线的估计精度。在理论上,放宽 与 独立的假设,纳入经验池时序相关性的影响,将使收敛性分析更加贴近实际训练动态。
摘要
反事实信用分配在离散动作空间的多智能体强化学习(MARL)中已被证明是有效的,但将其扩展到连续动作的协作任务仍然具有挑战性。现有方法通过蒙特卡洛采样来近似反事实基线,但常常会在策略梯度中引入偏差,并且无法保证收敛到局部最优,因为所采样的动作可能未得到充分训练。为了解决这些局限性,我们提出了SAFE,一种新颖的多智能体强化学习框架,它采用以从每个智能体经验回放缓冲区采样的自我演化默认动作作为条件的反事实基线。该设计自然地扩展到连续动作空间,无需依赖额外的仿真、奖励模型或特定环境的先验知识。该基线能够准确量化每个智能体的贡献,并且不会在确定性策略梯度中引入偏差,从而确保收敛到局部最优。在协作车辆任务上的大量实验表明,SAFE持续优于现有最优模型。
Abstract
Counterfactual credit assignment has proven effective in multi-agent reinforcement learning (MARL) for discrete action spaces, yet its extension to continuous-action cooperative tasks remains challenging. Existing methods that approximate the counterfactual baseline via Monte Carlo sampling often introduce bias into policy gradients and fail to guarantee convergence to local optima, as the sampled actions may not have been sufficiently trained. To address these limitations, we propose SAFE, a novel MARL framework that employs a counterfactual baseline conditioned on a self-evolving default action sampled from each agent's experience buffer. This design naturally extends to continuous action spaces without relying on additional simulations, reward models, or environment-specific prior knowledge. The baseline accurately quantifies each agent's contribution, and introduces no bias into the deterministic policy gradient, ensuring convergence to local optima. Extensive experiments on cooperative vehicular tasks demonstrate that SAFE consistently outperforms state-of-the-art models.
论文详细总结(自动生成)
论文总结:SAFE——面向连续动作空间协作任务的自我演化默认动作
1. 核心问题与研究动机
研究背景:多智能体强化学习(MARL)在协同任务(如星际争霸II等离散动作场景)取得了显著成功,但在真实世界中的连续控制任务(如自动驾驶车辆网络)部署仍受限于以下三点:
- 任务通常要求连续动作控制,而现有信用分配方法多针对离散动作空间设计;
- 实际部署需完全去中心化策略,因通信不可靠;
- 联合状态-动作空间维度爆炸,需在 CTDE 范式下保持可扩展性。
关键问题:现有的反事实信用分配方法(如 COMA)通过中心化评论家量化每个智能体贡献,但天然依赖离散动作空间。对连续动作空间的朴素扩展采用蒙特卡洛采样近似反事实基线 ,但带来两大缺陷:
- 采样动作可能训练不足,导致 无法准确反映智能体贡献;
- 该基线的期望不为零,向策略梯度引入偏差,无法保证收敛到局部最优。
核心研究问题:如何设计一种适用于连续动作空间、既能准确量化智能体贡献、又不引入梯度偏差、且保证收敛的反事实基线?
2. 方法论
2.1 核心思想
提出 SAFE(Self-evolving Default Action From Experiences) 框架,核心创新点为:从各智能体经验回放缓冲区中采样一个自演化默认动作 ,用于构造反事实基线:
其中 为训练步 时的经验回放池, 从中均匀采样。随着训练推进,缓冲区中频繁执行的动作逐渐聚集, 自然逼近智能体的"平均表现"动作,无需额外仿真、奖励模型或任务先验。
2.2 网络架构与算法流程
- 中心化评论家(训练时):输入全局状态 、所有智能体观测-动作历史 与联合动作,输出全局 值;
- 去中心化演员(执行时):输入自身历史 ,输出连续动作 ,智能体间共享参数;
- 动作生成:,其中 , 由 1.0 指数退火至 0.05(50000 回合)。
2.3 优势函数与策略梯度
优势函数定义为:
策略梯度形式为:
2.4 收敛性证明(Lemma 0.1)
由于 与 独立(来源于经验缓冲区而非当前策略),基线项期望为零:
利用确定性与随机策略的极限等价关系 ,可将收敛结论从随机策略梯度推广至确定性策略梯度:
从而保证收敛到局部最优,且不引入偏差。
3. 实验设计
3.1 环境与场景
基于 Highway-Env(Leurent 2018)合作式自动驾驶高速场景:
- 控制车辆(绿色)从左向右行驶,障碍车辆(蓝色)反向行驶;
- 动作:转向角范围 ;
- 观测:自身及邻居车辆的位置、速度、航向等运动学特征;
- 奖励:碰撞惩罚 + 编队激励 + 效率奖励。
四个复杂度递增的场景:
| 场景 | 受控车辆数 | 障碍车辆数 |
|---|---|---|
| 2V1O | 2 | 1 |
| 3V2O | 3 | 2 |
| 5V2O | 5 | 2 |
| 7V2O | 7 | 2 |
3.2 对比方法(Baselines)
| 方法 | 类型 | 说明 |
|---|---|---|
| VDN | 价值分解 | 离散动作 |
| QMIX | 价值分解 | 离散动作,单调混合网络 |
| IQL | 独立 Q 学习 | 离散动作 |
| COMA | 反事实信用分配 | 离散动作 |
| MAPPO | 策略梯度 | 离散元动作 {LEFT LANE, IDLE, RIGHT LANE, FASTER, SLOWER} |
3.3 消融实验
为区分性能提升是源于信用分配机制还是单纯的连续动作适配,设计了以下消融:
- SAFE_a=0:将替换动作固定为 ;
- SAFE_batch_mean:用 32 个采样动作的均值 作为替换动作;
- COMA_cont:连续动作版 COMA,蒙特卡洛采样近似基线;
- Centralized_critic:共享中心化评论家,无信用分配。
3.4 参数研究
考察基线采样数 的影响(),对比 SAFE_1、SAFE_30、SAFE_50、SAFE_80、SAFE_100。
4. 资源与算力
- GPU:NVIDIA RTX 5060Ti,显存 16 GB;
- 重复运行:每个实验 3 次独立运行(three independent runs);
- 训练回合:150000~175000 回合(部分曲线延伸至此);
- 未明确说明:训练总时长、CPU 配置、超参数搜索计算开销、代码运行时间等均未给出。
5. 实验数量与充分性
实验数量概览
- 主实验:4 个场景 × 6 种方法 = 24 组训练曲线对比;
- 碰撞率统计表:4 场景 × 6 方法 = 24 个数值点;
- 参数研究:5 种采样数(K=1, 30, 50, 80, 100),3V2O 场景下训练约 175000 回合;
- 消融实验:4 种变体 + SAFE,3V2O 场景;
- 轨迹与密度分析:3 个智能体 × 4 个训练阶段(100/1000/10000/100000 episodes),共 12 张概率密度图;
- 训练 3 次独立运行,取平均,统计稳定性有一定保证。
充分性评估
- ✅ 覆盖了多种智能体规模与不同难度场景;
- ✅ 包含消融实验区分贡献来源;
- ✅ 提供参数敏感性分析;
- ⚠️ 仅在 3V2O 上做参数与消融研究,未在其他场景验证;
- ⚠️ 仅 3 次独立运行,统计置信度有限;
- ⚠️ 缺少置信区间或方差报告;
- ⚠️ 所有基线(VDN/QMIX/COMA/MAPPO/IQL)均使用离散元动作,而非真正映射到连续动作空间,存在对比公平性争议——这是论文核心限制之一。
6. 主要结论与发现
1. 性能优势:SAFE 在四个场景中碰撞率与回合奖励均显著优于所有基线:
- 2V1O:碰撞率 0.029,比 COMA 低 97%,比 QMIX 低 40%;
- 3V2O:碰撞率 0.067,比 COMA/QMIX 低 91-93%;
- 5V2O:比 COMA/QMIX 低 92%;
- 7V2O:比 COMA 低 78%,比 QMIX 低 82%。
2. 基线演化验证:图 4b 概率密度分析显示,随着训练推进,采样动作的分布自发聚集到智能体最常执行的动作区间,有效反映平均表现。
3. 单样本优于多样本平均:图 5a 表明 时 SAFE 表现最佳,增加采样数 不仅无助于估计精度,反而引入偏差。
4. 性能提升源于信用分配:图 5b 显示 SAFE_a=0、SAFE_batch_mean、COMA_cont、Centralized_critic 均未达到 SAFE_1 的性能,说明提升来源于信用分配机制本身,而非连续动作适配。
5. 理论保证:数学证明 SAFE 基线对确定性策略梯度无偏,保证收敛到局部最优。
7. 优点
- 方法简洁优雅:仅用一个超参数(采样数 K=1)即可实现,避免了复杂的多样本平均;
- 无需任务先验:默认动作从经验池自动获取,跨任务可迁移;
- 理论完整:提供了从随机到确定性策略梯度的无偏收敛性证明;
- 实验设计合理:包含碰撞率、回奖励、轨迹可视化、概率密度演化等多维度评估;
- 消融与参数研究齐全:能区分贡献来源,验证设计选择的合理性;
- 跨场景泛化良好:在 2~7 辆车、1~2 个障碍的多个场景均稳定优于基线。
8. 不足与局限
- 基线对比公平性存疑:所有 MARL 基线(VDN/QMIX/COMA/MAPPO/IQL)均被限制在离散元动作上对比,而非让其在连续动作下竞争性适配;这使得"SAFE 更优"的结论部分源于"连续动作空间本身的优势"而非信用分配方法本身的优势。虽然论文通过消融部分回应,但未在统一连续动作适配条件下做严格比较。
- 环境单一:仅在 Highway-Env 高速场景验证,未涵盖其他连续控制基准(如 MuJoCo 合作任务、机器人足球、蜂群控制等),泛化性未充分验证。
- 统计显著性不足:仅 3 次独立运行,未报告置信区间或标准差,难以判断性能差异是否统计显著。
- 场景与消融不对称:参数研究与消融实验仅在 3V2O 场景进行,未在其他场景重复,结论的稳健性有限。
- 依赖均匀采样假设:默认动作从经验池均匀采样,但未分析经验池中动作分布偏差(例如早期失败回合可能引入较多极端动作)对基线的影响。
- 算力信息不全:缺少训练总时长、收敛回合数、超参数选择过程等细节,难以复现和评估成本。
- 理论假设较强:收敛性证明基于 与当前 独立的假设,但实际经验池中存在时序相关性(最近的策略轨迹占比更高),可能削弱理论保证的现实有效性。
- 应用范围有限:当前仅在合作车辆任务验证,未涉及竞争或混合环境,也未扩展至高维视觉观测场景。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。