
面向具有连续状态–动作空间的网状多智能体强化学习的可扩展策略优化
Scalable Policy Optimization for Networked Multi-Agent Reinforcement Learning with Continuous State-Action Spaces
📝 TLDR
面向连续状态-动作空间的网络化多智能体协作强化学习,现有方法在大规模网络中难以兼顾可扩展性与收敛理论保证。本文提出CDCPG算法,每个智能体在有界图邻域内维护局部actor,并采用谱随机特征表示局部转移核配合最小二乘TD critic。理论证明在指数空间衰减与持续激励条件下,算法以Õ(ε^{-2})共享oracle样本将平均逐智能体平稳性推至任意ε精度,计算与通信开销仅随邻域大小而非网络规模增长。结合自适应局部性规则选取截断半径,并在网络化线性二次基准实验中验证局部性与特征维度预测。
🧭 速览
网络化多智能体强化学习在连续状态-动作空间下的策略优化同时面临可扩展性与理论分析的挑战。
提出CDCPG算法,融合局部actor、基于谱随机特征的局部转移核表示与最小二乘TD critic,并设计自适应截断半径选取规则。
在指数空间衰减与持续激励条件下以Õ(ε^{-2})共享oracle样本达ε-平稳性,逐智能体计算与通信仅取决于邻域大小。
为连续空间网络化协作MARL提供了首个同时具备严格样本复杂度与局部性保证的策略优化框架。
🆚 方法对比
CDCPG(Continuous Distributed Coupled Policy Gradient)
- 邻域局部化使计算与通信复杂度与网络规模解耦
- 样本复杂度Õ(ε⁻²),匹配光滑非凸一阶最优下界
- 自适应局部性规则自动平衡截断误差与图衰减残差
- 无条件激励边界可通过在线矩阵浓度证书监控
- 依赖指数空间衰减假设,实际环境中可能不严格成立
- 实验仅在网络化线性二次基准上验证,场景较单一
- 规范化随机特征的TD稳定性存在维度障碍
- 共享oracle样本假设在实际部署中可能受限
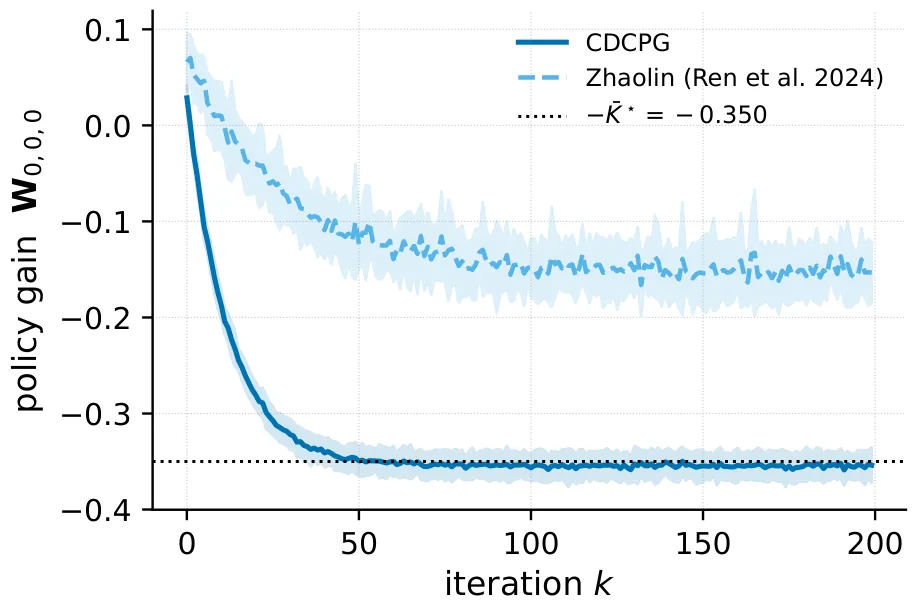
Ren等人的谱动态嵌入+网络化MDP方法
- 在共享轨迹生成模型下每智能体精度匹配离散情形
- 将谱方法与网络化MDP框架自然结合,适合核逼近
- 具有显式的有限样本保证
- 假设LSTD设计矩阵逆有界为原始问题条件,缺乏可验证性
- 未将逆界与特征维度m或策略参数θ建立联系
- 随机特征残差被视为结构性地板,无法作为精度调优量
朴素截断方法(Naive truncation)
- 形式简单直观,易于初步实现
- 存在连续核不匹配的内在缺陷
- 截断后贝尔曼理论不完善
- 截断偏差与核近似误差耦合,难以分离分析
完全去中心化Actor-Critic方法
- 完全分布式部署,无需中心化协调
- 基于共识机制适合大规模网络
- 依赖渐近混合而非显式空间衰减,收敛分析较弱
- 缺乏有限样本复杂度保证
- 收敛速度可能受网络规模制约
随机傅里叶特征(Random Fourier Features)
- 在紧集上具有高概率一致逼近保证
- 通过有限维内积近似平移不变核,维度明确
- 适合核岭策略评估及动力学诱导核场景
- 对规范化随机特征的TD稳定性存在维度障碍
- 逼近精度受特征维度m制约,高精度需求大维度
本文提出的CDCPG通过邻域局部化与谱方法结合,克服了Ren等方法中LSTD逆界不可监控、朴素截断中连续核不匹配以及完全去中心化方法缺乏有限样本保证的缺陷,在保持网络规模无关计算复杂度的同时实现了Õ(ε⁻²)的样本复杂度。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 14 张)
展开查看 14 张图
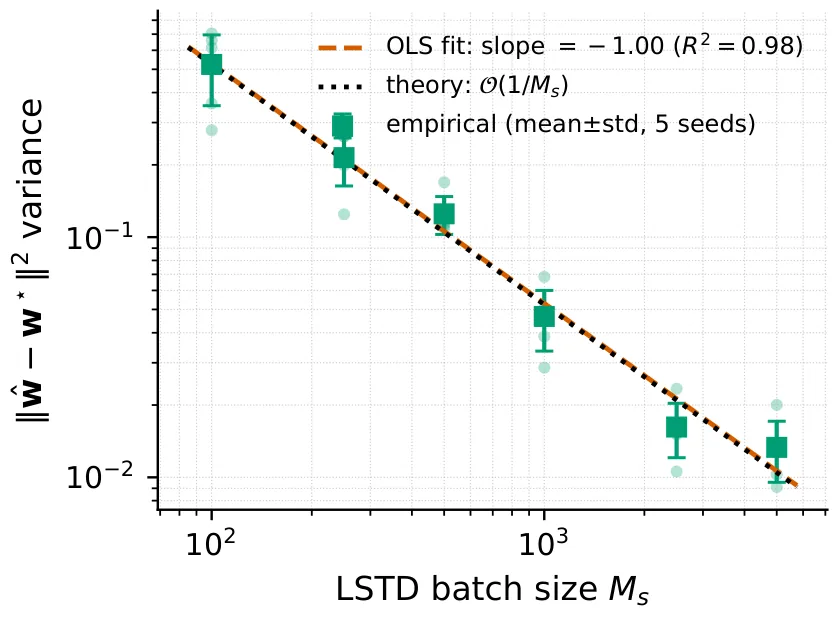
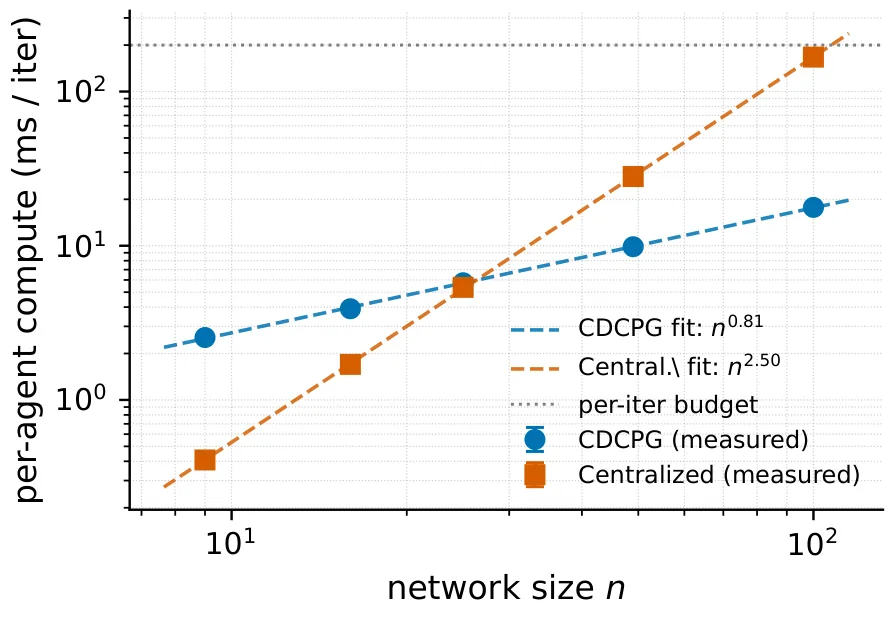
TL;DR
这篇论文提出了 CDCPG(连续分布式耦合策略梯度)算法,针对连续状态–动作空间下的网状多智能体协作强化学习问题。核心突破在于:每个智能体只需在局部图邻域内维护 actor 和 critic,理论上证明算法以 的共享预言机采样复杂度将平均逐智能体平稳性推进到任意 精度,同时计算与通信开销仅随邻域大小而非网络规模增长。实验在网状线性–二次基准上验证了局部性和随机特征维度的理论预测。
研究背景与动机
在现代分布式系统中,多智能体协作问题无处不在:从信息物理系统的协调控制,到电网的分布式优化,再到多机器人编队任务。系统中的每个智能体只与空间上邻近的伙伴发生显著交互,这种稀疏性构成了设计可扩展算法的物理基础。然而,当状态–动作空间从离散转向连续时,传统的网络化多智能体强化学习方法面临严峻挑战:全局联合策略空间随智能体数目指数增长,使得集中式方法在计算和通信上难以承受;而完全去中心化的方法又缺乏有效的协调机制,难以保证收敛性和样本效率。
现有研究在这一方向上取得了不少进展,但仍存在明显的理论缺口。部分工作将问题限制在离散状态–动作空间,无法直接应用于机器人控制等连续控制场景;另一些采用混合式架构(如基于注意力机制或共识平均的方法),虽然工程效果不错,但缺乏严格的有限样本复杂度保证。换言之,研究者面临一个核心困境:如何在连续域中同时实现严格的样本复杂度控制和空间局部性保证——即算法的计算与通信开销应该只依赖于邻域大小,而非整个网络的规模。
本文正是瞄准这一缺口展开。其核心假设是智能体交互呈指数空间衰减:远处智能体之间的状态–动作价值函数耦合强度以指数速率下降,这为局部化提供了理论依据。在此基础上,CDCPG 算法被设计为一种在局部邻域内运作的 actor-critic 框架,同时在理论上给出明确的样本复杂度下界和局部性保证。
方法
CDCPG 的设计围绕一个核心挑战展开:如何在局部视野内近似全局动作价值函数 ,而又不引入因截断导致的理论不一致性。传统做法是直接将远处的智能体忽略,但这会破坏贝尔曼方程的结构,因为截断后的价值函数在更新时会与真实的延续核产生不匹配。
论文的第一个关键创新是条件期望型截断 Q 函数。具体而言,将截断动作价值函数定义为 ,即在给定局部状态邻域 的条件下对全局价值函数取条件期望。通过辅助局部贝尔曼算子 ,这个截断函数在 等价类中获得定义良好的固定点,从而消除了朴素截断论证中的延续核不匹配问题。这一定义在数学上保证了局部 critic 学到的近似值函数与真实的全局价值函数之间存在可量化的偏差上界。
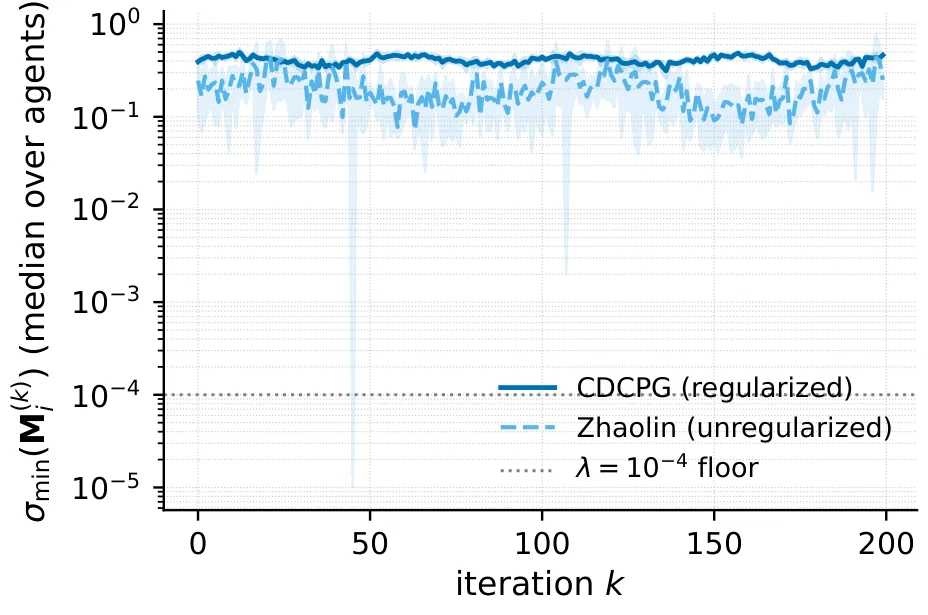
在价值函数近似层面,CDCPG 采用谱随机特征(Random Fourier Features, RFF) 表示局部转移核。高斯核的 Bochner 分解为谱表示提供了理论基础:通过对频谱进行截断采样,可以将无限维的核函数映射到有限维的随机特征向量 。然而,这里存在一个微妙的技术障碍:归一化随机特征在 TD 更新中的稳定性并非理所当然。论文通过严密的维度分析揭示了这一问题,并证明了无条件激发界,将 TD 稳定性归结为一个对称持续激发条件。该条件可以通过在线矩阵集中证书进行事后监控,从而为算法的数值稳定性提供了可验证的诊断工具。
在策略梯度估计方面,CDCPG 将每个智能体的梯度构造为仅依赖邻域内的 critic 和 actor。具体地,个体目标梯度为
值得注意的是,这个梯度表达式虽然形式上涉及全局价值函数 ,但通过指数衰减假设,远处智能体的贡献可以被安全地截断。Critic 的更新采用局部化最小二乘时序差分(LSTD)方法,其权重通过求解 得到,其中 是基于随机特征构造的矩阵。
论文还引入了跨参数 Hessian 衰减这一新假设,要求策略梯度的 Hessian 矩阵元素随图距离指数衰减。这一假设保证了目标函数的光滑性参数 与网络规模无关,从而使得全局步长的选取可以独立于 ,这对于大规模网络的部署至关重要。
在参数更新的理论分析中,论文采用了可预测事件因式分解技术。传统的分析往往依赖于全局未来事件的数学期望,而新方法通过可预测指标 选取行式条件差分不等式,得到 stopped-process 形式的结果。这避免了复杂的全局鞅论论证,使得理论推导更加清晰。
自适应局部化规则是最后一个技术亮点。论文推导出最优截断半径 ,该规则在目标精度下平衡了截断残差(由指数衰减速度 决定)和图衰减残差(由邻域外的耦合强度决定)。这意味着在追求高精度时,算法会自动扩展邻域半径;在精度需求不高时,则保持较小的邻域以节省计算资源。
实验与结果
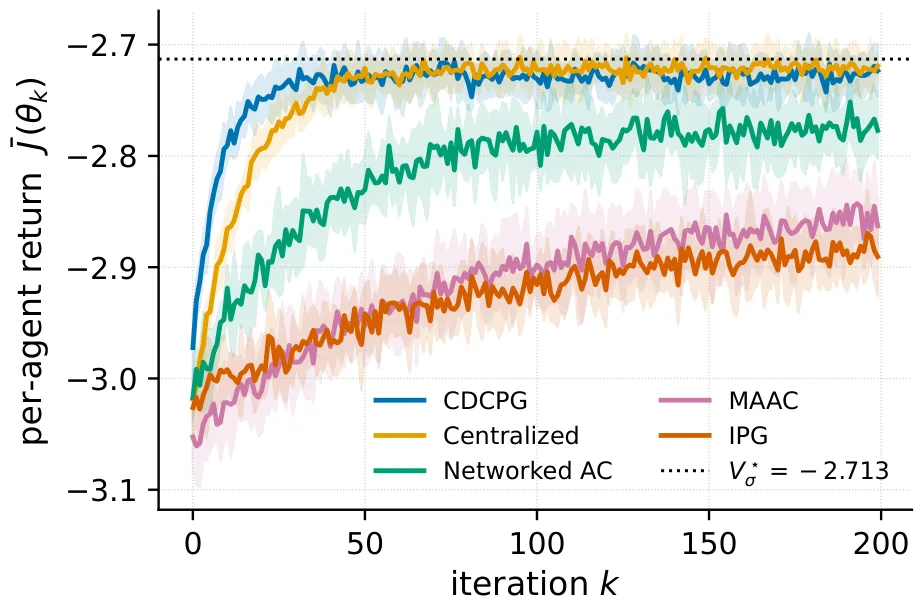
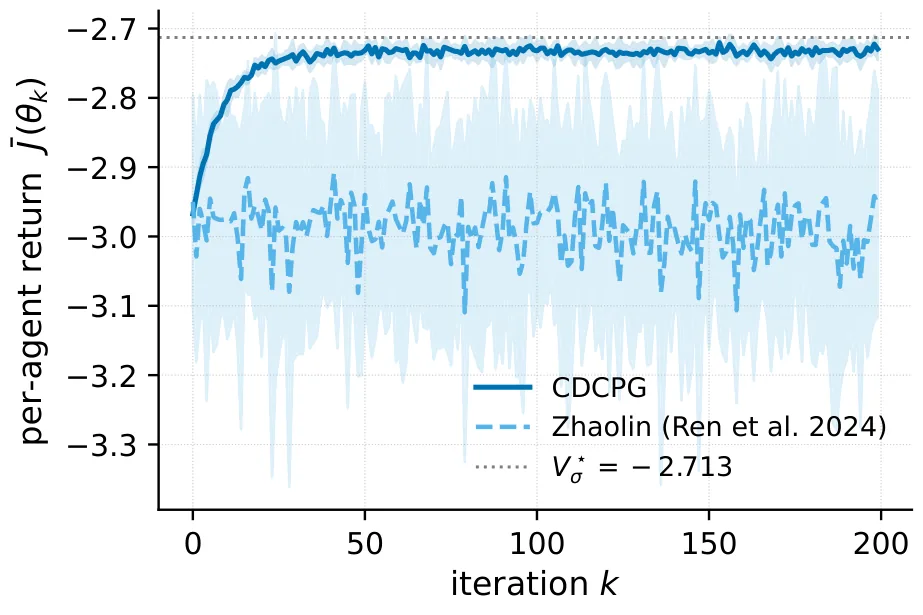
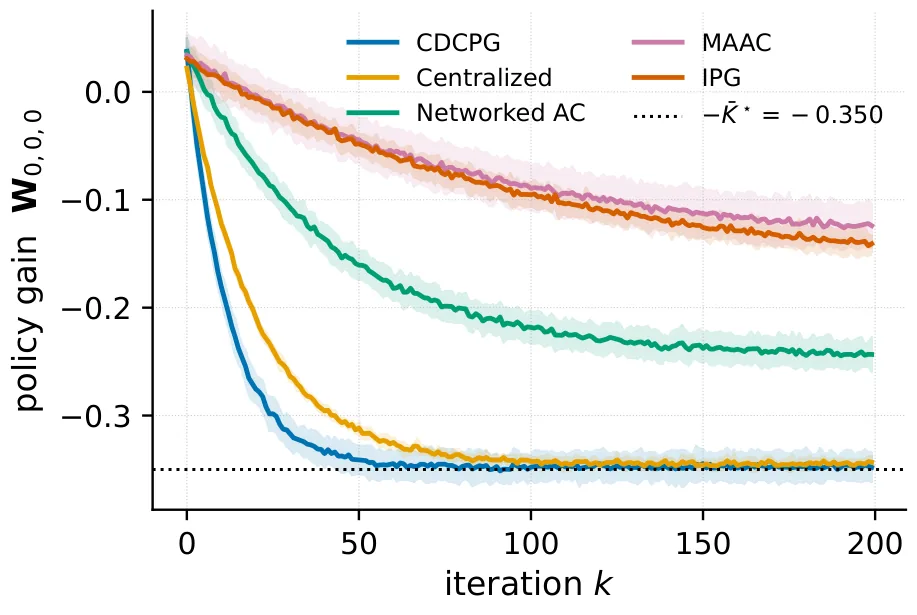
实验采用自行构造的线性耦合二次型(LCQ)基准作为测试平台。系统包含 个智能体,部署在路径图上,每个智能体持有标量状态 和动作 。局部动力学考虑了自身状态的持续性、相邻智能体的耦合以及高斯噪声,奖励函数则为邻域耦合的二次形式。实验参考 LQR 最优解 作为理论基准,并将 CDCPG 与四种基线方法进行对比:独立策略梯度(IPG)、单 hop 共识网络化 Actor-Critic、网络化 MAAC(注意力机制)以及集中式策略梯度。
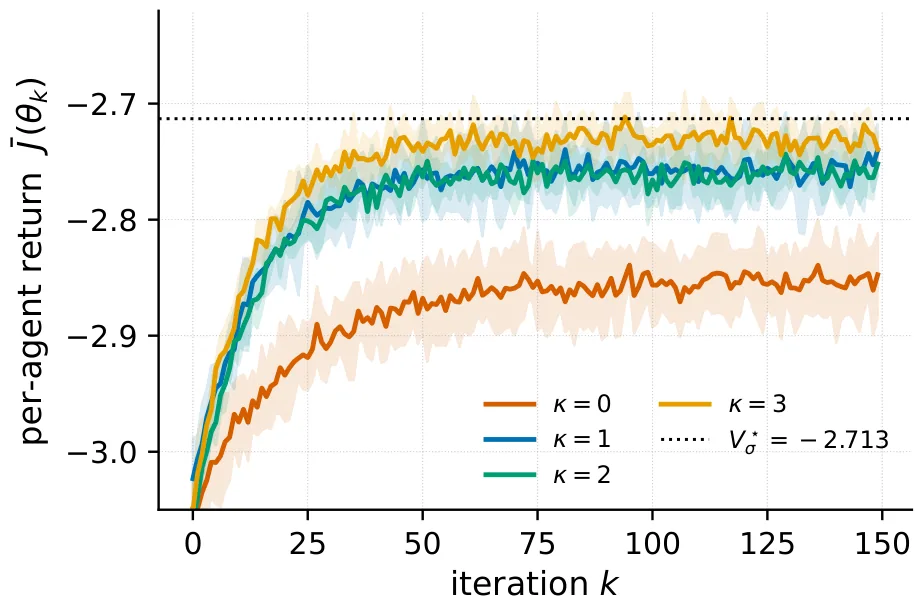
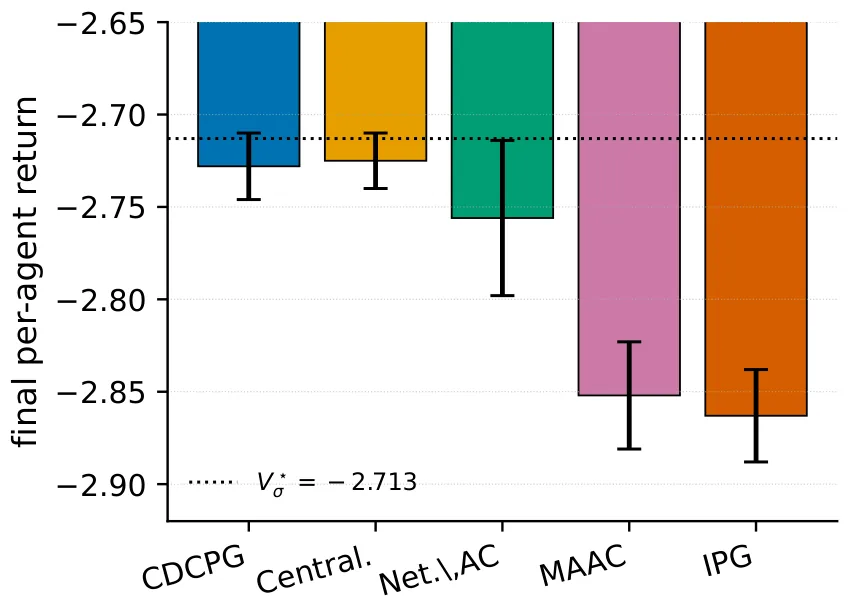
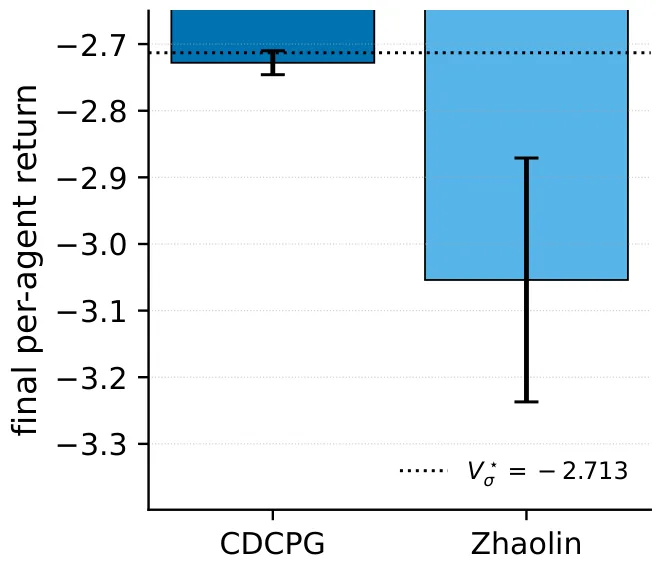
实验结果呈现了清晰的层次结构。在最终性能指标上,CDCPG 显著优于所有去中心化基线方法,其迭代次数 接近集中式基线的 25 次迭代,而 IPG 和 MAAC 则需要 55 到 133 次迭代才能达到相同性能。这一差距充分说明了局部 critic 设计在利用网络稀疏性方面的有效性。
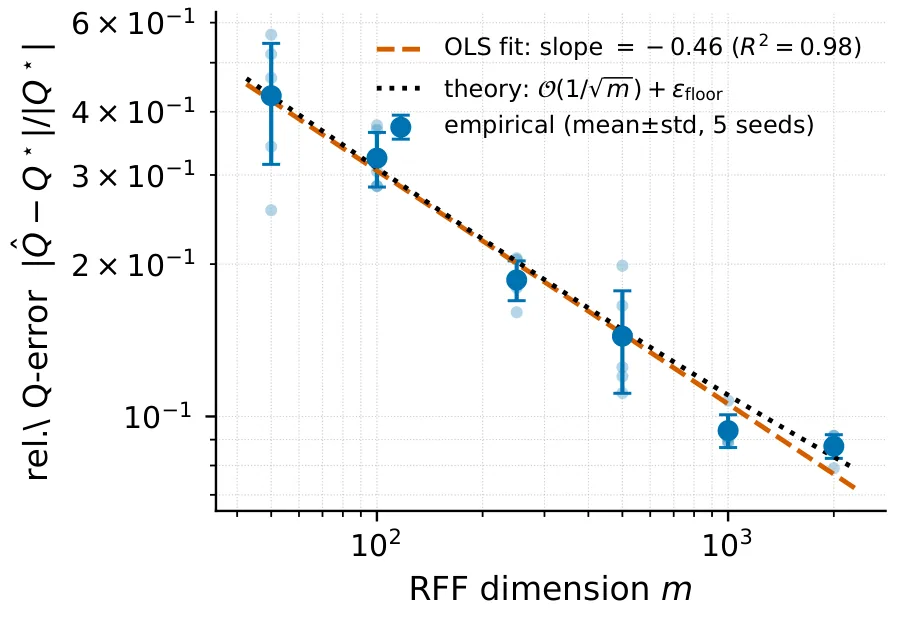
随机特征维度的消融实验进一步验证了理论预测。研究者将 RFF 维度从 50 逐步增加到 2000,观察相对 Q 误差的变化趋势。拟合结果表明误差随维度以 的斜率下降(在双对数坐标下),与理论预测的 收敛速率高度一致, 的决定系数说明这一关系具有很强的规律性。
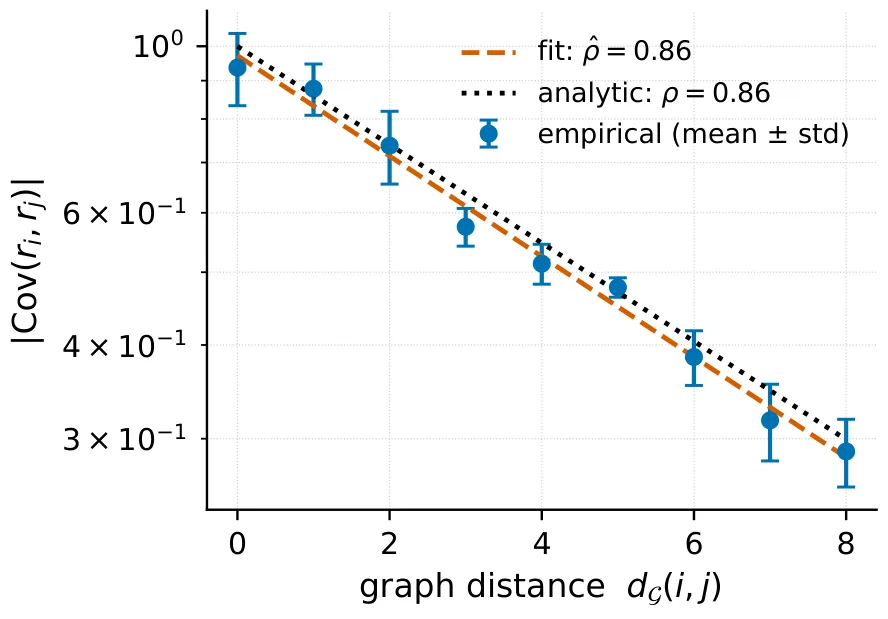
图衰减代理的验证实验通过分析智能体对之间协方差随图距离的衰减趋势,确认了指数空间衰减假设的合理性。回归分析得到衰减系数 ,表明邻居之间的耦合强度大约是次近邻的 86%,这为截断半径的选取提供了经验依据。
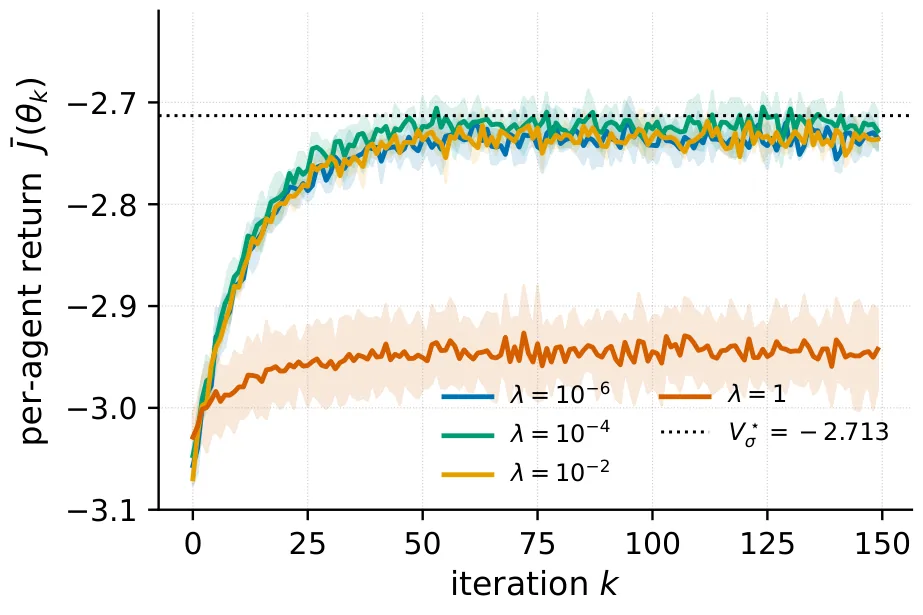
截断半径和正则化参数的消融实验则表明,存在一个相对平坦的参数区间,在该区间内算法性能对超参数选择不敏感。当正则化参数 从 增大到 时,性能基本保持稳定;但当 增大到 1 时,TD 矩阵的条件数恶化导致性能崩塌,这与理论分析中 尺度的临界点预测吻合。
讨论与可借鉴点
这篇论文在理论层面实现了网状多智能体强化学习研究的重大突破:首次在连续状态–动作空间下同时给出了严格的有限样本复杂度保证和空间局部性分析。 的收敛速率与光滑非凸优化的一阶下界在指数层面匹配,说明算法在样本效率意义上接近最优。局部性保证意味着算法的可扩展性瓶颈从网络规模 降低到邻域大小 ,这对于大规模部署具有重要的工程意义。
然而,论文的实验验证也存在明显的局限性。LCQ 基准的规模仅为 9 个智能体,虽然足以验证理论预测的趋势,但无法展现算法在大规模网络中的实际行为。更重要的是,论文明确承认实验中的假设验证只是"一致性检验",并未对关键假设进行端到端的认证。结构化二次基 critic 和理论分析中的 RFF-LSTD critic 存在差异,两者在真实环境下的行为一致性仍是未解决的问题。
条件期望型截断的思路具有独立的理论价值。传统上,局部化方法往往需要引入额外的偏差项来补偿截断带来的误差,而新框架通过将截断定义为条件期望,获得了天然的数学结构优势。这种设计选择虽然在实现上增加了复杂性,但为后续研究提供了一个更坚实的理论基础。
持续激发条件的可监控化是一个实用的工程贡献。在理论分析中,激发条件通常以假设的形式出现,难以在实际部署前验证。论文提出通过在线矩阵集中证书事后监控该条件,为算法的在线诊断提供了工具,使得研究者可以在训练过程中检测算法是否进入不稳定状态,从而采取相应的补救措施。
跨参数 Hessian 衰减假设的提出填补了网络化强化学习中曲率分析的空白。该假设将单智能体强化学习的平滑性条件推广到多智能体场景,并通过图谱分析证明了 的网络规模无关性。这一结果意味着在设计学习率等超参数时,可以将网络规模视为无关因素,简化了实际部署中的调参过程。
未来的研究可以在几个方向上继续推进。首先,将框架推广到更一般的非线性函数近似(如神经网络),探索谱方法的结果在何种程度上可以迁移。其次,设计完全去中心化的变体,移除共享预言机的假设,以适应真正的分布式部署场景。最后,在更大规模的真实系统(如无人机集群、智能电网)上进行验证,检验理论保证在实践中的鲁棒性。
摘要
我们针对具有连续状态和动作空间的网状马尔可夫决策过程中的协作强化学习问题,提出了连续分布式耦合策略梯度(CDCPG)算法。每个智能体在有界图邻域上维护一个局部执行器(actor),并通过局部转移核的谱随机特征表示,由一个局部化的最小二乘时序差分评论器(critic)对截断动作价值函数进行评估。分析包含四项贡献。第一,截断动作价值函数被构造为关于邻域的条件期望,由此得到一个适定的局部化贝尔曼理论,消除了朴素截断论证中的延续核不匹配问题。第二,我们揭示了归一化随机特征下时序差分稳定性的一个维度性障碍,并证明了无条件激发界(unconditional excitation bound),将稳定性归结为一个对称持续激发条件,该条件可通过在线矩阵集中证书进行监控。第三,在智能体交互呈指数空间衰减、激发条件成立以及目标函数光滑的条件下,CDCPG 以 次共享预言机采样,将平均逐智能体平稳性度量驱动至任意超出量 范围内逼近一个被显式刻画的近似下界,且其超出量依赖关系与光滑非凸一阶速率相匹配;逐智能体计算和通信量由邻域大小而非网络规模所决定。第四,一种自适应局部化规则选取截断半径,以在目标精度下平衡截断残差与图衰减残差。在网状线性–二次基准实验上的结果印证了关于局部性和特征维度的理论预测。
Abstract
We develop the Continuous Distributed Coupled Policy Gradient (CDCPG) algorithm for cooperative reinforcement learning in networked Markov decision processes with continuous state and action spaces. Each agent maintains a local actor over a bounded graph neighborhood, and a localized least-squares temporal-difference critic evaluates a truncated action-value function through a spectral random-feature representation of the local transition kernel. The analysis makes four contributions. First, the truncated action-value function is constructed as a conditional expectation over the neighborhood, yielding a well-posed localized Bellman theory that removes the continuation-kernel mismatch of naive truncation arguments. Second, we expose a dimensional obstruction to temporal-difference stability for normalized random features and prove an unconditional excitation bound that reduces stability to a symmetric persistence-of-excitation condition, monitorable through an online matrix-concentration certificate. Third, under exponential spatial decay of agent interactions, the excitation condition, and smoothness of the objective, CDCPG drives an averaged per-agent stationarity measure to within any excess of an explicitly characterized approximation floor using shared-oracle samples, and the excess dependence matches the smooth nonconvex first-order rate; per-agent computation and communication are governed by the neighborhood size rather than the network size. Fourth, an adaptive-locality rule selects the radius that balances truncation and graph-decay residuals against the target accuracy. Experiments on a networked linear-quadratic benchmark corroborate the locality and feature-dimension predictions.
论文详细总结(自动生成)
论文总结:面向具有连续状态–动作空间的网状多智能体强化学习的可扩展策略优化
1. 核心问题与研究动机
在网络化多智能体系统(如信息物理系统、电网、分布式控制)中,智能体之间的动力学、奖励与观测只受有界图邻域影响,因此全局联合状态–动作空间随智能体数目 指数增长,使集中式方法难以处理,而完全去中心化方法又难以协调。已有可扩展的网络化 MARL 工作主要假设离散状态–动作或采用混合式架构(如注意力、共识平均),缺乏同时具备严格有限样本复杂度保证与空间局部性(计算/通信依赖邻域大小而非网络规模)的策略优化算法。本文研究的核心问题是:
> 如何在连续状态–动作空间下的网络化协作 MARL 中,设计一种算法,其有限样本复杂度可以显式控制,且计算与通信开销随邻域大小而非 增长。
关键假设包括指数空间衰减(B2:智能体 的 仅与远处邻居呈 量级的弱耦合)以及 TD 矩阵的持续激发条件(C 或 C')。
2. 方法论:CDCPG 算法
2.1 核心思想
CDCPG(Continuous Distributed Coupled Policy Gradient)将每个智能体限制在图邻域内维护一个局部 actor,并由谱随机特征(RFF)+ 局部化 LSTD 评论器对邻域内的截断动作价值函数进行线性近似。算法框架包含四个关键技术:
1. 条件期望型截断 Q 函数:定义截断 Q 函数为 ,通过辅助局部贝尔曼算子 在 等价类中得到定义良好的固定点,避免了朴素截断导致的延续核不匹配问题(命题 1)。
2. 归一化 RFF 的谱表示:对局部高斯核转移 采用 Bochner 分解 + 截断随机 Fourier 特征 ,并通过 -splitting 控制 signed approximant 的尾部(定理 1,定理 2)。
3. 特征维度感知的 TD 稳定性:将谱方法的 后置假设替换为维度依赖的 (命题 2 证明存在维度障碍 ),并通过引理 3 推导出无条件激发界:
4. 跨参数 Hessian 衰减 (D3):要求 ,以保证 与网络规模无关(附录 B)。
2.2 关键公式与目标
- 个体目标梯度(公式 5):
- LSTD 设计与正则化:,其中
- 充分条件:定理 4 给出局部 critic 误差界
- 集中性目标:,步长规则 ,
2.3 算法流程(Algorithm 1)
预随机特征采样(每个智能体 对 ),主循环 步:对所有智能体并行执行共享 LSTD(共享数据 )→ critic 权重求解 → 邻域 收集 → 分布式梯度估计 (共享数据 )→ 块投影梯度更新,返回轨迹平均参数 。
3. 实验设计
- 基准:自行构造的 LCQ(Linear-Coupled-Quadratic) 基准, 个智能体在路径图上,每个智能体标量状态 ,动作 ,局部动力学
二次邻域耦合奖励,并参考 LQR 解 作为基准;参考值 。
- 基线方法:独立策略梯度(IPG)、网络化 Actor–Critic(Networked AC, 共识)、MAAC(注意力)以及集中式策略梯度。所有方法共享探索规模 、采样预算和学习率。
- 参数设置(表 II):、、、(余弦衰减)、、、、5 个随机种子。
- 批评器消融:使用结构化二次基 critic(用于本地化预测验证)以及 RFF–LSTD 批评器(用于维度趋势验证)。
4. 资源与算力
- 论文未明确给出 GPU 型号、数量或训练时长。从实验规模(,,,,5 个种子)判断所需的算力较低,应可在单机 CPU/单 GPU 环境完成;附录中也未给出 wall-clock 时间。
- 同时承认 LCQ 与集合 A–D 的全部假设并不严格一致,因此没有提出绝对算力/扩展性声明。
5. 实验数量与充分性
共四项研究:
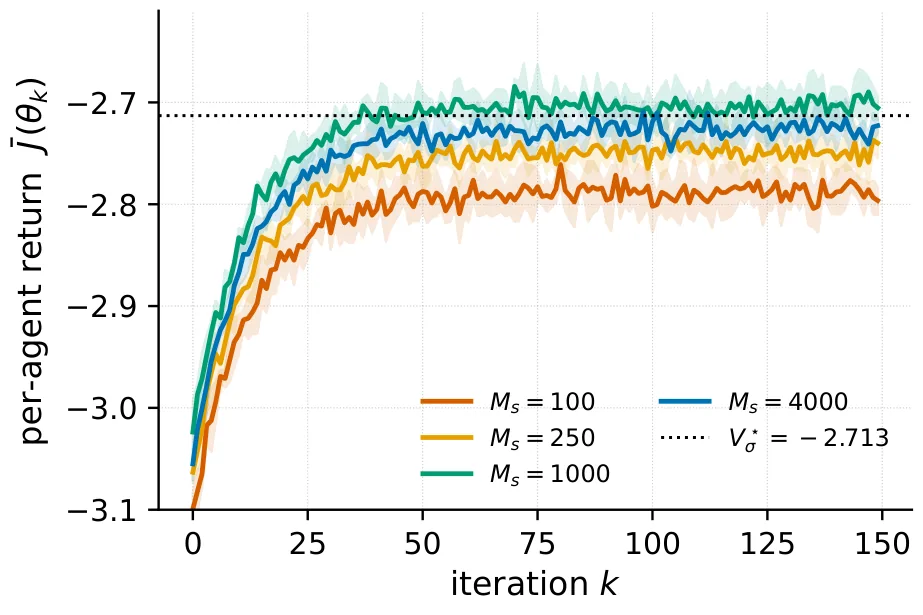
1. 基线比较(图 1–3、表 III):CDCPG 相对 Centralized、Networked AC、MAAC、IPG 的最终回报,5 seeds。
2. RFF 维度消融(图 4): 下的相对 Q 误差拟合斜率 (),与 一致。
3. 图衰减代理(图 5): 对图距离回归得 。
4. 截断半径 与正则化 消融(表 IV,图 6):,。
充分性评价:四项研究各自针对理论的一个组件(局部性、特征近似、衰减条件、正则化)作为一致性检验,并未完整证明假设;论文明确说明"none of these studies certifies an assumption",并主动区分了结构化 critic 与分析中的 RFF–LSTD critic。对真正 RFF–LSTD 端到端的 (i, k) 上的完整 Proposition 3 认证被标记为未来工作。同时承认 5 个随机种子下未声明统计不可区分,实验规模较小。
6. 主要结论与发现
- 样本复杂度:在固定 的共享 oracle 模型下,存在 与 ,使得 ;共享预言机总调用数
其超出量依赖与光滑非凸一阶下界 在指数层面匹配(但 oracle 模型不同,不声明极小极大最优)。
- 局部性:每个智能体的计算与通信由 (邻域大小)而非 决定。
- 结构性下界 由四项组成:bin(与 相关)、trunc( 衰减)、rff()、graph()。
- 障碍声明: 决定原始证书下 bin 项会随 增长——这是当前 LSTD 上界方法的人工产物(Lemma 6 提供精确 gap 形式)。
- 实验匹配:LCQ 上 CDCPG 在迭代次数 上接近集中式 baseline(25),显著优于本地基线(55–133);RFF 维度拟合斜率与 一致; 消融显示相邻 hop 收益比约 ; 在四阶区间平坦并按 规模在 时崩塌。
7. 方法与实验设计的亮点
- 首个在连续域同时给出严格样本复杂度与局部性保证的网络化协作 MARL 策略优化方法,弥补了 Qu 等 (2020, 2022)、Lin 等 (2021)、Ren 等 (2024) 等工作中或为离散、或为模块化、缺乏端到端复杂度分析的不足。
- 条件期望截断避免了朴素 Bellman 截断的延续核不匹配,技术上具有独立的理论价值。
- 特征维度障碍 + 激发归约:将不可验证的 后置假设化归为可监控的对称持续激发条件(可通过在线矩阵集中证书 Proposition 3 进行 post-hoc 验证)。
- 跨参数 Hessian 衰减 (D3) 是首次在连续域网络化 RL 中独立提出的曲率衰减假设,并经过图求和得到 与 无关的定理。
- 可预测事件因式分解:以可预测指标 选取行式 (pathwise) 条件差分不等式,避免依赖全局未来事件 ,给出 stopped-process 形式(定理 7)。
- 零半径 actor 特化: 时 raw/conditional 直接在条件期望内分解,bin 项中 贡献可被消去(推论 2),与仿真实验一致。
- 自适应局部化诊断(命题 4):,将 graph-decay 残差压到目标精度以下。
8. 不足与局限
- 假设未验证、依赖未消解:(C) 与 (C') 都是未经验证的结构性前提,激发引理 3 只是归约而非验证;当前的 没有进一步下界匹配 。
- 结构性 floor 受维度障碍约束:在 最优情况下,证书层的 ,即随特征维度增加而线性增长,这是当前 LSTD 分析上界方法的产物,并非算法本身的下界。
- LCQ 基准并非 Sets A–D 的字面实例(线性动力学+二次奖励在 clipping 前无界),论文明确表示这是一致性检验而非定理假设的认证,结构化 critic 与 RFF–LSTD critic 在实验中分开使用,降低了端到端比较的说服力。
- Proposition 3 的认证仅事后(post-hoc)有效,无法在主轨迹上预先确立 ,未来仍需稳定性-on-a-tube 论证或在线停止规则;pilot run 仅能标定参数、不能认证主轨迹。
- 样本数随网络规模存在多对数依赖:在固定 下,需 ,进而 ,故"全 -均匀"的承诺被打破,仅停留在 polylog 层级。直径尺度上 会引入 因子。
- 5 seeds 的样本规模不足,未声明统计不可区分;多次外部 Monte Carlo 验证( 使用 episodes)独立于算法训练 loop。
- 理论 oracle 与最优 oracle 不完全对应:本地化估计器有偏、共享样本,与 Arjevani 等 (2023) 的无约束光滑非凸下界仅在指数层面匹配,并未声明极小极大最优。
- 应用领域:依赖指数空间衰减(B2)与曲率衰减(D3),仅在状态和动作连续但相互作用可被小邻域截断的系统中适用(如电力系统频率控制、分布式 LQR);对非局部耦合或强耦合对抗性场景不直接适用。
- 诚实声明:作者明确指出"既未声明 minimax 最优,也未对 oracle 模型差异做隐藏",是值得称道的学术诚实,但削弱了与已有工作的可比性。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。