
Search-on-Graph-R1:使用强化学习训练大语言模型搜索知识图谱
Search-on-Graph-R1: Training Large Language Models to Search Knowledge Graphs with Reinforcement Learning
📝 TLDR
知识图谱问答需要多跳推理,现有方法依赖大型闭源模型推理成本高。Search-on-Graph-R1将导航能力内化进8B模型,先用金标准SPARQL脚手架教师沿已知路径采集轨迹进行监督微调,再用强化学习优化。8B模型在WebQSP、CWQ、GrailQA上超越所有冻结前沿大模型系统,并在CWQ上达到对比最佳。无需推理时辅助模块或训练时LLM裁判。
🧭 速览
知识图谱多跳问答需沿关系链推理,现有调用大模型加检索工具的方法部署成本高。
以金标准SPARQL为脚手架让教师沿已知路径调用Search采集轨迹,先监督微调8B模型,再以强化学习继续优化搜索策略。
8B模型在WebQSP、CWQ、GrailQA上超越对比中所有冻结前沿大模型系统,CWQ取得最强结果,SFT与RL带来互补增益,RL以更少Search调用到达答案。
SFT与RL贡献互补增益,方法可跨模型家族迁移,为KGQA提供无需辅助模块的低成本部署方案。
🆚 方法对比
SoG-R1
- 8B模型超越冻结前沿LLM系统
- 推理时无需辅助模块
- 训练无需LLM裁判
- SFT与RL贡献互补增益
- 依赖235B教师生成数据
- 需金标准SPARQL脚手架
- 两阶段训练流程复杂
SoG-SFT
- 训练流程简单高效
- 教师轨迹知识图谱原生接地
- 可直接部署无需RL
- 缺少RL阶段的搜索效率优化
- 性能低于完整SoG-R1
SoG-R1-Zero
- 验证RL可从基座模型起步
- 为消融实验提供对比基线
- 避免SFT数据依赖
- 冷启动困难性能受限
- 缺少接地轨迹的监督信号
EoG
- 采用两阶段SFT加RL流程
- 与SoG-R1方法框架相似
- 离线子图作为静态文本注入
- 从不发出实时查询
- 准确率受限于预处理召回
KG-Hopper
- 对知识图谱进行实时查询
- 支持导航推理融合
- 依赖外部LLM裁判评分
- 可回退到参数记忆
- 无法保证引用事实存在于KG
语义解析方法
- 输出可执行逻辑形式
- 一次解析完成查询编译
- 难以泛化未见过的schema
- 单次提交schema特定关系
前沿LLM提示加KG检索工具
- 在多跳KGQA基准上具竞争力
- 支持推理与查询交错进行
- 依赖GPT-4级模型部署成本高
- 延迟高不适合生产环境
SoG-R1通过将教师轨迹接地到实时知识图谱并融合检索与推理,在8B规模上超越依赖前沿LLM的提示方法及EoG、KG-Hopper等并发工作,而仅基于语义解析或离线子图的方法在未见schema或预处理召回上存在根本局限。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
知识图谱问答需要沿着图谱中的关系链路进行多步推理才能找到答案,传统做法依赖大型闭源语言模型,成本高昂。本文提出的 Search-on-Graph-R1 通过「脚手架教师」采集轨迹的方式,用监督微调结合强化学习将图谱导航能力内化到一个 8B 参数的紧凑模型中。该方法在 WebQSP、CWQ、GrailQA 三个基准上全面超越了所有冻结的前沿大模型系统,且在推理时无需任何辅助模块,训练时也不需要大模型评判器。
研究背景与动机
知识图谱问答是自然语言处理中一个经典而富有挑战性的任务。给出一个自然语言问题,系统需要从知识图谱(论文使用 Freebase)中识别主题实体,然后沿着若干条关系边逐步跳转,最终定位到答案实体或答案节点。比如「Who is the mother of the actress who starred in The Matrix?」这样的问题,就需要先找到电影《黑客帝国》的主演,再找到这位演员的母亲。
这类任务的核心难点在于多跳推理——模型必须学会在图中执行多次导航,每一步都需要根据问题语义选择正确的下一步关系。早期的解决方案依赖手工设计的规则或模板匹配,后来随着深度学习的发展,神经网络方法逐渐占据主流。然而,真正让知识图谱问答性能大幅提升的,是大规模语言模型的兴起。
近年来,研究者倾向于直接提示前沿大语言模型(如 GPT-4、Claude 等),配合检索或搜索工具让模型在知识图谱上「探索」。这种范式确实有效,但存在一个根本性的瓶颈:它必须依赖规模巨大的闭源模型进行推理,每次 API 调用都伴随着可观的成本。更重要的是,当需要处理海量问题时,这种成本会迅速膨胀到难以承受的地步。
这就引出了本文的核心问题:能否把这种图谱导航能力「内化」到一个更小、更高效的模型中,让它能够像大型模型一样在知识图谱上进行多跳推理,却不需要在推理时调用任何外部的大型模型?
方法
将图谱导航能力压缩到小模型面临一个关键挑战:训练数据从哪来?直接让小模型在图谱上探索会产生大量低质量的轨迹,因为小模型本身就缺乏正确的推理能力。这形成了一个困境——我们需要用好的轨迹来训练模型,但好的轨迹恰恰需要模型已经具备的能力才能产生。
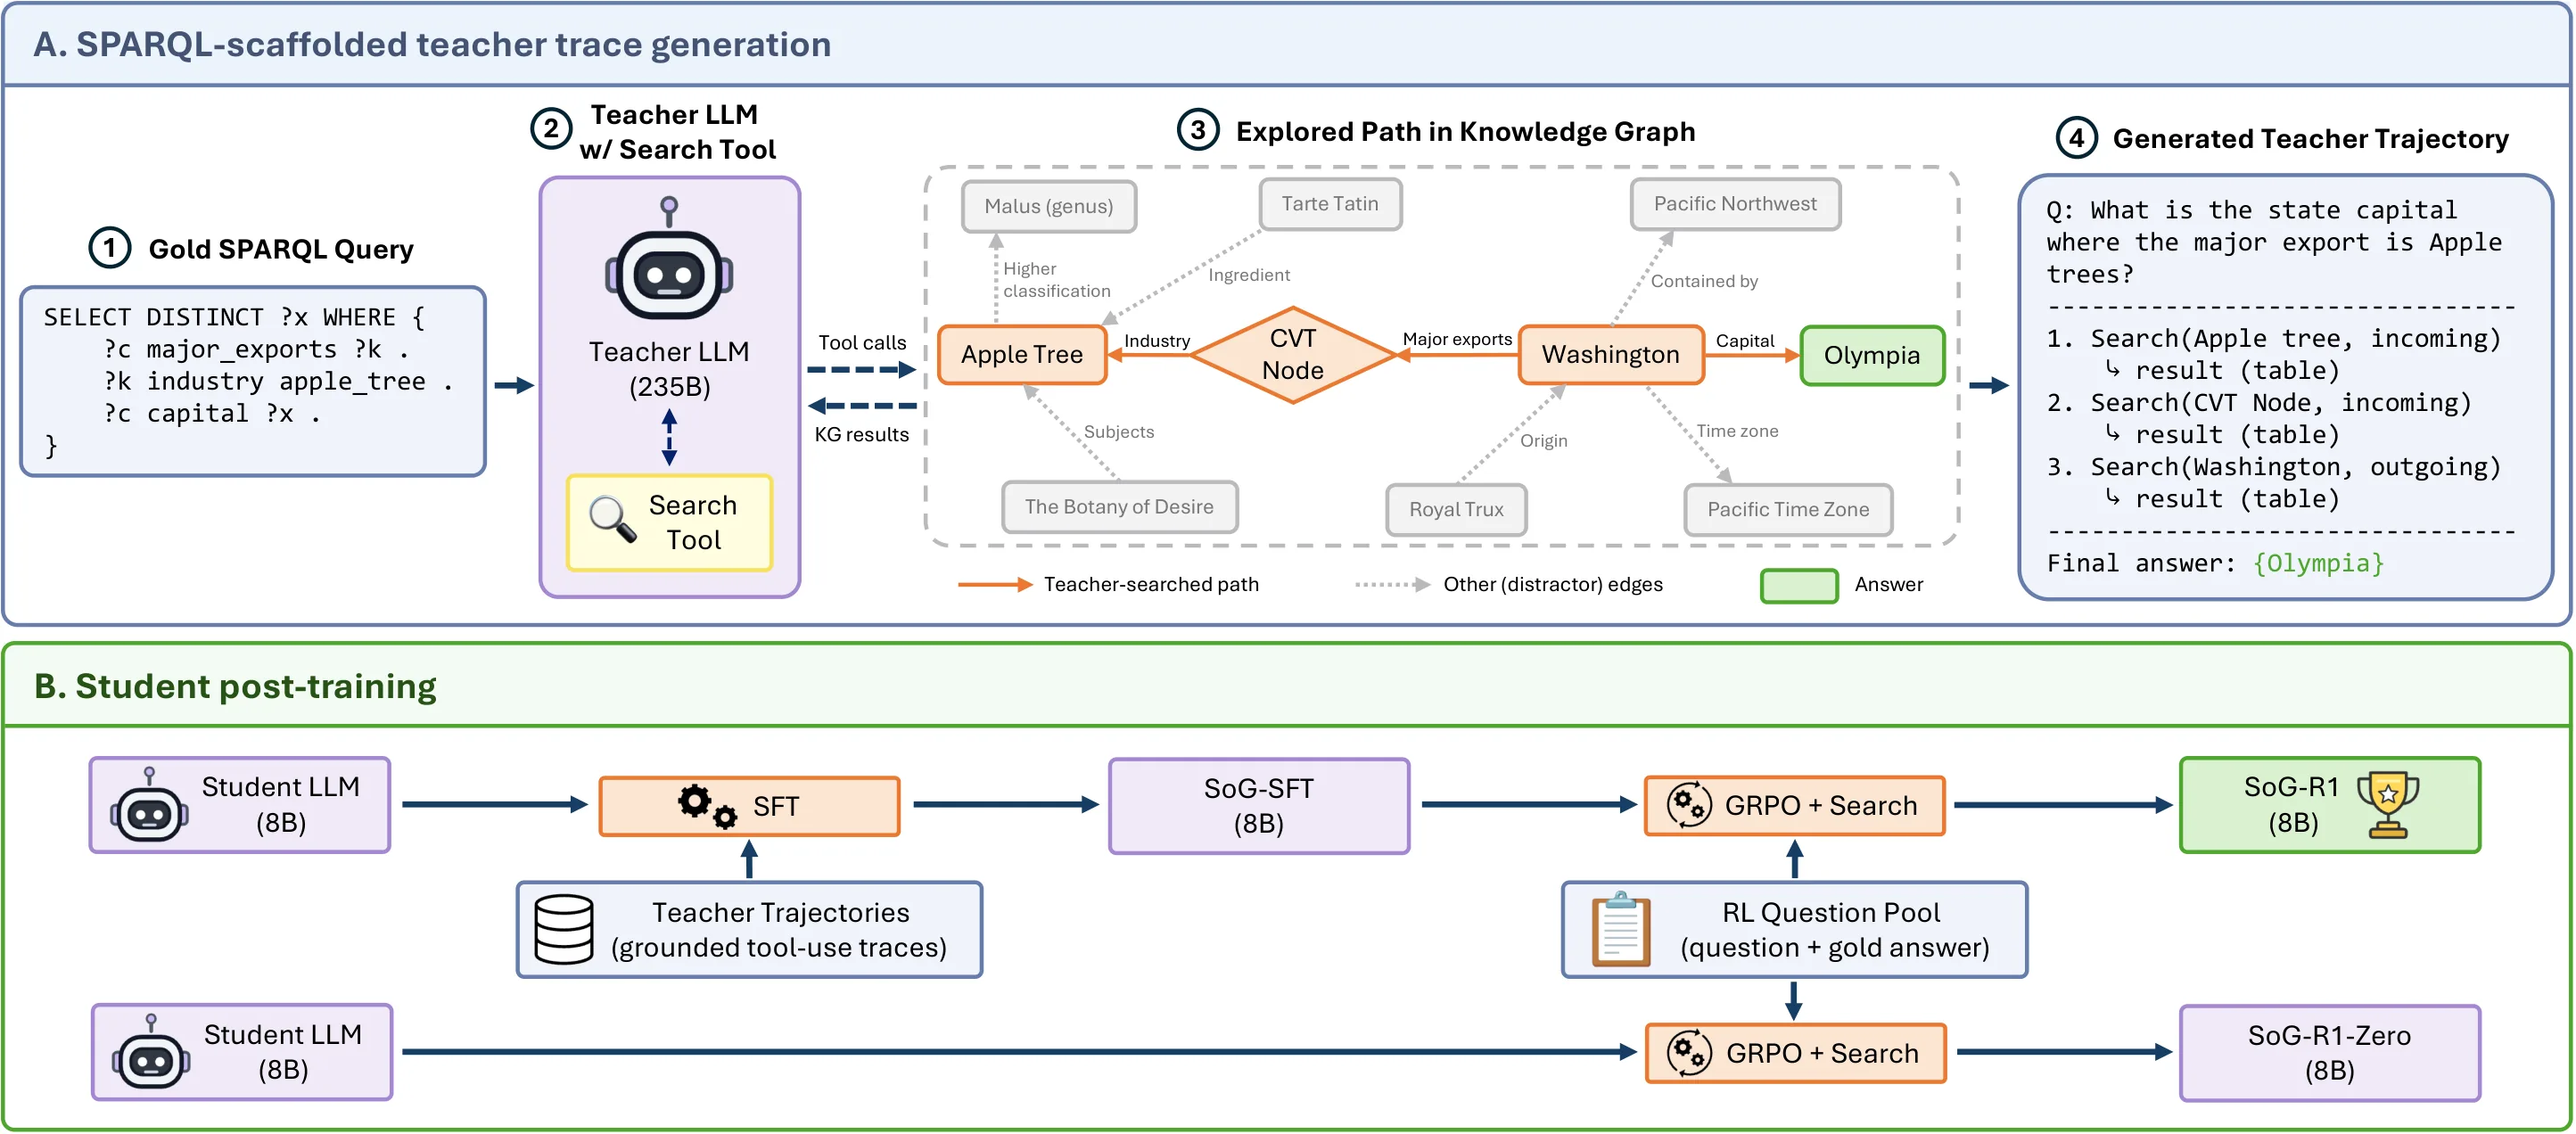
Search-on-Graph-R1 的核心创新在于脚手架教师的设计。作者没有让模型自己「摸索」答案路径,而是利用每个问题自带的金标准 SPARQL 查询作为引导。SPARQL 是知识图谱的标准查询语言,一条 SPARQL 查询本质上就是从主题实体到答案实体的完整路径描述。
具体做法是:对于每个训练样本,先将问题的 SPARQL 查询解析成一系列原子操作,然后让一个前沿教师模型按照这个序列逐步调用 \texttt{Search} 工具在真实的 Freebase 服务器上执行。每一步执行后,教师都会获得返回的中间实体,作为下一步的输入,最终抵达答案。
这样做有几个精妙之处。首先,所有轨迹天然是在真实图谱上执行的,与知识图谱高度 grounding,不会产生幻觉或虚假推理。其次,教师永远不会「迷路」,因为 SPARQL 查询已经保证了路径的正确性。第三,轨迹中包含了丰富的图谱结构信息——实体类型、关系含义、中间结果——这些都是有效的监督信号。
有了高质量轨迹后,训练分为两个阶段。第一阶段是监督微调,用采集到的轨迹数据直接微调 8B 基座模型。模型需要学会在给定问题和当前状态的情况下,预测下一步应该调用什么工具、传入什么参数。这让模型建立起基本的「图谱导航直觉」。
第二阶段是强化学习。作者采用了一种无需外部评判器的 RL 方法,奖励信号直接来自图谱——当模型最终找到的实体恰好是标准答案时,给予正向奖励;否则给予负向奖励。这个过程鼓励模型在保持准确率的同时,学会用更少的 \texttt{Search} 调用次数到达答案,实现了效率与效果的双重优化。
值得注意的是,这种 RL 训练完全在离线模式下进行,不需要实时访问图谱或 LLM 评判器,大大降低了训练成本。
实验与结果
作者在三个标准的知识图谱问答基准上进行了评估:WebQSP、CWQ(Complex Web Questions)和 GrailQA。这三个数据集覆盖了从简单单跳到复杂多跳的各种问题类型,是该领域最常用的评测集。
实验结果令人印象深刻。在所有三个数据集上,经过训练的 8B 模型都超越了所有被冻结的前沿大模型系统——所谓「冻结」,意味着这些大模型在推理时不可进行任何微调或适配。8B 模型不仅在参数量上小了数十倍,而且能够独立完成整个推理过程,不需要任何外部辅助。
特别是在 CWQ 这个最具挑战性的数据集上,该方法取得了所对比系统中的最佳结果。CWQ 中的问题往往涉及复杂的逻辑组合(如「且」「或」「非」),需要模型在图谱上进行更深层的推理,这恰恰验证了该方法在复杂推理场景下的鲁棒性。
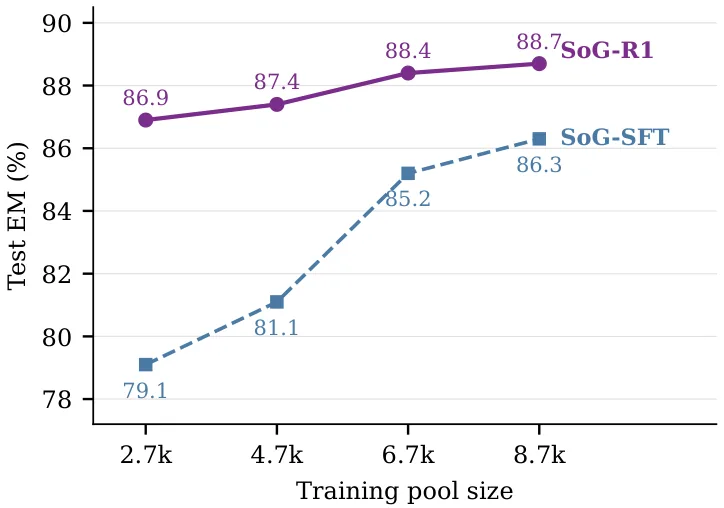
作者还进行了详细的消融实验来验证各训练阶段的作用。结果显示,监督微调和强化学习产生了互补的增益:SFT 让模型学会了基本的图谱操作模式,而 RL 则进一步优化了决策策略,使模型能够在不牺牲准确率的前提下缩短推理路径。平均而言,经过 RL 训练后的模型所需的 \texttt{Search} 调用次数比 SFT 初始化版本更少,这说明强化学习帮助模型学到了更高效的推理策略。
另一个重要发现是方法的可迁移性。作者尝试将训练流程应用于不同的基座模型家族,都观察到了类似的性能提升,表明该方法并不依赖于特定的模型架构。
讨论与可借鉴点
Search-on-Graph-R1 展示了一条将大型模型的复杂推理能力迁移到紧凑模型的可行路径。其核心启示在于:当直接模仿难以获得时,可以通过结构化先验(如 SPARQL 查询)来引导数据采集过程,从而绕开「先有能力才能产生好数据」的困境。这种「脚手架教师」的设计思路在许多需要内化复杂能力的场景中都具有参考价值。
该方法的局限性也值得思考。首先,它依赖于每个问题都有可用的 SPARQL 查询作为监督信号,这在实际应用中往往不可得。其次,当前的方法针对知识图谱这一特定场景设计,如何泛化到其他需要多步推理的任务(如多跳表格问答、程序合成等)还有待探索。第三,虽然 8B 模型已经足够紧凑,但在某些边缘部署场景中可能仍然过大。
从更宏观的角度看,这项工作呼应了近期关于「推理能力是否可以被压缩」的系统性讨论。它表明,至少对于结构化环境中的导航任务,答案是肯定的。未来的研究可能会进一步探索:更小的模型能否获得类似的能力?如何在没有金标准查询的情况下扩展这种方法?这些问题将为该方向的持续发展提供动力。
摘要
知识图谱问答(KGQA)需要从主题实体出发,经由若干层关系跳转才能到达答案。已有方法通过提示前沿大语言模型并借助检索工具来探索图谱,但它们对前沿规模推理的依赖使其部署成本高昂。我们提出 Search-on-Graph-R1(\sogrone{}),通过监督微调(SFT)以及随后的强化学习(RL),将这种导航能力内化进一个紧凑的 8B 模型中。我们的核心思路是:利用每个问题的标准 SPARQL 查询来搭建一个前沿教师模型,使教师通过实时 \texttt{Search} 工具遍历一条已知的含答案路径,而无需自行发现该路径。由于每一次调用都在真实的 Freebase 服务器上执行,所得轨迹天然以知识图谱为依据。在 WebQSP、CWQ 和 GrailQA 上,\sogrone{}(8B)超越了我们比较中所有冻结的前沿大模型系统,并在 CWQ 上取得了所对比系统中最为领先的结果。它在推理时不依赖任何辅助模块,在训练时也不使用大模型评判器。对各训练阶段进行隔离分析表明:SFT 与 RL 带来互补的增益;我们的方法可在不同模型家族间迁移;且相较于 SFT 初始化版本,RL 学会以更少的 \texttt{Search} 调用次数抵达答案。
Abstract
Knowledge graph question answering (KGQA) requires navigating from topic entities to an answer several relations away. Recent methods prompt a frontier LLM to explore the graph through a retrieval tool, but their reliance on frontier-scale inference makes them costly to deploy. We present Search-on-Graph-R1 (\sogrone{}), which internalizes this navigation into a compact 8B model through supervised fine-tuning (SFT) followed by reinforcement learning (RL). Our central idea is to scaffold a frontier teacher with each question's gold SPARQL query, so the teacher traverses a known answer-bearing path with a live \texttt{Search} tool rather than having to discover the path itself. Since every call executes against a live Freebase server, the resulting trajectories are grounded in the knowledge graph by construction. On WebQSP, CWQ, and GrailQA, \sogrone{} at 8B surpasses every frozen frontier-LLM system in our comparison and posts the strongest results on CWQ of any system we compare against. It does so using no auxiliary module at inference and no LLM judge during training. Isolating each training stage shows that SFT and RL contribute complementary gains, our approach transfers across model families, and RL learns to reach answers in fewer \texttt{Search} calls than its SFT initialization.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。