
面向部分可观测性下时序知识图谱记忆的神经-符号元策略
Neuro-Symbolic Meta-Policies for Temporal Knowledge-Graph Memory under Partial Observability
📝 TLDR
在部分可观测强化学习场景中,智能体需决定记忆中内容的保留、检索与遗忘。本文提出一种神经-符号元策略,在每个决策点动态选择符号记忆启发式,同时保持整体执行的符号性。该方法在RoomKG环境内以带时间标注的RDF图为记忆载体,融合知识图谱编码与问答、探索、遗忘多任务价值头。在长时记忆容量512的设置下,qualifier感知的StarE-GNN配置在多种基线中取得最优留出集性能,并保留步骤级可追溯性。
🧭 速览
部分可观测环境下,传统记忆管理难以兼顾适应性与可解释性,亟需可控的保留与遗忘机制。
神经-符号元策略动态选取符号记忆启发式,以RDF图编码记忆并联合优化QA、探索与遗忘价值头。
在RoomKG容量512的留出房间测试中,qualifier感知的StarE-GNN配置优于多种符号、神经与神经-符号基线。
兼具自适应性、步骤级可追溯性与语义网基础,为可解释的部分可观测记忆管理提供新方案。
🆚 方法对比
Neuro-Symbolic Meta-Policy
- 结合神经适应性与符号可解释性
- 在符号启发式间选择,保留逐步可追溯性
- 512容量下取得最佳保持性能
- 显式操作符代替隐式动作
- 依赖底层符号启发式质量
- 框架复杂度较高
- 泛化至其他领域尚待验证
RoomKG (Temporal KG Memory Substrate)
- 基于RDF图的结构化状态表示
- 支持时间RDF三元组标注
- 语义Web基础扎实,显式可检查
- 显式模拟部分可观测性
- 表示能力受限于RDF三元组
- 仅适用房间类结构化环境
- 非本文贡献,仅作评估平台
StarE-GNN (Qualifier-aware Configuration)
- 限定符感知超关系消息传递
- 在512容量下取得最佳保持性能
- 适合时间知识图谱编码
- 支持超关系图结构
- 计算复杂度高于普通GNN
- 依赖限定符标注的完整性
- 仅在特定超参下验证
R-GCN (Relational Graph Convolutional Network)
- 成熟的关系感知图编码架构
- 适合多关系RDF图编码
- 已有多领域应用验证
- 不处理限定符与超关系
- 对时间标注支持有限
- 性能不及StarE-GNN配置
Fixed Symbolic Heuristics
- 完全可解释,执行透明
- 无需训练,决策可追溯
- 实现简单,开销低
- 跨上下文灵活性差
- 无法自适应不同场景
- 性能受限于人工设计质量
Fully Neural/Recurrent RL Policies
- 端到端自适应能力强
- 无需手工设计记忆启发式
- 灵活适应不同上下文
- 隐式记忆难以检查与追溯
- 缺乏显式推理与解释性
- 不透明,调试困难
Hierarchical Options Framework
- 提供分层策略选择思路
- 成熟的方法论基础
- 选项为隐式嵌入而非显式符号操作
- 不保持符号执行的透明性
本文在符号、神经与神经符号三类方法间进行对比,提出的神经符号元策略在保持符号执行可追溯性的同时获得最佳适应性,其中StarE-GNN限定符感知配置在RoomKG 512容量下优于R-GCN等基线编码器。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文探讨了部分可观测强化学习中记忆管理的核心问题——智能体需要学会何时保留、何时检索、何时遗忘信息。作者提出了一种神经-符号元策略,在 RoomKG 环境中使用时序知识图谱作为记忆载体,让智能体在每个决策点动态选择合适的符号化记忆启发式。在长期记忆容量 512 的设定下,带限定符感知的 StarE-GNN 配置在符号化、神经化及神经-符号化等多种系统对比中取得最优性能,同时保留了记忆管理决策的步骤级可追溯性。
研究背景与动机
部分可观测强化学习(Partially Observable Reinforcement Learning)是当前智能体研究中的核心挑战之一。与全观测环境不同,智能体只能获得不完整的观测信息,这意味着它必须依靠记忆来弥补信息的缺失。然而,记忆并非越多越好——无限增长的记忆会带来计算负担,而无关信息的堆积则会干扰决策。因此,如何在时间维度上优雅地决定保留、检索与遗忘哪些信息,成为一个兼具理论意义和实践价值的问题。
传统的记忆管理方法大致分为两类。一类是完全符号化的方法,这类方法使用预定义的规则或逻辑来进行记忆操作,执行过程透明可追溯,但缺乏适应性,难以应对复杂多变的环境。另一类是完全端到端的方法,使用神经网络隐式地学习记忆策略,这类方法具有较强的表达能力,但决策过程往往是一个黑箱,难以解释和审计。两类方法各有优劣,如何兼取所长、避其所短,正是这篇论文的切入点。
值得注意的是,这项工作选择了一条与主流不同的道路——将记忆的表示和管理扎根于 Semantic Web 的技术栈。具体而言,论文使用资源描述框架(RDF)图来表示隐藏状态和观测,并引入时序 RDF 三元组标注来记录记忆的时间信息。这一选择使得记忆具有天然的语义结构,也为后续的符号化操作提供了统一的形式化基础。
方法
论文的核心贡献是一种神经-符号元策略(neuro-symbolic meta-policy)。这里的"元策略"指的是一个高层次的控制器,它并不直接决定智能体的行为,而是在每个决策点选择应该应用哪种记忆启发式策略。这种设计的直觉在于:不同的场景可能需要不同的记忆操作——某些时候需要检索相关信息来辅助推理,某些时候需要探索新的可能性,而某些时候则需要主动遗忘以释放记忆空间。元策略的作用,就是根据当前的情境动态地做出这个选择。
在具体实现上,论文构建了一个多层次的架构。基础层是记忆的内容本身,以时序知识图谱的形式存储。具体来说,每个记忆条目被表示为一个 RDF 三元组,其中包含主语、谓词、宾语以及一个时间戳标注。这种表示方式的优势在于,RDF 图天然支持链接和推理,丰富的语义关系可以直接编码到记忆的结构中。
中间层是知识图谱编码器,负责将离散的 RDF 图转换为连续的向量表示,供神经网络处理。论文比较了多种编码配置,最终发现带限定符感知的 StarE-GNN 效果最佳。StarE-GNN 是一种专门设计用于处理 RDF 图的图神经网络架构,它能够保留图中的语义结构信息,生成高质量的图嵌入。
顶层是价值头(value heads),分别对应三种任务:问答、探索和遗忘。问答头负责评估从记忆中检索信息对当前决策的价值;探索头评估尝试新行为的潜在收益;遗忘头则评估删除某些记忆条目的必要性。这三个价值信号共同构成元策略的决策基础,使其能够在不同情境下做出合理的记忆管理选择。
整个系统的优雅之处在于,虽然底层的知识图谱编码和价值评估借助了神经网络的力量,但记忆的表示和操作始终保持符号化的形式。这意味着智能体的记忆管理决策可以追溯到具体的记忆条目和符号推理过程,而不仅仅是一堆浮点数的运算结果。
实验与结果
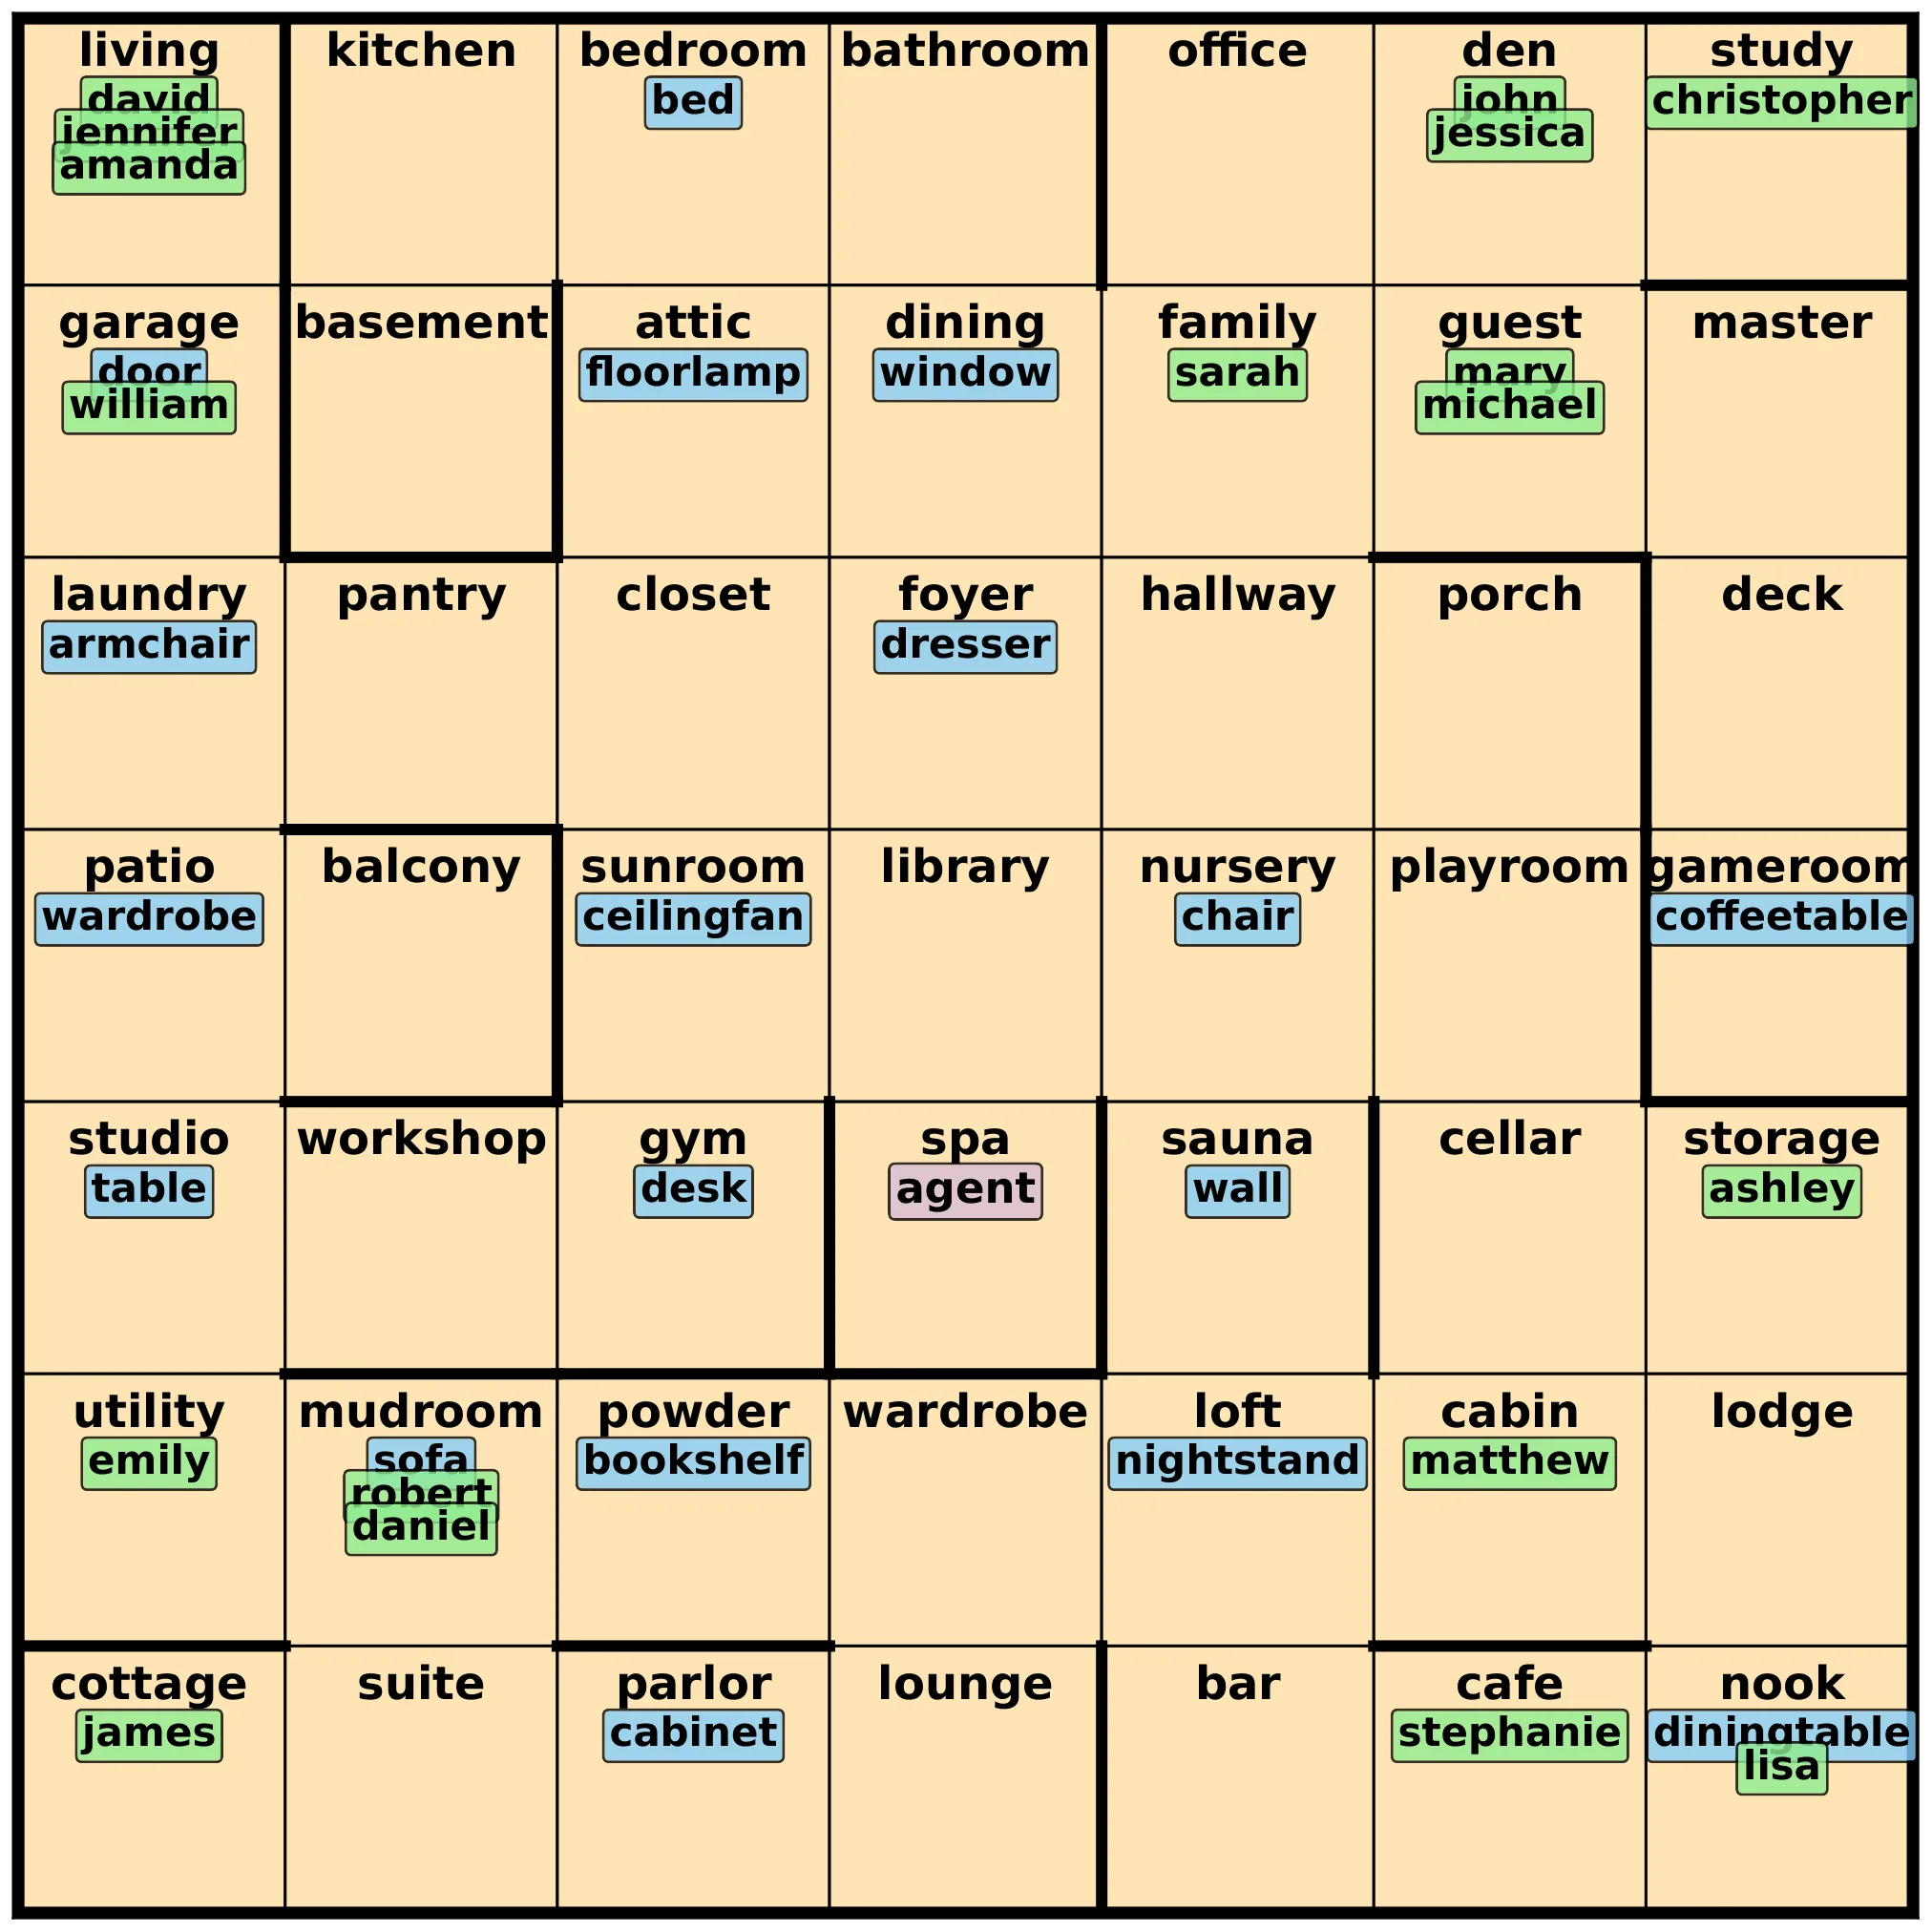
论文在 RoomKG 环境中进行实验评估。RoomKG 是一个专门为时序知识图谱记忆研究设计的基准环境,它模拟了智能体在多个房间中探索和交互的场景。实验采用训练集和测试集房间划分的方式,测试模型在新房间中的泛化能力。
记忆容量被设定为 512,这是一个相对较大的长期记忆规模,足以容纳丰富的历史信息,但又不至于大到让记忆管理变得无关紧要。在这一设定下,论文对比了三类基线方法:纯符号化系统、纯神经化系统,以及其他神经-符号化方法。
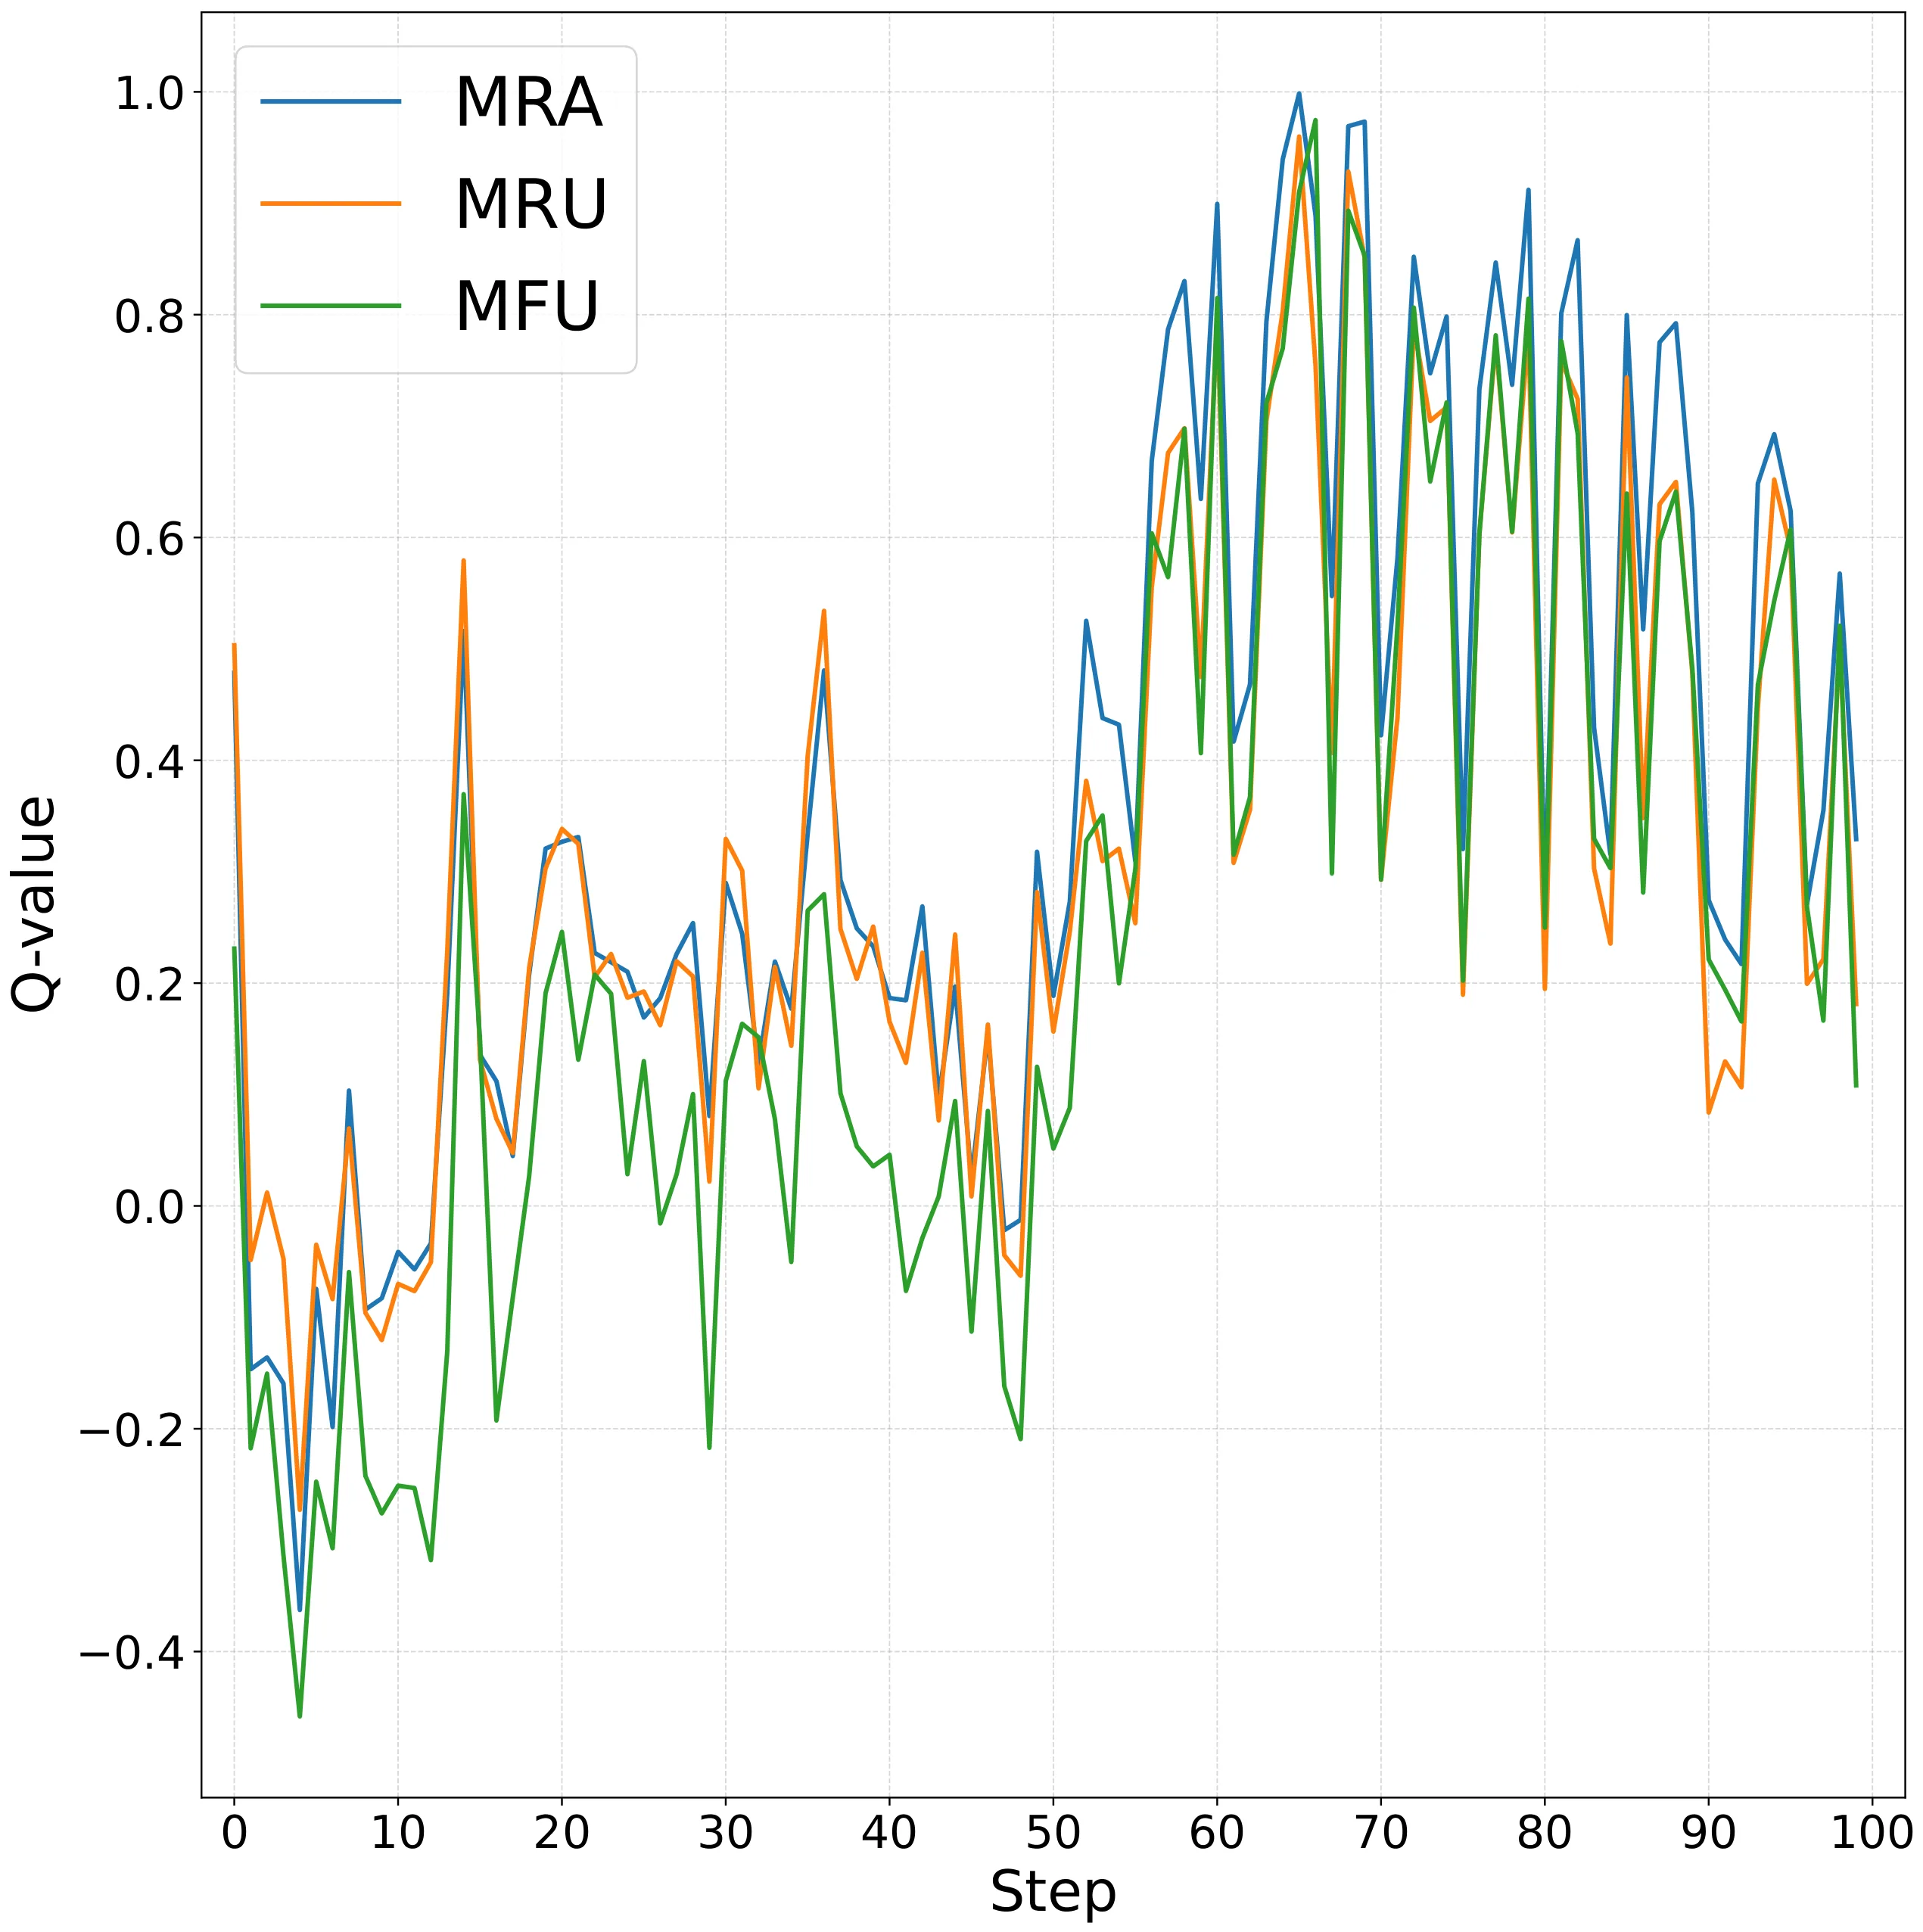
实验结果清晰地表明,带限定符感知的 StarE-GNN 配置在所有对比方法中取得了最佳的留出集性能。这一结果说明了两个关键点:首先,知识图谱编码能够有效地捕获记忆内容中的语义关系,为记忆管理决策提供有价值的信息;其次,限定符信息的保留对于性能提升至关重要——忽略 RDF 三元组中的限定词会导致信息损失,进而影响决策质量。
除了性能指标,论文还特别强调了"步骤级可追溯性"这一特性。在元策略的每次决策中,可以清晰地追踪它选择了哪种记忆启发式、基于了哪些记忆条目、经过了怎样的符号化推理过程。这种可解释性在许多实际应用场景中具有重要价值,尤其是当智能体的决策需要接受审查或与人类协作时。
讨论与可借鉴点
这篇论文的一个核心贡献在于证明了在记忆管理任务中,神经方法和符号方法并非互斥的选择。通过神经-符号元策略的设计,作者成功地将神经网络的表达学习能力与符号系统的可解释性结合起来。这种"神经为用、符号为体"的思路,或许可以为更广泛的研究提供参考。
然而,这项工作也存在一些局限和未解决的问题。首先,RoomKG 环境相对简化,在更复杂的真实世界场景中,时序知识图谱记忆的scalability和效率还有待验证。其次,RDF 图的构建和维护本身需要额外的知识工程成本,如何在动态环境中自动构建和维护知识图谱记忆,仍是一个开放问题。第三,StarE-GNN 等图神经网络的计算复杂度随图规模增长,在记忆容量进一步扩大时的效率需要考虑。
对于未来研究而言,一个有前景的方向是探索更丰富的符号化推理能力。当前系统的符号操作主要停留在检索和遗忘层面,未来或许可以引入更复杂的推理模式,如基于规则的演绎或多跳关系查询。另一个方向是将时序 RDF 标注扩展为更丰富的语义标注体系,例如添加置信度、来源、可信度等元信息,使记忆管理决策能够基于更全面的信息做出。
摘要
部分可观测强化学习需要在时间维度上决定保留、检索与遗忘哪些信息。我们提出了一种神经-符号元策略,其在保持执行过程符号化的同时,学习在每个决策点应用何种符号化记忆启发式。我们的设定在 RoomKG 中使用时序知识图谱记忆,其中隐藏状态与观测以资源描述框架(RDF)图表示,记忆通过时序 RDF 三元组标注进行增强。该模型将记忆内容的知识图谱编码与用于问答、探索和遗忘的价值头相结合,产生一个兼具自适应性且可审视的控制器。这使得该工作通过基于 RDF 的表示、与标注兼容的图语义,以及在显式记忆状态上执行的基于图的符号化操作,直接扎根于语义网。在长期记忆容量为 512 的训练/测试房间划分下,带限定符感知的 StarE-GNN 配置在所比较的符号化、神经化及神经-符号化系统中取得了最佳的留出性能,同时保留了记忆管理决策的步骤级可追溯性。
Abstract
Partially observable reinforcement learning requires deciding what to retain, retrieve, and forget over time. We introduce a neuro-symbolic meta-policy that learns which symbolic memory heuristic to apply at each decision point while keeping execution symbolic. Our setting uses temporal knowledge-graph memory in RoomKG, where hidden state and observations are represented as Resource Description Framework (RDF) graphs and memory is augmented with temporal RDF triple annotations. The model combines knowledge-graph encoding of memory contents with value heads for question answering, exploration, and forgetting, yielding a controller that is both adaptive and inspectable. This gives the work a direct Semantic Web grounding through RDF-based representation, annotation-compatible graph semantics, and graph-based symbolic operations over explicit memory state. On train/test room splits at long-term memory capacity of 512, the qualifier-aware StarE-GNN configuration achieves the best held-out performance among the compared symbolic, neural, and neuro-symbolic systems while preserving step-level traceability of memory-management decisions.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。