
AlayaWorld:交互式长视野世界建模——完整技术报告
AlayaWorld: Interactive Long-Horizon World Modeling -- Full Technical Report
📝 TLDR
传统游戏开发依赖繁重人工流水线,无法即时响应用户输入生成可探索虚拟世界。AlayaWorld 基于 15B 视频扩散 Transformer,以自回归方式生成短潜空间块,融合持久 sink 帧、压缩时序历史、几何对齐空间记忆与近期帧条件约束,支撑相机轨迹与可切换文本提示下的稳定交互。通过将分布匹配蒸馏、自强制++ 与一致性蒸馏融合为离散自回归蒸馏,将每块采样步数压缩至 4 步,仍可输出 24fps 的 540p/720p 视频,在 iWorld-Bench 长时序生成任务上取得最佳成绩,为交互式世界模型研究提供全栈开源可扩展基础。
🧭 速览
交互式视频世界模型须同时满足交互、时空一致性、长时序稳定性与高效响应四大耦合能力,现有方法难以兼顾。
15B DiT 自回归生成短潜块,融合 sink 帧、压缩时序历史、几何空间记忆与近期帧条件;通过分布匹配蒸馏、自强制++ 与一致性蒸馏联合实现四步推理。
在 iWorld-Bench 长时序生成中取得最佳成绩,每块采样从约 30 步降至 4 步,可输出 24fps 的 540p/720p 视频。
AlayaWorld 作为全栈开源长期项目,为交互式长时序视频世界模型研究提供可扩展基础。
🆚 方法对比
AlayaWorld
- 15B参数视频扩散Transformer基础
- 生成24fps 540p和720p高质视频
- 在iWorld-Bench取得最佳性能
- 开源全栈可扩展基础项目
- 计算资源需求高部署门槛高
- 分辨率限于720p不够高
- 15B模型规模带来显存压力
Bounded Visual Context
- 融合多类型上下文保证时空一致性
- 包含持久sink帧与几何记忆
- 支持可切换文本提示交互
- 上下文管理机制较复杂
- 多组件协同增加显存开销
- 压缩历史可能丢失细节
Corrupted History训练策略
- 有效减少长期生成漂移
- 利用自生rollouts自监督训练
- 通过预测残差提升鲁棒性
- 可能放大模型固有偏差
- 训练数据收集流程复杂
- 需额外构造损坏历史样本
Discrete Autoregressive Distillation
- 推理从约30步降至4步
- 融合DMD/SF++/CD三种蒸馏优势
- 保持自回归生成质量
- 激进步数缩减可能损失质量
- 多种蒸馏技术组合复杂
- 需精心设计损失平衡
Distribution-Matching Distillation
- 有效对齐师生模型分布
- 标准成熟的蒸馏方法
- 无需对抗训练更稳定
- 需精细调参优化效果
- 可能存在质量与速度权衡
- 对教师模型质量依赖大
Self-forcing++
- 扩展自强制方法提升一致性
- 改进版降低训练不稳定
- 增强长视野生成能力
- 增加额外训练开销
- 实现复杂参数敏感
- 论文细节披露有限
Consistency Distillation
- 支持少步快速采样
- 技术成熟易于集成
- 保持时间一致性
- 激进蒸馏可能导致质量下降
- 对教师模型质量依赖大
- 边界一致性难以完美
AlayaWorld通过统一框架融合Bounded Visual Context与三种蒸馏技术(DMD、Self-forcing++、CD),相比单一蒸馏方法在长视野一致性和推理效率上均更优,但系统复杂度和训练成本也更高。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
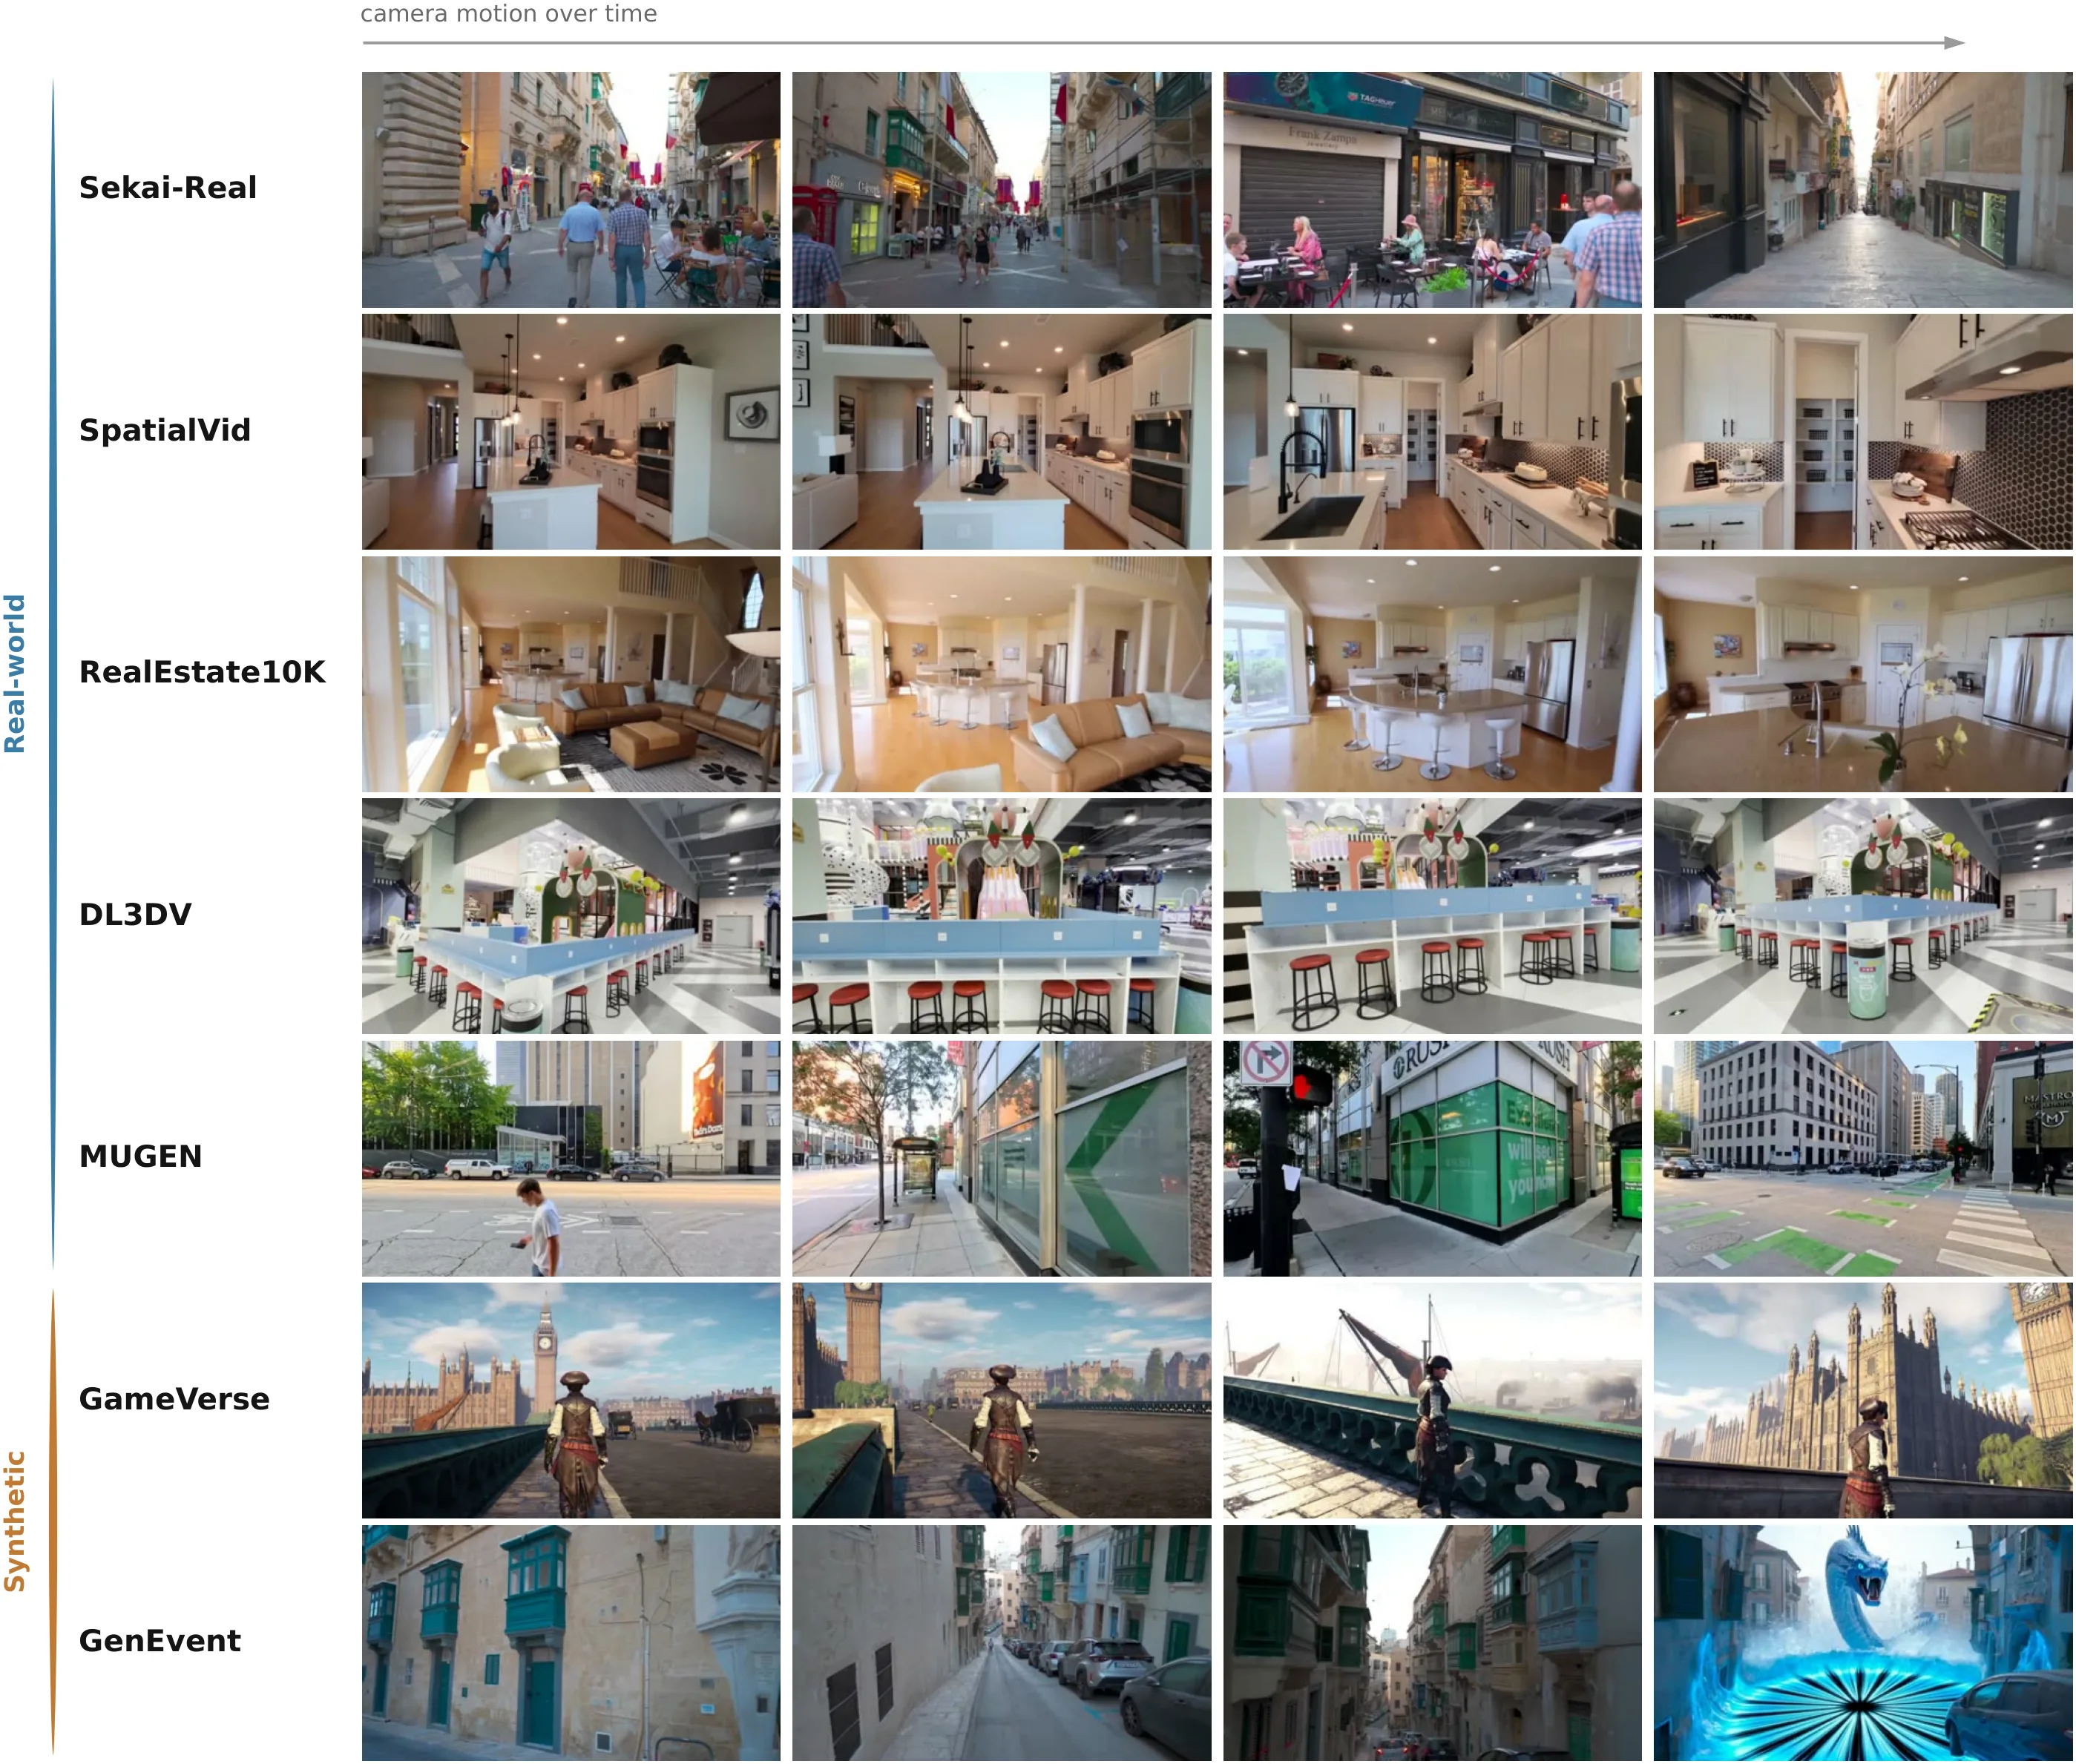
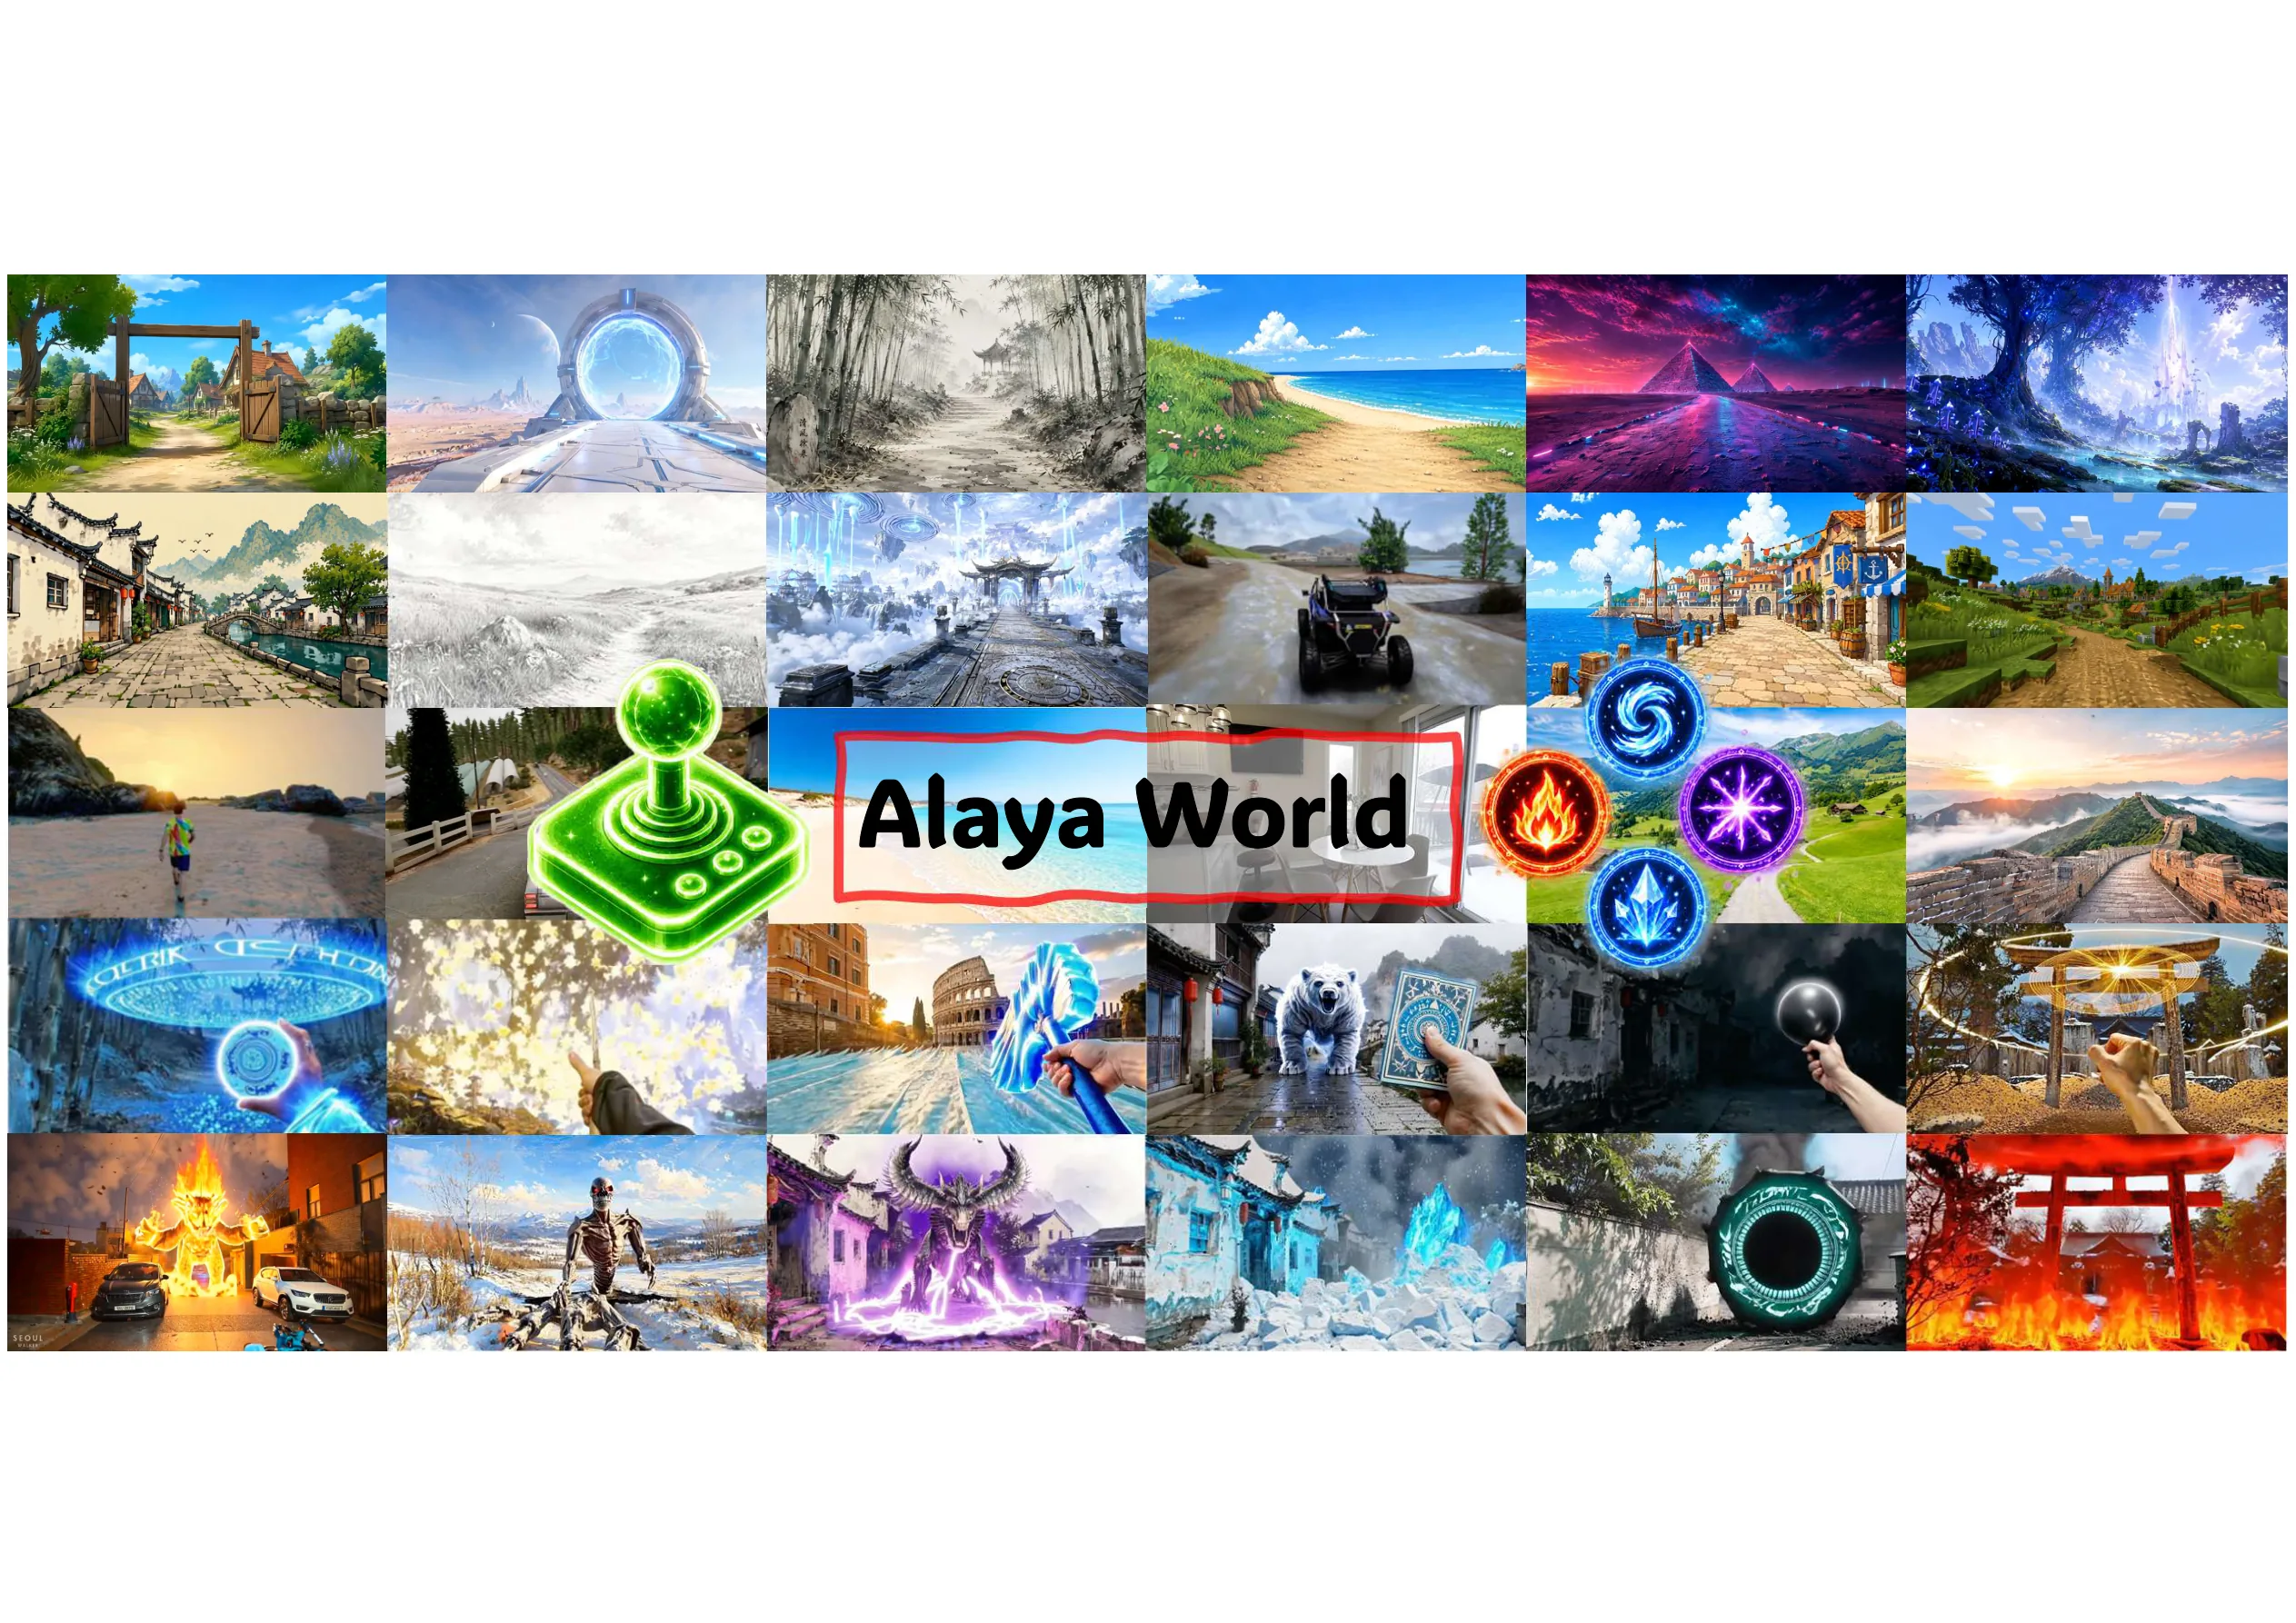
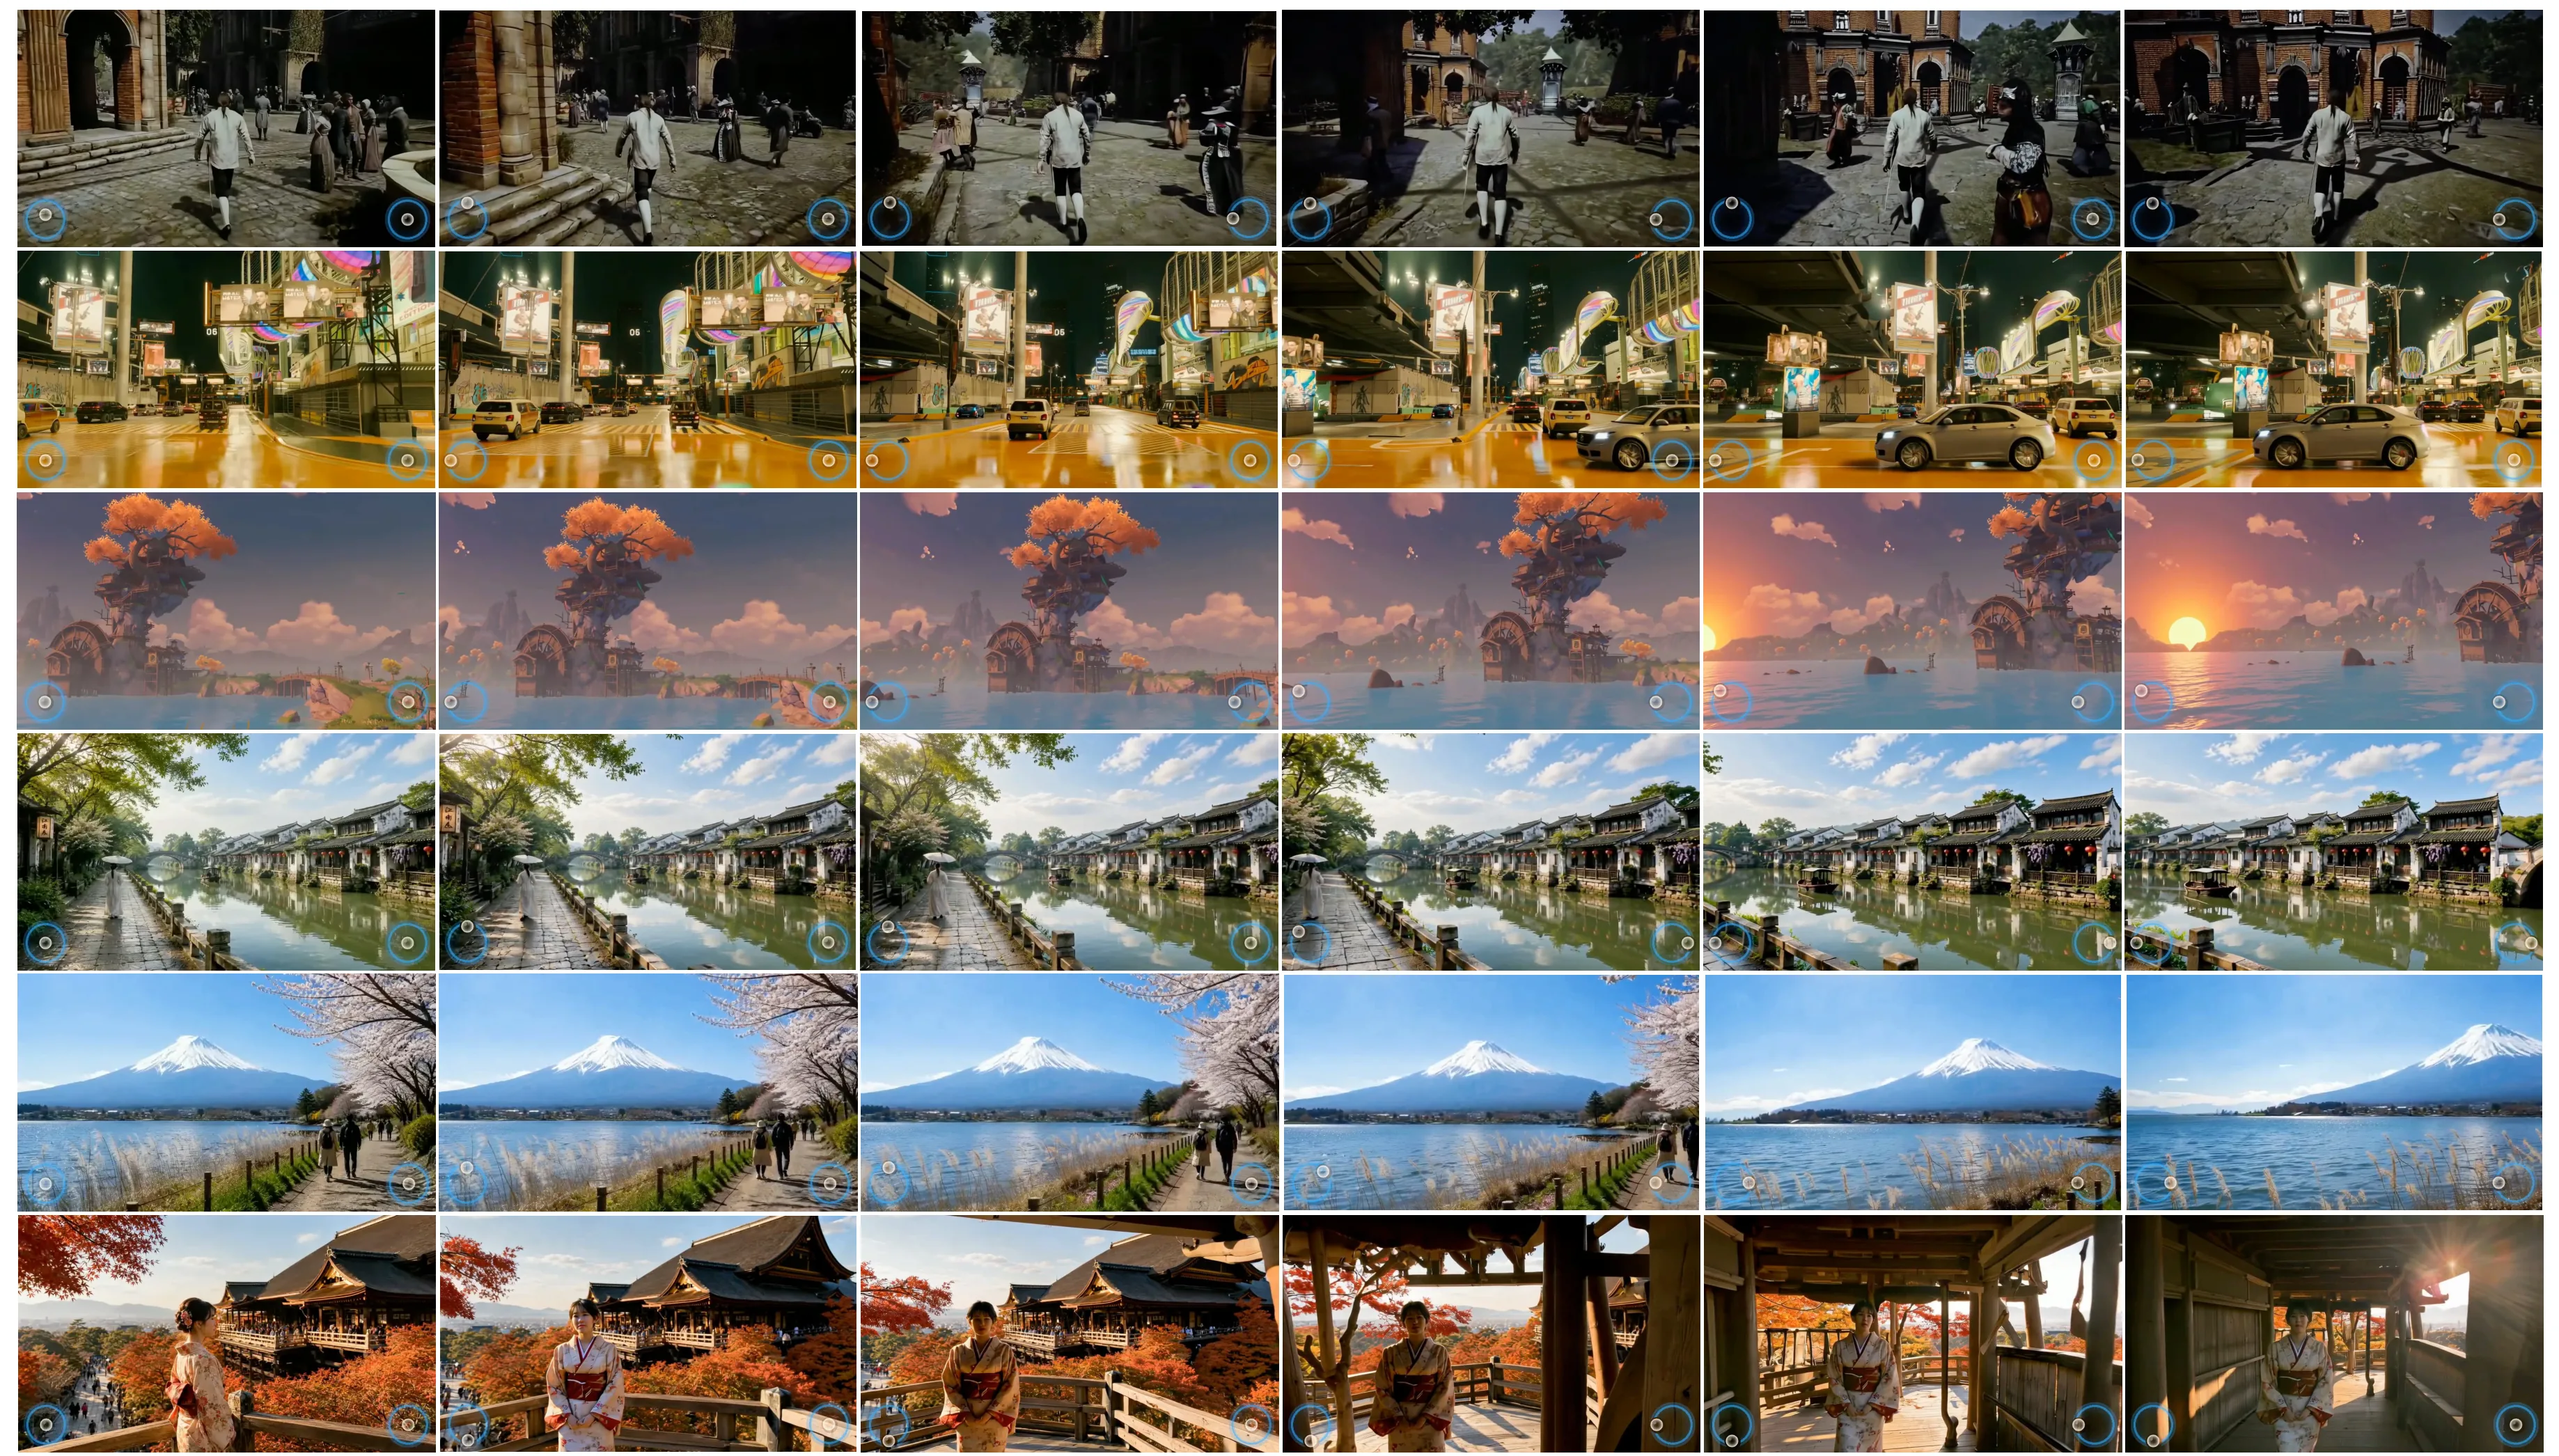
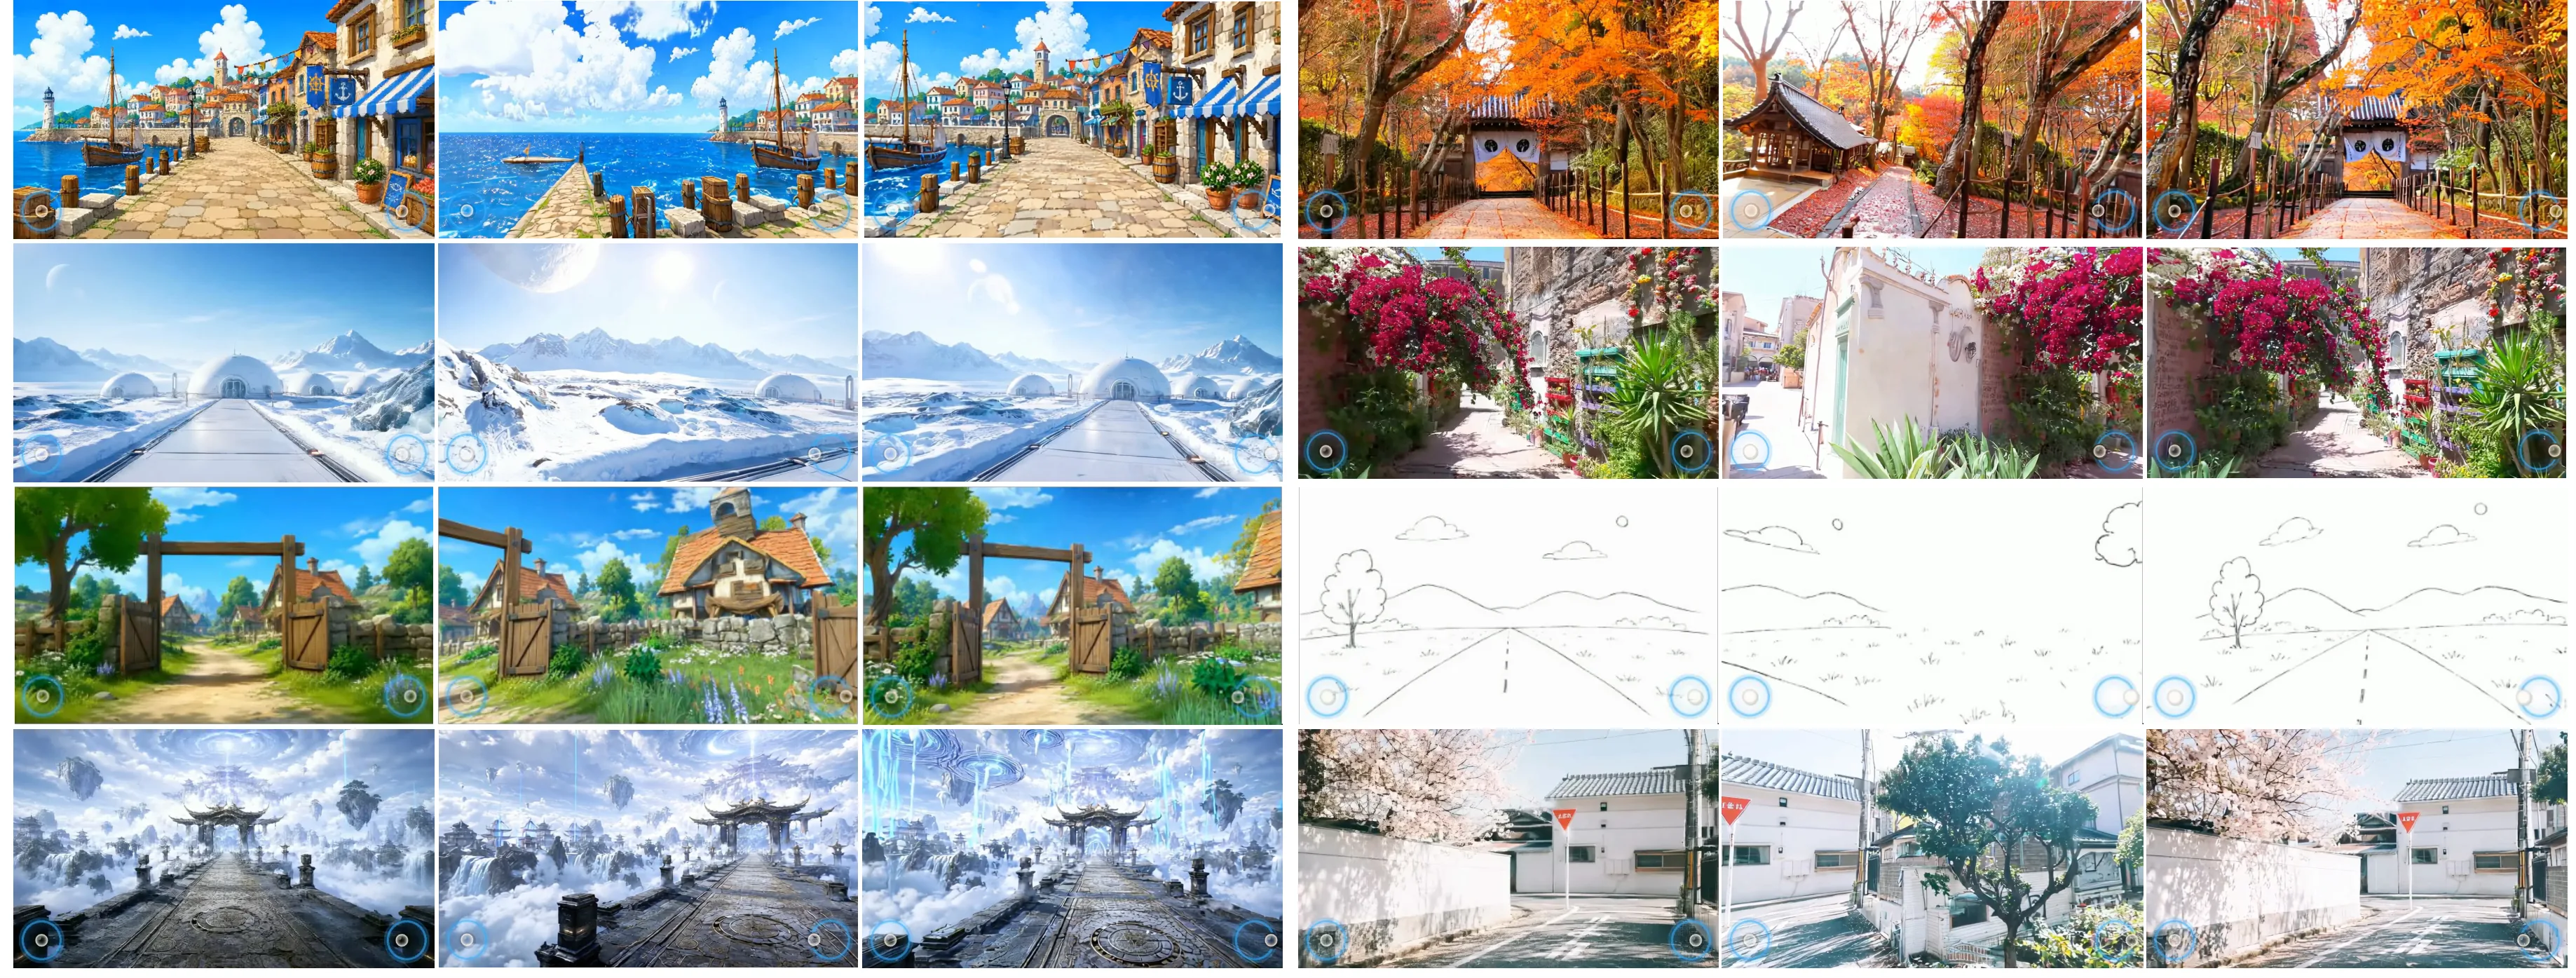
TL;DR
AlayaWorld 是一个基于 15B 视频扩散 Transformer 的交互式长视野世界模型,能够以 24fps 生成 540p/720p 视频,并支持相机轨迹与文本提示的实时交互控制。其核心创新在于设计了融合持久 sink 帧、压缩时序历史、几何对齐空间记忆的有界视觉上下文机制,并引入结合分布匹配蒸馏、self-forcing++ 与一致性蒸馏的离散自回归蒸馏方案,将每块推理步数从约 30 步压缩至 4 步,在 iWorld-Bench 长时序生成任务上取得了最佳成绩。
研究背景与动机
传统电子游戏的世界构建依赖劳动密集型管线:美术团队需要手工制作资产、动画师逐帧设计运动轨迹、物理程序员编写碰撞与重力规则、游戏策划用代码或脚本定义交互逻辑。这条流水线的核心局限在于无法即时响应用户输入——玩家的每一个动作都需要提前规划好对应的资产与逻辑,一旦超出预设范围,系统就会"穿帮"。
视频世界模型(Video World Model)的愿景正是要打破这一瓶颈:让用户通过文本、图像甚至一段视频,就能实时生成可探索、可交互、持续演化的虚拟环境。这种能力意味着任何人都可以成为"造物主",用自然语言描述自己想象中的世界,系统则在用户探索的过程中即时生成一致的视觉内容。
然而,实现这一愿景面临四项紧密耦合的核心挑战:交互性要求模型能根据用户输入(如相机移动、文本描述切换)实时调整生成内容;持久时空一致性要求同一物体在跨越数十秒的生成中保持外观与行为的连贯;稳定的长视野生成要求模型在数百帧甚至更长时间跨度内不出现明显退化或"幻觉";高效响应则要求推理延迟足够低以支撑实时交互体验。
此前的工作往往在这几个维度上顾此失彼——有的模型生成长视频但推理太慢无法交互,有的模型响应快但一致性很快崩溃,有的模型一致性尚可但无法处理复杂的相机运动与文本切换。AlayaWorld 的切入点是重新设计视觉上下文机制与蒸馏训练流程,让这四个维度能够在同一个框架下协同优化。
方法
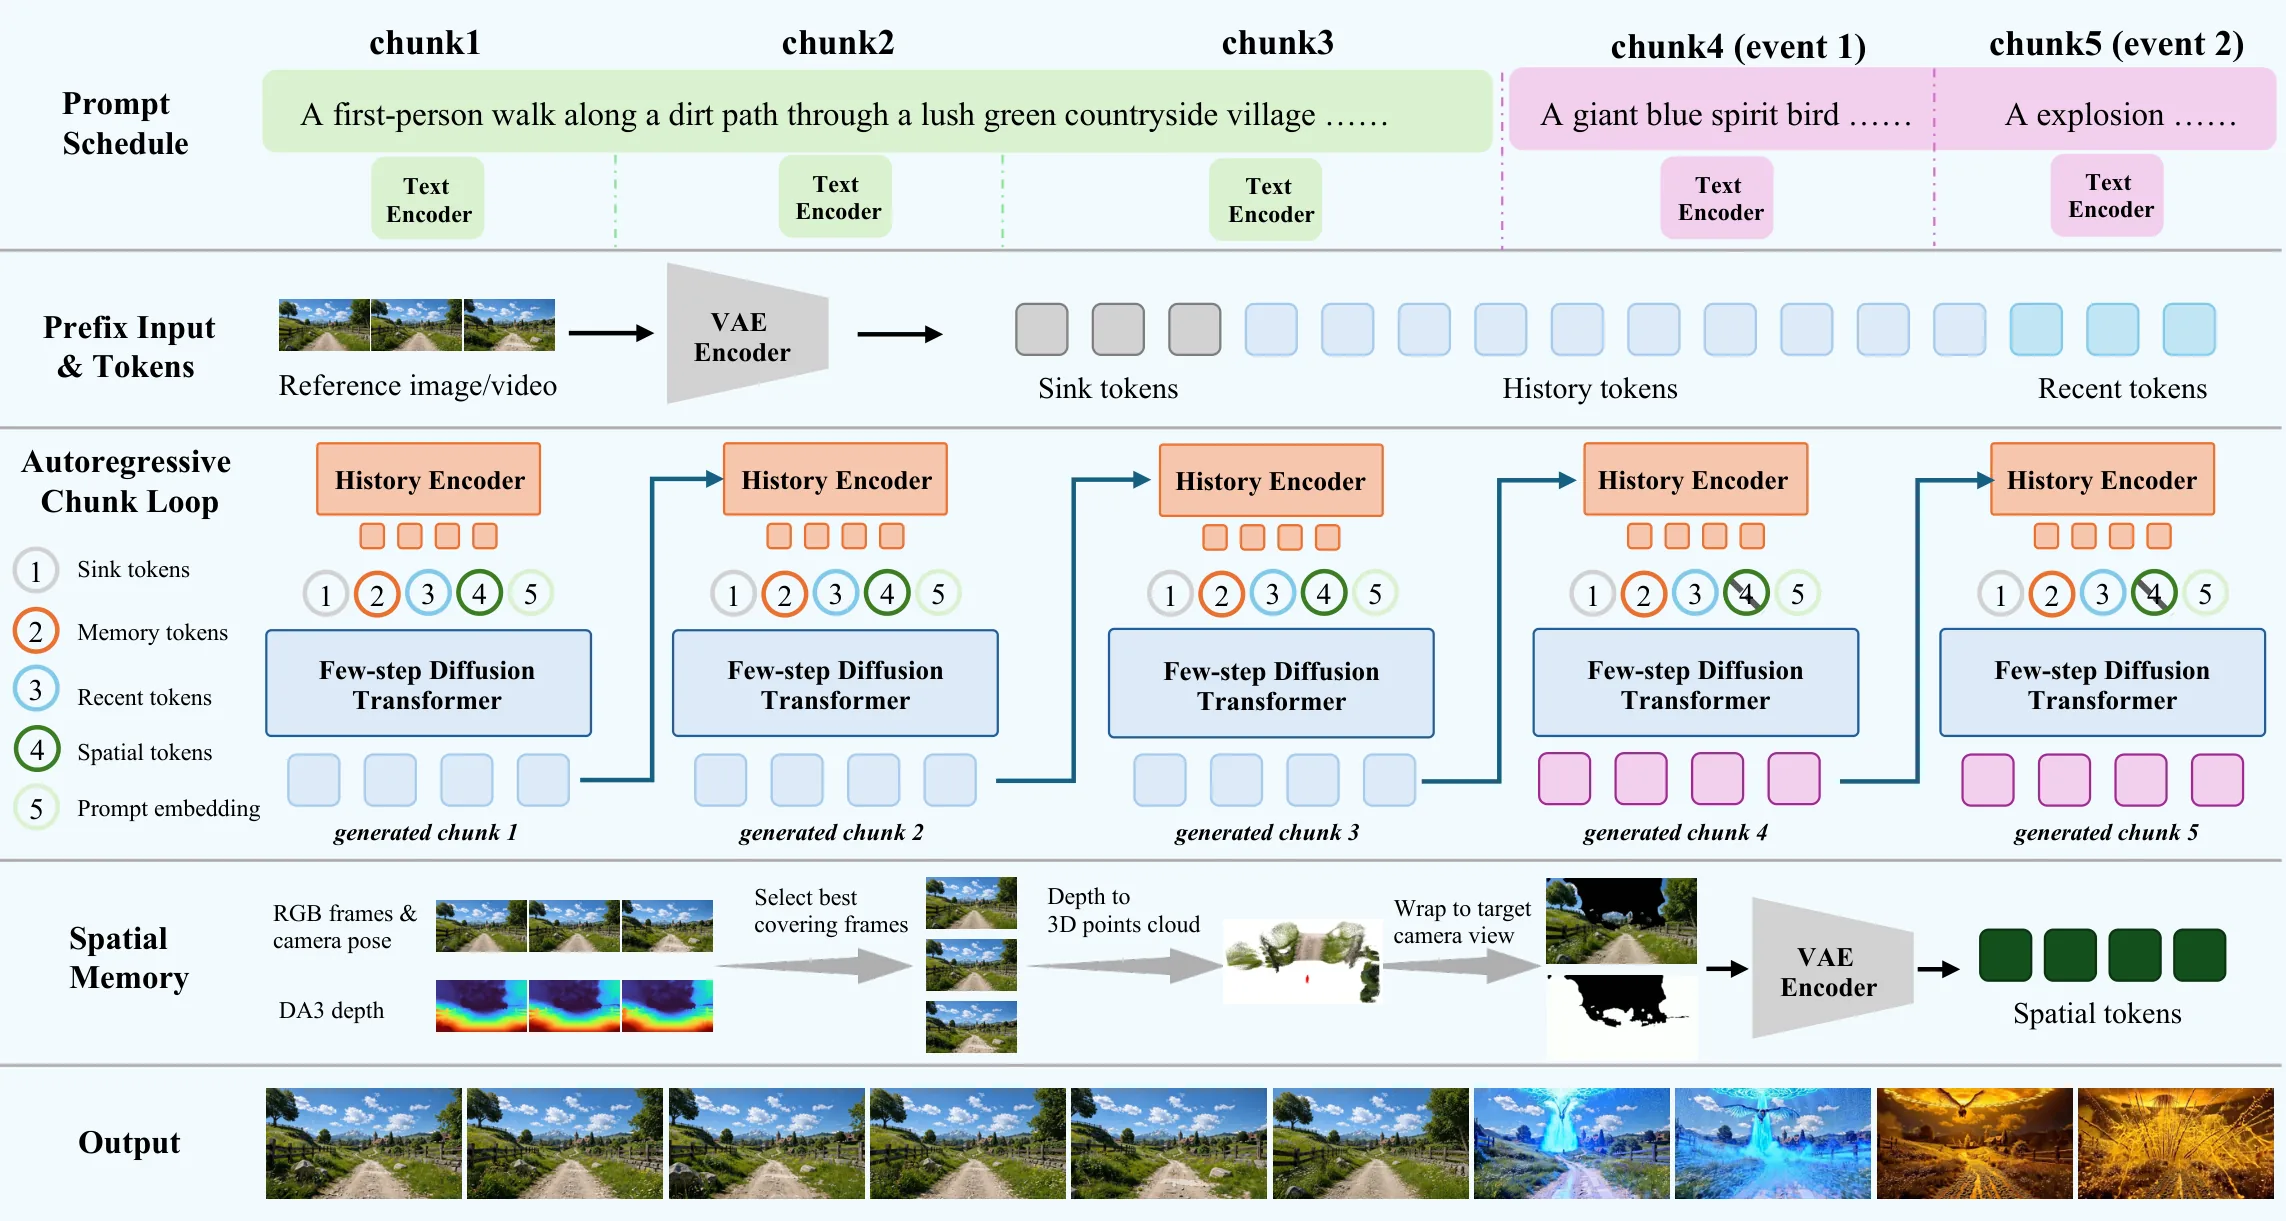
AlayaWorld 的核心架构是一个 15B 参数的视频扩散 Transformer(Video DiT),采用自回归方式生成短潜变量片段(chunks)。论文的关键创新首先体现在其有界视觉上下文(Bounded Visual Context)设计上。
传统自回归视频生成模型通常将所有历史帧作为上下文输入,但这种方法存在两个严重问题:一是显存与计算量随时间线性增长,很快就会超出硬件限制;二是误差会随时间累积,早期的微小偏差会在后续生成中被不断放大,导致长期漂移(long-term drift)。AlayaWorld 提出的有界视觉上下文通过四种机制的协同来解决这些问题:
持久 sink 帧(Persistent Sink Frame) 作为全局锚点,维持整个生成过程的视觉参照系,类似于传统 SLAM 系统中的回环检测机制,但以一种可学习的方式实现。压缩的时间历史(Compressed Temporal History) 将过去数十帧的信息压缩为低维表示,大幅降低上下文长度的增长速度。几何对齐的空间记忆(Geometry-Aligned Spatial Memory) 则将 3D 几何信息显式编码到记忆机制中,使模型在处理相机运动时能够保持场景结构的稳定性——当相机旋转或平移时,场景中的物体不会因此产生畸变。近期帧条件约束(Recent-Frame Conditioning) 则利用最后几帧的高分辨率原始信息作为局部约束,确保生成内容在短期内的视觉保真度。
这四种机制的组合使得视觉上下文在时间维度上有界(bounded)而非无限增长,同时又能同时捕获全局一致性、几何稳定性与局部细节。
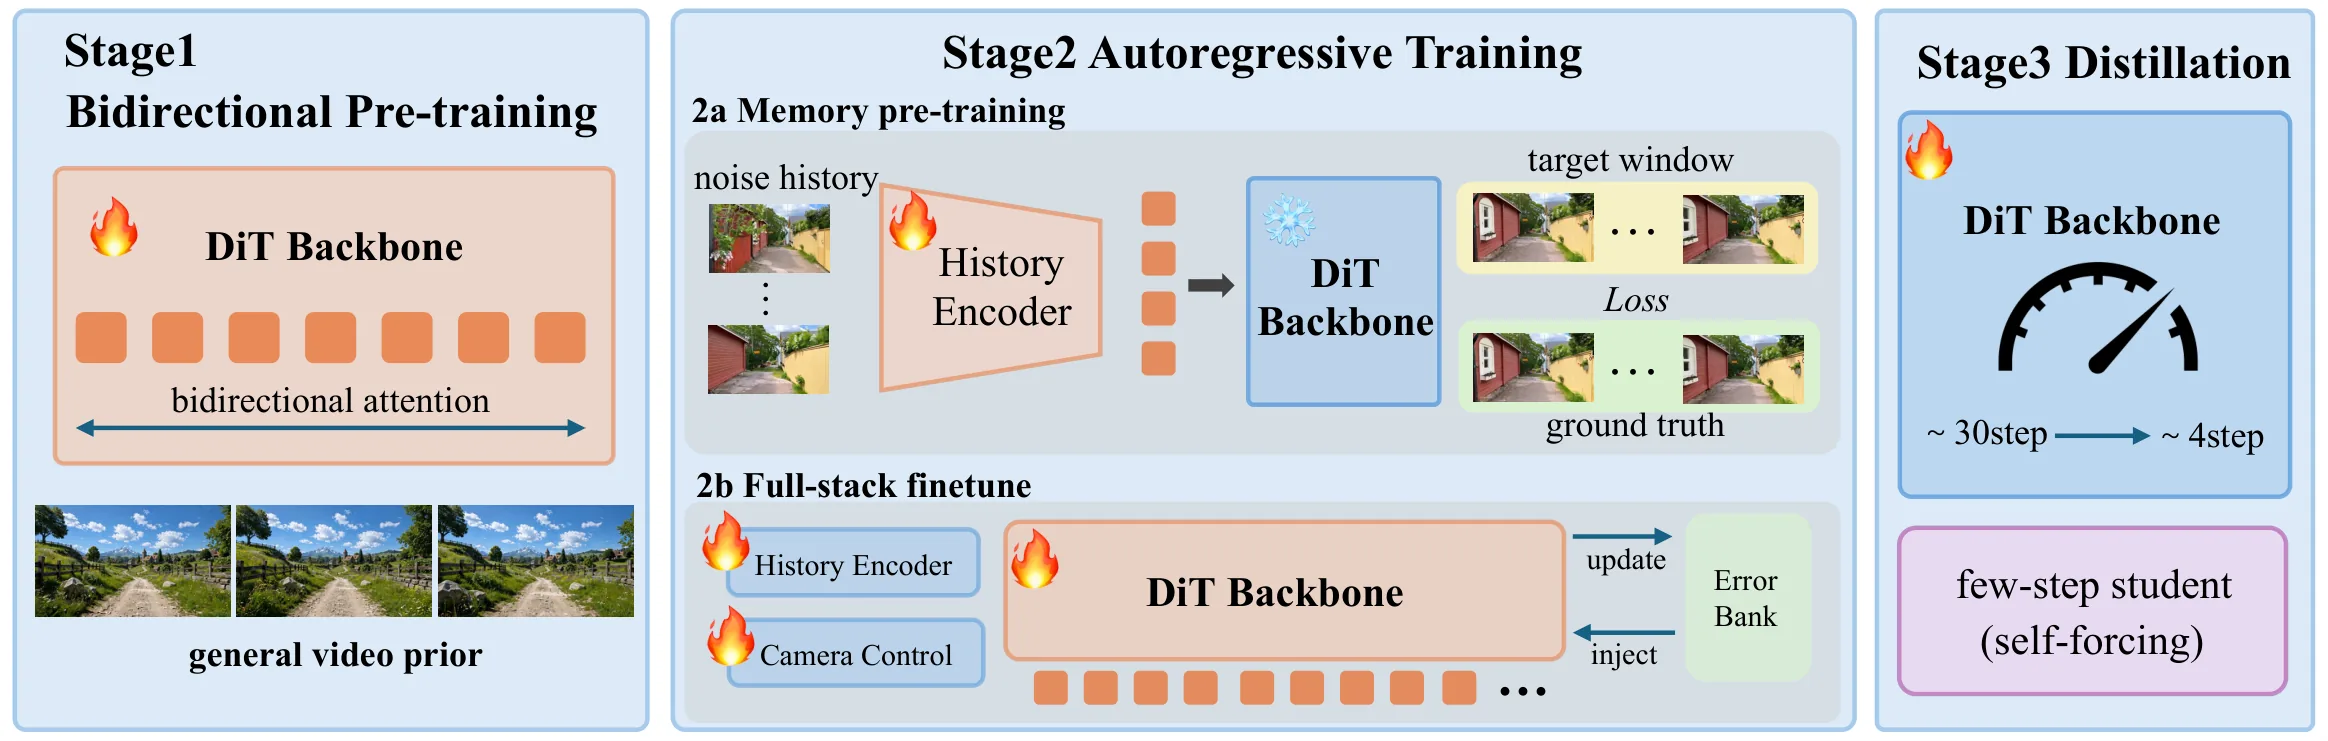
在训练策略上,AlayaWorld 为解决长期漂移问题采用了双路损坏机制。第一路是历史帧损坏(corrupted history)——在训练时随机将部分历史帧替换为损坏版本,强制模型学会在信息不完整时也能保持一致。第二路是预测残差收集(prediction residual collection)——从模型自身的 rollout 中采样失败案例,将这些预测偏差作为额外训练信号,让模型学会"自我纠错"。这两种机制的结合显著增强了模型在长序列生成中的鲁棒性。
推理效率是交互性的关键瓶颈。直接用扩散模型生成视频通常需要数十甚至数百个采样步骤,这在实时场景下是不可接受的。AlayaWorld 提出的离散自回归蒸馏(Discrete Autoregressive Distillation) 将三种互补的蒸馏技术统一到一个框架中:分布匹配蒸馏(Distribution Matching Distillation, DMD) 负责在离散 token 空间中进行分布对齐;self-forcing++ 利用模型自身的预测作为下一步的条件输入,形成自监督的训练信号;一致性蒸馏(Consistency Distillation) 则确保同一序列的不同采样路径最终收敛到一致的结果。三者的融合使得每块的推理步数从约 30 步压缩至 4 步,而输出质量几乎没有明显下降。
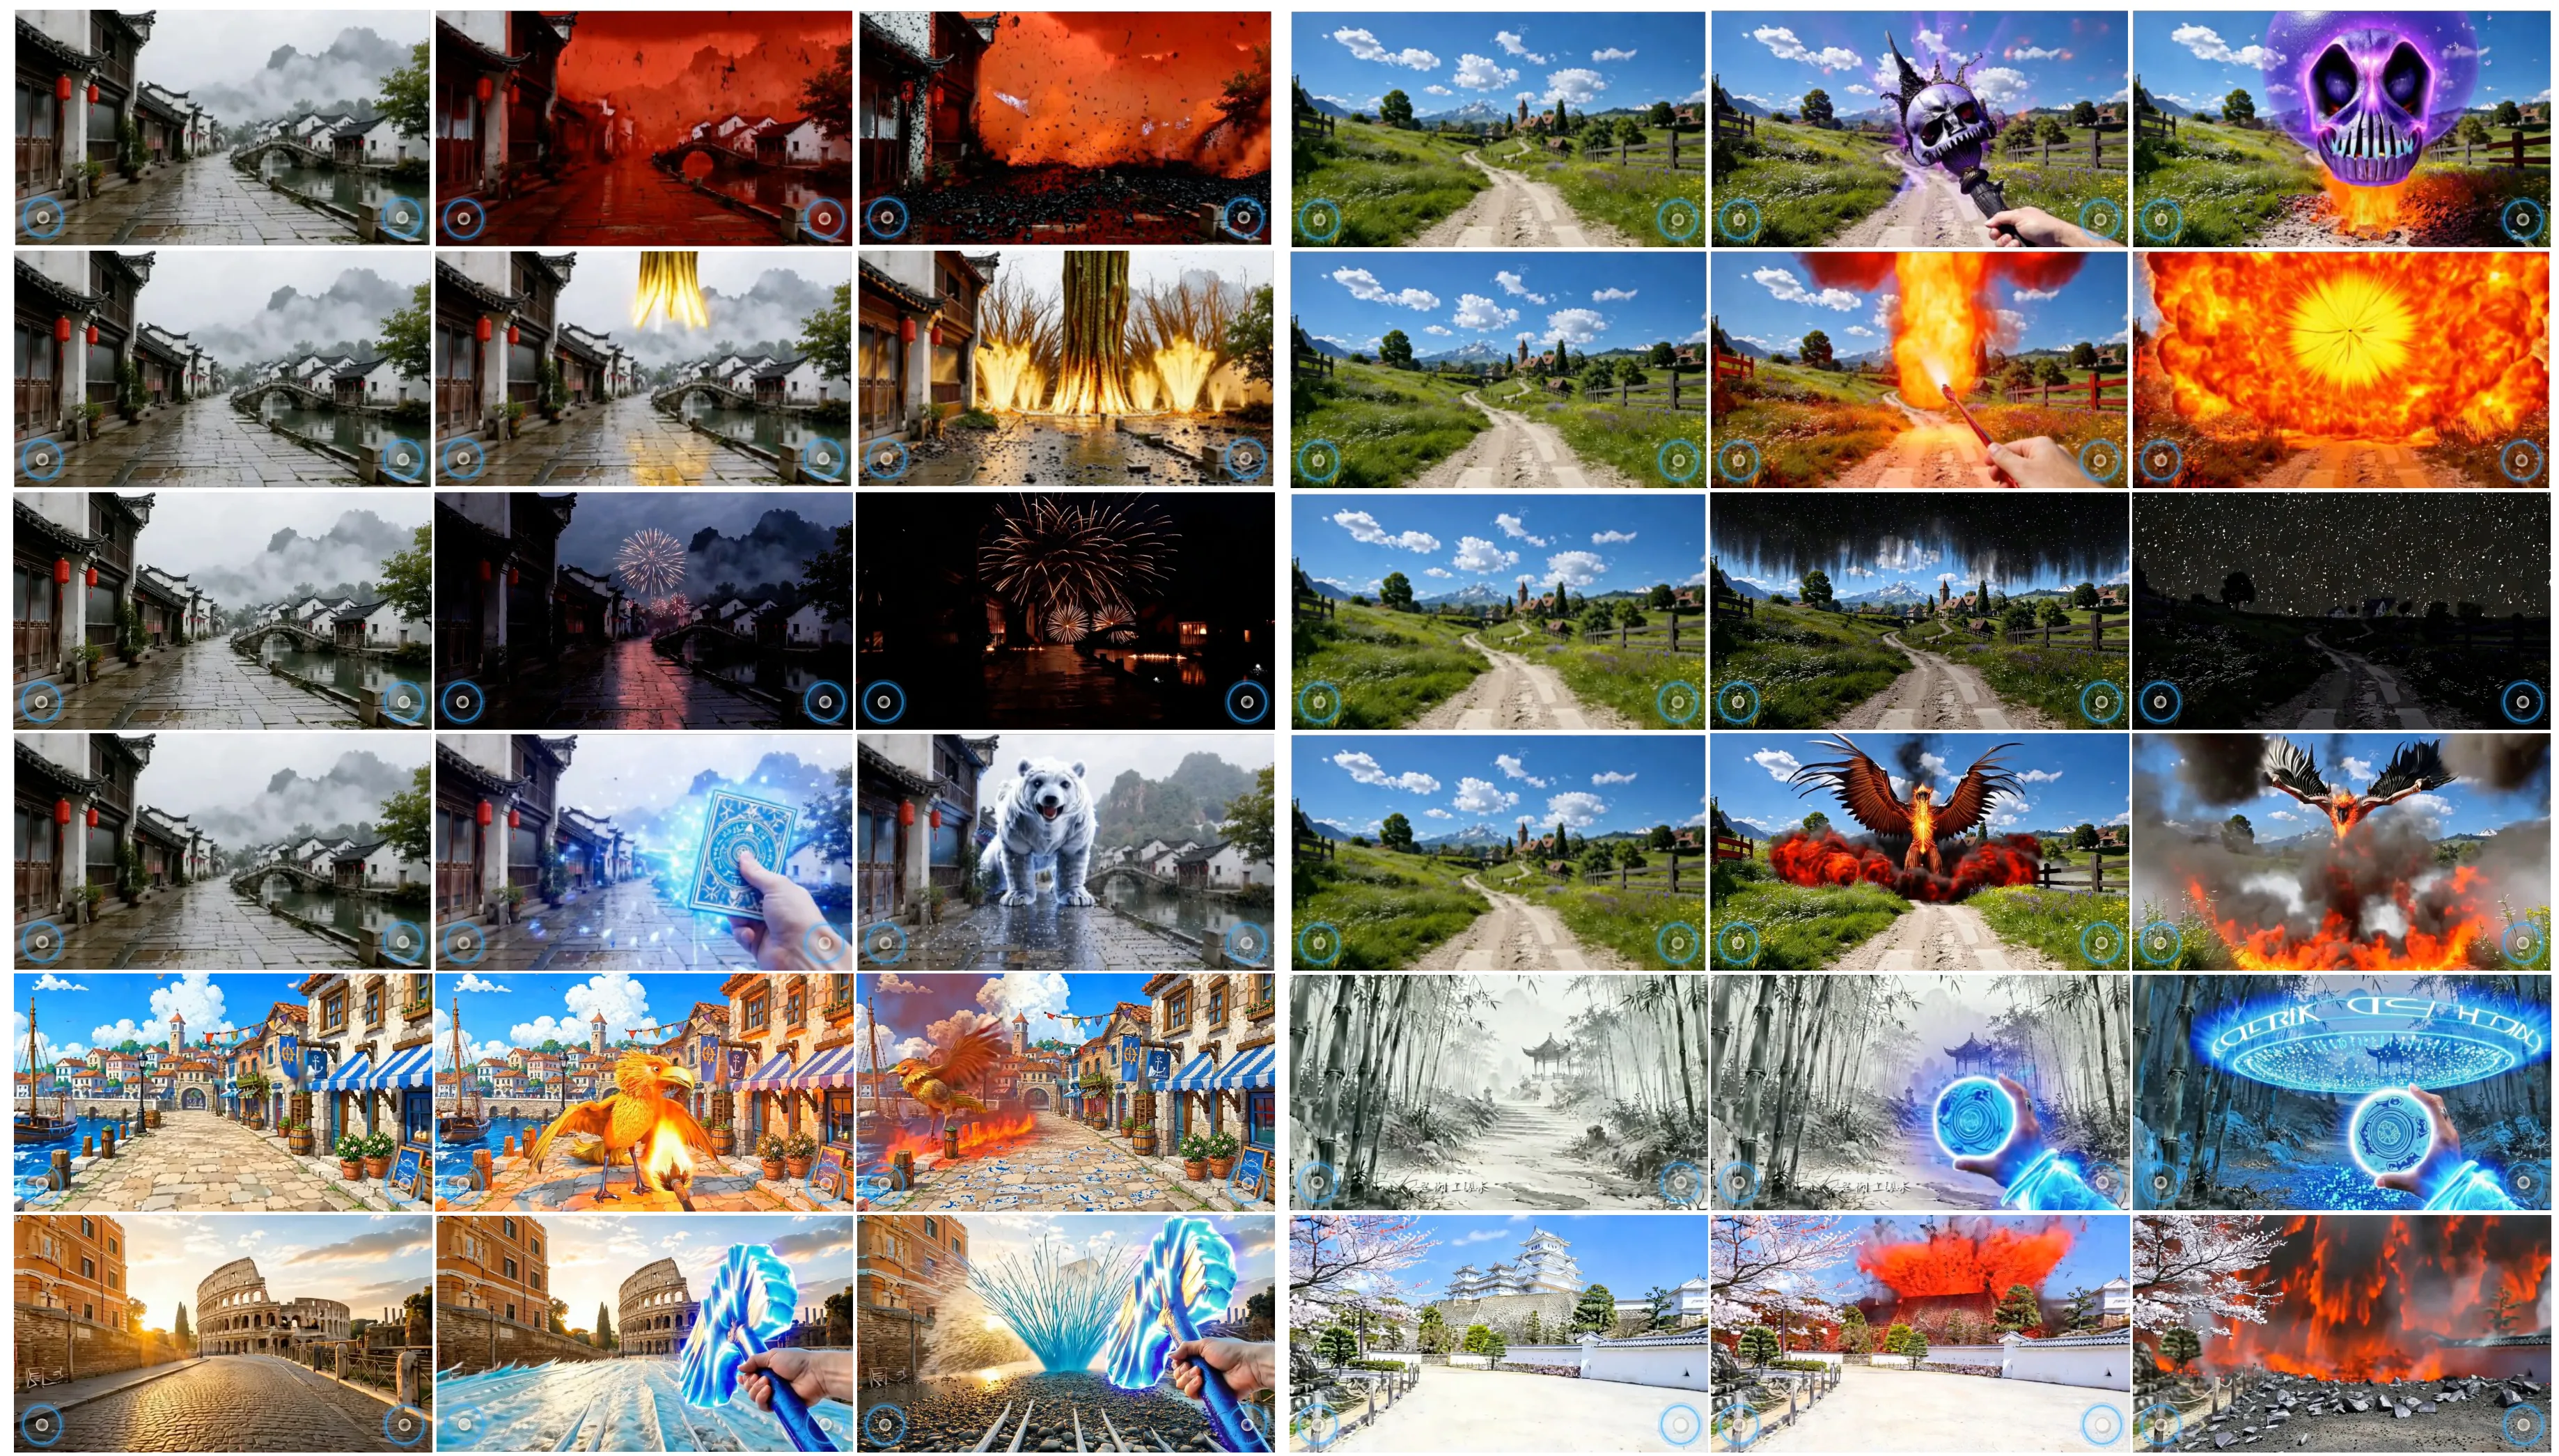
最终系统支持的生成规格为 24fps 的 540p 或 720p 视频,支持相机轨迹控制(用户可以指定相机的旋转角度与移动路径)以及可切换的文本提示(用户可以在生成过程中随时改变对场景的描述)。
实验与结果
论文在 iWorld-Bench 上进行了系统性的评测。iWorld-Bench 是一个专门为交互式世界模型设计的长时序生成 benchmark,涵盖了多种场景复杂度与交互模式的测试任务。
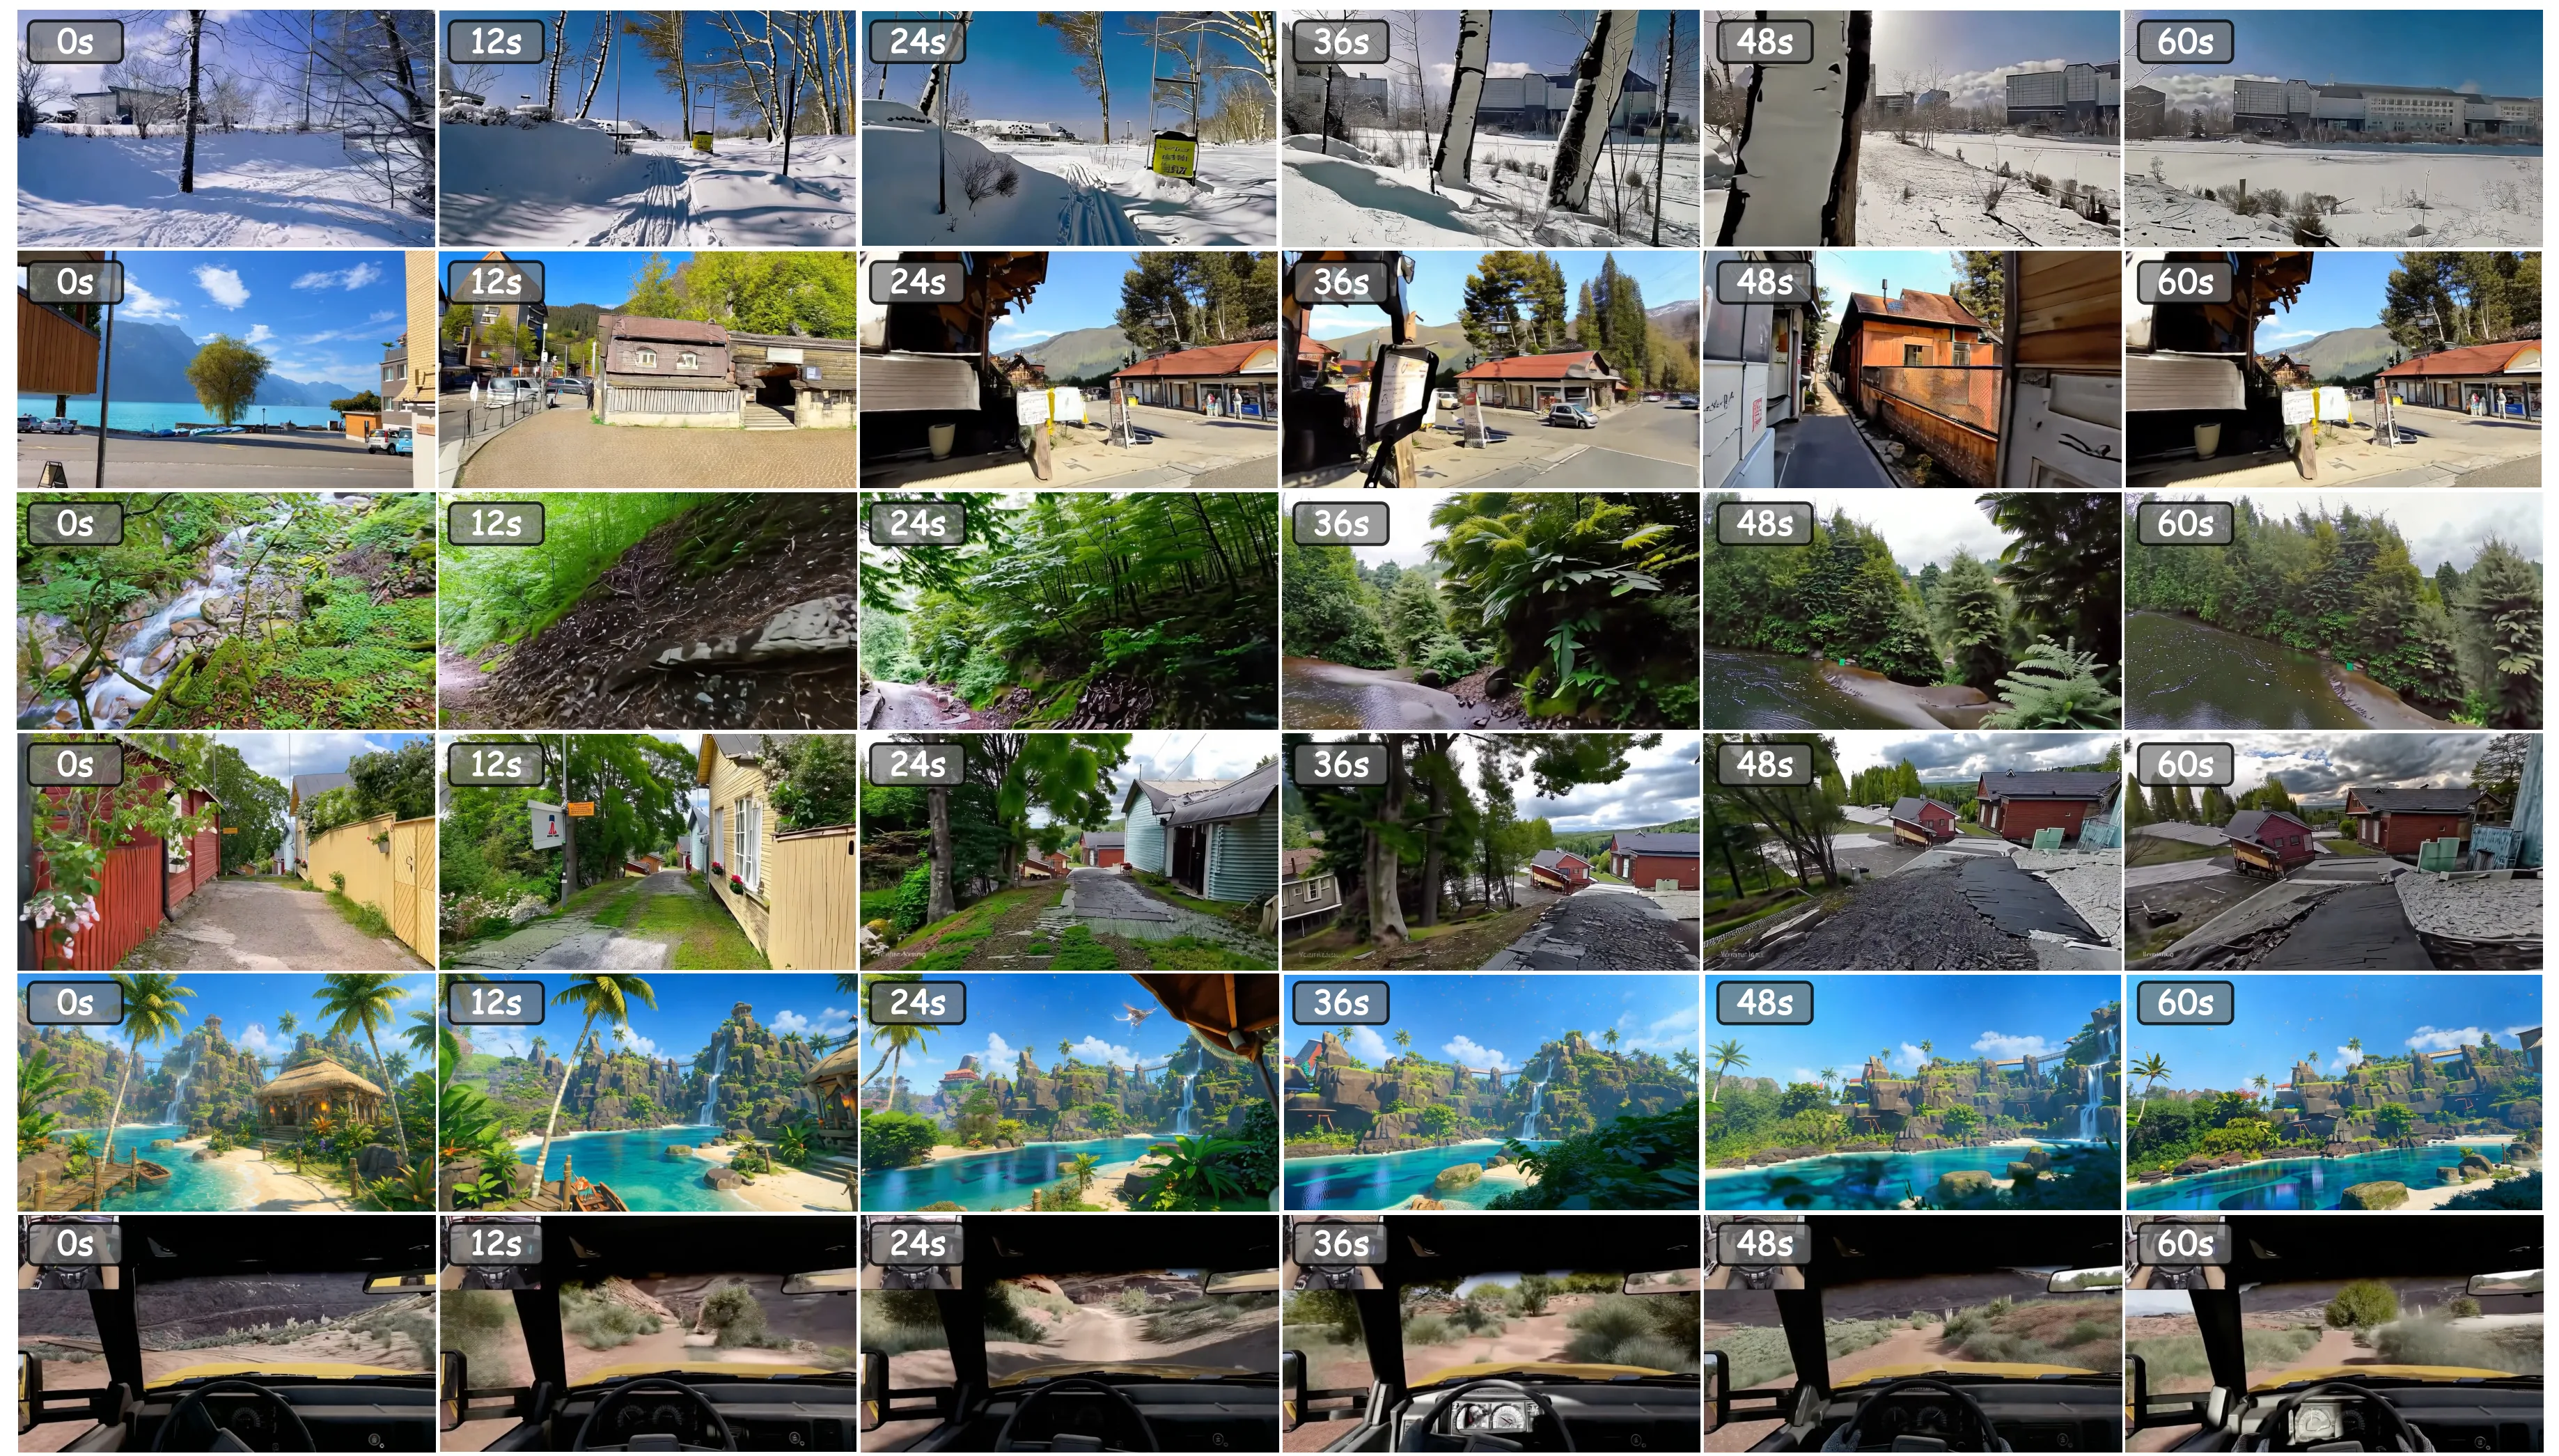
在长视野生成的核心指标上,AlayaWorld 取得了最佳成绩。与此前的方法相比,其生成的视频在时空一致性指标上提升显著——这得益于有界视觉上下文中的几何对齐空间记忆机制,使得相机运动时场景结构保持稳定;在文本-视频对齐指标上也有明显改善,说明压缩时序历史在保留语义信息方面表现良好。
消融实验验证了各个模块的贡献。移除 sink 帧机制后,长期一致性出现明显下降;移除几何对齐记忆后,相机运动场景中的物体畸变显著增加;仅用 4 步蒸馏(而非完整训练)的版本虽然效率更高,但在细节纹理上仍有可见差距——这说明三种蒸馏技术的融合是必要的,单一技术无法完全弥补加速带来的质量损失。
在交互响应延迟方面,4 步推理使得系统能够在消费级 GPU 上实现亚秒级的生成延迟,为实时交互提供了可行性基础。720p 生成的延迟略高于 540p,但仍在可接受范围内。
讨论与可借鉴点
AlayaWorld 的局限首先体现在推理步数的进一步压缩上——4 步已经是相当激进的加速,如果追求更极致的实时体验(如 AR/VR 中的 90fps 生成),仍需要算法层面的突破或硬件加速的配合。其次,论文主要验证了在相机轨迹与文本切换场景下的交互能力,对于更复杂的物理交互(如物体碰撞、液体流动)的支持尚未充分探索。
从更宏观的视角看,AlayaWorld 的设计思路对整个视频生成领域都有借鉴价值。其有界视觉上下文的分层设计(全局锚点 + 压缩历史 + 几何记忆 + 局部细节)提供了一种处理长序列一致性的通用框架,可以迁移到其他需要长期记忆的任务中。而离散自回归蒸馏的三合一策略则展示了一种将多种蒸馏目标统一训练的可行路径,避免了逐一调优的繁琐工程。
作为"全栈开源长期项目",AlayaWorld 的意义不仅在于提供一个可用的基线模型,更在于为整个交互式视频世界模型的研究社区提供一个可扩展的基础设施。其架构设计允许后续研究者替换或增强各个组件——比如用更大规模的基础模型、用不同的压缩策略管理历史信息、或探索更高效的蒸馏目标——从而推动这一方向持续演进。
摘要
与依赖劳动密集型管线进行资产生成、动画、物理和编程的传统电子游戏开发不同,视频世界模型能够根据用户输入即时生成交互式环境。它使我们能够从文本、图像或视频创建可定制、可探索、持续演化的虚拟世界。实现这一愿景需要四项紧密耦合的能力:交互性、持久的时空一致性、稳定的长视野生成以及高效响应。我们提出了 AlayaWorld,这是一个交互式长视野视频世界模型,能够以 24 fps 生成 540p 和 720p 的视频。AlayaWorld 基于一个 15B 的视频扩散 Transformer 构建,在相机轨迹和可切换文本提示下自回归地生成短潜变量片段。其有界视觉上下文结合了持久汇帧、压缩的时间历史、与几何对齐的空间记忆以及近期帧条件。为了减少长期漂移,模型使用被损坏的历史以及从自身推演中收集的预测残差进行训练。我们进一步引入了一种结合分布匹配蒸馏、self-forcing++ 与一致性蒸馏的离散自回归蒸馏方案,将每个片段的推理从约 30 个采样步骤减少到 4 个步骤。在 iWorld-Bench 上,AlayaWorld 在长视野生成方面取得了最佳性能。AlayaWorld 作为一个全栈、开源、长期项目,旨在为未来交互式视频世界模型的研究提供一个可扩展的基础。
Abstract
Unlike conventional video game development, which relies on labor-intensive pipelines for asset production, animation, physics, and programming, video world models generate interactive environments from user inputs instantly. It enable us to create customized, explorable, and continuously evolving virtual world from text, an image, or video. Realizing this vision requires four tightly coupled capabilities: interaction, persistent spatiotemporal consistency, stable long-horizon generation, and efficient response. We present AlayaWorld, an interactive long-horizon video world model that generates 24-fps video at 540p and 720p. Built on a 15B video diffusion transformer, AlayaWorld generates short latent chunks autoregressively under camera trajectories and switchable text prompts. Its bounded visual context combines a persistent sink frame, compressed temporal history, geometry-aligned spatial memory, and recent-frame conditioning. To reduce long-term drift, the model is trained with corrupted histories and prediction residuals collected from its own roll-outs. We further introduce a discrete autoregressive distillation formulation that combines distribution-matching distillation, self-forcing++, and consistency distillation, reducing inference from approximately 30 sampling steps to four steps per chunk. On iWorld-Bench, AlayaWorld achieves the best performance over long-horizon generation. Conceived as a full-stack, open-source, and long-term project, AlayaWorld is intended to provide an extensible foundation for future research on interactive video world models.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。