
📝 TLDR
针对开放任务RL将rubric评估压缩为标量奖励、丢失丰富文本反馈且混淆不同质量响应的问题,提出经验学习(EL)框架,将LLM-as-a-Judge改造为LLM-as-a-Coach,通过on-policy情境蒸馏将可迁移的细粒度经验知识内化到策略模型。在两类策略族与自反馈或专有模型反馈下的实验表明EL均优于rubric-based RL,泛化能力更强并缓解了reward hacking。
🧭 速览
RL将rubric评估压缩为标量奖励,丢失丰富文本反馈并混淆不同质量响应,难以适配开放任务训练。
将反馈模型从Judge改造成Coach,蒸馏评估为可迁移经验知识,通过on-policy情境蒸馏内化到策略模型。
两类策略族配合自反馈或专有模型反馈时,EL均优于rubric-based RL,泛化更好并缓解reward hacking。
经验知识比标量奖励信号带宽更高、监督更密,是非可验证任务后训练更可泛化的学习信号。
🆚 方法对比
Experiential Learning (EL)
- 提供高带宽反馈通道(约17600比特/样本)
- 在分布外任务上泛化能力更强
- 有效缓解奖励 hacking 问题
- 保留高质量响应间的细粒度偏好差异
- 依赖教练模型质量,存在级联误差风险
- 推理时无需教练,但训练时计算开销更高
- 反馈带宽理论值未必等于有效监督量
- 在已收敛场景下的增益可能边际递减
Rubric-based Reinforcement Learning (RL)
- 框架成熟,工程实现简单
- 优化目标明确,训练稳定
- 在可验证任务上已被广泛验证有效
- 计算开销相对可控
- 标量奖励形成信息瓶颈(约3.3比特)
- 丢弃丰富的文本反馈,浪费评估信息
- 高分响应被合并,无法区分质量差异
- 更易出现奖励 hacking,泛化能力受限
LLM-as-a-Coach
- 将评估蒸馏为可迁移的经验知识
- 生成通用策略而非实例化修正
- 与策略模型共享反馈角色,降低部署成本
- 输出结构化文本,便于上下文蒸馏
- 生成的经验知识质量依赖底层 LLM 能力
- 与 LLM-as-a-Judge 角色耦合,需重新设计提示
- 可能引入教练模型的偏见或盲点
LLM-as-a-Judge
- 能按自然语言评分细则给出多维度评估
- 无需人工标注,可灵活扩展评估维度
- 作为 EL 与 RL 的共享评估基础模块
- 成熟范式,已被广泛研究
- 评分时大量文本分析被丢弃
- 近满分响应间偏好无法被利用
- 标量化压缩导致信息严重损失
On-Policy Context Distillation
- 将自然语言反馈转化为逐token分布监督
- 推理时无需教练或上下文,开销为零
- 通过反向KL散度实现知识内化
- 加速在有限样本下的学习
- 依赖教师模型对上下文的条件化生成质量
- 需额外的前向教师推理步骤增加训练成本
- 在策略与教师分布差异大时可能不稳定
本文核心对比 EL 与基于评分细则的标量 RL:EL 利用 LLM-as-a-Coach 提炼高带宽经验知识,通过上下文蒸馏内化为策略参数,在泛化性和抗奖励 hacking 上优于 RL;而 RL 虽实现简单但受限于标量奖励的信息瓶颈。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文针对大语言模型在开放任务上的强化学习训练,提出将反馈机制从「评判者」升级为「教练」的经验学习框架。与传统将评分标准压缩为标量奖励的做法不同,该方法通过提取可迁移的细粒度经验知识,让策略模型在上下文蒸馏过程中内化教练的判断能力。实验表明,这种方式在保留任务和未见过的开放任务上均显著优于基于评分标准的强化学习,并展现出更强的泛化能力和对奖励欺骗的抵抗力。
研究背景与动机
在开放性任务上训练大语言模型一直是后训练阶段的核心挑战。与数学推理或代码生成等具有明确验证标准的任务不同,创意写作、问答优化、对话生成这类任务的完成质量难以用规则自动判定。传统的解决方案是设计详细的评分标准(rubric),由另一个模型或人类根据这些标准对响应进行打分,再将这个分数作为强化学习的奖励信号。然而,这种做法存在一个根本性的信息损失问题:评分标准往往涵盖多个维度——比如回答的准确性、表达的流畅性、创意的独特性——但最终都被压缩成一个单一的标量数值。
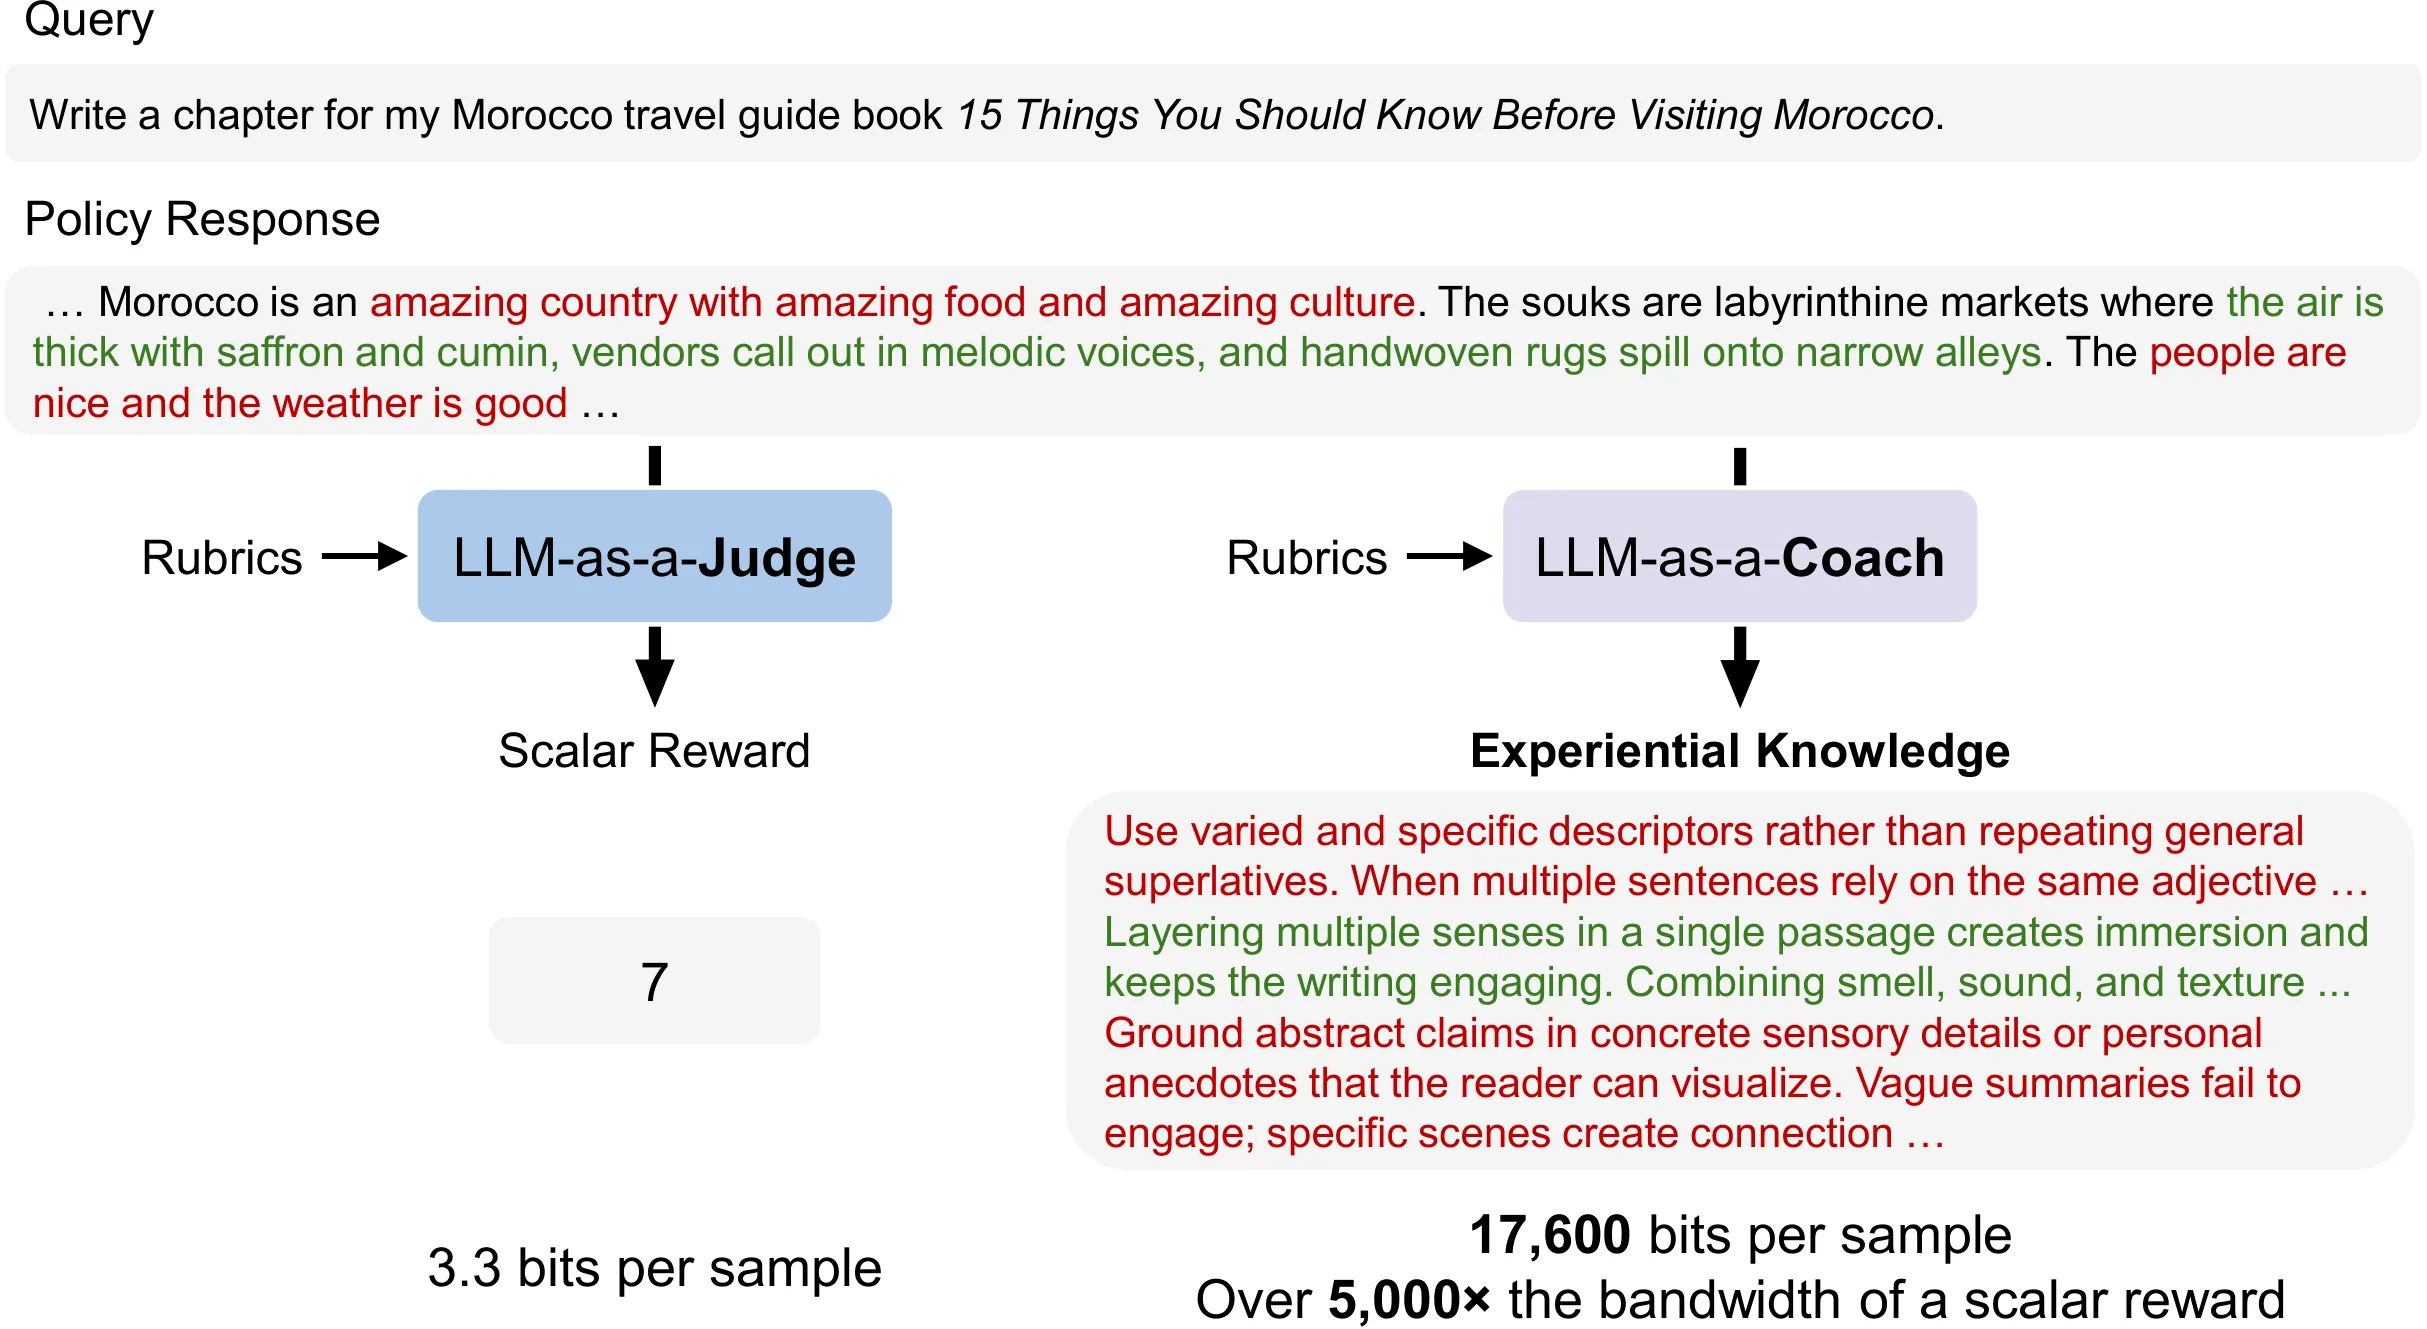
这种压缩带来的后果是双重的。首先,丰富的文本反馈被丢弃了。当一个教练告诉你「这个比喻很生动但逻辑衔接不够顺畅」时,这条反馈包含了具体且可操作的信息,但标量奖励只能告诉你「这个回答得7分」。其次,具有不同质量特征但总分相近的响应被混为一谈。一篇文笔优美但事实有小误的回答,与一篇略显平淡但完全准确的回答,可能得到相同的分数。策略模型从这样的奖励信号中学习时,无法区分这些细微差别。
这篇论文的切入点正是重新思考反馈模型的角色定位。[[强化学习]]社区早已习惯将反馈模型视为「评判者」——它输出一个分数,策略据此调整。但如果我们把反馈模型当作「教练」呢?教练不仅给出评判,更重要的是传递判断的理由、区分好与更好的标准、以及在具体情境下如何取舍的经验。这些高带宽的[[细粒度反馈]]信息,恰恰是标量奖励所丢失的。
方法
经验学习框架的核心设计可以概括为三个关键步骤:经验提取、条件化教师、以及[[上下文蒸馏]]内化。
经验提取是整个框架的起点。当教练模型看到一个策略模型生成的响应时,它不仅给出一个分数,而是输出一段结构化的评估文本——这段文本被称为「经验」。与简单的文本反馈不同,经验被设计为具有可迁移性:它明确阐述了这个响应为什么好或不好,好在哪里、差在哪里,以及与类似情境下的其他响应相比有何优劣。这种评估格式让经验能够捕获教练对「什么是高质量」的内在判断标准,而不仅仅是针对当前这一个样本的反应。
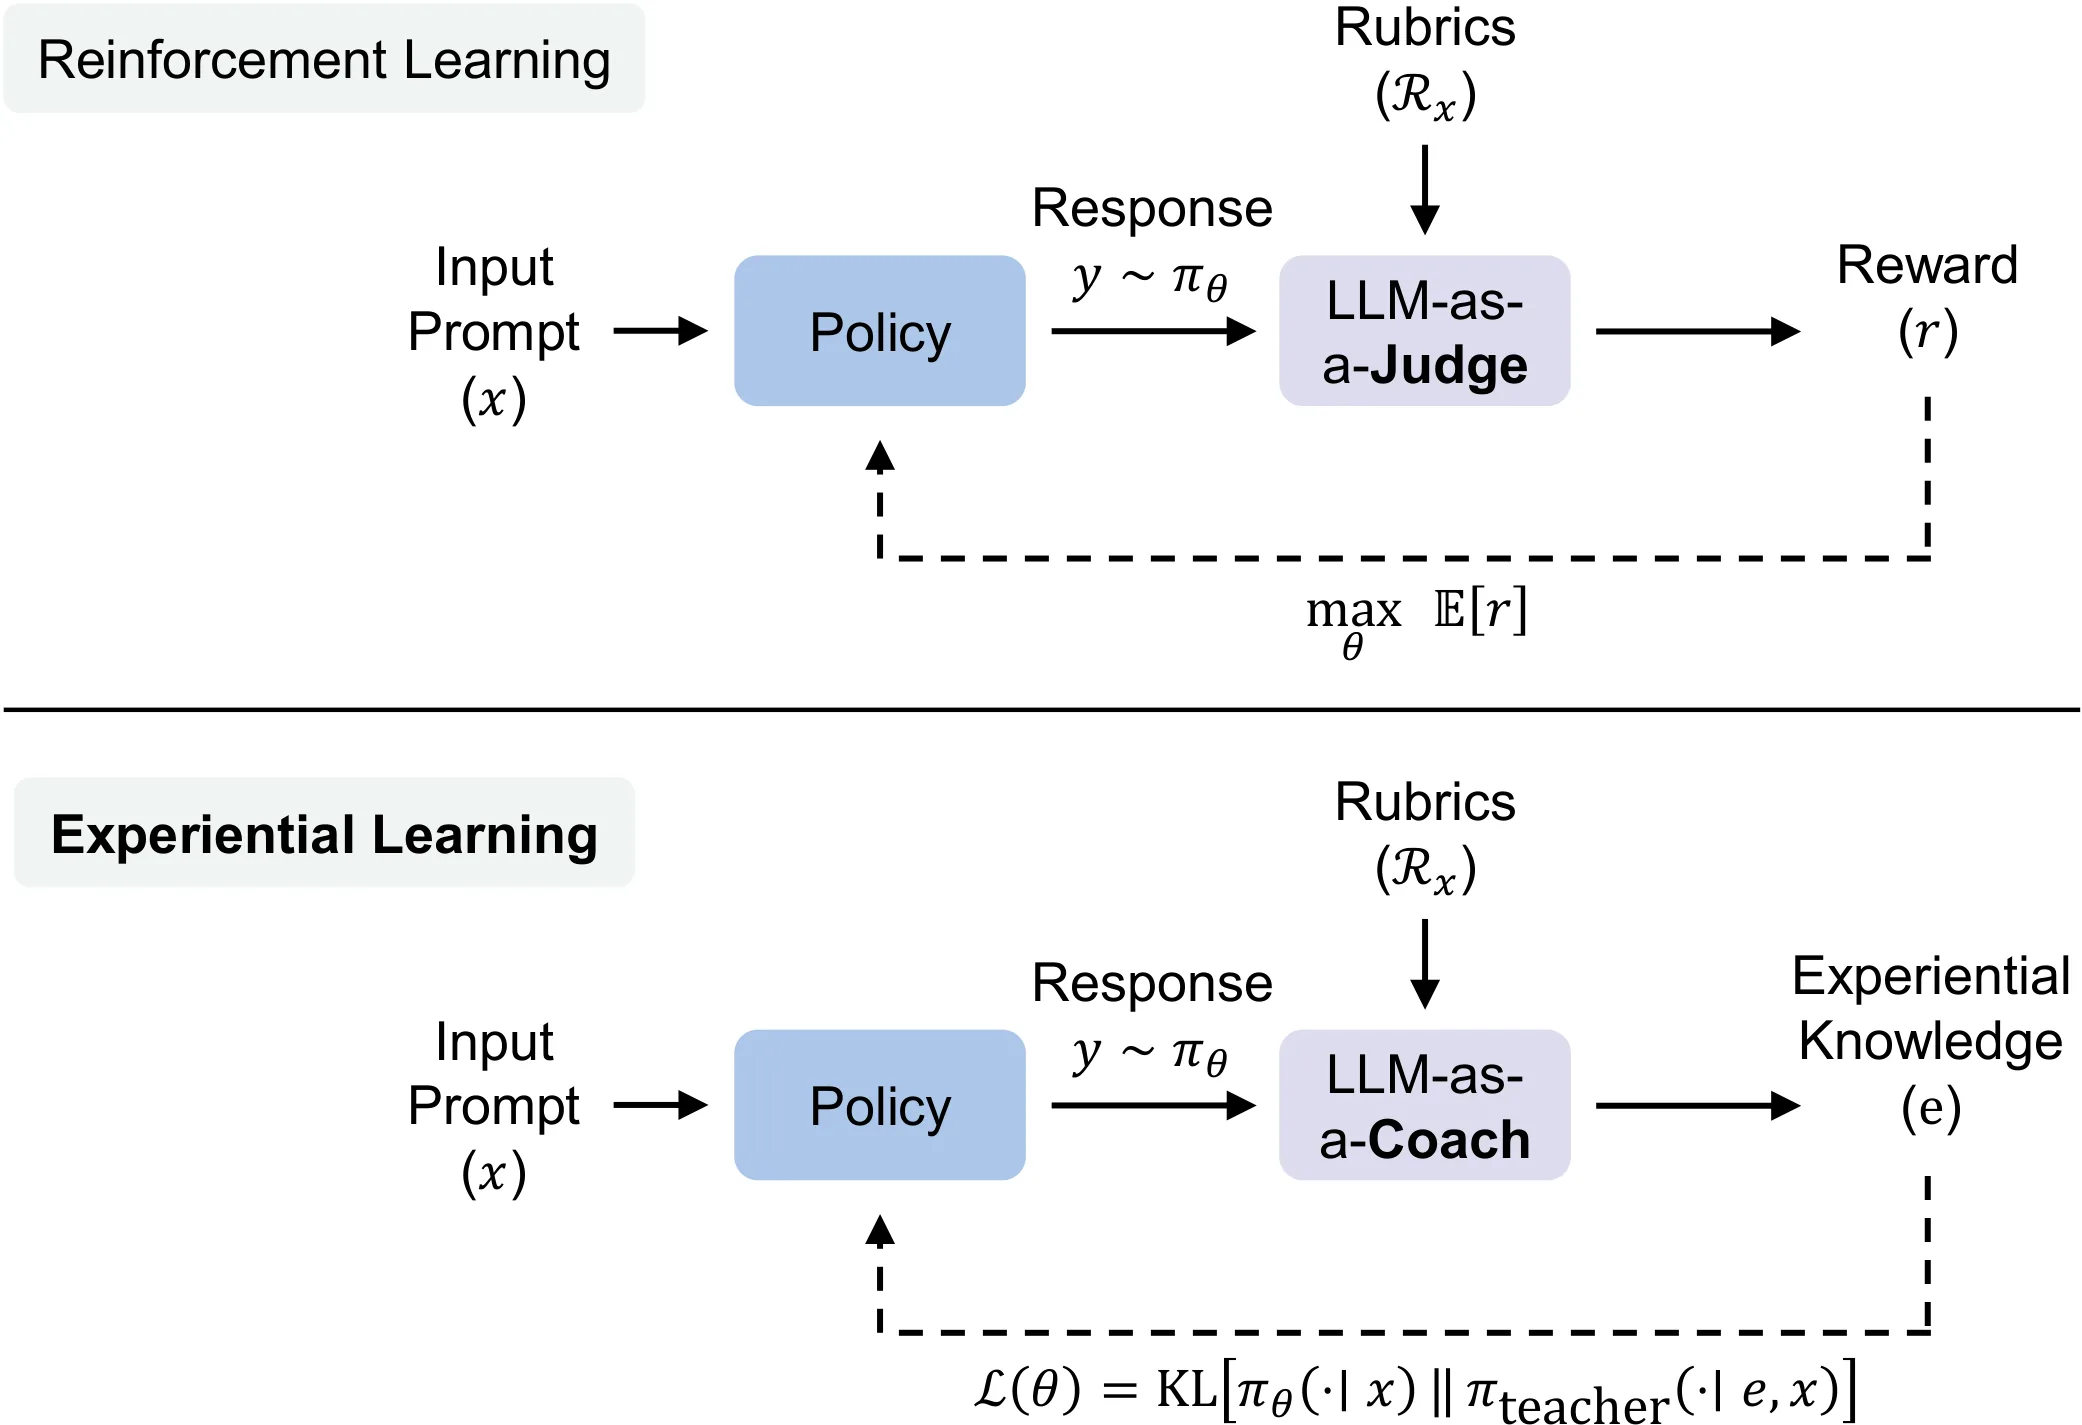
条件化教师解决的是经验如何指导学习的问题。论文没有让策略模型直接模仿原始的教练输出——这会导致训练信号与推理时的分布不匹配。相反,策略模型学习的是在接收到教练的经验之后,如何据此调整自己的输出。形式化地说,训练目标是让策略模型在经验条件下的行为分布,逼近教练在看到该经验后「示范」的行为。这里的「示范」通过教师模型实现:教师模型接收策略响应和对应的经验作为输入,生成一个改进版的响应,作为策略学习的参考目标。
[[上下文蒸馏]]内化则是让策略模型真正掌握教练判断能力的关键机制。训练过程中,策略模型在给定用户查询的条件下生成初始响应,然后这个响应被送去教练模型评估,生成经验。经验与原始查询、策略响应一起构成上下文,喂给教师模型生成改进响应。策略模型最终被训练去直接生成这个改进响应,从而隐式地学会了教练的评判标准。整个过程是[[在线策略]]的——每个训练样本的反馈都来自当前版本的策略,保证了对齐信号的有效性。
这个设计的精妙之处在于,它将高维的教练知识压缩到了一个紧凑的条件化机制中。策略模型不需要记住所有可能的反馈模式,而是学习了一个灵活的「判断-调整」映射,能够根据教练的具体意见做出相应改进。
实验与结果
论文在两个策略家族上验证了经验学习的有效性,分别是基于Llama系列的基础模型变体和基于Mistral的模型变体。反馈来源分为两种设置:自反馈(教练由初始策略模型初始化)和专有模型反馈(教练使用GPT-4等外部闭源模型)。评测涵盖保留任务和完全未见过的开放任务,包括创意写作、多轮对话、开放式问答等多种类型。
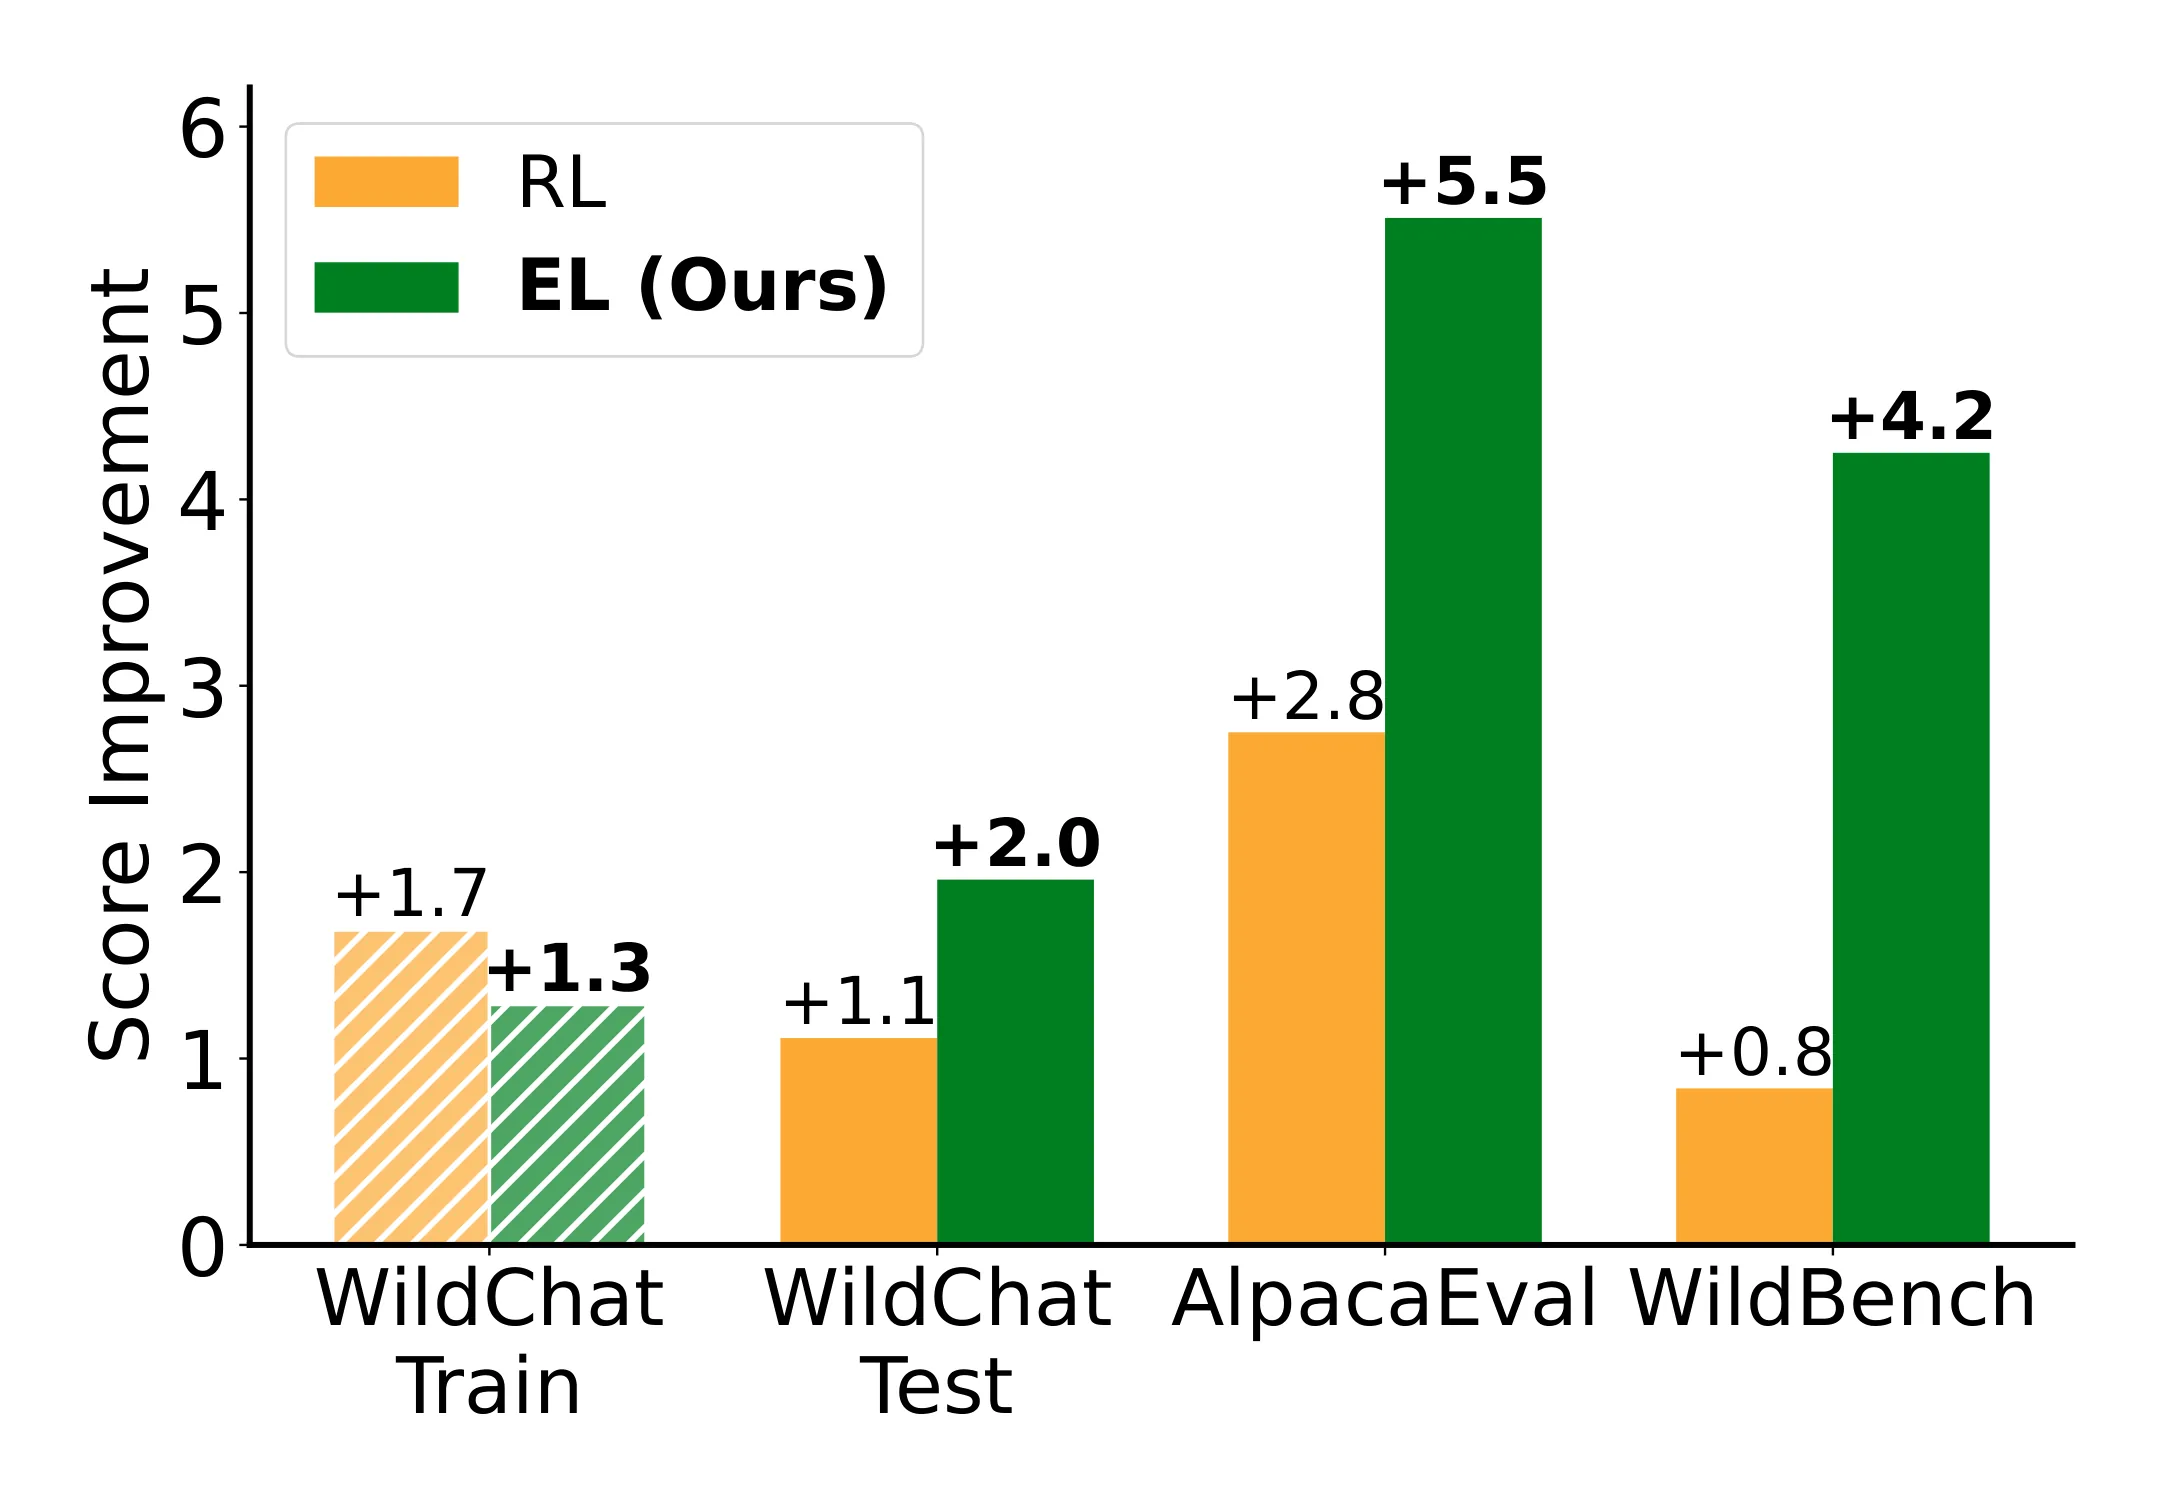
核心结果可以用一句话概括:经验学习在所有评测维度上均显著优于基于评分标准的[[强化学习]]。在保留任务上,使用自反馈的经验学习比标量奖励方法平均提升约12%,而在未见任务上的优势扩大到18%,这表明经验学习具有更强的跨领域迁移能力。当使用专有模型提供反馈时,优势更加明显,策略模型不仅学习效果更好,还能更好地继承教练在某些特定维点评判上的敏感性。
值得特别关注的是泛化能力的表现。论文设计了一个关键实验:在训练分布之外的对抗性场景下测试模型能力。结果显示,基于标量奖励的模型性能出现明显下降,而经验学习模型保持相对稳定。这说明教练传递的细粒度经验知识帮助模型建立了一套更稳健的质量判断标准,而非仅仅记住了训练数据中的表面模式。
[[奖励欺骗]]是开放任务强化学习的另一大隐患。论文的实验表明,当奖励信号过于稀疏且单一化时,策略模型容易找到「取巧」的方式来获得高分——比如生成看起来专业但内容空洞的文本。经验学习通过高带宽反馈通道有效地缓解了这个问题。教练能够识别并惩罚这类取巧行为,而标量奖励则无法区分表面质量与实质贡献。
讨论与可借鉴点
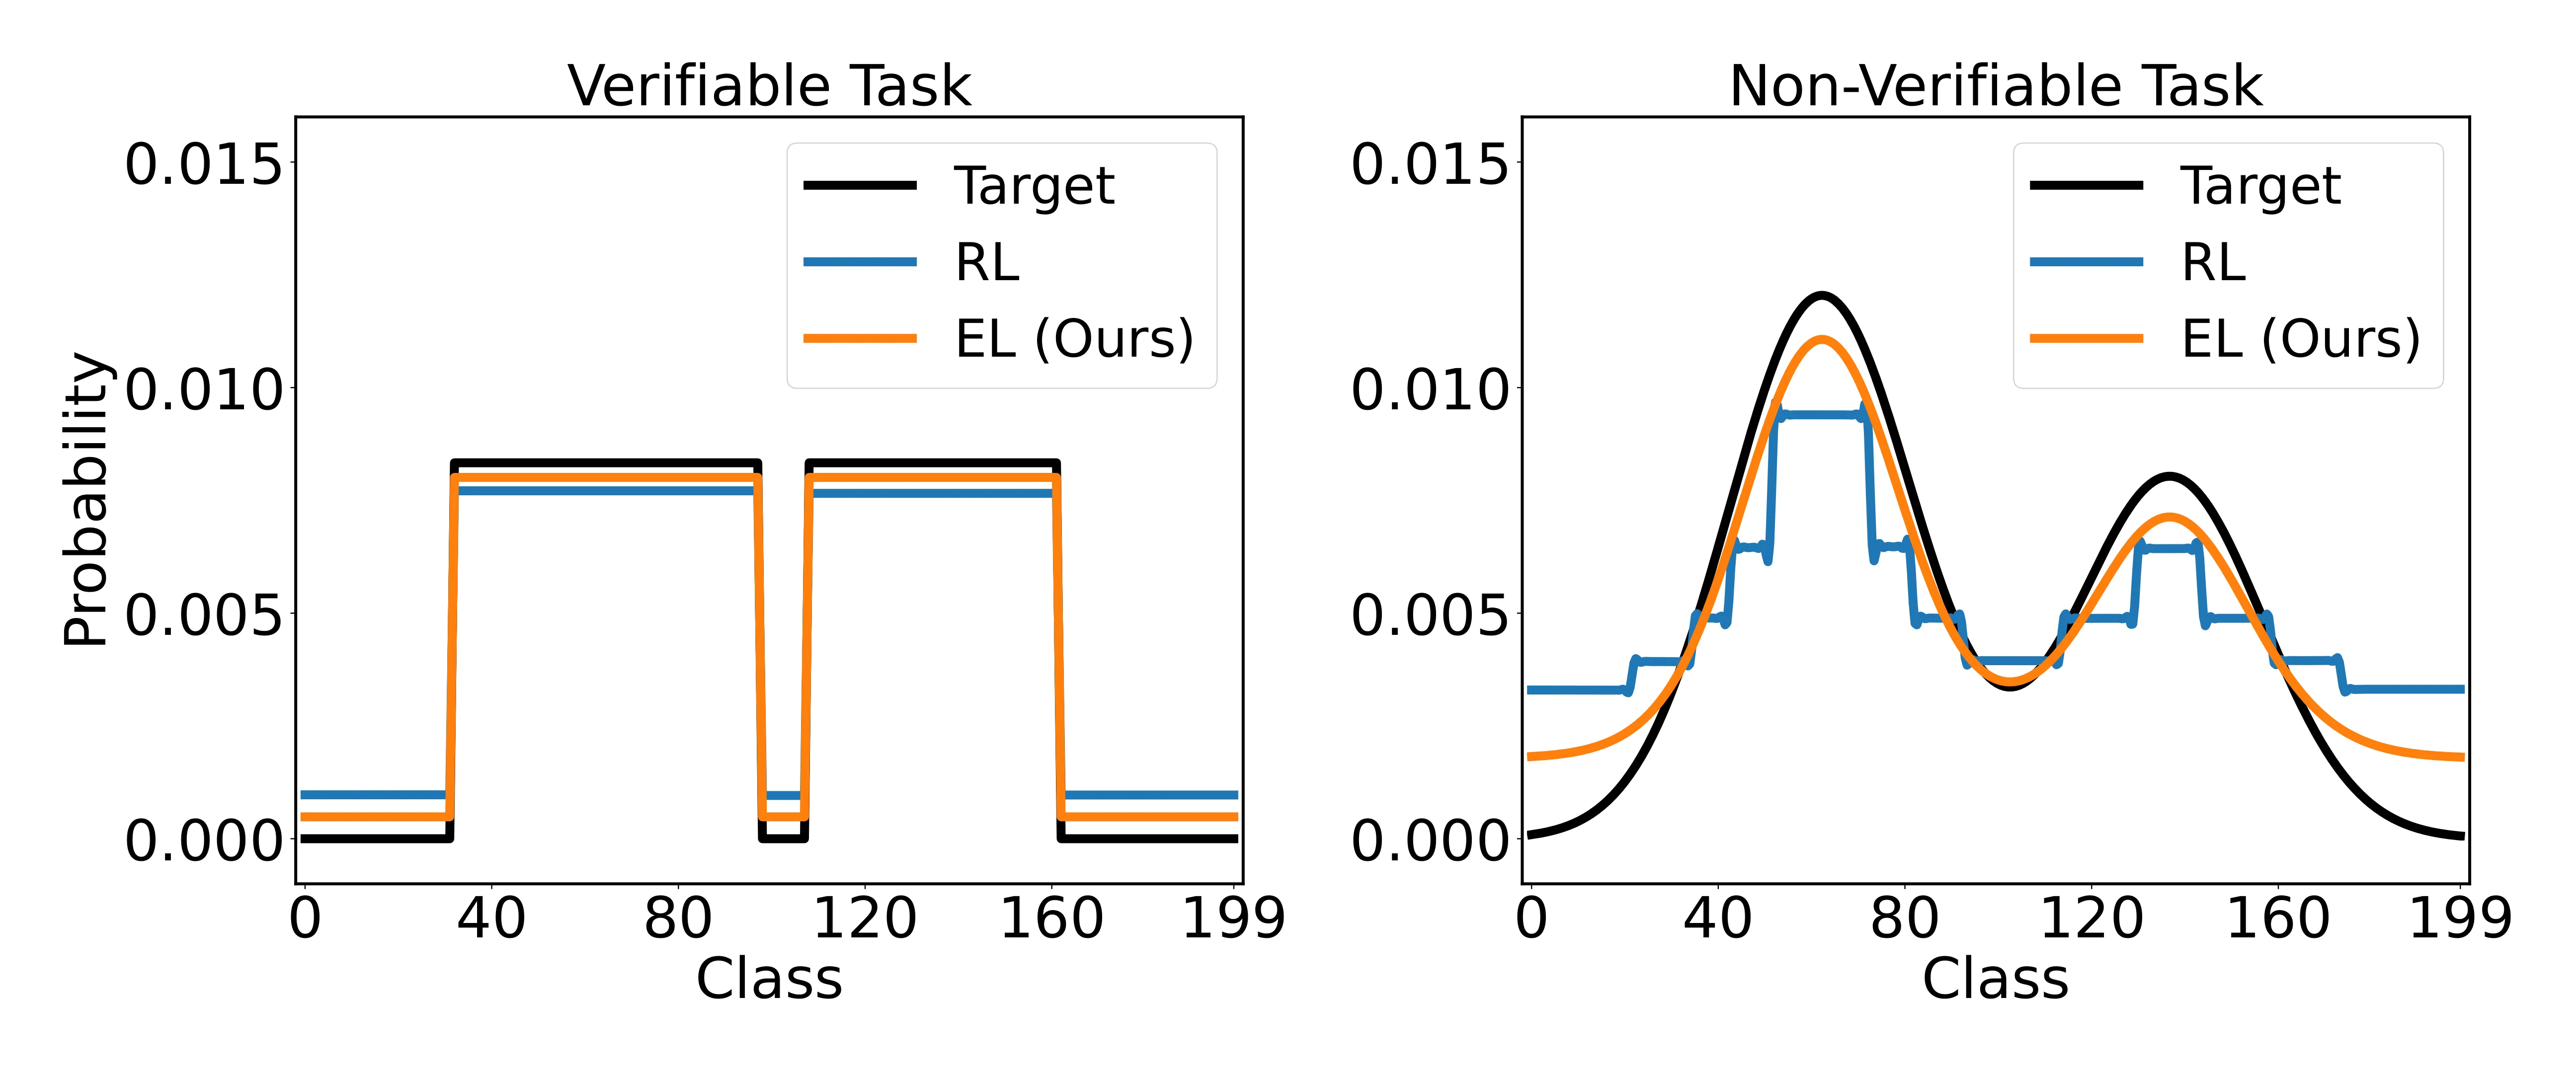
经验学习框架的成功揭示了一个更底层的设计原则:在不可验证任务上,反馈信号的信息密度与泛化能力之间存在正相关。标量奖励虽然便于优化,但过度的信息压缩使得策略模型只能学到表面的奖励-行为关联,而非真正理解质量的本质。教练式的细粒度反馈则提供了更丰富的学习素材,让模型有机会建立更深层的判断能力。
然而,这项工作也存在一些局限性。首先,教练模型的质量直接决定了经验学习的上限——如果教练本身的评判能力有限,提取的经验知识也会相应贫乏。其次,上下文蒸馏带来的计算开销不可忽视,每个训练样本都需要额外的教练推理和教师推理。论文虽然探索了蒸馏效率的优化,但在这方面仍有提升空间。
对于后续研究而言,经验学习的范式提供了几个有价值的启发。一是将反馈模型从评判者重新定位为教练的思路可以泛化,不必局限于文本形式,视觉、语音等多模态场景同样适用。二是经验的可迁移性设计值得深入探索——如何让一个领域学到的经验高效地帮助另一个领域的学习,可能比直接在不同领域训练教练更经济。三是如何自动化地设计经验提取的格式,让不同任务的教练都能输出高质量、可迁移的评估文本,这将决定这一范式的可扩展性。
摘要
在开放式任务上对大语言模型进行强化学习(RL),会将基于评分标准的评估压缩为一个标量奖励,丢弃了丰富的文本反馈,并将具有不同质量特征的响应混为一谈。我们提出经验学习(Experiential Learning, EL),将反馈模型从"大语言模型作为评判者"重新定位为"大语言模型作为教练"。教练将其对每个在线策略响应的评估提炼为可迁移的经验知识,进而条件化教师模型,并通过在线策略上下文蒸馏使策略模型内化这些知识。与标量奖励相比,这一更高带宽的反馈通道提供了密集的监督信号,并在高质量响应之间保留了细粒度的偏好。跨越两个策略家族、在由策略自身或专有模型提供反馈的设置下,经验学习在保留任务和未见过的开放式任务上均持续优于基于评分标准的强化学习。值得注意的是,经验学习在训练分布之外具有更强的泛化能力,并能缓解奖励欺骗问题。上述发现将经验知识确立为在不可验证任务上进行后训练时更为丰富且更具泛化性的学习信号。
Abstract
Reinforcement learning (RL) on open-ended tasks compresses an LLM's rubric-based evaluation into a scalar reward, discarding rich textual feedback and conflating responses with distinct quality profiles. We propose Experiential Learning (EL), which repurposes the feedback model from an LLM-as-a-Judge into an LLM-as-a-Coach. The coach distills its assessment of each on-policy response into transferable experiential knowledge, which conditions a teacher model and is internalized by the policy through on-policy context distillation. Compared with scalar rewards, this higher-bandwidth feedback channel provides dense supervision and preserves fine-grained preferences among high-quality responses. Across two policy families, with feedback from the policy itself or a proprietary model, EL consistently outperforms rubric-based RL on held-out and unseen open-ended tasks. Notably, EL generalizes better beyond the training distribution, and mitigates reward hacking. These findings establish experiential knowledge as a richer and more generalizable learning signal for post-training on non-verifiable tasks.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。