
迈向智能体式基于代理的模型:可行性、性能与统计模型检验
Towards Agentic Agent-based Models: Feasibility, Performance, and Statistical Model Checking
📝 TLDR
随着大语言模型能力增强,研究者尝试将其引入基于智能体的仿真模型(ABM),但LLM驱动的决策对仿真可靠性与成本的影响尚不明确。本文以Mesa+MultiVeStA平台为基础,在经典Schelling隔离模型中嵌入一个调用LLM进行邻居分类的混合智能体,保留其余智能体使用原本符号规则。实验发现小模型在语义分类或重复工具调用中可能失败,大模型则通过初步检验。论文展示了统计模型检查可用于评估引入LLM组件对ABM观测量与运行行为的影响。
🧭 速览
LLM能力增强使其可被嵌入ABM替代或增强规则,但缺乏对可靠性、计算成本与群体行为影响的系统评估方法。
在Mesa+MultiVeStA平台中扩展Schelling隔离模型,让一个智能体通过自然语言描述与工具调用,由本地LLM完成邻居分类并据此判定幸福感。
小模型在语义分类或重复工具调用中频繁失败,大模型通过初步检验;统计模型检查可量化LLM组件对ABM观测量与运行行为的影响。
该工作为LLM驱动ABM的可行性与性能评估提供了受控实验框架与初步方法学参考。
🆚 方法对比
Classical Schelling Segregation Model
- 规则简单明确,可复现透明
- 集体行为从局部规则自然涌现
- 在社会科学中广泛验证
- 决策规则刚性,缺乏适应性
- 无法处理自然语言等非符号信息
- 难以表达复杂异质性决策逻辑
LLM-extended Schelling Model
- 通过工具调用实现LLM决策透明化
- 保留全局Schelling动力学不变
- 提供受控基准测试环境
- 引入语义错误与随机变异性
- 小模型工具调用可能失败不可用
- 计算开销显著,影响仿真效率
Mesa
- Python生态中流行的ABM框架
- 已与MultiVeStA集成支持SMC
- 在社会科学中应用广泛
- 原生设计面向符号规则系统
- 对LLM智能体集成支持有限
MultiVeStA
- 黑盒SCA工具可集成外部模拟器
- 无需模型转换即可分析
- 提供统计置信保证
- 依赖大量仿真运行次数
- 对LLM非确定性需额外处理
Statistical Model Checking (SMC)
- 仿真基分析提供统计保证
- 黑盒操作适合现有仿真模型
- 可定量估计引入LLM的影响
- 多次仿真在LLM场景下成本高
- 难以覆盖所有LLM行为模式
本文提出在经典Schelling模型中混合一个LLM智能体,通过Mesa+MultiVeStA统计模型检查对比纯符号规则与LLM驱动决策在可靠性、运行时开销和涌现行为上的差异。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 1 张)
展开查看 1 张图
TL;DR
这篇论文探讨了一个很实际的问题:能不能把大语言模型塞进基于代理的仿真模型里,让智能体变得更"聪明",同时又不把整个仿真搞崩?研究者在经典的谢林隔离模型上做了受控实验——保留大部分代理用传统符号规则做决策,只让一个代理调用 LLM 来判断邻居和自己像不像。结果发现小模型容易在语义理解或反复生成工具调用时翻车,大模型则基本能过关。论文还展示了统计模型检验工具可以帮助我们量化"引入 LLM 组件之后,仿真的可观测行为到底变了多少"。
研究背景与动机
基于代理的模型(ABM)是社会科学、经济学和生态学等领域常用的仿真工具。它的基本思路很优雅:不直接给系统写宏观方程,而是给一堆"代理"每人写几条简单的个体决策规则,然后让它们在网格或者网络里跑来跑去、互相影响,最终复杂的集体行为——比如城市形成、市场波动或者种族隔离——会从这些局部交互中"涌现"出来。谢林隔离模型就是最经典的例子:代理只关心邻居里和自己不一样的比例是不是太高,如果是就搬家;就这么简单的规则,最后整个系统却会出现明显的社会隔离。
然而,传统 ABM 有一个天然的局限:代理的决策规则必须事先用符号语言写死,规则本身缺乏灵活性和语义理解能力。代理说"我看看周围有没有和我不一样的邻居",这个"不一样"怎么界定?通常研究者会把它编码成几个固定的特征标签(比如种族、收入),但现实中的"差异"远比几个二进制标签丰富。大语言模型(LLM)的出现让研究者看到了突破这个天花板的可能性——能不能让代理自己用自然语言理解邻居、通过对话来决定搬不搬?
但这里有个根本性的担忧。LLM 是概率模型,它的输出有随机性,延迟不可控,成本也远高于几行 if-else 代码。如果把 LLM 嵌进 ABM 里,仿真还能保持可重复性吗?成本会膨胀到什么程度?更重要的是,引入 LLM 之后,模型的集体行为会不会和原始设计产生偏差?这些问题的答案决定了"LLM + ABM"这条路到底能不能走通。这篇论文就是奔着回答这些问题去的。
方法
研究者选择了一个极简但控制得很好的实验设定。他们在 Mesa——一个流行的 Python ABM 库——上复现了经典的谢林隔离模型,同时把它和统计模型检验工具 MultiVeStA 做了集成。MultiVeStA 能对 ABM 的运行轨迹做形式化验证,比如检验"最终状态下格子板上相邻格子同类的比例超过某个阈值的概率"这类性质,这在传统的蒙特卡洛仿真里是跑不出来的。
关键设计在于"混合智能体"的引入。在标准的谢林模型里,所有代理判断邻居是否"相同"的逻辑都是一样的——比如都是"种族标签一致即为相同"。研究者在这里做了一个变化:只让一个特定的代理把邻居分类任务外包给 LLM。具体做法是,这个 LLM 代理收到的不是结构化的特征向量,而是一段自然语言描述——比如"这是一位中年居民,拥有本科学位,收入中等偏上"——然后它需要调用工具来递增"相似邻居"或"不同邻居"的计数器。如果计数器显示不同邻居超过阈值,这个代理就认为"不开心"并触发搬家行为。
这个设计的聪明之处在于"隔离变量"。除了这一个代理的决策逻辑被替换成 LLM 调用之外,模型的所有其他部分——格子结构、移动规则、满意度判定、仿真步推进——完全保持原样。这让我们能单独观察 LLM 组件在语义层面(理解自然语言描述)、操作层面(能否稳定生成正确的工具调用格式)和计算层面(延迟和成本)对系统的影响,而不会被其他因素干扰。
实验与结果
研究者部署了多个规模不同的本地 LLM,在相同初始条件下反复运行仿真,记录了三个维度的表现。
在语义分类能力上,较小的模型(比如 7B 参数量级)频繁出错。比如给定"肤色不同但收入相同"的邻居描述,小模型有时会错误归类,导致代理的满意度判断和预期不符。较大的模型在这类简单语义任务上基本能给出合理的分类结果。
在工具调用稳定性上,问题更严重。LLM 代理需要反复调用工具来更新相似/不同邻居的计数器,但小模型在连续调用时经常生成格式错误的请求,或者陷入重复生成同一个调用的循环——也就是说,它在操作层面变得不可用。大模型虽然也有延迟问题,但至少能正确完成连续的工具调用序列。
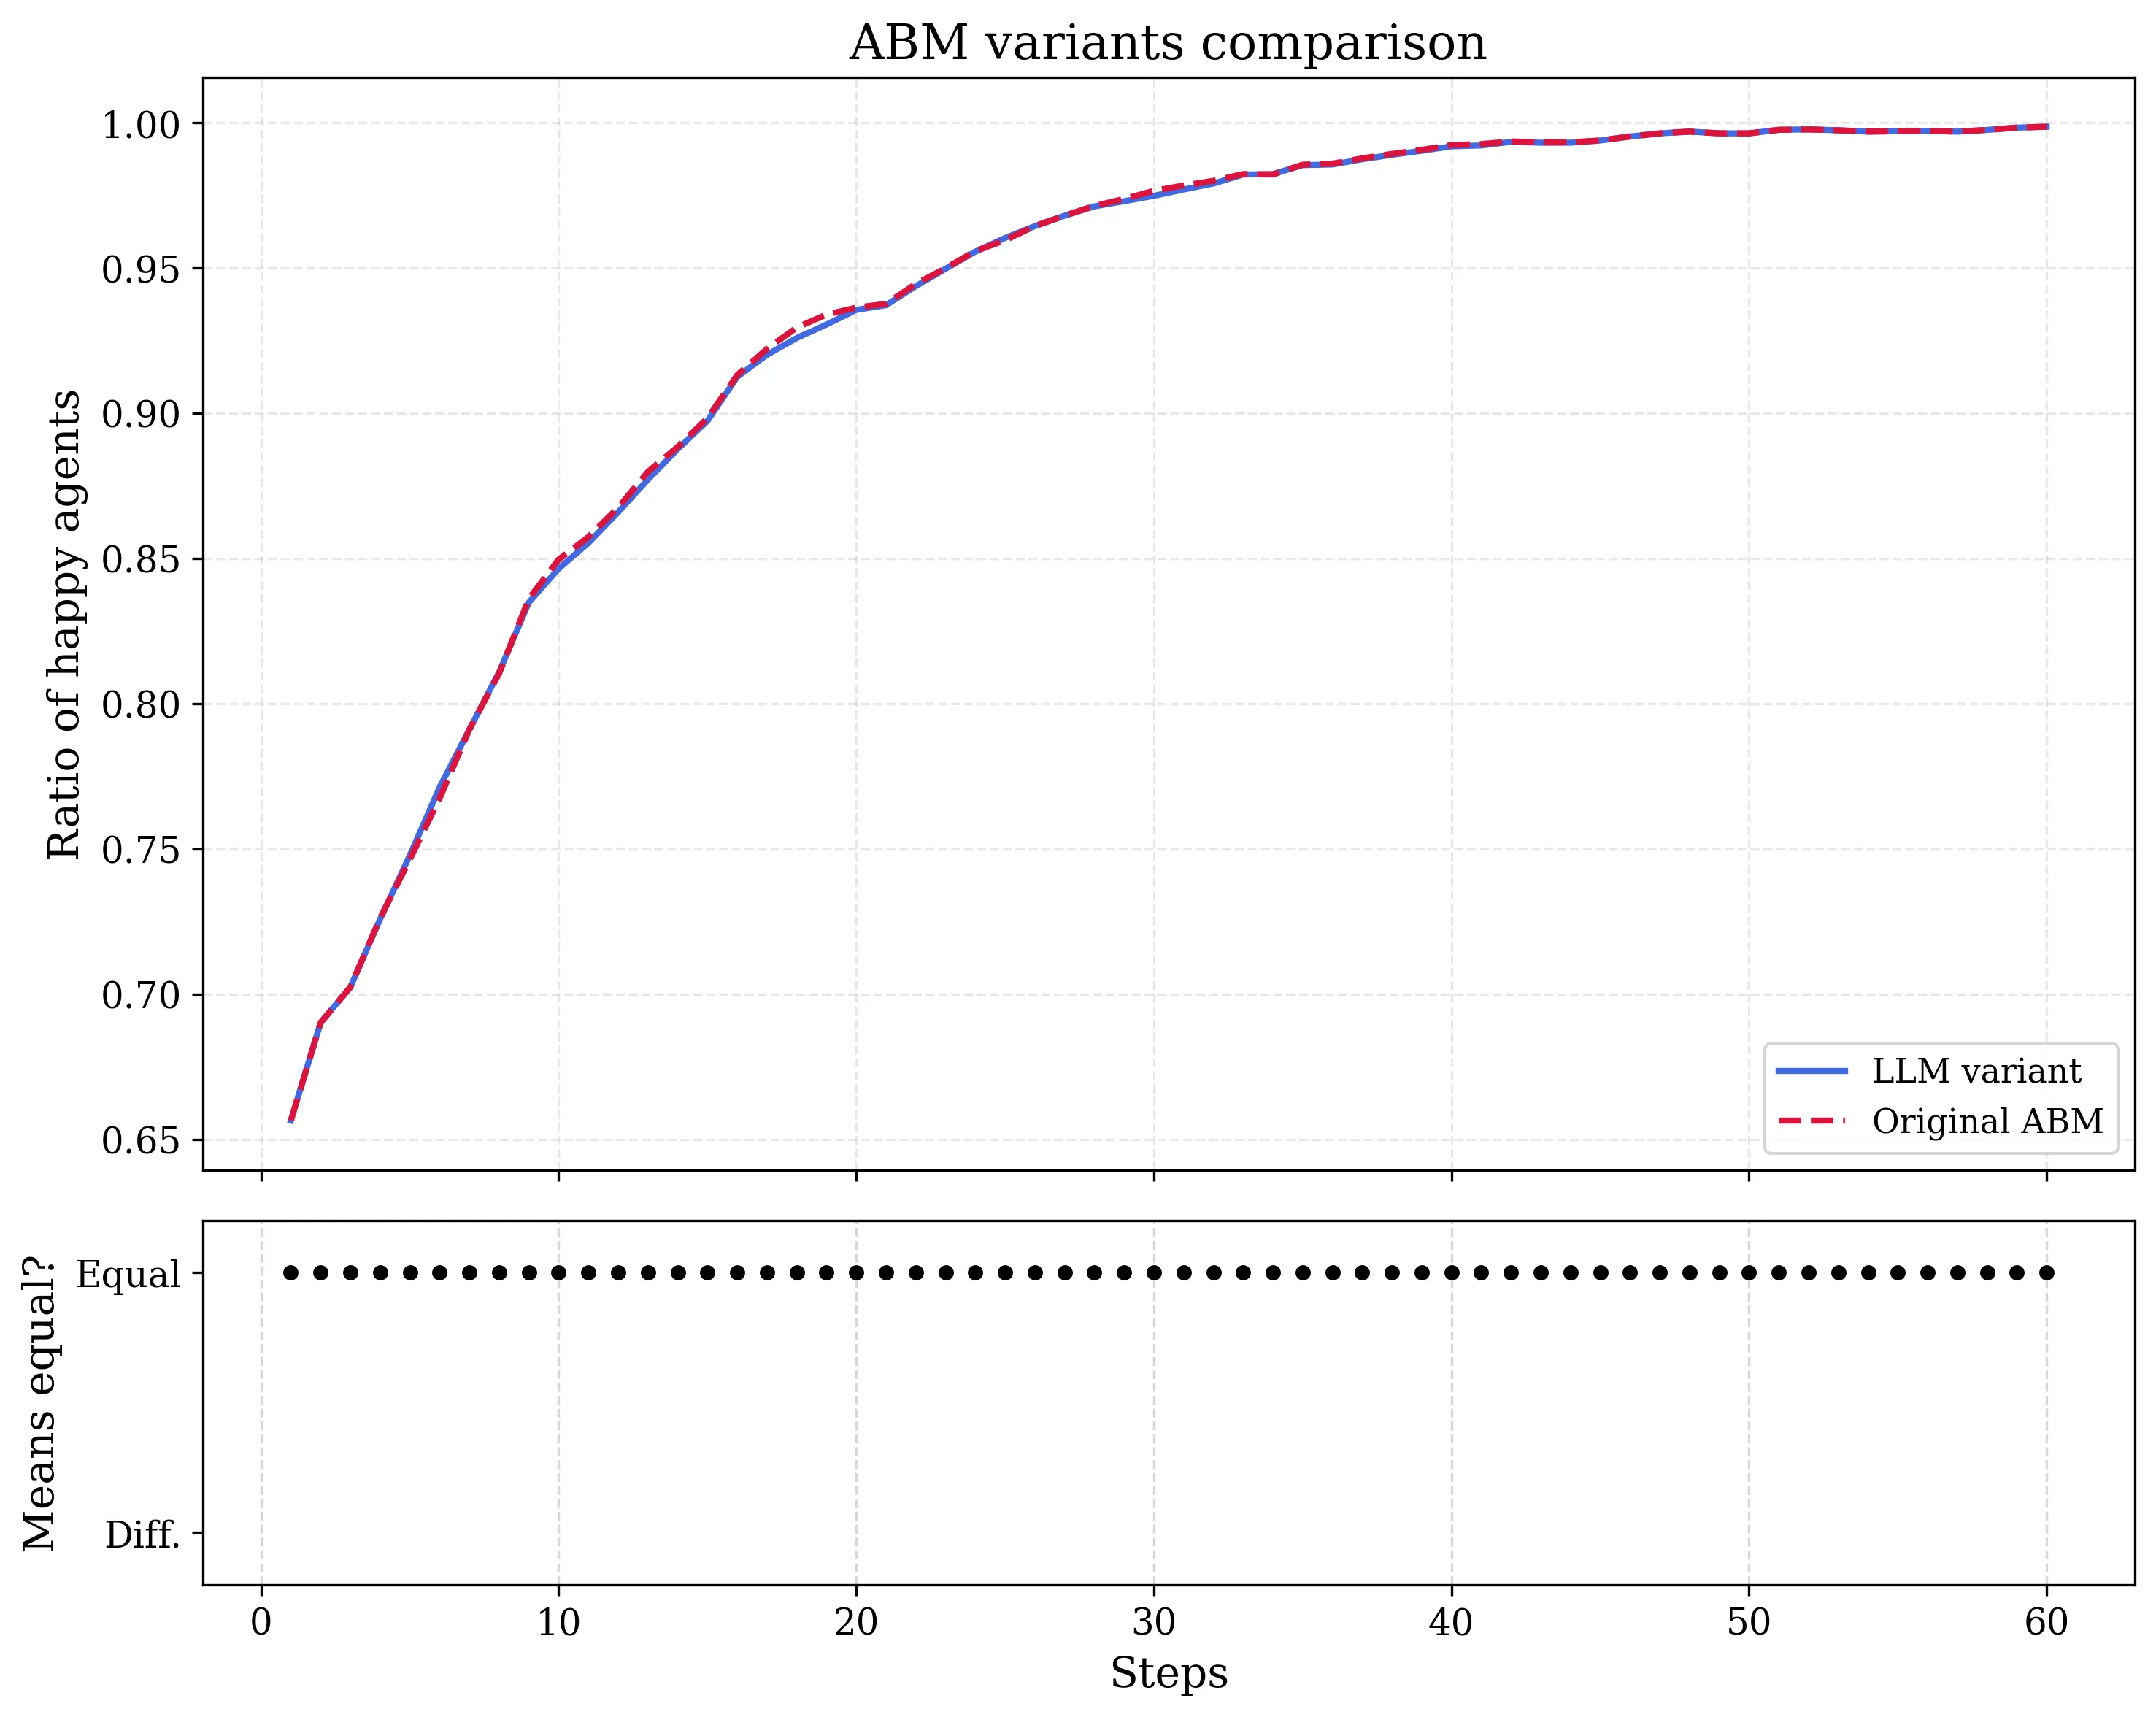
更有意思的是宏观行为的偏差。研究者用 MultiVeStA 检验了加入 LLM 代理后,系统的可观测量——比如平均满意度、隔离指数——是否还在统计模型检验的预期范围内。对于大模型,这些可观测量与纯符号版本没有显著差异;但小模型引入的噪声会向上传导,最终导致宏观隔离水平偏离预期。
讨论与可借鉴点
这篇论文最重要的贡献不是某个具体模型设计,而是它展示了一套评估 LLM 组件对 ABM 可靠性影响的方法论。当研究者想用 LLM 来丰富代理的决策能力时,他们需要一个系统化的方式来回答:这个 LLM 代理的行为和它所替换的符号规则等效吗?宏观涌现结果会不会因此改变?论文里 Mesa + MultiVeStA 的集成提供了一个可以直接复用的工具链。
从局限性来看,这个实验只引入了单个 LLM 代理,而实际应用中可能需要大量 LLM 驱动的代理协同工作——那时候成本和延迟问题会被急剧放大。另外,谢林模型本身是个相对简单的设定,LLM 在更复杂的决策场景(比如多目标权衡、跨时间维度的推理)中的表现还没有被触及。统计模型检验虽然能量化偏差,但它本身也有计算成本,和 LLM 的成本叠加在一起,可能不适合大规模快速探索。
对于后续研究而言,一个清晰的方向是把"LLM 代理的错误率"建模成一个显式参数引入 ABM,做敏感性分析——比如假设 LLM 代理有 10% 的概率误分类邻居,系统的隔离程度会怎么变?这比单纯跑几次仿真更能揭示 LLM 可靠性的边界。另一个方向是把统计模型检验和 LLM 的不确定性量化结合起来,让研究者不只看到"LLM 代理行为变了",还能看到"变了多少、哪个环节最容易出错"。
摘要
基于代理的模型(ABM)依赖简洁、明确且可复现的个体决策规则,而复杂的集体行为则从代理间的交互中涌现。大语言模型(LLM)的最新进展使得用基于LLM的智能体能力去替换、丰富或扰动这些规则变得颇具吸引力。然而,这引出一个方法论问题:引入LLM驱动的决策会如何影响ABM仿真的可靠性、计算成本与行为?我们针对流行的Python ABM库Mesa所构建的ABM模型,并结合统计模型检验,对这一问题展开研究。在Mesa与统计模型检验工具MultiVeStA集成的基础上,我们对经典的谢林隔离模型进行扩展,引入混合种群:普通代理依据标准的符号规则对邻居进行分类,而其中一个代理则通过工具调用将该分类任务委托给LLM。该启用了LLM的代理接收关于邻居代理的自然语言描述,并调用工具以递增相似/不同邻居的计数器;这些计数器根据原始谢林动力学决定其满意度。这提供了一个极简但受控的设定,使得基于LLM的决策在语义、操作和计算层面的行为能够在其他方面保持标准的ABM内部得到研究。我们报告了使用本地部署、不同规模LLM的初步实验,结果表明较小的模型可能在简单的语义分类实验中失败,或在重复生成工具调用时变得操作上不可用,而测试中较大的模型则通过了这些初步检验。我们讨论了统计模型检验如何估计经典ABM的可观测量,并量化将智能体式LLM组件引入仿真模型所带来的影响。
Abstract
Agent-based models (ABMs) rely on simple, explicit and reproducible rules for individual decision making, while complex collective behavior emerges from interactions among agents. Recent advances in large language models (LLMs) make it tempting to replace, enrich, or perturb these rules with LLM-based agentic capabilities. However, this raises a methodological question: how does introducing LLM-driven decisions affect the reliability, computational cost, and behavior of ABM simulations? We investigate this for Mesa ABM models, a popular Python library for ABMs, analyzed by statistical model checking. Building on Mesa's integration with the statistical model checker MultiVeStA, we extend the classical Schelling segregation model with a hybrid population: ordinary agents classify neighbors using the standard symbolic rule, while one agent delegates this task to an LLM through tool calls. The LLM-enabled agent receives natural-language descriptions of neighboring agents and invokes tools that increment counters of similar/different neighbors; these counters determine its happiness according to the original Schelling dynamics. This provides a minimal but controlled setting where the semantic, operational, and computational behavior of LLM-based decisions can be studied inside an otherwise standard ABM. We report preliminary experiments with locally served LLMs of different sizes, showing that smaller models may fail simple semantic classification experiments or become operationally unusable during repeated tool-call generation, while larger tested models pass these preliminary checks. We discuss how statistical model checking can estimate classical ABM observables and quantify the impact of introducing agentic LLM components into simulation models.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。