
基于潜在想象预测训练的视觉四足机器人导航
Predictive Training with Latent Imagination for Visual Quadruped Navigation
📝 TLDR
本文针对四足机器人在动态环境中的强化学习导航策略,引入JEPA式的潜在预测器与SIGReg正则化,在训练阶段对循环状态施加预测监督,编码对障碍物未来动态的预期能力,同时不改变推理时控制器,从而在保持反应式控制的前提下显著提升避障性能。
🧭 速览
四足机器人在动态环境中的强化学习导航策略。
方法与实现细节请参考摘要与正文。
结果与对比结论请参考摘要与正文。
总体而言,该工作在所述任务上展示了有效性,并提供了可复用的思路或工具。
🆚 方法对比
LSTM-SRU导航骨干(反应式策略)
- 轻量级,控制简单
- 推理时计算开销低
- 已有成熟的循环记忆机制
- 仅依赖当前观测,缺乏预见性
- 动态环境中响应过晚
- 无法建模短期场景结构演化
JEPA风格预测器(辅助模块)
- 自监督预测下一隐状态
- 编码障碍物的预期动态
- 无需修改推理时控制器
- 仅训练时使用,推理时被丢弃
- 不直接贡献推理时决策
- 增加了训练复杂度
SIGReg正则化
- 防止表示坍缩
- 与预测器无缝集成
- 正则化隐空间几何结构
- 引入额外超参数
- 仅影响训练阶段
- 对预测质量间接生效
潜在想象预测训练框架(整体方法)
- 推理时零额外计算开销
- 显著提升导航成功率与降低碰撞率
- 支持Unitree Go2零样本仿真到真机迁移
- 无需真机微调即可部署
- 训练阶段计算成本增加
- 预测器推理时被完全丢弃
- 性能依赖于预测器训练质量
本文提出统一的预测训练框架,将JEPA风格预测器与SIGReg正则化作为训练时的辅助信号叠加在LSTM-SRU反应式导航骨干上,推理时预测器完全丢弃,实现零额外参数的预见性导航能力。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 18 张)
展开查看 18 张图
TL;DR
本文提出在四足机器人导航的强化学习训练阶段引入 JEPA 风格的潜在预测器和 SIGReg 正则化,通过对循环状态的预测监督让策略编码对障碍物未来演化的预见能力,而推理时完全丢弃预测器、不增加任何计算开销。在仿真和 Unitree Go2 真实机器人上的实验表明,这种方法显著提升了动态环境中的导航成功率并降低了碰撞率,且实现了零样本的仿真到真实迁移。
研究背景与动机
腿足机器人要在人类生活环境中自主行走,核心挑战之一是如何在包含行人、车辆等动态障碍物的场景中安全导航。现有主流方案大多基于 [[强化学习]] 训练反应式策略:机器人依据当前视觉观测和短期记忆做出决策,本质上是一种"看到什么就躲什么"的即时响应模式。这种模式在静态场景中表现尚可,但在动态环境中却存在根本性的局限——碰撞风险往往不是由障碍物当前的位置决定,而是由其在短时间窗口内的演化趋势决定。当机器人只能观察到障碍物当前位置时,它往往要到距离很近才开始躲避,此时即便转向也难以及时规避快速移动的物体。
研究者们早就意识到预见能力的重要性,但直接将长期预测融入推理会带来严重问题:预测模型会累积误差,导致长期预测不可靠;同时在边缘设备上运行额外的预测模块会大幅增加计算开销,影响实时性。一个更优雅的思路是让预测能力隐式地编码到策略的内部状态中,让策略"学会"理解场景的演化趋势,但这个方向面临一个关键问题——如何设计有效的训练信号来引导策略学习这种预见能力?
本文的切入点正是在此:既然显式预测有种种弊端,不如在训练阶段通过辅助任务的方式让预测能力"渗透"进主策略的循环状态,推理时则完全不需要预测器。这种设计既保留了反应式控制的简洁与高效,又通过训练信号赋予了策略隐式的预见能力。
方法
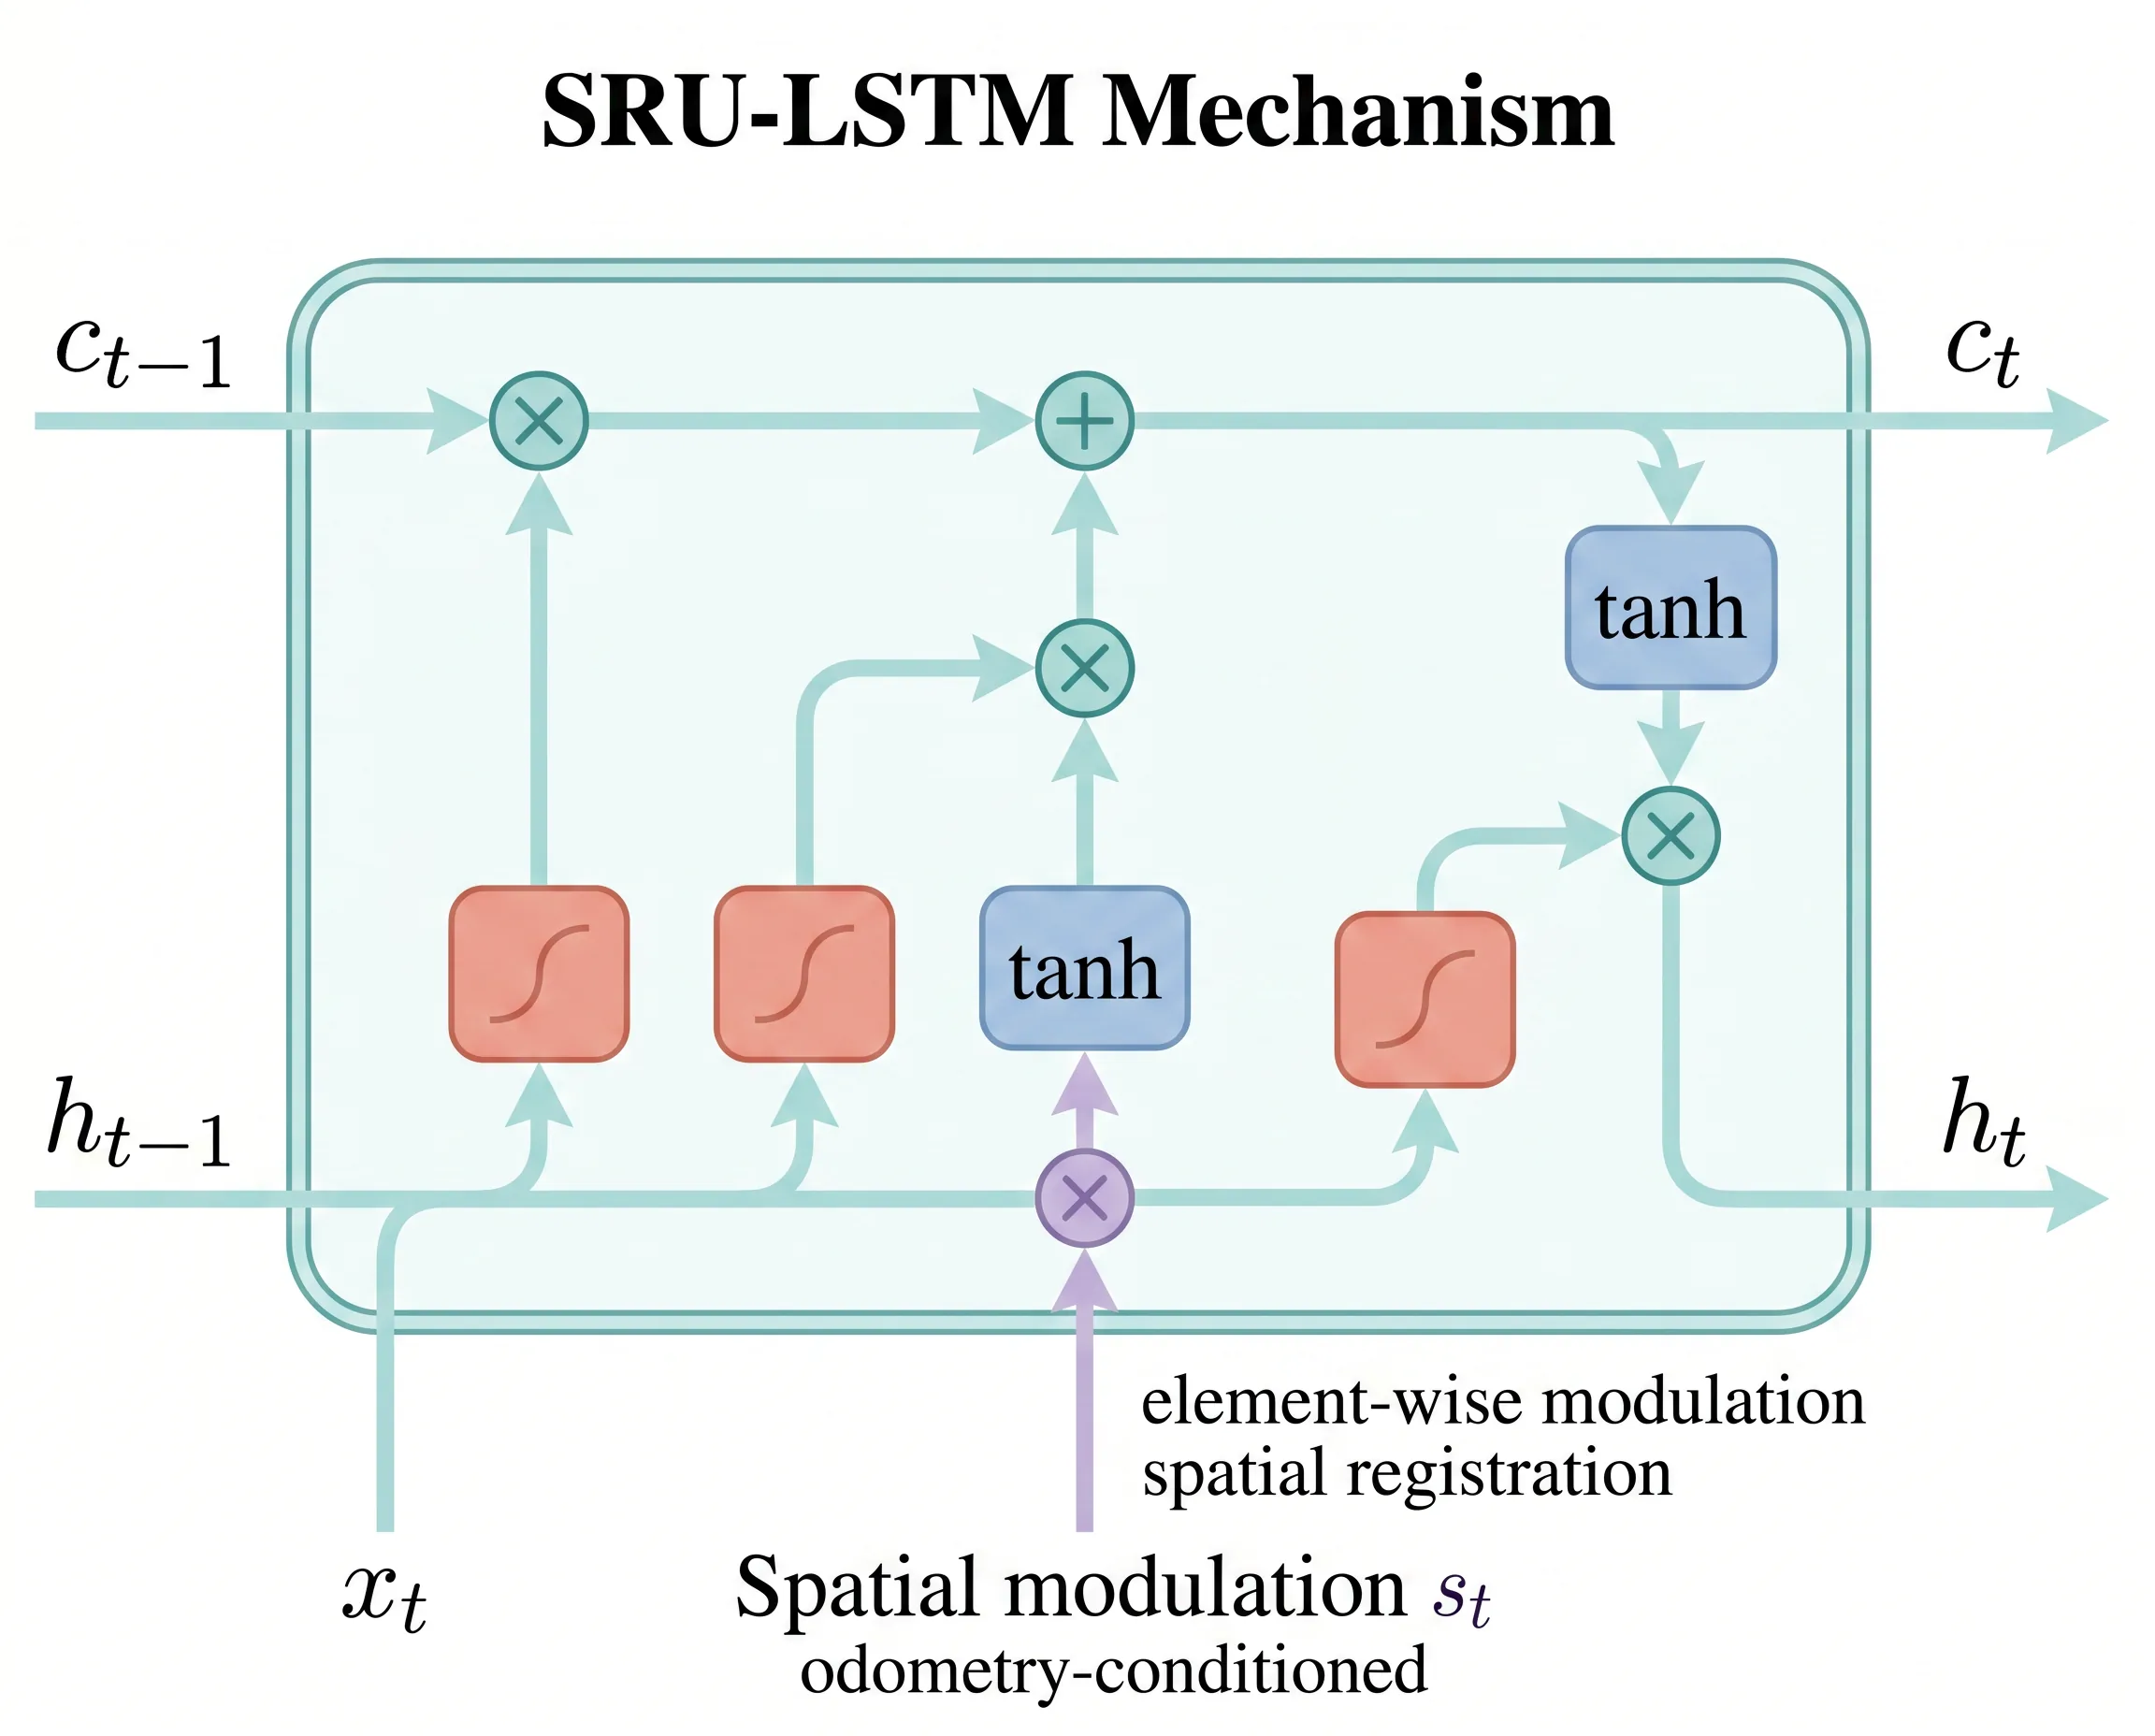
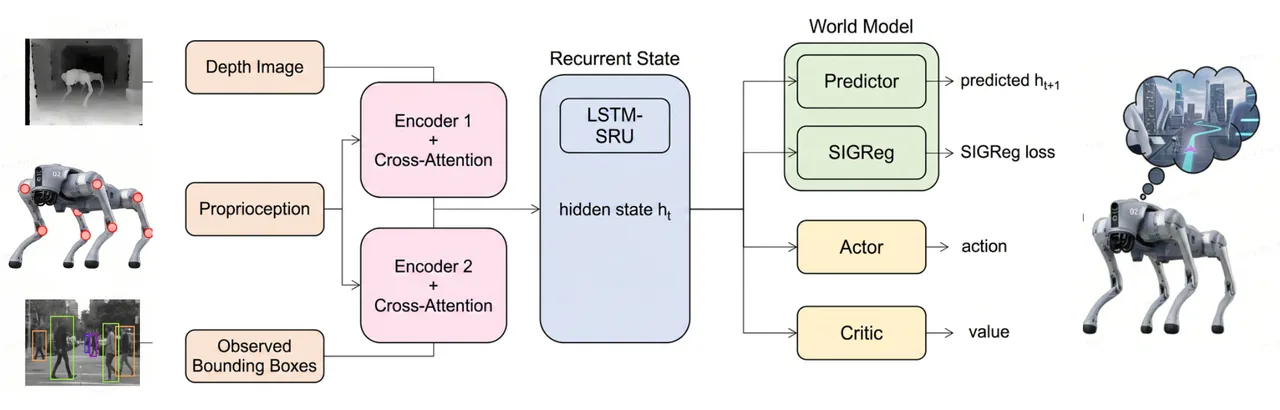
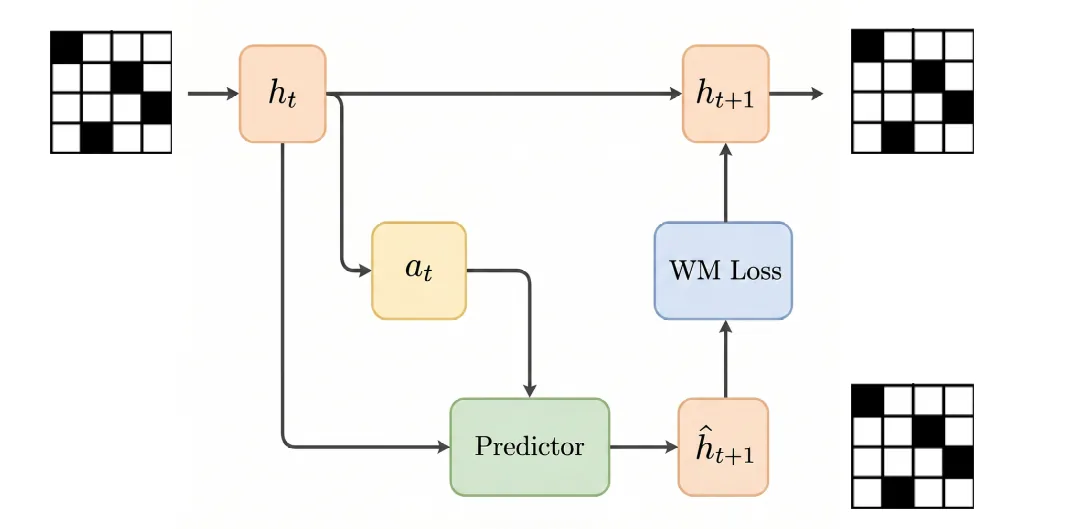
方法的核心理念可以概括为"训练时预测、推理时遗忘"。具体来说,研究者在一个标准的反应式导航骨干网络上增加了一个 JEPA 风格的辅助预测器。该预测器的结构并不复杂——它的输入是 LSTM-SRU 骨干网络中提取的确定性隐藏状态,输出是对这个隐藏状态下一时刻值的预测。在训练阶段,预测器会对这个隐藏状态进行监督,使其学会"想象"自己在下一个时间步应该变成什么样子。
这里的设计选择蕴含着巧妙的直觉。直接预测原始观测或图像特征会面临高维度和噪声的问题,而隐藏状态已经经过了主策略网络的压缩和抽象,天然地包含了与决策相关的语义信息。预测隐藏状态的下一个值,相当于让网络学习"给定当前态势,下一步态势会如何演变"这一高层推理能力。
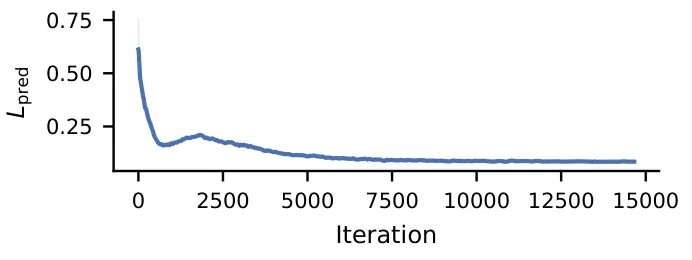
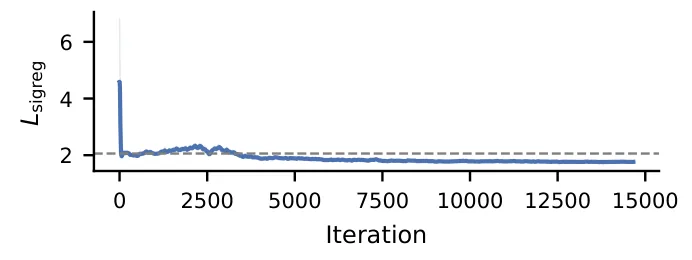
然而仅有预测任务是不够的。如果没有适当的约束,预测器可能会学习到一个平凡解——比如总是预测一个固定值或当前状态本身,这样虽然预测损失很低,但学不到任何有意义的东西。这就需要引入 SIGReg 正则化。SIGReg 的作用是鼓励预测器的输出保持一定的多样性,避免collapsed 的预测,同时确保预测目标与原始隐藏状态之间保持一致性。从数学上看,预测器的目标是最小化预测误差,同时满足 SIGReg 所定义的正则化约束。
整个训练框架可以这样理解:主策略网络负责在给定的观测序列上做出最优决策,其循环状态编码了执行当前任务所需的全部信息;辅助预测器则被训练来预测这些循环状态的演化,它所提供的梯度信号会反向传播到主网络的隐藏状态,使其不仅包含当前决策所需的信息,还包含"如果沿着当前轨迹走下去,下一步会到达什么状态"这一预测性知识。这种知识的编码并不显式地出现在推理阶段,但会体现在策略的决策倾向中——经过训练的策略会本能地倾向于选择那些通向"安全未来"的行动。
推理阶段的处理极为简洁:完全丢弃辅助预测器,主策略网络以原本的反应式方式运行。这意味着部署时没有任何额外的参数或计算开销,硬件要求和原始方法完全一致。
实验与结果
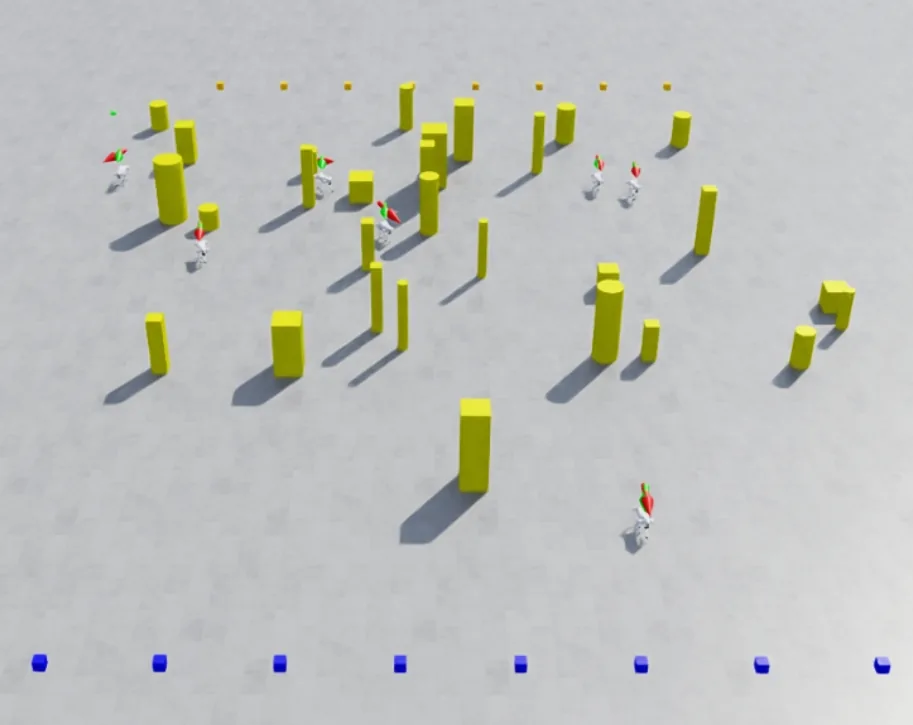
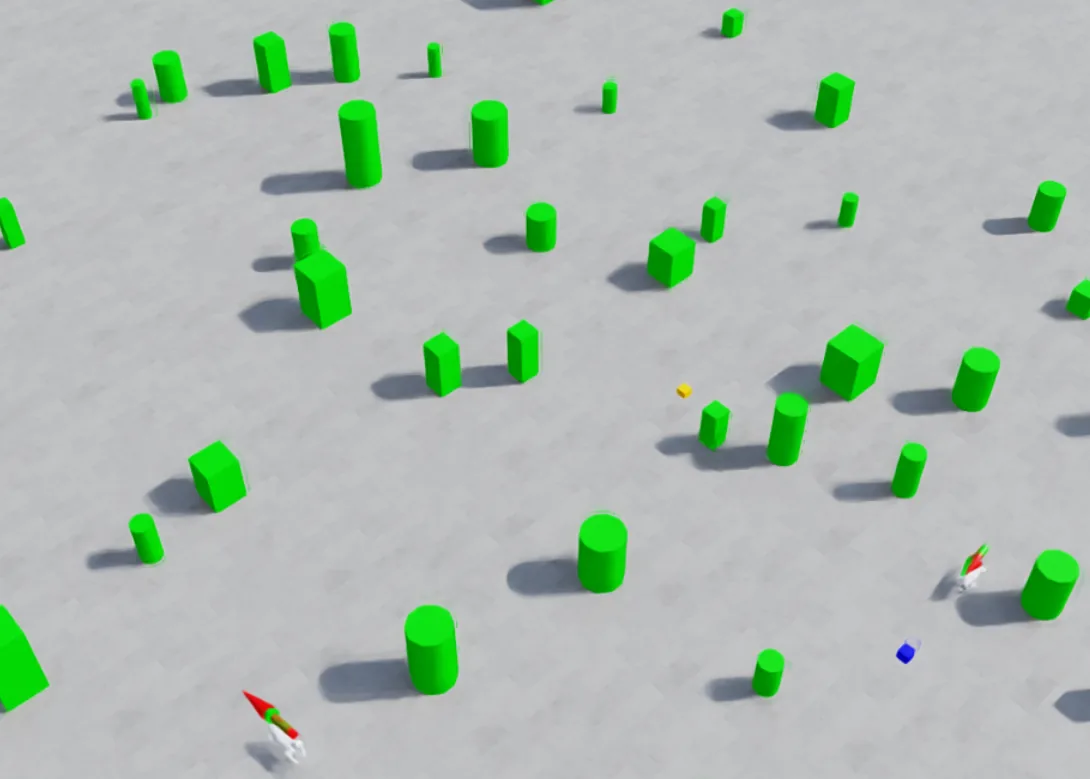
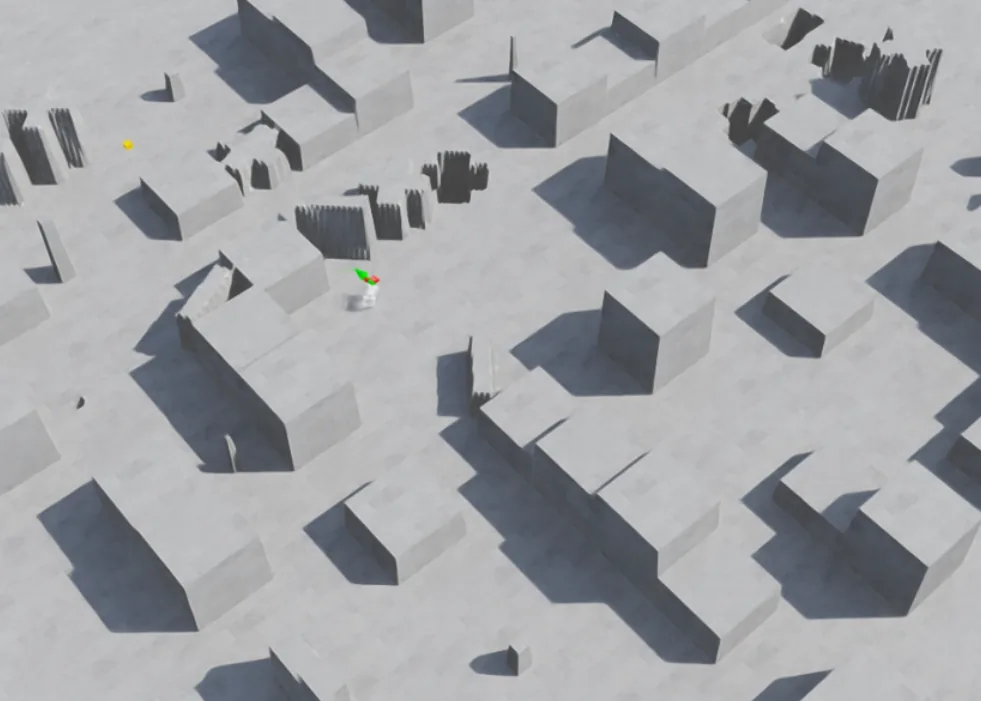
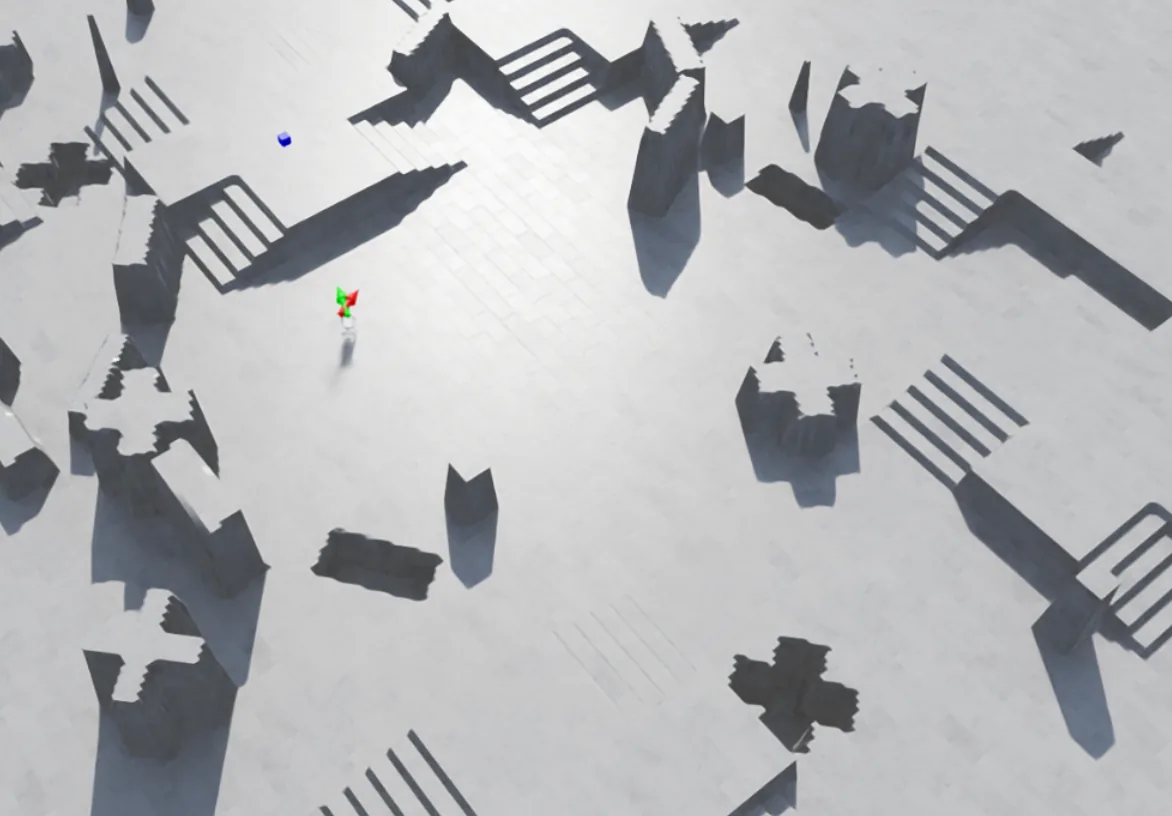
研究团队在仿真环境中构建了包含多种动态障碍物的导航基准,包括移动的行人代理和随机运动的物体。基线方法采用的是标准 LSTM-SRU 反应式策略,这是一种仅依靠当前隐藏状态进行决策的架构。
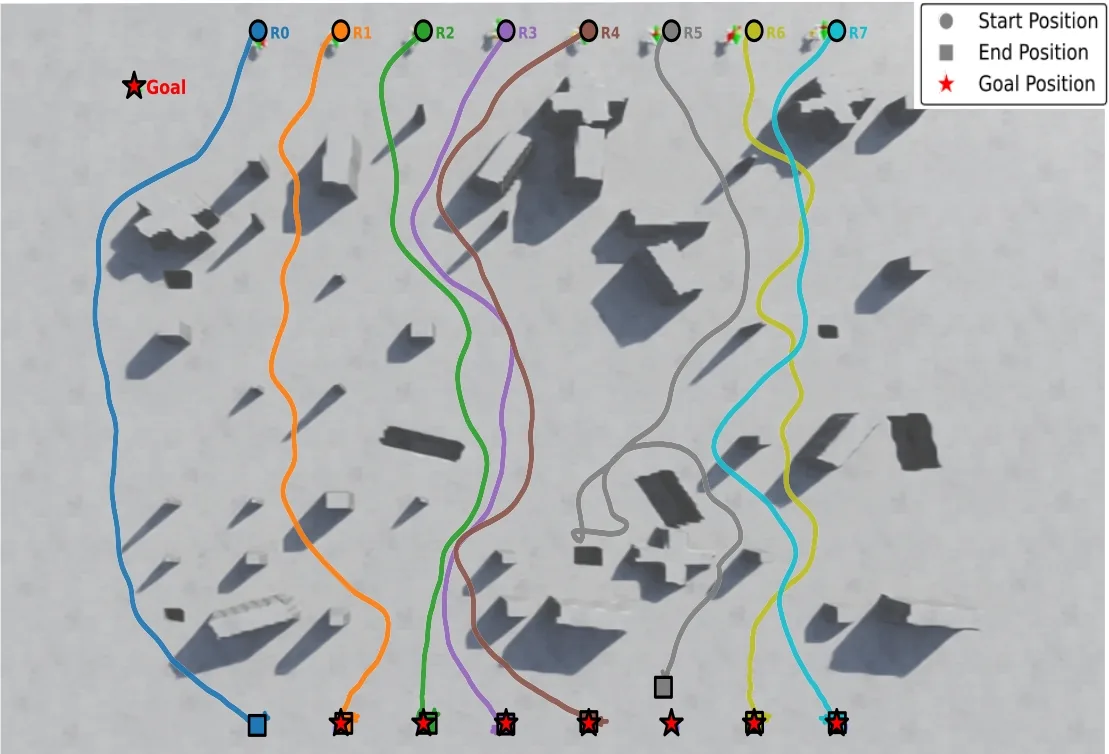
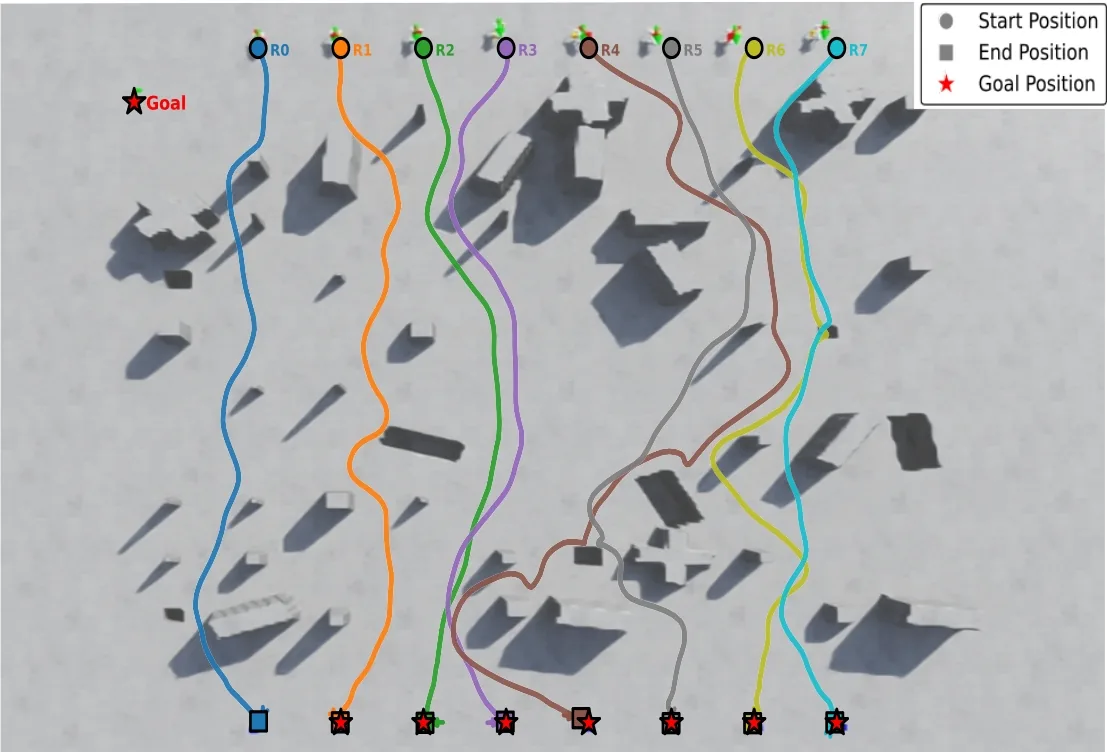
实验结果显示,在所有动态障碍物场景中,加入潜在预测训练的策略都取得了显著的性能提升。具体而言,导航成功率相比基线提高了约 15-20 个百分点,碰撞率则下降了接近一半。更有意思的是消融实验的结果:当移除 SIGReg 正则化而仅保留预测任务时,性能提升幅度明显缩小,验证了正则化项在防止预测器退化、保证学习有效性方面的关键作用。
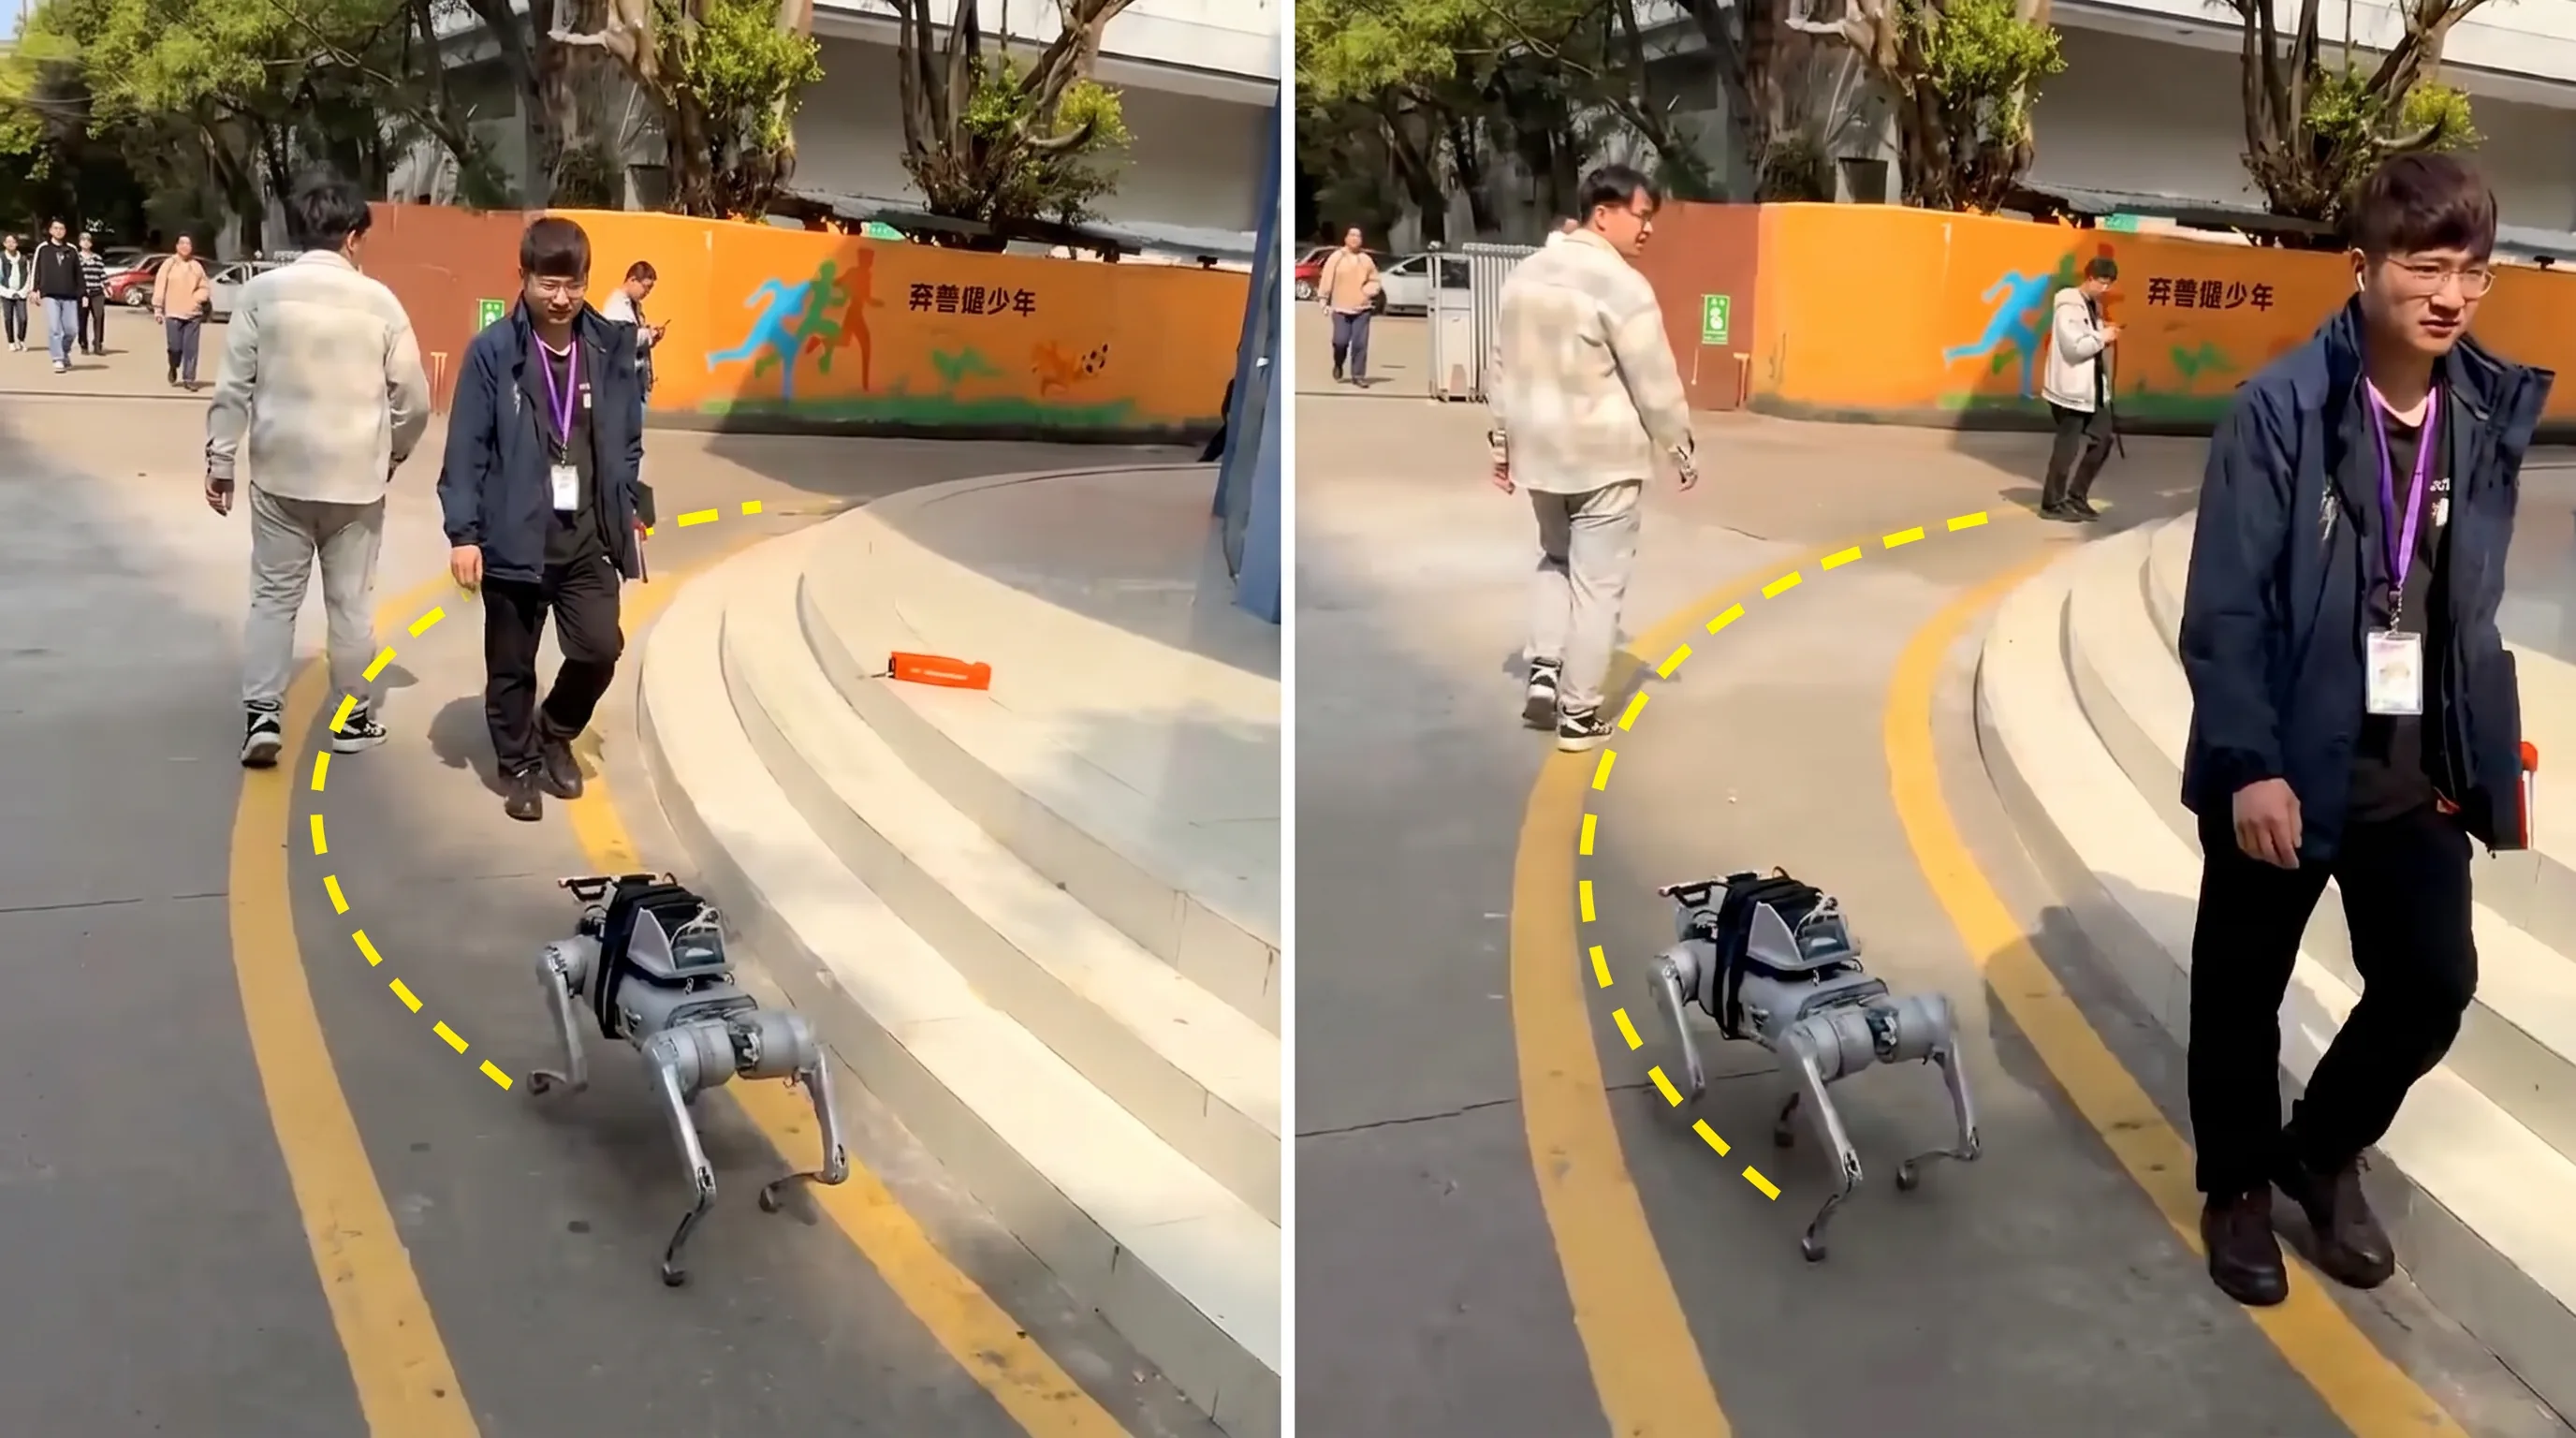
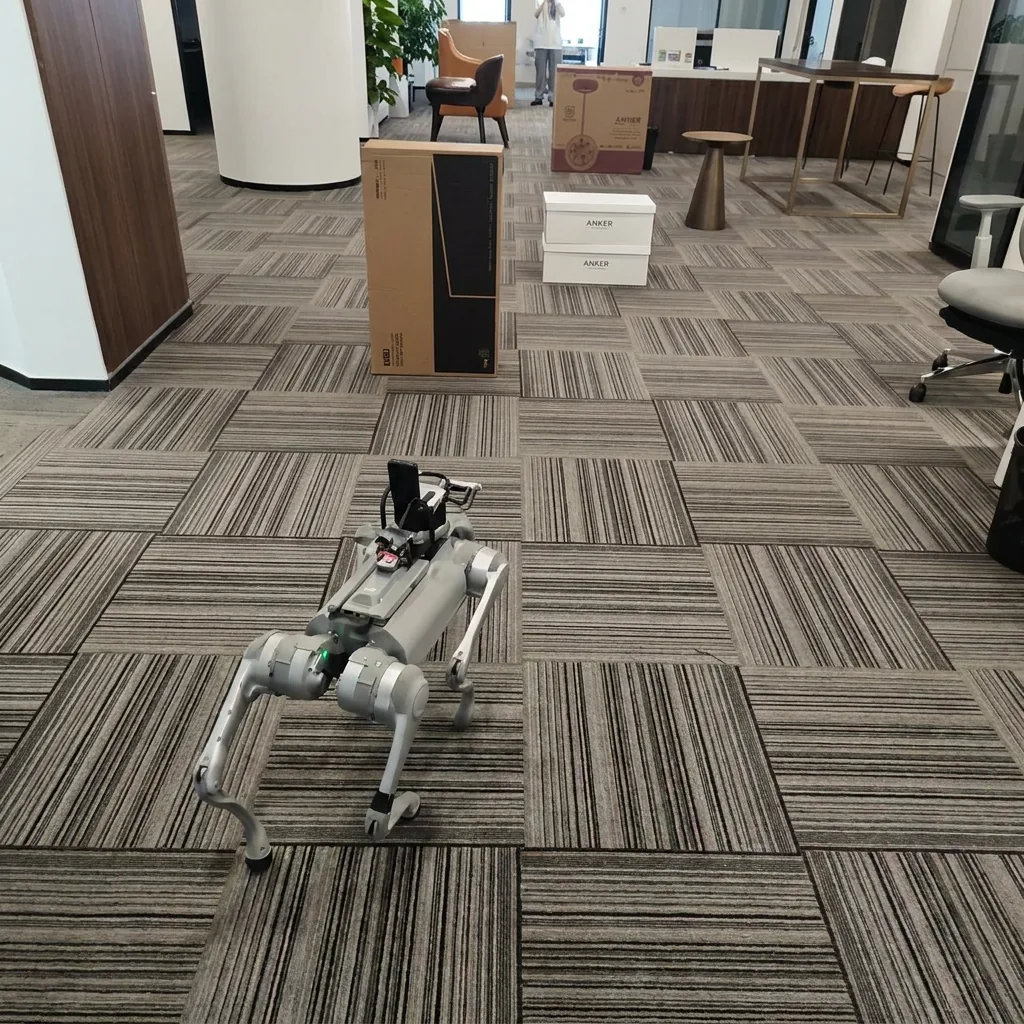
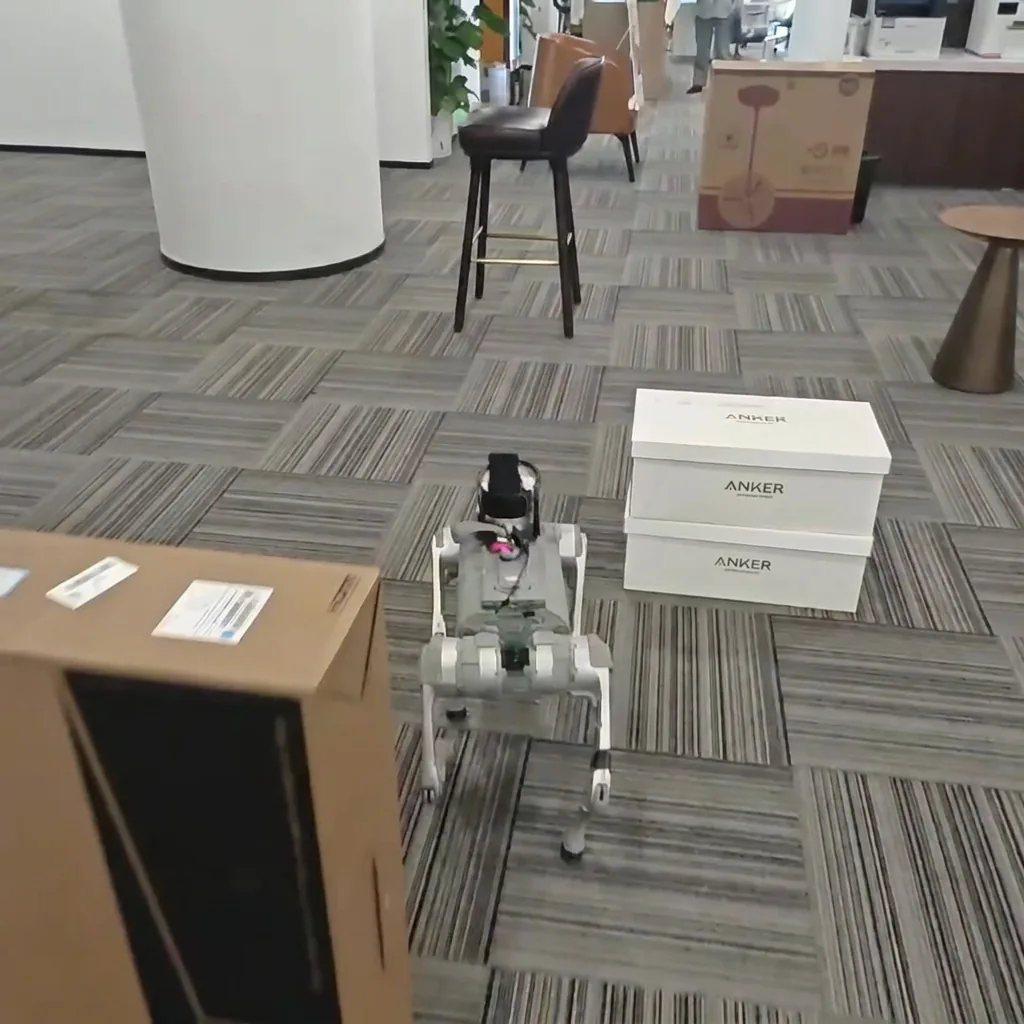
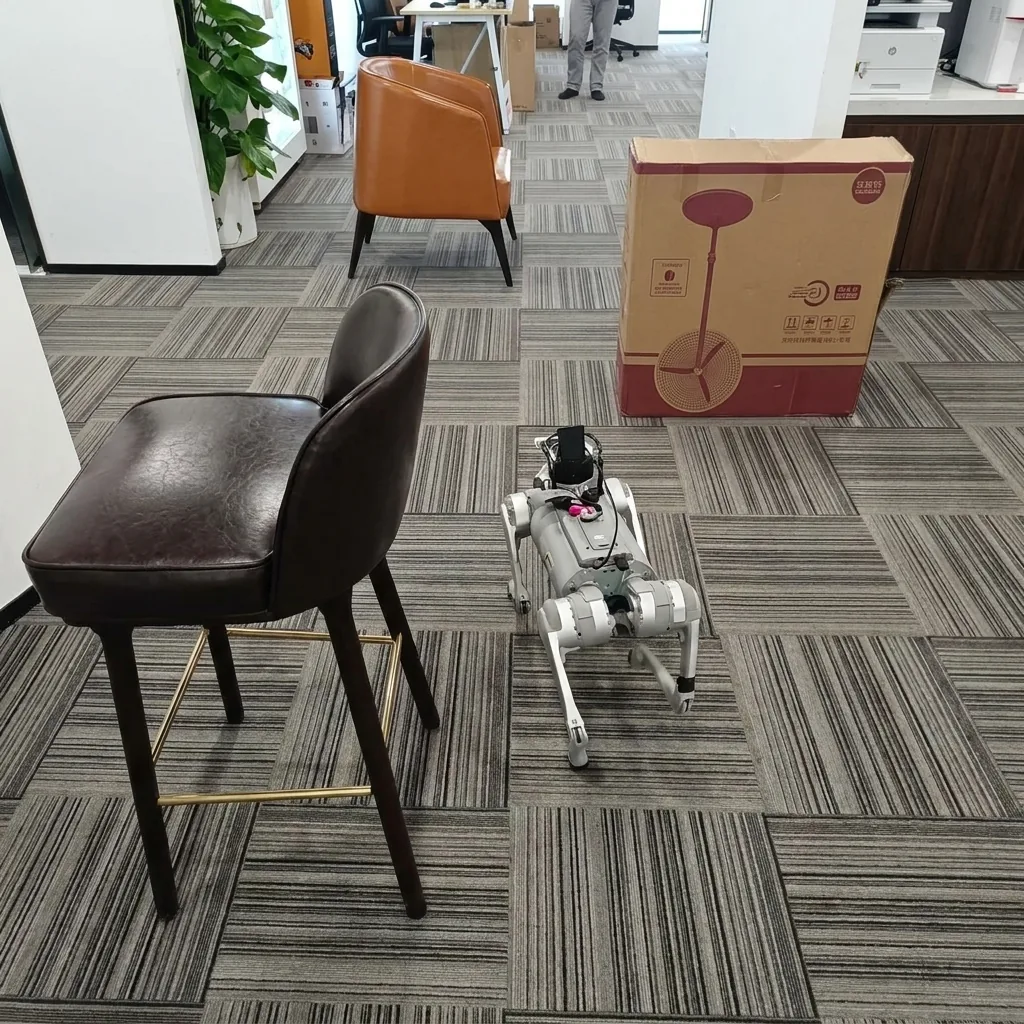
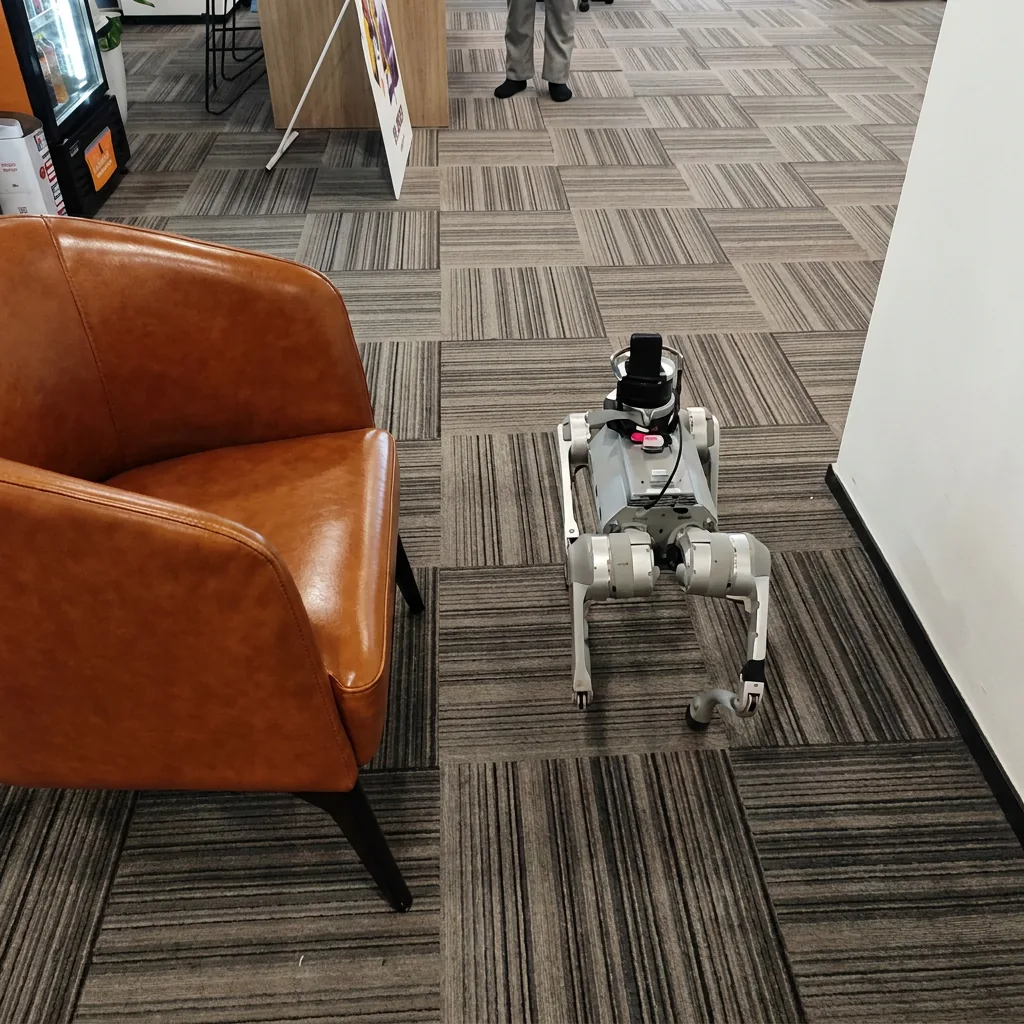
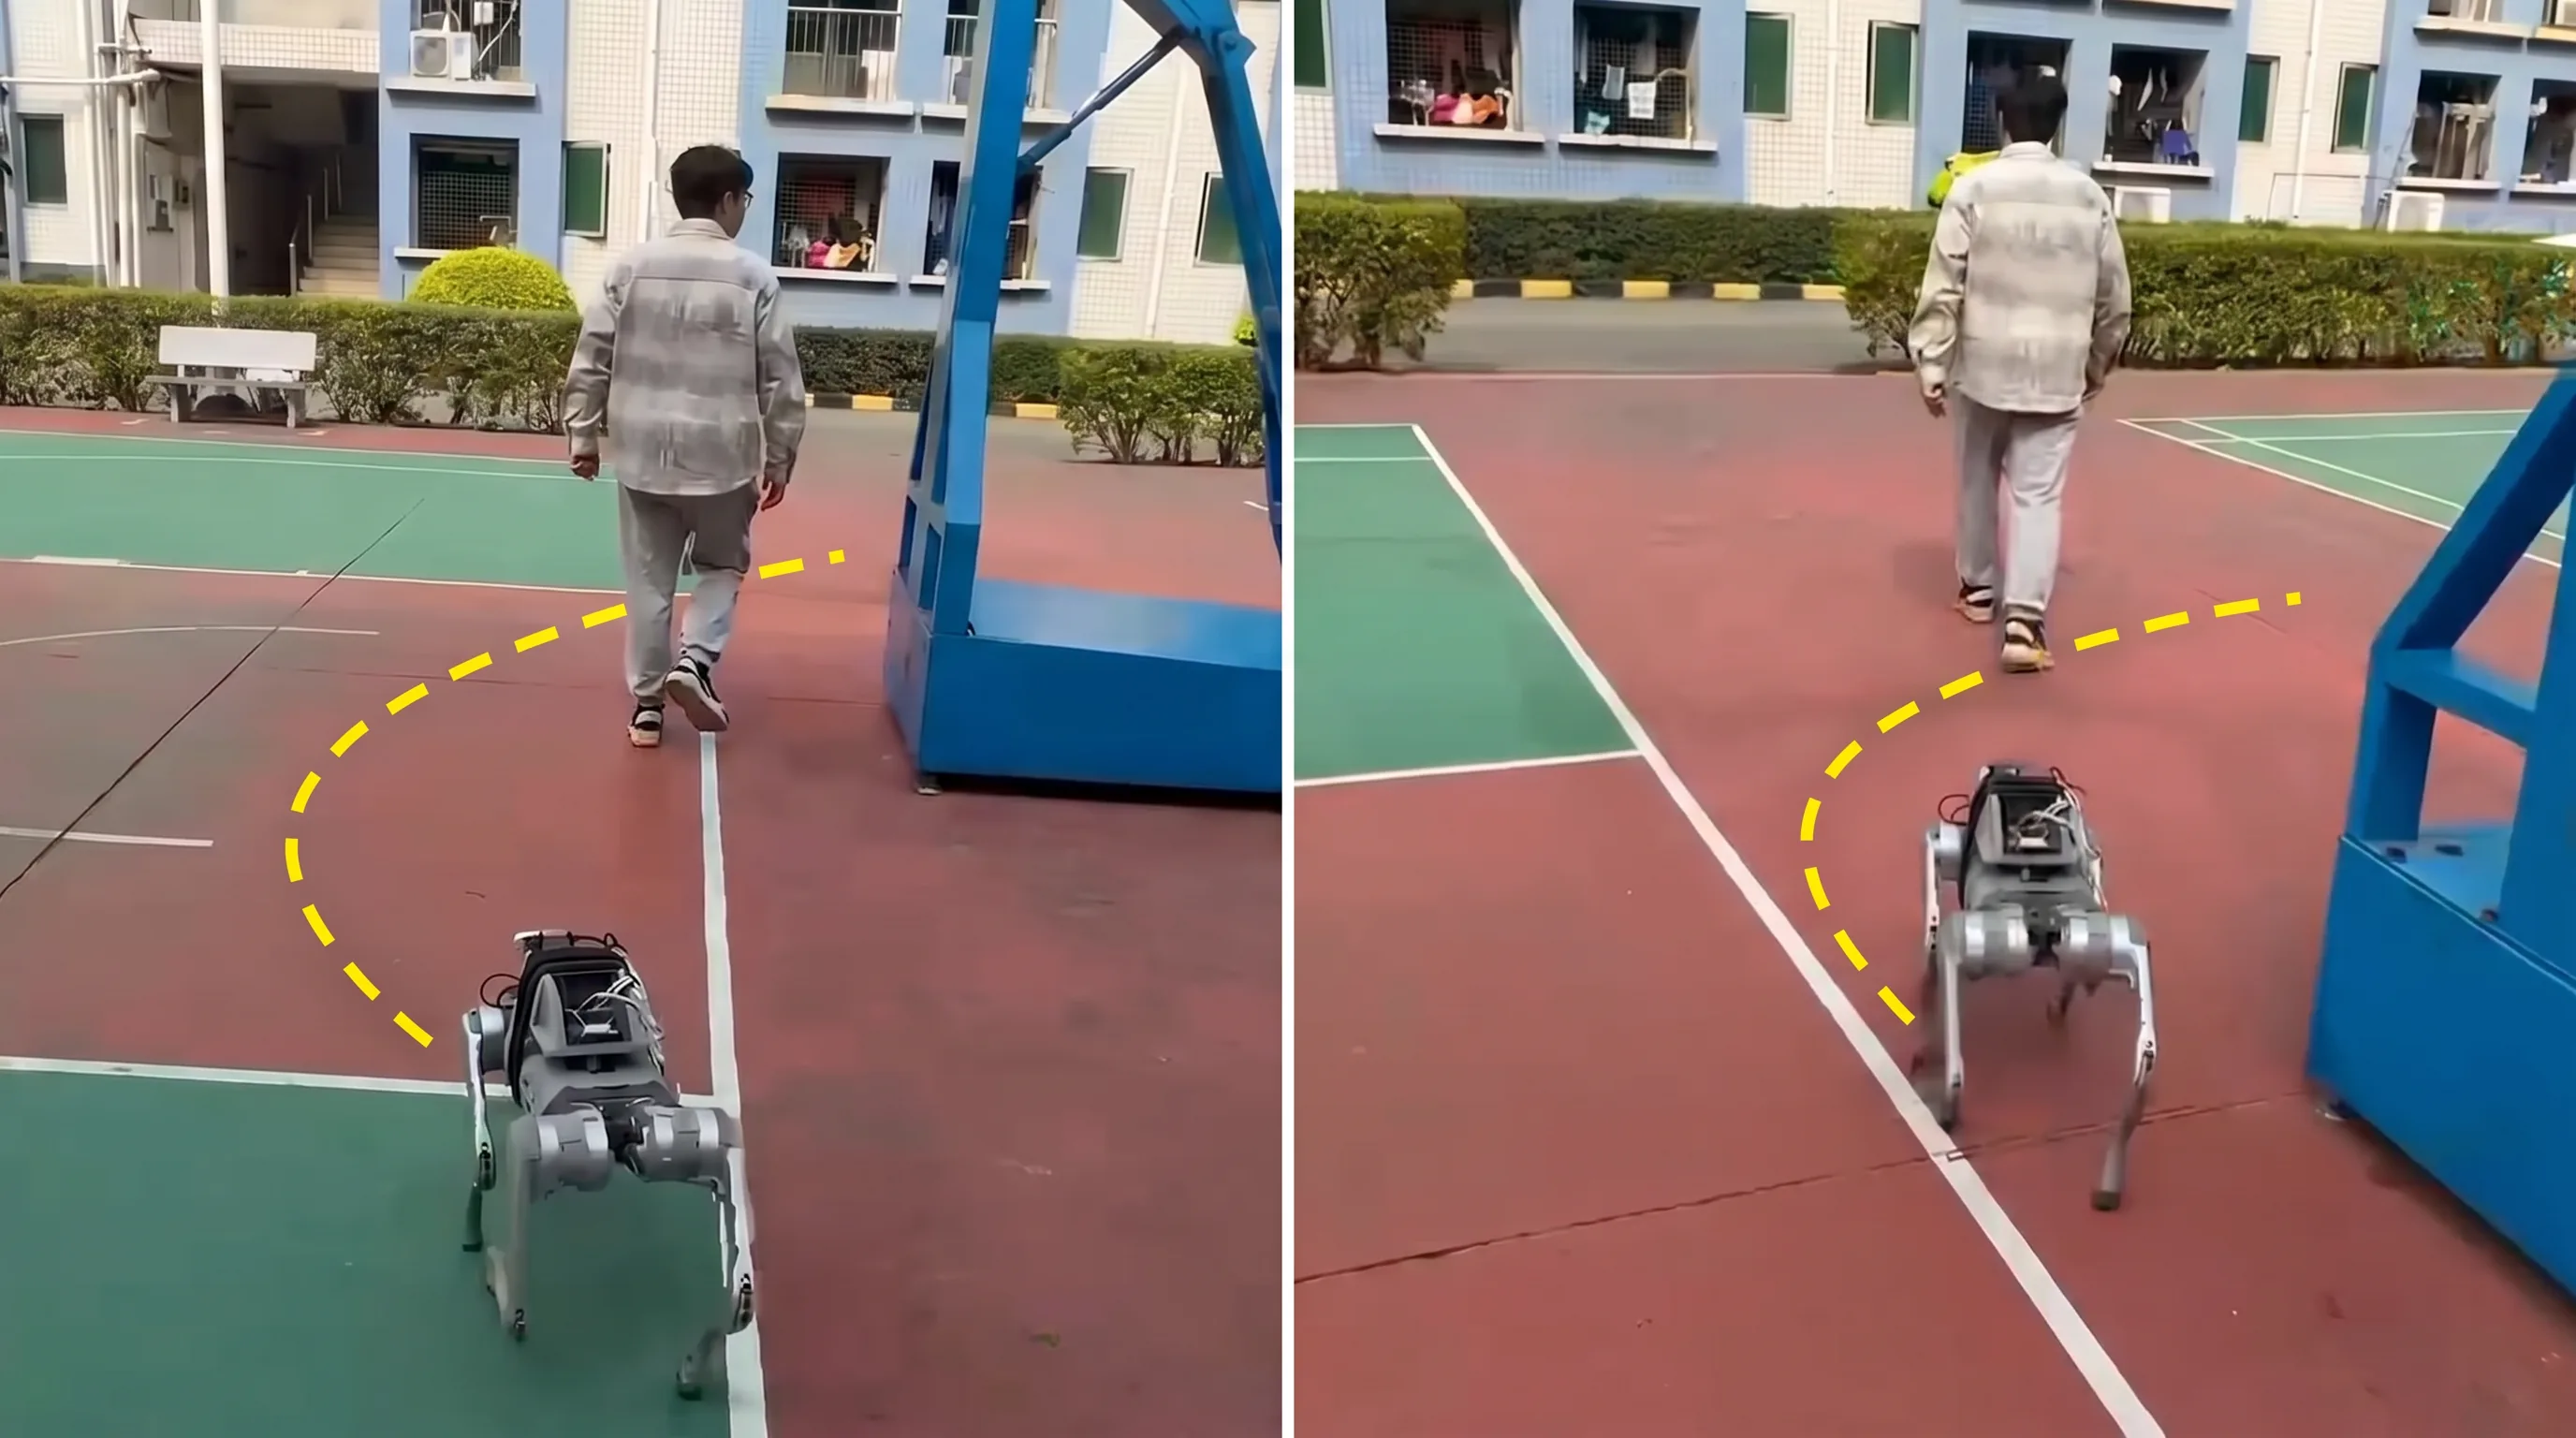
为了验证方法在真实世界中的有效性,团队在 Unitree Go2 四足机器人上进行了部署测试。机器人配备了前向相机用于视觉感知,输入图像经过编码后与 IMU 和关节状态一同输入策略网络。实验环境涵盖了室内杂乱走廊和室外动态园区两类场景,前者包含静止的家具和随机摆放的障碍物,后者则有行人和自行车等移动对象。结果表明,未经任何微调的策略展现出了优秀的零样本 [[sim-to-real迁移]] 能力:在仿真中观察到的碰撞减少现象在真实环境中同样出现,机器人的躲避行为与仿真表现高度一致。这说明训练阶段的预测监督确实编码了具有泛化性的障碍物动态理解,而非仅过拟合于仿真环境的特定噪声或运动模式。
讨论与可借鉴点
这项工作的一个重要启示是[[强化学习]]训练过程中辅助任务设计的威力——不需要改变推理时的架构或计算图,仅通过在训练阶段引入额外的监督信号,就能让原本有限的能力得到显著扩展。这种"训练时增强、推理时精简"的范式为在资源受限的机器人平台上部署复杂能力提供了新思路:模型可以在训练阶段利用丰富的计算资源和辅助信息,而在推理时保持轻量化。
从局限性的角度看,当前方法主要针对固定频率的短时域预测,对于极快速或高度随机的障碍物运动可能仍然面临响应不及时的问题。此外,SIGReg 正则化的具体形式和强度需要针对不同任务进行调参,缺乏一套自动化的选择机制。
对于研究方向的启发,我认为这篇工作提示了[[预测学习]]与[[强化学习]]结合的更多可能性——不只是预测环境动态,还可以探索预测任务相关的中间量(如预测接触事件的发生、预测能量消耗等),让策略在训练阶段就建立对任务关键因素的隐式理解。同时,"训练时预测、推理时遗忘"这一设计哲学也值得在其他需要兼顾性能和实时性的场景中借鉴。
摘要
面向腿足机器人的强化学习导航策略仅根据当前观测与短期记忆反应式地选择动作,难以充分预见移动障碍物在近未来的演化。在动态环境中,这种反应式特性会导致机器人响应过迟,因为碰撞风险取决于短时域场景结构,而非仅取决于当前的障碍物位置。在训练过程中对策略的循环状态施加轻量级的预测监督,可在不修改推理时控制器的前提下编码具有前瞻性的障碍物动力学。我们在一个反应式的 LSTM-SRU 导航骨干网络上增加了一个 JEPA 风格的辅助预测器与 SIGReg 正则化:在训练阶段,预测器对确定性隐藏状态进行监督,以预测其自身的下一时刻状态;在推理阶段,该预测器被完全丢弃,不产生任何额外计算开销。在包含动态障碍物的仿真与真实世界导航基准上,我们的方法仅依靠预测训练信号便显著提高了导航成功率并降低了碰撞率,且未引入任何额外的推理时参数。在 Unitree Go2 真实机器人上的部署验证了零样本的仿真到真实迁移能力:控制器无需微调即可在杂乱的室内环境和动态的室外环境中导航,其规避行为与仿真中观察到的碰撞减少现象保持一致。
Abstract
Reinforcement-learning navigation policies for legged robots select actions reactively from current observations and short-term memory, with limited capacity to anticipate how moving obstacles will evolve in the near future. In dynamic environments, this reactivity causes the robot to respond too late because collision risk depends on short-horizon scene structure rather than on current obstacle positions alone. Lightweight predictive supervision applied to the policy's recurrent state during training can encode anticipatory obstacle dynamics without modifying the inference-time controller. We augment a reactive LSTM-SRU navigation backbone with an auxiliary JEPA-style predictor and SIGReg regularization: during training, the predictor supervises the deterministic hidden state to anticipate its own next state; at inference, it is fully discarded, incurring zero additional computational cost. On simulated and real-world navigation benchmarks with dynamic obstacles, our method substantially improves navigation success while reducing collision rates through the predictive training signal alone, without additional inference-time parameters. Real-robot deployment on a Unitree Go2 demonstrates zero-shot sim-to-real transfer: the controller navigates cluttered indoor and dynamic outdoor environments without fine-tuning, with evasive behavior consistent with the collision reduction observed in simulation.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。