
在实践迁移约束下重新思考强化学习算法的适用性
Rethinking the Suitability of Reinforcement Learning Algorithms Under Practical Transfer Constraints
📝 TLDR
迁移导向强化学习要求算法评估超越样本效率。本文从墙钟时间和动力学失配鲁棒性两个维度出发,在统一迁移协议下对 PPO、SAC、TD-MPC2 进行受控对比。关键发现是:凭借大规模并行训练,样本效率较差的 PPO 在实际训练时间内反而更快产出可用策略;且域随机化覆盖度对三种范式(on-policy、off-policy、model-based)算法的鲁棒性提升作用相近。本文强调并行训练能力与域随机化鲁棒性应纳入 RL 算法实用评估体系。
🧭 速览
迁移导向强化学习场景下,仅以样本效率评判算法适用性,缺乏对训练时间与动力学随机化的实用性考量。
在同一迁移协议下,从墙钟时间预算与域随机化覆盖率两维度,对 PPO、SAC、TD-MPC2 进行受控对比实验。
PPO 借助并行训练在墙钟时间上反超 SAC 与 TD-MPC2;域随机化对三种算法产生相近的鲁棒性增益。
评估迁移导向 RL 算法应综合考虑样本效率、并行训练时间与域随机化下的鲁棒性,而非单一指标。
🆚 方法对比
PPO
- 支持大规模并行仿真,墙钟时间内更快产出可用策略
- 广泛用于sim-to-real迁移流水线
- 从域随机化中受益,提升策略鲁棒性
- 样本效率低,交互次数需求多
- 标准基准上性能通常不如SAC等算法
SAC
- 样本效率高,所需环境交互次数少
- 标准连续控制评估协议下表现强
- 从域随机化中受益,增强鲁棒性
- 并行仿真扩展性较弱
- 墙钟时间下不如大规模并行PPO快
TD-MPC2
- 基于模型学习与规划,样本效率较高
- 标准连续控制基准上性能强
- 从域随机化中受益
- 模型学习引入额外计算开销
- 墙钟时间下可能慢于并行PPO
域随机化(Domain Randomization)
- 提升策略对动力学差异的鲁棒性
- 对on-policy、off-policy和model-based均有益
- 效果受任务、算法和覆盖度共同影响
- 无单一算法获得一致最优优势
本文在统一迁移协议下对比PPO、SAC、TD-MPC2三种不同范式RL算法,发现并行PPO在墙钟时间下反而更快产出可用策略,而三者从域随机化中的受益程度相似,不存在一致性的算法优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
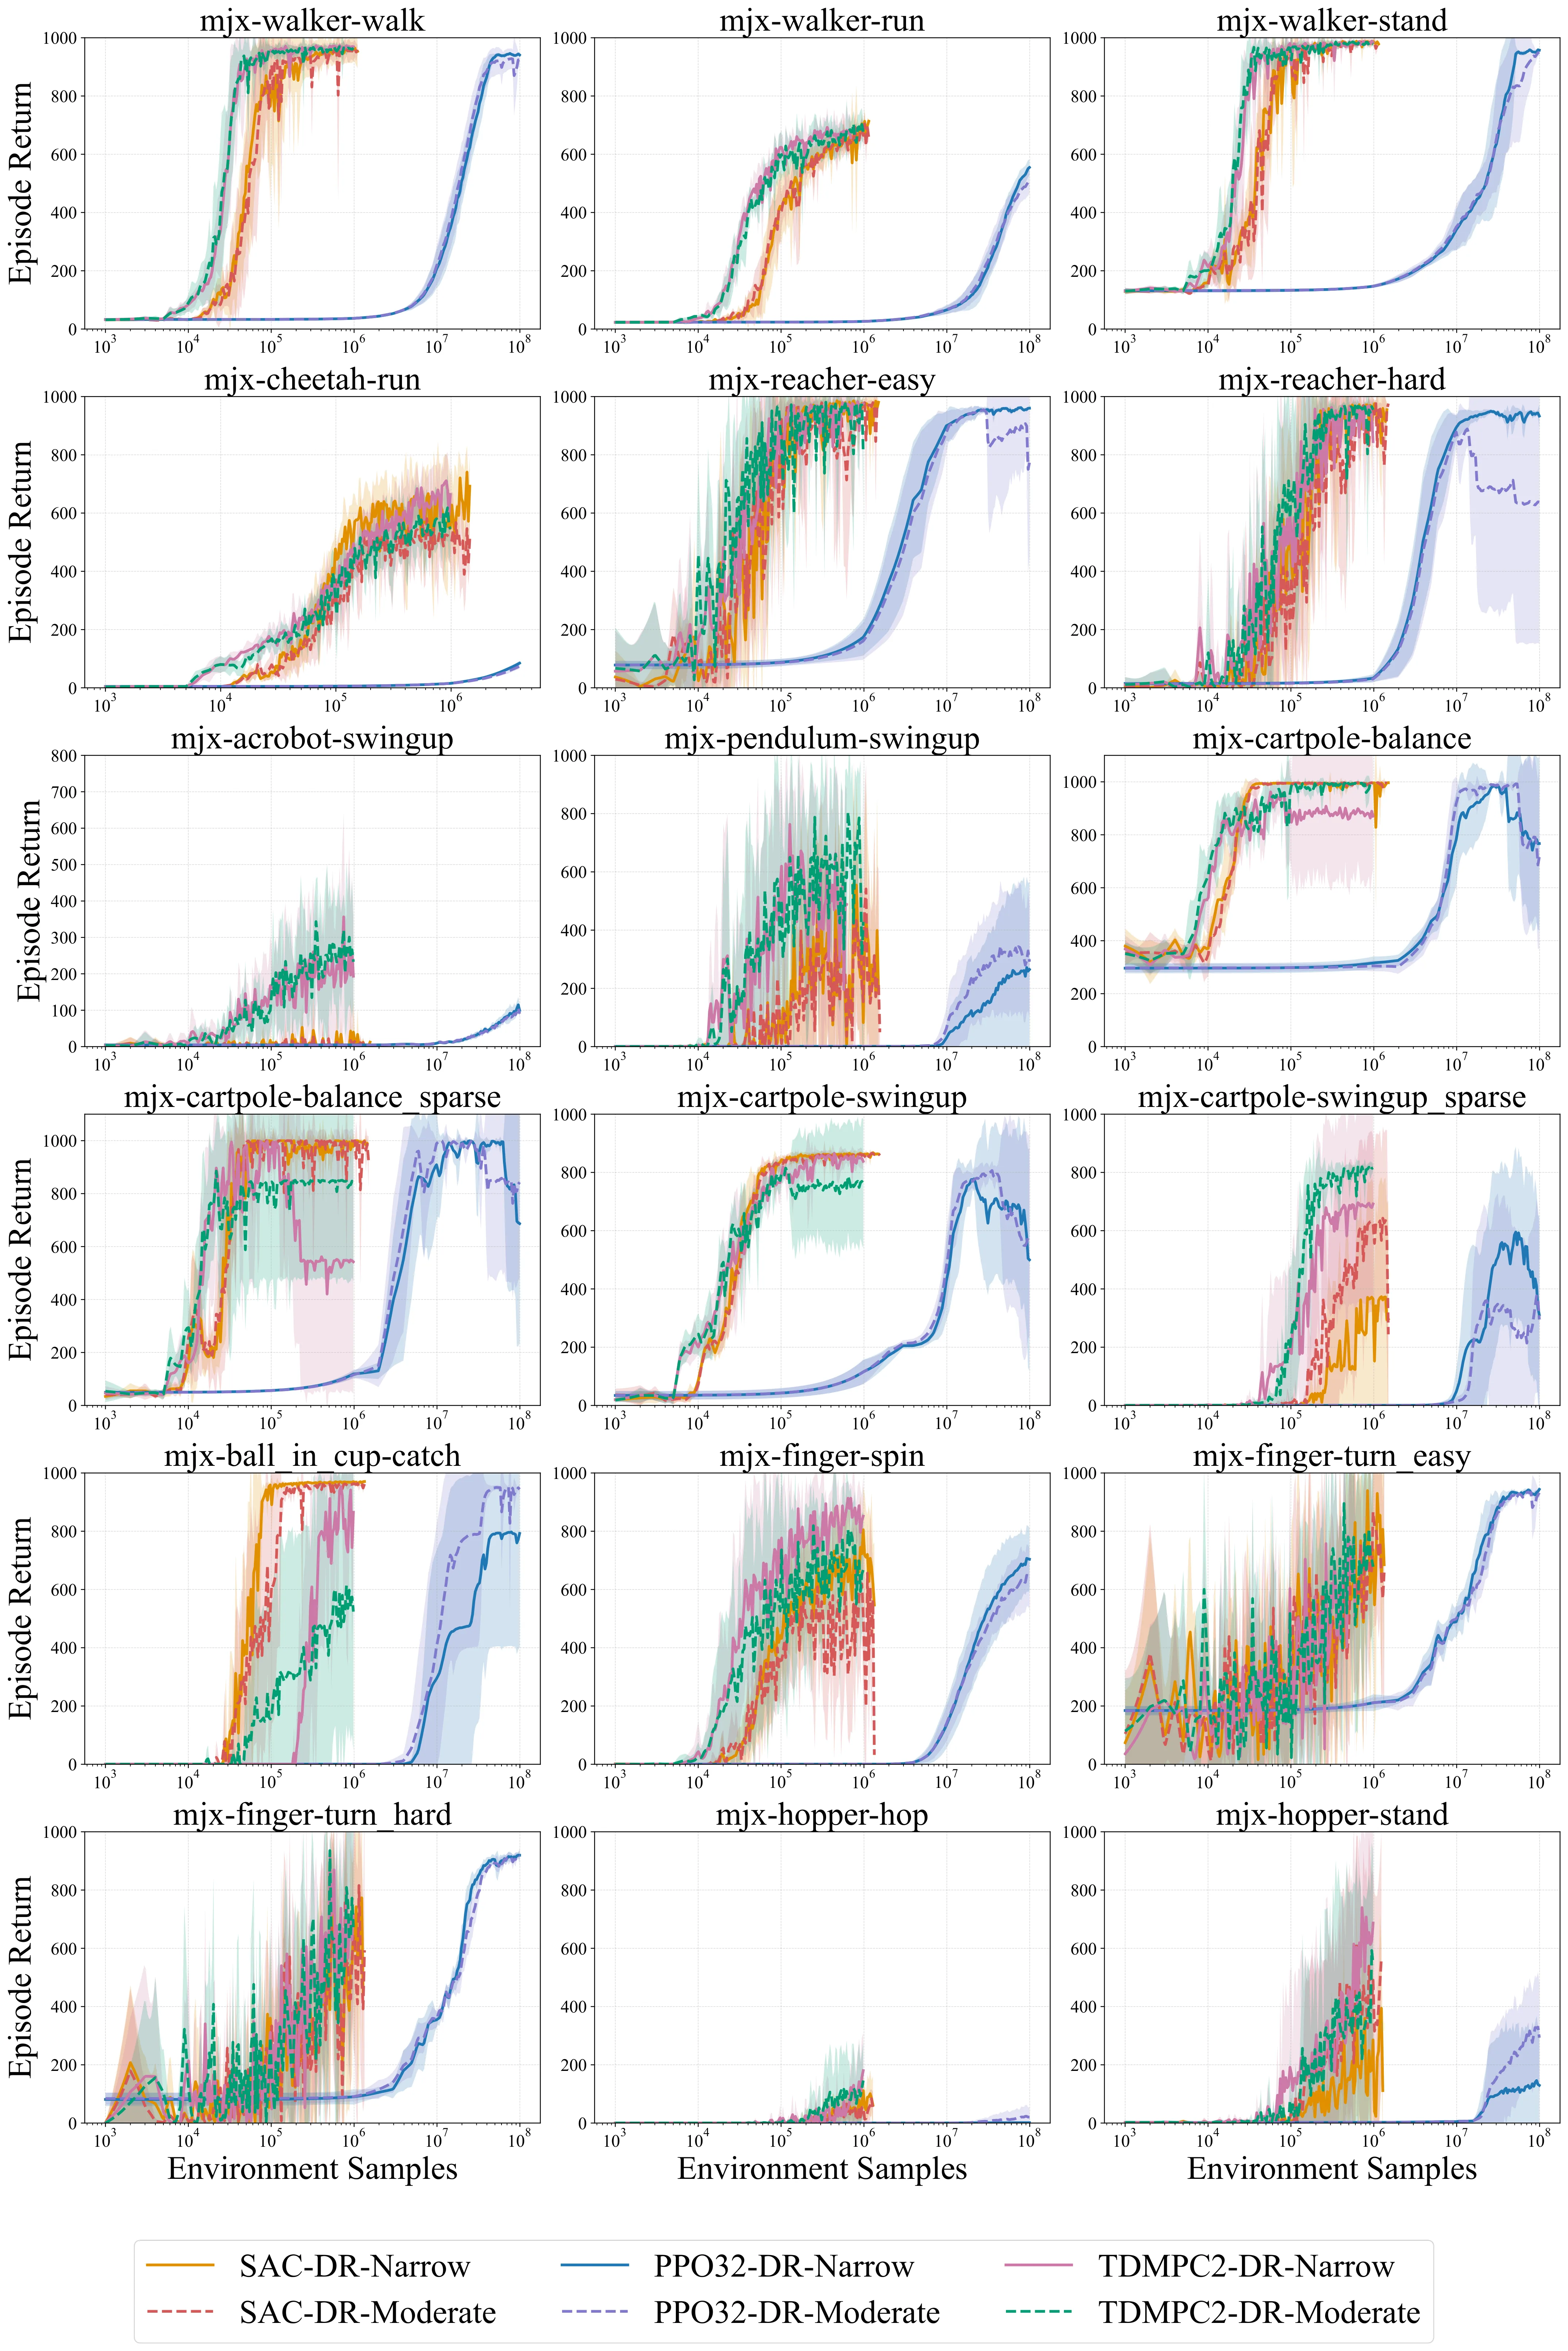
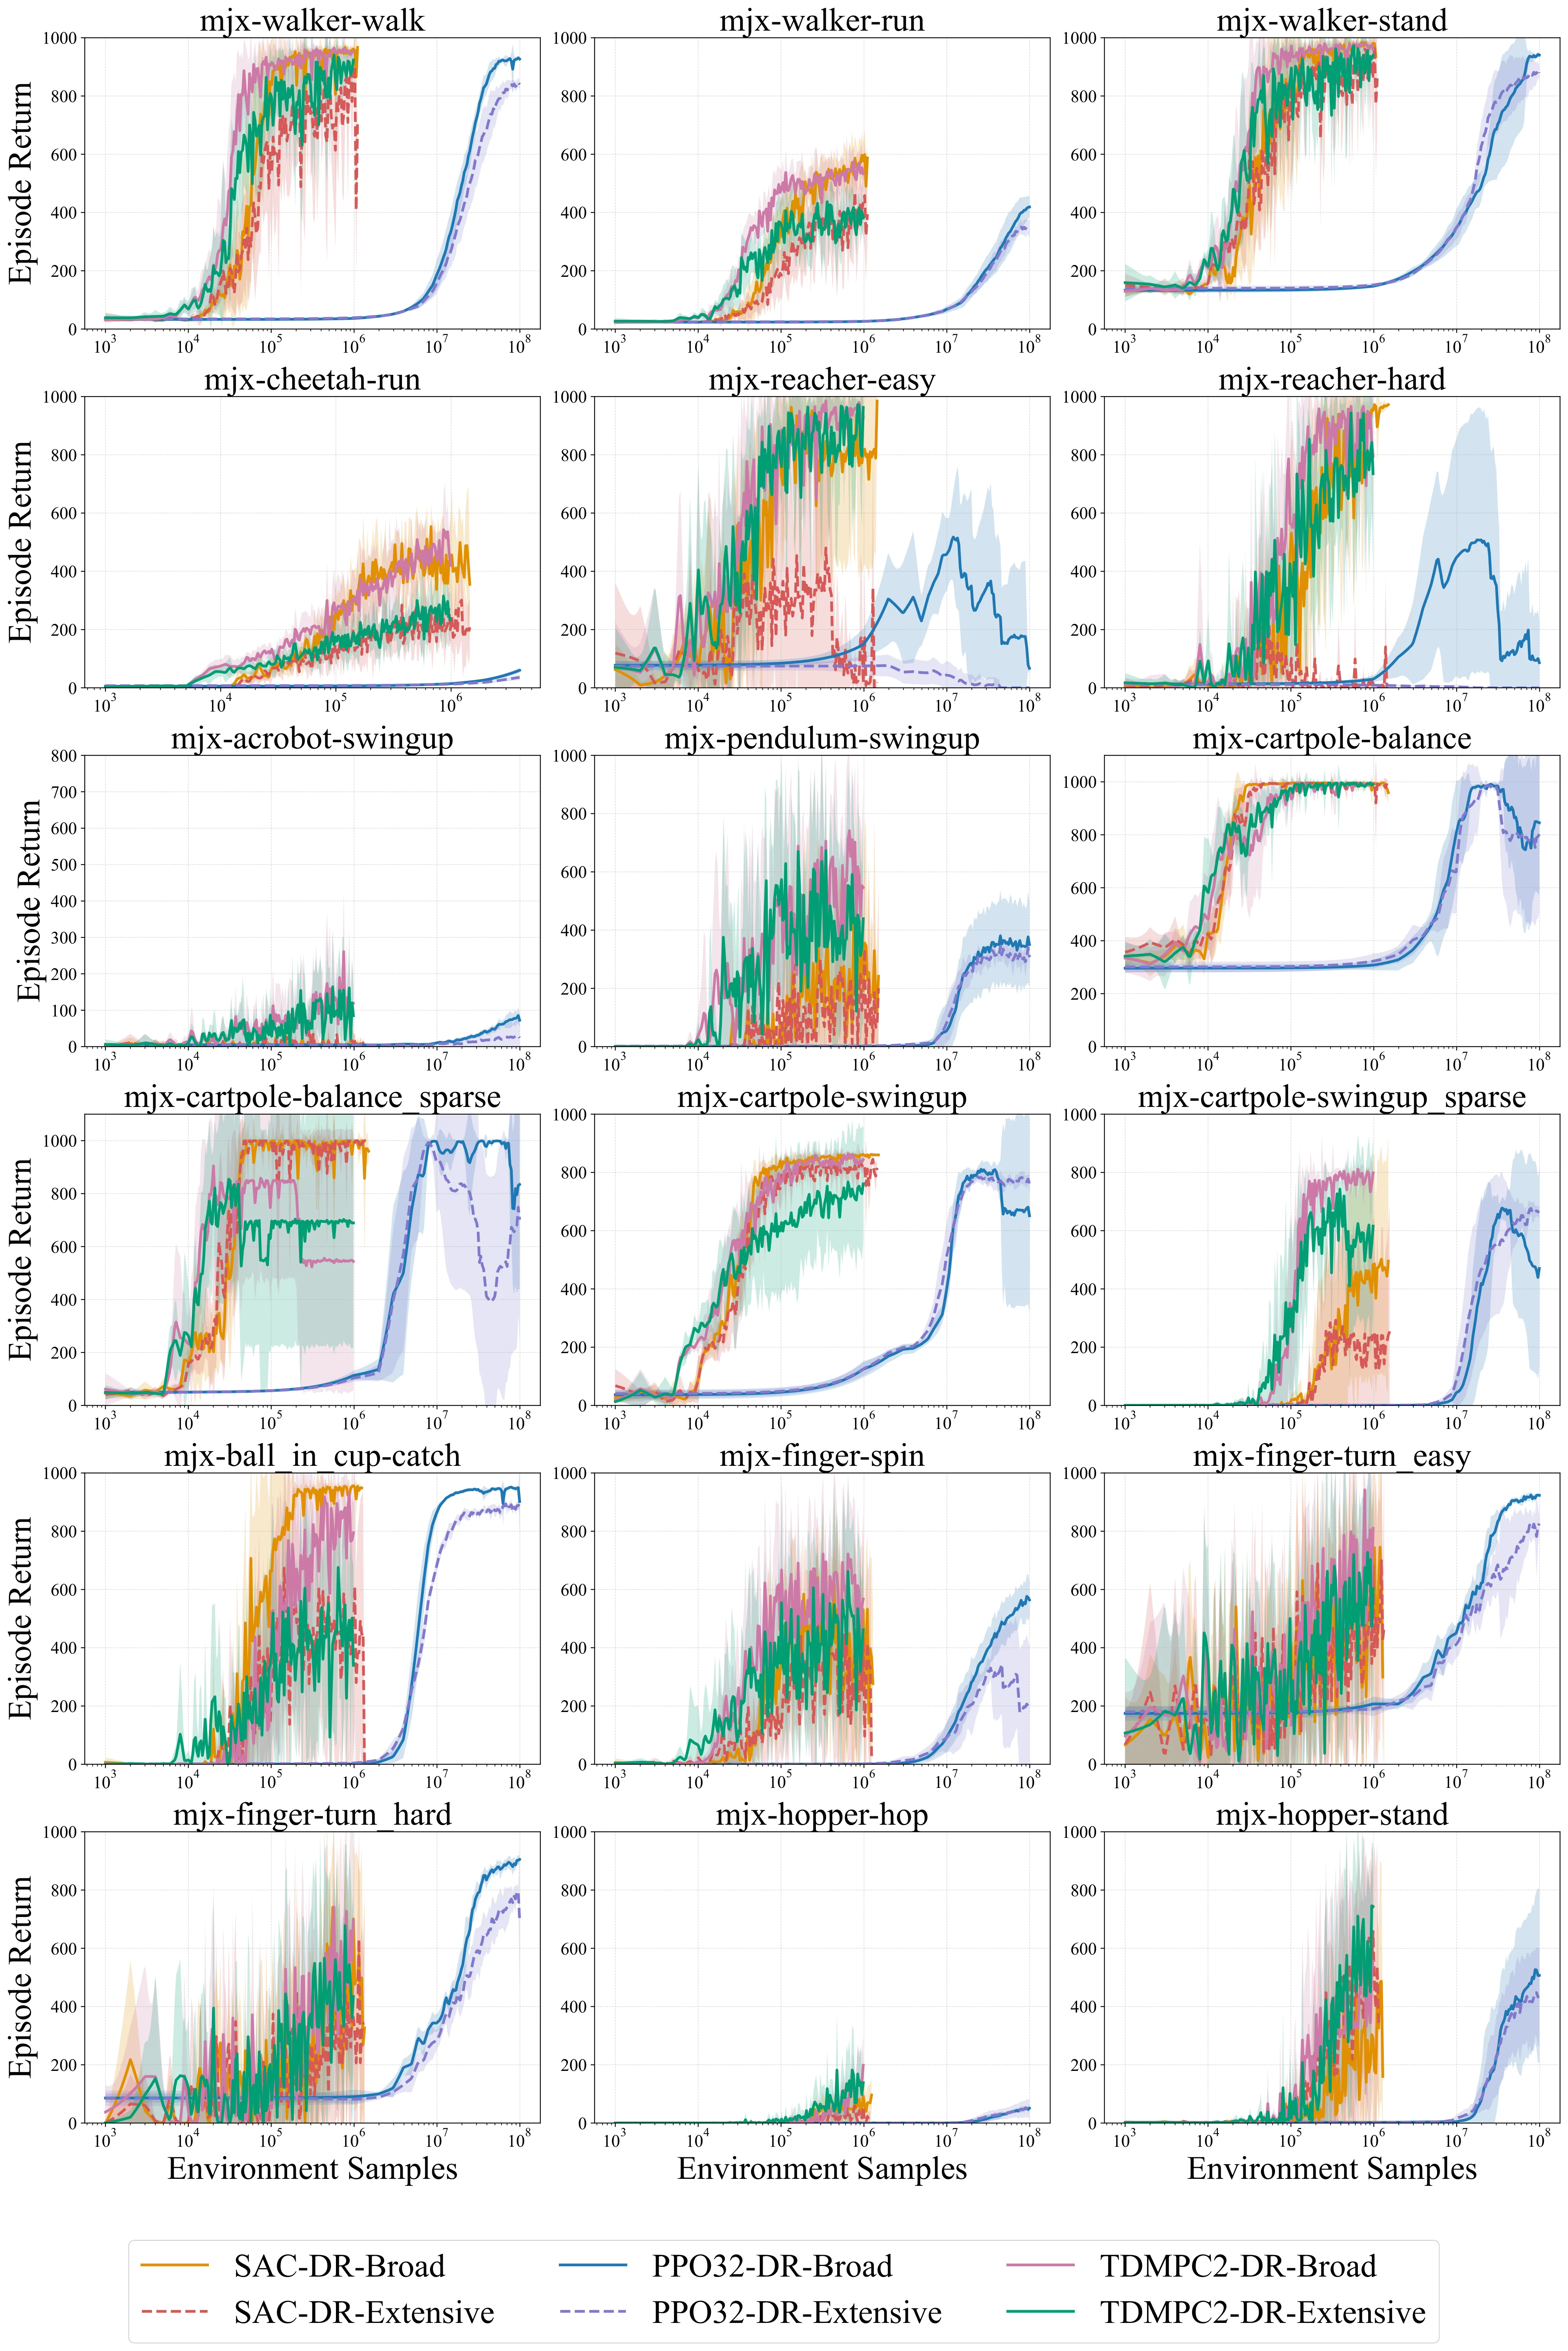
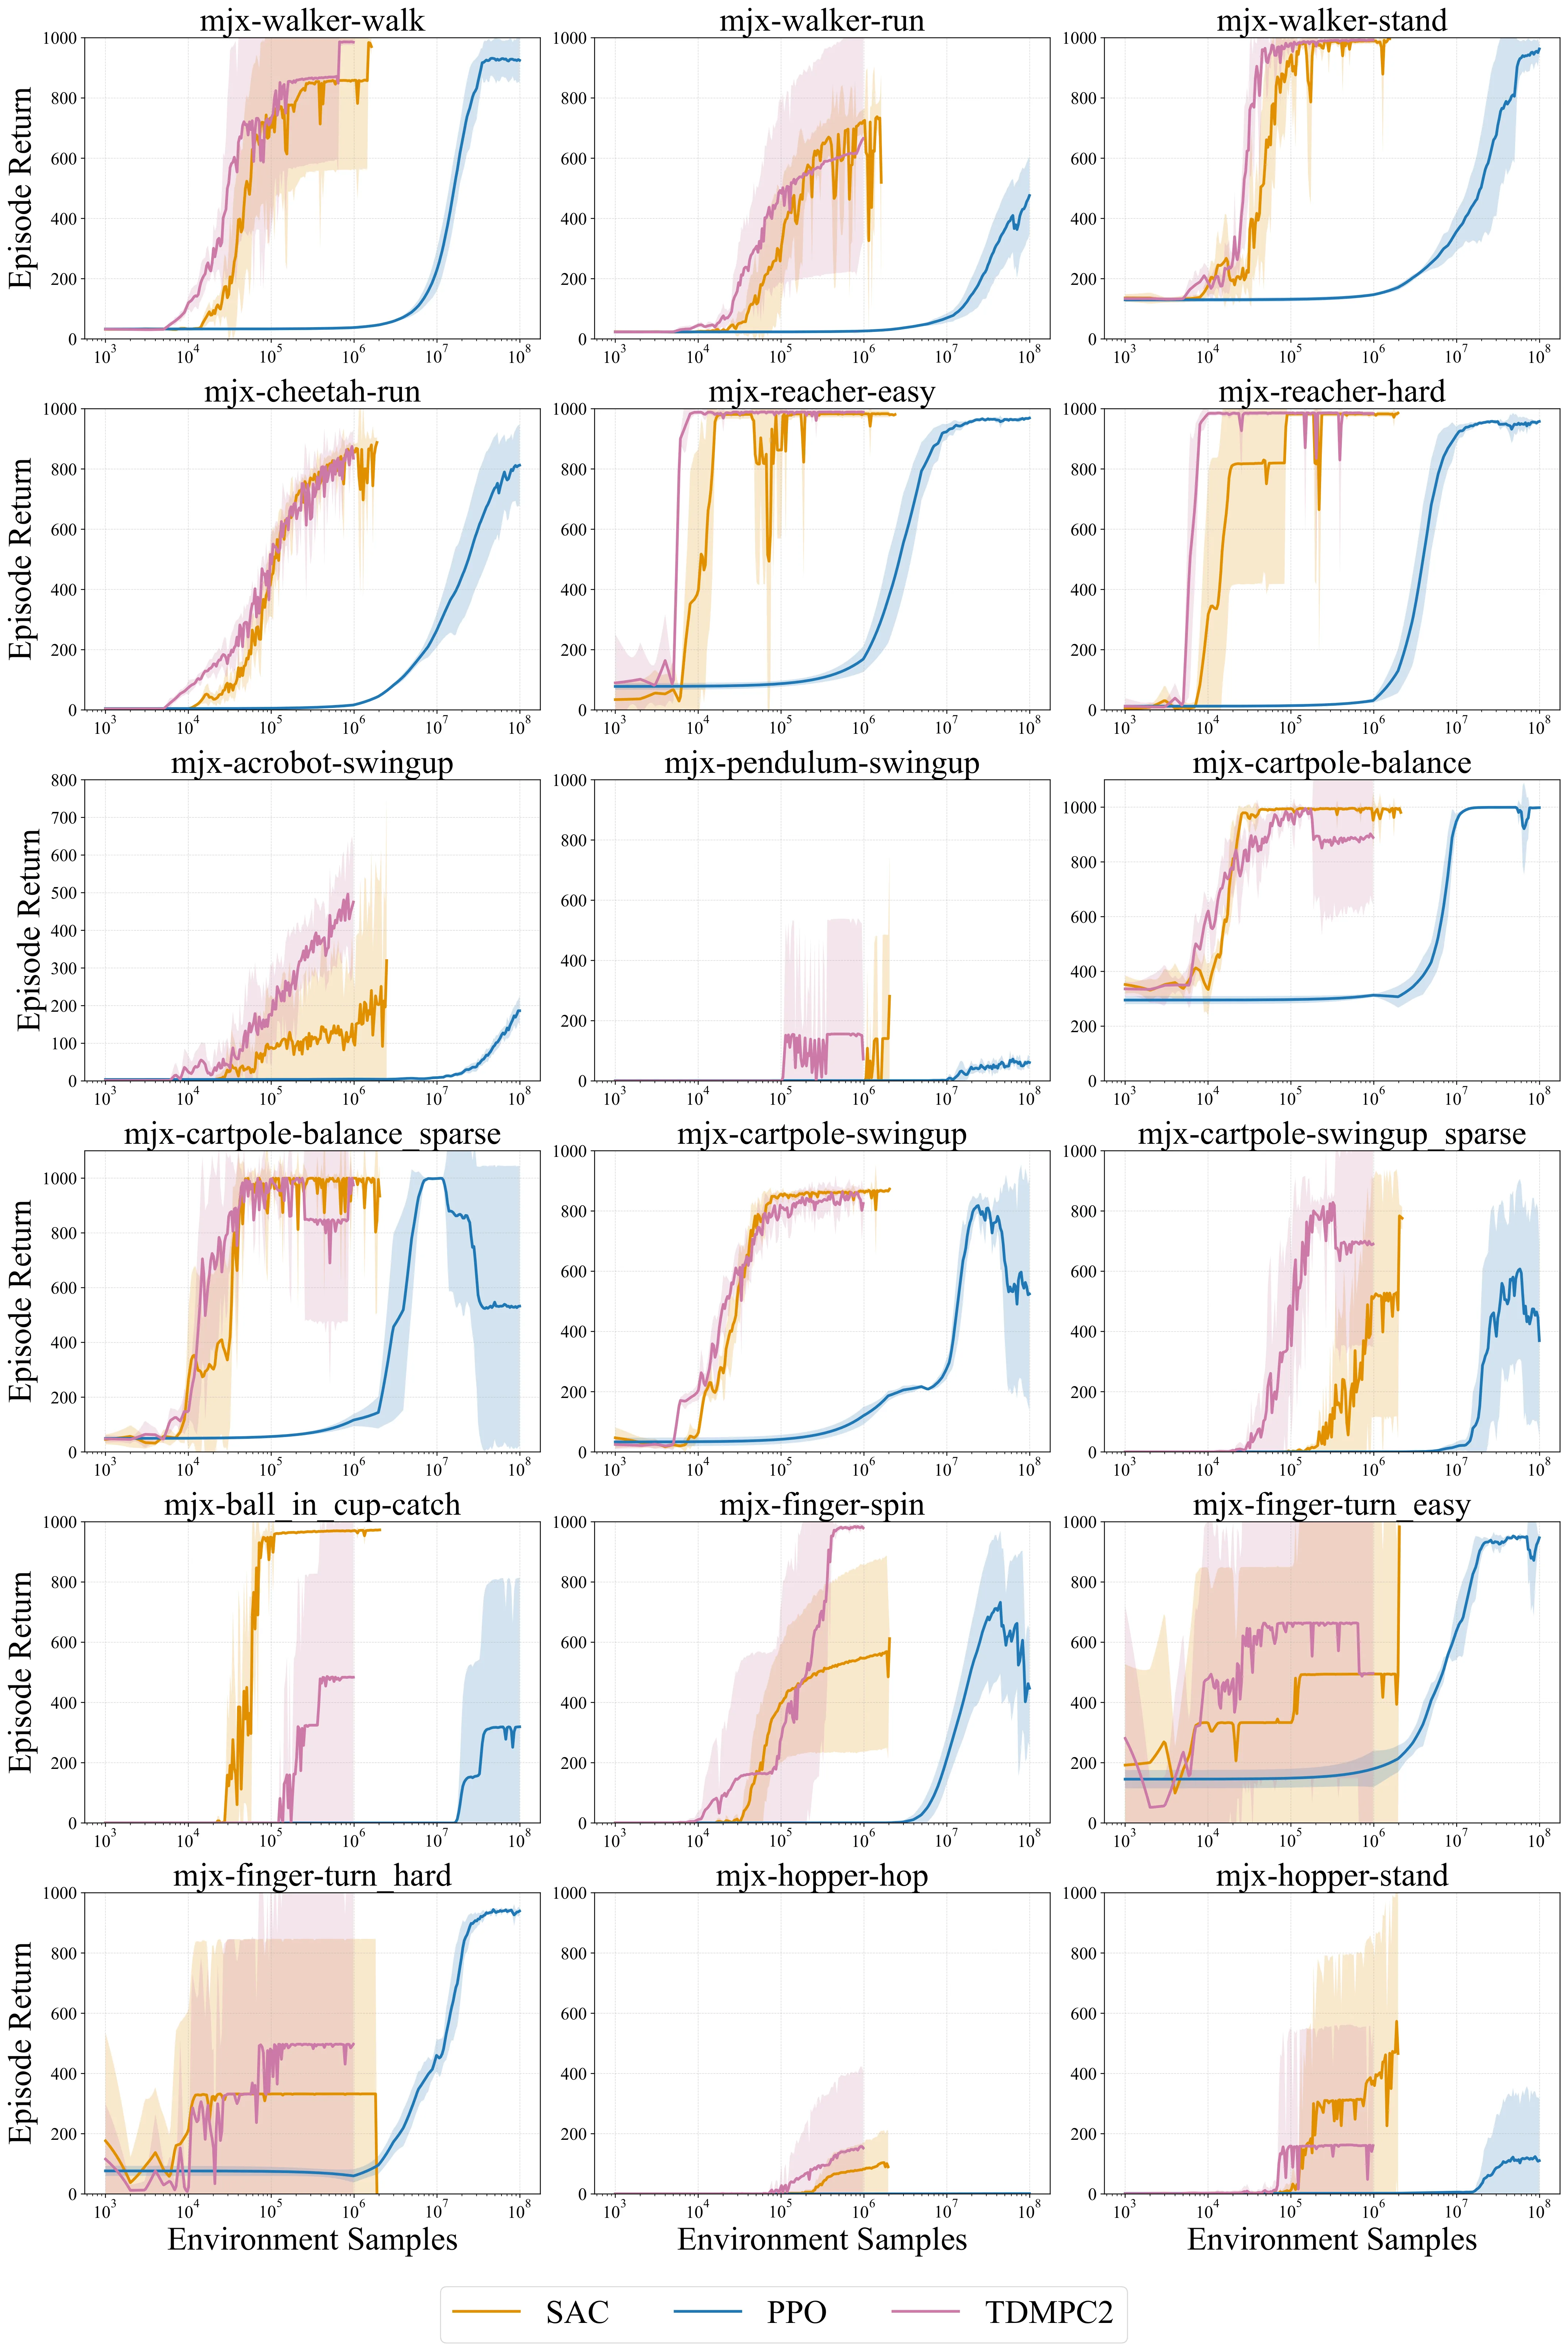
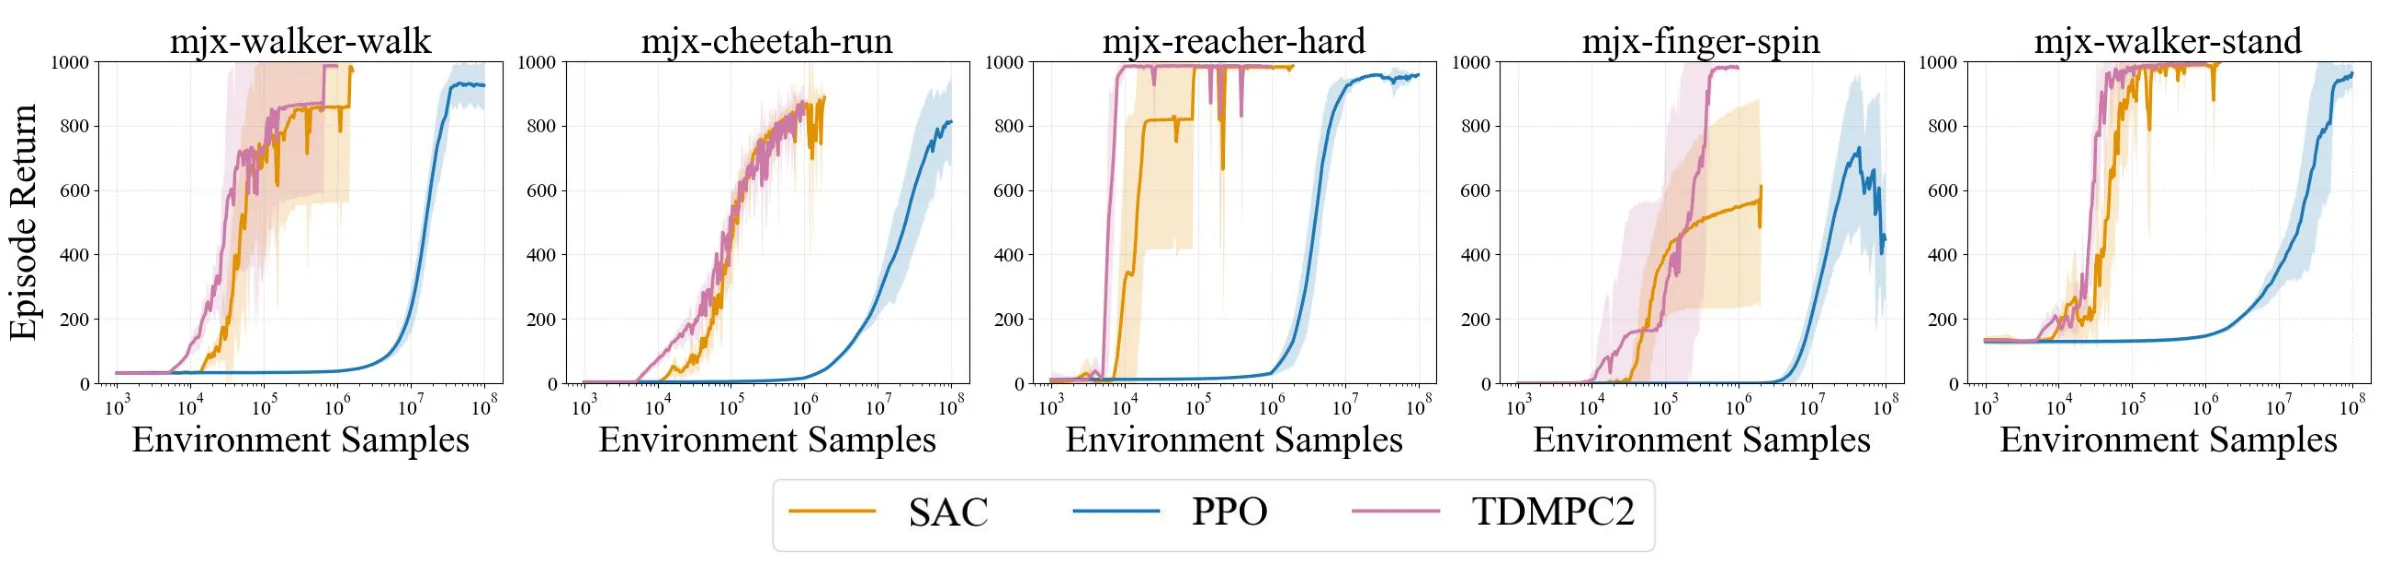
TL;DR
这篇论文在统一的迁移协议下,对 PPO、SAC、TD-MPC2 三种代表不同范式的强化学习算法进行了受控对比,发现了两个对实践者至关重要的结论:其一,当评估指标从传统的「交互步数」换成「实际墙钟时间」时,样本效率较低的 PPO 反而可能更快训练出可用策略,因为其大规模并行训练的优势在真实场景中更为关键;其二,[[域随机化]]对 on-policy、off-policy、model-based 三种范式均能带来相似的鲁棒性提升,不存在某一范式系统性占优的现象。这些发现提醒我们,[[迁移学习]]场景下的算法评估不能只看[[样本效率]],还必须纳入实际训练时间和策略部署的可用性。
研究背景与动机
在强化学习的学术研究中,[[样本效率]]几乎是评估算法的首要指标。社区习惯性地比较「算法用了多少步交互才能学会任务」,并将样本效率更高的方法视为更优的选择。SAC、TD-MPC2 等算法在标准评测协议下表现优异,也因此获得了广泛关注。然而,这些结论往往基于「交互步数」这一评价维度,忽略了现实工程场景中真正起约束作用的因素。
当目光转向 [[sim-to-sim]] 或 [[sim-to-real]] 迁移场景时,问题变得更加复杂。一方面,现代仿真训练管线中,环境交互的成本极低,GPU 上可以同时运行数千个并行环境,真正的瓶颈往往不是「能收集多少样本」,而是「在有限的墙钟时间内能否得到一个可部署的策略」。另一方面,训练环境的动力学参数与真实部署环境之间必然存在差异,如何让策略在 [[动力学失配]] 的情况下依然鲁棒,是迁移成功的关键。
这篇论文的核心动机正是回应这两个现实挑战:评估维度需要从纯粹的样本效率扩展到实践中的墙钟效率,以及对域随机化覆盖度的鲁棒性响应。作者提出了一个关键问题——如果把「算法用了多少秒训练完成」作为评价标准,关于算法优劣的结论是否会发生改变?
方法
论文采用 [[上下文 MDP]](CMDP)作为问题的形式化框架。设环境动力学由潜在上下文变量 参数化,状态转移定义为 。训练时从分布 采样,部署时从 采样。当 时,零样本迁移的性能完全取决于算法对分布外情况的泛化能力。
围绕这一框架,论文设置了两条平行的评估轴线。交互轴关注回报随交互步数的变化,这对应传统的样本效率评价;墙钟时间轴关注回报随实际训练耗时的变化,这反映算法在真实工程约束下的可用性。通过在 GPU 上对各算法进行基准测试,论文将「训练步数」转换为「实际秒数」,从而实现两条轴线的直接对比。
对于 [[域随机化]] 的实验设置,论文定义了五档覆盖度:Nominal(无随机化)、Narrow、Moderate、Broad 和 Extensive。随机化覆盖的质量、阻尼、作动力、摩擦系数、杆长等物理参数,以乘性扰动的方式相对于标称值采样,覆盖范围逐档扩大。评估时则使用两套上下文集合——Nominal-Centered 集合以训练分布的均值附近为主,Shifted 集合则整体偏离训练分布,从而区分「训练分布之内」「训练分布边缘」和「训练分布之外」三种评估场景。
实验中选取的三种算法各具代表性:PPO 作为 [[同策略]](on-policy)算法的代表,采用 2048 个并行环境的大规模并行配置;SAC 作为 [[异策略]](off-policy)算法的代表,使用单环境标准配置;TD-MPC2 作为 [[基于模型]](model-based)算法的代表,同样采用单环境标准配置。这种选择刻意呈现了「算法在各自典型使用形态下的对比」而非「同等算力条件下的对比」,作者在论文中明确指出这正是其实验设计的意图——因为在实践中,从业者通常不会用 PPO 的方式去配置 SAC,也不会用 SAC 的方式去配置 PPO。
实验与结果
实验在 DeepMind Control Suite 的 18 个连续控制任务上进行,包括 walker、cheetah、reacher、acrobot 等经典场景。训练在配备 NVIDIA A100 GPU 的计算节点上完成,总共进行了约 1620 组训练运行(3 算法 × 5 DR 覆盖度 × 18 任务 × 6 种子)。
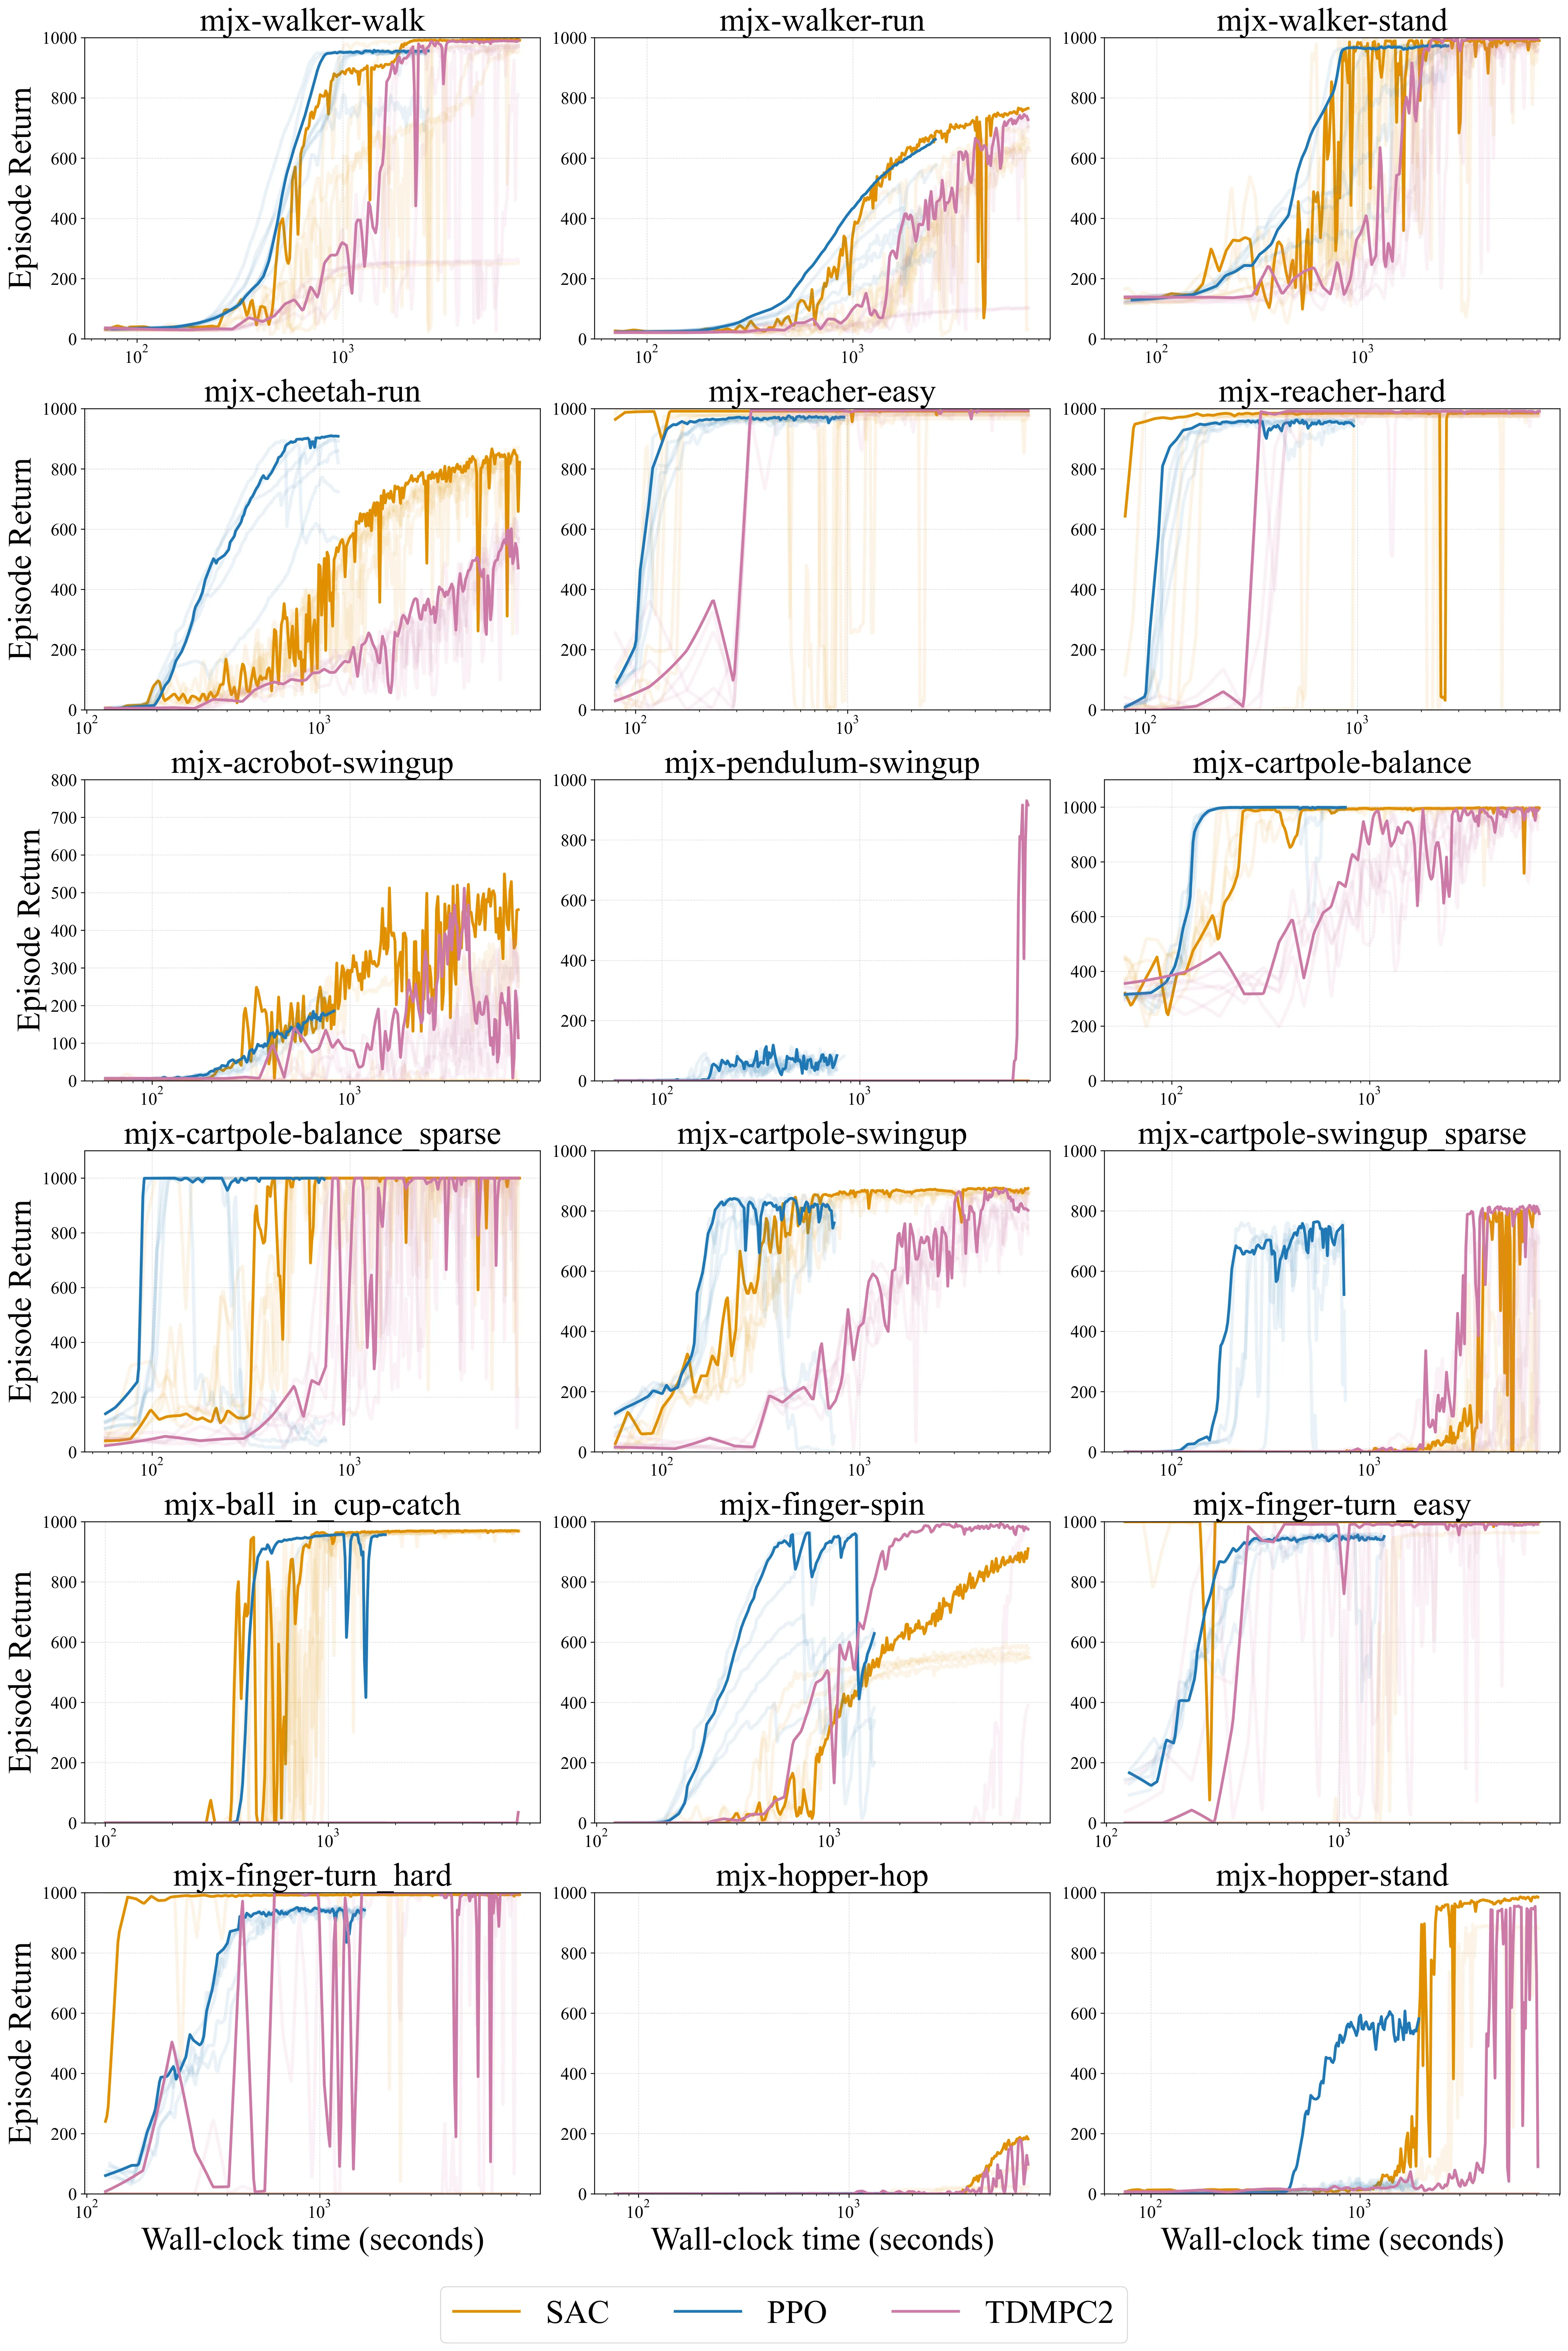
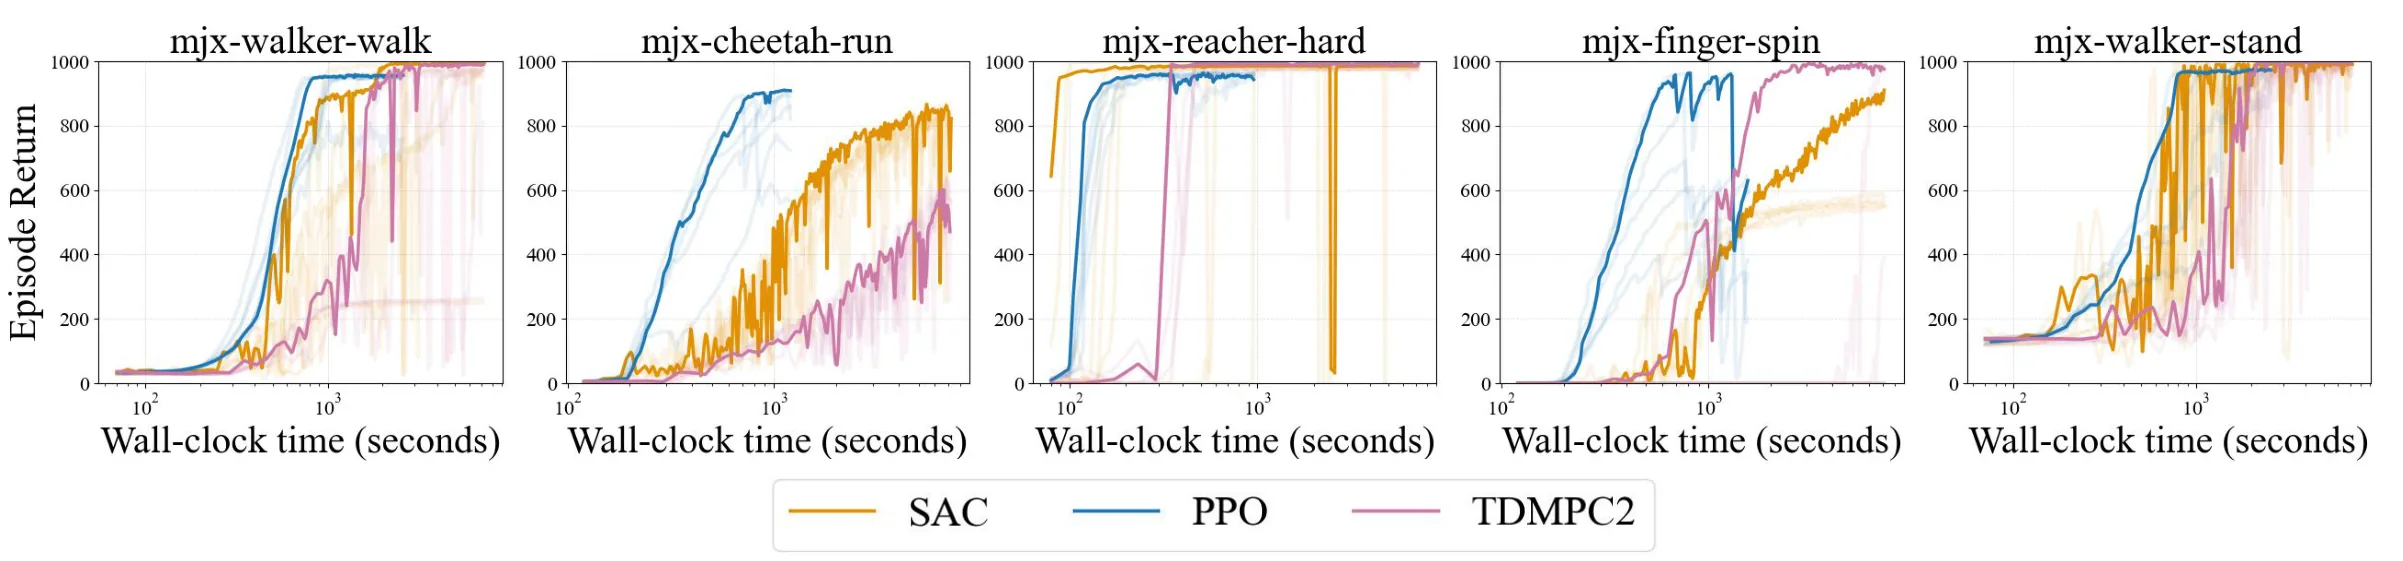
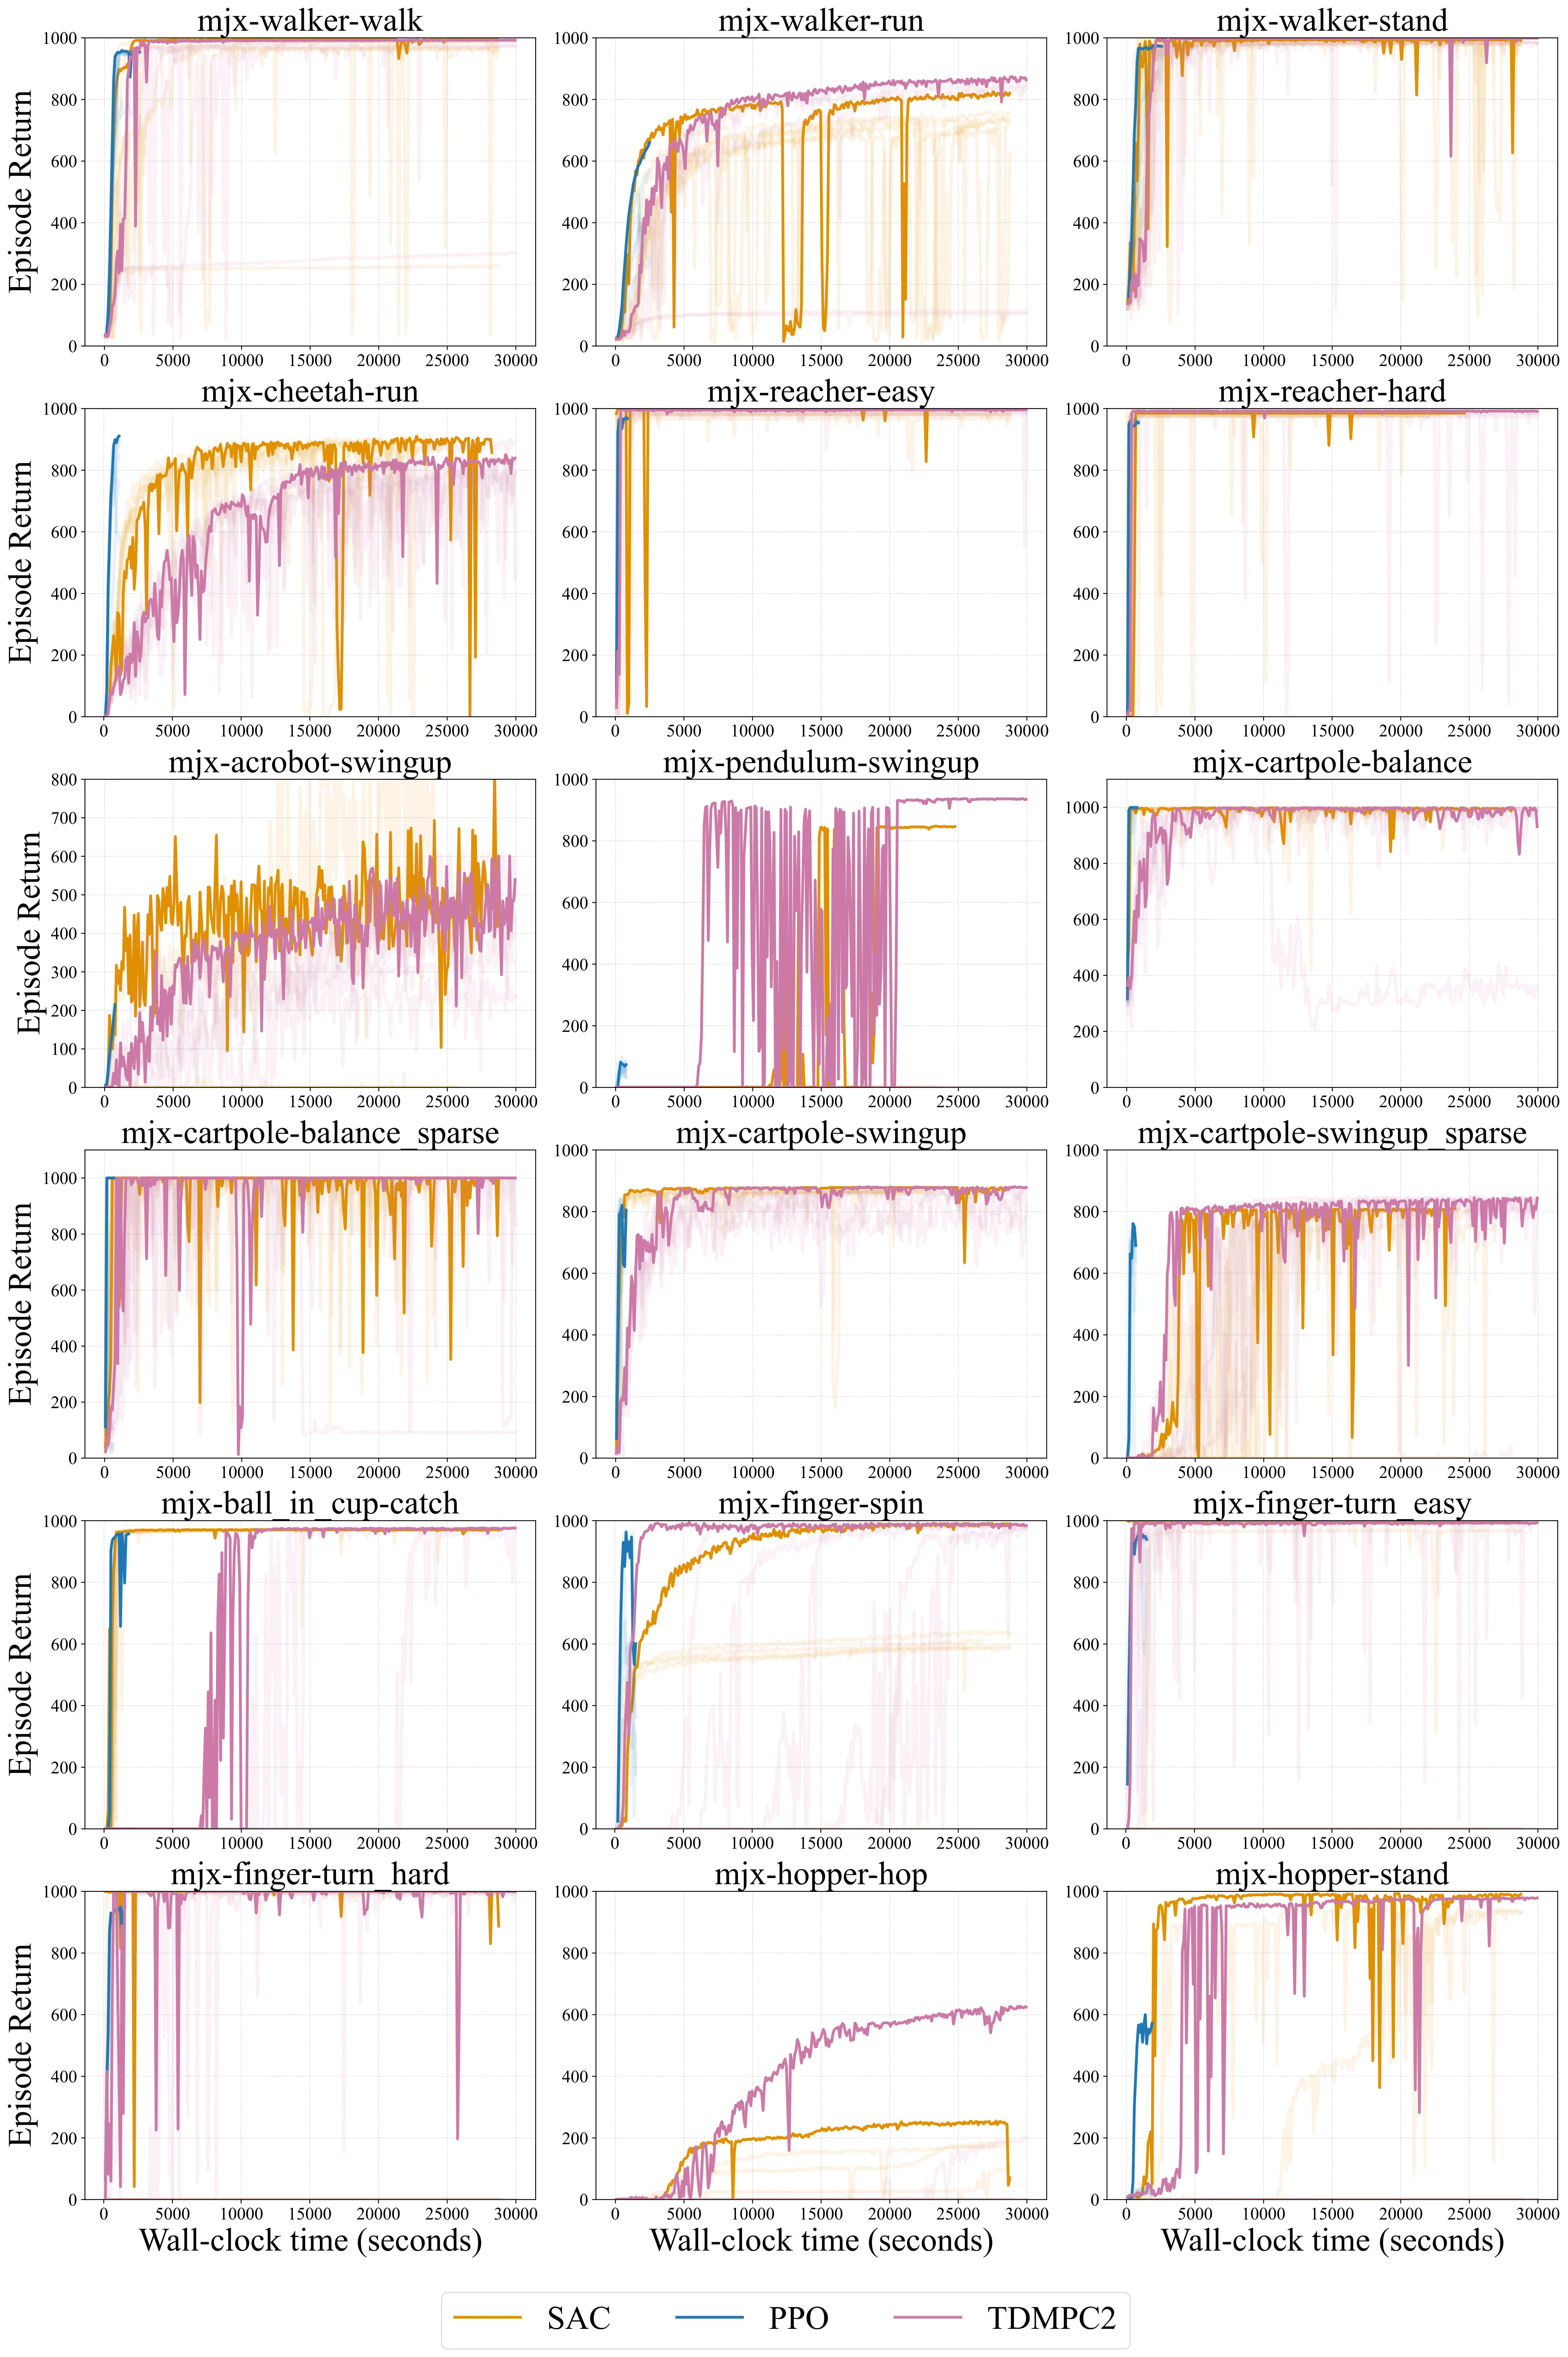
在墙钟时间维度上,结果揭示了一个颇具反直觉的现象:尽管 SAC 和 TD-MPC2 在样本效率上明显领先 PPO,但在实际训练耗时上,PPO 往往能够更早地达到有竞争力的策略性能。以 cheetah-run 和 finger-spin 任务为例,PPO 借助 2048 并行环境,能够在远短于 SAC 和 TD-MPC2 的时间内产出高性能策略。这一发现验证了大规模并行训练范式在实践中的价值:当环境交互成本可忽略时,「并行度 × 单步计算效率」的综合表现比「单步样本利用率」更为关键。
在 [[域随机化]] 维度上,三种算法呈现出高度一致的响应模式。无论采用的是同策略、异策略还是基于模型的方法,适当的随机化覆盖度都能显著提升 [[零样本迁移]] 的鲁棒性。值得注意的是,迁移性能并不随 DR 覆盖度单调提升——当评估上下文超出训练分布支持过多时,过大的随机化范围反而可能稀释策略对核心动力学特征的适应能力。例如,在 walker-walk 和 walker-stand 任务上,DR 对 SAC 的改善尤为显著,而 finger-spin 任务则在 Shifted 评估模式下表现出对 Narrow DR 的特殊敏感性。
综合两条评估轴线的结果,论文的核心建议是:迁移导向的 RL 算法选择应综合考量交互效率、墙钟性能和对动力学失配的鲁棒性,而非单一依赖样本效率指标。
讨论与可借鉴点
这篇论文最为可贵之处在于戳破了强化学习社区一个广泛存在的「学术评价」与「工程实践」之间的错位。样本效率固然重要,但它隐含地假设了「每一步交互的获取成本是均质的且不可忽视的」。然而在现代 GPU 加速的仿真环境中,这一假设往往不成立。当并行度成为可调节的变量时,PPO 所代表的大规模并行范式展现出了独特的工程优势。
论文的局限同样值得坦诚面对。作者在讨论中明确指出,PPO、SAC、TD-MPC2 三者之间的墙钟时间对比建立在「各自典型使用形态」的基础上,而非「同等算力条件」。如果对 SAC 和 TD-MPC2 也施加大规模并行配置,结论是否会逆转,这是一个悬而未决的问题。论文将「并行变体的 SAC、TD-MPC2」列为未来工作的优先方向。此外,实验仅覆盖 sim-to-sim 场景而未涉及真实物理系统的 sim-to-real 验证,以及仅考虑零样本迁移而未探索少样本或在线适应方案,这些都是可以延伸的研究方向。
对于正在进行迁移导向 RL 研究或工程实践的从业者而言,论文的启发是明确的:在设定评估协议时,应该明确报告墙钟时间这一实践维度;在选择算法时,应该根据实际的并行计算资源和时间预算进行权衡,而非机械地套用样本效率排行榜;在设计域随机化策略时,不必将过多精力放在「哪种 RL 范式更适合域随机化」这一问题上,因为现有证据表明三种范式对此的响应是大致相当的,真正的挑战在于如何为具体任务选取恰当的随机化覆盖范围。
摘要
面向迁移的强化学习要求在超越标准样本效率的多个维度上对算法进行评估。我们关注两个维度:实践效率,即在基于实际时钟时间而非交互次数的预算下,关于算法适用性的结论是否会发生变化;以及动力学失配下的鲁棒性,即不同的学习范式如何响应由域随机化所引入的训练分布的变异性。我们为强化学习从业者提供两点见解。首先,在面向迁移的场景中,比较不同算法的样本效率通常是一个不充分的评估标准。训练一个可用策略所需的实际时钟时间是实践者考虑的重要因素。我们发现,样本效率较低的PPO算法能够比相对样本效率更高的SAC和TD-MPC2等算法更快地生成高性能策略,这验证了关于大规模并行训练范式的普遍认识。其次,域随机化有助于不同类型的算法学习鲁棒策略。具体而言,尽管PPO、SAC和TD-MPC2分别代表了不同的强化学习范式——同策略、异策略以及基于模型的学习与规划——我们发现域随机化以相似的方式影响这三种算法。据我们所知,这是首次在相同的迁移协议下对域随机化覆盖范围对PPO、SAC和TD-MPC2的影响进行受控比较。综合来看,这两点见解强调了评估强化学习算法时不仅应关注样本效率,还应考虑实际因素,例如训练时间以及算法生成可用策略的能力。
Abstract
Transfer-oriented reinforcement learning requires evaluating algorithms along dimensions that go beyond standard sample efficiency. We focus on two dimensions: practical efficiency, which asks whether conclusions about algorithm suitability change under wall-clock rather than interaction-based budgets, and robustness under dynamics mismatch, which asks how different learning paradigms respond to variability in the training distribution induced by domain randomization. We provide two insights to reinforcement-learning practitioners. First, comparing the sample efficiency of different algorithms is often an insufficient criterion in transfer-oriented settings. The wall-clock time required to train a decent policy is an important consideration for practitioners, and we find that the sample-inefficient PPO algorithm can produce a performant policy faster than relatively more sample-efficient algorithms such as SAC and TD-MPC2, validating the common understanding of massively parallel training paradigms. Second, domain randomization can help different kinds of algorithms learn robust policies. In particular, although PPO, SAC, and TD-MPC2 represent different RL paradigms - on-policy, off-policy, and model-based learning and planning, respectively - we find that domain randomization affects all three algorithms in a similar way. To the best of our knowledge, this is the first controlled comparison of the effect of domain-randomization coverage on PPO, SAC, and TD-MPC2 under the same transfer protocol. Taken together, these two insights highlight the importance of evaluating RL algorithms not only by sample efficiency, but also by practical considerations such as training time and the algorithms' ability to produce usable policies.
论文详细总结(自动生成)
论文总结:在实践迁移约束下重新思考强化学习算法的适用性
1. 核心问题与整体含义(研究动机与背景)
在连续控制领域,SAC 与 TD-MPC2 等算法在基于交互次数(interaction-based)的标准评估协议下表现出色,强化学习社区普遍以样本效率作为算法优劣的核心度量。然而,在 sim-to-sim 与 sim-to-real 等迁移导向的应用场景中,仅靠样本效率不足以评判算法适用性,因为:
- 实践效率:现代仿真训练管线中环境交互成本低、可大规模并行生成,而墙钟时间(wall-clock time)才是真正的运营约束。开发者关心能否在有限时间预算内获得可用策略。
- 动力学失配鲁棒性:部署环境动力学往往与训练环境存在差异,域随机化(Domain Randomization, DR)是常用的迁移手段,但其对不同学习范式(on-policy / off-policy / model-based)的影响尚无系统性比较。
论文提出两个核心问题:
1. 当评估基于墙钟时间而非交互次数时,算法适用性的结论是否改变?
2. 不同学习范式对域随机化覆盖率的增加是否会产生不同的响应?
2. 方法论:核心思想、关键技术与公式
2.1 问题形式化:上下文 MDP(CMDP)
设环境动力学由潜在上下文变量 参数化,状态转移定义为:
训练时上下文从分布 采样,部署时从 采样。零样本迁移即在 时直接将训练策略部署到 上。
2.2 两条评估轴线
- 交互轴(interaction-based):回报关于交互步数的函数,反映传统样本效率。
- 墙钟时间轴(wall-clock):回报关于训练实际耗时的函数,反映可用性。
2.3 训练分布与评估分布关系(Table 1)
论文通过 5 档 DR 覆盖度(Nominal / Narrow / Moderate / Broad / Extensive)和 2 种评估模式(Nominal-Centered / Shifted),将评估上下文与 的关系划分为 in-support、out-of-support、partially out-of-support,从而显式建模"训练分布的构造如何影响零样本泛化"。
2.4 域随机化参数化(Table A.1)
对质量、阻尼、作动力、摩擦、杆长等参数以乘性方式相对标称值采样,覆盖范围逐档扩大(如质量从 扩展到 )。
2.5 算法实现
- SAC:采用 CleanRL 单环境参考实现;
- TD-MPC2:使用作者官方代码库;
- PPO:采用 Brax 实现,配置 2048 个并行环境。
3. 实验设计
3.1 基准与场景
- 任务:DeepMind Control Suite(DMC)的 18 个连续控制任务(walker、cheetah、reacher、acrobot、pendulum、cartpole、ball_in_cup、finger、hopper 等),通过 MuJoCo XLA(MJX)实现。
- 评估协议:零样本 sim-to-sim 迁移,使用两套固定评估集(Nominal-Centered 与 Shifted),每套 15 个评估上下文,跨算法与训练配置复用。
3.2 对比方法
- PPO(on-policy,2048 并行)
- SAC(off-policy,单环境标准配置)
- TD-MPC2(model-based + planning,单环境标准配置)
并比较 5 档域随机化覆盖率:无 DR / Narrow / Moderate / Broad / Extensive。
3.3 评估指标
- 交互轴:6 个种子的均值 ± 标准差;
- 墙钟轴:每个种子绘制完整曲线,并按学习曲线累积回报排名选取最佳运行;
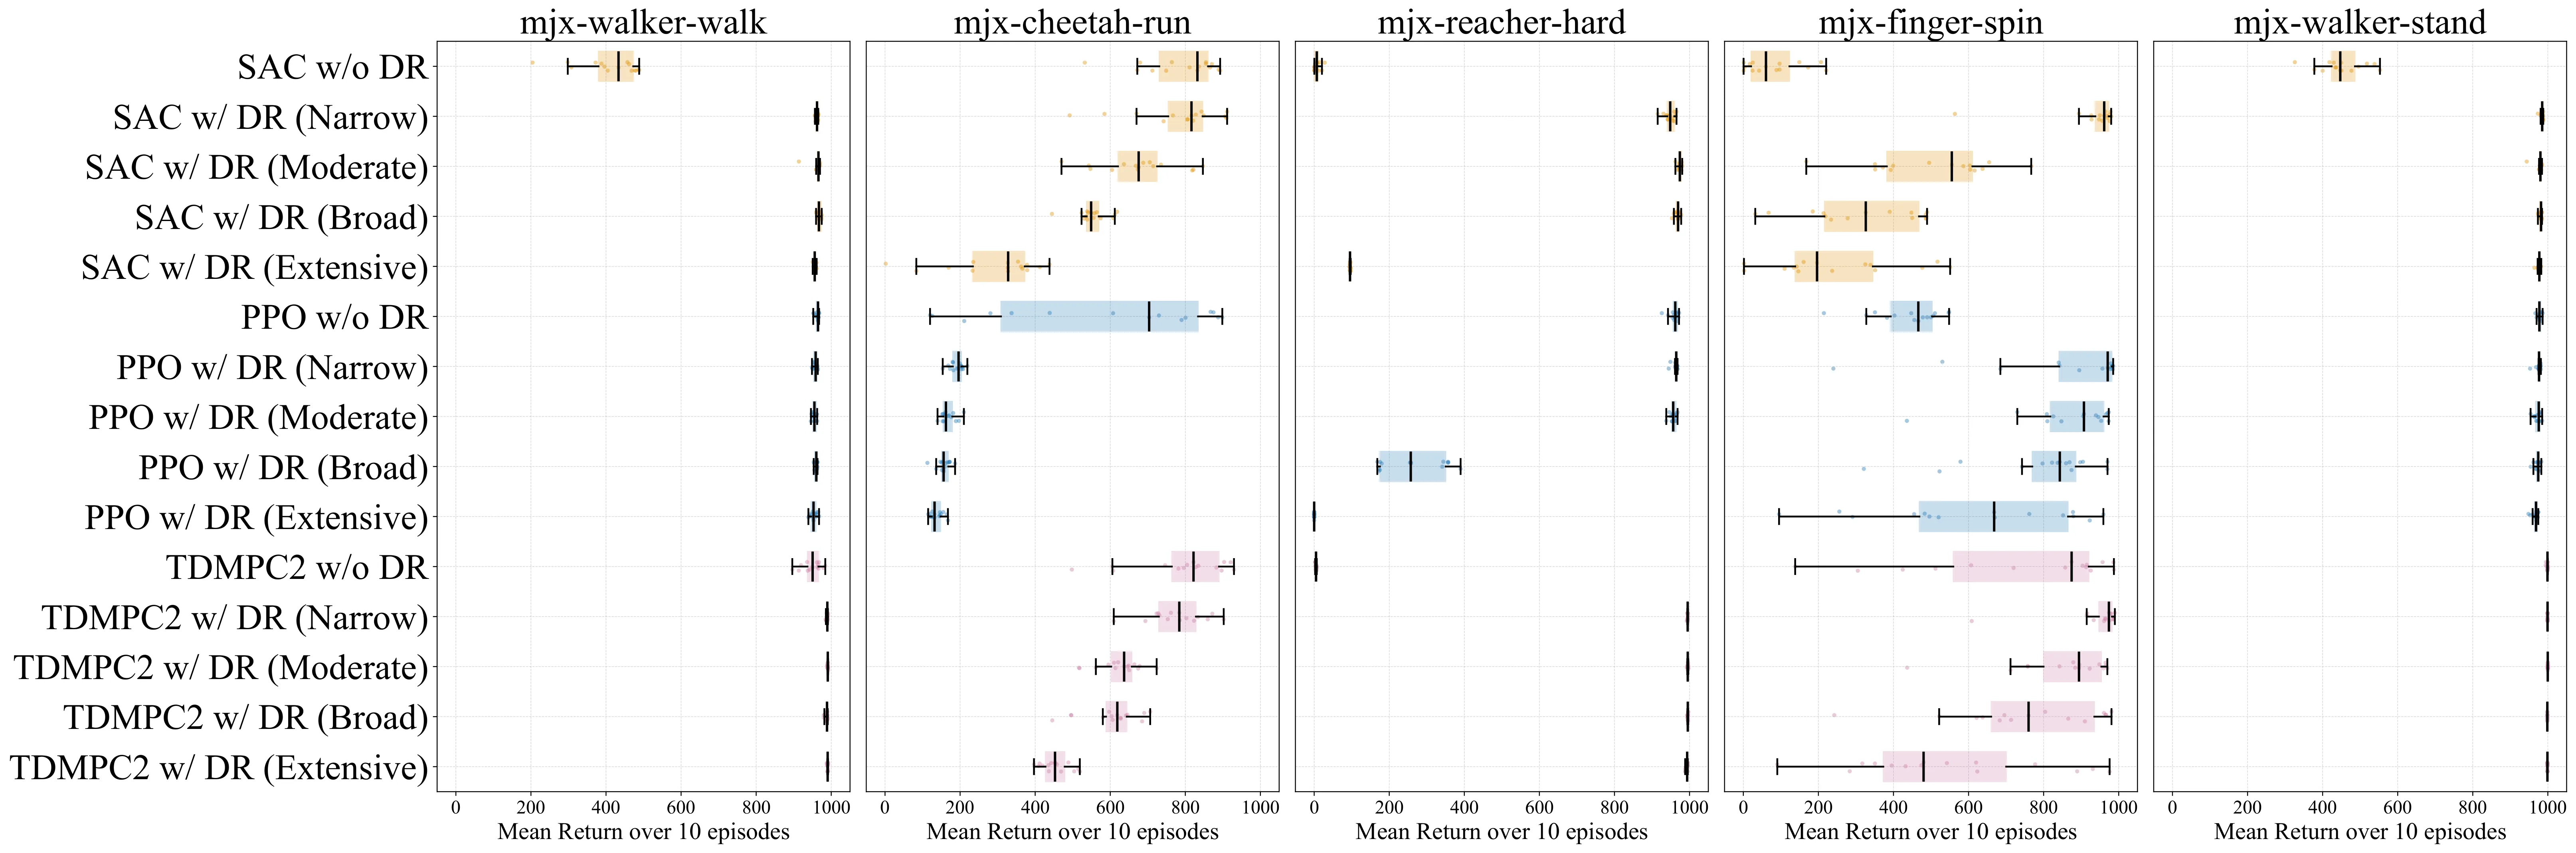
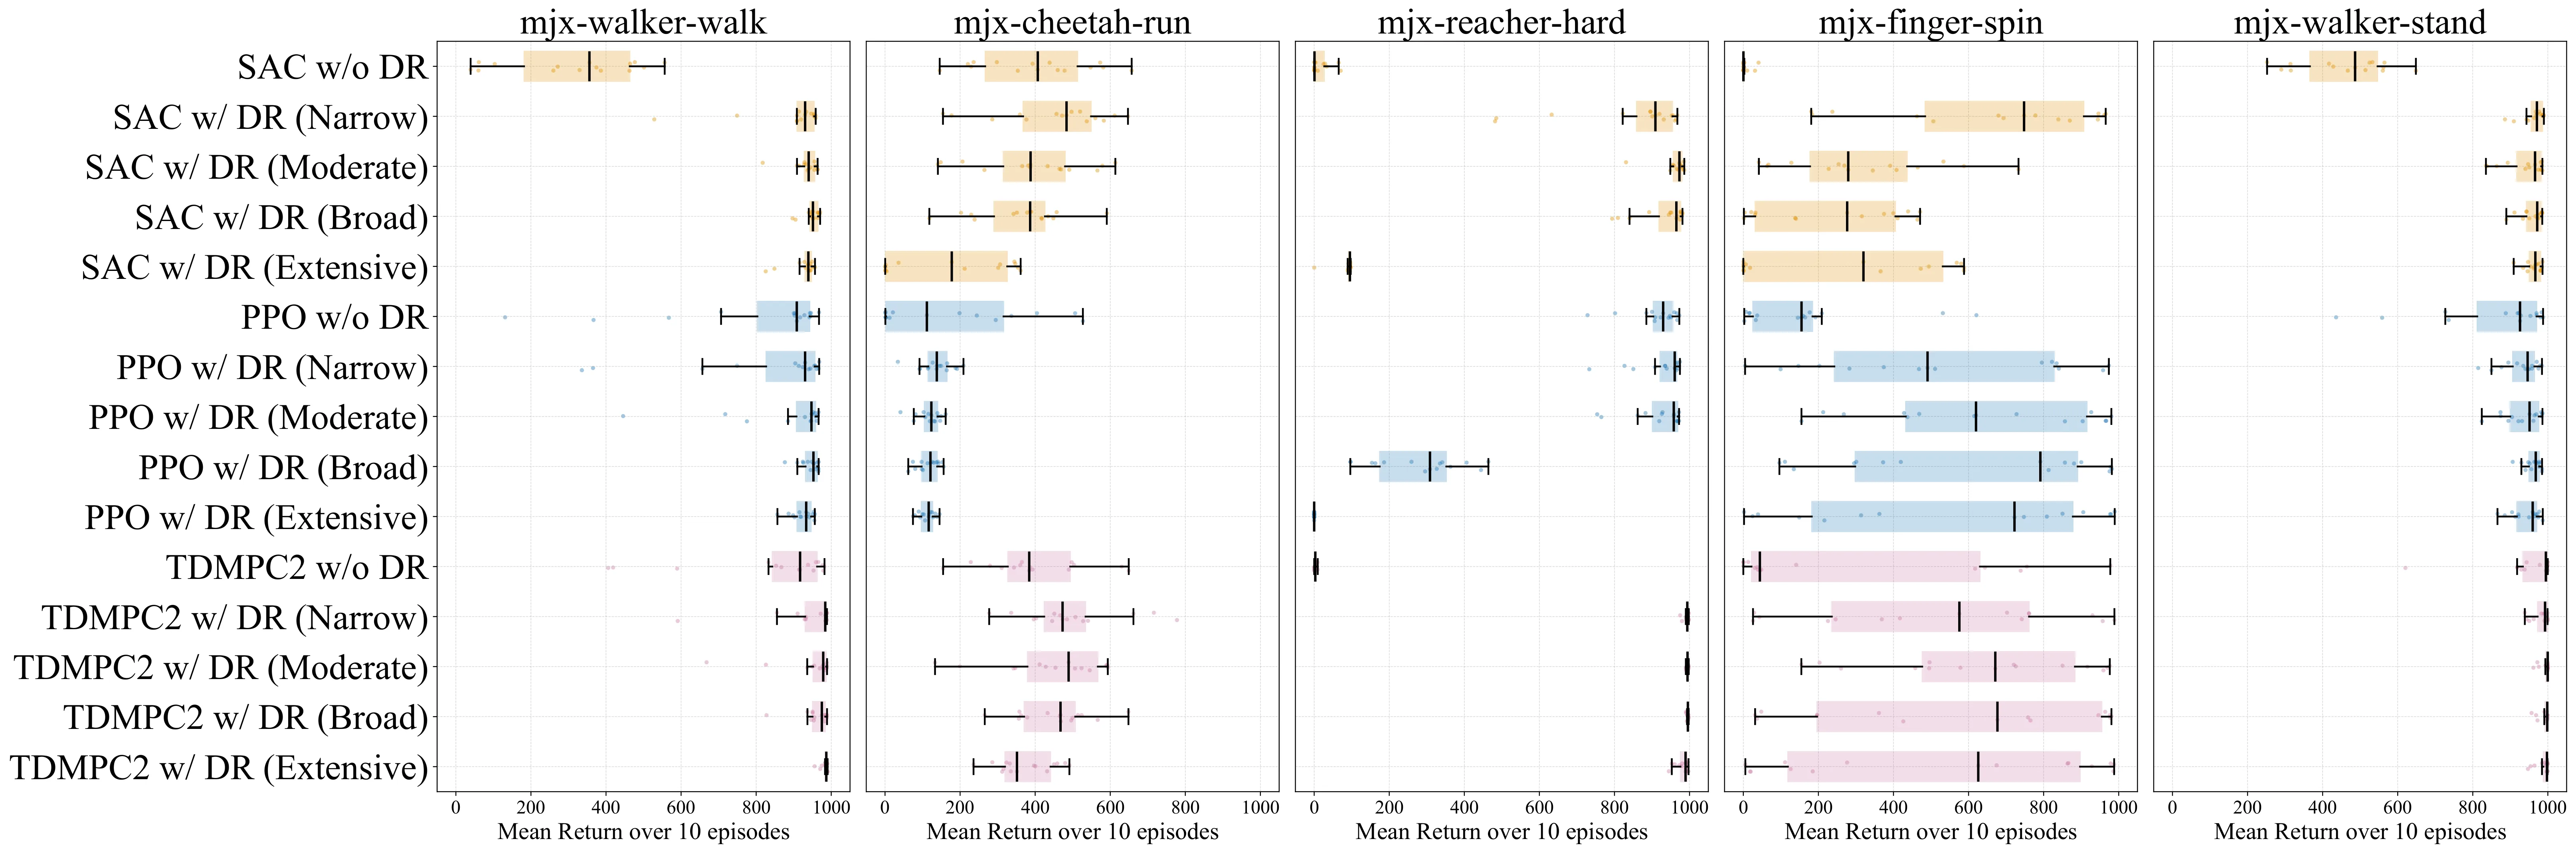
- 迁移鲁棒性:评估时每个环境运行 10 回合取均值,使用箱线图展示。
4. 资源与算力
- 所有实验运行在配备 NVIDIA A100 GPU 的计算节点上;
- 墙钟时间轴通过在代表性训练窗口上平均每次交互耗时,将训练步数转换为实际秒数;
- 论文未明确给出 GPU 数量、总训练时长或总计算成本;
- 致谢提及 Digital Research Alliance of Canada 提供计算资源;
- 资助来源:加拿大国家研究委员会 AI for Design Challenge Program 与 CIFAR Canada AI Chair。
5. 实验数量与充分性
- 任务数量:18 个 DMC 任务;
- 训练配置:3 算法 × 5 DR 覆盖度(含无 DR) = 15 种组合 × 18 任务 × 6 种子 = 约 1620 组训练运行;
- 评估模式:2 套(Nominal-Centered / Shifted),每套 15 个上下文 × 10 回合;
- 补充材料:Figure B.1–B.7 给出 18 任务下的全部学习曲线与迁移箱线图;
- 统计方式:6 种子(交互轴均值 ± 标准差),墙钟轴上额外展示最佳种子与所有种子曲线(依据 Tanaka & Mahmood 2026 关于"深度 RL 中性能变异"的研究,避免点平均掩盖差异)。
总体来看实验量较大,覆盖了多种任务、算法与 DR 覆盖度的组合。但需要指出:SAC 与 TD-MPC2 在实验中并未采用与 PPO 相同规模的大规模并行配置,因此算法间的对比建立在"各自典型使用形态"基础上而非同等硬件配置,这一定程度限制了公平性(论文在限制与未来工作中也明确承认)。
6. 主要结论与发现
6.1 墙钟时间维度
- 在所考察配置下,PPO 借助 2048 并行环境,实际墙钟时间上往往比 SAC 和 TD-MPC2 更快达到有竞争力的回报,特别在 cheetah-run、finger-spin 上表现明显。
- SAC 与 TD-MPC2 在样本效率上仍然领先(reacher-hard、finger-spin、walker-stand 等)。
- 结论:样本效率排行 ≠ 墙钟效率排行,样本低效的 PPO 之所以更快,并非交互更高效,而是大规模并行生成更多交互。
6.2 域随机化维度
- 三种算法(on-policy / off-policy / model-based)均可从 DR 中获益,未发现某一范式对 DR 系统性占优;
- DR 效果依赖于任务、算法、训练覆盖度、评估模式四者的组合;
- 转移性能不随 DR 覆盖度单调提升:Broad/Extensive 覆盖评估分布时,反而可能不如 Narrow/Moderate;
- 例外情况:finger-spin 在 Shifted 评估下,Narrow DR 即便超出其训练分布支持,仍取得强表现;walker-walk 与 walker-stand 上 DR 对 SAC 改善显著。
6.3 核心建议
迁移导向 RL 的算法选择应综合考量:
1. 交互效率(样本效率);
2. 墙钟性能(并行可扩展性、训练稳定性);
3. 动力学失配下的鲁棒性。
7. 优点
- 评估视角创新:同时引入交互轴与墙钟轴两条评估线,明确指出传统样本效率排行在迁移场景下的误导性;
- 首次受控对比:在同一迁移协议下系统比较 PPO、SAC、TD-MPC2 在不同 DR 覆盖率下的零样本迁移表现;
- 实验规模较大:18 任务 × 3 算法 × 5 DR 档位 × 6 种子,覆盖全面;
- 统计呈现细致:墙钟曲线同时展示最佳种子与所有种子,避免均值掩盖个体差异;
- 问题形式化严谨:通过 CMDP 与 与 关系显式建模训练—评估分布关系;
- 实用价值高:直接回应 sim-to-real 工程实践中"为何 PPO 仍被广泛使用"以及"SAC/TD-MPC2 在 DR 下是否可靠"的现实关切。
8. 不足与局限
- 算法配置不对等:PPO 使用 2048 并行环境,而 SAC、TD-MPC2 采用单环境标准配置,本质上不是"同等算力条件下的算法对比",而是"算法在各自典型使用形态下的对比",这使 PPO 的墙钟优势部分归因于并行度差异而非算法本身;
- 缺乏并行版 SAC/TD-MPC2 的对比:作者明确将"大规模并行下的 SAC、TD-MPC2"作为未来工作(参见 Raffin 2025、Seo et al. 2025 的最新进展),目前结论无法回答"在同等并行度下 PPO 是否仍具优势";
- 场景范围有限:仅在 DMC 任务(sim-to-sim)上评估,未涉及真实物理系统的 sim-to-real 验证;
- 评估模式有限:只考虑零样本迁移,未考虑少样本或在线自适应迁移;
- DR 范围手工设计:4 档 DR 范围由作者预设,未引入自适应 DR(ADR)或自动 DR(ADR / curriculum)方案;
- 未报告总训练时长、GPU 数量、能耗:算力成本信息不完整,难以评估实际部署开销;
- 结论的普适性:当 PPO 并行规模减小、或 SAC/TD-MPC2 采用并行变体时,本文"PPO 更快"的结论可能不成立;
- 缺少安全性 / 失败成本维度:在迁移导向的真实应用(如机器人)中,策略失败成本同样重要,但本文未纳入。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。