
WAR:面向同步智能体强化学习的工作负载感知 Rollout 系统
WAR: Workload-Aware Rollouts for Synchronous Agentic Reinforcement Learning
📝 TLDR
同步智能体强化学习训练中,长horizon rollout生成已成主要瓶颈,轨迹可达数万token。WAR提出负载感知的rollout系统,联合优化解码与调度:低负载时用无额外草稿模型的SuffixDecoding复用历史轨迹后缀作推测草稿;高负载时转为基于缓存局部性、轨迹进度和服务器负载的全局请求调度。在长上下文agent rollout上分别取得1.4倍与最高1.6倍的吞吐量提升。
🧭 速览
长horizon rollout生成是同步agentic RL训练的主要系统瓶颈,轨迹可扩展至数万token。
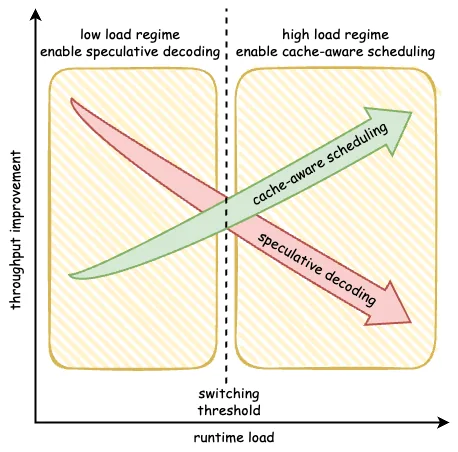
WAR依据运行时负载切换策略:低负载用SuffixDecoding推测解码,高负载用全局缓存感知调度。
长上下文agentic rollout吞吐量在低负载下提升1.4倍,高负载下最高提升1.6倍。
WAR在不改动RL算法的前提下跨负载区间稳健加速,为可扩展长上下文agent训练提供实用路径。
🆚 方法对比
WAR
- 联合优化解码与调度,跨负载均提升吞吐
- 低负载1.4倍、高负载达1.6倍吞吐提升
- 无需修改底层RL算法,易于部署
- 根据运行时负载自适应切换优化策略
- 需同时管理解码与调度两套子系统
- 依赖运行时负载检测,增加调度复杂度
- 对不同RL框架需定制集成,工作量未知
- 实验规模与场景多样性论证仍有限
SuffixDecoding(低负载下的无模型投机解码)
- 无额外草稿模型,避免GPU资源争用
- 复用历史轨迹后缀模式,适合代理任务
- 对持续更新的目标模型无失配问题
- 代码模式跨提示重复时接受率高
- 依赖历史轨迹中的后缀复用模式
- 仅在低负载下加速效果显著
- 后缀匹配准确性影响接受长度
- 首次使用时无历史模式可复用
缓存感知调度(高负载下全局调度器)
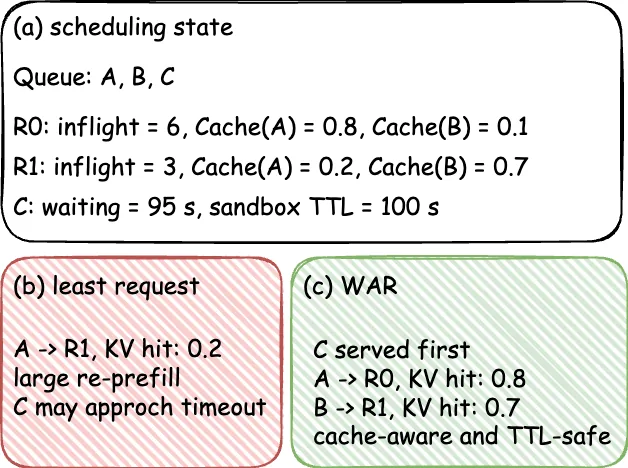
- 依据缓存局部性减少KV缓存重算
- 考虑轨迹进度与服务器负载均衡
- 缓解长尾掉队者造成的资源浪费
- 无需草稿模型,纯系统级优化
- 需全局调度器,增加系统协调开销
- 高负载下调度决策本身有计算成本
- 效果依赖请求间缓存复用程度
- 未改变同步RL训练的长尾等待问题
异步Rollout
- 可重叠rollout与训练,提升硬件利用率
- 缓解同步等待导致的部分资源闲置
- 吞吐量潜力高于同步方案
- 引入策略陈旧性,数据与当前模型不一致
- 需更复杂的worker间协调机制
- 可能损害训练稳定性和收敛性
- 增加reward计算与模型更新的耦合复杂度
基于模型的投机解码
- 通用推理加速方法,适用于多种任务
- 在GPU欠饱和时可显著减少解码步数
- 草稿模型可针对目标模型定制优化
- 草稿模型与目标模型争用GPU资源
- RL持续更新目标模型时草稿失配严重
- 需额外维护和同步草稿模型,复杂度高
- 高负载下多token验证开销反超收益
veRL等现有同步RL框架(最少请求+粘性会话)
- 策略简单,易于实现和部署
- 轻负载下效果可接受
- 已广泛用于主流同步RL训练
- 高负载下未考虑KV缓存局部性
- 仅基于请求数调度导致负载不均
- 长上下文请求并发时重算开销大
- 对长尾轨迹缺乏有效调度机制
WAR通过负载感知策略将SuffixDecoding的无模型投机解码与缓存感知调度互补结合,分别针对低/高负载优化,相比基于模型的投机解码避免了GPU争用,相比异步rollout保持了策略一致性,相比veRL的简单调度在高负载下显著减少了KV缓存重算。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图
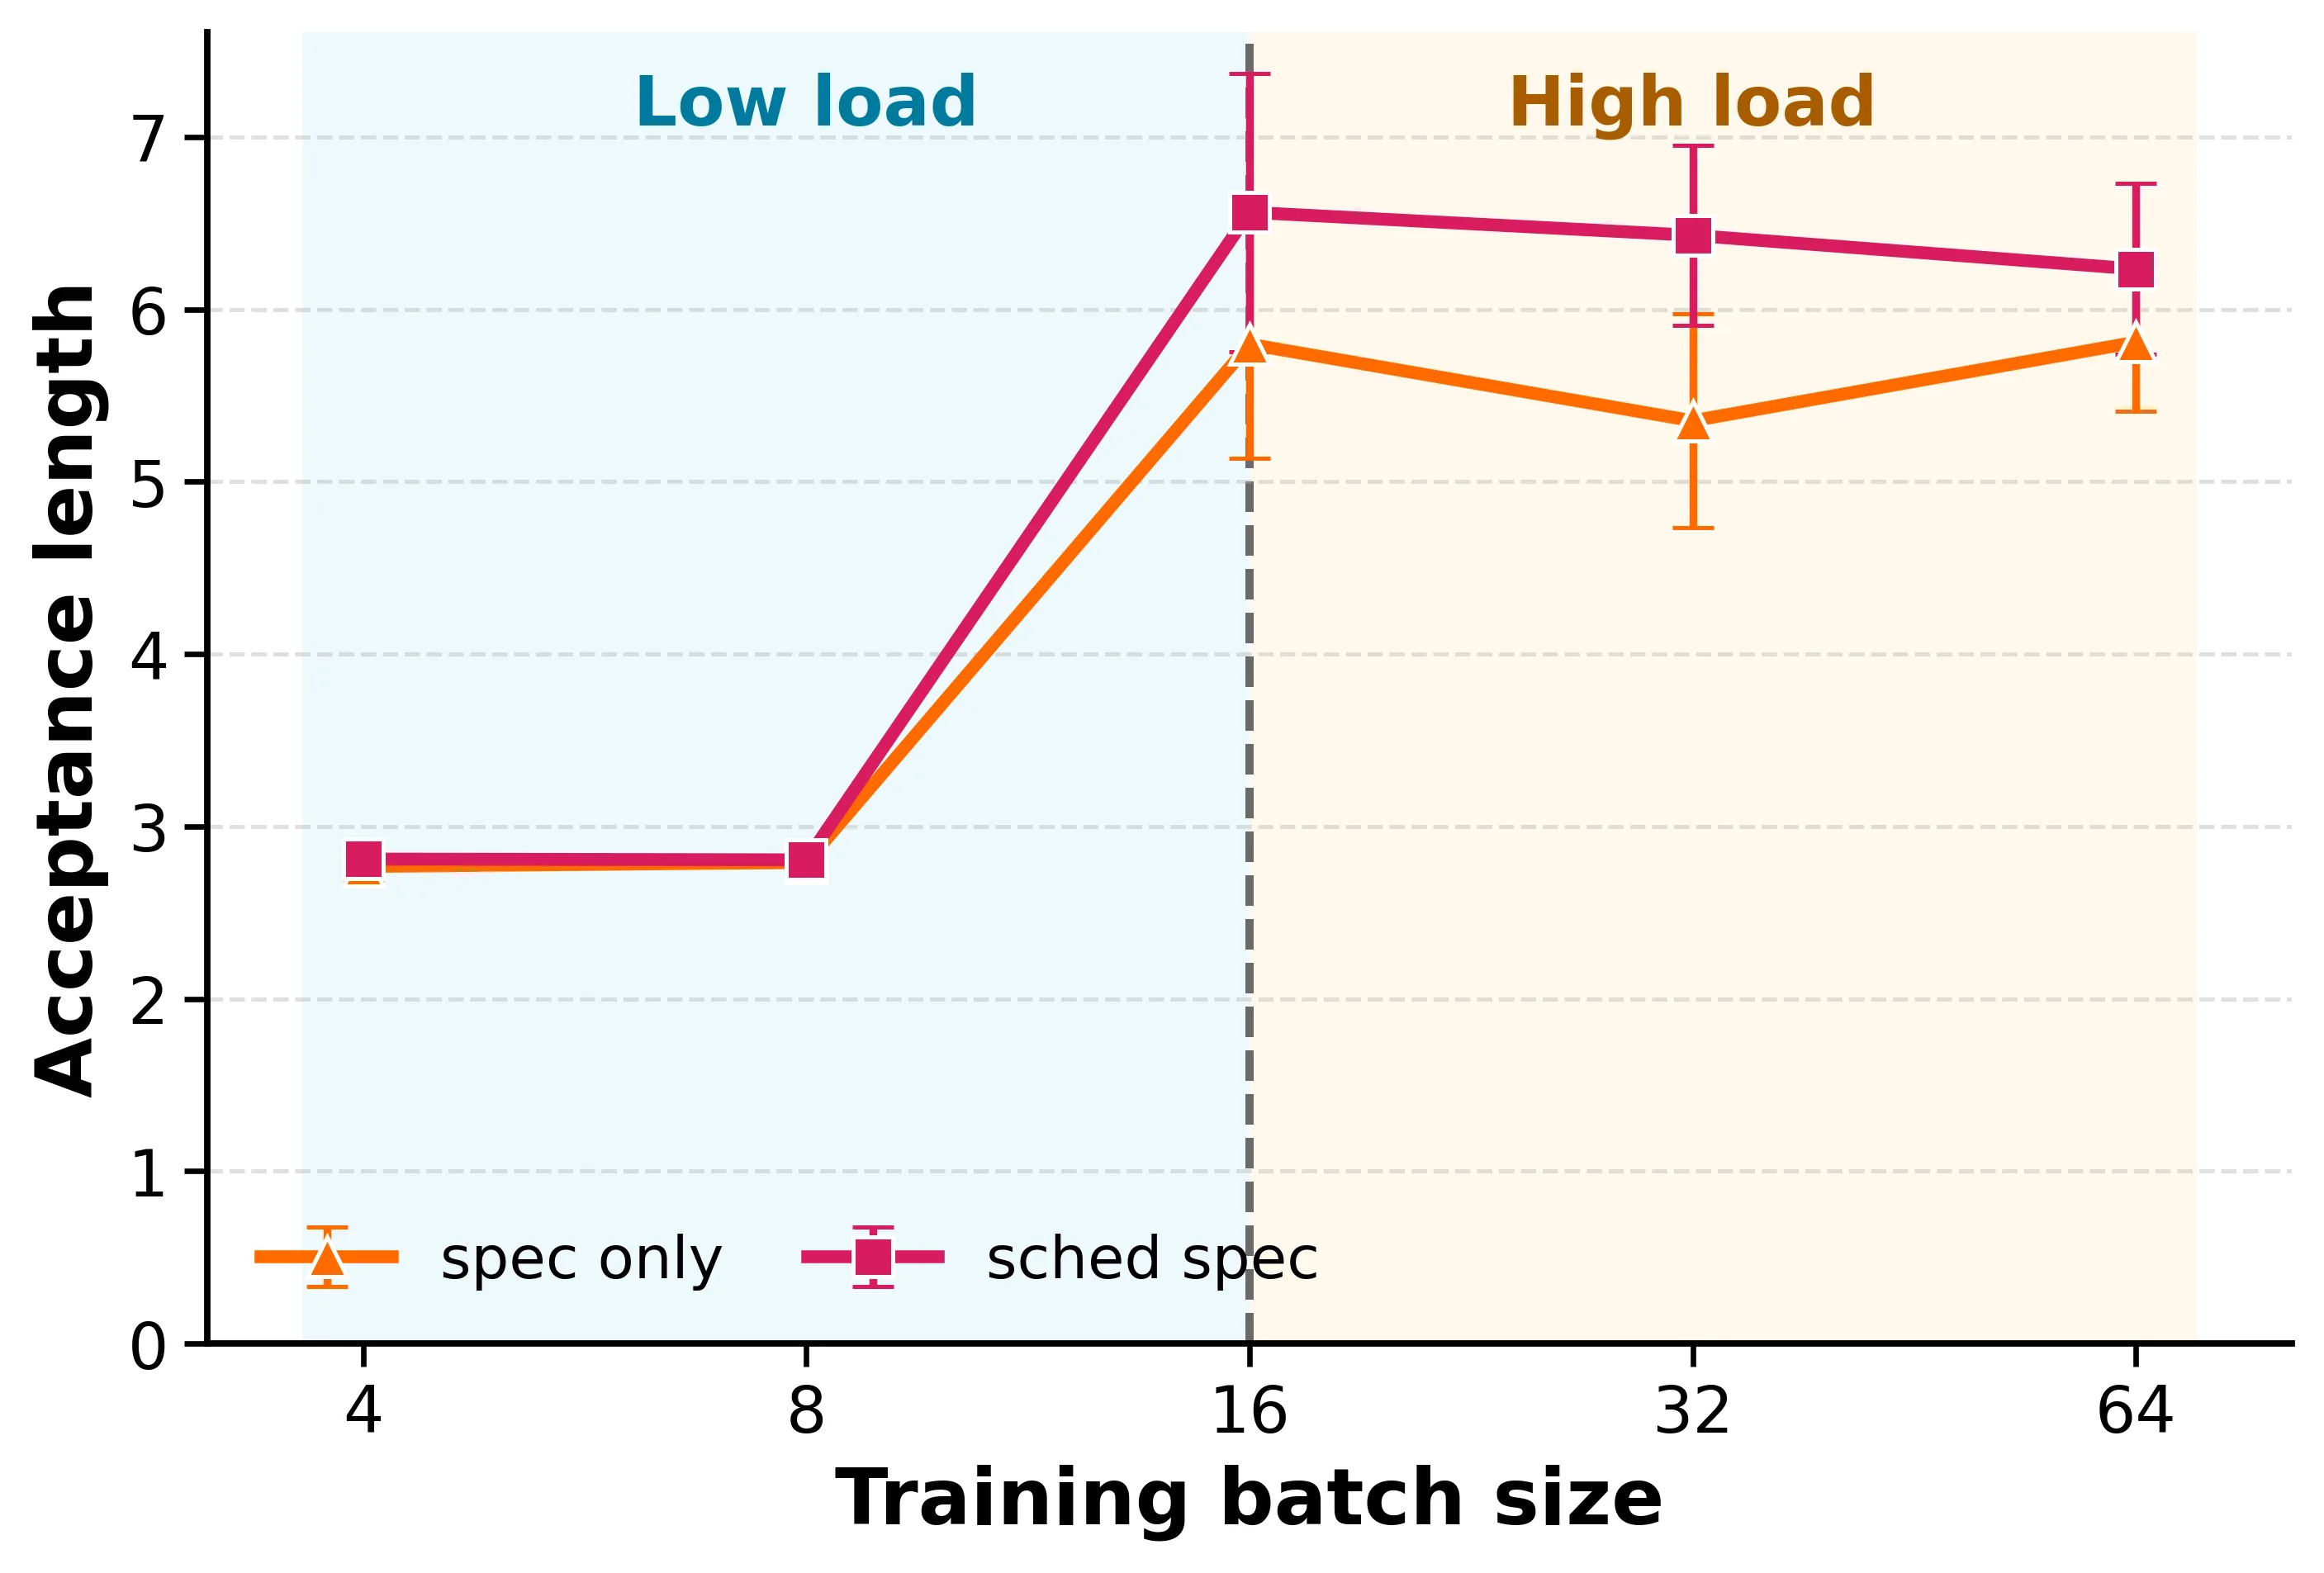
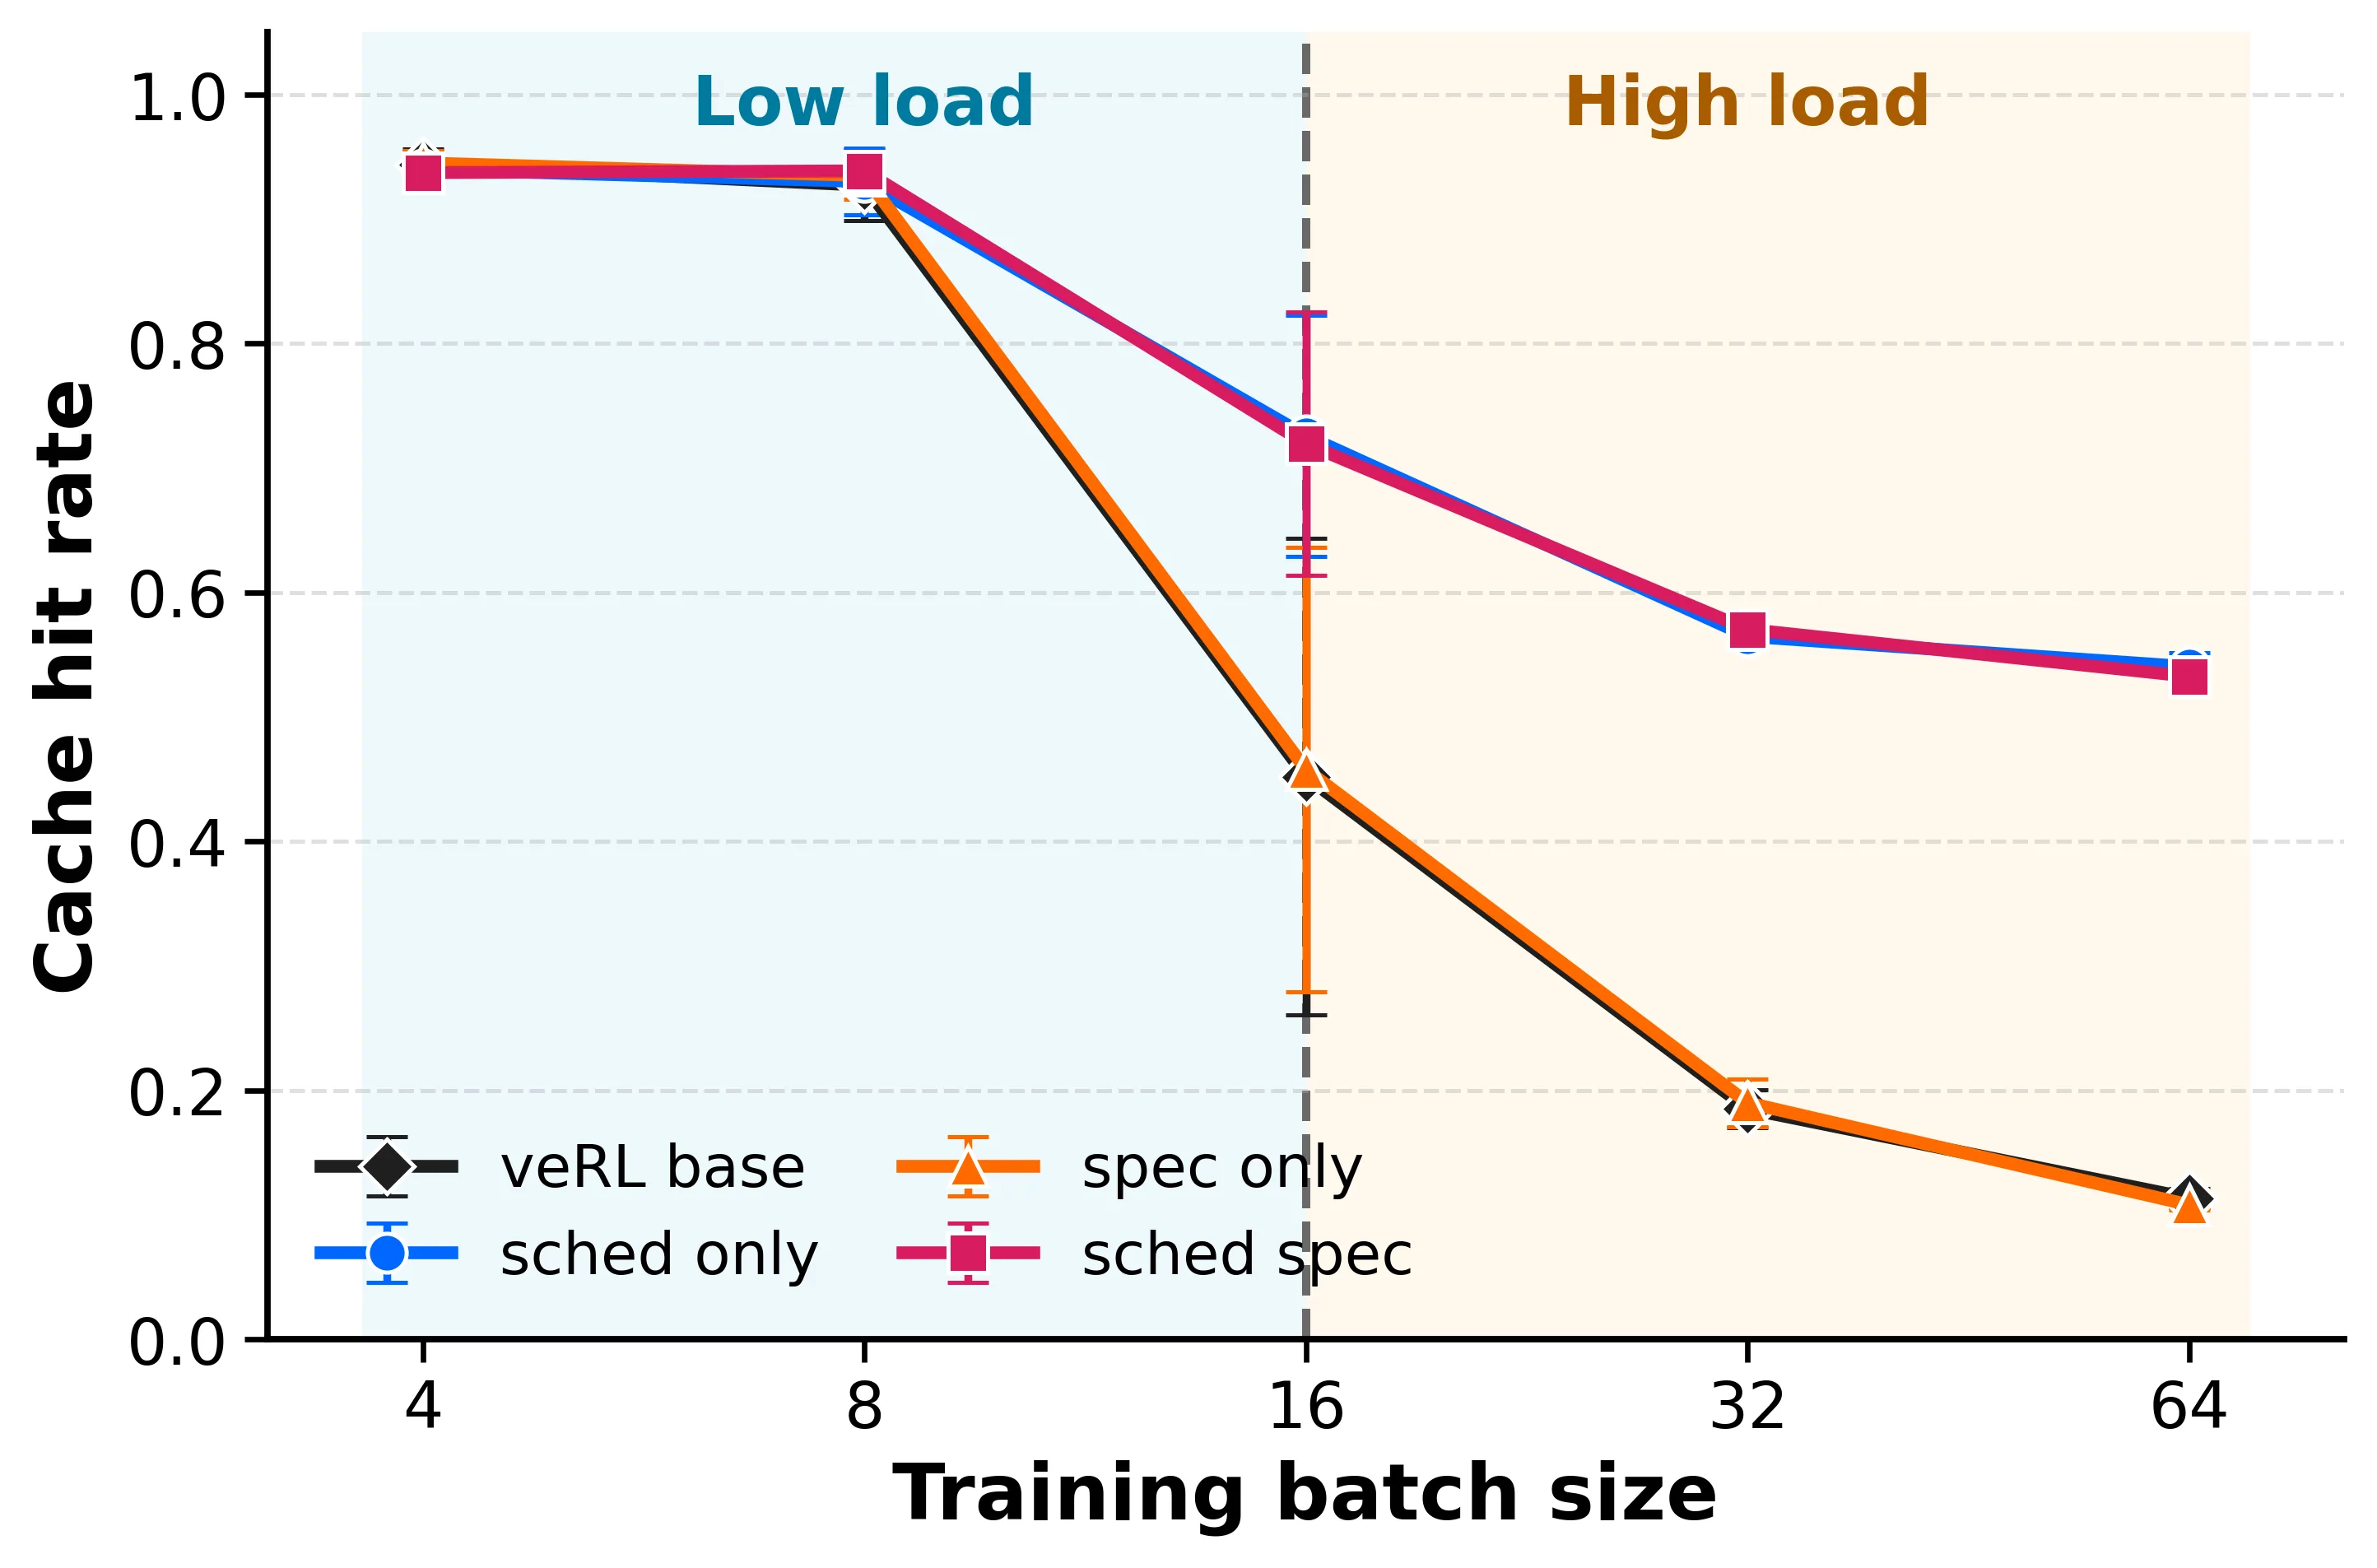
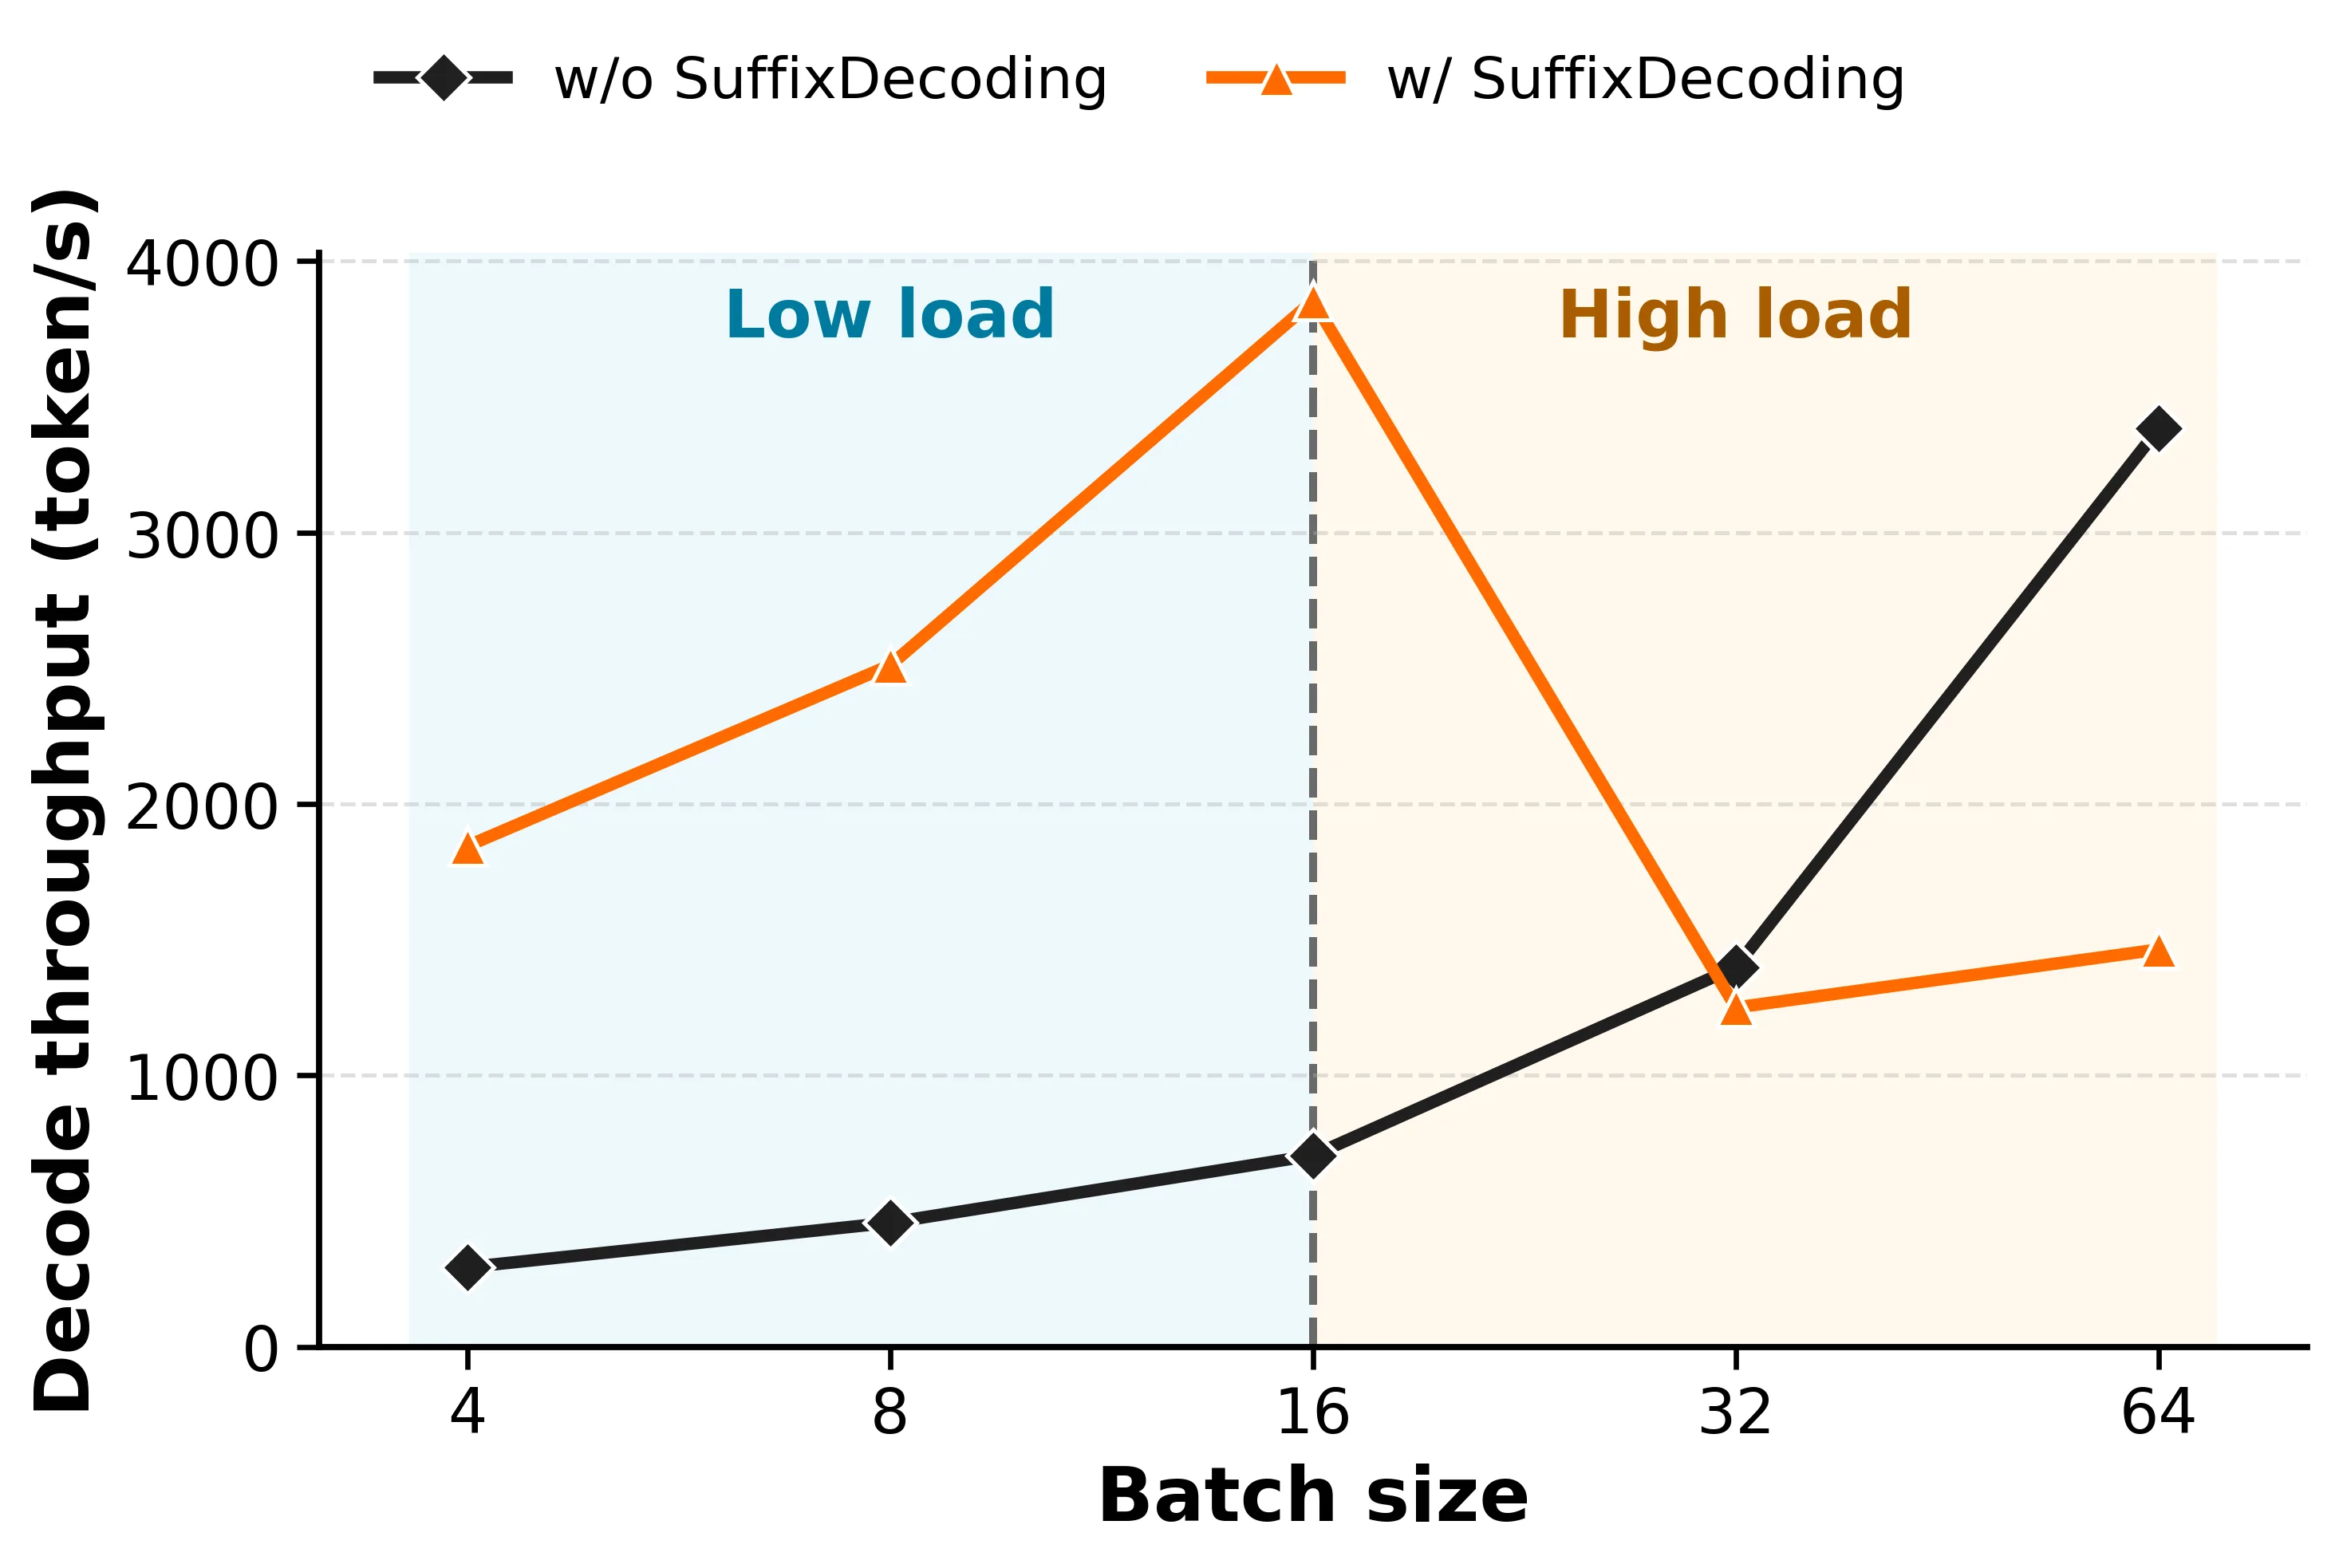
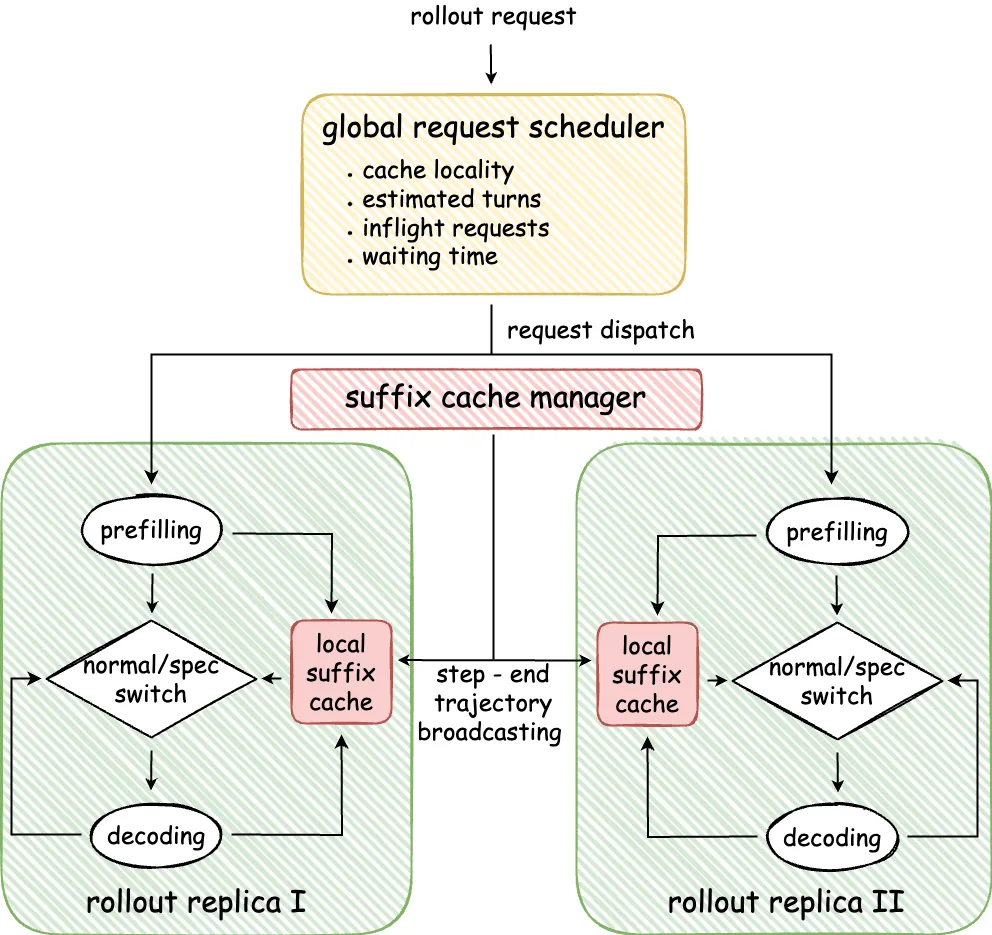
TL;DR
WAR 是一项针对同步智能体强化学习训练中 rollout 生成瓶颈的系统优化工作。它观察到负载高低会决定最优优化策略——低负载时用 SuffixDecoding 复用已完成轨迹的后缀作为投机草稿实现无模型推测解码,高负载时切换为缓存感知的全局调度来减少 KV 缓存重计算并均衡负载。实验表明 WAR 在长上下文智能体 rollout 上分别取得 1.4 倍和最高 1.6 倍的吞吐量提升,无需修改底层 RL 算法。
研究背景与动机
在智能体强化学习的训练流程中,rollout(轨迹生成)阶段负责让智能体与环境进行交互、产生训练数据。随着大语言模型被引入作为智能体的策略网络,研究者希望智能体能够完成复杂的长时序任务——比如在真实环境中多轮对话、使用工具、规划子目标等。这意味着每次 rollout 生成的轨迹长度会迅速膨胀到数万 token 量级,成为训练管线中名副其实的计算密集型瓶颈。
同步 RL 训练的一个核心特征是:所有 rollout 副本必须等待最慢的一个完成才能进入策略更新阶段。这与异步训练不同,后者的参数服务器可以持续接收梯度并更新模型,而同步训练天然受到木桶效应的制约。当轨迹越来越长时,这个问题会进一步加剧——某个副本若因长序列的注意力计算而拖慢,整体训练速度就会被它拖累。
已有的加速方案各有局限。基于模型(model-based)的投机解码需要额外部署一个轻量草稿模型,这会引入 GPU 显存争用问题,且草稿模型本身也需要训练和更新,显著增加了系统复杂度。更重要的是,在高负载场景下批量解码已经接近饱和,投机解码的加速收益会明显收窄,此时继续执着于解码层面的优化并非最优策略。
WAR 的核心洞察正在于此:没有一种放之四海而皆准的最优优化方案,策略选择必须跟随运行时负载动态调整。
方法
WAR 的设计围绕两条技术路径展开,分别适配不同的负载区间。
低负载下的 SuffixDecoding
当系统负载较低时,GPU 和计算资源相对充裕,此时可以充分利用投机解码的空间。WAR 引入了一种无模型(model-free)的推测解码策略——SuffixDecoding。其核心思路是:从已完成的历史轨迹中提取后缀模式,直接用作当前 rollout 的投机草稿。
这一设计的巧妙之处在于:智能体在环境中的行为往往具有重复性和模式性。比如一个使用工具的智能体,其轨迹末尾的 token 序列(如"Result: ...\nNow I will...")可能在多次交互中反复出现。SuffixDecoding 利用这种后缀复用性,将已生成的轨迹结尾片段缓存起来,作为后续 rollout 的预测草稿。当主模型在生成下一个 token 时,投机草稿会同步生成若干候选 token,主模型随后只需验证这些候选是否合理,而无需完全从零自回归生成。
与基于模型的草稿器相比,SuffixDecoding 最大的优势在于它不引入额外的神经网络模型。草稿生成完全基于查表和字符串匹配,这使得它几乎不消耗额外 GPU 算力,也不会与 rollout 的主模型生成产生资源竞争。在负载较低、批量规模尚小时,这种轻量级投机策略能带来可观的加速比。
高负载下的缓存感知全局调度
当负载升高、批量规模扩大时,批量解码本身的并行度已经得到充分利用,投机解码的边际收益递减。此时 WAR 将优化重点转移到系统层——通过更智能的请求调度来减少冗余计算和负载不均。
具体而言,WAR 的全局调度器在分配请求到各个 rollout 副本时,会综合考量三个因素:缓存局部性(cache locality)、轨迹进度(trajectory progress)以及服务器负载(server load)。缓存局部性意味着将具有相似前缀或共享上下文的请求调度到同一副本,以复用已计算的 KV 缓存,避免重复进行注意力计算。轨迹进度考量则是将处于相近生成阶段(近邻 token 位置)的请求聚合,因为此时它们的计算热点更可能重叠。服务器负载均衡则确保没有单个节点被过度支配,导致其他节点空闲等待。
这三者的联合优化形成了一个多目标调度问题。调度器需要在最大化缓存复用(减少重计算)与保持负载均衡(避免某节点成为瓶颈)之间取得平衡,而 SuffixDecoding 在解码层面的优化为这个调度决策提供了更大的容错空间——即使偶发的调度不完美也能通过投机加速来弥补。
实验与结果
WAR 的实验聚焦于长上下文智能体场景,使用包含多轮交互的复杂任务来模拟真实环境中的 rollout 生成。实验设置对比了基线方法(无特殊优化的标准批量解码)以及多种已有的加速方案,包括基于模型的投机解码变体。
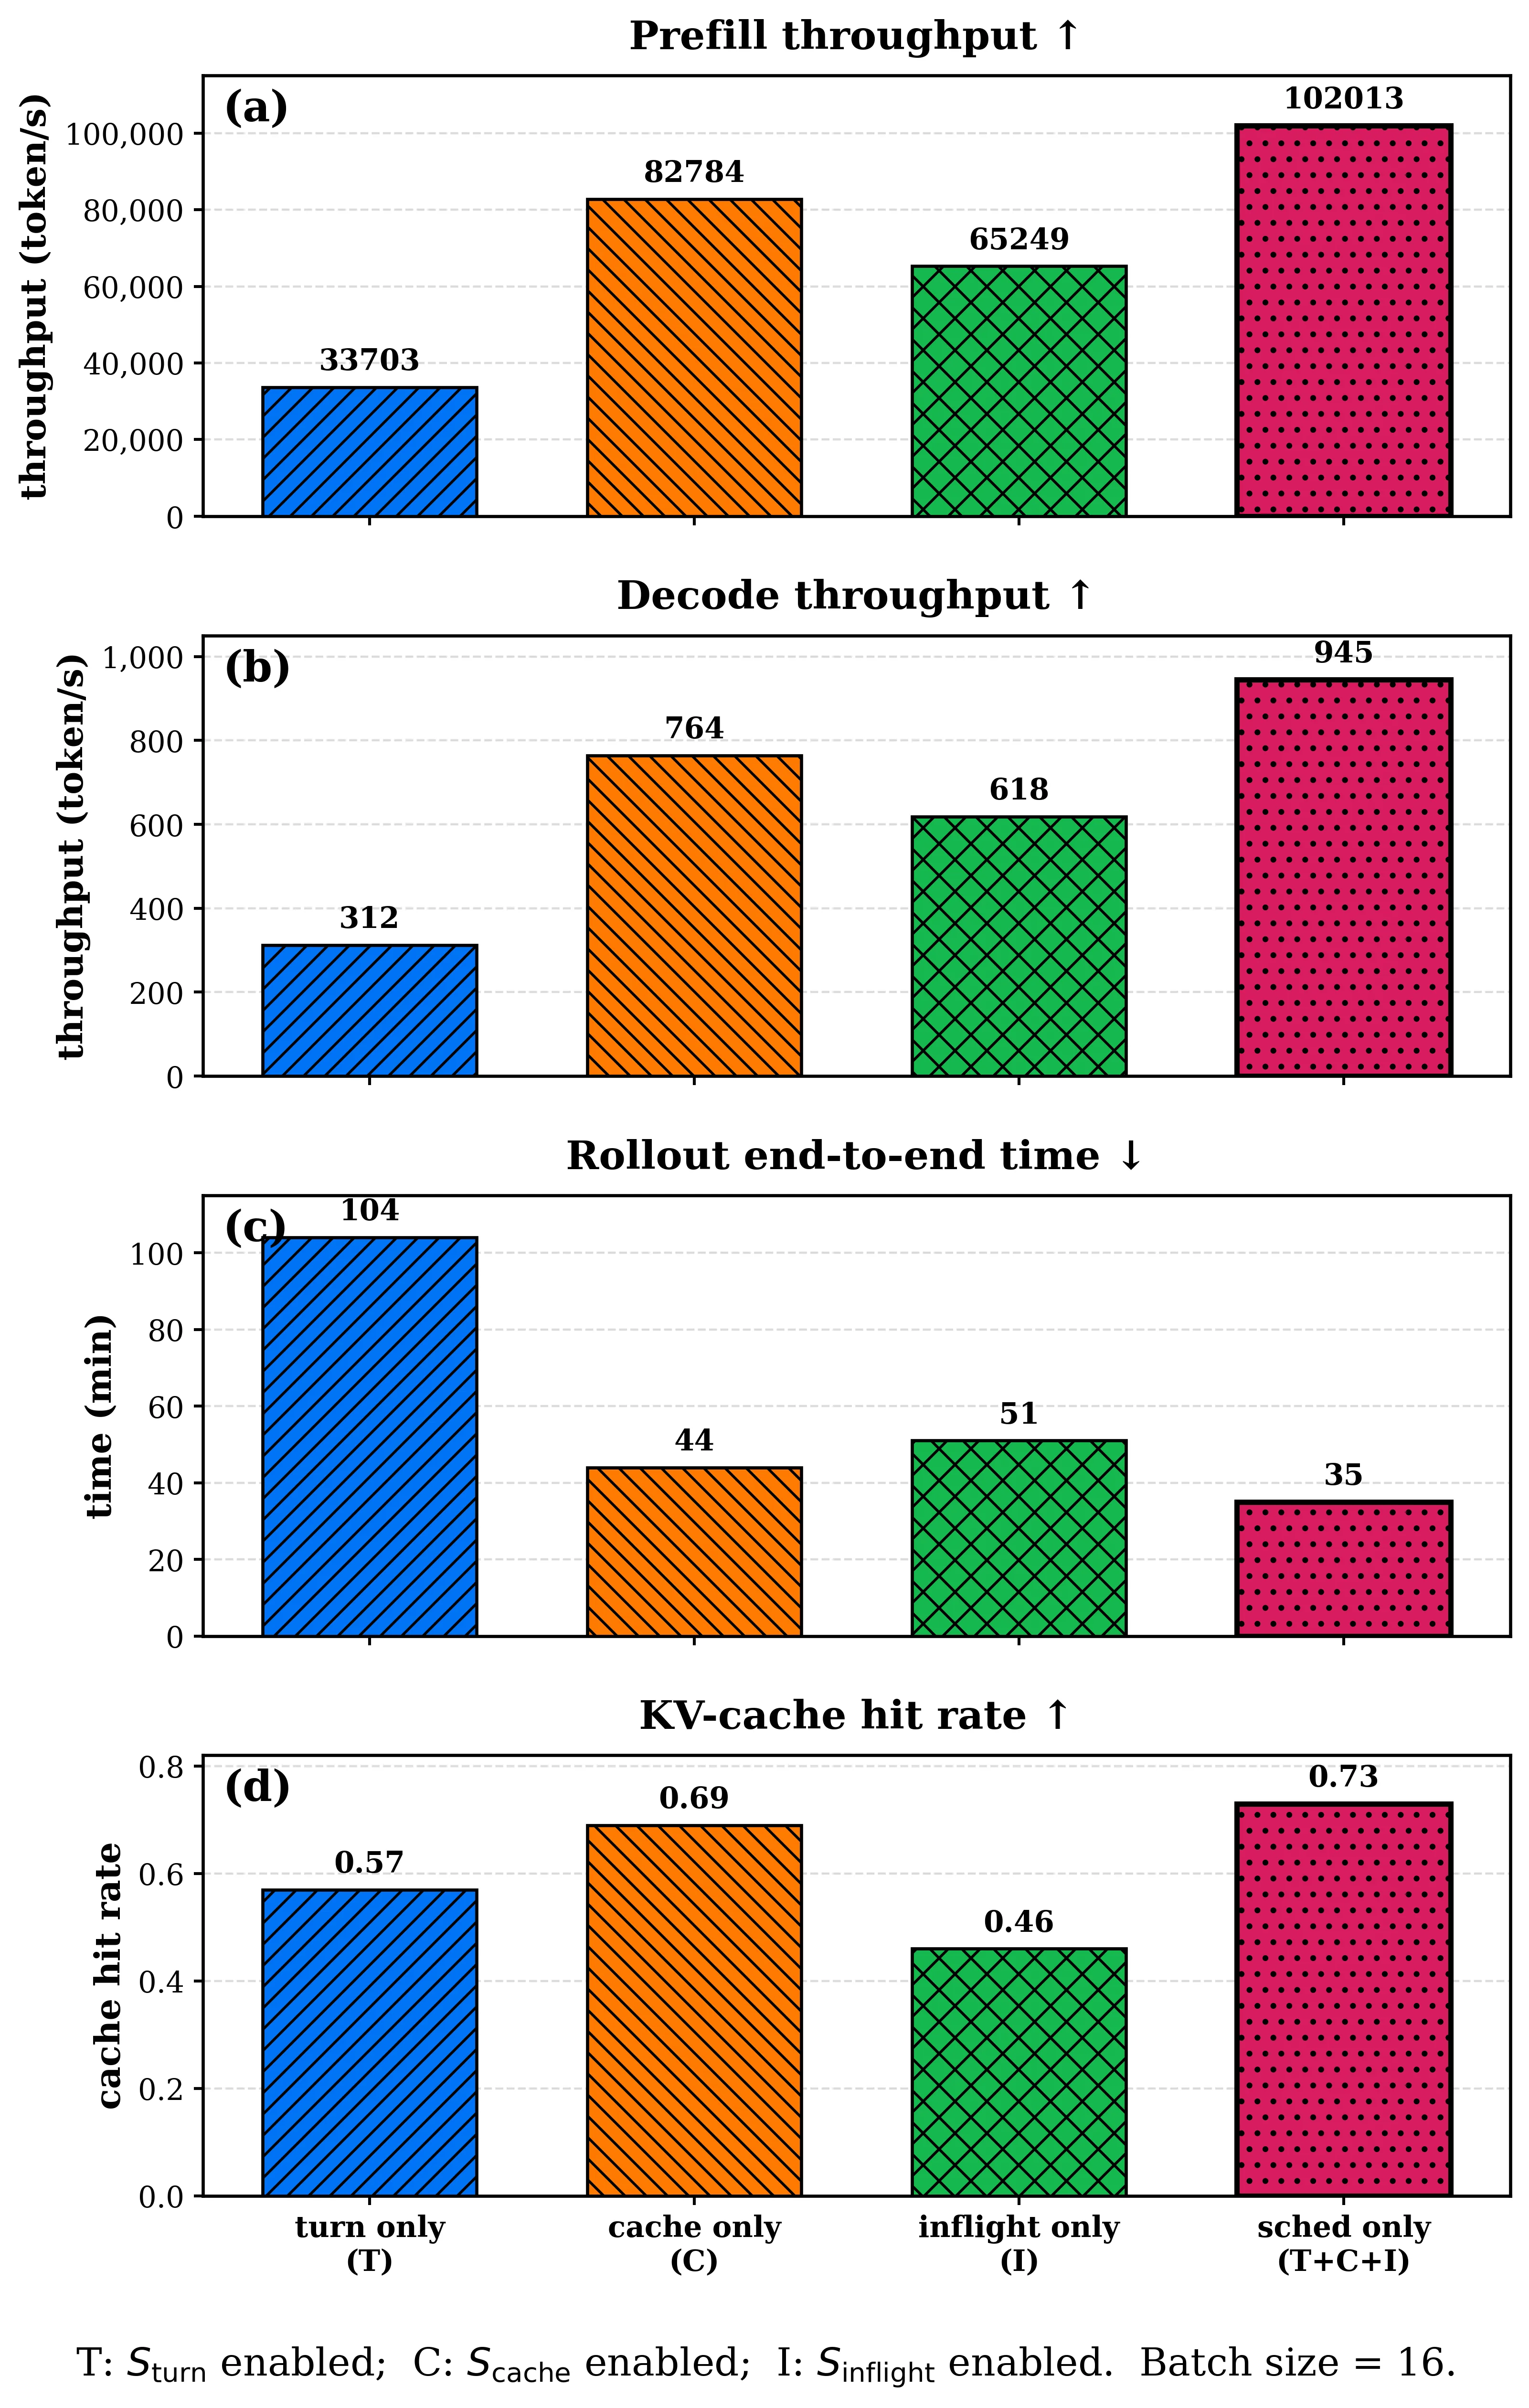
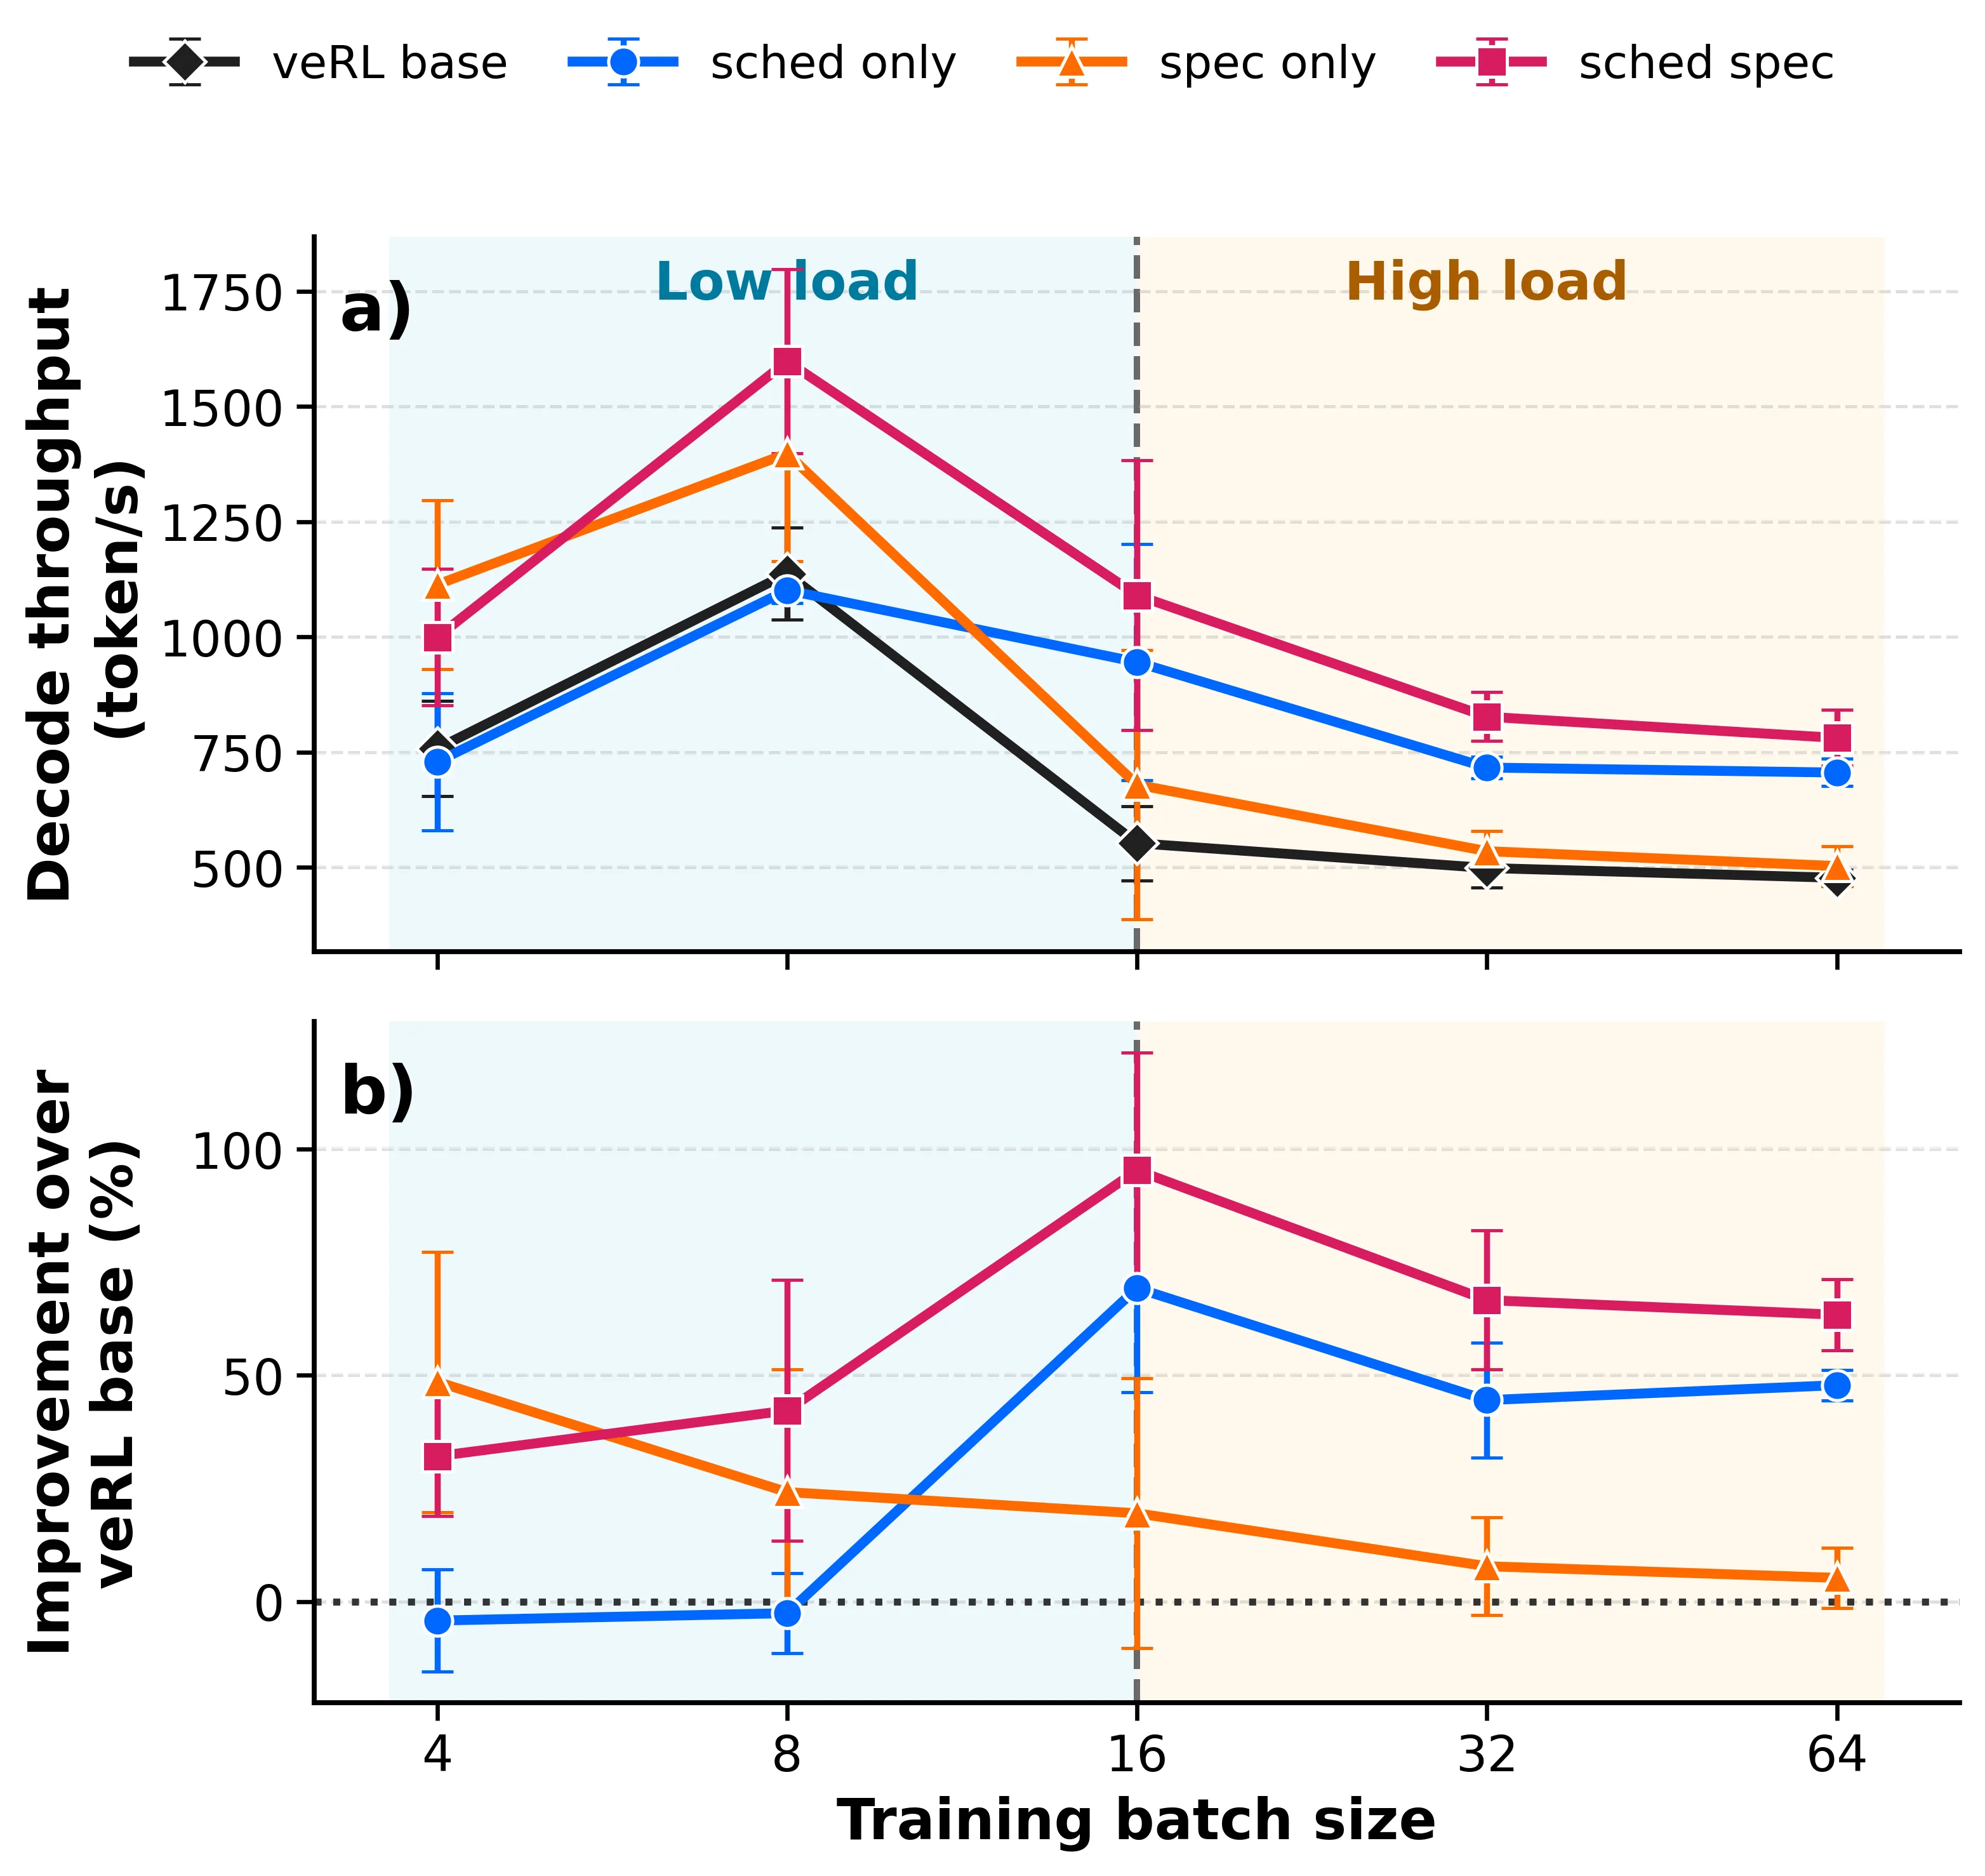
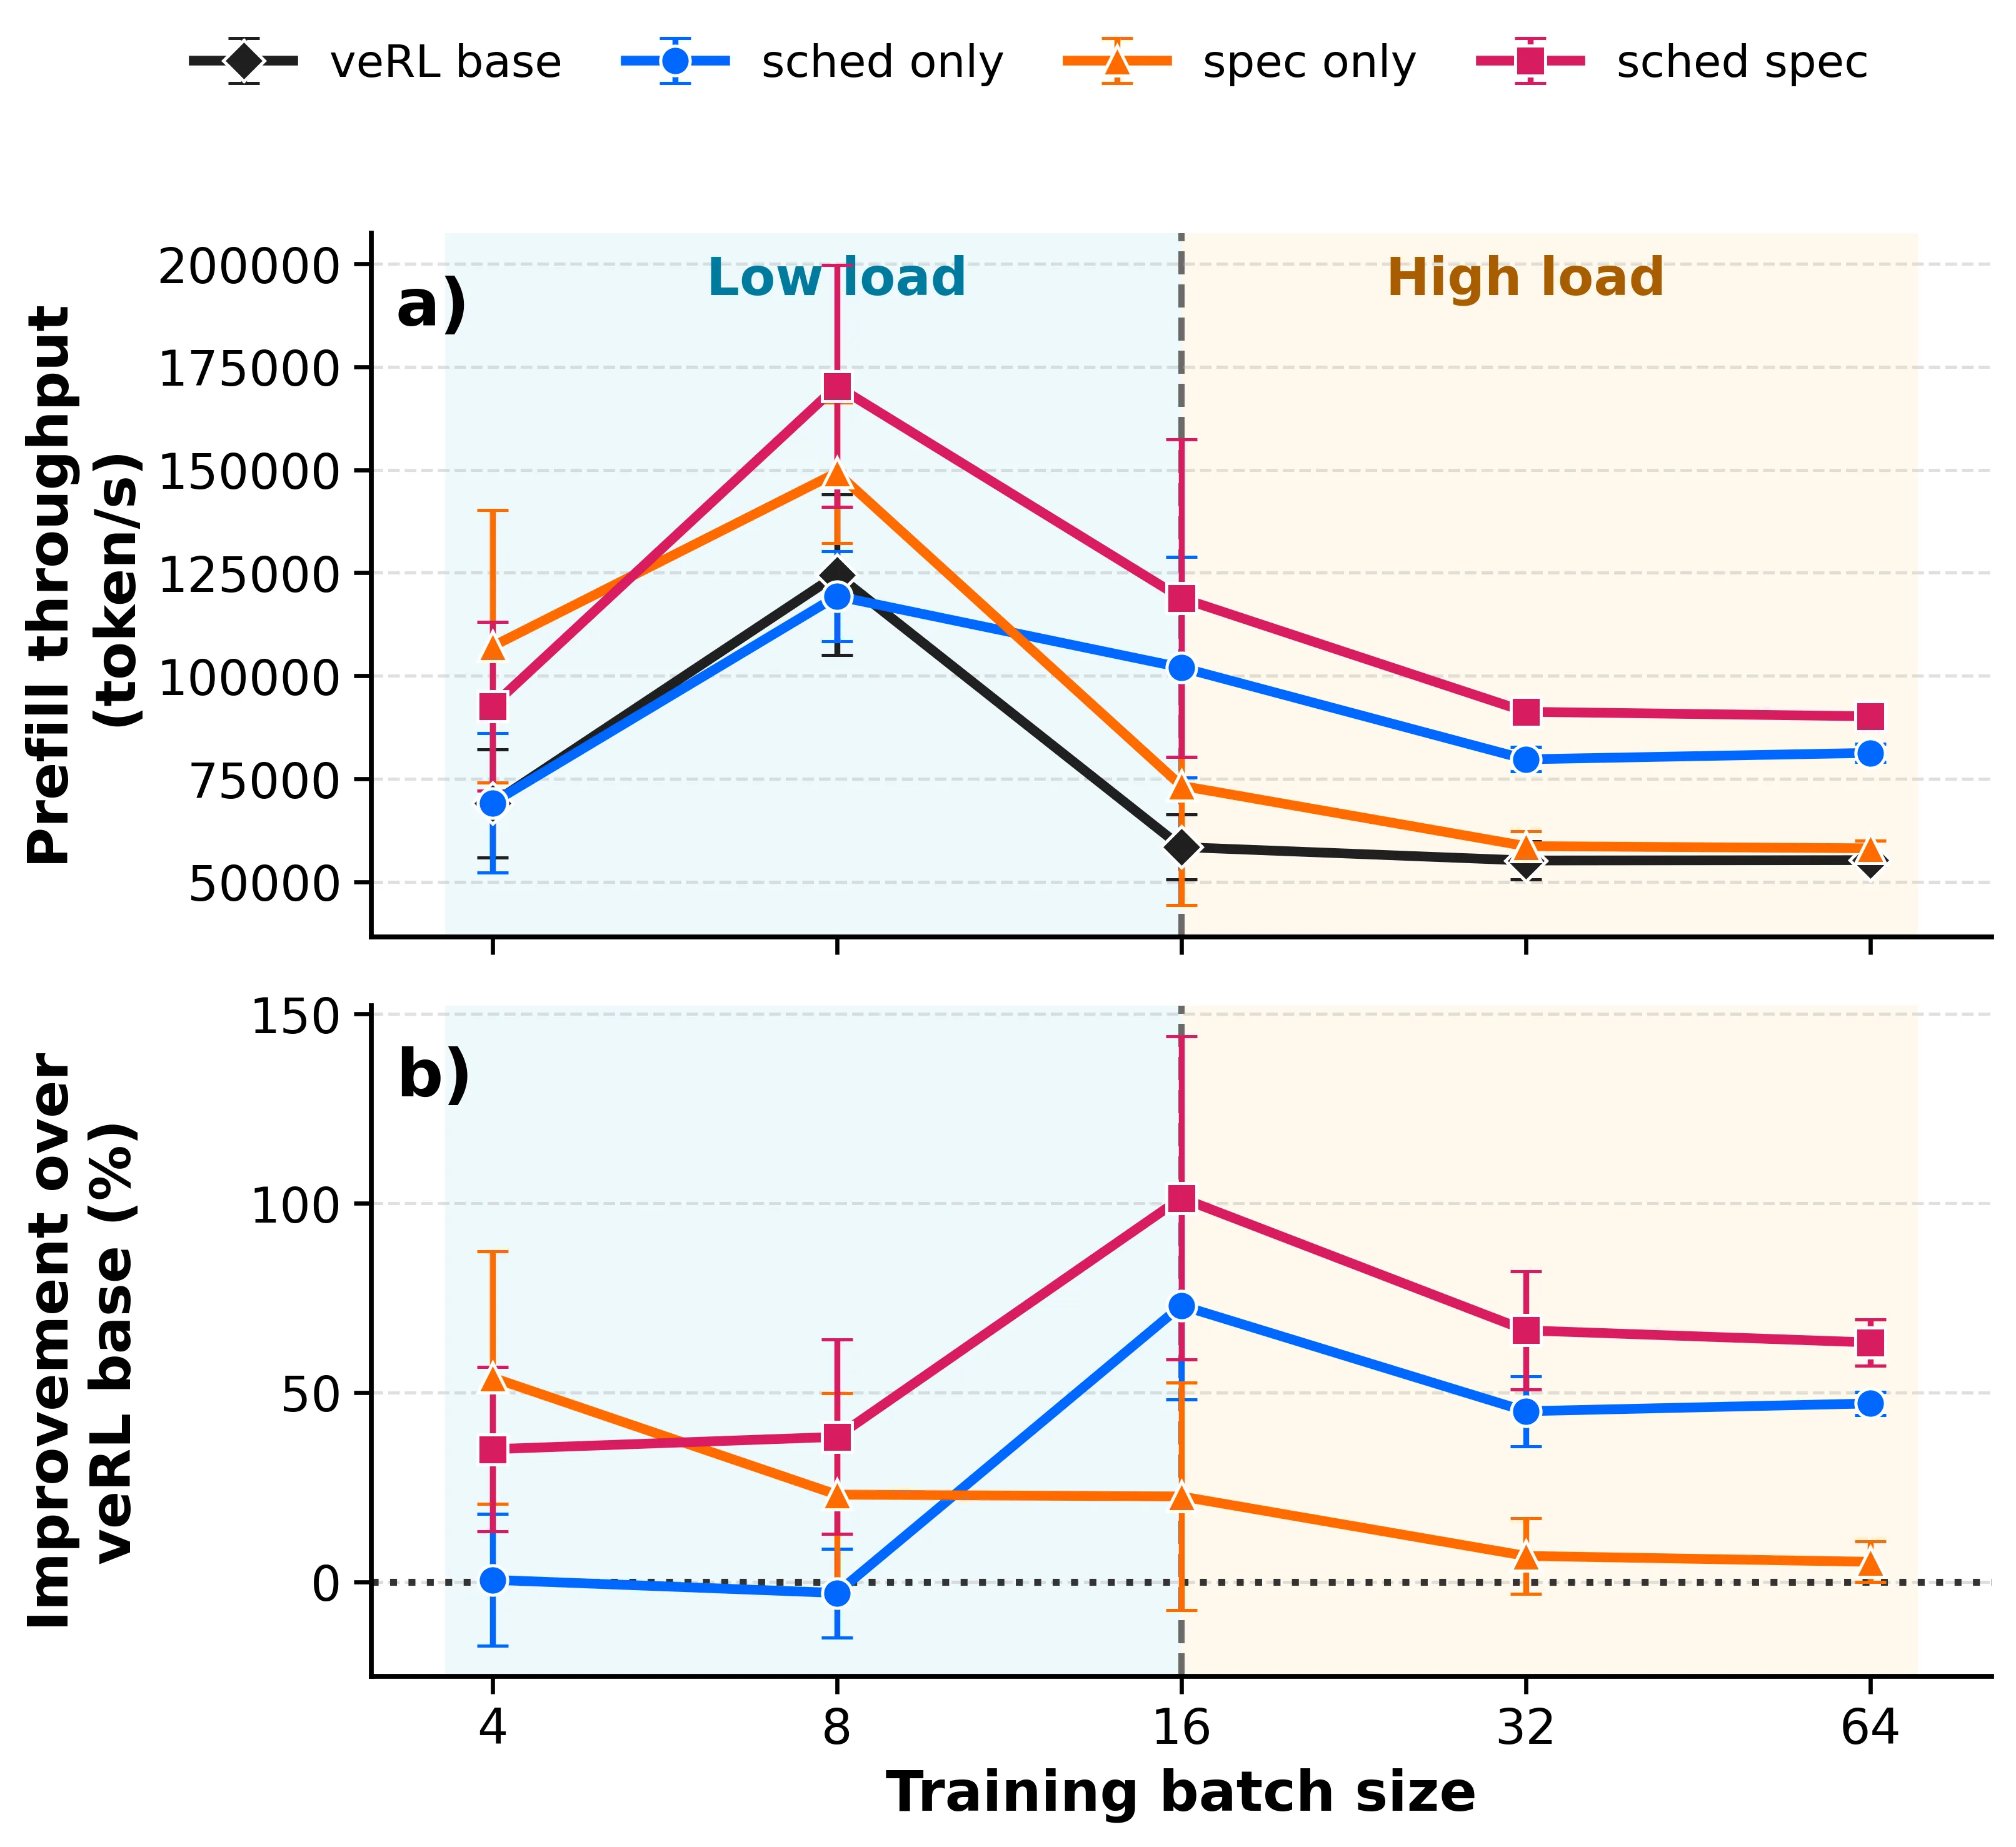
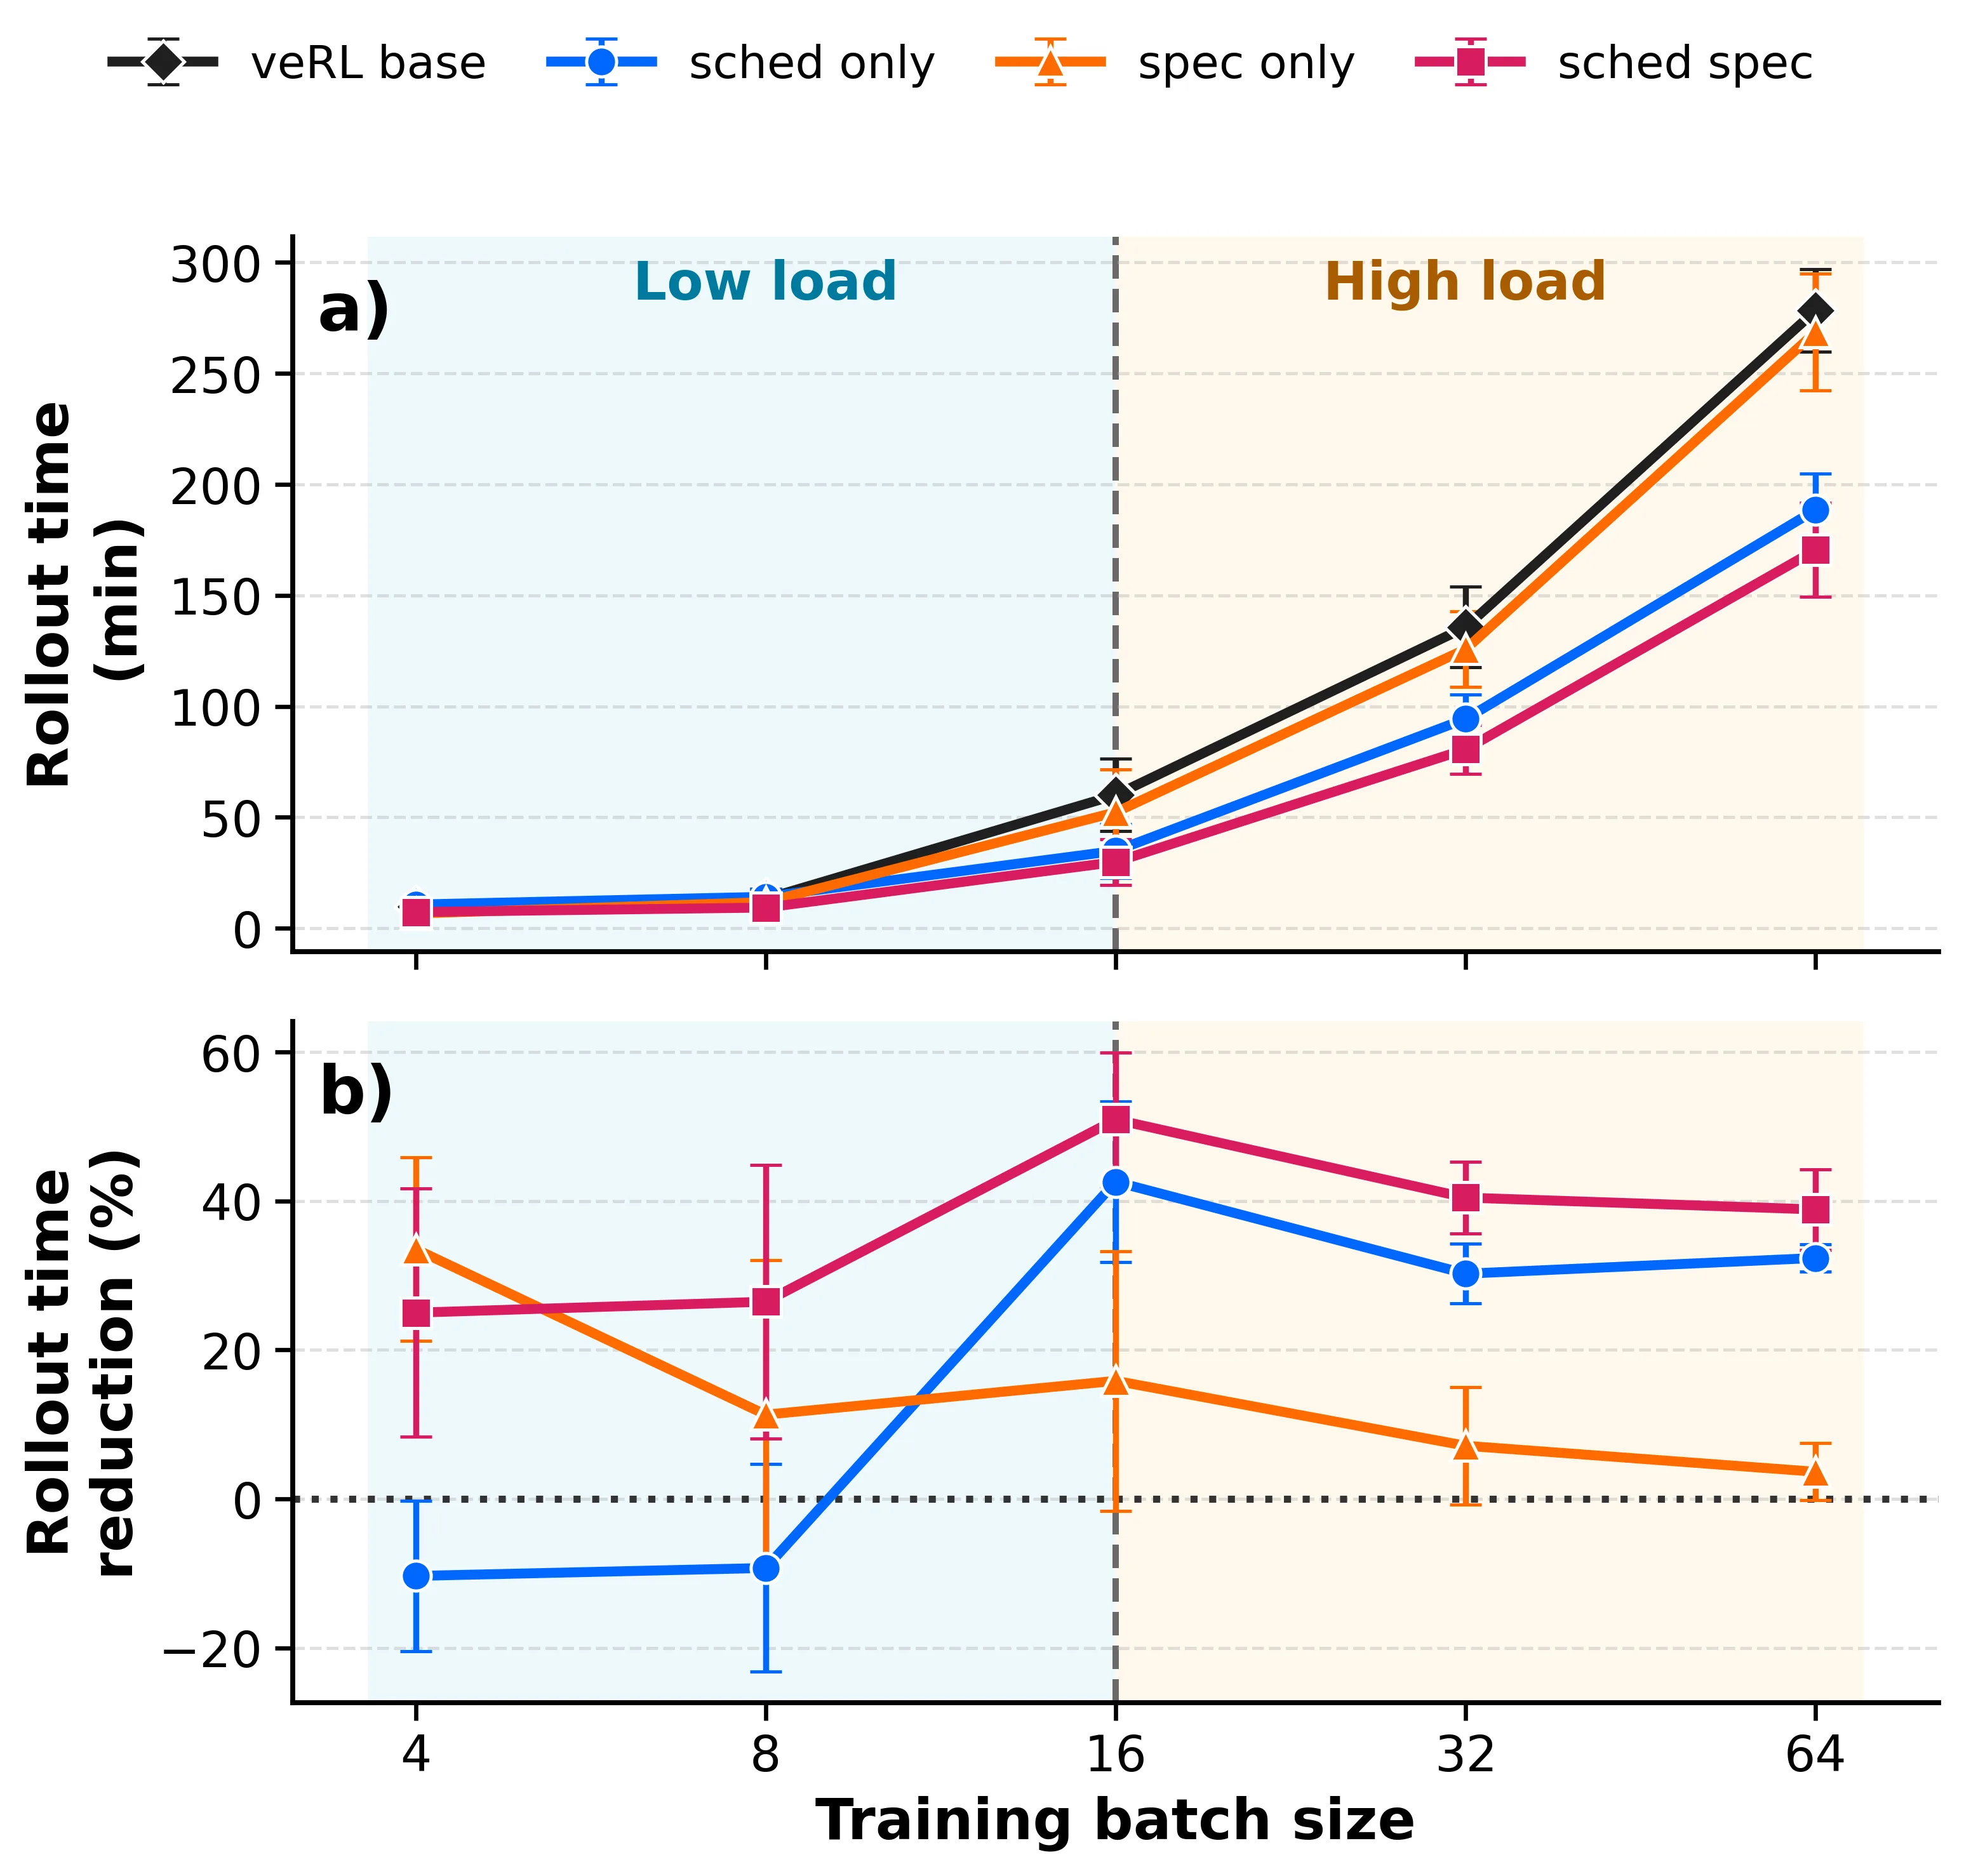
在低负载配置下(批量规模较小),SuffixDecoding 的效果尤为显著。由于草稿生成不占用主模型的计算资源,系统能够更充分地利用 GPU 的并行能力。实验观测到的吞吐量提升达到 1.4 倍,这一收益在轨迹长度增长时依然保持稳健。
高负载配置下(批量规模增大、批量解码趋于饱和),SuffixDecoding 的相对收益有所下降,但缓存感知调度开始发挥主导作用。通过减少跨副本的 KV 缓存重复计算和缓解负载倾斜,整体吞吐量提升攀升至最高 1.6 倍。这一结果验证了 WAR 的核心假设:高负载下调度优化比解码优化更有效。
值得注意的是,WAR 的所有实验都保持了底层 RL 算法完全不变。这说明系统层面的优化具有通用性——无论使用 PPO、GRPO 还是其他策略梯度方法,只要 rollout 生成构成瓶颈,WAR 都能提供加速。
讨论与可借鉴点
WAR 的局限性值得讨论。首先,SuffixDecoding 的效果依赖于轨迹序列中确实存在可复用的后缀模式。对于随机性极高、每次交互都高度独特的任务(如纯探索性的新环境),后缀复用的命中率可能较低,加速收益会打折扣。其次,全局调度器的设计假设了多副本架构的可行性——对于资源受限无法运行多个 rollout 副本的场景,这部分优化无从实施。
更深层的启发在于 WAR 提出的工作负载感知范式。系统优化中常常存在这样的"甜蜜点悖论":某种优化在特定条件下效果拔群,换一个场景却收效甚微。WAR 表明,与其费力寻找全场景最优的单一方案,不如让系统具备自适应能力,根据运行时状态在多种策略间切换。这一思想对于 [[reinforcement learning]] 训练系统之外的其他大模型推理加速场景同样有参考价值——[[speculative decoding]] 与调度优化的组合并非此消彼长的竞争关系,而是可以互补增益。
最后,WAR 的实验揭示了一个值得关注的事实:即使在高度优化的推理引擎上,长轨迹生成仍然是 [[reinforcement learning]] 训练的主要瓶颈。这提示系统研究者:模型训练的优化重心可能需要从传统的参数更新阶段更多地向数据生成阶段倾斜。
摘要
长时序 rollout 生成已成为智能体强化学习(RL)中主要的系统瓶颈。随着智能体在环境中进行多轮交互,轨迹(trajectory)长度迅速增长至数万 token,使得同步 RL 训练越来越受限于 rollout。我们提出 WAR,一种工作负载感知的 rollout 系统,通过联合优化解码与调度策略,大幅加速同步智能体 RL。WAR 建立在以下关键观察之上:最优的 rollout 优化策略取决于运行时负载:(1)在低负载下,WAR 启用基于 SuffixDecoding 的无模型投机解码(speculative decoding),将先前已完成的轨迹中的后缀模式作为未来 rollout 的投机草稿加以复用。与基于模型的草稿器不同,SuffixDecoding 不引入额外的草稿模型,并避免了与 rollout 生成争用 GPU。(2)在高负载下,批量解码已趋于饱和,留给投机的加速空间有限,此时 WAR 将优化重点转向缓存感知的调度。全局调度器根据缓存局部性、轨迹进度和服务器负载,将请求分配到各 rollout 副本,以减少冗余的 KV 缓存重计算并缓解负载不均。通过结合解码层的后缀复用与系统层的 rollout 调度,WAR 在不同工作负载区间均能带来稳健的吞吐提升,且无需改变底层 RL 算法。WAR 将长上下文智能体 rollout 吞吐量在低负载下提升 1.4 倍,在高负载下最高提升 1.6 倍。上述结果表明,WAR 消除了同步智能体 RL 中一项主要的 rollout 瓶颈,并为可扩展的长上下文智能体训练提供了一条切实可行的路径。
Abstract
Long-horizon rollout generation has become the dominant systems bottleneck in agentic reinforcement learning (RL). As agents interact with environments over many turns, trajectories rapidly grow to tens of thousands of tokens, making synchronous RL training increasingly constrained by rollout. We propose WAR, a workload-aware rollout system that substantially accelerates synchronous agentic RL by jointly optimizing decoding and scheduling. WAR is built on a key observation: the optimal rollout optimization strategy depends on runtime load: (1) Under low load, WAR enables model-free speculative decoding with SuffixDecoding, which reuses suffix patterns from previously completed trajectories as speculative drafts for future rollouts. Unlike model-based drafters, SuffixDecoding introduces no additional draft model and avoids GPU contention with rollout generation. (2) Under high load, where saturated batched decoding leaves limited room for speculative speedup, WAR shifts the optimization focus to cache-aware scheduling. A global scheduler places requests across rollout replicas based on cache locality, trajectory progress and server load, reducing redundant KV-cache recomputation and mitigating load imbalance. By combining decoding-level suffix reuse with system-level rollout scheduling, WAR delivers robust throughput improvements across workload regimes without changing the underlying RL algorithm. WAR improves long-context agentic rollout throughput by 1.4x under low load and up to 1.6x under high load. These results show that WAR removes a major rollout bottleneck in synchronous agentic RL and provides a practical path toward scalable long-context agent training.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。