
📝 TLDR
LLM后训练面临两大范式困境:RL依赖粗粒度结果监督,难以有效归因和获取新知识;OPD通过KL散度无条件模仿教师,相似教师无新知、差异过大教师指导无效,被局限在同家族蒸馏内。本文提出Distilled RL,将教师监督融入RL目标以提供细粒度指导,包含逆向重要性采样裁剪、负样本重置和序列级几何归一化三项机制。在同家族和跨家族蒸馏场景下,pass@1与pass@k均显著超越RL和OPD基线。该工作拓展了LLM后训练的知识迁移路径,缓解了无条件模仿的两难。
🧭 速览
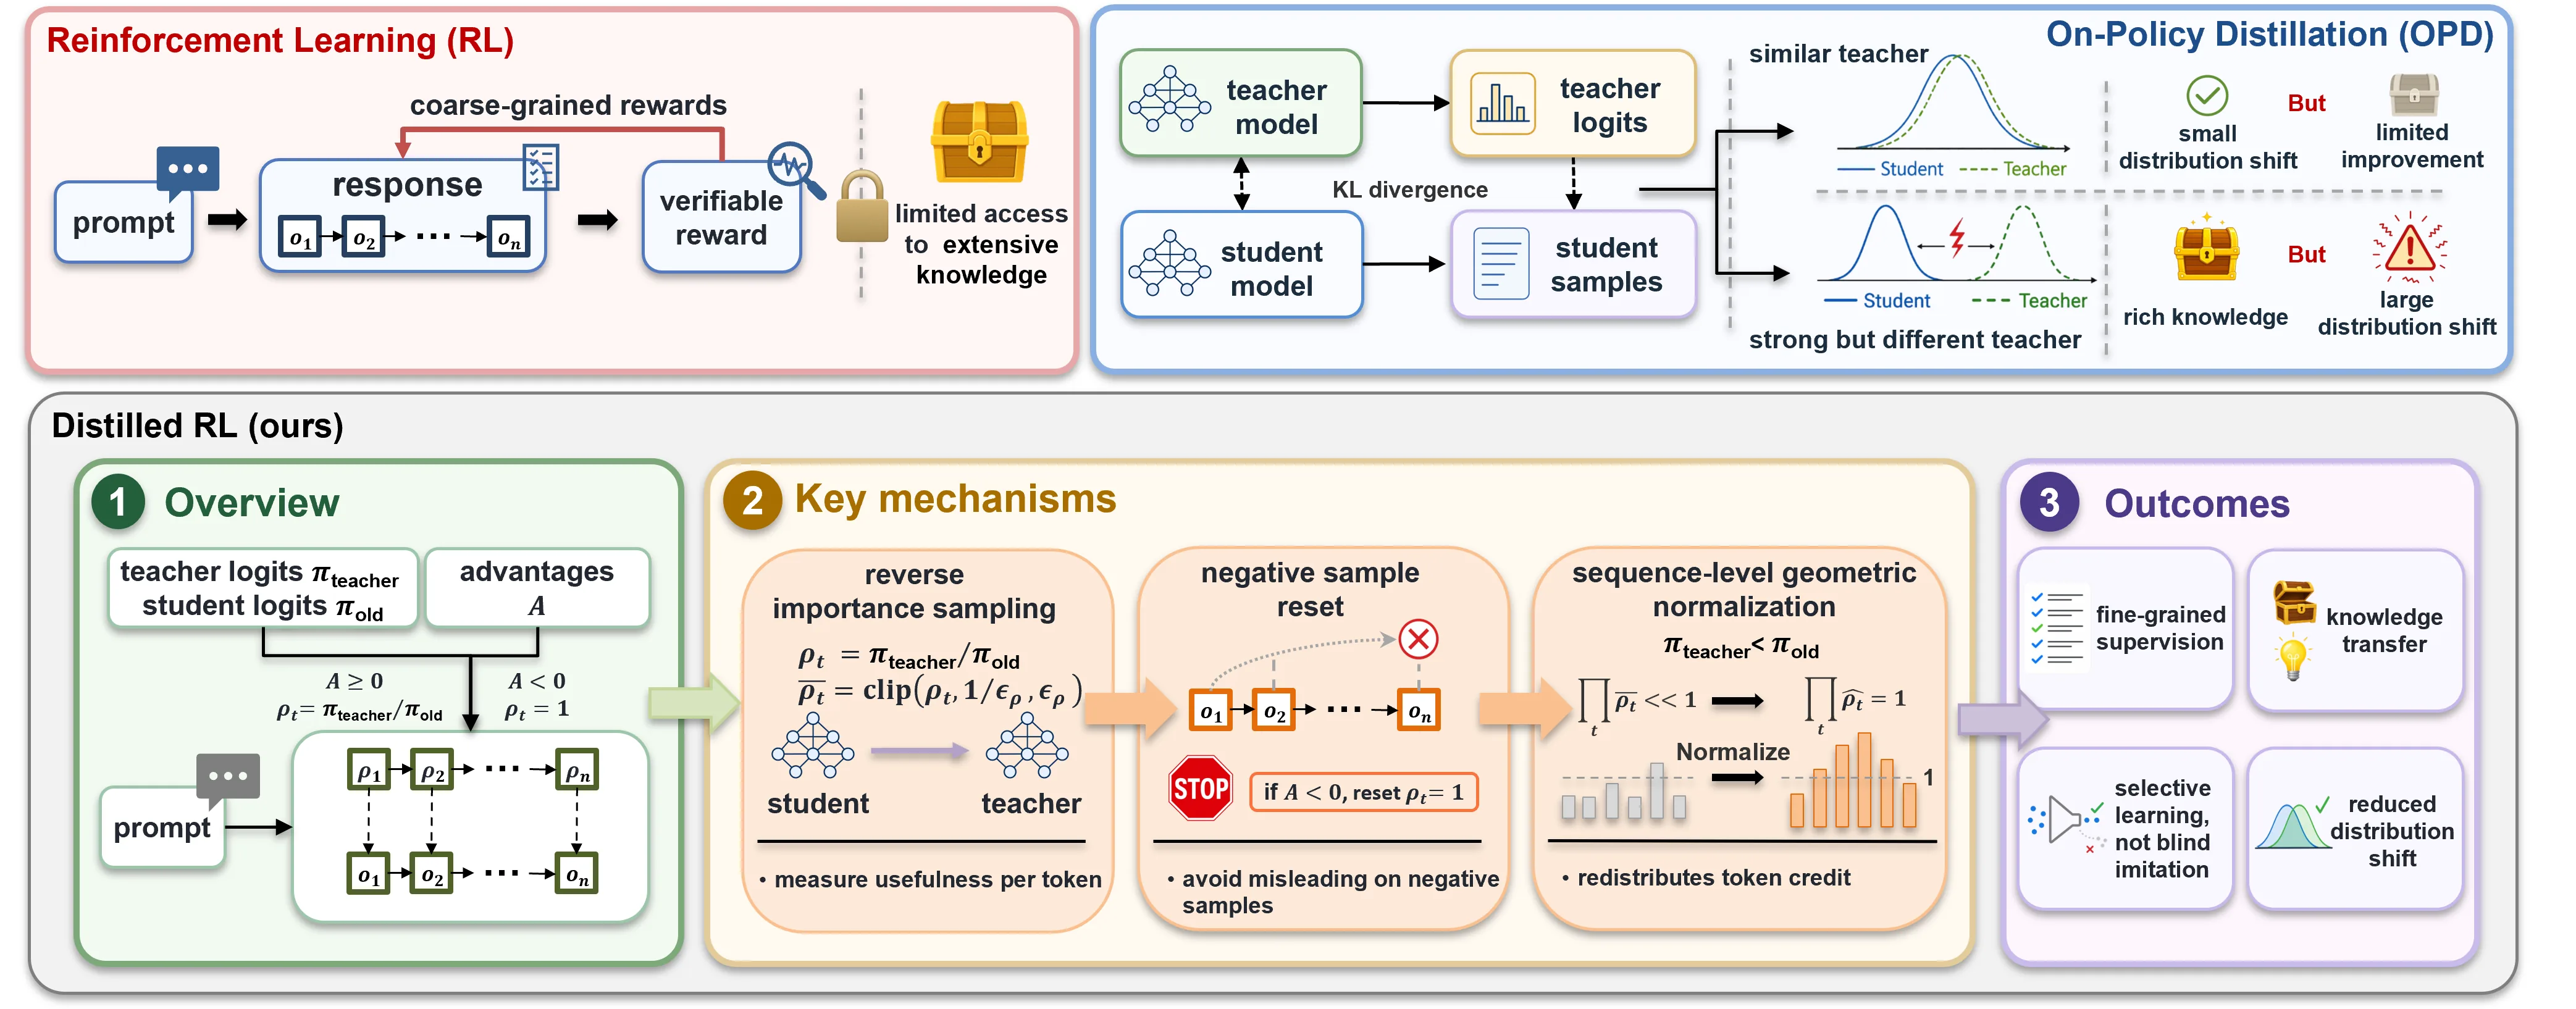
RL粗粒度结果监督导致信用分配困难、获取新知识能力有限;OPD无条件KL匹配使蒸馏被局限在同家族范围内,难以有效利用差异较大的教师。
Distilled RL将教师监督融入RL目标,包含逆向重要性采样与裁剪、负样本重置、序列级几何归一化三个组件,实现选择性新知识迁移。
同家族与跨家族蒸馏设置下,pass@1和pass@k均显著优于标准RL和OPD基线,能有效迁移原本不可用的教师知识。
Distilled RL突破了OPD仅限同家族蒸馏的局限,为LLM后训练提供细粒度知识迁移的新范式,拓展了教师模型选择范围。
🆚 方法对比
Reinforcement Learning (RL)
- on-policy训练减少分布偏移与灾难遗忘
- 有效强化学生已具备的行为能力
- 在复杂推理任务上取得显著进展
- 仅使用序列级粗粒度奖励信号
- 信用分配困难,难定位关键推理步骤
- 难以引入当前策略未覆盖的新知识
On-Policy Distillation (OPD)
- 提供密集的token级监督反馈
- 减少蒸馏数据与学生推理分布的失配
- 保留来自更强教师的细粒度指导
- KL散度无条件模仿教师分布
- 教师相似则无新知识,差异大则指导失效
- 主要局限于同家族蒸馏,跨家族性能下降
- 可能导致过早收敛,限制后续奖励提升
Distilled Reinforcement Learning (Distilled RL)
- 将教师监督集成进RL目标实现细粒度引导
- 选择性迁移新知识,避免无条件模仿在跨家族蒸馏中显著优于RL与OPD三个组件简洁可解释,有案例研究佐证
- 训练时需要教师模型参与,计算开销较大
- 三组件机制增加实现复杂度
- 依赖教师可用性,需在线推理教师策略
Reverse Importance Sampling with Clipping
- 衡量教师对每个学生token的相对偏好
- 通过裁剪防止梯度放大不稳定
- 裁剪阈值需调参,可能引入偏差
- 反向重要性比率方差较高
Negative Sample Reset
- 仅对正优势样本施加教师重加权
- 保留原始RL对负样本的惩罚信号
- 硬性重置为1可能丢失部分有用教师信号
- 二值化处理忽略了负样本中的细微差异
Sequence-Level Geometric Normalization
- 匹配自回归序列概率的乘法分解结构
- 消除师生似然系统性尺度差异
- 保留教师对token的相对偏好排序
- 几何均值归一化对极端比值较敏感
- 序列级归一化忽略token间长度差异
RL擅长强化已有行为但难引入新知识,OPD通过token级模仿提供密集信号却受限于教师兼容性;所提Distilled RL将教师监督融入RL目标,结合三组件机制,在同家族与跨家族场景下均优于RL与OPD。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
TL;DR
这篇论文针对大语言模型后训练中两条主流技术路线的各自短板,提出了一种名为 Distilled RL 的融合方法。它将教师模型的细粒度 token 级偏好嵌入强化学习目标,让 RL 框架能够选择性吸收教师知识而不陷入无条件模仿的陷阱。在同家族蒸馏(Qwen3-4B/1.7B)和跨家族蒸馏(DSQW-1.5B)等多个场景下,该方法在 pass@1 和 pass@16 指标上均显著超越了标准的强化学习和策略蒸馏基线,尤其在跨家族设置中提升最为显著。
研究背景与动机
大语言模型的后训练是决定模型实际可用性的关键阶段,当前主要依赖两条技术路线。[[强化学习]] 方法(如 GRPO、PPO)通过任务奖励信号驱动优化,能帮助模型掌握推理能力和对齐特性,但存在一个根本性的困难——[[信用分配]]。当模型生成一段完整响应后,奖励信号通常被均匀分配到所有 token 上,这种粗粒度的监督使得模型难以精确判断序列中哪一步决策导致了最终的成功或失败。更棘手的是,RL 的学习信号完全来自任务本身,对于学生模型当前尚不具备的新知识,几乎没有主动获取的能力。
另一条路线是在策略蒸馏(OPD),它通过 [[KL散度]] 让学生的 token 分布向教师模型靠拢。这种方式看似能引入教师知识,却陷入了一个两难困境:与学生相似的教师几乎无法提供新知识,而差异显著的教师因为分布失配,会在 token 级别引入大量模仿噪声,导致优化困难甚至发散。这种特性将 OPD 大多限制在同家族蒸馏的舒适区内——教师和学生模型的血缘关系足够近,分布差异尚在可控范围。
论文敏锐地观察到,将 OPD 与 RL 简单叠加(损失函数 1:1 相加)同样效果不佳。OPD 会迅速将学生推向 KL 诱导的局部最优,提前挤压了后续 RL 信号的提升空间。这说明两种范式的融合不能停留在损失函数的机械组合,而需要在优化目标的更深处实现有机整合。
方法
论文的核心思路是不把教师监督当作独立的模仿损失,而是将其转化为强化学习梯度中的 token 级加权信号。具体而言,在 GRPO 风格的组内归一化优势函数基础上,引入教师对每个 token 的偏好程度作为权重,让优化过程有选择地放大或抑制不同位置的梯度贡献。
标准 GRPO 的优势加权目标可以写为:
其中 是重要性采样比, 是优势函数。Distilled RL 在此基础上引入了教师权重 :
这里的教师权重 由反向重要性采样比 驱动,计算方式是教师模型与旧策略在第 个 token 上的似然比:
围绕这个核心机制,论文设计了三个环环相扣的组件。
第一个组件是带裁剪的反向重要性采样。与 PPO 中"行为策略→当前策略"的方向相反,这里衡量的是"教师→学生"的偏好差异。直觉上,当教师在某个 token 上给出比学生更高的似然时,说明这个 token 是教师的"偏好区域",值得学生多学习;反之则应谨慎放大。为了防止极端的似然比(通常出现在跨家族蒸馏中)造成梯度不稳定,论文对 在 区间内裁剪,取 。
第二个组件是负样本重置。当优势 (正向样本)时,使用上述 ;而当 (负向样本)时,直接令 ,恢复到标准 RL 目标。这一设计的直觉在于:负样本轨迹本身就不是好轨迹,如果继续按教师的 token 级偏好对其进行放大或抑制,只会让学生进一步偏离教师,反而抑制了知识迁移。
第三个组件是序列级几何归一化。由于采样来自学生自身分布, 出现频率较高,多个 token 的似然比累乘会系统性压低整条正向样本的学习信号。几何归一化通过将每个 token 的裁剪比 除以同一序列上所有 的几何平均,确保 。这相当于在 token 间重新分配学习信号的权重,而不改变整条响应的总体优化强度。
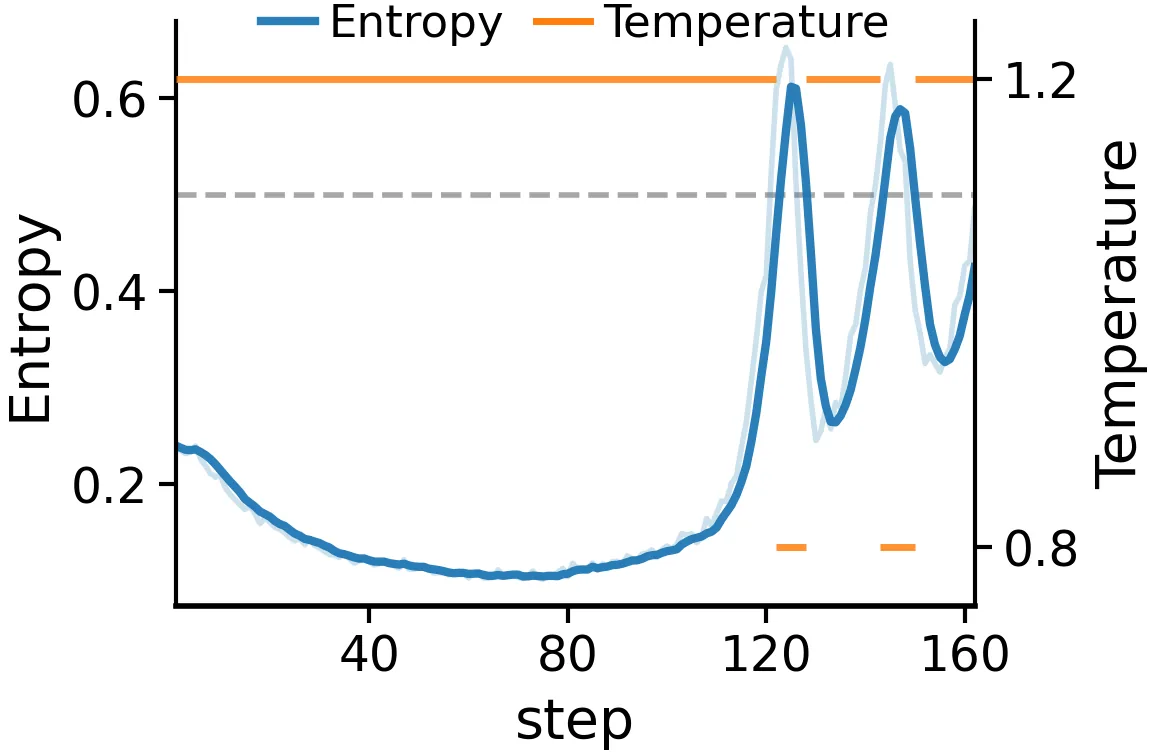
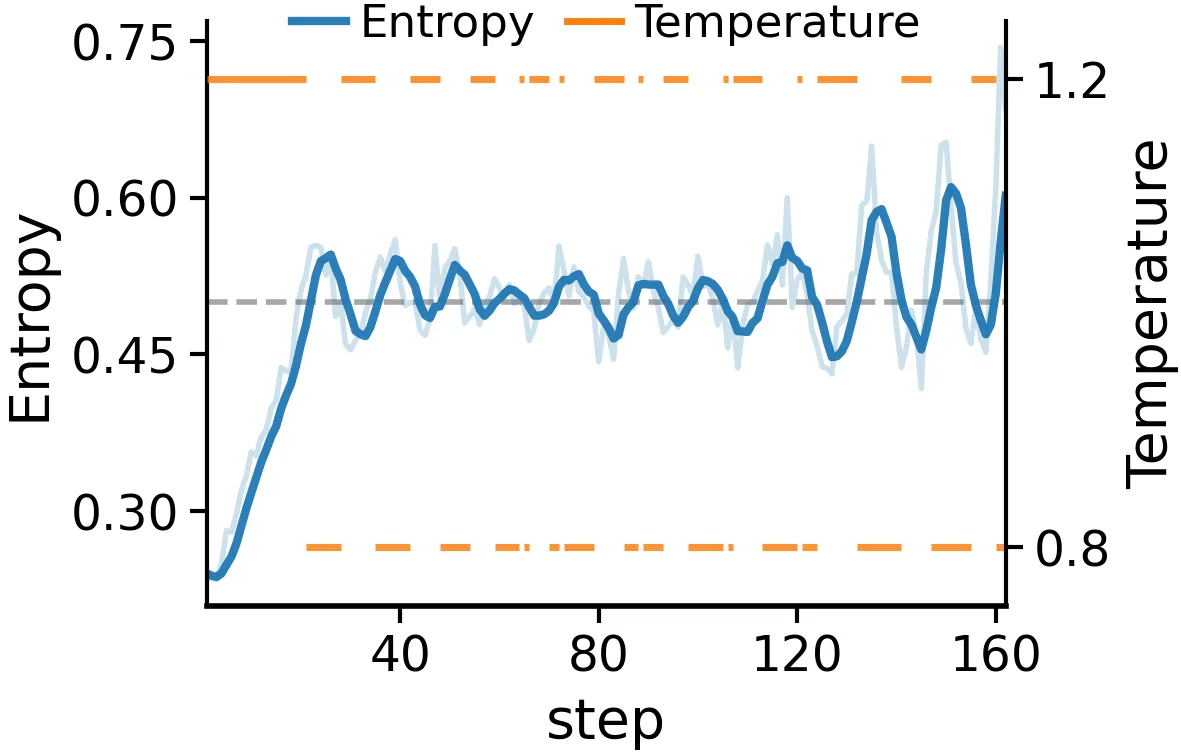
为了验证该方法确实能传递"任务奖励之外"的教师信息,论文设计了一个熵控制案例:用学生模型自身构造温度受控的"教师"(高熵时使用 ,低熵时使用 ),观察学生能否跟踪教师的熵特性。实验表明 Distilled RL 能让学生的策略熵快速进入目标区域并随教师温度动态调节,这直接证明了方法学到的是教师分布层面的特性,而非简单的奖励拟合。
实验与结果
实验在三个学生模型上展开:同家族的 Qwen3-4B 和 Qwen3-1.7B,以及跨家族的 DeepSeek-R1-Distill-Qwen-1.5B(DSQW-1.5B)。教师统一使用 Qwen3-8B-GRPO,训练数据集为 DAPO-17K。评测覆盖数学推理(AIME24/25/26、CMIMC25、HMMT25、AMC23、GSM8K、MATH500 等)和知识密集型泛化(MMLU-Pro、SuperGPQA),同时汇报 pass@1 和 pass@16 两个指标。
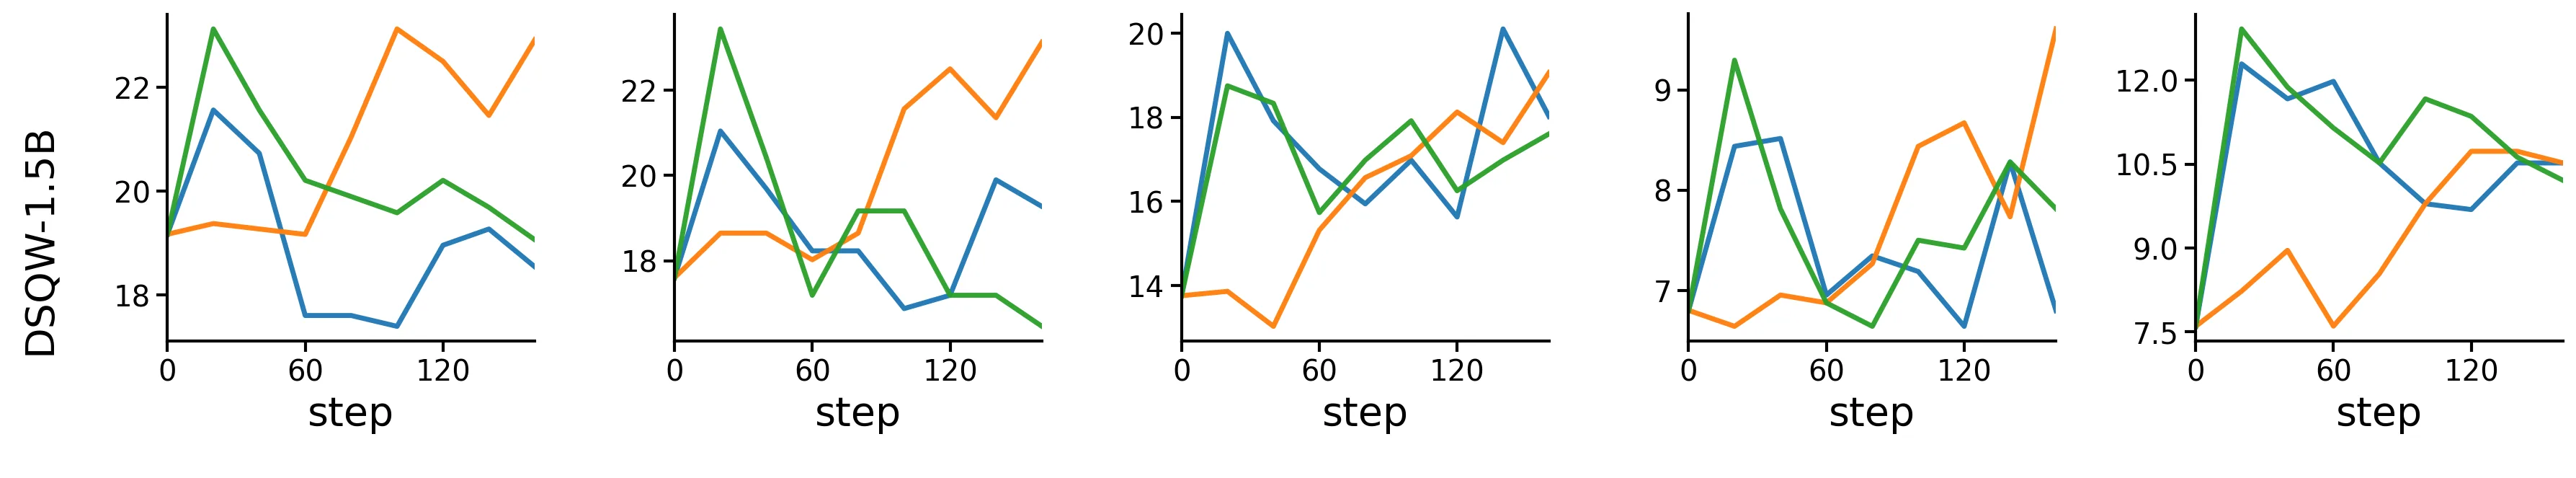
主实验结果清晰地呈现了方法的优势。在 DSQW-1.5B 这个最具挑战性的跨家族蒸馏场景中,Distilled RL 的平均 pass@1 从基线的 31.70 提升到 40.00,相比 OPD 的 35.27 和 RL 的 36.86 均有显著优势。值得注意的是,OPD+RL 在这个场景下甚至弱于纯 RL,说明无条件 KL 匹配在跨家族设置中引入了过多噪声,而 Distilled RL 通过选择性加权成功规避了这个问题。在同家族蒸馏中,Qwen3-4B 从 46.33 提升到 58.96,Qwen3-1.7B 从 39.86 提升到 46.37,均稳定超越所有基线。
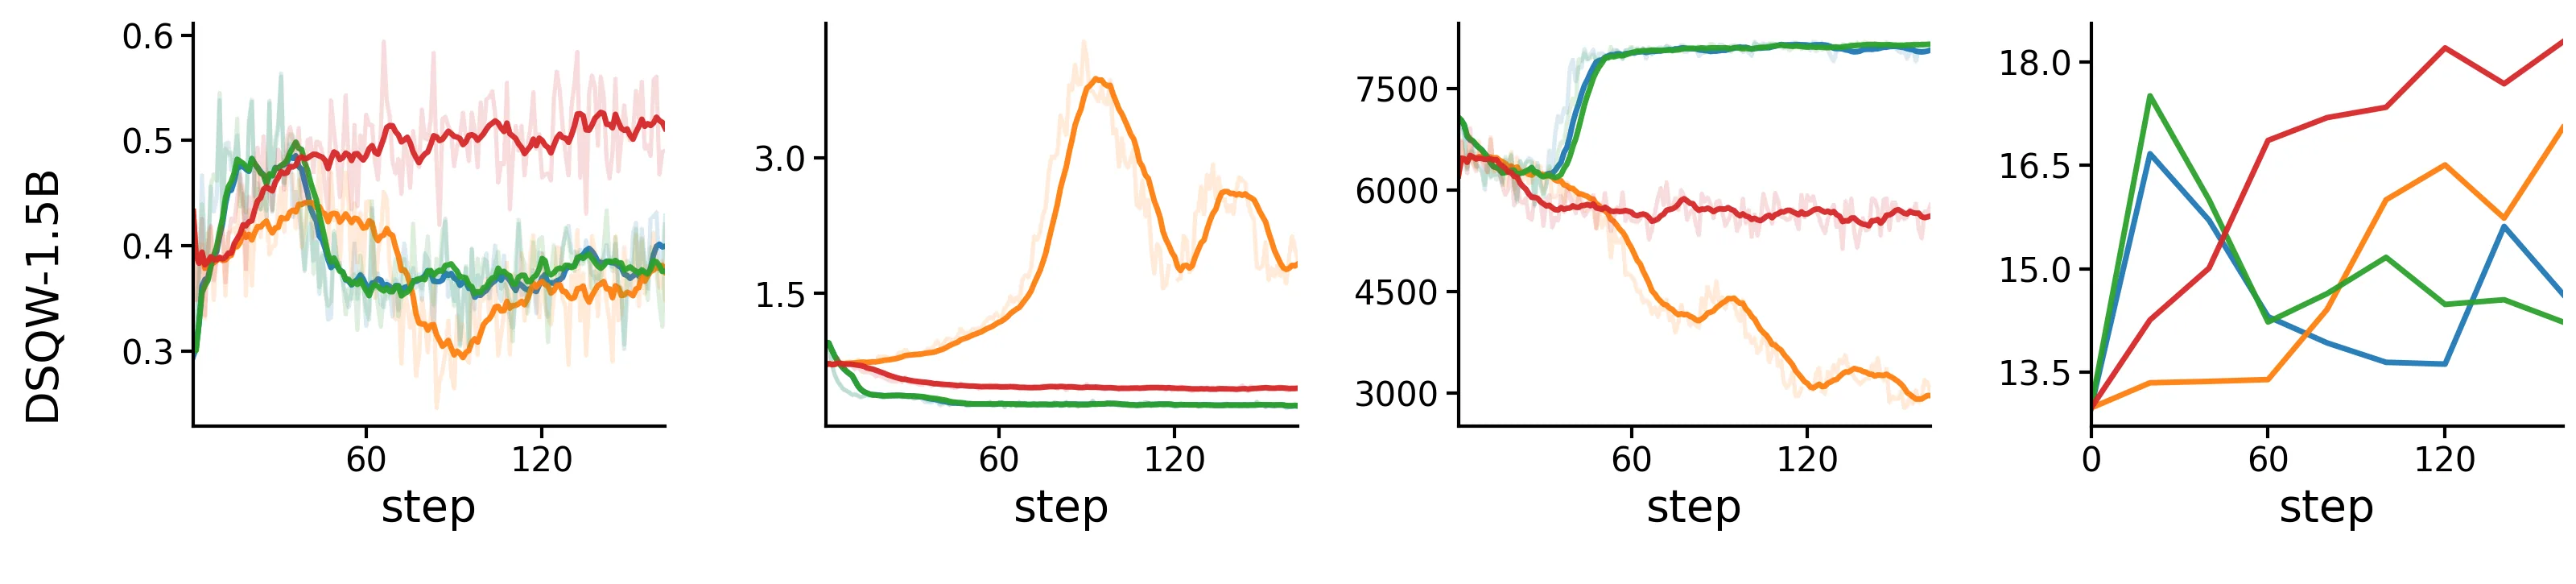
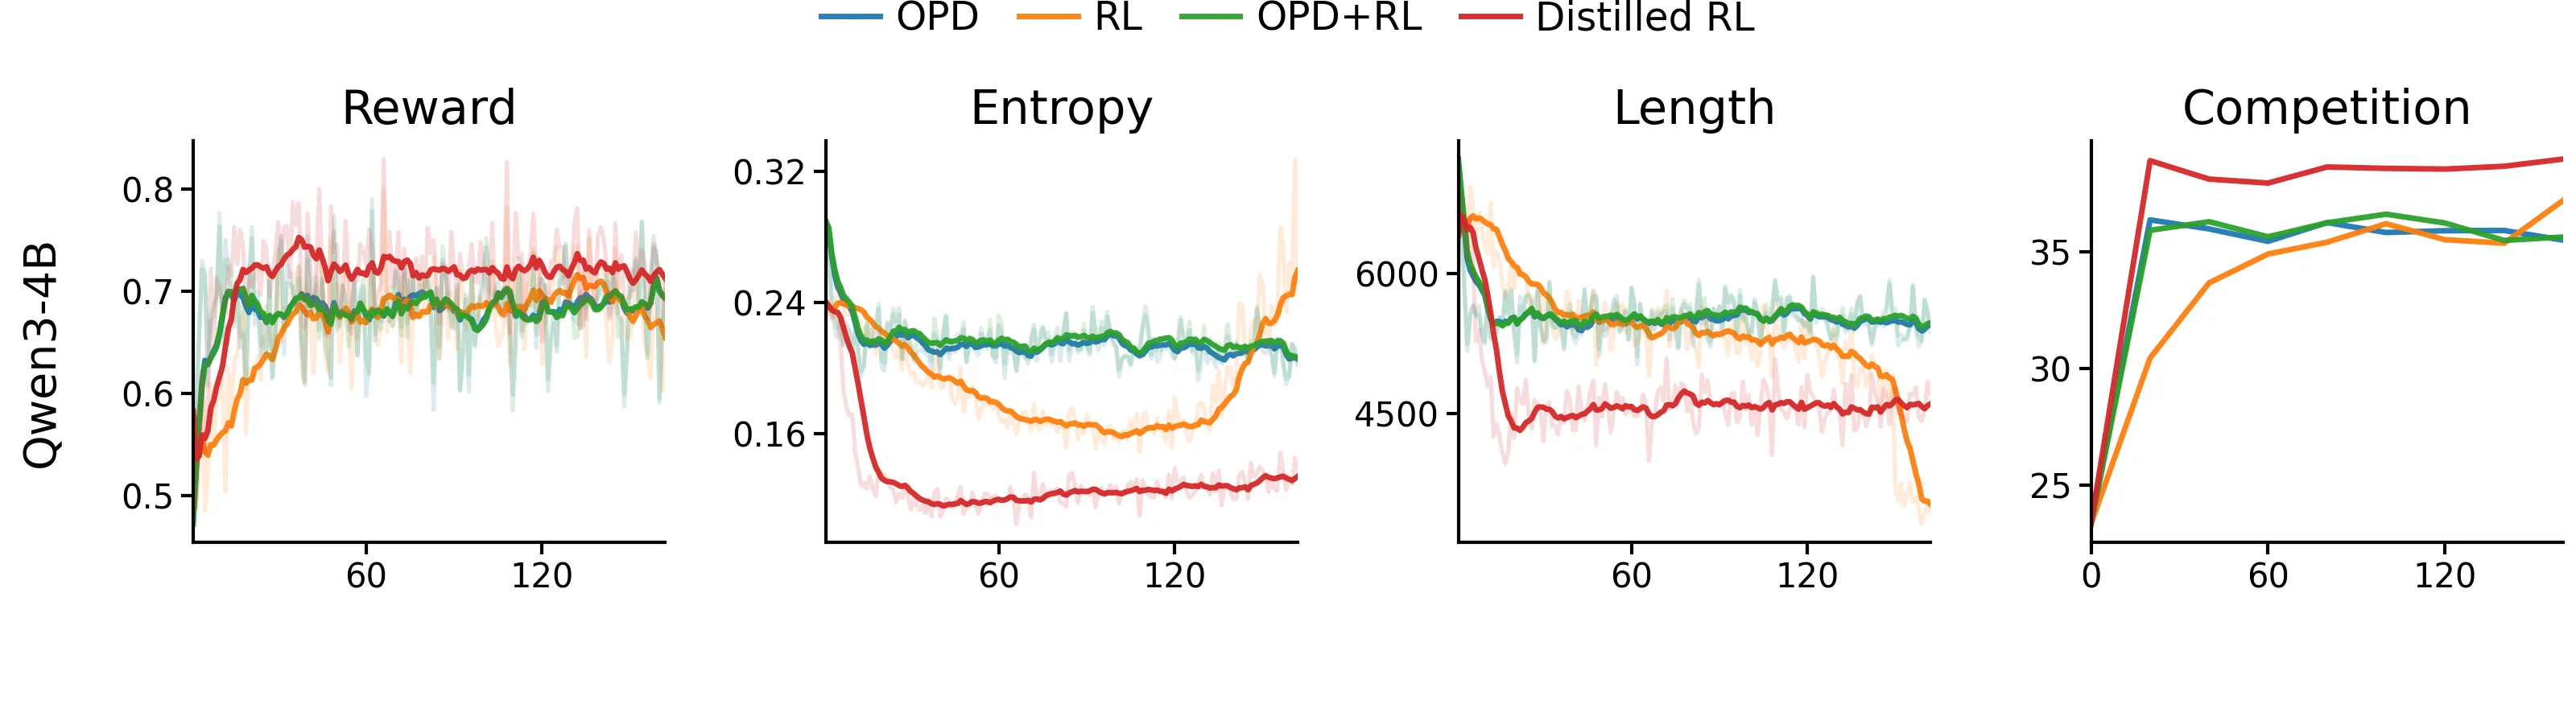
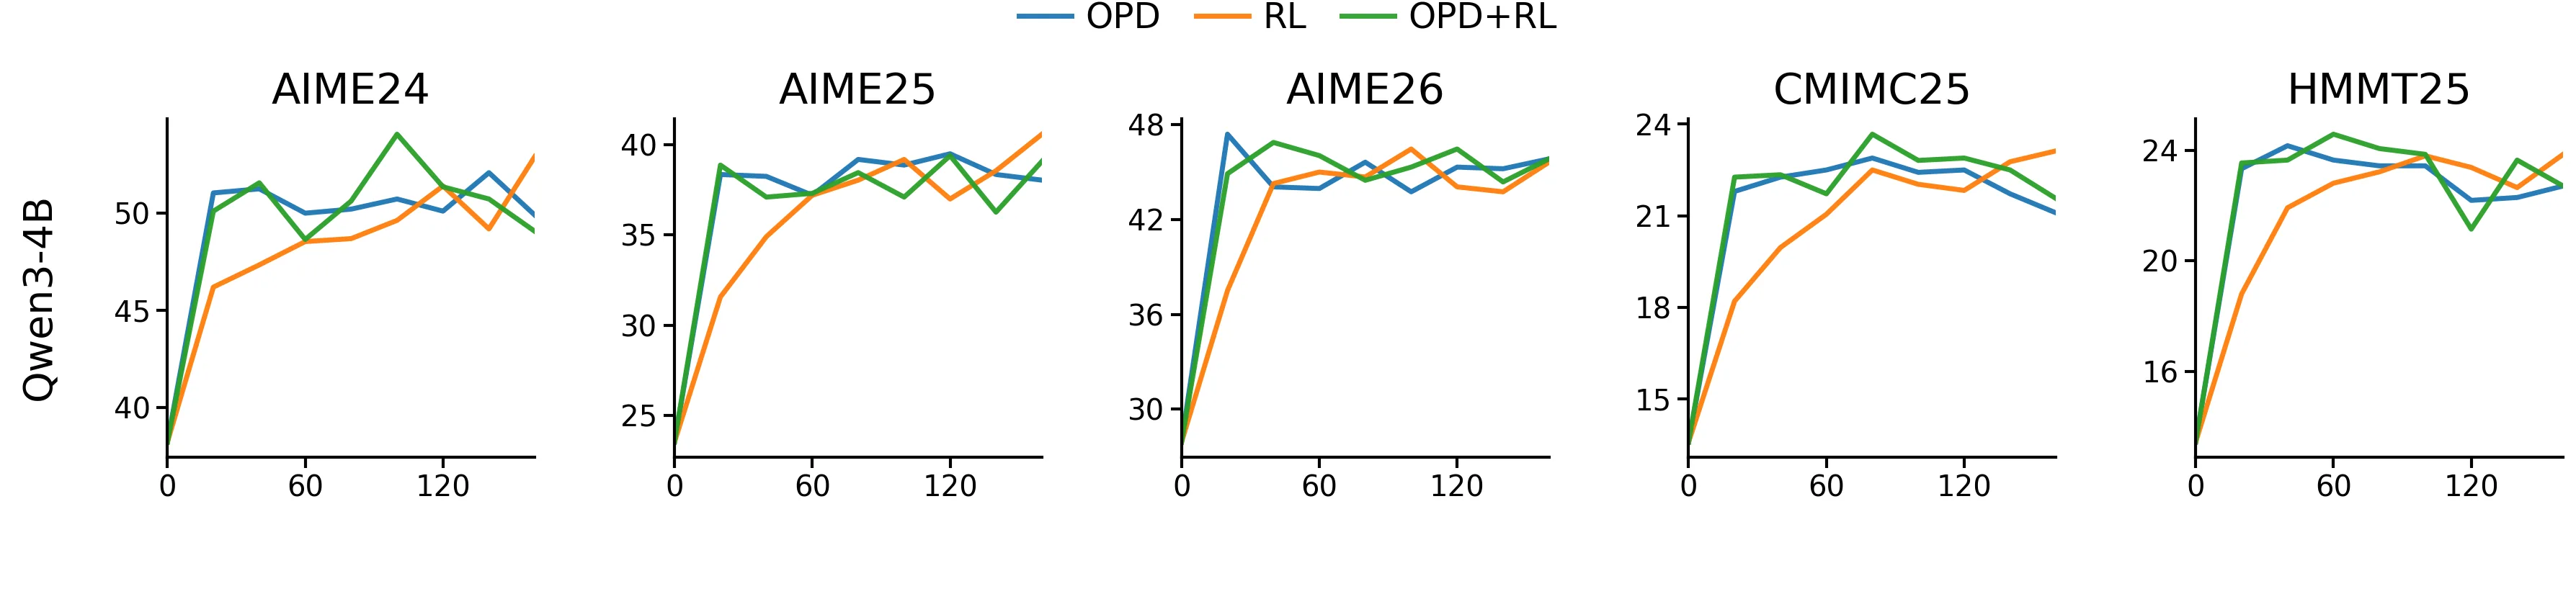
训练动力学分析揭示了背后的机制差异。OPD 收敛极快但很快陷入平台,RL 提升缓慢且不稳定,而 Distilled RL 在整个训练过程中维持了较高且稳定的奖励曲线、适中的策略熵,以及持续上升的 pass@1 表现。几何归一化在其中发挥了关键作用——没有它,正向样本的累积信号会被系统性压制,导致训练后期优势无法维持。
消融实验进一步确认了各组件的必要性。去掉负样本重置后,DSQW-1.5B 和 Qwen3-4B 的平均 pass@1 分别下降 6.39 和 8.81,是所有组件中影响最大的。去掉几何归一化的降幅略小但仍然显著,说明两个组件分别从"避免负向模仿"和"稳定信号尺度"两个角度共同保障了方法的有效性。
讨论与可借鉴点
论文的核心贡献在于重新定义了 [[知识蒸馏]] 与 [[强化学习]] 的融合方式——不是将 KL 散度作为独立损失项叠加在 RL 目标上,而是将教师的 token 级偏好转化为 RL 梯度的加权信号。这种设计让优化过程能够选择性地吸收教师知识:对于教师偏好的 token 给予更多学习权重,对于教师不偏好但任务成功的 token 保持尊重(通过负样本重置避免惩罚),对于跨家族蒸馏中极端的分布差异则通过裁剪和几何归一化稳定梯度。
方法的主要局限在于对教师能力的隐式信任。论文假设教师在每条成功样本的 token 级决策上都是可靠的,但随着学生能力增强,教师可能在某些题目上已经不如学生,此时 token 级重权可能引入次优偏好。作者在 Limitation 部分坦承这一点,并提出可通过教师 rollout、验证器或置信度门控等方式缓解,但本文尚未给出具体方案。此外,训练仅持续 160 步,对于 RL 和蒸馏方法的长期收敛行为判断尚不充分;、裁剪范围等超参的灵敏度也未系统研究。
对于该领域的后续研究,一个值得探索的方向是将教师能力的在线估计引入框架,根据师生分布差异动态调整权重区间——师生相似时放宽裁剪以充分吸收知识,差异过大时收紧裁剪以保持稳定。另一个方向是将这种选择性知识迁移的思想迁移到其他后训练场景,例如多教师蒸馏、带有代码执行反馈的 RLHF、以及长上下文推理等需要细粒度信用分配的复杂任务。
摘要
大语言模型(LLM)后训练对于提升推理能力、适应性和对齐效果至关重要。现有方法主要遵循两种范式:强化学习(RL)和在策略蒸馏(OPD)。然而,RL依赖于粗粒度的结果监督,导致信用分配困难,且获取新知识的能力有限。与此同时,OPD通过KL散度无条件地匹配教师模型的logits,这造成了一个两难困境:相似的教师模型几乎无法提供新知识,而差异显著的教师模型又往往给出无效指导,这在很大程度上将OPD限制在同系列蒸馏范围内。我们提出了蒸馏式强化学习(Distilled RL),将教师监督融入RL目标中,以提供细粒度的指导,有选择地迁移新知识,并避免无条件模仿。蒸馏式强化学习包含三个组件:带裁剪的反向重要性采样、负样本重置和序列级几何归一化。通过一个简洁而可解释的案例研究,我们证明了蒸馏式强化学习能够有效地将先前无法获得的知识从教师模型迁移到学生模型。在同系列与跨系列蒸馏设置下的大量实验表明,蒸馏式强化学习在pass@1和pass@k指标上均显著优于标准RL和OPD。代码已开源:https://github.com/597358816/Distilled-RL。
Abstract
Large language model (LLM) post-training is essential for improving reasoning, adaptation, and alignment. Existing methods mainly follow two paradigms: reinforcement learning (RL) and on-policy distillation (OPD). However, RL relies on coarse-grained outcome supervision, resulting in difficult credit assignment and limited capability to acquire new knowledge. OPD, meanwhile, unconditionally matches teacher logits through KL divergence, which creates a dilemma: similar teachers provide little new knowledge, while substantially different teachers often yield ineffective guidance, largely restricting OPD to within-family distillation. We propose Distilled Reinforcement Learning (Distilled RL), which integrates teacher supervision into the RL objective to provide fine-grained guidance, selectively transfer new knowledge and avoid unconditional imitation. Distilled RL contains three components: reverse importance sampling with clipping, negative sample reset, and sequence-level geometric normalization. Through a concise and interpretable case study, we demonstrate that Distilled RL can effectively transfer previously unavailable knowledge from a teacher model to a student model. Extensive experiments across both within-family and cross-family distillation settings show that Distilled RL substantially outperforms standard RL and OPD in terms of both pass@1 and pass@k. Our code is available at https://github.com/597358816/Distilled-RL.
论文详细总结(自动生成)
Distilled Reinforcement Learning for LLM Post-training 论文总结
一、核心问题与研究动机
LLM 后训练主要依赖两条技术路线——强化学习(RL)和在策略蒸馏(OPD)——但二者均存在显著局限:
- RL 的局限:通常将序列级奖励均匀分配到所有 token 上,监督粒度极粗,导致严重的信用分配困难;同时,RL 的学习信号主要来自任务奖励,对学生模型当前不具备的知识几乎没有获取能力。
- OPD 的局限:通过 KL 散度无条件匹配教师分布,面临两难困境——与学生相似的教师几乎不能提供新知识,而差异过大的教师则因分布失配导致 token 级模仿噪声大、优化困难。因此现有 OPD 大多被限制在同家族(within-family)蒸馏内,难以用于跨家族(cross-family)场景。
- 将二者简单相加(OPD+RL)同样效果不佳:OPD 迅速将学生推向 KL 诱导的局部最优,挤压了后续 RL 信号的提升空间。
本文的核心问题是:如何在 RL 框架内引入教师监督,使其提供细粒度的 token 级指导,并能同时适用于同家族与跨家族蒸馏?
二、方法论:Distilled RL
2.1 总体思想
不将教师监督作为独立的 KL 模仿损失,而是将其直接融入 RL 目标,通过反向重要性采样将教师对每个 token 的偏好转化为 RL 梯度中的 token 级权重,使教师充当"选择性的细粒度指导者",而非"无条件模仿目标"。
2.2 标准 RL 与 OPD 目标回顾
标准策略优化(PPO/GRPO 类)目标:
OPD 目标(在学生自生成轨迹上做反向 KL):
2.3 Distilled RL 目标
将教师对 token 的似然作为权重引入 GRPO 风格的优势加权目标:
其中
2.4 三大核心组件
1. 反向重要性采样 + 裁剪(Reverse importance sampling with clipping)
- 与 PPO/GRPO 的"行为策略→当前策略"修正方向相反,此处将"学生采样轨迹"按"教师/学生"似然比 加权。
- 同时对 在 内裁剪(论文取 ),防止极端 teacher-student 似然比造成梯度不稳定。
2. 负样本重置(Negative sample reset)
- 当 (正向样本)时,使用 ;当 (负向样本)时,令 ,即恢复为标准 RL 目标。
- 直觉:负样本意味着该轨迹本身不佳,若仍按教师偏好放大或抑制 token,会把学生推离教师,反而抑制知识迁移。
3. 序列级几何归一化(Sequence-level geometric normalization)
- 由于采样自学生分布, 出现频率高,多个 token 累乘会系统性地压低正向样本的学习信号。
- 将每个 token 的裁剪比 除以同一序列上所有 的几何平均,保证 ,仅在 token 间重新分配学习信号,而不改变整条响应的总体优化强度。
2.5 可解释的熵控制案例
为证明该方法能传递"任务奖励之外"的教师信息,作者用学生模型自身构造温度受控的"教师"(entropy > 0.5 时使用 ,否则 ),观察学生熵能否跟踪阈值。结果显示学生熵快速进入目标区域并随教师温度调节,验证了 Distilled RL 确实能学到教师分布层面的信息,而非仅由奖励驱动。
三、实验设计
3.1 训练与评测框架
- 实现框架:EasyR1 与 VeRL。
- 教师模型:Qwen3-8B-GRPO。
- 学生模型:Qwen3-4B(同家族)、Qwen3-1.7B(同家族)、DeepSeek-R1-Distill-Qwen-1.5B(DSQW-1.5B,跨家族)。
- 训练集:DAPO-17K。
- 关键超参:global batch size=128、mini-batch=64、micro-batch/GPU=2、rollout 组大小 、最大 prompt 长度 2048、最大响应长度 8192、采样温度 1、top-p 0.99、学习率 、训练 160 步、policy clip 、、GRPO 风格组内归一化优势、二元正确性奖励。
3.2 评测基准
- 数学推理:AIME24/25/26、CMIMC25、HMMT25、AMC23、GSM8K、MATH500、Minerva、Olympiad。
- 知识密集型泛化:MMLU-Pro、SuperGPQA(取 500 例固定子集)。
- 评测指标:Pass@1(32 次采样、温度 0.1、top-p 0.95)和 Pass@16。
3.3 对比方法
- Base:未做后训练的学生原始模型。
- OPD:在学生自生成轨迹上做反向 KL 蒸馏。
- RL:GRPO。
- OPD+RL:两损失按 1:1 直接相加。
- Distilled RL(本文方法)。
四、资源与算力
论文未明确披露所用 GPU 型号、数量、墙钟训练时长等算力细节,仅说明训练步数为 160、全局 batch size=128、组大小 、最大响应长度 8192 等配置,并基于 EasyR1/VeRL 框架实现。读者可据此估算:160 步 × 128 条 prompt × 8 rollouts ≈ 约 16 万次响应采样(含 8192 token 的最大长度),算力消耗较大,但论文没有给出具体 GPU 类型、并行规模或 wall-clock 时间。
五、实验数量与充分性
实验规模较为充分,主要包括:
1. 主结果(Tables 2–3):3 个学生模型 × 10 个数学基准 × 4 个对比方法,Pass@1 与 Pass@16 双指标;并单独对比了跨家族蒸馏(DSQW-1.5B)。
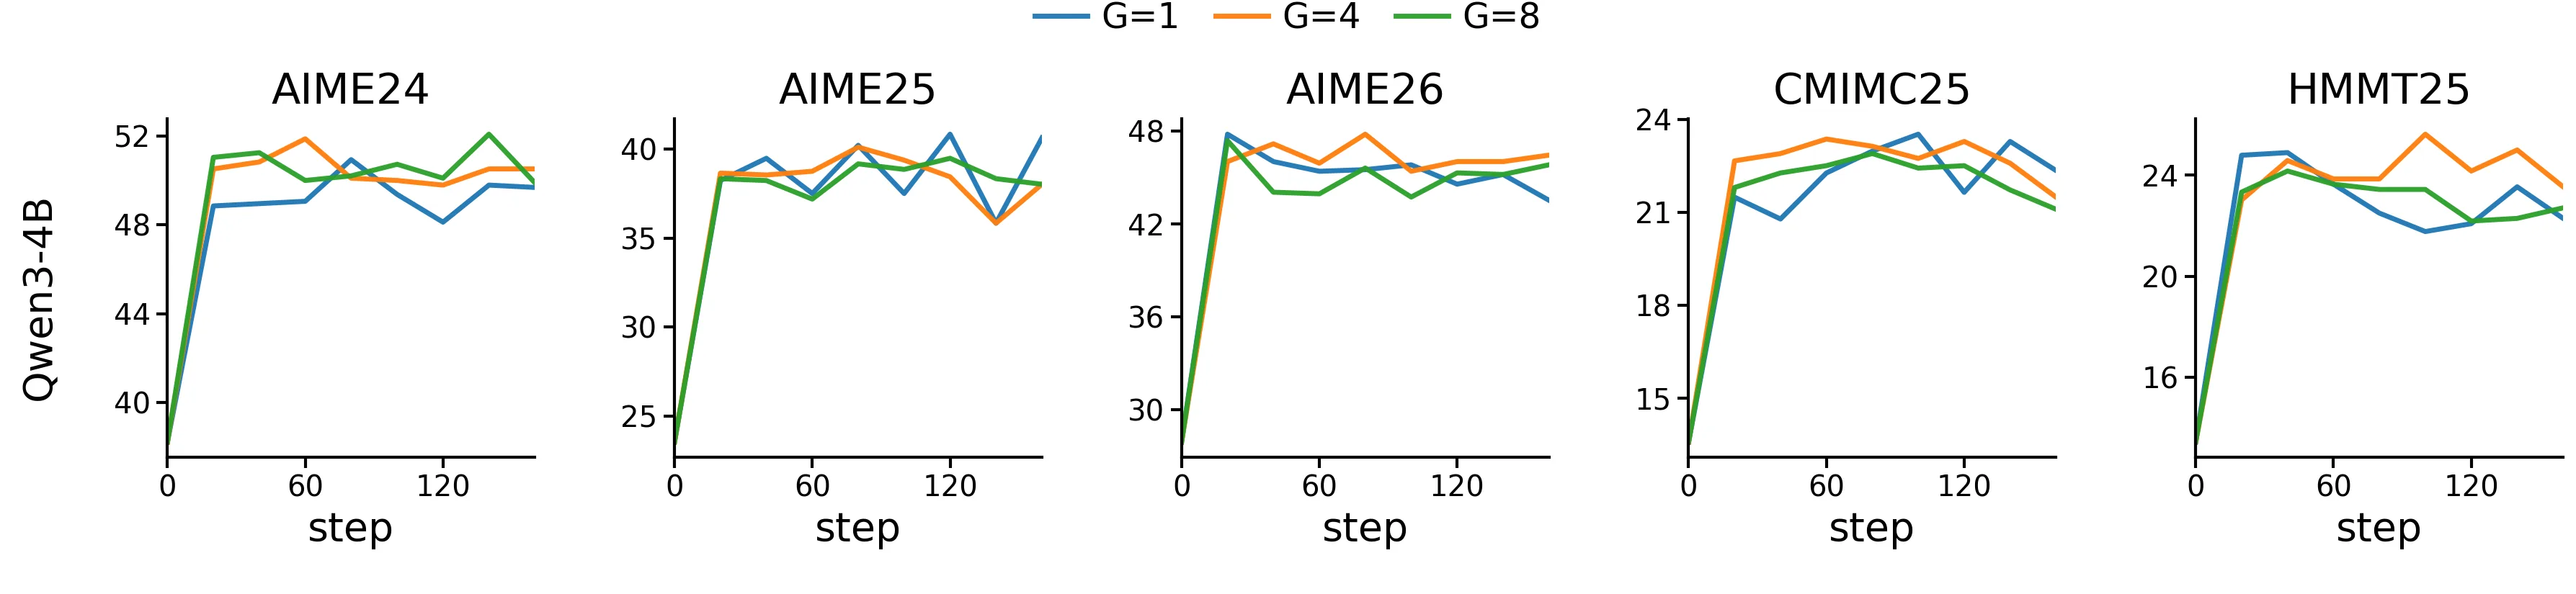
2. 训练动力学分析(Fig. 2, 3, 5):在 5 个竞赛基准上对比奖励、策略熵、响应长度、平均 Pass@1 等曲线;并研究了 rollout 组大小 对 OPD 的影响。
3. 可解释性实验(Fig. 4, 6):熵控制教师实验验证信息迁移能力,并配合消融展示负样本重置的作用。
4. 消融实验(Table 4):在 DSQW-1.5B 与 Qwen3-4B 上分别去掉"负样本重置"和"几何归一化",验证两组件对平均 Pass@1 的贡献(去掉负样本重置降幅最大,分别 -6.39 与 -8.81)。
5. 泛化性评估(Table 3):MMLU-Pro 与 SuperGPQA 验证未过拟合于数学推理。
总体看,实验覆盖了同家族、跨家族、多基准、多指标、多模型,辅以动力学与消融分析,实验较为充分且公平(统一训练步数、prompt 分布、rollout 预算与评测协议)。不过消融只涉及两个组件的"整体开关",未对 、 裁剪范围等做更细致的灵敏度研究。
六、主要结论与发现
- 在 3 个学生模型、10 个数学基准上,Distilled RL 在 Pass@1 上均稳定优于 OPD、RL 与 OPD+RL。DSQW-1.5B 平均从 31.70 提升到 40.00(+4.73 vs OPD、+3.14 vs RL);Qwen3-4B 从 46.33 提升到 58.96;Qwen3-1.7B 从 39.86 提升到 46.37。
- 在 MMLU-Pro 与 SuperGPQA 上,Distilled RL 同样取得最佳或极具竞争力的成绩,未损害通用知识能力。
- 在 Pass@16 评测下,Distilled RL 在多数竞赛基准上继续领先,说明其不仅提升最高概率响应,还整体改善了响应分布。
- 跨家族蒸馏场景提升尤为显著:DSQW-1.5B 上 OPD+RL 仍弱于 RL,而 Distilled RL 反超所有基线,证明选择性融入教师偏好比无条件 KL 匹配更鲁棒。
- 训练动力学上,Distilled RL 在训练中维持较高且稳定的奖励、适中策略熵、稳定的响应长度,并保持 Pass@1 的持续上升;OPD 早收敛,RL 提升慢。
- 熵控制案例证明 Distilled RL 能迁移"奖励信号之外"的教师分布特性。
七、优点与亮点
1. 问题定位精准:明确指出 RL 与 OPD 的互补短板,并将二者融合的失败归因于"无条件模仿压制后续奖励优化",逻辑清晰。
2. 设计简洁可解释:三大组件各对应一个明确动机——稳定梯度(裁剪)、避免负向模仿(reset)、消除系统性尺度偏差(几何归一化),且均有直观数学与表格说明。
3. 跨家族蒸馏的实质性突破:在 DSQW-1.5B 这一挑战性场景中显著领先,是相对 OPD 体系的重要扩展。
4. 包含可解释性案例研究:用熵控制教师直接证明"信息传递"而非"奖励拟合",提供了一种简洁的因果性验证范式。
5. 训练动力学与泛化评测齐备:同时报告奖励、熵、响应长度、Pass@1/Pass@16 与知识密集基准,避免了"只在狭窄数学任务上自证"的常见缺陷。
6. 开源代码:提供完整实现。
八、不足与局限
1. 隐含假设较强:方法默认教师对每条成功样本都具备"值得模仿"的能力,但随着学生增强,教师可能在某些题目上并不优于学生,此时 token 级重权仍可能引入次优偏好。论文在 Limitation 部分坦承这一点,并提出可通过教师 rollout、验证器、置信度门控等方式缓解,但本文并未给出对应方案。
2. 教师能力无显式估计:缺少对教师能力的在线评估或动态衰减机制,存在当教师局部弱于学生时"反向灌入噪声"的潜在风险。
3. 算力信息缺失:未披露 GPU 型号/数量、墙钟训练时长、显存占用等关键算力细节,复现成本难以预估。
4. 超参研究有限:未对 、裁剪范围、几何归一化方式等进行系统灵敏度分析,方法的最优工作区间与鲁棒性边界尚不完全清楚。
5. 训练步数偏少:仅 160 步训练,对 RL/蒸馏方法长期收敛行为的判断仍不充分;Pass@1 曲线是否在更长训练下仍单调上升也未验证。
6. 基线覆盖不全面:缺少与 DPO、KDRL、MiniLLM 等近期 RL+KD 融合方法的直接对比;KL 系数、OPD+RL 混合比也仅取了单一设置。
7. 评测场景单一:主要面向数学推理与两项知识密集基准,对代码、对话、Agentic 等后训练常见场景未涉及,方法在异构任务上的迁移性尚待验证。
8. 跨家族边界不清晰:虽然 DSQW-1.5B 上表现良好,但对更大规模或更异构教师(如完全不同的 tokenizer、跨模态教师)的可推广性未作讨论。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。