
基于逆向强化学习的数字孪生用于意图驱动的无人机网络
Inverse-Reinforcement Learning Enabled Digital Twin for Intent-based Drone Networks
📝 TLDR
针对意图驱动无人机基站在资源受限、动态无线网络中的轨迹设计难题,中心服务器部署的数字孪生系统需在无法实时获取DBS服务优先级的前提下提供调整建议。提出基于逆向强化学习的数字孪生驱动方案,从观测行为中反推DBS意图,求解优先用户服务率最大化的轨迹优化问题。仿真表明该方案可实时近优调整轨迹,相比传统车载强化学习减少约85%性能损失,较普通无人机网络整体性能提升最高2.5倍。
🧭 速览
动态无线环境中DBS轨迹需随环境变化调整,但数字孪生无法实时获取随时间演化的DBS服务意图,导致基于过时信息的轨迹优化效果受限。
采用逆向强化学习从DBS观测行为中推断未知意图,结合数字孪生仿真预测环境变化,迭代求解最大化优先用户服务率的轨迹。
方案可近实时提供近最优轨迹,相比车载RL方案减少约85%性能损失,较无DT辅助的标准无人机网络性能提升最高2.5倍。
IRL与数字孪生结合有效解决意图未知与环境不确定下的轨迹自适应问题,为无人机网络意图感知提供了新范式。
🆚 方法对比
IRL-based DT actuation (作者提出方案)
- 在未知DBS意图下提供近实时、近最优轨迹调整
- 性能损失比传统RL板上控制减少约85%
- DT框架使网络性能提升最高达2.5倍
- 无需访问DBS核心意图即可推断服务优先级
- 依赖间歇性DBS-DT服务器连接,存在同步延迟
- IRL推断的意图准确性影响轨迹调整质量
- 仿真验证,实际部署的计算开销未知
Gaussian-based trajectory design 方法 [14]-[16]
- 基于高斯模型快速估计信道与用户分布
- 板上计算资源有限时可快速更新轨迹
- 实现简单,计算开销较低
- 欠拟合真实动态,仅服务平均需求
- 无法适应训练环境外的突发变化
- 对复杂用户行为建模能力有限
Reinforcement Learning based trajectory design [17]-[20]
- Double Q学习可最大化DBS网络容量
- 迁移RL加速灾后轨迹搜索
- 多智能体RL支持无线供电DBS优化
- 过度拟合训练环境,对意外环境变化反应迟缓
- 无法及时调整轨迹响应突发障碍
- 训练成本高,泛化能力受限
Meta learning based trajectory adaptation [21][22]
- 支持动态环境下的加速轨迹自适应
- 有助于DBS快速适配新场景
- 结合先验知识减少学习时间
- 仍需DBS反复飞行采集环境信息
- 响应用户需求存在延迟
- 对快速变化环境的适配有限
Digital Twin frameworks for drones [23]-[25]
- 无人机群DT支持协同操作规划
- 联邦DT提升状态快速变化的实时保真度
- 多尺度DT支持宏观关联与微观路径规划
- 缺乏对DBS意图的解释能力
- 主要依赖优化驱动范式,计算密集
- 未捕获DBS决策驱动的网络动态
传统RL板上DBS控制 (对比基线)
- 板上自主决策,不依赖远程服务器
- 可直接感知本地环境进行控制
- 对环境变化适应性差,性能损失大
- 板上计算资源有限,难以训练复杂模型
标准DBS网络含错误延迟感知 (对比基线)
- 实现简单,部署成本低
- 无需DT基础设施支持
- 环境感知错误且延迟严重
- 网络性能显著低于DT增强方案
作者提出的IRL-based DT方案结合了DT的预测能力与IRL推断未知意图的优势,相比传统RL板上控制和含错误延迟感知的标准网络在性能损失上减少约85%、性能提升达2.5倍,显著优于Gaussian-based、RL-based、Meta-learning以及现有DT框架等被对比方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
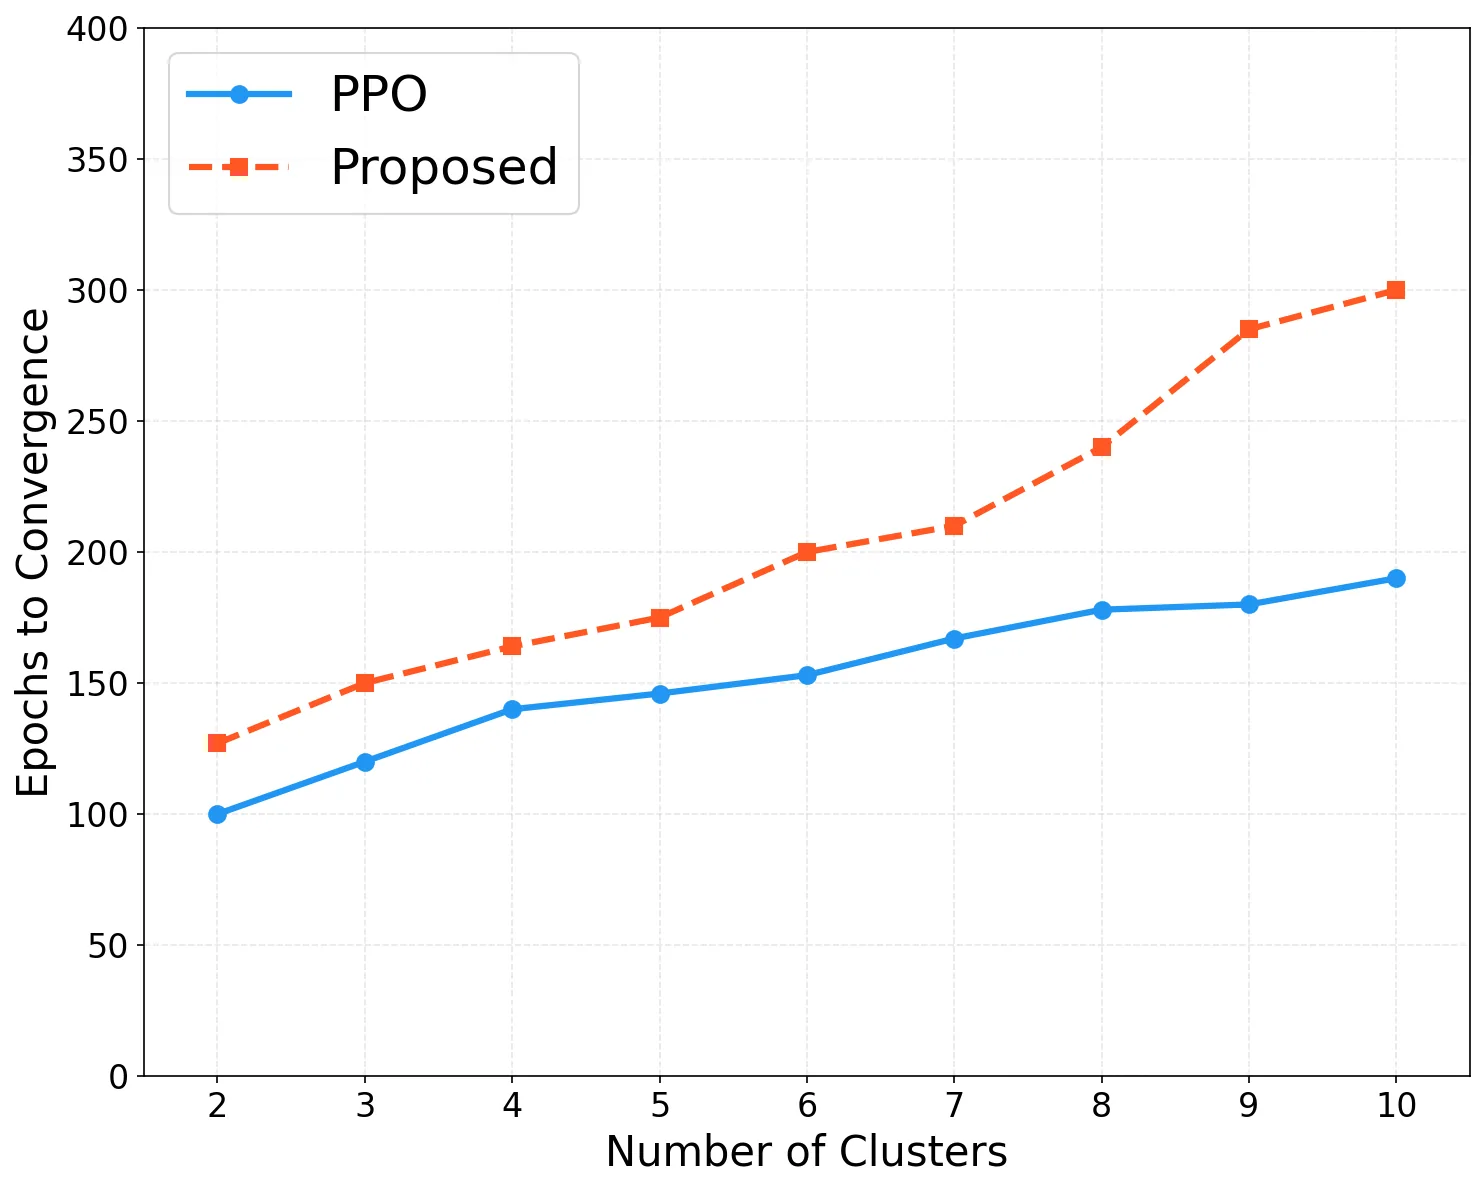
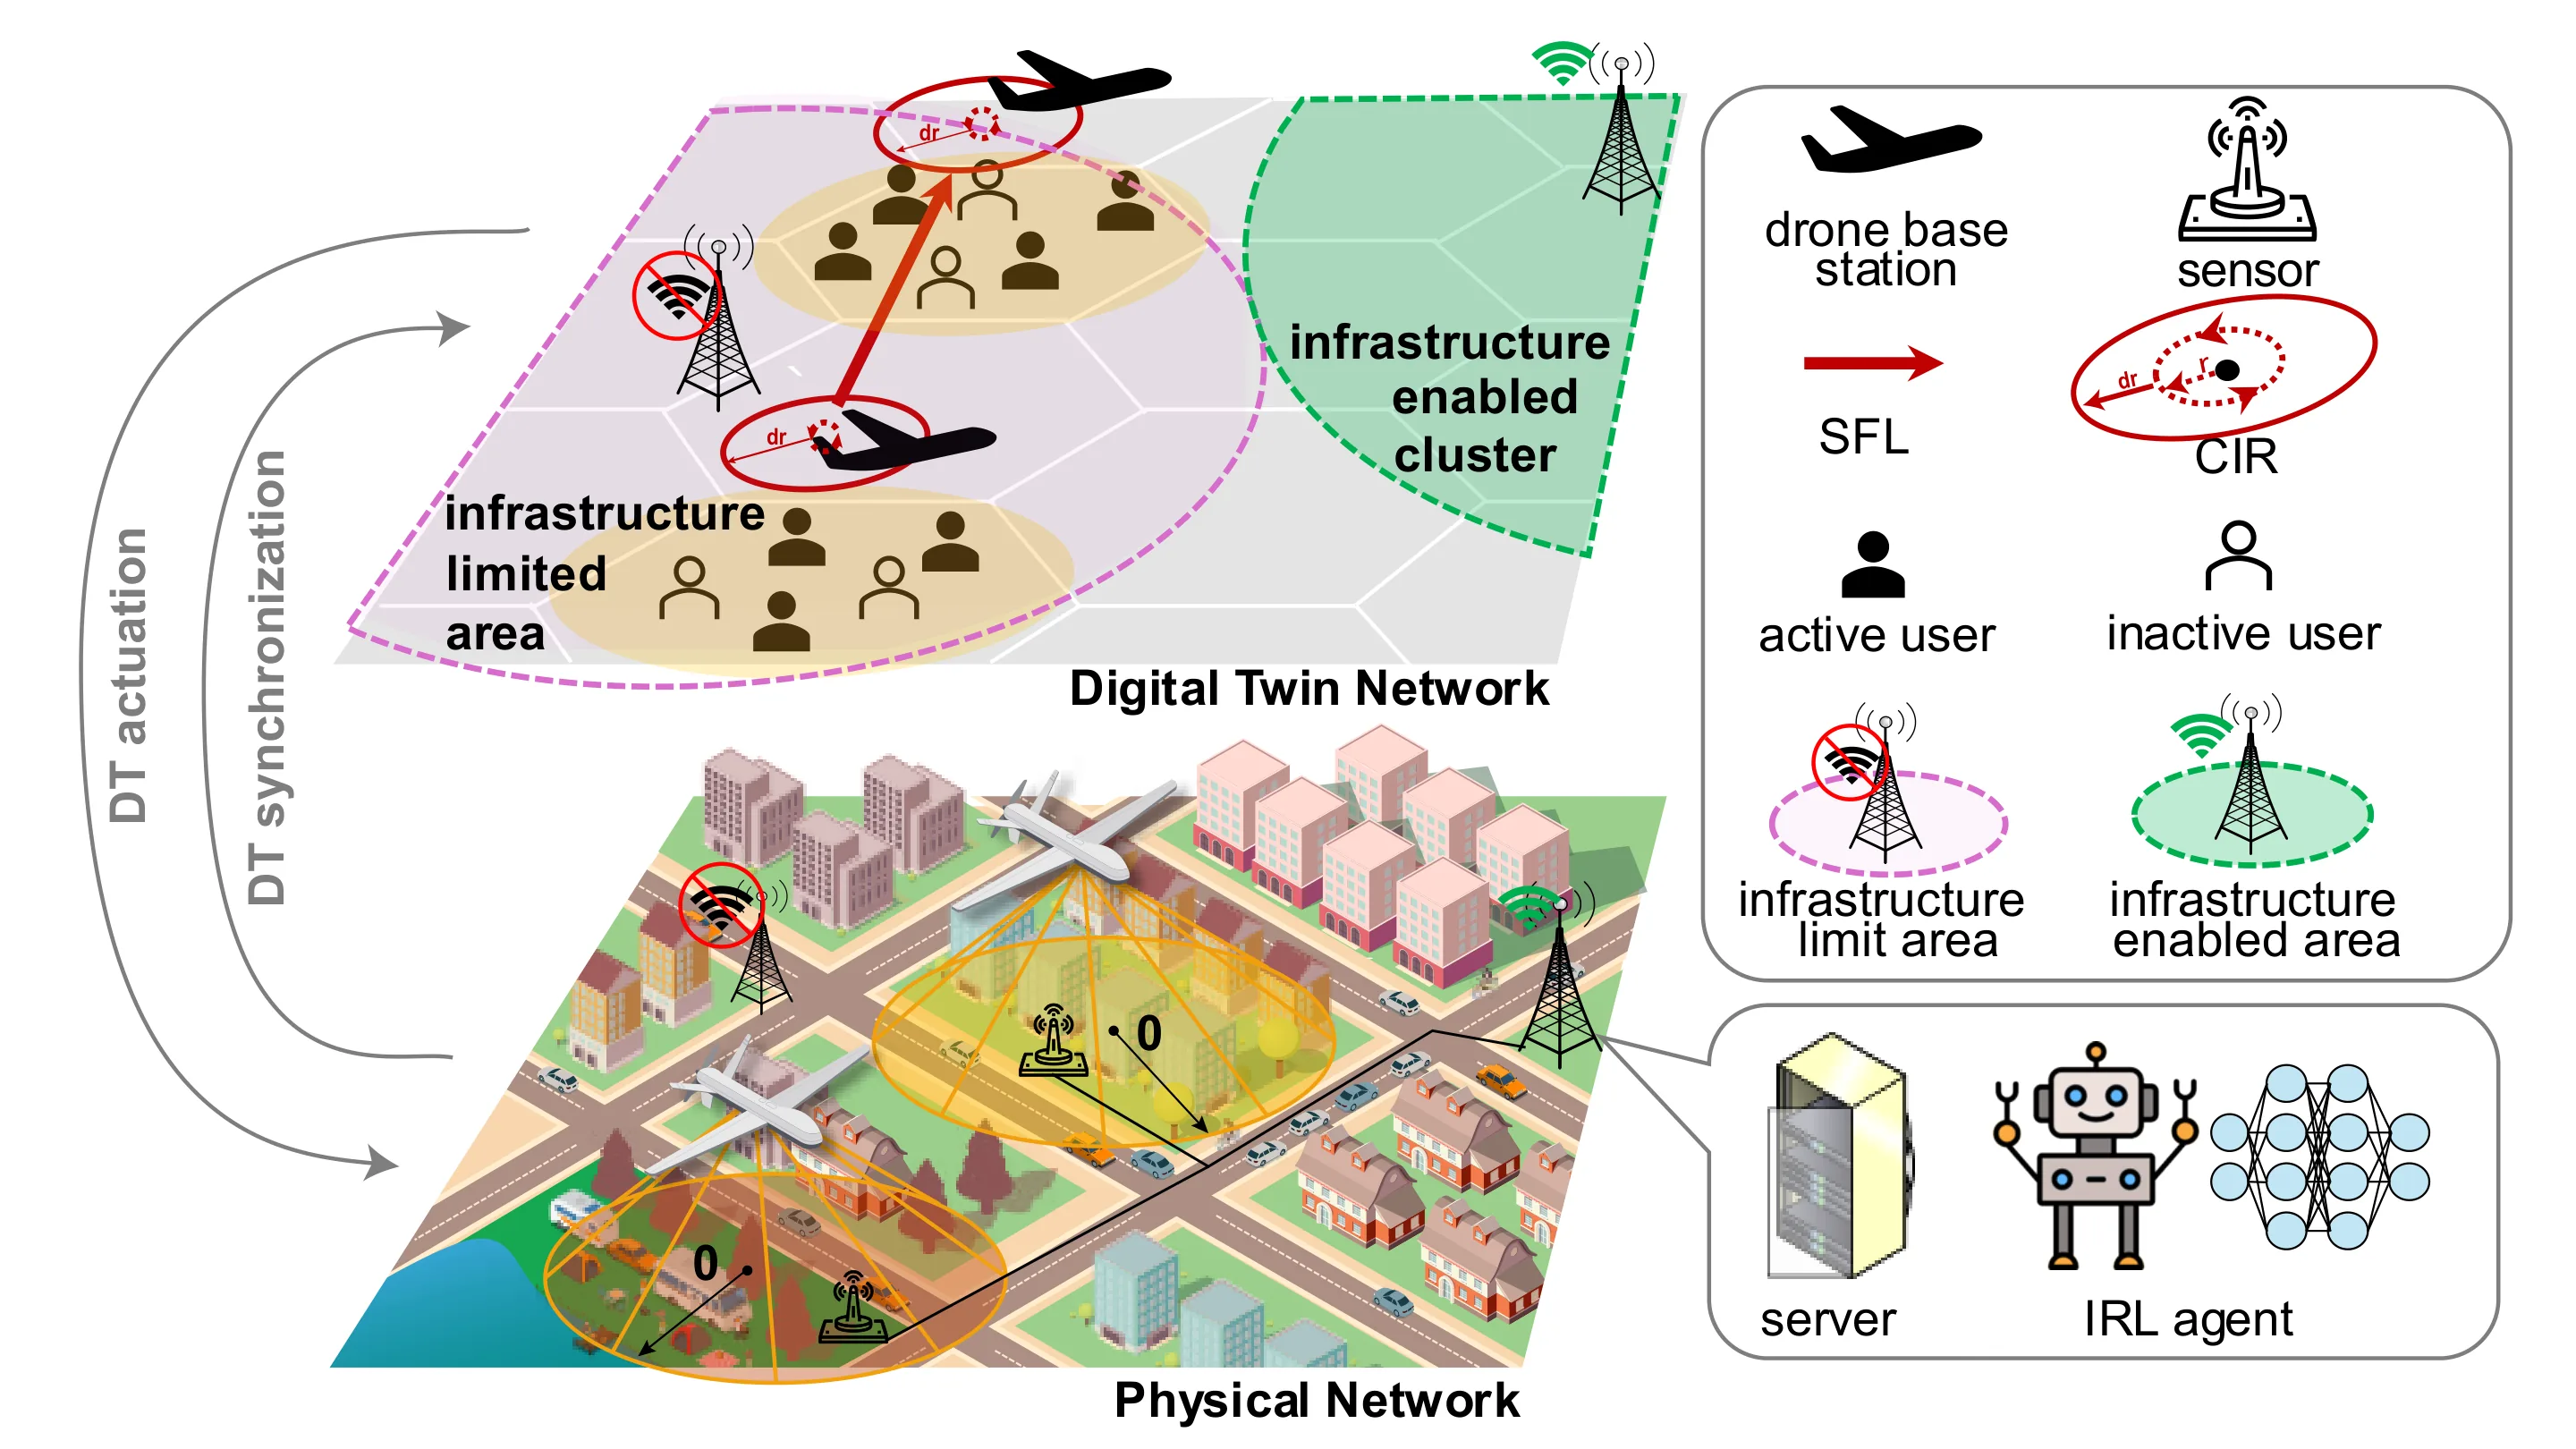
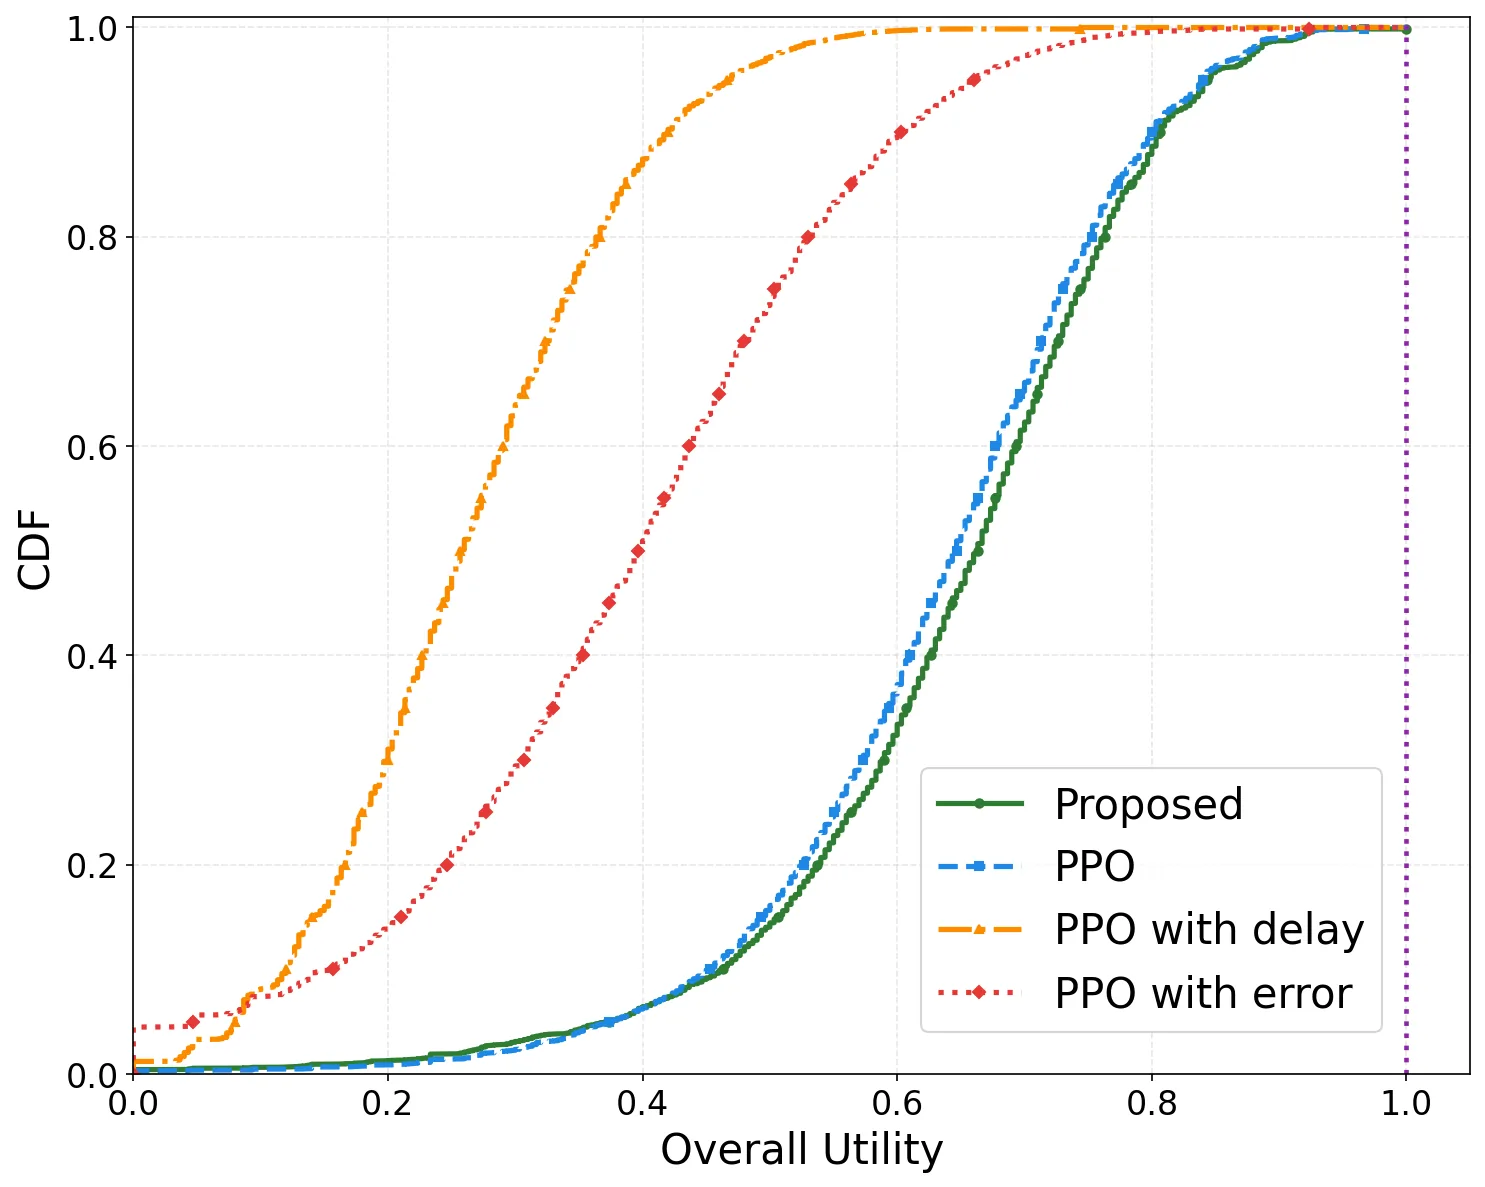
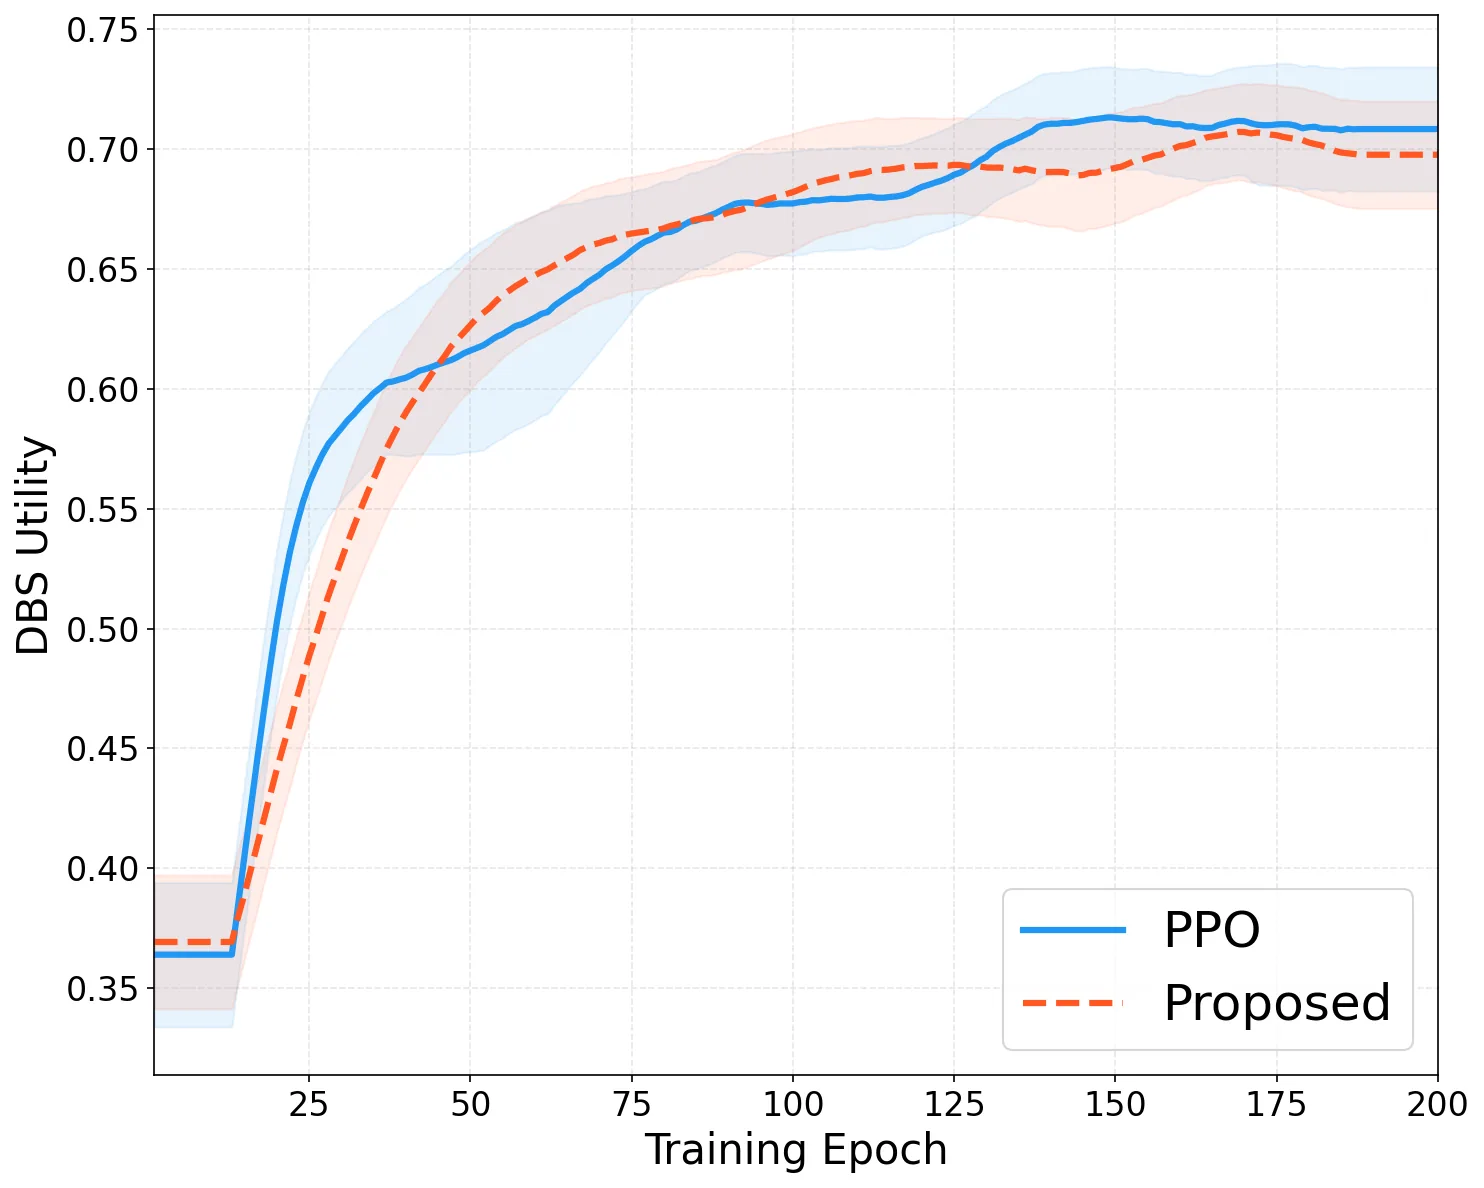
TL;DR
本文针对无人机基站(DBS)在动态无线环境中的轨迹规划难题,提出了一种基于[[数字孪生]]与[[逆向强化学习]]的协同方案。该方法通过观察无人机实际飞行的历史数据来反推其隐含的服务优先级意图,进而在无需直接获取意图信息的前提下优化轨迹。仿真结果显示,相比传统车载强化学习方法,方案在环境变化下的性能损失减少约85%;相比存在感知误差的标准无人机网络,整体性能提升最高达2.5倍。
研究背景与动机
随着无人机技术在应急通信、交通监控等场景的广泛应用,无人机基站正在从单点飞行器演化为具备自主决策能力的智能网络节点。在这类应用中,无人机基站需要根据其预期任务动态调整飞行轨迹,以优先覆盖特定的用户集群——比如交通监控场景中高风险的高速公路路段。然而,真实部署环境面临两个相互交织的挑战:网络资源受限且无线信道状态快速变化,同时无人机基站的飞行决策高度依赖其服务意图(即哪些用户群体应当获得优先接入)。
在传统的系统架构中,决策控制功能通常直接部署在无人机本地的计算单元上。这种做法的弊端在于,机载计算资源有限,难以支撑复杂的实时优化算法;同时,当外部环境发生剧烈变化(如用户大规模迁移或突发障碍物)时,单一无人机的感知范围有限,容易产生决策偏差。近年来,[[数字孪生]]技术的兴起为这一问题提供了新的解决思路:中心服务器可以构建物理无线网络的虚拟镜像,持续模拟和预测网络状态变化,并向无人机提供轨迹调整建议。
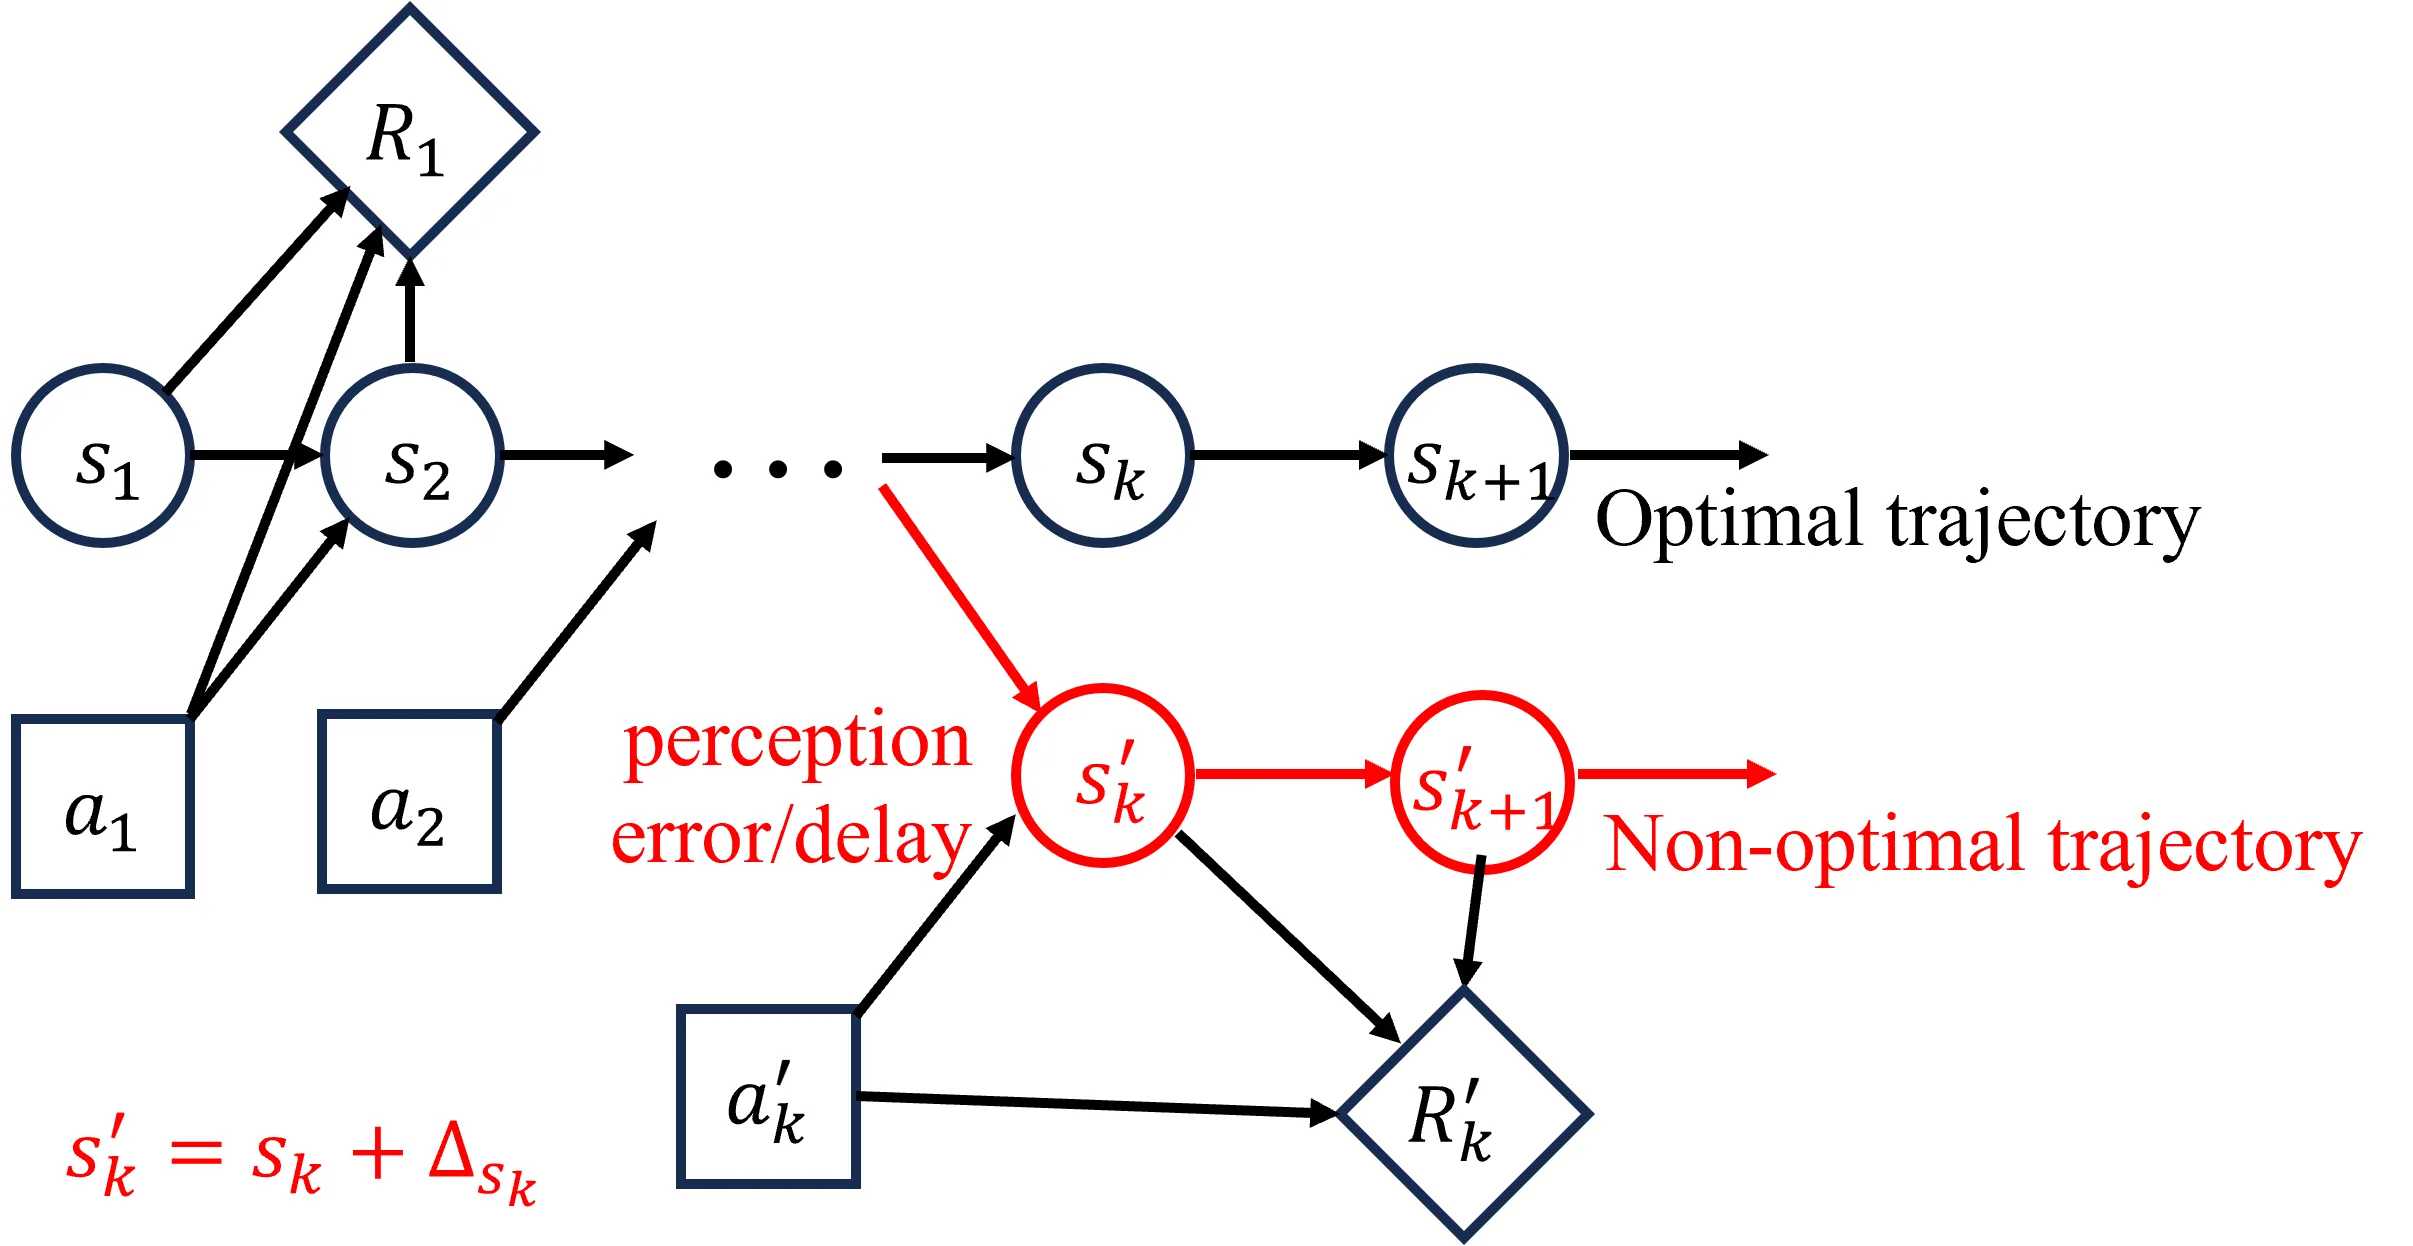
然而,数字孪生系统在实施过程中遭遇了一个关键瓶颈——意图信息的获取问题。无人机基站的服务优先级并非固定不变,而是随着任务需求、用户分布和时间演进而动态调整。更重要的是,由于无人机与中心服务器之间的通信链路存在间歇性中断,意图信息往往无法及时同步至数字孪生系统。换言之,数字孪生虽然具备模拟和预测能力,却无法确切知晓无人机当前“想做什么”。这就好比一位经验丰富的导航顾问,虽然能够精确预测路况,却不知道乘客最在乎的是赶时间、省油还是避开收费站的私人偏好。
正是这一困境催生了本文的核心研究问题:如何在无人机基站意图未知且不可预测的前提下,利用[[数字孪生]]的预测能力来优化其飞行轨迹,使得优先用户的服务比例最大化。
方法
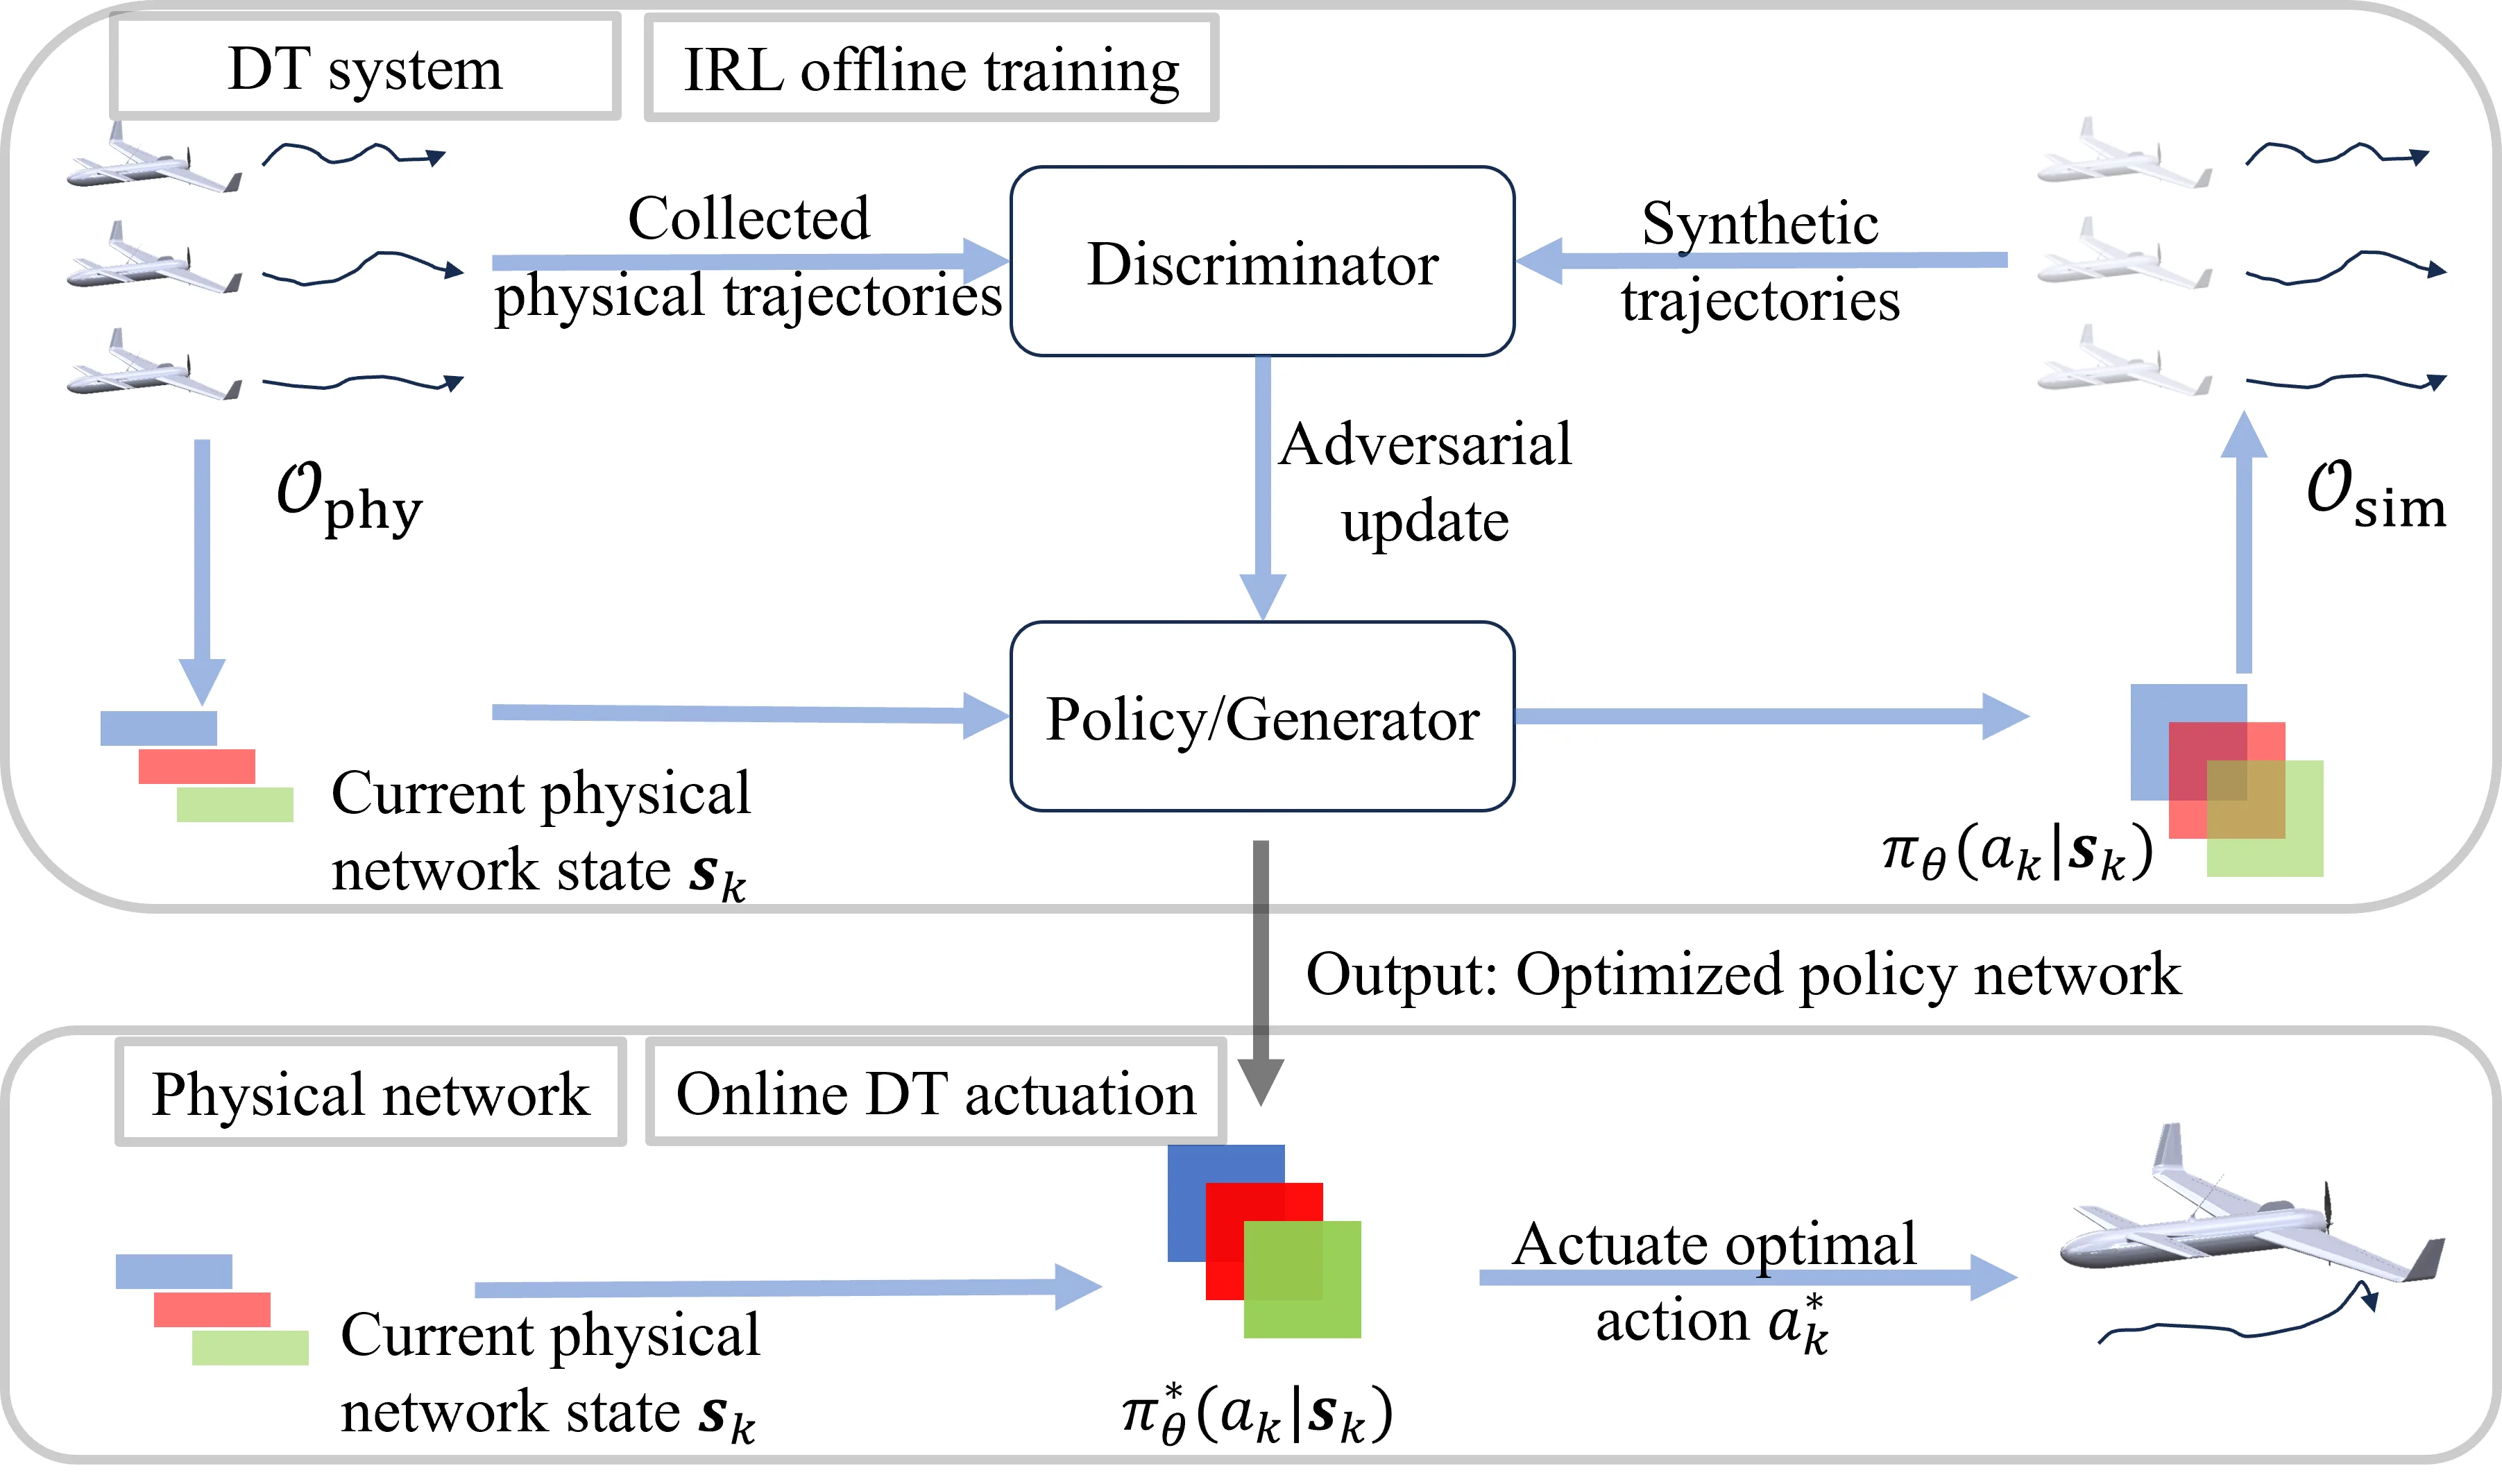
面对这一难题,作者没有选择直接要求无人机上报意图(因为通信链路不可靠),也没有退而求其次让数字孪生进行盲目猜测,而是巧妙地引入[[逆向强化学习]]作为桥梁。逆向强化学习的核心思想是:智能体的行为是意图的忠实映射,因此可以通过观察智能体的实际行为来反推其背后的奖励函数或意图。在本文场景中,这意味着即使数字孪生无法直接询问无人机“你现在优先服务哪些用户”,它也可以通过分析无人机过去的飞行轨迹来推断这一信息。
具体而言,作者将整个问题建模为一个两阶段的学习-优化框架。第一阶段是意图推理阶段,数字孪生系统收集无人机近期在实际环境中飞行的轨迹数据。这些轨迹数据虽然可能受到环境扰动和局部感知误差的影响,但总体上反映了无人机对优先用户区域的偏向性关注。[[逆向强化学习]]算法将这些观测到的轨迹作为专家示例(expert demonstrations),通过最大化专家轨迹的似然来估计隐含的意图奖励函数。这一过程的直觉在于:如果无人机反复飞越某一区域或在该区域停留时间较长,那么该区域很可能对应着较高的服务优先级。
第二阶段是轨迹优化阶段,数字孪生利用估计得到的意图奖励函数,结合当前的网络环境模拟结果,求解使优先用户服务率最大化的轨迹。这个优化问题被表述为标准的[[轨迹优化]]形式,其目标函数为估计奖励的期望累积值,约束条件包括无人机的动力学限制、通信覆盖范围以及避免障碍物的安全约束。由于数字孪生运行在计算资源充裕的中心服务器上,这一优化可以采用较为精细的算法(如基于梯度的轨迹规划或图搜索方法),而无需考虑实时性压力。
整个方案的一个关键设计考量在于,意图推理与轨迹优化并非孤立执行,而是形成了闭环迭代关系。数字孪生首先根据历史轨迹估计意图,据此推荐新的轨迹;无人机执行推荐轨迹后产生新的行为数据,这些数据又反馈回意图推理阶段用于更新估计。这种闭环设计确保了系统能够适应意图的缓慢漂移:当外部任务目标逐渐变化时(例如从监控路段转向响应突发事故),逆向强化学习能够逐步捕捉到这一趋势并调整推荐策略。
与直觉上的替代方案相比,这一设计具有显著优势。若直接要求无人机实时上报意图,则间歇性连接会导致信息缺失;若让数字孪生独立预测意图,则缺少监督信号且容易偏离真实需求。逆向强化学习通过“观察行为而非询问意图”的方式,既规避了通信瓶颈,又确保了推断结果与实际需求的一致性。
实验与结果
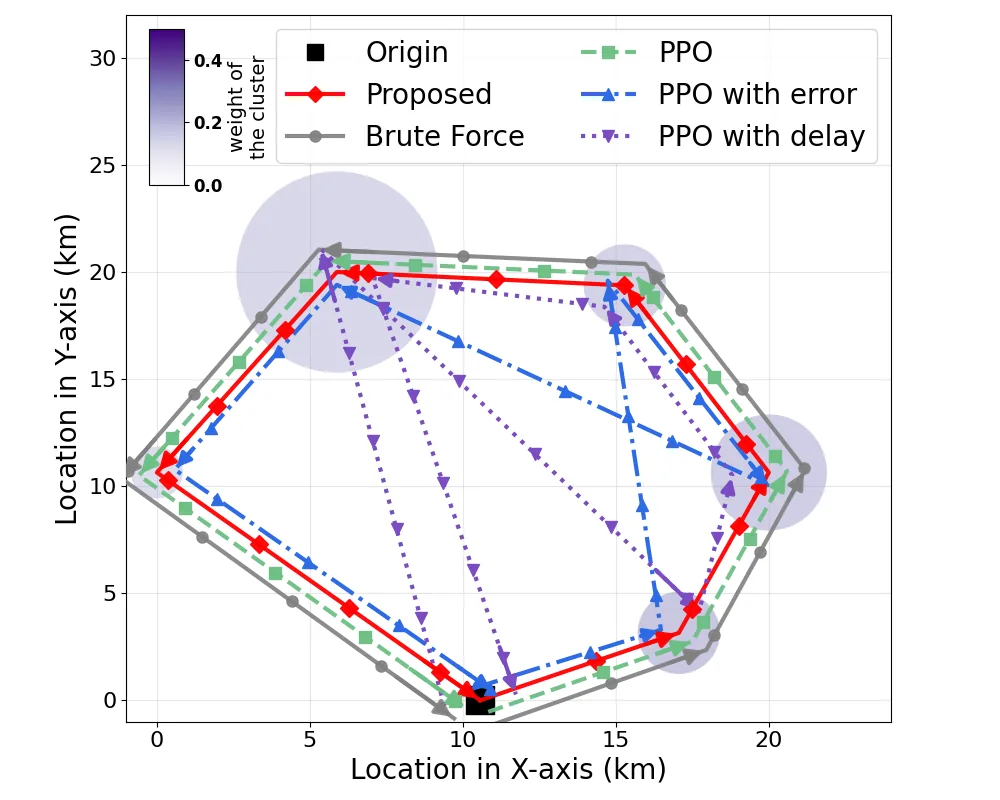
作者在仿真环境中构建了包含多个动态用户集群的无线网络场景,无人机基站的飞行区域涵盖城市郊区混合地形,信道模型考虑了遮挡、阴影衰落等实际因素。实验中设置了两类对比基准:其一是传统的车载强化学习方法,无人机完全依赖机载感知和本地决策来规划轨迹;其二是基于有误差且存在延迟的环境感知进行操作的标准无人机网络。
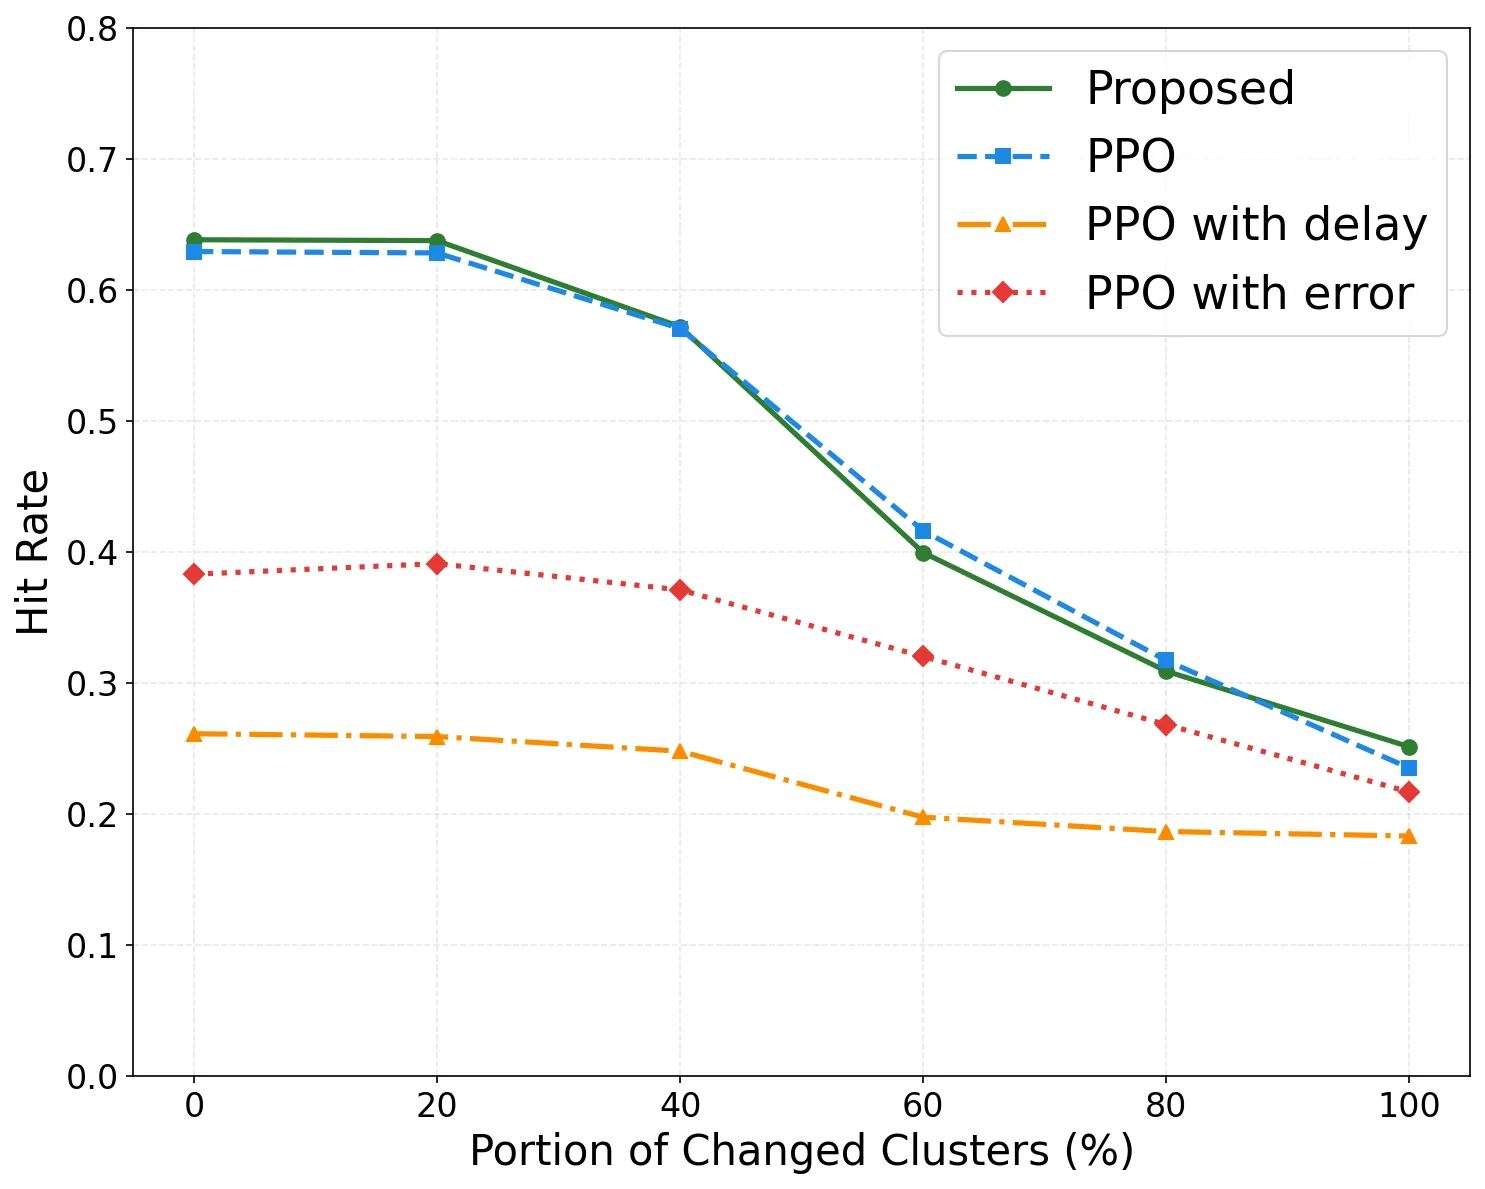
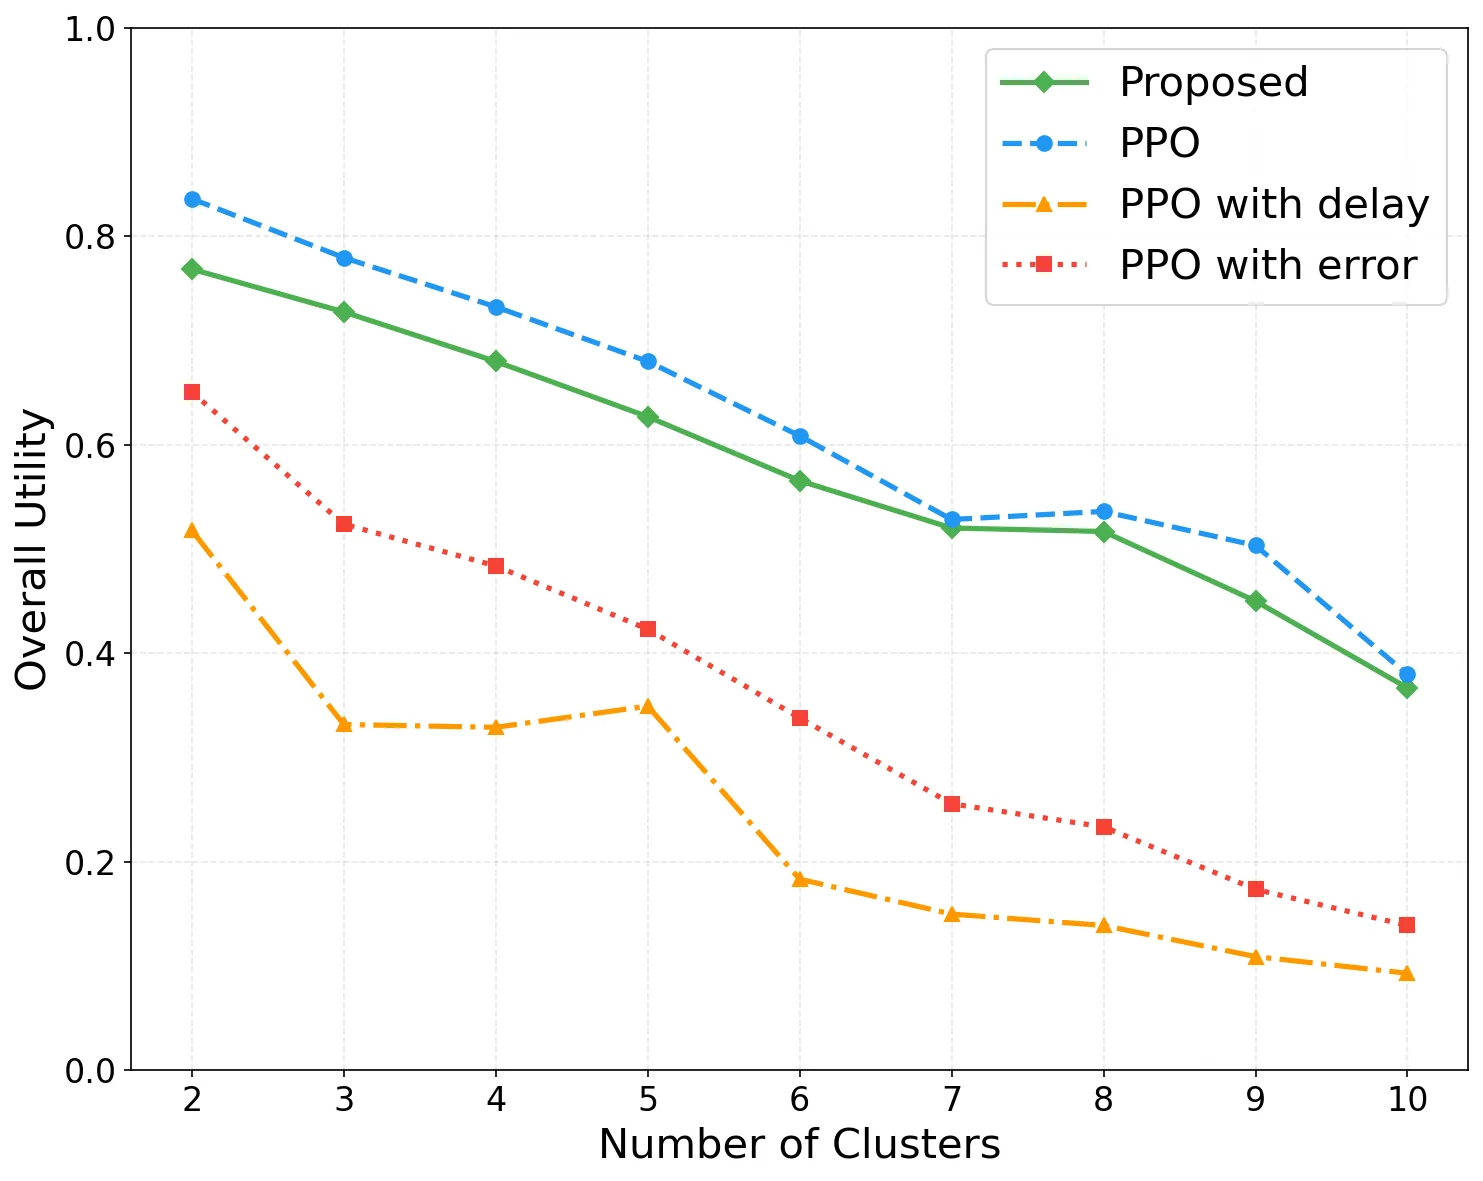
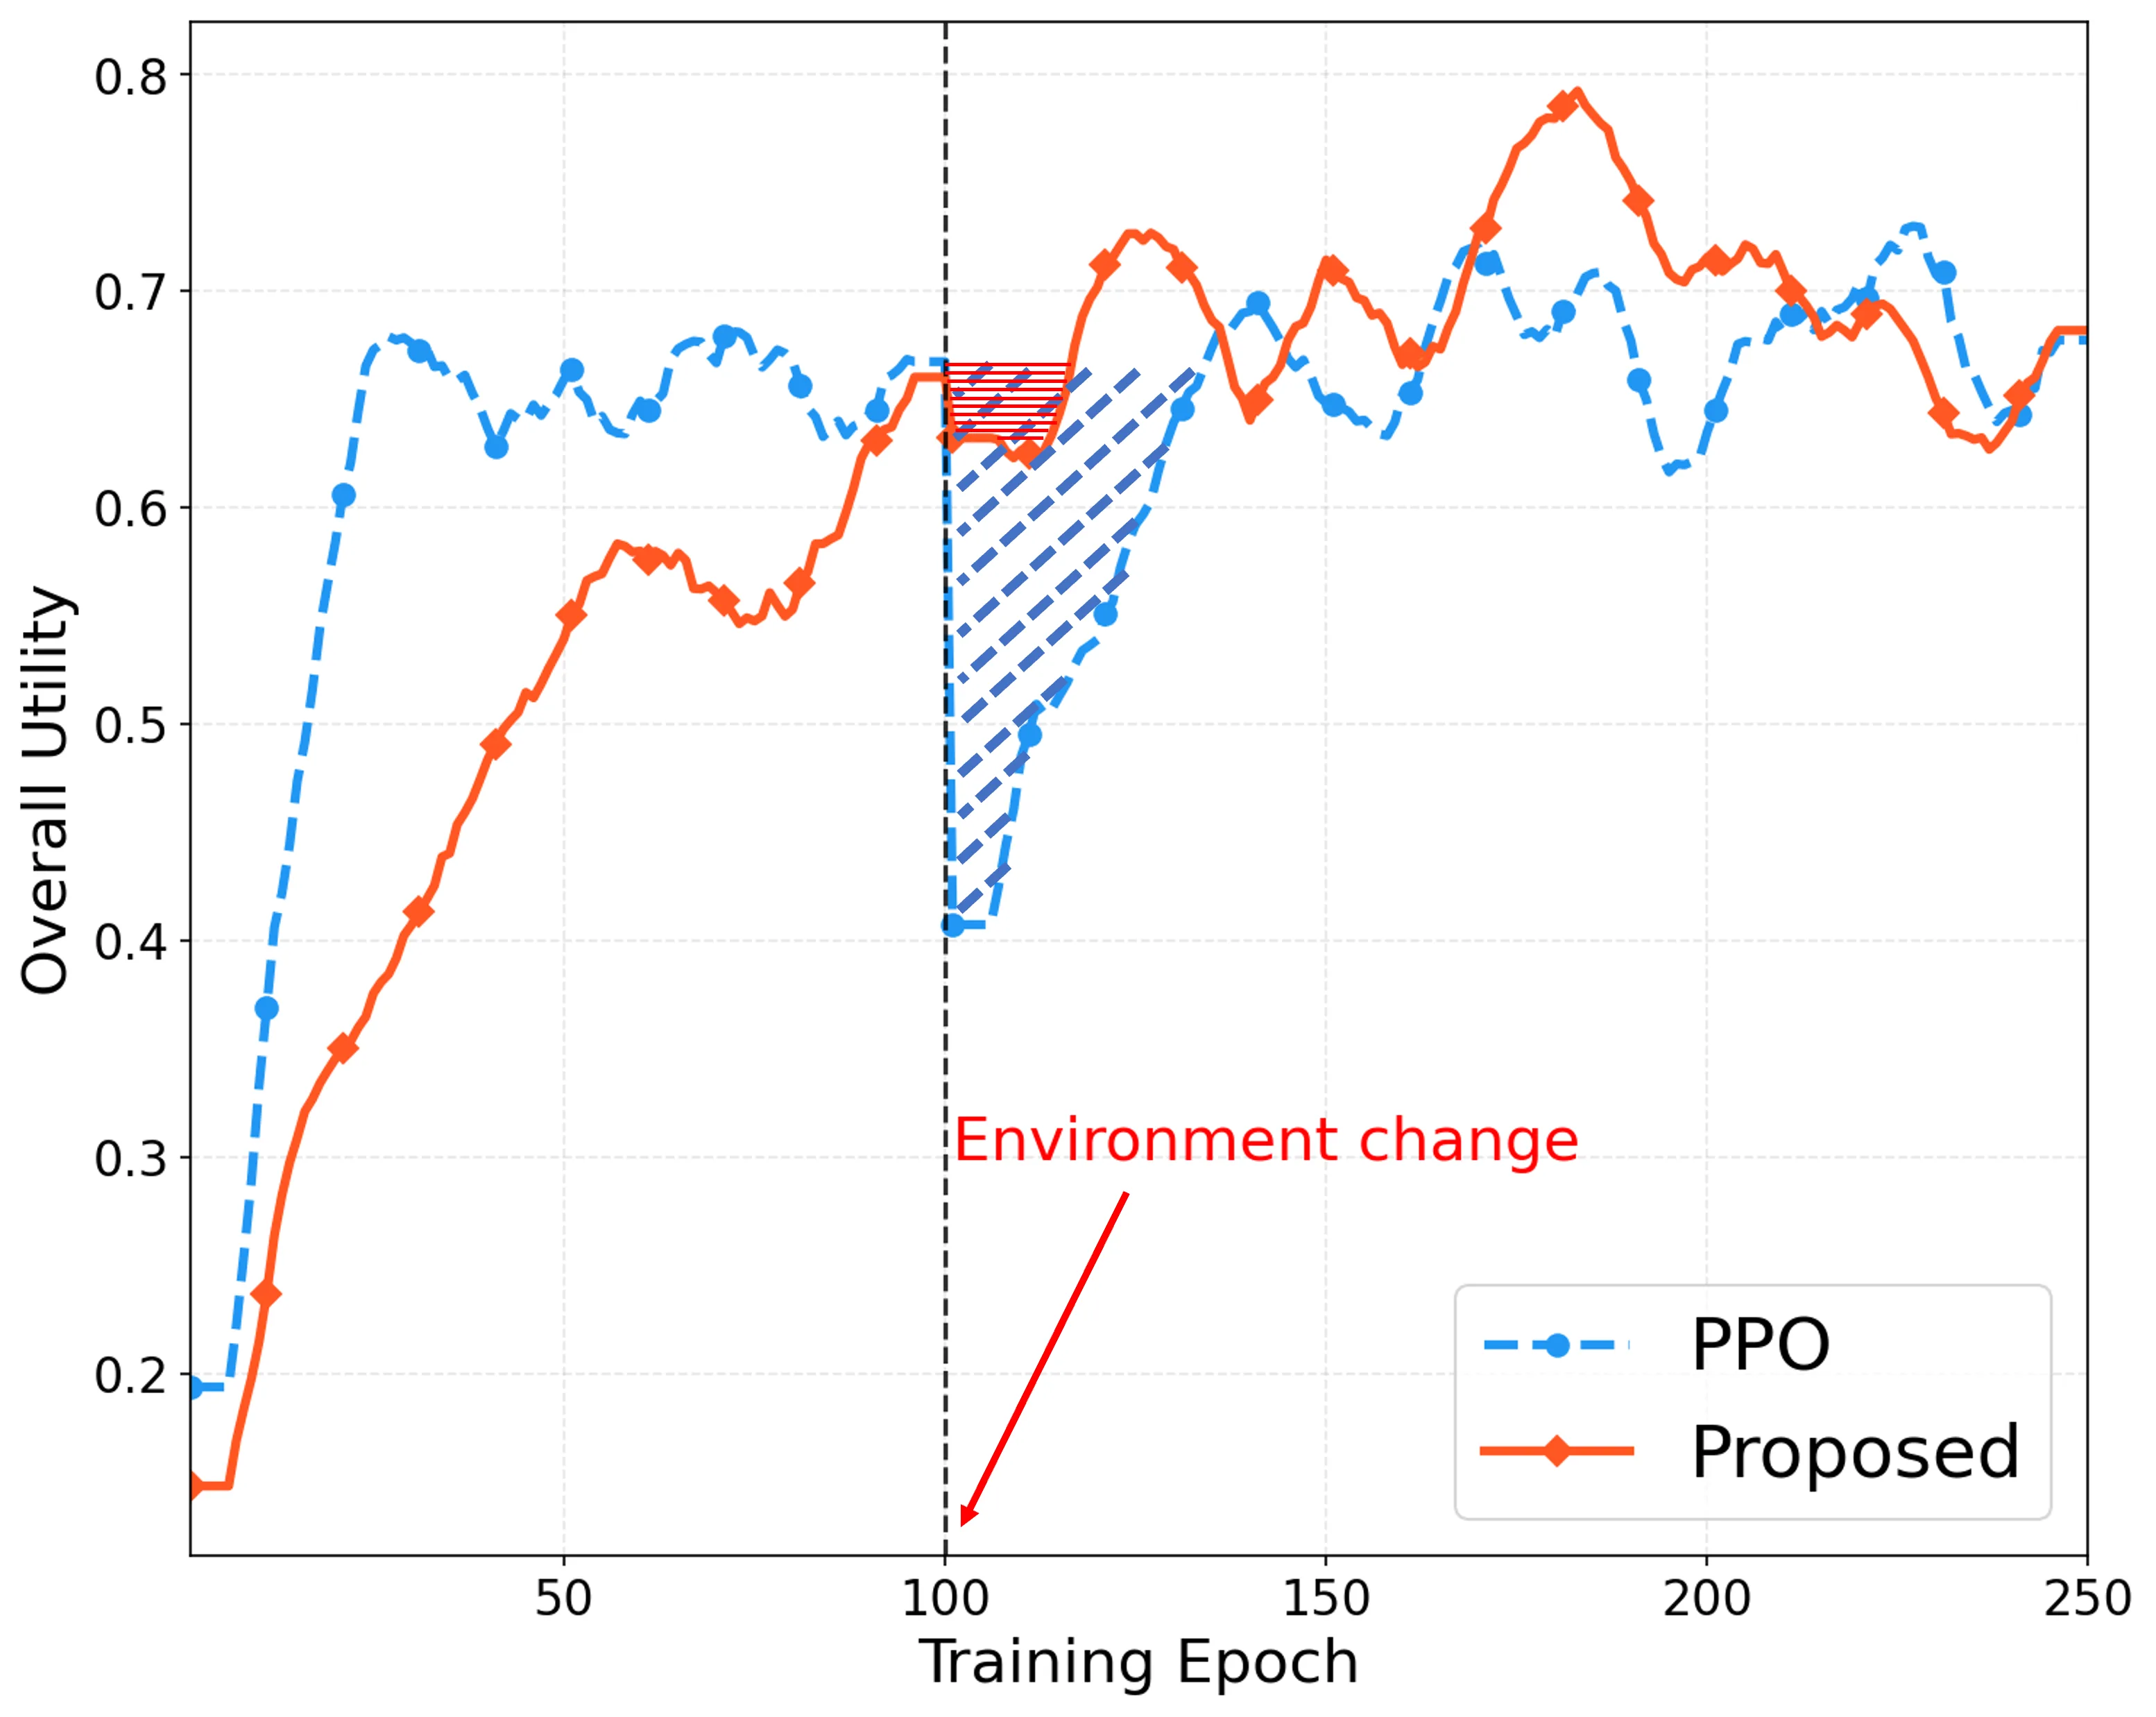
从关键性能指标来看,所提方案在优先用户服务率这一核心目标上表现出色。当环境变化频率较低时,车载强化学习方法尚能维持较为合理的服务率,但随着环境动态性增强(模拟用户集群的快速迁移或突发障碍物),其性能急剧下降。实验数据显示,在高频变化场景下,[[数字孪生]]驱动方案的优先用户服务率相比车载强化学习提升了约85%的性能差距——这意味着原本因环境突变而损失的服务质量,在引入逆向强化学习辅助决策后得到了近乎完全的补偿。
另一个引人注目的结果是方案的鲁棒性优势。标准无人机网络在存在感知误差和通信延迟的情况下,往往会对优先用户区域产生误判或错失调整时机。而数字孪生框架通过中心服务器的全局视角和精准模拟,能够在无人机尚未感知到环境变化之前就预判其影响,并提前推荐绕行或调整方案。仿真表明,这种预见性调度使整体网络性能相比基准方法提升最高达2.5倍。
值得强调的是,方案的计算开销和实时性也得到了充分验证。意图推理阶段虽然涉及机器学习模型的训练,但数字孪生服务器的充裕算力使得整个推理-优化循环能够在秒级时间内完成,远快于无人机基站的飞行时间尺度。这意味着推荐轨迹的生成速度能够跟上环境的实际变化节奏,避免了“优化结果还未得出,环境已经再次改变”的尴尬局面。
讨论与可借鉴点
尽管实验结果令人振奋,本文揭示的局限性同样值得深思。首先,逆向强化学习的推断质量高度依赖专家轨迹数据的丰富程度和代表性。若无人机在某些意图状态下缺乏足够的行为样本(例如新任务启动初期),意图估计可能存在较大方差。如何在有限样本下保证推断的可靠性,是后续研究需要关注的方向。
其次,本文假设意图随时间缓慢漂移,但在极端场景下(如应急响应任务的突然切换),意图可能发生阶跃式变化。逆向强化学习的自适应机制能否快速捕捉这类突变,仍有待更充分的评估。
从更宏观的视角来看,本文的核心贡献在于提出了一种在信息不对称条件下实现人机协作决策的范式:不用直接询问对方“你想要什么”,而是通过观察对方的行为来推断其意图,进而提供恰到好处的辅助。这种思想在[[意图驱动网络]]、智能交通系统乃至多智能体协作等领域都具有广泛的适用性。当未来网络中的决策主体日益多元、意图信息日益碎片化时,这种“行为推断+预测优化”的设计思路或许将成为构建自主智能系统的关键支柱。
摘要
本文研究了资源受限、动态无线网络环境中意图驱动无人机的轨迹设计问题。在所考虑的模型中,无人机作为补充基站,在地面用户集群之间导航以提供按需上行数据接入。根据其预期应用(例如交通监控),无人机基站(DBS)优先服务于某些集群(例如高风险的高速路段)。部署在中央服务器上的数字孪生(DT)系统创建物理无线网络环境的虚拟表示,以模拟和预测相关变化,此时 DBS 的轨迹也应相应调整。然而,DT 系统在建议调整 DBS 轨迹时,并无法保证获取底层的 DBS 意图(即服务优先级),因为该意图会随时间演变,并且由于 DBS 与 DT 服务器之间的间歇性连接,该意图无法及时更新至 DT 系统。此类调整被建模为一个优化问题,其目标是寻找使 DBS 所服务的优先用户比例最大化的轨迹。为了在未知的 DBS 意图和不可预测的环境变化下求解该问题,本文提出了一种基于逆向强化学习(IRL)的 DT 驱动解决方案。仿真结果表明,与基于强化学习的机载 DBS 传统控制方案相比,所提解决方案能够提供近实时、近最优的轨迹调整,在环境变化下的性能损失减少约 85%。此外,与标准无人机网络中 DBS 基于其有误差且延迟的环境感知进行操作相比,所提 DT 框架可将无人机网络性能提升高达 2.5 倍。
Abstract
In this paper, the problem of the trajectory design for an intent-based drone operating in resource-constrained, dynamic wireless network environments is studied. In the considered model, the drone acts as a supplementary base station that navigates among ground user clusters to provide on-demand uplink data access. Given its intended application (e.g traffic monitoring), the drone base station (DBS) prioritizes serving certain clusters (e.g. high-risk highway sections). A digital twin (DT) system, hosted on a central server, creates a virtual representation of the physical wireless network environment to simulate and predict related changes, in which case the DBS trajectory should also be adjusted. Then, the DT system suggests adjustments to DBS trajectories without guaranteed access to the underlying DBS intent (i.e., service priorities), as this intent evolves over time and cannot be updated to the DT system in a timely manner due to intermittent connectivity between the DBS and the DT server. Such adjustment is posed as an optimization problem whose goal is to find the trajectories with which the fraction of prioritized users served by the DBS is maximized. To solve this problem under unknown DBS intent and unpredictable environment changes, an inverse reinforcement learning (IRL) based DT actuation solution is proposed. Simulation results demonstrate that the proposed solution provides near-real-time, near-optimal trajectory adjustment, with approximately 85\% less performance loss across environmental changes, compared to traditional reinforcement learning based on-board DBS control. The DT framework also enhances drone network performance by up to 2.5 times, compared to standard drone networks where a DBS operates with its erroneous and delayed environmental sensing.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。