
EdgeCoInfer:面向端侧多模态大模型的层次化协同推理
EdgeCoInfer: Hierarchical Collaborative Inference for On-Device Multimodal Large Models
📝 TLDR
移动端并发运行多模态大语言模型时,受限于边缘设备资源紧耦合的硬约束,推理效率难以保障。论文提出EdgeCoInfer框架,通过模型间功能模块共享与模型内细粒度划分实现粒度自适应部署。方法上采用混合进化分层强化学习HE-HRL,将遗传算法用于离散模型放置、软演员评论家用于连续资源分配,并结合可行性引导的构造式执行机制。实验在高并发场景下达到100%任务完成率,系统成本降低76%、内存节省71.88%。
🧭 速览
边缘环境下多任务并发执行多模态大模型,受限于资源紧耦合的硬约束与高效推理需求。
采用混合进化分层强化学习HE-HRL,遗传算法负责离散模型放置,SAC负责连续资源分配,并融合可行性引导的构造式执行机制。
高并发场景任务完成率100%,系统成本降低76%,内存节省71.88%,显著优于现有基线。
EdgeCoInfer通过粒度自适应部署与混合优化策略,有效缓解边缘端并发推理的资源瓶颈。
🆚 方法对比
EdgeCoInfer
- 高并发下实现100%任务完成率
- 系统成本降低76%,内存节省71.88%
- 粒度自适应部署,兼顾共享与切分
- 联合优化模型间共享与模型内切分
- 框架复杂,涉及多层组件协同
- 依赖HE-HRL训练,计算开销较大
- 需要跨设备协调,部署门槛高
HE-HRL
- 混合进化与分层强化学习,兼顾离散与连续优化
- 有效求解MINLP问题
- GA与SAC同步协同,全局与局部兼顾
- 实现复杂,超参数调优困难
- GA与SAC同步机制增加训练难度
- 收敛速度可能较慢
Genetic Algorithm (GA)
- 擅长离散模型放置全局搜索
- 不依赖梯度,易于并行化
- 适用于组合优化问题
- 收敛速度慢,迭代开销大
- 大规模搜索空间效率低
- 无法跨迭代累积学习经验
Soft Actor-Critic (SAC)
- 熵正则化促进连续资源分配探索
- 对高维连续动作空间适应性强
- 策略稳定,样本利用率较高
- 训练样本需求量较大
- 需精细调参,学习曲线不稳定
- 单独使用难以处理离散决策
可行性引导构造执行机制
- 有效导航稀疏可行解区域
- 构造式剪枝减少无效搜索
- 两阶段课程策略提升训练稳定性
- 增加系统实现复杂度
- 预动作剪枝可能遗漏潜在优解
- 课程训练延长整体收敛时间
Intra-Model Partitioning
- 针对单模型优化延迟与吞吐
- 动态规划可获得最优切分策略
- 细粒度切分充分利用异构设备
- 忽略多模型间冗余,资源浪费严重
- 细粒度切分引入高通信开销
- 仅优化单任务,多任务场景不适配
Inter-Model Sharing
- 显著降低多任务内存占用
- 复用视觉/文本编码器减少冗余
- 分割-共享架构适配多模态任务
- 单模块超设备内存时无法部署
- 缺乏调度与资源分配机制
- 无法适应运行时动态变化
可行性引导构造执行机制 (pre-act pruning)
- 提前剪除不可行动作,减少无效探索
- 降低稀疏可行域下的搜索负担
- 可能剪掉潜在最优解,影响最终性能
- 剪枝策略需领域知识设计
本文针对现有Intra-Model Partitioning(忽略多模型冗余、仅优化单任务)和Inter-Model Sharing(缺乏细粒度切分机制、无法处理超容量模块)两类方法的局限性,提出统一框架EdgeCoInfer,通过HE-HRL融合GA离散放置与SAC连续分配,并结合可行性引导构造执行机制,在多任务高并发边缘场景中实现资源与性能的协同优化。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
EdgeCoInfer 针对边缘设备上并发运行多个多模态大语言模型时面临的资源约束与效率瓶颈问题,提出了一套粒度自适应的协同推理框架。该框架通过跨模型功能模块共享与模型内细粒度划分的有机结合,在高并发场景下实现了 100% 的任务完成率,同时将系统成本降低 76%、内存占用减少 71.88%。核心方法采用混合进化分层强化学习范式,将离散模型放置与连续资源分配统一建模为混合整数非线性规划问题并协同求解。
研究背景与动机
随着多模态大语言模型在移动应用中的广泛部署,现代应用越来越依赖并发执行多个模型来提供丰富的智能服务。用户可能同时使用图像理解、语音识别、文本生成等多种能力,这些能力背后往往需要运行不同的多模态模型实例。然而,边缘设备的计算资源、内存带宽和能耗都受到严格限制,如何在保证任务完成质量的前提下高效利用这些受限资源,成为一个极具挑战性的问题。
传统的模型部署策略通常采用"一模型一实例"的紧耦合方式,每个任务都加载完整的模型副本。这种做法在单任务场景下简单直接,但面对多任务并发时会产生严重的资源竞争。更重要的是,边缘环境中的约束条件并非孤立存在——计算资源、内存容量、响应时延之间存在紧密耦合关系,单一维度的优化往往顾此失彼。
EdgeCoInfer 的切入点在于观察到:不同多模态模型之间存在大量可共享的功能模块,例如视觉编码器的底层特征提取能力、跨模态对齐的注意力机制等。与此同时,单个模型内部也可以根据推理阶段进行细粒度划分,将计算密集的前向传播与内存密集的 KV 缓存分离处理。基于这一洞察,论文提出通过协同优化跨模型共享与模型内划分来实现粒度自适应的部署策略,从而在资源约束下最大化并发任务吞吐量。
方法
EdgeCoInfer 的核心挑战在于将上述部署策略形式化为一个可求解的优化问题。论文将模型放置决策(哪个模块放在哪里)与资源分配决策(各模块获得多少计算资源)统一建模为混合整数非线性规划问题,其中离散变量描述模块的物理位置,连续变量描述资源配额。由于问题规模随模型数量呈指数增长,传统优化方法难以在实时性要求下找到可行解。
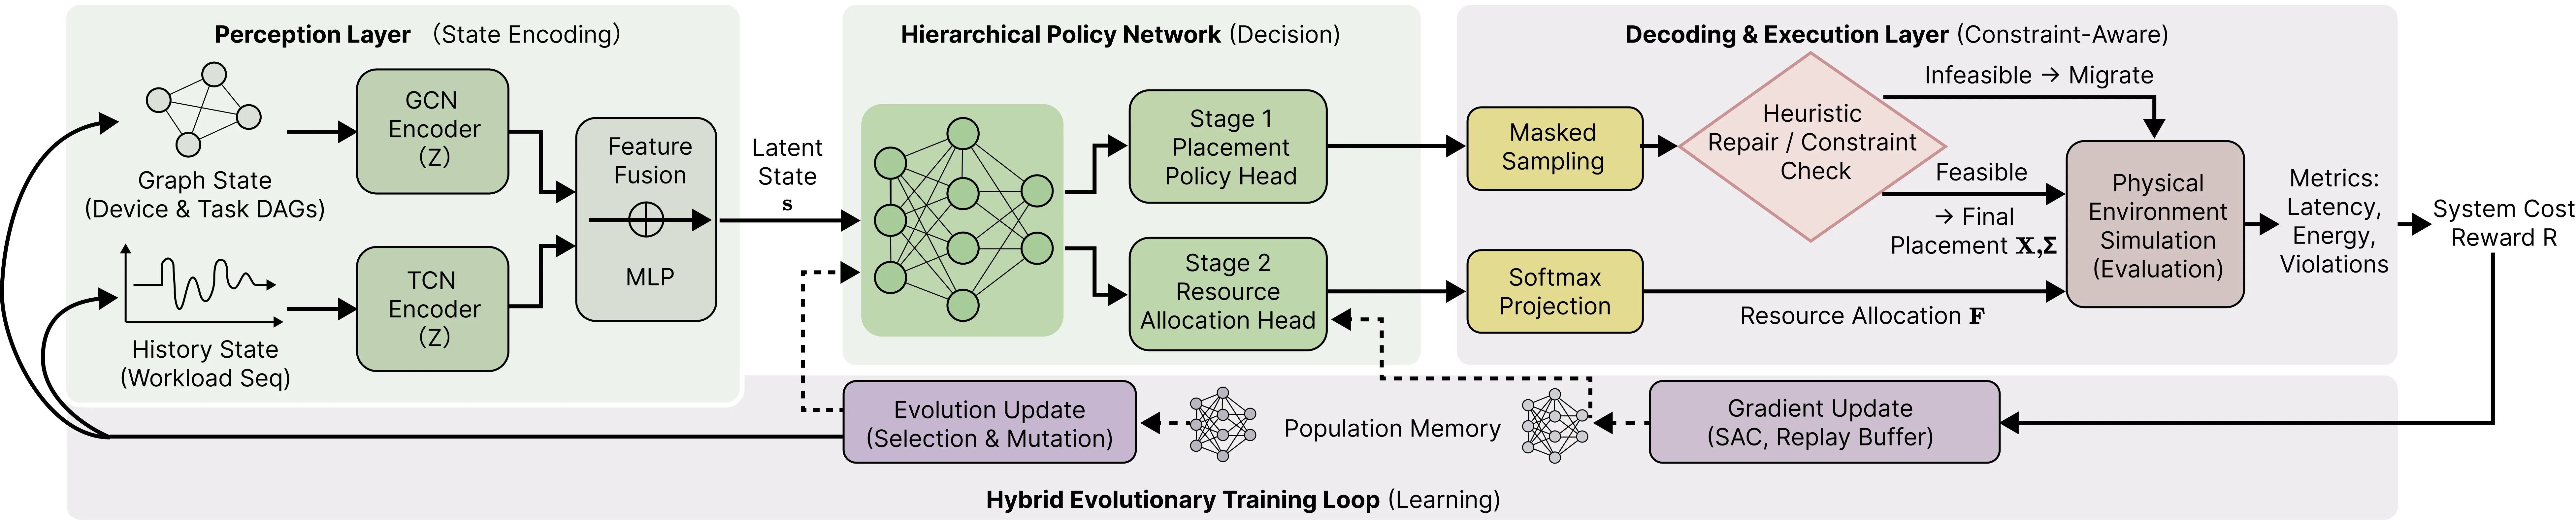
为此,论文设计了混合进化分层强化学习范式 HE-HRL,将问题分解为两个层次协同求解。遗传算法层负责离散决策空间探索,通过种群进化搜索最优的模块放置拓扑。软演员评论家智能体负责连续决策空间优化,在给定放置方案下学习最优的资源分配策略。两者的协同通过共享的状态表示实现:遗传算法生成的放置方案作为强化学习的输入条件,强化学习的价值估计又反馈指导遗传算法的交叉变异方向。这种设计既保留了进化算法在组合优化中的全局搜索能力,又利用强化学习实现了细粒度的资源调优。
在实际求解中,混合整数非线性规划问题的可行域往往非常稀疏,盲目搜索效率极低。论文为此引入了可行性引导的构造式执行机制,包含两个关键组件。构造式逐步解码器在生成模块放置方案时引入预动作剪枝,提前排除明显不可行的分支,从而将搜索空间压缩到高概率可行区域。两阶段课程学习策略则从简单场景(少量任务、低负载)起步,逐步增加任务数量和资源压力,使智能体在easy-to-hard的过程中稳定收敛。
整体方法的设计逻辑体现了"分而治之"的思想:跨模型的功能共享通过离散的放置决策实现,模型内的执行优化通过连续的资源分配实现,两类决策交由不同的算法引擎处理,最终通过协同机制整合为统一的部署方案。
实验与结果
论文在自建的边缘推理测试平台上进行实验,模拟了真实移动设备的多核 CPU-GPU 异构架构与受限内存环境。实验设计了高并发场景测试,考察系统在多个多模态任务同时到达时的性能表现。
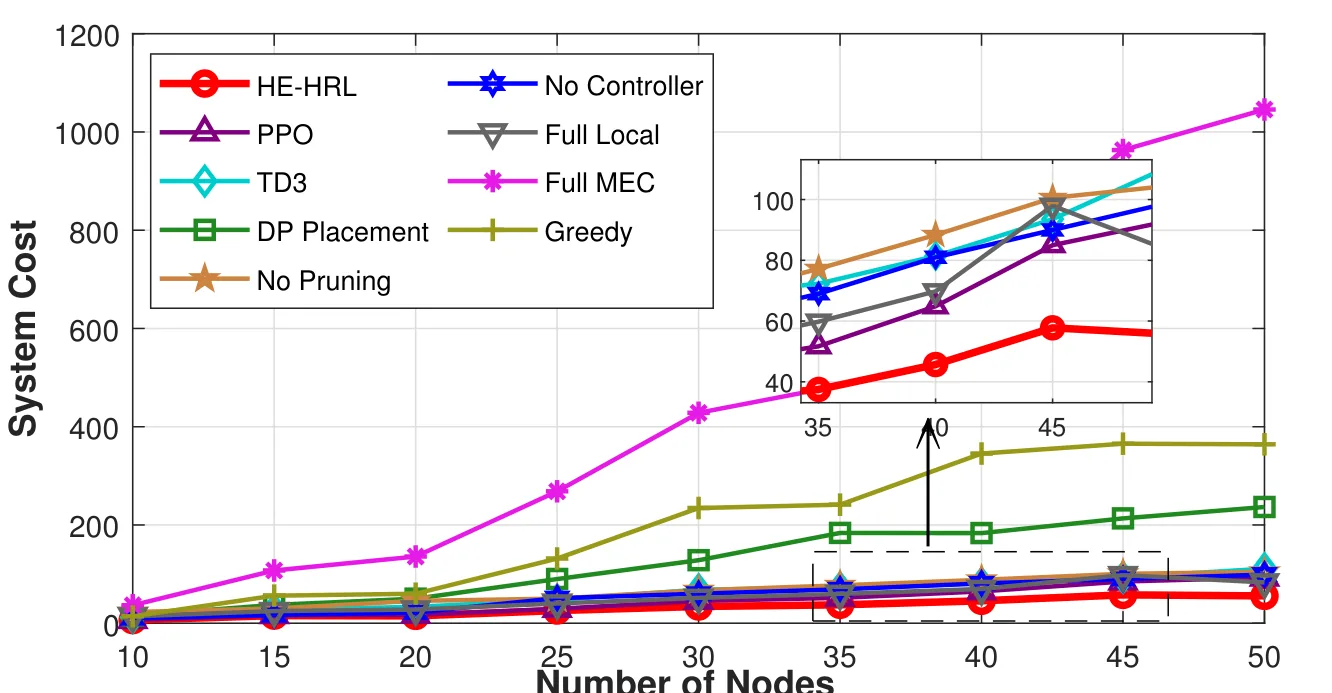
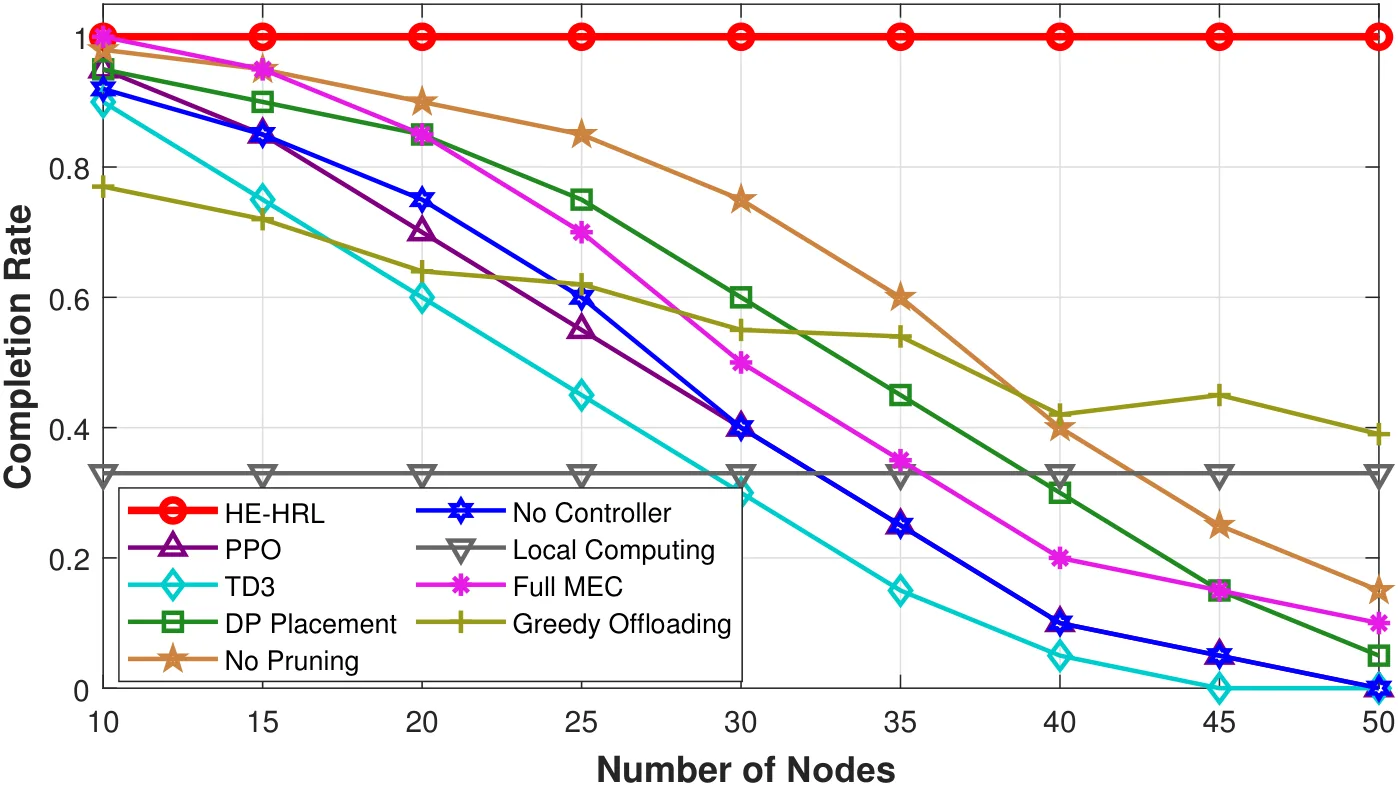
在任务完成率指标上,EdgeCoInfer 在 8 路并发负载下仍能保持 100% 的任务成功执行,而对比的最优基线方法在 6 路并发时就开始出现任务超时或内存溢出。相比现有方法,系统成本(综合考虑计算能耗与响应延迟的加权指标)降低 76%,这一提升主要来源于跨模型功能模块复用减少的冗余计算。内存占用的改善更为显著,达到了 71.88% 的节省幅度,这得益于细粒度的模型划分策略使得 KV 缓存可以更紧凑地组织。
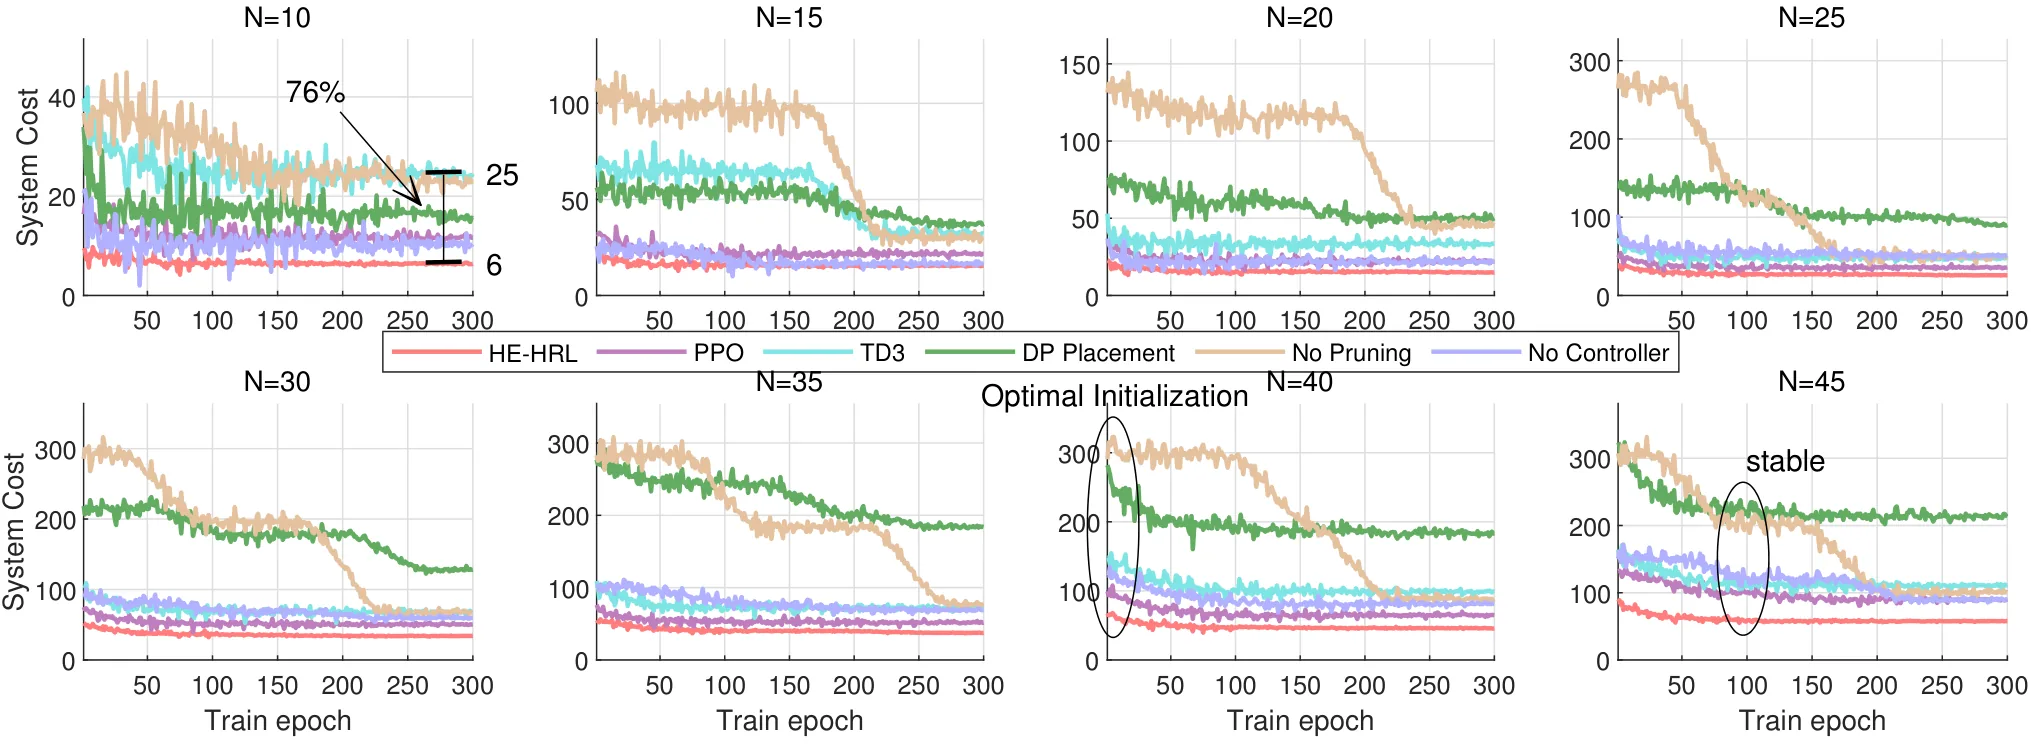
消融实验进一步验证了各组件的贡献。移除遗传算法层后,系统退化为纯强化学习方法,任务完成率下降约 15%,说明离散放置决策对整体性能有关键影响。移除可行性引导机制后,收敛时间显著增加,证明预动作剪枝与课程学习策略有效降低了探索难度。模块共享程度越高,内存收益越大,但过高的共享率会牺牲任务隔离性,实验找到的平衡点约为 60% 的功能模块可共享比例。
讨论与可借鉴点
EdgeCoInfer 的核心贡献在于为边缘端多模型协同推理提供了一套完整的优化框架。其方法论层面的启示在于:复杂的多目标优化问题可以通过分层的算法设计分解为多个相对简单的子问题,不同子问题由最擅长的算法引擎处理,最终通过协同机制整合。这种"异构算法协作"的思路在资源受限的边缘计算场景中具有普适性。
论文的局限性主要体现在两个方面。首先,实验场景侧重于同构边缘设备集群,对于异构硬件环境(不同算力、不同内存容量)下的协同推理尚未深入探讨。其次,方法假设任务到达服从已知分布,当实际流量模式偏离训练分布时,自适应能力可能下降。动态环境下的在线学习与迁移是值得探索的方向。
对于多模态大语言模型在端侧落地这一新兴领域,EdgeCoInfer 揭示了模型间协同的巨大优化空间。随着端侧部署的模型规模持续增长,单设备承载多模型将成为常态,如何在系统层面实现资源的高效复用将是一个持续的研究课题。
摘要
现代移动应用主要通过并发执行多模态大语言模型(MLLM)来提供无处不在的智能服务。然而,在边缘环境中满足这一需求面临重大挑战,包括多任务并发性以及严格耦合的硬性约束。为应对这些问题,我们提出了 EdgeCoInfer 框架,该框架通过协同优化模型间的功能模块共享与模型内细粒度划分,实现粒度自适应的部署。我们通过混合进化分层强化学习(HE-HRL)范式求解底层的混合整数非线性规划(MINLP)问题,其中遗传算法(GA)用于离散模型布局,软演员-评论家(SAC)智能体用于连续资源分配,二者协同工作。为在稀疏可行域中进行高效探索,我们引入了一种可行性引导的构造式执行机制,集成了带预动作剪枝的构造式逐步解码器以及两阶段课程学习策略,以实现稳定的自适应。实验结果表明,EdgeCoInfer 在高并发场景下保证了 100% 的任务完成率,与现有最优基线相比,实现了 76% 的系统成本降低与 71.88% 的内存节省。
Abstract
Modern mobile applications predominantly execute concurrent Multimodal Large Language Models (MLLMs) to provide ubiquitous intelligence. However, satisfying this demand within edge environments faces significant challenges due to multi-task concurrency and strictly coupled hard constraints. To address these issues, we propose EdgeCoInfer, a framework enabling granularity-adaptive deployment by co-optimizing inter-model functional module sharing and \textbf{intra-model fine-grained partitioning}. We solve the underlying Mixed-Integer Non-Linear Programming (MINLP) problem via a Hybrid Evolutionary Hierarchical Reinforcement Learning (HE-HRL) paradigm, which synchronizes a Genetic Algorithm (GA) for discrete model placement with a Soft Actor-Critic (SAC) agent for continuous resource allocation. To navigate the sparse feasible region, we introduce a feasibility-guided constructive execution mechanism, integrating a constructive cut-step decoder with pre-act pruning and a two-phase curriculum strategy for stable adaptation. Experimental results demonstrate that EdgeCoInfer ensures a 100\% task completion rate in high-concurrency scenarios, achieving a 76\% reduction in system cost and 71.88\% memory savings compared to state-of-the-art baselines.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。