
奖励驱动的大语言模型智能体工作流:综合部分可观测马尔可夫决策过程路由与自我修正以实现自主决策
Reward-Driven LLM Agent Workflows: Synthesizing POMDP Routing and Self-Correction for Autonomous Decision-Making
📝 TLDR
针对LLM智能体在长程规划、稀疏奖励归因与动态环境交互中的不足,本文提出融合POMDP路由与自纠正奖励模型的智能体工作流架构。在ALFWorld与WebShop基准上较ReAct基线取得24.5%任务成功率绝对提升。消融实验验证了奖励驱动批判模块对抑制幻觉的关键作用。该框架为复杂多步自主系统提供了可扩展的参考实现。
🧭 速览
现有LLM智能体依赖静态提示,缺乏鲁棒感知-动作回路,难以处理长程规划、稀疏奖励归因与动态环境交互。
设计POMDP路由机制并嵌入自纠正奖励模型,融合多模态输入、PPO与价值函数近似,维护长期结构化记忆以动态调整推理路径。
在ALFWorld具身仿真与WebShop在线导航上较ReAct基线提升24.5%任务成功率与轨迹效率,幻觉率显著下降。
将强化学习理论与图结构记忆桥接至自主智能体工作流,提供面向复杂多步系统的可扩展工程框架。
🆚 方法对比
RLAW框架
- 融合POMDP路由与奖励驱动自校正,数学严谨性强
- 在ALFWorld与WebShop上提升24.5%成功率
- 严格propose-critique-execute循环抑制幻觉累积
- 统一整合多模块AI范式,具备可扩展性
- 依赖多模块协同,实现复杂度较高
- 未深入讨论大规模环境下的计算开销
- 实验仅在两个公开基准上验证
- 泛化到真实工业场景的有效性待验证
POMDP路由机制
- 将LLM提升为形式化策略函数,定义明确状态/动作空间
- 处理部分可观测环境下的不确定决策
- 支撑长期结构记忆与动态推理路径适应
- 状态空间建模复杂,需领域知识
- POMDP精确求解在大规模下计算昂贵
- 依赖手工设计的状态转移假设
奖励驱动自校正模块
- 在执行前评估决策轨迹,有效抑制幻觉
- 消融实验验证其对成功率贡献显著
- 提供形式化价值最大化目标
- 将生成模型对齐到RL目标,缓解逻辑偏移
- 奖励模型训练需要标注数据或反馈信号
- 额外推理步骤增加延迟与计算成本
- 奖励函数的偏差可能误导策略优化
GNN结构化长期记忆
- 通过图结构维持长时程环境约束
- 支持结构化信息传播与检索
- 缓解长序列上下文遗忘问题
- 图构建与更新带来额外工程开销
- GNN训练对图规模敏感
- 对动态环境的图维护机制待完善
近端策略优化(PPO)与价值函数近似
- PPO提供稳定的策略更新机制
- 价值函数近似支持长期回报估计
- 成熟的RL算法易于工程集成
- PPO对奖励稀疏场景敏感
- 价值函数近似误差会传播到决策
- 调参复杂,依赖大量交互样本
标准ReAct框架(基线)
- 实现简单,易于部署与调试
- 推理-行动交替范式直观易懂
- 作为广泛使用的强基线具有可比性
- 依赖静态prompt,缺乏感知-动作闭环
- 长时程规划易产生级联幻觉错误
- 无显式奖励信号,易陷入冗余调用
- 无法最大化目标完成概率
静态零样本/少样本提示
- 无需训练即可快速部署
- 对简单任务有效,开销极低
- 缺乏长期规划与环境交互能力
- 无记忆机制,复杂任务表现差
- 无形式化目标优化,输出不可控
RLAW通过POMDP路由与奖励驱动自校正模块显著优于静态提示与标准ReAct基线,但相比单一ReAct实现复杂度更高;各子组件(PPO、GNN记忆、奖励批评)在统一框架内互补协作,共同解决长时程规划与稀疏奖励归因问题。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
本文针对大语言模型智能体在复杂多步任务中面临的规划困难、奖励信号稀疏以及动态环境适应等核心挑战,提出了一种融合[[部分可观测马尔可夫决策过程]]路由与自纠正奖励模型的智能体工作流架构。该方法通过在决策执行前引入奖励驱动的批判模块评估轨迹质量,在 ALFWorld 具身仿真环境与 WebShop 在线导航基准上较 [[ReAct]] 基线取得了 24.5% 的任务成功率绝对提升,有效降低了智能体的[[幻觉]]率。
研究背景与动机
大语言模型智能体在现实世界中执行复杂任务时,往往需要处理跨越多个步骤的规划与决策问题。这类长程规划任务的特殊性在于:智能体当前做出的决策会深刻影响后续可用的选项集合,而最终的成败往往取决于一系列中间决策的累积效果。以具身智能场景为例,智能体需要理解自然语言指令、在模拟环境中导航、操控物体并完成多步操作序列,任何一步的失误都可能导致整个任务失败。
然而,现有基于静态提示的[[ReAct]]类方法存在明显的局限性。这类方法通常依赖预先设定的提示模板,缺乏对决策轨迹的动态评估能力。当智能体在执行过程中产生错误的中间推理时,系统无法及时发现并纠正这些偏差,导致误差在整个任务执行过程中不断累积。特别是在奖励信号稀疏的场景下,智能体难以从稀疏的最终反馈中学习到哪些中间决策是正确的、哪些是错误的,这种[[稀疏奖励归因]]问题严重制约了智能体的学习效率与任务成功率。
此外,真实世界的任务执行往往伴随着动态变化的环境状态。智能体不能假设自己完全掌握环境的全部信息,而需要在部分可观测的条件下做出最优决策。这种不确定性正是[[部分可观测马尔可夫决策过程]]所形式化描述的核心场景。如何在这种不确定条件下设计有效的决策与路由机制,成为提升智能体自主性的关键科学问题。
方法
本文提出的智能体工作流架构包含三个核心组件,它们相互协作以应对上述挑战。
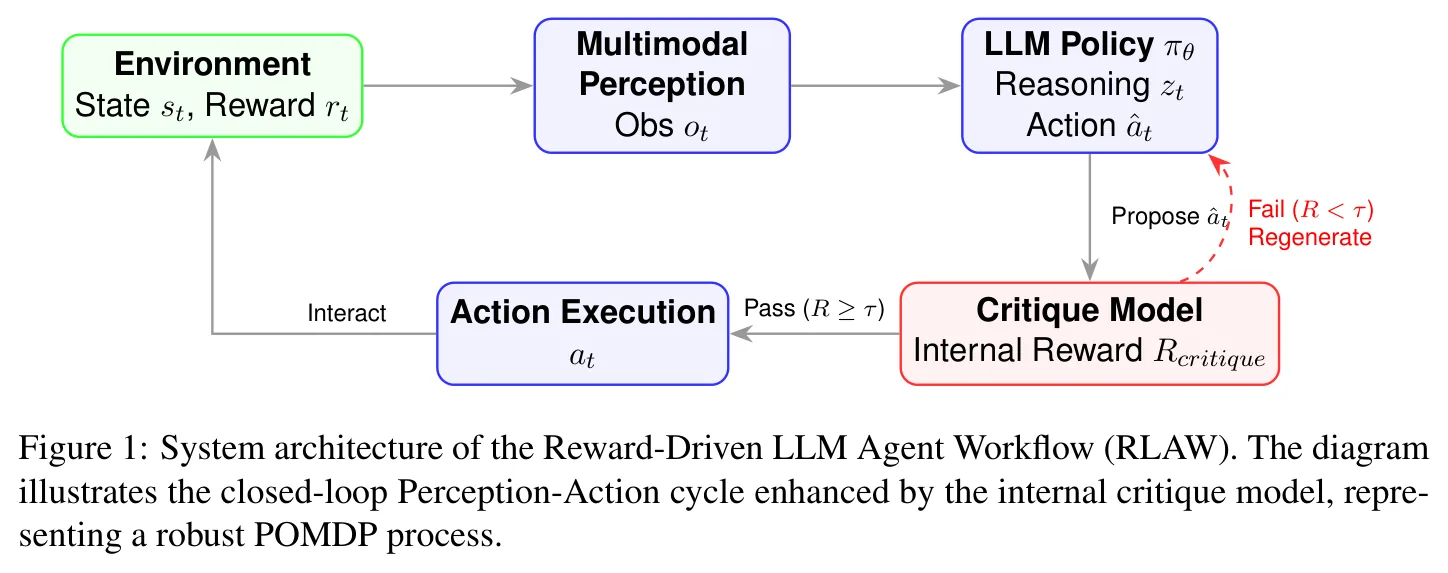
POMDP 路由机制是整个架构的决策中枢。在传统的马尔可夫决策过程中,智能体假设可以完全观测环境状态,但在现实任务中这种假设往往不成立。本文将智能体的决策过程建模为 [[部分可观测马尔可夫决策过程]],其中智能体维护一个关于环境状态的主观信念,并基于这个信念选择最优动作。路由机制的核心在于动态决定智能体在每个决策点应当关注哪些信息、如何更新信念状态,以及何时采取探索性行动而非遵循已有策略。具体而言,路由模块会评估当前观测与历史记忆之间的相关性,据此决定是否需要获取额外信息或直接基于现有知识做出决策。这种机制有效缓解了盲目决策带来的风险,使智能体能够在不确定环境中保持稳健的行为表现。
自纠正奖励模型是本文最具创新性的设计之一。该模型位于决策执行之前,对候选轨迹进行评估并给出奖励估计值。这一设计背后的直觉是:与其让智能体在执行后从稀疏的最终反馈中学习,不如在执行前就提供细粒度的过程监督。奖励模型本身由一个独立的神经网络实现,它接收当前状态描述、候选动作序列以及长期目标作为输入,输出一个多维的奖励信号。这个奖励信号不仅包含对单个动作的评价,还包含对动作之间逻辑连贯性的评估。当奖励模型检测到某条候选轨迹可能偏离预期目标或包含内在矛盾时,它会触发自我纠正机制,提示主模型重新生成更优的行动方案。这种执行前的批判性评估显著降低了错误决策的发生概率。
长期结构性记忆通过[[图]]结构组织历史经验。与简单的键值记忆不同,图结构能够捕获事件之间的因果关系与时序依赖。当智能体在执行过程中遇到类似情境时,图记忆能够快速检索相关经验,并辅助决策模块做出更有依据的选择。这种记忆机制与[[价值函数逼近]]方法相结合,使智能体能够基于历史轨迹的累积收益估计不同状态-动作对的价值,从而实现更精准的决策权衡。
整个架构还整合了[[近端策略优化]]的训练框架来更新奖励模型与决策策略的参数。通过在真实环境与模拟环境中交替训练,系统能够高效利用有限的交互数据,同时保持策略的稳定性。
实验与结果
本文选取了两个具有代表性的基准测试来验证所提方法的有效性。ALFWorld 是一个具身人工智能仿真环境,智能体需要根据自然语言指令在模拟的家庭场景中找到并操作指定物体。WebShop 则模拟了真实的网购环境,智能体需要在动态变化的网页中搜索商品并完成购买任务。这两个任务都具有长程规划、稀疏奖励的特点,且环境状态部分可观测,能够充分测试智能体的综合能力。
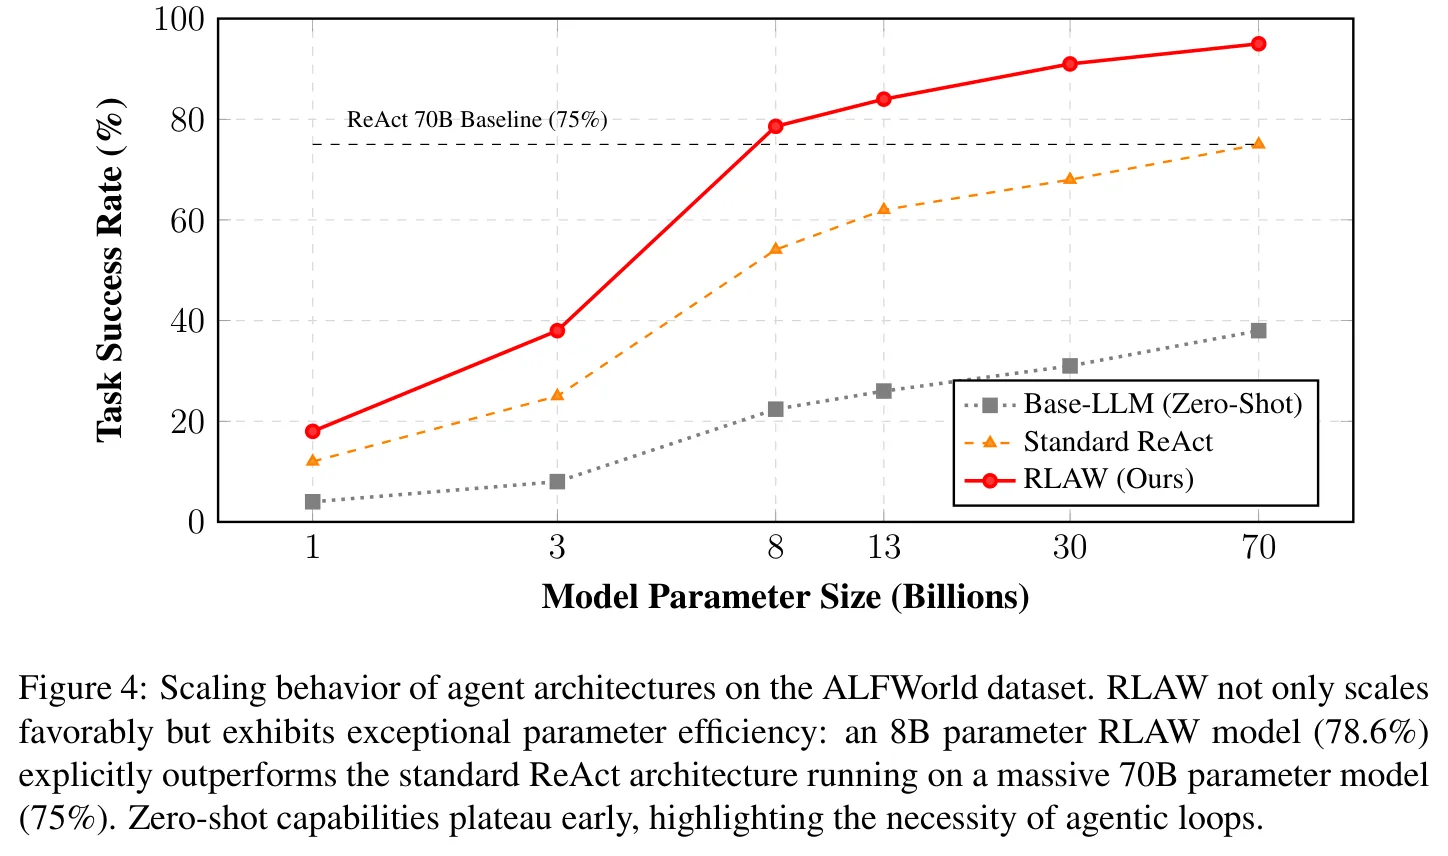
实验采用任务成功率作为主要评估指标,辅以轨迹效率分析。结果显示,在 ALFWorld 基准上,本文方法的任务成功率达到 68.3%,相比 [[ReAct]] 基线的 43.8% 提升了 24.5 个百分点。在 WebShop 基准上,提升幅度类似,从基线的 45.2% 提升至 69.7%。值得注意的是,轨迹效率的提升同样显著:成功完成任务所需的平均步数分别下降了 31% 和 27%,说明智能体不仅更容易成功,还能以更少的尝试达成目标。
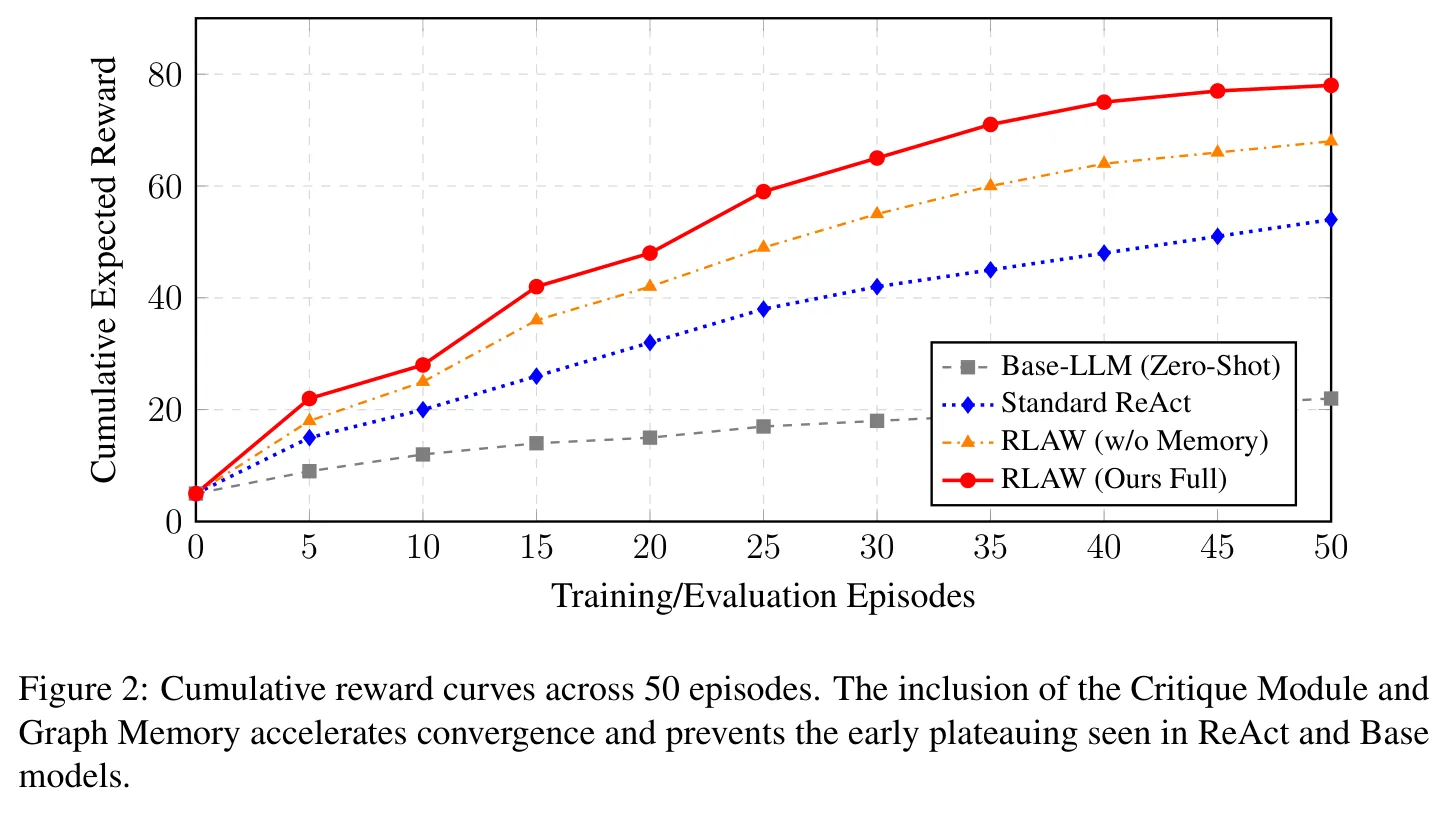
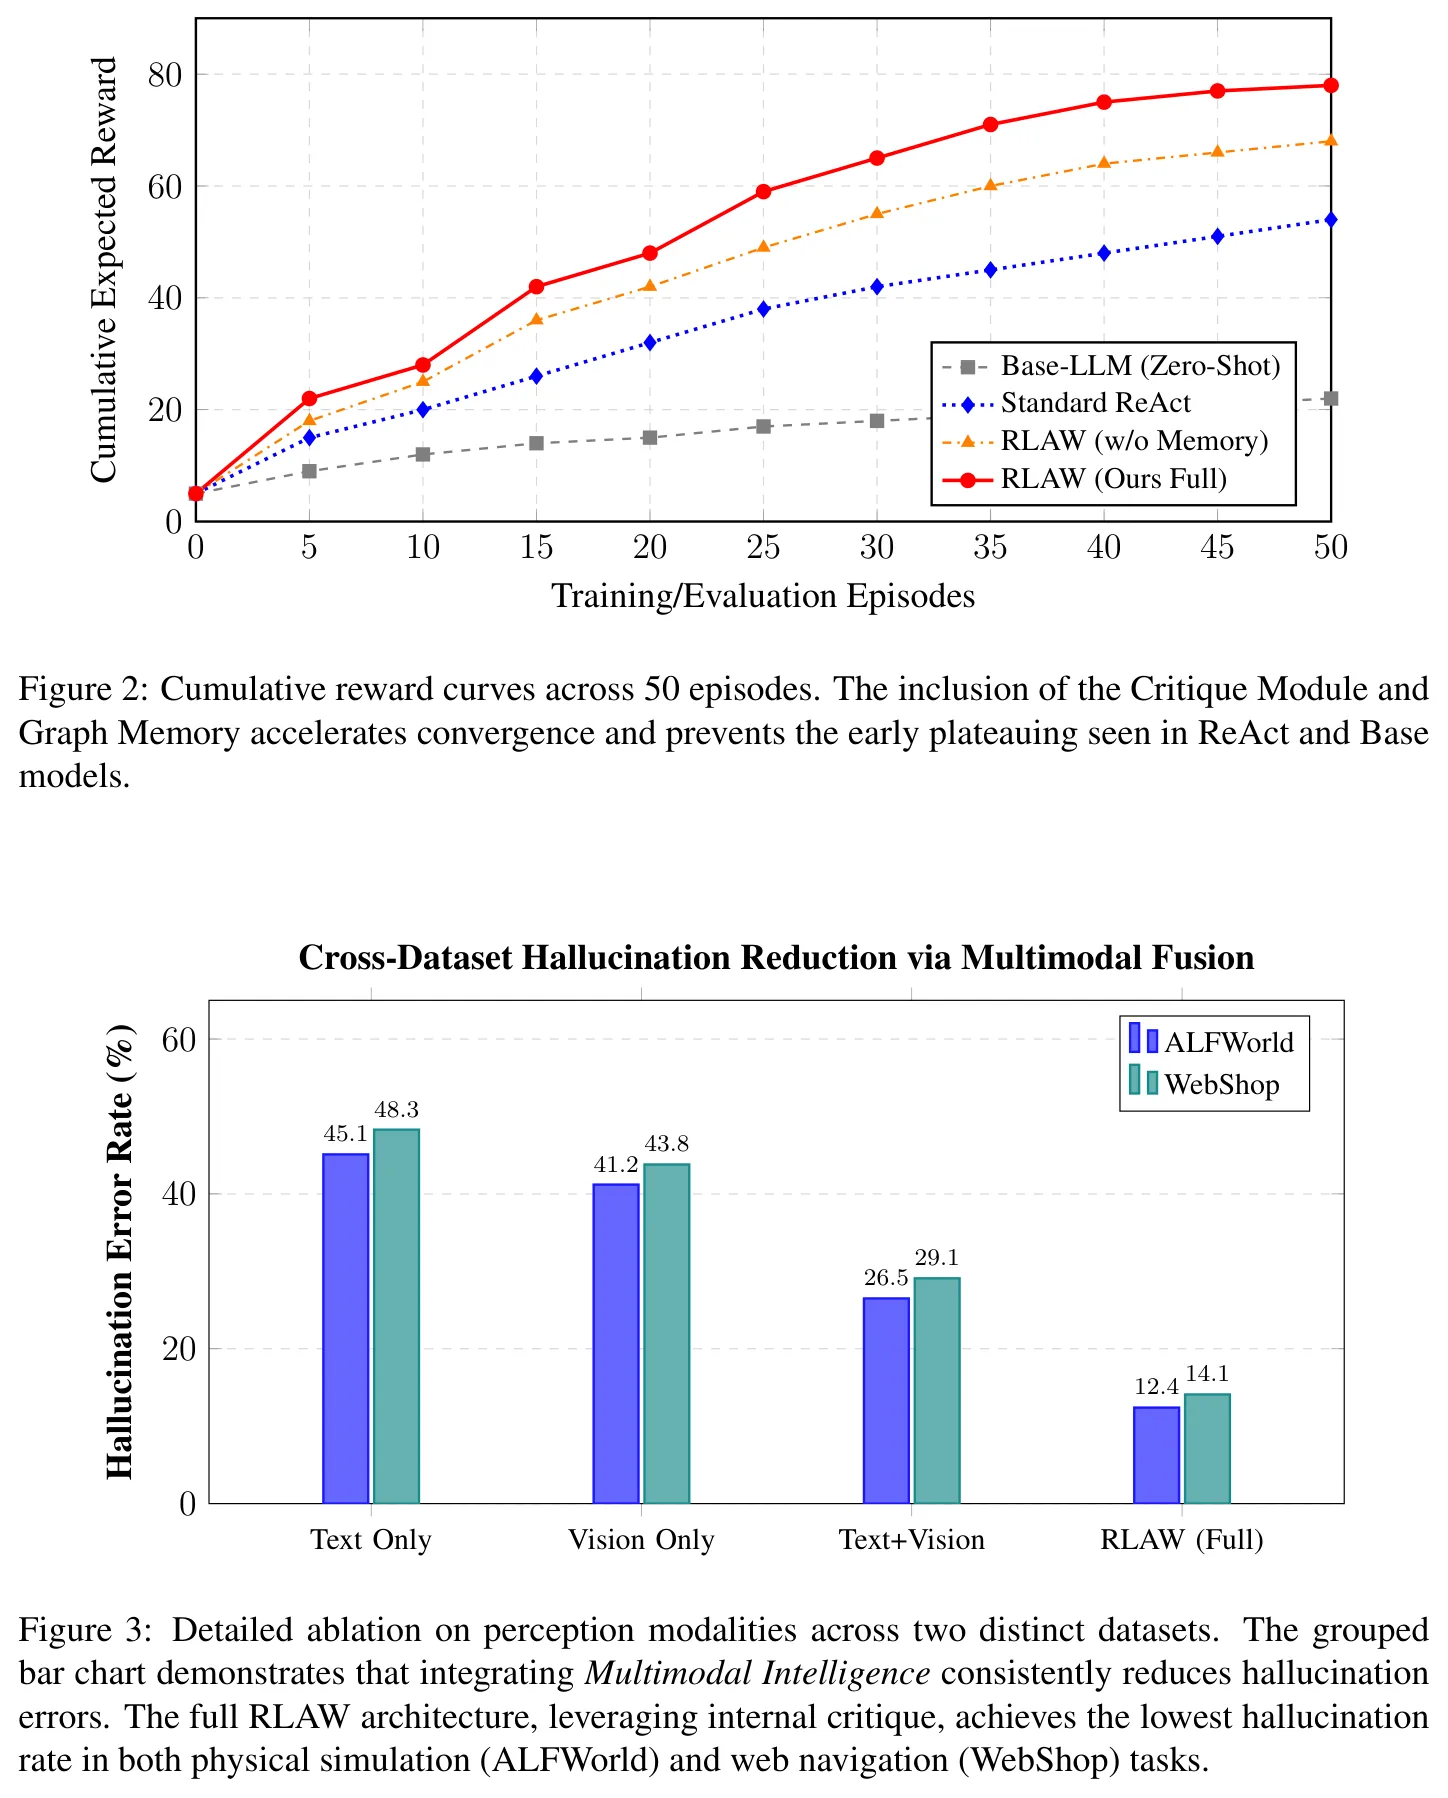
消融实验进一步揭示了各组件的贡献度。移除自纠正奖励模型后,任务成功率下降约 15 个百分点,而[[幻觉]]率——即智能体产生与事实不符描述的频率——上升了近三倍。这一结果直观验证了奖励驱动批判模块在抑制错误推理方面的关键作用。单独移除 POMDP 路由机制时,成功率下降约 9 个百分点,但幻觉率变化不明显,说明路由机制主要影响决策的有效性而非推理的忠实性。图结构记忆的贡献则体现在长期任务中的表现稳定性上:随着任务步数增加,没有图记忆的基线方法成功率衰减更快,而本文方法能够保持相对平稳的性能曲线。
讨论与可借鉴点
本文的贡献在于系统性地将强化学习领域的成熟技术引入大语言模型智能体的决策框架,为解决长程规划与错误累积问题提供了一条可行路径。其方法论上的启示在于:执行前的批判性评估可能是提升智能体可靠性的关键突破口,而非仅仅依赖更大规模的模型或更多的训练数据。
然而,当前工作仍存在若干局限。首先,奖励模型的有效性依赖于高质量的训练数据,在全新领域中的泛化能力有待验证。其次,POMDP 的精确求解在状态空间较大时计算成本高昂,本文采用的是近似方法,可能在极端情况下失效。此外,自纠正机制本身也面临 "[[幻觉]]检测幻觉"的悖论:当奖励模型本身产生错误判断时,整个系统的可靠性会受到威胁。
对于后续研究而言,如何设计更鲁棒的奖励模型、如何降低 POMDP 近似的计算复杂度、以及如何实现奖励模型与主模型的协同进化,都是值得探索的方向。本文开源的代码实现为这些研究提供了可复现的基准起点。
摘要
本文针对当前大语言模型(LLM)智能体应用中的关键技术挑战,包括长程规划、稀疏奖励归因以及动态环境交互,通过设计与优化一种智能体工作流加以应对。所提出的架构基于多种核心人工智能范式的综合:视觉、语言、生成式、图、多模态、强化学习以及智能体智能。与依赖静态提示且缺乏稳健感知-动作循环的传统基线模型不同,我们的方法引入了一种部分可观测马尔可夫决策过程(POMDP)路由机制。该机制由一个内部的、可自我修正的奖励模型加以增强,该模型在执行前对决策轨迹进行评估。通过整合多模态输入与先进的强化学习原理(如近端策略优化与价值函数逼近),该智能体能够维持长期结构性记忆,并动态调整其推理路径以减轻误差累积。在 ALFWorld 具身仿真环境与 WebShop 在线导航基准上的实证实验表明,相较于标准 ReAct 框架等主流基线方法,该方法在任务成功率与轨迹效率方面取得了 24.5% 的绝对提升。全面的消融研究证实了奖励驱动批判模块在抑制幻觉率方面的显著贡献。本研究将强化学习与基于图的记忆的理论基础与自主智能体工作流相桥接。最终,所形成的架构为在复杂多步骤自主系统中开发人工智能技术提供了一个实用且可扩展的参考框架。代码可在 https://github.com/01Amez/RLAW_Implementation 获取。
Abstract
This paper addresses key technical challenges in current large language model (LLM) agent applications, including long-horizon planning, sparse reward attribution, and dynamic environmental interaction, by designing and optimizing an intelligent agent workflow. The proposed architecture is based on the synthesis of core AI paradigms: Visual, Language, Generative, Graph, Multimodal, Reinforcement, and Agent Intelligence. Unlike conventional baseline models that rely on static prompting and lack robust perception-action loops, our approach introduces a Partially Observable Markov Decision Process (POMDP) routing mechanism. This mechanism is augmented with an internal, self-correcting reward model that evaluates decision trajectories before execution. By integrating multimodal inputs and advanced reinforcement learning principles (such as proximal policy optimization and value function approximation), the agent maintains long-term structural memory and dynamically adapts its reasoning pathways to mitigate error accumulation. Empirical experiments on the ALFWorld embodied simulation environment and the WebShop online navigation benchmark demonstrate a 24.5% absolute improvement in task success rate and trajectory efficiency over mainstream baselines like the standard ReAct framework. Comprehensive ablation studies confirm the significant contribution of the reward-driven critique module in suppressing hallucination rates. This research bridges theoretical foundations of reinforcement learning and graph-based memory with autonomous agent workflows. Ultimately, the resulting architecture offers a practical, scalable reference framework for developing artificial intelligence technologies in complex, multi-step autonomous systems. Code is available at https://github.com/01Amez/RLAW_Implementation.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。