
通过强化学习增强膀胱癌个性化治疗:一种复发性患者状态转移决策支持框架
Enhancing Personalized Bladder Cancer Treatment Through Reinforcement Learning: A Recurrent Patient State Transition Decision Support Framework
📝 TLDR
膀胱癌复发性疾病的治疗效果随临床周期变化,传统决策支持系统依赖静态指南或单步预测,难以捕捉疾病动态进展。本文提出循环患者状态转移模拟框架,整合预测状态转移建模与基于DQN的马尔可夫决策过程,预测模块估计治疗后肿瘤特征变化,RL智能体在模拟患者轨迹上序贯优化治疗决策。在模拟复发性治疗环境中,累积奖励63,918.87,平均训练损失0.0056,策略改进6.62%,验证了序列学习与治疗优化能力,为精准肿瘤学的动态决策支持提供了灵活框架。
🧭 速览
膀胱癌治疗需个性化与适应性决策,传统静态指南或单步预测模型无法捕捉复发性疾病的动态进展。
提出循环患者状态转移模拟框架,融合预测状态转移建模与MDP/DQN强化学习,序贯优化治疗决策。
累积奖励63,918.87,平均训练损失0.0056,策略改进得分6.62%,优于现有RL治疗规划方法。
验证了序列学习与稳健治疗优化能力,为AI辅助精准肿瘤学的动态决策支持提供了灵活框架。
🆚 方法对比
Recurrent Patient State-Transition Simulation Framework
- 整合预测建模与DQN实现动态个性化决策
- 累积奖励达63918.87、训练损失仅0.0056
- 支持序贯治疗轨迹与可解释模拟日志
- 策略改进分数6.62%体现稳定学习
- 仅在仿真环境验证尚未临床验证
- 泛化至其他癌种的有效性未评估
- 依赖仿真患者轨迹的真实性
- 模块间交互增加了系统复杂度
Predictive State-Transition Modeling Module
- 可估计治疗干预后肿瘤特征变化
- 支持多次复发事件的纵向建模
- 为强化学习提供演化状态输入
- 预测精度受限于训练数据规模
- 无法完全捕捉非线性的肿瘤进展
- 对罕见亚型泛化能力存疑
Markov Decision Process (MDP)
- 为序贯治疗决策提供形式化框架
- 便于将状态、动作、奖励明确建模
- 支持连续多步规划与回报优化
- 肿瘤动态可能违反严格马尔可夫性
- 状态空间设计直接影响策略质量
- 状态转移概率估计困难
Deep Q-Network (DQN)
- 能处理高维临床状态空间
- 经验回放提升训练稳定性
- 成熟算法易于与预测模块集成
- 存在Q值过估计偏差
- 样本效率较低需大量训练轮次
- 离散动作空间限制治疗组合细度
Conventional Static Clinical DSS
- 基于临床指南易于临床落地
- 模型可解释性高
- 实现与部署成本较低
- 静态规则无法适应病情演化
- 缺少对复发事件的动态处理
- 无法针对个体患者持续优化
本文提出的Recurrent Patient State-Transition Simulation Framework通过将Predictive State-Transition Modeling与MDP、DQN融合,实现了对传统静态DSS的动态化升级,相较同类RL治疗规划方法在累积奖励和策略改进方面表现更优,但仍需临床实证验证。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 13 张)
展开查看 13 张图
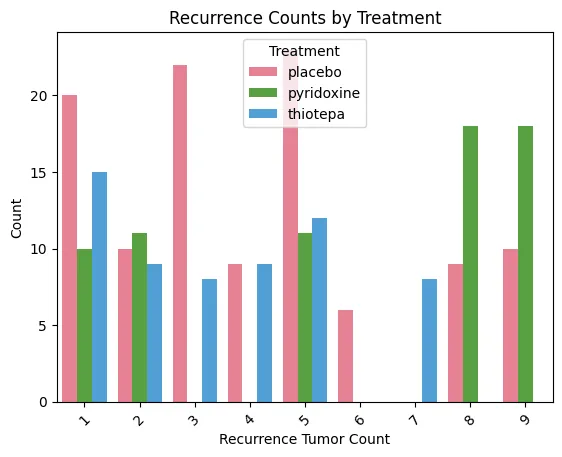
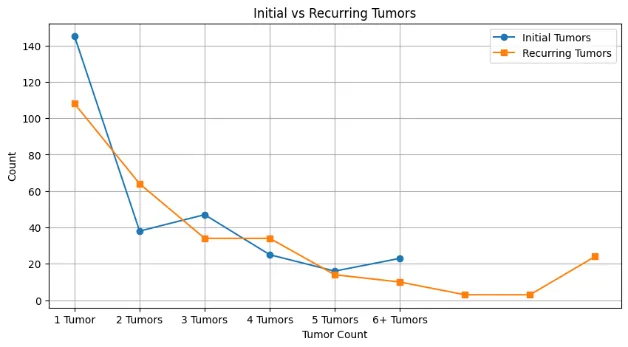
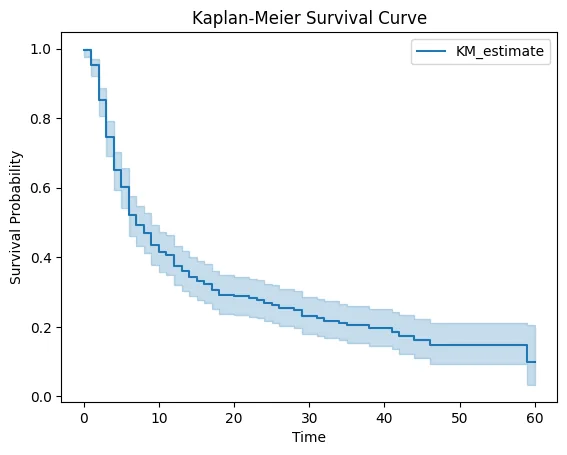
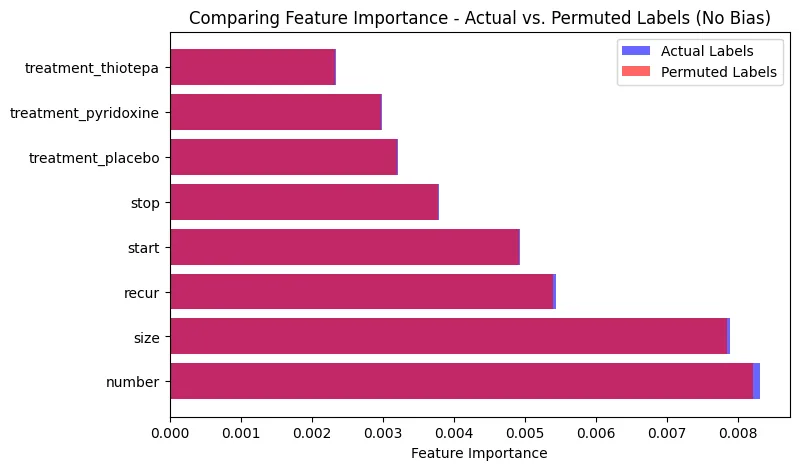
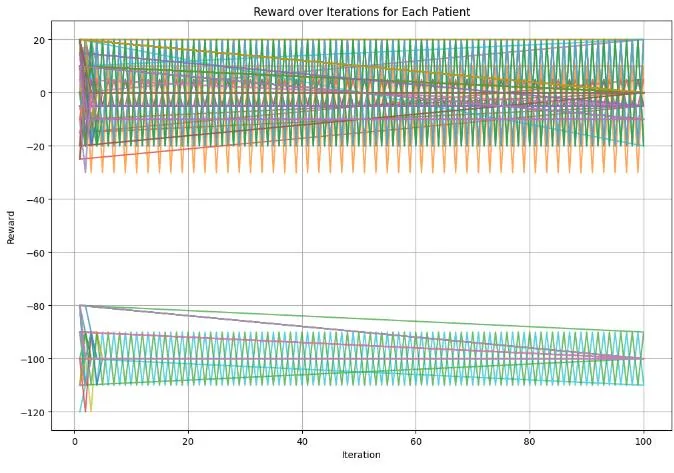
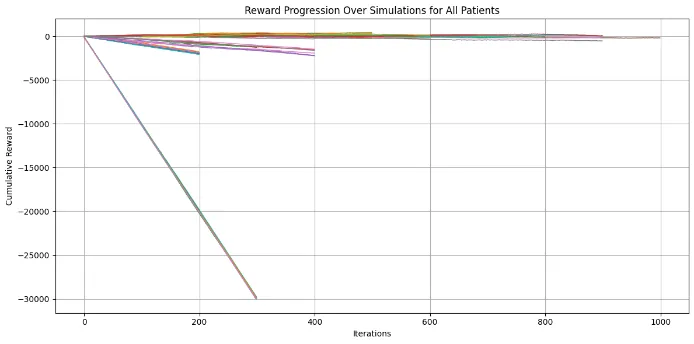
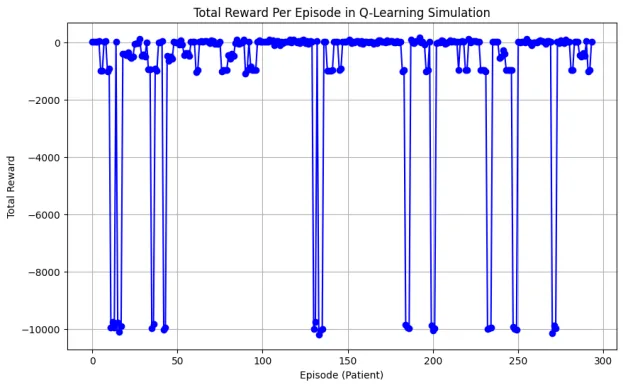
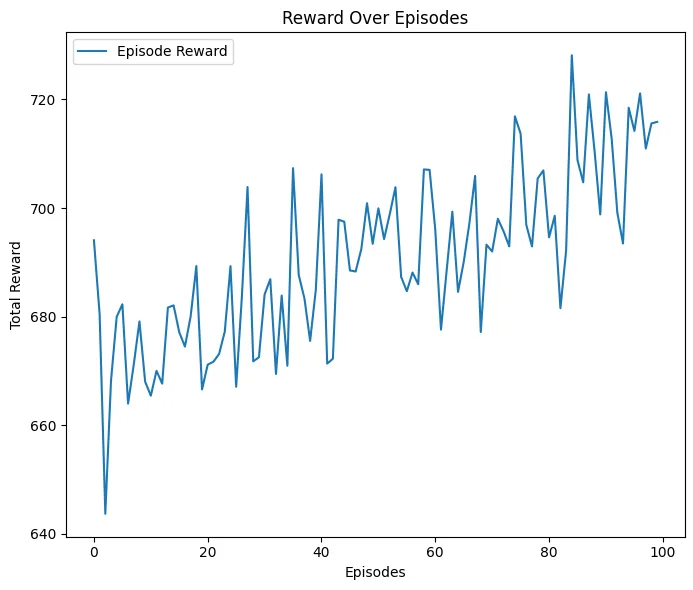
TL;DR
这篇论文针对膀胱癌复发性疾病的治疗决策难题,提出了一套融合预测性状态转移建模与强化学习的模拟框架。系统通过预测治疗后肿瘤特征变化,结合DQN智能体在模拟患者轨迹上序贯优化治疗方案,最终在模拟环境中取得累积奖励63,918.87、策略改进6.62%的效果,为精准肿瘤学的动态治疗规划提供了可解释的决策支持方案。
研究背景与动机
膀胱癌是全球范围内常见的恶性肿瘤之一,其治疗过程具有显著的复杂性——尤其对于复发性疾病患者而言,同一治疗手段在不同临床周期的效果往往存在差异。传统的临床决策支持系统大多基于静态指南或单步预测模型,前者无法适应个体差异,后者仅能给出单一时间点的推荐而忽略了治疗是一个序贯决策过程。这种局限性在复发性疾病场景下尤为突出,因为疾病进展本身就构成了一个动态演化系统,当前治疗选择会显著影响未来的疾病状态和治疗选项。
造成这一困境的核心挑战在于治疗效果的异质性与动态性。膀胱癌患者在接受手术、化疗或免疫治疗后,肿瘤的生物学特征会发生变化,而这些变化又会反过来影响后续治疗的敏感性。传统方法难以建模这种“状态-动作-下一状态”的链式依赖关系,更无法在模拟环境中探索不同治疗序列的长期效果。
本文的切入点正是将治疗规划问题形式化为一个[[马尔可夫决策过程]],通过构建一个能够捕捉复发性患者状态转移规律的模拟环境,使强化学习智能体能够在其中学习到适应疾病动态演进的最佳治疗策略。这种方法的优势在于:它不依赖单一预测结果,而是通过与环境的持续交互,逐步优化整个治疗轨迹上的决策质量。
方法
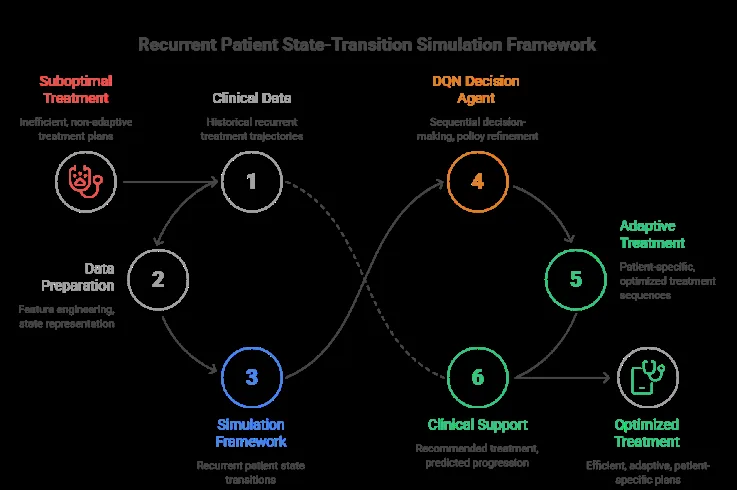
该框架的核心设计围绕两个关键模块展开:预测性状态转移建模与基于DQN的强化学习决策优化。两者通过模拟环境的循环交互形成闭环,共同支撑起整个治疗规划系统。
预测性状态转移模块承担着“模拟疾病演进”的任务。它以当前患者状态(包括肿瘤大小、分级、侵袭程度等特征)以及选择的治疗动作为输入,输出预测的下一状态分布。这一模块本质上是一个多步转移概率估计器,需要学习不同治疗方案作用于不同疾病状态后可能产生的临床结果。论文中采用深度神经网络来建模这种复杂的非线性映射关系,使得预测结果能够捕捉到真实临床中存在的个体差异和不确定性。
基于DQN的马尔可夫决策过程环境则将治疗规划问题形式化为标准的[[强化学习]]范式。状态空间描述了患者在每个临床节点上的疾病特征;动作空间对应可选择的治疗方案集合,如TURBT手术、膀胱内灌注化疗、免疫检查点抑制剂等;奖励函数的设计则综合考量了治疗效果(肿瘤缩小或消失)、治疗成本(副作用、生活质量影响)以及长期预后。智能体通过与这个模拟环境持续交互,学习估计每个状态-动作对的长期价值(即Q值),进而输出最优治疗建议。
值得注意的设计选择是“循环患者状态转移”的概念框架。传统的治疗模拟通常假设患者状态转移是独立同分布的,而本文强调复发性疾病的特征在于状态转移存在时间序列依赖性——既往治疗历史会影响当前状态的分布。这一设计直觉来源于临床观察:复发性膀胱癌患者通常经历过前序治疗,其肿瘤生物学特性可能已发生变化。框架通过将历史状态信息编码进当前状态表示,确保智能体能够感知这种动态演化。
此外,系统在可解释性方面做了额外设计。它不仅输出最终治疗推荐,还生成详细的仿真日志和治疗轨迹可视化,让临床医生能够追溯智能体的决策逻辑,理解为什么在特定状态下选择某种治疗方案。这种透明度对于临床应用至关重要,因为它使医生能够在AI建议与自身专业判断之间进行有意义的比较和整合。
实验与结果
研究团队设计了一套模拟复发性膀胱癌治疗环境来验证框架的有效性。实验采用标准的训练-评估分离设置,智能体在多个回合(episode)中学习逐步改进其治疗策略。
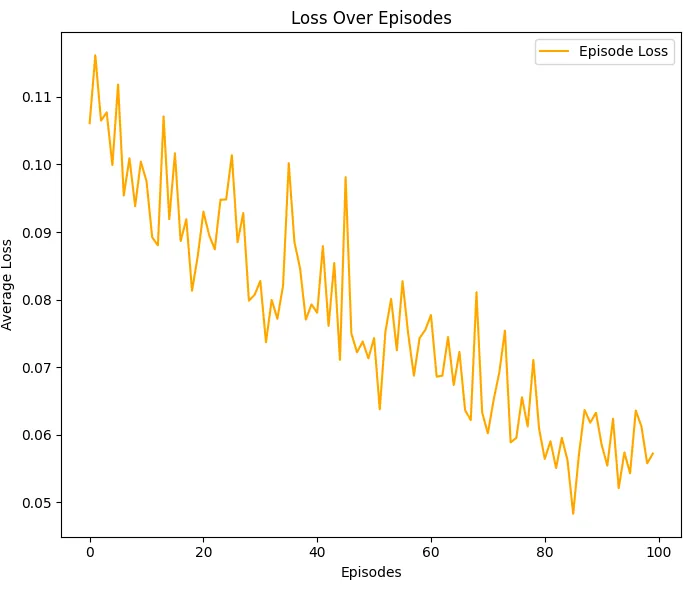
核心评估指标包括三个方面:累积奖励反映智能体在完整治疗轨迹上的总体表现,训练损失衡量学习过程的稳定性,策略改进得分则衡量相比基线策略的性能提升幅度。实验结果表明,框架达到累积奖励63,918.87,每个回合的平均训练损失控制在0.0056的低水平,策略改进得分为6.62%。这三个数字的含义需要结合具体临床场景理解:累积奖励的高值表明智能体能够在长期治疗过程中维持良好的效果-成本平衡;低训练损失说明预测模块能够稳定地模拟状态转移规律,使强化学习信号质量可靠;策略改进得分则量化了框架相对于传统基线方法的增益。
与现有基于强化学习的治疗规划方法进行对比是该实验设计的另一重点。结果显示,所提出的循环状态转移框架在各项指标上均展现出优势,这验证了“显式建模状态转移时间依赖性”这一设计决策的实际价值——当智能体能够感知复发性疾病的历史轨迹时,它能够做出更具前瞻性的治疗决策。
需要指出的是,这些结果目前仅在模拟环境中获得。模拟环境虽然能够以较低成本进行大规模实验,但其状态转移概率来自历史数据或专家知识,可能无法完全复制真实临床环境的复杂性。论文也承认了这一点,将模拟环境定位为“验证框架可行性”的阶段性工具,而非最终临床部署环境。
讨论与可借鉴点
这项研究的价值在于为精准肿瘤学提供了一种动态治疗规划的范式框架。与其说它解决了膀胱癌治疗的具体问题,不如说它展示了一种可迁移的方法论:当疾病具有显著的时间动态性和异质性时,将治疗决策建模为[[马尔可夫决策过程]]并通过强化学习求解是一个自然且有潜力的选择。框架中预测模块与决策模块的解耦设计使得系统具有良好扩展性——预测模块可以替换为更精确的领域特定模型,决策模块也可以尝试更先进的强化学习算法。
然而,现阶段框架距离临床应用仍有距离。首要局限在于模拟环境的真实性——状态空间的定义、转移概率的估计、奖励函数的设计都涉及大量临床专业知识,任何环节的偏差都可能导致智能体学到“错误的优化目标”。其次,框架输出的可解释性虽然比纯黑箱模型有所改进,但与临床医生期望的决策依据仍有差距——医生不仅想知道“应该用什么治疗”,更想知道“为什么”。最后,数据稀缺性是制约此类系统发展的根本因素:复发性膀胱癌患者的纵向治疗数据难以获取,跨机构数据共享又面临隐私和标准化挑战。
对于该领域后续研究,有几个方向值得关注。一是将框架扩展到多模态数据融合,除了临床特征还能纳入影像、病理、基因组学信息,使状态表示更加丰富。二是探索模型不确定性量化,让智能体在预测置信度低时主动寻求医生输入或选择保守方案。三是研究离线强化学习方法,直接从历史治疗数据中学习策略,避免大量模拟环境交互的样本效率问题。
总体而言,这篇论文为AI辅助治疗决策提供了一个结构完整的设计参考,其核心贡献不在于某项具体技术突破,而在于将临床问题形式化、模块化的思维方式。对于关注医疗AI应用的读者而言,理解其框架设计背后的临床逻辑与工程取舍,比单纯复现代码更有价值。
摘要
膀胱癌治疗需要个性化且自适应的决策过程,尤其是在复发性疾病中,治疗效果在连续临床发作过程中会发生变化。传统的临床决策支持系统通常依赖静态治疗指南或单步预测模型,这限制了它们随时间捕捉疾病进展的能力。本文提出了一种用于膀胱癌治疗规划的复发性患者状态转移仿真框架,该框架将预测性状态转移建模与马尔可夫决策过程(MDP)和深度Q网络(DQN)强化学习环境相集成。预测模块估计治疗后肿瘤特征的变化,而强化学习智能体通过与模拟的患者轨迹交互来顺序优化治疗决策。该框架通过持续调整推荐以适应不断演变的临床状态,实现动态的、患者特异性的治疗规划。它还生成可解释的治疗轨迹和详细的仿真日志,以提高透明度并支持临床决策。所提出的框架针对现有的基于强化学习的治疗规划方法进行了评估。它获得了累积奖励63,918.87,每个回合的平均训练损失为0.0056,策略改进得分为6.62%,证明在模拟的复发性治疗环境中实现了有效的序列学习和稳健的治疗优化。这些发现突出了复发性患者状态转移仿真与强化学习相结合作为个性化膀胱癌治疗规划和AI辅助精准肿瘤学的灵活决策支持框架的潜力。
Abstract
Bladder cancer treatment requires personalized and adaptive decision-making, particularly for recurrent disease, where treatment effectiveness changes across successive clinical episodes. Conventional clinical decision support systems typically rely on static treatment guidelines or single-step predictive models, limiting their ability to capture disease progression over time. This paper presents a recurrent patient state-transition simulation framework for bladder cancer treatment planning that integrates predictive state-transition modeling with a Markov Decision Process (MDP) and a Deep Q-Network (DQN) reinforcement learning environment. The predictive module estimates changes in tumor characteristics following treatment, while the reinforcement learning agent sequentially optimizes treatment decisions by interacting with simulated patient trajectories. This framework enables dynamic, patient-specific treatment planning by continuously adapting recommendations to evolving clinical states. It also generates interpretable treatment trajectories and detailed simulation logs to improve transparency and support clinical decision-making. The proposed framework was evaluated against existing reinforcement learning-based treatment planning approaches. It achieved a cumulative reward of 63,918.87, an average training loss per episode of 0.0056, and a policy improvement score of 6.62%, demonstrating effective sequential learning and robust treatment optimization in a simulated recurrent treatment environment. These findings highlight the potential of recurrent patient state-transition simulation with reinforcement learning as a flexible decision-support framework for personalized bladder cancer treatment planning and AI-assisted precision oncology.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。