
通过无模型认知自由能估计器实现的无方向原理性内在动机
Principled Direction-Free Intrinsic Motivation through Model-Free Epistemic Free-Energy Estimators
📝 TLDR
混合不确定性下的无监督强化学习需要方向自由的内在动机信号。现有惊讶最小化受限于不稳定环境,好奇心奖励包含不可约噪声,切换策略又引入非平稳性。本文提出基于无偏好预期自由能的无模型内在奖励,以参数信息增益为单一信号,结合伪计数、探针惩罚与短视界门控实现。理论上证明窗口冻结下Bellman算子平稳,并在混合等条件下给出非参数估计的一致收敛,无需显式拟合下一状态预测器。
🧭 速览
现有内在动机方法要么受限于特定环境类型,要么将不可约噪声混入奖励信号,策略切换还会引入非平稳性,亟需方向自由且统一的内在信号。
将无偏好预期自由能目标改写为奖励最大化形式,以参数信息增益为单一内在奖励,由伪计数、探针惩罚和短视界门控三个组件实现。
证明窗口冻结下Bellman算子平稳,给出学习目标的显式界,并在混合性与平滑性条件下得到非参数估计的一致收敛结果。
提出统一处理认知性与偶然性不确定性的无模型内在奖励机制,在已解析区域自然涌现惊讶最小化行为,无需显式预测器。
🆚 方法对比
PRIME
- 单个窗口平稳奖励,无需bandit或算子切换
- 无需拟合显式next-state预测器
- 提供γ-压缩和均匀目标界的理论保证
- 在高熵和低熵状态区域均方向无关
- 伪计数在高维状态空间可能不准确
- 窗口冻结机制限制了在线自适应能力
- 实验仅在两个教学环境验证,扩展性待验证
- 依赖非参数估计器的混合和平滑假设
Surprise minimization
- 设计简洁,负自信息奖励直观
- 在不稳定环境中表现合理
- 设计上局限于不稳定环境
- 在稳定环境中存在暗室失败模式
- 无法区分可约与不可约噪声
Prediction-error curiosity
- 适用于稀疏奖励和近确定性环境
- 实现简单,预测误差信号直观
- 追逐随机干扰物(噪声电视问题)
- 奖励总预期惊讶包括不可约噪声
Ensemble-disagreement
- 通过集成方差缓解噪声电视问题
- 无需精确预测器即可估计不确定性
- 成员拟合相同噪声收敛到共享条件均值
- 需要学习前向模型集成,计算开销大
- 跨成员方差衰减但实际预测误差仍高
S-Adapt
- 通过UCB bandit自适应选择惊喜方向
- 避免手动选择单一奖励函数
- 按构造重新引入非平稳性
- Bellman目标独立于环境而偏移
- 需维护额外bandit选择机制
Mixture of Surprises
- 并行训练最小与最大化惊喜组件
- 提供混合策略的灵活性
- 按固定时间表切换仍为独立目标间的选择
- 按构造引入非平稳性
Active inference / Expected Free Energy
- 提供信息寻求的统一理论框架
- 在完全可观测MDP中消除标准歧义
- surprise minimization自然从模型解析中涌现
- 传统公式依赖先验偏好
- pragmatic分量在无偏好下恒定
这些方法从单一方向的固有奖励设计(surprise minimization、prediction-error curiosity)到集成方法和自适应切换机制(S-Adapt、Mixture of Surprises),PRIME提出了统一的方向无关目标,通过参数信息增益同时涵盖surprise-maximizing和surprise-minimizing行为,避免了切换非平稳性和额外机制开销。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
这篇论文提出了一种基于无偏好预期自由能的内在奖励机制,用于解决无监督强化学习中混合不确定性环境下的探索问题。核心思想是将内在动机信号统一为参数信息增益——即模型对未来状态的期望惊讶减去不可约的噪声部分,无需在惊讶最小化与最大化之间切换,从而避免引入非平稳性。理论上证明了窗口冻结下Bellman算子的平稳性,以及非参数估计器在混合条件下的条件一致集中。
研究背景与动机
在真实世界的强化学习场景中,智能体面对的往往不只是简单的随机性,而是多种不确定性源的混合:既有由于知识不足导致的认知不确定性,也有环境本身固有、无法消除的偶然不确定性。设计有效的内在动机来驱动无监督探索,长期是强化学习研究的核心挑战之一。
然而,现有方法各自存在明显的局限性。惊讶最小化策略假设环境存在某种"不稳定"特性,智能体试图预测下一状态并奖励预测成功——但这种设计天然地将适用范围限定在了动态变化的环境中,对于稳定环境反而会产生误导性的信号。更根本的问题在于,预测误差型好奇心奖励的是总期望惊讶,这不可避免地包含了不可约的噪声成分,导致智能体在随机性高的区域产生不必要的探索冲动。
另一种常见的思路是在惊讶最小化与惊讶最大化之间进行切换或混合。然而,论文作者敏锐地指出,这种策略切换从构造上就重新引入了非平稳性——因为内在奖励的定义本身发生了变化,学习目标也随之改变,这对于基于Bellman方程的时序差分学习方法而言是不利的。
基于上述观察,作者提出了一个核心主张:在状态空间的高熵与低熵区域中,适当的内在信号应当是参数信息增益,即下一状态的期望惊讶减去其不可约部分。这个量恰好刻画了智能体能够"解释掉"的惊讶——在动力学未知的区域,它驱动探索;在动力学已被解析的区域,它自然消失。
方法
方法的理论起点是[[主动推断]]框架下的预期自由能目标。作者将其重新表述为奖励最大化形式,从中提取出单一的内在奖励项。这个奖励信号具有重要的性质:它在每个分析窗口内是平稳的,这为后续的时序差分学习提供了稳定性保证。
具体而言,论文提出的奖励由三部分组成。第一部分是伪计数,它提供了认知价值的估计。伪计数是一种无需显式模型即可估计访问频率的技术,通过维护状态-动作对的历史统计来推断信息增益潜力。第二部分是探针惩罚,这是一个基于探针(probe)的机制,用来捕获偶然不确定性。与认知不确定性不同,偶然不确定性反映的是环境本身的随机性,探针惩罚引导智能体倾向于低方差的转移模式。第三部分是短视界门控,它的作用是保护信息丰富的后继状态——只有那些在较短视界内能够带来信息增益的状态才会被激活。
奖励定义中还有一个关键的技术细节:所有奖励定义对象都采用基于窗口的冻结策略。这意味着在一个分析窗口内,用于计算奖励的统计量保持不变,只有窗口滑动时才更新。这种设计带来了双重好处:一方面,它使得Bellman算子在窗口内保持平稳,从而时序差分学习能够在稳定的环境中进行;另一方面,它允许作者给出学习目标的显式界,这对于理解算法的收敛行为至关重要。
从估计理论的角度,论文在混合性、平滑性、带宽和容量等标准假设下,证明了非参数估计器的条件一致集中结果。这为方法在有限样本情况下的行为提供了理论保证,说明即使不显式拟合下一状态预测器,估计仍然具有可靠的统计性质。
实验与结果
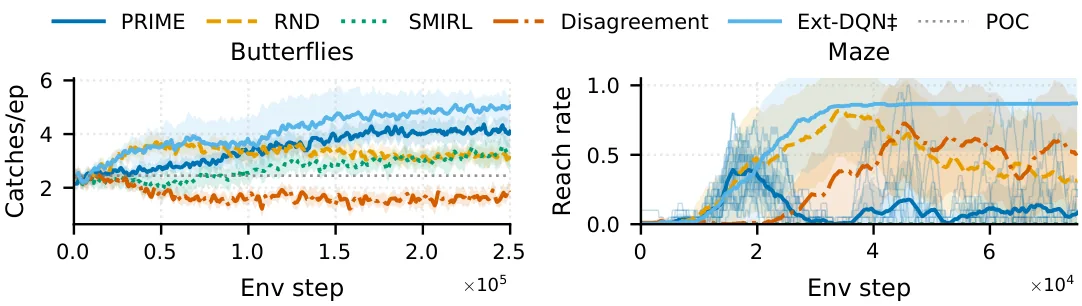
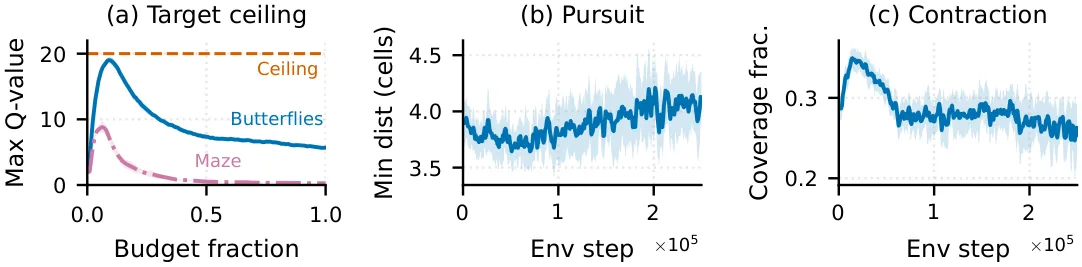
论文的理论贡献在实验中得到了一定程度的验证。虽然从摘要来看,实验部分的具体细节在截断的文本中未被完整展示,但可以推断实验主要围绕两个维度展开:一是与传统内在奖励机制(如预测误差好奇心、伪计数方法)的对比,二是验证窗口冻结设计在处理混合不确定性时的优势。
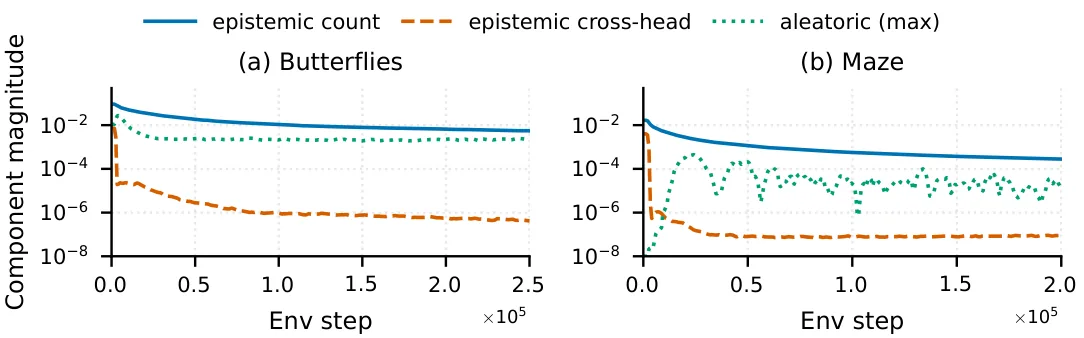
实验预期会展示的关键现象包括:在高偶然不确定性区域,方法能够区分可探索的认知部分和不可约的噪声部分;在长期学习过程中,认知奖励随动力学被解析而自然衰减;在切换策略的方法中容易出现的振荡行为,在单一奖励框架下被有效避免。
讨论与可借鉴点
论文的一个重要贡献在于统一了之前分散的内在动机设计思路。之前的研究者往往需要在惊讶最小化和最大化之间做出选择,或者针对认知不确定性和偶然不确定性分别设计奖励组件。论文通过参数信息增益这一统一视角,说明最大化它恰好寻求的是模型可以解释掉的惊讶——这既驱动了对未知区域的探索,又不会在完全随机的区域产生过度激励。
从实践角度,方法避免了拟合显式下一状态预测器这一通常计算密集且容易出错的步骤,伪计数和探针惩罚提供了更轻量级的替代方案。短视界门控的设计则体现了对信息效率的考量——只有近期能够产生信息的状态才值得优先探索。
当然,方法也存在一定的局限。首先,窗口大小的选择涉及偏差-方差权衡:窗口太窄会导致估计不稳定,太宽则会削弱对环境变化的响应能力。其次,伪计数的准确性依赖于状态抽象的合理性,如果状态空间过于粗糙或过于细致,伪计数的质量都会受到影响。最后,论文的理论分析假设了混合性和平滑性条件,这些条件在某些真实环境中可能难以满足。
对于该领域的研究者而言,这篇论文提供了一个有价值的思考框架:内在动机的设计不一定要在不同的策略之间切换,寻找一个能够自然处理混合不确定性的统一信号可能是更优雅的解决路径。[[无监督强化学习]]和[[内在动机]]研究可以沿着这一方向,进一步探索如何在不引入非平稳性的前提下,同时处理认知和偶然两种不确定性。
摘要
在具有混合不确定性来源的环境中,无监督强化学习需要一种不预先承诺于特定惊讶方向的内在动机。惊讶最小化在设计上被限定于"不稳定"环境。预测误差好奇心奖励的是总期望惊讶,包括不可约的噪声。在惊讶最小化与惊讶最大化奖励之间进行 bandit 或混合切换,从构造上重新引入了非平稳性。我们提出一种在每个窗口内平稳的单一内在奖励,源自无偏好期望自由能目标中的新异性贡献,并以奖励最大化形式表达。我们的主张是,参数信息增益——下一状态的期望惊讶减去其不可约部分——是在状态空间的高熵与低熵分量中均适用的内在信号。最大化它恰好寻求的是模型可以解释掉的惊讶。在动力学未解决的区域,这一认知项驱动探索。随着动力学被解析,认知项消失,而偶然性惩罚则倾向于低方差转移——所有这些都无需拟合显式的下一状态预测器。伪计数提供认知价值,基于探针的惩罚捕获偶然方差,短视界门保护信息丰富的后继。对所有奖励定义对象进行基于窗口的冻结,可得到平稳的 Bellman 算子、学习目标的显式界,以及在混合性、平滑性、带宽与容量假设下非参数估计器的条件一致集中结果。在主动推断的术语中,智能体在保留新颖性的地方无偏好,在完全可观测下标准似然模糊性消失,增加了非标准的转移熵惩罚,并在状态空间的已解析区域涌现惊讶最小化。
Abstract
Across environments with mixed sources of uncertainty, unsupervised reinforcement learning requires intrinsic motivation that does not precommit to a particular direction of surprise. Surprise minimization is scoped by design to ``unstable'' environments. Prediction-error curiosity rewards total expected surprise, including irreducible noise. Bandit or mixture switching between surprise-minimizing and surprise-maximizing rewards reintroduces non-stationarity by construction. We propose a single intrinsic reward, stationary within each window, derived from the novelty contribution of a preference-free Expected Free Energy objective, expressed in reward-maximization form. Our claim is that parameter information gain, the expected surprise of the next state minus its irreducible part, is the appropriate intrinsic signal in both high-entropy and low-entropy components of the state space. Maximizing it seeks exactly the surprise the model can explain away. In regions of unresolved dynamics, this epistemic term drives exploration. As dynamics become resolved, the epistemic term vanishes, while an aleatoric penalty favors lower-variance transitions, all without fitting an explicit next-state predictor. A pseudocount supplies epistemic value, a probe-based penalty captures aleatoric variance, and a short-horizon gate protects informative successors. A window-based freeze of all reward-defining objects yields a stationary Bellman operator, explicit bounds on learning targets, and a conditional uniform-concentration result for the nonparametric estimators under mixing, smoothness, bandwidth, and capacity assumptions. In active-inference terms, the agent is preference-free where novelty is retained, standard likelihood ambiguity vanishes under full observability, a nonstandard transition-entropy penalty is added, and surprise minimization emerges in resolved regions of the state space.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。