
RELIC:通过揭示原则学习多智能体规划中可解释的可组合技能
RELIC: Revealed Principles for Learning Interpretable Composable Skills in Multi-Agent Planning
📝 TLDR
在隐私约束下的多智能体规划中,智能体需提升专项技能同时保护内部实现。RELIC框架让每个智能体通过私有LLM引导搜索优化程序化技能,受信编排器仅依据团队表现评估更新。成功行为被抽象为可迁移的原则,供其他智能体在自身接口中实例化与组合,实现跨智能体的技能迁移。该工作提出了隐私保护技能学习与协调的新范式。
🧭 速览
现有研究多假设集中优化或共享策略访问,难以应对智能体独立开发、接口异构且需保护实现隐私的协作场景。
各智能体通过私有LLM引导搜索优化程序化技能,受信编排器仅依据团队级表现评估,成功行为抽象为可跨智能体实例化的原则。
在异构技能签名下实现跨智能体的技能组合与迁移,将协调与实现共享解耦,支持隐私受限的多智能体协同。
提出隐私保护下技能学习与协调的新范式,使独立开发的异构智能体能够协同而无需共享可执行策略。
🆚 方法对比
RELIC
- 首次提出隐私约束下异构多智能体规划新设置
- 揭示原则实现跨智能体技能迁移
- 结合私有搜索与原则中介传输
- 多领域实验中团队性能与技能复用均提升
- 依赖可信协调器,存在单点信任风险
- LLM引导搜索计算开销较高
- 原则抽象质量受LLM归纳能力限制
- 仅靠团队级奖励,个体更新信号稀疏
Private per-agent LLM-guided skill search
- 私有代码搜索保护各智能体实现细节
- 基于MCTS直接在代码空间中探索
- 产出可解释的程序化决策技能
- 代码搜索空间大,LLM调用成本高
- 仅依赖团队奖励,更新信号较稀疏
- 每智能体独立搜索难以直接协调
Revealed principles abstraction and transfer
- 将成功行为抽象为可移植的原则
- 支持异构签名下跨智能体技能重用
- 分离协调与实现共享的设计
- 抽象过程可能丢失关键行为细节
- 原则归纳质量依赖LLM能力
- 重实例化需额外LLM调用开销
Centralized multi-agent planning baselines
- 全局统一优化,理论上界较高
- 便于理论分析与收敛性证明
- 需共享策略,违反隐私约束
- 不支持异构智能体接口
- 不适合独立开发的多智能体团队
Skill library retrieval baselines
- 复用已有技能库,部署成本较低
- 成熟检索机制支持快速调用
- 依赖预建技能库,无法在线学习
- 统一表示难以适配异构接口
- 不支持隐私约束下的协同改进
本文主要提出 RELIC 框架,结合私有程序搜索与揭示原则中介传输实现隐私保护下的多智能体协调;相比集中式多智能体规划和技能库检索等基线范式,RELIC 在异构接口与隐私约束下具有独特优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
RELIC 针对「接口异构 + 实现隐私」约束下的多智能体规划问题,提出了一种通过揭示原则(revealed principles)实现跨智能体技能迁移的框架。每个智能体在私有 LLM 引导的搜索中优化程序化技能,可信编排器仅依据团队性能评估更新;成功行为被抽象为可解释的文本原则,供其他智能体在其自身接口中重新实例化与组合。实验在 6 个基准的两套测试规模上均超越人类启发式、超启发式、协同进化、深度 RL 超启发式以及最新 LLM-based AHD 方法 MOTIF,为隐私受限的多智能体协作引入了一种协调与实现解耦的新范式。
研究背景与动机
多智能体规划在现实场景中往往面临一个根本性的张力:各智能体由不同团队独立开发,拥有不同的决策接口与能力表征,但系统整体又需要协调一致地完成复杂任务。已有的研究范式——无论是协同进化算法(CCEA)、超启发式方法(HHS/HAOS)还是基于深度强化学习的超启发式(RL-IS)——通常假设存在某种共享的技能表征空间:要么所有智能体访问同一策略库,要么有一个中心规划器掌握完整的实现细节。这种假设在许多真实场景中是不成立的。当智能体 A 的函数签名是 solve(positions, budget) 而智能体 B 的签名是 schedule(jobs, machines, skills) 时,直接共享可执行代码既不可能(接口不兼容)也不被允许(实现隐私)。
这一问题的重要性在于其现实普遍性。供应链系统中的不同模块、金融交易中的多个独立策略引擎、机器人协作中的异构控制系统,都天然存在接口异构与实现私有的约束。已有方法要么依赖共同的动作空间(难以泛化到异构接口),要么要求集中式优化(与隐私约束矛盾),要么使用黑箱神经网络的隐式表征(无法提取可迁移的原则)。RELIC 的切入点是:既然直接共享实现不可行,那能否共享一种介于「可执行代码」与「纯黑箱」之间的中间表示——既能传达成功行为的本质逻辑,又能适配不同智能体的具体接口?答案是揭示原则:一种短文本的自然语言抽象,可以被任何智能体在自己的上下文中重新实例化。
方法
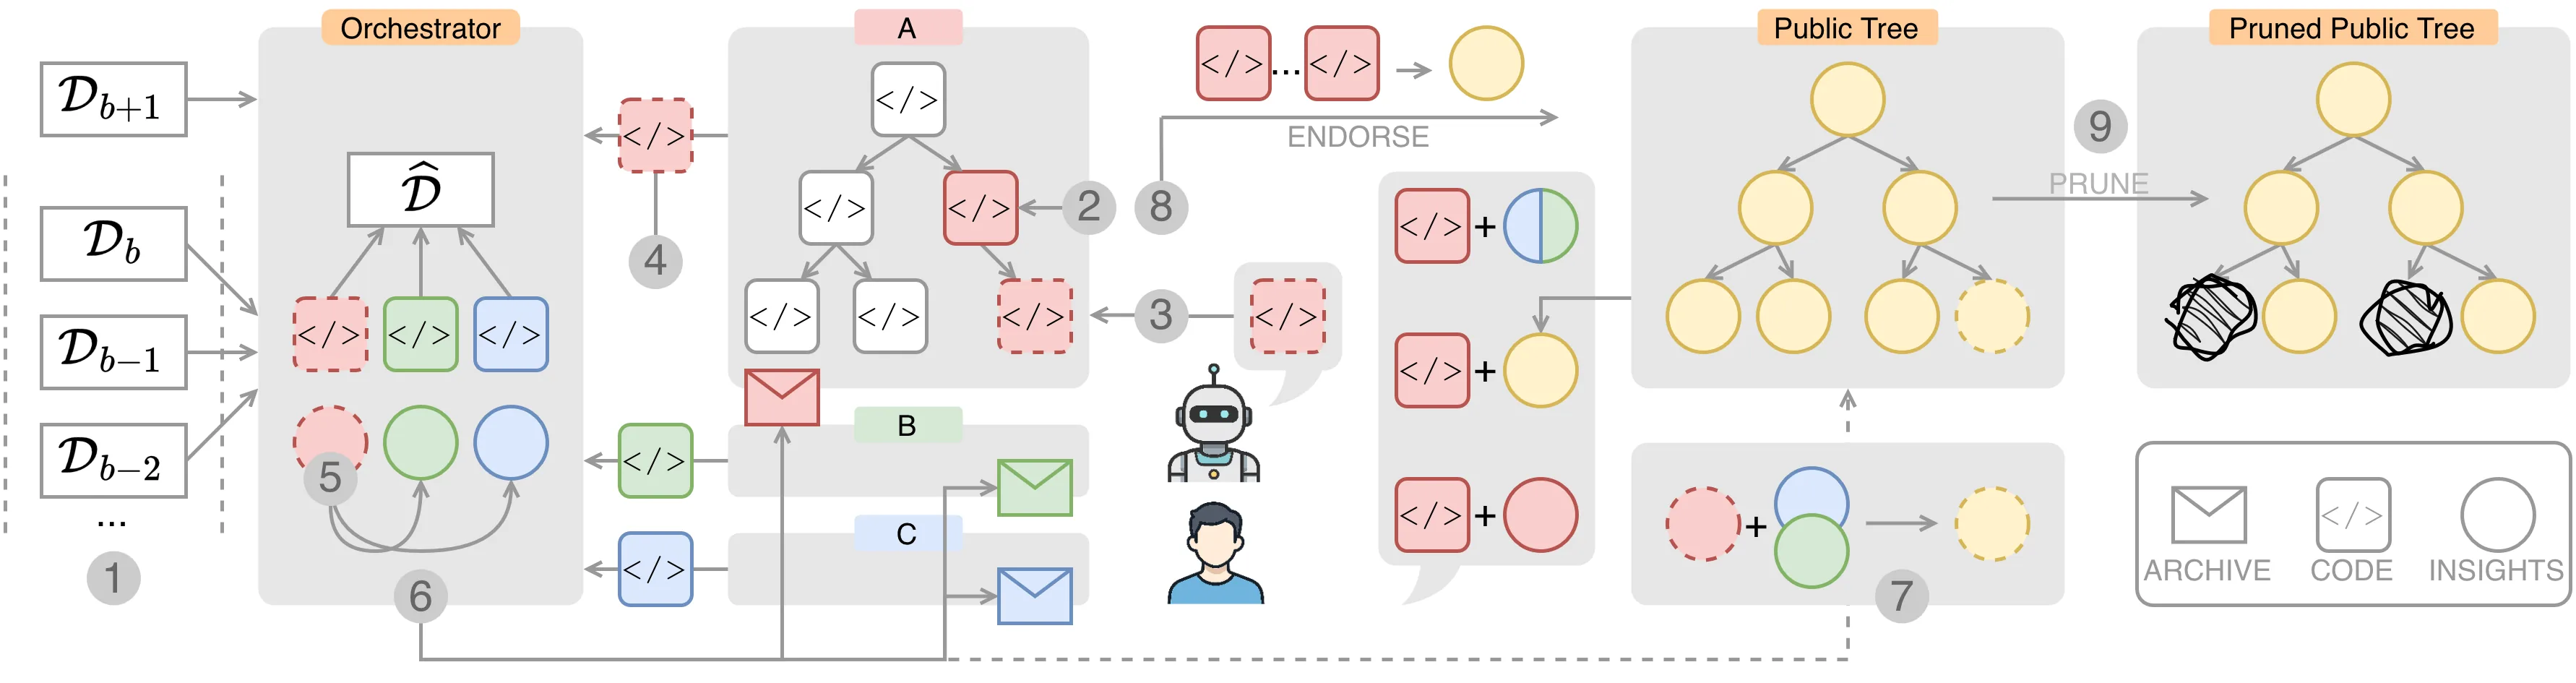
RELIC 的核心设计思想可以概括为一句话:将协调与实现解耦。协调发生在原则层面(What should be done),而非实现层面(How to do it)。这通过一套精心设计的私有搜索与原则传播机制来实现。
每个智能体 维护一棵私有搜索树 ,树上每个节点 代表一个候选的程序化技能 ——一段可执行的 Python 风格代码片段。搜索过程采用两层 UCT 选择机制驱动:上层选择最有潜力的节点,下层选择对当前节点进行何种编辑操作(生成、Lift、Bridge 或 Reflect,见下文)。一旦选定了操作,由该智能体私有的 LLM 在当前上下文 下生成修订后的程序 。该候选随后被提交给可信编排器——一个仅知道团队中所有智能体签名但不知道任何实现细节的外部评估者。编排器将 替换到团队中运行,通过 评估其带来的团队级性能增益 。正的增益意味着该修订是有价值的,会驱动 UCT 统计量的更新。
关键是三种编辑算子的设计,它们共同支撑了原则的抽象与迁移:
Lift(L) 作用于本智能体已往成功经验中积累的私有原则。当搜索树的一个节点表现平庸时,智能体可以尝试将一条已验证有效的原则 在自身签名 下重新实例化。这相当于问:「我过去在类似情况下是怎么做的,现在这个新场景能否复用同样的思路?」Lift 保证了历史成功经验不会被遗忘,而是被主动复用。
Bridge(B) 是跨智能体迁移的核心机制。每个智能体都有一个本地原则存档 ,其中包含了从其他智能体「揭示」过来的公共原则(通过公共树 索引)。当智能体 面临挑战时,其 Bridge 算子可以参考其他智能体贡献的原则 ,在 下重新实例化 对应的策略逻辑。这模拟了团队成员之间「分享经验教训」的协作模式——不说「你照着我的代码做」,而是说「我当时遇到类似情况的做法是……」。
Reflect(R) 则引入了编排器生成的元认知反馈。编排器不仅评估团队性能,还会计算「移除智能体 后的子集团队」与「完整团队」之间的性能差异,从而生成一段反思摘要 ,指出智能体 在当前批次中是「决定性的」还是「冗余的」。智能体据此反思自身策略,调整搜索方向。
这三类算子的组合使得原则的流动形成一个有机网络:Lift 盘活自身经验,Bridge 引入队友智慧,Reflect 依据全局反馈自适应调整。原则的抽象与传播遵循一个蒸馏-揭示-交叉蒸馏的循环:每当一个智能体在某个批次中获得了正增益,其最优技能 会被 LLM 蒸馏为一条原则 ,存入本地存档并广播至其他智能体的存档中。公共树 追踪每条原则被引用的次数和累计背书值 ,高背书的原则更容易在后续被 Bridge 引用。
实验与结果
论文在六类基准上系统评估了 RELIC 的有效性。这些基准分为两族:多智能体路径规划(包括 Prize Collection、Area Reconnaissance 和 Dynamic Servicing)和多智能体调度(包括 Job Dispatch、Skilled Tasks 和 Flow Shop)。每个基准设定三个智能体 A、B、C,信息量逐级递增——A 仅观测局部状态,B 额外感知队友状态,C 拥有全局系统级特征。这种设计覆盖了从纯局部决策到全局协调的典型异构谱。
训练阶段采用 5 批次 × 10 实例的流式协议,每批次每智能体进行 10 次私有搜索迭代。测试在两个更大的留出集( 和 )上各评估 20 个实例,重复 5 次独立运行以控制方差。
结果表明,RELIC 在所有 6 个基准上整体优于 7 个对比方法(从人类启发式到最新 LLM-based AHD 方法 MOTIF)。特别值得注意的是 Dynamic Servicing 场景:在 的测试规模下,RELIC 达到 85.48 的团队性能,显著优于 MOTIF(63.66)和 RL-IS(48.00),提升幅度分别约 34% 和 78%。这说明在请求随机到达、状态高度动态变化的场景中,通过原则迁移积累的协调经验具有更强的泛化能力。
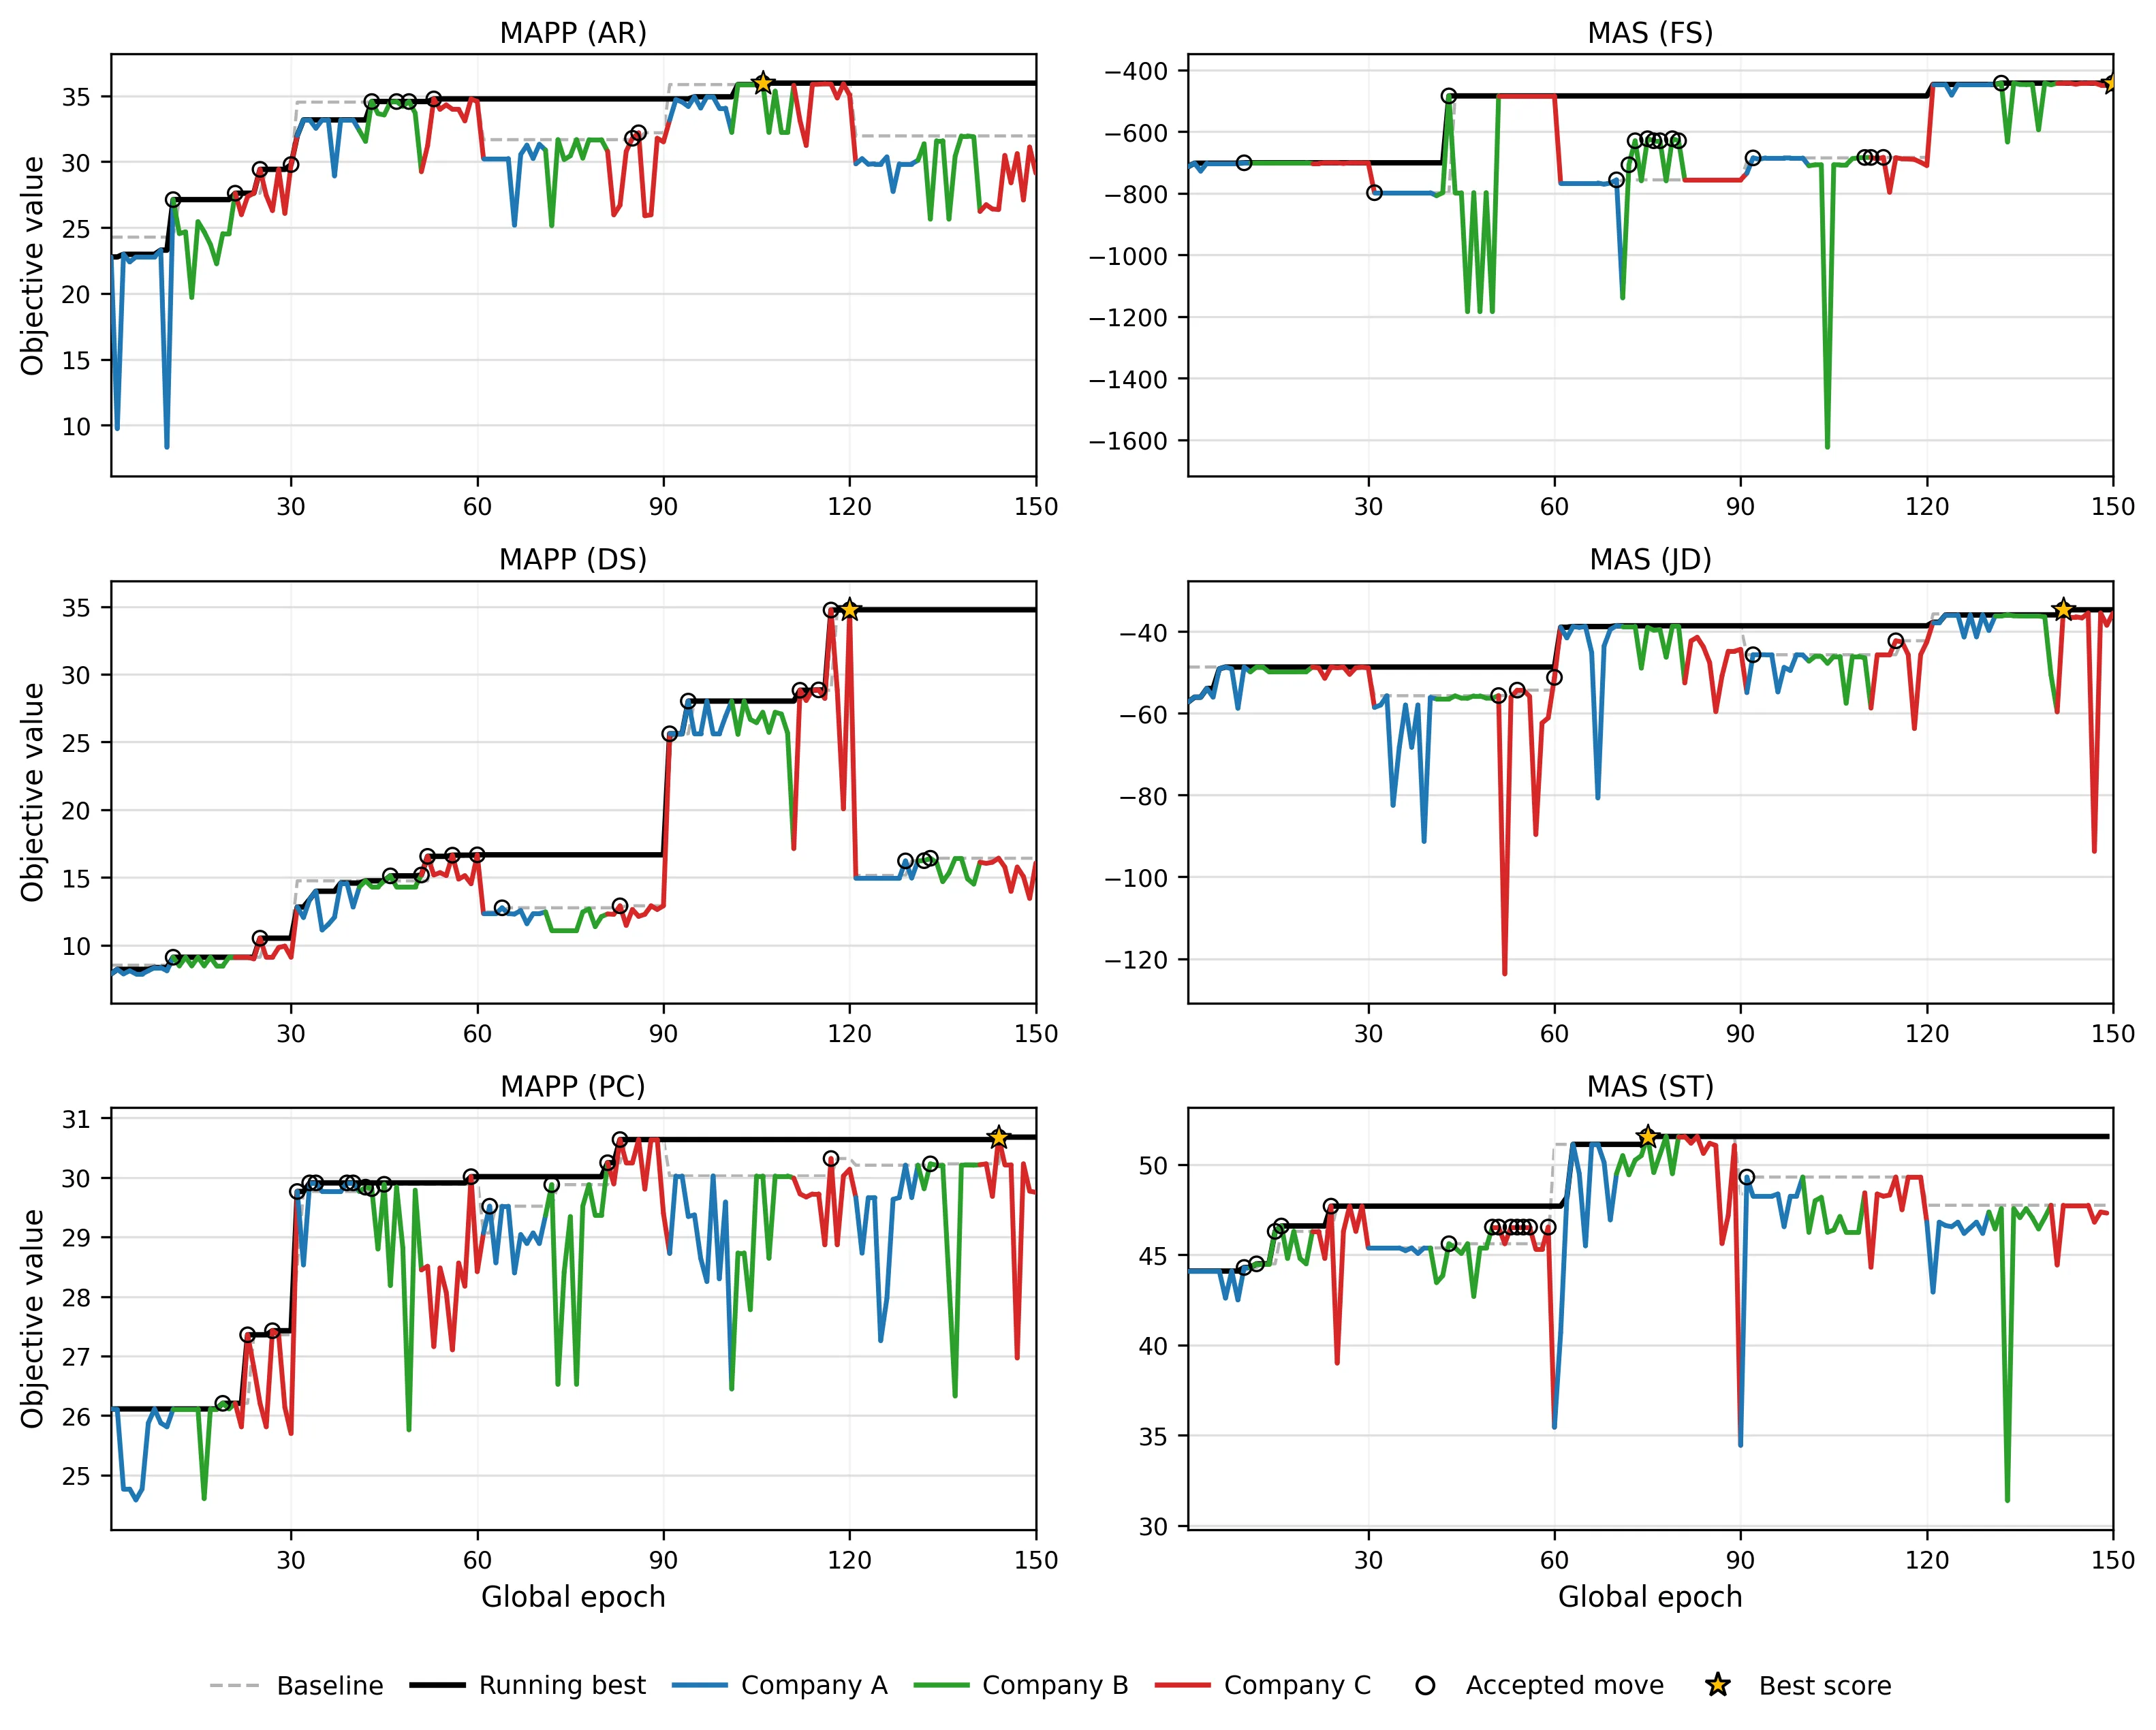
论文的收敛分析进一步揭示了跨智能体技能迁移的涌现动态。Figure 2 展示了训练过程中三个智能体的贡献轨迹:尽管 A、B、C 拥有不同的信息量和角色定位,它们的累积贡献趋于均衡。这一现象表明,原则迁移机制并非简单地让信息丰富的智能体「喂」给信息匮乏的智能体,而是促进了协调结构的自主涌现——每个智能体都在从自身视角贡献有价值的局部原则,整体团队则通过组合这些原则获得非线性增益。
讨论与可借鉴点
RELIC 最根本的方法论贡献在于提出了一种新的协作粒度:原则而非代码。这一设计选择使其天然适合接口异构、隐私敏感的真实系统,但也带来了一些值得关注的局限。
从可借鉴的角度看,有几个设计理念值得提炼。首先是「协调与实现解耦」的原则性思考:许多多智能体系统中,协作往往被隐式地嵌入到共享策略空间或中心化规划器中,而 RELIC 表明,只要设计好抽象层与实例化机制,协作完全可以发生在比实现更高一层的语义空间中。其次是三层算子(本地提升、跨智能体迁移、全局反思)的组合设计——它提供了一个可解释的、可干预的协作框架,不像端到端强化学习那样是黑箱直通。此外,流式批次训练配合混合批次采样()的策略对于非平稳任务流下的稳定收敛也有参考价值。
然而,论文在实验层面存在明显不足。最主要的缺陷是缺少消融实验:Lift、Bridge、Reflect 三个算子的独立贡献未被剥离,「私有搜索」与「原则迁移」两大组件的相对权重也未量化分析。这使得「原则迁移机制真正驱动了性能提升」这一核心论断缺乏直接的因果支撑。此外,论文未披露公共原则的数量分布、跨智能体实例化成功率、原则平均长度等中介变量的统计数据,难以验证原则作为知识载体的有效性。计算资源(GPU、时间、token 消耗)的不透明也限制了复现性评估。
更根本的局限在于场景覆盖范围。RELIC 目前仅验证于离散优化类基准(路径规划、调度),尚未涉及连续控制、多智能体博弈或真实强化学习环境。可信编排器的设计本质上是半集中式的监督——虽然不知道各智能体的实现细节,但仍然需要一个全局可信的评估者,这在完全去中心化的场景中可能不适用。
总体而言,RELIC 提出了一种概念上优雅且实践上有效的新范式。揭示原则作为「足够具体以指导行动、足够抽象以跨接口迁移」的知识载体,在隐私约束下的多智能体协作中展现了显著的潜力。其局限性更多指向一个有前景的研究方向——如何进一步量化原则迁移的因果贡献、如何扩展到更通用的决策场景、如何在去中心化信任模型下实现类似的协调结构——而非范式本身的缺陷。
摘要
当智能体必须在保持其内部实现私有性的同时提升专业化的决策技能时,多智能体规划会变得显著更加困难。这一场景出现于智能体独立开发、暴露不同的接口与能力,却仍需在不共享可执行策略的前提下进行协作的情况。已有研究大多假设集中式优化、共享策略访问或共同的技能表征,因而难以适用于隐私受限的协作。我们提出 RELIC,一个通过揭示原则学习可解释且可组合技能的框架。每个智能体通过由大语言模型引导的私有搜索来优化自身的程序化技能,而一个可信的协调器仅依据团队层面的性能来评估所提议的更新。成功的行为不会以代码形式广播,而是被抽象为可迁移的原则,供其他智能体在其自身的接口中实例化,并与本地策略进行重组。这将协作与实现共享解耦,从而在异构技能签名下实现跨智能体的迁移。RELIC 因此为多智能体规划中的隐私保护技能学习与协作引入了一种新范式。
Abstract
Multi-agent planning becomes substantially harder when agents must improve specialized decision-making skills while keeping their internal implementations private. This regime arises when agents are developed independently, expose different interfaces and capabilities, and must nevertheless coordinate without sharing executable policies. Prior research has largely assumed centralized optimization, shared policy access, or common skill representations, making it poorly suited to privacy-constrained cooperation. We introduce RELIC, a framework for learning interpretable and composable skills via revealed principles. Each agent refines its own programmatic skill through private LLM-guided search, while a trusted orchestrator evaluates proposed updates solely through team-level performance. Successful behaviors are not broadcast as code; instead, they are abstracted into portable principles that other agents can instantiate within their own interfaces and recombine with local strategies. This separates coordination from implementation sharing, enabling cross-agent transfer under heterogeneous skill signatures. RELIC thus introduces a new paradigm for privacy-preserving skill learning and coordination in multi-agent planning.
论文详细总结(自动生成)
RELIC 论文总结
1. 核心问题与研究动机
论文聚焦于隐私受限的多智能体规划场景:当多个智能体由不同团队独立开发、拥有异构的决策接口(不同的函数签名、输入维度、可用信息)时,它们必须在不共享可执行策略的前提下协同提升团队整体性能。
已有研究的局限:
- 多假设集中式优化(单一规划器、共享符号模型或全局技能库);
- 多假设共同技能表征,即所有智能体共享同一实现空间;
- 难以处理"独立开发 + 接口异构 + 仅以团队表现为监督信号"的真实协作约束。
因此,核心挑战并非单纯优化各智能体技能,而是发现可迁移的协调结构:成功的局部策略中哪些部分能被抽象、传达,并被另一个接口与角色不同的智能体重新实例化与复用。
2. 方法论
2.1 整体框架
RELIC(REvealed Learning of Interpretable Composable skills)的核心思想是将协调与实现解耦:
- 每个智能体 维护一棵私有搜索树 ,其节点是可解释的程序化技能候选 ;
- 可信编排器(orchestrator)仅以团队级性能评估候选更新;
- 成功行为被抽象为揭示原则(revealed principles)——短文本策略描述,供其他智能体在自己的函数签名 下实例化与组合。
2.2 形式化
设 个智能体,团队 ,任务流批次 ,批次目标为:
其中混合批次 用以缓解非平稳任务流下的短视更新。
2.3 私有程序搜索(LLM-guided MCTS)
每个节点同时记录访问次数 、节点值 与算子统计 。搜索采用两层 UCT 选择:
节点选择:
算子选择:
候选生成与评分:选定算子 后,由 LLM 在上下文 下生成修订程序 。其相对于当前团队的增益为:
2.4 三类编辑算子(关键设计)
- L(Lift):在已有揭示原则 与智能体自身签名 下重新实例化原则,;
- B(Bridge):引用其他智能体贡献的公共原则 ,,通过公共树检索:
- R(Reflect):依据编排器生成的反思摘要 ,通过比较"完整团队"与"移除智能体 的子集团队"在批次上的表现,识别 在何处是决定性的还是冗余的,。
2.5 揭示原则与公共树
- 本地存档 存储每个智能体的私有原则;
- 公共树 中每个节点 存储原则文本 、类型 、贡献者 、访问次数与累计背书值 。
原则的更新包括:
- Distill:从本批最优正增益节点 经 LLM 蒸馏 抽出 ;
- Reveal:将各智能体当前最优技能 抽象为 ,广播至其他智能体的本地存档;
- Cross-distill:从 与 抽取额外公共原则。
当通过原则 引发的 Bridge 修订获得正增益 时,更新 、;低背书的叶节点会被周期性剪枝。
2.6 流程
每个批次 经两阶段更新:
3. 实验设计
3.1 基准场景
六类基准,分为两族:
多智能体路径规划(Multi-Agent Path Planning):
- Prize Collection(团队定向问题 TOP,Chao et al., 1996):在预算 下最大化团队收集奖励;
- Area Reconnaissance(Singh et al., 2009):通过高斯空间相关性核 最小化剩余不确定性;
- Dynamic Servicing(Kirac et al., 2025):在随机到达请求下最大化期望总服务价值。
多智能体调度(Multi-Agent Scheduling):
- Job Dispatch(Kacem et al., 2012):平行机加权 tardiness 最小化;
- Skilled Tasks(Fırat & Hurkens, 2012):异构技能效率下最大化按时完成的任务总价值;
- Flow Shop(Kyparasis & Koulamas, 2001):三阶段流水车间最小化加权完工时间。
所有基准统一采用 三个智能体 ,信息量逐级递增:A 仅看局部状态;B 含队友状态;C 拥有更密集的系统级表示(如完整剩余价值向量、机器负载向量、流水线状态)。三个智能体的函数签名异构,正是 RELIC 要解决的核心设定。
3.2 训练与评估协议
- 训练:每基准 5 个批次,每批 10 个实例,任务规模 (按问题族递减);
- 测试:在 两个更大的留出测试集上各 20 个实例评估;
- 每基准做 5 次独立运行;
- LLM 后端:
gpt-4o-mini,采样温度 1.0; - 每个训练批次每智能体 10 次私有搜索迭代,总计 次私有程序扩展。
3.3 对比方法
| 方法 | 类别 | 训练范式 |
|---|---|---|
| GS | 人类启发式 | 网格搜索 |
| HHS (Cowling et al., 2001) | 超启发式 | 集中离线 |
| CCEA (Potter & Jong, 2000) | 协同进化 | 集中离线 |
| HAOS (Pei et al., 2024) | 在线/离线混合 | 离线 |
| RL-IS (基于 DRLH, Kallestad et al., 2023) | 深度 RL 超启发式 | 离线批处理 |
| MOTIF (Kiet et al., 2026) | LLM-based AHD | 最接近的 LLM 基线 |
| RELIC | 私有搜索 + 原则迁移 | 在线流式批次 |
4. 资源与算力
论文未明确披露 GPU 型号、数量或总训练时长。仅给出:
- LLM 后端为
gpt-4o-mini(闭源 API 服务,温度 1.0); - 每个 run 共 150 次私有 LLM 程序扩展步骤(5 batches × 3 agents × 10 iterations);
- 搜索树最大深度为 8,回放样本量为 2。
未提供关于 GPU 数量、训练墙钟时间、token 消耗或单次实验成本等具体信息,因此难以全面评估其计算开销。
5. 实验数量与充分性
- 主实验:1 张表 × 6 基准 × 2 测试规模 = 12 个数值点 × 7 个方法 × 5 次运行;
- 收敛图:1 张(Figure 2),展示 RELIC 训练过程中三个智能体的均衡贡献;
- 缺乏消融实验:未单独剥离 Lift / Bridge / Reflect 三个算子的贡献,也未对"私有搜索"与"原则迁移"做组件级消融;
- 缺乏原则树分析:未给出公共原则数量、背书分布、跨智能体实例化次数等细粒度统计;
- 缺乏跨域迁移测试:未评估在一个领域学习到的原则是否能迁移到另一领域;
- 未对比不同 LLM 后端或温度的影响;
- 未分析超参数敏感性(如 、、、回放大小、树深度)。
总体而言,主实验覆盖面较广(涵盖路径与调度两大族、离散与连续型奖励),但消融与敏感性分析明显不足,结论的因果性较弱。
6. 主要结论
1. 跨异构接口的有效性:RELIC 在所有 6 个基准、2 个测试规模上整体优于人类启发式、超启发式、协同进化、RL 超启发式以及最近的 LLM-based AHD 方法 MOTIF;
2. 动态服务场景提升最显著:在 Dynamic Servicing 的 上,RELIC 达到 85.48,显著优于 MOTIF(63.66)和 RL-IS(48.00);
3. 技能复用与团队收敛:Figure 2 显示三个公司虽然独立训练,但贡献接近均衡,说明原则迁移机制促进了协调结构的涌现;
4. 隐私保护可行性:在不共享可执行代码的前提下,揭示原则为跨智能体迁移提供了替代通道。
7. 优点
- 新范式:明确将"协调"与"实现"分离,提出的"揭示原则"机制填补了隐私受限多智能体协作中可迁移协调结构的研究空白;
- 可解释性强:智能体的技能以可执行程序呈现,原则以短文本抽象,便于人审与组合;
- 接口异构友好:通过 Lift/Bridge/Reflect 三个算子在不统一签名空间的前提下实现迁移;
- 流式训练合理:使用混合批次 缓解非平稳任务流下的过拟合;
- 统一基准体系:6 个基准、3 角色设定形成较完整的对比基座;
- 智能体角色设计精细:A→B→C 信息层级递增,覆盖了从纯局部到全局系统的典型异构谱。
8. 不足与局限
- 消融与因果性不足:缺少对 Lift / Bridge / Reflect 三类算子的独立消融,难以判断每个组件的真实贡献;
- 基准规模较小:训练仅 5 批次 × 10 实例;测试仅 ,未能体现大规模问题上的可扩展性;
- 运行次数偏少:仅 5 次独立运行,缺少置信区间或显著性检验;
- 无原则质量分析:未报告学到的原则数量、长度、复用率、跨智能体实例化成功率等关键指标,难以验证"原则"中介机制是否真正驱动了性能提升;
- 资源与成本不透明:未披露计算资源、token 消耗、训练时间,限制复现性评估;
- LLM 后端单一:仅使用
gpt-4o-mini,未验证方法在不同能力 LLM 上的鲁棒性; - 应用限制:聚焦于三类离散路径规划与三类调度,未涉及连续控制、博弈或多智能体强化学习场景;可信编排器假设仍属于"半集中"监督,未讨论去中心化信任问题;
- 对手方法限制:MOTIF 作为最接近的 LLM 基线,被匹配搜索预算与种子,但未进行更细粒度的提示工程对比,存在公平性争议空间。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。