
DS@GT ARC 在 eRisk 2026 上的研究:结合结构化算法指导的混合多智能体大语言模型系统用于对话式抑郁症筛查
DS@GT ARC at eRisk 2026: Hybrid Multi-Agent LLM System with Structured Algorithmic Guidance for Conversational Depression Screening
📝 TLDR
针对eRisk 2026对话式抑郁筛查任务,需在不直接询问敏感问题的情况下通过访谈LLM角色生成BDI-II评分及四项关键症状。系统经历三阶段迭代,最终采用基于Gemma 27B开源模型的混合多智能体架构,配合对话树、可靠性加权共识与聚类插补三类算法监督。Run 3以ADODL 0.9063位列完整提交第三、21支参赛队第二,性能优于付费基线且成本仅为其四分之一。该工作验证了充分的算法监督可使较弱开源模型在对话访谈任务中媲美闭源强模型。
🧭 速览
探索能否以开源模型替代付费闭源模型,在对话式抑郁筛查访谈任务中实现竞争力同时控制成本。
采用多智能体架构分离访谈与评分,以Gemma 27B替代GPT-5-nano,并引入预计算对话树、可靠性加权共识聚合与聚类插补三类算法组件。
混合Run 3取得ADODL 0.9063,在完整提交中排名第三、21支队伍中第二,性能优于付费基线Run 1的0.8841,成本约为后者四分之一。
验证了核心假设:充分的算法监督可使较弱开源模型在对话访谈角色中与较强闭源模型竞争。
🆚 方法对比
Monolithic Single-Model Prototype
- 端到端实现简单,仅需单一提示词
- 便于快速验证基本功能
- API成本最低,无需协调开销
- 存在分数漂移现象,跨运行不稳定
- 症状覆盖不一致,重复性差
- 单模型同时承担面试与评分,职责过载
Baseline Multi-Agent Architecture
- 面试与评分职责分离,提高可靠性
- 协调编排层改善症状覆盖
- 以约两倍API成本换取更稳定表现
- API开销约为单模型的两倍
- 多代理编排增加系统复杂度
- 依赖付费模型,成本仍较高
Hybrid Multi-Agent Configuration
- Run 3 ADODL达0.9063,总排名第3
- 使用开源Gemma 27B,成本约降为1/4
- 超越付费基线Run 1的0.8841
- 验证弱开源模型可媲美强付费模型
- 需额外算法补偿模型推理能力不足
- 流水线组件多,工程复杂度较高
- 开源模型指令遵循较弱
Precomputed Dialogue Tree
- 标准化面试开场与追问流程
- 补偿开源模型指令遵循能力弱
- 降低面试轮次中的方差
- 灵活性下降,难以适应多样化回应
- 依赖预定义结构,适应性有限
- 维护对话树需领域知识
Reliability-Weighted Consensus Aggregation
- 借鉴Weaver框架,增强鲁棒性
- 通过可靠性加权降低单次偏差
- 有效应对开源模型高方差问题
- 权重计算增加额外复杂度
- 并非专为抑郁筛查场景设计
- 聚合过程增加计算开销
Cluster-Based Imputation
- 填补未探查症状的数据空白
- 利用症状间相关性提升覆盖
- 缓解轮次限制带来的信息缺失
- 插值结果引入不确定性
- 依赖聚类质量,聚类偏差会传递
- 可能掩盖真实未探查的症状
Weaver Framework
- 提供可靠性加权聚合的理论基础
- 成熟框架,可迁移至LLM场景
- 支持多源信息融合决策
- 原始设计非面向对话式筛查
- 需适配后才能用于抑郁评估
- 在医疗领域应用经验有限
系统经三阶段迭代:单模型原型(简单但不稳定)→ 多代理基线(可靠但昂贵)→ 混合配置(以开源Gemma 27B配合对话树、可靠性加权聚合与聚类插值三个算法组件,以约1/4成本达到ADODL 0.9063,超越付费基线0.8841),证明了算法监督下弱开源模型可与强付费模型竞争。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
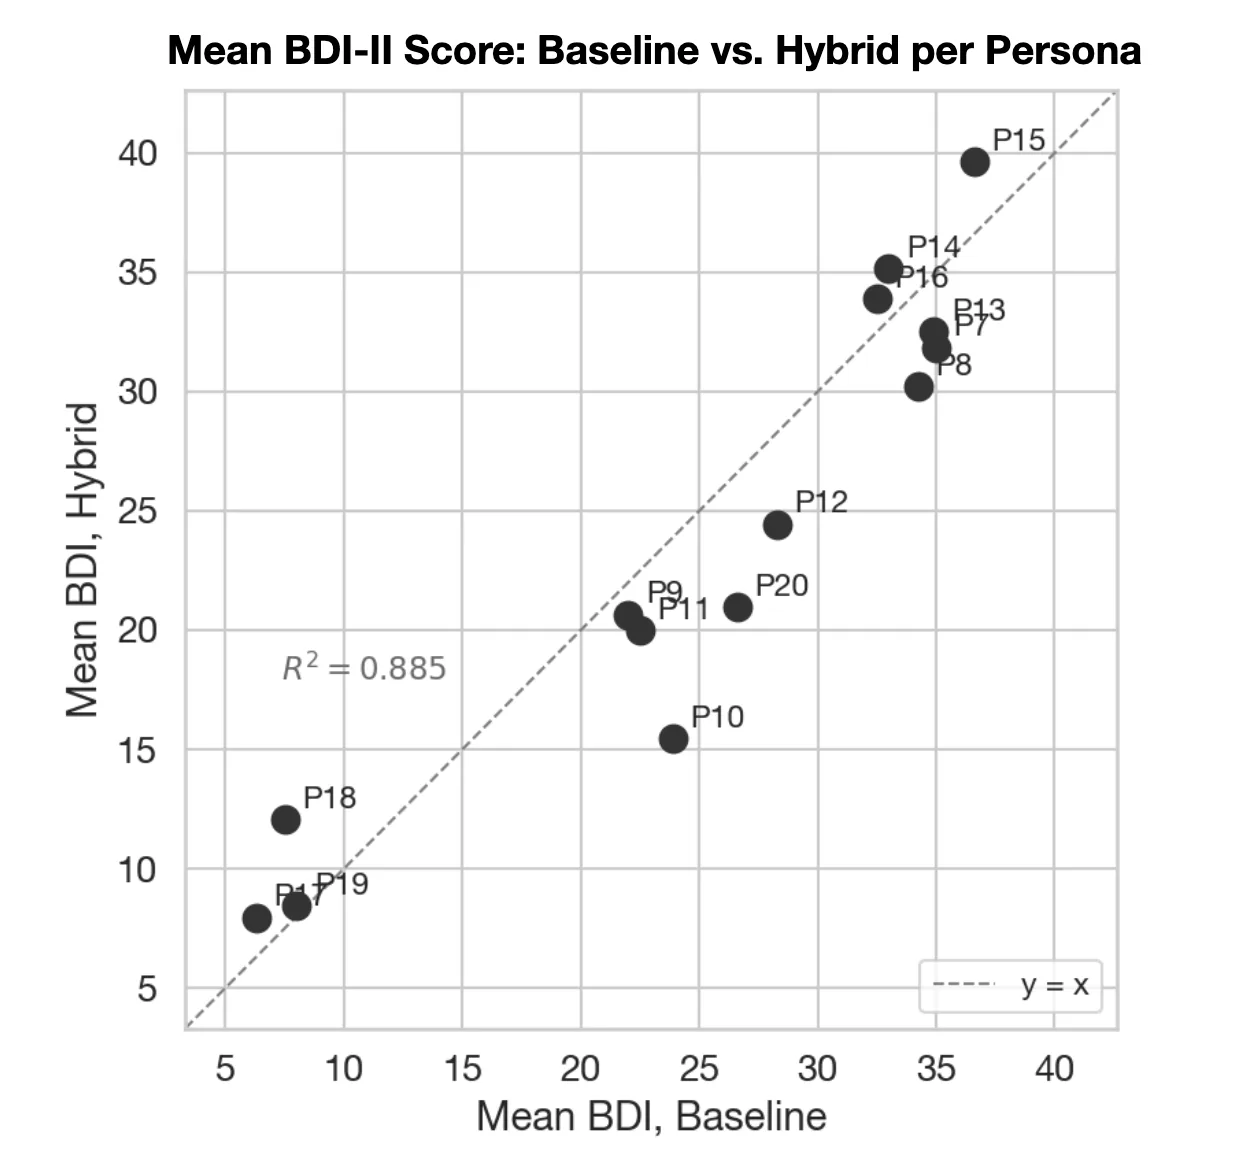
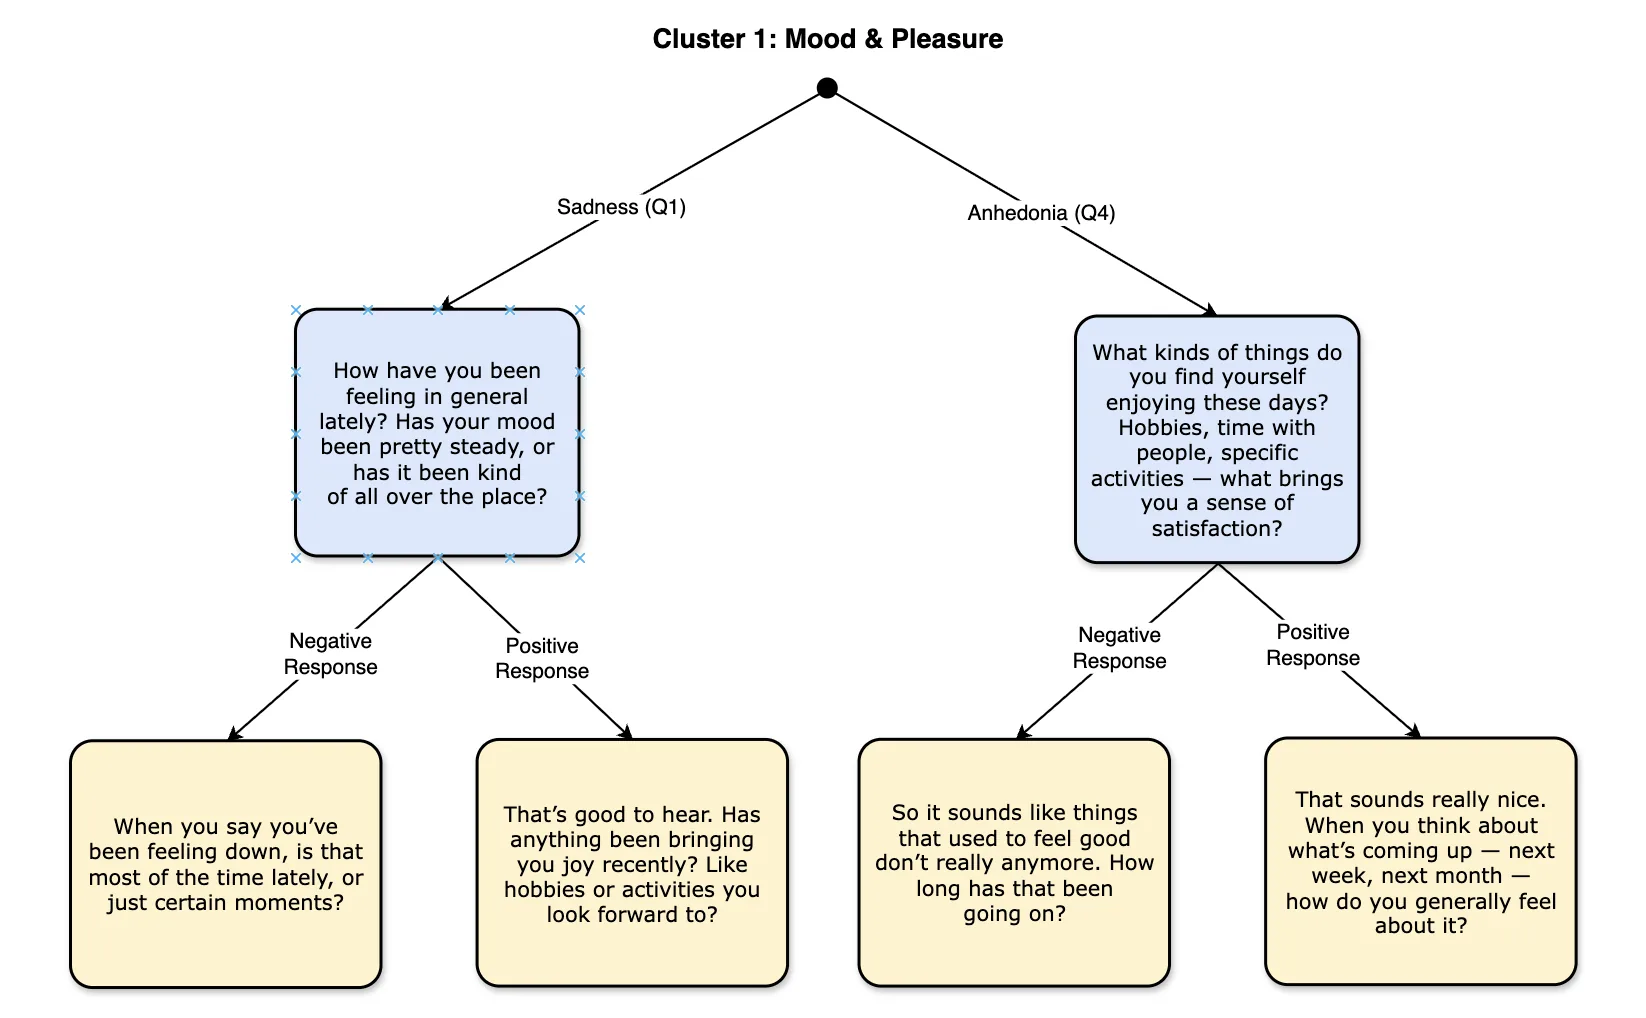
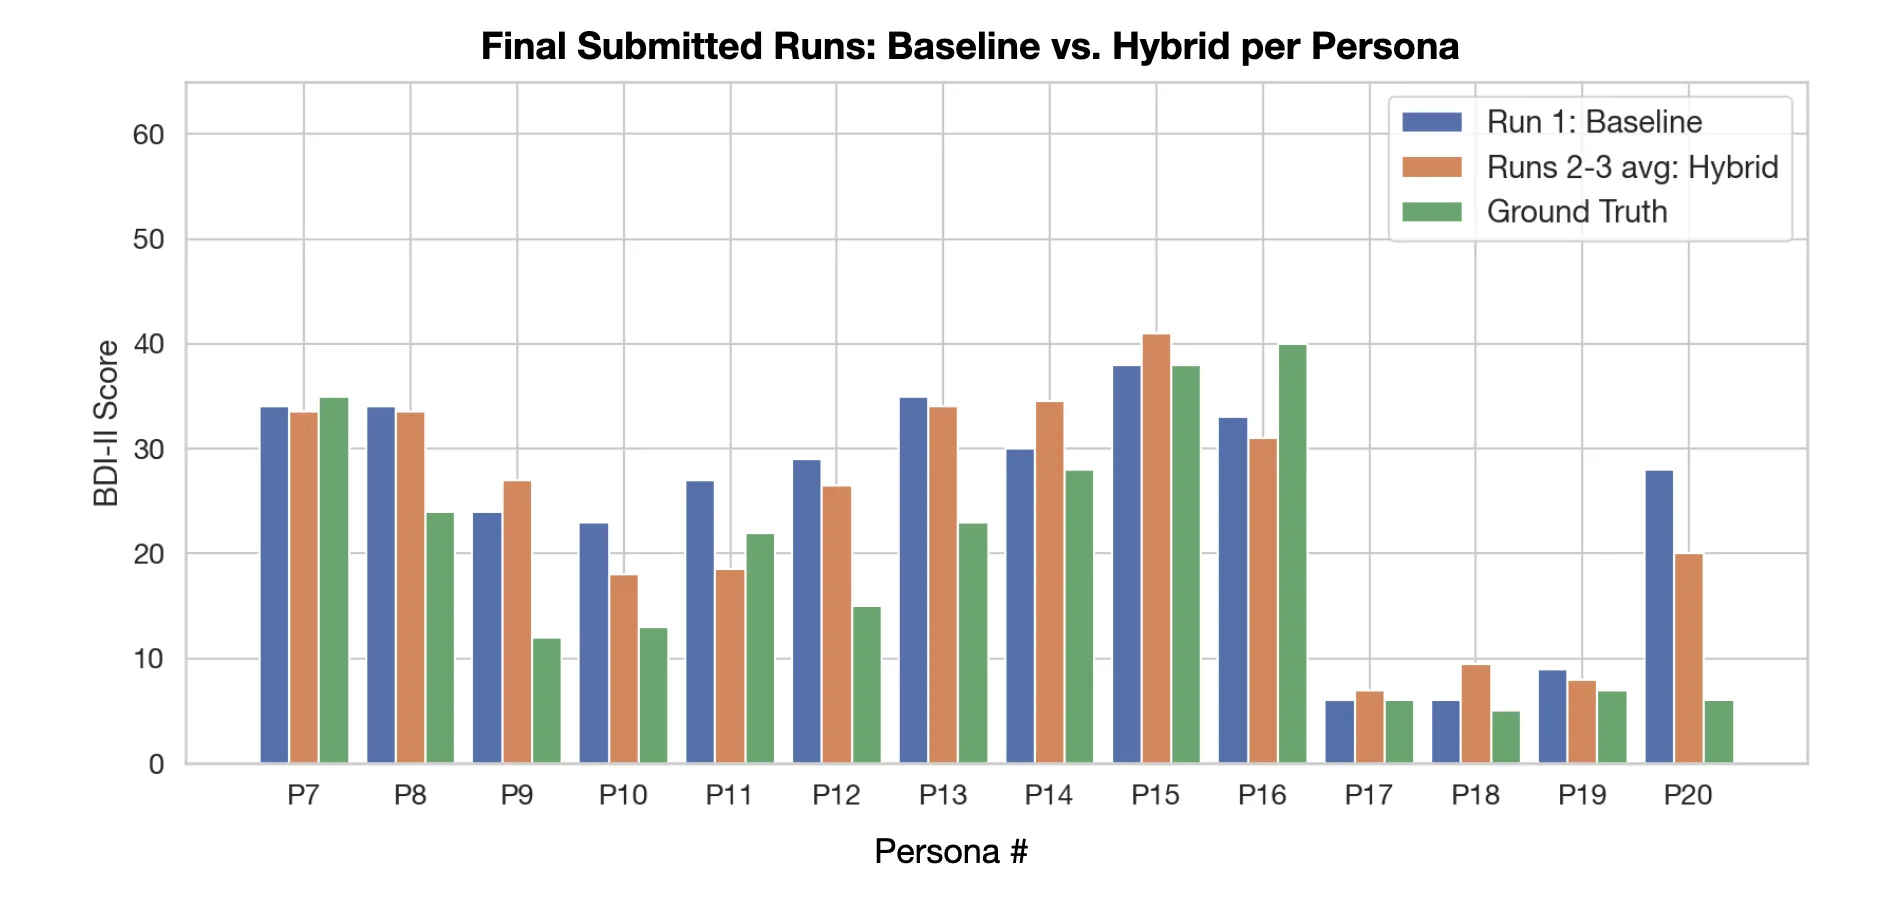
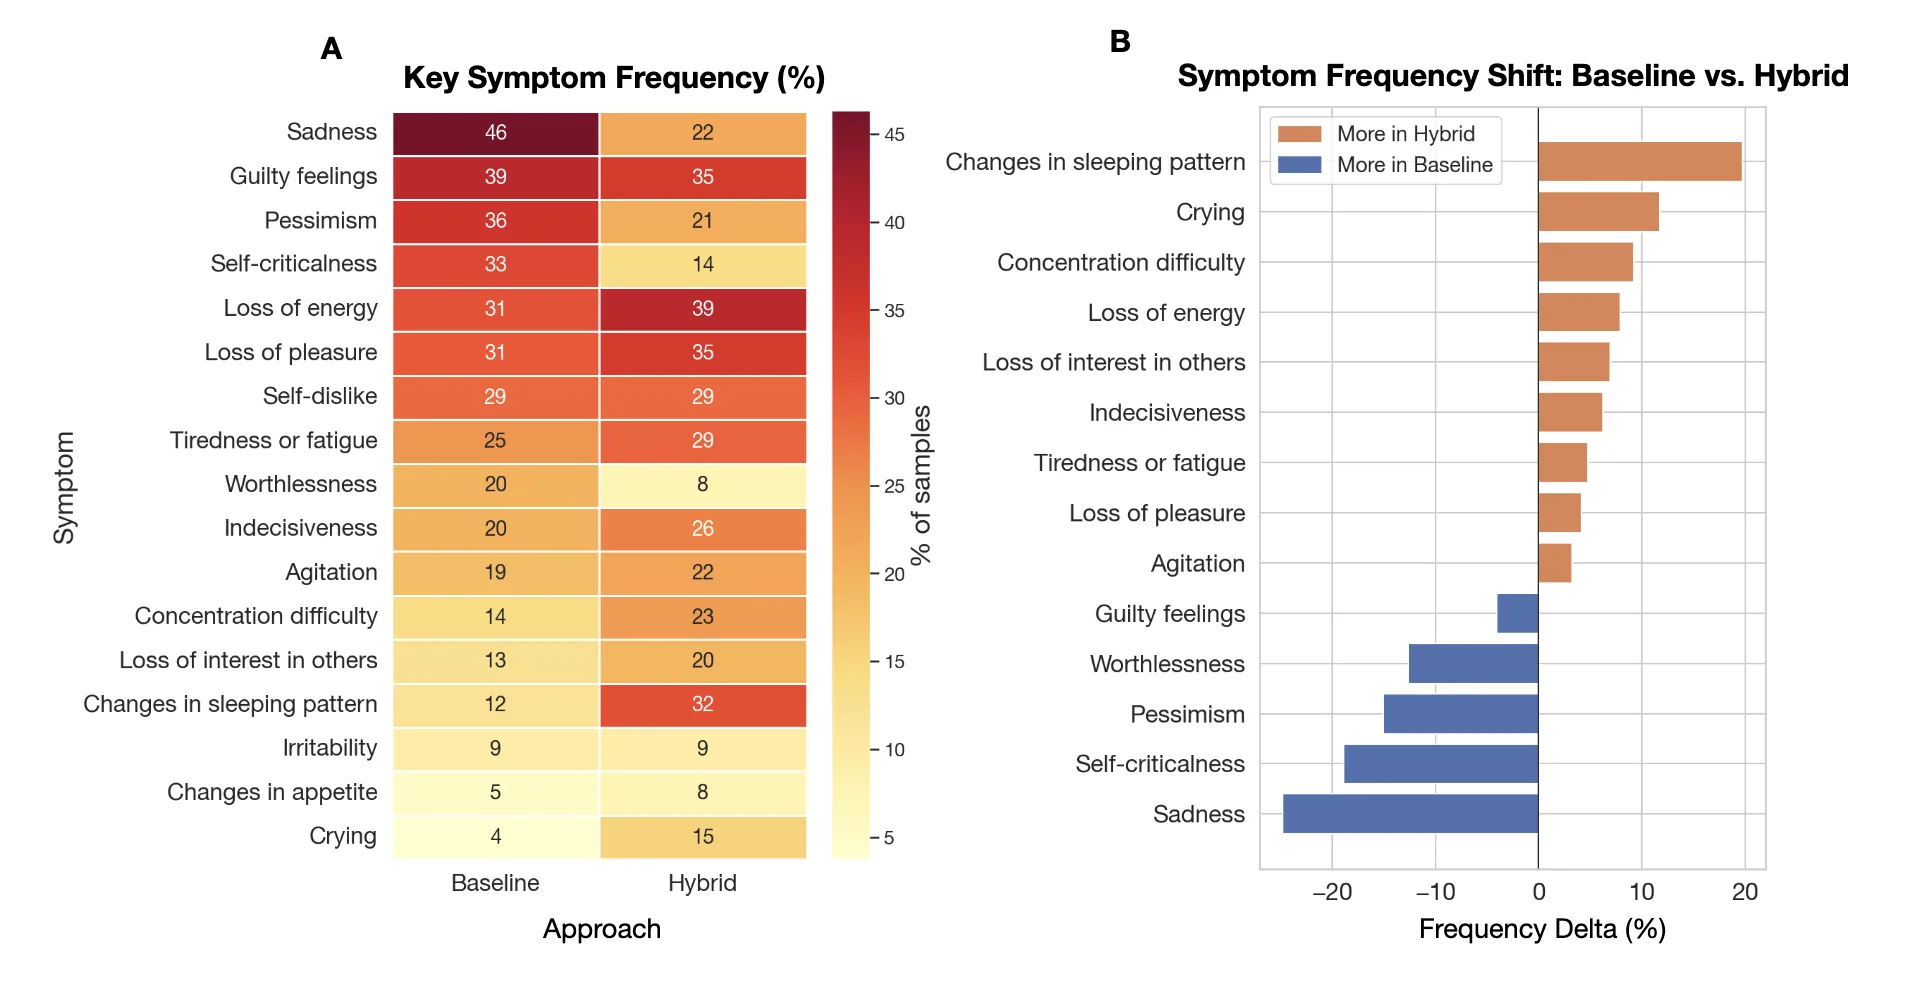
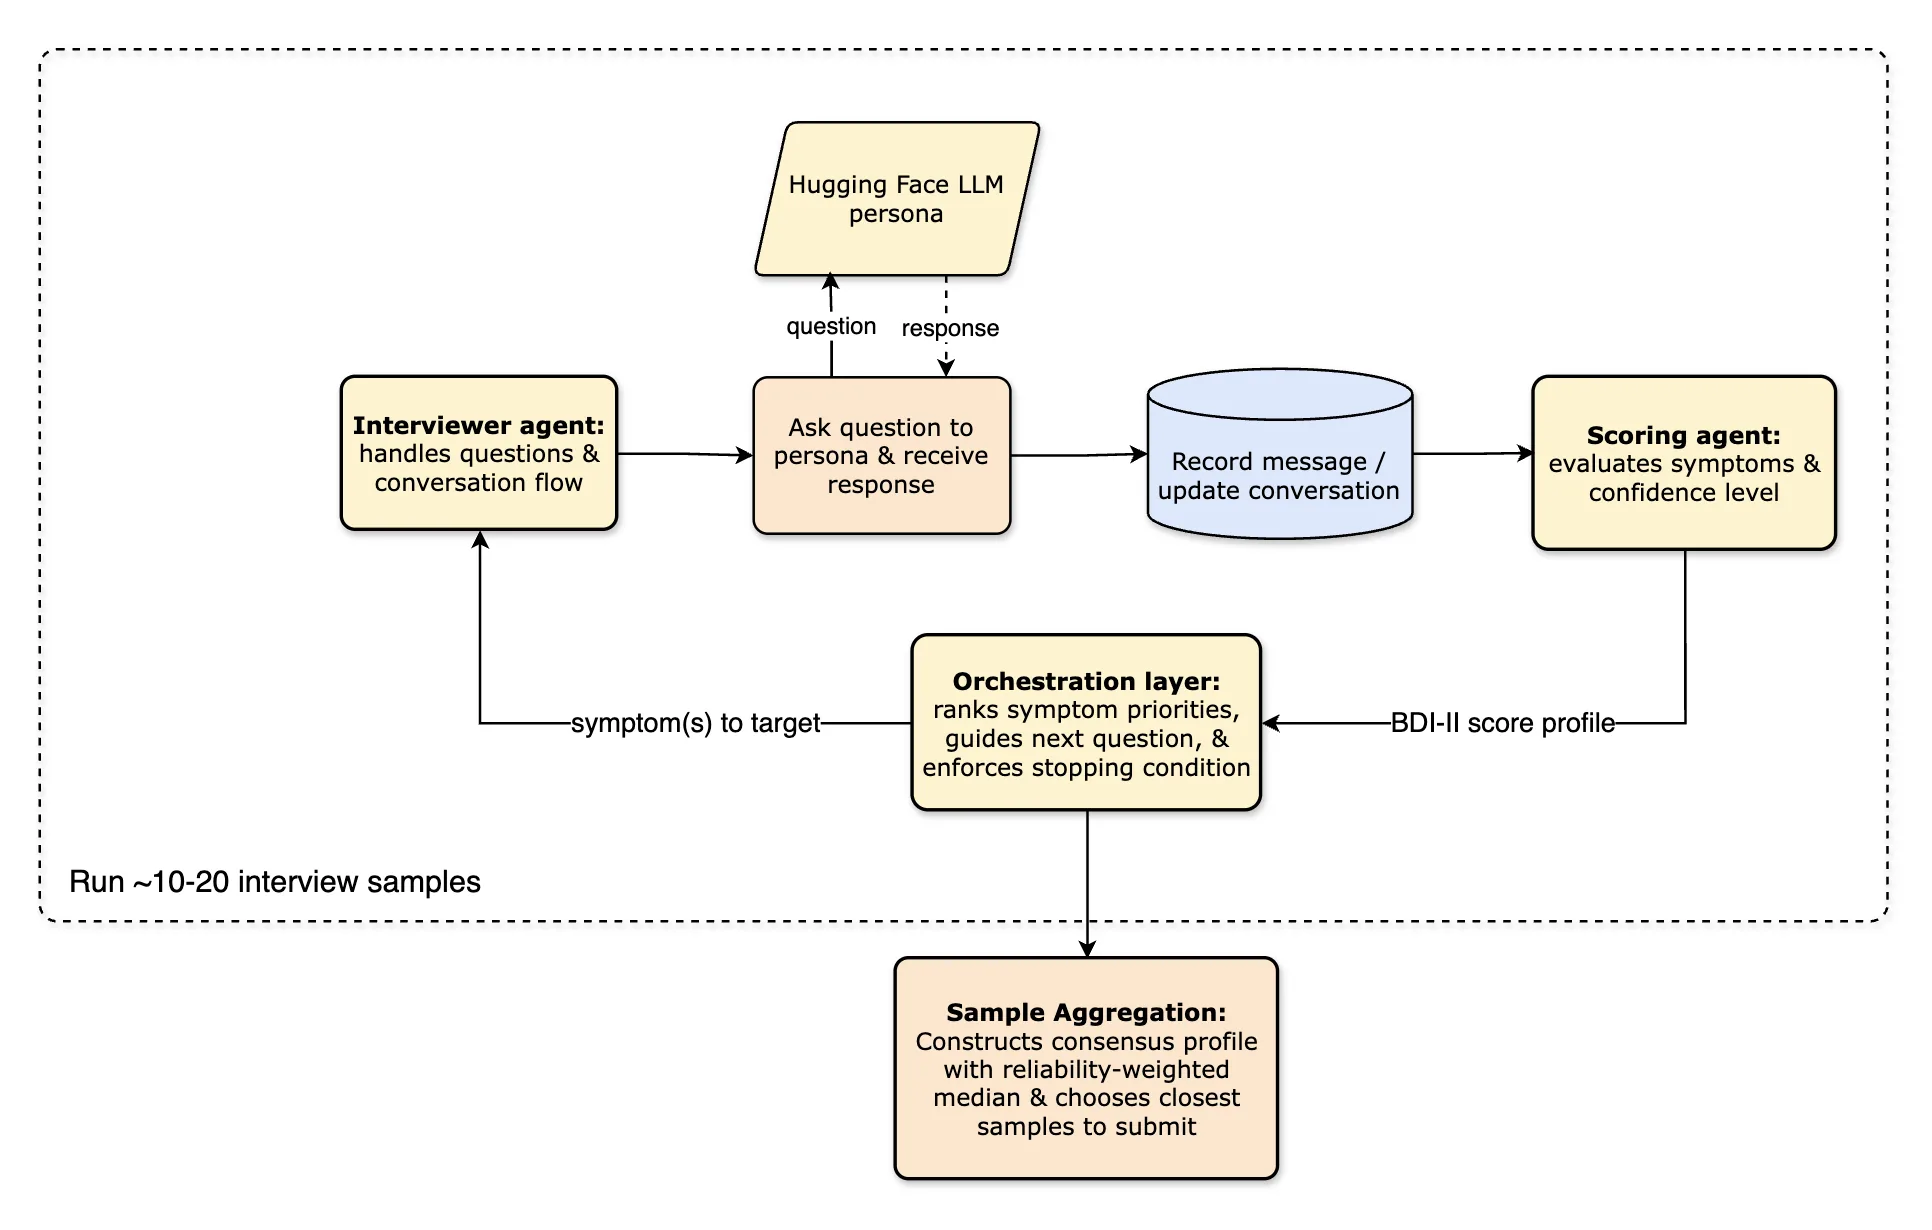
TL;DR
DS@GT 团队参加了 eRisk 2026 对话式抑郁症筛查挑战赛,构建了一套混合多智能体系统,通过与大语言模型角色进行访谈来生成抑郁量表评分。他们先用付费的 GPT-5-nano 搭建基线,随后将访谈者替换为开源的 Gemma 27B,并通过对话树、可靠性加权共识和聚类插补三种算法组件弥补模型能力的不足。最终混合方案以仅四分之一的 API 成本,在 21 支参赛队伍中位列第二,验证了充分算法监督下弱开源模型可媲美强闭源模型的假设。
研究背景与动机
在数字心理健康领域,如何在保护用户隐私和尊严的前提下完成有效的抑郁筛查,是一个持续存在的挑战。eRisk 2026 Task 1 设置了一个独特的评测场景:系统需要与扮演不同抑郁状况的大语言模型角色(persona)进行对话访谈,在不直接询问敏感问题(如“你是否有过自杀念头”)的前提下,生成贝克抑郁量表第二版(BDI-II)评分以及四项关键症状指标。ADODL 作为核心评测指标,衡量系统预测结果与真实标签之间的匹配程度。
这一任务的难点在于平衡。直接询问敏感问题虽然能快速获取信息,但违背了真实筛查场景中的伦理原则;而间接访谈则要求系统具备更强的语言理解和推理能力,能够从用户的日常表达中推断其心理状态。此外,参赛系统还需要处理角色扮演失败的情况——当被访谈的 LLM 角色未能如预期那样回应时,系统应当具备容错能力。
DS@GT 团队最初尝试了单体式单模型方案,直接让一个大语言模型完成从对话到评分的全部工作。这种方案简洁但脆弱:模型既需要扮演好一个耐心、有技巧的访谈者,又需要准确地将访谈信息转化为量表评分,两项任务之间存在天然的冲突。更重要的是,模型可能在访谈过程中直接询问敏感问题,导致评分不合法。
方法
为了解决上述问题,团队将系统拆解为多个协作的组件,发展出三阶段迭代的架构演进路径。
第一阶段是基线多智能体架构。该设计将访谈和评分两个核心功能分离:专门的访谈智能体负责与角色进行自然对话,引导话题但不直接触碰敏感区域;评分智能体则接收对话记录,独立生成 BDI-II 评分和症状判断。一个协调编排层负责管理两个智能体之间的信息流转,确保访谈内容与评分逻辑的一致性。这种 [[多智能体架构]] 的分离设计使得各组件可以独立优化,也为后续引入更强算法监督奠定了基础。
第二阶段是混合配置方案。团队发现付费模型虽然能力强,但成本高昂,每角色 API 调用费用较高。他们将访谈智能体替换为开源的 Gemma 27B,将评分智能体替换为 Claude-sonnet-4-20250514。这种替换带来显著的成本优势,但也暴露了开源模型在推理深度和指令遵循方面的短板——Gemma 27B 更容易在复杂对话中出现偏离主题、过早结束访谈或在追问时缺乏技巧等问题。
为了弥补这一差距,混合方案引入了三个精心设计的算法组件。
第一个组件是预计算对话树。团队预先构建了一个标准化的访谈结构,包括开场白模板库、针对各类症状的追问策略树,以及在特定对话节点触发的条件分支。访谈智能体不再被要求自主决定访谈走向,而是从对话树中选取合适的节点内容与角色交流。这种结构化引导确保了访谈的基本质量下限,即使模型本身的能力有限。
第二个组件是可靠性加权共识聚合。该设计受到 Weaver 框架的启发,核心思想是在多次独立采样中,不同版本的回答具有不同的可信度。团队让系统生成多个候选评分和症状判断,然后根据每个候选结果的历史可靠性(通过对比验证集表现获得)对它们进行加权平均。这种 [[加权聚合]] 机制能够有效抑制模型偶尔产生的幻觉或异常输出,将多次采样的多样性转化为更稳健的最终预测。
第三个组件是针对未探测症状的聚类插补。由于对话长度和话题走向的限制,部分角色的某些症状可能在访谈中未被充分覆盖。对于这些“缺失”的症状,系统使用 [[聚类分析]] 方法进行推断:基于已有的对话特征和已探测症状,将当前角色归入最相似的已知案例群组,然后借用该群组在相应症状上的统计特征进行填充。这种基于相似性的 [[插补]] 策略在信息不完整时提供了合理的默认值。
实验与结果
团队针对全部 20 个角色提交了三个完全自动化的运行结果。Run 1 来自付费基线方案(GPT-5-nano 访谈者),ADODL 得分为 0.8841。Run 2 和 Run 3 均来自混合方案,只是在参数配置上有所差异。
最终,Run 3 以 ADODL 0.9063 的成绩位列所有完整提交运行中的第三名,使得 DS@GT 在 21 支参赛队伍中总体排名第二。这一结果不仅超越了团队自身的付费基线(提升约 2.2 个百分点),而且是在 API 成本仅为其四分之一的前提下实现的。
从消融分析来看,三个算法组件的贡献各有侧重。对话树的使用显著提升了访谈的规范性和完整性,有效减少了开源模型常见的访谈中途放弃或主题漂移问题。可靠性加权共识在平滑单次输出的随机性方面效果明显,特别是在 BDI-II 数值评分这一连续指标上。聚类插补则在处理访谈时间受限导致的信息缺失时发挥了关键作用,使得系统在信息不完整的条件下仍能给出合理的症状预测。
值得注意的是,Run 2 的表现略逊于 Run 3,这表明混合方案对配置参数敏感。团队在报告中指出,对话树的节点选择策略、共识采样的次数以及聚类插补的阈值设置都存在调优空间。
讨论与可借鉴点
这项工作最核心的启示在于验证了一个重要的研究假设:[[开源模型]] 与 [[闭源模型]] 之间的能力差距,可以部分地通过算法层面的监督和引导来弥合。当模型本身无法可靠地完成某项复杂任务时,将其嵌入一个结构化的流程框架、引入外部知识约束、以及设计冗余的校验机制,往往比单纯追求更强的基础模型更为经济有效。
从工程角度看,DS@GT 的做法提供了一套可复用的多智能体系统设计范式:将能力边界清晰的功能分离到独立智能体中、通过预计算的结构化知识补充模型的弱推理区、以及利用多次采样的聚合提升输出的稳健性。这套范式不局限于抑郁筛查场景,对于其他需要深度交互和高可靠性输出的对话系统同样具有参考价值。
然而,这项工作也存在若干局限。首先,20 个测试角色的规模相对有限,在更大规模的真实用户群体上的泛化能力有待验证。其次,对话树和聚类插补的有效性高度依赖于训练数据的分布假设,如果真实用户的行为模式与角色扮演存在系统性差异,这些组件可能失效。此外,团队在报告中坦诚,尽管刻意避免直接询问敏感问题,但在某些对话路径下,访谈智能体仍可能间接地触及这类话题,这涉及如何在筛查效果与伦理边界之间取得平衡的更深层问题。
对于未来研究方向,一个值得探索的方向是自适应对话树——当前的预计算结构是固定的,而更理想的系统应当能够根据访谈进展动态地扩展或收缩对话节点,从而在保证覆盖度的同时提高效率。另一个方向是引入用户建模,根据被访谈者的语言风格和情绪状态实时调整访谈策略,这可能需要结合在线学习或强化学习的方法。
摘要
我们介绍了 DS@GT 提交至 eRisk 2026 Task 1 对话式抑郁症筛查挑战赛的系统。该任务要求系统访谈模拟不同抑郁症状况的大语言模型角色(persona),并在不直接询问敏感心理健康问题的前提下,为每个角色生成贝克抑郁量表第二版(BDI-II)评分以及四个关键症状。我们的流程经历了三个阶段的发展:首先是一个单体式单模型原型,随后是一个基线多智能体架构,该架构将对话式访谈与 BDI-II 评分分离,并由一个协调编排层进行管理;最终是一个混合配置版本,将付费的 GPT-5-nano 访谈者替换为开源的 Gemma 27B。为了弥补该模型在推理和指令遵循方面的较弱能力,混合方案引入了三个算法组件:一个预先计算的对话树,用于标准化访谈开场和后续追问;一种受 Weaver 框架启发的可靠性加权共识聚合方法;以及一个针对未探测症状的基于聚类的插补步骤。我们针对全部 20 个角色提交了三个完全自动化的运行结果,其中 Run 1 来自付费基线,Run 2 和 Run 3 来自混合方案。混合方案的 Run 3 取得了 0.9063 的 ADODL 分数,在所有完整提交运行中排名第三,使 DS@GT 在 21 支参赛队伍中总体位列第二;同时以大约四分之一的单角色 API 成本超越了我们的付费基线 Run 1(0.8841)。这些结果支持我们的核心假设:在充分的算法监督下,较弱的开源模型能够在对话访谈者角色中与更强的专有模型相竞争。我们的源代码可在 https://github.com/dsgt-arc/erisk-task1-2026 获取。
Abstract
We describe DS@GT's submission to the eRisk 2026 Task 1 challenge on conversational depression screening, in which systems interview LLM personas that simulate individuals with varying depression profiles and produce a Beck Depression Inventory II (BDI-II) score plus four key symptoms per persona, without directly asking sensitive mental health questions. Our pipeline evolved through three stages: a monolithic single-model prototype to start off, a baseline multi-agent architecture that separates conversational interviewing from BDI-II scoring under a coordinating orchestration layer, and a final hybrid configuration that replaces the paid GPT-5-nano interviewer with the open-source Gemma 27B. To offset the model's weaker reasoning and instruction-following, the hybrid adds three algorithmic components: a precomputed dialogue tree that standardizes interview openers and follow-ups, a reliability-weighted consensus aggregation inspired by the Weaver framework, and a cluster-based imputation step for unprobed symptoms. We submitted three fully automated runs across all 20 personas, with Run 1 from the paid baseline and Runs 2 and 3 from the hybrid. Hybrid Run 3 achieved an ADODL of 0.9063, ranking 3rd among all complete-submission runs and placing DS@GT 2nd among the 21 teams overall, while outperforming our paid baseline Run 1 (0.8841) at roughly one-quarter of the per-persona API cost. These results support our central hypothesis that with sufficient algorithmic supervision, a weaker open-source model can compete with a stronger proprietary model in the conversational interviewer role. Our source code is available at https://github.com/dsgt-arc/erisk-task1-2026.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。