
反馈归因与表征几何:多智能体强化学习中个体奖励与共享奖励的比较指标
Feedback Attribution and Representation Geometry: Metrics for Comparing Individual and Shared Rewards in MARL
📝 TLDR
合作多智能体强化学习常采用团队共享奖励,难以区分个体贡献。本文提出 EffRank/n 与 D_act 两个低开销诊断指标,分别衡量表征有效秩与智能体间动作分布差异。在 SMACv2 protoss_5_vs_5 上对 MAPPO 做观测可见性与奖励分配的交叉实验,发现表征几何主要由观测决定而非奖励形式:当单位类型可见时两类奖励的 EffRank/n 与探针精度相近,而个体奖励下 D_act 明显更高。贡献在于提示几何诊断需控制角色观测,并验证未观测持久角色的测试必要性。
🧭 速览
合作多智能体共享团队奖励可能掩盖个体贡献,亟需可量化诊断表征与行为差异的低开销方法。
提出 EffRank/n 与 D_act 两项诊断指标,在 SMACv2 上对 MAPPO 进行观测与奖励分配的 2×2 交叉实验。
几何特征由观测主导,单位类型可见时两类奖励下 EffRank/n 与探针精度接近;个体奖励下 D_act 更高,行为分化更明显。
奖励分配主要体现于行为而非表征几何,提示几何诊断须控制角色信息并测试未观测的持久角色。
🆚 方法对比
EffRank/n
- 低开销,小批量可计算,<5%额外计算
- 量化表征维度冗余与角色分离度
- 有效秩归一化消除智能体数影响
- 仅测几何结构,不区分行为差异
- 对观察中的角色信息敏感,需严格控制变量
- 单一标量可能丢失局部几何细节
D_act
- 直接度量行为多样性,补足几何指标
- 配对KL散度均值,解释力直观
- 计算轻量,与EffRank/n互补
- 仅反映行为分布差异,不揭示内在动机
- 高方差,如共享奖励下0.07-0.20的波动
- 无法区分多样性来源是角色还是噪声
MAPPO
- 成熟稳定,可训练4M步达到胜任策略
- 共享编码器适合检验角色分离假设
- 支持中心化训练分散执行框架
- 共享编码器易导致表征坍缩
- 对奖励分配方式敏感,需配合细粒度奖励
- 在100+智能体大规模场景扩展性未验证
共享团队奖励
- 对齐联合目标,训练稳定
- 避免个体贡献估计偏差
- 实现简单,业界常用方案
- 抹除个体贡献信号,易产生同质策略
- 在SMACv2中D_act仅1.07低于个体奖励
- 无法激励互补角色形成,如Neural MMO所示
个体伤害贡献奖励
- D_act达1.23高于共享奖励,行为更多样
- 智能体仍胜任且可按角色分离
- 鼓励个体贡献归因,缓解信用分配
- 可能引入自私行为偏离团队目标
- 需额外设计个体贡献估计器
- 在稀疏奖励场景下信号噪声大
COMA
- 反事实基线精确分配个体信用
- 保持团队目标同时归因个体贡献
- 理论上有明确的信用分配保证
- 需中心化critic,实际部署受限
- 反事实计算开销随智能体数指数增长
- 论文仅作背景对比,未在实验中验证
VDN
- 将团队价值分解为个体价值之和
- 结构简单,易于实现和训练
- 分散执行天然兼容
- 加性分解限制表达能力
- 无法捕捉智能体间非线性交互
- 论文未测试其表征几何差异
QMIX
- 单调混合网络增强值分解能力
- 保持分散执行,中心化训练优势
- 在StarCraft基准上表现优异
- 单调性约束限制函数逼近能力
- 混合网络增加超参数调优成本
- 论文仅作文献对比,未实测
本文提出EffRank/n与D_act作为轻量诊断指标,在MAPPO框架下对比共享与个体奖励,发现几何表征由观察信息主导而行为多样性由奖励分配主导,区别于COMA/VDN/QMIX等显式信用分配方法仅优化训练目标。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文关注合作多智能体强化学习中一个看似基础却容易被忽视的问题:团队共享奖励与个体奖励究竟是否会在已训练好的智能体身上留下可测量的差异?作者提出 EffRank/n 与 D_act 两个轻量级诊断指标,分别从表征几何与行为分布两个维度来探测奖励归因的效应。在 SMACv2 的 protoss_5_vs_5 任务上运行 MAPPO 的交叉实验后发现,编码器的角色几何结构主要由观测中的单位类型信息驱动,奖励形式的影响几乎可以忽略不计——遮蔽观测中的单位类型位后,两种奖励方案下的探针准确率双双跌回随机水平。这项工作的贡献在于提醒研究者:表征诊断必须控制好观测输入,否则容易把「从观测中读取角色」误认为「从奖励中学会角色特化」。
研究背景与动机
合作多智能体强化学习(MARL)系统在面对需要角色分工的任务时,通常面临一个经典的两难选择:是让每个智能体接收团队整体表现的平均奖励(共享奖励),还是尽可能追踪每个智能体对团队成果的边际贡献(个体奖励)。共享奖励的实现成本低、信号稳定,但在理论上存在信用分配困难的问题——当团队胜利时,每个智能体无法知道自己究竟做了多少贡献,反之亦然。已有大量研究致力于设计更好的信用分配算法,如 COMA、VDN、QMIX 等,它们试图从共享回报中反向推断每个智能体的价值函数。然而,这些工作几乎都聚焦于学习阶段的算法改进,极少有人回过头来问一个更基础的问题:当我们用一种奖励方式训练出表现良好的策略之后,这种选择是否已经在智能体的表征或行为层面留下了可测量的痕迹?
这个问题之所以重要,是因为表征质量直接关系到智能体能否泛化到未见过的情境,也关系到我们能否解释和调试大规模多智能体系统。近年来,单智能体强化学习中关于表征坍缩(representation collapse)的研究表明,过度共享的编码器可能导致所有智能体学到相似的嵌入,丧失角色特异性。然而在多智能体场景下,现有诊断工具面临一个容易被忽略的混淆因素:角色信息可能既来自奖励的差异化反馈,也来自观测中直接提供的线索(如单位类型、游戏角色ID等)。如果不控制观测输入,研究者很容易把「从观测中读取角色」误判为「从奖励中学会角色特化」,从而高估共享奖励的危害或个体奖励的收益。这正是本文想要厘清的因果链条。
方法
作者提出两个互补的诊断指标,分别针对表征空间的结构和策略输出的行为分布。
第一个指标 EffRank/n 是对有效秩概念的改造。给定 个智能体的时间平均 GRU 嵌入质心组成的矩阵 ,先对其奇异值做归一化得到 ,再按下式计算有效秩:
将结果除以 得到 EffRank/n,这个归一化步骤使得不同规模任务上的数值可以直接比较。EffRank/n 的直观含义是编码器实际使用的「角色维度」占全部智能体槽位的比例——如果所有智能体的嵌入高度重叠,有效秩会趋近于 1/n(对应完全坍缩);如果每个智能体占据独立的方向,EffRank/n 则接近 1。该指标的上界期望约为 ( 为真实角色数),这给出了一个「干净角色表征」的理论上限。
第二个指标 D_act 衡量智能体之间动作分布的平均成对 KL 散度:
这里的 是给定智能体 局部观测时策略输出的动作分布。D_act 捕捉的是瞬时的行为多样性——如果两个智能体面对不同观测总是给出相似的动作反应,即使它们的表征空间彼此分离,D_act 也会偏低;反之,如果奖励归因驱动了更强的角色特化,D_act 会显著高于共享奖励条件下的基线。值得注意的是,由于策略通常是共享的,D_act 的绝对值同时受到观测多样性与学到的特化程度两个因素的调制,因此需要在保持环境和观测分布固定的前提下做组间比较才有意义。
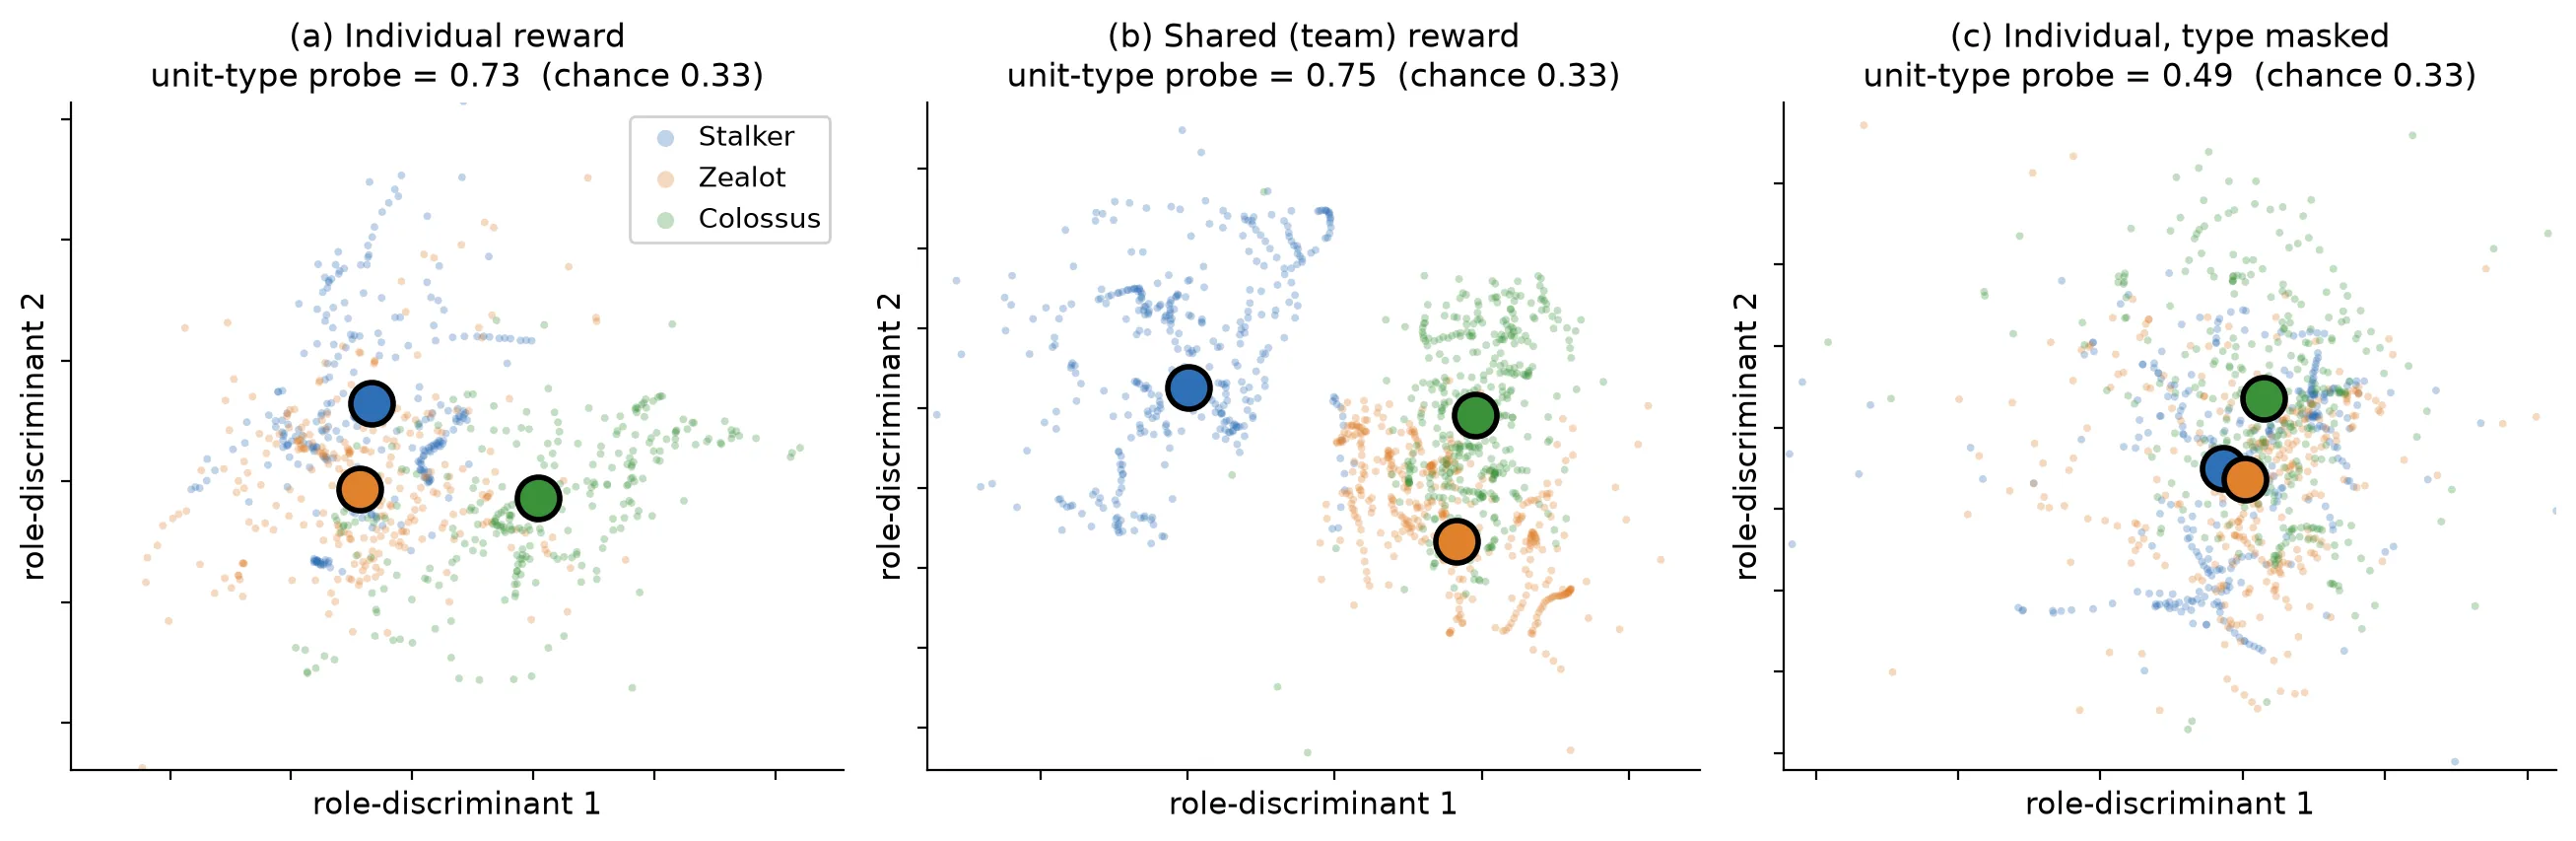
除了这两个指标,作者还设计了一个角色探针(role probe)来验证编码器是否真正编码了角色信息。探针采用冻结编码器加逻辑回归三分类器的标准范式,目标是根据嵌入向量预测单位类型(stalker/zealot/colossus)。为避免智能体槽位固定带来的过拟合,作者采用留一智能体槽位交叉验证(leave-one-agent-slot-out cross-validation)——训练集和测试集使用不同的智能体槽位,确保探针学到的是对角色本身的泛化而非对固定槽位的记忆。
实验与结果
实验在 SMACv2 的 protoss_5_vs_5 地图上进行,这是一个典型的异构多智能体协作任务:5 个友方神族单位(stalker、zealot、colossus 各若干,每集独立采样单位类型组合)对战 5 个敌方单位。作者采用完全共享权重的 MAPPO 策略,GRU 编码器加线性 actor/critic 头,每组条件训练 4M 环境步。
实验采用 2×2 交叉设计,操纵两个因素:观测中是否包含单位类型位(可见 vs. 遮蔽),以及奖励归因方式(个体伤害贡献奖励 vs. 共享团队奖励)。每组 3 个随机种子,评估时取 32 条确定性轨迹的平均。
核心结果可以概括为三点。首先,当观测中包含单位类型时,奖励形式对表征几何几乎没有影响:共享奖励组的 EffRank/n 为 0.31±0.03,个体奖励组为 0.29±0.02,几乎相同;角色探针准确率分别为 0.75±0.05 和 0.73±0.05,均远超 1/3 的随机猜测水平。这说明共享奖励并未导致表征坍缩,智能体仍然学到了清晰的角色几何。其次,奖励形式对行为的影响确实存在但幅度有限:个体奖励组的 D_act 达到 1.23±0.06,高于共享奖励组的 1.07±0.20,对应的确定性胜率也略高(0.48 vs. 0.39)。这表明奖励归因的效应主要体现在策略输出的多样性上,而非编码器的几何结构。第三,遮蔽观测中的单位类型位彻底颠覆了上述差异:遮蔽后,两种奖励条件下的探针准确率都跌至约 0.49,几乎退化为随机猜测,同时 EffRank/n 也大幅下降。这直接证明之前观察到的角色几何完全来自观测输入而非奖励驱动的特化。
作者还在 48 智能体的 Tribal Village 环境中验证了两个指标的可迁移性。结果显示,无论是共享奖励还是个体奖励,探针都能以 0.82–0.87 的准确率区分「贡献组」,EffRank/n 均约为 0.175,表明指标在更大规模场景下仍然有效。但在 Tribal Village 上,两个奖励臂之间的差异进一步缩小,这与该环境中角色信息更隐含、不直接暴露在观测中有关。
讨论与可借鉴点
这项研究最直接的方法论启示是:在评估多智能体系统是否学会了角色特化时,必须对观测中可直接读取的角色信息进行控制。如果单位类型、阵营归属这类信息本身就编码在观测向量中,那么即使不做任何信用分配改进,共享奖励下的智能体也能通过简单地「记住观测中的角色位」来产生角色相关的表征和差异化行为。这不是真正的角色特化,而是对输入信号的直接复制——一旦这些线索被遮蔽或缺失,智能体就会失去角色感知能力。因此,未来在设计诊断基准时,应该优先选择那些角色信息无法从单步观测中直接获取、必须通过长期协作历史或因果推理才能推断的场景。
论文的局限性也比较明显。核心实验仅基于 SMACv2 的单一地图和神族单位类型,星际争霸中 stalker/zealot/colossus 各自拥有截然不同的攻击范围、移动速度和生命值,这些动力学差异本身就构成了丰富的角色区分线索,可能放大了观测的主导效应。在其他奖励稀疏、单位类型不编码在观测中、或需要更复杂协作的场景下,奖励归因对表征几何的影响可能会更为显著。此外,4M 步的训练规模相对有限,最佳胜率仅达 0.48 左右,这意味着策略尚未完全收敛,更强的角色特化是否需要更长的训练或更优的基线才能显现,目前尚无定论。
从实用角度看,EffRank/n 和 D_act 作为训练过程中的轻量级监控工具具有不错的价值——作者报告的额外开销低于 5%,可以较容易地集成到现有训练流程中实时追踪表征与行为的变化趋势。但需要记住,这两个指标各自只能提供部分信息:EffRank/n 反映的是嵌入空间的结构,忽略了行为层面;D_act 反映的是动作输出的差异,但无法区分这种差异是来自观测多样性还是真正的奖励驱动特化。正确做法是将它们与角色探针联合使用,并结合本文所示范的观测遮蔽消融来厘清因果。
摘要
合作多智能体强化学习系统普遍使用团队平均奖励,这种反馈归因方式使每个智能体获得的反馈与团队整体结果一致,而与个体贡献无关。我们提出一个问题:这种选择是否会在已学得的表征上留下可测量的、几何或行为层面的印记。我们提出 EffRank/(按智能体数量归一化的有效秩)与 (智能体动作分布之间的平均成对 KL 散度),作为低开销的奖励归因效应诊断指标,并在 SMACv2 的 \texttt{protoss\_5\_vs\_5} 任务上对训练良好的 MAPPO 智能体进行测试,其中单位类型被编码在观测中。在一个观测 × 奖励归因的对比实验中(观测到单位类型 vs. 遮蔽单位类型;个体伤害贡献奖励 vs. 共享团队奖励),表征集几何由观测而非奖励决定。当观测到单位类型时,共享奖励与个体奖励具有相近的 EffRank/( vs. )和探针准确率( vs. ,均远超 的随机水平),而 在个体奖励下略高( vs. )。遮蔽单位类型使超出随机水平的探针信号削减一半以上,在两种奖励条件下均降至 。简言之:获得个体奖励的智能体具备能力且其角色可区分,但在 SMACv2 上观测决定了表征集几何,奖励归因的影响主要体现在行为上。因此,几何诊断指标必须对观测到的角色信息加以控制,并测试那些未被直接观测到的持久性角色。EffRank/ 与 带来的额外开销低于 5\%。
Abstract
Cooperative multi-agent RL systems routinely use team-averaged rewards, a feedback-attribution choice that gives each agent the team outcome regardless of its individual contribution. We ask whether this leaves a measurable signature, geometric or behavioral, on learned representations. We propose EffRank/ (effective rank normalized by agent count) and (mean pairwise KL divergence between agents' action distributions) as low-overhead diagnostics for reward-attribution effects, then test them on competent MAPPO agents in SMACv2 \texttt{protoss\_5\_vs\_5}, where unit type is encoded in the observation. In an observation reward-attribution comparison (unit type observed vs.\ masked; individual damage-contribution reward vs.\ shared team reward), geometry follows observation rather than reward. With unit type observed, shared and individual rewards have similar EffRank/ ( vs.\ ) and probe accuracy ( vs.\ , both chance), while leans higher under individual rewards ( vs.\ ). Masking unit type cuts the above-chance probe signal by more than half, to in both reward arms. In short: individually rewarded agents are competent and separable by role, but on SMACv2 the observation explains the geometry and reward attribution shows up mainly in behavior. Thus geometric diagnostics must control for observed role information and test persistent roles that are not directly observed. EffRank/ and add 5\% overhead.
论文详细总结(自动生成)
论文总结:反馈归因与表征几何——多智能体强化学习中个体奖励与共享奖励的比较指标
1. 核心问题与研究动机
- 核心问题:在合作型多智能体强化学习(MARL)中,团队共享奖励的反馈归因方式是否会在已学得的表征或行为上留下可测量的印记?个体奖励与共享奖励对编码器表征几何与策略行为的影响有何差异?
- 背景:
- 大规模 MARL(如 Neural MMO,在 100–1000 智能体规模下)报告了团队共享奖励易导致策略同质化、缺乏互补角色的问题。
- 信用分配文献(COMA、VDN、QMIX 等)关注如何从共享回报中反向归因个体贡献,但本文关注的是已训练完成策略的表征与行为诊断,而非学习算法本身。
- 表征坍缩(rank collapse)研究指出 RL 训练会降低表征维度,但多集中于单智能体场景。
- 动机缺口:现有诊断指标未明确区分"由直接观测到的角色输入触发的几何结构"与"由奖励归因驱动的角色特化",可能导致因果误判。
2. 方法论
2.1 两个低开销诊断指标
- EffRank/(按智能体数量归一化的有效秩):
- 灵感来自 Roy & Vetterli (2007) 的有效秩概念。
- 对由 个智能体的时间平均 GRU 嵌入质心组成的矩阵 计算有效秩:
- 归一化处理:,上界期望约为 ( 为角色数),接近 表示坍缩为单一共享方向。
- 在每个智能体的质心嵌入上计算,避免被瞬时时间步变化所主导。
- (行为多样性指标):
- 智能体间动作分布的平均成对 KL 散度:
- 反映瞬时的动作分布差异,需与 EffRank/ 及探针结果联合解读。
- 由于策略是共享的, 的绝对值同时反映观测多样性与学到的特化程度,因此需要在保持环境与观测分布固定的条件下进行比较。
2.2 角色探针与评估协议
- 角色探针:冻结编码器,拟合三路单位类型(stalker/zealot/colossus)的逻辑回归分类器,使用留一智能体槽位(leave-one-agent-slot-out)交叉验证,以排除在槽位上的过拟合。
- 指标组合解读原则:
- 仅 变化、EffRank/ 与探针不变 → 奖励归因改变了行为但未改变几何。
- EffRank/ 较低 + 探针接近随机 → 编码器在特定角色标签上坍缩。
3. 实验设计
3.1 主要基准与环境
- SMACv2 \texttt{protoss\_5\_vs\_5}(10gen protoss):5 个友方神族单位(stalker/zealot/colossus,每集独立同分布采样)对战 5 个敌方单位;单位类型默认编码于观测的"单位类型位"中。
- Tribal Village(附录描述):48 个智能体的网格世界,包含采集、建造与资源争夺。
- 策略:单一完全共享的 MAPPO(Yu et al., 2022)策略,GRU 编码器 + 线性 actor/critic 头,无智能体专属参数。
- 训练规模:每组条件训练 4M 环境步。
3.2 交叉对比设计
| 维度 | 水平 1 | 水平 2 |
|---|---|---|
| 观测 | 单位类型可见(默认) | 遮蔽自身单位类型位(obs_mask_unit_type) |
| 奖励归因 | 个体(按伤害贡献分配) | 共享(团队平均奖励) |
- 每格 3 个种子,32 条/种子的确定性评估轨迹。
- 评估指标:EffRank/、、单位类型探针准确率、确定性胜率。
3.3 对比方法
- 论文不直接对比其他方法,而是以奖励归因 × 观测结构的消融设计为核心。
- 隐含的方法论基线为:
- 信用分配算法(COMA/VDN/QMIX)——本文保持算法固定。
- 表征共享架构(PRISM、LoRASA)——背景文献。
- 行为多样性度量(SND、ACORM、MA2CL)——背景文献。
4. 资源与算力
- 文中未明确披露具体的 GPU 型号、数量、训练墙钟时间或每秒步数(steps-per-second)。
- 已知训练规模:每条件 4M 步,3 种子,每个种子 32 条确定性评估轨迹。
- 指标开销:作者宣称 EffRank/ 与 增加 < 5% 的额外计算开销,但无对应的具体测算方法说明。
5. 实验数量与充分性
- 实验数量:SMACv2 上的 交叉设计(4 组),每组 3 种子,总计 12 个独立训练;Tribal Village 上各奖励方案各取一个最佳检查点进行对比;并报告了 32 个评估回合/种子的平均与标准差。
- 充分性评估:
- 优点:消融结构清晰,引入"观测遮蔽"操作巧妙地切断了"角色来自观测而非奖励"的混淆来源;留一槽位探针设计有效排除槽位过拟合。
- 局限:
- 单一基准(SMACv2 神族 5v5)外推到一般 MARL 场景的能力有限。
- 训练步数(4M)有限,确定性胜率仅 0.24–0.48,尚未达到顶级比赛水平,限制了"团队特化是否需要更强能力"的结论。
- 未提供不同超参、规模、训练步数下的敏感性分析。
- Tribal Village 部分仅作为指标可用性验证,缺乏深入消融。
6. 主要结论与发现
1. 几何由观测主导:在 SMACv2 上,当单位类型可见时,个体与共享奖励的 EffRank/ 几乎相同( vs. ),探针准确率均超 0.73(远超 随机水平),说明共享奖励未坍缩编码器的角色几何。
2. 行为差异确实存在:个体奖励下 更高( vs. ),胜率也更高( vs. ),表明奖励归因主要在行为层面留下印记。
3. 遮蔽观测切断了混淆通道:遮蔽单位类型位使两个奖励条件下的探针准确率都降至 ,几乎退化为随机,证明之前的"角色几何"主要源自观测嵌入而非奖励驱动的特化。
4. Tribal Village 上指标有效但未呈现奖励臂差异:两个奖励臂均能成功编码"贡献组"(探针 0.82 vs. 0.87),EffRank/ 均约 , 相近(3.83 vs. 4.11),胜率一致(84.4%)。
5. 方法论建议:几何诊断必须控制观测中可直接读取的角色信息,并选用未在观测中暴露的持久性角色作为测试对象,否则会造成对奖励效应的高估。
7. 优点
- 诊断框架设计精巧:将"几何"与"行为"分离评估(EffRank/ + + 探针),并明确提出在观测控制下解读。
- 混淆变量处理出色:通过"遮蔽单位类型位"操作直接揭示几何来自观测的捷径,避免了常见的"看似特化实为观测记忆"的伪结论。
- 留一槽位探针:有效防止编码器仅在固定智能体槽位上过拟合,提升结论可信度。
- 低开销:作者宣称<5% 开销,便于嵌入现有训练流程进行常态化监控。
- 跨规模验证:在 5v5 与 48 智能体两种规模上都进行了适用性测试。
- 临床式行文:先建立基线(个体奖励 + 可见角色),再切换奖励臂,最后通过遮蔽观测"揭穿"几何来源,符合因果排查的逻辑链条。
8. 不足与局限
- 基准单一:核心结论建立在 SMACv2 单地图(神族 5v5)上,缺乏在星际其他种族、对称/非对称地图、稀疏奖励场景下的复现。
- 训练预算保守:4M 步下胜率仅 0.24–0.48,难以断言"更强的特化"是否需要更长的训练或更高能力的基线策略才能显现。
- 未充分揭示期望假设:作者提出"干净角色表征的理论上限为 ",但未给出在何种条件下该上界可达的论证或实证。
- 资源披露缺失:未报告 GPU 型号/数量、训练时长、每秒步数等算力信息,复现门槛不透明。
- 探针有效性边界:在 SMACv2 上遮蔽后探针仅略微高于 0.49,可能因速度、攻击范围等动力学特性泄漏单位类型;作者承认但未量化泄漏通道。
- Tribal Village 实验薄弱:仅作为指标可行性演示,未做消融、未做种子统计,难以支撑更广泛的跨场景声明。
- 未涵盖持续性角色:作者在讨论中明确指出"未来工作应使用持久且不可观测的角色",意味着当前实验设置并未完全满足论文本身设定的最佳测试条件,存在自我审查式的局限声明。
- 架构普遍性:只在 MAPPO + 完全共享 GRU 上验证,对其他共享架构(注意力、混合专家、PRISM、LoRASA 等)的可迁移性尚未涉及。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。