
基于控制仿射动力学近似的可认证安全基于模型强化学习
Certifiable Safe Model-Based Reinforcement Learning with Control-Affine Dynamics Approximation
📝 TLDR
本文提出利用残差不确定性中控制仿射结构的安全模型强化学习框架,为机器人实现可认证的安全控制。
🧭 速览
基于控制仿射残差结构的安全模型强化学习。
方法与实现细节请参考摘要与正文。
结果与对比结论请参考摘要与正文。
总体而言,该工作在所述任务上展示了有效性,并提供了可复用的思路或工具。
🆚 方法对比
所提安全MBRL框架(ARFF+ACP+CBF+MPPI)
- 显式保留控制仿射结构,减少模型偏差
- ACP提供可证明的高概率安全保障
- 计算复杂度随数据集高效扩展
- 乐观探索兼顾安全与近最优性能
- 仅在倒立摆与四旋翼仿真验证,缺乏实物实验
- 理论假设依赖标称动力学部分已知
- 自适应校准增加在线计算开销
ARFF(控制仿射随机傅里叶特征)
- 高效逼近GP,计算开销小
- 显式保留控制仿射结构无偏
- 适用于在线控制场景
- 仍为近似模型,预测存在偏差风险
- 依赖核函数与超参数的选择
ACP(自适应共形预测)
- 在线更新打破交换性假设
- 与模型无关,适用范围广
- 提供可认证的不确定性区间
- 覆盖率保证依赖在线校准样本量
- 序列更新可能累积偏差
CBF(控制屏障函数)
- 安全约束可转化为优化问题
- 提供形式化安全保证
- 传统方法假设控制仿射部分完全已知
- 依赖模型精度,模型偏差导致失效
GPs(高斯过程)
- 提供均值与方差的不确定性估计
- 广泛应用于安全MBRL
- 训练计算负担重,难以在线应用
- 方差估计常过于保守或过于自信
RFF/稀疏GP近似
- 显著降低GP计算复杂度
- 便于在线部署
- 预测偏差影响MBRL性能
- 方差估计偏低导致安全性失效
MPPI(模型预测路径积分)
- 基于采样的模型预测控制方法
- 与Thompson采样探索自然结合
- 计算成本随采样数线性增长
- 对模型精度依赖较强
标准共形预测(CP)
- 无需依赖预测模型即可量化不确定性
- 提供有限样本覆盖率保证
- 假设数据可交换,在线场景易违反
- 静态校准无法随数据更新
论文针对传统GP/RFF+CP方案存在的计算昂贵、近似偏差及在线交换性失效等问题,提出以ARFF保留控制仿射结构、以ACP在线校准不确定性的统一安全MBRL框架,在安全性可认证性与计算效率间取得平衡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 1 张)
展开查看 1 张图
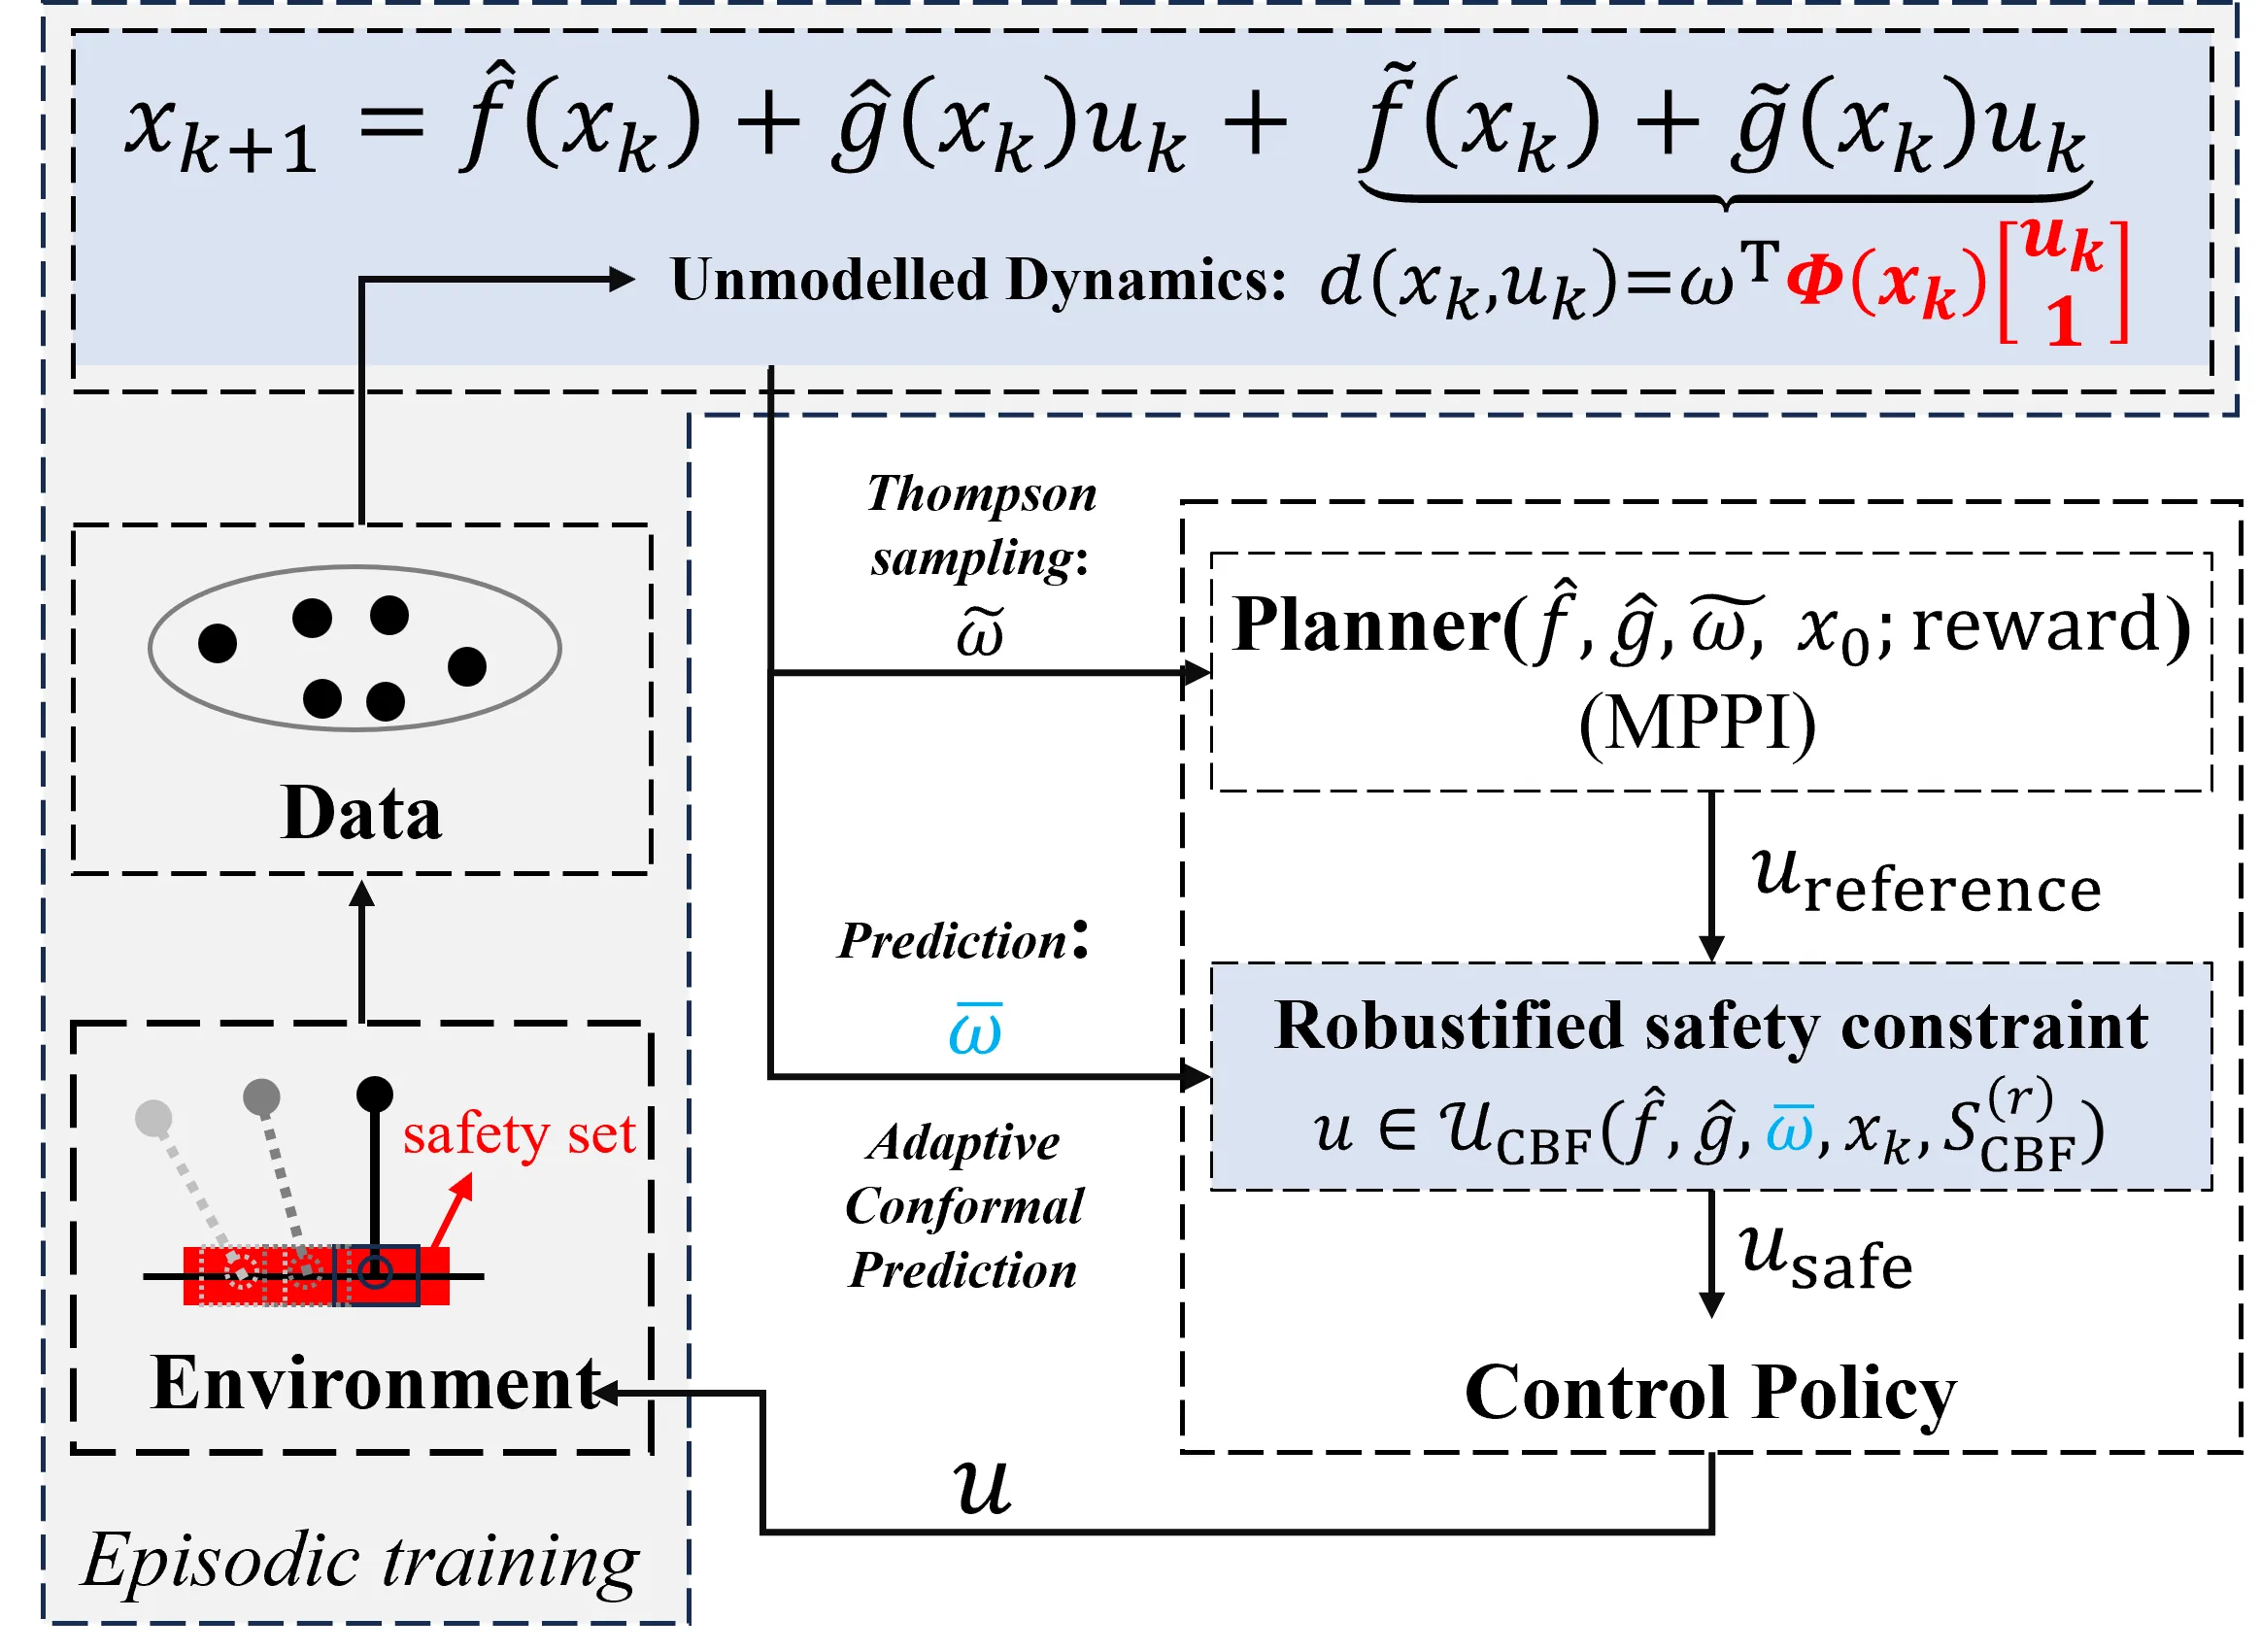
TL;DR
这篇论文针对安全强化学习中残差模型不确定性被忽视的问题,提出了 SafeCARL 框架。该框架利用控制仿射随机傅里叶特征(ARFF)显式建模残差动力学的控制仿射结构,并结合自适应一致性预测(ACP)进行不确定性量化,最终通过控制屏障函数实现可认证的安全控制。实验表明,该方法在倒立摆和四旋翼平台上将安全率从 0% 提升至接近 100%,同时将优化求解时间缩短约 8 倍。
研究背景与动机
安全强化学习(Safe RL)是机器人领域的一个核心挑战:机器人需要在部分未知的环境中学习高效完成任务,同时严格遵守安全约束。一种被广泛采用的思路是将控制理论(如[[控制屏障函数]]、安全胶囊等)与强化学习方法相结合,形成安全基于模型的强化学习(Safe MBRL)框架。
这类方法的核心逻辑是:先利用物理定律构建一个标称的动力学模型,再通过数据驱动的方式学习残差不确定性,补偿标称模型与真实系统之间的偏差。控制性能和安全保证都依赖于这两个组件的准确性。
然而,已有方法在处理残差不确定性时存在根本性缺陷。传统做法将残差项建模为 ,即假设残差仅与状态相关,与控制输入无关。这忽略了一个关键事实:真实的残差往往包含控制仿射分量——也就是说,控制输入本身也会影响系统建模的误差。这种简化带来的后果是双重的。首先,模型偏差增大,导致控制器性能下降。其次,在基于控制屏障函数设计安全约束时,由于控制输入被嵌套在非线性数据驱动模型中,优化问题难以保持凸性,甚至无法高效求解。
另一个隐患来自不确定性量化本身。随机傅里叶特征(RFF)等方法在近似高斯过程时,往往会系统性地低估预测方差。这听起来像是好事——低估不确定性意味着约束更"严格"——但实际上,这种保守性是不正确的,它会导致安全约束在关键时刻失效。
基于以上观察,这篇论文提出的核心问题是:如何在保留残差动力学控制仿射结构的前提下,高效学习系统动力学,并提供可认证的安全保证?
方法
SafeCARL 框架的核心设计围绕三个关键组件展开,形成一条从动力学学习到安全控制的完整 pipeline。
第一步是控制仿射随机傅里叶特征(ARFF)建模。 作者没有简单地将残差建模为状态的函数,而是将其显式表达为控制仿射形式:
特征函数 的设计尤为巧妙:
这里 是标准随机傅里叶特征,通过高频正弦和余弦函数对状态空间进行非线性展开。关键在于, 被显式分离出来,使得整个残差项关于控制输入保持线性。
通过岭回归可以直接求解权重矩阵 ,其解析形式为:
这种显式建模的优势体现在两个方面:控制输入保持线性使得后续的[[控制屏障函数]]优化问题天然保持凸性;解析解的存在意味着计算复杂度不会随数据集规模爆炸式增长。
第二步是自适应一致性预测(ACP)进行不确定性量化。 作者定义了一个安全屏障证书函数 ,其真实值记为 。ACP 的目标是为这个证书构造一个可靠的置信区间:
这里的 是历史误差的分位数,通过在线递推更新 逐步调整置信水平。ACP 的一个重要特性是它不依赖任何特定的预测模型假设,因此避免了 RFF 或高斯过程方差低估的问题。
第三步是基于控制屏障函数的安全过滤。 最终的优化问题表述为:
由于 ARFF 建模保证了残差关于 是线性的,安全约束本身也保持线性,整个优化问题是严格凸的,可以直接用 CVXPY 等凸优化求解器高效求解。
整个 SafeCARL 的学习循环如下:在每个回合中,先用 ARFF 拟合残差动力学,通过 Thompson Sampling 采样动力学参数驱动 MPPI 生成参考控制,再经过 CBF 安全过滤得到最终动作。
实验与结果
实验在两个典型的机器人平台上验证了方法的有效性:倒立摆(Cartpole)和三维四旋翼。
Cartpole 实验 的设置颇具挑战性:标称物理参数被故意设置为不准确的值(),模拟真实场景中物理参数难以精确获取的情况。基线对比包括基于真实动力学的 MPPI-GT(性能上界)、基于标准 RFF 的 MPPI-RFF(LC³),以及本文方法的各个变体。
结果显示,标准 LC³ 方法在 Cartpole 上的安全率为 0%,完全无法保证安全。添加控制仿射结构但不使用 ACP 的方法安全率约为 60%。而完整 SafeCARL 框架的安全率达到了 100%,满足了 的安全认证要求。更值得注意的是,任务奖励与真实动力学下的性能上界非常接近,说明安全增强并没有过度牺牲控制性能。
三维四旋翼实验 进一步验证了方法在更复杂系统上的表现。系统包含 9 维状态和 4 维控制输入,残差来自质量参数偏差和周期性风扰。实验分为稳定任务(悬停在指定位置)和跟踪任务(跟踪 8 字形轨迹)。在稳定任务中,安全率从 LC³ 的 0% 提升到了 98%,最小安全指标值也显著提高。在跟踪任务中,ARFF 的控制仿射建模显著降低了模型偏差,跟踪精度优于对比基线。
计算效率 是方法的一个显著优势。由于 ARFF 将优化问题转化为凸问题,求解时间从 RFF 非线性优化的 2.51ms(Cartpole)和 3.27ms(Quadrotor)降低到了 0.38ms 和 0.44ms,实现了约 8 倍的提速。这意味着整个框架可以在毫秒级别完成控制决策,非常适合实时机器人应用。
样本效率 方面,SafeCARL 约需 10 个学习回合即可收敛到稳定的性能和安全保障,显示出良好的数据利用效率。
讨论与可借鉴点
这篇论文在安全强化学习领域提出了一个具有清晰理论支撑的方法,其设计思路对相关研究有几点值得借鉴之处。
结构先验的重要性 是最核心的启示。将控制输入的结构信息显式编码到模型设计中,不仅仅是提高拟合精度,更关键的是改变了优化问题的数学性质——从非凸变为凸。这提醒我们,在设计数据驱动的机器人控制器时,不应盲目追求"端到端"的灵活性,而应充分利用物理先验知识。
不确定性量化与控制结构的兼容 是另一个重要主题。ACP 方法不依赖特定模型假设的特性,使其能够与 ARFF 建模无缝配合。然而,这种兼容性并非自动达成——它需要建模层和控制层在设计之初就考虑彼此的需求。这提示未来的安全学习系统设计应该采用"联合优化"的视角,而非分别设计子系统后再拼接。
论文也存在若干局限。首先,所有实验均停留在仿真环境,真实机器人中的传感器噪声、执行器延迟、模型失配等问题尚未验证。其次,ACP 的递推更新假设分布漂移是渐进的,对于快速环境变化(如突发扰动)的鲁棒性存疑。再者,控制屏障函数要求安全集是前向不变的,对于欠驱动或强非线性系统,如何设计合适的屏障函数仍是开放问题。
从更宏观的角度看,这项工作展示了控制理论与机器学习的深度融合如何产生"1+1>2"的效果。ARFF 的解析特性和 ACP 的模型无关性使得理论保证更容易建立,而 CBFs 的凸优化求解又保证了实用性。这种"可证明性"与"实用性"的平衡,正是安全强化学习走向真实机器人应用所急需的。
摘要
安全基于模型的强化学习(RL)通常将控制理论分析与机器人强化学习相结合,使机器人能够在安全地探索(部分)未知系统动力学的同时,推导出兼顾任务效率的控制动作。控制性能与安全保障通常依赖于部分建模的标称系统动力学的先验知识,以及用于补偿残余模型不确定性的数据驱动模型。然而,现有方法往往忽视了残余模型不确定性的结构(例如,控制仿射分量),这可能导致基于安全学习控制器下的机器人行为过于保守或安全保证失效。本文提出了一种安全强化学习框架,利用控制屏障函数(CBF)学习控制仿射动力学并获得可认证的数据驱动安全策略。具体而言,我们首先采用控制仿射随机傅里叶特征(ARFF)将机器人动力学建模为控制仿射形式,该方法在计算效率上能够随数据集规模进行扩展,并能减少基于模型的强化学习中潜在的模型偏差。随后,采用一种基于自适应一致性预测(ACP)的无模型高效不确定性量化方法,对由学习得到的控制仿射动力学所引入的安全约束不确定性进行量化。这使得数据驱动的安全保障能够与基于 CBF 的原理化、高效控制器综合相兼容。在倒立摆和三维四旋翼平台上的仿真结果验证了所提框架的有效性。
Abstract
Safe model-based reinforcement learning (RL) often bridges control-theoretic analysis and RL for robots to safely explore (partially) unknown system dynamics while deriving control actions for task efficiency. The control performance and safety assurance typically rely on prior knowledge of partially modeled nominal system dynamics and the data-driven models that compensate for residual model uncertainties. However, existing methods often overlook the structure of residual model uncertainties (e.g., components affine in control), which could lead to overly conservative robot behaviors or invalid safety guarantees under the safe learning-based controllers. This paper proposes a safe reinforcement learning framework that learns control-affine dynamics with a certifiable data-driven safe policy using control barrier functions (CBF). Specifically, we first use Control-Affine Random Fourier Features (ARFF) to model robot dynamics in a control-affine form, which offers computational efficiency that scales with dataset size and reduces potential model bias for model-based reinforcement learning. Then, a model-free, efficient uncertainty quantification method using adaptive conformal prediction (ACP) is applied to quantify the uncertainty in the safety constraint arising from the learned control-affine dynamics. This allows for data-driven safety assurance amenable to principled and efficient controller synthesis with CBF. Simulation results on the cartpole and the 3D quadrotor platforms demonstrate the effectiveness of the proposed framework.
论文详细总结(自动生成)
论文总结:基于控制仿射动力学近似的可认证安全基于模型强化学习
1. 核心问题与研究动机
- 研究背景:安全基于模型的强化学习(Safe MBRL)旨在让机器人在部分未知的系统动力学下,既能安全探索又能保证任务效率。然而,其性能与安全性依赖于两部分:(1) 部分已知的标称动力学(由物理定律推导),(2) 数据驱动学习的残差不确定性模型。
- 现有方法的不足:
- 已有方法(如 GP-free 或标准 RFF)在建模残差不确定性 时忽略其控制仿射结构,即默认 ,忽略了控制输入 对残差的影响;
- 这种忽略会导致:① 模型偏差较大进而影响控制性能;② CBF 优化问题需要将优化变量传播进非线性数据驱动模型而难以高效求解;
- RFF 近似 GP 还会低估预测方差,导致不确定性感知的安全约束过于乐观,无法保证安全。
- 本文核心问题:如何在保留残差动力学控制仿射结构的前提下,高效学习并提供可认证的安全保证?
2. 方法论
2.1 整体框架
- 提出 SafeCARL(Safe Control-Affine RL)框架:每个学习回合分为两步:
1. 用 ARFF 拟合残差动力学 → 用 Thompson Sampling 采样的动力学经 MPPI 产生参考控制输入;
2. 用 CBF 进行安全过滤得到最终安全控制量。
2.2 关键技术 1:控制仿射随机傅里叶特征(ARFF)
- 将残差动力学建模为线性仿射形式:
- 特征 设计为:
- 其中 , 独立同分布于高斯分布。
- 训练:通过岭回归求解:
- 优势:解析解,不随数据集规模而显著增加计算成本;显式分离控制输入,使后续 CBF 优化保持凸性。
2.3 关键技术 2:自适应一致性预测(ACP)不确定性量化
- 定义安全屏障证书预测值 ,真实值 。
- 利用 ACP 构造置信区间:
- 通过对误差 计算分位数 ,其中 。
- 定理 1:将机会约束 等价转化为确定性的不确定性感知安全约束:
- 利用 ACP 递推更新 ,保证在线可用的、模型无关的可靠不确定性区间。
2.4 关键技术 3:基于 CBF 的安全控制综合
- 优化问题:
- 其中 。
- 关键优势:由于控制输入 在残差项中保持线性,约束保持线性,整个优化为凸优化,可用 CVXPY 直接求解。
2.5 探索策略
- 引入 Thompson Sampling 在动力学参数空间采样 ,以平衡探索与利用。
3. 实验设计
3.1 仿真平台
- Cartpole(Gymnasium):状态 ,控制输入 ,目标 ;残差源自不精确物理参数 。
- 3D Quadrotor Stabilization:9 维状态,4 维控制(角速度 + 推力),目标位置 ,残差来自质量偏差 与风扰 。
- 3D Quadrotor Tracking:跟踪 8 字形轨迹,验证所学动力学的迁移能力。
3.2 对比基线
| 方法 | 描述 |
|---|---|
| MPPI-GT | 基于真实动力学的 MPPI(性能上界) |
| MPPI-RFF(LC³) | 基于标准 RFF 学习残差 |
| MPPI-ARFF | 本方法去掉安全约束 |
| MPPI-ARFF-CBF | 本方法无不确定性量化 |
| MPPI-RFF-CBF-ACP | RFF 配 ACP(用于计算时间对比) |
| SafeCARL(本文) | ARFF + CBF + ACP |
3.3 评价指标
- 奖励收敛速度与终值;安全性( 的比率,最小 值);计算时间(每回合求解时间)。
4. 资源与算力
- CPU:AMD Ryzen 7960X 24-Core 处理器用于计算时间基准。
- 求解器:CVXPY(用于 SafeCARL 的凸优化)、IPOPT(用于 RFF 基线的非线性优化)。
- 未提及:未使用 GPU,论文未明确说明每回合训练 ARFF 的具体时长或总训练壁钟时间。
- 特征数:。
5. 实验数量与充分性
- 每种场景重复 100 次独立实验以统计安全率与最小 值分布。
- 消融实验:两种平台均设置 3 组对比(无安全约束 / 仅 CBF / 含 ACP 不确定性感知),共 6 组。
- 多起点泛化测试:在四旋翼上额外测试 3 个不同起点。
- 仿真任务数:3 个任务(Cartpole、Quadrotor 稳定、Quadrotor 跟踪)。
- 充分性评估:
- 优点:实验覆盖奖励、安全、计算效率、泛化能力多个维度,统计上有 100 次重复;
- 局限:仅在仿真平台进行;未提供多次随机种子的统计显著性检验细节;对比维度偏少(仅和 LC³ 系列对比)。
6. 主要结论与发现
- 安全性:Cartpole 安全率从 LC³ 的 0% 提升到 100%;UAV 从 0% 提升到 98%(均满足 );
- 任务性能:奖励水平接近 MPPI-GT,显著优于 MPPI-RFF;
- 样本效率:约 10 个回合即可收敛;
- 计算效率:求解 Eq.(17) 耗时从 RFF 的 (Cartpole)/ (UAV)降至 / ,约 8 倍提速;
- 3D Quadrotor 跟踪:控制仿射建模减少了模型偏差,图 8 跟踪精度优于 LC³。
7. 优点
- 结构性改进:显式保留残差动力学的控制仿射结构,降低模型偏差并使 CBF 优化保持线性;
- 凸优化加速:因残差为 的线性函数,可使用 CVXPY 凸求解,求解时间数量级下降;
- 模型无关不确定性量化:ACP 不依赖特定预测模型,避免 RFF/GP 的方差低估问题;
- 理论支撑:提供定理 1 与收敛性保证,安全性可认证;
- 实用性:算法 1 简单易实现,集成于 MBRL 主循环开销低。
8. 不足与局限
- 仅仿真验证:未在真实机器人上验证,对真实噪声、模型失配、感知延迟的鲁棒性未知;
- 应用范围受限:要求系统本身具有控制仿射结构,严格控制李雅普诺夫函数类(如欠驱动系统)可能受限;
- ACP 假设:虽然 ACP 较标准 CP 弱,但仍需合理选取 与学习率 ,对非平稳分布漂移的鲁棒性未深入分析;
- 理论保证的边界:仅证明高概率 的安全性,但未分析灾难性失败时的恢复行为;
- 对比基线有限:未与 CoRL、GPR-based safe RL 等更多近期的安全 RL 方法直接对比;
- 特征数 的选择缺乏理论指导:RFF 特征的逼近误差与 的关系未深入讨论;
- 消融不够细致:没有单独分析 ARFF 与 ACP 的贡献占比(如在固定约束下对比 ARFF vs RFF 的性能差距)。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。