
何时进行规划:学习在反应式控制与审慎规划之间进行选择
When to Plan: Learning to Select Between Reactive Control and Deliberative Planning
📝 TLDR
人类能灵活切换快速反应决策与慢速深思熟虑规划,即元推理能力。在人工智能体中,反应式策略直接由状态映射到动作,但泛化能力差;基于模型的决策时规划虽鲁棒却计算开销大。本文提出一种强化学习方法,训练元推理策略以反应式策略的不确定性分数为条件分配计算,在运动规划和导航环境中证明该策略能有效判断何时依赖反应式策略、何时启用规划,并随反应式策略改进自适应偏向纯反应式控制。
🧭 速览
反应式策略泛化能力差,决策时模型规划计算开销高,如何让智能体自适应选择决策模式以兼顾速度与质量是关键挑战。
训练一个元推理策略,以反应式策略输出的不确定性分数作为条件信号,决定是否调用决策时规划进行计算分配。
在运动规划和导航环境中能准确判断何时依赖反应式策略、何时启用规划,并随反应式策略改进自适应偏向纯反应式控制。
该方法为学习型元推理提供了一种基于不确定性分配计算的实用框架,统一了反应式控制与决策时规划。
🆚 方法对比
Reactive Policy(反应式策略)
- 单次前向推理即可输出动作,速度快
- 在训练分布内表现良好
- 可通过RL或模仿学习直接训练
- 在训练分布外泛化能力差
- 无法可靠处理陌生环境状态
- 缺乏对自身不确定性感知能力
Model-based Decision-Time Planning(基于模型的决策时规划)
- 在全状态空间上产生近优动作序列
- 比反应策略泛化更鲁棒
- 不依赖训练分布的覆盖度
- 需要额外计算时间,延迟动作输出
- 仍受限于学习到的世界模型训练分布
- 计算成本高,难以实时响应
Uncertainty-conditioned Meta-reasoning Policy(不确定性条件元推理策略)
- 通过反应策略不确定性分数动态分配计算
- 能适应反应策略能力提升向纯反应控制过渡
- 在运动规划任务中回报高于固定策略基线
- 适用于序列式跨步的元层决策
- 依赖不确定性估计的准确性
- 训练复杂度高于单一策略
- 在高度随机环境中不确定性信号可能不稳定
Baselines(固定策略基线:纯反应或纯规划)
- 实现简单,无需元层学习
- 策略单一,调试和部署容易
- 无法自适应分配计算资源
- 回报低于元推理方法(如表1所示)
- 不能根据环境特性平衡反应与规划
反应式策略速度快但泛化差,规划泛化好但延迟高;本文提出的不确定性条件元推理策略通过学习反应策略的不确定性分数动态选择两者,在回报上优于纯反应或纯规划基线,并能在反应策略改进时自动向纯反应控制过渡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图

TL;DR
这篇论文研究人工智能体如何学习在「快速反应」与「慢速规划」之间自适应切换——即元推理能力。核心思路是用一个强化学习训练的元策略,以反应式策略的集成不确定性评分为条件,决定每一步该直接输出动作还是调用规划器。在运动规划与导航的5个环境中,该方法均显著优于固定范式的基线,且能随反应式策略的提升自然收敛到全反应式控制。
研究背景与动机
人类认知中「快思慢想」的双系统现象早已被心理学和认知科学广泛讨论:System 1 依赖直觉快速反应,System 2 则通过审慎推理做出更优决策。如何让机器智能体也具备这种灵活切换的能力,是人工智能领域一个根本性问题。
在现有的智能体设计范式中,反应式策略通常指那些直接将状态观测映射为动作的策略,无论是通过强化学习还是模仿学习训练。这类策略的优势在于推理速度快,单步决策几乎零延迟;然而其泛化能力往往受限于训练分布,当智能体遭遇分布外状态时,性能可能急剧下降。典型的例子是网格世界的导航策略:训练时见过的起点-终点组合表现良好,但换一对起终点就可能失效。
相比之下,决策时规划(如基于 A\* 的搜索或模型预测控制)虽然计算开销更大、决策延迟更高,但理论上能够在更广阔的状态空间中保证解的质量——只要有足够的时间和计算预算。这类方法依赖精确的环境动力学模型,在复杂场景下往往更鲁棒。
两种范式各有优劣,但现有方法通常在部署时固定选择其中之一,无法根据当前情境自适应地在速度与质量之间权衡。本文提出的核心问题是:智能体能否学会判断「当前状态是否在反应式策略的能力范围内」,从而只在必要时才付出规划的代价?这种能力在认知科学中被称为元推理。
方法
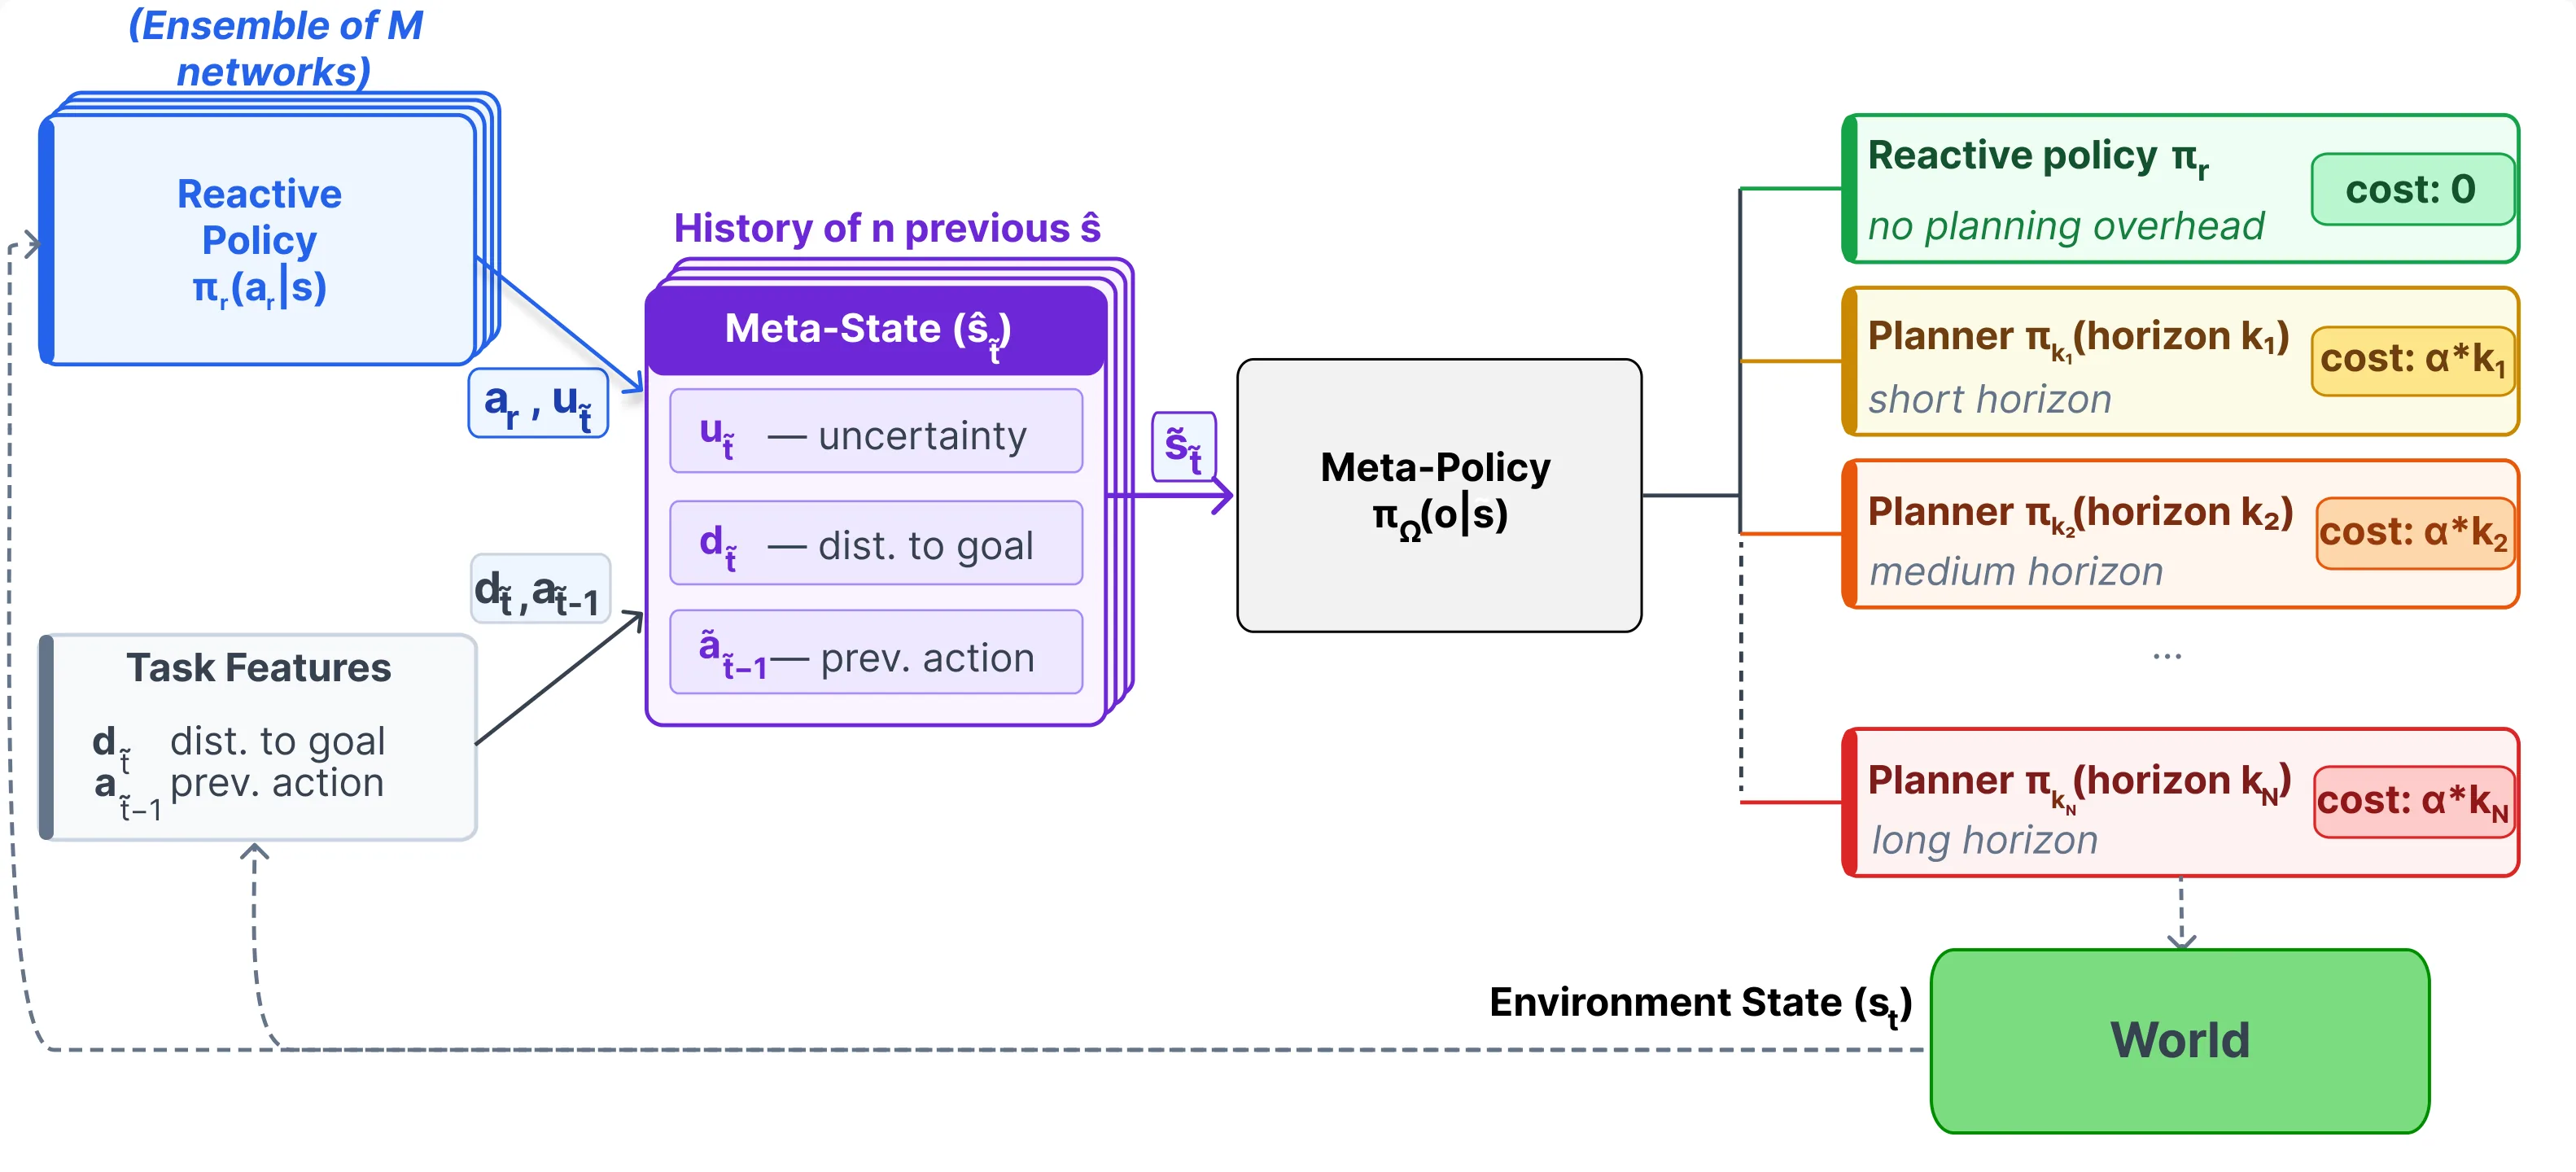
将上述问题形式化需要一套统一的框架。作者选择在 [[Options 框架]] 的基础上构建元 MDP。设原始环境 MDP 为 ,元 MDP 则扩展为 ,其中选项集合 包含两类原子选项:反应式选项 直接调用训练好的反应式策略输出动作(无额外规划代价),而规划选项 则以固定视野 调用规划器生成序列动作后开环执行。
元决策的奖励函数需要将规划的计算代价与动作执行的代价统一度量。作者将元奖励定义为
其中 表示规划的时间成本( 为规划深度成本系数), 为执行一步动作的代价。元策略的训练目标便是在到达目标的整个回合中最小化总时间代价——这自然引导其学会在「快速但可能低质量」与「慢速但更可靠」之间做出最优权衡。
元策略需要基于什么样的信息来做决策?作者设计了元观测的四个组件:反应式策略的[[不确定性估计]]分数 、到目标的距离 、上一元动作 ,以及最近 步历史(默认 )。这四个组件拼接构成元观测 。设计原则是这些信息必须能够无搜索地实时获取,同时又能反映反应式策略在当前状态下的可靠程度。
不确定性分数是整套机制的关键信号。作者采用 个神经网络的集成来估计反应式策略的认知不确定性。对于连续动作空间,取各网络输出的均值作为动作,方差之和作为不确定性
对于离散动作空间,则用均值分布的熵来度量不确定性
直观理解是:高不确定性状态往往对应分布外输入,此时反应式策略的行为不可靠,元策略应倾向于调用规划。
元策略本身通过 [[PPO]] 算法训练。训练时每个选项终止时触发一次元动作选择,元策略输出选择哪种选项继续执行。整个系统形成一种分层强化学习的结构:上层(元策略)决定「用哪种方式决策」,下层则执行具体的反应式或规划选项。
作者还探索了元策略与反应式策略的联合训练。思路很自然:先用规划器收集一些反应式策略覆盖不到的数据,然后定期用行为克隆微调反应式策略。随着反应式策略的覆盖范围扩大,其在越来越多状态上的不确定性下降,元策略自然学会减少规划调用,最终收敛到全反应式控制。这种课程式学习无需人工设计,完全由不确定性信号驱动。
实验与结果
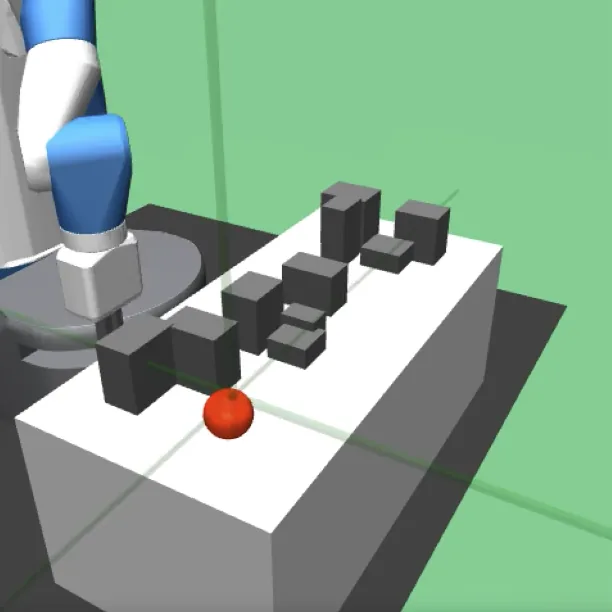
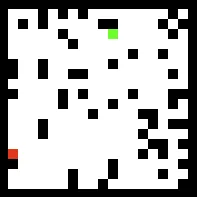
实验在5个环境中展开,涵盖离散网格世界与连续控制两类任务:Box Push(Sokoban 式推箱)、DoorKey(取钥匙开门序列)、Fetch(7自由度机械臂图像控制)、Maze(迷宫导航)和 Navigation(二维连续位移)。每个环境生成20个任务实例,一半属于反应式策略的训练分布内样本,一半为分布外测试。
主实验将元策略与固定范式基线对比,包括「总是反应式」「总是短/中/长视野规划」四种策略。在全部5个环境中,元策略均取得最优回报:Box Push 提升约2倍,Fetch 提升约2.5倍。关键在于元策略并非简单地「偶尔规划」,而是学会了根据情境选择最优策略组合。
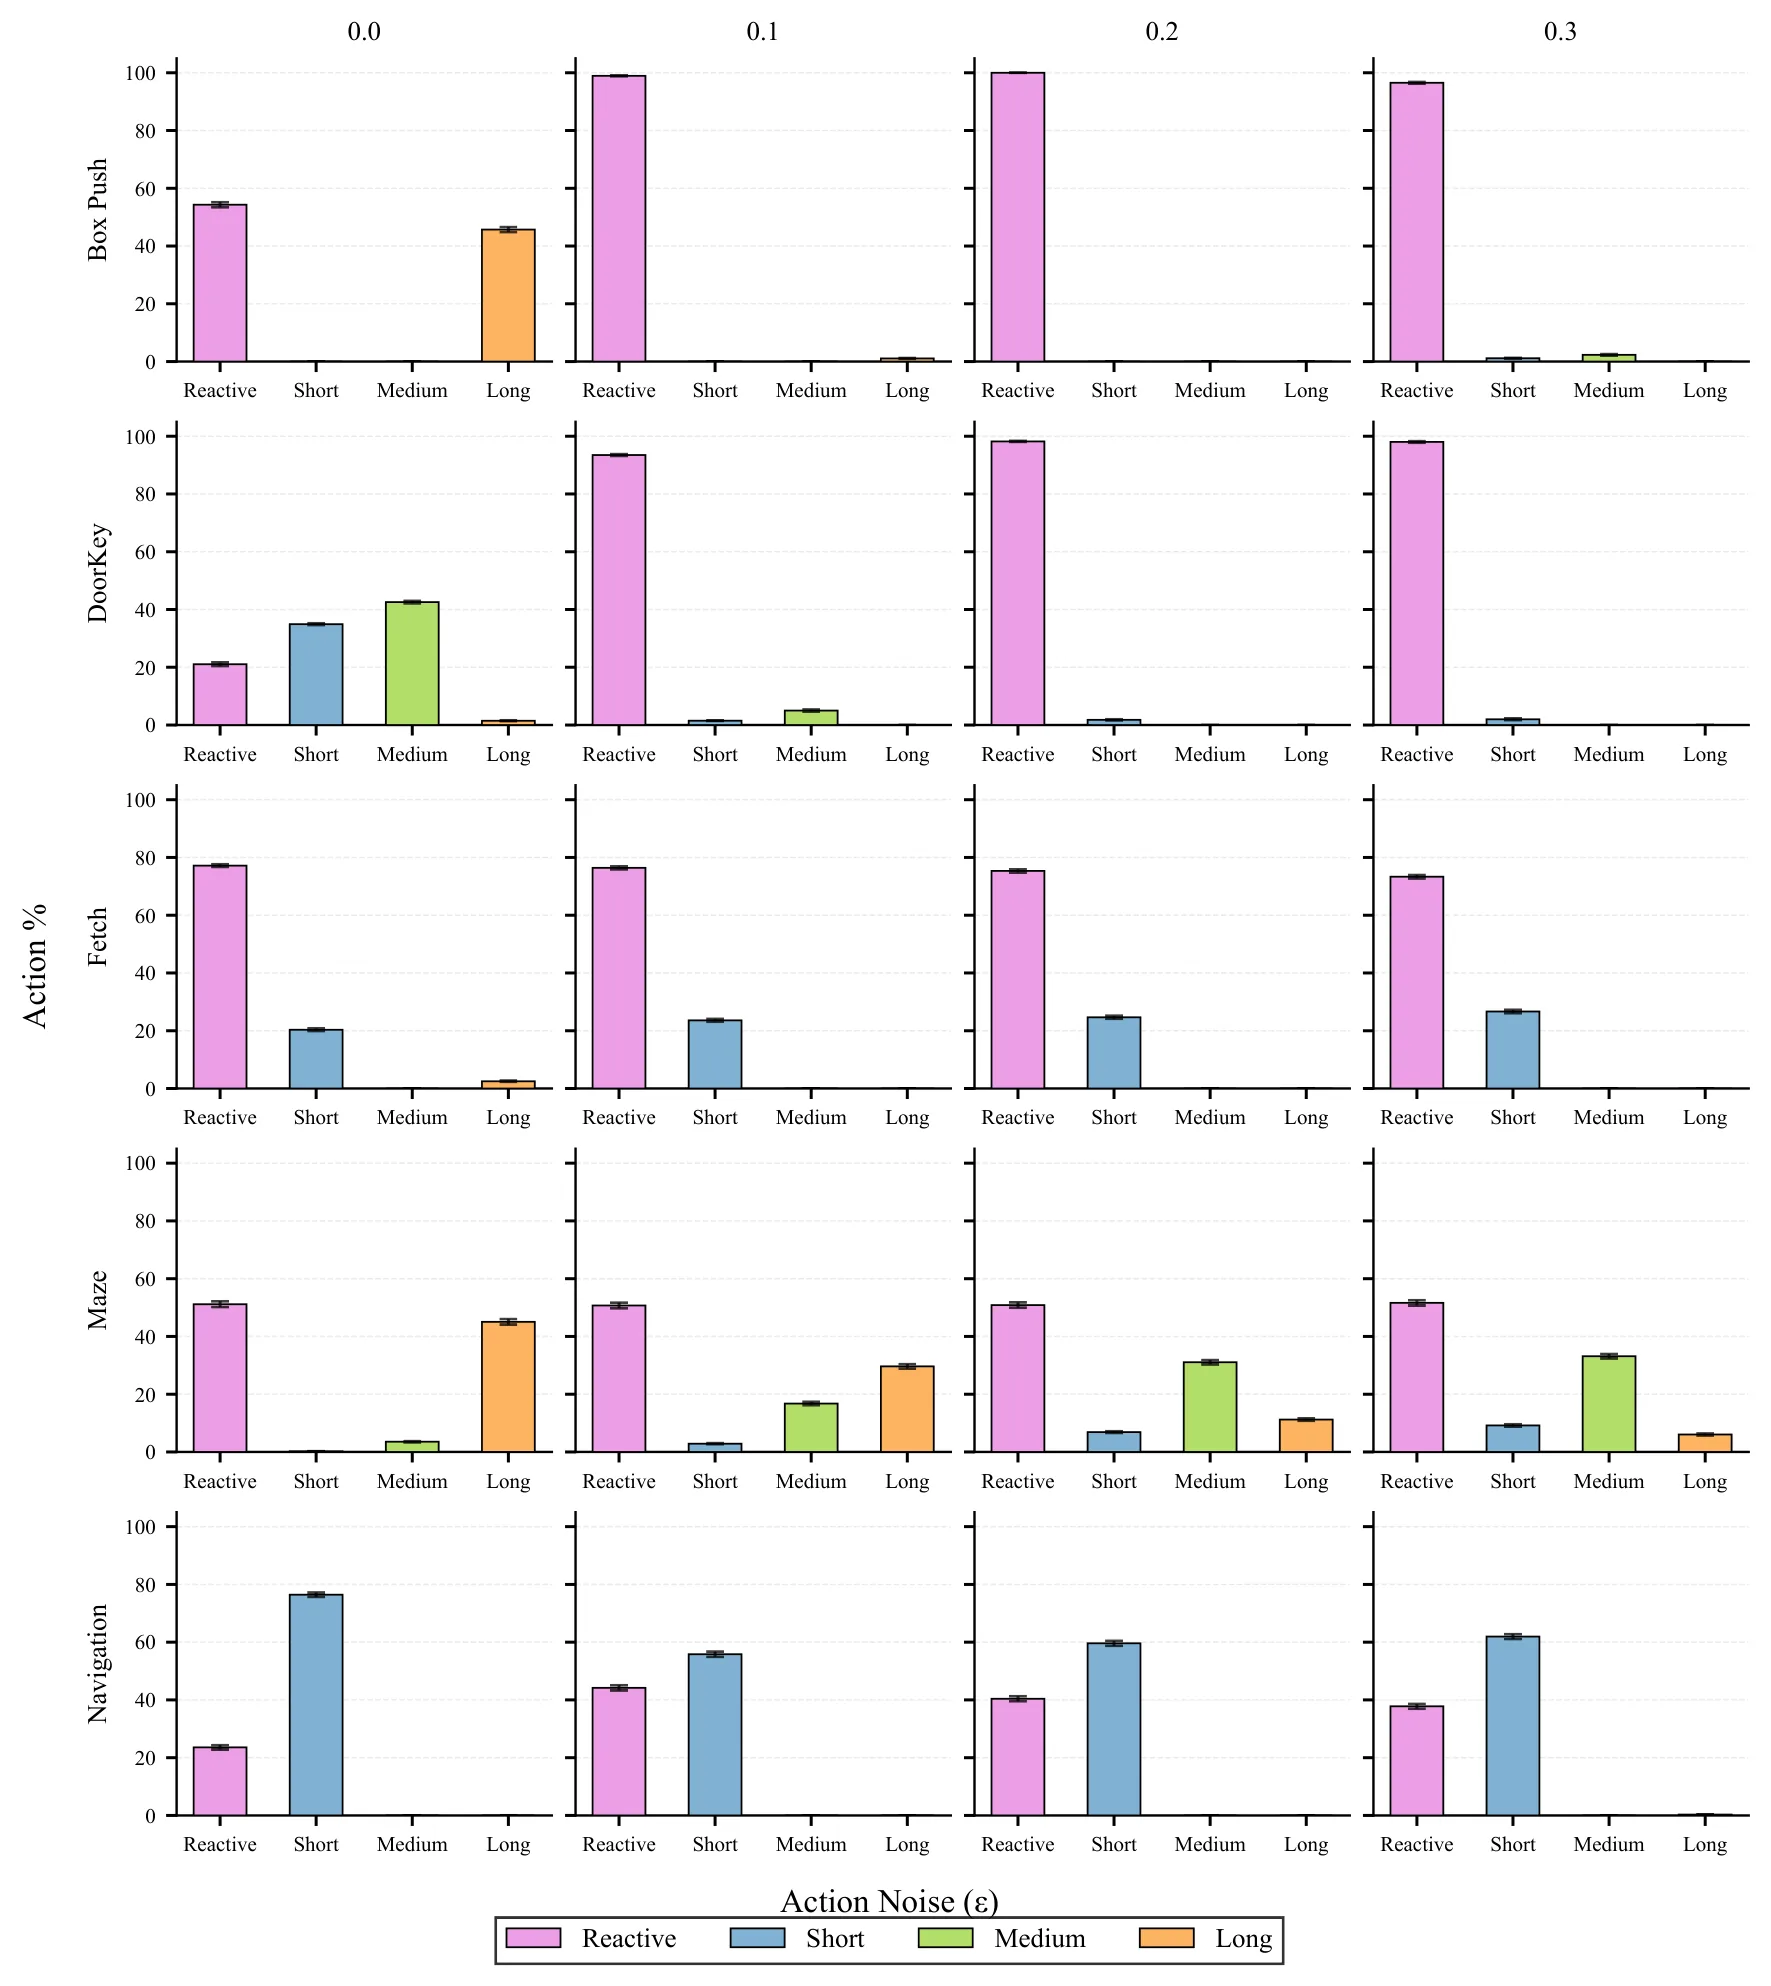
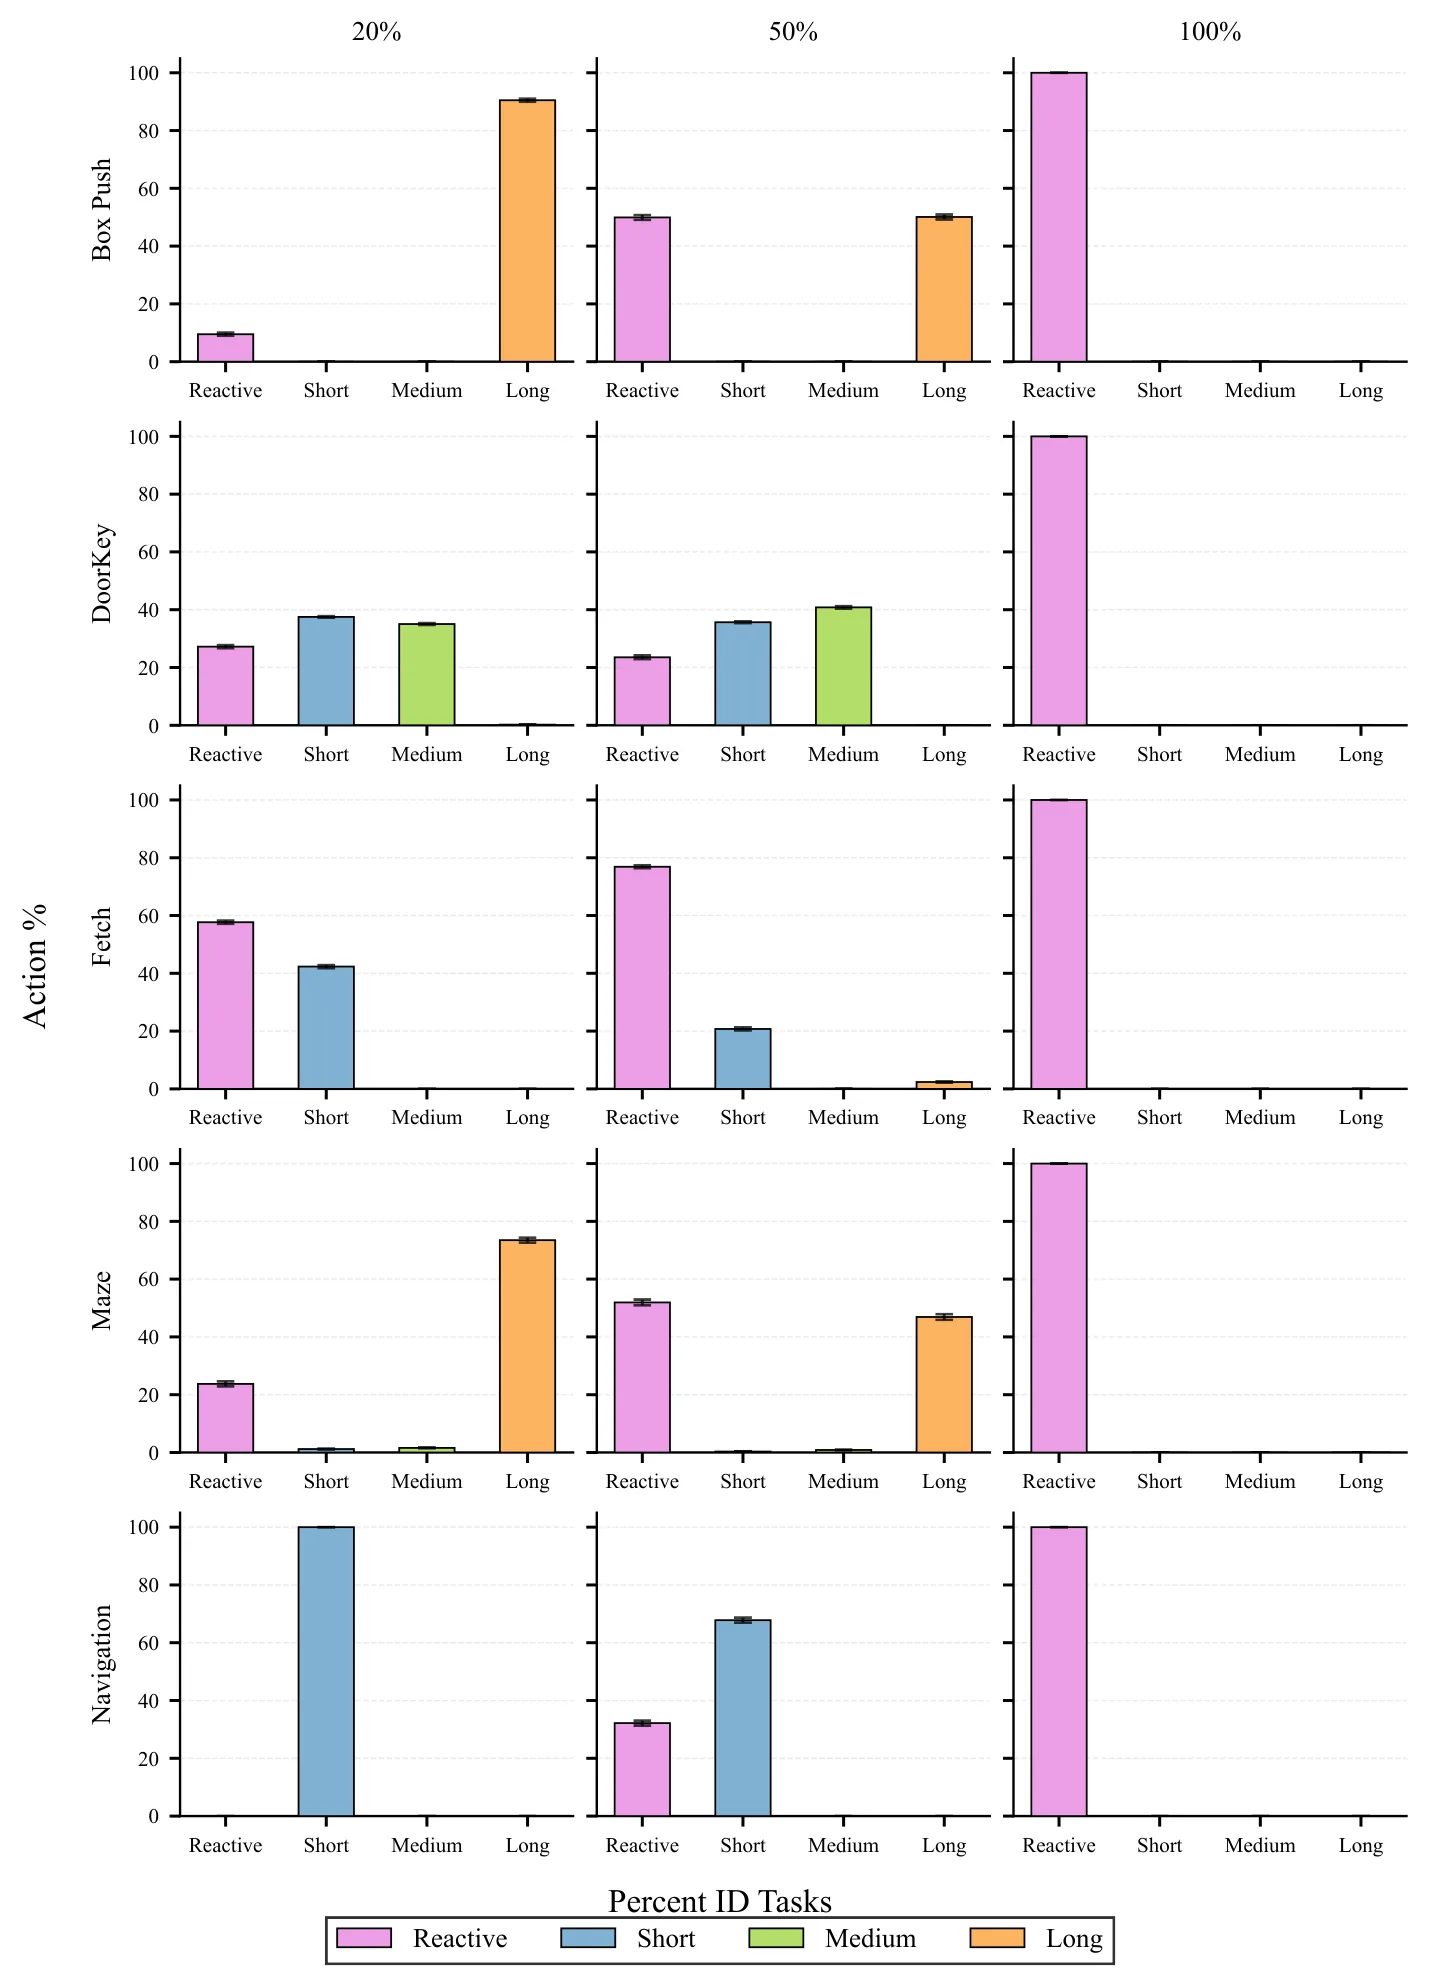
分析元动作的统计分布可以发现有趣的现象:三个环境收敛到「反应式 + 单一规划视野」的二元混合,而非三元甚至更多元。这说明元策略学会了识别「当前状态是否在反应式策略的能力圈内」这一二元判断,而非「规划视野越长越好」的线性偏好。Fetch 环境中反应式占比超过75%,而 DoorKey 主要依赖中等视野规划——这与任务结构相符:DoorKey 需要严格的钥匙-门序列,规划视野过短会导致提前失败。
观测消融实验揭示了各组件的贡献:移除 History 和 Uncertainty 在 BoxPush 和 Fetch 上导致约4.5倍和1.7倍的性能退化,是最关键的两个组件。相比之下,到目标距离和上一步元动作的影响较为有限。
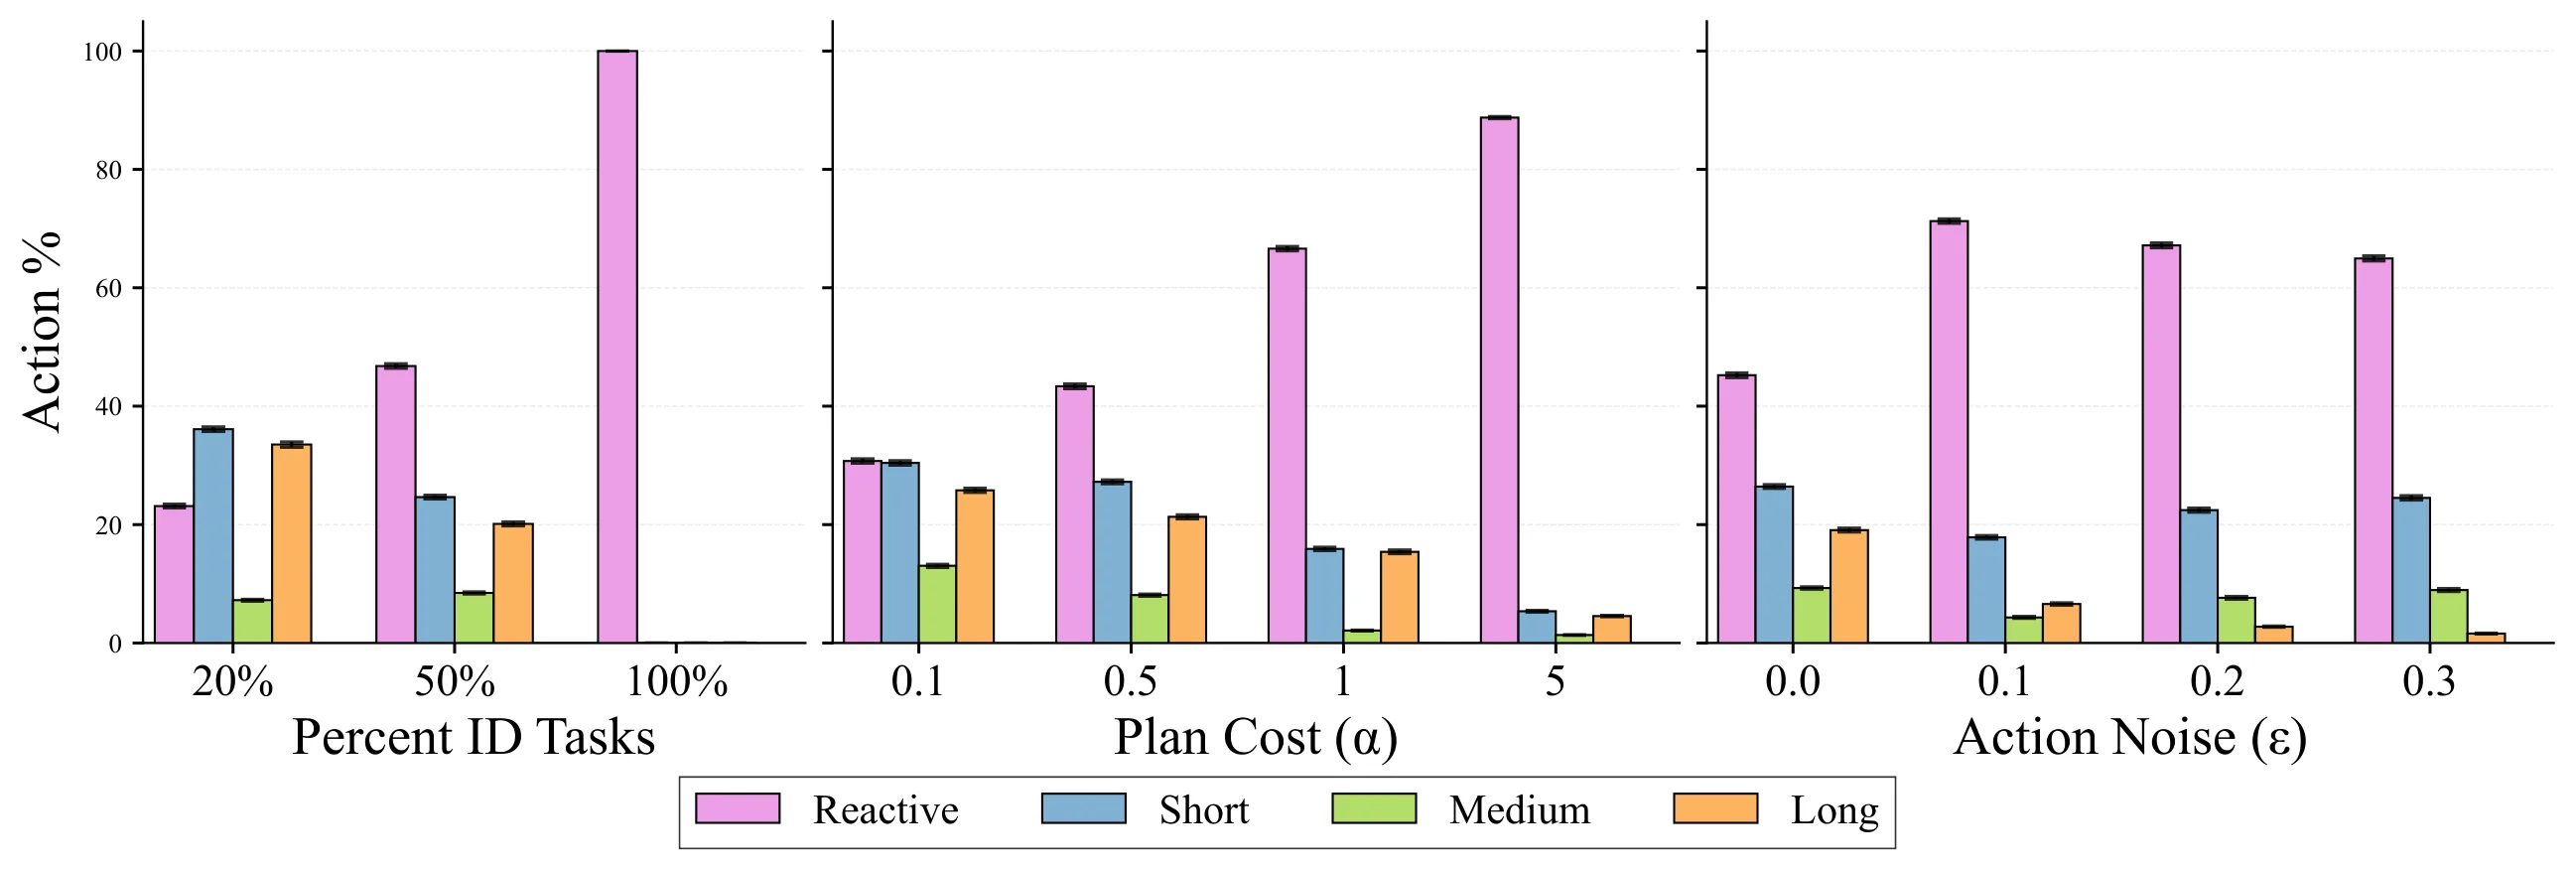
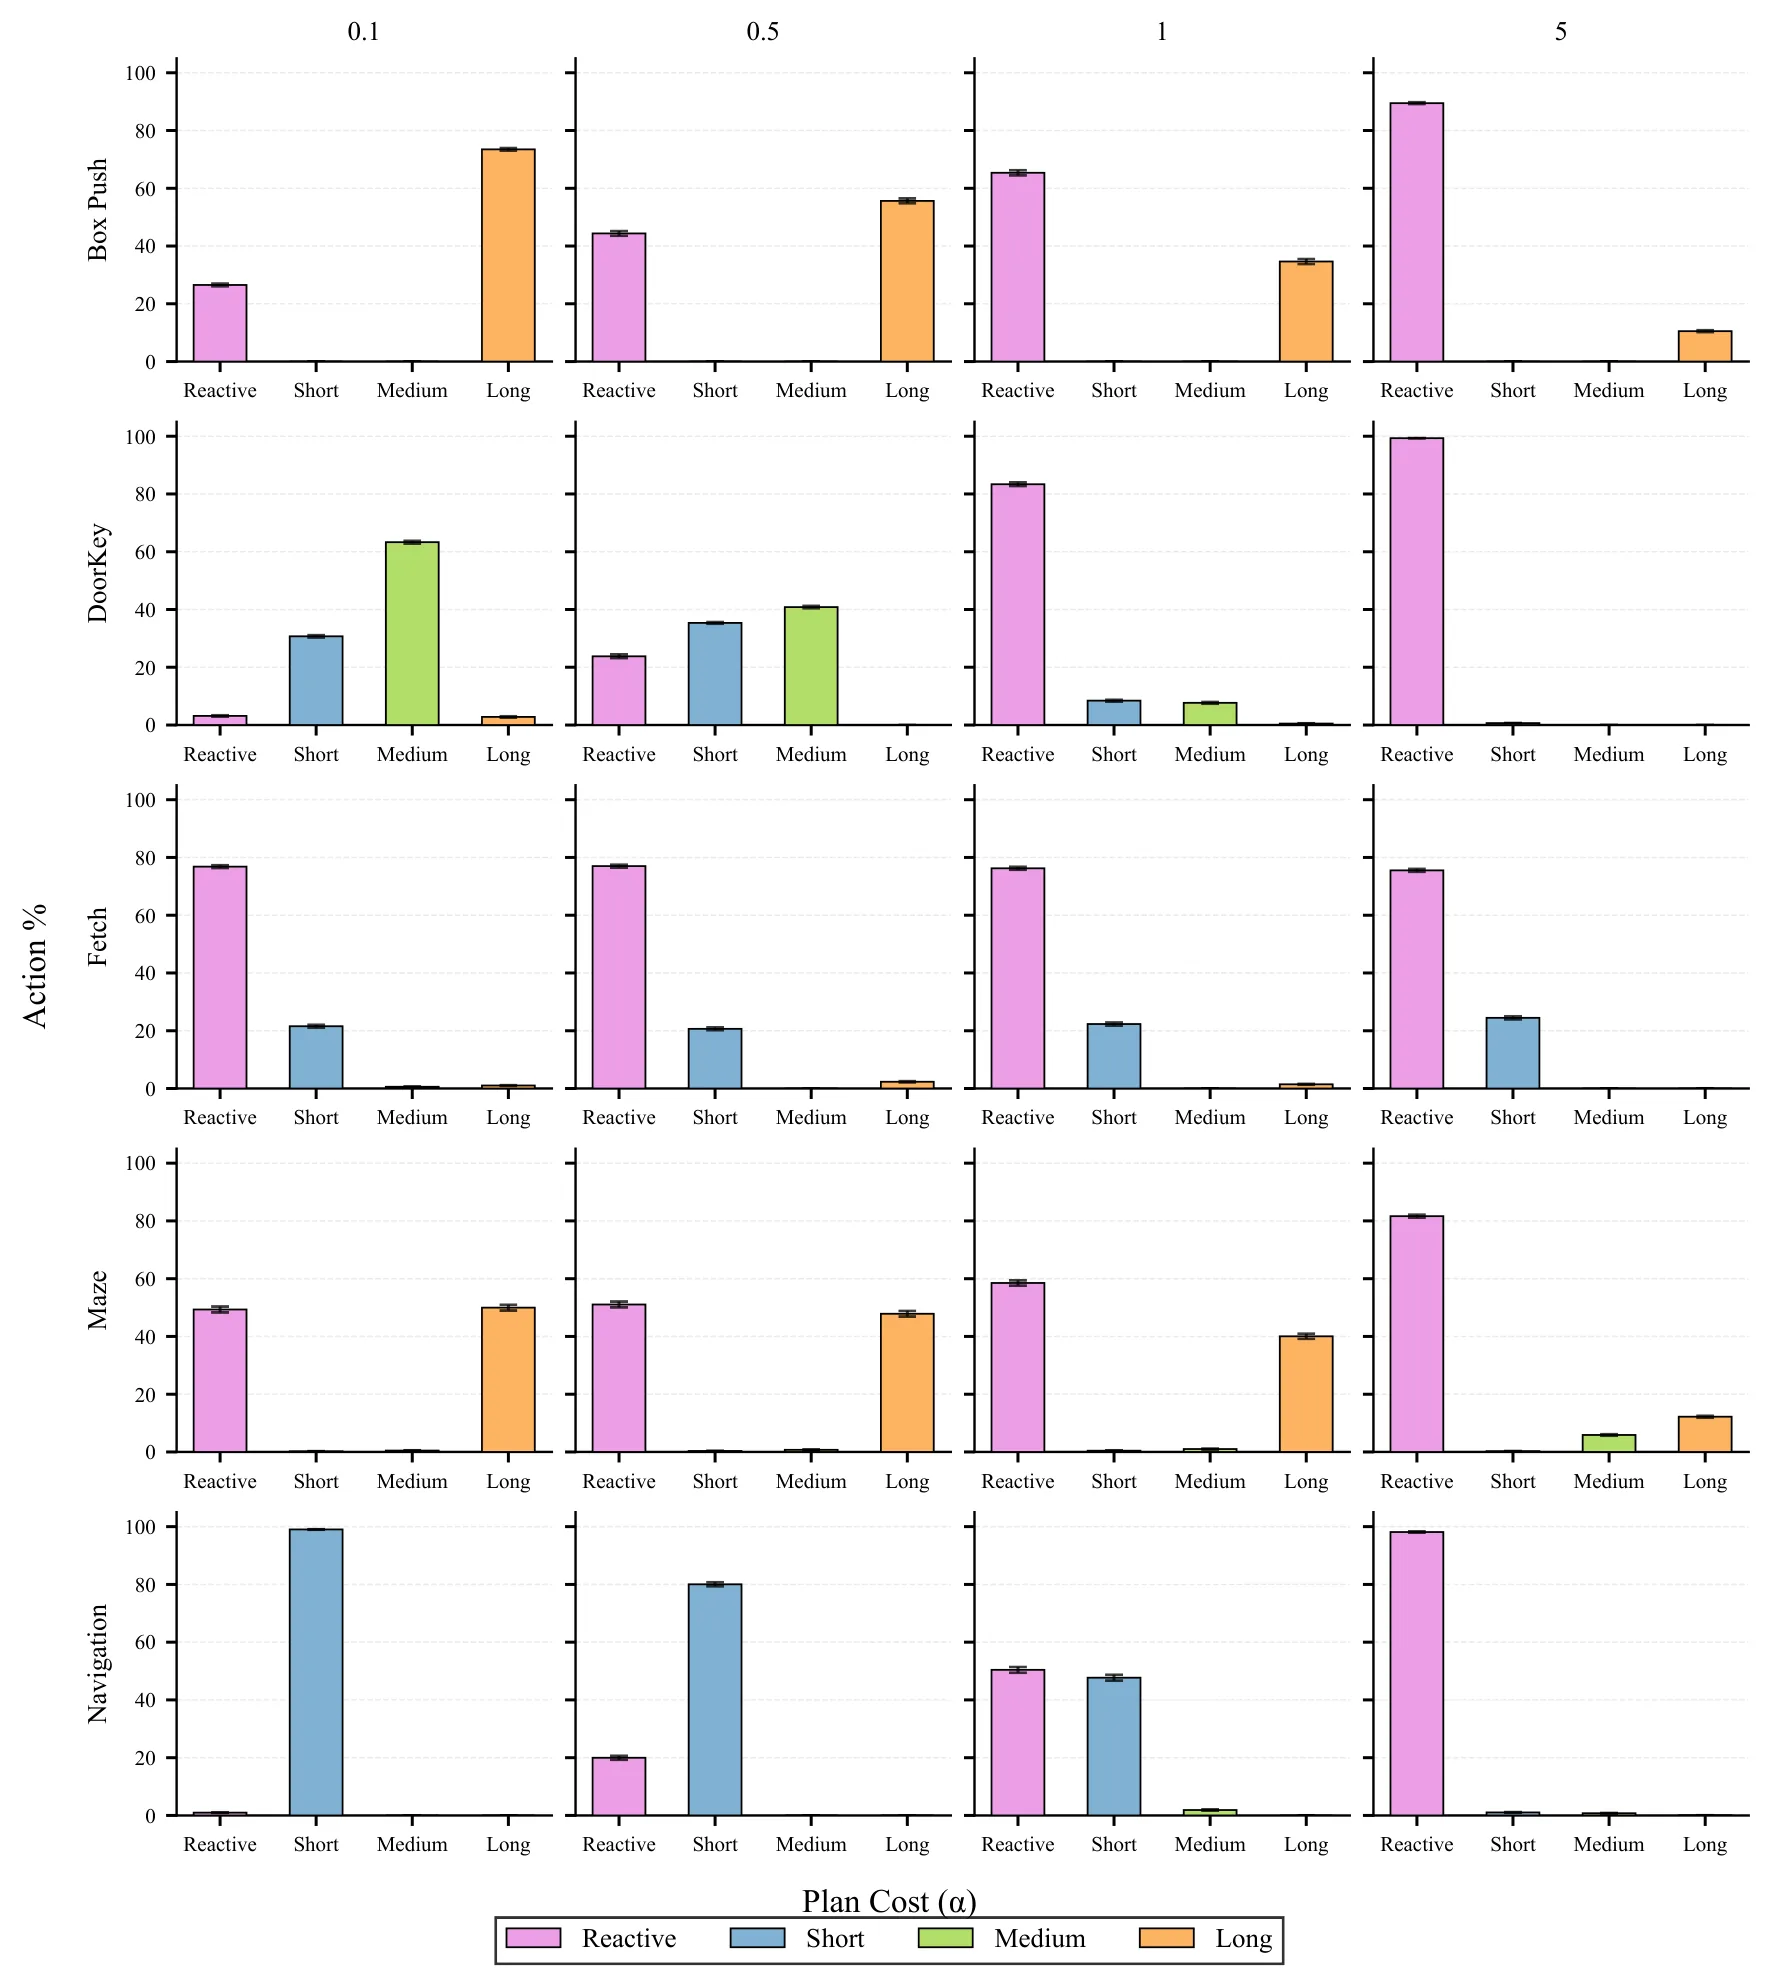
环境特性的扫描实验进一步验证了方法的适应性。当训练分布内任务比例从20%升至100%时,元策略的反应式动作占比同步上升,最终收敛到全反应式。当规划成本 提高时,元策略学会更多依赖反应式,但短/中/长三种规划的比例保持稳定——这说明元策略学到的是「何时需要规划」而非「规划多长」。环境噪声提升时,长视野规划骤降而短/中视野保留效用,反映了规划误差累积对长视野方案的敏感性。
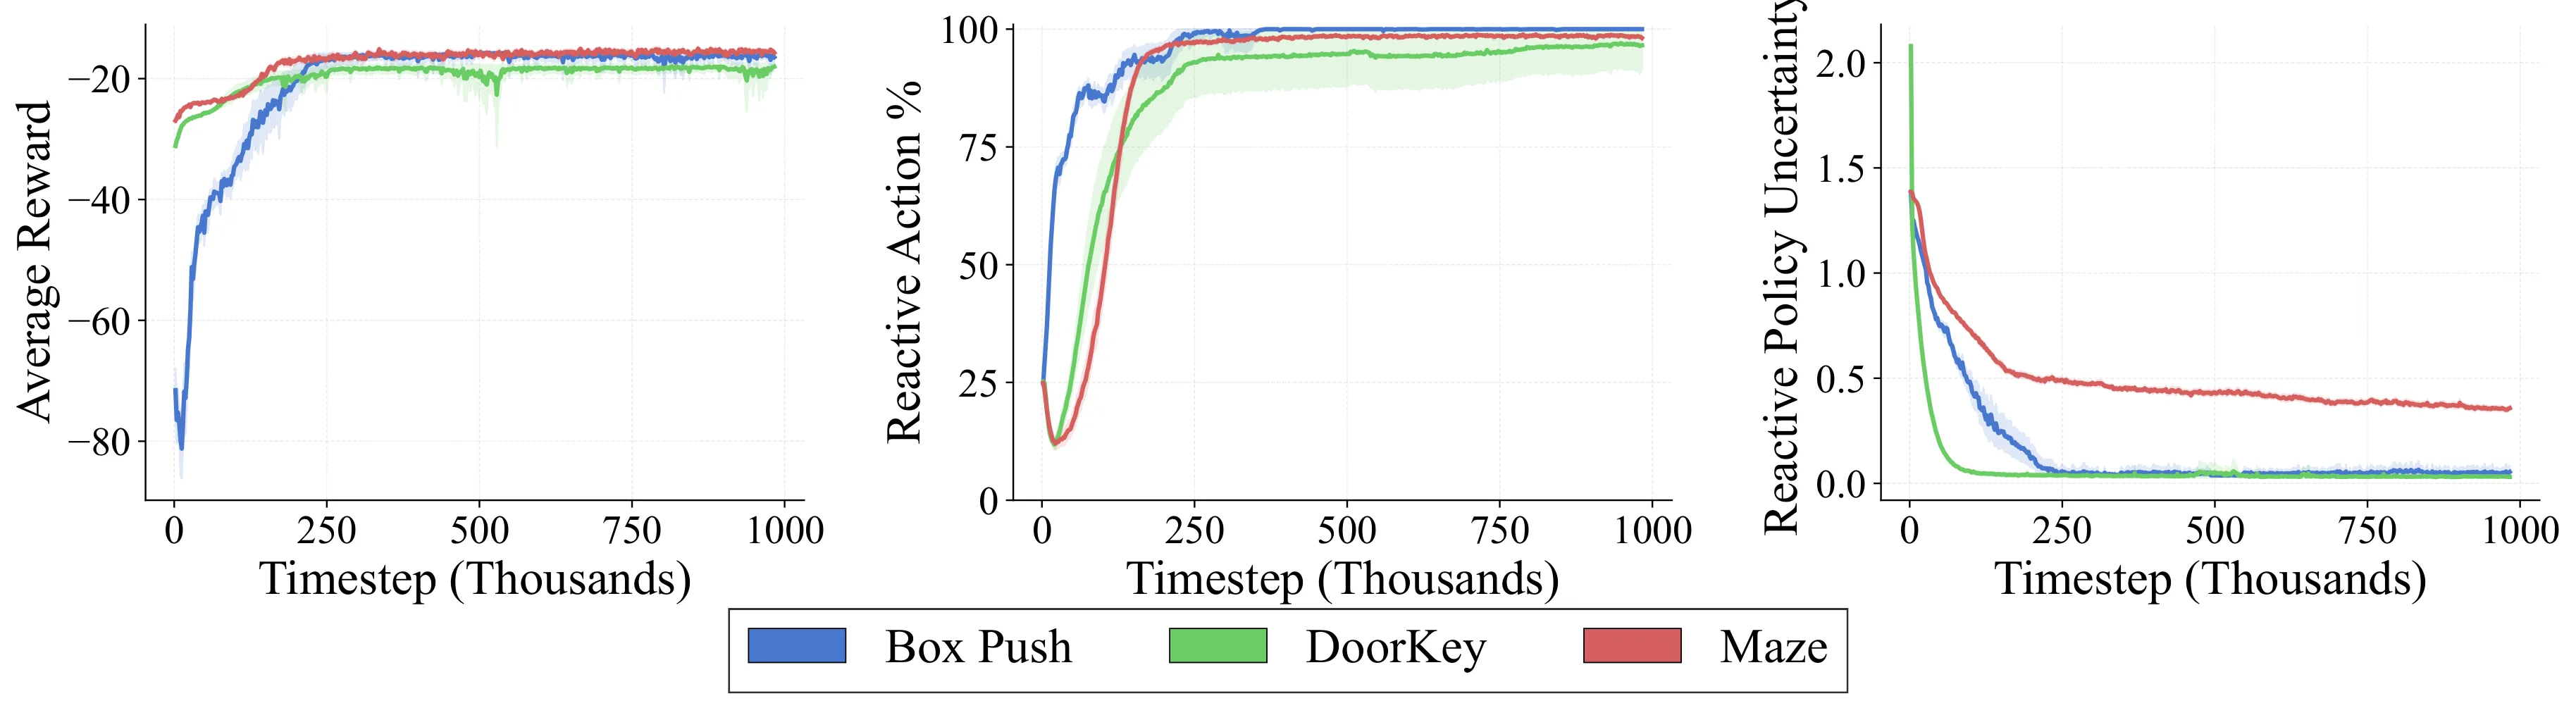
联合训练实验在 BoxPush、DoorKey 和 Maze 上验证了课程学习机制。随着反应式策略在元策略产生的 OOD 数据上被行为克隆微调,不确定性信号整体下降,元策略平滑地将规划调用率从初期的高水平降至零,达成向全反应式控制的迁移。
讨论与可借鉴点
这篇论文在 [[元推理]] 与分层强化学习的交叉点上提供了一个清晰的问题形式化和可行的解决方案。其最核心的贡献在于用不确定性作为「何时该慎思」的信标——这一设计既有认知科学的直觉支撑,又在工程上通过集成方法可实现。
值得思考的几个方向:首先,当前方案依赖精确的环境动力学模型供规划器使用,而现实系统中的模型往往是有误差的。如何在模型不确定性存在的情况下进行鲁棒的元决策,是一个尚未解决的问题。其次,不确定性分数、到目标距离等元观测组件目前需要针对任务手工设计,将其扩展到端到端从原始高维感知输入中学习不确定性,是更通用方案的关键。最后,论文仅以回合总时间为优化目标,实际应用中可能还需要考虑安全性约束、最差情况表现等额外维度。
对于更广泛的研究社区,这篇工作的启发在于:不必追求一个「全知全能」的单一策略,而是可以构建「专用快速模型 + 必要时调用通用规划」的分层架构。不确定性信号作为自适应调度的触发器,这一思路也可以迁移至 LLM 的推理时机选择、云边端模型的动态路由等场景。
摘要
人们早已认识到,人类能够在快速的反应式决策与较慢的审慎规划之间灵活切换。本文研究如何在人工智能体中学习这种被称为元推理的能力。我们将反应式决策建模为直接将状态观测映射为动作的策略。此类策略可以通过强化学习(RL)或模仿学习进行训练,但在其训练分布之外的泛化能力可能较差。另一方面,基于模型的决策时规划更有可能在更广泛的状态集合下产生良好动作,但需要额外的计算时间,从而延迟行动。在本工作中,我们提出了一种强化学习方法,用于训练一种元推理策略,该策略通过以反应式策略的不确定性评分为条件来分配计算资源。该评分使其能够预测反应式策略何时可能表现较差,以及何时需要进行规划。我们在运动规划与导航环境中进行了实证研究,结果表明该设计使元推理策略能够学会何时反应式策略能够提供足够好的动作,以及何时需要进行决策时规划。此外,我们还表明,随着反应式策略的不断改进,我们的设计能够使元智能体逐渐转向完全反应式控制。
Abstract
It has long been recognized that humans have the ability to switch between fast, reactive decision-making and slower, deliberative planning. In this paper, we study the question of how to learn this ability, known as meta-reasoning, in artificial agents. We model reactive decision-making as a policy that directly maps state observations to actions. Such policies can be trained with reinforcement learning (RL) or imitation learning, but may generalize poorly outside of their training distribution. Alternatively, model-based decision-time planning is more likely to produce good actions across a broader set of states but requires additional computation time, which delays acting. In this work, we introduce an RL method for training a meta-reasoning policy that allocates computation by conditioning on a reactive-policy uncertainty score. This score enables it to predict when the reactive policy is likely to perform poorly and when planning is needed. We conduct an empirical study on motion planning and navigation environments, showing that this design enables the meta-reasoning policy to learn when the reactive policy provides a good-enough action versus when decision-time planning is needed. Additionally, we show that our design enables the meta-agent to shift toward fully reactive control as the reactive policy improves.
论文详细总结(自动生成)
论文总结:《When to Plan: Learning to Select Between Reactive Control and Deliberative Planning》
1. 核心问题与研究动机
- 核心问题:人工智能体如何在「快速反应式控制」与「慢速审慎规划」之间进行动态选择,使决策速度与决策质量取得最优权衡。
- 问题背景:
- 反应式策略(如基于 model-free RL 或模仿学习的策略)单次推理快,但泛化能力差,仅在训练分布内表现良好,在分布外(OOD)状态上可能产生低质量动作。
- 决策时规划(如 A\* 搜索)跨全状态空间鲁棒性较强,但计算开销大、延迟高。
- 现有方法通常在测试时固定一种决策范式(全反应 / 全规划),缺乏自适应分配算力的机制。
- 理论定位:本文属于 AI 元推理(meta-reasoning)研究,目标是将「System 1 / System 2」思想操作化为可学习的算力分配策略。
- 形式化挑战:元推理本身是一个序列决策问题,要求智能体在整条任务轨迹中持续判断「何时反应、何时规划」。
2. 方法论
2.1 元推理的形式化(基于 Options 框架)
- 在标准 MDP 基础上,构造元 MDP:
- 选项(Options)集合 包含两类:
- 反应式选项 (一步选项,无规划代价)。
- 规划选项 (固定规划视野 ,生成序列 后开环执行)。
- 代价模型(统一为时间单位):
其中 表示规划代价, 为执行一步代价, 为规划深度成本系数。
- 目标:在到达目标的回合内最小化总时间(同时优化规划与执行代价)。
2.2 元观测设计
元观测 由三部分拼接而成,需满足「可无搜索计算」与「反映反应式策略实时能力」两个要求:
- :反应式策略的不确定性分数。
- :到目标的距离。
- :上一元动作。
- 元状态 还拼接最近 步历史(论文默认 ),形成短时趋势信息。
2.3 不确定性估计(反应式策略集成)
反应式策略采用 个神经网络集成的形式(Lakshminarayanan et al., 2017):
- 连续动作:
- 离散动作:用均值分布的熵表示不确定性:
- 设计动机:高不确定性 ≈ OOD 输入 → 元策略据此推断反应式策略是否可靠,是否需要规划。
2.4 元策略训练
- 使用 PPO(Stable Baselines3 默认超参数)训练元策略 ,奖励由规划代价 + 执行代价构成。
- 元决策时机:每个选项终止时触发一次元动作选择。
2.5 联合训练扩展
- 在元策略训练期间,将规划器产生的数据加入回放缓冲,每隔若干回合用行为克隆对反应式策略进行微调。
- 形成自然课程:元策略先调用规划收集 OOD 数据 → 反应式策略扩展覆盖 → 元策略识别不确定性下降 → 收敛到全反应式控制。
3. 实验设计
3.1 环境套件(5 个,全部为导航/运动规划任务)
- Box Push:6×6 Sokoban 式离散网格,三箱任务,动作不可逆。
- DoorKey:MiniGrid 改编,离线符号化观测,需取钥匙→开门→到达目标。
- Fetch:7-DOF 机械臂基于图像的 Fetch Reach,含障碍(Cartesian→Joint 通过 IK)。
- Maze:迷宫型网格世界,每个布局含 5 个起终点对,反应式策略接受图像输入。
- Navigation:二维连续位移控制,图像输入。
3.2 训练设置
- 每个环境生成 20 个任务,一半归为反应式 in-distribution(ID),一半为 OOD。
- 规划器:A\(离散)/ lattice A\(连续),以最大搜索深度近似时间预算。
- 三个规划视野(短/中/长)= 任务视野的 15%/30%/50%。
- 默认规划成本 。
3.3 对比方法
- 基线:Always-React、Always-Short-Plan、Always-Medium-Plan、Always-Long-Plan。
- 消融对象:依次去掉 Distance / History / Previous Action / Uncertainty 中的一个。
3.4 主要实验维度
1. 主结果:固定计算基线对比(Table 1)。
2. 元动作分布(Table 2)。
3. 观测空间消融(Table 3)。
4. 环境特性扫描(图 3):
- ID 任务比例(20% / 50% / 100%)。
- 规划成本 (0.1 / 0.5 / 1 / 5)。
- 环境动作噪声 (0 / 0.1 / 0.2 / 0.3)。
5. 联合训练曲线(图 4):在 BoxPush、DoorKey、Maze 上展示回报、反应式占比、不确定性随时间收敛过程。
4. 资源与算力
- 论文未明确披露使用的 GPU 型号、数量或总训练时长。
- 仅在第 6.6 节联合训练实验中提到「因算力限制,仅在 BoxPush、DoorKey、Maze 三个环境上开展,未包含 Fetch 与 Navigation」,说明存在明显算力约束。
- 评估规模可估算的统计量:
- 主实验每组 30 个独立种子,每种子 300 个评估回合。
- 联合训练同样使用 30 个种子(具体时长未披露)。
5. 实验数量与充分性
- 实验规模:
- 5 个环境 × 主结果 + 4 项观测消融 + 3 类环境特性扫描 + 1 项联合训练 = 至少 9 个独立实验分支。
- 附录 C 提供了按环境拆分的环境特性曲线,进一步增加数据点。
- 统计严谨性:
- 全部结果均带 95% bootstrap 置信区间,置信区间宽度显式报告。
- Table 1 中用「加粗 + 与最佳者置信区间重叠」的判断方式标注显著差异。
- 30 种子 × 300 回合的样本量较大,能为结论提供一定稳定性保障。
- 评估的客观性:
- 基线覆盖了所有「单一范式」策略;消融覆盖了元观测的每个组成。
- 唯一明显不足:联合训练缺乏与「仅冻结反应式策略」「仅更新反应式策略」等基线的对比,难以拆解收益究竟来自元策略适应性还是反应式策略本身。
6. 主要结论与发现
- 整体性能:在 5 个环境上,元策略均取得优于全部固定计算基线的回报(Box Push ≈ 2× 改进,Fetch ≈ 2.5× 改进)。
- 元动作分布呈现环境特征:
- 三环境收敛到「反应式 + 单一规划视野」二元混合;Fetch 主要走反应式(>75%),DoorKey 主要走中等视野规划。
- 导航中反应式策略偶尔陷入停滞,元策略能识别并切到规划。
- 观测消融:History 与 Uncertainty 是关键组件,移除后在 BoxPush(4.5× 退化)与 Fetch(1.7× 退化)上退化最显著;其余三项在多数环境中影响较小。
- 环境特性响应:
- ID 任务比例提升 → 反应式动作占比同步上升;100% ID 时收敛到全反应式。
- 规划成本 提升 → 反应式占比上升,但长/中/短规划比例保持稳定(元策略学会「何时规划」而非「规划多长」)。
- 环境噪声 上升 → 长规划骤降(误差累积敏感),但短/中规划保留效用。
- 联合训练:随着反应式策略在元策略调用规划产生的轨迹上被行为克隆微调,不确定性信号整体下降,元策略平滑迁移到完全反应式控制。
7. 优点
- 问题形式化清晰:把「何时规划」建模为可学习的序列元决策问题(Options + meta-MDP),比单步选择更贴合实际部署需求。
- 观测设计简洁可解释:不确定性 + 距离 + 历史 + 上一步动作,三组件均无需搜索计算,便于实际部署。
- 不确定性信号机制合理:基于集成网络的方差/熵估计,无需额外训练,与认知科学中「OOD 触发慎思」的假设一致。
- 实验系统性强:覆盖多环境、多基线、多消融、多环境变量扫描以及联合训练,多角度验证方法鲁棒性。
- 统计严谨:大种子数 + bootstrap 置信区间,结论可信度较高。
- 与现实场景的连接:讨论部分直接指出该机制可迁移至 LLM 推理时机选择与云边端机器人模型路由,具有应用前景。
8. 不足与局限
- 依赖完美的世界模型:规划器均使用精确(已知)动力学模型,真实场景中模型本身存在误差;论文明确指出未来需引入模型不确定性。
- 观测依赖手工特征:不确定性、距离等都需要针对任务设计,不能直接迁移到纯高维图像等设置。
- 环境受限:任务均为单智能体、规划期环境静止的设定,不允许中途打断正在执行的规划。
- 算力披露缺失:未报告硬件型号、总训练时长与碳足迹等,复现成本难以估算。
- 联合训练对照不足:未与冻结反应式策略 / 仅迭代反应式策略的基线做对照,难以隔离元策略自适应带来的增量收益。
- 评估指标单一:仅以回合总时间代价为回报,缺少安全性、最差回合表现、不同种子稳定性等补充维度。
- 规模有限:5 个环境均为中小规模导航/抓取类,未在自动驾驶、真实机器人或大规模仿真基准上验证。
- 基准策略偏弱:固定基线不包含「基于规则启发式的不确定性切换」等更聪明的对手,对比说服力可能受限。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。