
用于流媒体视频游戏中鲁棒且高效模仿学习的增广方法
Augmentations for Robust and Efficient Imitation Learning in Streamed Video Games
📝 TLDR
在流媒体3D游戏场景中,模仿学习训练游戏代理面临演示数据昂贵和网络传输引入时空伪影导致协变量偏移的问题。本文提出面向流媒体的四类时空数据增强方法(像素化块、抹除、全局模糊、鬼影),并基于预测逆动力学模型PIDM实现。实验表明该方法在稳定条件下性能提升最高达41%,在网络延迟场景下性能仅下降7.45%,显著优于基线49.82%的降幅。该工作证明针对流媒体特性设计的时空增强是提升游戏代理鲁棒性与数据效率的简洁有效手段。
🧭 速览
模仿学习训练3D游戏代理成本高,且流媒体传输引入时空相关视觉伪影,造成测试时协变量偏移,亟需鲁棒且数据高效的解决方案。
提出四种模拟低带宽流媒体伪影的时空数据增强(像素块、抹除、模糊、鬼影),并将其集成到预测逆动力学模型PIDM的潜在表征空间中。
在三个3D游戏任务上,稳定条件下性能最高提升41%;引入网络延迟时性能仅下降7.45%,远优于无增强基线的49.82%降幅。
针对流媒体场景设计的时空数据增强是简单而有效的工具,可显著提升游戏代理的鲁棒性与数据效率。
🆚 方法对比
Streaming Augmentations
- 提升样本效率高达41%
- 网络延迟下性能仅下降7.45%
- 针对四类流媒体伪影设计
- 简单即插即用无需修改架构
- 仅覆盖四种特定伪影类型
- 时间相关性模拟依赖固定参数
- 在稳定条件下提升幅度有限
PIDM (Predictive Inverse Dynamics Models)
- 在潜空间中分解决策过程
- 提高离线IL数据效率
- 结合未来状态条件与逆动力学
- 无需奖励信号或在线交互
- 依赖近期帧历史表示状态
- 训练复杂度较高
- 在流媒体伪影下仍易失效
Standard Image Augmentations (RAD/DrQ)
- 提升视觉控制泛化能力
- 改善数据效率
- 实现简单成熟可靠
- 帧间独立采样缺乏时间一致性
- 无法应对流媒体结构性伪影对协变量偏移鲁棒性不足
Domain Randomization
- 增强对分布偏移的鲁棒性
- 训练场景多样化提升泛化
- 与底层动态无关
- 原本针对纹理/光照/相机
- 未针对压缩/延迟等信道伪影
- 随机化策略可能引入噪声
本文核心提出Streaming Augmentations并实例化于PIDM框架,相比RAD/DrQ等标准图像增强方法,前者通过时间相关伪影建模显著提升流媒体场景下的鲁棒性,与Domain Randomization形成信道级随机化的互补关系。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
TL;DR
这篇论文针对流媒体 3D 游戏中的模仿学习问题,提出了一组针对网络传输伪影设计的时空数据增强方法(像素化块、抹除、全局模糊、鬼影),并在预测逆动力学模型 PIDM 上验证。实验结果显示,在相同数据预算下,增广方法带来最高 41% 的性能提升;面对网络延迟时,使用增广训练的智能体性能仅下降 7.45%,而基线方法的性能跌幅高达 49.82%。这表明针对流媒体场景量身定制的增强策略是训练鲁棒游戏智能体的简洁有效手段。
研究背景与动机
在三维复杂游戏环境中,让智能体学会像人类一样决策是一项极具挑战的任务。[[模仿学习]]提供了一条可行的路径:智能体通过观察人类玩家的视觉输入与对应动作,建立从观测到行为的映射关系。然而,这种方法在实际部署中面临两个核心困难。
首先,高质量的人类演示数据代价高昂。训练一个能在现代 3D 游戏中稳定运行的智能体,通常需要数千乃至数万帧的专家级演示,这些数据的采集与标注需要耗费大量人力与时间。其次,现代游戏越来越多地通过流媒体方式运行——玩家的客户端并不存储完整的游戏程序,而是实时接收服务器传输的编码视频流。这种架构虽然降低了客户端的硬件门槛,却也引入了网络传输特有的视觉伪影:带宽受限时画面会出现块状失真,网络波动时可能产生局部涂抹痕迹,帧率不稳定时会出现全局模糊,运动物体周围则可能留下重影(鬼影效应)。
这些伪影看似只是视觉层面的瑕疵,却会在测试时造成严重的[[协变量偏移]]问题。训练时智能体看到的是清晰完整的游戏画面,而部署时接收的却是带有各种伪影的流媒体帧。分布的微小变化足以让一个在干净数据上表现优异的策略完全失效,导致智能体性能断崖式下跌。如何在有限的演示数据上训练出对这类伪影具有鲁棒性的策略,成为一个亟待解决的问题。
方法
面对上述挑战,本文的核心思路是「既然无法改变网络条件,那就让智能体在训练时就习惯这些伪影」。具体而言,作者设计了一组四类时空数据增强方法,模拟低带宽网络连接下常见的视觉伪影类型。
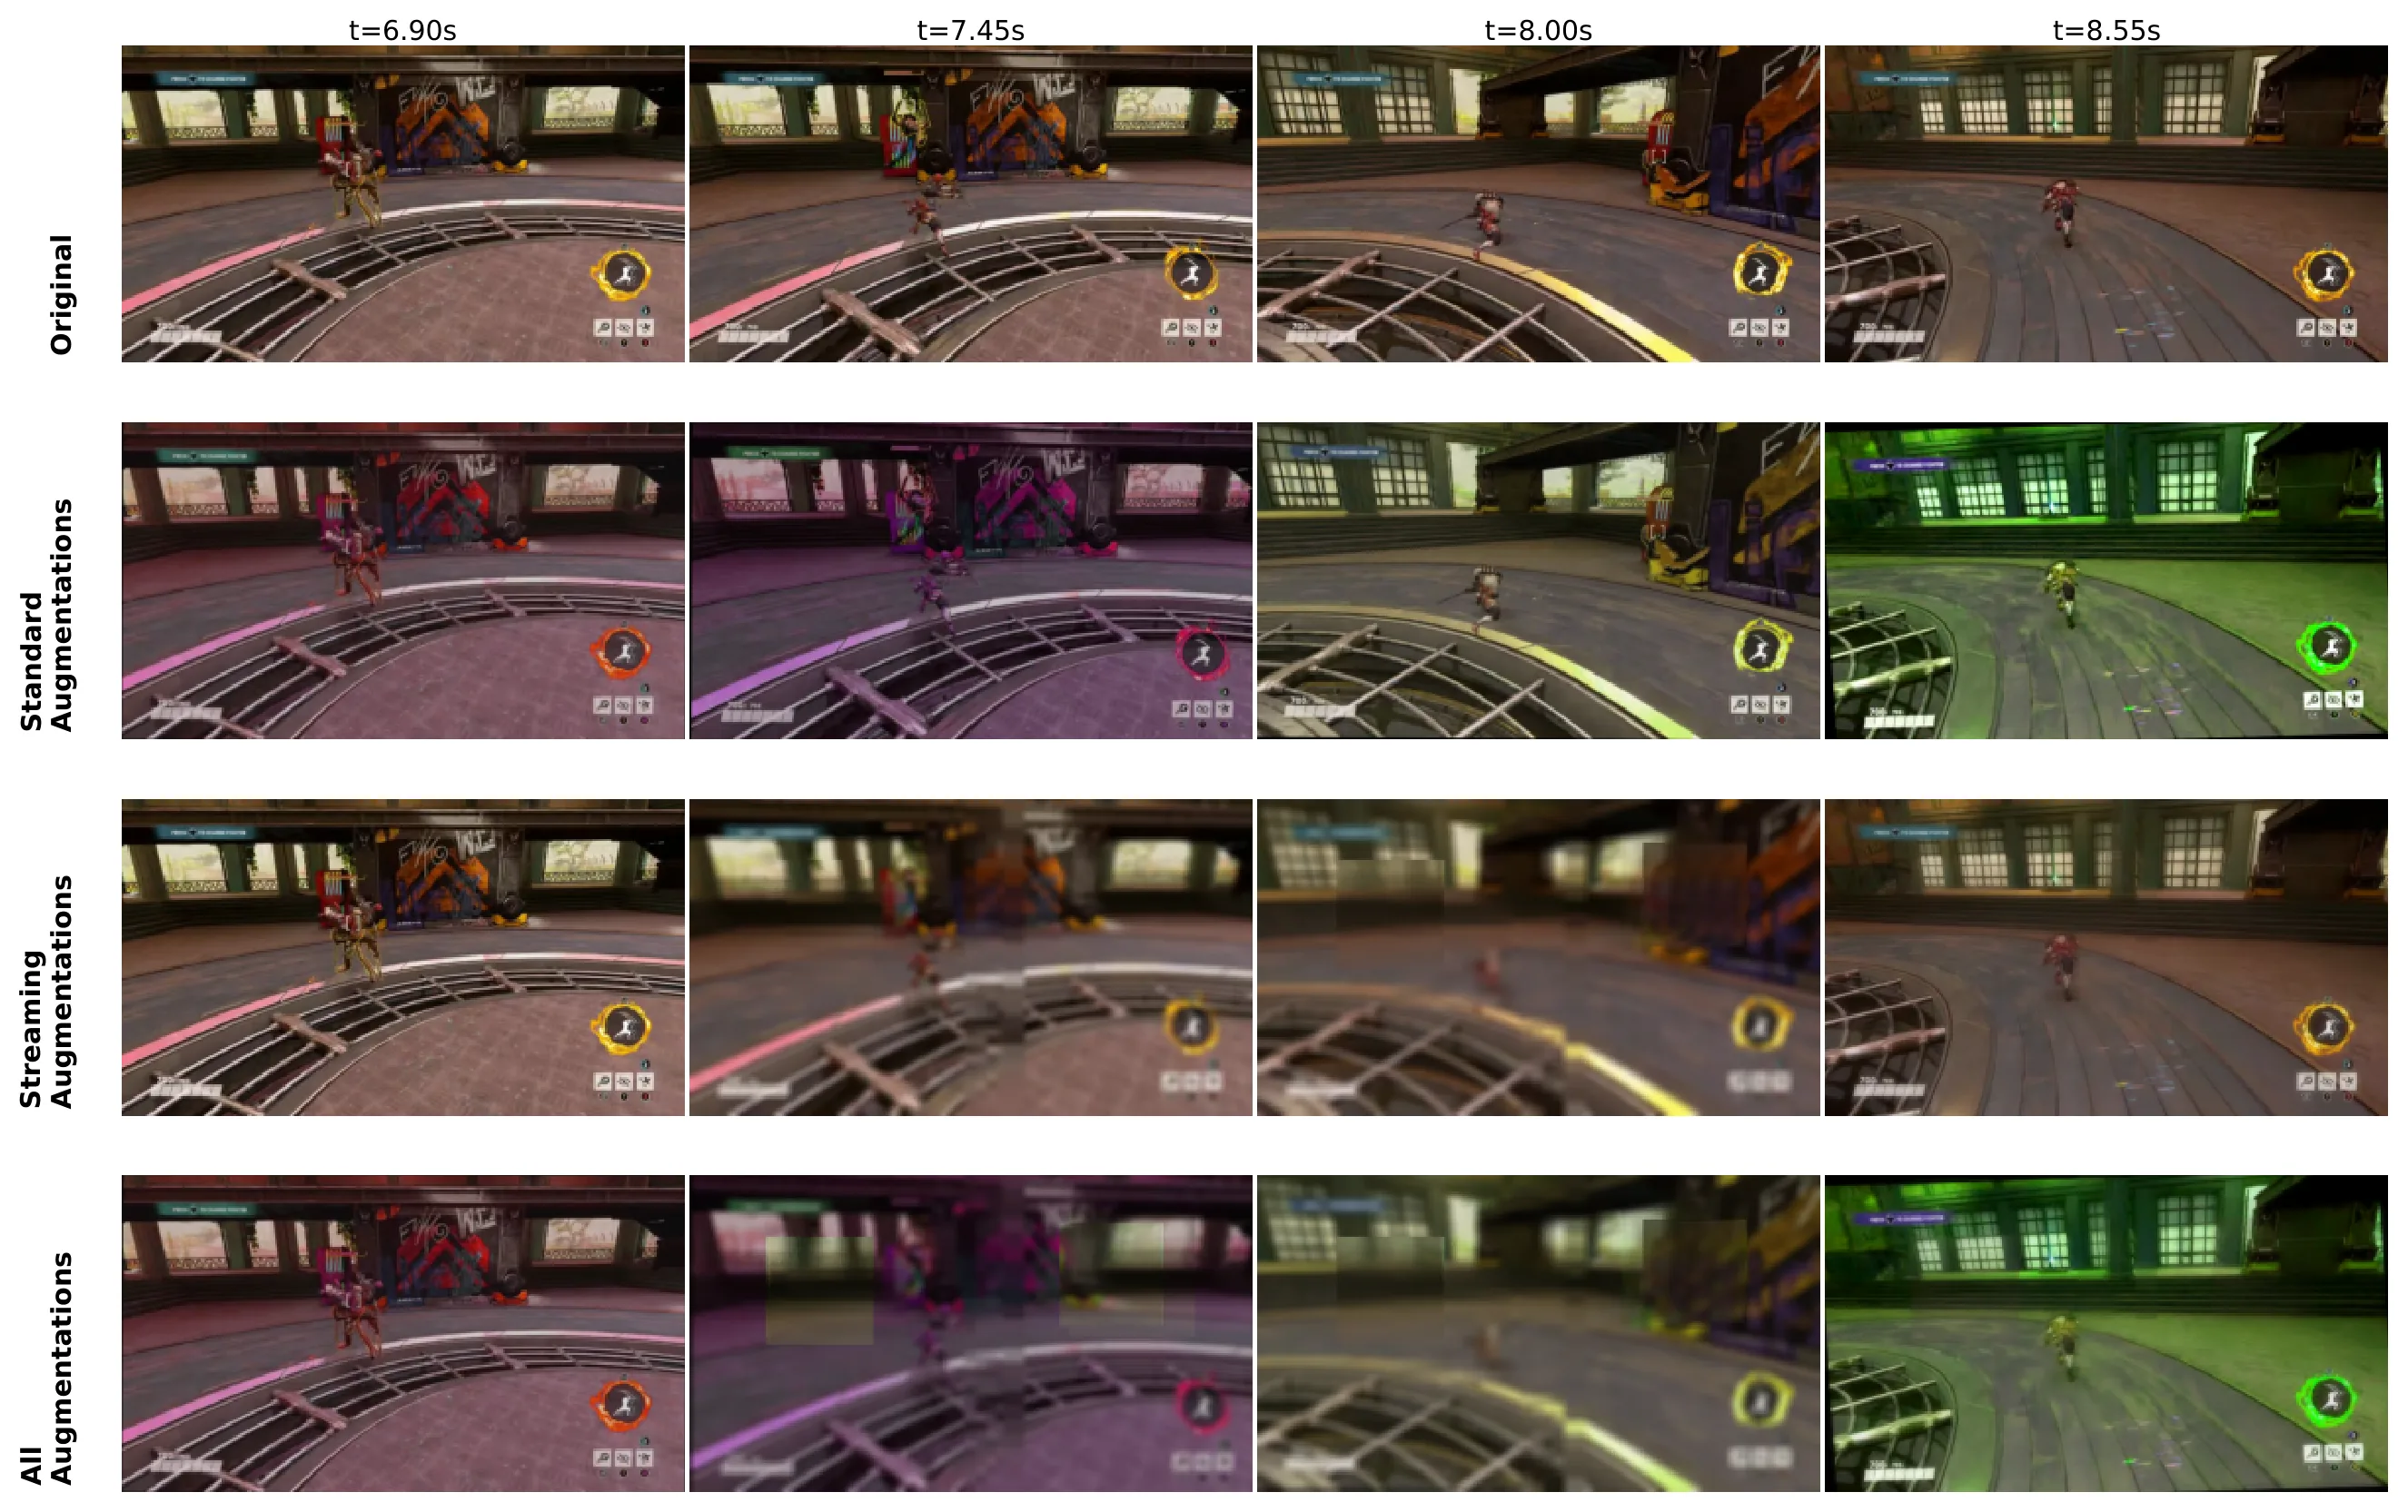
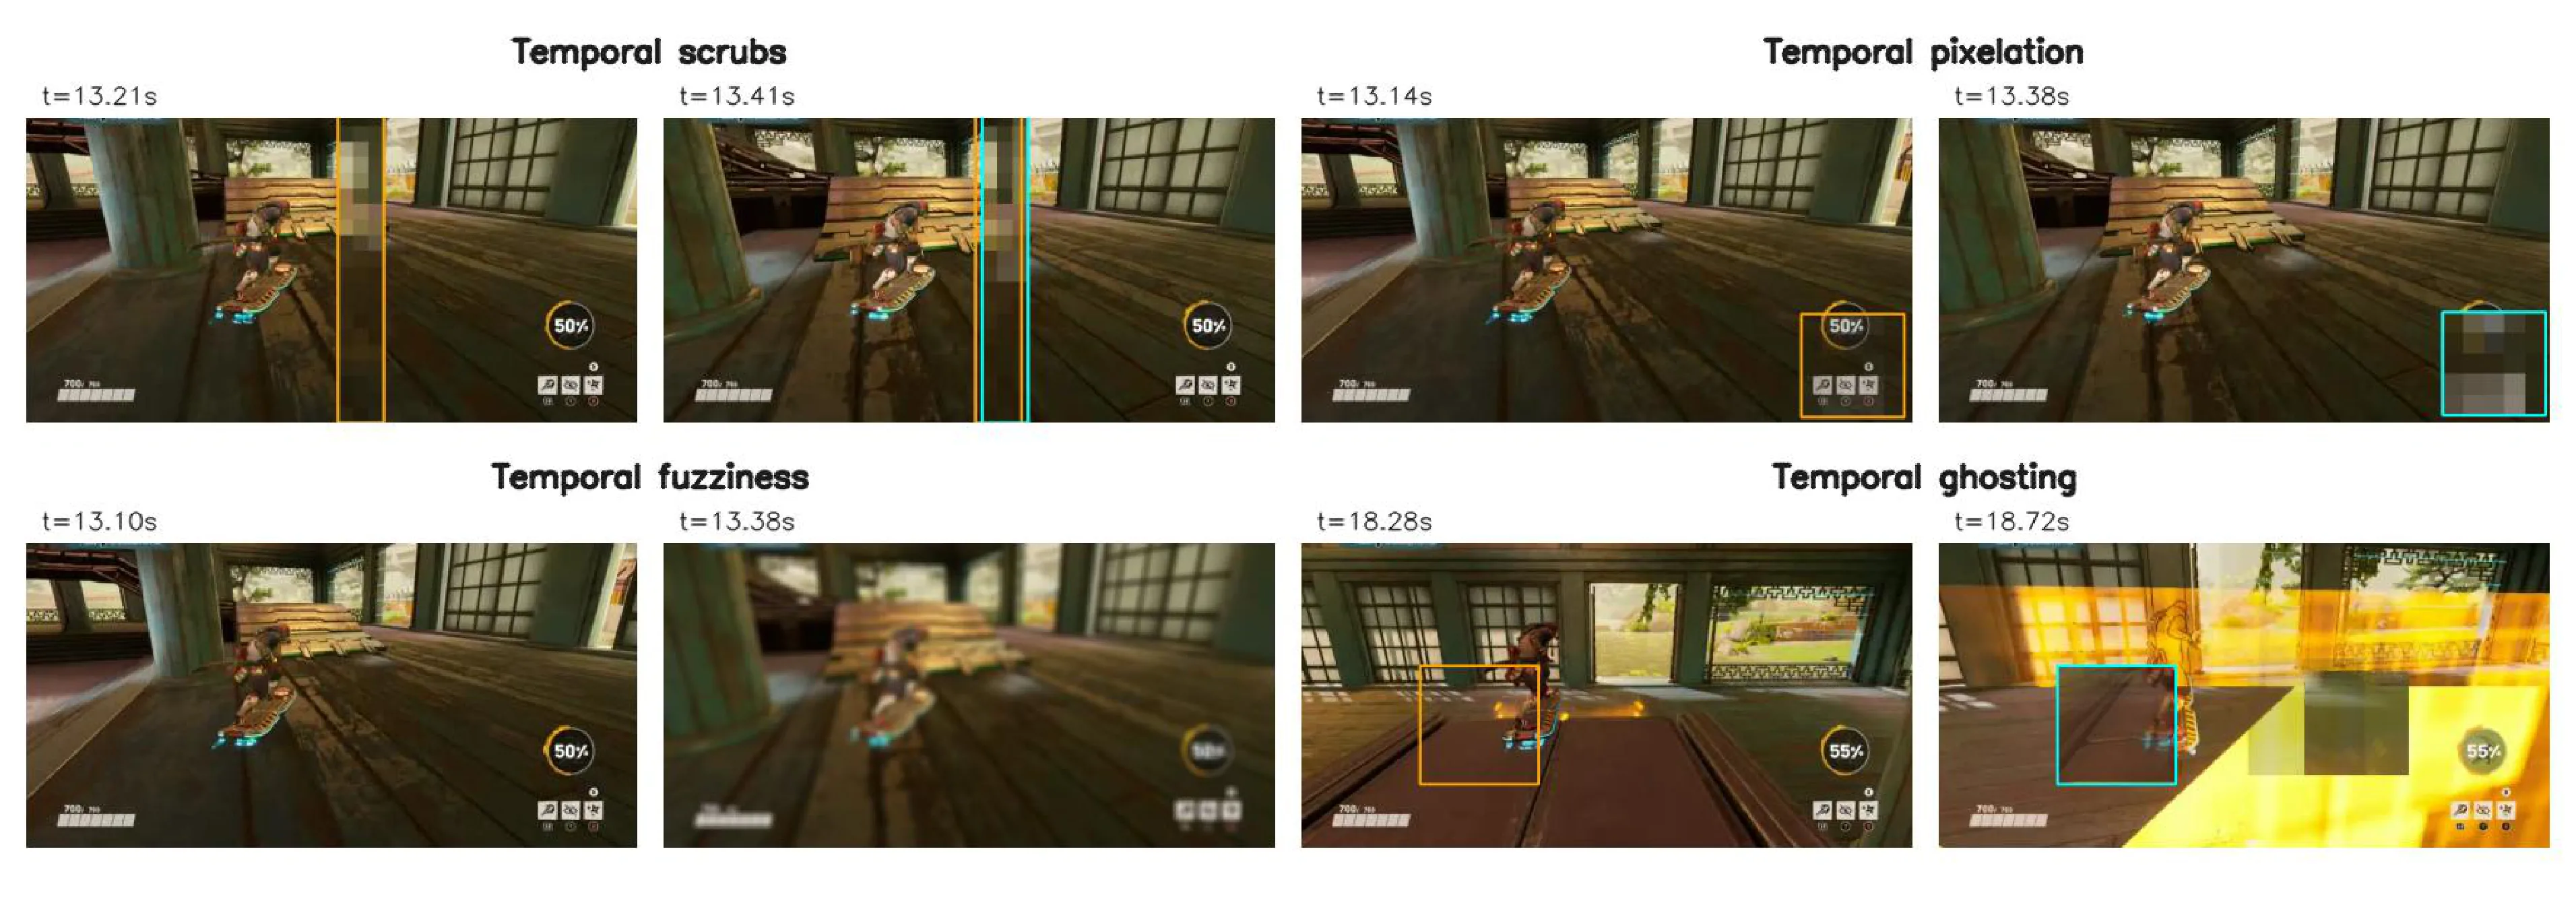
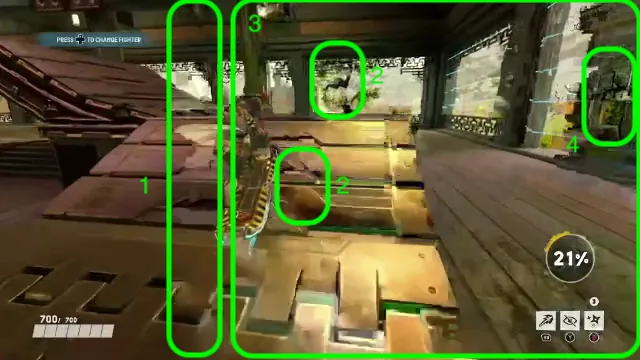
像素化块状失真(Pixelated Blocks):模拟压缩编码时因码率不足导致的马赛克效果。该增强将图像划分为若干不规则块,对每个块进行不同程度的模糊或像素化处理,模拟局部细节丢失的情形。直觉上这与 JPEG 压缩的块效应相似,但本文的策略更加可控,能够独立调节每个块的失真强度。
抹除(Scrubs):对应网络传输中的帧丢弃或局部解码失败。实现方式是在图像上随机选择若干矩形区域,将其替换为前一帧的对应内容或纯色块,从而制造出时间上的不连续感。这种伪影在网络波动时尤为常见。
全局模糊(Global Blur):模拟帧率下降或运动模糊导致的整体清晰度降低。通过高斯滤波对整个图像进行模糊处理,模糊核的大小作为超参数控制模糊程度。这一增强的直觉来源于:当网络带宽严重受限时,编码器往往会降低分辨率或增加帧内预测强度,从而导致画面整体变糊。
鬼影(Ghosting):模拟物体运动时前后帧信息混合产生的残影效果。实现时将当前帧与前一帧按一定权重叠加,生成带有拖尾感的视觉输出。这种伪影在帧率不稳定或使用双线性插值的流媒体系统中较为常见。
在模型层面,本文选择了预测逆动力学模型(PIDM)作为基架。PIDM 的核心思想是在[[潜空间]]中同时完成两件事:其一,学习一个前向世界模型,根据当前状态和动作预测下一状态;其二,训练一个逆向动力学模型,根据当前状态与「期望的未来状态」反推应该采取的动作。关键设计在于「未来状态条件化」机制——即便当前观测带有伪影,智能体也可以利用预测的未来状态来校正决策,从而在存在扰动的情况下仍能保持策略的连贯性。
时空增广与 PIDM 的结合产生了协同效应。空间层面的伪影(像素化块、模糊)迫使逆向动力学模型学会从残缺信息中推断关键特征;时间层面的伪影(抹除、鬼影)则让前向模型在状态转移存在噪声时依然能够可靠预测。这种多层次的扰动注入,使得训练出的智能体对各类网络异常都具有较强的容忍度。
实验与结果
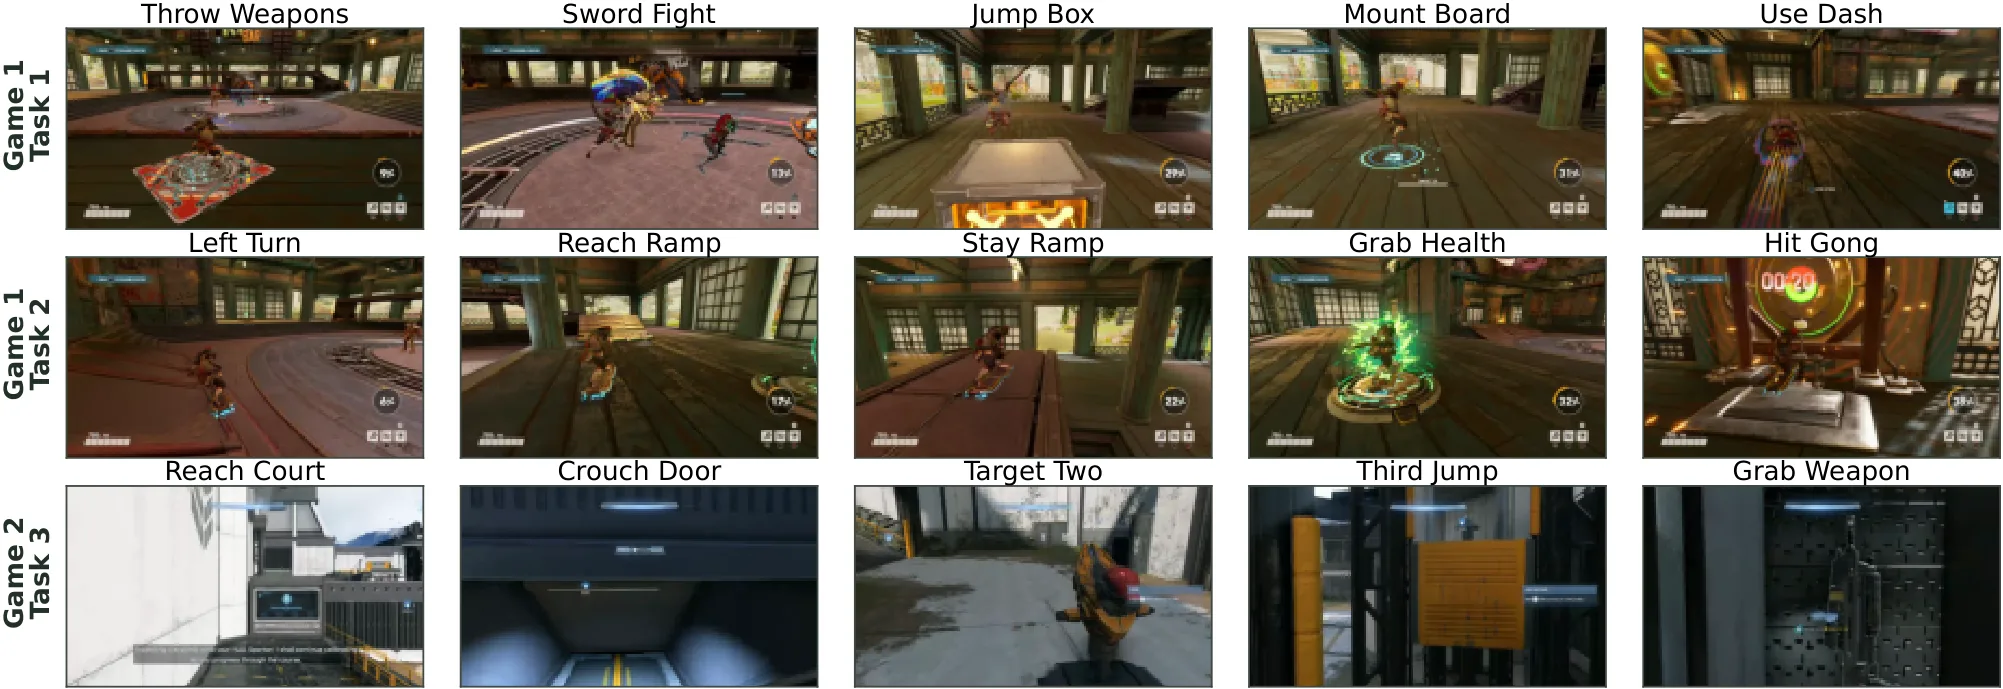
实验在现代三维视频游戏的三个任务上进行,涵盖了不同难度等级的场景。评估指标采用任务成功率与累积奖励的标准化得分。
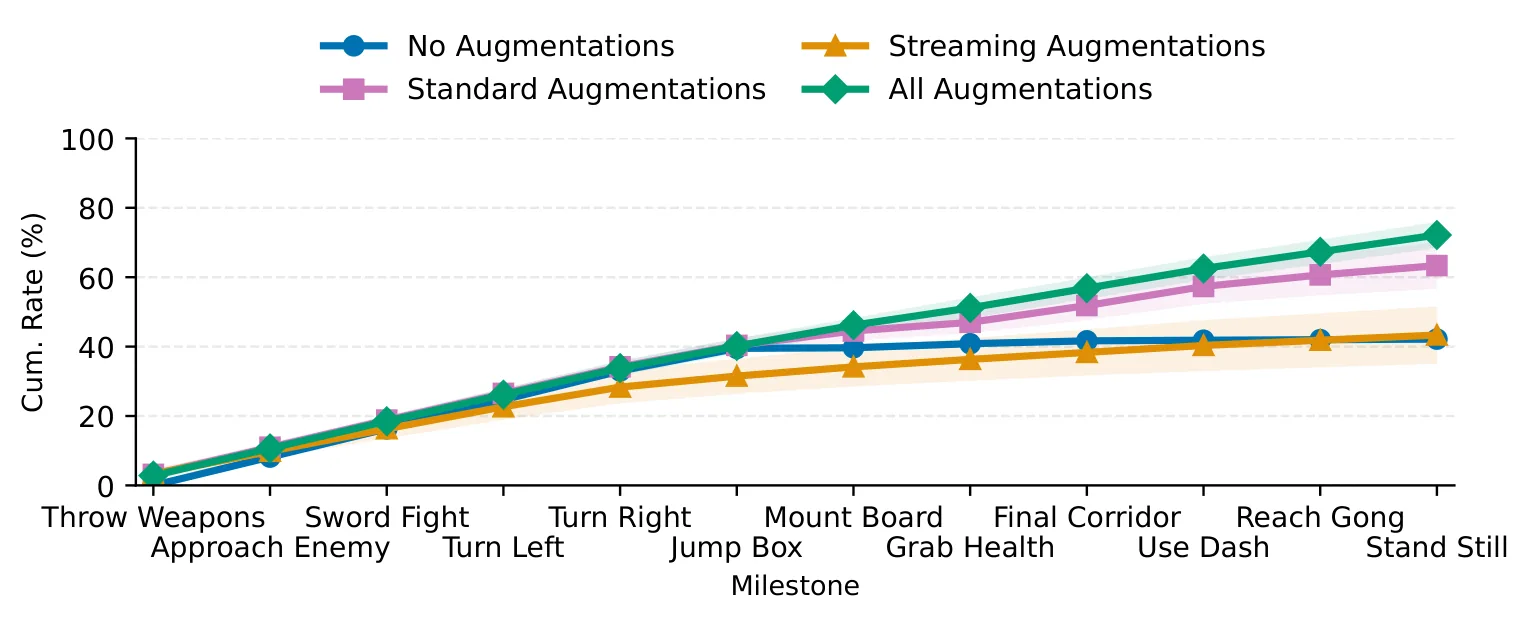
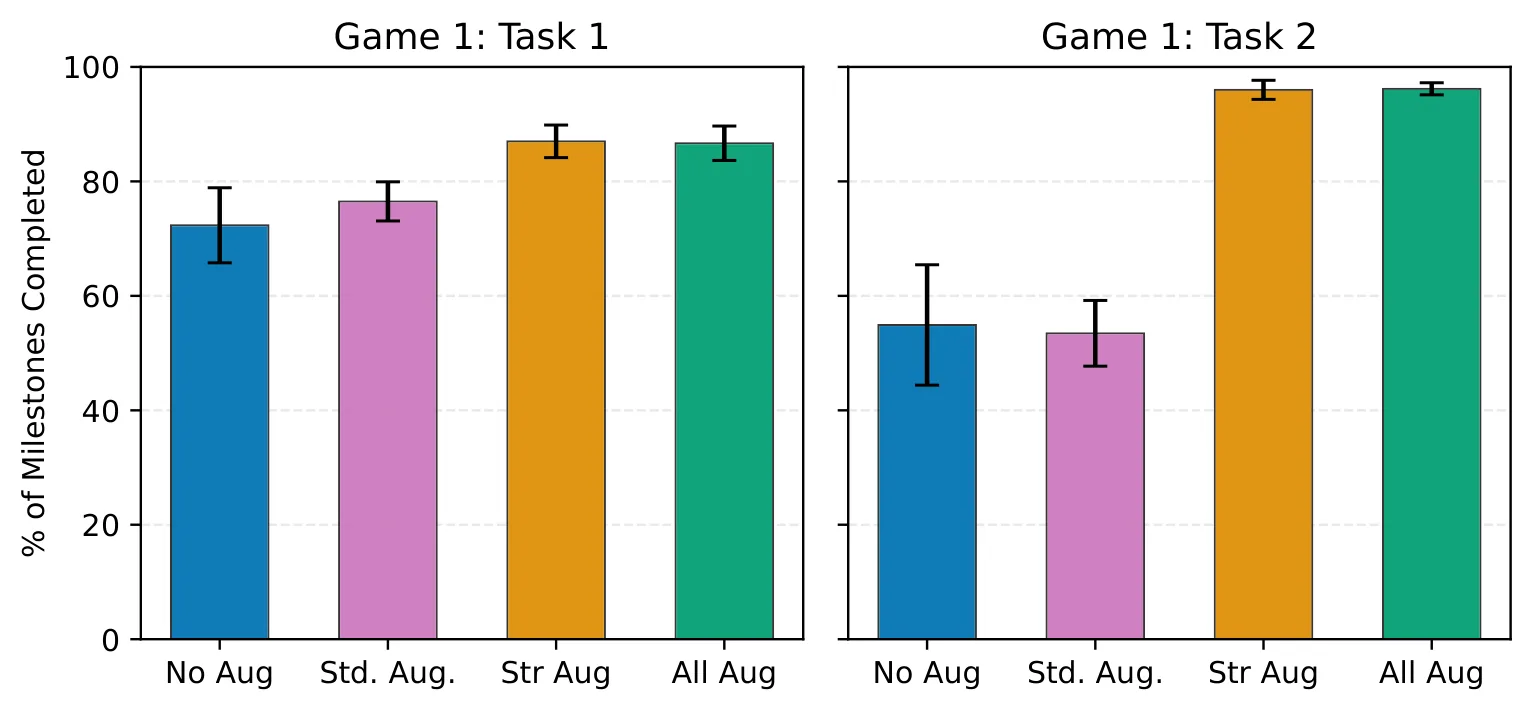
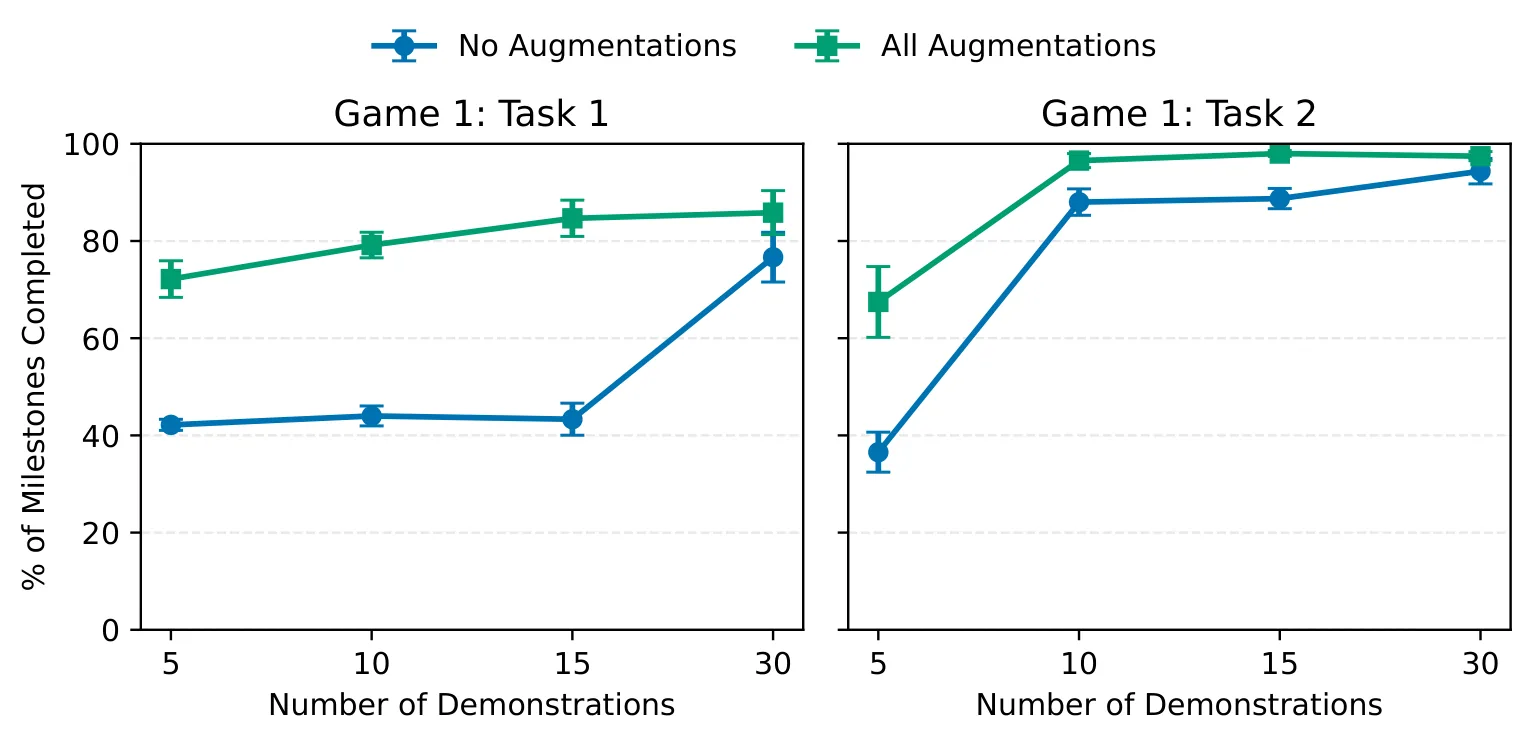
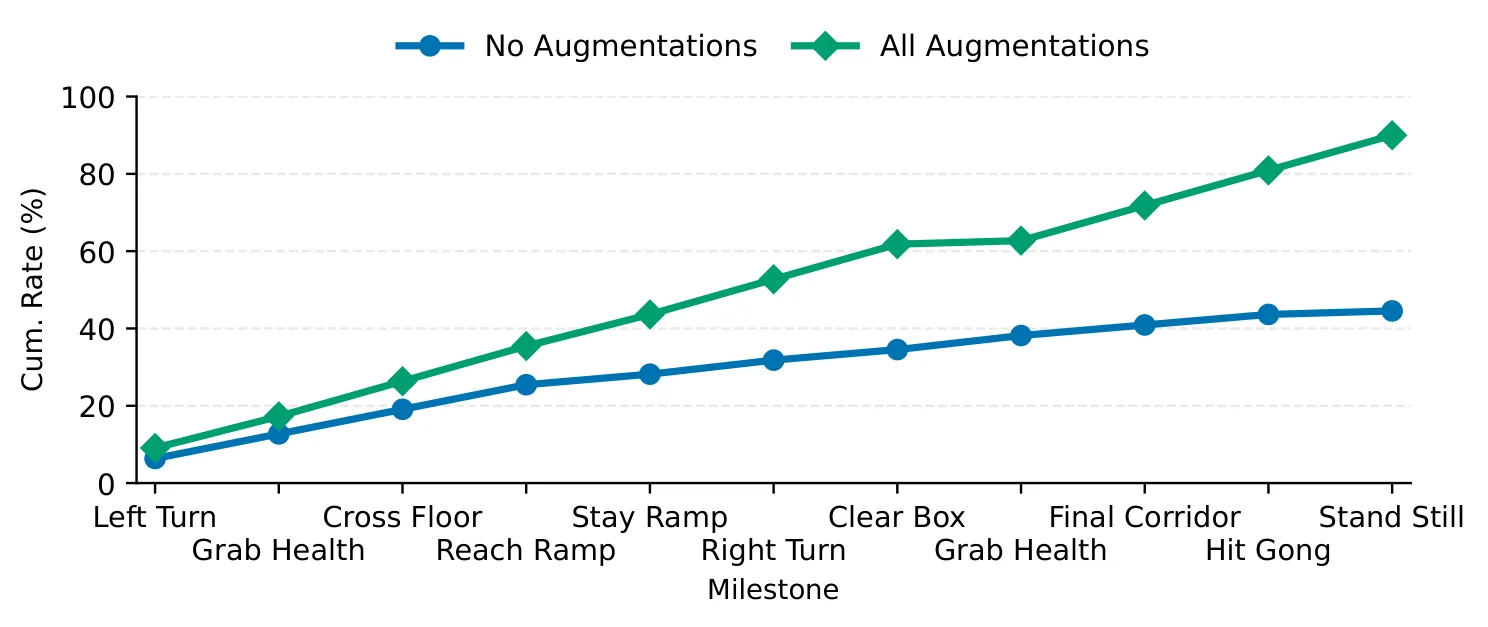
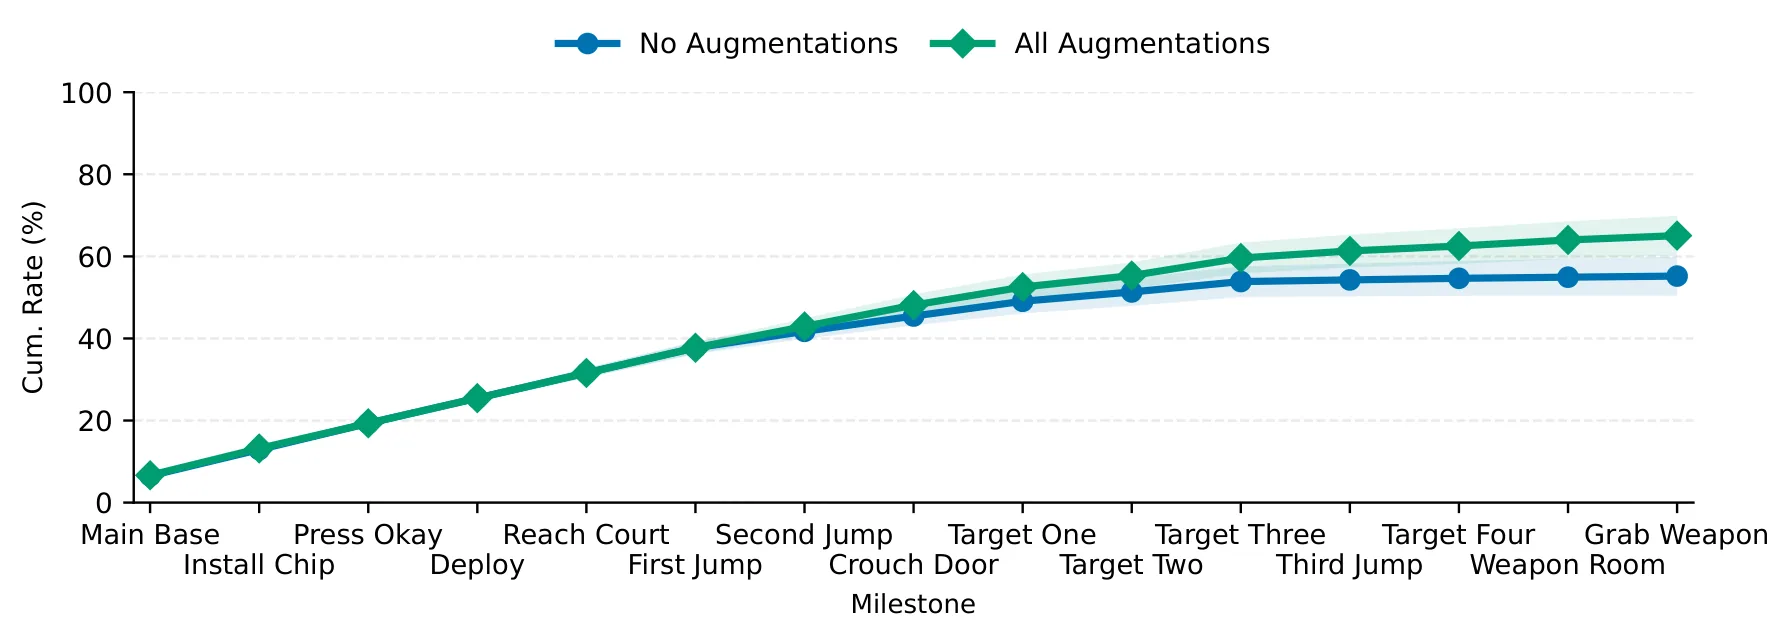
在数据效率方面,研究者对比了使用和不使用增广的训练方案,控制两侧消耗的演示数据量完全相同。结果显示,在稳定流媒体条件下,使用时空增广训练的智能体相比基线最高可提升 41% 的评估性能。这一数字背后反映的是:增广实际上扩充了训练分布的覆盖范围,使得智能体在相同数据预算下接触到了更丰富的视觉变体。
鲁棒性测试则引入了受控的网络延迟模拟。结果极具说服力:当延迟增加时,仅用原始数据训练的智能体性能下降幅度高达 49.82%,几乎折半;而使用增广训练的智能体性能仅下降 7.45%。这意味着增广策略使智能体对网络波动具有了极强的抗干扰能力,在真实流媒体环境中具有重要的实用价值。
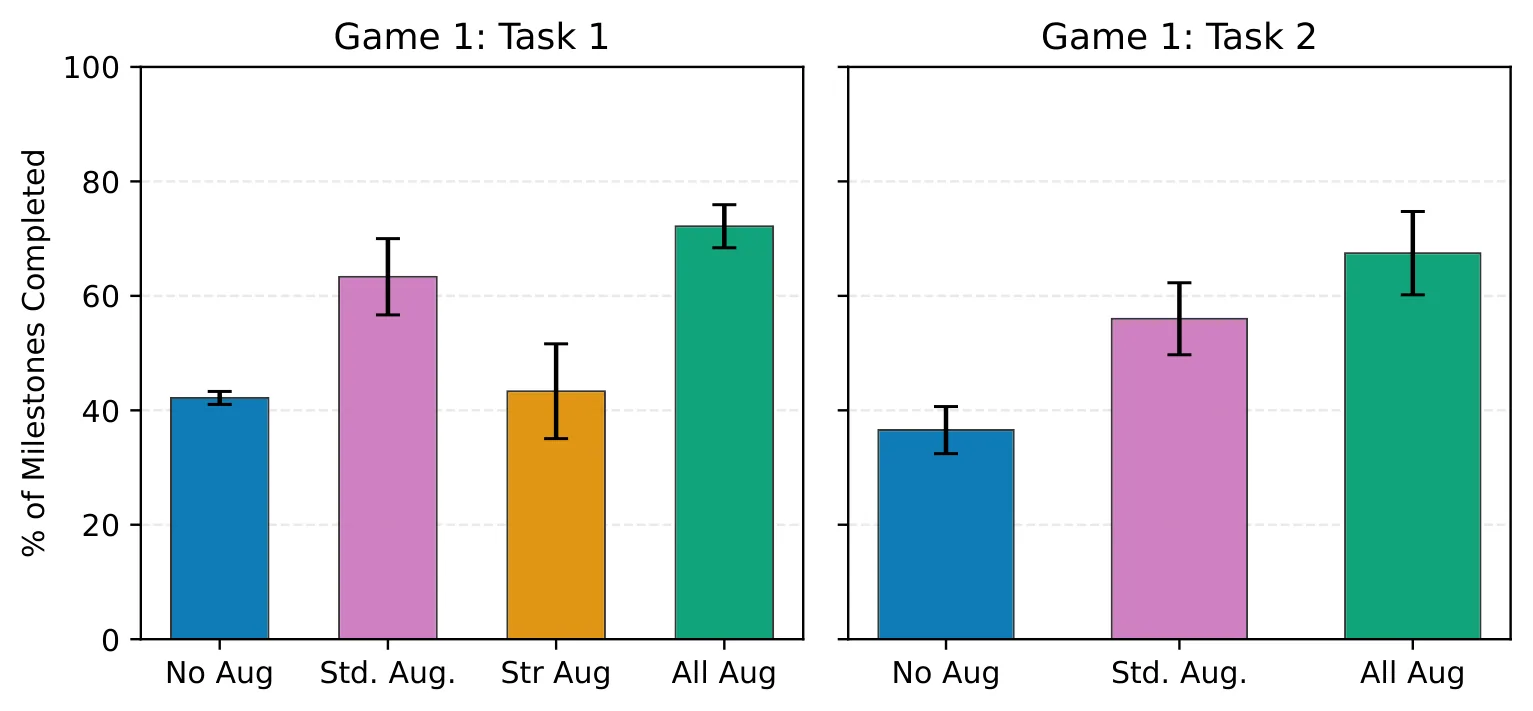
消融实验进一步揭示了各类增广的贡献占比。结果表明,四种增广方法存在一定互补性——单独使用任一种都无法达到全部四种联合使用的效果。其中,像素化块状失真和全局模糊对空间扰动的补偿作用最为显著,而抹除和鬼影则在时间一致性维护上更为关键。
讨论与可借鉴点
这项工作的一个重要贡献在于提出了「针对特定部署场景设计[[数据增强]]」的方法论范式。传统观点认为数据增强只是锦上添花,用于扩充数据量或轻微提升泛化能力;而本文证明,在明确知晓测试分布偏移方向的情况下,精细设计的增强策略可以成为决定性因素。特别是在流媒体游戏这类网络条件多变的场景中,提前在训练阶段模拟真实部署中的扰动分布,是一种成本极低的鲁棒化手段。
从更宽广的视角看,这一思路与对抗训练、领域自适应等领域存在深层联系。核心问题都是「训练与测试分布不一致时如何保证性能」,只是本文选择了在输入层面进行分布对齐这一相对直接的方式。未来可探索的方向包括:将增广策略与更先进的[[潜空间]]建模方法结合,进一步压缩所需演示数据量;或将该框架迁移到其他流媒体应用场景,如云游戏、自动驾驶远程操控等。
局限方面,四类增广方法虽然覆盖了主流的网络伪影类型,但可能无法涵盖所有真实场景中的异常情况。此外,增广强度的超参数调优目前依赖人工经验,尚缺乏自动化的强度校准机制。
摘要
模仿学习是一种颇具吸引力的方法,可通过训练策略将视觉观测映射为人类示范中的动作,从而将游戏智能体扩展到复杂的三维环境中。然而,这类示范的采集成本较高,而现代游戏通常通过流媒体方式运行,网络延迟与压缩会引入时空相关的视觉伪影,从而在测试时导致协变量偏移。为应对这些挑战,我们提出了流媒体增广方法,可模拟低带宽网络连接下常见的四类伪影:像素化块状失真、局部涂抹、全局模糊以及重影。我们在预测式逆向动力学模型(PIDM)的基础上实现了该方法,该模型在习得的潜空间中结合未来状态条件化与逆向动力学策略,并在现代三维视频游戏的三个任务上评估了我们增广方法的效果。在稳定的流媒体条件下,使用时空增广训练的智能体,在相同数据预算下,相比未使用增广训练的智能体,评估性能最高可提升 41%。当引入网络延迟时,使用增广训练的智能体性能仅下降 7.45%,而仅使用原始数据训练的智能体性能下降高达 49.82%。这些结果清楚地表明,针对流媒体场景量身定制的时空增广是一种简单而强大的工具,可用于训练鲁棒且高效的游戏智能体。
Abstract
Imitation learning is an appealing way to scale game-playing agents to complex 3D environments by training policies to map visual observations to actions from human demonstrations. However, these demonstrations are expensive to collect and modern game-playing is often done through streaming in which network delay and compression introduce spatiotemporally correlated visual artifacts that can cause a covariance shift at test time. To address these challenges, we propose streaming augmentations that mimic four types of artifacts commonly encountered during streaming with low-bandwidth network connection: pixelated blocks and scrubs, global blur, and ghosting. We instantiate our approach on top of predictive inverse dynamics models (PIDM), which combine future-state conditioning with an inverse dynamics policy in a learned latent space, and evaluate the impact of our augmentations across three tasks in modern 3D video games. Under stable streaming conditions, agents trained with spatiotemporal augmentations achieve up to 41% higher evaluation performance compared to agents trained without augmentations under an identical data budget. When network lag is introduced, agents trained with augmentations degrade by only 7.45% vs 49.82% of the original performance for agents trained only with the original data. These results clearly indicate that spatiotemporal augmentations tailored for the streaming setting are a simple yet powerful tool to train robust and efficient game-playing agents.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。