
从像素到状态:将交互式世界模型重新思考为游戏引擎
From Pixels to States: Rethinking Interactive World Models as Game Engines
📝 TLDR
交互式游戏世界需要动作-状态-观测的循环一致性。现有视频生成模型虽能预测未来帧,但缺乏对显式游戏状态的建模与长时持久性,难以满足真实交互需求。本文以传统游戏引擎的"动作-状态-观测"循环为分析框架,从动作控制、状态动力学、状态-观测持久性、实时生成四个维度综述现有方法,并构建面向《黑神话:悟空》的可扩展数据引擎,发布超90小时帧对齐游戏数据。该工作为状态感知的交互世界建模提供清晰研究图景与数据基础。
🧭 速览
视频生成模型被视为下一代游戏引擎,但缺乏显式状态建模与长时一致性,难以实现真正的交互式游戏世界。
以游戏引擎"动作-状态-观测"循环为框架,从动作控制、状态动力学、状态-观测持久性、实时生成四个维度综述代表性方法族并分析权衡。
构建《黑神话:悟空》数据引擎,发布90+小时帧对齐的玩家动作、真实游戏状态、视觉观测与结构化语义标注数据。
为交互游戏世界建模提供清晰研究图景,推动状态感知世界模型研究从像素预测迈向显式状态推理。
🆚 方法对比
Action-State-Observation 统一框架
- 借鉴传统游戏引擎循环结构,维度划分清晰
- 将碎片化研究系统组织为四维度
- 明确每个维度所需能力与权衡
- 框架偏向理论分析,缺少具体实现验证
- 各维度间交互关系讨论有限
- 依赖传统引擎视角,对纯生成式方法适配性待考察
Camera-Controlled Video Generation
- 支持视角运动精细控制
- 成熟方案,输入空间直观
- 可结合扩散模型灵活注入相机参数
- 主要处理视角而非语义级动作
- 难以表达复杂实体交互与战斗
- 控制粒度与生成质量存在权衡
Language-Entity-Level Interfaces
- 扩展交互表达范围,支持语义级指令
- 可描述角色行为与世界事件
- 为高层意图驱动生成提供接口
- 语言指令存在歧义与组合爆炸
- 推理延迟较高,难满足实时需求
- 依赖强语言模型,增加系统复杂度
Memory Mechanisms (长一致性机制)
- 维持长时序生成的一致性
- 支持长周期滚动生成
- 缓解视觉漂移与遗忘问题
- 记忆容量与计算开销难以平衡
- 存储策略设计缺乏统一范式
- 对状态级一致性保证仍有限
Distillation and Streaming Techniques
- 推动生成向实时帧率迈进
- 降低推理延迟与显存占用
- 支持端侧与流式部署
- 蒸馏后质量下降不可避免
- 生成多样性与速度存在权衡
- 对长序列稳定生成仍有挑战
Black Myth: Wukong Data Engine
- 提供90小时帧对齐动作-状态-观测数据
- 包含引擎导出真实游戏状态,标注丰富
- 玩家技能多样,利于泛化研究
- 仅覆盖单一游戏,生态多样性受限
- 数据采集与标注成本较高
- 依赖游戏引擎接口,可复现性受限
本文以传统游戏引擎的 action-state-observation 循环为统一框架,系统对比了相机控制、语言接口、记忆机制、蒸馏流式等代表性方法家族,并配套发布了面向《黑神话:悟空》的数据引擎,为状态感知的交互世界建模提供评测基础。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
这篇论文从传统游戏引擎的"动作–状态–观测"循环出发,系统审视了交互式游戏世界建模这一新兴领域,将现有方法归纳为四个核心维度——动作控制、状态动力学、状态-观测持久性和实时生成——并针对国产 3A 游戏《黑神话:悟空》构建了一套包含超过 90 小时帧对齐游戏数据的可扩展数据引擎,为状态感知的交互世界建模提供了清晰的研究图景与坚实的数据基础。
研究背景与动机
构建能够对玩家动作做出连贯响应的交互式游戏世界,长期以来是计算机图形学、游戏工程与人工智能领域共同追逐的目标。近年来,[[视频生成模型]]的快速发展为这一目标开辟了一条数据驱动的实现路径:通过在用户动作条件下预测未来观测帧,这类模型日益被视为潜在的下一代[[游戏引擎]]替代方案。
然而,当我们将这些看似强大的视频生成模型真正放置到游戏交互场景中时,会发现它们与理想之间存在显著鸿沟。真正的交互式游戏世界需要满足三个核心要求:交互结果必须遵循随游戏条件演化的规则(例如,攻击虚弱状态的敌人应该产生不同于攻击满血敌人的效果);动作的后果必须在长时程上持续保持(你砍掉的那扇门不应在几步之后就莫名其妙地重新出现);生成循环必须在实时约束下运行(玩家无法接受动作发出后等待数秒才能看到反馈)。
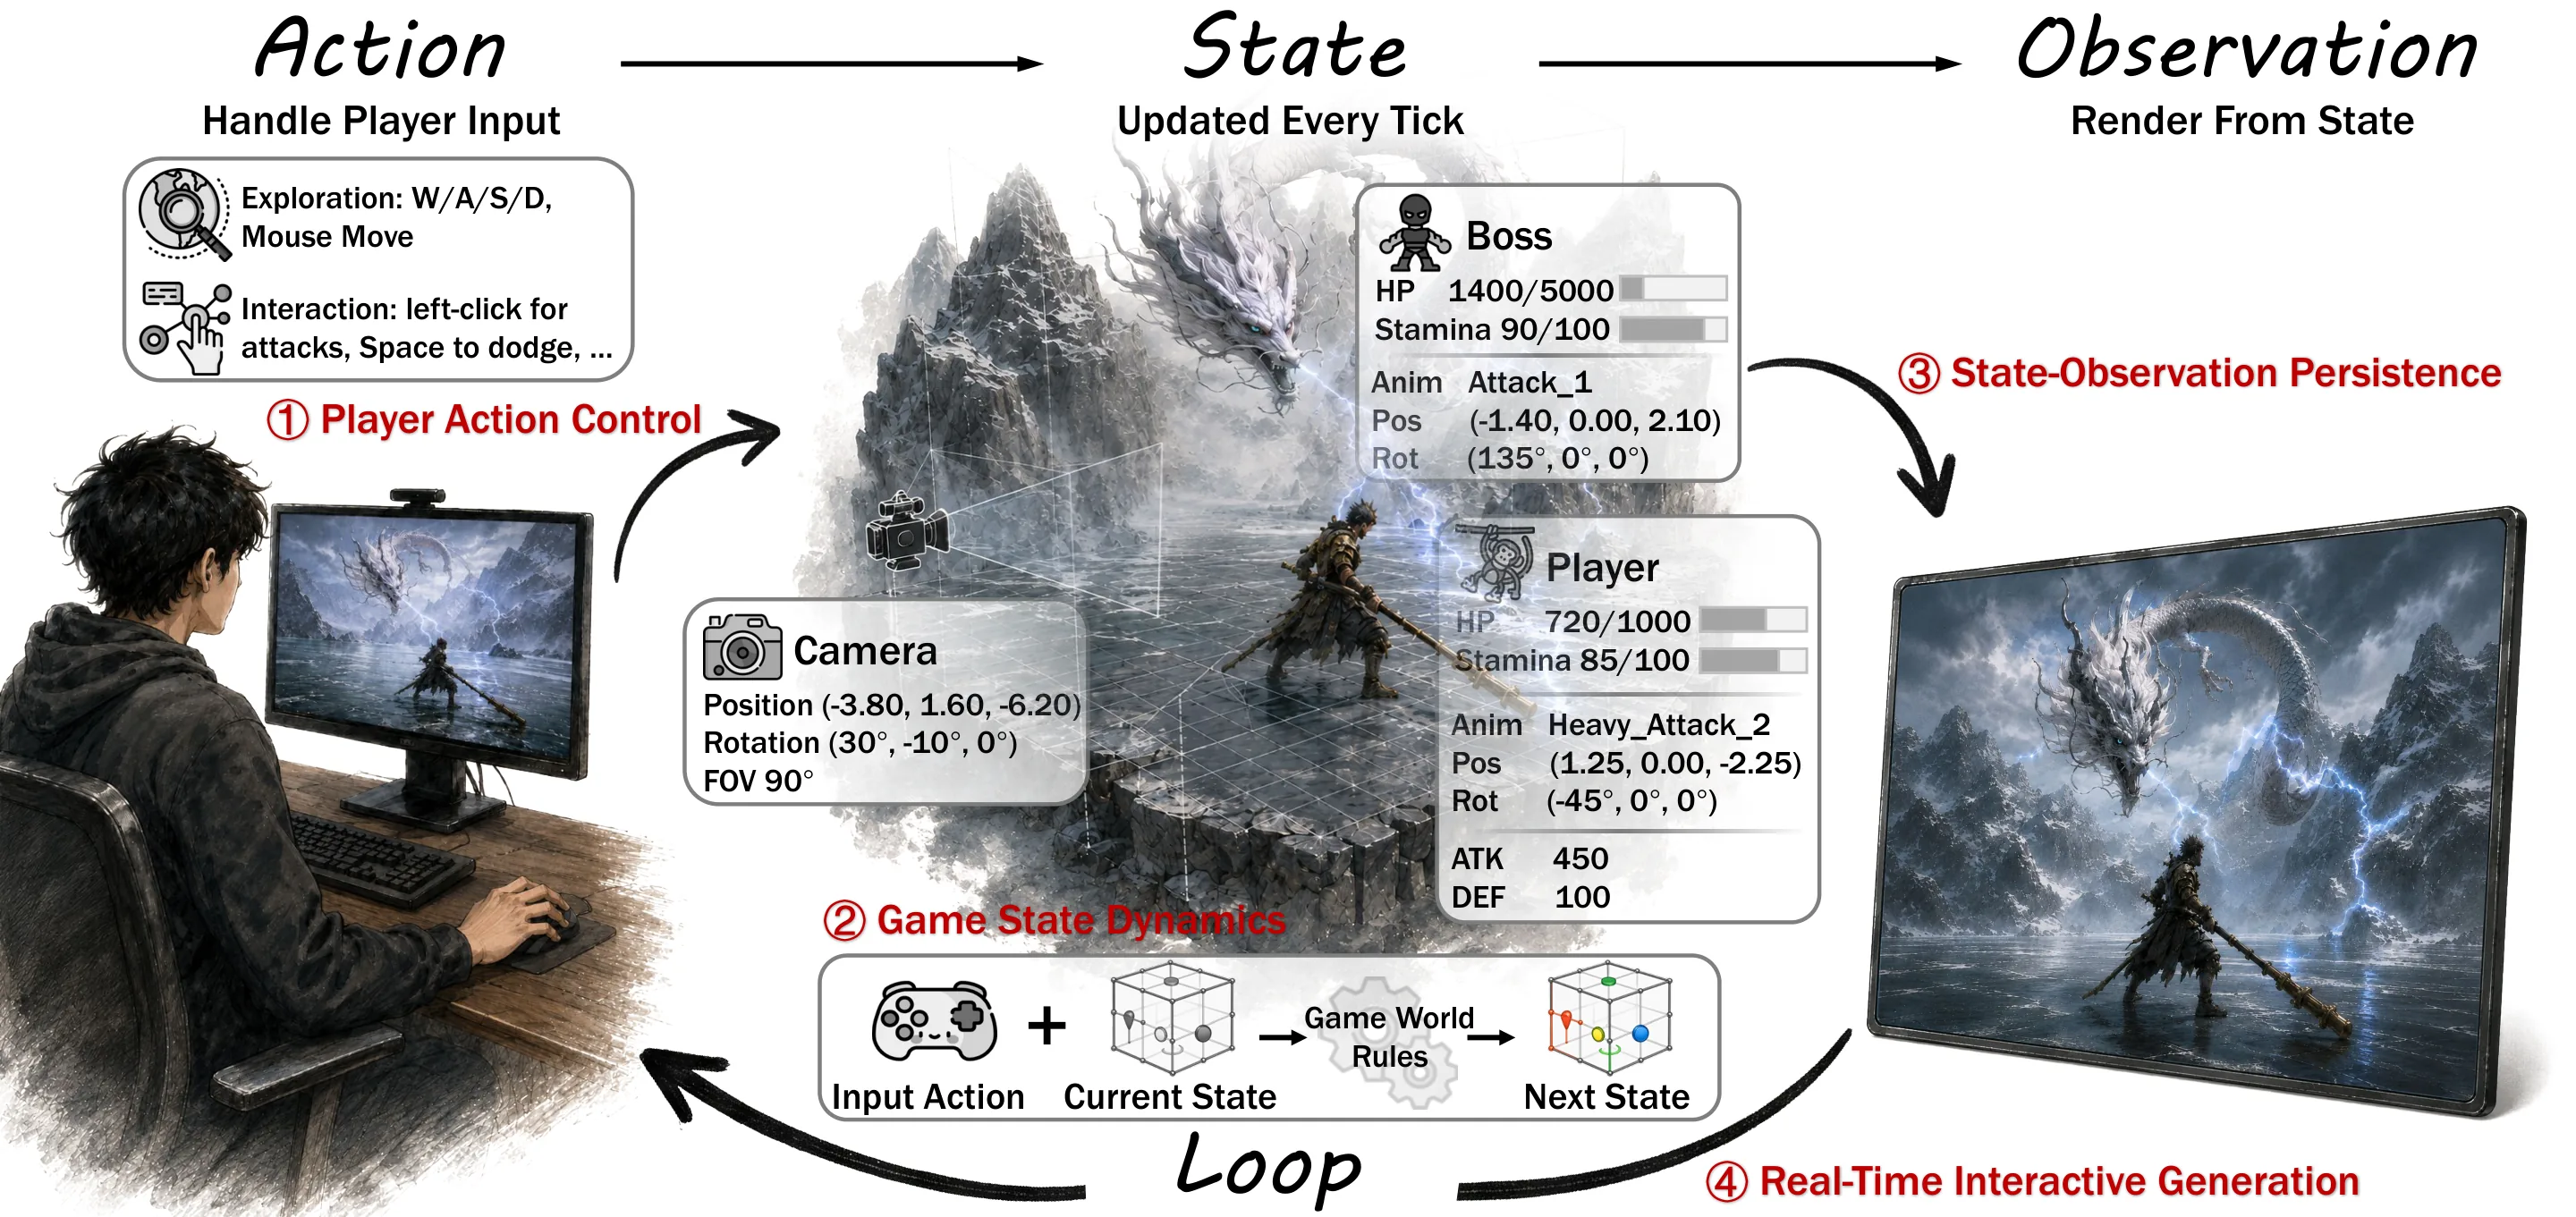
传统游戏引擎解决这些问题的方式是构建一个清晰的循环回路:玩家动作依据预定义的规则更新一个显式的游戏状态,而观测(即玩家看到的画面)则从该状态渲染生成。这种架构确保了因果链条的透明性和状态记忆的持久性。但纯粹基于学习的方法往往缺乏这种显式状态建模,导致生成的内容虽然在视觉上流畅,却难以维持跨时间的因果一致性和状态连续性。
这正是这篇论文的切入点:它没有简单地将视频生成模型视为答案,而是以传统游戏引擎的循环回路为分析透镜,系统性地审视交互式世界建模面临的核心挑战,从而为这一新兴领域提供一份清晰的研究地图。
方法
论文的核心方法论是维度化分析框架。作者并非提出单一的新模型或算法,而是以"动作–状态–观测"循环为组织视角,将交互式游戏世界建模拆解为四个相互关联的维度,每个维度对应一组核心能力要求和若干代表性方法家族。
第一维度是玩家动作控制,解决的是"如何让模型理解并响应玩家意图"的问题。现有方法家族包括基于条件化视频生成的方案(将动作指令作为生成条件输入)和基于强化学习动作规划的方案(将动作预测建模为序列决策问题)。两者的权衡在于:前者更擅长生成视觉连贯的观测,但难以保证动作执行的精确性;后者在动作执行上更为可靠,但往往缺乏对观测质量的端到端优化。
第二维度是游戏状态动力学,即如何建模游戏规则与状态演化。这涉及一个根本性挑战:游戏规则往往是离散的、符号化的(如生命值、道具数量、位置坐标),而视觉观测是连续的、高维的。论文讨论的方法家族包括隐式状态建模(状态信息隐含在模型参数中)和显式状态建模(引入结构化的状态表示)。作者指出,状态表示的选择直接影响模型对规则的理解能力和泛化性能——缺乏显式状态的模型容易出现"违反物理常识"或"违背游戏逻辑"的生成结果。
第三维度是状态-观测持久性,关注的是"动作影响能否在长时间跨度上保持一致"的问题。这是视频生成模型的传统弱项:单次生成模型在处理长时程依赖时容易出现状态漂移(drift),即初始状态的影响逐渐衰减直至消失。论文分析的方法家族涵盖自回归生成范式(逐步预测下一帧,可能导致误差累积)和全局记忆增强方案(引入外部记忆机制维持状态信息)。
第四维度是实时交互式生成,这是游戏应用的硬约束。游戏通常要求 30 到 60 帧每秒的渲染速率,而高质量视频生成模型的推理延迟往往以秒计。论文讨论了模型压缩、知识蒸馏、渐进式生成等技术路径,以及在生成质量与推理效率之间寻求平衡的工程考量。
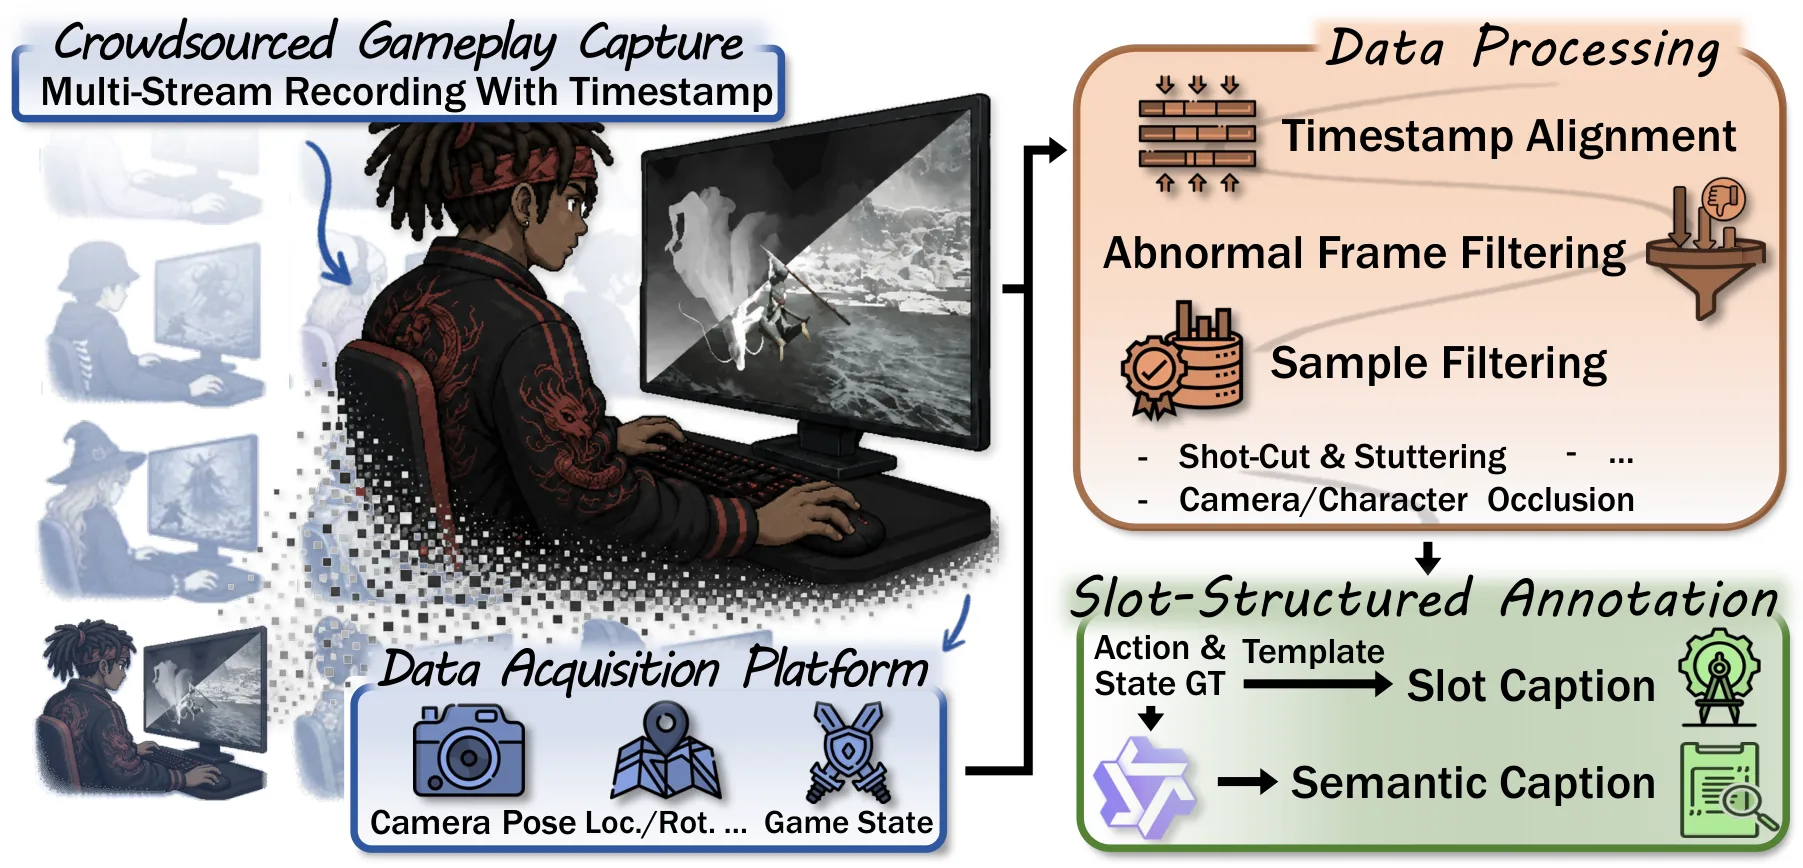
在数据分析框架之外,论文的另一项重要贡献是面向《黑神话:悟空》的可扩展数据引擎。作者设计了一套数据采集管线,能够同步记录玩家的输入动作、引擎内部的真实游戏状态,以及对应的视觉观测帧。这解决了该领域长期面临的数据稀缺问题——此前缺乏同时包含动作、状态和观测的大规模对齐数据。该数据引擎采集了超过 90 小时的游戏过程,涵盖多样的游戏场景和交互情境,并附带结构化标注(如物体类别、语义分割)和语义标注(如场景描述、事件标签)。
实验与结果
论文在实验部分主要展示的是数据引擎的建设成果。作者详细报告了数据采集的规模、覆盖的游戏场景类型,以及数据质量控制的流程。具体而言,超过 90 小时的帧对齐数据涵盖了游戏中的战斗场景、探索场景、剧情过场等多种情境,每帧数据包含精确的玩家输入时间戳、完整的游戏内部状态快照(角色位置、生命值、道具栏等)以及对应的渲染画面。
论文还展示了数据的多层次标注体系如何支撑不同研究需求。结构化标注(如物体检测框、语义分割掩码)便于训练感知导向的模型组件;语义标注(如场景描述、事件分类)则为更高层的任务(如基于自然语言的游戏控制)提供监督信号。作者通过若干消融实验验证了数据质量——例如,仅使用部分数据进行动作条件视频生成模型的微调,就能显著提升生成结果在动作对齐和状态一致性方面的表现。
此外,论文在方法综述部分也穿插了现有工作的对比分析。在动作控制维度上,条件化视频生成方案(如 VideoGPT、DreamFusion 等)在视觉质量上表现优异,但在动作执行精确性上弱于端到端动作规划方案;在状态动力学维度上,采用显式状态表示的模型(如 World Models 系列)在规则遵循和泛化能力上优于纯隐式方案,但增加了工程复杂度;在持久性维度上,引入全局记忆机制的方法显著缓解了状态漂移问题,但增加了推理开销。
讨论与可借鉴点
这篇论文的首要贡献在于提供了一个清晰的研究图景——它没有急于提出"正确答案",而是系统梳理了交互式世界建模的核心挑战和现有路径的权衡取舍。这种分析思路对后续研究者具有重要参考价值:它帮助我们在方法选择时明确 trade-off 的所在,而非盲目追求单一指标的最优。
然而,论文也坦承了若干局限。首先,四个维度之间的相互依赖和联合优化问题尚未被充分探讨——在实际系统中,动作控制、状态建模、持久性和实时性往往相互制约,孤立地改进单一维度可能收效甚微。其次,数据引擎目前仅覆盖单一游戏,《黑神话:悟空》的特定艺术风格和战斗系统限制了研究发现的泛化性,将数据采集扩展到更多游戏类型是自然的下一步。第三,论文主要聚焦于方法层面的综述分析,缺乏端到端的完整系统展示——一个真正将四个维度整合起来并在实际游戏中验证的原型系统,将更具说服力。
对于这一研究方向而言,论文指出的几个开放问题值得深思:如何在保持状态可解释性的同时利用大规模预训练模型的能力?状态表示的粒度应该如何选择——过粗的状态可能无法捕获关键细节,过细的状态又面临工程复杂度爆炸?以及,在实时约束下,生成质量与推理效率的最优平衡点究竟在哪里?
《黑神话:悟空》数据引擎的发布本身就是一个重要的基础设施贡献。它使得研究者可以在统一的benchmark上公平比较不同方法,也为该领域提供了急需的大规模训练数据。未来随着更多游戏数据的加入和标注体系的完善,这一资源有望成为状态感知游戏世界建模研究的重要基石。
摘要
构建能够对玩家动作做出连贯响应的交互式世界,一直是计算机图形学、游戏与人工智能领域的共同目标。近期涌现的视频生成模型通过基于用户动作预测未来观测,提供了一条数据驱动的实现路径,并日益被视为潜在的下一代游戏引擎。然而,要实现真正可交互的游戏世界,需要满足若干要求:交互结果遵循随游戏条件演化的规则,其影响能够在长时程上持续保持,并且生成循环能够实时运行。传统游戏引擎通过一个循环的动作–状态–观测回路来实现这些特性:在该回路中,玩家动作依据预定义规则更新一个显式的游戏状态,而观测则从该状态渲染生成。本文以这一回路作为组织视角,沿四个维度对交互式游戏世界建模展开审视:玩家动作控制、游戏状态动力学、状态–观测持续性,以及实时交互式生成。在每个维度上,我们从交互式游戏世界所需的能力出发,将现有方法归并为若干具有代表性的方法家族,并讨论每个家族的优势与权衡。作为分析的补充,我们针对《黑神话:悟空》提出了一种可扩展的数据引擎,采集了超过 90 小时的游戏过程,包含帧对齐的玩家动作、真实游戏状态与视觉观测,并附带结构化与语义标注,可作为面向状态感知游戏世界建模的研究资源。我们希望本文能够清晰呈现该领域的现状,并推动交互式游戏世界的进一步发展。
Abstract
Building interactive worlds that respond coherently to player actions has long been a shared goal of computer graphics, games, and artificial intelligence. Recent video generative models provide a data-driven route toward this goal by predicting future observations conditioned on user actions, and are increasingly regarded as potential next-generation game engines. Realizing a genuinely interactive game world, however, requires interaction outcomes that follow rules over evolving game conditions, consequences that persist over long horizons, and a generation loop that operates in real time. Conventional game engines realize these properties through a recurrent action-state-observation loop, in which player actions update an explicit game state according to predefined rules and observations are rendered from the resulting state. Taking this loop as an organizing lens, this paper examines interactive game world modeling along four dimensions: player action control, game state dynamics, state-observation persistence, and real-time interactive generation. For each dimension, we start from the capabilities required by an interactive game world, group existing approaches into representative families, and discuss the strengths and trade-offs of each family. Complementing this analysis, we present a scalable data engine for Black Myth: Wukong that collects over 90 hours of gameplay with frame-aligned player actions, ground-truth game states, and visual observations, together with structured and semantic annotations, as a resource for state-aware game world modeling. We hope this paper offers a clear picture of where the field stands and fosters progress toward interactive game worlds.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。