
📝 TLDR
多语言LLM对齐面临人类偏好数据在不同语言间分布不均的难题。论文提出基于元学习的RLHF与DPO框架,利用其他语言的偏好数据学习可迁移的初始化参数,使目标语言仅需极少样本即可完成有效对齐。理论层面给出元奖励建模与元策略优化的收敛保证;实验显示在仅100条目标语言偏好样本时,相对基线获得最高28%的胜率提升,并跨多种语言、模型规模和语言距离均保持优势。
🧭 速览
多语言LLM对齐中,人类偏好数据在不同语言间分布极不均衡,低资源语言缺乏足够标注数据,难以有效进行对齐训练。
提出元学习框架用于RLHF与DPO,借助其他语言偏好数据学习可迁移初始化,仅需少量目标语言样本即可快速适配。
仅100条目标语言偏好样本时,胜率相对基线提升最高达28%,并在多语言、多模型规模、不同语言距离下均稳定优于基线。
为低资源语言LLM对齐提供了理论保证扎实、数据高效的解决方案,验证了跨语言偏好知识迁移的可行性与鲁棒性。
🆚 方法对比
MAML-RLHF
- 利用多语言数据学习可迁移初始化
- 仅需100样本即可有效适配新语言
- 提供元奖励模型收敛性理论保证
- 比标准RLHF胜率提升显著
- 需多语言偏好数据用于元训练
- 梯度计算开销大,实现复杂
- 依赖语言间任务结构相似性
MAML-DPO
- 元训练初始化支持快速策略适配
- 低资源场景下胜率最高提升28%
- 理论保证元策略优化收敛性
- 在不同目标语言和模型规模上稳定有效
- Bradley-Terry损失超出传统MAML理论范围
- 对元训练语言组合选择敏感
- 计算开销高于标准DPO
Standard RLHF
- 成熟的对齐框架,理论完备
- 实现相对简单,生态支持好
- 依赖大量目标语言偏好数据
- 低资源语言上性能显著下降
- 未利用跨语言知识迁移
Standard DPO
- 无需训练奖励模型,流程简洁
- 直接优化策略,计算效率高
- 低资源语言对齐效果有限
- 缺乏跨语言知识共享机制
- 仅100样本时无法有效微调
Multilingual Preference Aggregation
- 直接利用多语言数据联合训练
- 实现简单,无需任务区分
- 假设语言间存在紧密关联
- 未建模任务级适应结构
- 数据分布不均时效果受限
Target-Language Fine-Tuning
- 针对特定语言优化,效果直接
- 需充足目标语言偏好数据支撑
- 无法利用其他语言知识
- 数据不足时容易过拟合
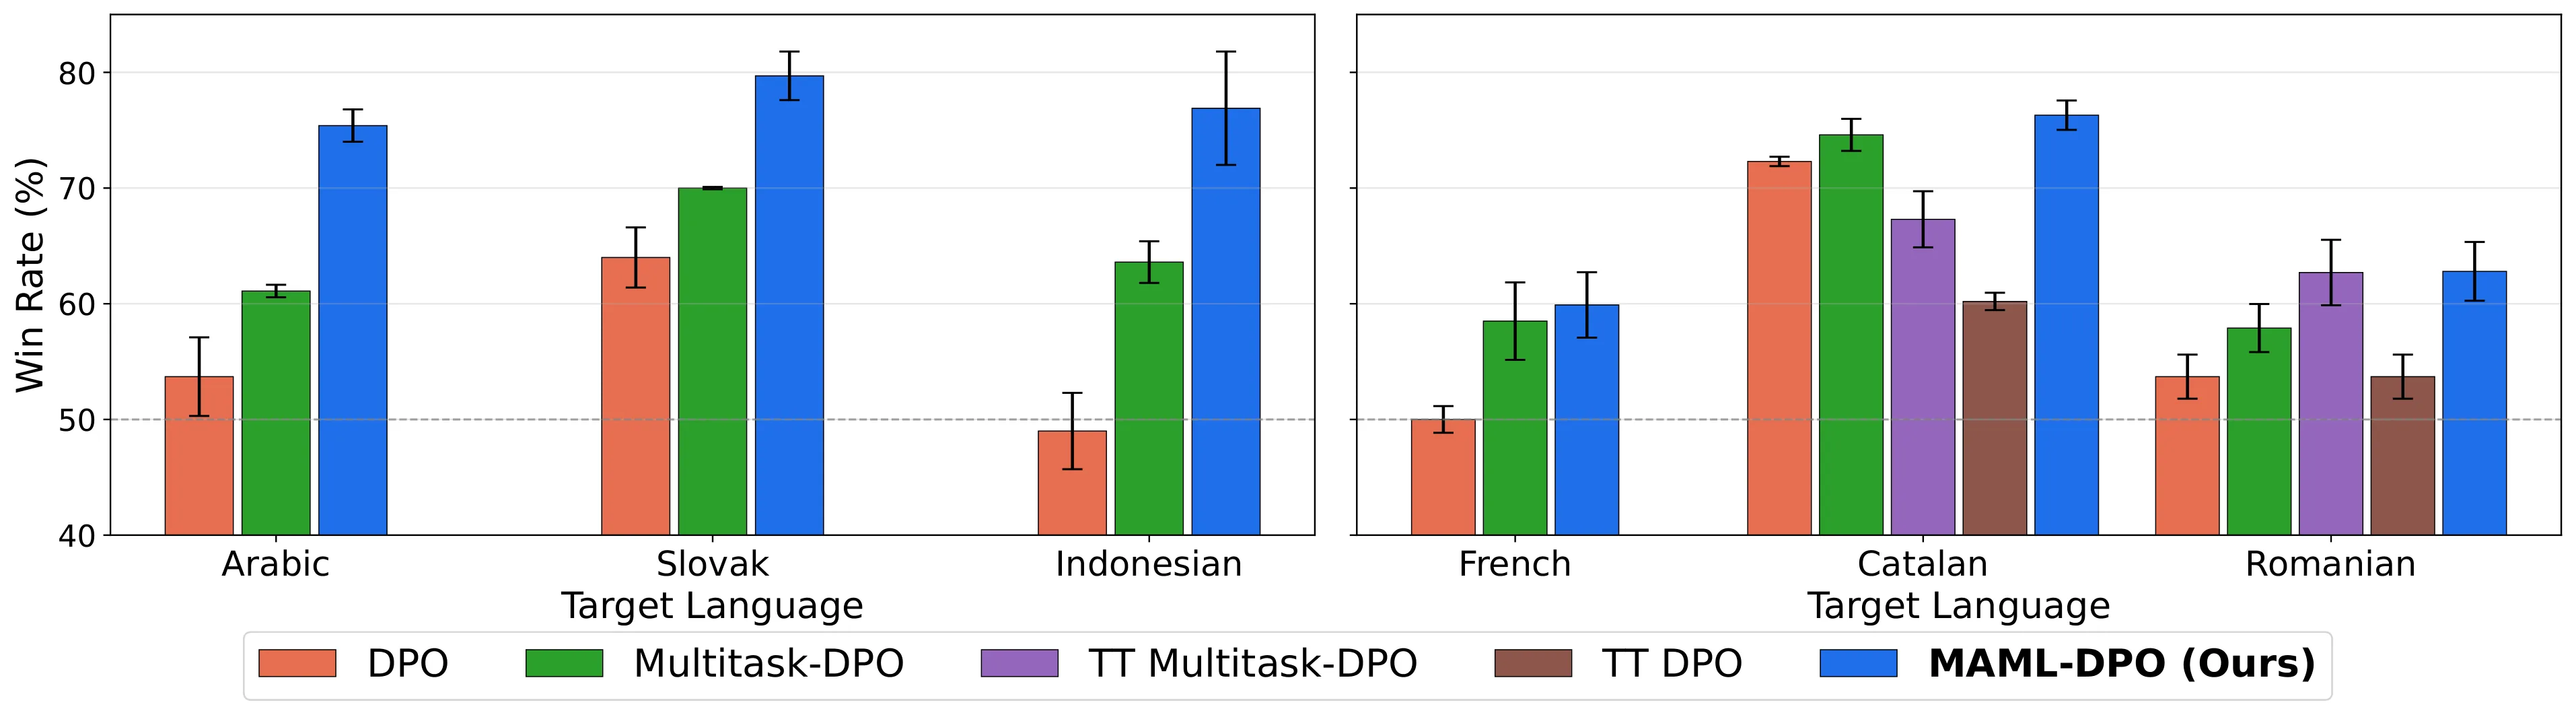
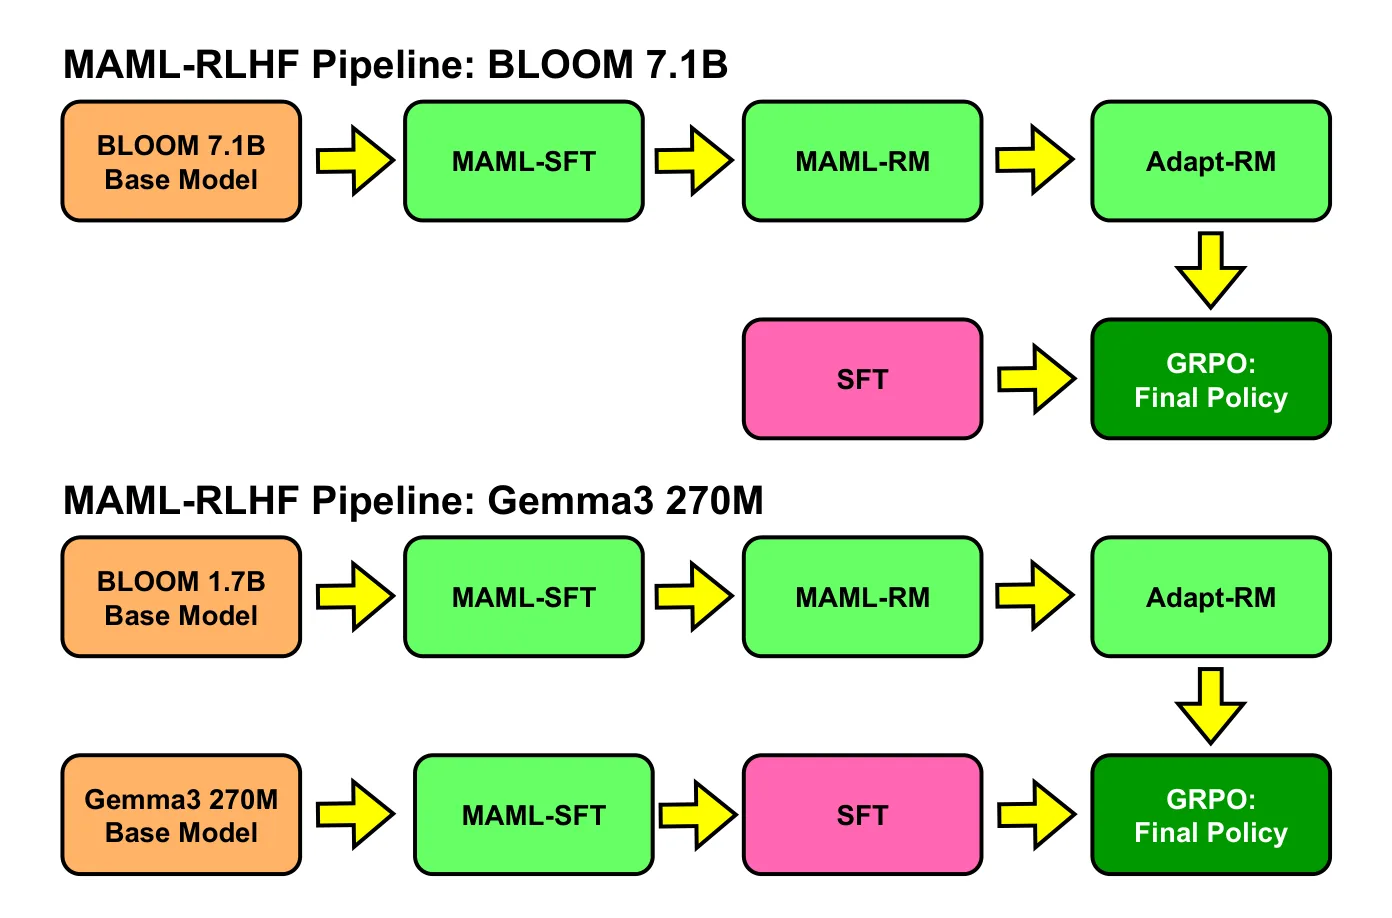
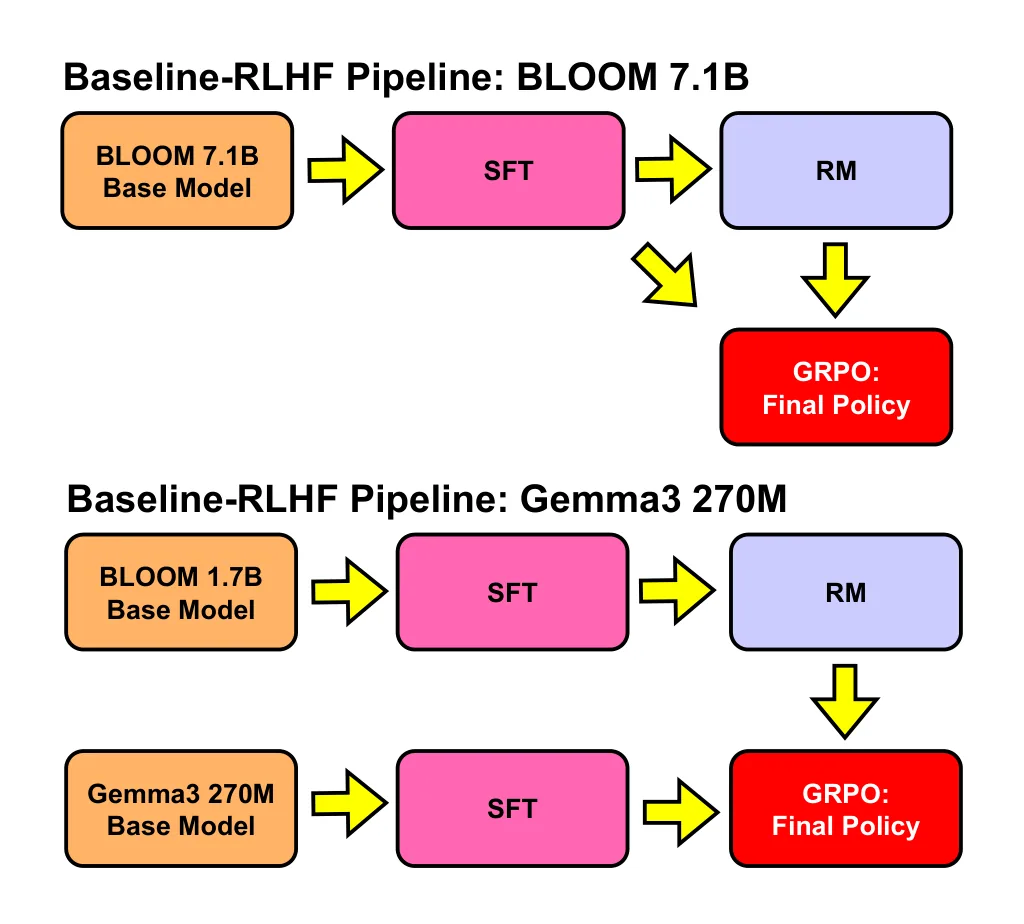
本文提出的MAML-RLHF和MAML-DPO通过元学习将多语言偏好对齐建模为任务级适应问题,显著优于标准RLHF/DPO基线及多语言数据聚合方法;两种方法共享统一元学习框架但分别针对奖励建模和策略优化路径展开。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 10 张)
展开查看 10 张图
TL;DR
本文提出一种面向多语言大语言模型对齐的元学习框架,通过从数据丰富的语言中学习可迁移的初始化参数,使目标语言在仅需 100 条偏好样本的极低资源设定下即可完成有效对齐。实验表明,该方法相比基线最高可获得 28% 的胜率提升,且在多种语言、模型规模和语言距离下均保持优势。
研究背景与动机
大语言模型的对齐训练——无论是基于人类反馈的强化学习(RLHF)还是直接偏好优化(DPO)——都高度依赖大量高质量的人类偏好数据。然而,这类数据的分布在世界各语言之间极不均衡:英语、中文等高资源语言拥有海量标注偏好,而大量低资源语言的可用水准则相当匮乏。这种不均衡直接导致了一个关键问题:同一个模型在不同语言上的对齐质量可能相差悬殊。
面对这一挑战,一个直观的思路是利用高资源语言的数据来辅助低资源语言的对齐。然而,简单地将英语偏好数据迁移到其他语言往往效果有限,因为人类的偏好表达本身就受到语言和文化背景的深刻影响,跨语言迁移会引入显著的分布偏移。
本文的切入点在于:能否从多种语言的偏好数据中学习到一种“通用”的初始化,使得在面对任意目标语言时,只需要极少的本地数据就能完成快速适配? 这正是元学习(meta-learning)的核心思想——学会如何学习。本文将元学习引入多语言偏好对齐,首次为这一设定提供了理论收敛保证,并在实验中验证了其在极低资源场景下的有效性。
方法
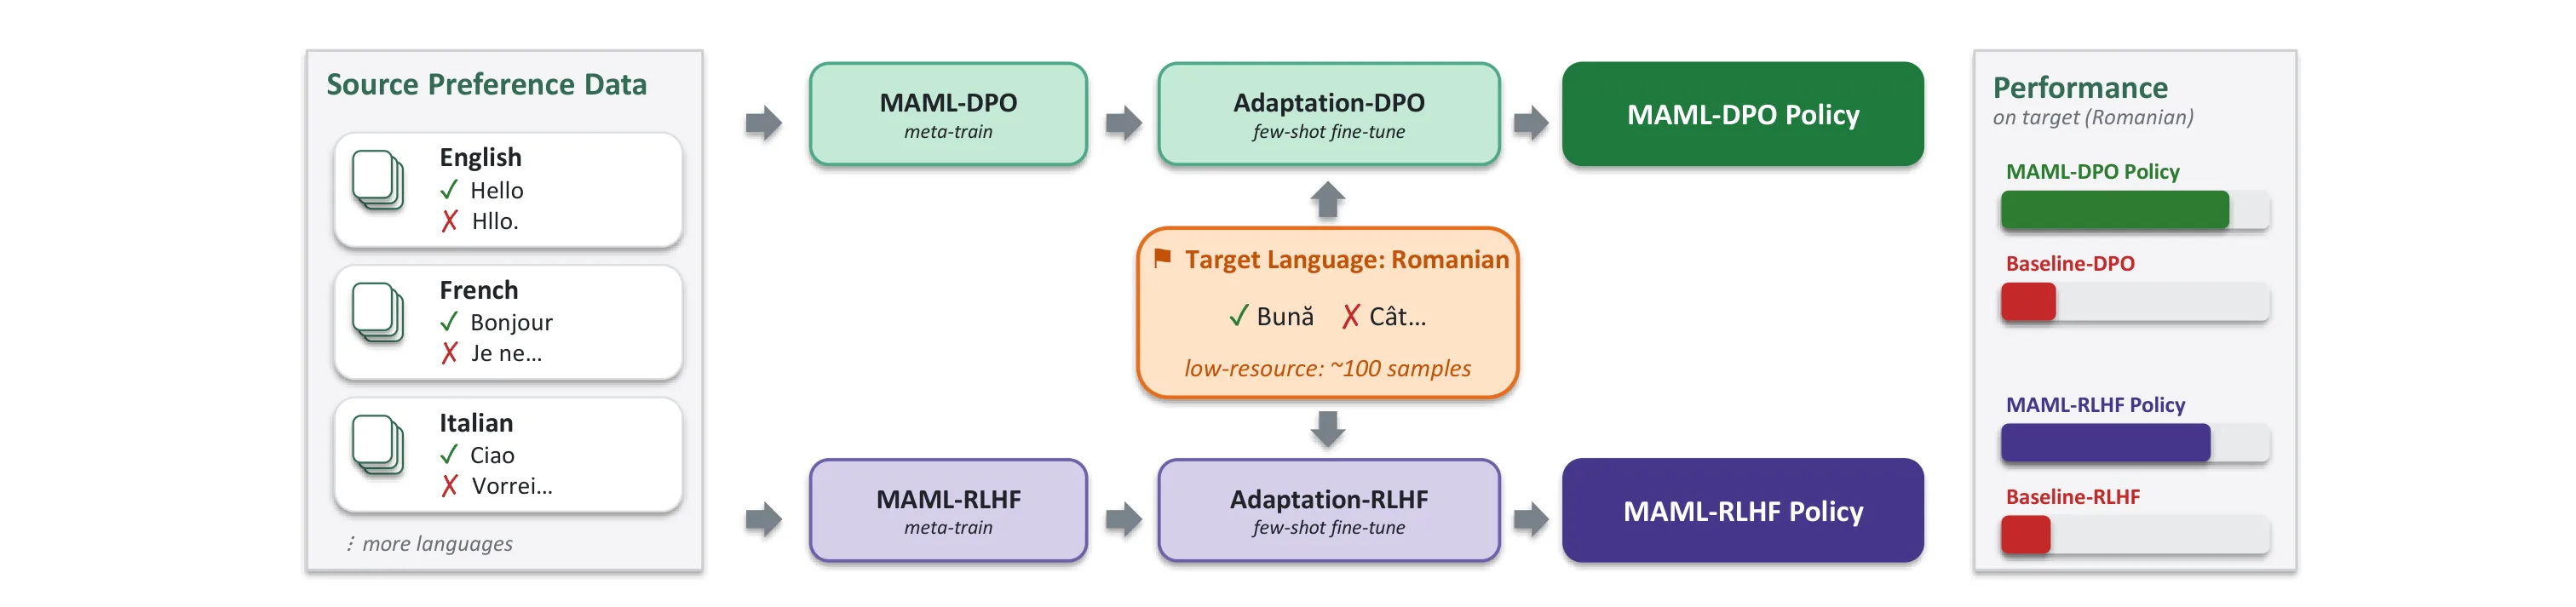
方法的核心是将多语言偏好对齐建模为一个元学习问题。假设我们有一组辅助语言,每个语言都拥有相对充足的偏好数据,而目标语言仅有极少量样本。元学习的目标是利用辅助语言的分布来学习一个初始化参数,这个参数能够通过少量梯度步骤快速适应目标语言。
论文将框架拆解为两个子问题:元奖励建模(meta-reward modeling)和元策略优化(meta-policy optimization)。
在元奖励建模部分,作者希望学习一个奖励函数,使其能够泛化到新语言。形式化地,假设从辅助语言 的偏好数据中采样一个偏好对 ,其中 是输入提示, 是被偏好的响应, 是不被偏好的响应。传统的奖励建模使用Bradley-Terry模型建模偏好概率:
元奖励建模的目标是学习初始奖励参数 ,使得在辅助语言上经历一次内部梯度更新后,参数能更好地适配目标语言:
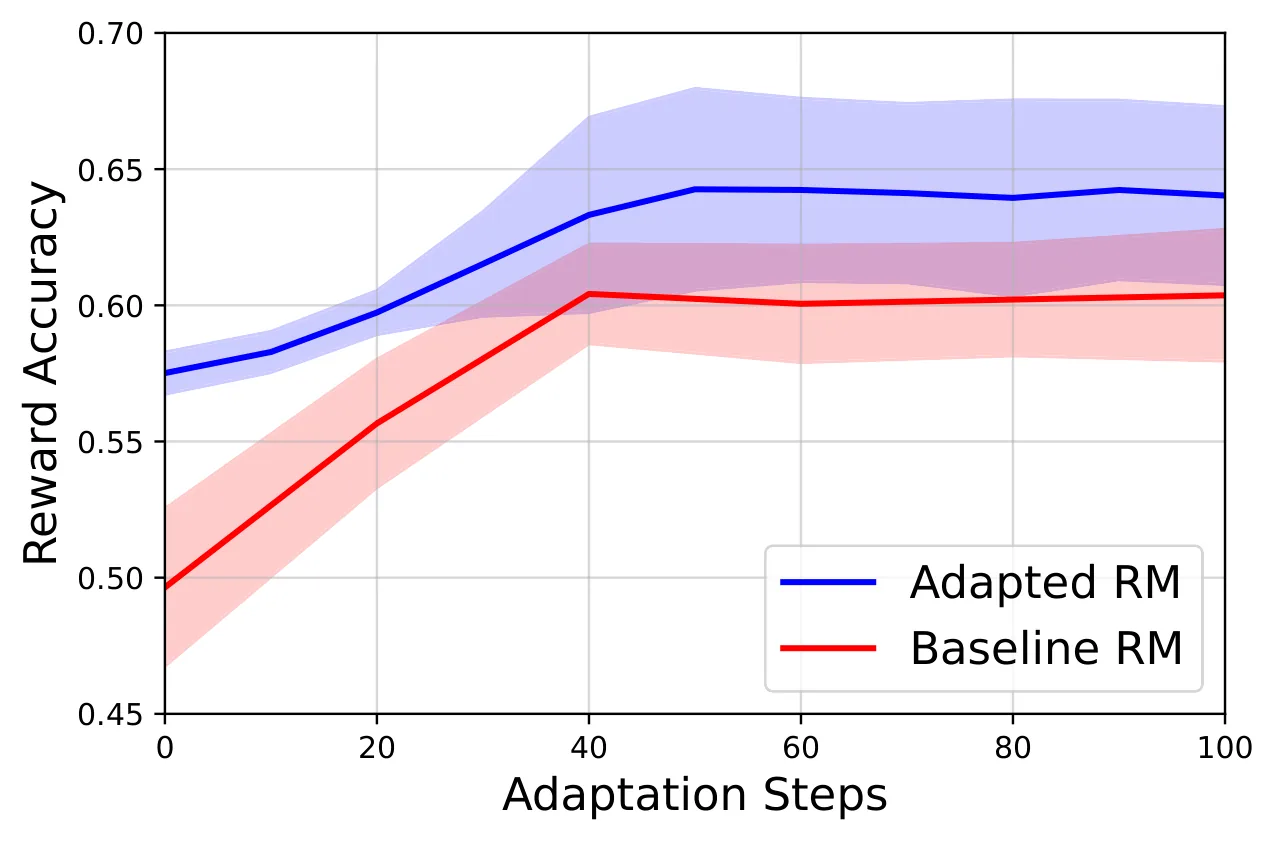
其中 是辅助语言上的偏好损失。外部更新则基于目标语言 的少量样本进行。论文利用MAML(模型无关元学习)的框架,通过分析梯度对齐度(gradient alignment)给出了收敛界:当初始参数位于一个“好”的流形上时,元学习能够保证对目标语言的快速适应。
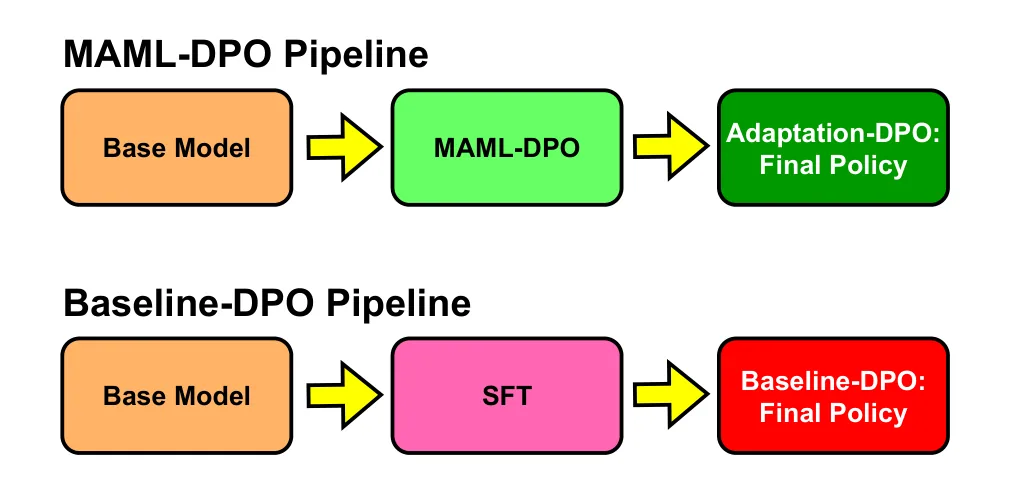
在元策略优化部分,作者将上述思想扩展到 [[DPO]](Direct Preference Optimization)框架。DPO将偏好数据直接转化为策略梯度的监督信号,绕过显式的奖励建模。类似地,元DPO在辅助语言上执行一步内部更新,然后在目标语言上进行外部更新:
其中 是经过内部更新的奖励函数, 是温度参数。
值得强调的是,这种分阶段的内-外循环设计是元学习的精髓所在:内部循环让模型在辅助任务上“学一次”,外部循环则评估这种学习能否迁移到新任务上。通过多次迭代,模型逐渐调整初始化参数,使其对各种语言都具有良好的少样本适应能力。
实验与结果
论文在多种实验设定下验证了方法的有效性。基准数据集涵盖了不同语系的语言,包括高资源语言和低资源语言,以模拟真实世界中的语言多样性。评估指标采用胜率(win-rate),即在相同提示下,由待评估模型生成的响应相比基线模型更被人类偏好的比例。
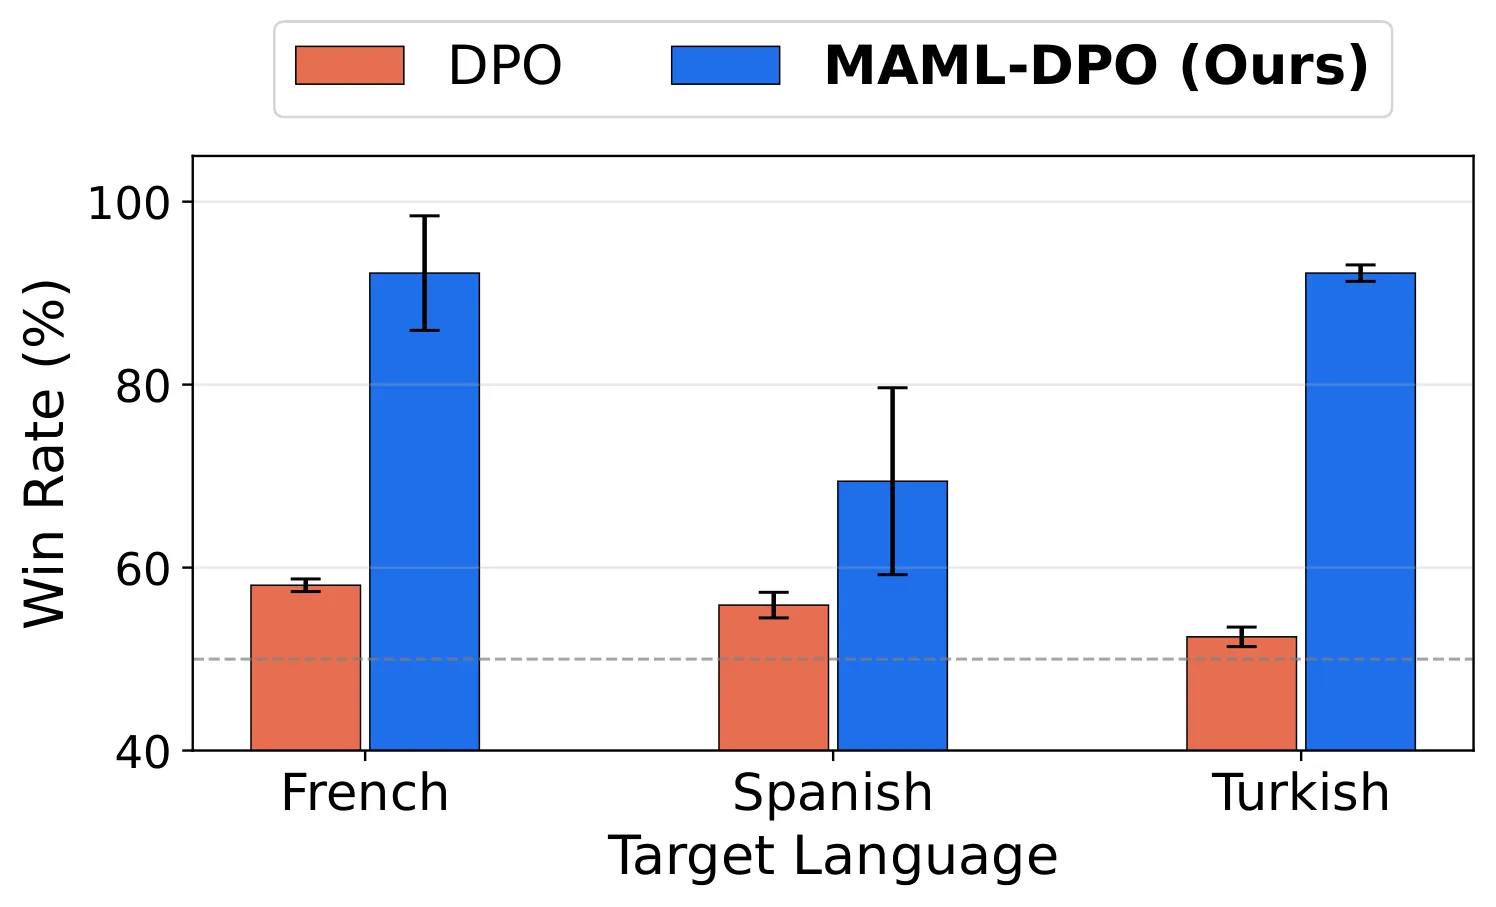
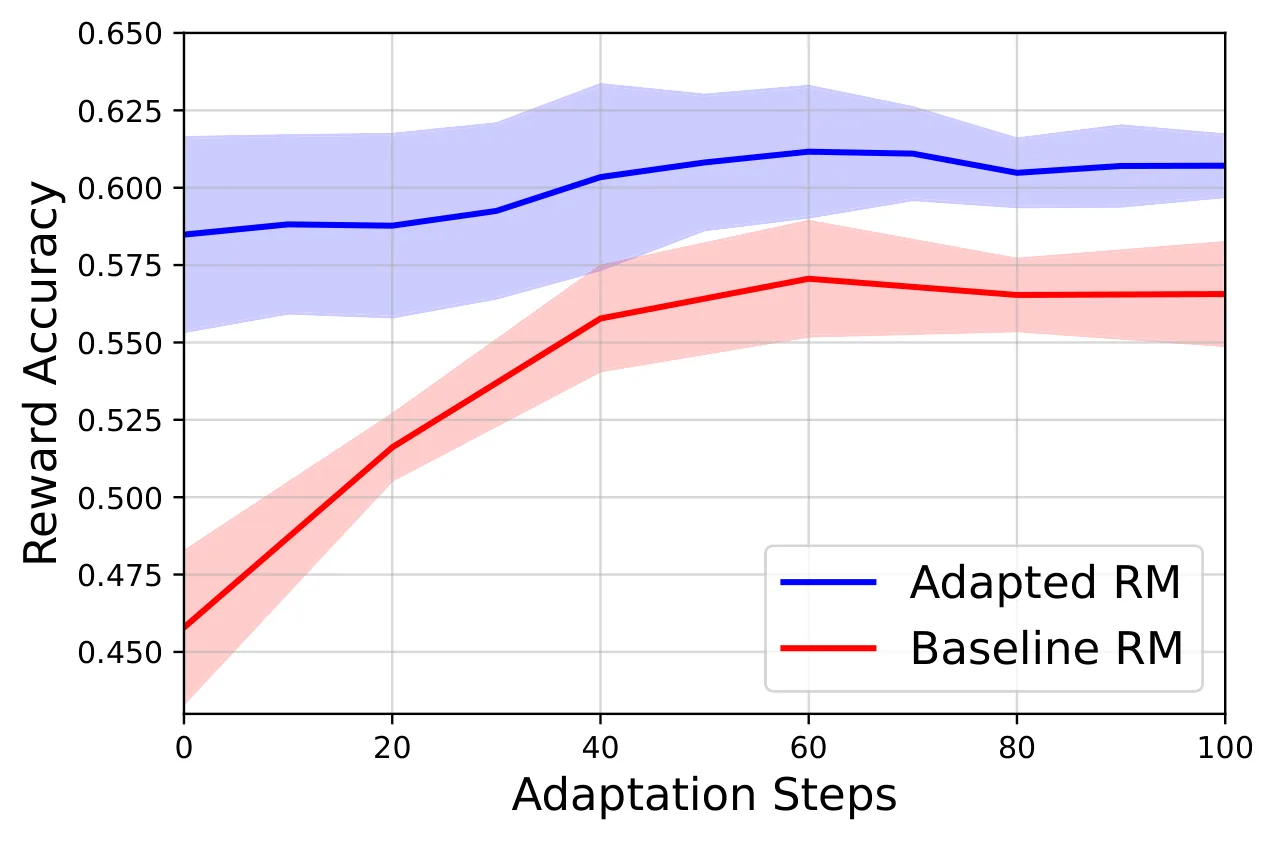
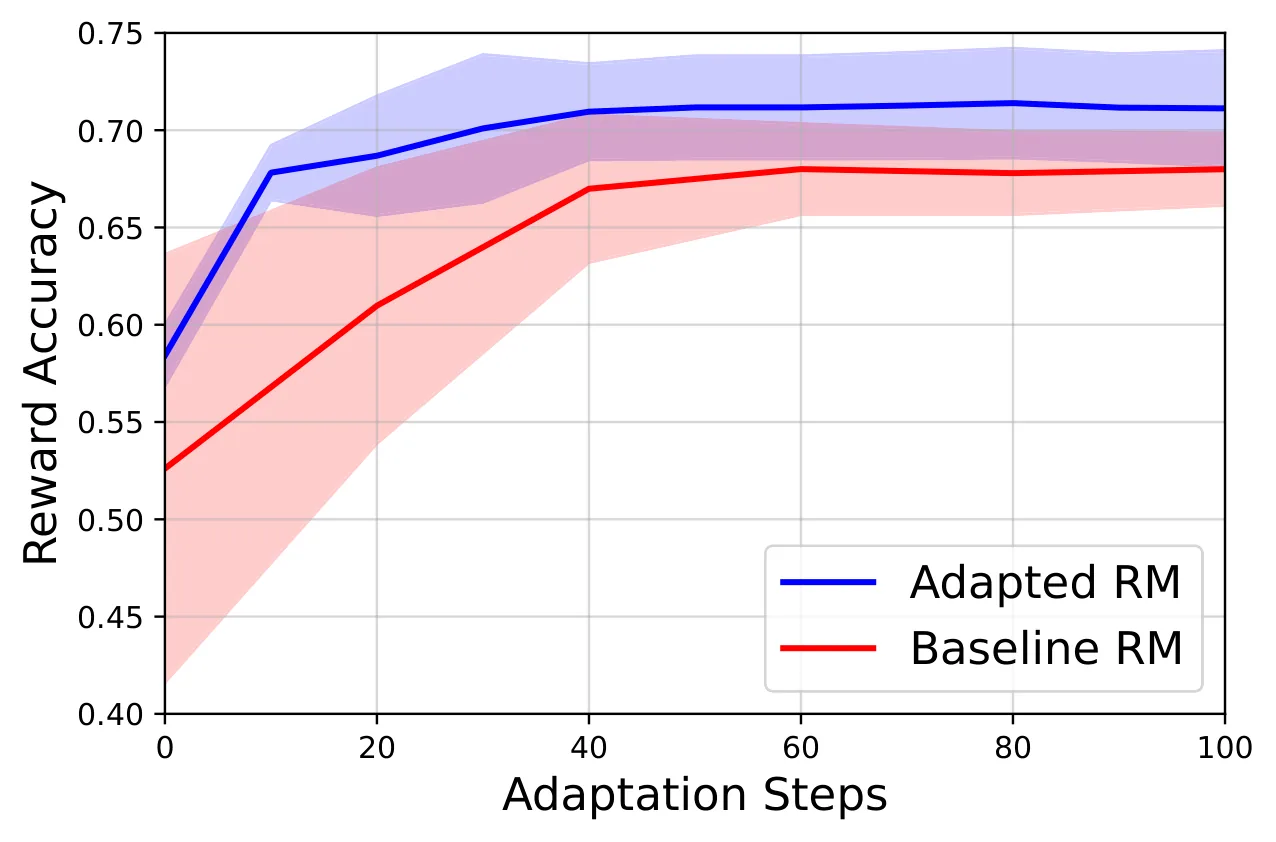
核心实验在极低资源设定下进行:目标语言仅使用 100 条偏好样本,而辅助语言则使用完整的可用数据。实验结果揭示了几个重要发现。首先,在仅有 100 条目标语言样本时,元学习方法相较于仅使用目标语言数据的基线方法实现了最高 28% 的胜率提升,这一幅度在实际应用中具有显著意义。其次,方法的优势在不同模型规模上均得到保持,说明元学习策略的收益不依赖于特定的模型容量。
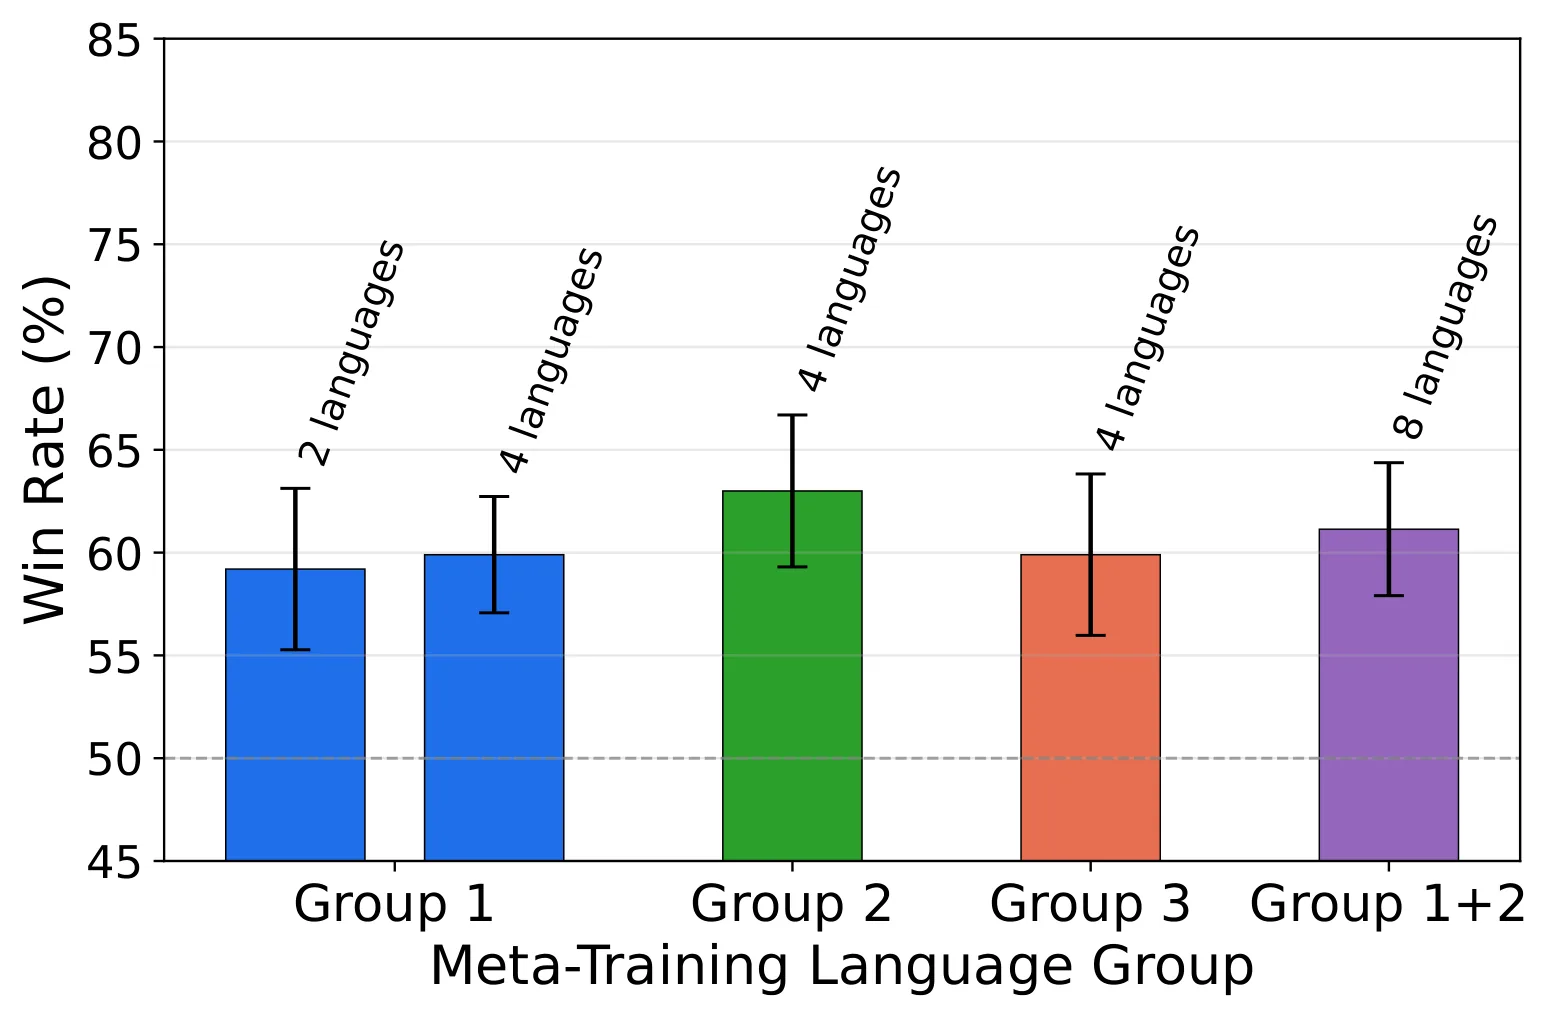
进一步的分析探究了语言距离的影响。论文测试了辅助语言与目标语言在不同语言学距离下的表现,结果显示元学习方法在各种距离设定下均优于基线,表明学习到的初始化参数具有跨语言泛化能力,而非仅仅捕捉了特定语言对的浅层关联。此外,当改变辅助语言的组合时(如只用印欧语系语言作为辅助,或混合使用不同语系),方法始终保持稳定优势,验证了其对辅助集构成的鲁棒性。
讨论与可借鉴点
尽管实验结果令人振奋,这项工作仍有若干值得深入探讨的局限。首先,理论分析基于若干简化假设(如偏好数据的独立同分布假设),在实际场景中,人类偏好的跨语言变异性可能更复杂,这为理论向实践的迁移留下了一定的鸿沟。其次,论文主要关注文本生成质量这一单一维度,而实际的对齐需求往往涉及安全性、有害性检测、价值观一致性等多个方面,如何在多维度上保持元学习的有效性仍有待探索。
从更宽广的视角来看,这项工作为大语言模型的多语言对齐提供了一种新的范式:与其为每种语言收集昂贵的偏好数据,不如通过元学习实现知识的跨语言迁移。这一思路启发了一系列后续问题:如何选择最优的辅助语言组合?语言类型学特征能否被显式编码以加速元学习?在模型持续预训练或微调的过程中,元学习的初始化策略是否需要动态调整?
对于从事大模型对齐研究或低资源语言处理的研究者而言,本文的核心贡献在于证明了元学习作为一种高效数据利用策略的可行性。它提醒我们,在追求更大规模、更多数据的同时,如何更好地复用已有知识,可能同样重要。
摘要
人类偏好数据在不同语言间的可用性不均衡,这对多语言场景下的大语言模型对齐构成了重大挑战。为了解决低资源语言对齐中数据不足的问题,我们针对基于人类反馈的强化学习和直接偏好优化提出了一种元学习框架。该框架通过利用其他语言的偏好数据,学习一种可迁移的初始化参数,使得在极少数据条件下也能有效地适配到目标语言。我们针对元奖励建模和元策略优化两种设定提供了理论保证,并在多语言基准上实证验证了所提方法的有效性。在仅有 100 条目标语言偏好样本的极低资源设定下,我们的方法相较于基线方法取得了高达 28% 的胜率提升,并在多种目标语言和模型规模上始终优于基线方法。此外,我们的方法在不同元训练语言组合以及与目标语言之间存在不同语言距离的情况下均保持了上述优势。
Abstract
Unequal availability of human preference data across languages poses a significant challenge for aligning large language models in multilingual settings. To address the lack of sufficient data in low-resource language alignment, we propose a meta-learning framework for Reinforcement Learning from Human Feedback and Direct Preference Optimization. By leveraging preference data from other languages, our framework learns a transferable initialization that enables effective adaptation to a target language with minimal data. We provide theoretical guarantees for both the meta-reward modeling and meta-policy optimization settings, and empirically demonstrate the effectiveness of our approach on multilingual benchmarks. In an extremely low-resource setting with only 100 target-language preference samples, our approach achieves up to win-rate improvements over baseline methods, and consistently outperforms baselines across multiple target languages and model scales. Our approaches retain these advantages across different combinations of meta-training languages and varying linguistic distances from the target languages.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。