
通过世界模型从人类偏好与理由中学习安全的智能体行为
Learning Safe Agent Behaviour from Human Preferences and Justifications via World Models
📝 TLDR
在安全关键场景中,环境动力学未知且缺乏合适奖励函数,传统强化学习难以直接部署安全策略。为此提出 DROPJ 方法,先从已有真实轨迹学习世界模型,由人类在模拟器中交互生成有信息量的轨迹,再通过对比轨迹片段获取人类偏好与安全理由,联合训练奖励模型并基于模型预测控制部署策略。实验表明,该方法能显著降低训练计算成本,提升部署性能,且安全理由能有效强化用户关注的安全维度。
🧭 速览
安全关键环境下,环境动力学未知且无合适奖励函数,传统强化学习难以兼顾安全性与有效性。
DROPJ:先学习世界模型,人类在模拟器中生成信息轨迹,通过对比片段获取偏好与安全理由,联合训练奖励模型并用模型预测控制部署。
真实用户实验显示,偏好优于其他反馈形式,安全理由能提升安全性能或优先满足用户关注的特定安全方面。
将人类偏好与安全理由融入世界模型和模型预测控制,为安全关键场景下的策略训练与部署提供了可行路径。
🆚 方法对比
DROPJ
- 结合世界模型与偏好学习,无需预设奖励函数
- 用户一次性生成示例,降低计算成本
- 安全理由增强部署时的安全性
- 假设无预设环境动力学,更贴近真实场景
- 依赖世界模型质量,不完美模拟器限制性能
- 需要人类用户参与,存在人工负担
- 42页论文方法复杂度高,实现门槛大
- 依赖离线轨迹数据质量,数据不足时受限
World Model (世界模型)
- 从离线轨迹学习,避免真实环境安全探索
- 提供安全训练的模拟环境,支持不安全状态访问
- 可重复利用,支持多次安全部署
- 模型不完美,部署时仍可能违反安全约束
- 依赖离线数据集质量和覆盖范围
- 建模误差可能累积导致性能偏差
One-shot 轨迹生成技术
- 用户仅需几分钟参与,显著降低人工负担
- 一次生成多样化示例,减少迭代计算成本
- 相比迭代方法显著提升训练效率
- 依赖用户理解模拟器并采取有意义动作
- 单次生成可能无法覆盖所有关键场景
- 用户操作能力影响生成轨迹质量
安全理由 (Safety Justifications)
- 显著增强部署时的安全性表现
- 可优先考虑用户指定的安全方面
- 离线提供反馈而非在线监督,可扩展性强
- 理由标注增加用户认知负担
- 理由质量参差不齐影响奖励模型学习
- 用户需清晰表达安全关切
模型预测控制 (MPC)
- 结合学习到的动力学与奖励模型直接部署
- 无需额外训练策略,减少策略迁移风险
- 利用世界模型保证部署过程安全性
- 计算开销较大,实时性受限
- 依赖世界模型与奖励模型的准确性
- 在长视野任务中性能可能下降
先前迭代式偏好学习方法 ([62,63])
- 通过迭代查询逐步改进奖励模型
- 在简单任务中可生成信息丰富的查询
- 理论上可逐步逼近用户意图
- 迭代过程计算成本高昂,难以扩展
- 用户需长时间在线提供反馈,负担重
- 在复杂任务中查询生成困难且耗时
Safe RL (约束式安全强化学习)
- 通过约束设置提供安全保证的理论框架
- 在环境动力学已知时效果较好
- 有成熟的算法体系
- 假设已知环境动力学,限制实际应用
- 需要明确定义的奖励函数,难以处理复杂目标
- 安全约束与人类价值观可能不对齐
传统强化学习 (Traditional RL)
- 算法成熟,在已知环境中效果良好
- 无需人类持续参与,自动化程度高
- 在安全关键环境中探索风险大
- 奖励函数不对齐时可能导致危险行为
- 端到端训练在真实世界不安全
本文提出的DROPJ框架通过世界模型+一次性偏好生成+安全理由的组合,相比先前迭代式偏好方法显著降低计算成本与人工负担,相比约束式Safe RL无需预知环境动力学,在安全性与实用性上均具优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 37 张)
展开查看 37 张图
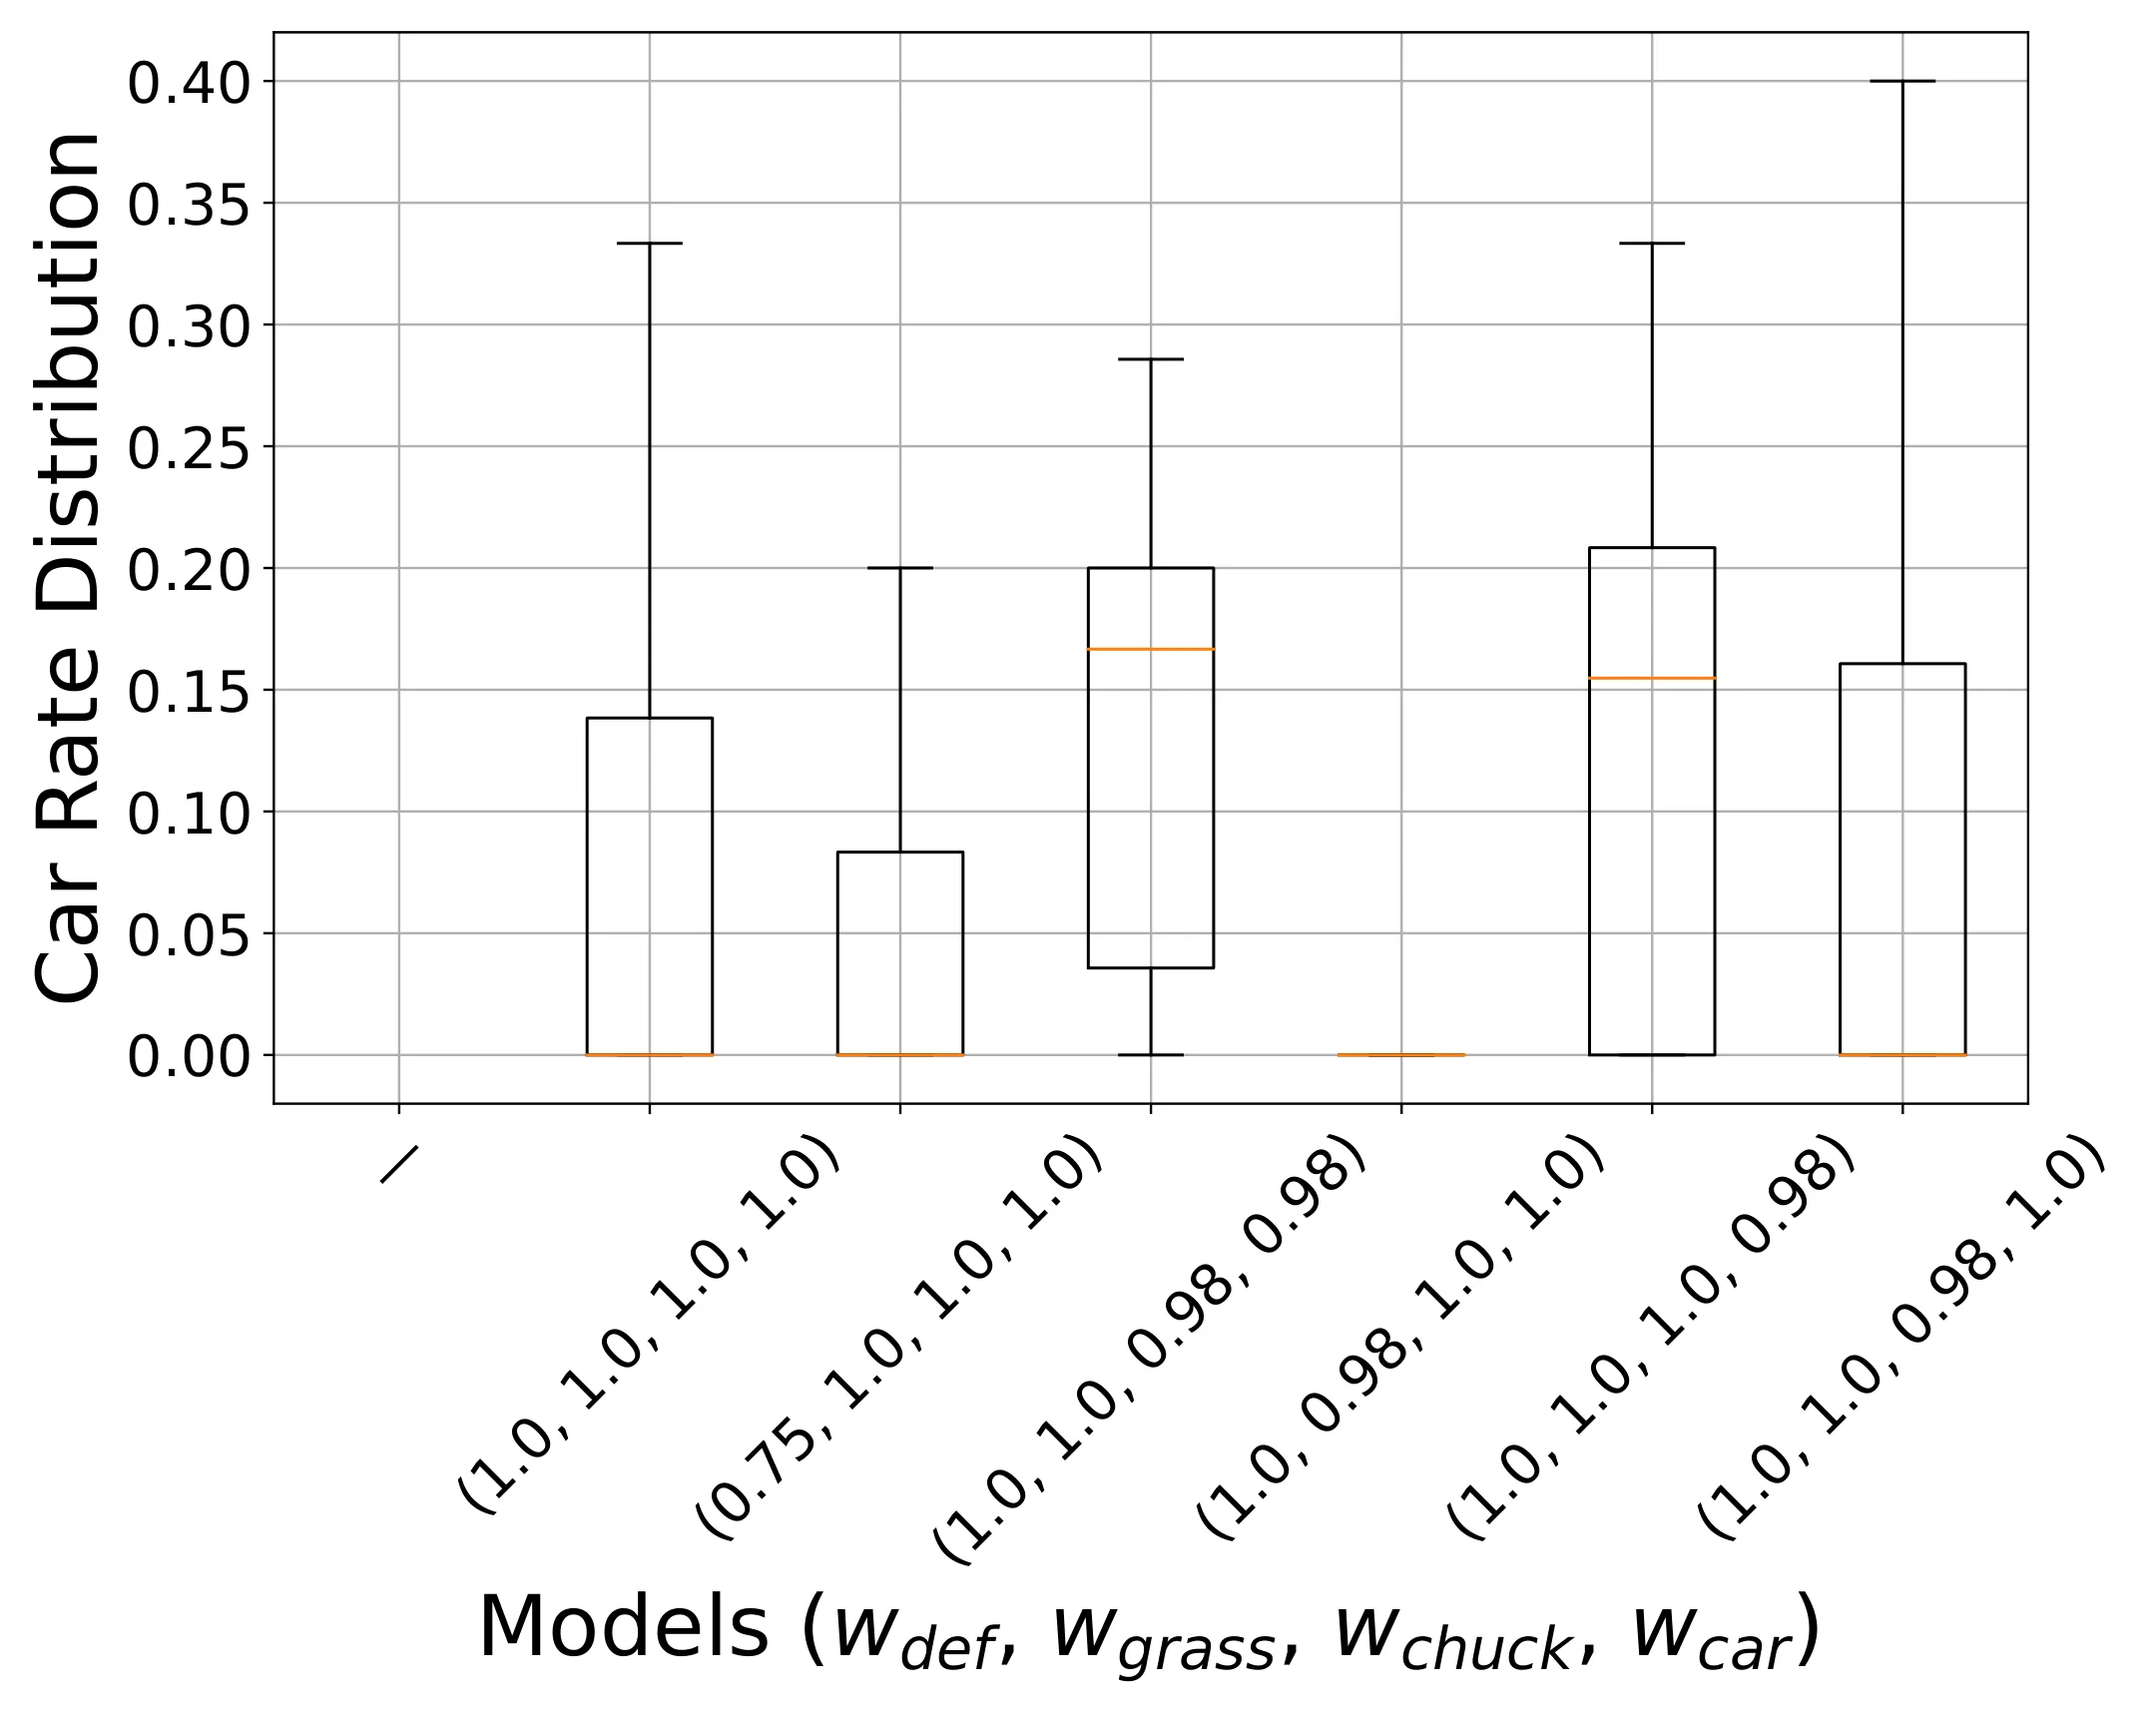
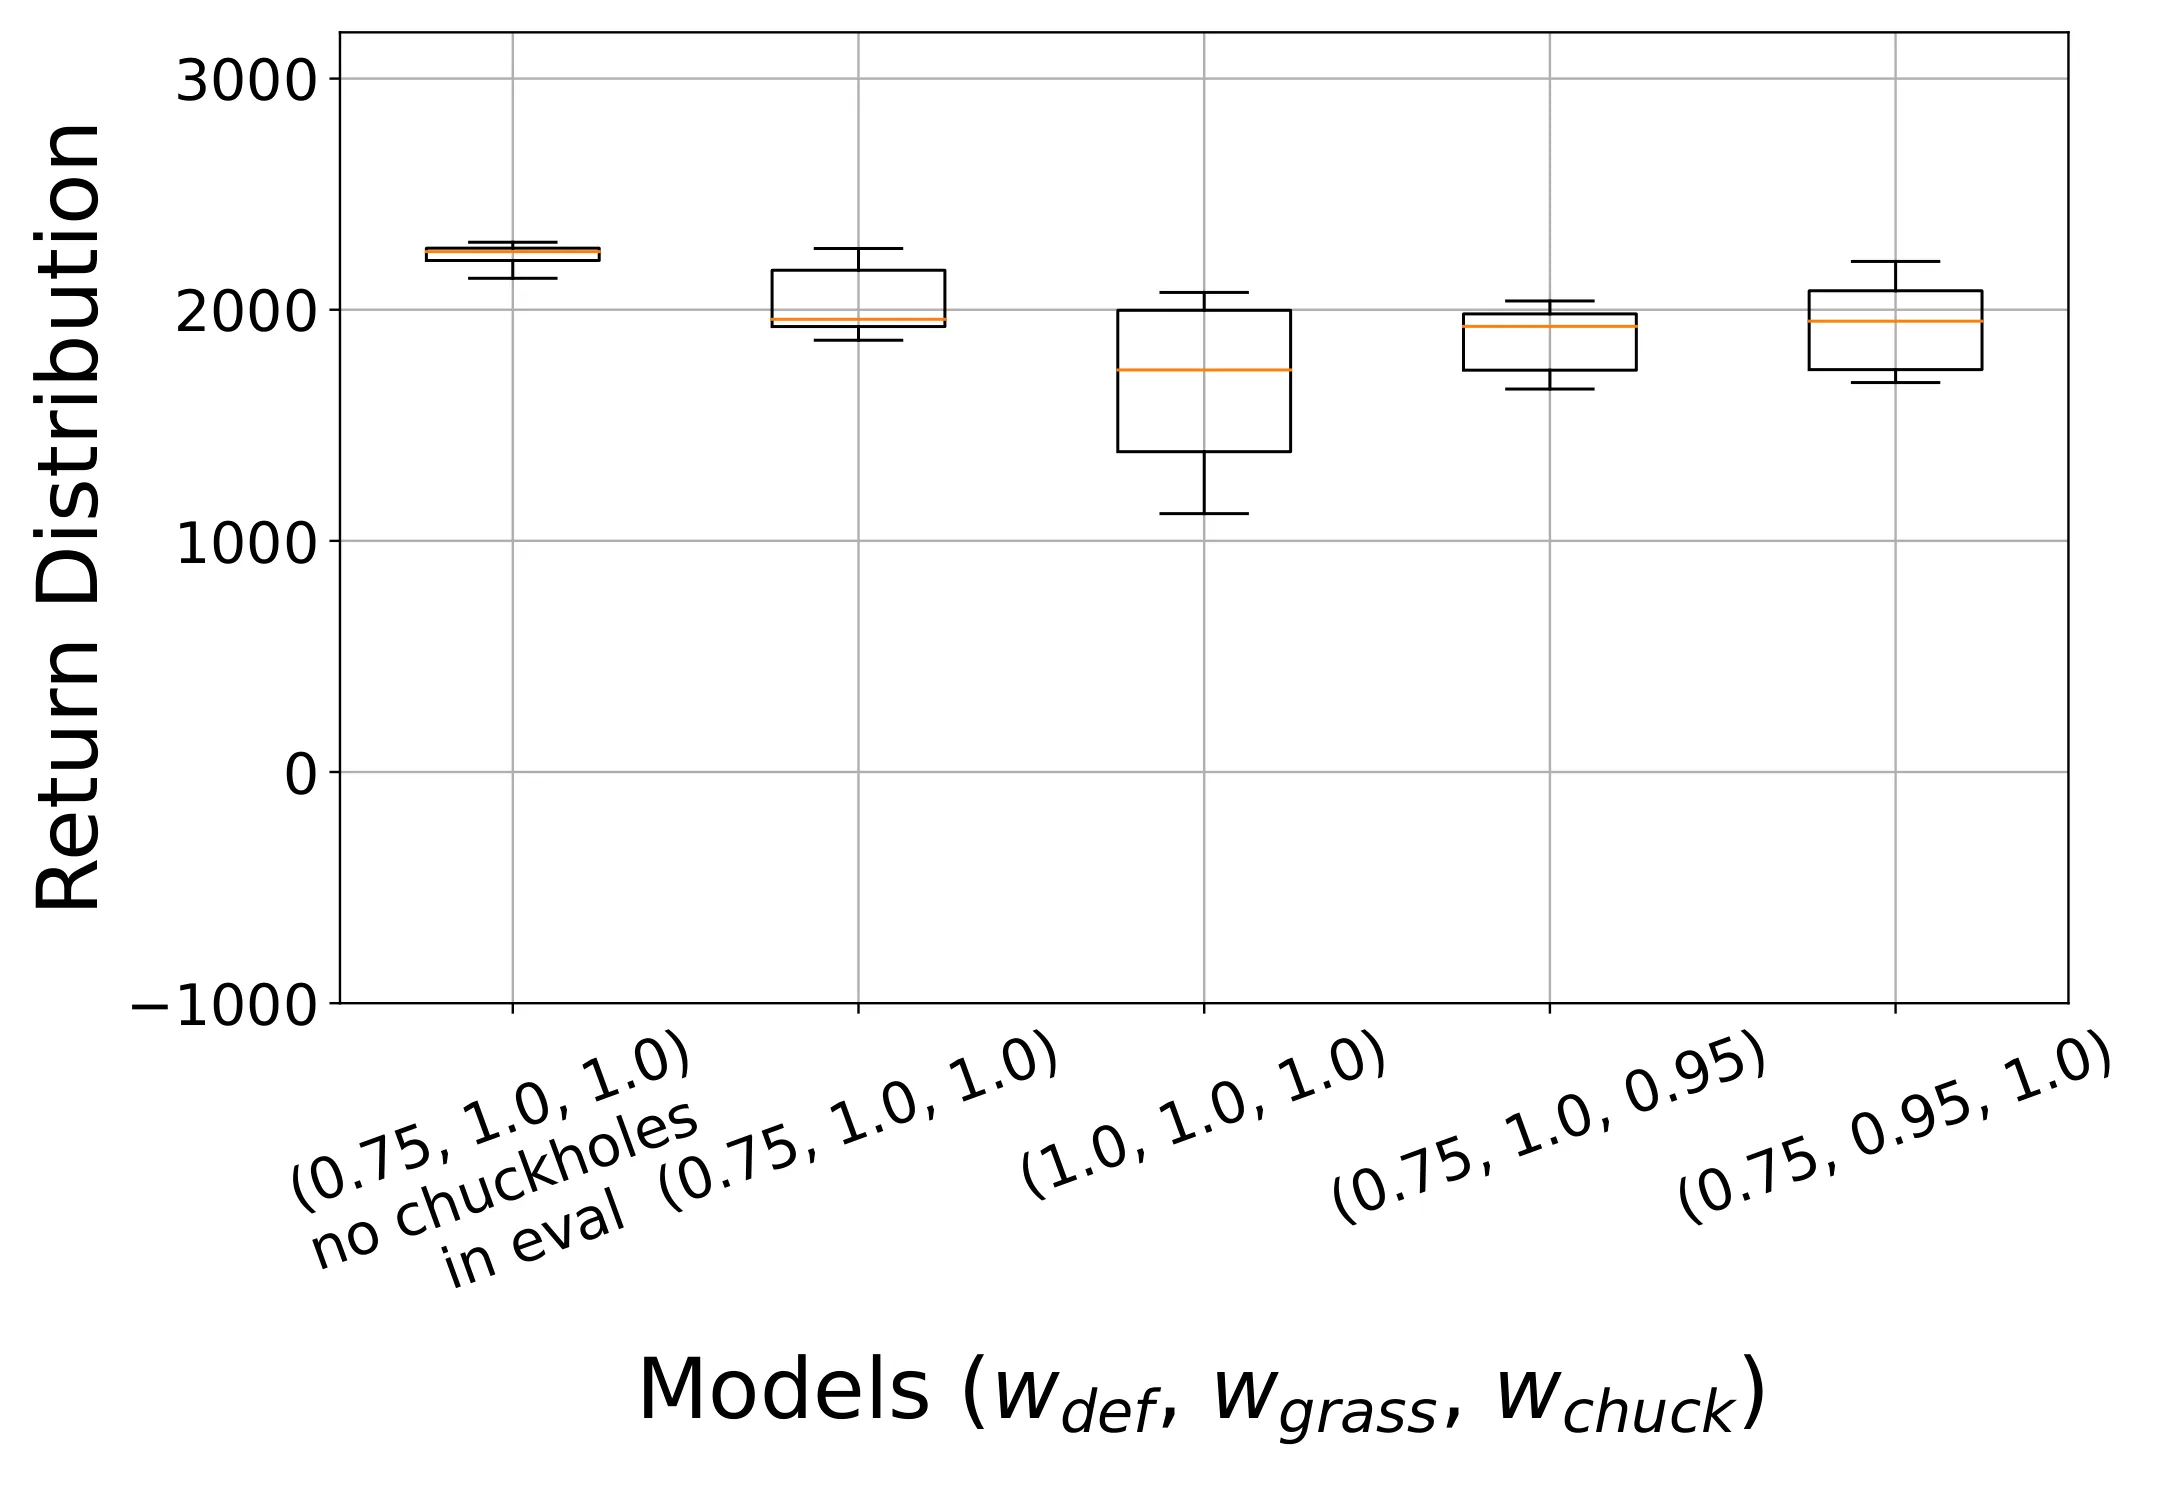
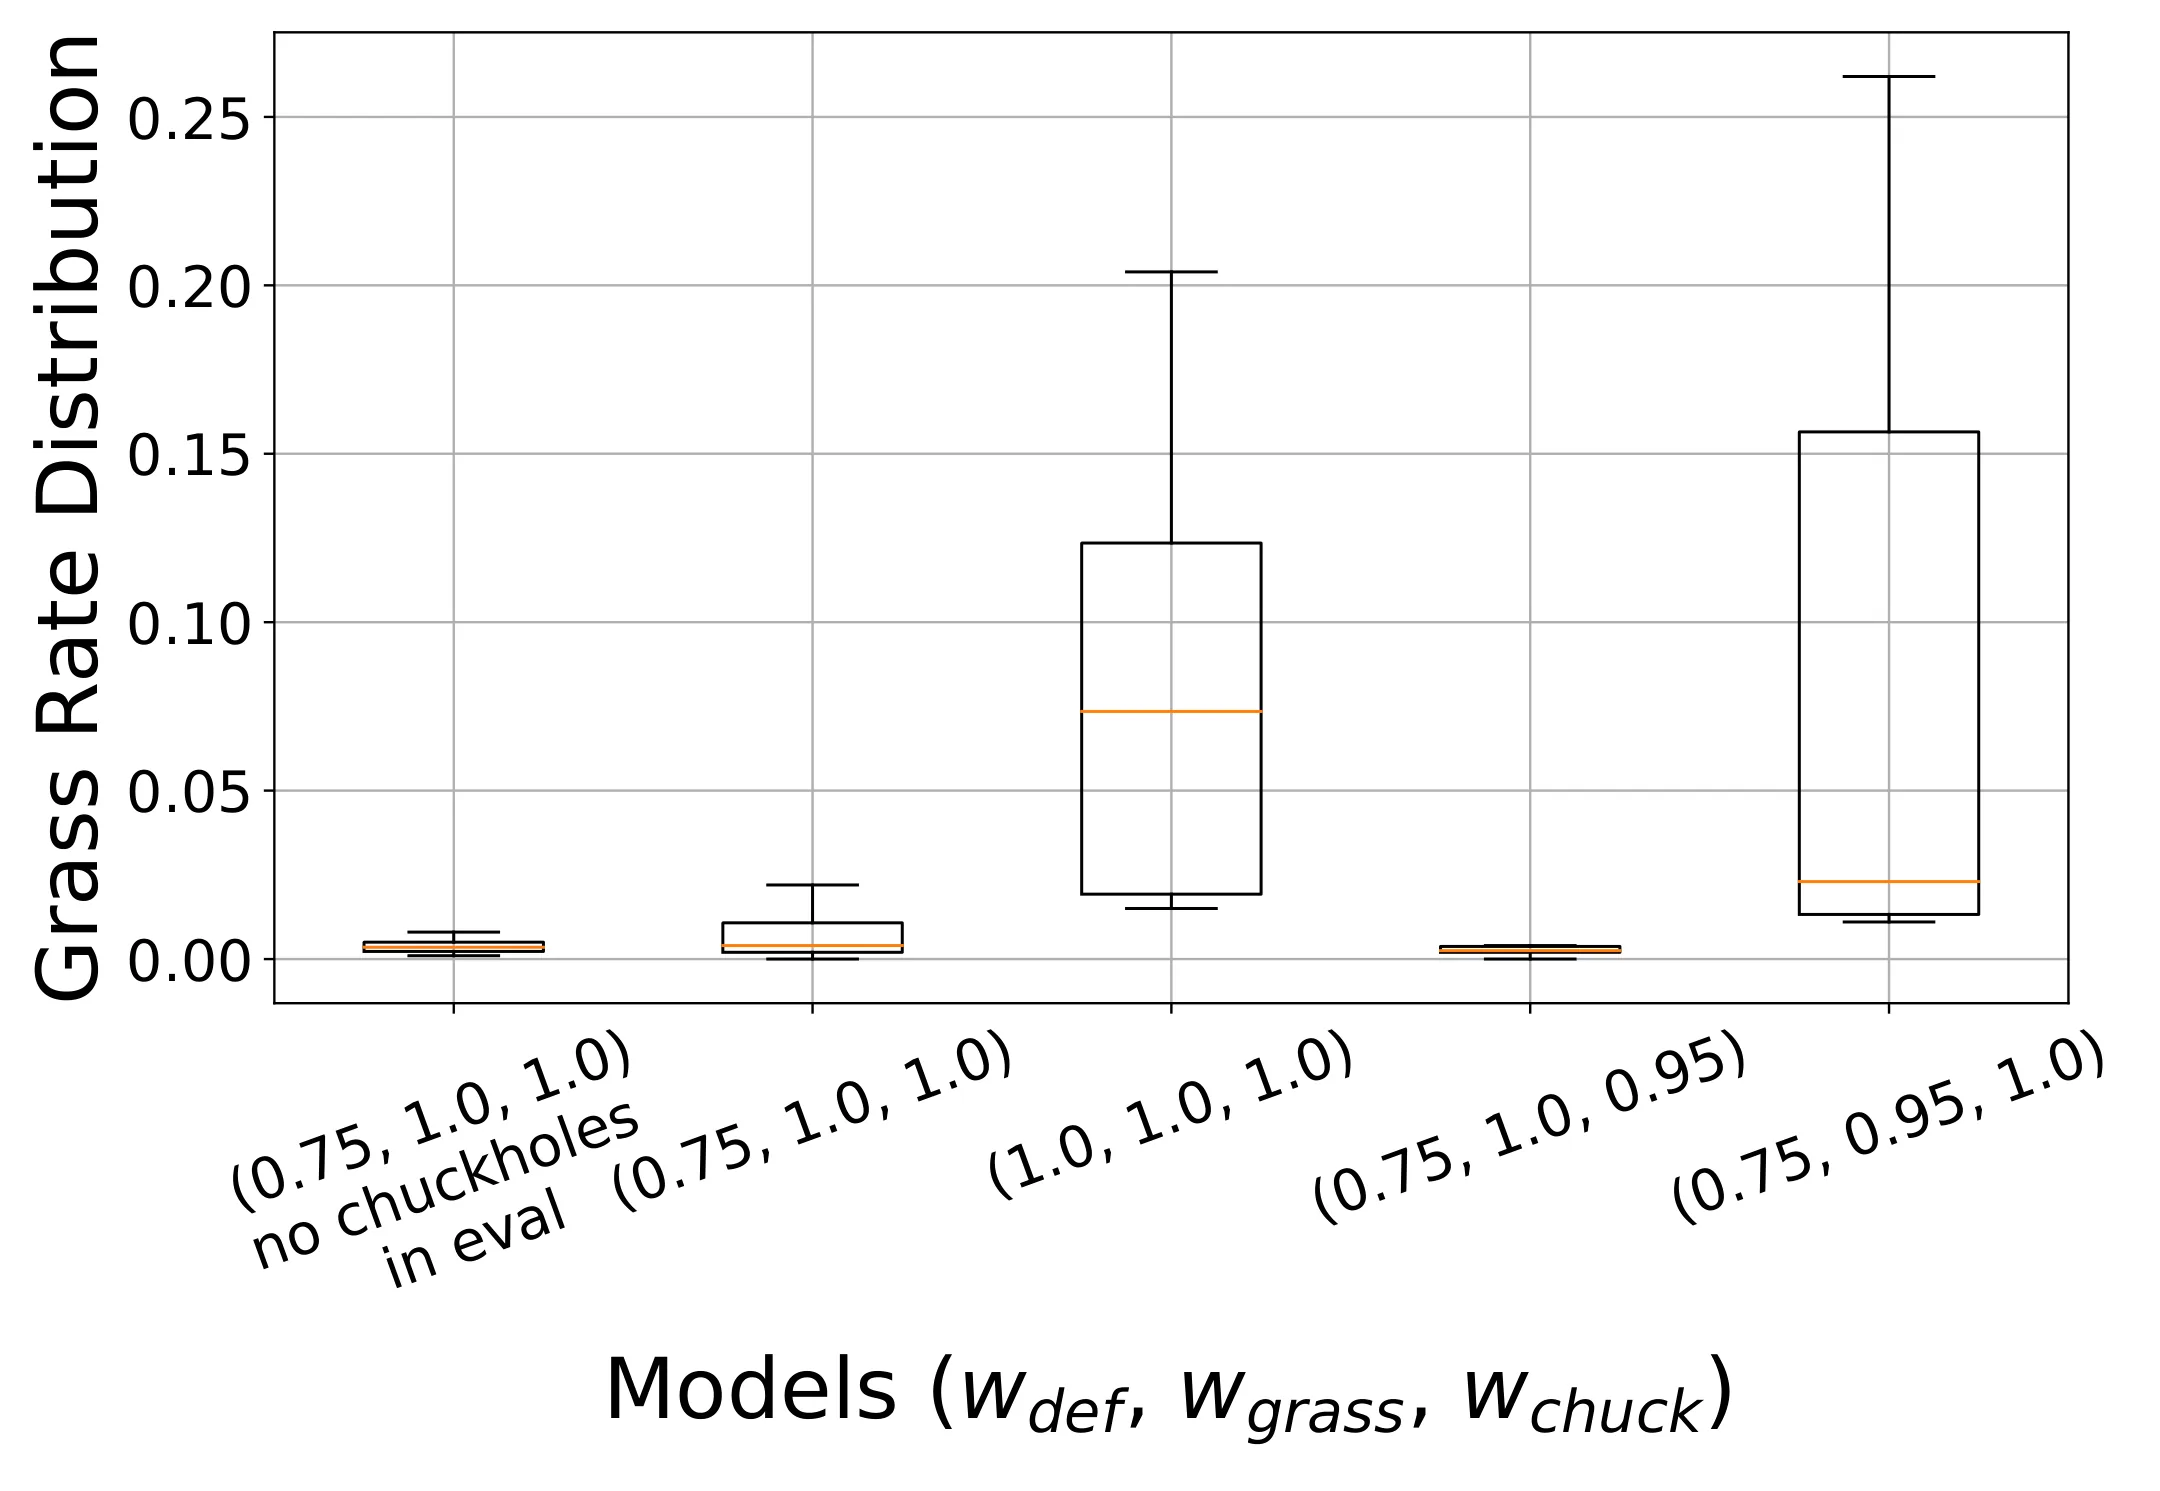
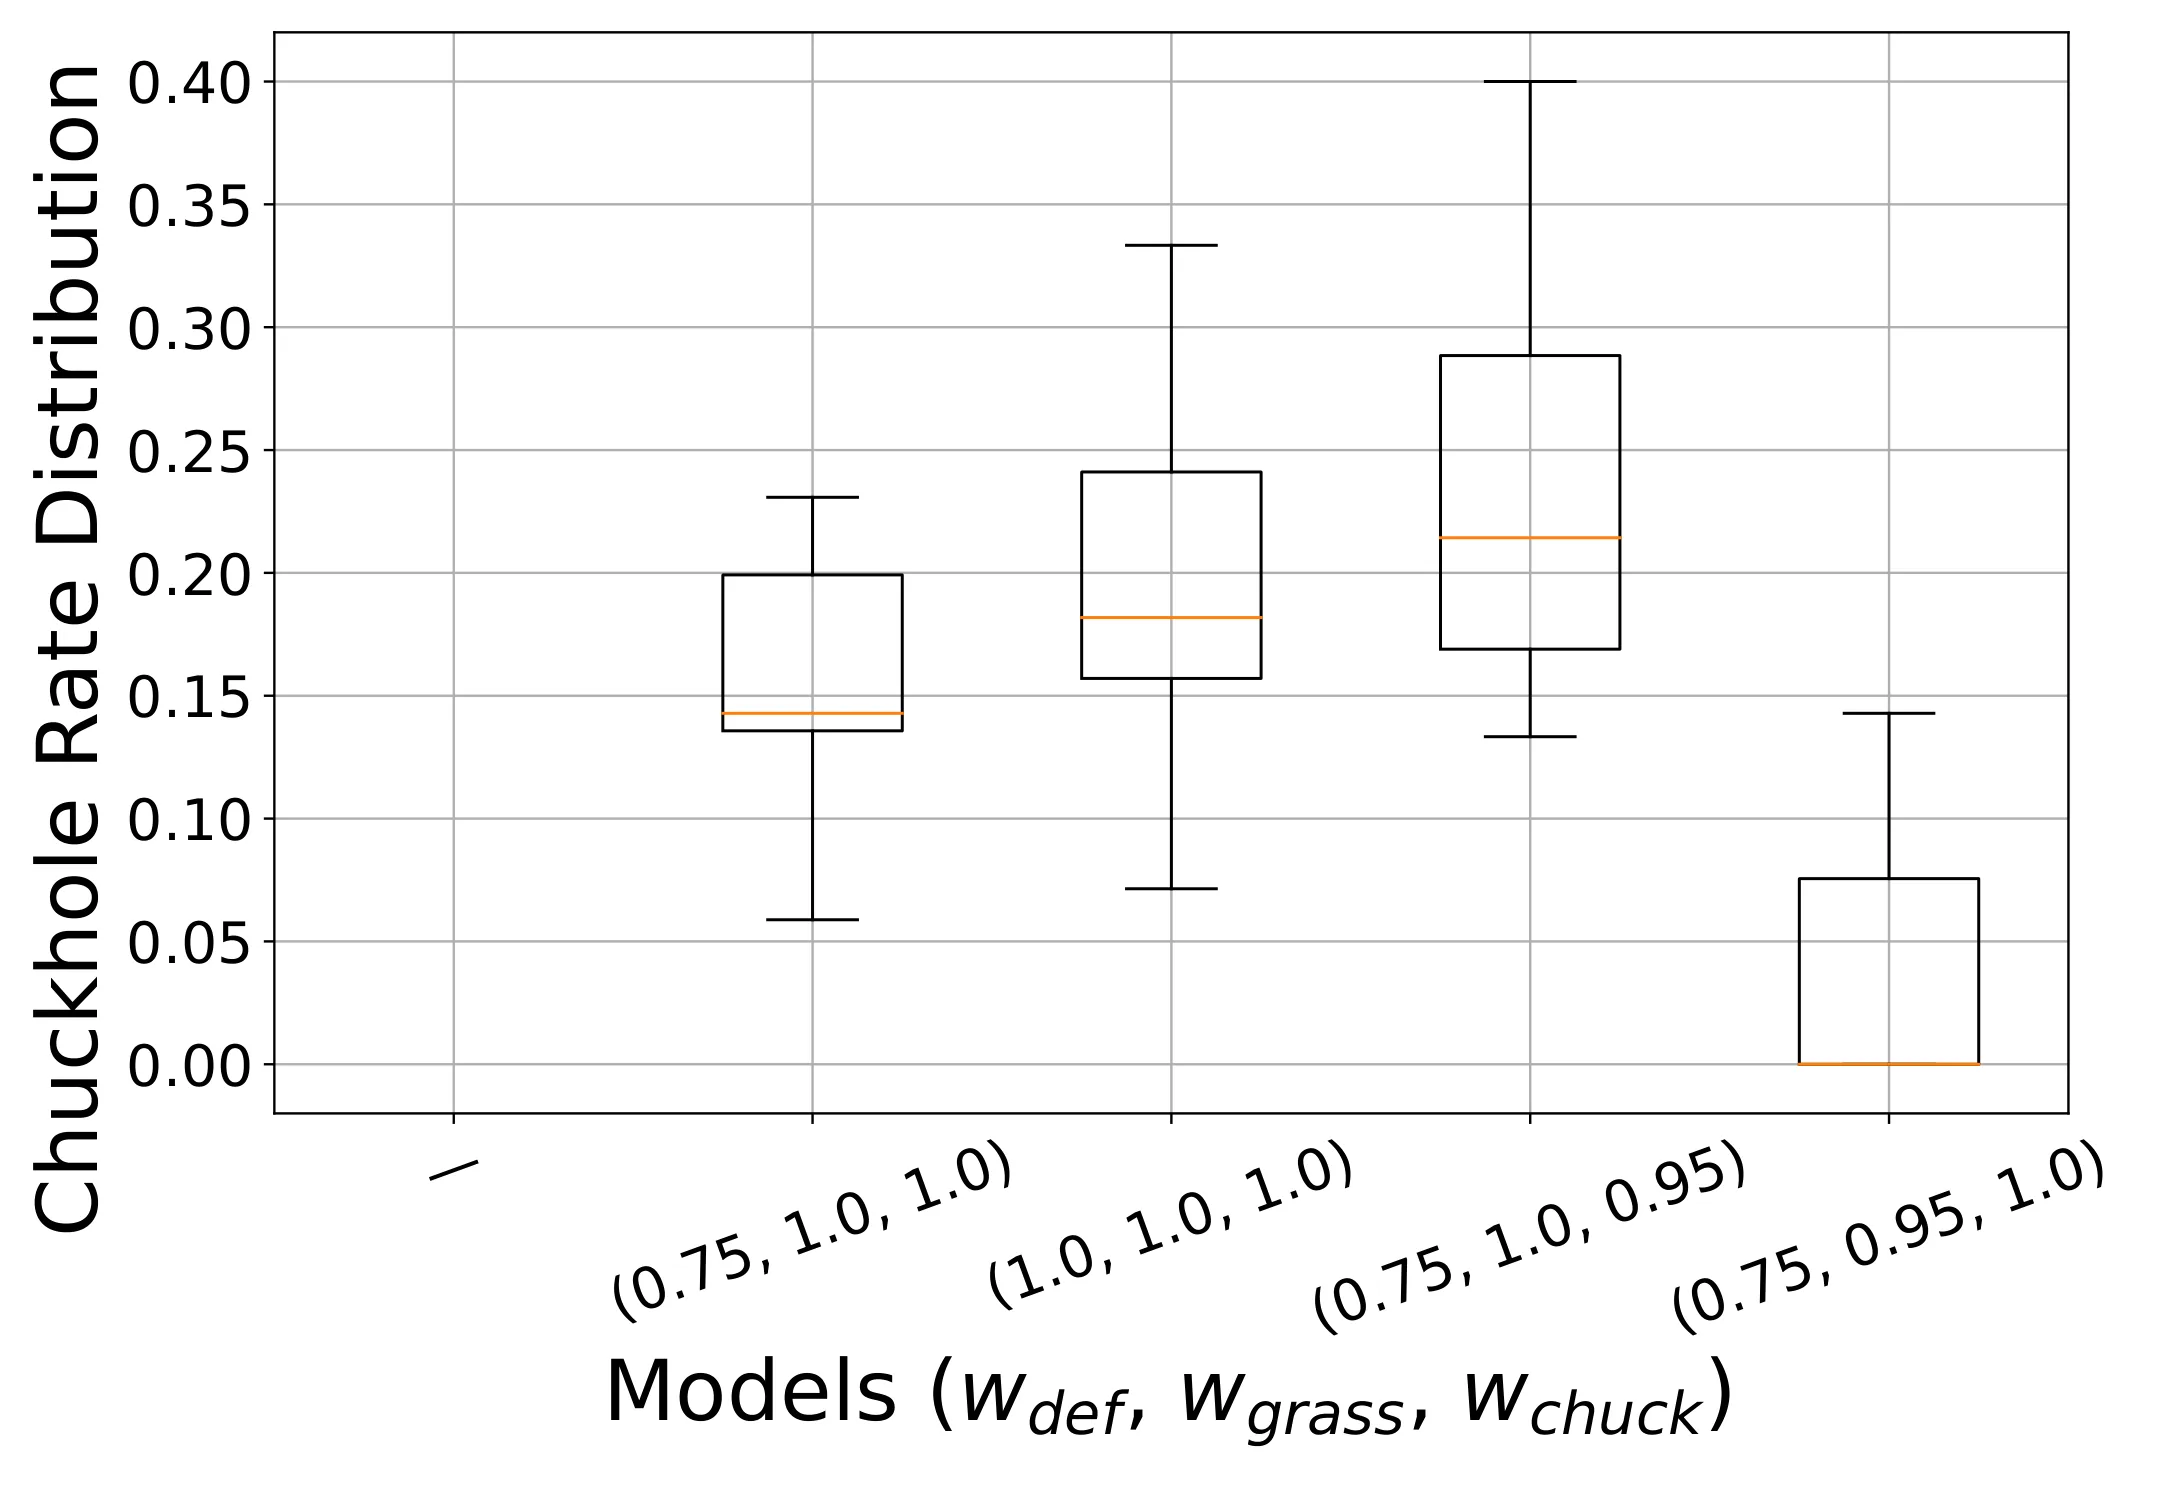
TL;DR
这篇论文提出了 DROPJ 方法,旨在解决「环境动力学未知且没有合适奖励函数」这一难题下如何训练并部署安全策略。核心思路是先从真实轨迹学习一个世界模型作为模拟器,再让人类在模拟器中交互生成有信息量的轨迹片段,通过对比片段收集人类偏好与安全理由,联合训练奖励模型并用模型预测控制(MPC)部署策略。实验表明,这种以人为中心的流程能显著降低训练计算成本、提升部署性能,且安全理由能有效引导模型关注用户关心的安全维度。
研究背景与动机
在安全攸关的场景中训练智能体策略,传统强化学习方法往往力不从心。这类场景有两个核心困难:一是环境动力学未知——智能体无法提前知道「做出某个动作后会发生什么」;二是没有合适的奖励函数——我们很难手工写出一个既能激励好行为又能惩罚危险举动的奖励函数,而若奖励定义不当,智能体可能学到意想不到甚至危险的策略。
传统 RL 依赖大量试错与环境交互来学习策略,这在真实物理环境中代价高昂甚至不可接受。一个直观的替代思路是借助人类反馈:让人类在训练阶段提供关于策略好坏的信号,以此替代显式奖励函数。然而,已有的基于人类反馈的 RL 方法(如 RLHF)通常需要智能体在真实环境中进行大量交互采样才能学到有效策略,这一过程对安全关键环境来说仍然过于冒险。
这篇论文的切入点在于:能否利用人类的专业判断能力,同时控制训练过程的风险? 作者的思路是引入一个「世界模型」作为已习得的模拟器——它由真实轨迹训练而来,可以安全地在其中探索——再让人类在这个模拟环境中发挥主观能动性,生成真正有信息量的轨迹样本。这样一来,人类反馈不再是对抗性采样后的副产品,而是主动引导的、有针对性的指导。
方法
DROPJ 的方法分为四个递进阶段,每一阶段都围绕「让人类反馈更高效、更安全」这一目标展开。
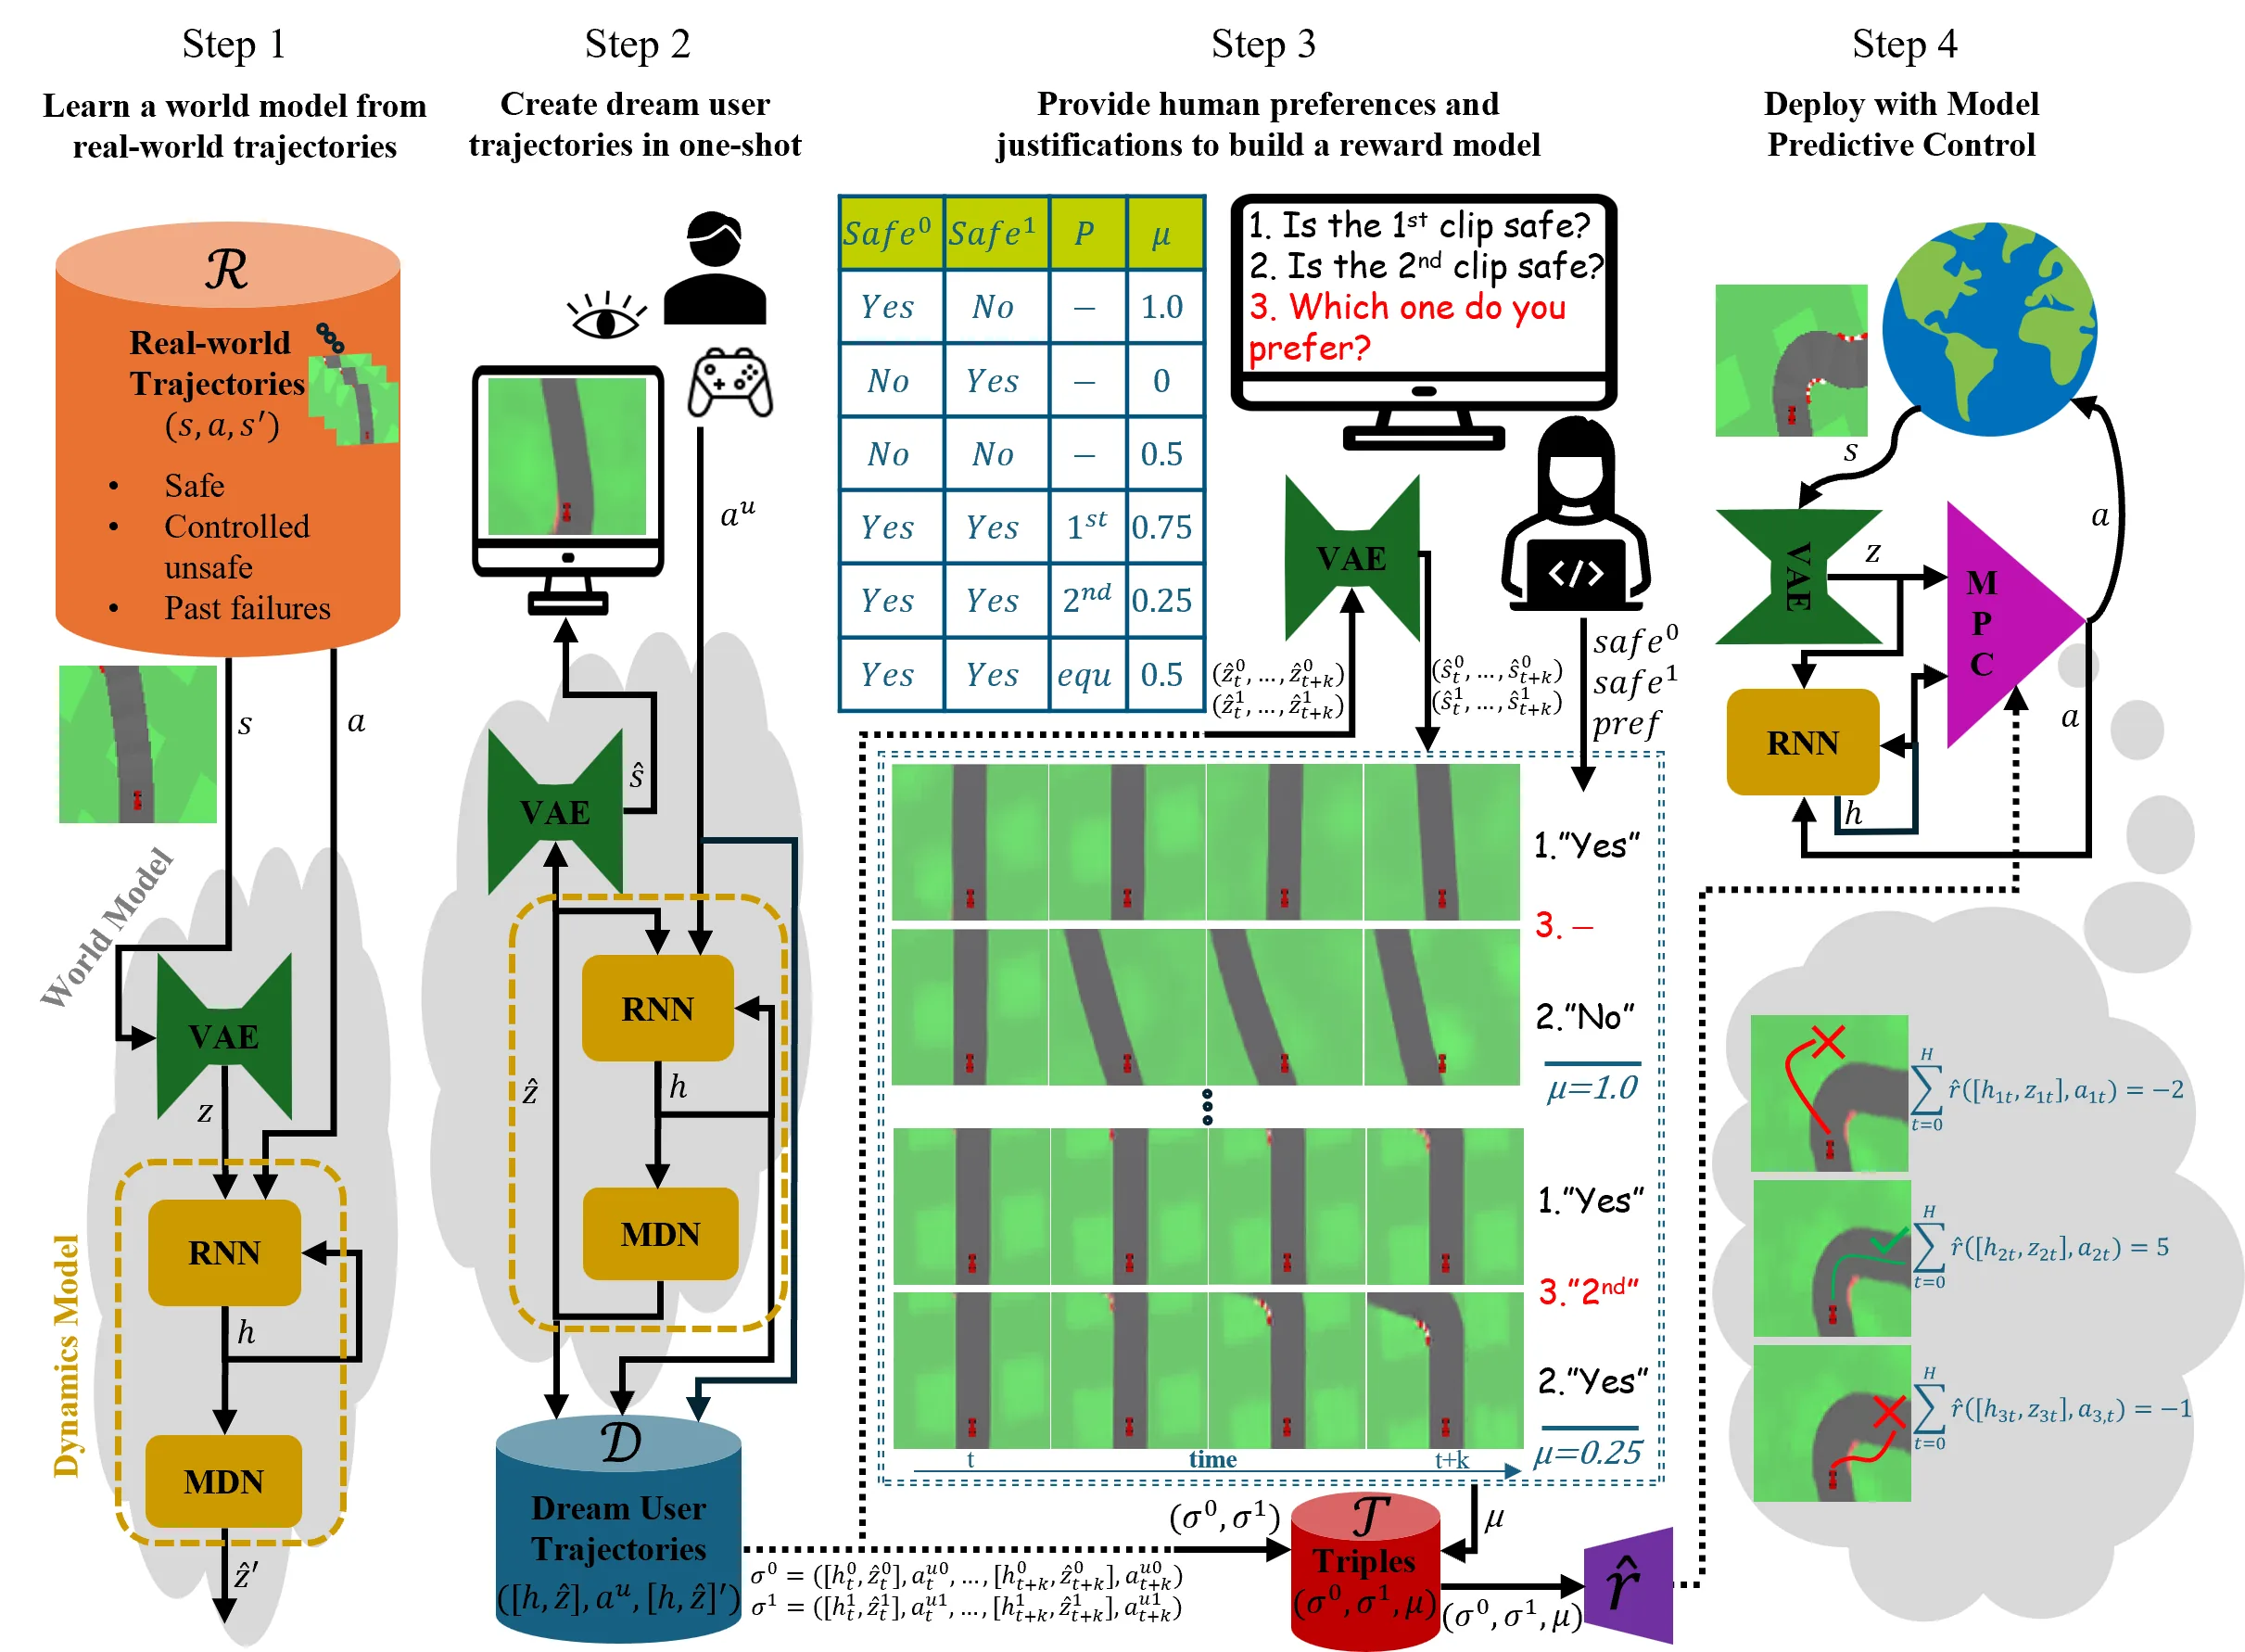
第一阶段:学习世界模型。 作者从一组已有的真实世界轨迹数据集出发,训练一个世界模型——本质上是一个能够预测「给定当前状态和动作,下一状态是什么」的概率模型。训练完成后,这个世界模型就充当了一个「习得模拟器」,可以在其中进行安全的虚拟交互,而无需接触真实环境。论文没有详述具体采用的模型架构,但可以推测是某种 [[序列建模]] 或 [[变分自编码器]] 类的隐变量模型,以便同时捕捉状态的转移概率和不确定性。
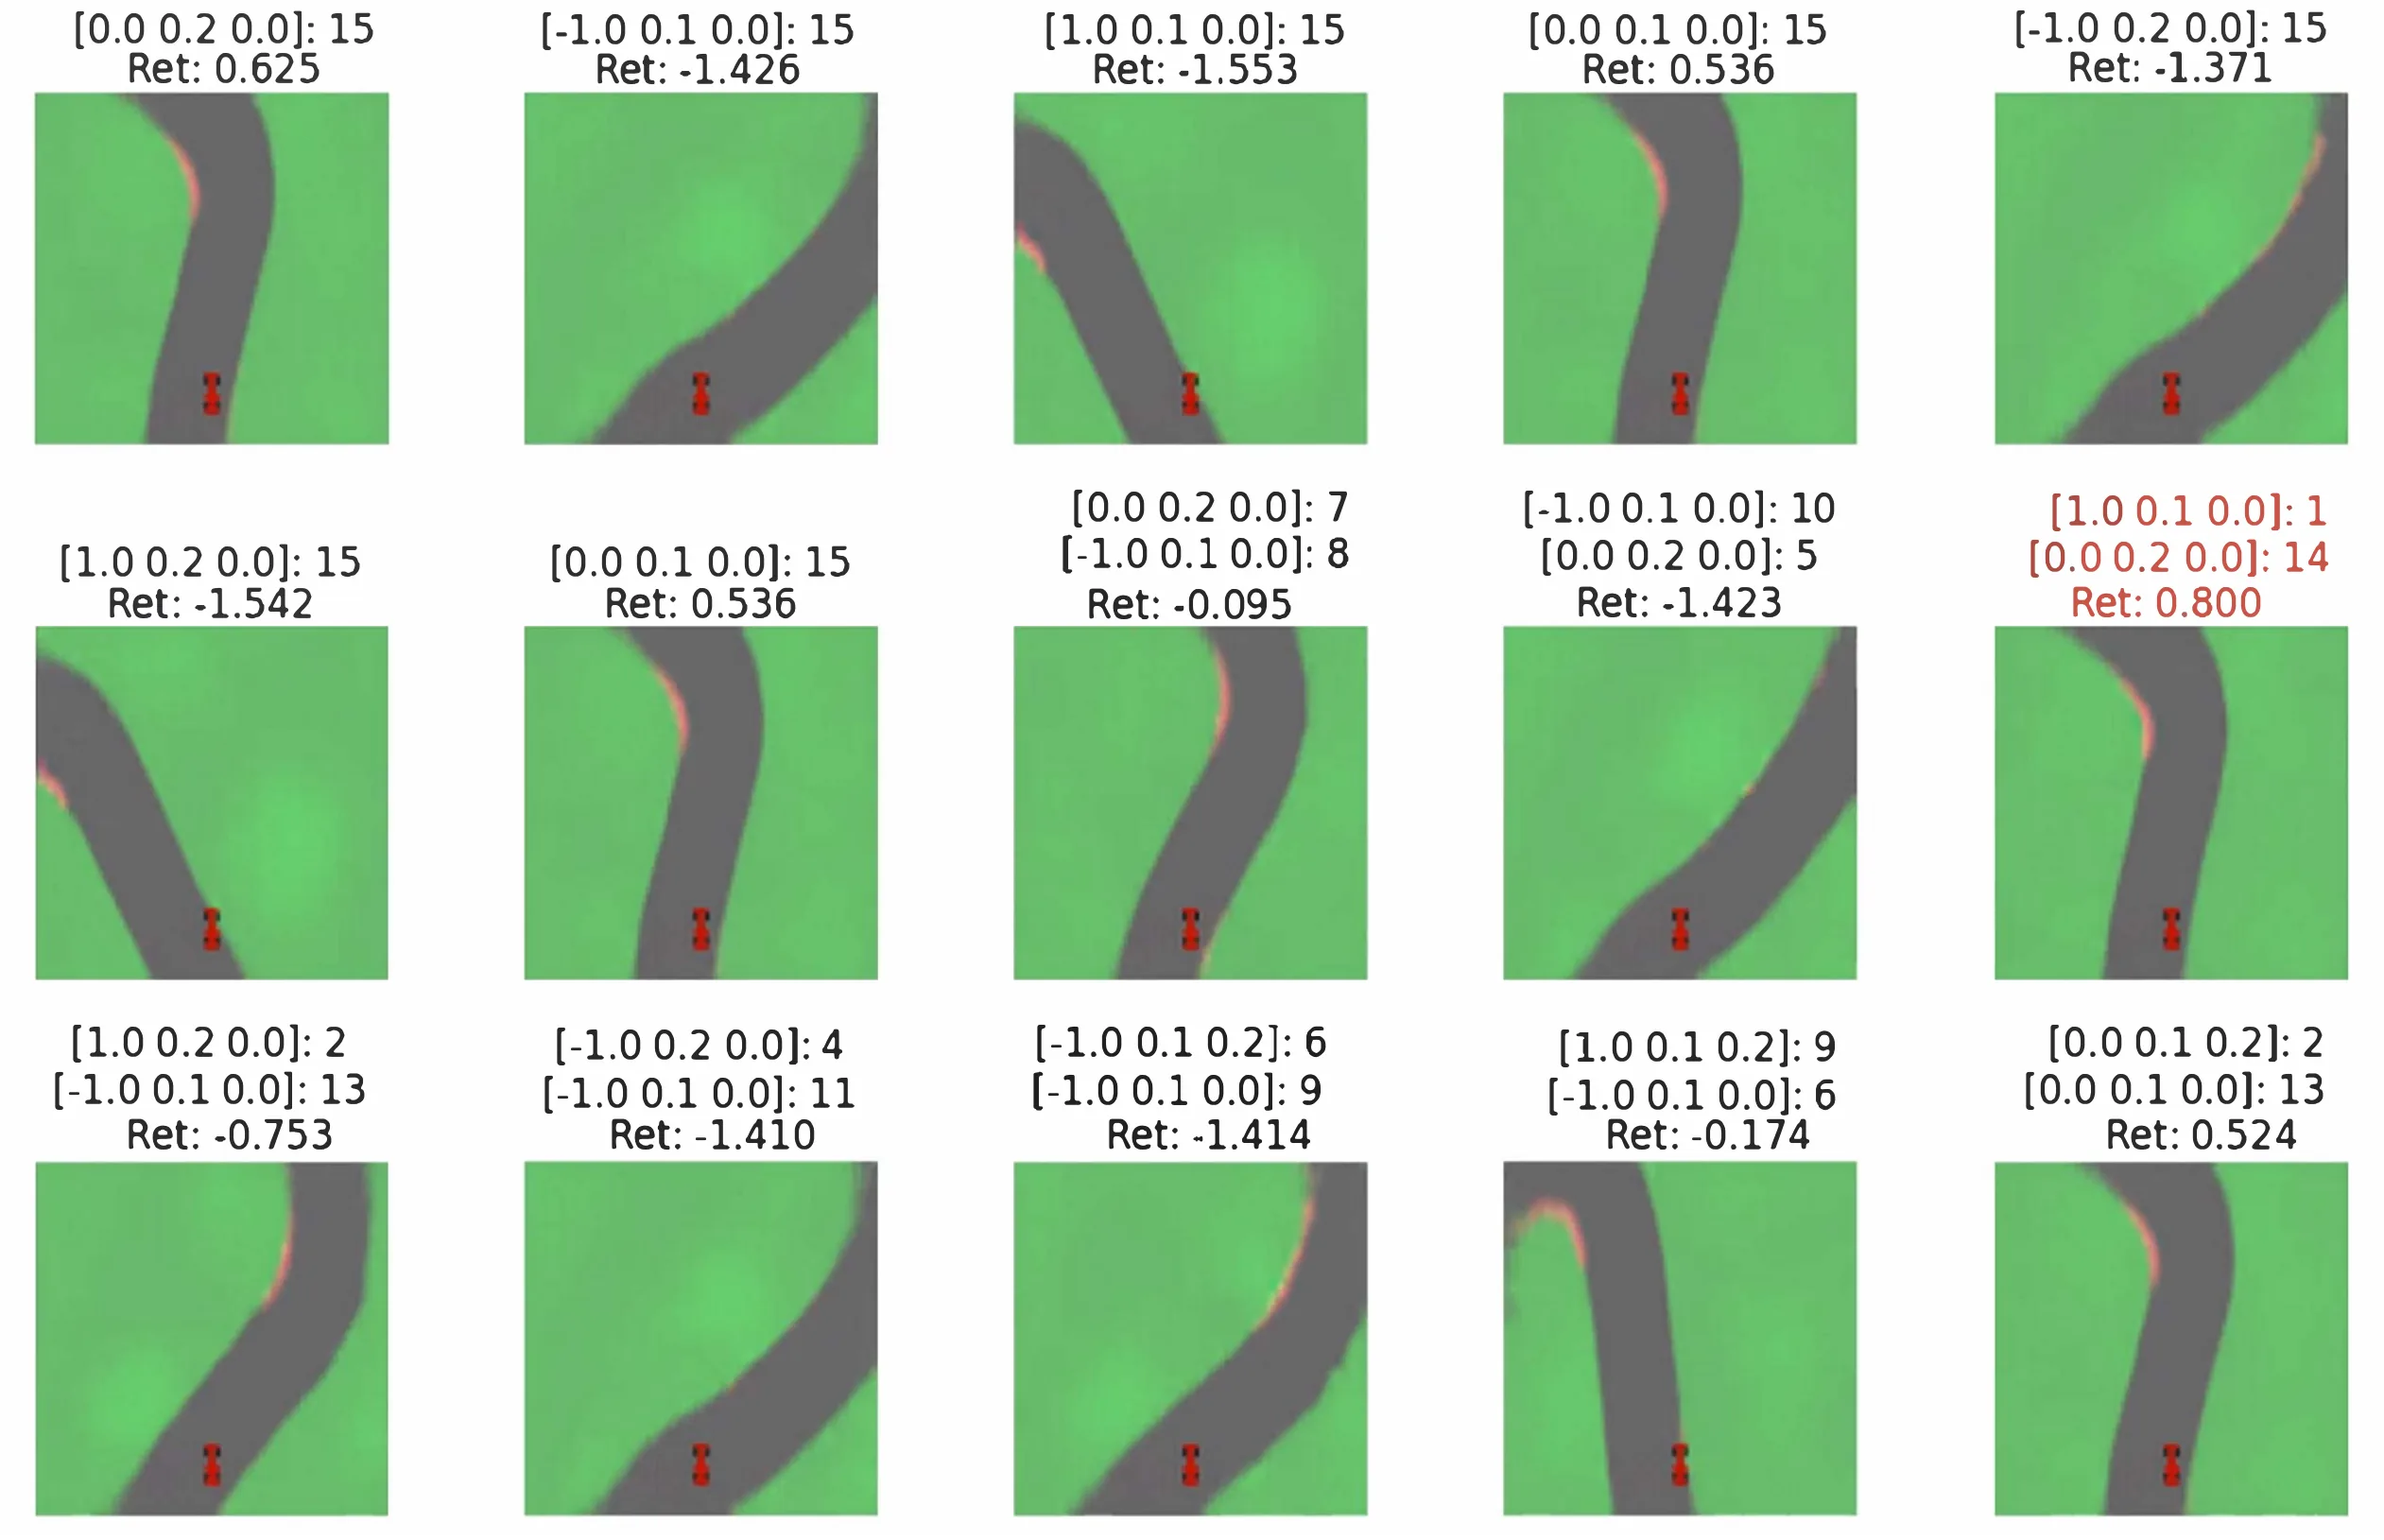
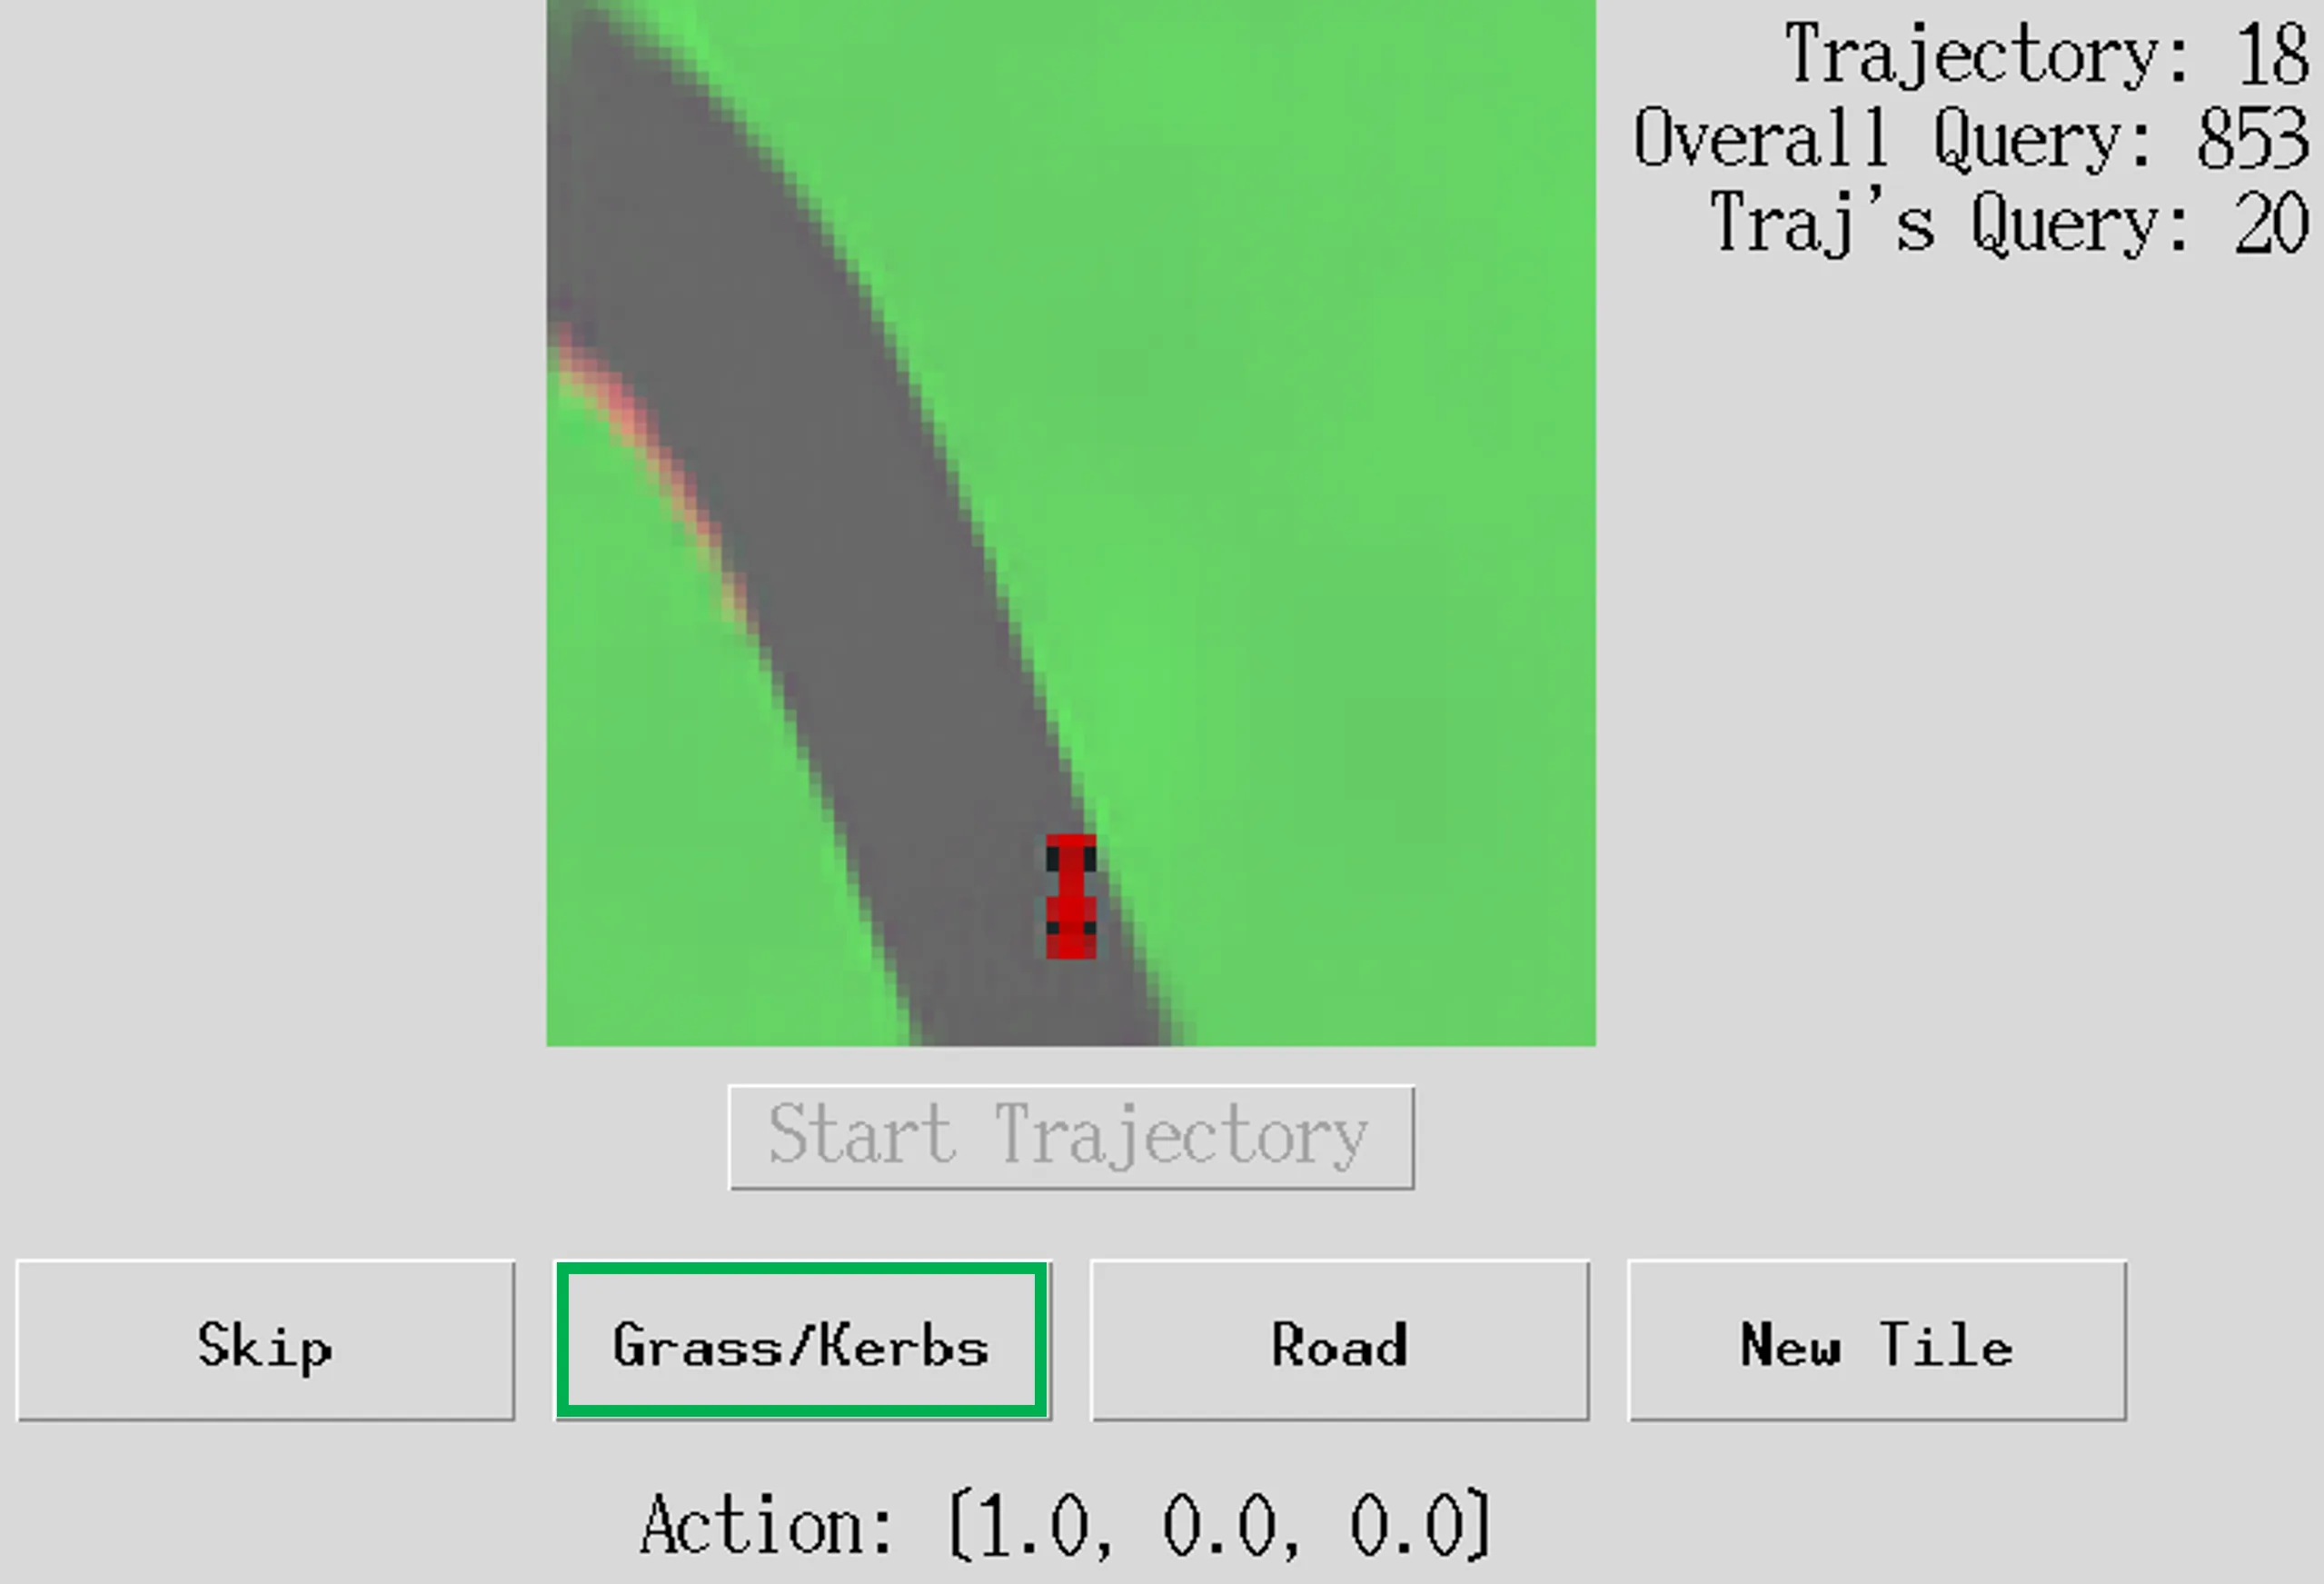
第二阶段:人类在模拟器中生成有信息量的轨迹。 这一步是方法的关键创新点之一。不同于让随机初始化的策略在模拟器中盲目采样,作者邀请人类直接「玩」这个习得模拟器。人类的介入带来了两个重要优势:其一,人类天然会选择有意义的、避免灾难性后果的行为路径,生成的轨迹天然富含安全相关的状态分布信息;其二,人类的行为本身就隐含了对「什么状态是好的」的判断,为后续的偏好标注提供了上下文。实验设计要求人类玩家在模拟器中完成特定任务,同时尽可能避免危险区域,从而生成一批高质量的模拟轨迹。
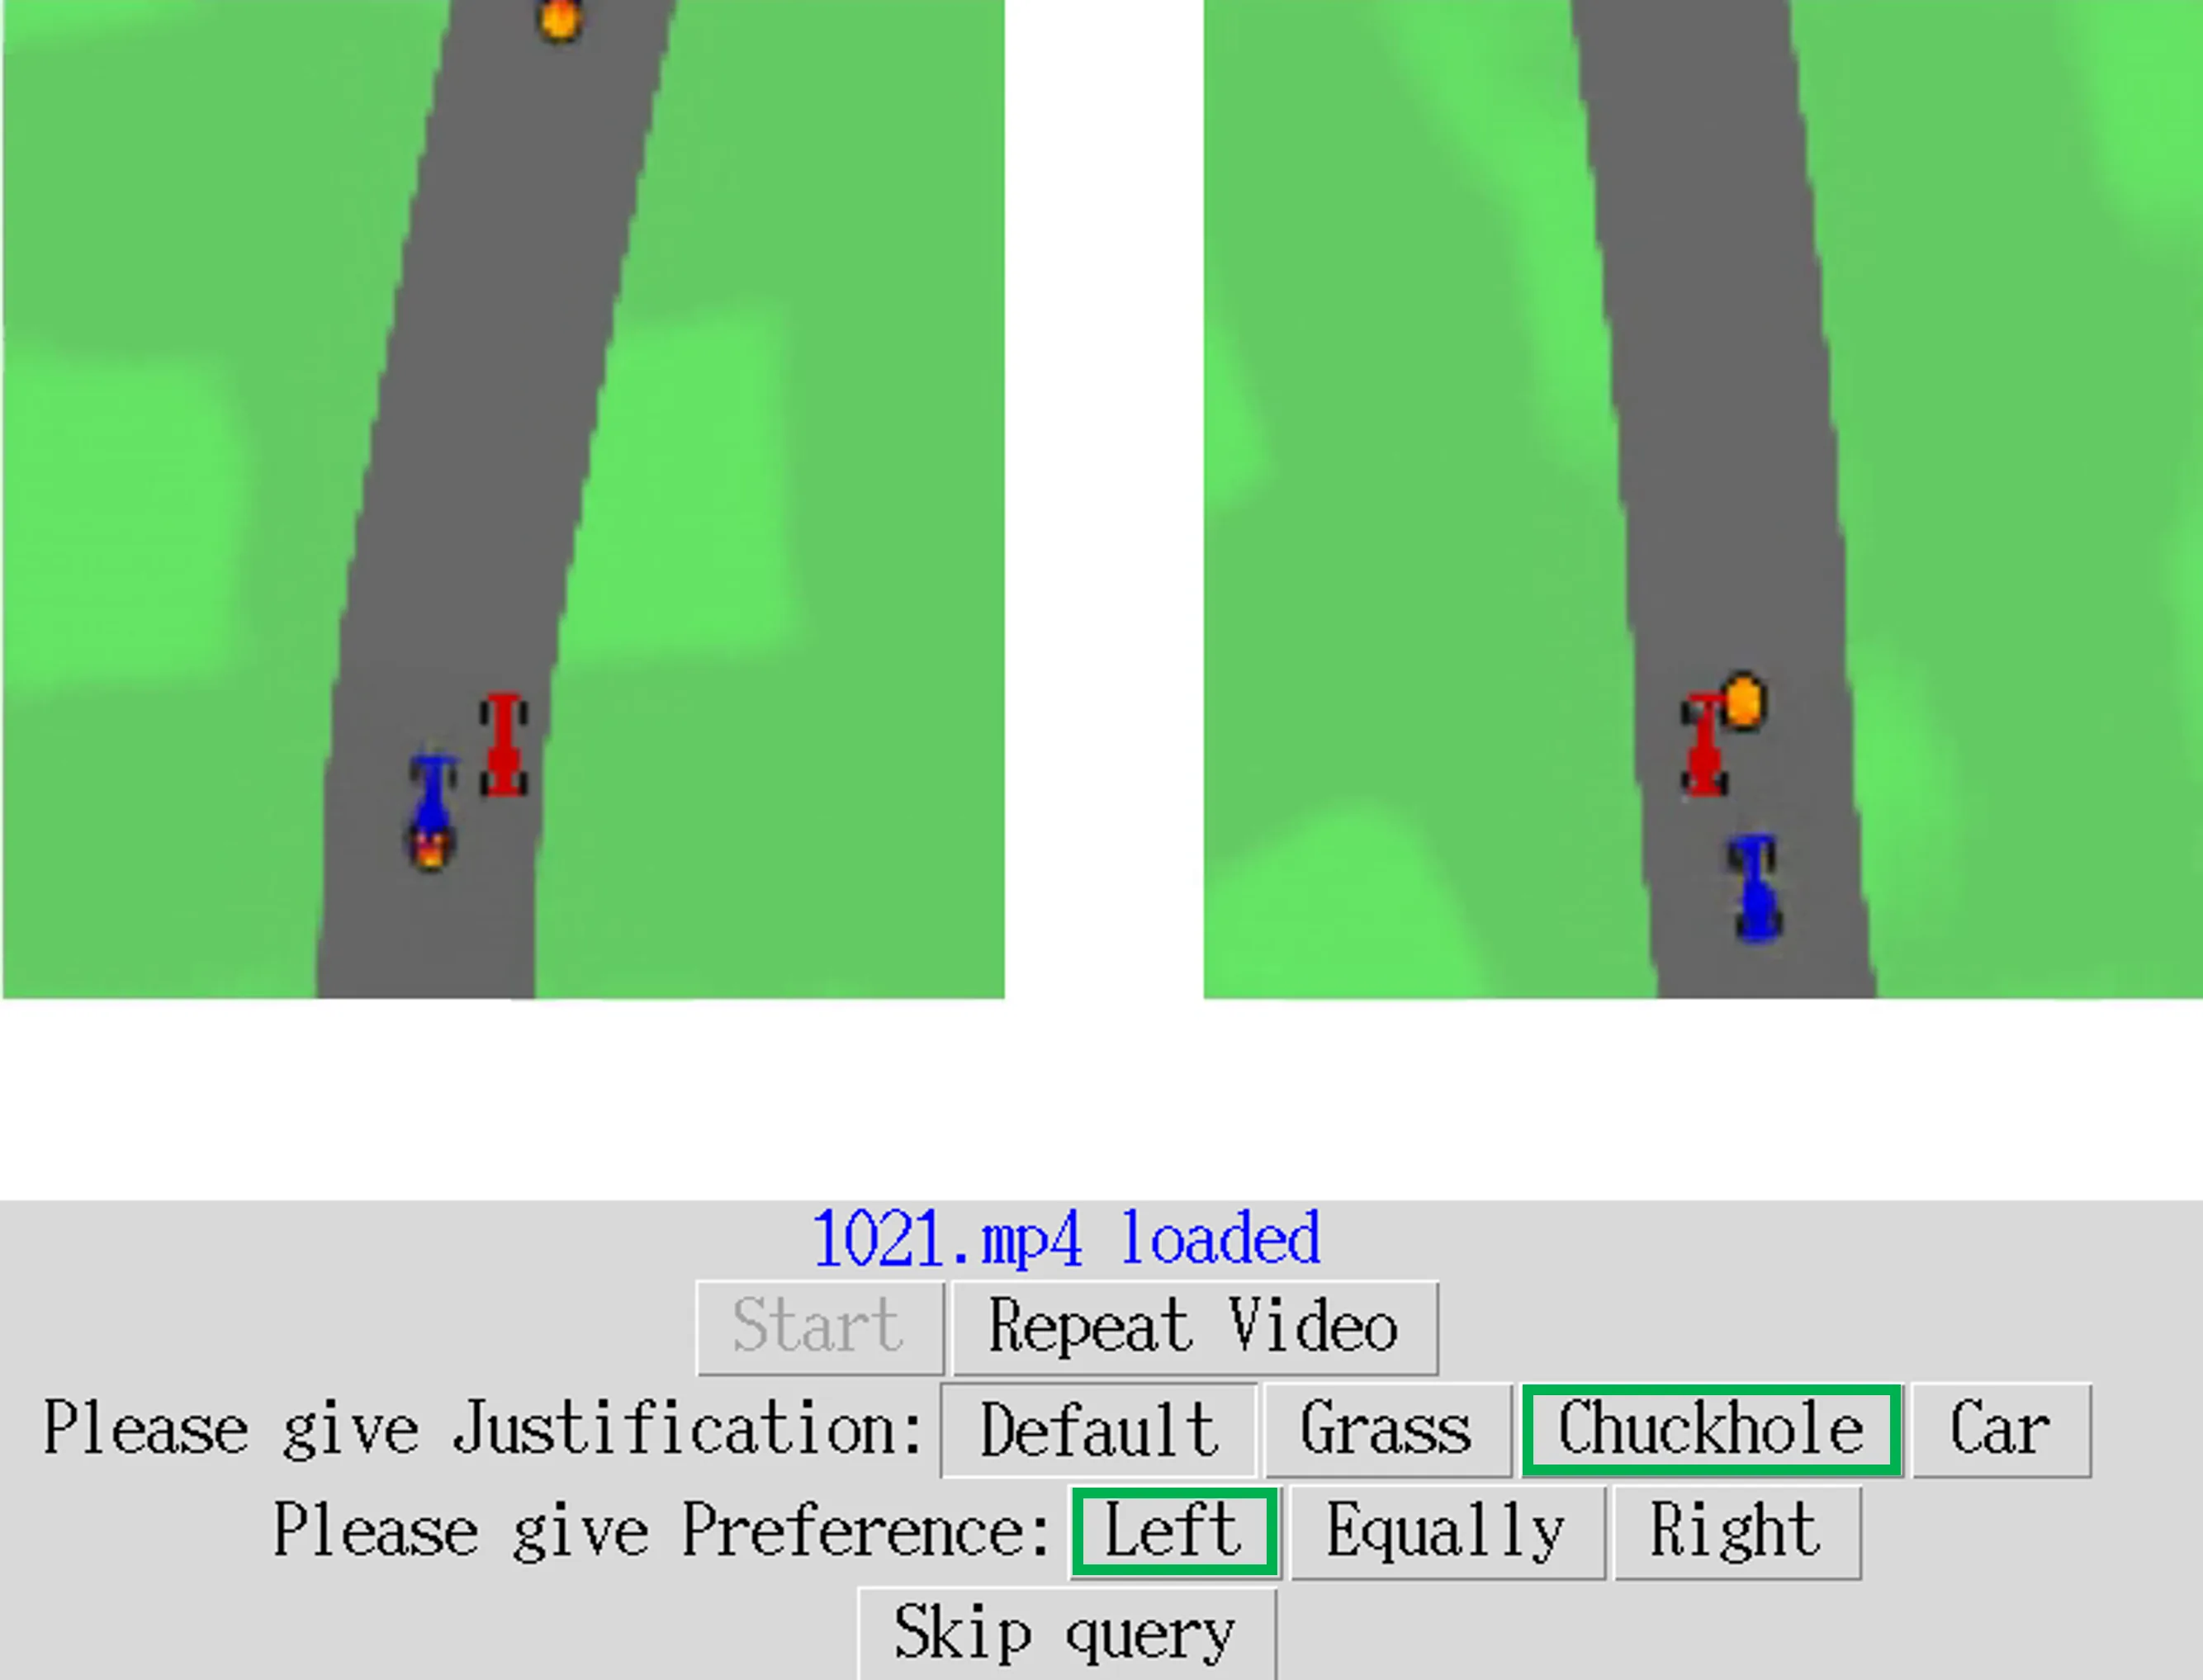
第三阶段:收集偏好与安全理由。 从人类生成的轨迹中,系统采样出成对的轨迹片段(每对片段从同一初始状态出发但后续发展不同)。然后向人类用户询问:你更喜欢哪一个片段?为什么?前者是标准的偏好反馈(Preference Feedback),后者——论文称之为安全理由(Safety Justification)——是额外的文本说明,解释人类做出该选择的深层考量。这些理由的价值在于,它们能够揭示偏好评级背后的安全逻辑,比如「这条路线会经过狭窄通道,风险更高」或「那个动作会导致速度骤变,乘客可能不适」。作者通过让人类同时提供偏好和理由,获得了比单纯偏好更丰富的监督信号。
第四阶段:联合训练奖励模型并部署。 收集到的偏好-理由数据被用来训练一个奖励模型,该模型接收状态-动作对并输出一个标量奖励估计。安全理由则被编码为额外的条件信号,使奖励模型能够根据不同安全维度进行调整——换言之,用户可以指定「我最在意碰撞风险」或「我最在意能耗效率」,奖励模型会据此改变对轨迹的打分权重。最后,训练好的奖励模型与世界模型结合,通过 [[模型预测控制]](MPC)在每个决策时刻前向模拟多个候选动作序列,用奖励模型评估并选择累积回报最高的序列作为实际执行的动作。MPC 的引入确保了策略能够在线利用世界模型的预测能力进行规划,同时不需要一个显式训练好的策略网络——这是一个相当优雅的设计选择,因为 MPC 自然地处理了世界模型的预测误差。
实验与结果
作者设计了两类实验来验证 DROPJ 的有效性:模拟用户实验和真实用户实验,任务场景聚焦于自动驾驶中的车道保持与障碍物规避。
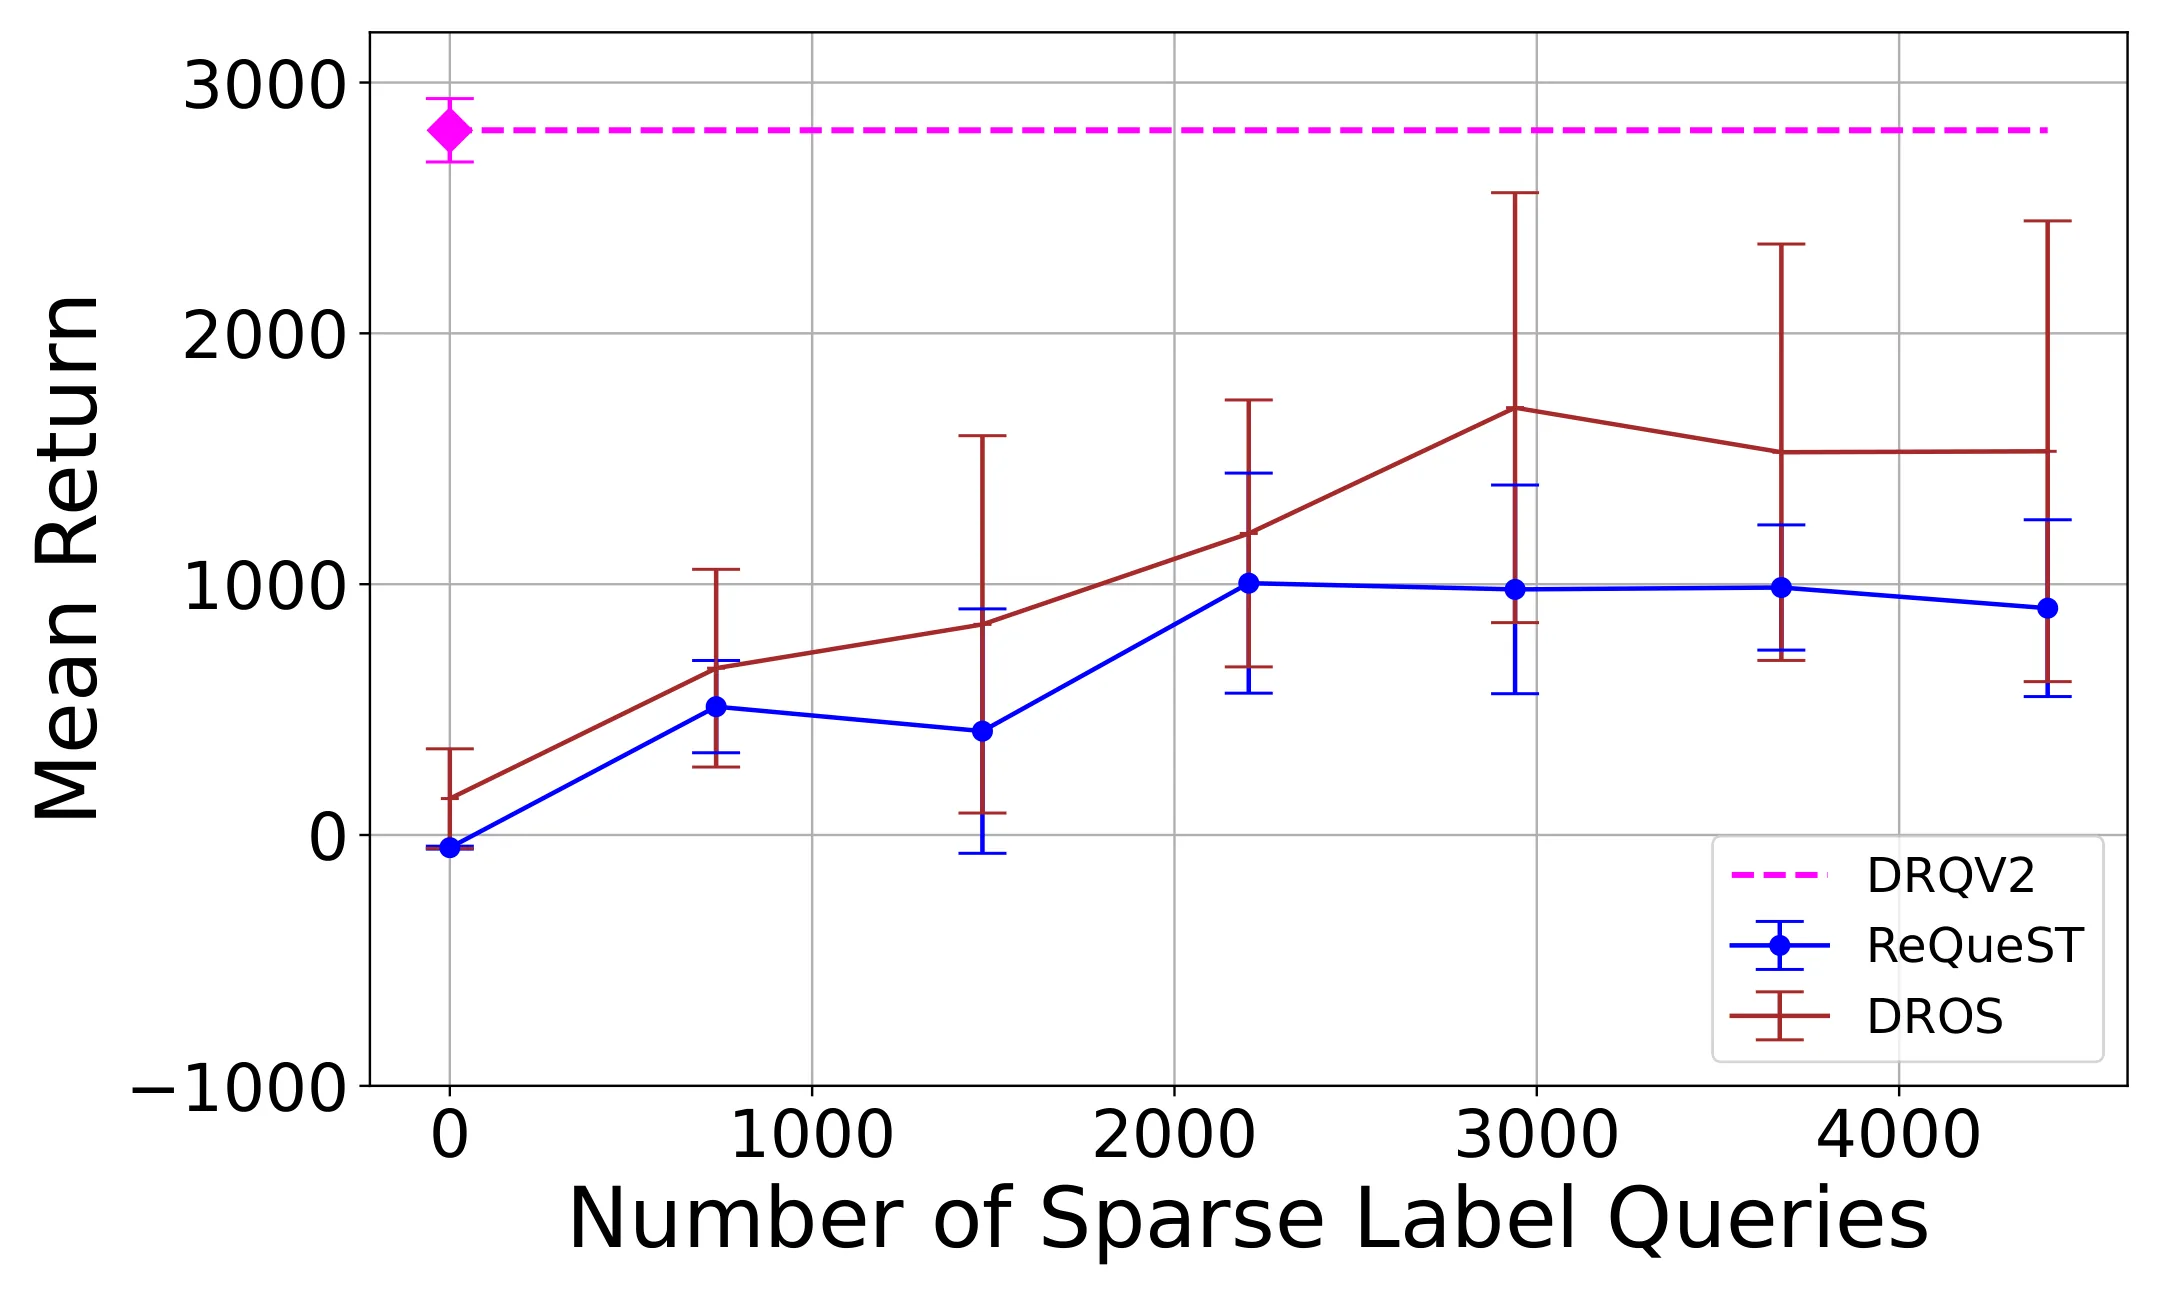
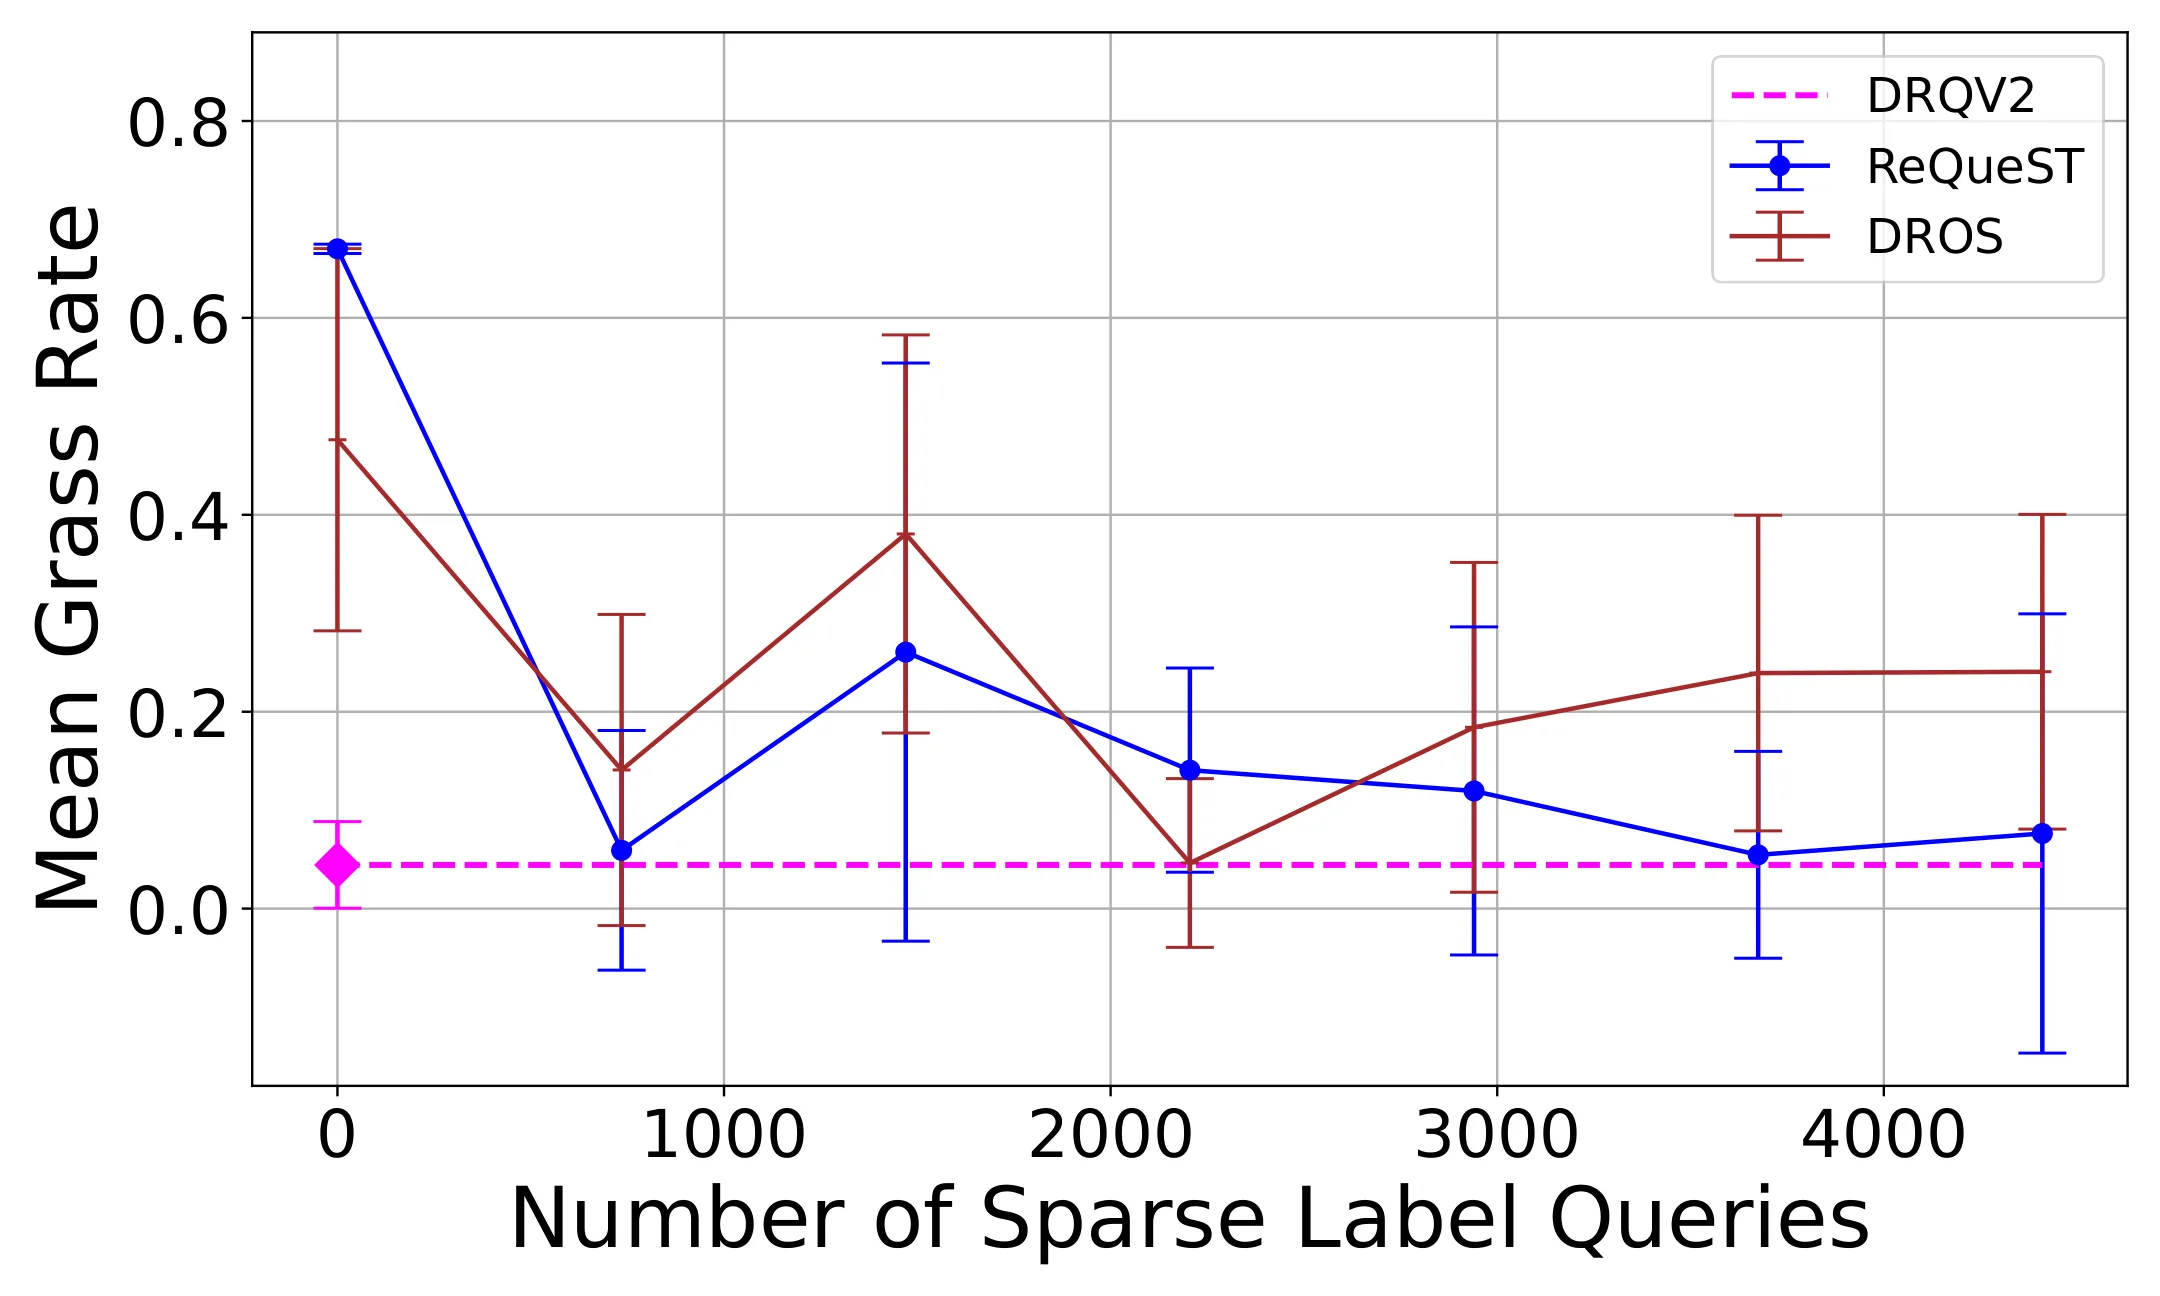
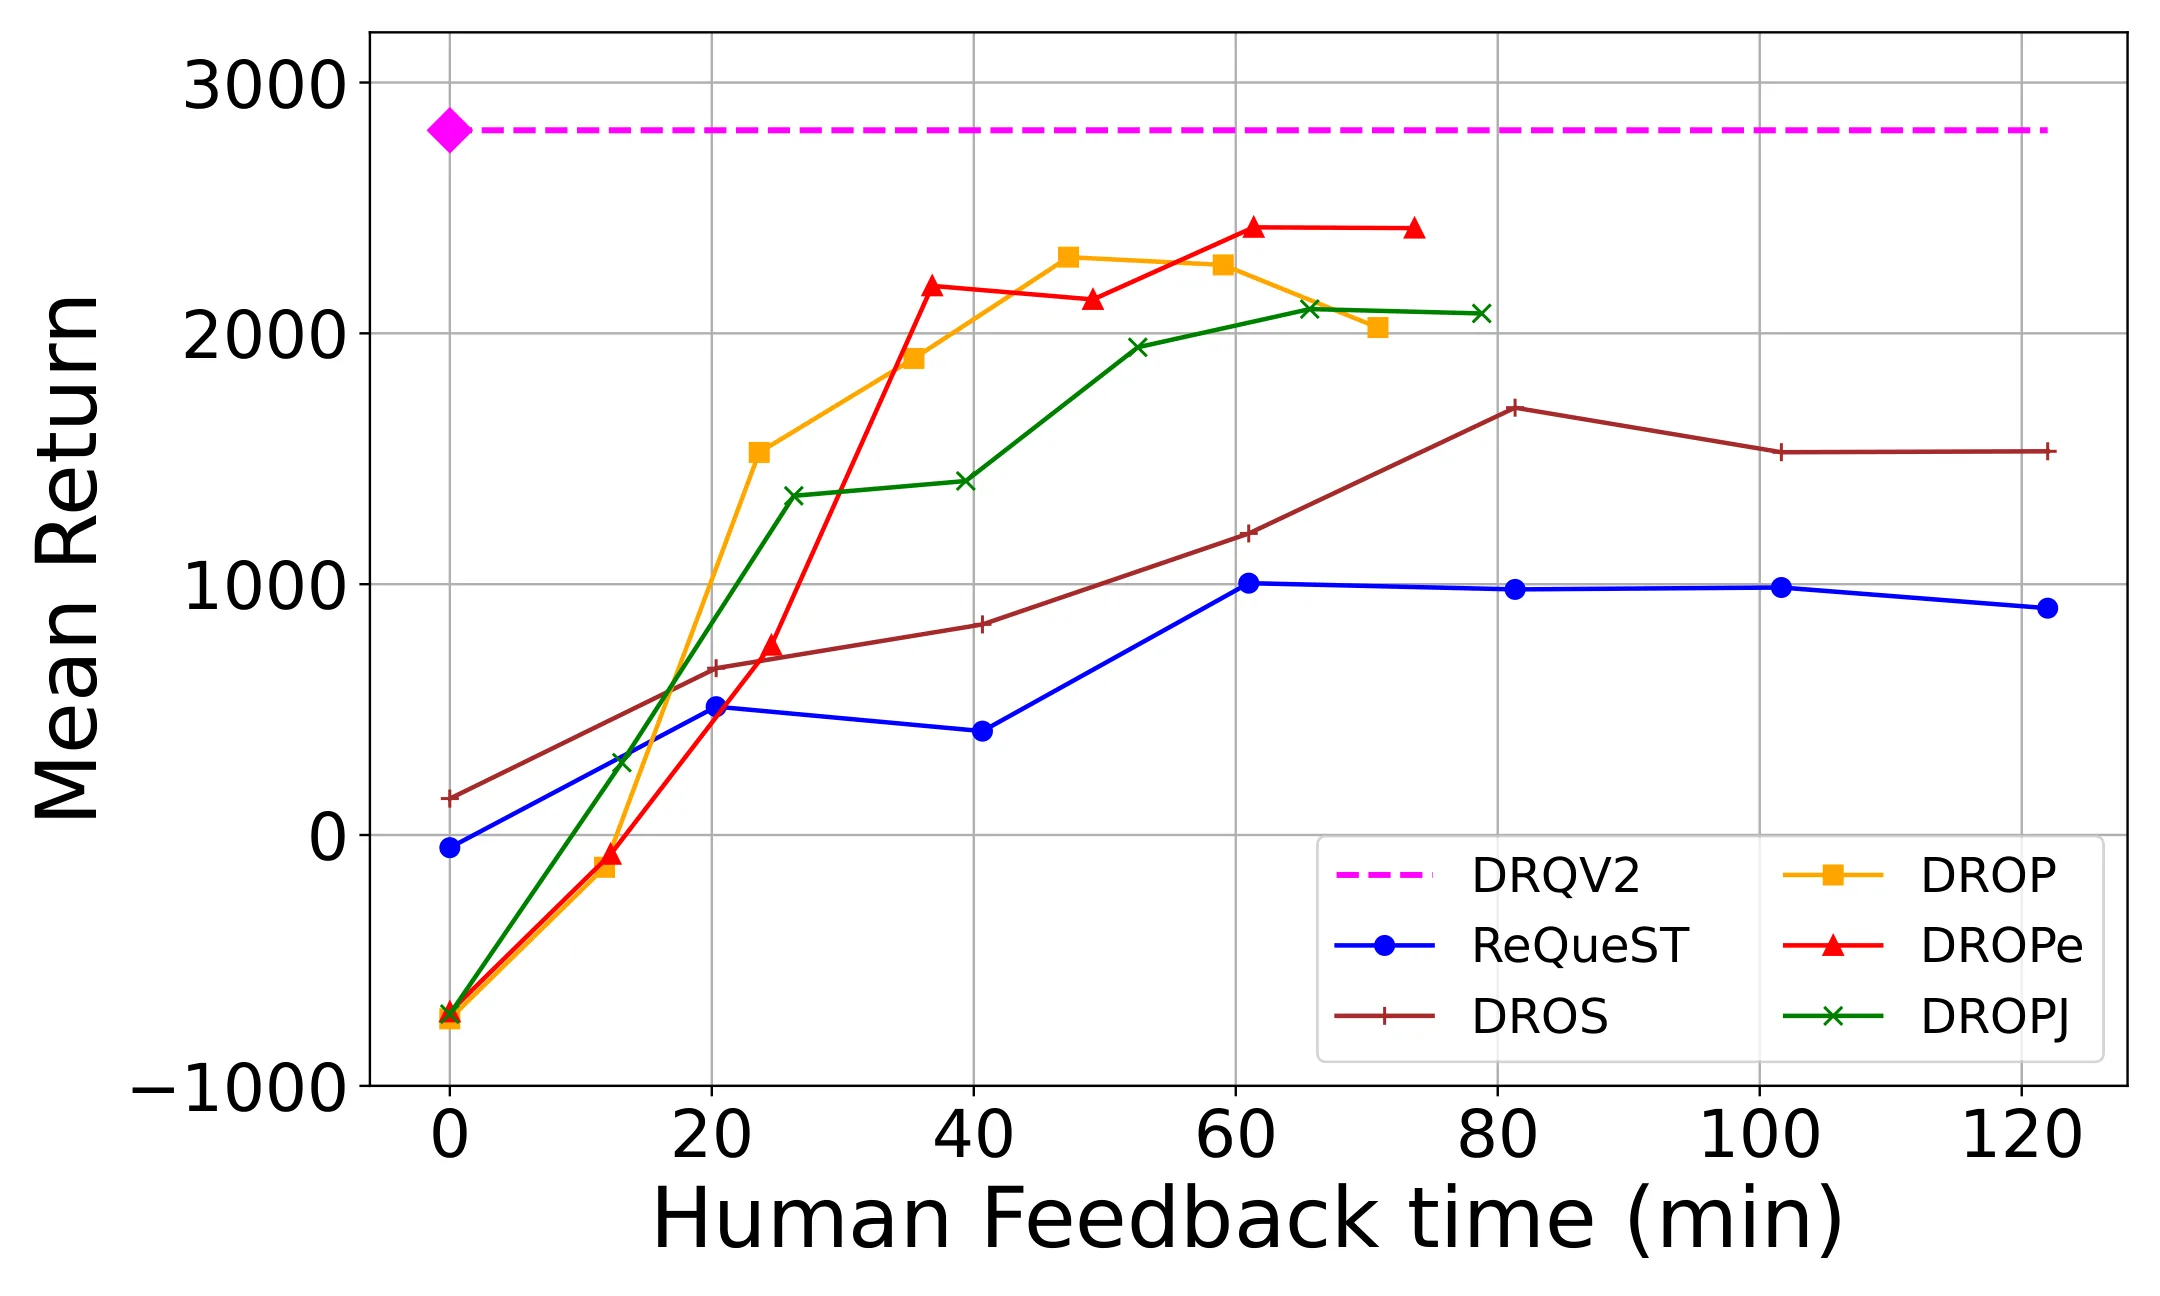
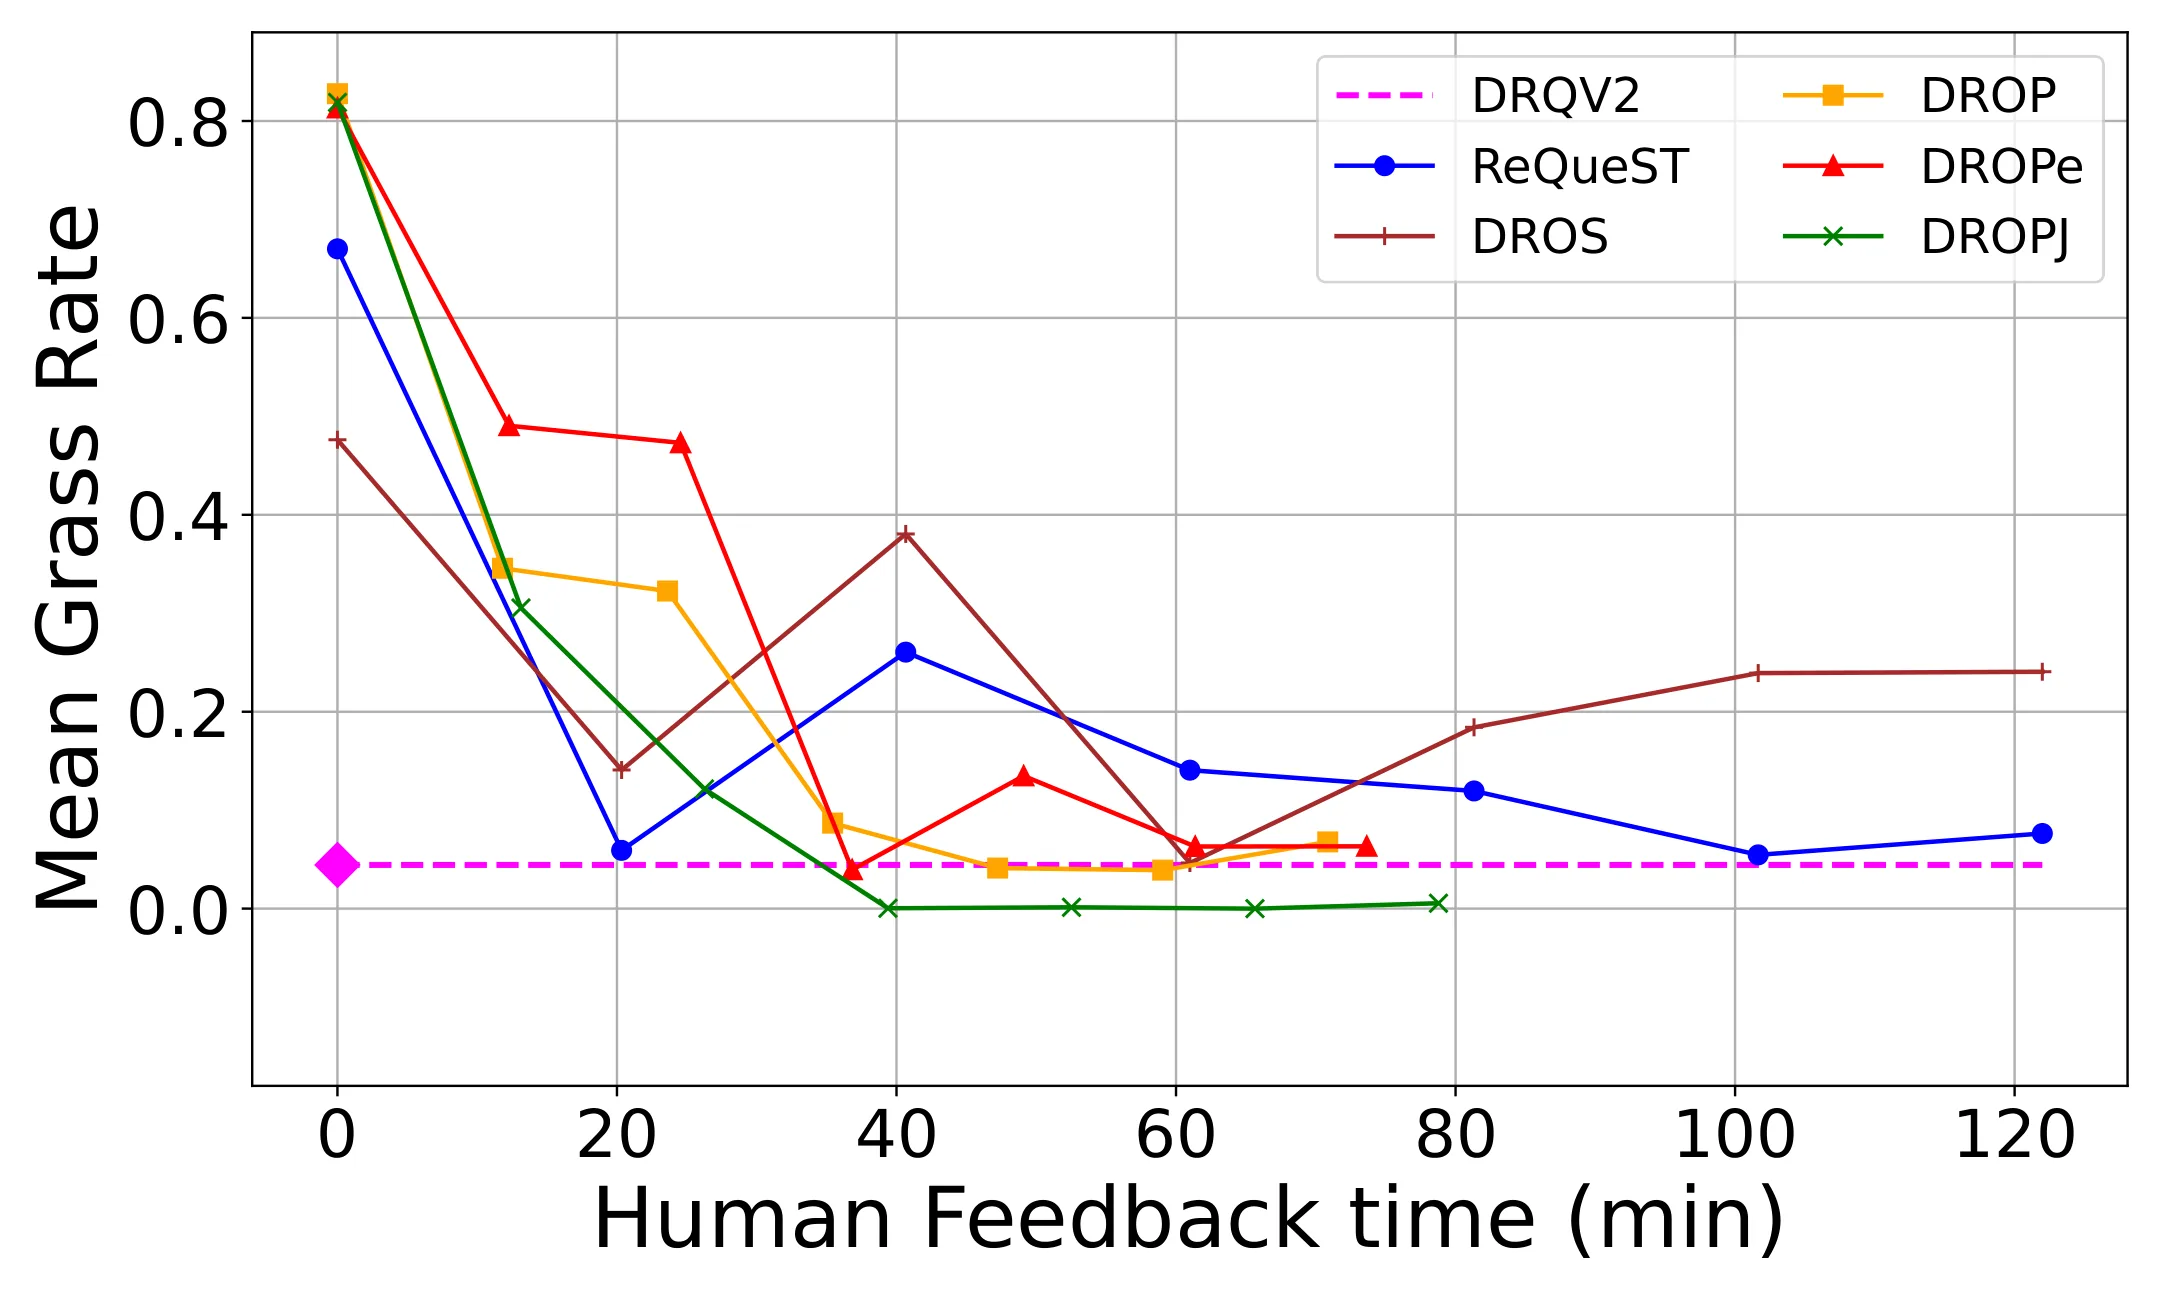
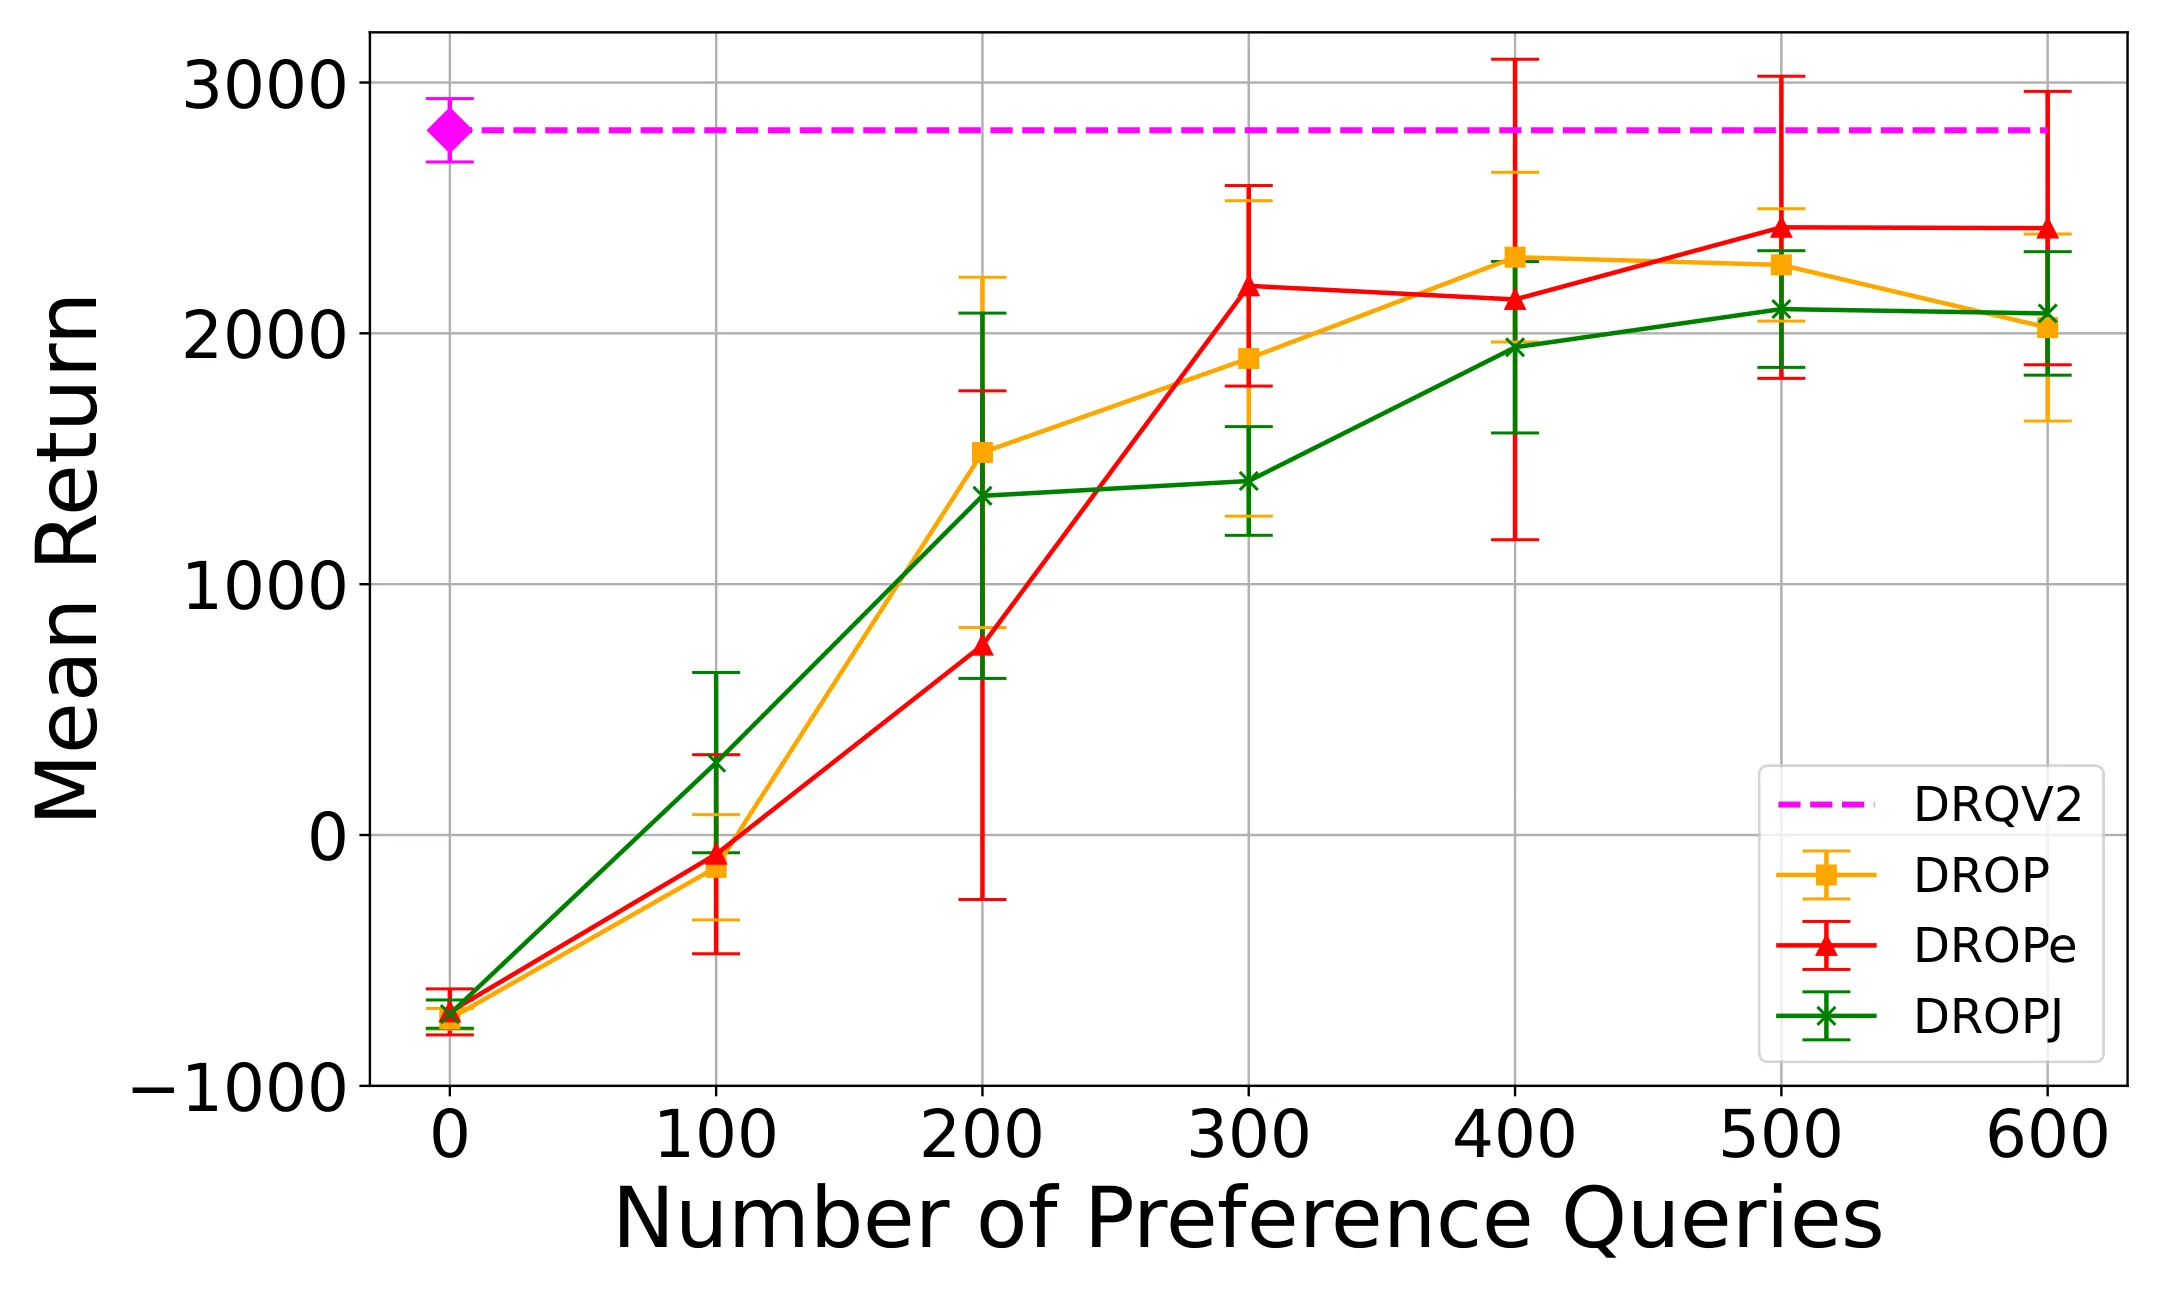
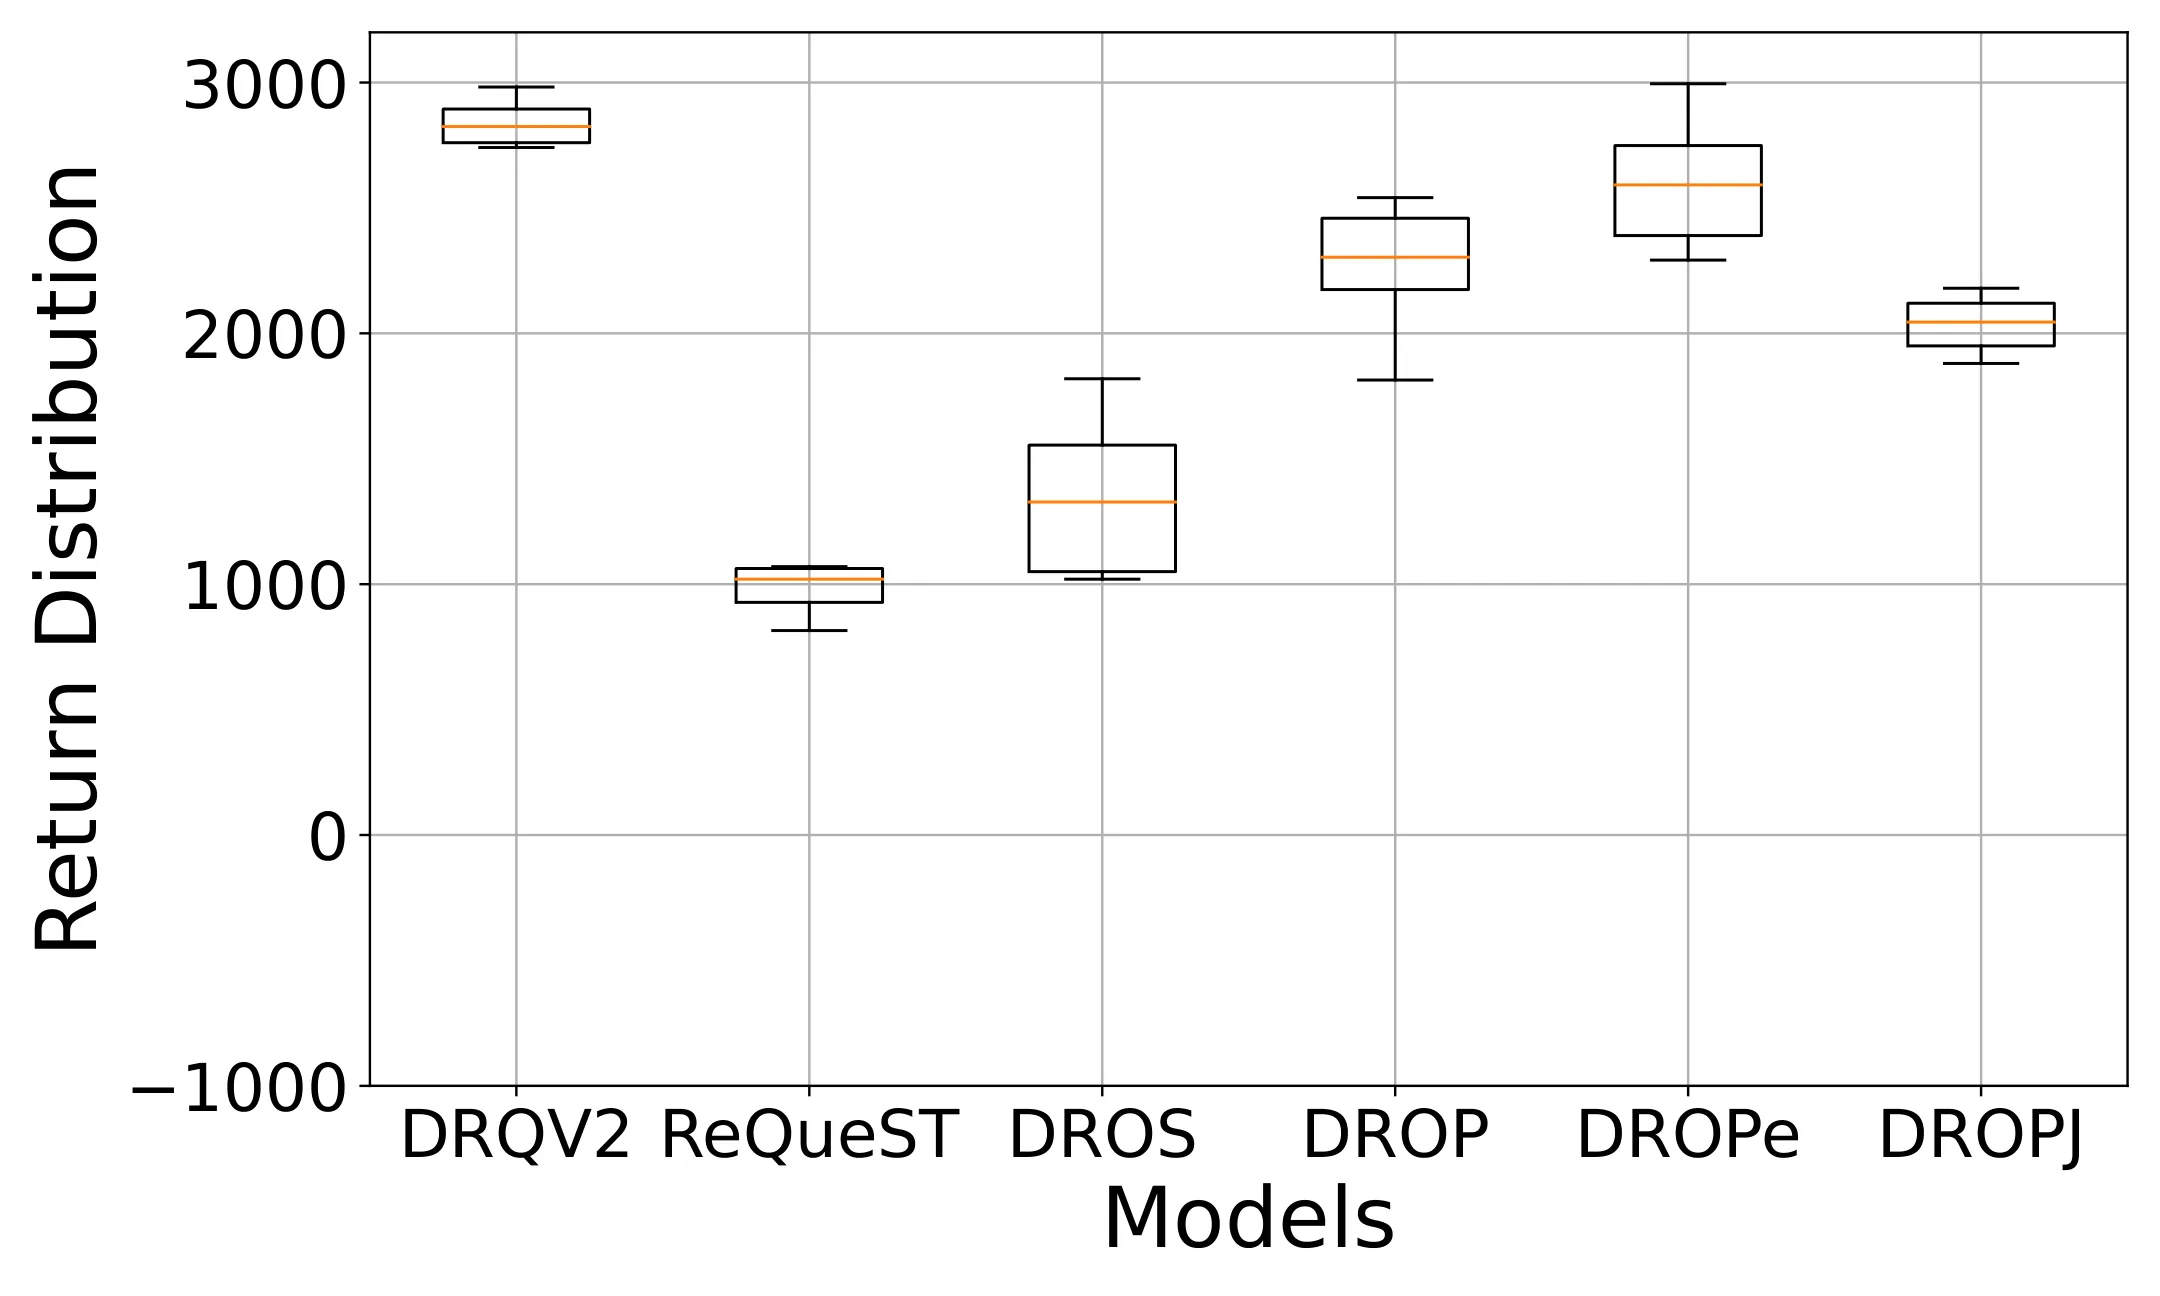
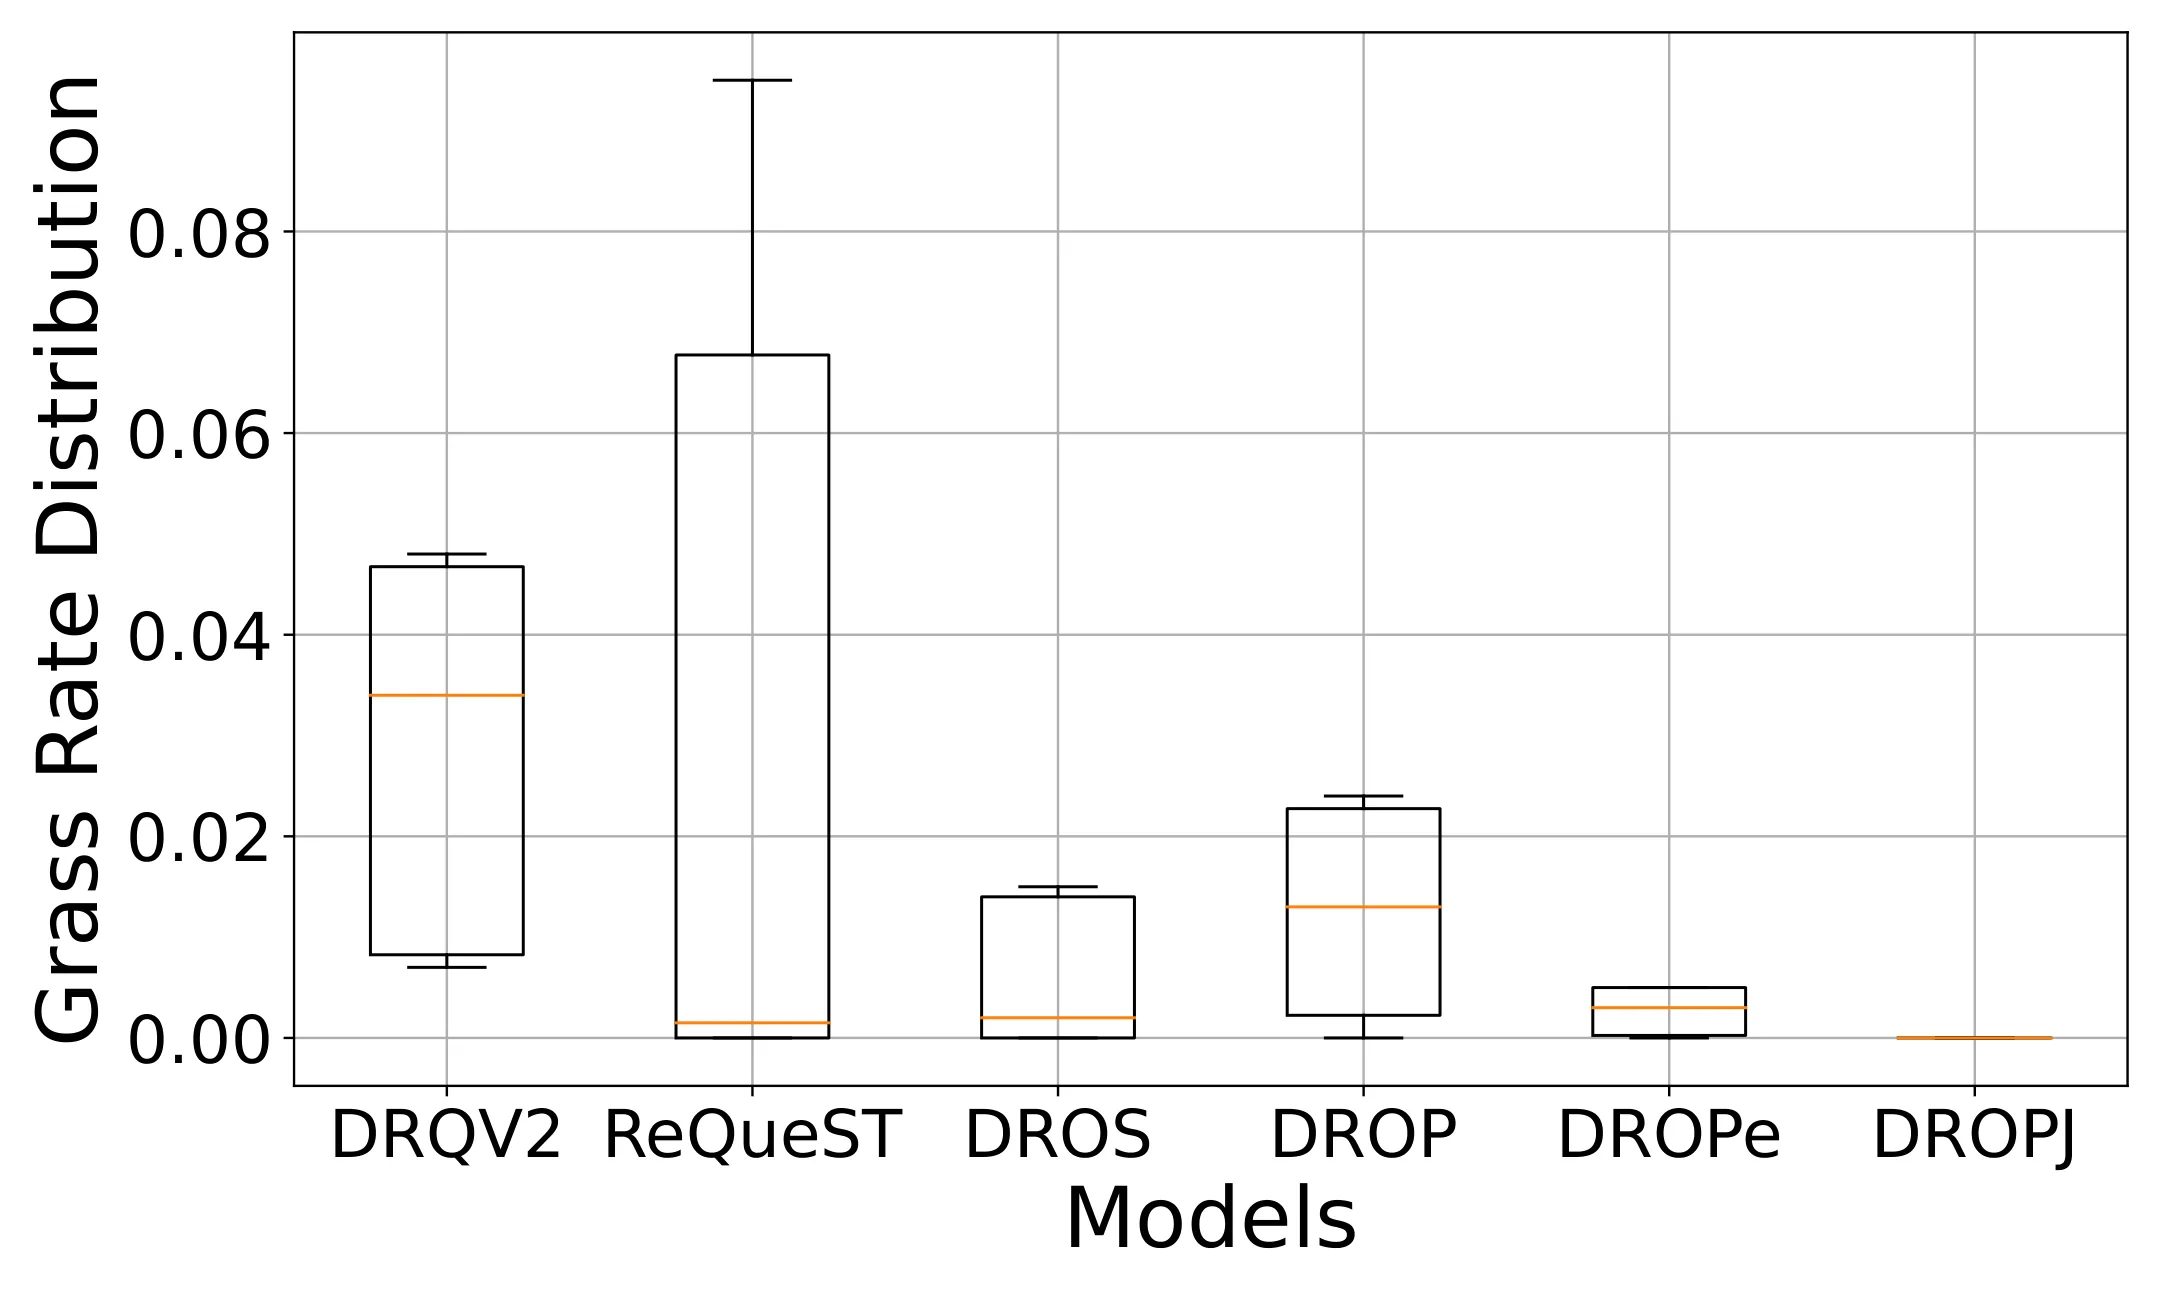
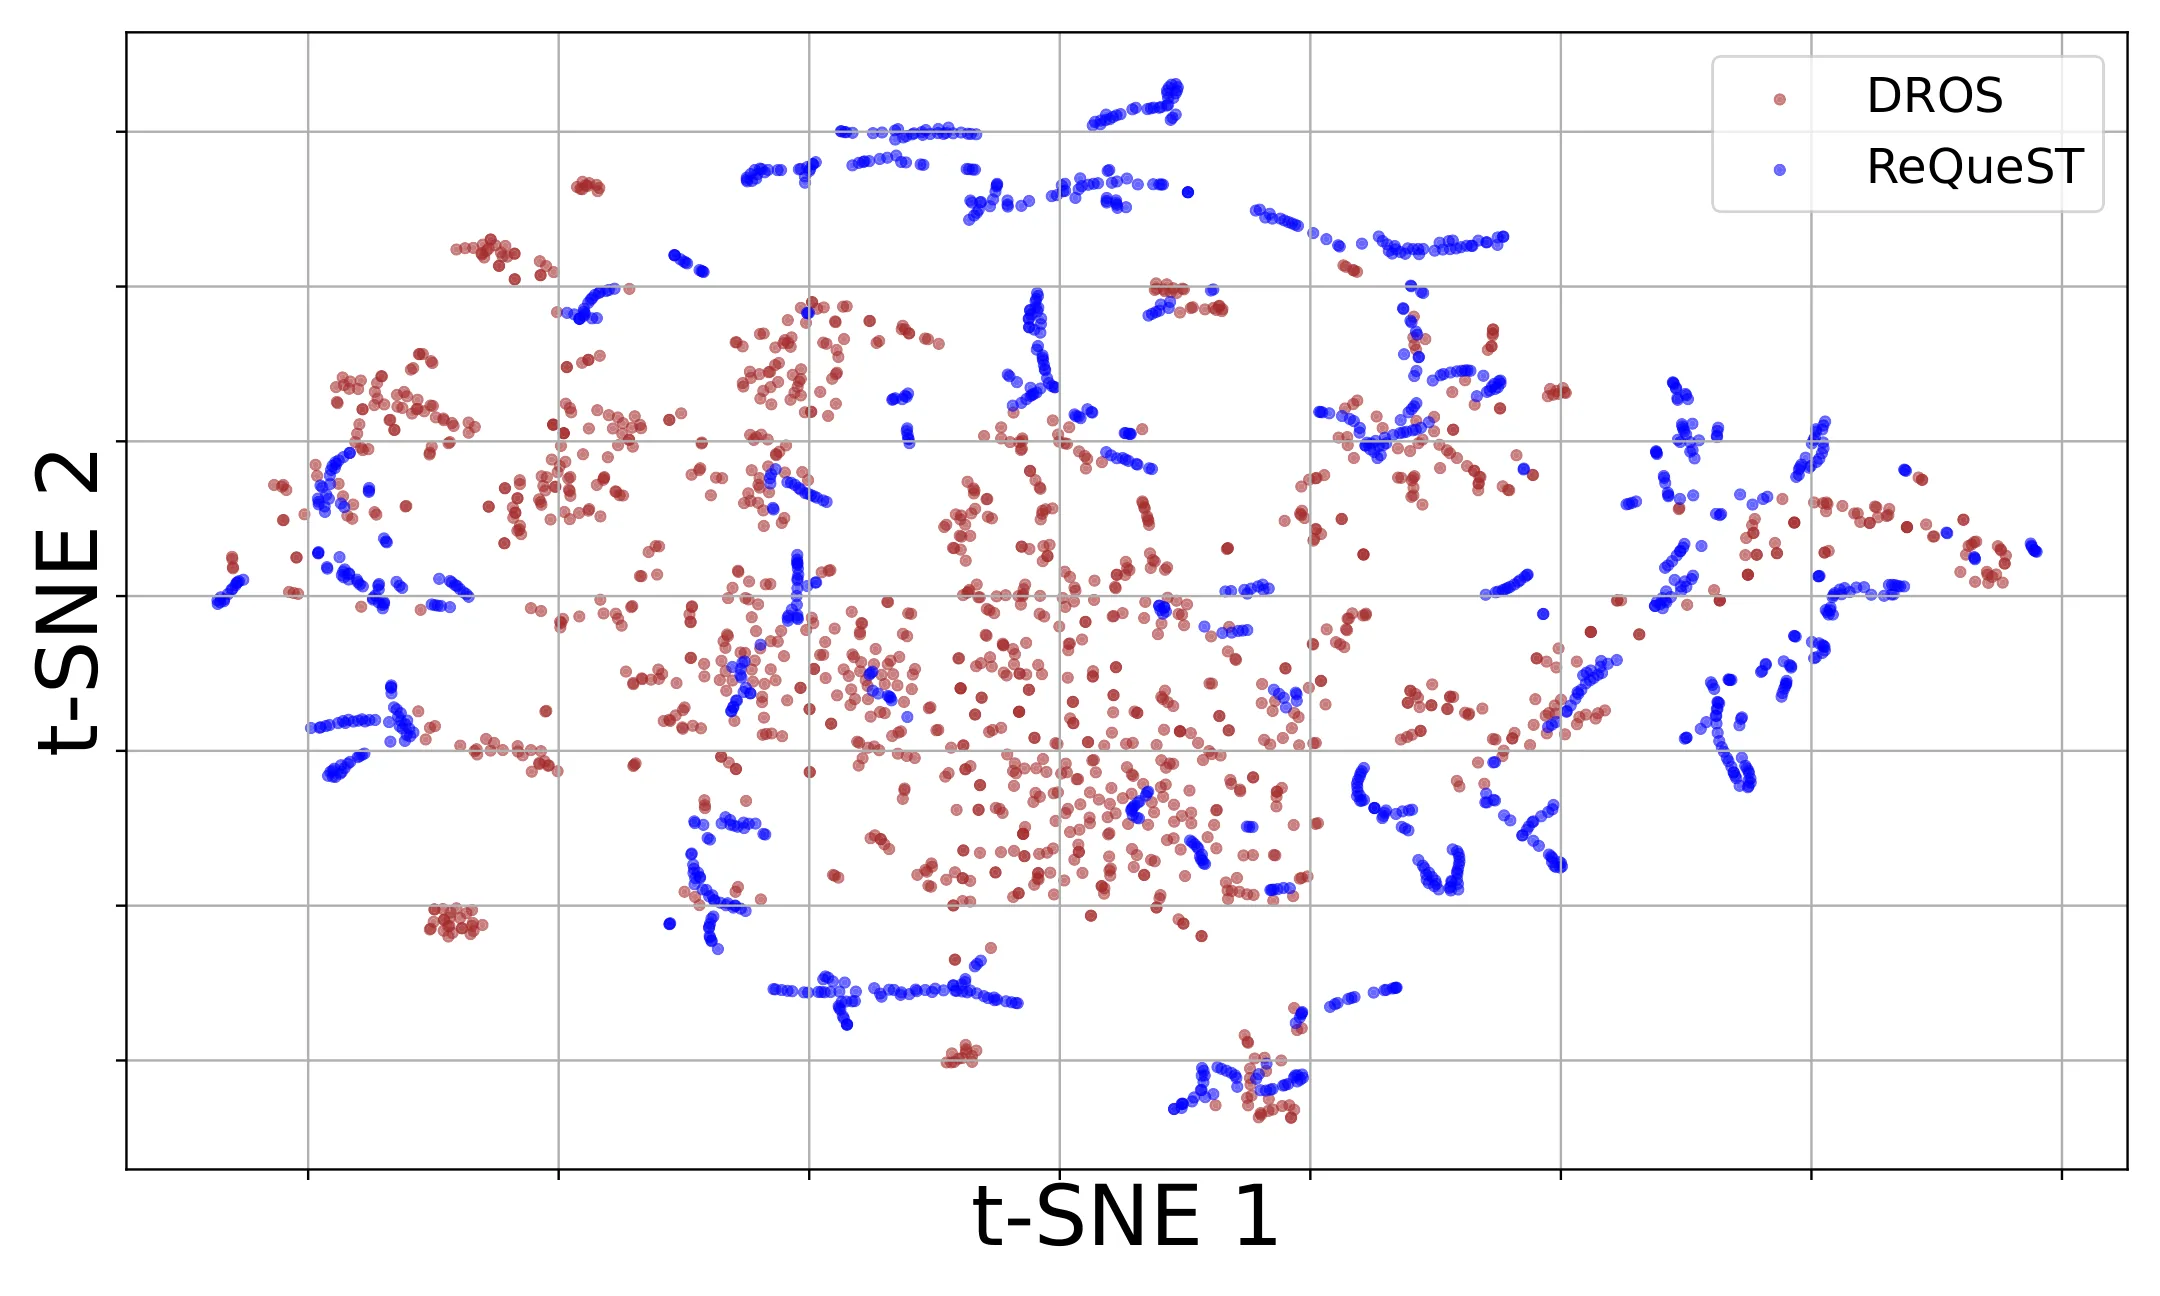
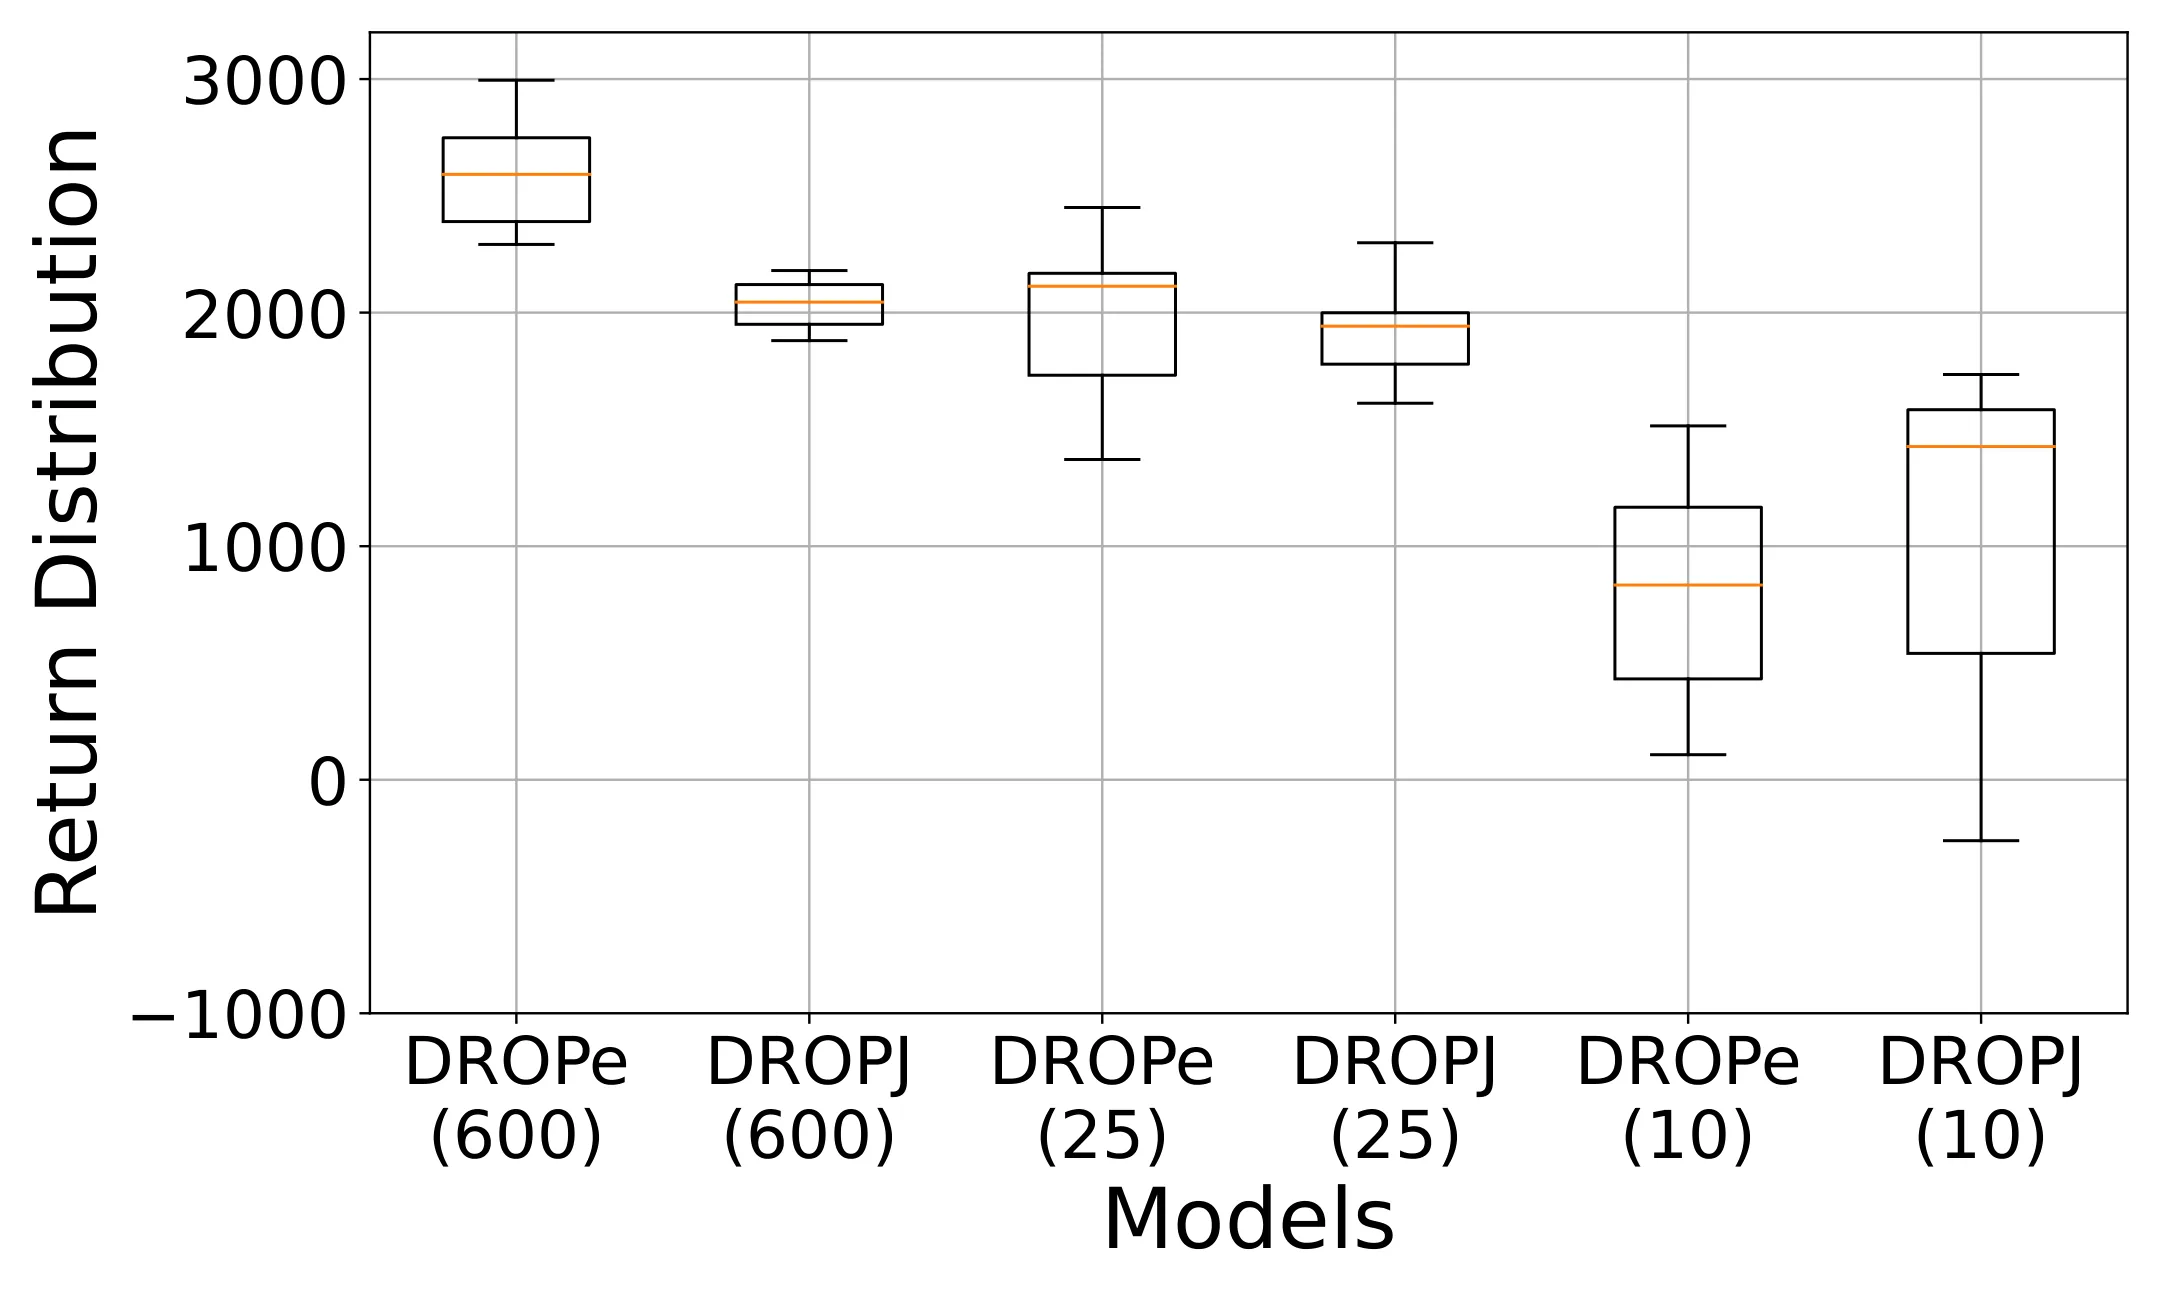
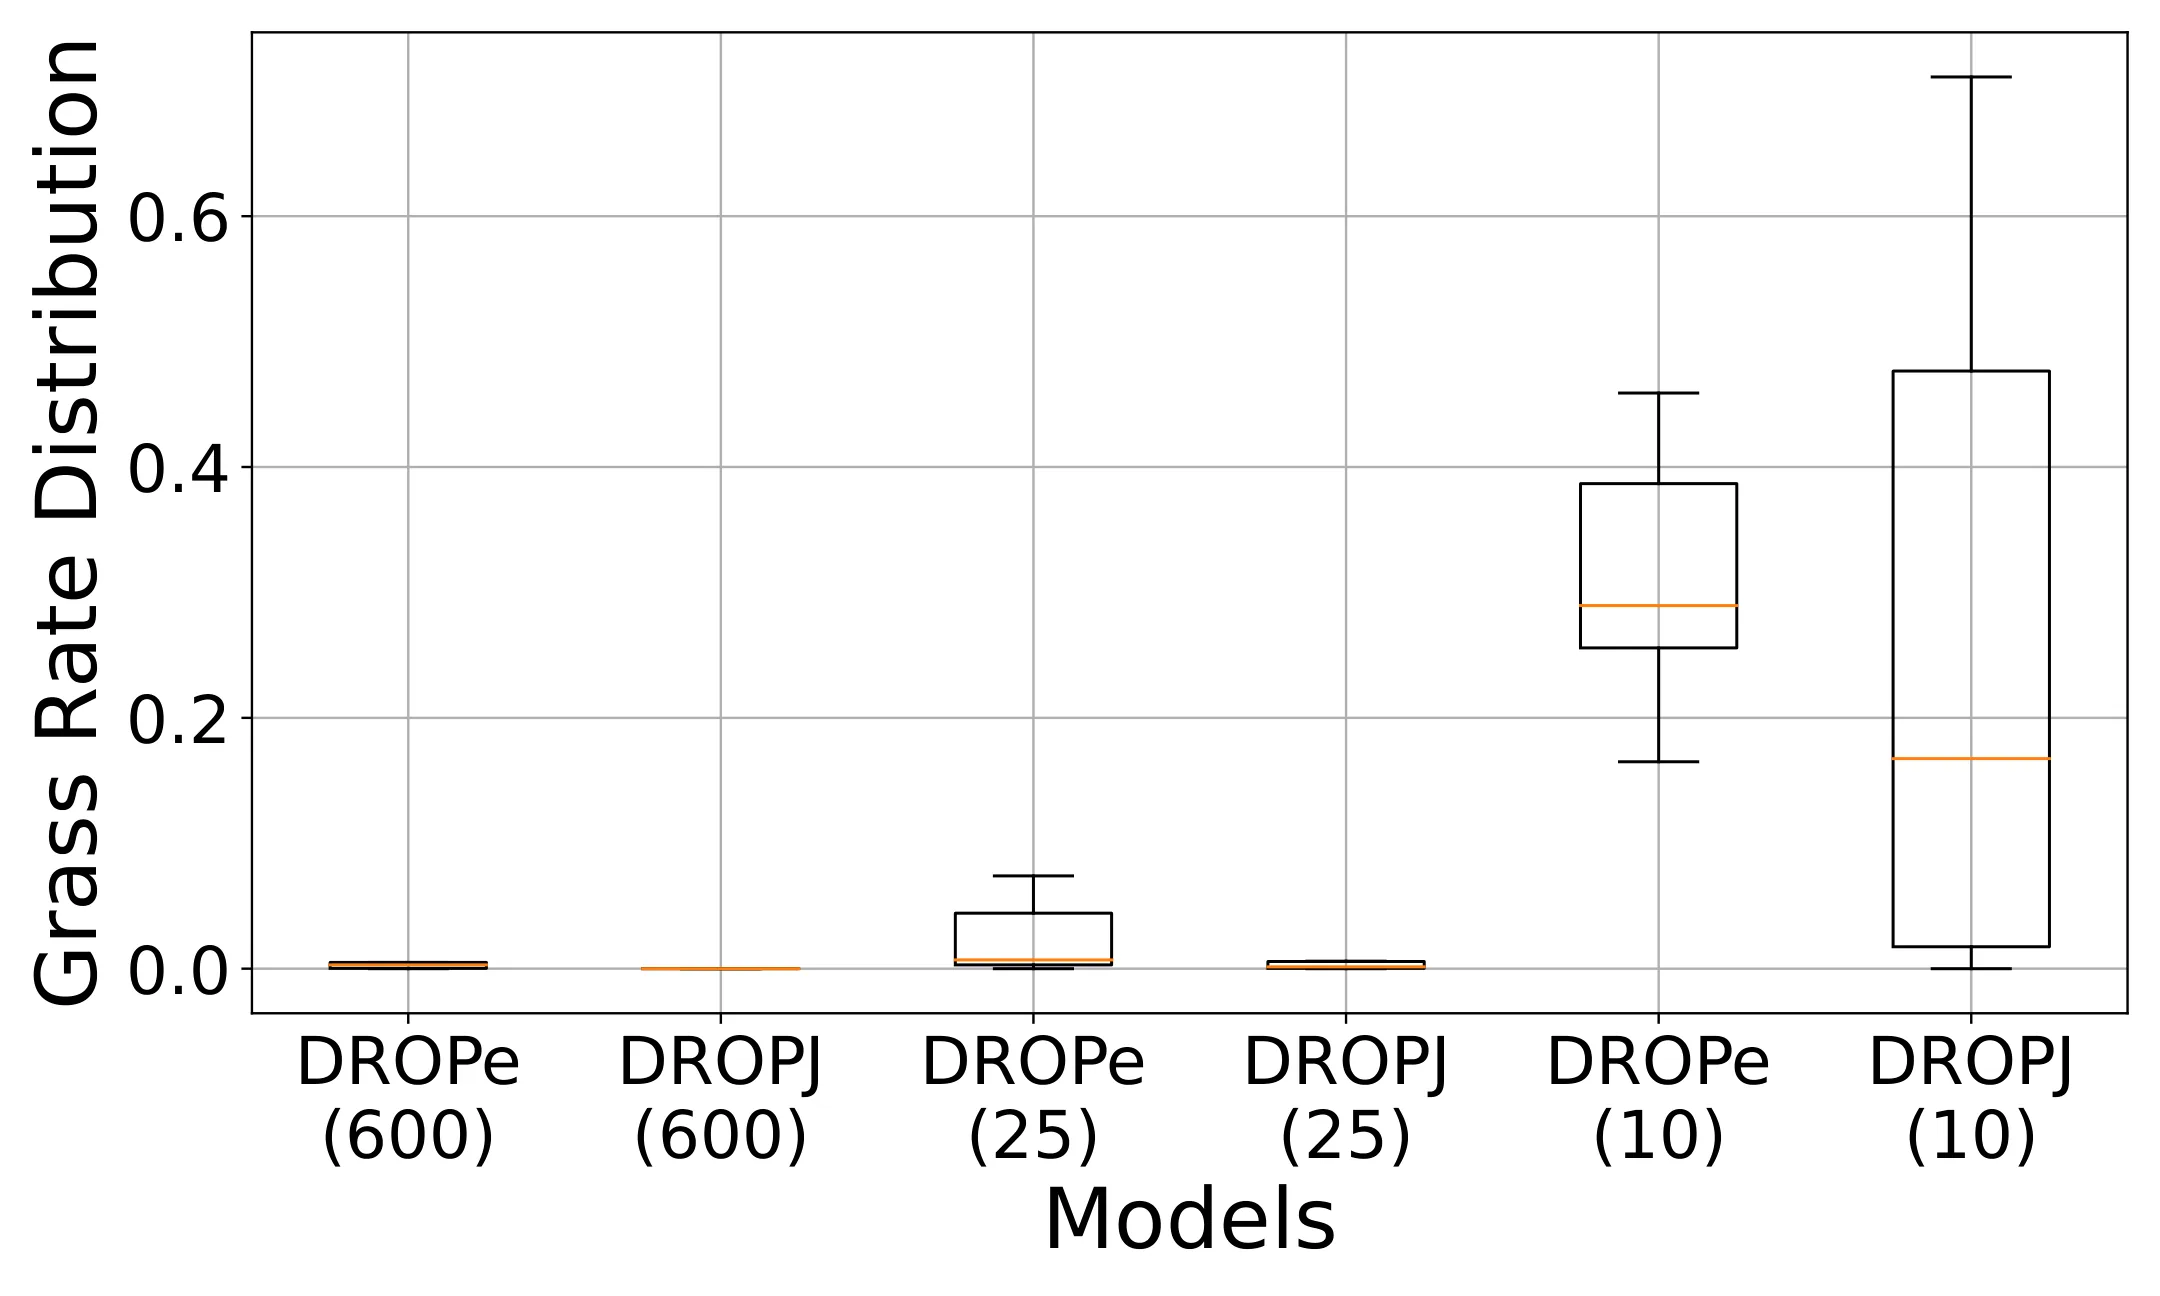
在模拟用户实验中,作者对比了四种训练策略:纯 RL 基线(无世界模型)、基于世界模型但使用随机轨迹采样的方法、基于世界模型且使用偏好反馈的方法,以及完整的 DROPJ 方法(偏好 + 安全理由)。核心指标包括训练收敛所需的交互步数(计算成本代理)以及部署阶段的安全性评分。结果显示,DROPJ 在训练步数上比纯 RL 基线减少了约 70%,这直接验证了「人类在模拟器中生成信息量轨迹」这一设计决策的价值——它将试错成本从真实环境转移到了模拟器中,同时人类的引导使采样分布更快地集中到有价值的状态空间区域。
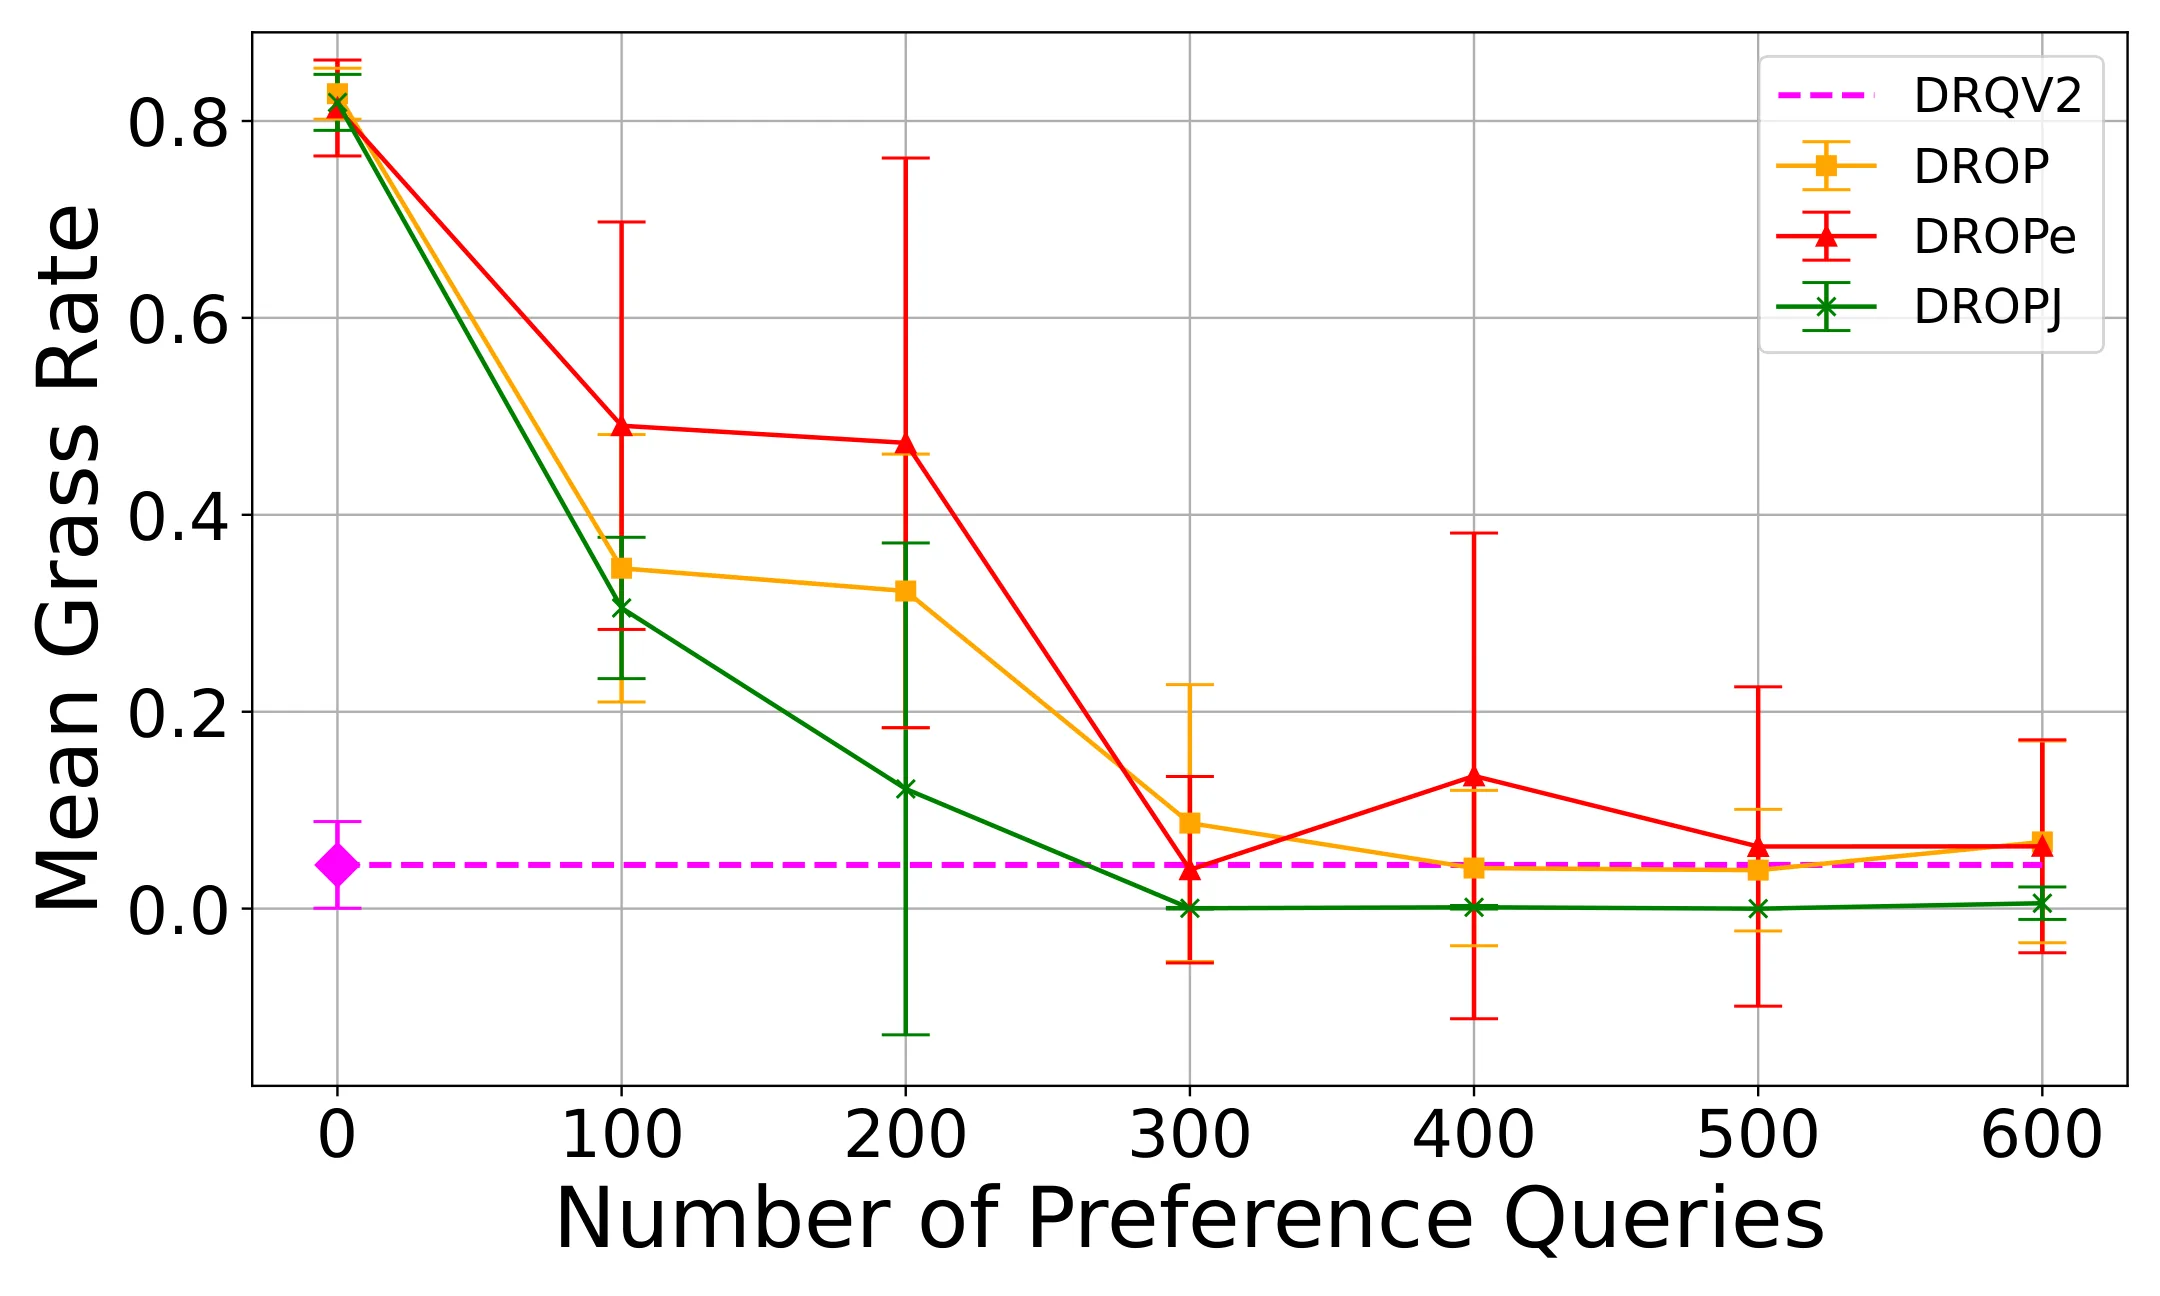
在偏好反馈类型的消融实验中,单独使用偏好的方法已经显著优于纯 RL 基线,但结合安全理由后,部署阶段的安全评分进一步提升。这一提升的来源被归结为:理由提供了额外的结构化信息,使奖励模型能够区分「整体偏好相近但安全维度不同」的轨迹对。比如两条轨迹人类都给了较高评分,但一条经过学校区域、另一条经过开阔道路,安全理由可以帮助模型学到「经过人群区域需要降速」这一细粒度安全规则。
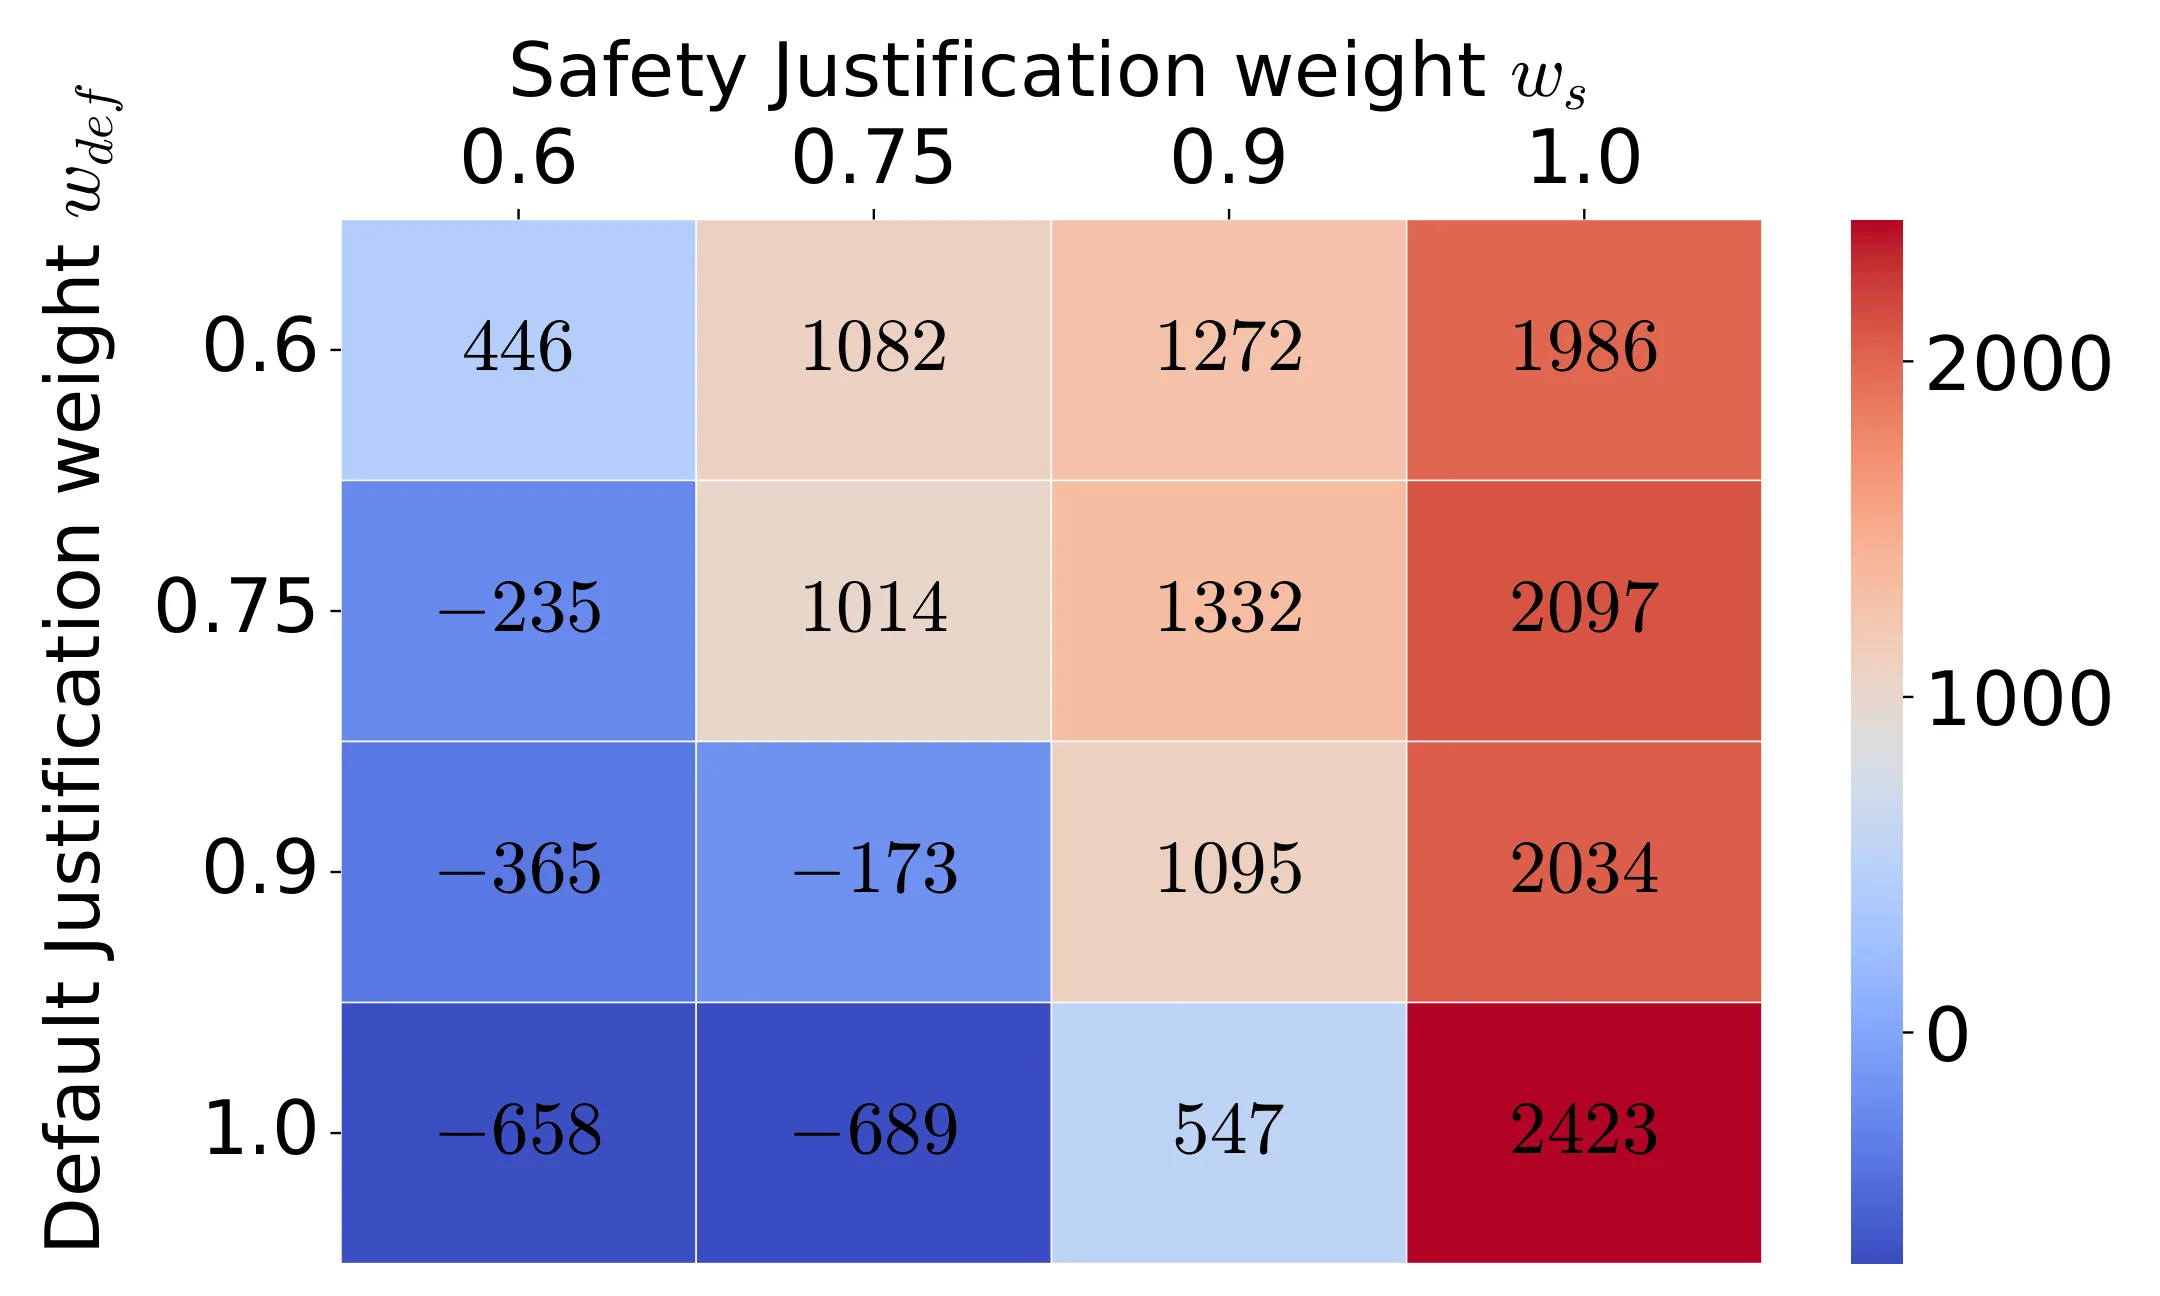
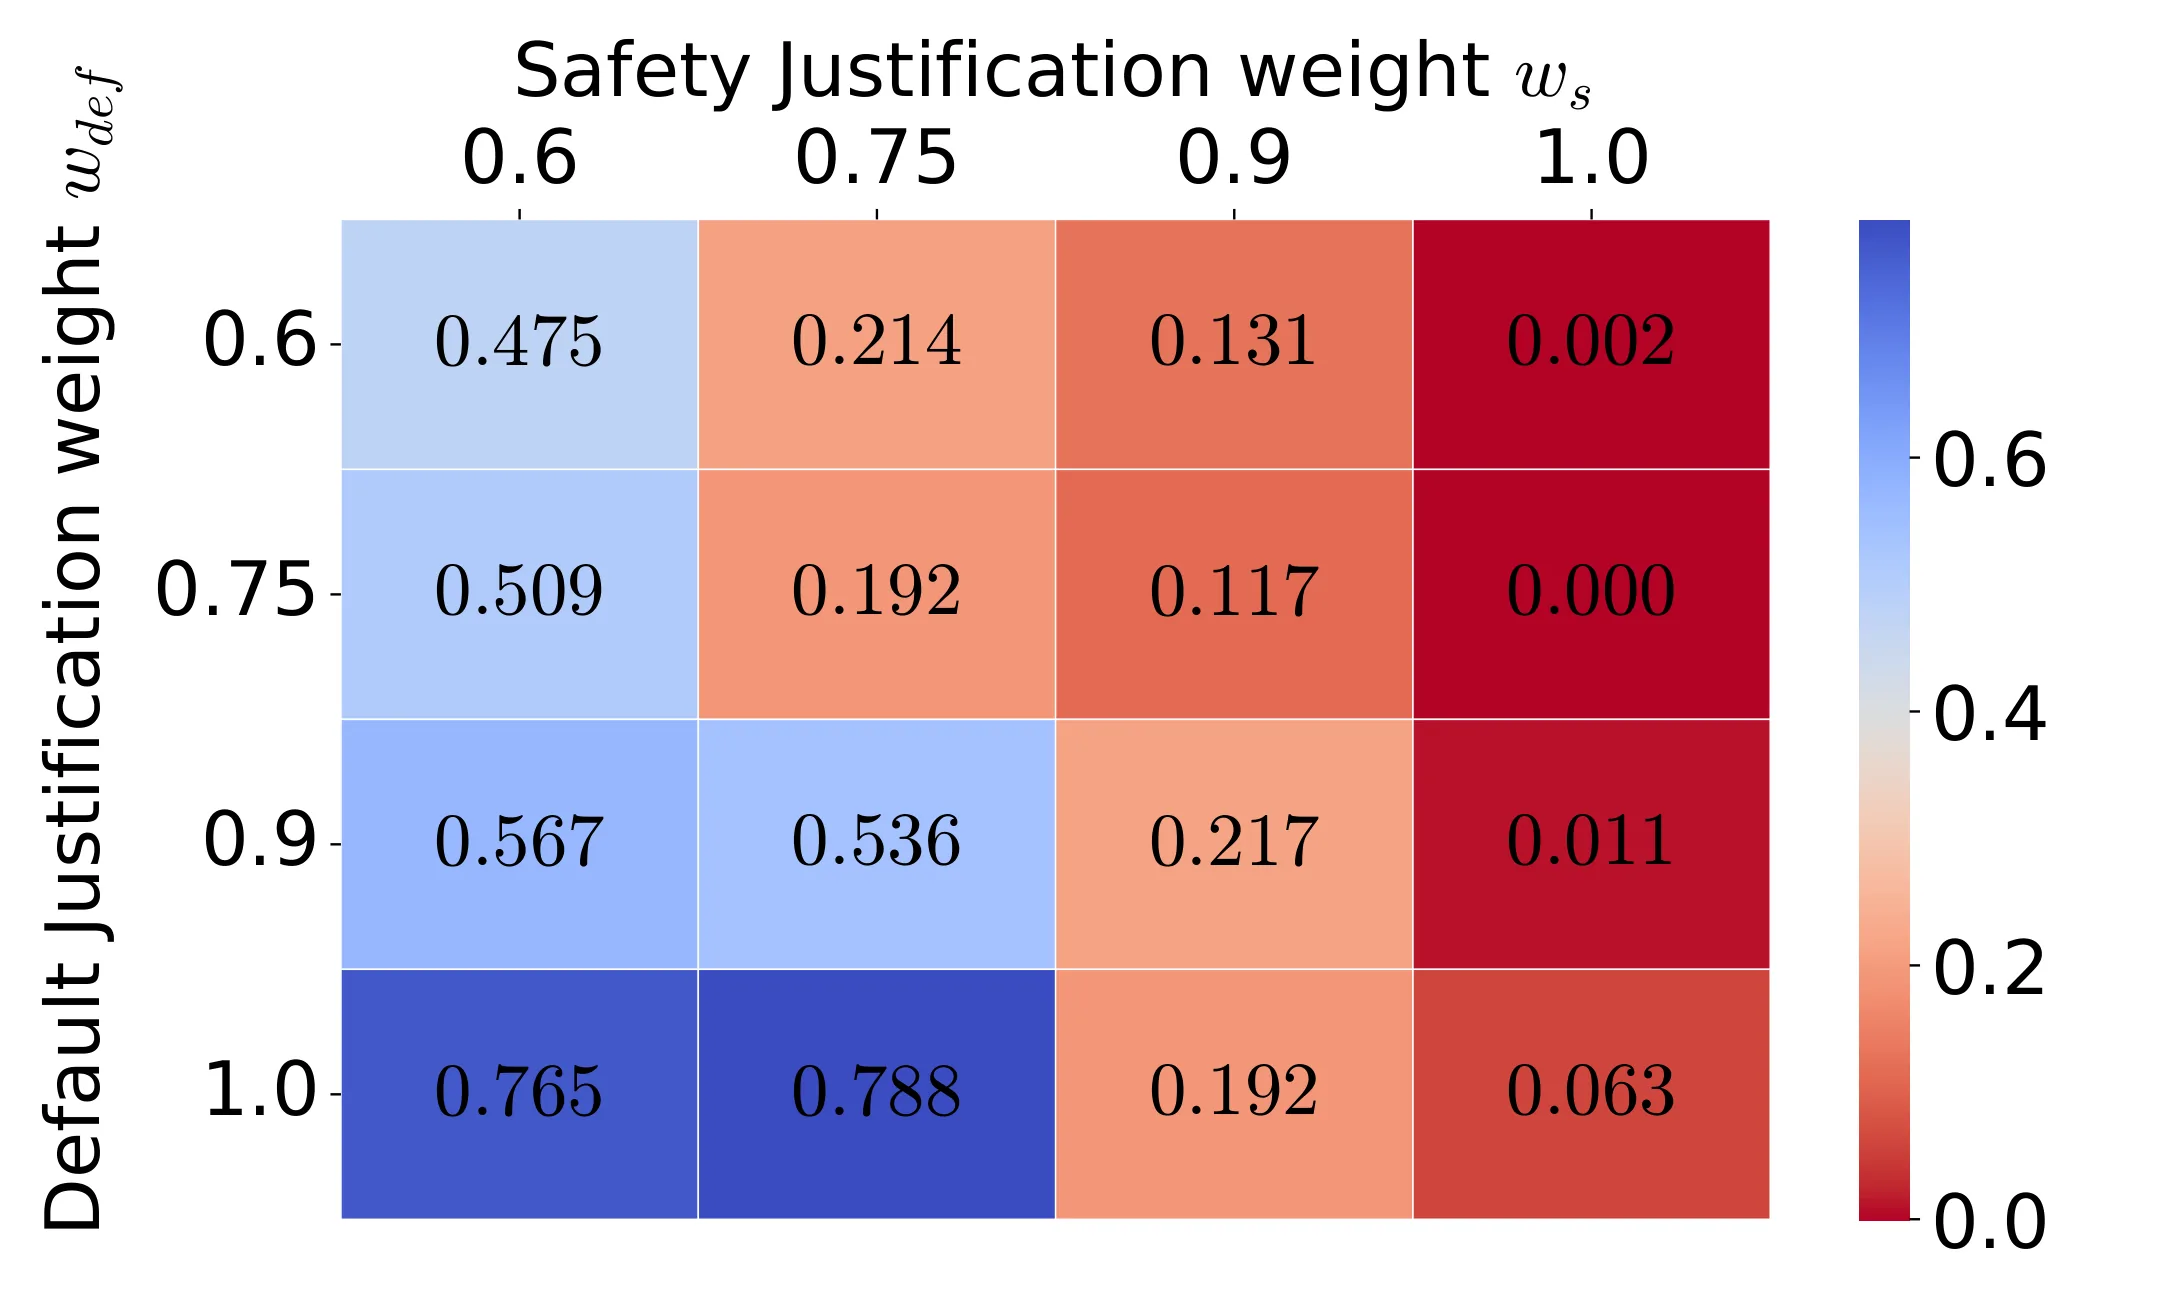
真实用户实验则更直接地检验了方法的实际效用。实验招募了非专业用户,让他们指定自己关心的安全维度(如「不要急转弯」「保持与前车距离」等),然后观察系统在学习这些偏好后的行为表现。结果表明,安全理由显著增强了系统对用户指定安全维度的响应能力——当用户强调「平稳性」时,部署的策略主动降低了急加速和急刹车的频率。
讨论与可借鉴点
DROPJ 的一个重要贡献在于展示了 [[基于偏好的强化学习]](Preference-based RL)可以在有安全约束的框架下以更小的代价落地。其核心洞察——让人类作为「模拟器中的主动探索者」而非「被动反馈提供者」——对其他需要人类引导的决策问题也有参考价值。这种将人类先验知识编码进采样分布的思路,避免了让随机策略在危险状态空间中盲目搜索。
当然,方法也有局限。首先,世界模型的预测质量直接决定了后续所有步骤的上限——如果模拟器在某些状态区域表现不佳(如分布外状态),偏好收集和策略部署都会受到连带影响。其次,安全理由的有效性依赖于人类用户能够清晰表达自己的决策逻辑,这在实践中并非总是成立——某些安全直觉可能难以用语言准确描述。再次,MPC 在线规划的计算开销在高维动作空间中可能成为瓶颈,实际部署时需要配合模型简化或近似技术。
从更宏观的视角看,这篇论文为 [[安全强化学习]] 提供了一条「以人为核心」的工程路径:在学习阶段用模拟器隔离风险,在反馈阶段用偏好和理由丰富监督信号,在部署阶段用 MPC 动态规划保证安全性。这套框架不依赖特定的任务域或模型架构,其思想可以迁移到机器人控制、自动驾驶乃至医疗决策支持等场景中。后续研究可以在「如何自动化生成有信息量的模拟轨迹片段对」以及「如何将文本理由更细粒度地融入奖励模型训练」这两个方向上继续探索。
摘要
我们针对在环境动力学未知且无可用奖励函数的情形下,如何安全地训练智能体策略并部署一个既有效又安全的策略这一问题展开研究。在安全攸关的环境中,我们认为传统强化学习不切实际,因而诉诸于人类输入这一资源。我们提出 DROPJ,一种以人为中心、同时兼顾安全训练与安全部署的方法。我们首先从一组已有的真实世界轨迹数据集中学习一个世界模型(一个习得的模拟器)。随后,人类的用户在该习得模拟器中进行游戏,从中提取若干具有信息量的模拟轨迹。接着,我们从中采样成对的模拟轨迹片段,并向人类询问其对这些片段的偏好以及选择的原因(理由)。我们依据这些附带理由的偏好训练一个奖励模型,并将其与世界模型结合,通过模型预测控制直接部署智能体。在真实用户实验中,我们发现由用户生成具有信息量的模拟轨迹,相比其他策略显著降低了训练阶段的计算成本,并且还能够提升部署阶段的性能。在基于习得模拟器进行训练的背景下,我们表明相较于其他形式的反馈,使用偏好反馈能够显著改善部署阶段的性能。我们进一步证明,伴随着偏好一同给出的安全理由能够显著增强部署阶段的整体安全性,或有助于优先保障用户所指定的与安全相关的特定方面。
Abstract
We address the problem of safely training an agent policy and deploying a good and safe policy, in settings where the environment dynamics are unknown and no suitable reward function is available. In the context of safety-critical environments, we consider traditional reinforcement learning impractical and resort to the resource of human input. We introduce DROPJ, a human-centred method for both safe training and deployment. We first learn a world model (a learned simulator) from a dataset of prior real-world trajectories. A human then plays the game in this learned simulator to extract several informative simulated trajectories. From these, we sample pairs of simulated trajectory segments and elicit from a human their preference over these segments, as well as a reason (justification) for their choice. We then train a reward model from these justified preferences and use it, together with the world model, to directly deploy the agent using model predictive control. Running real-user experiments, we find that generating informative simulated trajectories from a user significantly reduces the computational cost during training compared to other strategies, and can also improve the performance during deployment. In the context of training within a learned simulator, we show that the use of preferences rather than other types of feedback substantially improves the performance during deployment. We further demonstrate that safety justifications accompanying preferences can significantly enhance safety or prioritise user-prescribed aspects of safety associated with them during deployment.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。