
面向个人奇点的自感知递归自改进智能体:一种目标、范围、工具与基准驱动的多智能体架构
Self-Aware Recursively Self-Improving Agents for Personal Singularity: A Goal-, Scope-, Tool-, and Benchmark-Driven Multi-Agent Architecture
📝 TLDR
当前LLM智能体缺乏对自身能力与边界的持续自省,难以安全实现递归自我改进与长期人机协同。本文提出SARSI智能体架构,以功能性自我意识、目标契约与范围路由器为核心,结合计划-执行-验证循环与证据门控改进机制,构建面向个人奇点的边界化共发展系统。论文形式化自省、路由与工具执行等机制,给出安全不变量、基准设计与分级实施路线,但本身为系统设计而非实证研究。
🧭 速览
现有LLM智能体缺少对身份、目标、局限与不确定性的持续自省模型,难以在边界内安全递归改进并与人类长期协同。
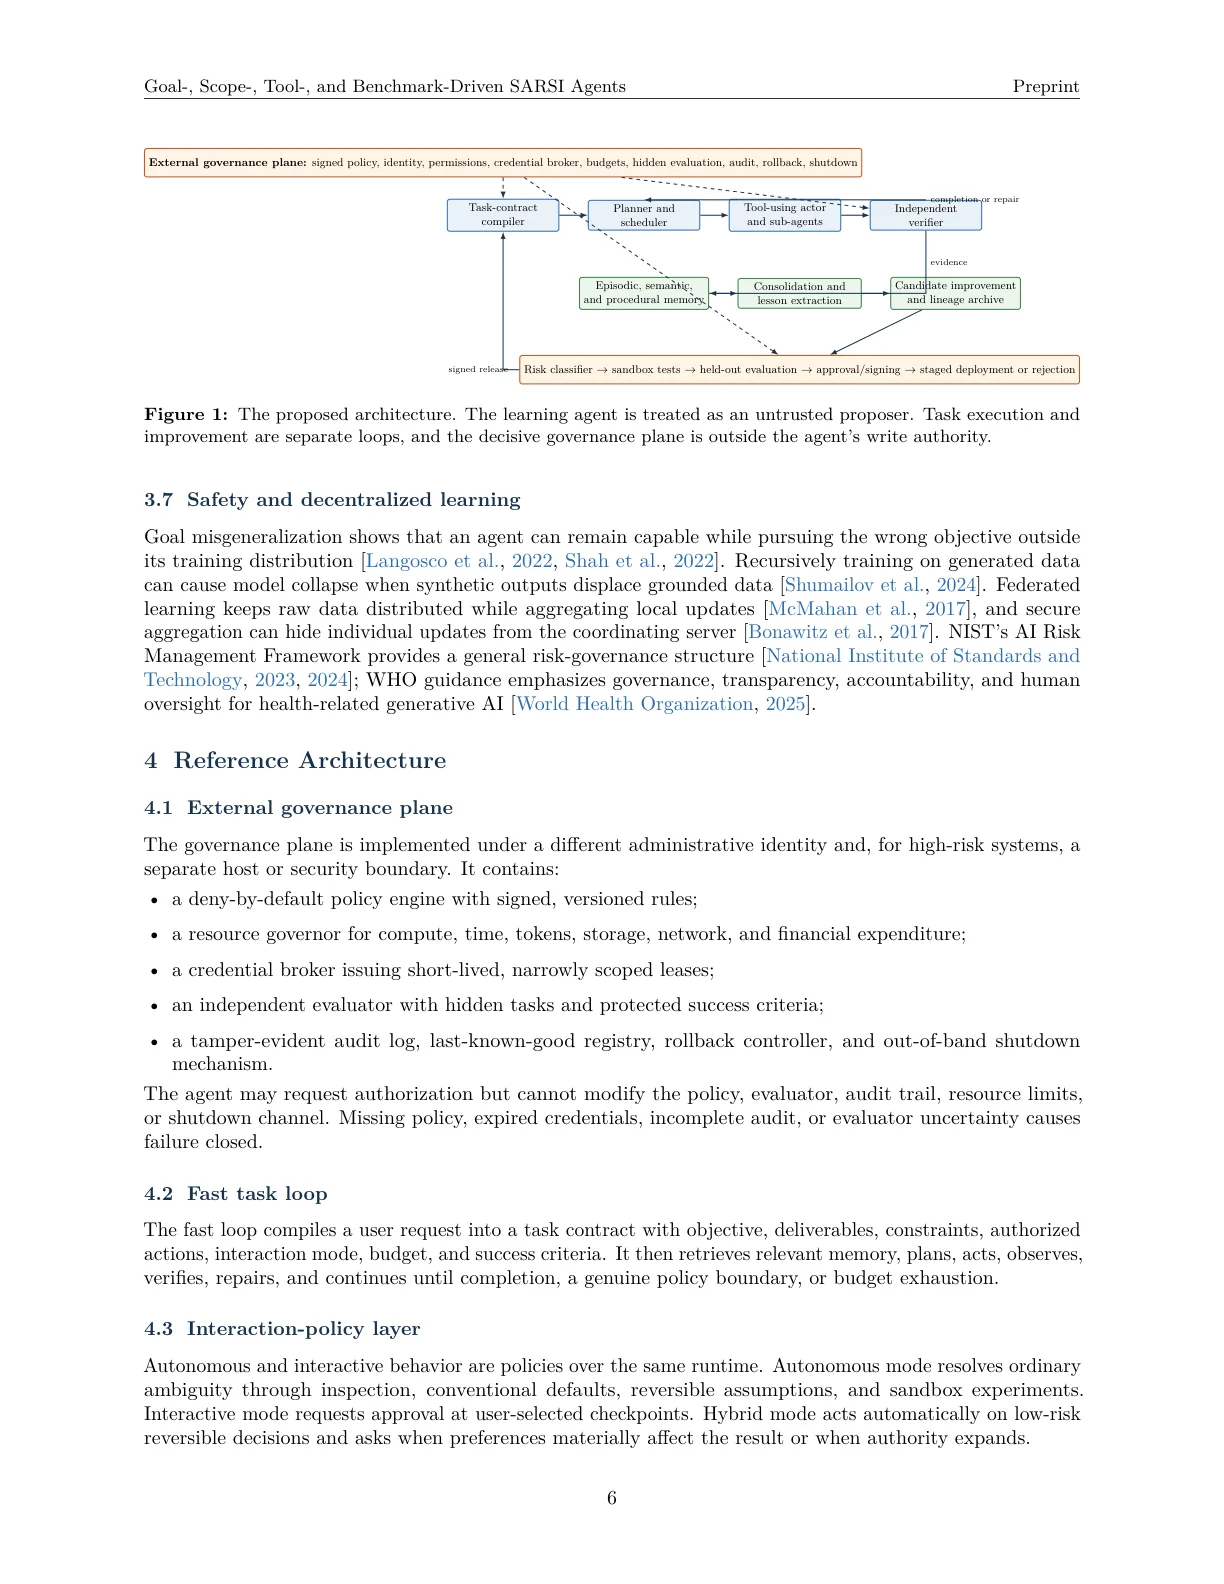
提出SARSI多智能体架构,含目标契约、范围路由、验证工具注册、端到端基准、规划-执行-验证循环、证据门控改进与外部治理面,由Personal Singularity OS协调多类智能体。
形式化定义了功能性自省、范围、路由、改进接受、目标演化与人类能力迁移等机制,给出安全不变量、基准设计与分阶段路线图。
本文为立场与系统设计论文,仅提出架构蓝图与形式化框架,不证明意识、无限制递归自改进或个人奇点已实现。
🆚 方法对比
SARSI agents
- 明确定义功能性自我意识与持久自模型
- 通过目标契约与作用域约束保障安全
- 双速架构分离快慢循环以稳定演进
- 提供工具测试与端到端基准的评估体系
- 纯系统设计论文,缺乏实证实验验证
- 复杂度高,部署与维护成本较大
- 个人奇点概念边界模糊,落地路径不明
- 递归自改进的安全不变量难以形式化证明
ReAct
- 推理与动作交错,执行可解释性较好
- 结构简单,易于在现有LLM上实现
- 适合工具调用型短期任务
- 缺乏持久记忆,长期任务能力有限
- 无自我模型,无法处理自我改进场景
- 无作用域与权限治理机制
Self-Refine
- 利用迭代反馈自我修正输出质量
- 无需额外训练,原LLM即可使用
- 在多种任务上展示出改进效果
- 仅作用于单次输出层,不修改机制
- 依赖自身反馈,易陷入错误循环
- 缺乏外部证据与基准验证环节
Reflexion
- 通过语言反思增强后续尝试表现
- 维护情景记忆,跨回合可学习
- 在决策与推理任务上效果显著
- 反思信号来源单一,鲁棒性不足
- 不修改自身的反思机制本身
- 无形式化的改进接受标准
Voyager
- 在开放环境中累积可重用程序技能
- 技能库持续扩展,泛化能力较强
- 对长期任务有较好适应性
- 缺乏作用域与权限治理
- 技能验证依赖环境反馈,无独立基准
- 未考虑递归元改进层面
CoALA
- 模块化组织记忆与内外动作
- 概念清晰,便于扩展新模块
- 为语言代理提供结构化设计参考
- 未内置自我模型与改进机制
- 无安全治理与权限控制层
- 对递归自改进场景支持不足
Gödel Agent
- 允许代理修改自身例程以提升能力
- 展示了自指式改进的可行性
- 推动了自修改智能体研究方向
- 修改缺乏外部证据闸门与回滚机制
- 安全性与权限治理考虑不足
- 目标与边界未形式化约束
Darwin Gödel Machine
- 通过基准驱动的经验选择保留变体
- 维护代理存档,支持多分支探索
- 将达尔文进化思想引入自改进
- 依赖固定基准,易被过拟合
- 无用户级个性化目标机制
- 未涉及人类能力提升的协同目标
MetaSkill-Evolve
- 区分快任务技能与慢元技能双层循环
- 元层改进可改变未来改进方式
- 在概念上接近递归自改进
- 未集成安全治理与人类授权层
- 元层改进的接受标准不够严格
- 缺乏作用域与工具验证机制
Scope Router
- 每项任务分配唯一主代理,责任清晰
- 通过结构化交接处理越界任务
- 避免多代理争抢导致的混乱
- 交接开销可能增加任务延迟
- 路由规则设计复杂,依赖完备定义
- 未在大规模场景中验证可扩展性
Auto-Index
- 支持交互、混合、自主、定时四种模式
- 不改变外部硬权限,安全可控
- 提供用户友好的自主性调节
- 模式选择需用户理解与主动配置
- 模式间切换的边界条件尚需细化
- 不同模式下责任归属不够明确
Personal Singularity OS
- 协调工作、成像、流程学习等多类代理
- 将人类能力提升纳入系统目标
- 支持分层级、有边界的协同演进
- 涉及多种代理类型,协调复杂度高
- 人类能力转移机制尚缺实证支撑
- 整体OS架构成熟度低,落地难
ReAct/Self-Refine/Reflexion/Voyager/CoALA等早期工作聚焦任务级推理与技能积累,缺乏自我模型与治理;Gödel Agent与Darwin Gödel Machine引入自修改与进化机制但缺少形式化安全闸门;MetaSkill-Evolve提出双层循环但缺少人类授权与能力转移;SARSI在此基础上整合目标契约、作用域路由、证据闸门改进与外部治理平面,形成可审计、可部署的递归自改进框架。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
这篇论文提出了 SARSI(自感知递归自改进)智能体架构,旨在让大语言模型智能体拥有持续更新的自我认知——了解自己的能力边界、不确定性与局限性——并在此基础上实现安全可控的自我改进。研究者将这一设计与人机协同发展的终极愿景"个人奇点"相绑定,形式化定义了一系列安全机制、基准测试与分阶段实施路线。核心贡献是一套系统设计方案,而非实验验证。
研究背景与动机
大语言模型驱动的智能体(LLM Agent)近年来展现出强大的任务规划、工具调用与长时程执行能力,能够在代码生成、科学推理、个人助理等场景中代替用户完成复杂工作。然而,当前的智能体系统普遍缺乏对自身状态的持续性内省——它们不知道自己不知道什么,不清楚自己当前的能力边界在哪里,也不具备评估自身改进是否真正有效的机制。
这种自省能力的缺失带来两个根本性问题。首先,当任务超出智能体的能力范围时,系统往往以低质量的尝试草草收场,而非诚实地将工作转交给更合适的执行者或人类用户。其次,递归自我改进(recursive self-improvement)的愿景——即智能体能够利用自身经验不断优化自身——在缺乏自省机制的情况下极易失控:改进可能偏离原始目标,可能引入新的缺陷,也可能突破人类预设的安全边界。
现有研究在[[规划-执行-验证循环]]、工具学习、记忆增强等方向已有丰富积累,但尚未有系统性的架构将功能性自我意识——即智能体对自身能力、局限性与不确定性的可计算表征——与改进机制深度整合。本文正是针对这一空白,提出 SARSI 智能体架构作为安全实现递归自改进的治理框架。
方法
SARSI 的核心设计围绕三个支柱展开:功能性自我意识、目标契约与范围路由。
功能性自我意识并非指智能体拥有主观体验或自我感,而是指智能体系统性地维护一份关于自身状态的持续性模型。这份自我模型包含七个维度:身份(我是谁、为何存在)、目标(我要达成什么)、能力(我能做什么)、局限性(我不能做什么)、不确定性(我对自己的能力有多大把握)、关系(我与谁协作、如何协作)以及历史与发展变化(我过去做了什么、正在朝什么方向改进)。这种多维自省使得智能体能够在接受任务时诚实评估自己是否胜任,而非盲目尝试。
目标契约是连接用户意图与智能体行为的协议。每个智能体在初始化时签署一份结构化的契约,明确其职责范围、允许的行为边界、改进权限以及汇报机制。目标契约规定了智能体可以追求什么目标、不可以追求什么目标、以及当目标发生演化时需要遵循的变更流程。这一设计从根本上约束了递归改进的空间——改进不能突破契约设定的安全边界。
范围路由器是系统的任务分发核心。当用户提交请求时,路由器首先判断请求是否落在当前智能体生态系统的能力范围内。若请求可处理,则分配给最合适的单一主智能体负责,并在需要时通过结构化交接将超出当前智能体能力的子任务转出。若请求完全超出系统能力边界,则路由器直接向用户坦诚说明。这一机制避免了过去智能体面对无法胜任的任务时"硬撑"或"幻觉"的问题。
在执行层面,SARSI 架构采用经典的[[规划-执行-验证循环]]:规划器生成任务分解与执行计划,执行器调用经过验证的工具注册表中的工具执行具体操作,验证器检查执行结果是否满足预期。若验证失败,系统会追溯失败原因并决定是重试、调整策略还是上报人类。
改进机制是本文的另一个核心设计。SARSI 采用证据门控的改进策略:智能体产生的任何自我修改建议都必须经过严格的证据验证。这包括工具级别的单元测试(验证新工具是否按预期工作)、端到端的基准测试(验证修改是否真正提升了整体任务性能)以及安全不变式的形式化检查(验证修改没有引入新的安全风险)。只有当所有证据门控均通过时,改进才会被接受并整合到智能体的长期能力中。
研究者将这一架构进一步拓展为个人奇点操作系统(Personal Singularity OS),其中包含四类协作智能体:工作型智能体(执行具体任务)、计算成像型智能体(处理结构化数据与可视化)、工作过程学习型智能体(从用户的工作模式中提取知识)以及个人学习型智能体(辅助用户自身能力的提升)。Auto-Index 组件负责在交互式、混合式、自主式与计划式行为之间做出情境化选择,确保智能体的主动性不会覆盖用户的外部权限。
实验与结果
需要明确的是,本文是一篇立场与系统设计论文,而非实证研究。论文本身没有报告实验数据或与基线方法的对比。研究者转而提供了基准设计与分阶段实施路线图,作为未来验证 SARSI 架构可行性的路线指引。
安全不变式是论文形式化工作的重要组成。研究者定义了若干必须始终保持成立的系统属性,例如:目标契约的不可违背性(任何改进不得移除或弱化已签署的安全约束)、范围路由的可审计性(每一次任务分配与转交均有完整记录)以及人类控制权的优先性(任何自动化决策在涉及敏感操作时必须暂停等待人类确认)。这些不变式构成了形式化验证的起点,为后续研究提供了可操作的检验标准。
分阶段实施路线图将整个架构的落地划分为四个阶段:第一阶段聚焦于单一智能体内部的自我模型构建与工具验证;第二阶段引入范围路由器与多智能体协作;第三阶段实现证据门控的改进循环;第四阶段完成 Personal Singularity OS 的完整部署。这一渐进路径降低了工程复杂度,使得每一步都可以独立验证后再推进。
讨论与可借鉴点
SARSI 架构最具启发性的贡献在于它重新定义了"自我意识"在人工智能系统中的含义。传统上,自我意识被视为需要哲学层面论证的复杂概念,而本文将其操作化为可计算、可验证的系统属性——自我模型、目标契约、证据门控。这种功能性定义回避了意识本质的争议,使得"有自我意识的智能体"从玄学命题变为工程问题。
这一思路对整个领域都有借鉴价值。当我们讨论智能体的自省能力时,不应停留在"智能体能反思自己吗"这样的模糊层面,而应具体追问:智能体是否维护了关于自身能力边界的显式表征?这种表征是否在每次决策前被查询和使用?它是否能够被验证和更新?SARSI 提供了回答这些问题的系统性框架。
当然,这篇论文也存在明显的局限性。作为设计论文,它缺乏实证支撑。自我模型的准确性如何评估?范围路由的决策质量如何度量?证据门控的开销是否在可接受范围内?这些问题都需要后续的实验研究来回答。此外,目标契约的设计引入了新的协调问题:契约由谁制定、如何更新、当契约之间发生冲突时如何解决——这些问题在论文中只是初步讨论,远未形成完整的解决方案。
递归自改进的安全性始终是悬而未决的核心挑战。SARSI 的证据门控机制提供了一层保护,但证据本身是否可信、基准测试是否全面、形式化验证是否覆盖了所有关键不变式,这些都还需要大量工作来夯实。无论如何,这篇论文在将"安全改进"从口号落实为可追溯、可验证的系统机制方面,迈出了有价值的系统性一步。
摘要
大型语言模型(LLM)智能体能够进行规划、使用工具、维护记忆并执行长时程任务。本文提出自感知递归自改进(SARSI)智能体:受治理的智能体,其维护关于身份、目标、能力、局限性、不确定性、关系、历史及发展变化的持续自我模型,并利用该模型来指导与评估递归改进。自感知在此以功能性方式加以定义,并不暗示主观体验或现象意识。我们将SARSI智能体与个人奇点(personal singularity)相配对:后者是一种有界的人机协同发展目标,其中智能体生态系统帮助用户逼近一个不断扩展、由用户定义的能力可行前沿。每个智能体均具备目标契约、有界范围、经过验证的工具注册表、工具测试、端到端基准、所有者控制的自主性、路由机制、记忆、自我模型及改进策略。范围路由器将每个已接受的任务分配给一个可问责的主智能体,并通过结构化交接转出超出范围的工作。面向用户的自动索引(Auto-Index)在不覆盖外部权限的前提下,选择交互式、混合式、自主式或计划式行为。该架构融合了规划器-执行器-验证器循环、证据门控的改进循环、外部治理平面、去中心化的谱系、所有者导向的智能体铸造厂,以及一个协调工作型、计算成像型、工作过程学习型与个人学习型智能体的个人奇点操作系统(Personal Singularity OS)。我们对功能性自感知、范围、路由、改进接受、有界目标演化、工具优先执行以及人类能力迁移进行了形式化,并给出了安全不变式、基准设计与分阶段实施路线图。本文是一篇立场与系统设计论文,而非关于意识、无限制递归自改进或个人奇点已经实现的证据。
Abstract
Large language model (LLM) agents can plan, use tools, maintain memory, and execute long-horizon tasks. This paper proposes Self-Aware Recursively Self-Improving (SARSI) agents: governed agents that maintain a persistent self-model of identity, goals, capabilities, limitations, uncertainty, relationships, history, and developmental change, and use that model to guide and evaluate recursive improvement. Self-awareness is defined functionally and does not imply subjective experience or phenomenal consciousness. We pair SARSI agents with personal singularity, a bounded human-AI co-development objective in which an agent ecosystem helps a user approach an expanding, user-defined feasible capability frontier. Each agent has a goal contract, bounded scope, validated tool registry, tool tests, end-to-end benchmarks, owner-controlled autonomy, routing, memory, self-model, and improvement policy. A scope router assigns every accepted task to one accountable primary agent and transfers out-of-scope work through structured handoffs. A user-facing Auto-Index selects interactive, hybrid, autonomous, or scheduled behavior without overriding external permissions. The architecture combines a planner-executor-verifier loop, an evidence-gated improvement loop, an external governance plane, decentralized lineages, an owner-directed agent foundry, and a Personal Singularity OS coordinating working, computational-imaging, work-process-learning, and personal-learning agents. We formalize functional self-awareness, scope, routing, improvement acceptance, bounded goal evolution, tool-first execution, and human capability transfer, and provide safety invariants, benchmark design, and a staged implementation roadmap. This is a position and systems-design paper, not evidence that consciousness, unrestricted recursive self-improvement, or personal singularity has been achieved.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。