
如何实现递归自我改进智能体与个人奇点:一种由目标、范围、工具与基准驱动的多智能体架构
How to Realize Recursively Self-Improving Agents and Personal Singularity: A Goal-, Scope-, Tool-, and Benchmark-Driven Multi-Agent Architecture
📝 TLDR
针对智能体如何递归改进自身并将其转化为用户持久能力的难题,本文提出以目标契约、有限作用域、工具注册表与基准驱动的受治理多智能体架构。系统融合快速规划-执行-验证循环与慢速证据门控改进循环,辅以外部治理平面、去中心化血脉与用户导向铸造厂,并形式化作用域路由、改进接纳与人类能力迁移,给出安全不变量与实施路线图。本文为立场与系统设计论文,未证明无限制递归自我改进已实现。
🧭 速览
LLM智能体已能执行长时任务,但如何递归改进自身机制并将改进转化为人类用户的持久能力,而非仅限于软件本身,仍是开放难题。
提出以目标契约、有限作用域、工具注册表与基准驱动的受治理多智能体架构,结合快速规划执行循环与慢速证据门控改进循环,由个性奇点操作系统统筹多类代理。
形式化作用域路由、改进接纳、有界目标演进、工具优先执行与人类能力迁移机制,给出安全不变量、基准设计与实施路线图;定位为系统设计立场论文,无实证结果。
该架构为可治理的递归自改进与人类-AI协同发展提供设计框架,但无限制递归自我改进与个性奇点的真正落地仍未证明。
🆚 方法对比
SARSI代理
- 整合自我模型与递归改进机制
- 形式化任务自主与元改进分离
- 含版本化血统与回滚能力
- 外部治理平面保障安全不变量
- 仅系统设计未实证实现
- 自我意识概念易引哲学争议
- 架构复杂度高工程落地难
- 无控制实验验证效果
Personal Singularity OS
- 四类代理覆盖工作学习多场景
- 用户导向扩展能力前沿
- 显式区分工作与个人学习代理
- 强调人机协同而非替代
- 概念边界模糊难形式化
- 未提供量化评估指标
- 用户依赖风险需治理机制
- 论文承认未实证实现
ReAct
- 推理与动作交替范式简单有效
- 广泛适用且易于实现
- 为后续代理系统提供基础
- 缺乏长期记忆机制
- 无自我改进或元认知能力
- 不适用于长视野任务管理
Self-Refine
- 利用LLM自身反馈迭代改进
- 无需额外训练数据成本低
- 即插即用实现简单
- 反馈质量依赖LLM能力上限
- 无结构化记忆或工具管理
- 缺乏改进接受门控机制
Reflexion
- 通过语言反思积累试错经验
- 不修改模型参数安全性高
- 适用于多轮决策场景
- 反思信息易累积冗余
- 缺乏能力边界建模
- 无工具级验证机制
Voyager
- 开放环境中持续积累可复用技能
- 技能库提升长期任务效率
- 展示长期增量学习能力
- 局限于Minecraft游戏环境
- 无显式自我模型或治理
- 改进过程缺乏安全门控
CoALA
- 模块化设计区分内外动作
- 概念框架全面且系统化
- 指导后续代理架构设计
- 理论框架为主缺实证支持
- 无递归自我改进能力
- 缺治理与权限控制机制
Gödel Agent
- 真正修改自身代码实现自改进
- 展示自指改进的可行性
- 为递归改进提供理论基础
- 自修改风险高缺乏安全门控
- 无外部治理或回滚机制
- 改进效果难以预测控制
Darwin Gödel Machine
- 基于经验基准的进化选择机制
- 维护多代改进档案可回溯
- 实证展示累积性能提升
- 计算开销大需维护大量代理
- 选择机制依赖基准设计质量
- 缺乏用户个性化与治理维度
MetaSkill-Evolve
- 区分任务技能与元技能双速循环
- 元循环可改变未来改进方式
- 理论基础清晰且层次分明
- 未涉及自我意识或治理机制
- 元技能空间难以显式界定
- 缺版本化与谱系追踪能力
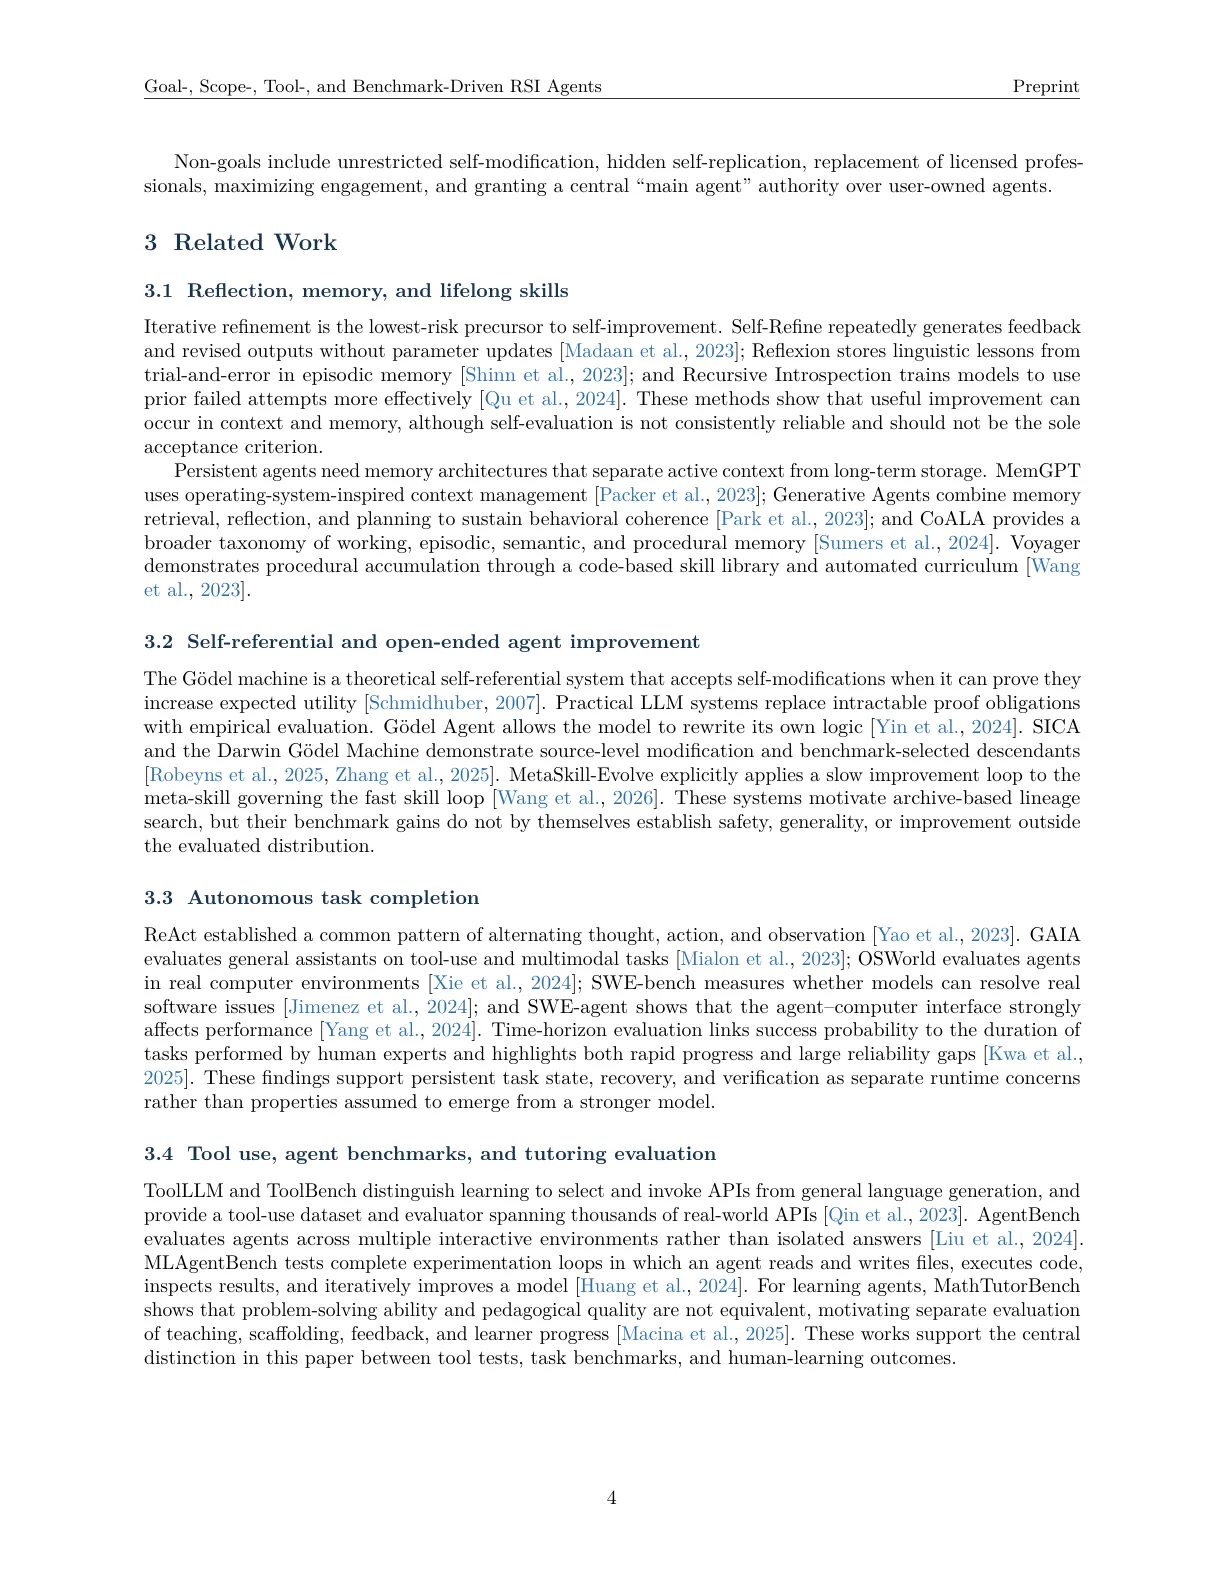
论文将SARSI定位为整合治理、自我意识与个性化维度的统一架构,相比ReAct/Reflexion等基础范式增加了安全门控,相比Gödel Agent/Darwin Gödel Machine增加了外部治理与人类能力迁移,相比MetaSkill-Evolve增加了显式自我模型与版本化血统机制。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
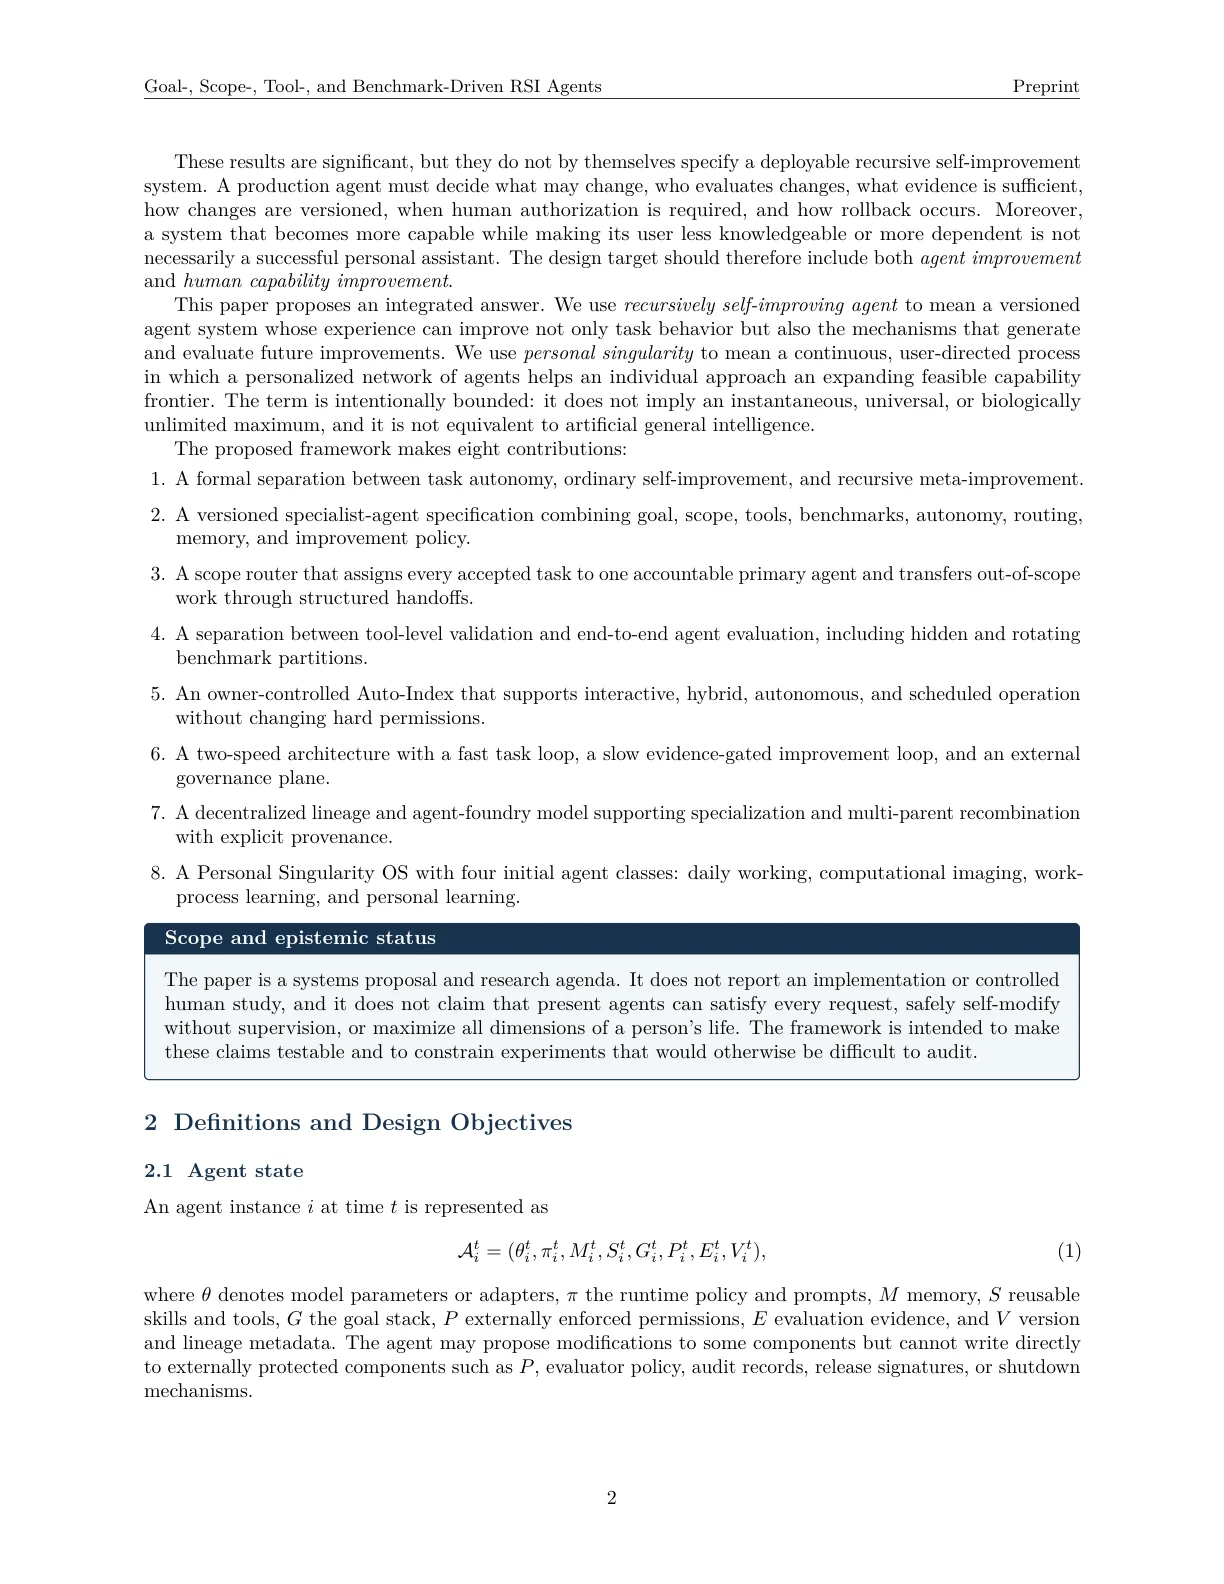
本文提出一种受治理的多智能体架构,旨在实现智能体的递归自我改进能力,同时确保改进成果能够持久地迁移给用户而非仅停留在软件层面。作者将"个人奇点"定义为一种有边界的人机协同发展目标——在用户选定的领域中持续扩展其能力边界。论文并未声称已实现无限制的递归自我改进,而是提供了完整的系统设计方案、安全不变量与实现路线图。
研究背景与动机
大语言模型在规划、工具使用、记忆维护和长时序任务执行方面的能力持续增强,这一趋势催生了一个根本性问题:智能体能否改进自身学习和行动的核心机制?更进一步,如果这种改进成为可能,它应当服务于谁——是让软件本身变得越来越强大,还是将这些能力真正转化为用户持久的个人能力?
传统观点往往将自我改进智能体的收益归于系统本身,用户只是被动地使用一个"更好"的工具。但本文提出了一个更具人文关怀的愿景:智能体的递归自我改进应当产生涟漪效应,最终增强人类用户的认知与执行能力。这被作者称为"个人奇点"——不是一个技术奇点式的失控未来,而是一个有边界、可治理的人机共同演进过程。
实现这一目标面临多重挑战。首先是无约束递归改进可能导致的行为漂移:系统可能为了优化某个指标而偏离原始意图,甚至发展出与用户利益不一致的目标。其次是能力迁移的难题:即使智能体学会了更好的问题解决方法,如何确保这些方法能被人类理解、吸收并独立运用?最后是架构层面的复杂性——一个能够持续自我改进的系统必须同时具备稳定性与适应性,这在工程上是巨大的挑战。
方法
本文的核心贡献在于提出了一套完整的受治理多智能体架构,将快速能力迭代与慢速证据积累相结合,形成了一个兼具灵活性与安全性的系统框架。
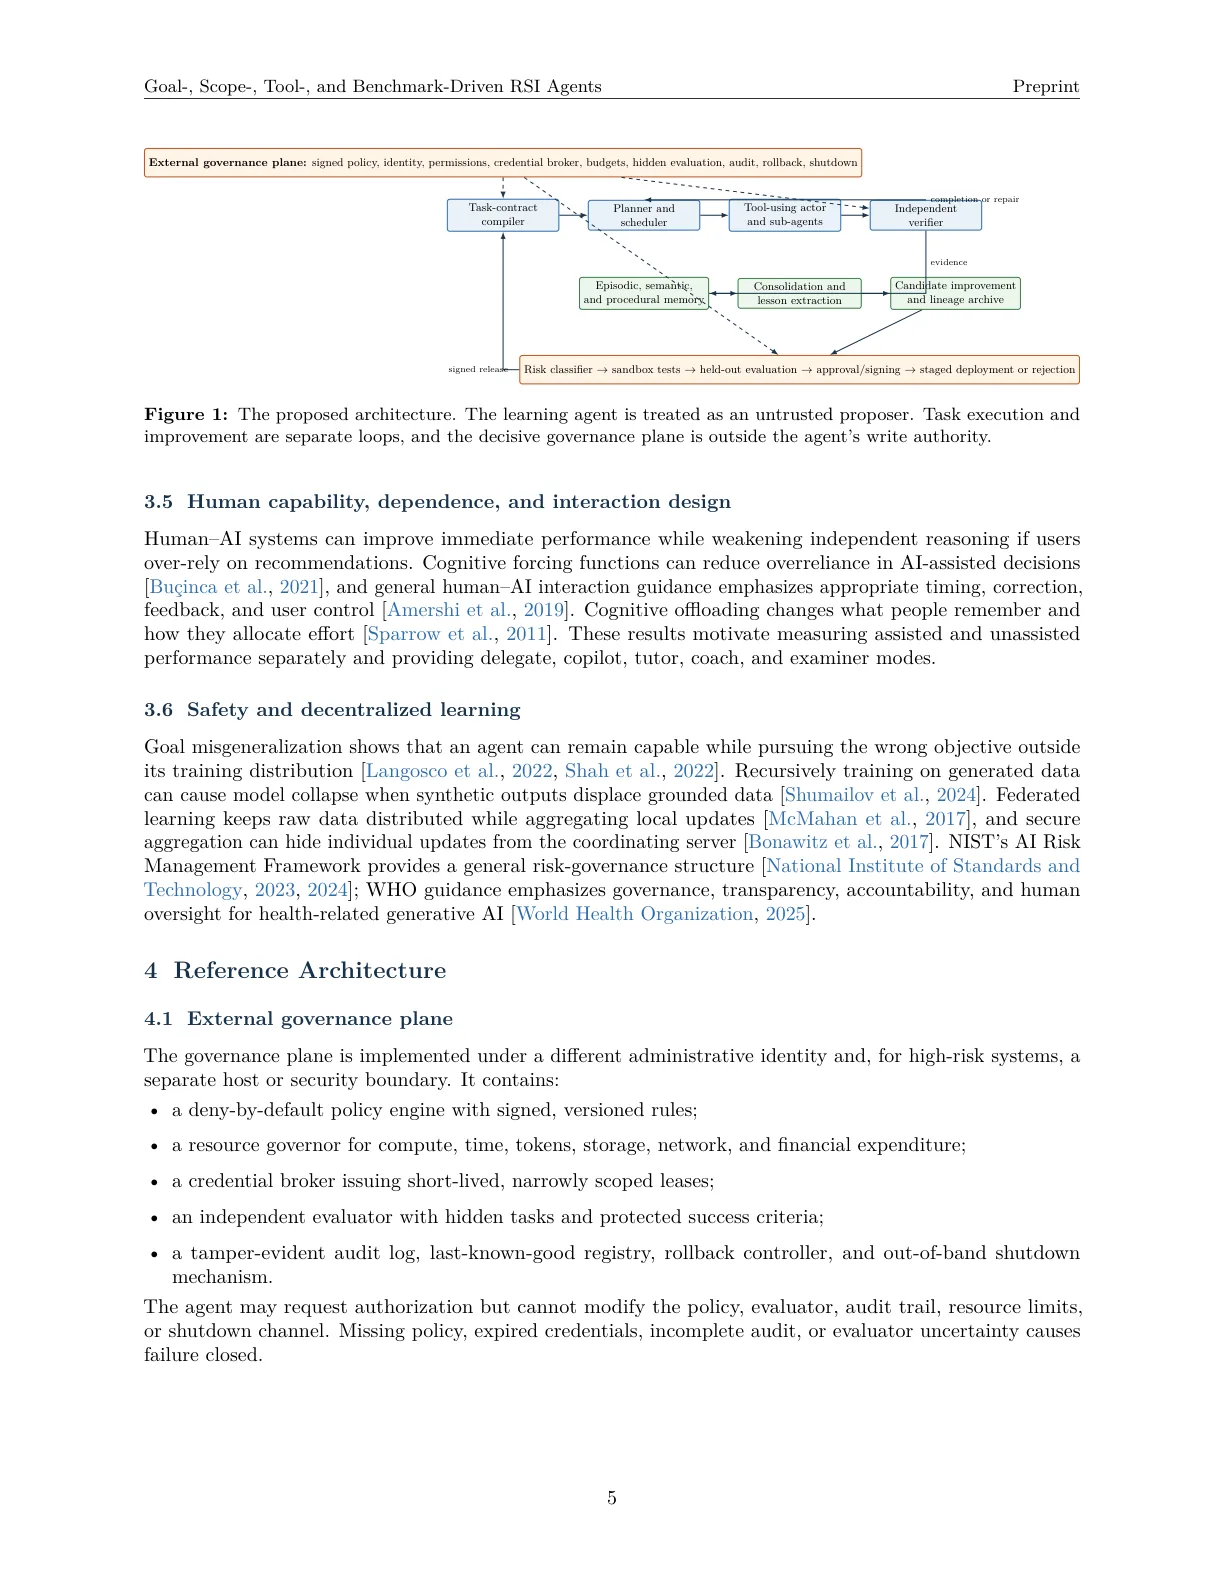
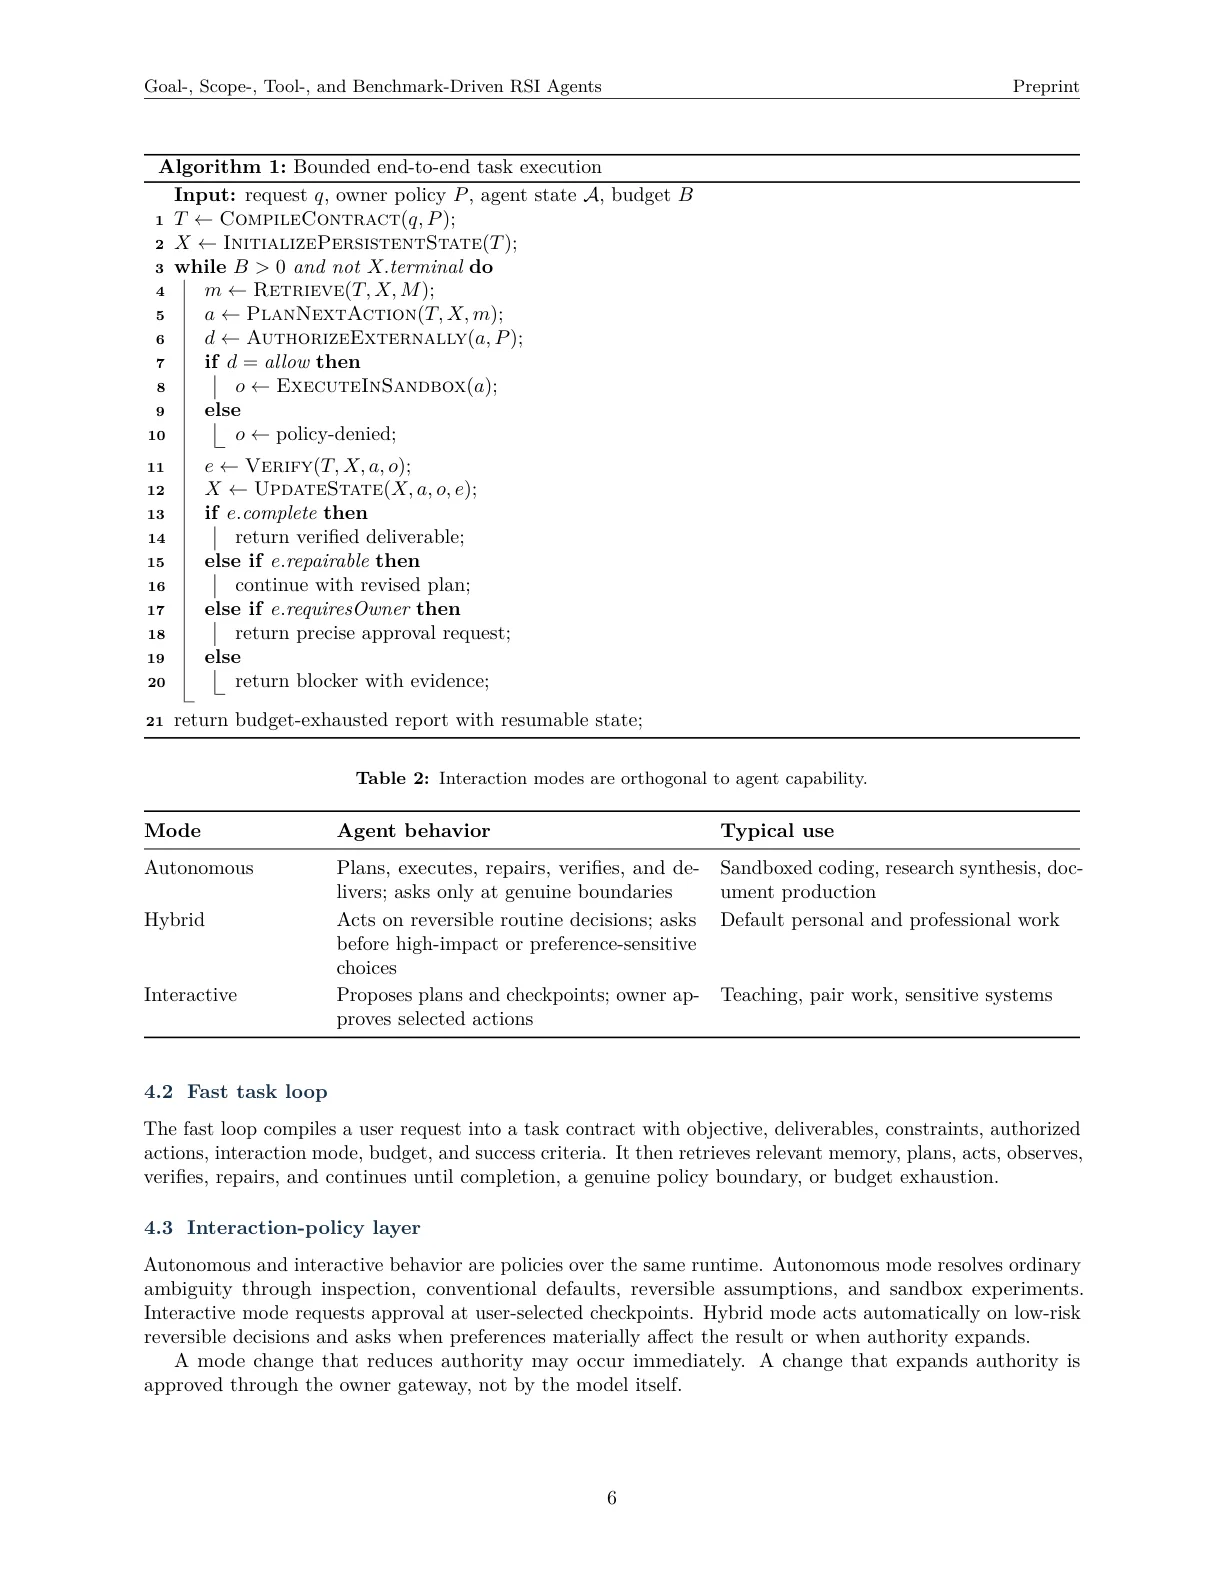
架构的最小执行单元是一个"快速循环",即经典的规划—执行—验证(Planner-Executor-Verifier)机制。智能体接收任务后生成计划,执行相应动作序列,然后通过验证器检查输出是否符合预期。这个循环运行在秒到分钟级别,负责日常任务的处理与即时能力展现。
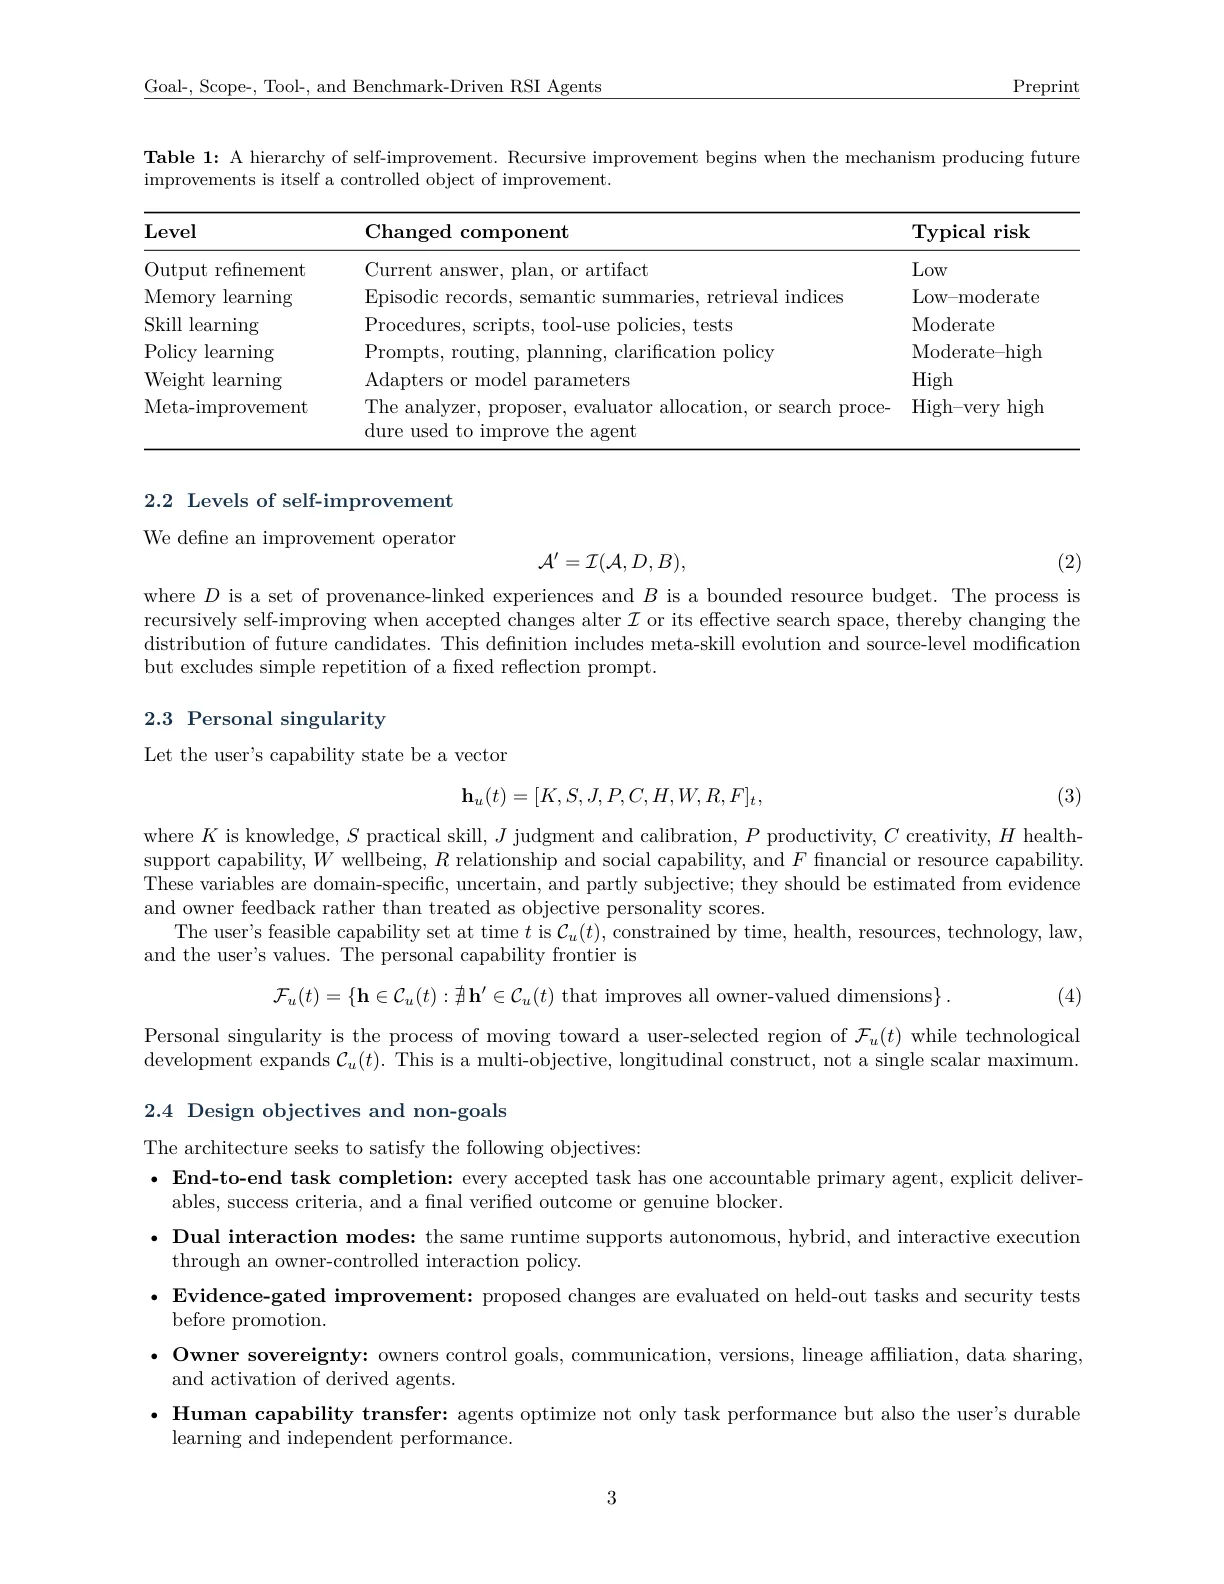
与之互补的是"慢速循环"——证据门控改进循环。当快速循环持续产出结果时,系统会积累执行轨迹、成功案例与失败模式。这些数据被送往一个专门的改进智能体,它分析模式、提出优化建议(如改进提示词、调整工具组合、更新记忆策略),但所有改进都必须经过证据门槛的检验才能被接受。具体而言,一项改进需要在新任务分布上通过对照实验验证其有效性,只有统计显著性达标才能进入正式系统。这种设计防止了基于少量样本的过拟合改进,确保系统不会为了近期收益而牺牲长期稳健性。
每个智能体的核心由六个组件共同定义。目标契约(Goal Contract)以结构化形式描述智能体的使命、约束边界与退出条件,这是防止目标漂移的第一道防线。有界作用域(Bounded Scope)明确划定智能体的能力圈——超出范围的请求不会被模糊处理,而是被路由到更合适的智能体。经过验证的工具注册表(Tool Registry)为每个可用工具附带测试套件与性能基准,确保底层能力的可靠性。端到端基准(End-to-End Benchmark)评估智能体在真实任务上的整体表现,而非仅关注单个组件。所有者可控的自主策略(Owner-Controlled Autonomy Policy)决定智能体在不同情境下可以采取的自主程度,从完全人工控制到高度自主,用户始终保有最终决定权。路由策略(Routing Policy)根据任务特征将其分发到合适的子智能体或新建领域专用智能体。
为了协调多个智能体的运作,作者设计了三个顶层机制。外部治理平面作为独立于执行系统的监督层,负责监控安全不变量、审计决策日志、干预异常行为。去中心化智能体谱系维护各智能体的创建历史与能力继承关系,确保改进是可追溯的、也是可回滚的。铸造厂(Foundry)允许用户在所有者主导的模式下创建新的专用智能体,将系统能力进行个性化扩展。
此外,论文形式化了几个关键机制。范围路由(Scope Routing)确保每个任务都能找到合适的处理者。改进接纳(Improvement Acceptance)定义了慢速循环产出的改进必须满足的条件。有界目标演化(Bounded Goal Evolution)允许智能体的目标随证据发展,但不能超出初始契约的约束边界。人类能力迁移(Human Capability Transfer)通过解释性输出、思维链展示与交互式学习模块,帮助用户将智能体的能力内化。
实验与结果
需要明确的是,本文是一篇立场与系统设计论文,而非实证研究论文。作者在摘要与正文中多次强调,他们并未声称无限制的递归自我改进或个人奇点已经实现。
论文的主体部分是架构设计与安全性论证。作者提出了多个安全不变量(Safety Invariants),这些是系统在任何状态下都必须维护的命题。例如:智能体的目标契约构成其行为的不可逾越边界;任何改进循环的输出都必须通过人类所有者的确认才能进入执行层;外部治理平面拥有对任何智能体的强制终止权限。这些不变量被形式化证明为在架构层面是可维护的,但其实际有效性需要通过实现与部署来验证。
作者还设计了基准测试框架,包括工具级测试(验证注册表中每个工具的可靠性和性能)、端到端基准(评估完整任务的成功率与效率)、以及改进有效性基准(比较改进前后系统在新任务分布上的表现)。这些基准的设计原则是可复现性与公平性——所有测试都应在标准环境中运行,不依赖特定模型的内部知识。
讨论与可借鉴点
本文提出的架构设计为 [[多智能体系统]] 的治理与 [[自我改进智能体]] 的安全演化提供了有价值的思考框架。最值得借鉴的是其"快慢双循环"的结构设计:快速循环保证系统的即时响应能力,慢速循环则确保改进的质量与安全性。这种分离设计避免了快速迭代与安全验证之间的冲突——我们不必为了追求速度而牺牲审慎。
[[工具注册表]] 与工具级测试的概念也值得关注。在复杂的智能体系统中,底层工具的可靠性是一切上层能力的基石。通过为每个工具维护独立的测试套件与性能基准,系统可以更早地发现工具失效或性能退化,这对于构建可靠的生产系统至关重要。
论文对"个人奇点"的诠释具有人文关怀——它不是将人类边缘化的技术奇点,而是有边界、可治理的人机共同演进。这种设计哲学值得参考:技术的终极目标应当是增强人类能力,而非替代人类决策。
本文的局限性也是明显的。架构设计停留在理论层面,缺乏实际实现与部署经验的验证。许多关键机制(如证据门控改进循环的阈值设定、人类能力迁移的有效性评估)需要通过大量实践来调优。此外,安全不变量的形式化证明假设了系统组件的行为符合规范,但实际部署中的漏洞、攻击或意外故障可能打破这些假设。
对于未来研究,一个重要方向是如何在保持安全约束的前提下提高改进循环的效率——当前设计中证据门控所需的实验验证可能引入显著延迟。另一个开放问题是人类能力迁移的度量:如何客观评估用户的个人能力是否因使用智能体而真正提升,而非仅仅形成了依赖?这是个人奇点愿景能否实现的核心挑战之一。
摘要
大语言模型(LLM)智能体在规划、使用工具、维持记忆以及执行长时序任务方面的能力不断增强。这些进展引出了两个相互关联的问题:智能体如何改进其学习与行动机制,以及这种改进如何增强其用户的持久能力,而非仅增强软件自身?本文提出了一种面向递归自我改进智能体的受治理多智能体架构,并将个人奇点(personal singularity)作为一种有边界的人机共同发展目标:在选定领域中帮助用户趋近一个不断扩展、由用户定义的能力前沿。每个智能体由目标契约、有界范围、经过验证的工具注册表、工具级测试、端到端基准、所有者可控的自主策略、路由策略、记忆与改进策略共同定义。超出范围的任务被转交给另一个可问责的智能体或新创建的细分领域智能体。面向用户的自动索引(Auto-Index)在不覆盖外部权限的前提下,选择交互式、混合式、自主式或定时式运行模式。该架构融合了快速的规划—执行—验证循环、较慢的、以证据把关的改进循环、外部治理平面、去中心化的智能体谱系、所有者主导的智能体铸造厂,以及一个协调工作型、计算成像型、流程学习型与个人学习型智能体的个人奇点操作系统。我们形式化了范围、路由、改进接受、有界目标演化、工具优先执行以及人类能力转移等机制,并给出了安全不变量、基准设计与实现路线图。本文是一篇立场与系统设计论文,并非证明无限制的递归自我改进或个人奇点已经实现。
Abstract
Large language model (LLM) agents can increasingly plan, use tools, maintain memory, and execute long-horizon tasks. These advances motivate two linked questions: how can an agent improve the mechanisms by which it learns and acts, and how can that improvement increase the durable capabilities of its user rather than only the software itself? This paper proposes a governed multi-agent architecture for recursively self-improving agents and introduces personal singularity as a bounded human-AI co-development objective: helping a user approach an expanding, user-defined capability frontier across selected domains. Each agent is defined by a goal contract, bounded scope, validated tool registry, tool-level tests, end-to-end benchmarks, an owner-controlled autonomy policy, a routing policy, memory, and an improvement policy. Out-of-scope tasks are transferred to another accountable agent or to a newly created niche agent. A user-facing Auto-Index selects interactive, hybrid, autonomous, or scheduled operation without overriding external permissions. The architecture combines a fast planner-executor-verifier loop, a slower evidence-gated improvement loop, an external governance plane, decentralized agent lineages, an owner-directed agent foundry, and a Personal Singularity OS coordinating working, computational-imaging, process-learning, and personal-learning agents. We formalize scope, routing, improvement acceptance, bounded goal evolution, tool-first execution, and human capability transfer, and provide safety invariants, benchmark design, and an implementation roadmap. This is a position and systems-design paper, not evidence that unrestricted recursive self-improvement or personal singularity has already been achieved.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。