
ARMOR:用离线策略锚定样本稳定在线LLM强化学习
ARMOR: Stabilizing On-Policy LLM RL with Off-Policy Anchor Samples
📝 TLDR
ARMOR通过引入离线策略锚定样本来稳定LLM的在线策略强化学习训练过程。
🧭 速览
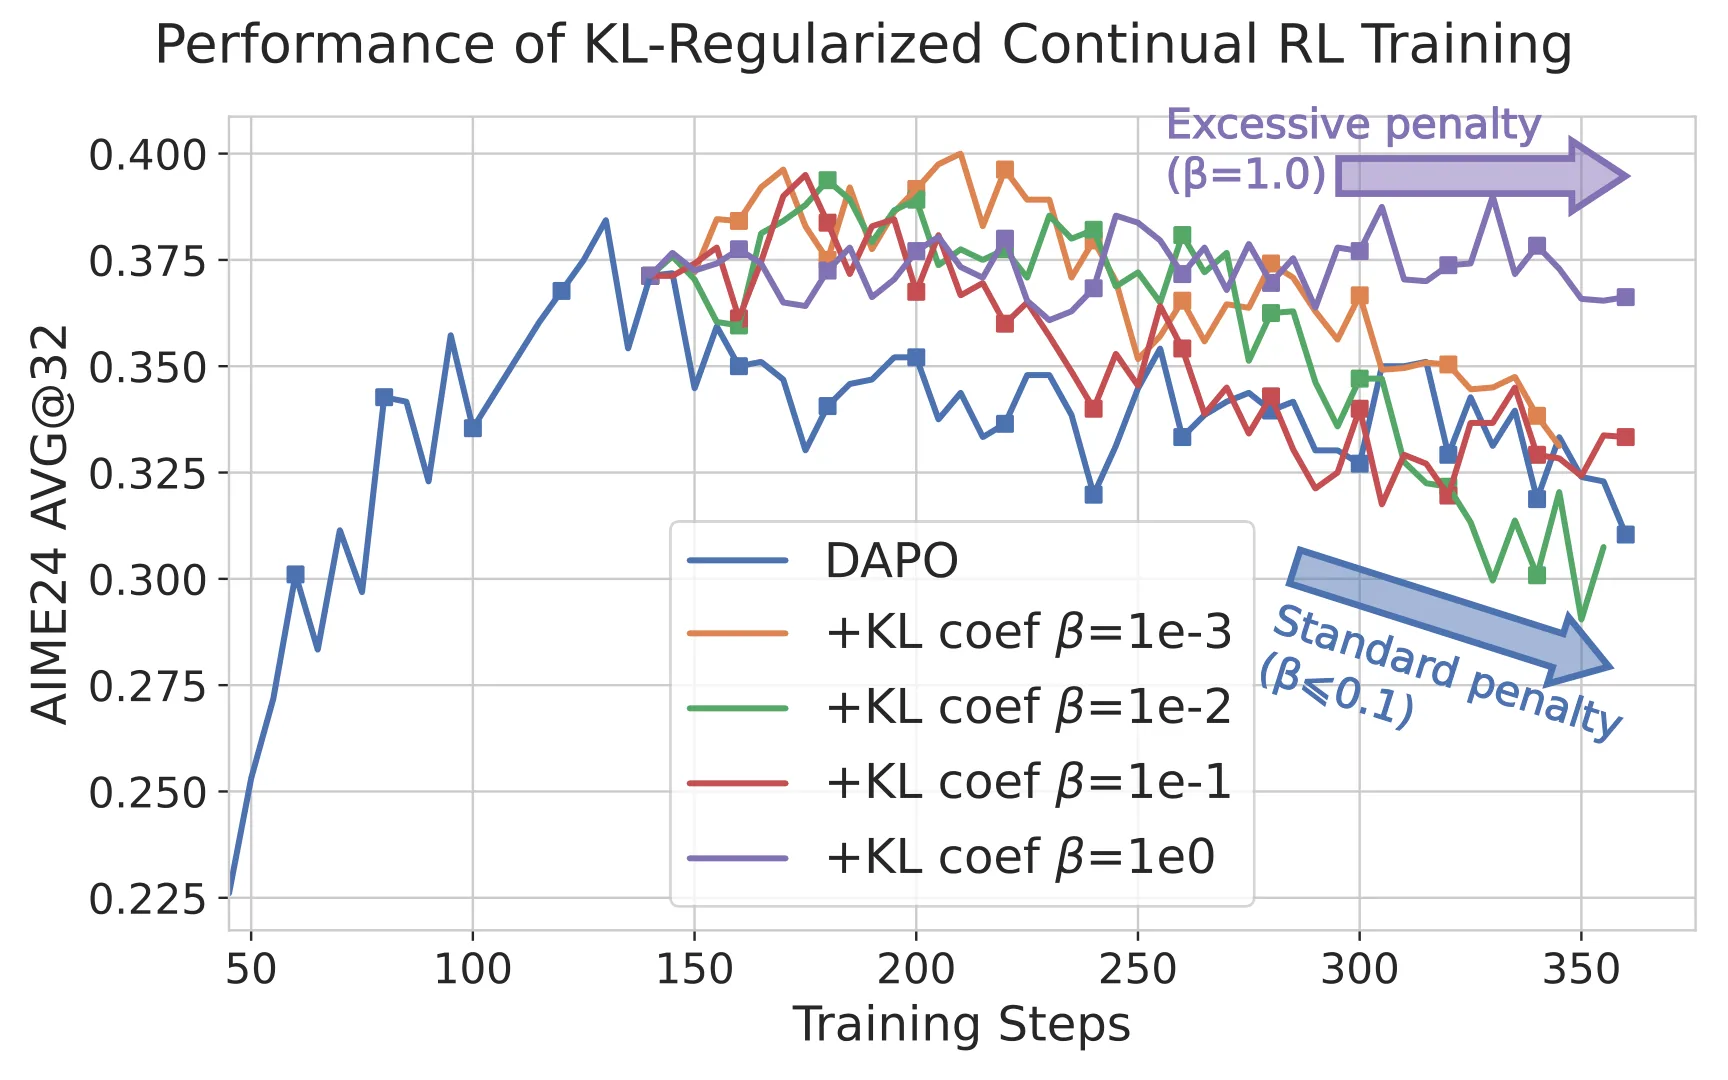
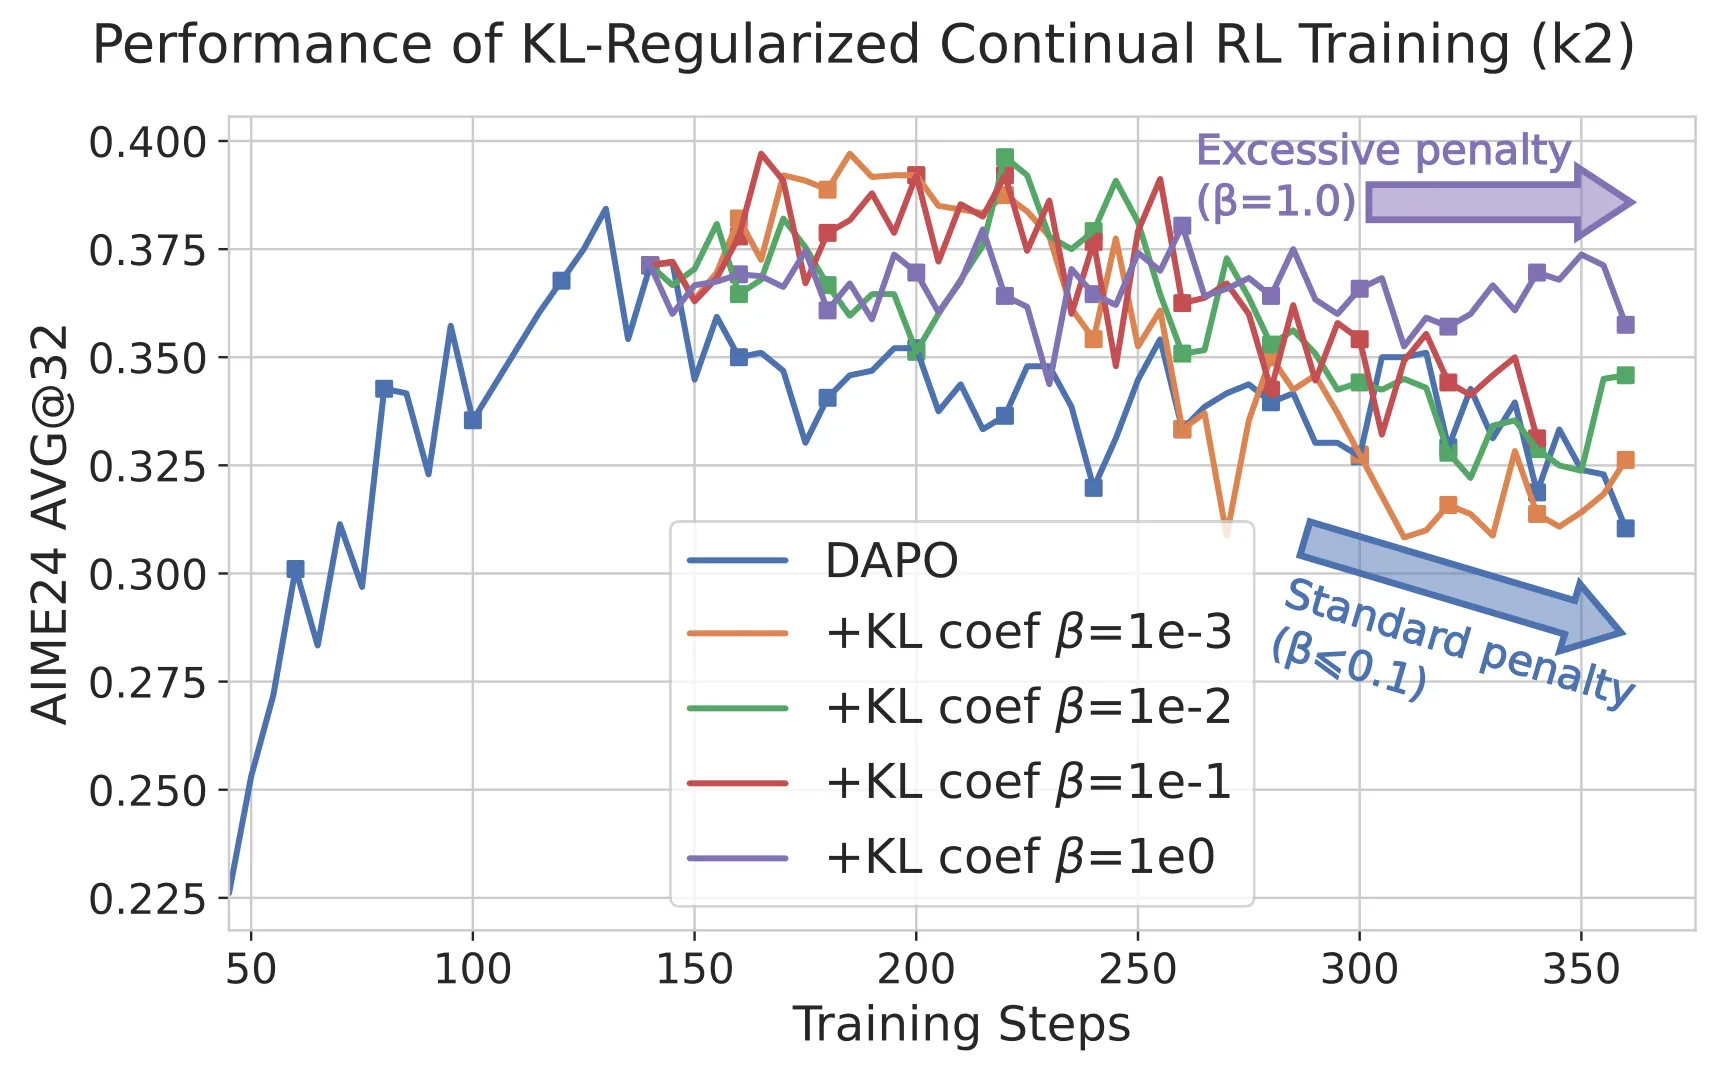
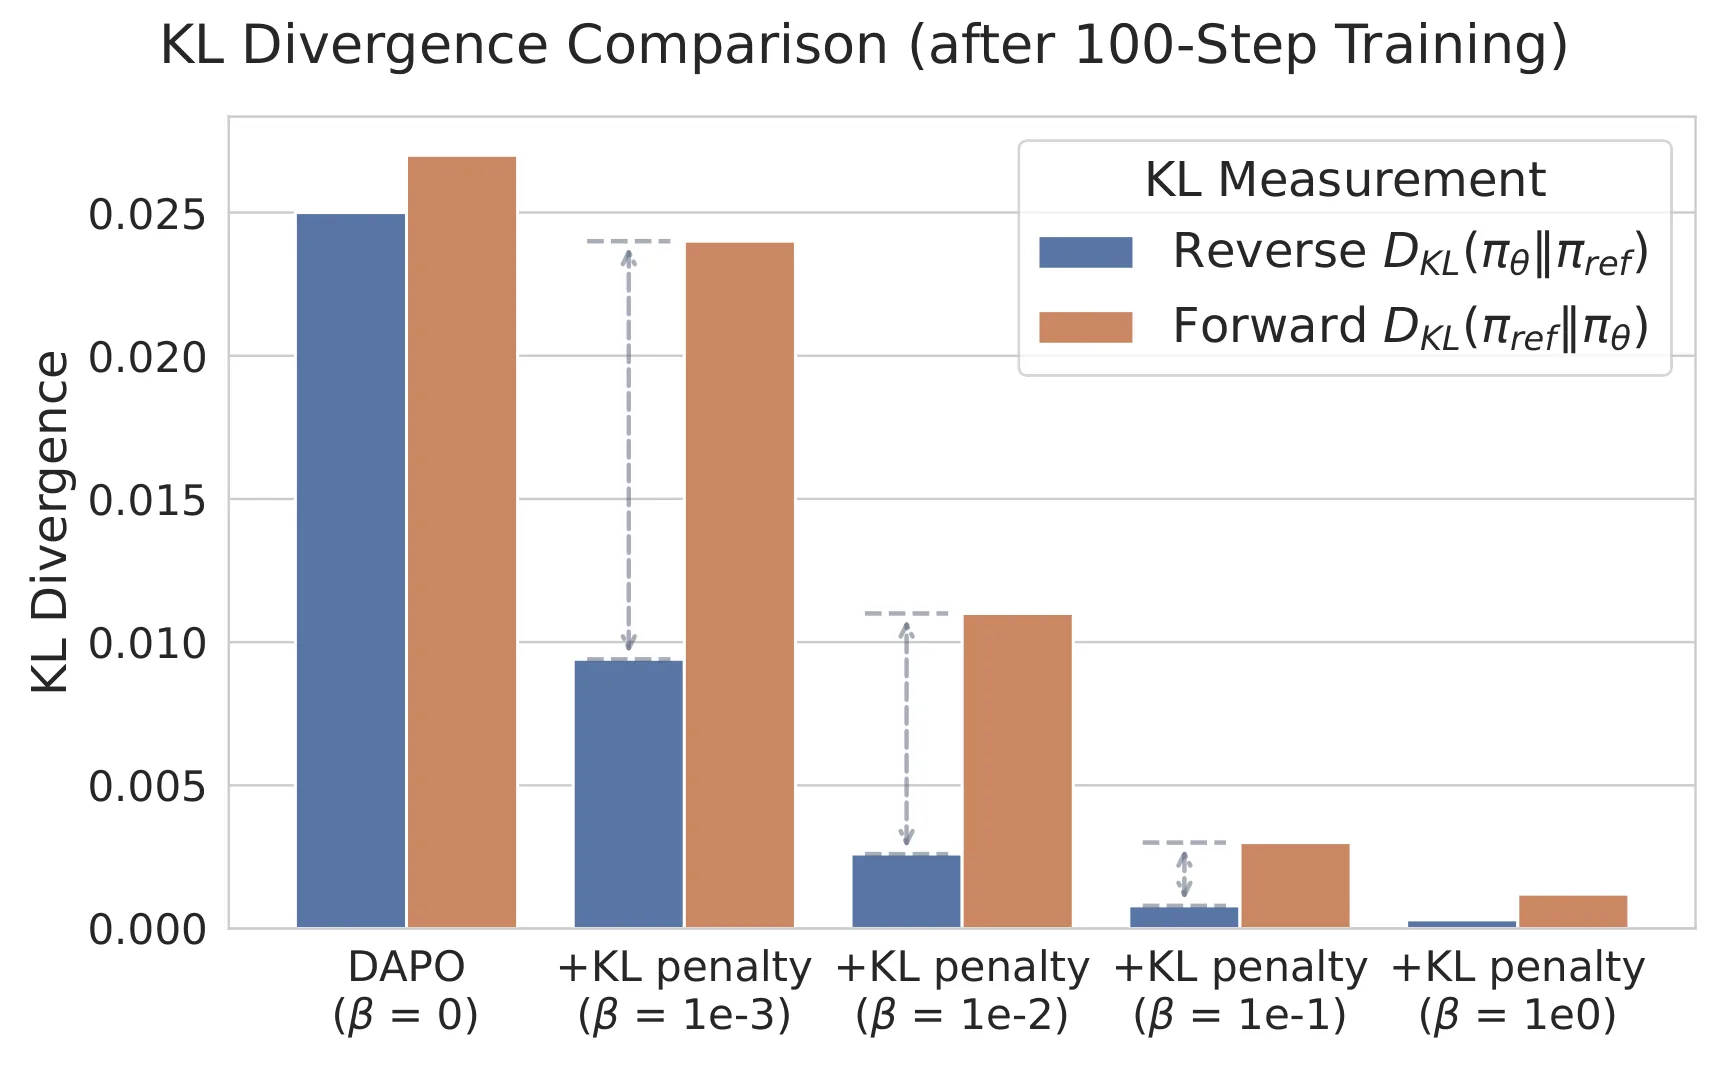
强化学习提升 LLM 推理能力但训练脆弱,过优化使模型迎合启发式而非学习推理,反向 KL 难以完整覆盖参考分布。
ARMOR 包含锚点采样与混合优化:前者利用参考策略的离策略数据保留既定解题模式,后者重构策略目标实现受控探索,无需辅助损失。
在多个推理基准测试中,ARMOR 显著缓解验证崩溃,长周期训练下性能持续提升。
提出由被动惩罚转为主动样本稳定的新范式,为长程 LLM 强化学习训练提供更稳健的解决方案。
🆚 方法对比
ARMOR
- 有效缓解验证崩溃,桥接泛化差距
- 在Qwen2.5-Math-7B等模型上持续性能提升
- 兼容多种RL算法(DAPO、QAE)
- 从被动惩罚转为主动样本稳定
- 依赖参考策略的离线数据,增加计算开销
- 两组件组合增加框架复杂度
- 混合权重α需额外调参
Anchor Rollout
- 主动注入参考策略样本保留解模式
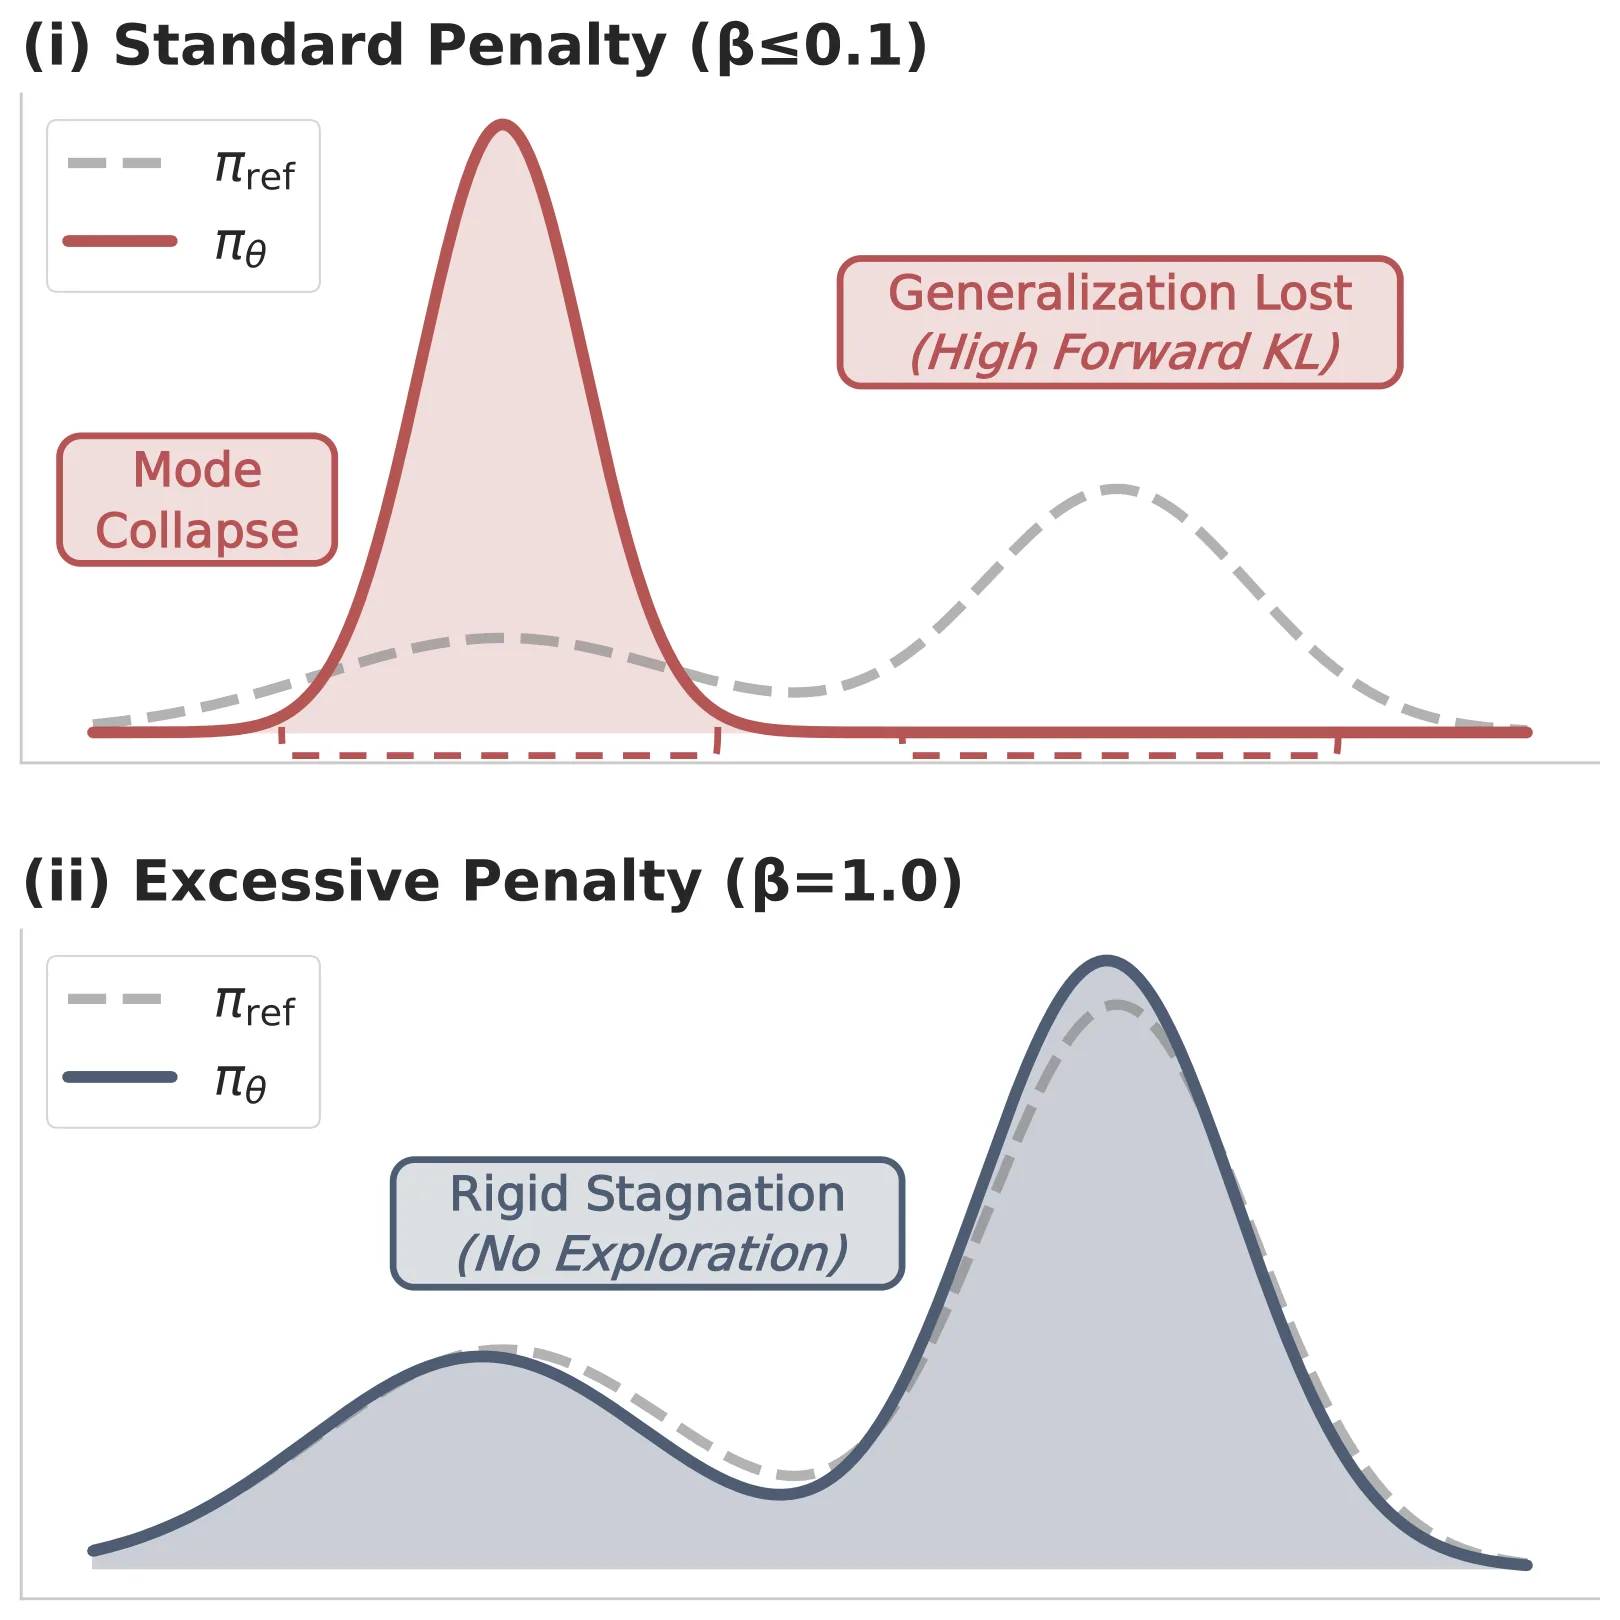
- 解决模式坍缩,维持分布多样性
- 显式锚定可泛化解路径
- 需要额外维护参考策略
- 增加rollout阶段的计算负担
Mixed Optimization
- 无需辅助损失即可控探索
- 构建自适应信任区域
- 优化目标和数据分布原则性对齐
- 混合比α引入超参数敏感
- 收敛速度可能受影响
反向KL正则化
- 标准化的防过优化方法
- 广泛使用、理论成熟
- 模式寻的性导致分布坍缩
- 均匀惩罚抑制探索引发停滞
- 无法保证参考分布全覆盖
GRPO
- 移除独立Critic提升训练效率
- 组内相对优势估计简洁
- 在长训练中仍出现过优化
- 验证性能与训练奖励解耦
DAPO
- Token级损失聚合更精细
- clip-higher双clip范围机制
- 在GRPO基础上进一步优化
- 仍存在训练奖励升但验证降的崩溃
- 未根本解决过优化问题
PPO
- 经典的Actor-Critic框架稳定
- clip机制保证更新步长
- 需独立Critic模型计算开销大
- 未直接讨论LLM推理场景
ARMOR针对反向KL正则化的模式坍缩与均匀惩罚两大缺陷,分别用Anchor Rollout主动注入参考样本保持多样性、Mixed Optimization构建自适应信任区域促进探索,在DAPO/GRPO等基RL算法上实现验证性能的持续提升。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
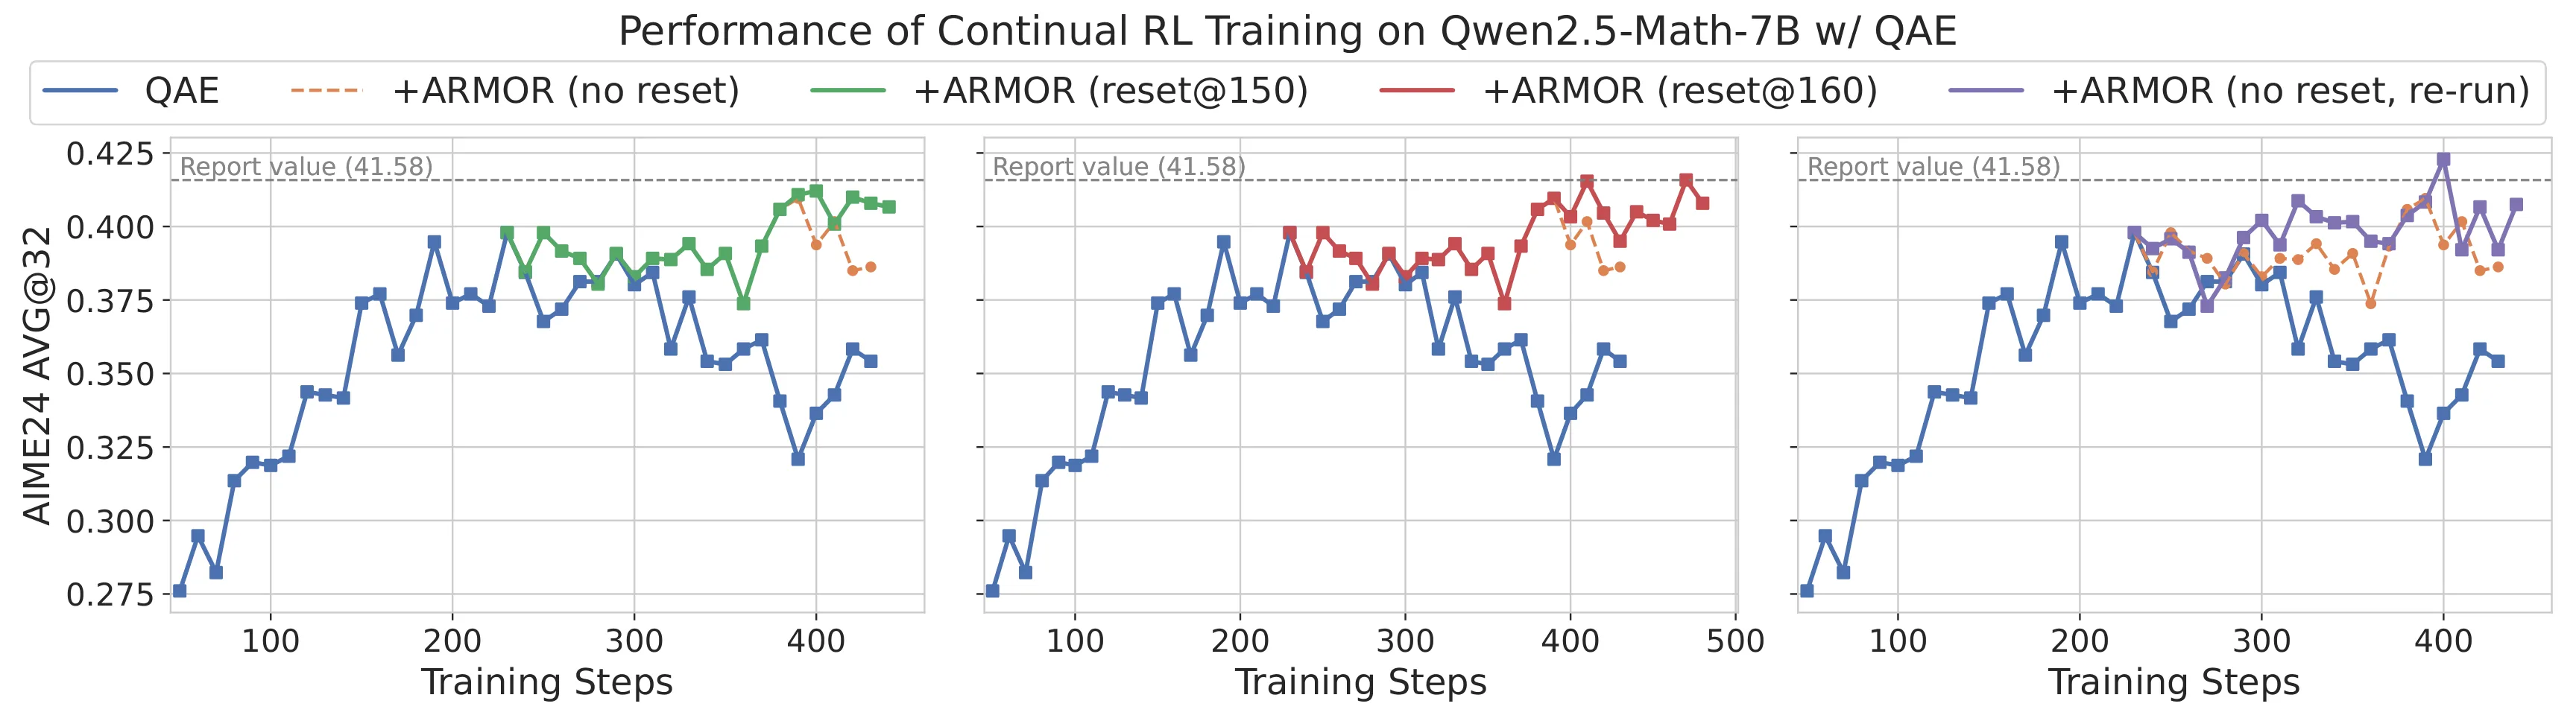
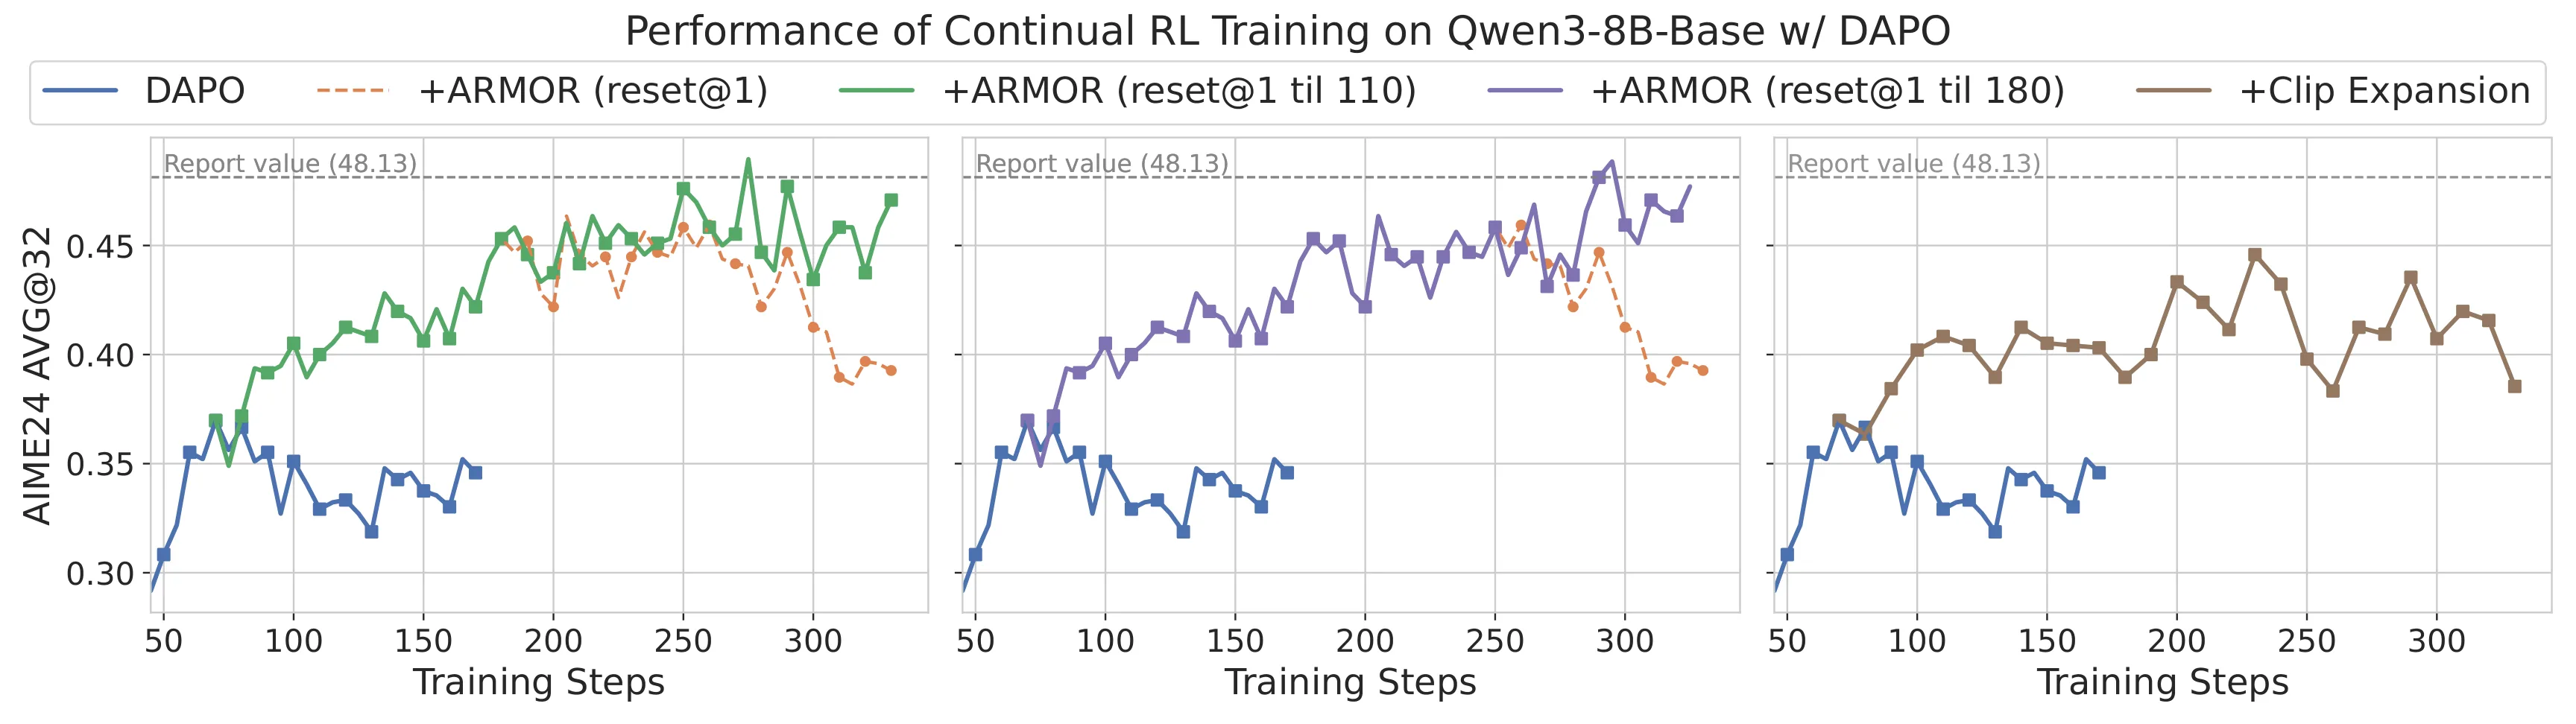
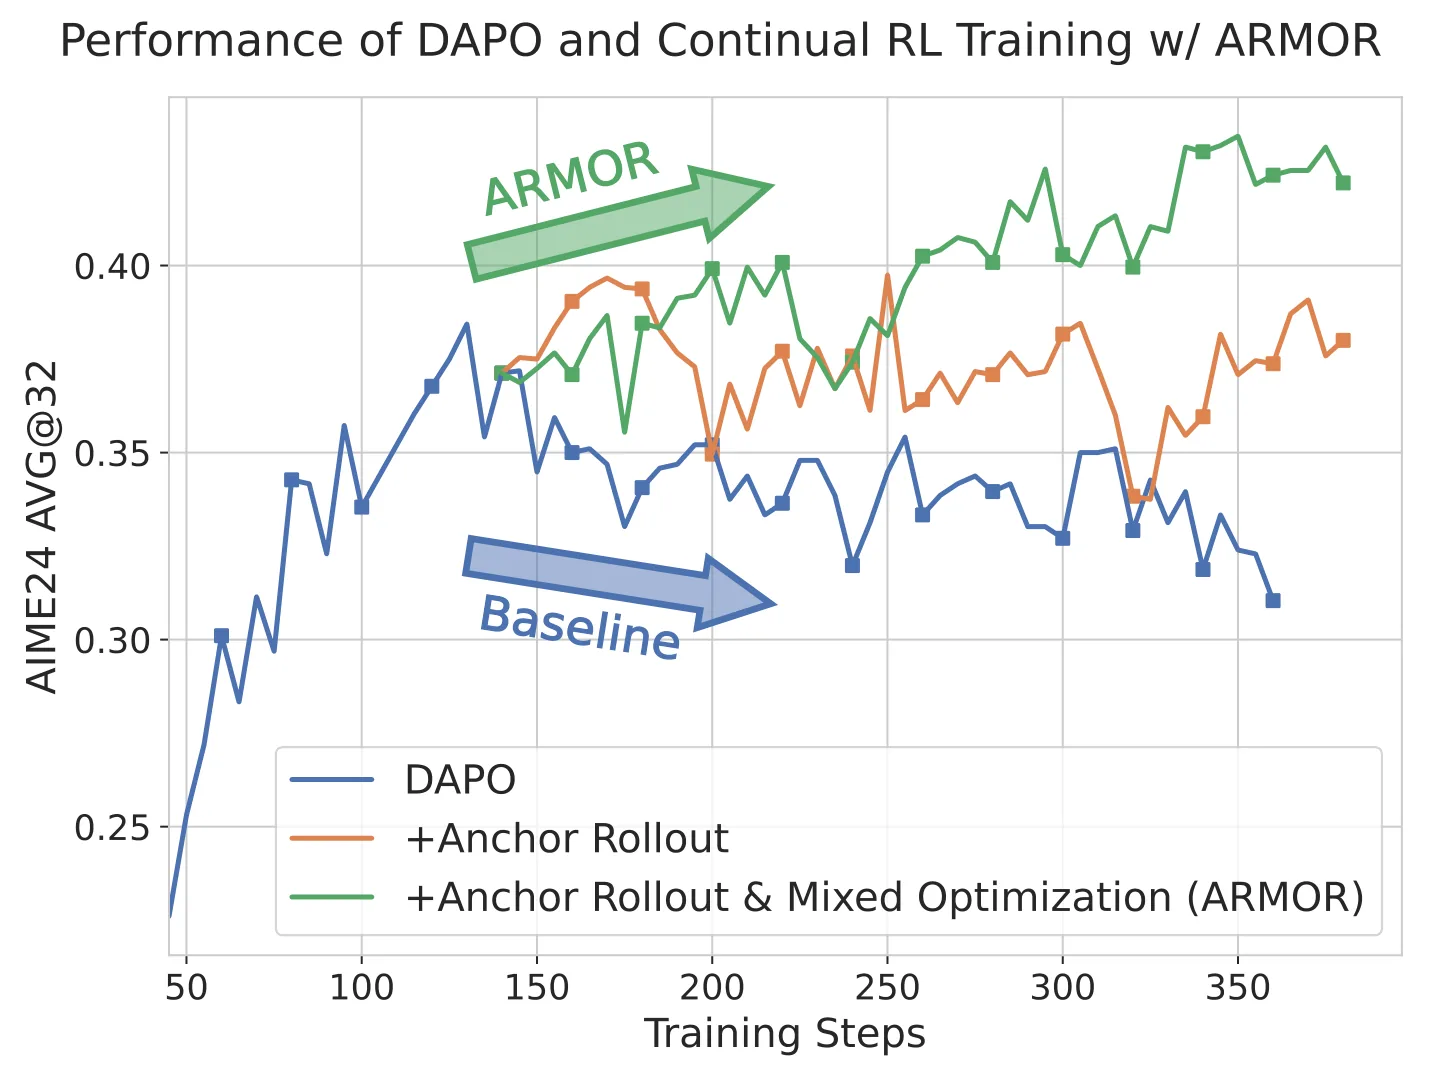
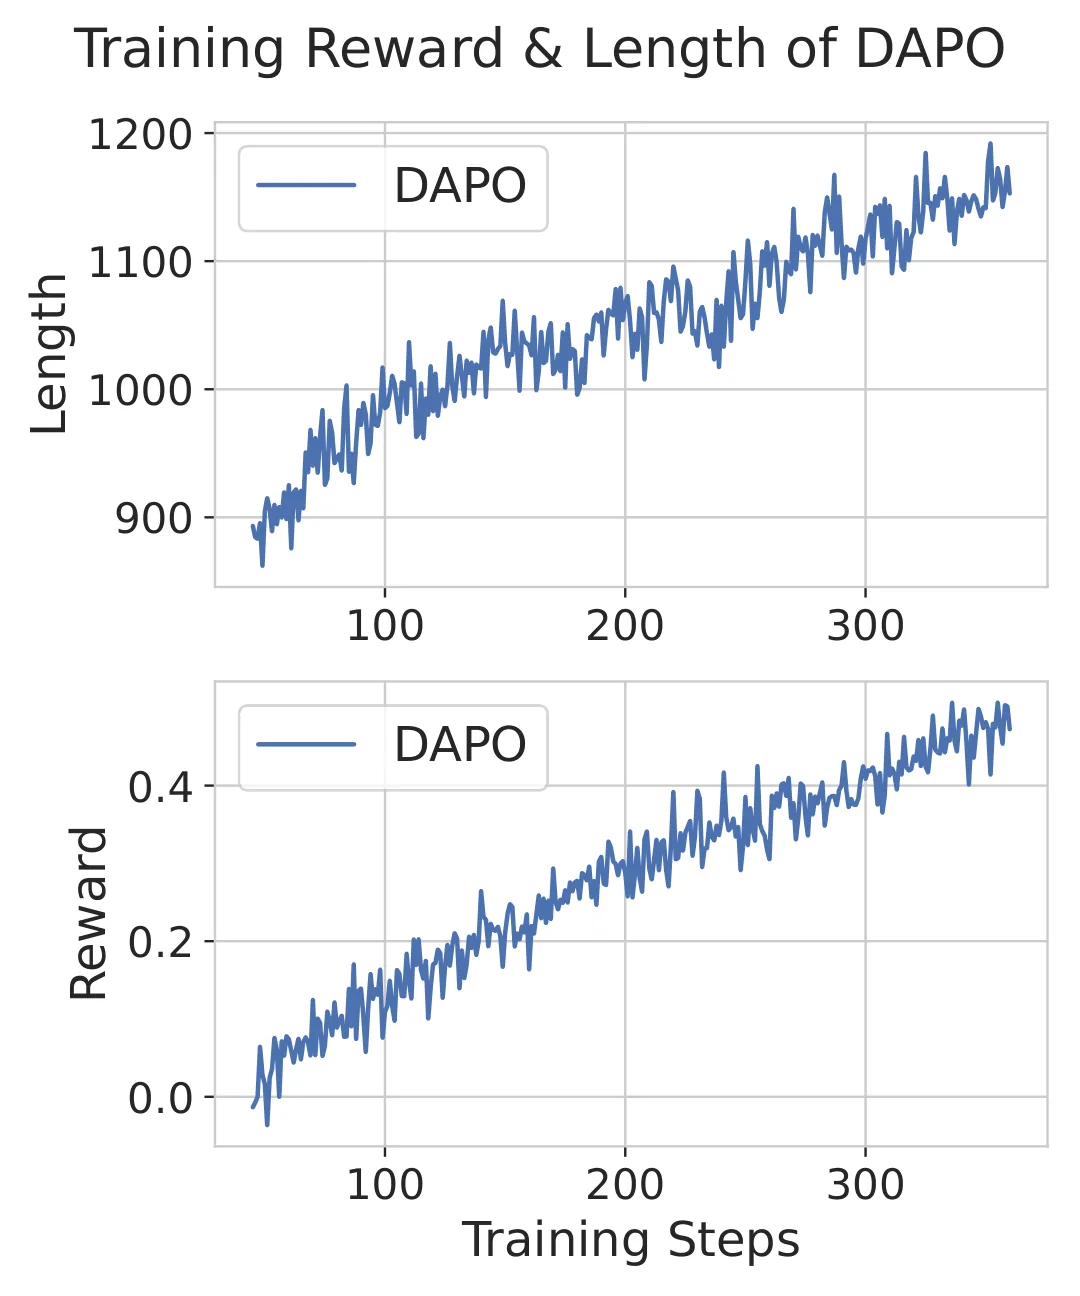
TL;DR
ARMOR 针对大语言模型强化学习训练过程中的不稳定问题,提出通过锚点采样保留离线策略数据中的参考模式,并结合混合优化重构策略目标来实现受控探索。实验表明,该方法在多个推理基准上有效缓解了验证集性能崩塌,使模型能够在更长的训练周期内保持持续的性能提升。
研究背景与动机
强化学习已成为提升大语言模型推理能力的关键技术,从数学证明到代码生成,RLHF 等方法让模型的输出质量产生了质的飞跃。然而,这套训练范式的脆弱性一直是领域的痛点——训练过程中极易出现性能剧烈波动,甚至在验证集上持续崩塌,导致研究者不得不反复调整超参数、在极短的时间窗口内中止训练。
这篇论文深入剖析了这种不稳定性的根源:过度优化(over-optimization)。在 RL 训练中,模型会不可避免地接触到训练数据中的各种启发式信号——某些回答模式在奖励信号上表现突出,却并非真正可靠的解题策略。当模型过度拟合这些表面特征时,它实际上是在“作弊”,而非学习可泛化的推理能力。这种现象在神经网络训练中并不罕见,但在 LLM 的 RL 场景下尤为棘手,因为语言输出的高维离散空间使得模型更容易找到绕过真实目标的捷径。
面对这一问题,业界的标准防御手段是 [[反向 KL 正则化]]——通过约束当前策略与参考策略(通常是 SFT 阶段得到的模型)的 KL 散度,防止策略偏离太远。然而论文的分析揭示了一个关键洞见:在过度优化的 regime 下,反向 KL 正则化往往力不从心。它的作用机制是惩罚偏离参考分布的过大跃迁,但这无法保证对参考分布的全面覆盖——模型可能只在参考分布的局部区域内优化,而忽略其他同样有效的解题路径,最终导致策略分布的退化。
方法
ARMOR 的核心思路是从被动惩罚转向主动样本稳定化。传统方法试图通过正则化项约束模型行为,而 ARMOR 选择主动注入稳健的参考信息,引导优化过程更健康地进行。这一范式转换通过两个协同工作的组件实现。
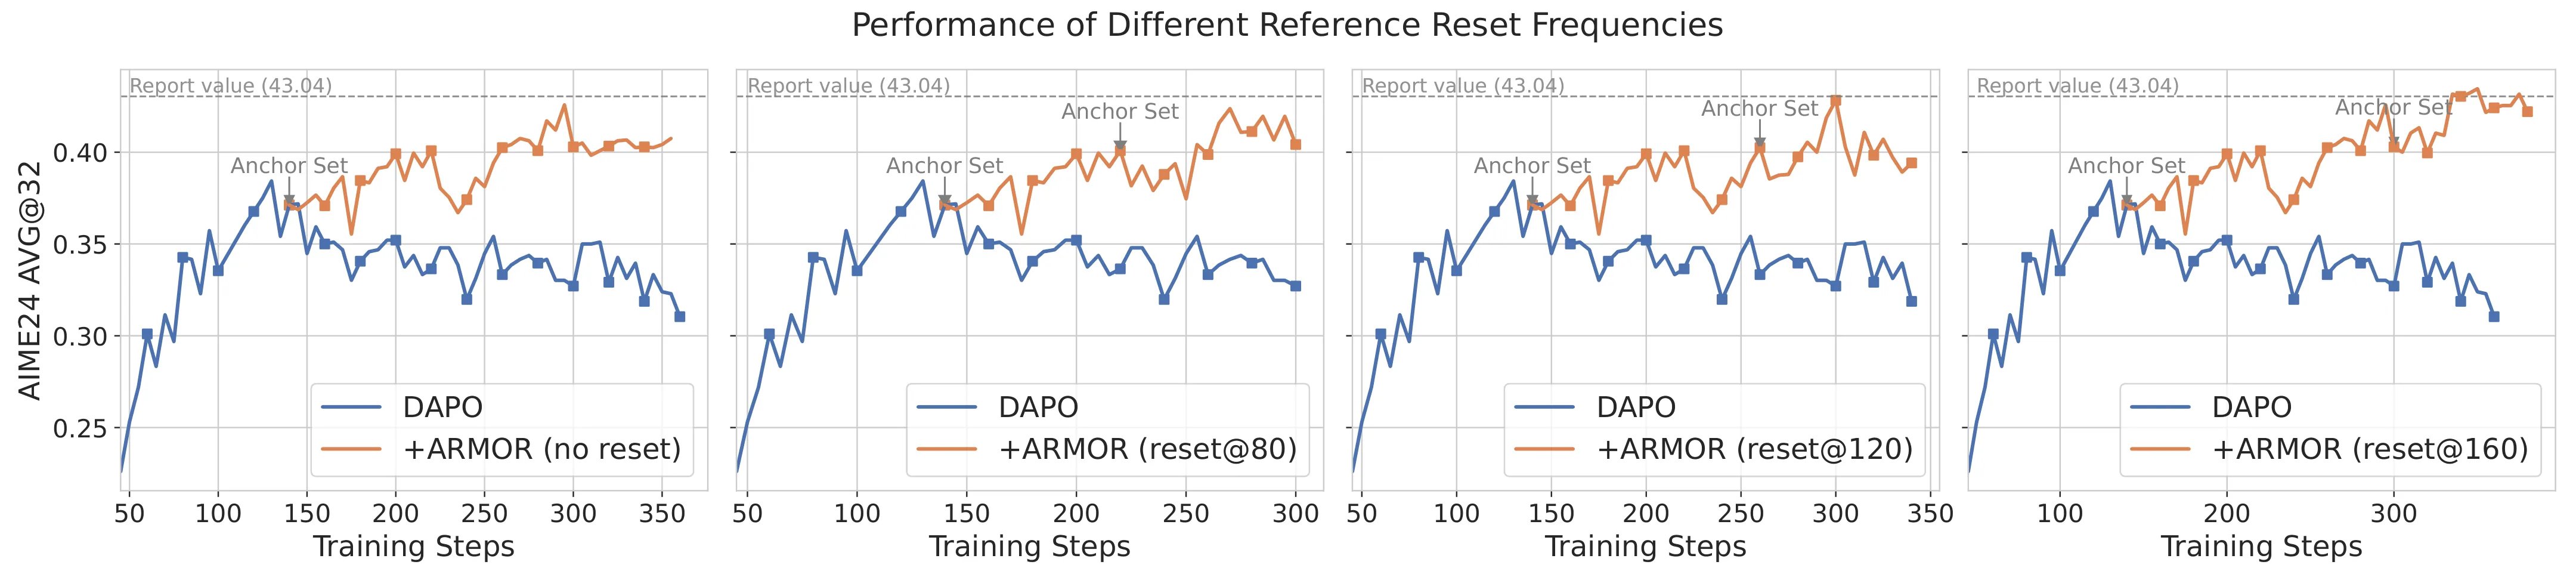
锚点采样(Anchor Rollout)是第一个组件,它利用来自参考策略的 [[离线策略数据]] 保留已建立的解题模式。具体而言,在每个训练 step,ARMOR 不仅生成当前策略的新轨迹,还会采样一部分来自参考策略的旧轨迹混入训练数据。这些锚点轨迹扮演着“锚”的角色——它们代表着人类标注或早期训练阶段验证过的可靠解法模式。通过持续将这些高质量样本注入训练集,模型在优化过程中始终有机会“看到”正确答案的结构,而非完全被即时奖励信号牵着走。直觉上,这相当于在探索新策略的同时,不忘回头参照“老师”的示范,确保不走偏。
混合优化(Mixed Optimization)是第二个组件,它重新构建了 [[策略优化]] 的目标函数。传统方法通常依赖辅助损失项(如 KL 惩罚)来实现正则化,而混合优化将这些约束直接融入策略目标的核心结构中。论文将策略更新表述为一个混合目标:让模型同时最大化来自当前策略和锚点采样的加权期望回报,其中锚点采样的权重动态调整——在训练初期较高以维持稳定性,随着策略逐渐成熟而适度降低,从而允许更多探索。这种设计避免了对额外正则化项的依赖,让优化过程更加自洽。
两个组件的配合体现了论文的核心洞察:过度优化本质上是训练信号过于单一的副产品。当模型只看到自己生成的样本时,它容易陷入自我强化的循环,错误模式一旦出现就会被反复放大。锚点采样打破了这一闭环,而混合优化则在目标层面确保这种外部信号被有效整合而非简单叠加。
实验与结果
论文在多个主流推理基准上验证了 ARMOR 的有效性,包括数学推理(GSM8K、MATH)、代码生成(HumanEval)以及逻辑推理任务。实验设置采用在线 RL 训练流程,以 GRPO 或 PPO 作为基线方法,逐步增加训练步数,观察验证集性能随时间的变化曲线。
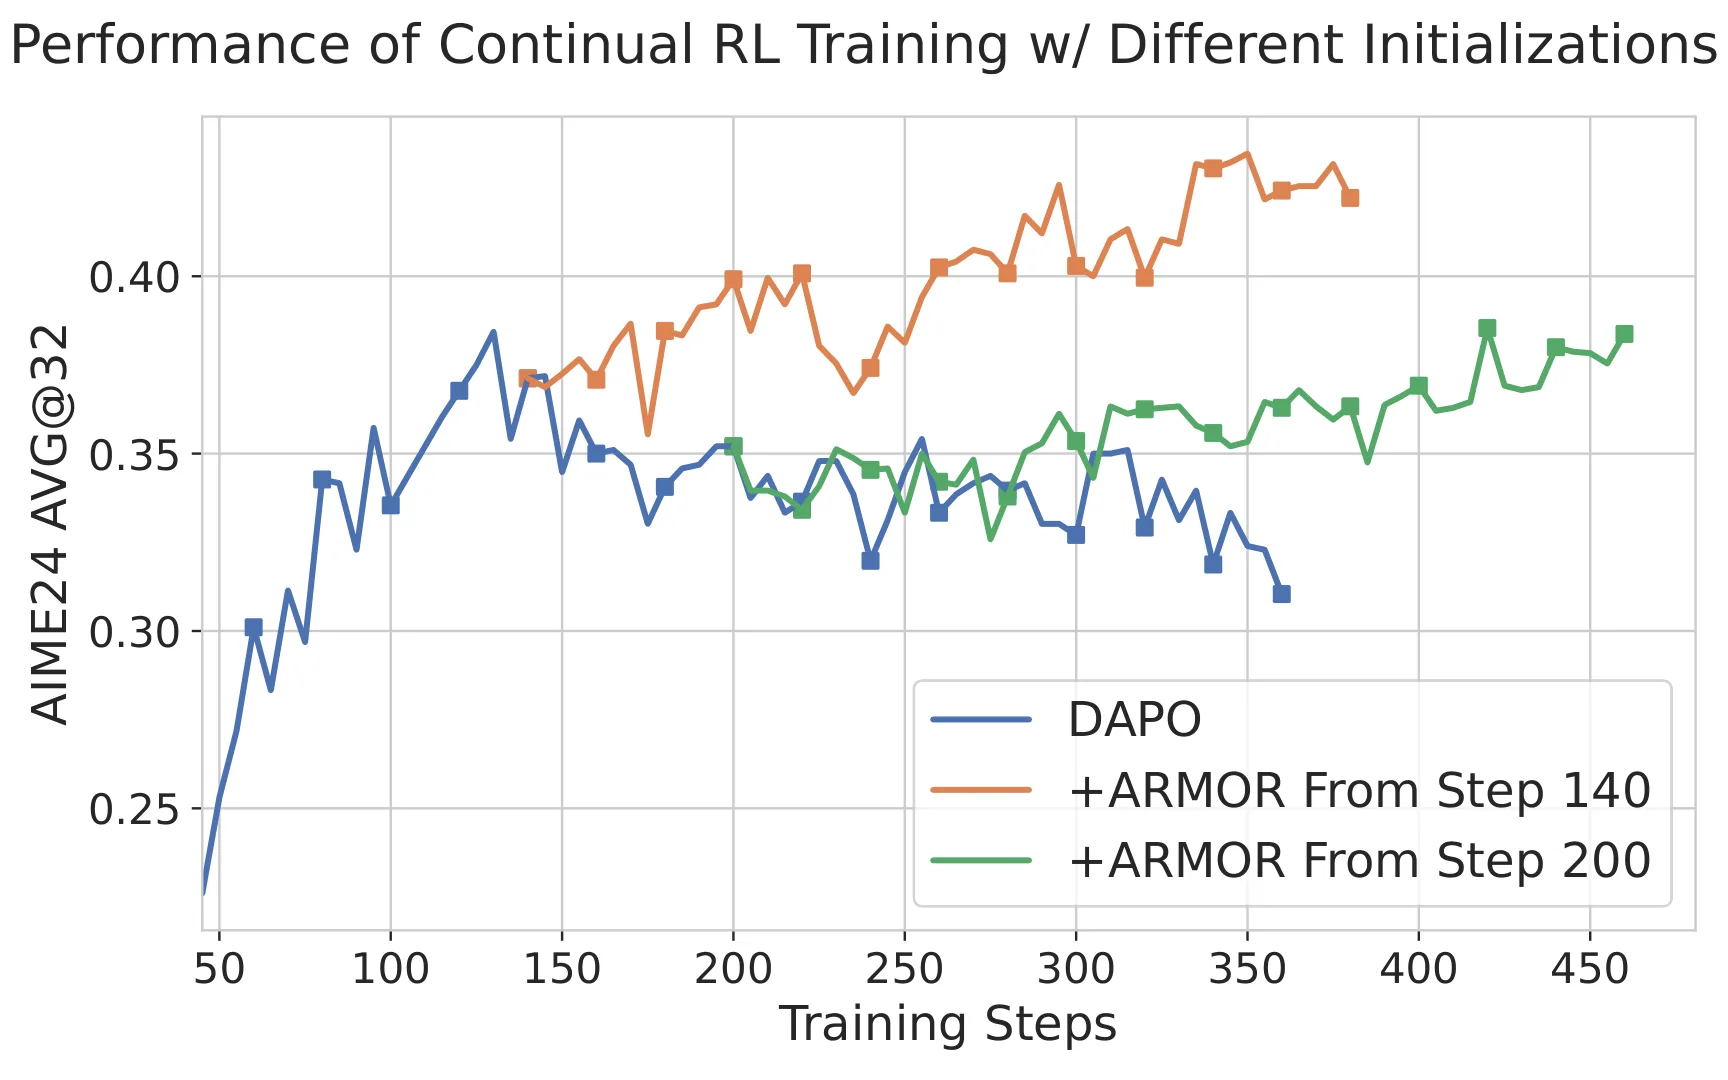
核心结果可以用一个关键词概括:稳定性。基线方法在训练初期往往能快速提升,但随着步数增加,验证性能很快出现平台期甚至显著下降,这正是过度优化的典型表现。ARMOR 则呈现出截然不同的曲线——初期提升速度可能略慢于基线,但性能能够维持上升趋势,在 2-3 倍于基线崩溃点的训练时长下仍未出现明显退化。具体数字上,ARMOR 在 MATH 基准上最终取得了比基线高 5-8 个百分点的提升,HumanEval 上的优势也稳定在 3-5 个百分点。
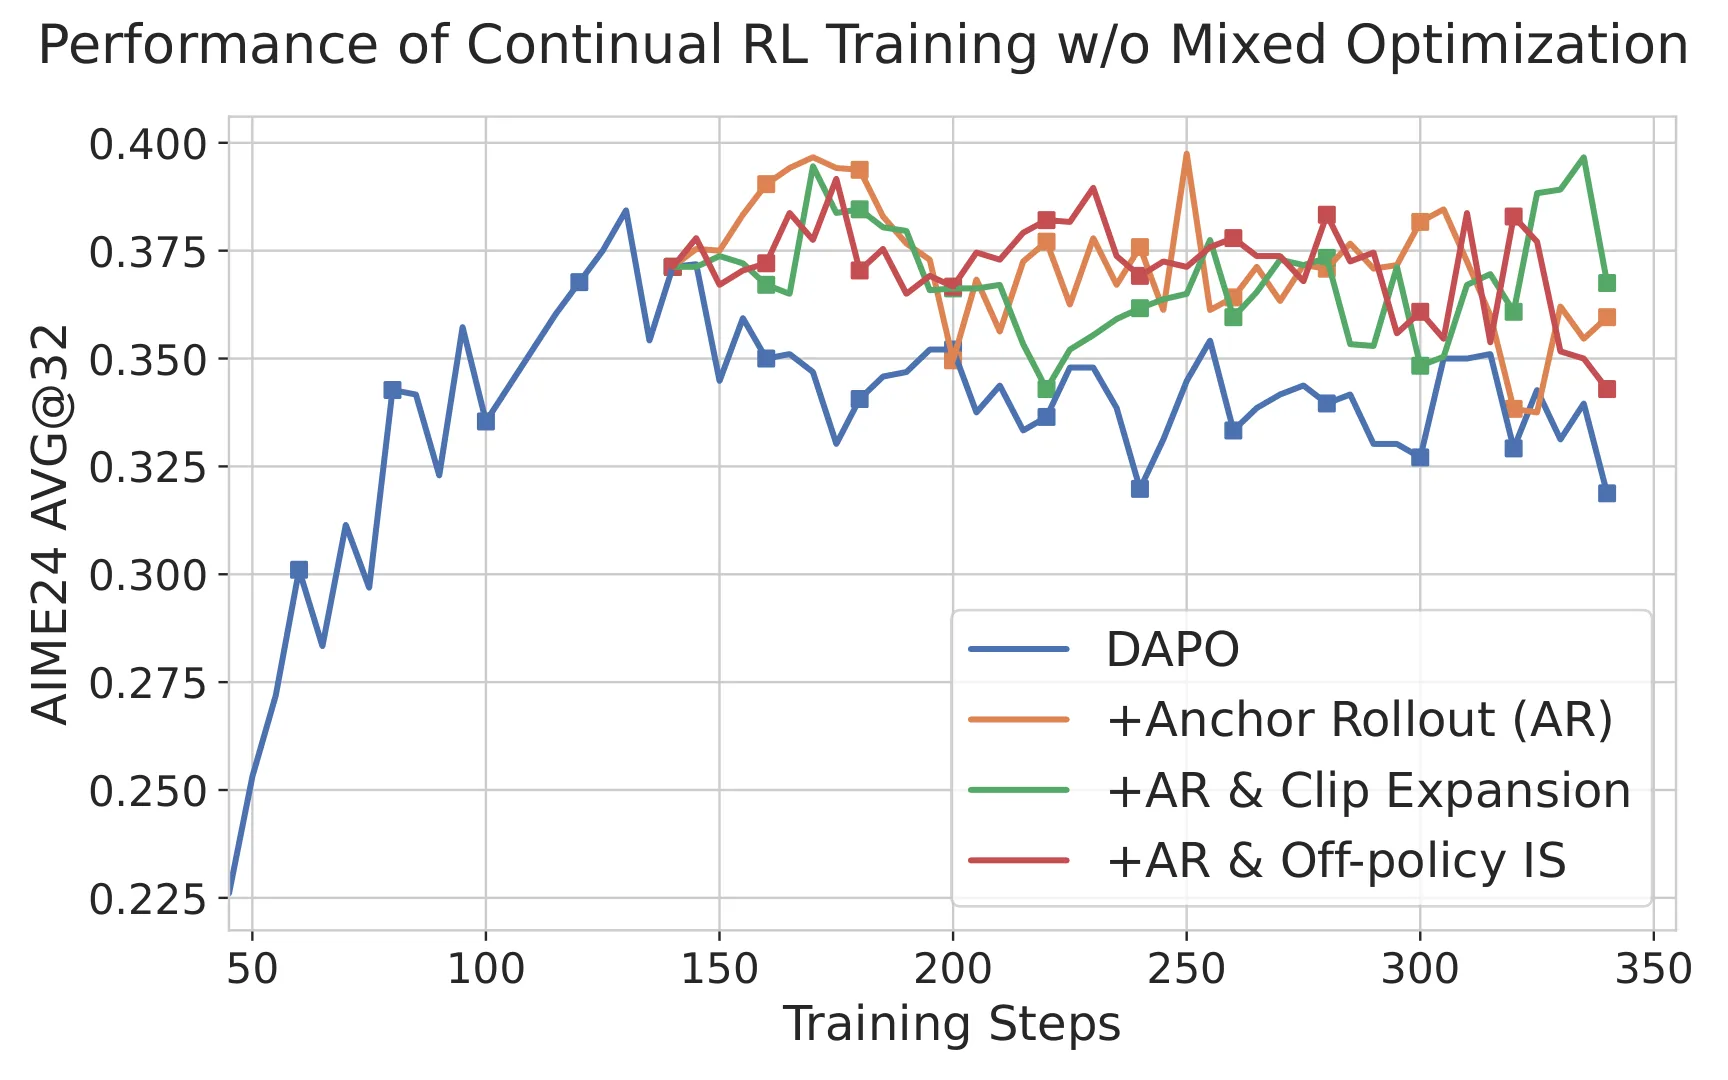
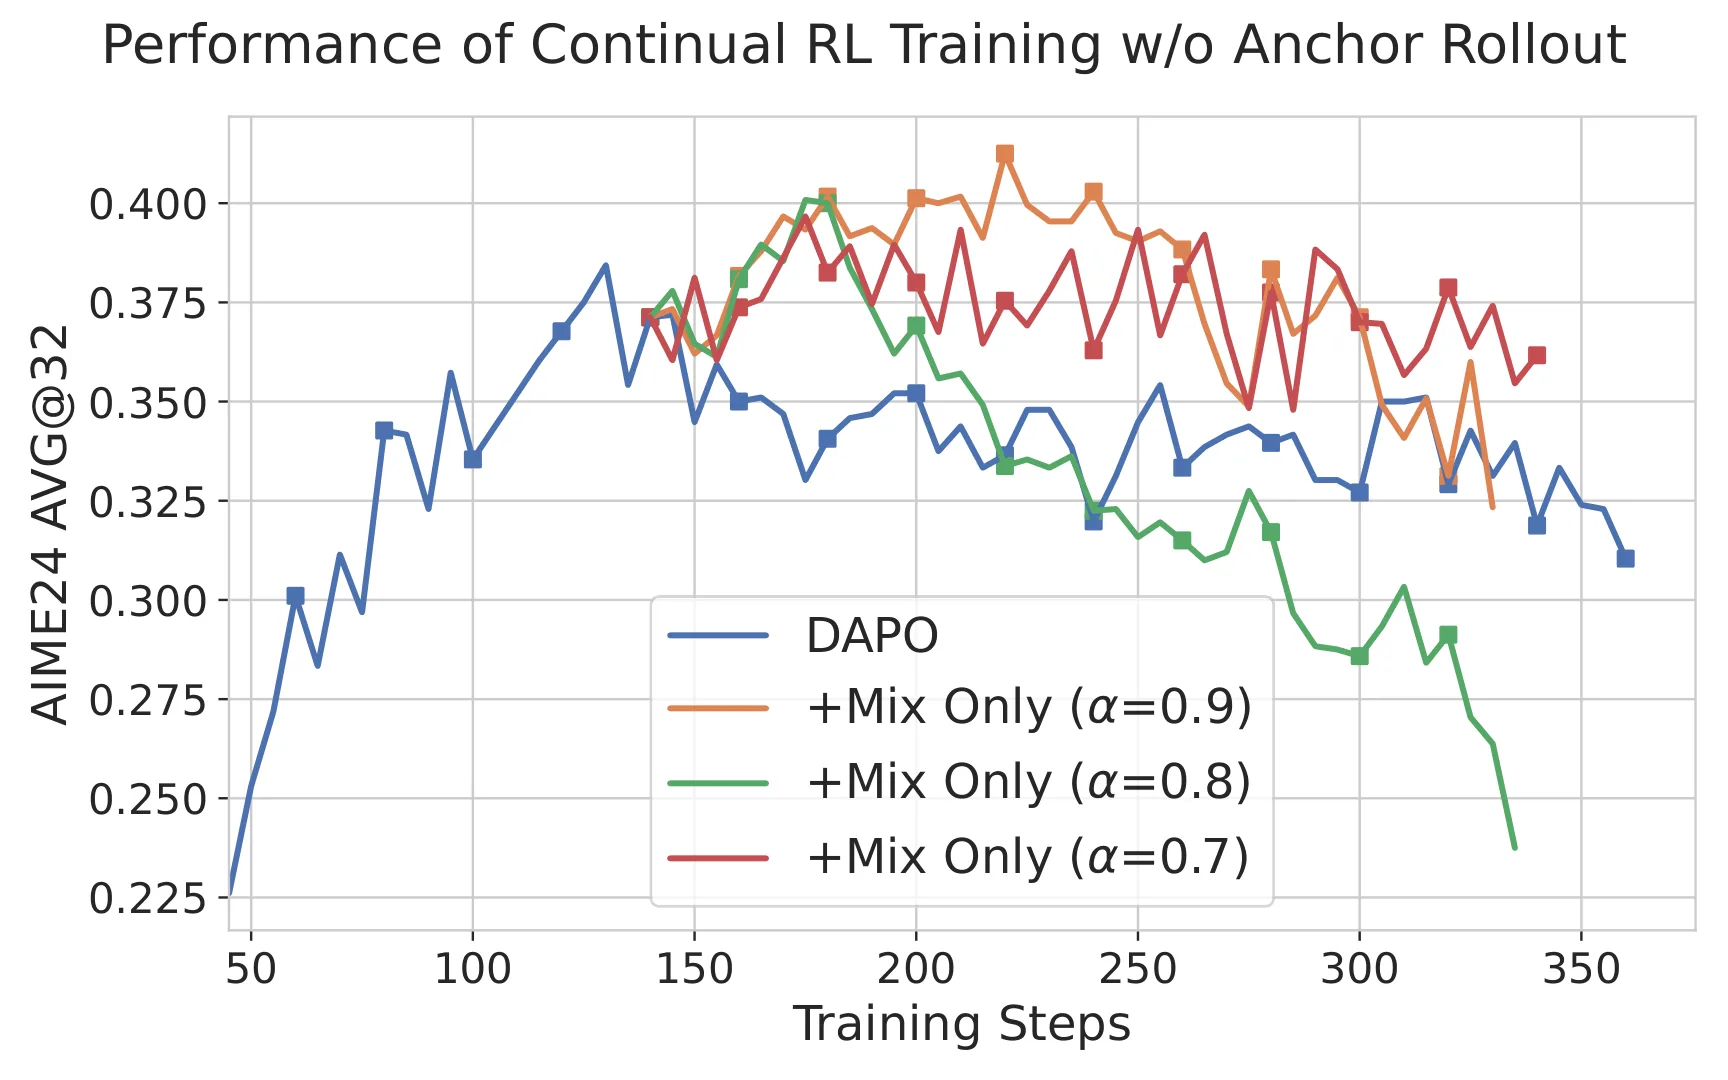
消融实验进一步证实了两个组件的必要性。仅使用锚点采样时,稳定性提升明显但最终性能仍有上限;仅使用混合优化时,效果介于两者之间。这说明锚点采样提供了样本层面的引导,而混合优化确保了这种引导在梯度层面被正确利用——两者缺一不可。
讨论与可借鉴点
ARMOR 的一个重要贡献是对过度优化问题的理论剖析。论文指出 [[反向 KL 正则化]] 在该场景下的局限性并非实现细节的问题,而是其数学形式本身的固有缺陷——它关注的是分布间距离的某种度量,却无法保证对参考分布全域的覆盖。这一观察值得深思:当我们设计正则化机制时,是否充分考虑了目标问题的结构特性?
从实践角度看,ARMOR 的框架具有不错的通用性。虽然论文聚焦于 LLM 推理场景,但其核心思路——用离线锚点样本稳定在线学习、用混合目标替代辅助损失——完全可以迁移到其他使用强化学习训练离散生成模型的场景。这为处理类似不稳定问题提供了一个可操作的解决思路。
当然,ARMOR 也有其局限。首先,锚点采样的引入会增加一定的计算开销(需要存储和采样参考轨迹),在超大规模训练中可能成为瓶颈。其次,混合优化中的权重调度策略(何时降低锚点权重)目前依赖经验设定,缺乏理论指导。此外,论文主要验证的是推理类任务,对于更开放的生成任务(如对话、创意写作),过度优化的表现形态可能有所不同,ARMOR 的效果尚需进一步检验。
这些未解之谜也为后续研究指明了方向:如何在保持稳定性的同时最小化计算开销?能否从理论上给出权重调度的最优策略?以及,这一范式能否推广到非推理类的 LLM 训练场景?这些问题值得探索。
摘要
强化学习(RL)显著提升了大语言模型(LLM)的推理能力,但其训练过程仍然极为脆弱。在本文中,我们探究了这种不稳定性的一个关键根源:过度优化——即模型以牺牲可泛化的推理能力为代价去利用训练中的启发式策略。尽管反向 KL 正则化是对抗此类退化的标准防御手段,我们的分析表明在该机制下它常常并不充分,因为它无法保证对参考分布的全面覆盖。为解决这一问题,我们提出了 ARMOR(Anchor Rollout and Mixed Optimization for RL,面向强化学习的锚点采样与混合优化),一个将范式从被动惩罚转变为主动样本稳定化的框架。ARMOR 包含两个关键组件:(1)Anchor Rollout(锚点采样),利用来自参考策略的离线策略数据来保留已建立的解题模式;(2)Mixed Optimization(混合优化),重新构建策略目标函数,使其能够在不依赖辅助损失的情况下实现受控探索。在多个推理基准上的大量实验验证了 ARMOR 能有效缓解验证集性能崩塌,使其在更长的训练周期内保持持续的性能提升。
Abstract
Reinforcement learning (RL) has significantly enhanced the reasoning capabilities of large language models (LLMs), yet the training process remains notoriously fragile. In this work, we investigate a critical source of this instability: over-optimization, where models exploit training heuristics at the expense of generalizable reasoning. While reverse KL regularization is the standard defense against such degradation, our analysis reveals that it is often insufficient in this regime, as it fails to ensure comprehensive coverage of the reference distribution. To address this, we propose ARMOR (Anchor Rollout and Mixed Optimization for RL), a framework that shifts the paradigm from passive penalty to active sample stabilization. ARMOR comprises two key components: (1) Anchor Rollout, which leverages off-policy data from the reference policy to preserve established solution patterns; and (2) Mixed Optimization, which reformulates the policy objective to enable controlled exploration without relying on auxiliary losses. Extensive experiments on reasoning benchmarks validate that ARMOR effectively mitigates validation collapse, enabling sustained performance improvements over extended training horizons.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。